

Comment réduire les temps d’arrêt du réseau

Les personnes qui ne travaillent pas dans le domaine de la technologie pourraient entendre « temps d’arrêt » et penser avec nostalgie aux vacances. Mais pour les professionnels de la technologie, le temps d’arrêt est un gros mot — et à juste titre. Un temps d’arrêt du réseau signifie une mauvaise journée au bureau.
Un temps d’arrêt du réseau signifie des clients mécontents, une productivité en chute libre et d’autres problèmes. Lorsqu’il s’agit d’applications destinées aux clients, comme un site web, le temps d’arrêt est coûteux : il coûte aux grandes entreprises environ 9 000 $ par minute.
Et bien que les temps d’arrêt puissent avoir un impact négatif sur les entreprises de tous types et de toutes tailles, ils sont particulièrement problématiques dans certains secteurs. Une entreprise de vente au détail pourrait perdre 1,1 million de dollars par heure d’interruption.

TL;DR : les temps d’arrêt sont mauvais.
Réduire et prévenir les temps d’arrêt, en revanche, est une bonne chose. En fait, c’est indispensable — car même de courtes périodes d’interruption du réseau peuvent nuire aux résultats financiers et causer des dommages collatéraux, comme une atteinte à la réputation.
Dans cet article, nous définirons le problème et ce qui est nécessaire pour le résoudre, notamment un cadre en 13 étapes pour élaborer votre propre plan de réduction des temps d’arrêt du réseau. Commençons par établir une définition simple.
Qu’est-ce qu’un temps d’arrêt du réseau ?
Un temps d’arrêt du réseau désigne l’indisponibilité d’une partie ou de la totalité d’un réseau informatique, rendant inaccessibles pendant un certain temps des éléments tels qu’un site web ou des applications internes comme un système ERP.
Les temps d’arrêt peuvent généralement être regroupés en deux grandes catégories : planifiés et non planifiés. Un temps d’arrêt planifié est exactement ce que son nom indique : il est intentionnel et programmé, généralement pour des opérations telles que la maintenance de routine, les mises à niveau du système ou la migration d’une application.
Lorsque nous disons que les temps d’arrêt du réseau sont néfastes, nous parlons réellement des temps d’arrêt du réseau non planifiés — c’est-à-dire lorsque le réseau tombe en panne de manière inattendue pour diverses raisons potentielles. Les causes peuvent être multiples : problèmes d’infrastructure, bogues logiciels, erreurs humaines ou cyberattaques.
De quoi — et de qui — a-t-on besoin pour minimiser les temps d’arrêt du réseau ?
Compte tenu des coûts quantitatifs et qualitatifs, même des temps d’arrêt peu fréquents du réseau justifient la mise en place de mesures correctives. Et si la tendance passe de temps d’arrêt peu fréquents à fréquents, il est alors temps de résoudre le problème avec davantage d’urgence.
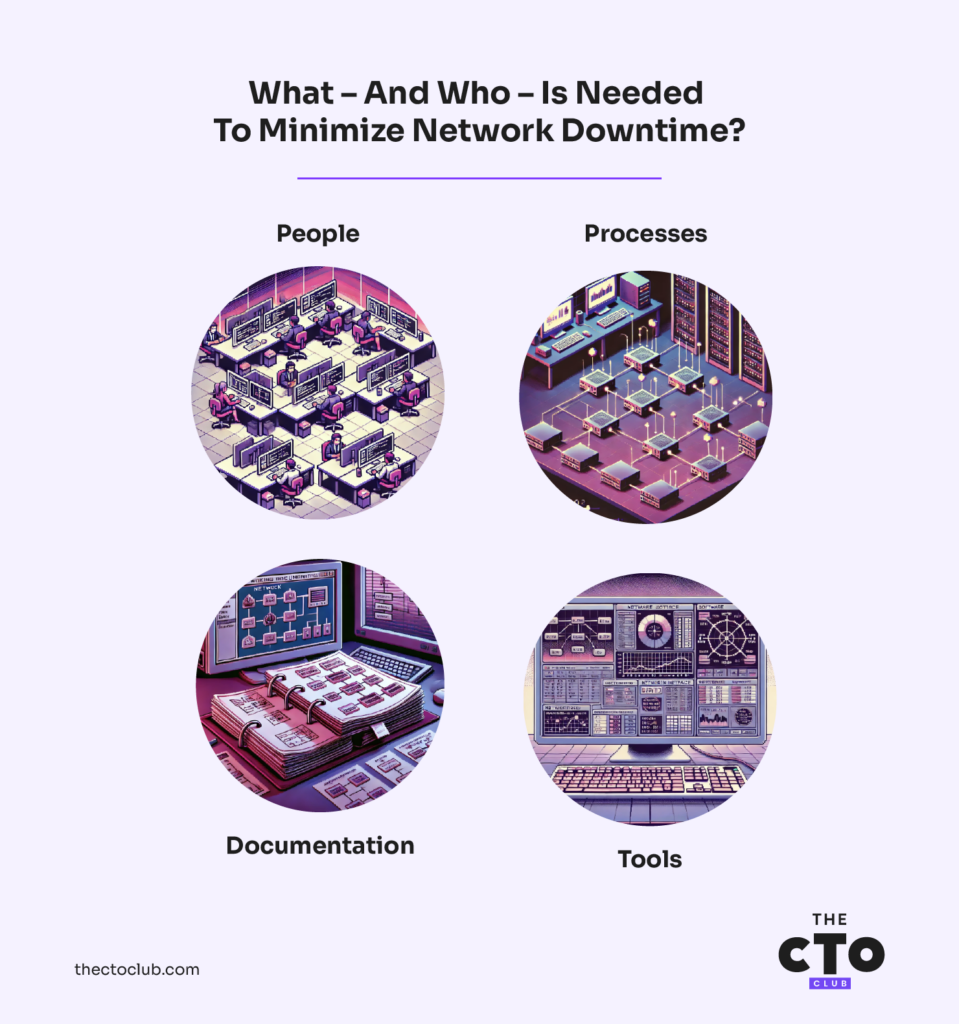
Il existe un ensemble de personnes, de processus, de documents et d’outils que vous devriez d’abord organiser, explique Viacheslav Petrenko, directeur de la technologie de l’entreprise de développement logiciel LITSLINK.
Petrenko a partagé ses conseils sur les principaux éléments à mettre en ordre avant de lancer une nouvelle initiative visant à réduire les temps d’arrêt du réseau. Ceux-ci peuvent être orientés vers l’avenir ou relever de l’historique. Ils comprennent :
Documentation
Petrenko conseille de rassembler les schémas de topologie du réseau, les rapports d’incident, les accords de niveau de service (SLA) et les journaux de gestion des changements comme documentation fondamentale.
Toute autre documentation pertinente, propre à l’organisation ou au réseau, mérite également d’être conservée à portée de main.
Processus
Les experts recommandent d’analyser plusieurs processus — ou de les mettre en place s’ils n’existent pas encore — dans le cadre d’une initiative de disponibilité du réseau. Ils comprennent :
Protocole d’analyse des causes profondes (RCA) : Il s’agit d’un processus fondamental pour réduire les temps d’arrêt du réseau, car son objectif ultime est d’identifier la ou les causes précises du problème. L’analyse des causes profondes « garantit une enquête approfondie sur chaque incident de temps d’arrêt afin d’éviter sa récurrence », explique Petrenko.
Article connexe : 5 outils d’analyse des causes profondes pour améliorer les tests et l’assurance qualité
Processus de gestion des changements : Il réduit les risques en contrôlant et en documentant soigneusement tous les changements apportés au réseau. Attention : il faut trouver un équilibre entre rigueur et agilité afin d’éviter les goulots d’étranglement.
Plans de reprise après sinistre et de continuité des activités : Tout effort visant à réduire les temps d’arrêt du réseau doit s’appuyer sur les plans plus larges de l’organisation en matière de résilience face aux perturbations opérationnelles majeures — et inversement.
Article connexe : Décryptage des 25 meilleurs services de reprise après sinistre
Calendrier de maintenance du réseau : La maintenance proactive — qui peut parfois entraîner un temps d’arrêt planifié — « contribue à prévenir les problèmes avant qu’ils ne surviennent en mettant régulièrement à jour et en optimisant le réseau », explique Petrenko.
Personnes
Pratiquement tout le monde dans une organisation dépend de son réseau, mais cela ne signifie pas que tous doivent participer à l’optimisation de ses performances et de sa fiabilité. Petrenko énumère les rôles suivants comme étant importants à inclure dans le processus. Gardez à l’esprit que les intitulés de poste spécifiques peuvent varier d’une entreprise à l’autre.
Ingénieurs réseau : Il va sans dire que les professionnels qui mettent en œuvre et assurent la maintenance de votre infrastructure réseau doivent participer au processus.
Administrateurs systèmes : De même, les personnes qui gèrent les serveurs (et les autres éléments de l’infrastructure) ainsi que les applications qui dépendent du réseau doivent être impliquées. Les intitulés associés peuvent notamment inclure ingénieur DevOps, ingénieur en fiabilité des sites et ingénieur infrastructure.
Professionnels de la sécurité : Impliquer votre personnel chargé de la sécurité contribue à « garantir la sécurité du réseau et à se protéger contre les interruptions causées par des attaques ou des violations », affirme Petrenko.
Analystes de données : Comme le montre la documentation présentée ci-dessus, l’optimisation d’un réseau implique l’analyse de grandes quantités de données de performance et d’autres informations. Vous avez besoin de personnes possédant les compétences nécessaires pour interpréter ces données et générer des informations utiles à l’amélioration.
Chef de projet : Dans les grandes entreprises notamment, il peut être nécessaire qu’une personne coordonne les efforts entre les équipes et veille au respect du calendrier.
Outils
Nous aborderons plus en détail ci-dessous les outils permettant de réduire les interruptions du réseau, mais disons pour l’instant que vous en aurez besoin, en vous concentrant notamment (sans toutefois vous y limiter) sur la surveillance, la journalisation, les tests et la planification. Les catégories spécifiques comprennent :
Logiciels de surveillance réseau : Vous ne pouvez pas résoudre des problèmes si vous ne savez même pas qu’ils existent. Ces outils assurent une visibilité en temps réel sur votre réseau et ses performances, et peuvent générer des alertes en cas de problèmes potentiels.
Outils de gestion de la configuration : Les outils de gestion de la configuration peuvent automatiser et suivre les modifications apportées à l’infrastructure et aux appareils réseau, ce qui, souligne Petrenko, peut réduire le risque d’erreur humaine lors de ces modifications.
Logiciels de gestion des journaux et outils d’analyse des journaux : La journalisation est un moyen essentiel d’établir les schémas de référence et le comportement « normal » d’un réseau, puis d’identifier les activités anormales avant qu’elles ne provoquent potentiellement une interruption.
Outils de test automatisé : L’automatisation des tests et des activités d’assurance qualité permet de détecter plus rapidement les problèmes et réduit également la quantité d’efforts humains nécessaires.
Logiciels de planification de capacité : La planification de capacité, souvent proposée comme fonctionnalité des outils de surveillance réseau, peut aider à prévoir les besoins futurs du réseau et à éviter les interruptions dues à une surcharge. Petrenko précise que cela nécessite des données d’entrée précises et des mises à jour régulières pour rester efficace.
-

NinjaOne
Visit WebsiteThis rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.4.7 -
Datadog
Visit WebsiteThis rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.4.5 -
Paessler PRTG
Visit WebsiteThis rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.4.6



Réduire les interruptions du réseau en 13 étapes
Alors, que faire concrètement de tout ce qui précède ? Nous avons ce qu’il vous faut : Petrenko nous a présenté un plan d’action en 13 étapes que vous pouvez utiliser pour élaborer votre propre stratégie en fonction des caractéristiques et des objectifs spécifiques de votre organisation et de son réseau.
Passons aux choses sérieuses :
- Évaluer la situation actuelle : C’est ici que vous rassemblez, organisez et analysez tous les éléments abordés ci-dessus, y compris la documentation et les autres données pertinentes.
Conseil de Petrenko : « Envisagez de faire appel à des consultants externes pour obtenir un point de vue impartial, mais veillez à impliquer toutes les parties prenantes internes afin d’avoir une vision complète. »
- Définir vos objectifs : « Réduire les interruptions » est un objectif général pertinent, mais décomposez-le en cibles plus précises pour les performances de votre réseau.
Conseil de Petrenko : « Ces objectifs doivent être ambitieux, mais réalistes, en tenant compte des normes du secteur et des besoins spécifiques de l’entreprise. »
- Constituer votre équipe : Créez une équipe pluridisciplinaire disposant des compétences, des connaissances et de l’autorité décisionnelle nécessaires pour obtenir des résultats.
Conseil de Petrenko : « Évitez de créer des silos et établissez de bons canaux de communication entre tous les membres de l’équipe. »
- Mettre en œuvre des outils de surveillance : Des logiciels complets de surveillance et d’analyse du réseau sont essentiels à toute initiative visant à garantir la disponibilité du réseau.
Conseil de Petrenko : « Vous devrez choisir entre des solutions sur site, infonuagiques ou hybrides en fonction de votre infrastructure. »
- Établissez vos indicateurs clés et vos valeurs de référence : Vous ne pouvez pas progresser vers un objectif si vous ne savez pas d’où vous partez.
Conseil de Petrenko : « Mesurez les performances actuelles afin de définir un point de départ pour les améliorations. Il est essentiel que ces indicateurs soient cohérents et pertinents par rapport à vos objectifs définis. »
- Identifiez et hiérarchisez les problèmes critiques : Selon l’état actuel de votre réseau, il est peu probable que vous puissiez résoudre tous les problèmes sous-jacents en même temps. Vous devez donc donner la priorité aux causes les plus importantes des temps d’arrêt. La « gravité » peut être comprise de manière globale en fonction des objectifs de votre organisation, comme le souligne Petrenko ci-dessous.
Conseil de Petrenko : ”Lors de la hiérarchisation, tenez compte à la fois de la fréquence et de l’impact des problèmes.”
- Développez votre stratégie : Élaborez un plan détaillé pour traiter tous les problèmes identifiés (une fois les problèmes prioritaires résolus), en incluant les échéances et l’allocation des ressources.
Conseil de Petrenko : ”N’oubliez pas de ne pas essayer de tout résoudre en même temps ; établissez vos priorités en fonction de l’impact et de la faisabilité.”
- Mettez en place des systèmes de redondance et de basculement : La redondance des composants réseau critiques et les processus automatisés de basculement sont tous deux des éléments essentiels d’une stratégie à long terme visant à assurer les performances et la résilience du réseau.
Conseil de Petrenko : « Cela peut inclure du matériel redondant, des architectures réseau multipaths ou des systèmes de basculement basés sur le cloud. Veillez à ce que votre redondance n’introduise pas une complexité inutile qui pourrait elle-même devenir une source de problèmes. »
- Mettez en œuvre les changements : Il est temps de passer à l’exécution, en commençant par les éléments prioritaires.
Conseil de Petrenko : « Veillez à suivre les processus de gestion des changements afin de réduire le risque d’introduire de nouveaux problèmes. »
- Surveillez et ajustez : Aucun plan n’est jamais parfait, alors préparez-vous à vous adapter au fur et à mesure de la mise en œuvre de votre stratégie.
Conseil de Petrenko : « Suivez continuellement les indicateurs de performance et ajustez le plan si nécessaire. Vous pourriez mettre en place des alertes automatisées pour réagir rapidement aux problèmes émergents. »
- Organisez régulièrement des formations professionnelles : Toute initiative de grande envergure visant à réduire les temps d’arrêt impliquera inévitablement que les équipes apprennent de nouvelles technologies et de nouveaux processus. Ne vous attendez pas à ce que le personnel se débrouille simplement au fur et à mesure.
Conseil de Petrenko : « Mettez en place des programmes de formation continue pour que le personnel reste informé des meilleures pratiques et des nouvelles technologies. Ces programmes doivent inclure des formations techniques et procédurales afin de garantir que tous les membres de l’équipe disposent des compétences nécessaires pour prévenir les problèmes de temps d’arrêt et y répondre. »
- Effectuez des exercices de reprise après sinistre : Comme pour la plupart des types de plans d’urgence, vous espérez évidemment ne jamais avoir à les utiliser réellement. Mais si cela devait arriver, vous voudriez vous assurer d’avoir testé vos plans au moyen de pannes simulées et d’autres problèmes.
Conseil de Petrenko : « Essayez de rendre ces exercices aussi réalistes que possible sans risquer de provoquer un véritable temps d’arrêt. »
- Suivez et communiquez vos progrès : Évaluez régulièrement vos progrès par rapport aux objectifs (étape 2) ainsi que les améliorations de vos indicateurs de référence, et communiquez les résultats aux parties prenantes.
Conseil de Petrenko : « Dans vos rapports, utilisez à la fois des indicateurs techniques et des mesures de l’impact commercial afin de donner une vision complète. »
Outils pour réduire les temps d’arrêt du réseau
Quels logiciels et autres outils peuvent jouer un rôle essentiel dans la réduction des temps d’arrêt et l’amélioration globale de la santé et des performances du réseau ? Nous avons inclus des exemples dans chaque catégorie.
1. Outils de surveillance du réseau
- Moniteur de performances réseau SolarWinds (NPM) : Fournit une surveillance complète des performances du réseau, la détection des pannes et des alertes.
- Nagios : Offre de solides fonctionnalités de surveillance, d’alerte et de création de rapports réseau.
- Moniteur réseau PRTG : Un outil polyvalent qui surveille tous les aspects de votre infrastructure réseau.
2. Outils de gestion et de configuration du réseau
- Cisco Prime Infrastructure : Aide à gérer et à optimiser votre infrastructure réseau.
- WhatsUp Gold : Fournit la surveillance et la gestion du réseau, y compris la gestion de la configuration.
3. Outils automatisés de réponse aux incidents
- PagerDuty : S’intègre aux outils de surveillance pour assurer la réponse aux incidents et l’envoi automatisé d’alertes.
- Opsgenie : Offre la gestion des astreintes, la réponse aux incidents et l’envoi d’alertes.
4. Outils de gestion des pannes
- Zabbix : Surveille les performances du réseau et aide à détecter et à résoudre les pannes.
- ManageEngine OpManager : Fournit la gestion des pannes, la surveillance des performances et la visualisation du réseau.
5. Outils de sauvegarde et de restauration de la configuration réseau
- RANCID (Really Awesome New Cisco confIg Differ) : Automatise la sauvegarde et la gestion de la configuration des appareils réseau.
- SolarWinds Network Configuration Manager (NCM) : Automatise la sauvegarde et la récupération de la configuration et contribue à garantir la conformité.
6. Gestion des journaux et outils d’analyse
- Splunk : Collecte et analyse les journaux des appareils réseau afin d’identifier et de résoudre les problèmes.
- ELK Stack (Elasticsearch, Logstash, Kibana) : Offre de puissantes fonctionnalités de gestion et d’analyse des journaux.
7. Analyse du trafic réseau
- Wireshark : Analyseur de protocoles réseau qui aide à diagnostiquer les problèmes du réseau.
- NetFlow Analyzer : Surveille le trafic réseau et aide à identifier les goulots d’étranglement.
8. Solutions de haute disponibilité et de basculement
- F5 BIG-IP : Fournit l’équilibrage de charge, le basculement et la haute disponibilité pour les services réseau.
- Cisco ASA : Offre de solides fonctionnalités de pare-feu et de basculement.
9. Tests de performances réseau
- iPerf : Mesure la bande passante et les performances du réseau.
- SolarWinds WAN Killer : Simule le trafic réseau afin de tester les performances du réseau dans différentes conditions.
10. Réseau privé virtuel (VPN)
- OpenVPN : Fournit un accès distant sécurisé au réseau et garantit la connectivité pendant les interruptions de service.
- Cisco AnyConnect : Solution VPN sécurisée qui fournit un accès distant aux ressources réseau.
11. Surveillance des points de terminaison
- Sysdig : Surveille et sécurise les environnements conteneurisés et l’infrastructure cloud.
- Datadog : Fournit une surveillance complète de la pile, notamment du réseau, des serveurs et des applications.
12. Outils de surveillance réseau basés sur le cloud
- ThousandEyes : Fournit une visibilité de bout en bout sur les performances du réseau via Internet et le cloud.
- LogicMonitor : Outil de surveillance basé sur le cloud qui offre des fonctionnalités complètes de surveillance réseau.
En résumé
Les interruptions de service réseau sont une réalité pour la plupart des organisations, mais cela ne signifie pas que vous devez les laisser sans surveillance. Utilisez le plan d’action et les outils ci-dessus pour améliorer les performances de votre réseau et réduire les temps d’arrêt coûteux.
Pour obtenir davantage d’informations sur les réseaux, veuillez vous abonner à notre newsletter. Nous vous aidons à créer des équipes et des systèmes SaaS capables de passer à l’échelle !

