

Cómo reducir el tiempo de inactividad de la red

Las personas no técnicas podrían oír “tiempo de inactividad” y pensar con nostalgia en unas vacaciones. Pero para los profesionales de la tecnología, el tiempo de inactividad es una expresión maldita, y con razón. El tiempo de inactividad de la red significa un mal día en la oficina.
El tiempo de inactividad de la red significa clientes insatisfechos, una productividad en picado y otros problemas. Cuando hablamos de aplicaciones orientadas al cliente, como un sitio web, el tiempo de inactividad es costoso: para las empresas más grandes, cuesta aproximadamente $9,000 por minuto.
Y aunque el tiempo de inactividad puede afectar negativamente a empresas de todo tipo y tamaño, resulta especialmente problemático en ciertos sectores. Un negocio minorista podría perder $1.1 millones por hora de tiempo de inactividad.

En resumen: el tiempo de inactividad es malo.
Reducir y prevenir el tiempo de inactividad, por otro lado, es bueno. De hecho, es imprescindible, porque incluso pequeñas cantidades de tiempo de inactividad de la red pueden perjudicar los resultados y causar daños colaterales, como daños a la reputación.
En este artículo definiremos el problema y lo que se necesita para resolverlo, incluido un marco de 13 pasos para desarrollar tu propio plan de reducción del tiempo de inactividad de la red. Primero, conviene basarnos en una definición sencilla.
¿Qué es el tiempo de inactividad de la red?
El tiempo de inactividad de la red se refiere a que una parte o la totalidad de una red de TI deja de estar disponible, lo que hace que elementos como un sitio web o aplicaciones internas, como un sistema ERP, sean inaccesibles durante cierto tiempo.
Por lo general, el tiempo de inactividad puede agruparse en dos grandes categorías: planificado y no planificado. El tiempo de inactividad planificado es precisamente eso: intencional y programado, normalmente para tareas como mantenimiento rutinario, actualizaciones del sistema o migración de una aplicación.
Cuando decimos que el tiempo de inactividad de la red es malo, realmente nos referimos al tiempo de inactividad no planificado de la red: ocurre cuando la red deja de funcionar inesperadamente por cualquiera de una serie de posibles razones. Puede haber todo tipo de causas para el tiempo de inactividad, desde problemas de infraestructura y errores de software hasta errores humanos y ciberataques.
¿Qué y quién se necesita para minimizar el tiempo de inactividad de la red?
Dados los costos cuantitativos y cualitativos, vale la pena tomar medidas para abordar incluso un tiempo de inactividad de la red poco frecuente. Y si la tendencia comienza a pasar de poco frecuente a frecuente, entonces es momento de resolver el problema con mayor urgencia.
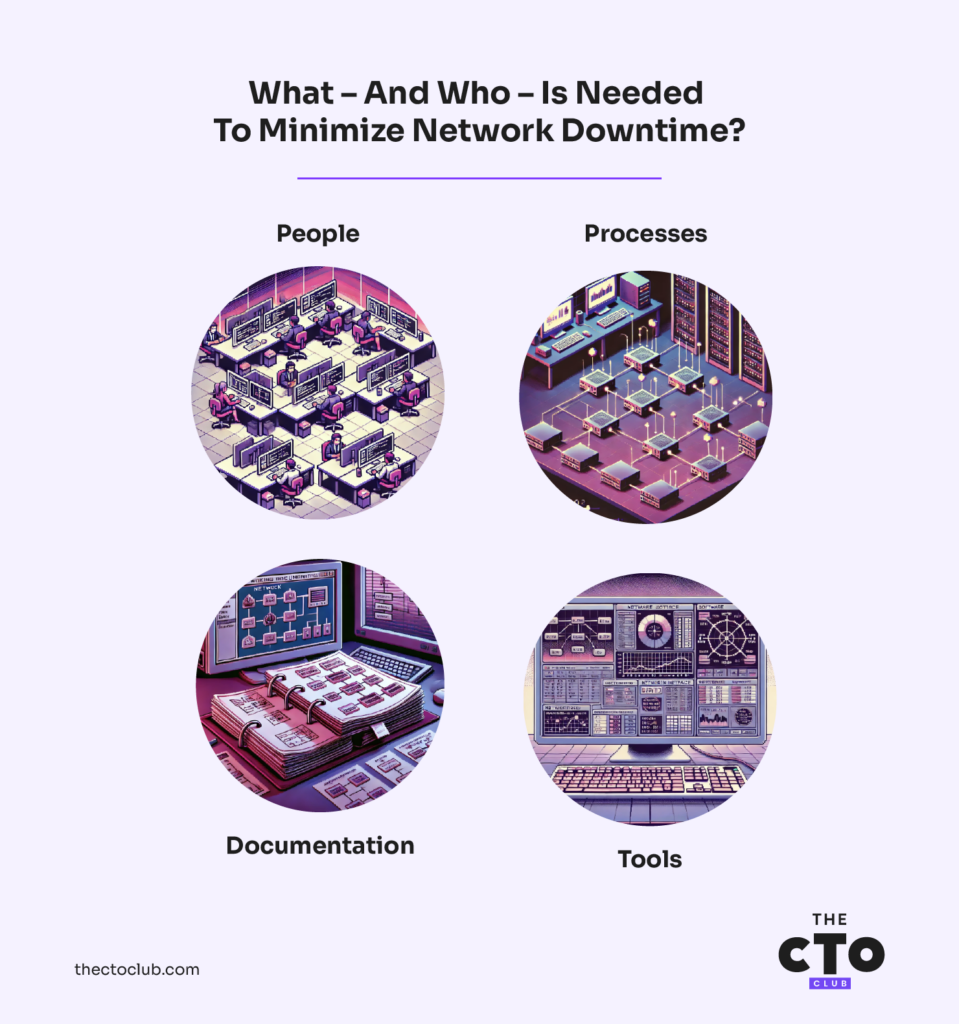
Hay una combinación de personas, procesos, documentación y herramientas que deberías organizar primero, afirma Viacheslav Petrenko, director de tecnología de la empresa de desarrollo de software LITSLINK.
Petrenko compartió sus recomendaciones sobre los elementos clave que deberías poner en orden antes de emprender una nueva iniciativa para reducir el tiempo de inactividad de la red. Estos pueden ser tanto prospectivos como históricos. Incluyen:
Documentación
Petrenko recomienda recopilar diagramas de topología de red, informes de incidentes, acuerdos de nivel de servicio (SLAs) y registros de gestión de cambios como documentación fundamental.
También conviene tener a mano cualquier otra documentación relevante específica de la organización o de la red.
Procesos
Hay varios procesos que los expertos recomiendan analizar o implementar, si actualmente no existen, como parte de una iniciativa de disponibilidad de la red. Estos incluyen:
Protocolo de análisis de la causa raíz (RCA): Este es un proceso fundamental para reducir el tiempo de inactividad de la red, porque su objetivo principal es identificar la causa o causas específicas del problema. El análisis de la causa raíz “garantiza una investigación exhaustiva de cada incidente de tiempo de inactividad para evitar que vuelva a ocurrir”, afirma Petrenko.
Lectura relacionada: 5 herramientas de análisis de la causa raíz para mejorar las pruebas y el control de calidad
Proceso de gestión de cambios: Minimiza el riesgo mediante el control y la documentación cuidadosos de todos los cambios en la red. Precaución: debe equilibrar la exhaustividad con la agilidad para evitar cuellos de botella.
Planes de recuperación ante desastres y continuidad del negocio: Cualquier esfuerzo para reducir el tiempo de inactividad de la red debe basarse en los planes más amplios de la organización para mantener la resiliencia frente a importantes interrupciones operativas, y viceversa.
Lectura relacionada: Descifrando los 25 mejores servicios de recuperación ante desastres
Calendario de mantenimiento de la red: Realizar un mantenimiento proactivo, que en ocasiones puede implicar un tiempo de inactividad planificado, “ayuda a prevenir problemas antes de que ocurran mediante la actualización periódica y la optimización de la red”, afirma Petrenko.
Personas
Prácticamente todas las personas de una organización dependen de su red, pero eso no significa que todas deban participar en la optimización de su rendimiento y fiabilidad. Petrenko menciona los siguientes roles como importantes para incluir en el proceso. Ten en cuenta que los títulos específicos de los puestos pueden variar de una empresa a otra.
Ingenieros de redes: No hace falta decir que los profesionales que implementan y mantienen tu infraestructura de red deben formar parte del proceso.
Administradores de sistemas: Del mismo modo, deben participar las personas que gestionan los servidores (y otra infraestructura) y las aplicaciones que dependen de la red. Entre los títulos relacionados podrían incluirse ingeniero de DevOps, ingeniero de fiabilidad del sitio e ingeniero de infraestructura.
Profesionales de seguridad: Involucrar a tu personal de seguridad ayuda a “garantizar la seguridad de la red y protegerla contra el tiempo de inactividad causado por ataques o brechas de seguridad”, afirma Petrenko.
Analistas de datos: Como se desprende de la documentación mencionada anteriormente, optimizar una red implica analizar grandes cantidades de datos de rendimiento y otra información. Necesitas personas con las habilidades necesarias para interpretar esos datos y generar información útil para mejorar.
Jefe de proyecto: Especialmente en las grandes empresas, es posible que necesites a alguien que coordine los esfuerzos entre equipos y mantenga todo conforme al calendario.
Herramientas
A continuación, profundizaremos en las herramientas para reducir el tiempo de inactividad de la red, pero por ahora basta con decir que necesitarás algunas, con especial atención a la supervisión, el registro, las pruebas y la planificación, entre otros aspectos. Entre las categorías específicas se incluyen:
Software de supervisión de redes: No puedes resolver los problemas si ni siquiera sabes que existen. Estas herramientas proporcionan visibilidad en tiempo real de tu red y su rendimiento, y pueden generar alertas sobre posibles problemas.
Herramientas de gestión de configuraciones: Las herramientas de gestión de configuraciones pueden automatizar y realizar un seguimiento de los cambios en la infraestructura y los dispositivos de red, lo que, según señala Petrenko, puede reducir el riesgo de error humano cuando se realizan cambios.
Software de gestión de registros y herramientas de análisis de registros: El registro es un medio crucial para establecer patrones de referencia y un comportamiento “normal” en una red, y luego identificar actividades anómalas antes de que puedan causar una interrupción.
Herramientas de pruebas automatizadas: Automatizar las pruebas y los procesos de control de calidad ayuda a detectar los problemas más rápido y también reduce la cantidad de esfuerzo humano necesario.
Software de planificación de capacidad: La planificación de capacidad, que a menudo es una función de las herramientas de supervisión de redes, puede ayudar a predecir los futuros requisitos de la red y evitar el tiempo de inactividad debido a la sobrecarga. Petrenko señala que esto requiere datos de entrada precisos y actualizaciones periódicas para seguir siendo eficaz.
-

NinjaOne
Visit WebsiteThis rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.4.7 -
Datadog
Visit WebsiteThis rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.4.5 -
Paessler PRTG
Visit WebsiteThis rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.4.6



Reduce el tiempo de inactividad de la red en 13 pasos
Entonces, ¿qué haces realmente con todo lo anterior? Te ayudamos: Petrenko compartió con nosotros un plan de acción de 13 pasos que puedes utilizar para desarrollar tu propia estrategia basándote en las características y los objetivos específicos de tu organización y su red.
Empecemos:
- Evalúa el estado actual: Aquí es donde recopilas, organizas y analizas todos los componentes que hemos mencionado anteriormente, incluida la documentación y otros datos relevantes.
Consejo de Petrenko: “Considera la posibilidad de contratar consultores externos para obtener una perspectiva imparcial, pero asegúrate de que todas las partes interesadas internas participen para obtener una visión completa”.
- Define tus objetivos: “Reducir el tiempo de inactividad” es un buen objetivo general, pero divídelo en metas más específicas para el rendimiento de tu red.
Consejo de Petrenko: “Estos objetivos deben ser ambiciosos pero realistas, teniendo en cuenta los estándares del sector y las necesidades específicas de la empresa”.
- Forma tu equipo: Crea un equipo multifuncional con las habilidades, los conocimientos y la autoridad para tomar decisiones necesarios para lograr resultados.
Consejo de Petrenko: “Evita crear silos y establece buenos canales de comunicación entre todos los miembros del equipo”.
- Implementa herramientas de supervisión: Un software completo de supervisión y análisis de redes es fundamental para cualquier iniciativa destinada a garantizar el tiempo de actividad de la red.
Consejo de Petrenko: “Tendrás que decidir entre soluciones locales, basadas en la nube o híbridas según tu infraestructura”.
- Establece tus métricas clave y valores de referencia: No puedes avanzar hacia un objetivo si no sabes desde dónde partiste.
Consejo de Petrenko: “Mide el rendimiento actual para establecer un punto de partida para las mejoras. Es fundamental que estas métricas sean coherentes y relevantes para tus objetivos definidos”.
- Identifica y prioriza los problemas críticos: Dependiendo del estado actual de tu red, es poco probable que puedas resolver todos los problemas subyacentes a la vez. Por eso, prioriza las causas más importantes del tiempo de inactividad. La “importancia” puede entenderse de forma integral en función de los objetivos de tu organización, como señala Petrenko a continuación.
Consejo de Petrenko: ”Al establecer prioridades, considera tanto la frecuencia como el impacto de los problemas”.
- Amplía tu estrategia: Desarrolla un plan detallado para abordar todos los problemas identificados (una vez resueltos los problemas de alta prioridad), incluidos los plazos y la asignación de recursos.
Consejo de Petrenko: ”Recuerda que no debes intentar arreglarlo todo a la vez; establece prioridades según el impacto y la viabilidad”.
- Desarrolla sistemas de redundancia y conmutación por error: La redundancia en los componentes críticos de la red y los procesos automatizados de conmutación por error son componentes fundamentales de una estrategia a largo plazo para el rendimiento y la resiliencia de la red.
Consejo de Petrenko: “Esto podría incluir hardware redundante, diseños de red multipruta o sistemas de conmutación por error basados en la nube. Asegúrate de que la redundancia no introduzca una complejidad innecesaria que, por sí misma, pueda convertirse en una fuente de problemas”.
- Implementa los cambios: Es hora de ejecutarlos, comenzando por los elementos de mayor prioridad.
Consejo de Petrenko: “Asegúrate de seguir los procesos de gestión de cambios para minimizar el riesgo de introducir nuevos problemas”.
- Supervisa y ajusta: Ningún plan alcanza la perfección, así que prepárate para adaptarlo mientras desarrollas tu estrategia.
Consejo de Petrenko: “Realiza un seguimiento continuo de las métricas de rendimiento y ajusta el plan según sea necesario. Puede que quieras implementar alertas automatizadas para responder rápidamente a los problemas emergentes”.
- Realiza actividades periódicas de desarrollo profesional: Cualquier iniciativa a gran escala para reducir el tiempo de inactividad inevitablemente implicará que las personas aprendan nuevas tecnologías y procesos. No esperes que el personal simplemente lo resuelva sobre la marcha.
Consejo de Petrenko: “Implementa programas de formación continua para que el personal se mantenga actualizado sobre las mejores prácticas y las nuevas tecnologías. Esto debe incluir formación tanto técnica como procedimental para garantizar que todos los miembros del equipo estén preparados para prevenir y responder a los problemas de tiempo de inactividad”.
- Realiza simulacros de recuperación ante desastres: Como ocurre con la mayoría de los tipos de planificación para emergencias, obviamente esperas no tener que necesitarlos nunca. Pero, si los necesitas, querrás asegurarte de haber probado tus planes mediante interrupciones simuladas y otros problemas.
Consejo de Petrenko: “Intenta que estos simulacros sean lo más realistas posible sin arriesgarte a provocar un tiempo de inactividad real”.
- Haz un seguimiento e informa sobre tu progreso: Evalúa periódicamente tu progreso hacia los objetivos (Paso 2) y las mejoras en tus métricas de referencia, y comparte los resultados con las partes interesadas.
Consejo de Petrenko: “En tus informes, utiliza tanto métricas técnicas como medidas del impacto empresarial para ofrecer una visión completa”.
Herramientas para reducir el tiempo de inactividad de la red
¿Qué software y otras herramientas pueden desempeñar un papel fundamental en la minimización del tiempo de inactividad y la mejora general de la salud y el rendimiento de la red? Hemos incluido ejemplos en cada categoría.
1. Supervisión de redes: herramientas
- Monitor de rendimiento de red de SolarWinds (NPM): Proporciona supervisión integral del rendimiento de la red, detección de fallos y alertas.
- Nagios: Ofrece sólidas funciones de supervisión, alertas y generación de informes de red.
- Monitor de red PRTG: Una herramienta versátil que supervisa todos los aspectos de tu infraestructura de red.
2. Herramientas de gestión y configuración de redes
- Cisco Prime Infrastructure: Ayuda a gestionar y optimizar la infraestructura de red.
- WhatsUp Gold: Proporciona supervisión y gestión de redes, incluida la gestión de configuraciones.
3. Herramientas automatizadas de respuesta a incidentes
- PagerDuty: Se integra con herramientas de supervisión para proporcionar respuesta a incidentes y alertas automatizadas.
- Opsgenie: Ofrece gestión de guardias, respuesta a incidentes y alertas.
4. Herramientas de gestión de fallos
- Zabbix: Supervisa el rendimiento de la red y ayuda a detectar y resolver fallos.
- ManageEngine OpManager: Proporciona gestión de fallos, supervisión del rendimiento y visualización de redes.
5. Herramientas de copia de seguridad y restauración de la configuración de red
- RANCID (Really Awesome New Cisco confIg Differ): Automatiza la copia de seguridad y la gestión de la configuración de los dispositivos de red.
- SolarWinds Network Configuration Manager (NCM): Automatiza la copia de seguridad y la recuperación de configuraciones, y ayuda a garantizar el cumplimiento.
6. Gestión de registros y herramientas de análisis
- Splunk: Recopila y analiza registros de dispositivos de red para identificar y solucionar problemas.
- ELK Stack (Elasticsearch, Logstash, Kibana): Proporciona sólidas capacidades de gestión y análisis de registros.
7. Herramientas de análisis del tráfico
- Wireshark: Un analizador de protocolos de red que ayuda a diagnosticar problemas de red.
- NetFlow Analyzer: Supervisa los patrones del tráfico de red y ayuda a identificar cuellos de botella.
8. Soluciones de alta disponibilidad y conmutación por error
- F5 BIG-IP: Proporciona equilibrio de carga, conmutación por error y alta disponibilidad para servicios de red.
- Cisco ASA: Ofrece sólidas capacidades de cortafuegos y conmutación por error.
9. Herramientas de pruebas de rendimiento
- iPerf: Mide el ancho de banda y el rendimiento de la red.
- SolarWinds WAN Killer: Simula el tráfico de red para probar el rendimiento de la red en diferentes condiciones.
More Articles
- 10 Mejores Programas de Gestión de TI Analizados para 2026
- 23 herramientas de monitoreo de redes basadas en la nube para 2026
- Las 10 mejores herramientas gratuitas de monitorización de redes analizadas en 2026
- Las 10 mejores herramientas de monitoreo del rendimiento para SaaS
- Los 10 mejores programas de monitorización de redes analizados para 2026
10. Red privada virtual (VPN): herramientas
- OpenVPN: Proporciona acceso remoto seguro a la red, garantizando la conectividad durante las interrupciones del servicio.
- Cisco AnyConnect: Una solución VPN segura que proporciona acceso remoto a los recursos de red.
11. Herramientas de supervisión de puntos finales
- Sysdig: Supervisa y protege entornos en contenedores e infraestructura en la nube.
- Datadog: Proporciona supervisión de toda la pila, incluida la supervisión de redes, servidores y aplicaciones.
12. Herramientas de supervisión de redes basadas en la nube
- ThousandEyes: Proporciona visibilidad integral del rendimiento de la red a través de Internet y la nube.
- LogicMonitor: Una herramienta de supervisión basada en la nube que ofrece capacidades integrales de supervisión de redes.
La conclusión
El tiempo de inactividad de la red es una realidad para la mayoría de las organizaciones, pero eso no significa que debas dejarlo sin control. Utiliza el plan de acción y las herramientas anteriores para mejorar el rendimiento de tu red y minimizar los costosos tiempos de inactividad.
Para obtener más información sobre redes, suscríbete a nuestro boletín. ¡Te ayudamos a crear equipos y sistemas SaaS que escalen!


