

Come ridurre i tempi di inattività della rete

I non addetti ai lavori potrebbero sentire parlare di “inattività della rete” e pensare con nostalgia a una vacanza. Ma per i professionisti della tecnologia, l’inattività della rete è una parola sgradita – e a ragione. L’inattività della rete significa una brutta giornata in ufficio.
L’inattività della rete significa clienti insoddisfatti, produttività in caduta libera e altri problemi. Quando si parla di applicazioni rivolte ai clienti, come un sito web, l’inattività della rete è costosa: per le aziende più grandi, l’inattività della rete costa circa 9.000 $ al minuto.
E sebbene l’inattività della rete possa avere un impatto negativo sulle aziende di ogni tipo e dimensione, è particolarmente problematica in alcuni settori. Un’attività commerciale potrebbe perdere 1,1 milioni di $ per ogni ora di inattività.

TL;DR: l’inattività della rete è negativa.
Ridurre e prevenire l’inattività della rete, d’altra parte, è positivo. Anzi, è indispensabile, perché anche brevi periodi di inattività della rete possono danneggiare i profitti e causare danni collaterali, come compromettere la reputazione.
In questo articolo definiremo il problema e ciò che è necessario per risolverlo, compreso un framework in 13 passaggi per sviluppare il proprio piano di riduzione dell’inattività della rete. Per prima cosa, è utile partire da una definizione semplice.
Che cos’è l’inattività della rete?
L’inattività della rete indica che una parte o la totalità di una rete IT diventa non disponibile, rendendo inaccessibili per un certo periodo elementi come un sito web o applicazioni interne, ad esempio un sistema ERP.
In genere, l’inattività della rete può essere suddivisa in due grandi categorie: pianificata e non pianificata. L’inattività pianificata è esattamente ciò che suggerisce il nome: è intenzionale e programmata, di solito per attività come la manutenzione ordinaria, gli aggiornamenti del sistema o la migrazione di un’applicazione.
Quando diciamo che l’inattività della rete è negativa, intendiamo davvero l’inattività della rete non pianificata: si verifica quando la rete si interrompe inaspettatamente per una qualsiasi delle molte possibili ragioni. Le cause dell’inattività della rete possono essere di ogni tipo: problemi infrastrutturali, bug del software, errori umani o attacchi informatici.
Cosa – e chi – è necessario per ridurre al minimo l’inattività della rete?
Considerati i costi quantitativi e qualitativi, vale la pena adottare misure per affrontare anche un’inattività della rete poco frequente. E se la situazione inizia a passare da poco frequente a frequente, è il momento di risolvere il problema con maggiore urgenza.
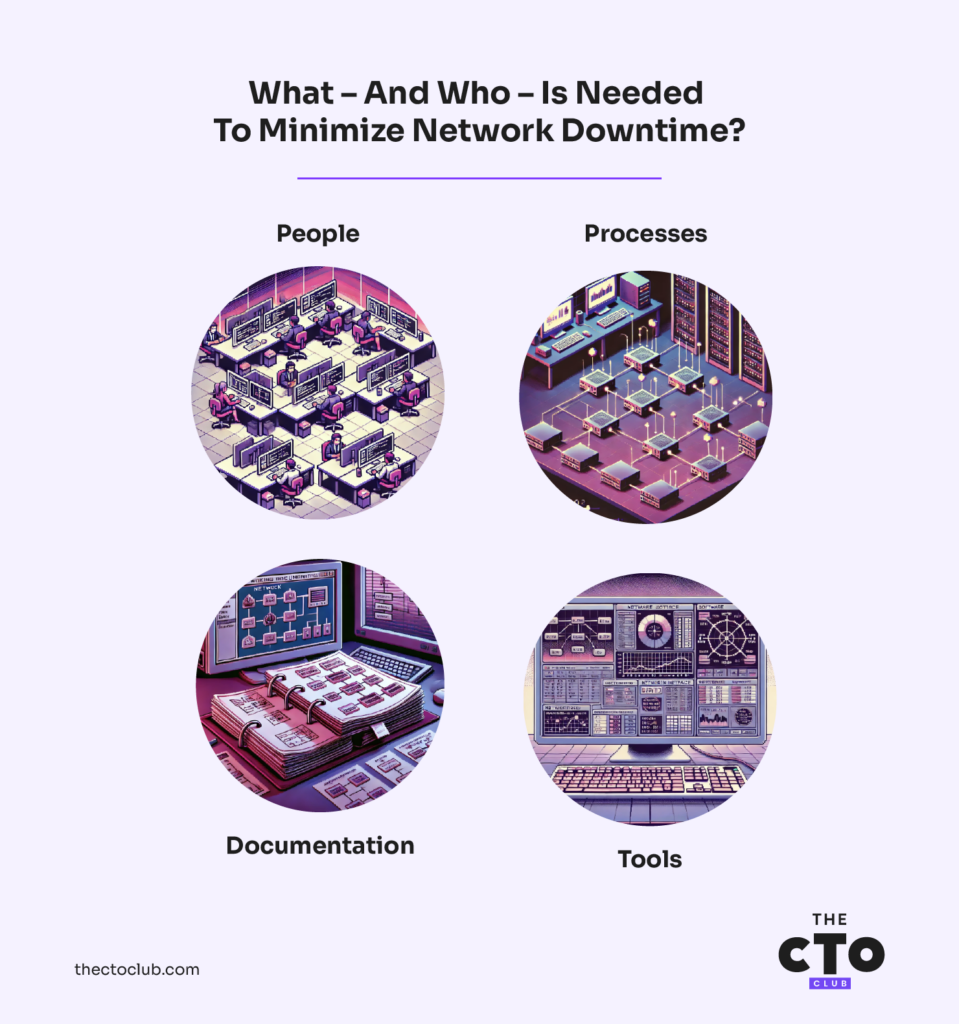
È necessario innanzitutto organizzare un insieme di persone, processi, documentazione e strumenti, afferma Viacheslav Petrenko, Responsabile tecnologico della società di sviluppo software LITSLINK.
Petrenko ha condiviso i suoi consigli sugli elementi chiave da mettere in ordine prima di intraprendere una nuova iniziativa per ridurre l’inattività della rete. Questi elementi possono essere sia orientati al futuro sia di carattere storico. Includono:
Documentazione
Petrenko consiglia di raccogliere diagrammi della topologia di rete, rapporti sugli incidenti, accordi sui livelli di servizio (SLA) e registri della gestione delle modifiche come documentazione fondamentale.
Vale inoltre la pena tenere a portata di mano qualsiasi altra documentazione pertinente e specifica dell’organizzazione o della rete.
Processi
Gli esperti consigliano di analizzare o implementare, se attualmente non sono presenti, diversi processi nell’ambito di un’iniziativa per garantire la disponibilità della rete. Tra questi:
Protocollo di analisi della causa principale (RCA): si tratta di un processo fondamentale per ridurre l’inattività della rete, perché il suo scopo ultimo è identificare la causa o le cause specifiche del problema. L’analisi della causa principale “garantisce un’indagine approfondita di ogni incidente di inattività della rete per prevenirne il ripetersi”, afferma Petrenko.
Lettura correlata: 5 strumenti di analisi della causa principale per test e controllo qualità migliori
Processo di gestione delle modifiche: riduce i rischi controllando e documentando con attenzione tutte le modifiche alla rete. Attenzione: è necessario bilanciare accuratezza e agilità per evitare colli di bottiglia.
Piani di ripristino di emergenza e continuità operativa: qualsiasi iniziativa volta a ridurre l’inattività della rete dovrebbe essere guidata dai piani più ampi dell’organizzazione per garantire la resilienza di fronte a importanti interruzioni operative e, viceversa, contribuire a tali piani.
Lettura correlata: I 25 migliori servizi di ripristino di emergenza: una guida alla scelta
Programma di manutenzione della rete: la manutenzione proattiva, che talvolta può comportare un’inattività pianificata, “aiuta a prevenire i problemi prima che si verifichino, aggiornando e ottimizzando la rete regolarmente”, afferma Petrenko.
Persone
Praticamente tutti i membri di un'organizzazione fanno affidamento sulla sua rete, ma ciò non significa che debbano essere tutti coinvolti nell'ottimizzazione delle prestazioni e dell'affidabilità. Petrenko elenca i seguenti ruoli come importanti da includere nel processo. Tieni presente che i titoli professionali specifici possono variare da un'azienda all'altra.
Ingegneri di rete: È superfluo dirlo: i professionisti che implementano e mantengono l'infrastruttura di rete devono far parte del processo.
Amministratori di sistema: Allo stesso modo, le persone che gestiscono i server (e altre infrastrutture) e le applicazioni che dipendono dalla rete dovrebbero essere coinvolte. I titoli correlati possono includere ingegnere DevOps, ingegnere dell'affidabilità dei siti e ingegnere dell'infrastruttura.
Professionisti della sicurezza: Coinvolgere il personale addetto alla sicurezza aiuta a “garantire la sicurezza della rete e a proteggere dai tempi di inattività causati da attacchi o violazioni”, afferma Petrenko.
Analisti dei dati: Come emerge dalla documentazione elencata sopra, ottimizzare una rete comporta l'analisi di grandi quantità di dati sulle prestazioni e di altre informazioni. Servono persone con le competenze necessarie per interpretare tali dati e generare informazioni utili per il miglioramento.
Responsabili di progetto: Soprattutto nelle grandi aziende, potrebbe essere necessaria una persona che coordini gli sforzi tra i team e mantenga le attività nei tempi previsti.
Strumenti
Di seguito analizzeremo più approfonditamente gli strumenti per ridurre i tempi di inattività della rete, ma per ora è sufficiente dire che ne serviranno alcuni, con particolare attenzione (ma non solo) al monitoraggio, alla registrazione dei dati, ai test e alla pianificazione. Le categorie specifiche includono:
Software di monitoraggio della rete: non è possibile risolvere i problemi se non si sa nemmeno che esistono. Questi strumenti garantiscono visibilità in tempo reale sulla rete e sulle sue prestazioni e possono generare avvisi in caso di possibili problemi.
Strumenti di gestione della configurazione: gli strumenti di gestione della configurazione possono automatizzare e monitorare le modifiche all'infrastruttura e ai dispositivi di rete, riducendo così, come osserva Petrenko, il rischio di errore umano quando vengono apportate modifiche.
Software di gestione dei log e strumenti di analisi dei log: la registrazione dei dati è un mezzo fondamentale per stabilire i modelli di base e il comportamento “normale” di una rete, e quindi identificare le attività anomale prima che possano causare un'interruzione.
Strumenti di test automatizzati: automatizzare le attività di test e QA aiuta a rilevare più rapidamente i problemi e riduce inoltre la quantità di lavoro umano necessaria.
Software di pianificazione della capacità: la pianificazione della capacità, spesso una funzionalità degli strumenti di monitoraggio della rete, può aiutare a prevedere i requisiti futuri della rete e a prevenire i tempi di inattività dovuti al sovraccarico. Petrenko osserva che, per rimanere efficace, richiede dati di input accurati e aggiornamenti regolari.
-

NinjaOne
Visit WebsiteThis rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.4.7 -
Datadog
Visit WebsiteThis rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.4.5 -
Paessler PRTG
Visit WebsiteThis rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.4.6



Riduci i tempi di inattività della rete in 13 passaggi
Quindi, cosa fare concretamente con tutto quanto detto sopra? Ci pensiamo noi: Petrenko ha condiviso con noi un piano d'azione in 13 passaggi che puoi utilizzare per sviluppare una strategia personalizzata in base alle caratteristiche e agli obiettivi specifici della tua organizzazione e della sua rete.
Iniziamo:
- Valuta lo stato attuale: è qui che raccogli, organizzi e analizzi tutti i componenti discussi sopra, inclusa la documentazione e gli altri dati pertinenti.
Il consiglio di Petrenko: “Prendi in considerazione il coinvolgimento di consulenti esterni per ottenere una valutazione imparziale, ma assicurati che tutte le parti interessate interne siano coinvolte per avere un quadro completo.”
- Definisci i tuoi obiettivi: “Ridurre i tempi di inattività” è un ottimo obiettivo generale, ma suddividilo in traguardi più specifici per le prestazioni della tua rete.
Il consiglio di Petrenko: “Questi obiettivi dovrebbero essere ambiziosi ma realistici, tenendo conto degli standard del settore e delle specifiche esigenze aziendali.”
- Costituisci il tuo team: crea un team interfunzionale con le competenze, le conoscenze e l'autorità decisionale necessarie per ottenere risultati.
Il consiglio di Petrenko: “Evita di creare silos e stabilisci buoni canali di comunicazione tra tutti i membri del team.”
- Implementa strumenti di monitoraggio: un software completo di monitoraggio e analisi della rete è fondamentale per qualsiasi iniziativa volta a garantire la disponibilità della rete.
Il consiglio di Petrenko: “Dovrai scegliere tra soluzioni locali, basate sul cloud o ibride in base alla tua infrastruttura.”
- Stabilisci le metriche chiave e i valori di riferimento: non puoi progredire verso un obiettivo se non sai da dove sei partito.
Il consiglio di Petrenko: “Misura le prestazioni attuali per stabilire un punto di partenza per i miglioramenti. È fondamentale che queste metriche siano coerenti e pertinenti agli obiettivi definiti.”
- Identifica e assegna la priorità ai problemi critici: a seconda dello stato attuale della rete, è improbabile che tu possa risolvere contemporaneamente tutti i problemi sottostanti. Dai quindi priorità alle cause più significative dei tempi di inattività. La “significatività” può essere intesa in modo olistico sulla base degli obiettivi della tua organizzazione, come osserva Petrenko di seguito.
Il consiglio di Petrenko: ”Quando assegni le priorità, considera sia la frequenza sia l’impatto dei problemi.”
- Amplia la tua strategia: sviluppa un piano dettagliato per affrontare tutti i problemi identificati (dopo aver risolto quelli ad alta priorità), includendo tempistiche e allocazione delle risorse.
Il consiglio di Petrenko: ”Ricorda di non cercare di risolvere tutto contemporaneamente; assegna le priorità in base all’impatto e alla fattibilità.”
- Sviluppa sistemi di ridondanza e commutazione automatica in caso di guasto: la ridondanza nei componenti critici della rete e i processi automatizzati di commutazione automatica in caso di guasto sono entrambi elementi chiave di una strategia a lungo termine per le prestazioni e la resilienza della rete.
Il consiglio di Petrenko: “Questo potrebbe includere hardware ridondante, architetture di rete a percorsi multipli o sistemi di commutazione automatica in caso di guasto basati sul cloud. Fai attenzione affinché la ridondanza non introduca complessità non necessarie che potrebbero a loro volta diventare una fonte di problemi.”
- Implementa le modifiche: è il momento di agire, iniziando dagli elementi ad alta priorità.
Il consiglio di Petrenko: “Assicurati di seguire i processi di gestione delle modifiche per ridurre al minimo il rischio di introdurre nuovi problemi.”
- Monitora e apporta modifiche: nessun piano raggiunge mai la perfezione, quindi preparati ad adattarti mentre porti avanti la tua strategia.
Il consiglio di Petrenko: “Monitora continuamente le metriche delle prestazioni e modifica il piano secondo necessità. Potresti voler implementare avvisi automatizzati per rispondere rapidamente ai problemi emergenti.”
- Svolgi regolarmente attività di sviluppo professionale: qualsiasi iniziativa su larga scala volta a ridurre i tempi di inattività comporterà inevitabilmente che le persone imparino nuove tecnologie e processi. Non aspettarti che il personale riesca semplicemente a cavarsela strada facendo.
Il consiglio di Petrenko: “Implementa programmi di formazione continua per mantenere il personale aggiornato sulle migliori pratiche e sulle nuove tecnologie. Ciò dovrebbe includere sia la formazione tecnica sia quella procedurale, per garantire che tutti i membri del team siano preparati a prevenire e gestire i problemi legati ai tempi di inattività.”
- Esegui esercitazioni di ripristino di emergenza: come per la maggior parte dei tipi di pianificazione delle emergenze, ovviamente speri di non averne mai bisogno. Ma, se dovesse accadere, vorrai assicurarti di aver testato i tuoi piani attraverso interruzioni simulate e altri problemi.
Il consiglio di Petrenko: “Cerca di rendere queste esercitazioni il più realistiche possibile senza rischiare tempi di inattività effettivi.”
- Monitora e comunica i tuoi progressi: valuta regolarmente i tuoi progressi verso gli obiettivi (fase 2) e i miglioramenti delle metriche di riferimento, quindi condividi i risultati con le parti interessate.
Il consiglio di Petrenko: “Nei tuoi report, utilizza sia metriche tecniche sia misure dell’impatto aziendale per offrire un quadro completo.”
Strumenti per ridurre i tempi di inattività della rete
Quali software e altri strumenti possono svolgere un ruolo fondamentale nel ridurre al minimo i tempi di inattività e migliorare lo stato e le prestazioni complessive della rete? Abbiamo incluso esempi per ogni categoria.
1. Strumenti di monitoraggio della rete
- SolarWinds Network Performance Monitor (NPM): offre un monitoraggio completo delle prestazioni della rete, il rilevamento dei guasti e gli avvisi.
- Nagios: offre solide funzionalità di monitoraggio, avvisi e reportistica della rete.
- PRTG Network Monitor: uno strumento versatile che monitora tutti gli aspetti della tua infrastruttura di rete.
2. Strumenti di gestione e configurazione della rete
- Cisco Prime Infrastructure: Aiuta a gestire e ottimizzare l'infrastruttura di rete.
- WhatsUp Gold: Fornisce monitoraggio e gestione della rete, inclusa la gestione della configurazione.
3. Strumenti automatizzati di risposta agli incidenti
- PagerDuty: Si integra con gli strumenti di monitoraggio per fornire risposta agli incidenti e avvisi automatizzati.
- Opsgenie: Offre gestione dei turni di reperibilità, risposta agli incidenti e avvisi.
4. Strumenti di gestione dei guasti
- Zabbix: Monitora le prestazioni della rete e aiuta a rilevare e risolvere i guasti.
- ManageEngine OpManager: Fornisce gestione dei guasti, monitoraggio delle prestazioni e visualizzazione della rete.
5. Strumenti di backup e ripristino della configurazione di rete
- RANCID (Really Awesome New Cisco confIg Differ): Automatizza il backup e la gestione della configurazione dei dispositivi di rete.
- SolarWinds Network Configuration Manager (NCM): Automatizza il backup e il ripristino della configurazione e contribuisce a garantire la conformità.
6. Gestione dei registri e strumenti di analisi
- Splunk: Raccoglie e analizza i registri dei dispositivi di rete per identificare e risolvere i problemi.
- ELK Stack (Elasticsearch, Logstash, Kibana): Fornisce potenti funzionalità di gestione e analisi dei registri.
7. Analisi del traffico di rete
- Wireshark: Un analizzatore di protocolli di rete che aiuta a diagnosticare i problemi di rete.
- NetFlow Analyzer: Monitora i modelli del traffico di rete e aiuta a identificare i colli di bottiglia.
8. Soluzioni ad alta disponibilità e commutazione automatica
- F5 BIG-IP: Fornisce bilanciamento del carico, commutazione automatica e alta disponibilità per i servizi di rete.
- Cisco ASA: Offre solide funzionalità di firewall e commutazione automatica.
9. Test delle prestazioni di rete
- iPerf: Misura la larghezza di banda e le prestazioni della rete.
- SolarWinds WAN Killer: Simula il traffico di rete per testare le prestazioni della rete in condizioni diverse.
More Articles
- Le 10 Migliori Soluzioni Software per la Gestione IT Recensite per il 2026
- 23 strumenti di monitoraggio della rete basati sul cloud per il 2026
- I 10 migliori strumenti gratuiti per il monitoraggio della rete recensiti nel 2026
- I 10 migliori strumenti di monitoraggio delle prestazioni per il SaaS
- I 10 migliori software di monitoraggio della rete recensiti per il 2026
10. Strumenti di rete privata virtuale (VPN)
- OpenVPN: Fornisce accesso remoto sicuro alla rete, garantendo la connettività durante i periodi di inattività.
- Cisco AnyConnect: Una soluzione VPN sicura che fornisce accesso remoto alle risorse di rete.
11. Strumenti di monitoraggio degli endpoint
- Sysdig: Monitora e protegge gli ambienti containerizzati e l'infrastruttura cloud.
- Datadog: Fornisce il monitoraggio dell'intero stack, inclusi rete, server e monitoraggio delle applicazioni.
12. Strumenti di monitoraggio della rete basati sul cloud
- ThousandEyes: Fornisce visibilità end-to-end sulle prestazioni della rete attraverso Internet e il cloud.
- LogicMonitor: Uno strumento di monitoraggio basato sul cloud che offre funzionalità complete di monitoraggio della rete.
In sintesi
Il tempo di inattività della rete è una realtà per la maggior parte delle organizzazioni, ma questo non significa che si debba ignorarlo. Utilizza il piano d'azione e gli strumenti indicati sopra per migliorare le prestazioni della tua rete e ridurre al minimo i costosi tempi di inattività.
Per ulteriori informazioni sulle reti, iscriviti alla nostra newsletter. Ti aiutiamo a creare team e sistemi SaaS scalabili!


