

So reduzieren Sie Netzwerkausfallzeiten

Technikfremde hören vielleicht „Ausfallzeit“ und denken wehmütig an einen Urlaub. Für IT-Fachleute ist Ausfallzeit jedoch ein Unwort – und das völlig zu Recht. Ein Netzwerkausfall bedeutet einen schlechten Tag im Büro.
Ein Netzwerkausfall bedeutet unzufriedene Kunden, sinkende Produktivität und andere Probleme. Wenn es um kundenorientierte Anwendungen wie eine Website geht, ist Ausfallzeit teuer: Ausfallzeiten kosten größere Unternehmen etwa 9.000 $ pro Minute.
Und obwohl Ausfallzeiten Unternehmen jeder Art und Größe negativ beeinträchtigen können, sind sie in bestimmten Branchen besonders problematisch. Ein Einzelhandelsunternehmen könnte durch eine Ausfallzeit von einer Stunde 1,1 Millionen $ verlieren.

Kurz gesagt: Ausfallzeit ist schlecht.
Ausfallzeiten zu reduzieren und zu verhindern ist hingegen gut. Tatsächlich ist es zwingend erforderlich – denn selbst kurze Netzwerkausfälle können das Betriebsergebnis beeinträchtigen und Folgeschäden wie einen Reputationsverlust verursachen.
In diesem Artikel definieren wir das Problem und erläutern, was zu seiner Lösung erforderlich ist – einschließlich eines 13-Schritte-Rahmens für die Entwicklung eines eigenen Plans zur Reduzierung von Netzwerkausfällen. Zunächst hilft es, von einer einfachen Definition auszugehen.
Was ist ein Netzwerkausfall?
Ein Netzwerkausfall bezeichnet den Ausfall eines Teils oder des gesamten IT-Netzwerks, wodurch beispielsweise eine Website oder interne Anwendungen wie ein ERP-System für einen bestimmten Zeitraum nicht zugänglich sind.
Ausfallzeiten lassen sich im Allgemeinen in zwei große Kategorien einteilen: geplante und ungeplante. Geplante Ausfallzeiten sind genau das: Sie sind beabsichtigt und terminiert, in der Regel für Dinge wie routinemäßige Wartungsarbeiten, Systemaktualisierungen oder eine Anwendungsmigration.
Wenn wir sagen, dass Netzwerkausfälle schlecht sind, meinen wir eigentlich ungeplante Netzwerkausfälle – also Situationen, in denen das Netzwerk aus einer Vielzahl möglicher Gründe unerwartet ausfällt. Ausfallzeiten können unterschiedlichste Ursachen haben, von Infrastrukturproblemen über Softwarefehler und menschliches Versagen bis hin zu Cyberangriffen.
Was – und wer – wird benötigt, um Netzwerkausfälle zu minimieren?
Angesichts der quantitativen und qualitativen Kosten lohnt es sich, auch bei seltenen Netzwerkausfällen Maßnahmen zu ihrer Behebung zu ergreifen. Und wenn sich die Entwicklung von seltenen hin zu häufigen Ausfällen bewegt, ist es an der Zeit, dieses Problem mit größerer Dringlichkeit zu lösen.
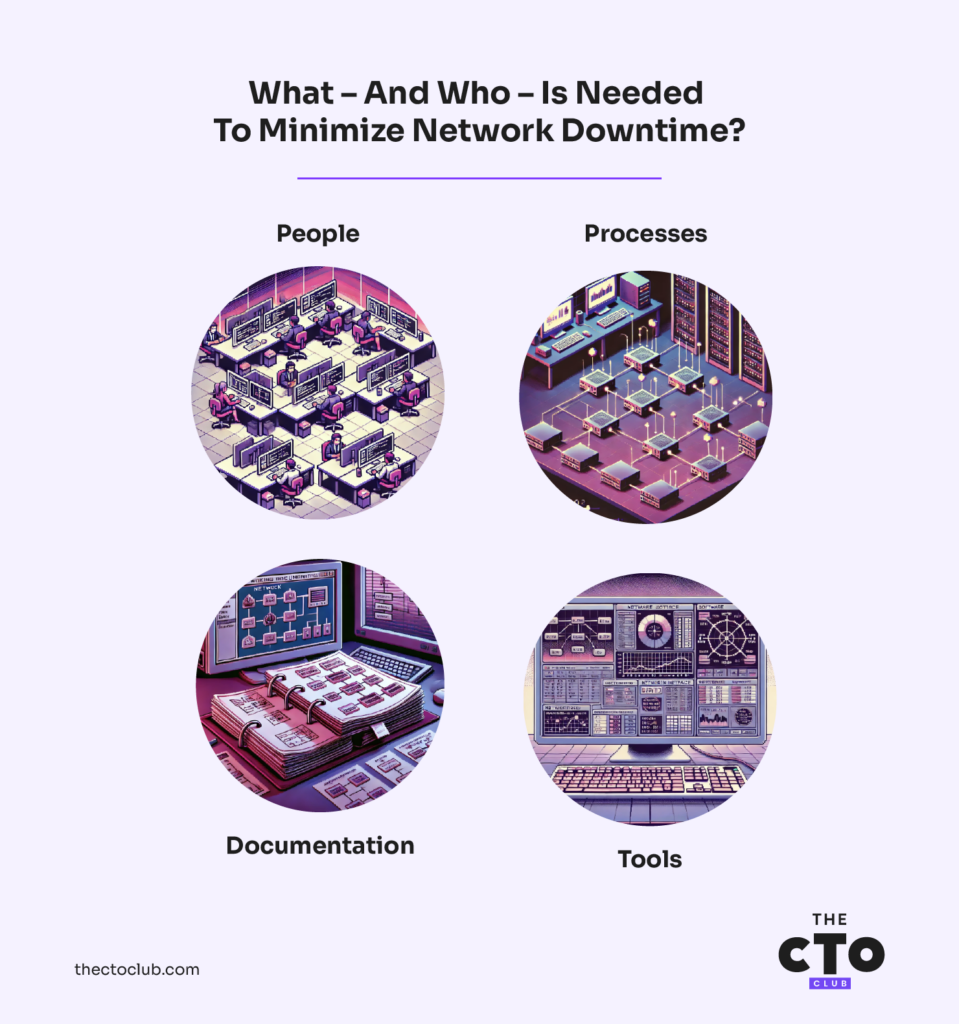
Es gibt eine Mischung aus Personen, Prozessen, Dokumentation und Werkzeugen, die Sie zunächst organisieren sollten, sagt Viacheslav Petrenko, Technischer Leiter beim Softwareentwicklungsunternehmen LITSLINK.
Petrenko teilte seine Empfehlungen zu den wichtigsten Bausteinen, die Sie in Ordnung bringen sollten, bevor Sie eine neue Initiative zur Reduzierung von Netzwerkausfällen starten. Diese können sowohl zukunftsorientiert als auch historisch sein. Dazu gehören:
Dokumentation
Petrenko empfiehlt, Netzwerktopologiediagramme, Vorfallberichte, Service-Level-Agreements (SLAs) und Änderungsmanagementprotokolle als grundlegende Dokumentation zu sammeln.
Auch alle anderen relevanten unternehmens- oder netzwerkspezifischen Dokumente sollten griffbereit aufbewahrt werden.
Prozesse
Experten empfehlen, im Rahmen einer Initiative zur Verbesserung der Netzwerkverfügbarkeit mehrere Prozesse zu analysieren oder – falls sie derzeit noch nicht vorhanden sind – einzuführen. Dazu gehören:
Protokoll zur Ursachenanalyse (RCA): Dies ist ein grundlegender Prozess zur Reduzierung von Netzwerkausfällen, da sein letztendlicher Zweck darin besteht, die konkrete(n) Ursache(n) des Problems zu ermitteln. Die Ursachenanalyse „gewährleistet eine gründliche Untersuchung jedes Ausfallvorfalls, um eine Wiederholung zu verhindern“, sagt Petrenko.
Verwandte Lektüre: 5 Werkzeuge zur Ursachenanalyse für bessere Tests und Qualitätssicherung
Prozess für das Änderungsmanagement: Minimiert Risiken, indem alle Netzwerkänderungen sorgfältig kontrolliert und dokumentiert werden. Achtung: Gründlichkeit und Agilität müssen ausgewogen sein, um Engpässe zu vermeiden.
Pläne für Notfallwiederherstellung und Geschäftskontinuität: Alle Bemühungen zur Reduzierung von Netzwerkausfällen sollten sich an den übergeordneten Plänen der Organisation für ihre Widerstandsfähigkeit angesichts größerer betrieblicher Störungen orientieren – und umgekehrt.
Verwandte Lektüre: Die 25 besten Dienste für die Notfallwiederherstellung entschlüsselt
Netzwerkwartungsplan: Proaktive Wartung – die manchmal geplante Ausfallzeiten beinhalten kann – „trägt dazu bei, Probleme zu verhindern, bevor sie auftreten, indem Netzwerkkomponenten regelmäßig aktualisiert und optimiert werden“, sagt Petrenko.
Personen
Praktisch jeder in einer Organisation ist auf deren Netzwerk angewiesen, aber das bedeutet nicht, dass alle an der Optimierung seiner Leistung und Zuverlässigkeit beteiligt sein müssen. Petrenko führt die folgenden Rollen als wichtig für die Einbeziehung in den Prozess auf. Dabei ist zu beachten, dass konkrete Berufsbezeichnungen von Unternehmen zu Unternehmen variieren können.
Netzwerkingenieure: Es versteht sich von selbst, dass die Fachleute, die Ihre Netzwerkinfrastruktur implementieren und warten, Teil des Prozesses sein müssen.
Systemadministratoren: Ebenso sollten die Personen beteiligt sein, die die Server (und andere Infrastruktur) sowie die Anwendungen verwalten, die auf das Netzwerk angewiesen sind. Verwandte Berufsbezeichnungen können hier DevOps-Ingenieur, Site-Reliability-Ingenieur und Infrastruktur-Ingenieur sein.
Sicherheitsexperten: Die Einbeziehung Ihres Sicherheitspersonals trägt dazu bei, die „Netzwerksicherheit zu gewährleisten und vor durch Angriffe oder Sicherheitsverletzungen verursachten Ausfallzeiten zu schützen“, sagt Petrenko.
Datenanalysten: Wie aus der oben aufgeführten Dokumentation hervorgeht, umfasst die Optimierung eines Netzwerks die Analyse großer Mengen an Leistungsdaten und anderen Informationen. Sie benötigen Personen mit den erforderlichen Fähigkeiten, diese Daten zu interpretieren und Erkenntnisse für Verbesserungen zu gewinnen.
Projektmanager: Insbesondere in großen Unternehmen benötigen Sie möglicherweise jemanden, der die Maßnahmen teamübergreifend koordiniert und dafür sorgt, dass alles im Zeitplan bleibt.
Werkzeuge
Wir gehen weiter unten ausführlicher auf Werkzeuge zur Reduzierung von Netzwerkausfällen ein. Für den Moment genügt jedoch die Feststellung, dass Sie einige benötigen werden, insbesondere – aber nicht ausschließlich – für Überwachung, Protokollierung, Tests und Planung. Zu den spezifischen Kategorien gehören:
Software zur Netzwerküberwachung: Sie können Probleme nicht lösen, wenn Sie nicht einmal wissen, dass sie existieren. Diese Werkzeuge gewährleisten einen Echtzeitüberblick über Ihr Netzwerk und seine Leistung und können Warnmeldungen zu möglichen Problemen erzeugen.
Werkzeuge für das Konfigurationsmanagement: Werkzeuge für das Konfigurationsmanagement können Änderungen an der Netzwerkinfrastruktur und an Geräten automatisieren und nachverfolgen. Wie Petrenko hervorhebt, kann dies das Risiko menschlicher Fehler bei der Durchführung von Änderungen verringern.
Software für die Protokollverwaltung und Werkzeuge zur Protokollanalyse: Die Protokollierung ist ein wichtiges Mittel, um grundlegende Muster und „normales“ Verhalten in einem Netzwerk zu bestimmen – und anschließend ungewöhnliche Aktivitäten zu erkennen, bevor sie möglicherweise einen Ausfall verursachen.
Werkzeuge für automatisierte Tests: Die Automatisierung von Test- und QS-Maßnahmen hilft, Probleme schneller zu erkennen, und reduziert außerdem den erforderlichen manuellen Aufwand.
Software für die Kapazitätsplanung: Die Kapazitätsplanung – häufig eine Funktion von Werkzeugen zur Netzwerküberwachung – kann dabei helfen, zukünftige Netzwerkanforderungen vorherzusagen und durch Überlastung verursachte Ausfallzeiten zu verhindern. Petrenko weist darauf hin, dass dafür eine genaue Dateneingabe und regelmäßige Aktualisierungen erforderlich sind, damit die Funktion effektiv bleibt.
-

NinjaOne
Visit WebsiteThis rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.4.7 -
Datadog
Visit WebsiteThis rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.4.5 -
Paessler PRTG
Visit WebsiteThis rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.4.6



Netzwerkausfallzeiten in 13 Schritten reduzieren
Was machen Sie also konkret mit all den oben genannten Informationen? Wir helfen Ihnen dabei: Petrenko hat uns einen 13-Schritte-Aktionsplan vorgestellt, den Sie verwenden können, um auf Grundlage der spezifischen Merkmale und Ziele Ihrer Organisation und ihres Netzwerks Ihre eigene Strategie zu entwickeln.
Beginnen wir:
- Aktuellen Zustand bewerten: In diesem Schritt sammeln, ordnen und analysieren Sie alle oben besprochenen Komponenten, einschließlich der Dokumentation und anderer relevanter Daten.
Petrenkos Ratschlag: „Ziehen Sie externe Berater hinzu, um eine unvoreingenommene Einschätzung zu erhalten, stellen Sie jedoch sicher, dass alle internen Beteiligten einbezogen werden, um ein umfassendes Bild zu erhalten.“
- Ziele festlegen: „Ausfallzeiten reduzieren“ ist ein gutes übergeordnetes Ziel, aber unterteilen Sie es in spezifischere Zielvorgaben für die Leistung Ihres Netzwerks.
Petrenkos Ratschlag: „Diese Ziele sollten ehrgeizig, aber realistisch sein und Branchenstandards sowie spezifische geschäftliche Anforderungen berücksichtigen.“
- Team zusammenstellen: Stellen Sie ein funktionsübergreifendes Team mit den erforderlichen Fähigkeiten, Kenntnissen und Entscheidungskompetenzen zusammen, die zum Erreichen der Ergebnisse benötigt werden.
Petrenkos Ratschlag: „Vermeiden Sie die Bildung von Silos und schaffen Sie gute Kommunikationskanäle zwischen allen Teammitgliedern.“
- Überwachungstools implementieren: Umfassende Software zur Netzwerküberwachung und -analyse ist für jede Initiative zur Verbesserung der Netzwerkverfügbarkeit von entscheidender Bedeutung.
Petrenkos Ratschlag: „Sie müssen auf Grundlage Ihrer Infrastruktur zwischen lokalen, cloudbasierten und hybriden Lösungen entscheiden.“
- Ihre wichtigsten Kennzahlen und Ausgangswerte festlegen: Sie können nicht auf ein Ziel hinarbeiten, wenn Sie nicht wissen, wo Sie gestartet sind.
Petrenkos Rat: „Messen Sie die aktuelle Leistung, um einen Ausgangspunkt für Verbesserungen festzulegen. Es ist entscheidend, dass diese Kennzahlen einheitlich und für Ihre definierten Ziele relevant sind.“
- Kritische Probleme identifizieren und priorisieren: Je nach aktuellem Zustand Ihres Netzwerks ist es unwahrscheinlich, dass Sie alle zugrunde liegenden Probleme gleichzeitig lösen können. Priorisieren Sie daher die bedeutendsten Ursachen für Ausfallzeiten. „Bedeutung“ kann ganzheitlich auf Grundlage der Ziele Ihrer Organisation verstanden werden, wie Petrenko im Folgenden anmerkt.
Petrenkos Rat: „Berücksichtigen Sie bei der Priorisierung sowohl die Häufigkeit als auch die Auswirkungen der Probleme.“
- Ihre Strategie erweitern: Entwickeln Sie einen detaillierten Plan, um alle identifizierten Probleme anzugehen (sobald die Probleme mit hoher Priorität gelöst sind), einschließlich Zeitplänen und Ressourcenzuweisung.
Petrenkos Rat: „Denken Sie daran, nicht alles auf einmal reparieren zu wollen, sondern nach Auswirkungen und Umsetzbarkeit zu priorisieren.“
- Redundanz- und Ausfallsicherungssysteme entwickeln: Redundanz bei kritischen Netzwerkkomponenten und automatisierte Ausfallsicherungsprozesse sind beide zentrale Bestandteile einer langfristigen Strategie für Netzwerkleistung und Widerstandsfähigkeit.
Petrenkos Rat: „Dazu könnten redundante Hardware, Netzwerkdesigns mit mehreren Pfaden oder cloudbasierte Ausfallsicherungssysteme gehören. Achten Sie darauf, dass Ihre Redundanz keine unnötige Komplexität einführt, die selbst zu einer Ursache für Probleme werden könnte.“
- Änderungen umsetzen: Jetzt geht es an die Umsetzung, angefangen bei den Punkten mit hoher Priorität.
Petrenkos Rat: „Halten Sie sich an die Prozesse des Änderungsmanagements, um das Risiko der Einführung neuer Probleme zu minimieren.“
- Überwachen und anpassen: Kein Plan verläuft jemals perfekt, seien Sie also darauf vorbereitet, Ihre Strategie während der Umsetzung anzupassen.
Petrenkos Rat: „Verfolgen Sie die Leistungskennzahlen kontinuierlich und passen Sie den Plan bei Bedarf an. Sie könnten automatische Warnmeldungen einrichten, um schnell auf neu auftretende Probleme zu reagieren.“
- Regelmäßige berufliche Weiterbildung durchführen: Jede groß angelegte Initiative zur Verringerung von Ausfallzeiten wird zwangsläufig dazu führen, dass Mitarbeiter neue Technologien und Prozesse erlernen müssen. Erwarten Sie nicht, dass die Mitarbeiter dies einfach während der Arbeit selbst herausfinden.
Petrenkos Rat: „Führen Sie fortlaufende Schulungsprogramme für Mitarbeiter ein, damit diese über bewährte Verfahren und neue Technologien auf dem Laufenden bleiben. Dies sollte sowohl technische als auch prozessbezogene Schulungen umfassen, um sicherzustellen, dass alle Teammitglieder in der Lage sind, Ausfallzeitprobleme zu verhindern und darauf zu reagieren.“
- Übungen zur Notfallwiederherstellung durchführen: Wie bei den meisten Arten der Notfallplanung hoffen Sie natürlich, sie niemals tatsächlich zu benötigen. Falls doch, sollten Sie sicherstellen, dass Sie Ihre Pläne durch simulierte Ausfälle und andere Probleme getestet haben.
Petrenkos Rat: „Versuchen Sie, diese Übungen so realistisch wie möglich zu gestalten, ohne tatsächliche Ausfallzeiten zu riskieren.“
- Ihre Fortschritte verfolgen und berichten: Bewerten Sie regelmäßig Ihre Fortschritte bei der Erreichung der Ziele (Schritt 2) sowie die Verbesserungen Ihrer Ausgangskennzahlen und teilen Sie die Ergebnisse mit den Stakeholdern.
Petrenkos Rat: „Verwenden Sie in Ihrer Berichterstattung sowohl technische Kennzahlen als auch Messgrößen für die geschäftlichen Auswirkungen, um ein vollständiges Bild zu vermitteln.“
Werkzeuge zur Reduzierung von Netzwerkausfallzeiten
Welche Software und anderen Werkzeuge können eine wichtige Rolle dabei spielen, Ausfallzeiten zu minimieren und den allgemeinen Zustand sowie die Leistung des Netzwerks zu verbessern? Wir haben Beispiele für jede Kategorie aufgenommen.
1. Werkzeuge zur Netzwerküberwachung
- SolarWinds Network Performance Monitor (NPM): Bietet umfassende Überwachung der Netzwerkleistung, Fehlererkennung und Warnmeldungen.
- Nagios: Bietet leistungsstarke Funktionen zur Netzwerküberwachung, für Warnmeldungen und Berichte.
- PRTG Network Monitor: Ein vielseitiges Werkzeug, das alle Aspekte Ihrer Netzwerkinfrastruktur überwacht.
2. Werkzeuge für Netzwerkverwaltung und -konfiguration
- Cisco Prime Infrastructure: Hilft bei der Verwaltung und Optimierung Ihrer Netzwerkinfrastruktur.
- WhatsUp Gold: Bietet Netzwerküberwachung und -verwaltung einschließlich Konfigurationsmanagement.
3. Automatisierte Tools zur Reaktion auf Vorfälle
- PagerDuty: Lässt sich in Überwachungstools integrieren, um die Reaktion auf Vorfälle und automatisierte Benachrichtigungen bereitzustellen.
- Opsgenie: Bietet Bereitschaftsmanagement, Reaktion auf Vorfälle und Benachrichtigungen.
4. Tools für das Fehlermanagement
- Zabbix: Überwacht die Netzwerkleistung und hilft bei der Erkennung und Behebung von Fehlern.
- ManageEngine OpManager: Bietet Fehlermanagement, Leistungsüberwachung und Netzwerkvisualisierung.
5. Tools zur Sicherung und Wiederherstellung der Netzwerkkonfiguration
- RANCID (Really Awesome New Cisco confIg Differ): Automatisiert die Sicherung und Verwaltung der Konfiguration von Netzwerkgeräten.
- SolarWinds Network Configuration Manager (NCM): Automatisiert die Sicherung und Wiederherstellung von Konfigurationen und trägt zur Einhaltung von Compliance-Anforderungen bei.
6. Tools zur Protokollverwaltung und -analyse
- Splunk: Sammelt und analysiert Protokolle von Netzwerkgeräten, um Probleme zu identifizieren und zu beheben.
- ELK Stack (Elasticsearch, Logstash, Kibana): Bietet leistungsstarke Funktionen zur Protokollverwaltung und -analyse.
7. Tools zur Datenverkehrsanalyse
- Wireshark: Ein Netzprotokollanalysator, der bei der Diagnose von Netzwerkproblemen hilft.
- NetFlow Analyzer: Überwacht Muster des Netzwerkverkehrs und hilft bei der Identifizierung von Engpässen.
8. Lösungen für Hochverfügbarkeit und Ausfallsicherung
- F5 BIG-IP: Bietet Lastverteilung, Ausfallsicherung und Hochverfügbarkeit für Netzwerkdienste.
- Cisco ASA: Bietet leistungsfähige Firewall- und Ausfallsicherungsfunktionen.
9. Tools für Leistungstests
- iPerf: Misst die Netzwerkbandbreite und -leistung.
- SolarWinds WAN Killer: Simuliert Netzwerkverkehr, um die Netzwerkleistung zu testen unter verschiedenen Bedingungen.
More Articles
10. Tools für virtuelle private Netzwerke (VPN)
- OpenVPN: Bietet sicheren Fernzugriff auf das Netzwerk und gewährleistet die Konnektivität während Ausfallzeiten.
- Cisco AnyConnect: Eine sichere VPN-Lösung, die Fernzugriff auf Netzwerkressourcen ermöglicht.
11. Tools zur Endpunktüberwachung
- Sysdig: Überwacht und schützt containerisierte Umgebungen und Cloud-Infrastrukturen.
- Datadog: Bietet Überwachung des gesamten Stacks einschließlich Netzwerk-, Server- und Anwendungsüberwachung.
12. Cloudbasierte Tools zur Netzwerküberwachung
- ThousandEyes: Bietet durchgängige Einblicke in die Netzwerkleistung über das Internet und die Cloud hinweg.
- LogicMonitor: Ein cloudbasiertes Überwachungstool mit umfassenden Funktionen zur Netzwerküberwachung.
Das Fazit
Netzwerk-Ausfallzeiten sind für die meisten Organisationen Realität, aber das bedeutet nicht, dass Sie sie unkontrolliert hinnehmen sollten. Nutzen Sie den oben beschriebenen Maßnahmenplan und die Tools, um die Leistung Ihres Netzwerks zu steigern und kostspielige Ausfallzeiten zu minimieren.
Für weitere Einblicke in Netzwerke abonnieren Sie bitte unseren Newsletter. Wir helfen Ihnen, SaaS-Teams und -Systeme aufzubauen, die skalieren!

