

10 bästa programvarorna för datavirtualisering 2026

10 Bästa programvaran för datavirtualisering – kortlista


Att hantera data över flera plattformar borde inte bromsa ditt team, men för många företag gör det just det. Isolerade system, långsamma ETL-pipelines och fragmenterade data gör det svårt att få de insikter du behöver när du behöver dem. Ditt team kan vara fast med att jonglera manuella integrationer, försenade rapporter eller efterlevnadsrisker som orsakas av duplicerade datamängder. Utmaningen handlar inte bara om att komma åt data – utan om att göra det effektivt, utan onödig förflyttning eller fördröjningar.
Det är där datavirtualisering kommer in. I stället för att replikera data mellan system ger den en enhetlig vy i realtid utan att själva datan flyttas. Det innebär snabbare åtkomst, bättre säkerhet och färre problem med att hantera integrationer. Jag har ägnat flera år åt att utvärdera datalösningar och vet vad som faktiskt fungerar i praktiken – inte bara vad som ser bra ut på papperet. I den här guiden går jag igenom de bästa verktygen för datavirtualisering som finns tillgängliga idag och hjälper dig att hitta rätt lösning för din arkitektur, dina säkerhetsbehov och dina affärsmål.
Varför du kan lita på våra programvarurekommendationer
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Sammanfattning av den bästa programvaran för datavirtualisering
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för en plattform för datasjöhus för enhetlig analys | 14 dagars kostnadsfri provperiod + kostnadsfri plan tillgänglig | Prissättning på begäran | Website | |
| 2 | Bäst med breda ekosystemintegrationer | 30 dagars kostnadsfri provperiod | Från $0.03/timme | Website | |
| 3 | Bäst för säker dokumentdelning och samarbete | Nej | Priser på begäran | Website | |
| 4 | Bäst för SQL-virtualisering | 30 dagars kostnadsfri provperiod + kostnadsfri plan tillgänglig | Från $0.50/kredit | Website | |
| 5 | Bäst för att utnyttja minnesbaserade databehandlingsfunktioner | Not available | Pris på begäran | Website | |
| 6 | Bäst för enhetlig datainsamling | Gratis provperiod tillgänglig | Pris på begäran | Website | |
| 7 | Bäst för hantering av granskningsprocesser i stor skala | Nej | Pris på begäran | Website | |
| 8 | Bäst för säkra virtuella datarum | Nej | Pris på begäran | Website | |
| 9 | Bäst för att ansluta alla dina datakällor till en enda logisk datasjö | Not available | $500/user/month (faktureras årligen) | Website | |
| 10 | Bäst för avancerad datamaskering och säkerhet | Not available | Website |

Recensioner av den bästa programvaran för datavirtualisering
Nedan hittar du mina detaljerade sammanfattningar av den bästa programvaran för datavirtualisering som hamnade på min kortlista. Mina recensioner ger en detaljerad genomgång av de viktigaste funktionerna, fördelarna \u0026 nackdelarna, integrationerna och de idealiska användningsområdena för varje verktyg, så att du kan hitta det bästa alternativet för dig.
Bäst för en plattform för datasjöhus för enhetlig analys

Bäst med breda ekosystemintegrationer
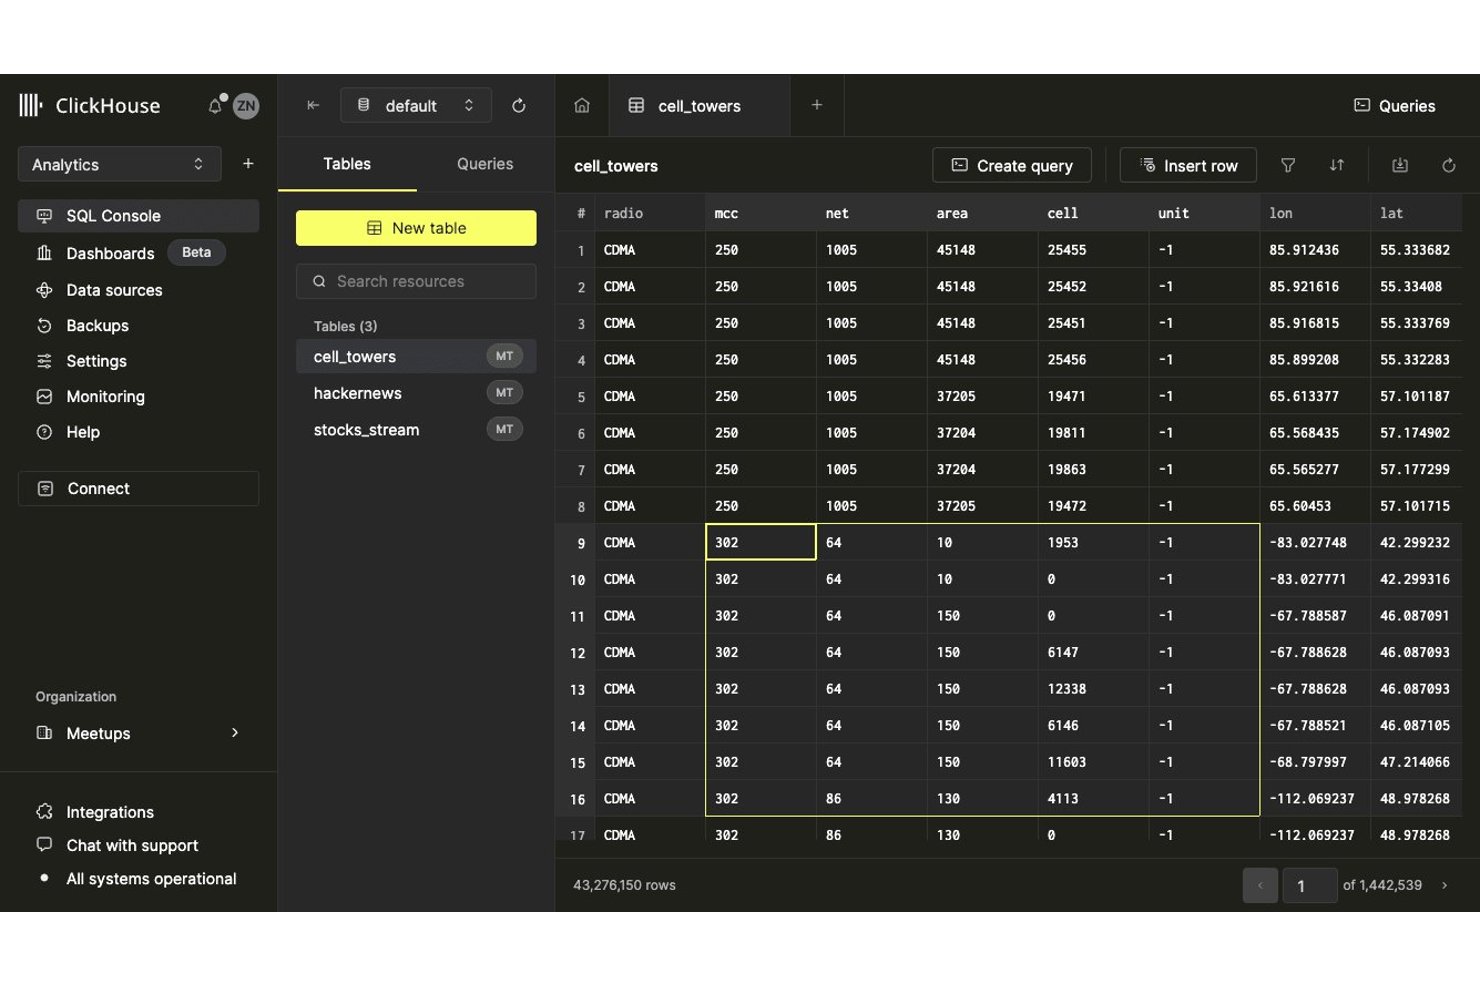
ClickHouse är en kolumnorienterad OLAP-databas med öppen källkod som stöder federerade frågor över heterogena källor – inklusive datasjöar, objektlagring, relationsdatabaser och strömningssystem – utan att data behöver flyttas.
Vem passar ClickHouse bäst för?
ClickHouse passar bra för dataingenjörer och arkitekter på medelstora till stora företag som bygger realtidsanalys-pipelines över distribuerade datamiljöer med flera moln.
Varför jag valde ClickHouse
Jag valde ClickHouse som en av de bästa eftersom det täcker mer av analys-ekosystemet än någon annan databas på den här listan. ClickPipes hanterar hanterad inläsning från Kafka, PostgreSQL CDC och MongoDB CDC, medan fler än 50 tabellfunktioner låter mig köra en enda SQL-fråga som sträcker sig över S3, Iceberg och Delta Lake utan att replikera en enda byte. Integrationen med OneLake i 2026 ger direkt federerad åtkomst till Microsoft Fabric-datauppsättningar, vilket är en betydande utökning för team som redan arbetar i det ekosystemet.
Viktiga funktioner i ClickHouse
- Distributioner med flera moln och BYOC: Kör ClickHouse Cloud på AWS, GCP eller Azure, eller i ditt eget VPC.
- Kolumnlagring med parallell körning: Lagrar data per kolumn och använder vektoriserad MPP-bearbetning för hög hastighet.
- Säkerhetspolicyer på rad- och kolumnnivå: Tillämpa detaljerade åtkomstkontroller direkt i databasen.
- Automatisk vertikal och manuell horisontell skalning: Justera resurser dynamiskt för att hantera varierande arbetsbelastningar och stora datamängder.
ClickHouse-integrationer
ClickHouse erbjuder inbyggda integrationer med Amazon S3, Google Cloud Storage, Azure Blob Storage, Apache Kafka, PostgreSQL, MySQL, MongoDB, Iceberg, Delta Lake, Microsoft Fabric och Tableau. Ett API finns tillgängligt för anpassade integrationer.
Pros and Cons
Pros:
- Extremt snabb analytisk frågekörning i stor skala
- Starkt stöd för federerade frågor över heterogena källor
- Kolumnorienterad lagring är utmärkt för OLAP-arbetsbelastningar
Cons:
- Funktioner för styrning och datahärkomst ligger efter dedikerade plattformar
- Inte utformad för transaktionella eller radbaserade arbetsbelastningar

Bäst för säker dokumentdelning och samarbete
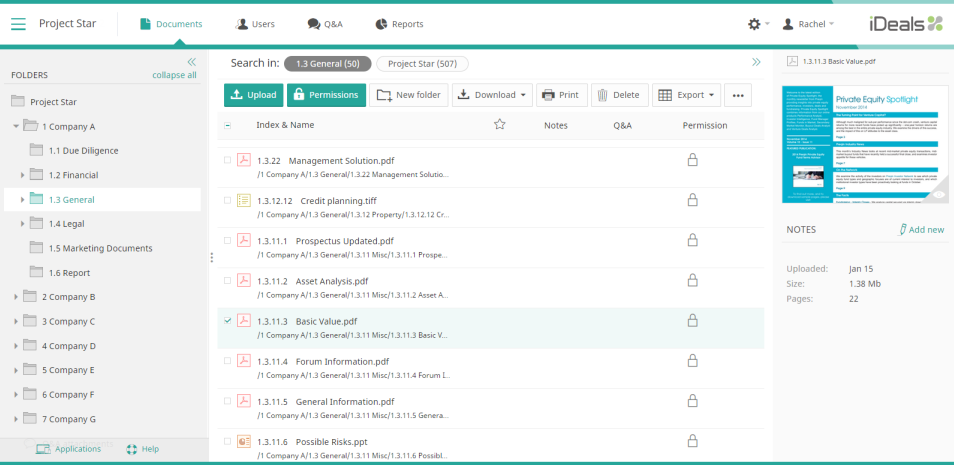
iDeals virtuella datarum är en omfattande plattform som hjälper företag att dela dokument och samarbeta på ett säkert sätt. Det här verktyget är utmärkt för att skapa en trygg miljö för utbyte av känslig information, vilket är avgörande för dess position som den självklara lösningen för säkert samarbete.
Varför jag valde iDeals virtuella datarum:
Jag valde iDeals virtuella datarum eftersom plattformen utmärker sig genom sina robusta säkerhetsåtgärder och sitt intuitiva gränssnitt, vilket är avgörande för alla samarbetsverktyg. Dess engagemang för dataskydd, i kombination med en användarvänlig design som främjar sömlöst samarbete, skiljer den från mängden. Anledningen till att jag anser att den är bäst för säker dokumentdelning och samarbete är dess krypterade digitala rum där team tryggt kan diskutera, dela och arbeta med dokument.
Utmärkande funktioner och integrationer:
Viktiga funktioner i iDeals virtuella datarum inkluderar datakryptering på hög nivå, anpassningsbara åtkomstnivåer och vattenmärkning av dokument för ett extra säkerhetslager. Dess granskningsspår och automatiska dokumentindexering bidrar till den övergripande användbarheten. När det gäller integrationer ansluter iDeals virtuella datarum till populära CRM-plattformar och Microsoft Office-applikationer, vilket säkerställer ett smidigt arbetsflöde.
Pros and Cons
Pros:
- Hög nivå av datasäkerhet och dataskydd
- Användarvänligt och intuitivt gränssnitt
- Omfattande granskningsspår för ansvarsskyldighet
Cons:
- Prisuppgifter är inte direkt tillgängliga på webbplatsen.
- Avancerade funktioner kan kräva teknisk kunskap.
- Upplevelsen av mobilappen kan förbättras.

Bäst för SQL-virtualisering
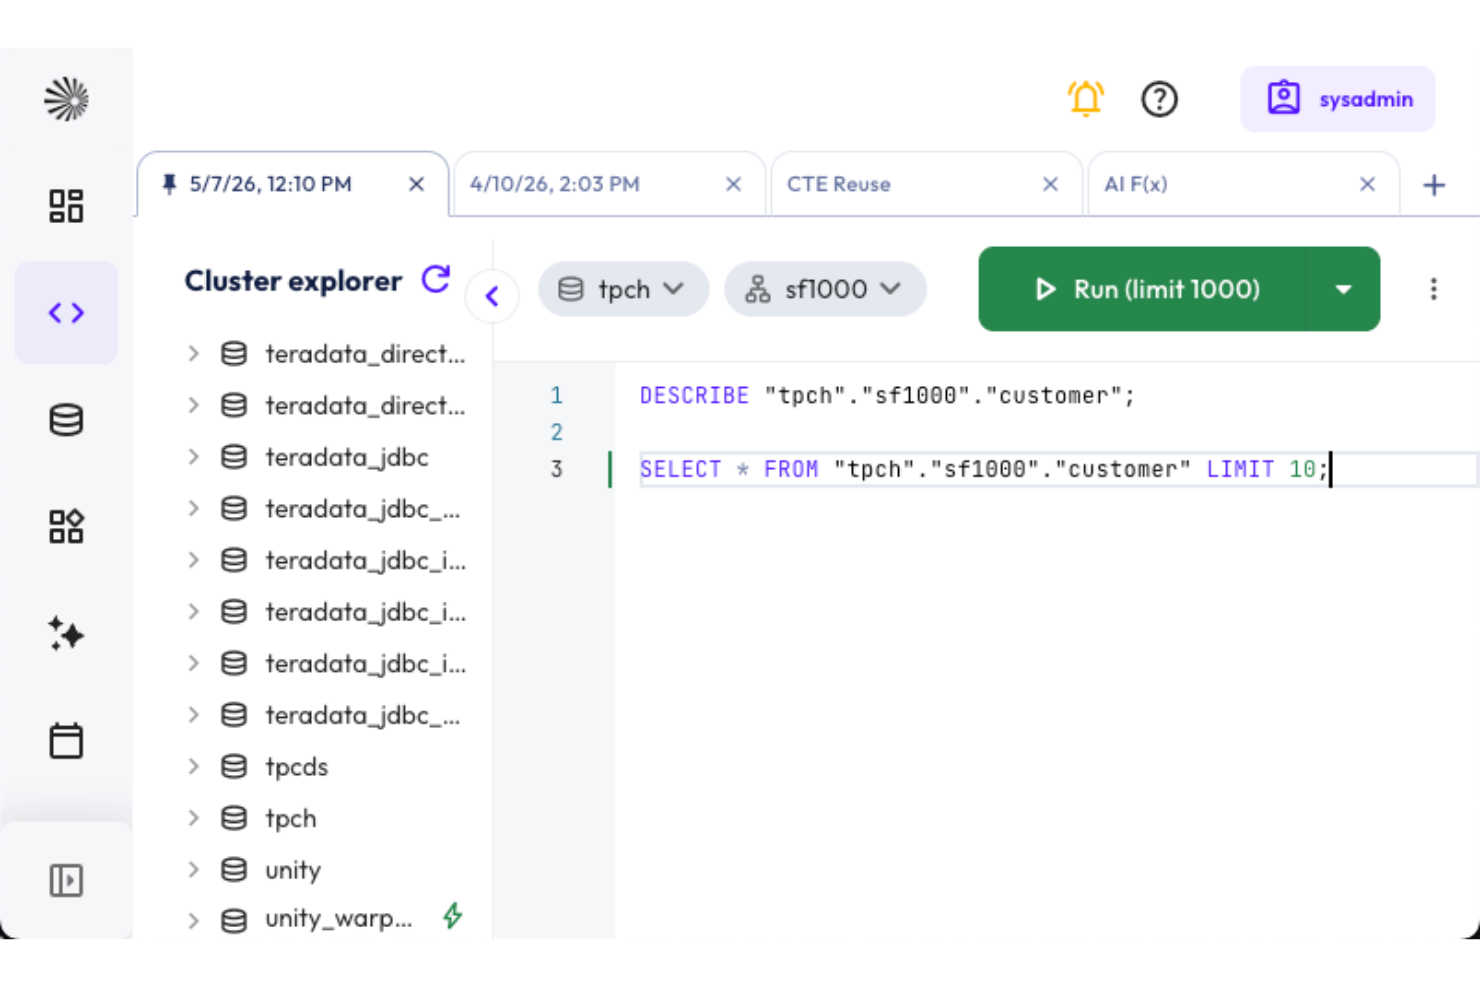
Starburst är en distribuerad SQL-frågemotor byggd på Trino som låter dig köra analyser över datasjöar, databaser och molnlagring utan att flytta eller kopiera data till ett centralt datalager.
Vem passar Starburst bäst för?
Starburst passar bra för dataingenjörer och analysteam på medelstora till stora företag som hanterar data spridd över flera molnplattformar eller lokala system.
Varför jag valde Starburst
Jag valde Starburst eftersom plattformen verkligen håller sökvägar, processer och data på samma plats i en federerad arkitektur. Det jag uppskattar mest är funktionen för dataprodukter, som låter mitt team publicera kuraterade och styrda datamängder som andra team kan upptäcka och fråga direkt utan att behöva be om pipelinearbete. Jag förlitar mig också på den policybaserade datamaskeringen, som tillämpar kontroller på kolumnnivå över alla anslutna källor från en enda plats, i stället för att konfigurera säkerhetsregler separat i varje system.
Viktiga funktioner i Starburst
- Federering av frågor över flera källor: Kör en enda SQL-fråga som samtidigt sammanfogar data från källor som Amazon S3, Google BigQuery och PostgreSQL.
- Kostnadsbaserad frågeoptimerare: Väljer automatiskt den mest beräkningseffektiva körningsplanen baserat på tabellstatistik och frågans komplexitet.
- Inbyggda anslutningar till datakällor: Förbyggda anslutningar länkar direkt till över 50 datakällor, inklusive Hive, Iceberg, Delta Lake och Kafka.
- Automatisk klusterskalning: Justerar beräkningsresurserna dynamiskt uppåt eller nedåt baserat på arbetsbelastningens efterfrågan.
Starburst-integreringar
Starburst erbjuder över 50 inbyggda anslutningar till datakällor, inklusive Snowflake, Oracle, PostgreSQL, MySQL, SQL Server, MongoDB, Kafka, Elasticsearch, BigQuery, Salesforce och Delta Lake, samt exklusiva anslutningar för SAP HANA, Teradata, IBM Db2 och Cosmos DB. Ett REST API är tillgängligt för anpassade integreringar, och distributioner stöds i ekosystemen AWS, Google Cloud och Microsoft Azure.
Pros and Cons
Pros:
- Snabba federerade frågor över flera källor
- Rollbaserad åtkomstkontroll för datastyrning
- Stark integrering med datasjöar och bred kompatibilitet
Cons:
- Hög resursförbrukning med stora datamängder
- Begränsade nätverksalternativ i GCP-miljöer

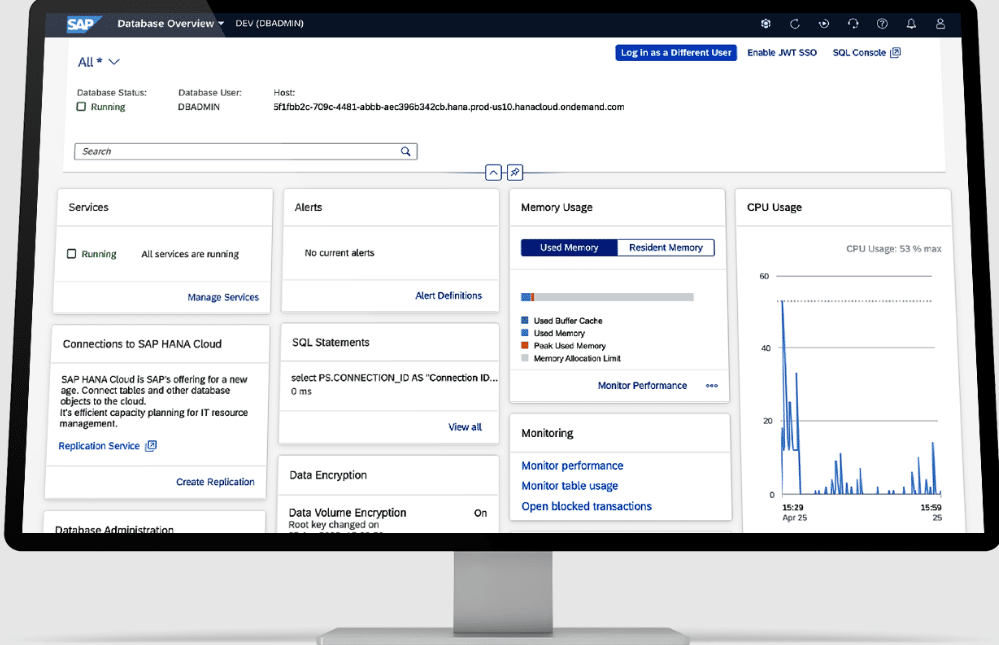
SAP HANA är en högpresterande databashanterare i minnet som accelererar datadrivet beslutsfattande och åtgärder i realtid. Dess förmåga att hantera stora datamängder och köra transaktioner och analyser på en enda plattform är anledningen till att den är idealisk för att utnyttja minnesbaserade databehandlingsfunktioner.
Varför jag valde SAP HANA:
SAP HANA var ett enkelt val för denna lista tack vare dess unika minnesbaserade databehandlingsfunktion. Den överträffar andra lösningar med sin höga prestanda och förmåga att hantera transaktionsdata och analytiska data på en enda plattform. Dessa egenskaper gör SAP HANA till det främsta verktyget för att dra nytta av minnesbaserade databehandlingsfunktioner.
Utmärkande funktioner och integrationer:
Viktiga funktioner i SAP HANA omfattar dataanalys i realtid, prediktiv analys och rumslig bearbetning, vilket gör det möjligt för organisationer att snabbt bearbeta och analysera stora datamängder.
Plattformen erbjuder en mängd olika integrationsalternativ. Den fungerar effektivt tillsammans med andra SAP-lösningar, tredjepartslösningar och datakällor, vilket säkerställer att dina affärsprocesser blir smidiga och effektiva.
Pros and Cons
Pros:
- Mycket effektiv minnesbaserad databehandling
- Förmåga att hantera både transaktionsdata och analytiska data på en enda plattform
- En mängd olika integrationsmöjligheter
Cons:
- Transparent prisinformation är inte offentligt tillgänglig.
- Plattformen kan vara för komplex för mindre företag.
- Kräver betydande resurser och kompetens för att implementeras effektivt

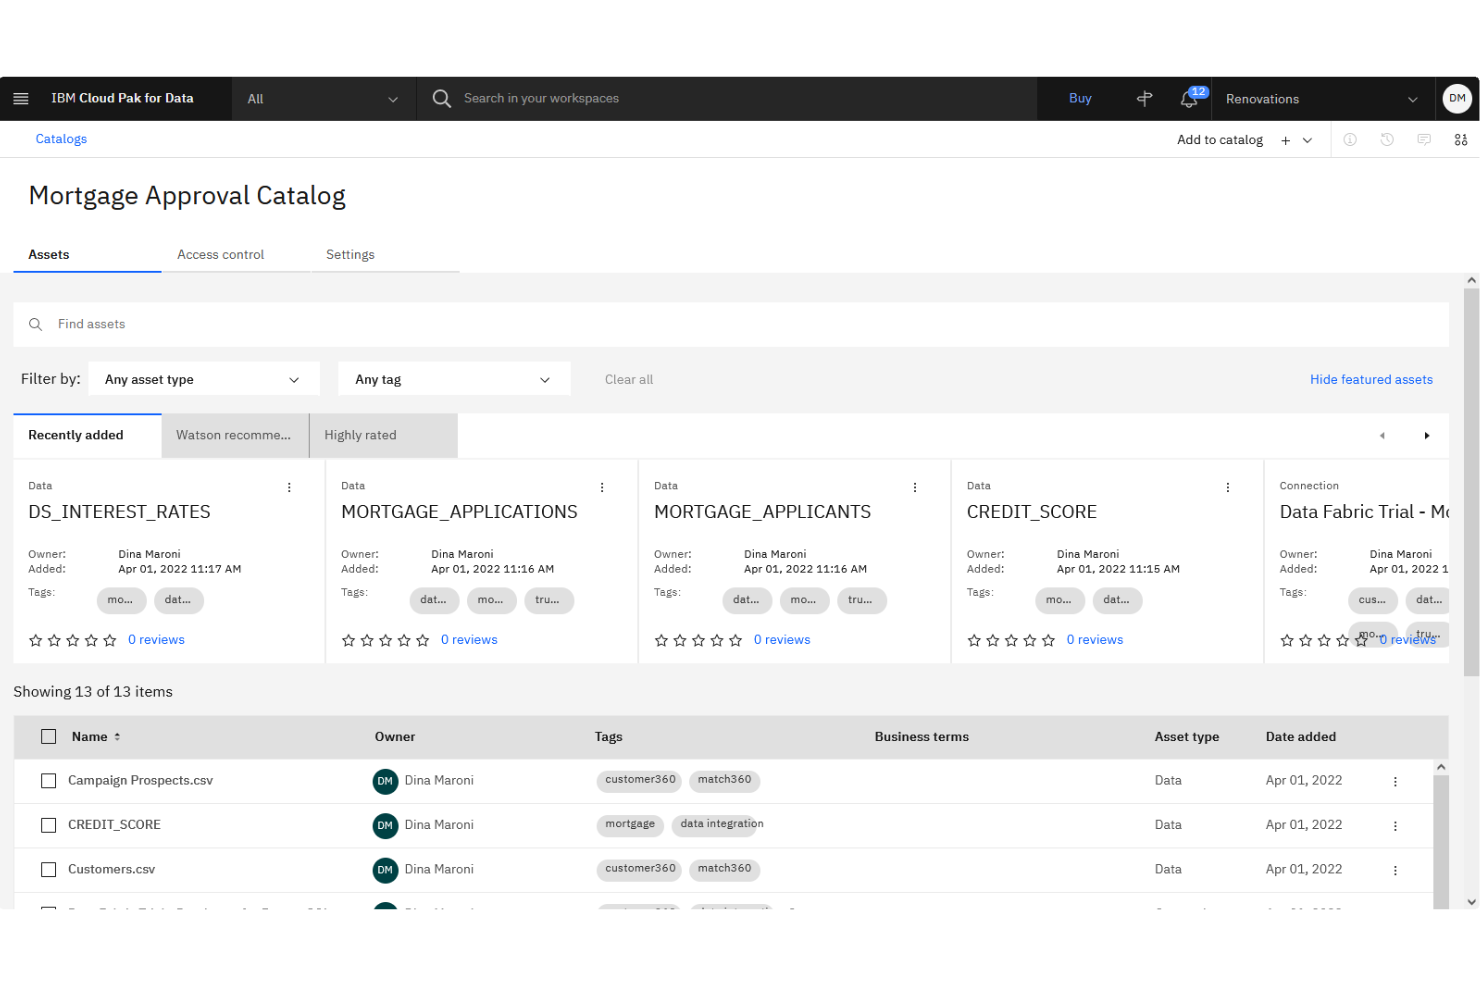
IBM Cloud Pak for Data är en modulär data- och AI-plattform som använder data fabric-arkitektur för att samla in, organisera och analysera data i lokala miljöer, molnmiljöer och hybridmiljöer utan att fysiskt flytta den.
Vem passar IBM Cloud Pak for Data bäst för?
IBM Cloud Pak for Data passar bra för stora företag och dataintensiva organisationer som hanterar komplexa IT-miljöer med flera moln eller hybridmoln.
Varför jag valde IBM Cloud Pak for Data
Jag har inkluderat IBM Cloud Pak for Data bland mina toppval eftersom plattformen hanterar insamling, organisering och analys av data utan att du behöver flytta data fysiskt mellan system. Jag uppskattar särskilt dess lager för datavirtualisering, som ansluter till över 60 datakällor i lokala miljöer och molnmiljöer i en enda vy. Jag förlitar mig också på den inbyggda hanteringen av metadata och tillämpningen av policyer, som automatiskt spårar datahärkomst och användning under hela datalivscykeln. För team som kör hybridmiljöer med flera moln är den kombinationen av virtualisering och styrning på en och samma plats genuint svår att återskapa med separata verktyg.
Viktiga funktioner i IBM Cloud Pak for Data
- Hantering av AI-livscykeln: Bygg, träna och distribuera maskininlärningsmodeller inom en enda plattform, från dataförberedelse till modelldistribution.
- Dataåtkomst via flera gränssnitt: Stöder gränssnitt för kod, arbetsyta och utan kod, så att användare med olika kunskapsnivåer kan söka i och arbeta direkt med data.
- Stöd för datapipelines: Kombinerar virtualisering, pipelines och anslutningar för att leverera både realtidsdata och batchdata för analys- och AI-arbetsbelastningar.
- Hantering av arbetsbelastningar över moln: Hantera och distribuera arbetsbelastningar över flera molnmiljöer från en enda kontrollpunkt utan att konfigurera om enskilda system.
Integrationer för IBM Cloud Pak for Data
IBM Cloud Pak for Data ansluter till ett brett utbud av datakällor, med anslutningar för plattformar som Amazon S3, Amazon Redshift, Google BigQuery, Google Cloud Storage, Microsoft Azure Blob Storage, Microsoft SQL Server, Oracle, Salesforce, SAP HANA och Teradata. En administratör kan även ladda upp JDBC-drivrutiner för att aktivera anslutningar till ytterligare datakällor, och IBM tillhandahåller ett Connector SDK på GitHub för att bygga anpassade anslutningar till datakällor som inte stöds direkt från början.
Pros and Cons
Pros:
- Gör sökningar i flera källor utan att flytta data
- Inbyggd styrning via Watson Knowledge Catalog
- Distribueras i hybridmiljöer och miljöer med flera moln
Cons:
- Komplex inledande konfiguration och distributionsprocess
- Kräver omfattande infrastruktur för att fungera väl

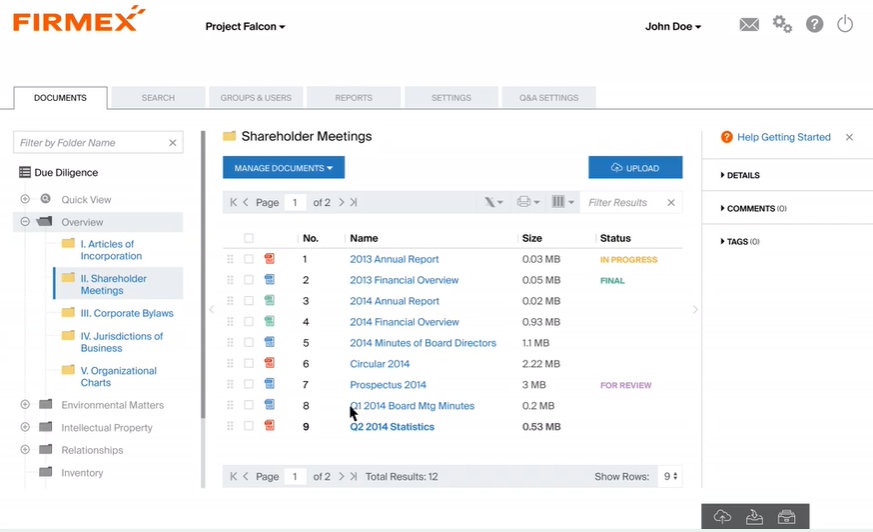
Firmex är ett verktyg som med bravur hanterar företagsgranskningar och erbjuder en idealisk plattform för att administrera komplexa granskningsprocesser i stor skala. Det ger en hög grad av kontroll, vilket gör det till den självklara lösningen för företag som behöver överlägsen datahantering under omfattande granskningar.
Varför jag valde Firmex:
Firmex tog plats på min lista tack vare sin imponerande kapacitet att hantera komplicerade granskningsuppgifter. Dess förmåga att effektivt och säkert hantera stora datamängder skiljer det från konkurrenterna. Jag valde Firmex som bäst för granskningsprocesser i stor skala tack vare dess omfattande uppsättning funktioner, utformad för att förenkla och effektivisera omfattande granskningar och dataanalyser.
Utmärkande funktioner och integrationer:
Firmex har robusta funktioner för dokumenthantering som möjliggör noggrann organisering och kategorisering, så att du alltid har kontroll över dina data. Dessutom ger de detaljerade behörighetsinställningarna ett extra lager av kontroll. När det gäller integrationer kan Firmex fungera sömlöst med Microsoft Office och olika molnlagringsplattformar, vilket möjliggör enkel import och export av data.
Pros and Cons
Pros:
- Specialiserat på företagsgranskningar
- Hög grad av datakontroll
- Värdefulla integrationer med vanligt använda plattformar
Cons:
- Behovet av transparent prissättning kan avskräcka
- Begränsad flexibilitet i datavisualisering

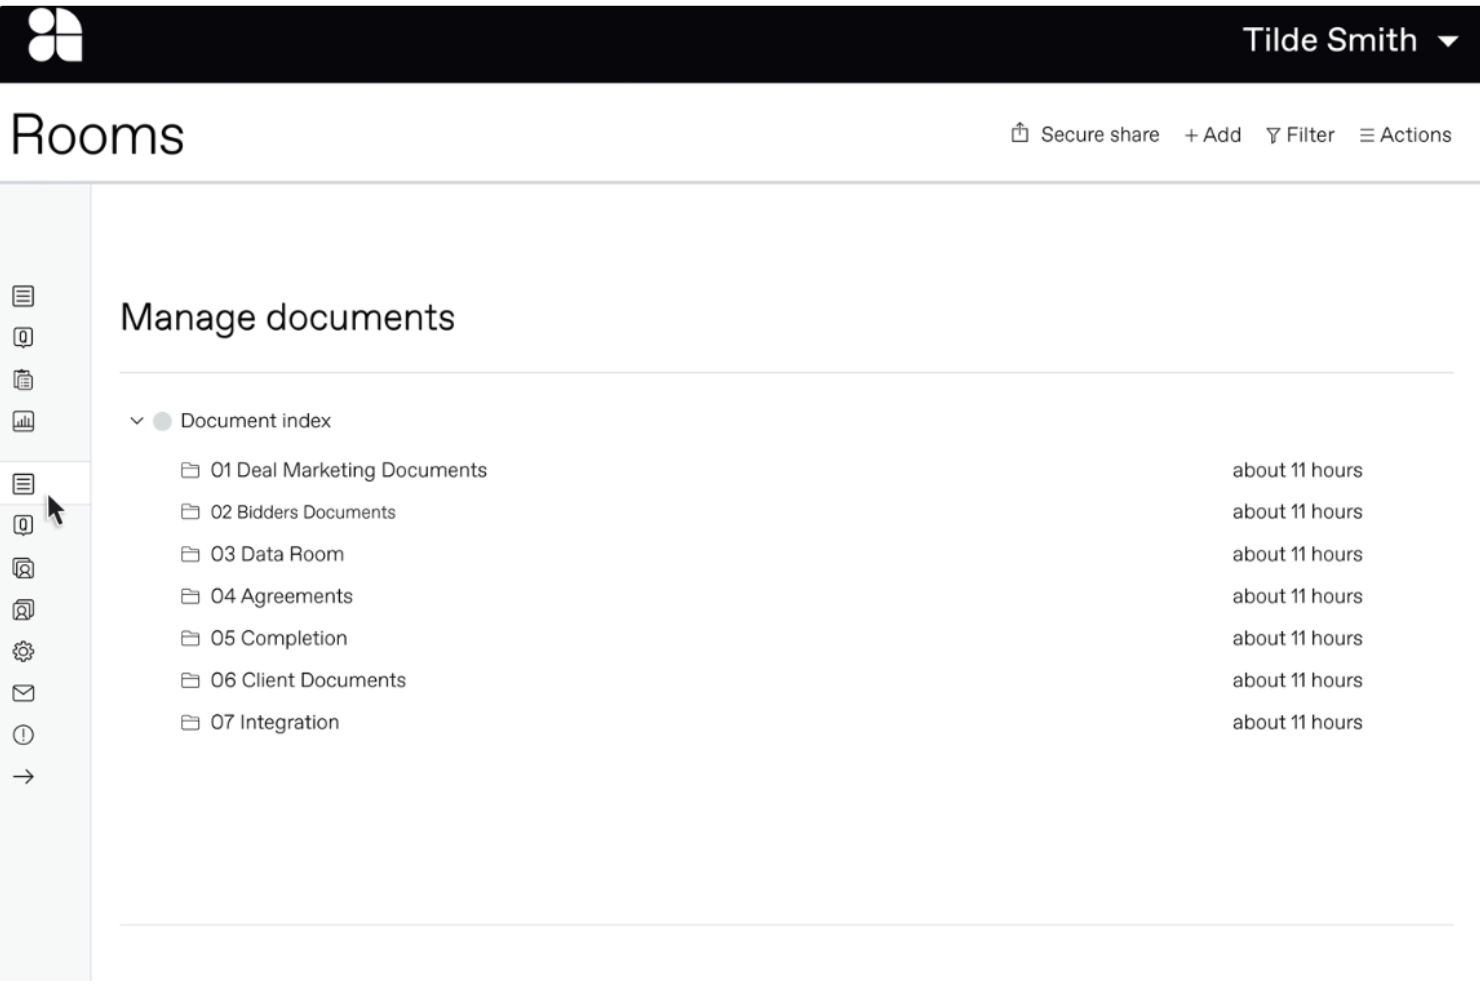
Ansarada är en virtuell datarums- och affärshanteringsplattform som centraliserar dokument, arbetsflöden och strukturerade processer för transaktioner som M&A, kapitalanskaffningar och revisioner.
Vem passar Ansarada bäst för?
Ansarada passar bra för företagsutvecklingsteam, investmentbankirer och juridiska rådgivare som hanterar transaktioner med höga insatser, som M&A, börsintroduktioner eller kapitalanskaffningar.
Varför jag valde Ansarada
Jag valde Ansarada eftersom plattformen samlar vägar, processer och data på ett och samma ställe under hela affärens livscykel. Det jag tycker är mest användbart är AI-sortering, som omorganiserar och omordnar dokument i datarummet på några minuter, samt AI-prognos, som kan identifiera den sannolika vinnande budgivaren senast dag 7 i en affär. Jag uppskattar också verktyget AI-smart Q&A, som hanterar frågor om företagsgranskning med automatiserade godkännanden, AI-kommentarer och varningar om liknande frågor. Det minskar den fram- och återgående kommunikation som vanligtvis gör transaktioner långsammare.
Ansaradas viktigaste funktioner
- Detaljerade behörighetskontroller: Ställ in rollbaserad åtkomst på mapp- och dokumentnivå, med alternativ för skrivskyddad åtkomst, nedladdningsbegränsningar, utgångsdatum och dynamisk vattenmärkning.
- Fjärrstyrd självförstörelse: Återkalla åtkomsten till valfritt delat dokument när som helst, även efter att det har laddats ned eller sparats externt.
- AI-redigering: Identifiera och maskera automatiskt känslig information i dokument innan de delas med budgivare eller rådgivare.
- Rapportering av granskningsspår: Spåra varje inloggning, dokumentvisning, nedladdning och behörighetsändring med exporterbara aktivitetsloggar för efterlevnad och transaktionsdokumentation.
Ansarada-integrationer
Ansarada erbjuder ett mindre antal inbyggda integrationer med Box, Dropbox, Google Drive och OneDrive för synkronisering av dokument till plattformen. Ett API är tillgängligt för att bygga anpassade integrationer med andra system som SharePoint, Xero och QuickBooks.
Pros and Cons
Pros:
- AI-drivna verktyg för dokumentsortering och maskering
- Prediktiv analys av budgivarnas engagemang
- Sex nivåer av detaljerad åtkomstkontroll
Cons:
- Långsam bearbetning vid stora datamängder
- Frekvent ny autentisering stör arbetsflödet

Bäst för att ansluta alla dina datakällor till en enda logisk datasjö
Data Virtuality är en kraftfull kanal som integrerar alla dina datakällor i en enhetlig, logisk datasjö. Genom att underlätta datakonsolidering lever den upp till sin status som det främsta verktyget för att skapa ett enhetligt dataekosystem.
Varför jag valde Data Virtuality:
Jag valde Data Virtuality på grund av dess unika förmåga att federera olika datakällor till en enda logisk enhet, en funktion som är avgörande i dagens datadrivna landskap. Denna aspekt gör lösningen särskiljande och ger den en oöverträffad förmåga att sammanföra disparata data på ett sammanhängande sätt. Det är bäst att sammanföra alla dina datakällor tack vare dess avancerade arkitektur och robusta anslutningsmöjligheter, vilket möjliggör enkel datakonsolidering och hantering.
Utmärkande funktioner och integrationer:
Data Virtuality utmärker sig genom dataåtkomst i realtid, omfattande anslutningsmöjligheter och SQL-baserad datamodellering. Skapandet av datapipelines med lite kod förenklar processen att upprätta dataanslutningar. När det gäller integrationer stöder Data Virtuality många databaser, molnlagringstjänster och CRM-system, vilket gör det till en mångsidig lösning som kan anpassas till alla datalandskap.
Pros and Cons
Pros:
- Omfattande anslutningsmöjligheter till olika datakällor
- Dataåtkomst i realtid för omedelbara insikter
- SQL-baserad datamodellering för enkel användning
Cons:
- Prissättningen kan vara hög för mindre organisationer.
- Kräver teknisk expertis för att utnyttjas fullt ut
- Begränsade funktioner för avancerad analys

Övrig programvara för datavirtualisering
Nedan finns en lista över ytterligare programvara för datavirtualisering som jag tog med på kortlistan men som inte hamnade bland de tio främsta. De är värda att ta en titt på.
- Oracle Big Data SQL Cloud Service
Bra för att kombinera data från Oracle Database, Hadoop och NoSQL
- SecureDocs Data Room
Bra för att underlätta företagsgranskning vid fusioner och förvärv
- Caplinked
Bra för säker fildelning och behov av virtuella datarum


Relaterade recensioner av IT-programvara
Om du fortfarande inte har hittat det du letar efter här kan du ta en titt på dessa alternativa verktyg som vi har testat och utvärderat.
- Programvara för nätverksövervakning
- Programvara för serverövervakning
- SD-Wan-lösningar
- Verktyg för infrastrukturövervakning
- Paketanalysator
- Verktyg för applikationsövervakning
Så utvärderar jag programvara för datastyrning
Jag delar upp min utvärdering i två lager—kärnkrav som datalinje, policytillämpning och klassificering, samt särskiljande faktorer som skiljer verktyg byggda för datastyrning i företagsskala åt.
Grundläggande funktioner (krav för denna lista)
När jag väljer verktyg till min lista rangordnar jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärkt inom området) för varje grundläggande funktion nedan. Därefter omvandlar jag verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå en totalpoäng på minst 75 % för att övervägas för inkludering.
- Datakatalogisering och upptäckt: Jag kontrollerar om plattformen automatiskt kan skanna och inventera tillgångar i molnbaserade datalager, datasjöar och lokala databaser, i stället för att förlita sig på manuell registrering.
- Spårning av datalinje: Det är viktigt att kunna följa hur en intäktssiffra flödar från källsystem genom transformationer till en instrumentpanel, så jag letar efter datalinje på kolumnnivå med visuell kartläggning.
- Policyhantering och tillämpning: Jag utvärderar om styrningsregler kan skapas centralt och tillämpas i olika system, inte bara dokumenteras i en wiki som ingen kontrollerar.
- Dataklassificering och känslighetsmärkning: Att automatiskt identifiera personligt identifierbar information i hundratals tabeller är ett verkligt behov, så jag letar efter ML-baserad klassificering med stöd för anpassade känslighetskategorier.
- Åtkomstkontroll och efterlevnadsrevision: Jag utvärderar rollbaserade eller attributbaserade åtkomstkontroller tillsammans med granskningsloggar som kan skapa beviskedjor för regulatoriska granskningar enligt GDPR eller HIPAA.
- Datakvalitetsstyrning: Kvalitetsregler, profilering och avvikelsedetektering bör upptäcka problem som plötsliga ökningar av nullvärden eller schemaskevhet innan de stör efterföljande rapporter och datapipelines.
När jag har en lista över verktyg som uppfyller dessa kriterier överväger jag vad som skiljer varje plattform från de andra.
Särskiljande faktorer (det som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer:
Utmärkande funktioner
Jag letar efter AI/ML-driven automatisering som minskar manuellt arbete, till exempel automatisk klassificering av tusentals kolumner i stället för att märka varje kolumn för hand. En datamarknadsplats är en annan särskiljande faktor—den låter affärsanvändare bläddra bland och begära styrda datamängder genom godkännandearbetsflöden i stället för att skicka ärenden till datateamet. Arbetsflöden för dataansvariga är också viktiga. Plattformar som dirigerar uppgifter till rätt dataägare via Slack eller Teams håller datastyrningen i rörelse utan att skapa flaskhalsar.
Bortom funktionerna
Integrationsekosystemet är en av de första sakerna jag kontrollerar. Ett styrningsverktyg som inte kan ansluta till din faktiska teknikstack—Snowflake, Databricks, dbt, Tableau—skapar blinda fläckar i hela pipelinen. Regulatorisk täckning är lika viktig; jag utvärderar om leverantörer tillhandahåller färdiga mallar för efterlevnad eller tvingar dig att bygga revisionsrapporter från grunden. Pristransparens väger också tungt i min utvärdering. Vissa leverantörer tar betalt per anslutning eller datakälla, vilket kan bli oförutsägbart när din miljö växer.
Så väljer du programvara för datavirtualisering
Det är lätt att fastna i långa funktionslistor och komplexa prisstrukturer. För att hjälpa dig att hålla fokus när du arbetar dig igenom din unika process för programvaruval kommer här en checklista över faktorer att ha i åtanke:
| Faktor | Vad du bör tänka på |
|---|---|
| Skalbarhet | Kan programvaran hantera ökande datamängder och växande användarkrav? Leta efter alternativ som stöder höga frågevolymer och miljöer med flera moln. |
| Integrationer | Kan den ansluta till dina befintliga datakällor, BI-verktyg och analysplattformar? Säkerställ smidig integration med databaser, molntjänster och API:er. |
| Anpassningsbarhet | Kan du konfigurera åtkomstkontroller, datavyer och optimeringar av frågor så att de passar dina behov? En flexibel lösning säkerställer att den passar din datastrategi. |
| Användarvänlighet | Är plattformen enkel för ditt team att navigera i? Leta efter ett intuitivt gränssnitt, enkel körning av frågor och minimala utbildningskrav. |
| Budget | Matchar prissättningen ditt teams behov? Ta hänsyn till licensmodeller, begränsningar för databearbetning och extra kostnader för avancerade funktioner. |
| Säkerhetsåtgärder | Hur väl skyddar den känsliga data? Kontrollera kryptering, åtkomstkontroller och efterlevnad av branschstandarder som GDPR och SOC 2. |
| Prestanda & hastighet | Ger den snabb körning av frågor och åtkomst i realtid till virtualiserade data? Långsam prestanda kan skapa flaskhalsar i analyser och rapportering. |
| Datastyrning | Erbjuder den granskning, metadatashantering och rollbaserad åtkomstkontroll? Dessa funktioner hjälper till att säkerställa datakvalitet, efterlevnad och överblick. |
Trender inom programvara för datavirtualisering
I min research samlade jag in otaliga produktuppdateringar, pressmeddelanden och versionsloggar från olika leverantörer av programvara för datavirtualisering. Här är några framväxande trender som jag håller ögonen på:
- AI-driven optimering av frågor: Allt fler plattformar använder AI för att förbättra frågeprestandan och minska fördröjningen. Maskininlärningsmodeller analyserar frågemönster och optimerar automatiskt körningsplaner, vilket hjälper team att få åtkomst till data snabbare utan manuell finjustering. Vissa leverantörer erbjuder nu prediktiv cachning för att förutse ofta åtkomna datamängder.
- Datafederering i realtid: Företag vill ha åtkomst till aktuella data utan replikering, vilket leder till framsteg inom realtidsfederering. Nya lösningar förbättrar möjligheten att ställa frågor mot flera källor samtidigt, även över strukturerade och ostrukturerade datamängder, vilket säkerställer noggrannhet ner på sekundnivå.
- Policybaserad datastyrning: Allt fler verktyg inför automatiserade styrningsfunktioner för att hjälpa team att upprätthålla efterlevnad. Dynamiska åtkomstkontroller, automatisk datamaskering och rollbaserade policyer blir standard för att minska säkerhetsrisker och uppfylla föränderliga regelverk.
- Datavirtualisering vid kanten: När allt mer data genereras vid kanten bygger vissa leverantörer virtualiseringslösningar som sträcker sig bortom traditionella datacenter. Dessa verktyg gör det möjligt för organisationer att bearbeta, analysera och ställa frågor mot kantdata utan att centralisera den, vilket minskar fördröjning och bandbreddsanvändning.
- Självbetjäningsbaserad datavirtualisering: Allt fler plattformar riktar sig till företagsanvändare genom att erbjuda alternativ utan kod och med lite kod. Dessa funktioner låter icke-tekniska team skapa virtualiserade vyer, köra frågor och få åtkomst till data i realtid utan att vara beroende av IT, vilket förbättrar flexibiliteten i datadrivet beslutsfattande.
Vad är programvara för datavirtualisering?
Programvara för datavirtualisering är ett praktiskt datahanteringsverktyg som främst används av företag, analytiker och IT-personal. Den här typen av programvara skapar en integrerad vy av data från olika, sinsemellan olikartade källor, såsom databaser, ODBC (öppen databasanslutning), JDBC (Java-databasanslutning), analytiska och strukturerade/ostrukturerade datakällor, applikationer och system, vilket gör det möjligt för användare att komma åt, manipulera och tolka dessa data utan att känna till deras fysiska plats eller format.
Programvara för datavirtualisering kan överbrygga skillnaden mellan olika dataformer, oavsett om de är relationella eller ostrukturerade. Denna innovativa metod erbjuder åtkomst i realtid och tillhandahållande på begäran, vilket överträffar traditionella verktyg för dataintegration.
Genom att skapa ett integrerat datalager effektiviserar datavirtualiseringstekniken ditt arbete och gör det mer effektivt och kostnadseffektivt. För organisationer som vill utöka sin datahanteringskapacitet bortom virtualisering kan en utforskning av omfattande programvara för dataväv ge ytterligare arkitektoniska fördelar. Den utnyttjar maskininlärning för beslutsstöd, stöder cachning och kan komma åt data från olika källor, inklusive webbtjänster och plattformar med öppen källkod. Den löser effektivt de problem som är förknippade med fragmenterade datamängder och datalager.
Funktioner i programvara för datavirtualisering
När du väljer programvara för datavirtualisering bör du hålla utkik efter följande viktiga funktioner:
- Dataåtkomst i realtid: Hämtar data från flera källor direkt utan att replikering eller förflyttning krävs.
- Federerade frågor: Kör frågor över olika databaser, datasjöar och molnlagring som om de vore en enda källa.
- Dynamisk datamaskering: Skyddar känslig information genom att automatiskt dölja eller förvränga data baserat på användarroller.
- AI-driven frågeoptimering: Använder maskininlärning för att förbättra frågeprestandan och minska bearbetningstiden.
- Metadatahantering: Organiserar, katalogiserar och berikar data med sammanhang för att förbättra sökbarhet och styrning.
- Rollbaserad åtkomstkontroll: Säkerställer att användare endast får åtkomst till data som de har behörighet att se, vilket förbättrar säkerhet och efterlevnad.
- Stöd för schema vid läsning: Gör det möjligt för användare att ställa frågor till ostrukturerade och halvstrukturerade data utan att fördefinierade scheman behövs.
- Självbetjäningsvyer för data: Låter företagsanvändare skapa virtualiserade datauppsättningar utan IT:s medverkan, vilket förbättrar flexibiliteten.
- Spårning av datahärkomst: Kartlägger datakällor, omvandlingar och beroenden för att förbättra transparens och granskningsbarhet.
- Databearbetning i kanten: Stödjer virtualisering av data som genereras i kanten, vilket möjliggör åtkomst med låg fördröjning för IoT och fjärrdrift.
Fördelar med programvara för datavirtualisering
Att implementera programvara för datavirtualisering ger flera fördelar för ditt team och din verksamhet. Här är några av de fördelar du kan se fram emot:
- Snabbare dataåtkomst: Hämtar data från flera källor i realtid utan replikering, vilket minskar fördröjningar i beslutsfattandet.
- Lägre lagringskostnader: Eliminerar behovet av att duplicera data mellan system, vilket minskar lagringskostnaderna.
- Bättre datastyrning: Tillämpar rollbaserade åtkomstkontroller och dynamisk maskering för att hålla känslig information säker.
- Förenklad dataintegration: Ansluter till databaser, molnplattformar och datasjöar utan komplexa ETL-processer.
- Ökad flexibilitet: Gör det möjligt för företagsanvändare att skapa och ändra datavyer utan att vara beroende av IT-team.
- Förbättrad frågeprestanda: Använder AI-drivna optimeringar och cachning för att snabba upp datahämtning och analys.
- Mer korrekta rapporter: Tillhandahåller en enhetlig vy av data, vilket säkerställer att rapporter hämtar information från de senaste och mest konsekventa uppgifterna.
Kostnader och priser för programvara för datavirtualisering
Att välja programvara för datavirtualisering kräver en förståelse av de olika prismodeller och abonnemang som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamstorlek, tillägg och mer. Tabellen nedan sammanfattar vanliga abonnemang, deras genomsnittliga priser och typiska funktioner som ingår i lösningar för programvara för datavirtualisering:
Jämförelsetabell för abonnemang för programvara för datavirtualisering
| Abonnemangstyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| Gratisabonnemang | $0 | Grundläggande datavirtualisering, begränsat antal frågor, åtkomst för en användare och communitysupport. |
| Personligt abonnemang | $10-$50/användare/månad | Högre frågebegränsningar, dataintegration från flera källor, rollbaserad åtkomstkontroll och grundläggande analys. |
| Företagsabonnemang | $100-$500/användare/månad | Avancerade säkerhetsfunktioner, AI-driven frågeoptimering, dataåtkomst i realtid och API-integrationer. |
| Enterprise-abonnemang | Anpassad prissättning | Anpassad skalbarhet, dedikerad support, efterlevnadscertifieringar och verktyg för datastyrning. |
Vanliga frågor
Här är några svar på vanliga frågor om programvara för datavirtualisering:
Vilka är fördelarna med att använda programvara för datavirtualisering?
Programvara för datavirtualisering erbjuder flera fördelar. Den förenklar datahanteringen genom att ge en enhetlig vy av data i realtid från olika källor. Det minskar behovet av fysisk dataförflyttning och konsolidering, vilket leder till kostnadsbesparingar. Det ger snabbare åtkomst till insikter eftersom data bearbetas och analyseras i realtid. Dessutom främjar \u003ca href=\u0022https://thectoclub.com/tools/best-data-governance-software/\u0022 data-wpil-monitor-id=\u002285\u0022\u003ebättre datastyrning\u003c/a\u003e, eftersom all data kan hanteras och övervakas från en plats. Slutligen förbättrar det säkerhet och efterlevnad genom att tillhandahålla mekanismer för att kontrollera dataåtkomst och säkerställa att datahanteringen uppfyller regulatoriska standarder.
Hur mycket kostar verktyg för datavirtualisering?
Priset på verktyg för datavirtualisering kan variera kraftigt beroende på deras funktioner, organisationens storlek och mängden data som hanteras.
Vilka är de vanligaste prismodellerna för dessa verktyg?
Några vanliga prismodeller omfattar prenumerationer per användare och månad, årliga prenumerationer samt prissättning baserad på datamängd. Vissa leverantörer erbjuder ett grundpaket med möjlighet att köpa ytterligare funktioner eller tjänster som tillägg.
Vilket är det typiska prisintervallet för programvara för datavirtualisering?
Ett grundläggande verktyg för datavirtualisering kan kosta så lite som $20 per användare och månad. Alternativ i mellansegmentet kan kosta mellan $50 och $100 per användare och månad. Mer omfattande lösningar på företagsnivå kan kosta flera hundra dollar per användare och månad.
Vilka är några av de billigaste och dyraste programvarorna?
Kostnaden för programvara för datavirtualisering kan variera från kostnadsfritt för vissa grundläggande verktyg, som Microsoft Power BI, till flera hundra dollar per månad för mer avancerade lösningar på företagsnivå, som Informatica och Denodo.
Finns det kostnadsfria alternativ för programvara för datavirtualisering?
\u0022Data är livsnerven i dagens företag, men att utvinna meningsfulla insikter från olika källor är fortfarande en stor utmaning. Traditionella integrationsmetoder har svårt att hantera prestanda, flexibilitet och styrning.
Datavirtualisering erbjuder en lösning genom att skapa en enhetlig vy över systemen – vilket eliminerar informationssilos, förbättrar åtkomsten och påskyndar insikter. Men med så många alternativ är det inte lätt att välja rätt programvara.
Den här guiden går igenom de främsta lösningarna för datavirtualisering för att hjälpa dig att enkelt navigera bland lokala data- och molnmiljöer samt hybridmiljöer.\u0022
Ja, det finns kostnadsfria alternativ. Microsoft Power BI erbjuder till exempel en kostnadsfri version med begränsade funktioner. Betalda versioner krävs dock vanligtvis för mer avancerade funktioner, särskilt för större företag.
\u0026nbsp;
Slutsats
Dagens datamättade landskap innebär att effektiv datahantering är avgörande för företagets framgång. Datavirtualisering erbjuder en kraftfull lösning för att övervinna informationssilos och frigöra värdefulla insikter.
Den här omfattande guiden hjälper dig att hitta rätt programvara för datavirtualisering utifrån dina behov. Överväg programvara för lagringsvirtualisering för att välja den perfekta plattformen för att förbättra dataåtkomsten, optimera frågeprestandan och påskynda beslutsfattandet.
Stärk din SaaS-tillväxt och ditt ledarskap. Prenumerera på vårt nyhetsbrev för de senaste insikterna för CTO:er och blivande teknikledare. Vi hjälper dig att skala smartare och leda starkare med guider, resurser och strategier från ledande experter!