

Att hantera en DevOps-pipeline är ingen liten bedrift. Mellan att säkerställa stabilitet i produktionen, spåra prestandaflaskhalsar och förhindra driftstopp kan pressen att hålla allt igång smidigt kännas överväldigande. Kanske har du upplevt frustrerande förseningar på grund av oupptäckta problem eller kämpat med verktyg som inte integreras sömlöst i dina arbetsflöden. Verkligheten är att det utan rätt verktyg för DevOps-övervakning blir en uppförsbacke att upprätthålla effektiviteten och leverera en fantastisk användarupplevelse.
Verktyg för DevOps-övervakning är utformade för att ge dig insyn i dina system, så att du kan identifiera och lösa potentiella problem innan de påverkar dina användare. De är avgörande för att upprätthålla en smidig drift, optimera prestandan och säkerställa att ditt team kan fokusera på innovation i stället för brandkårsutryckningar. Under årens lopp har jag arbetat med många övervakningslösningar i stora projekt och med olika team. I den här guiden delar jag med mig av mina främsta rekommendationer och insikter för att hjälpa dig välja det perfekta verktyget för att effektivisera dina processer och hålla dina system igång med maximal prestanda.
Varför du kan lita på våra programvarurekommendationer
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Expertgranskare:
- Paulo Gardini MiguelTeknikdirektör
 Tim FisherVP för AI
 Gabriel RosasTech Lead & mjukvaruarkitekt
 Christhian GruhnTech Lead & plattformsarkitekt

Jämförelsetabell för verktyg för DevOps-övervakning
Tabellen nedan jämför prisuppgifterna för mina främsta val av verktyg för DevOps-övervakning.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för övervakning av hybridinfrastruktur | 30 dagars kostnadsfri provperiod + kostnadsfri plan tillgänglig | Från $200/månad (faktureras årsvis) | Website | |
| 2 | Bäst för övervakning av riktiga användare | 30 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig | Från 10 USD/månad (faktureras årsvis) | Website | |
| 3 | Bäst för övervakning av flera moln | 30 dagars kostnadsfri provperiod + kostnadsfri demo + kostnadsfri plan tillgänglig | Från $199/år | Website | |
| 4 | Bäst för infrastrukturinsikter i realtid | 14 dagars kostnadsfri provperiod + kostnadsfri plan + kostnadsfri demo tillgänglig | Från $4.50/nod/månad (faktureras årsvis) | Website | |
| 5 | Bäst för övervakning av SSL-certifikat | Gratisabonnemang + gratis demo tillgänglig | Från $8/10 övervakningar/månad (årsvis fakturering) | Website | |
| 6 | Bäst för heltäckande prestandaövervakning för stora företag | 15 dagars kostnadsfri provperiod | Från $0.08/8 GB/timme | Website | |
| 7 | Bäst för övervakning av serverstörningar och avbrott | 14 dagars kostnadsfri provperiod | Från $21 per användare och månad | Website | |
| 8 | Bäst för kontinuerlig övervakning av stora portnätverk | 30 dagars kostnadsfri provperiod | Från $1,995/användare | Website | |
| 9 | Bäst för prestandaövervakning av webbplatser och mobila enheter | 15 dagars kostnadsfri provperiod | Från $6/core/månad | Website | |
| 10 | Bäst för observerbarhet i hela SaaS-teknikstacken | Gratis plan tillgänglig | Från $49/användare/månad | Website |


Recensioner av de bästa verktygen för DevOps-övervakning
Här är en titt på de främsta verktygen för DevOps-övervakning. Jag lyfter fram funktionerna som varje verktyg erbjuder och varför de förtjänar en plats på den här listan.
 Bäst för övervakning av hybridinfrastruktur
- 30 dagars kostnadsfri provperiod + kostnadsfri plan tillgänglig
- Från $200/månad (faktureras årsvis)
Visit WebsiteCustomer Rating:4.6/5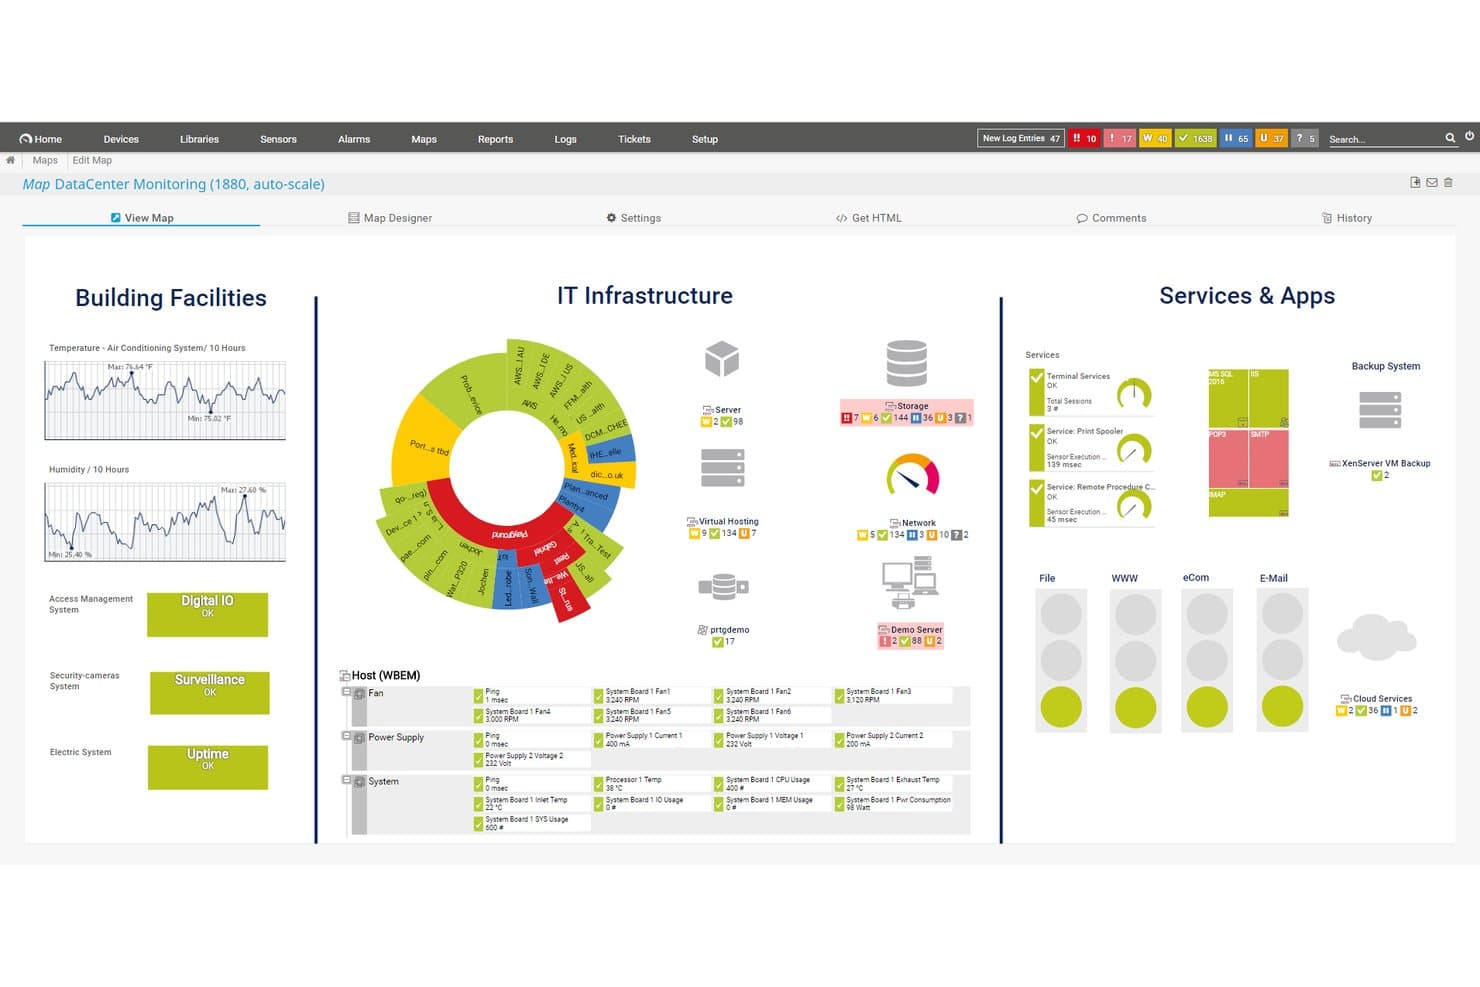
Paessler PRTG erbjuder en övervakningskarta för datacenter som visar byggnadsanläggningar, IT-infrastruktur samt tjänster och appar i en enda enhetlig instrumentpanel. Paessler PRTG är en agentlös plattform för övervakning av IT-infrastruktur som spårar nätverksenheter, servrar, applikationer, databaser och molnresurser genom ett sensorbaserat system med anpassningsbara instrumentpaneler och realtidsaviseringar.
Vem passar Paessler PRTG bäst för?
IT-driftteam i medelstora till stora organisationer som behöver centraliserad insyn i lokala nätverk, servrar och hybridinfrastruktur.
Varför jag valde Paessler PRTG
Jag valde Paessler PRTG som ett av de bästa alternativen eftersom den sensorbaserade arkitekturen låter mig hämta mätvärden från nätverksenheter, servrar, applikationer och molnresurser till en och samma plattform. Jag gillar hur kartdesignern i PRTG låter mig skapa anpassade instrumentpaneler i realtid som återspeglar min faktiska infrastruktur, i stället för en generisk mall. Konfigurationen av fjärrsonder utökar täckningen till flera platser utan att separata övervakningsverktyg behöver konfigureras.
Viktiga funktioner i Paessler PRTG
- Sensorbaserad övervakning: Låter dig spåra olika typer av enheter, tjänster och protokoll genom att tilldela individuella sensorer till specifika mätvärden.
- Anpassade REST-sensorer: Gör det möjligt att hämta data från API:er från tredje part eller anpassade applikationer via HTTP-förfrågningar.
- Distribuerad övervakning med fjärrsonder: Stöder övervakning av geografiskt utspridd infrastruktur från en och samma konsol.
- Granskningsloggning och enkel inloggning: Möjliggör spårning av användaraktivitet och smidigare åtkomsthantering för efterlevnad i större organisationer.
Integrationer med Paessler PRTG
Paessler PRTG erbjuder inbyggda integrationer med Amazon CloudWatch, Microsoft Azure, VMware vSphere och Slack samt ett API för anpassade integrationer.
Pros and Cons
Pros:
- Anpassningsbara sensorer i olika infrastrukturlager
- Starkt stöd för lokal distribution och hybriddistribution
- Automatisk identifiering kartlägger hela nätverket automatiskt
Cons:
- Begränsad inbyggd övervakning av containrar och Kubernetes
- Användargränssnittet känns föråldrat jämfört med moderna alternativ
Learn more about Paessler PRTG: Bäst för övervakning av riktiga användare
- 30 dagars kostnadsfri provperiod + kostnadsfri demo tillgänglig
- Från 10 USD/månad (faktureras årsvis)
Visit WebsiteCustomer Rating:4.7/5
Site24x7 erbjuder anpassningsbara instrumentpaneler där DevOps-team kan skräddarsy sina övervakningsvyer efter sina specifika behov. Site24x7 är en molnbaserad övervakningslösning utformad för DevOps- och IT-driftteam. Den erbjuder omfattande övervakningsfunktioner för webbplatser, servrar, nätverk, applikationer och molntjänster. Med Site24x7 kan du få realtidsinsikter i prestandan och hälsan hos din IT-infrastruktur.
Varför jag valde Site24x7: Jag gillar funktionen för övervakning av applikationsprestanda (APM). Det här verktyget hjälper dig att identifiera och felsöka prestandaproblem i dina applikationer genom att ge detaljerade insikter i transaktionsspår, databasfrågor och applikationskomponenter. En annan värdefull funktion är övervakning av riktiga användare (RUM). RUM gör det möjligt att spåra och analysera upplevelserna hos faktiska användare på dina webbplatser och webbapplikationer. Genom att förstå hur användare interagerar med dina tjänster kan du fatta välgrundade beslut för att förbättra användbarhet och prestanda.
Site24x7:s utmärkande funktioner och integrationer
Funktioner omfattar syntetisk övervakning av webbtransaktioner, vilket låter dig simulera användarinteraktioner för att identifiera potentiella problem innan de påverkar riktiga användare. Dessutom ger nätverksövervakning insyn i hälsan hos dina nätverksenheter, vilket hjälper dig att upprätthålla tillförlitligheten. Logghantering är en annan funktion som gör det möjligt för dig att samla in och analysera loggar från olika källor, vilket underlättar effektiv felsökning och problemlösning.
Integrationer omfattar ServiceNow, PagerDuty, Jira, Microsoft Teams, Slack, Nagios, AWS, Azure, Google Cloud Platform, Docker, Jenkins och Kubernetes.
Pros and Cons
Pros:
- Erbjuder realtidsaviseringar via olika kanaler
- Anpassningsbara instrumentpaneler och rapporter
- Omfattande övervakning av olika system
Cons:
- För många aviseringar kan kännas överväldigande för användare
- Komplex initial konfiguration för stora miljöer
Learn more about Site24x7: Bäst för övervakning av flera moln
- 30 dagars kostnadsfri provperiod + kostnadsfri demo + kostnadsfri plan tillgänglig
- Från $199/år
Visit WebsiteCustomer Rating:4.3/5
Robust plattform för hantering av applikationsprestanda med omfattande övervakningsfunktioner och tredjepartsintegrationer för förbättrad IT-överblick. ManageEngine Applications Manager är ett omfattande verktyg som erbjuder övervakning av flera moln, vilket gör det möjligt för användare att övervaka, hantera, granska och säkra sin multimolns- och hybridinfrastruktur. Dess unika säljargument är dess förmåga att erbjuda en enhetlig lösning för övervakning och hantering av multimolnmiljöer, vilket gör det till det bästa valet för företag som vill effektivisera sin övervakning av flera moln.
Varför jag valde ManageEngine Applications Manager: ManageEngine Applications Manager utmärker sig genom att erbjuda robusta funktioner som möjliggör kontinuerlig övervakning, prestandaanalys och felsökning genom hela DevOps-pipelinen. Det stöder ett proaktivt förhållningssätt till incidenthantering, möjliggör automatisering av rutinmässiga kontroller och tillhandahåller detaljerad analys för att förbättra beslutsfattandet. Dess förmåga att sömlöst integreras med olika verktyg för utveckling, testning och driftsättning gör det till en värdefull tillgång för DevOps-team som strävar efter hög effektivitet och minimala driftstopp.
ManageEngine Applications Managers främsta funktioner och integrationer
Funktioner omfattar omfattande stöd direkt från start för övervakning av mer än 100 applikationer och servrar, från databaser, webbservrar, applikationsservrar och virtuella servrar till molnplattformar, containrar och mikrotjänstarkitekturer. Dessutom innehåller ManageEngine Applications Manager avancerade funktioner för analys av grundorsaker som drivs av maskininlärningsalgoritmer.
Integrationer omfattar Amazon Web Services (AWS), Microsoft Azure, Google Cloud Platform, Oracle Database, MySQL, Microsoft SQL Server, VMware, Docker, Apache Tomcat och Redis.
Pros and Cons
Pros:
- Omfattande övervakningsfunktioner för applikationer, servrar och molnmiljöer
- Anpassningsbara instrumentpaneler och rapporter för insiktsfull analys
- Automatiserad avvikelsedetektering och varningsmekanismer
Cons:
- Kan vara komplicerat att konfigurera och anpassa efter specifika behov
- Kostnaden kan vara för hög för små och medelstora företag
Learn more about ManageEngine Applications Manager: Bäst för infrastrukturinsikter i realtid
- 14 dagars kostnadsfri provperiod + kostnadsfri plan + kostnadsfri demo tillgänglig
- Från $4.50/nod/månad (faktureras årsvis)
Visit WebsiteCustomer Rating:4.8/5
Netdata tillhandahåller helt automatiserade instrumentpaneler som visualiserar varje enskilt mätvärde. Netdata är en plattform med öppen källkod för övervakning och felsökning som erbjuder högupplösta mätvärden, journaler och visualiseringar i realtid för systemövervakning. Målet är att erbjuda ett kostnadseffektivt och användarvänligt alternativ till dyrare och mer komplexa plattformar.
Varför jag valde Netdata: Jag gillar att plattformen betonar data med hög detaljrikedom och tillhandahåller visualiseringar i realtid, vilket gör det möjligt för användare att övervaka systemets prestanda och hälsa med precision. Den förenklar och förbättrar även övervakningsprocessen för DevOps med funktioner för att samla in, lagra, fråga efter, visualisera och skapa aviseringar för ett stort antal mätvärden. Netdata kan köras på flera noder, och varje Netdata-instans kan fungera självständigt.
Netdatas främsta funktioner och integrationer
Funktioner inkluderar aviseringar som meddelar användare om problem som upptäcks i systemet, automatisk avvikelsedetektering samt automatiserade och anpassningsbara instrumentpaneler. Dessutom är kärnan i Netdata-ekosystemet öppen källkod och innehåller alla övervakningsfunktioner, såsom databasen, frågemotorn, poängsättningsmotorn, hälsomotorn och maskininlärningsmotorn.
Integrationer inkluderar containrar, Kubernetes-containrar, virtuella maskiner, Apache, Consul, Elasticsearch, OpenSearch, MySQL, Redis, Squid-loggfiler, Windows, macOS och hundratals fler.
Pros and Cons
Pros:
- Automatiserade aviseringar
- Övervakning av obegränsat antal mätvärden
- Interaktiva diagram för datavisualisering
Cons:
- Kan innebära en inlärningskurva för att maximera funktionerna
- Insikterna skulle kunna vara mer heltäckande
Learn more about Netdata: Bäst för övervakning av SSL-certifikat
- Gratisabonnemang + gratis demo tillgänglig
- Från $8/10 övervakningar/månad (årsvis fakturering)
Visit WebsiteCustomer Rating:4.7/5
UptimeRobot följer SSL-certifikatstatus och drifttid i en instrumentpanel i realtid. För DevOps-team som söker en tillförlitlig övervakningslösning erbjuder UptimeRobot ett praktiskt alternativ som stöder övervakning av SSL-certifikat utöver driftskontroller. Det passar team av alla storlekar, från soloanvändare till större organisationer, som behöver insyn i tjänstetillgänglighet och slutpunktsprestanda. Genom att hjälpa team att upptäcka problem som certifikatförfall, driftstopp och långsamma svarstider bidrar UptimeRobot till stabil drift och konsekvent tjänsteleverans.
Varför jag valde UptimeRobot
Jag valde UptimeRobot för dess övervakning av SSL-certifikat, som hjälper DevOps-team att undvika problem som orsakas av utgångna eller felkonfigurerade certifikat. Verktyget spårar certifikatstatus och skickar aviseringar innan certifikaten löper ut, vilket minskar risken för åtkomstvarningar eller tjänsteavbrott. UptimeRobot tillhandahåller även driftstoppsaviseringar genom integrationer som Slack och PagerDuty, vilket gör det enklare för team att reagera snabbt och hålla tjänsterna tillförlitliga.
Viktiga funktioner i UptimeRobot
Utöver övervakning av SSL-certifikat erbjuder UptimeRobot:
- Kontroller från flera platser: Övervaka dina tjänster från flera globala platser för att säkerställa tillgänglighet världen över.
- Övervakning av svarstid: Följ hur snabbt din server svarar för att få insyn i flaskhalsar i prestandan.
- Anpassningsbara statussidor: Dela statusuppdateringar i realtid med användare via varumärkesanpassade statussidor.
- Incidenthantering: Hantera och lös incidenter effektivt med anpassningsbara aviseringar och åtkomstnivåer för teamet.
UptimeRobot-integrationer
Integrationerna omfattar Slack, PagerDuty, Microsoft Teams, Telegram, Discord, Splunk On-Call med flera, vilket möjliggör smidig hantering av aviseringar på de kommunikationsplattformar du föredrar.
Pros and Cons
Pros:
- Realtidslarm säkerställer snabb respons på driftstörningar
- SSL-övervakning hjälper till att effektivt upprätthålla webbplatssäkerheten
- Stöder flera larmkanaler
Cons:
- Begränsade anpassningsmöjligheter i aviseringsinställningarna jämfört med konkurrenterna
- Inte lämpligt för komplexa DevOps-stackar
Learn more about UptimeRobot: Bäst för heltäckande prestandaövervakning för stora företag
- 15 dagars kostnadsfri provperiod
- Från $0.08/8 GB/timme
Visit WebsiteCustomer Rating:4.5/5
Dynatrace gör det möjligt att övervaka prestandamätvärden för hela din stack via en enda instrumentpanel. Dynatrace är ett verktyg för övervakning av applikationsprestanda (APM) som använder en inbyggd AI-lösning för att hjälpa DevOps-team att lokalisera prestandaproblem. Det utmärker sig vid övervakning av miljöer med flera plattformar, inklusive multicloudmiljöer, containrar, mikrotjänster och användarupplevelser.
Varför jag valde Dynatrace: Jag valde Dynatrace för dess djupgående prestandaövervakning, som är idealisk för stora företag. Det erbjuder detaljerad insyn i kunder, hybridmiljöer och alla aspekter av din infrastruktur.
Dynatraces utmärkande funktioner & integrationer:
Funktioner jag uppskattade var de som prioriterar prestanda, såsom infrastrukturövervakning och applikationsövervakning. Dessutom använder Dynatrace AI för att kontinuerligt söka efter prestandaproblem och fastställa grundorsaken.
Integrationer som Dynatrace samarbetar med inkluderar Akamas, GitLab, Gremlin, NeoLoad, LaunchDarkly, xMatters, JFrog och PagerDuty via inbyggda integrationer.
Pros and Cons
Pros:
- Använder en AI-assistent för att förbättra felsökningen och hjälpa till att lösa problem
- Brett observationsomfång som sträcker sig ända ner till kodnivå
- Mycket aktiv supportavdelning som kan besvara alla frågor om du kör fast
Cons:
- Inlärningskurva för att använda Dynatrace effektivt
- Priset är en nackdel för många små och medelstora företag
 Bäst för övervakning av serverstörningar och avbrott
- 14 dagars kostnadsfri provperiod
- Från $21 per användare och månad
Visit WebsiteCustomer Rating:4.5/5
Du kan övervaka och beräkna procentandelen misslyckade API-begäranden i PagerDuty. PagerDuty är en plattform för incidenthantering som skickar aviseringar när det uppstår en tjänstestörning eller ett avbrott. Under kritiska situationer kan den skicka e-postaviseringar, SMS-aviseringar och telefonaviseringar till ditt utvecklingsteam eller din kundbas.
Varför jag valde PagerDuty: Jag valde PagerDuty eftersom det är ett utmärkt verktyg om du driver verksamhetskritisk infrastruktur som du vill hålla koll på. Plattformen gör det möjligt för dig att omedelbart få aviseringar om incidenter.
PagerDuty – utmärkande funktioner och integrationer:
Funktionerna som jag tyckte var mest användbara är helt inriktade på att avisera team när system, noder eller applikationstjänster börjar fungera fel. De omfattar e-postaviseringar, mobilaviseringar, rotorsaksanalys, realtidsaviseringar och prioritering. Du kan även automatiskt schemalägga och eskalera problem.
Integrationerna omfattar förbyggda insticksprogram för AWS, ServiceNow, Salesforce, Zendesk, Atlassian, Datadog, Slack, Splunk med flera.
Pros and Cons
Pros:
- Gör det möjligt för dig att tilldela incidenthantering till rätt person eller team
- Anpassningsbara aviseringar kan skickas via e-post, telefon, SMS eller pushaviseringar
- Filtrerar aviseringar för att prioritera framträdande larm som indikerar verkliga hot, samtidigt som falsklarm minskar
Cons:
- Det kan vara svårt att hitta historiska aviseringar om du inte har ett exakt ID
- Använder en konventionell instrumentpanel som skulle kunna vara mer anpassningsbar för specifika behov och preferenser
Learn more about PagerDuty: Bäst för kontinuerlig övervakning av stora portnätverk
- 30 dagars kostnadsfri provperiod
- Från $1,995/användare
Visit WebsiteCustomer Rating:4.6/5
Här kan du övervaka bandbredd och portstatus i Nagios. Nagios är ett program med öppen källkod som övervakar nätverkstrafik kontinuerligt. Det kan spåra bandbreddsanvändning per port för inkommande och utgående trafik, upptäcka nätverksavbrott, identifiera överbelastade portar och upptäcka nätverksmissbrukare.
Varför jag valde Nagios: I stället för att utsätta mina system för sårbarheter eller oroa mig för långsam nätverksprestanda ger Nagios mitt DevOps-team omedelbar insyn i vårt nätverk. Jag uppskattade också att det loggar information som problem i nätverksinfrastrukturen och processer som misslyckats per port.
Nagios främsta funktioner och integrationer
Funktionerna som erbjuds av Nagios säkerställer säkerheten för mina nätverksportar. Detta omfattar SNMP-övervakning, övervakning av switchar och routrar, nätverksövervakning och pingövervakning, vilket hjälper mig att upprätthålla integriteten och säkerheten i min nätverksinfrastruktur.
Integrationer som finns färdigbyggda omfattar Amazon SNS, Prometheus, PagerDuty, Dynatrace med flera. Nagios har dessutom över 3 000 officiella plugin-program och plugin-program från communityn som utvecklare kan lägga till i sin stack.
Pros and Cons
Pros:
- Versionen med öppen källkod är 100 % kostnadsfri
- Resurssnålt för minimal resursanvändning
- Ökar tillgängligheten för hela din nätverksinfrastruktur vid protokollfel och nätverksavbrott
Cons:
- Separata licenser krävs för säkerhets- och nätverksinsynsfunktioner
- Använder filer i stället för databaser för att lagra konfigurationsfiler i serverdelen
Learn more about Nagios: Bäst för prestandaövervakning av webbplatser och mobila enheter
- 15 dagars kostnadsfri provperiod
- Från $6/core/månad
Visit WebsiteCustomer Rating:4.3/5
AppDynamics kan övervaka historiska betalningsuppgifter och tillhandahålla data om andelen användarinloggningar. AppDynamics är ett verktyg för hantering av applikationsprestanda i hela teknikstacken. Det använder maskininlärningsalgoritmer för att upptäcka prestandaproblem, jämföra dem med baslinjemätvärden och utlösa aviseringar vid behov.
Varför jag valde AppDynamics: Jag valde AppDynamics eftersom verktyget fokuserar på applikationsprestanda och samtidigt använder övervakning för att säkerställa en optimal användarupplevelse. Oavsett om du hanterar en webbplats eller en mobilapp ser AppDynamics till att dina kunder inte stöter på problem som tidsgränsöverskridningar eller långsamma sidladdningar.
AppDynamics utmärkande funktioner & integrationer:
Funktioner som jag upptäckte gör AppDynamics utmärkt för prestandaövervakning inkluderar övervakning av applikationsprestanda (APM), insyn i infrastrukturen och databasövervakning. Dessutom fångade övervakning av slutanvändare också min uppmärksamhet, eftersom den säkerställer att dina användare får högsta möjliga applikationshastighet.
Integrationer som AppDynamics samarbetar med inkluderar färdiga insticksprogram för LoadRunner, Sainapse och NeoLoad för prestanda och kontinuerlig leverans. AppDynamics samarbetar även med SquaredUp, Medallia och Quantum Metric för att övervaka kundupplevelsen.
Pros and Cons
Pros:
- Ger realtidsinformation om processer som förbrukar CPU och minne
- Övervakningsdjupet för webbapplikationer och infrastruktur är enormt
- Nätverksinsyn gör att du kan se mängden bandbredd som används per nod
Cons:
- Funktionaliteten kan vara överväldigande för små företag
- Ingen automatisk genomsökning av applikationer; de måste definieras i en konfigurationsfil
Learn more about AppDynamics: Bäst för observerbarhet i hela SaaS-teknikstacken
- Gratis plan tillgänglig
- Från $49/användare/månad
Visit WebsiteCustomer Rating:4.3/5
Du kan övervaka varje instans av din tjänst med New Relic. New Relic är ett verktyg för webbspårning och analys som övervakar realtidsobserverbarheten för varje applikationskomponent som är distribuerad över databaser och servrar.
Varför jag valde New Relic: Jag valde New Relic eftersom det erbjuder en 'allt-i-ett'-lösning som övervakar och analyserar alla aspekter av din teknikstack. Med fullständig insyn från början till slut kan team få användbara insikter när problem uppstår och snabbt hantera och lösa dem.
New Relics utmärkande funktioner och integreringar:
Funktioner som jag upptäckte gör New Relic utmärkt för övervakning av hela teknikstacken är applikationsövervakning och databasövervakning. Dessutom finns tillgänglighetsövervakning för att säkerställa att dina system fungerar på offentliga eller privata platser dygnet runt.
Integreringar finns tillgängliga med förbyggda insticksprogram som AWS, Kubernetes, Azure, Google Cloud Platform och Prometheus. Du kan även använda inbyggda integreringar som SQL Server för att skicka frågor till New Relic.
Pros and Cons
Pros:
- Mycket funktionsrik och ger möjlighet att skriva anpassade frågor mot insamlade instrumenteringsdata
- Ger insikter i mätvärden och prestanda även under hög belastning och stress
- Enkel installation av agenten som gör att du kan visa data på din instrumentpanel inom några minuter
Cons:
- Kostnaden kan anses vara hög, särskilt för nystartade företag och även medelstora företag
- Gränssnittet kan vara lite svårt att hantera på grund av antalet alternativ på skärmen
Learn more about New Relic:
Andra verktyg för DevOps-övervakning
Här är några andra verktyg som inte riktigt tog sig in bland de 12 främsta, men som definitivt är värda att ta en titt på:
- 11SplunkBäst för övervakning och sökning i stora datamängder
- 12PrometheusBäst för larm och aggregering av mätvärden
- 13Grafana CloudBäst för övervakning av dataanalys och visualisering
- 14BuddyBäst för övervakning av webbplatser och mobilappar för små företag
- 15InfluxDBBäst för övervakning av tidsseriedata i en enda databas med flera användningsområden
- 16SensuBäst för övervakning av molnmiljöer
- 17ChaosSearchBäst för att centralisera logg- och händelsedata i molnet
- 18Dotcom MonitorBäst för övervakning av kritiska arbetsflöden
- 19IcingaBäst för att kontrollera tillgängligheten hos nätverksresurser
Relaterade recensioner av programvara och verktyg
Om du fortfarande inte har hittat det du letar efter här kan du ta en titt på dessa andra typer av verktyg som vi har testat och utvärderat.
- Programvara för nätverksövervakning
- Programvara för serverövervakning
- SD-WAN-lösningar
- Verktyg för infrastrukturövervakning
- Paketanalysverktyg
- Verktyg för applikationsövervakning
Så utvärderar jag DevOps-övervakningsverktyg
Jag utvärderar dessa verktyg i två lager: kärnkrav som mätvärdesinsamling, distribuerad spårning och dirigering av aviseringar, följt av särskiljande faktorer som avgör hur väl de passar er teknikstack och ert team.
Kärnfunktionalitet (grundläggande krav för denna lista)
När jag väljer verktyg till min lista rangordnar jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärker sig inom området) för varje kärnfunktion nedan. Därefter omvandlar jag verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå en minsta totalpoäng på 75 % för att övervägas för inkludering.
- Infrastruktur- och applikationsövervakning: Jag utvärderar om ett verktyg kan spåra värdar, containrar, databaser och applikationstjänster på ett och samma ställe, till exempel genom att övervaka CPU-toppar på Kubernetes-noder tillsammans med API-fördröjning.
- Övervakning av hela teknikstacken: Loggar, mätvärden och spår bör korreleras mellan tjänster så att du kan följa en långsam begäran från ett frontendfel genom mikrotjänsternas olika led till grundorsaken.
- Aviseringar i realtid och incidenthantering: Jag kontrollerar om det finns konfigurerbara aviseringsvillkor, eskaleringspolicyer och dirigering till verktyg som PagerDuty eller Slack, så att beredskapsingenjörer meddelas via rätt kanal.
- Övervakning av CI/CD-pipelines: Det är viktigt att kunna spåra distributioner. Jag letar efter insyn i byggsteg, felfrekvenser och möjligheten att korrelera en misslyckad distribution med en produktionsincident.
- Integrationer med DevOps-verktygskedjan: Verktyget bör kunna ansluta till er befintliga stack. Jag letar efter inbyggda anslutningar till Kubernetes, Terraform, Jenkins, GitHub och större molnleverantörer.
- Avvikelsedetektering och grundorsaksanalys: Jag utvärderar om verktyget går längre än statiska tröskelvärden. ML-baserad avvikelsedetektering och händelsekorrelation hjälper SRE-team att sålla bort aviseringsbrus under driftstörningar.
När jag har en lista över verktyg som uppfyller dessa kriterier undersöker jag vad som särskiljer varje plattform.
Särskiljande faktorer (det som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer:
Utmärkande funktioner
Uppföljning av SLO:er är en viktig särskiljande faktor. Jag letar efter verktyg som låter SRE-team definiera felbudgetar och övervaka förbrukningstakter, så att beslut om tillförlitlighet förblir datadrivna snarare än reaktiva. Syntetisk övervakning är också viktig – simulering av API-anrop eller användarflöden från flera regioner upptäcker fördröjningsproblem innan riktiga användare stöter på dem. RUM kompletterar detta genom att samla in faktisk prestanda i webbläsare och på mobila enheter, vilket ger en fullständig bild av hur en distribution påverkar slutanvändarupplevelsen.
Bortom funktionerna
Jag utvärderar noggrant hur förutsägbara priserna är. Vissa verktyg tar betalt per värd medan andra tar betalt baserat på datavolym, och kostnaderna för loggretention kan skena när du samlar in terabyte från ett stort Kubernetes-kluster. Stöd för OpenTelemetry är en annan faktor jag kontrollerar, eftersom användning av öppna standarder skyddar teamet mot leverantörsinlåsning om behoven förändras. Jag tar också hänsyn till tiden till nytta: automatisk instrumentering och förbyggda instrumentpaneler kan vara skillnaden mellan att komma igång på några dagar och att behöva ägna veckor åt manuell konfigurering.
Så väljer du verktyg för DevOps-övervakning
Det är lätt att fastna i långa funktionslistor och komplexa prisstrukturer. För att hjälpa dig att behålla fokus när du arbetar dig igenom din unika process för programvaruval kommer här en checklista över faktorer att tänka på:
| Faktor | Vad man bör tänka på |
|---|---|
| FaktorSkalbarhet | Vad man bör tänka påSe till att verktyget kan hantera ökande arbetsbelastningar och fler användare utan att prestandan försämras. Molnbaserade alternativ med automatisk skalning kan hjälpa till att hantera tillväxt. |
| FaktorIntegrationer | Vad man bör tänka påKontrollera om verktyget integreras med er befintliga DevOps-stack, inklusive CI/CD-pipelines, molntjänster och plattformar för incidenthantering. |
| FaktorAnpassningsbarhet | Vad man bör tänka påLeta efter möjligheter att justera övervakningsinställningar, aviseringströsklar och instrumentpaneler så att de passar teamets arbetsflöden och prioriteringar. |
| FaktorAnvändarvänlighet | Vad man bör tänka påVerktyget bör ha ett tydligt gränssnitt och intuitiva kontroller så att teamet snabbt kan upptäcka problem och agera på dem. Komplicerade konfigurationer kan fördröja svarstiderna. |
| FaktorBudget | Vad man bör tänka påJämför prenumerationskostnader, licensavgifter och extra avgifter för avancerade funktioner eller utökade datagränser. Var uppmärksam på dolda kostnader. |
| FaktorSäkerhetsskydd | Vad man bör tänka påLeta efter kryptering, åtkomstkontroller och säker dataöverföring för att skydda känslig information och förhindra dataintrång. |
| FaktorRealtidsaviseringar | Vad man bör tänka påVerktyget bör ge omedelbara aviseringar om prestandaproblem eller driftstopp, så att teamet kan agera snabbt och minimera stillestånd. |
| FaktorDatalagring och rapportering | Vad man bör tänka påSe till att verktyget lagrar historiska data tillräckligt länge för meningsfull analys och identifiering av trender. Exporterbara rapporter är användbara vid teamgenomgångar. |
Trender inom DevOps-övervakningsverktyg
I min research samlade jag in otaliga produktuppdateringar, pressmeddelanden och versionsloggar från olika leverantörer av DevOps-övervakningsverktyg. Här är några framväxande trender som jag håller ett öga på:
Förbättrad avvikelsedetektering: Nya maskininlärningsmodeller förbättrar avvikelsedetekteringen, hjälper team att upptäcka oregelbundna mönster i realtid och minskar antalet falska positiva resultat.
Fullstack-observerbarhet: Leverantörer går längre än grundläggande övervakning för att erbjuda en komplett bild av infrastruktur, applikationer och användarupplevelse på samma plats. Det gör det enklare att identifiera och lösa problem. När du utvärderar plattformar för observerbarhet bör du leta efter lösningar som erbjuder heltäckande övervakningsfunktioner.
AI-drivna insikter: Fler verktyg använder AI för att analysera data och förutsäga prestandaproblem innan de uppstår. Det hjälper team att agera proaktivt i stället för att reagera på fel.
Distribuerad spårning: Verktyg lägger till spårningsfunktioner som gör det möjligt för team att följa förfrågningar genom mikrotjänster och containrar. Det hjälper till att fastställa var fördröjningar eller fel uppstår.
Självläkande system: Vissa verktyg erbjuder nu automatiserad åtgärdshantering, där systemet kan upptäcka ett problem och åtgärda det utan mänsklig inblandning. Detta minskar driftstopp och svarstider.
Vad är DevOps-övervakningsverktyg?
DevOps-övervakningsverktyg är specialiserade programvarulösningar som är utformade för att spåra och analysera prestandan och hälsan hos applikationer och infrastruktur i realtid. Dessa verktyg används främst av DevOps-ingenjörer, systemadministratörer och IT-yrkesverksamma för att säkerställa sömlös drift och leverans av programvaruprodukter.
DevOps-övervakningsverktyg hjälper till att automatisera övervakningsprocessen, ge insikter i systemets prestanda samt snabbt identifiera och lösa problem innan de påverkar produktionsmiljön. Funktioner som realtidsaviseringar, verktyg för dataobserverbarhet och prediktiv analys stöder alla proaktiv problemlösning och förbättrar den operativa effektiviteten.
Funktioner
Här är några av de viktigaste funktionerna som jag letar efter i DevOps-övervakningsverktyg när jag utvärderar dem för min lista:
- Realtidsaviseringar och meddelanden: Den här funktionen säkerställer omedelbar kännedom om problem när de uppstår. Den är avgörande för att snabbt begränsa problem och förhindra att mindre problem utvecklas till större driftstörningar.
- Omfattande instrumentpaneler: Instrumentpaneler ger en samlad vy över alla mätvärden och loggar. De är avgörande för att visualisera tillståndet i utvecklingspipeline och applikationernas hälsa, vilket gör det enklare att identifiera trender och potentiella problem.
- Anpassningsbara mätvärden: Anpassningsalternativ för övervakning av specifika mätvärden. Genom att anpassa mätvärden efter specifika behov blir övervakningen mer fokuserad, vilket säkerställer att team kan följa de prestandaindikatorer som är mest relevanta för deras projekt.
- Logghantering och analys: Effektiv logghantering och analytiska funktioner. Analys av loggar hjälper till att diagnostisera problem och förstå applikationernas beteende, vilket är viktigt för felsökning och optimering.
- Skalbarhet: Möjligheten att skala övervakningslösningar i takt med att projekten växer. Skalbarhet säkerställer att övervakningsverktyget kan hantera ökade belastningar och förhindrar försämrad prestanda över tid.
- Integrationsmöjligheter: Möjligheten att integrera med ett brett utbud av API-övervakningsverktyg och plattformar. Den här funktionen möjliggör smidigt samarbete mellan verktygen som används i utvecklingspipeline och förbättrar effektiviteten i arbetsflödet samt datakonsekvensen.
- Säkerhets- och efterlevnadsfunktioner: Inbyggda säkerhetsåtgärder och rapportering av regelefterlevnad. Dessa funktioner bidrar till att skydda känsliga data och säkerställa att utvecklingspipeline uppfyller regulatoriska krav.
- Automatiserad incidenthantering: Automatisering av incidenthanteringsprocessen. Genom att hantera incidenter automatiskt kan team minska driftstopp och förbättra svarstiderna, vilket leder till mer tillförlitliga applikationer.
- Stöd för molnbaserade miljöer: Optimerat för övervakning av molnbaserade miljöer. Eftersom många applikationer numera hostas i molnet säkerställer inbyggt stöd att övervakningen är effektiv i dessa miljöer.
- Helhetsinsyn från början till slut: Möjligheten att övervaka varje del av utvecklingspipeline. Den här funktionen ger en heltäckande bild av pipeline, från kodincheckningar till driftsättning, vilket är avgörande för att förstå effekten av ändringar och identifiera flaskhalsar.
Fördelar
Övervakningsverktyg spelar en viktig roll i DevOps-ekosystemet. De hjälper inte bara till att snabbt identifiera och lösa problem, utan ger också insikter som kan leda till mer välgrundade beslut och förbättrad övergripande prestanda. Här är några mer specifika fördelar med dessa verktyg för ditt DevOps-team:
- Förbättrad operativ effektivitet: DevOps-övervakningsverktyg automatiserar spårning och analys av olika mätvärden och loggar i hela utvecklingspipeline. Den här automatiseringen frigör värdefull tid för teamen och gör att de kan fokusera på mer strategiska uppgifter i stället för manuell övervakning och felsökning.
- Förbättrad systemtillförlitlighet: Genom att tillhandahålla realtidsaviseringar och meddelanden gör dessa verktyg det möjligt för team att snabbt upptäcka och åtgärda problem innan de utvecklas till mer omfattande problem. Denna förmåga att reagera omedelbart minskar driftstopp avsevärt och säkerställer att systemen förblir stabila och tillförlitliga.
- Proaktiv problemlösning: Användningen av prediktiv analys och avvikelsedetektering hjälper organisationer att förutse problem innan de uppstår. Genom att identifiera potentiella problem i förväg kan team implementera korrigeringar proaktivt, förhindra störningar och upprätthålla en smidig drift.
- Optimerad prestanda: DevOps-verktyg för databaser ger insikter i applikationers och infrastrukturs prestanda och identifierar flaskhalsar och förbättringsområden. Denna information gör det möjligt för team att optimera sina system för bättre prestanda, vilket förbättrar användarupplevelsen och den operativa effektiviteten.
- Förstärkt säkerhetsnivå: Med funktioner som fokuserar på övervakning av säkerhetsmätvärden och efterlevnadsstandarder spelar dessa verktyg en avgörande roll för att identifiera sårbarheter och säkerställa att systemen följer bästa praxis för säkerhet. Den förstärkta säkerhetsnivån skyddar mot intrång och upprätthåller integriteten hos organisationens data och system.
Kostnader & priser
Med en mängd olika abonnemangsalternativ tillgängliga kan en förståelse av priserna och funktionerna i varje alternativ hjälpa programvaruköpare att fatta ett välgrundat beslut som överensstämmer med deras behov och budget. Från kostnadsfria versioner utformade för mindre projekt till planer på företagsnivå med avancerade funktioner finns det övervakningsverktyg för verksamheter av alla storlekar.
Jämförelsetabell för DevOps-övervakningsverktyg
Nedan följer en detaljerad genomgång av vanliga abonnemangsalternativ och priser för DevOps-övervakningsverktyg, avsedd att hjälpa dem som är nya inom denna programvarukategori att navigera bland sina val.
| Plantyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| PlantypGratis | Genomsnittligt pris$0 | Vanliga funktionerGrundläggande övervakningsfunktioner, begränsade mätvärden och loggar, communitysupport, tillgång till forum |
| PlantypGrundläggande | Genomsnittligt pris$20-$50/användare/månad | Vanliga funktionerFörbättrade övervakningsfunktioner, fler mätvärden och loggar, e-postsupport, integration med andra verktyg |
| PlantypStandard | Genomsnittligt pris$50-$100/användare/månad | Vanliga funktionerFullständig övervakningssvit, avancerad analys, support dygnet runt, anpassningsbara instrumentpaneler, integrationsalternativ |
| PlantypPremium | Genomsnittligt pris$100-$200/användare/månad | Vanliga funktionerPremiumfunktioner inklusive prediktiv analys, maskininlärningsfunktioner, dedikerad support, anpassade integrationer |
| PlantypFöretag | Genomsnittligt prisAnpassad prissättning | Vanliga funktionerAlla premiumfunktioner samt skalbarhetsalternativ, dedikerad kundansvarig, säkerhet på företagsnivå |
Vanliga frågor om DevOps-övervakningsverktyg
Här är några svar på vanliga frågor om DevOps-övervakningsverktyg: