

Gerir um pipeline de DevOps não é tarefa fácil. Entre garantir a estabilidade em produção, acompanhar os estrangulamentos de desempenho e evitar períodos de inatividade, a pressão para manter tudo a funcionar sem problemas pode ser avassaladora. Talvez já tenha enfrentado atrasos frustrantes causados por problemas não detetados ou tido dificuldades com ferramentas que não se integram perfeitamente nos seus fluxos de trabalho. A realidade é que, sem as ferramentas de monitorização de DevOps certas, manter a eficiência e proporcionar uma excelente experiência ao utilizador torna-se uma batalha difícil.
As ferramentas de monitorização de DevOps foram concebidas para lhe dar visibilidade sobre os seus sistemas, ajudando-o a identificar e resolver potenciais problemas antes de estes afetarem os seus utilizadores. São essenciais para manter operações fluidas, otimizar o desempenho e garantir que a sua equipa se pode concentrar na inovação em vez de estar constantemente a resolver problemas. Ao longo dos anos, trabalhei com inúmeras soluções de monitorização em grandes projetos e com equipas diversificadas. Neste guia, partilharei as minhas principais recomendações e perspetivas para o ajudar a escolher a ferramenta perfeita para otimizar os seus processos e manter os seus sistemas a funcionar com o máximo desempenho.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Tabela comparativa das ferramentas de monitorização de DevOps
A tabela abaixo compara os detalhes de preços das minhas principais escolhas de ferramentas de monitorização de DevOps.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Best for hybrid infrastructure monitoring | Free plan + 30-day free trial available | From $200/month (billed annually) | Website | |
| 2 | Best for monitoring alongside cloud operations | Free demo available | From $3,500/month | Website | |
| 3 | Best for real user monitoring | Free plan + 30-day trial + demo available | From $10/month | Website | |
| 4 | Best for multi-cloud monitoring | Free plan + 30-day trial available | From $395/year (billed annually) | Website | |
| 5 | Best for real-time infrastructure insights | 14-day free trial + free plan + free demo available | From $4.50/node/month (billed annually) | Website | |
| 6 | Best for SSL certificate monitoring | Free plan + free demo available | From $8/10 monitors/month (billed annually) | Website | |
| 7 | Best for end-to-end performance monitoring for large businesses | 15-day free trial | From $7/month | Website | |
| 8 | Best for monitoring server disruptions and outages | 14-day free trial + free plan + free demo available | From $21/user/month | Website | |
| 9 | Best for continuous monitoring of large port networks | 30-day free trial | From $2,595 one-time | Website | |
| 10 | Best for performance monitoring for websites and mobile | 30-day free trial | From $6/vCPU/month (billed annually) | Website |


Avaliações das melhores ferramentas de monitorização de DevOps
Eis uma análise das principais ferramentas de monitorização de DevOps. Destacarei as funcionalidades oferecidas por cada ferramenta e explicarei por que merecem um lugar nesta lista.
 Best for hybrid infrastructure monitoring
- Free plan + 30-day free trial available
- From $200/month (billed annually)
Visit WebsiteCustomer Rating:4.6/5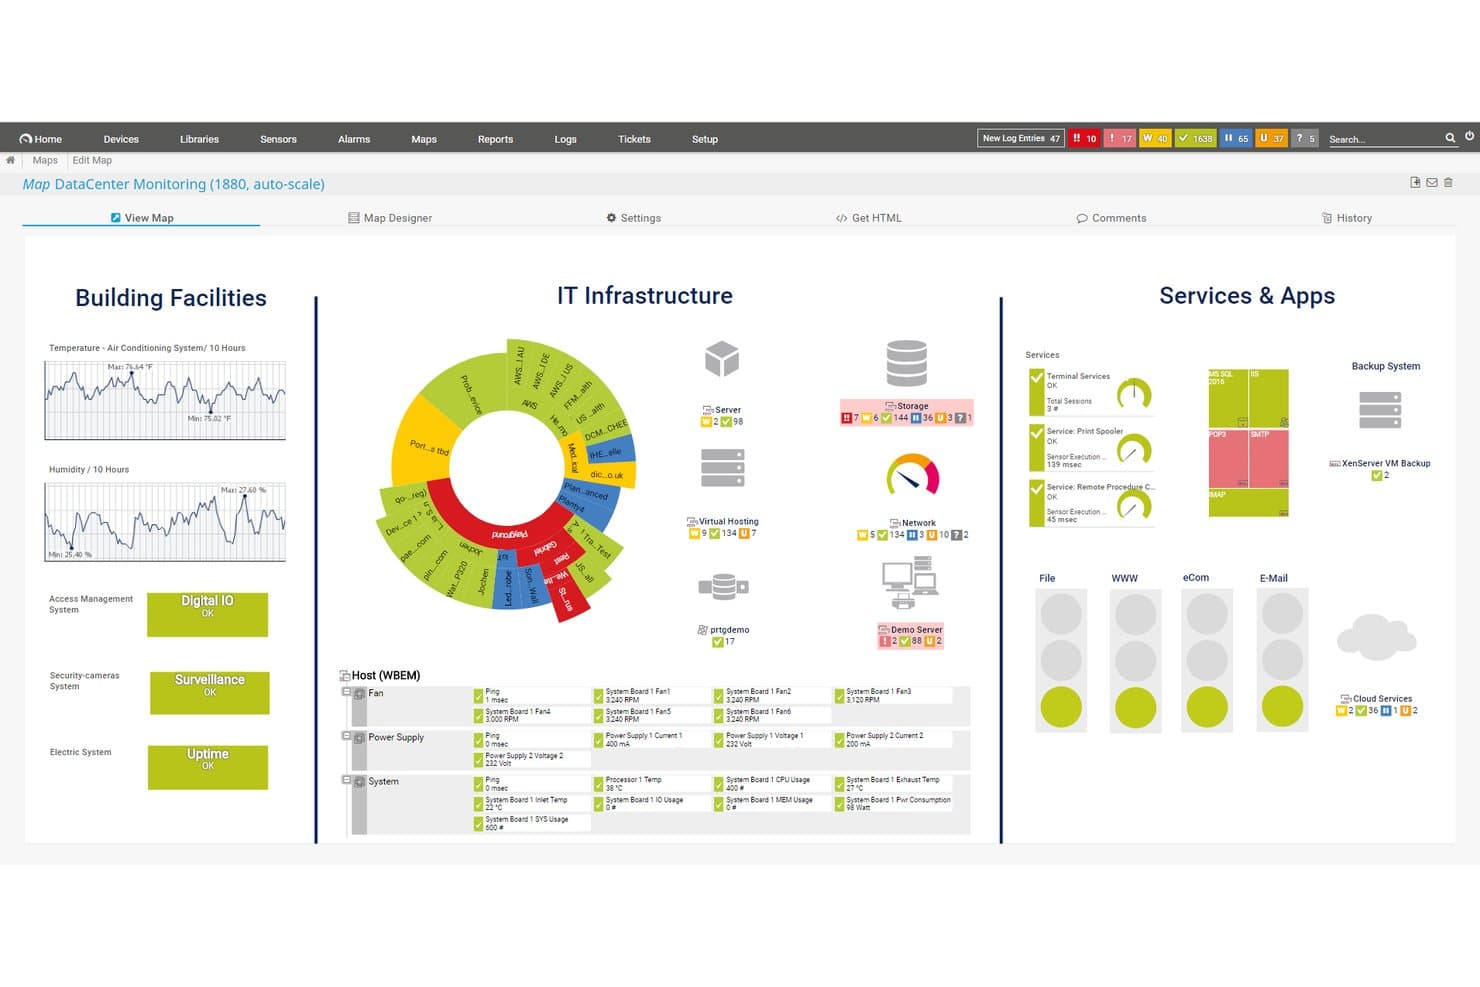
Paessler PRTG offers a data center monitoring map displaying building facilities, IT infrastructure, and services and apps in a single unified dashboard. Paessler PRTG is an agentless IT infrastructure monitoring platform that tracks network devices, servers, applications, databases, and cloud resources through a sensor-based system with customizable dashboards and real-time alerts.
Who Is Paessler PRTG Best For?
IT operations teams in mid-size to enterprise organizations that need centralized visibility across on-premises networks, servers, and hybrid infrastructure.
Why I Picked Paessler PRTG
I picked Paessler PRTG as one of the best because its sensor-based architecture lets me pull metrics from network devices, servers, applications, and cloud resources into a single platform. I like how the PRTG map designer lets me build real-time custom dashboards that reflect my actual infrastructure layout, not a generic template. The remote probe setup extends that coverage across multiple sites without spinning up separate monitoring tools.
Paessler PRTG Key Features
- Sensor-based monitoring: Lets you track a range of device types, services, and protocols by assigning individual sensors to specific metrics.
- REST custom sensors: Allows pulling data from third-party APIs or custom applications through HTTP requests.
- Distributed monitoring with remote probes: Supports monitoring geographically dispersed infrastructure from a single console.
- Audit logging and single sign-on: Enables user activity tracking and streamlined access management for compliance in larger organizations.
Paessler PRTG Integrations
Paessler PRTG offers native integrations with Amazon CloudWatch, Microsoft Azure, VMware vSphere, and Slack, and provides an API for custom integrations.
Pros and Cons
Pros:
- Auto-discovery maps your entire network automatically
- Strong on-premises and hybrid deployment support
- Customizable sensors across infrastructure layers
Cons:
- UI feels dated compared to modern alternatives
- Limited native container and Kubernetes monitoring
Learn more about Paessler PRTG: Best for monitoring alongside cloud operations
- Free demo available
- From $3,500/month
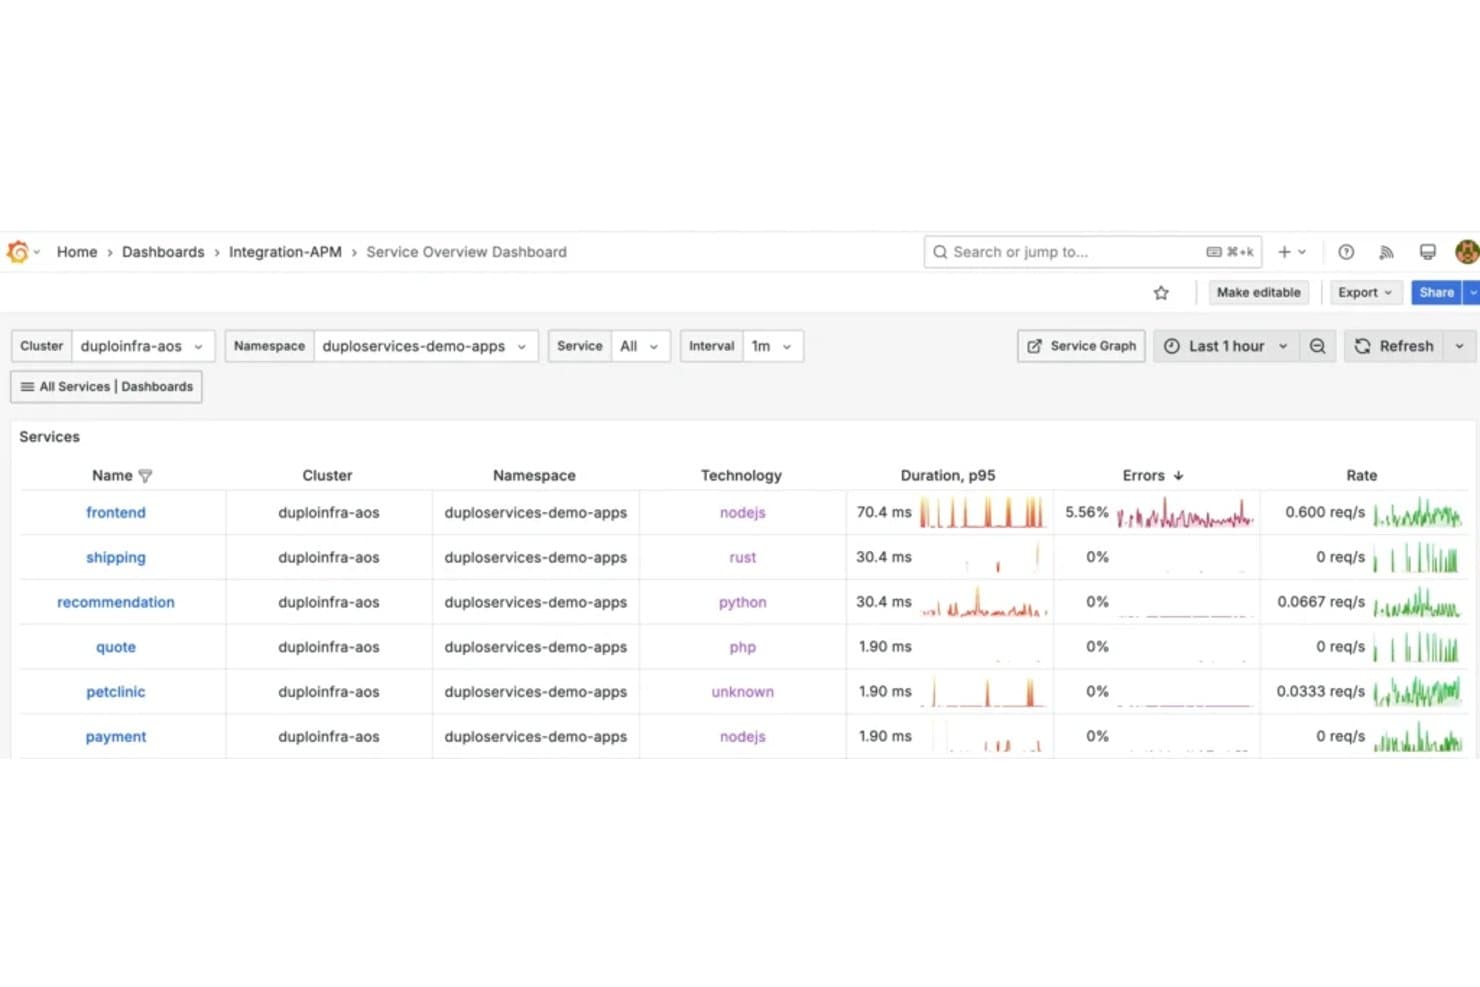
DuploCloud tracks service health, error rates, and latency in one view. DuploCloud is an AI-powered DevOps platform that bundles cloud infrastructure automation with an integrated observability suite covering metrics, logs, traces, and alerting across AWS, Azure, and GCP environments.
Who Is DuploCloud Best For?
DuploCloud suits DevOps engineers and SREs who want observability built into the same platform they use to provision and manage cloud infrastructure.
Why I Picked DuploCloud
DuploCloud earns its spot on my shortlist because it's the only platform where I can provision cloud infrastructure and monitor it in the same place. I love that the Advanced Observability Suite layers Grafana dashboards, Loki-based log correlation, and OpenTelemetry traces directly onto the infrastructure I'm already managing, so when a deployment causes a spike in error rates, I can compare pre- and post-deployment metrics without switching tools. The service dependency mapping traces slow or failed transactions back to the exact service or infrastructure component causing the problem.
DuploCloud Key Features
- OpenTelemetry-based distributed tracing: Collects and correlates trace data across distributed services using the OpenTelemetry Operator with annotation-based auto-instrumentation for .NET, Java, Node.js, Python, and Go.
- Grafana Loki log aggregation: Captures logs with automatic Kubernetes metadata tagging, supporting live log streaming, time-range filtering, and direct navigation from a log entry to its associated trace.
- Anomaly detection alerting: Monitors key signals like error rates and latency in real time and triggers customizable threshold or anomaly-based alerts when metrics deviate from expected patterns.
- Tenant-scoped observability dashboards: Provides per-tenant Grafana dashboards showing cloud spend, Kubernetes metrics, logs, traces, and profiles in a single view.
DuploCloud Integrations
DuploCloud documents integrations with Prometheus, Grafana, OpenSearch, Datadog, Kubernetes, Terraform, AWS, Azure, and Google Cloud Platform. It supports CI/CD workflows through REST APIs, including Jenkins, GitHub Actions, Bitbucket, and Azure DevOps.
Pros and Cons
Pros:
- Tenant dashboards combine spend and service health
- Correlated telemetry speeds root-cause investigations
- Developer self-service reduces deployment bottlenecks
Cons:
- Unusual Kubernetes setups can require workarounds
- Standard monitoring lacks APM and broad alerting
Learn more about DuploCloud: Best for real user monitoring
- Free plan + 30-day trial + demo available
- From $10/month
Visit WebsiteCustomer Rating:4.7/5
Site24x7 offers customizable dashboards where DevOps teams can tailor their monitoring views according to their specific needs. Site24x7 is a cloud-based monitoring solution designed for DevOps and IT operations teams. It offers comprehensive monitoring capabilities for websites, servers, networks, applications, and cloud services. With Site24x7, you can gain real-time insights into your IT infrastructure's performance and health.
Why I Picked Site24x7: I like its application performance monitoring (APM) feature. This tool helps you identify and troubleshoot performance issues in your applications by providing detailed insights into transaction traces, database queries, and application components. Another valuable feature is real user monitoring (RUM). RUM allows you to track and analyze the experiences of actual users on your websites and web applications. By understanding how users interact with your services, you can make informed decisions to improve usability and performance.
Site24x7 Standout Features & Integrations
Features include synthetic web transaction monitoring, which lets you simulate user interactions to identify potential issues before they affect real users. Additionally, network monitoring provides visibility into the health of your network devices, helping you maintain reliability. Log management is another feature that enables you to collect and analyze logs from various sources, facilitating efficient troubleshooting and issue resolution.
Integrations include ServiceNow, PagerDuty, Jira, Microsoft Teams, Slack, Nagios, AWS, Azure, Google Cloud Platform, Docker, Jenkins, and Kubernetes.
Pros and Cons
Pros:
- Comprehensive monitoring for various systems
- Customizable dashboards and reports
- Offers real-time alerts across various channels
Cons:
- Complexity in initial setup for large environments
- Excessive alerts can be overwhelming for users
Learn more about Site24x7: Best for multi-cloud monitoring
- Free plan + 30-day trial available
- From $395/year (billed annually)
Visit WebsiteCustomer Rating:4.3/5
Robust application performance management platform with extensive monitoring capabilities and third-party integrations for improved IT oversight. ManageEngine Applications Manager is a comprehensive tool that offers multi-cloud monitoring, allowing users to monitor, manage, audit, and secure their multi-cloud and hybrid infrastructure. Its unique selling point lies in its ability to provide a unified solution for monitoring and managing multi-cloud environments, making it the best choice for businesses looking to streamline their multi-cloud monitoring efforts.
Why I Picked ManageEngine Applications Manager: ManageEngine Applications Manager excels by offering robust features that facilitate continuous monitoring, performance analysis, and troubleshooting across the entire DevOps pipeline. It supports a proactive approach to incident management, enables automation of routine checks, and provides detailed analytics to improve decision-making. Its ability to seamlessly integrate with various development, testing, and deployment tools makes it a valuable asset for DevOps teams aiming for high efficiency and minimal downtime.
ManageEngine Applications Manager Standout Features & Integrations
Features include extensive out-of-the-box support for monitoring more than 100 applications and servers, ranging from databases, web servers, application servers, and virtual servers, to cloud platforms, containers, and microservices architectures. Plus, ManageEngine Applications Manager incorporates advanced root cause analysis features powered by machine learning algorithms.
Integrations include Amazon Web Services (AWS), Microsoft Azure, Google Cloud Platform, Oracle Database, MySQL, Microsoft SQL Server, VMware, Docker, Apache Tomcat, and Redis.
Pros and Cons
Pros:
- Automated anomaly detection and alerting mechanisms
- Customizable dashboards and reports for insightful analytics
- Comprehensive monitoring capabilities across applications, servers, and cloud environments
Cons:
- The cost may be prohibitive for small to medium-sized enterprises
- Can be complex to set up and customize for specific needs
Learn more about ManageEngine Applications Manager: Best for real-time infrastructure insights
- 14-day free trial + free plan + free demo available
- From $4.50/node/month (billed annually)
Visit WebsiteCustomer Rating:4.8/5
Netdata provides fully automated dashboards that visualize every single metric. Netdata is an open-source monitoring and troubleshooting platform that offers high-resolution metrics, journal logs, and real-time visualizations for system monitoring. It aims to provide a cost-effective and user-friendly alternative to more expensive and complex platforms.
Why I Picked Netdata: I like that the platform emphasizes high-fidelity data and provides real-time visualizations, enabling users to monitor system performance and health with precision. It also simplifies and enhances the monitoring process for DevOps with features for collecting, storing, querying, visualizing, and alerting for a wide range of metrics. Netdata can be run on multiple nodes, and each instance of Netdata is capable of autonomous operation.
Netdata Standout Features & Integrations
Features include alerts to notify users of any issues detected within the system, automatic anomaly detection, and automated and customizable dashboards. Additionally, the core of the Netdata ecosystem is open-source, and it includes all the monitoring features such as the database, query engine, scoring engine, health engine, and machine learning engine.
Integrations include Containers, Kubernetes Containers, Virtual Machines, Apache, Consul, Elasticsearch, OpenSearch, MySQL, Redis, Squid log files, Windows, macOS, and hundreds more.
Pros and Cons
Pros:
- Interactive graphs for data visualization
- Unlimited metric monitoring
- Automated alerts
Cons:
- Insights could be more comprehensive
- May come with a learning curve to maximize its features
Learn more about Netdata: Best for SSL certificate monitoring
- Free plan + free demo available
- From $8/10 monitors/month (billed annually)
Visit WebsiteCustomer Rating:4.7/5
UptimeRobot tracks SSL certificate status and uptime in one real-time dashboard. For DevOps teams seeking a dependable monitoring solution, UptimeRobot offers a practical option that supports SSL certificate monitoring alongside uptime checks. It suits teams of all sizes, from solo operators to larger organizations, that need visibility into service availability and endpoint performance. By helping teams detect issues such as certificate expirations, downtime, and slow response times, UptimeRobot supports stable operations and consistent service delivery.
Why I Picked UptimeRobot
I picked UptimeRobot for its SSL certificate monitoring, which helps DevOps teams avoid issues caused by expired or misconfigured certificates. It tracks certificate status and sends alerts before expirations occur, reducing the risk of access warnings or service interruptions. UptimeRobot also provides downtime alerts through integrations like Slack and PagerDuty, making it easier for teams to respond quickly and keep services reliable.
UptimeRobot Key Features
In addition to SSL certificate monitoring, UptimeRobot offers:
- Multi-location Checks: Monitor your services from multiple global locations to ensure worldwide accessibility.
- Response Time Monitoring: Track how quickly your server responds to provide insights into performance bottlenecks.
- Customizable Status Pages: Share real-time status updates with users through branded status pages.
- Incident Management: Efficiently manage and resolve incidents with customizable alerts and team access levels.
UptimeRobot Integrations
Integrations include Slack, PagerDuty, Microsoft Teams, Telegram, Discord, Splunk On-Call, and more, allowing seamless alert management across your preferred communication platforms.
Pros and Cons
Pros:
- Supports multiple alert channels
- SSL monitoring helps maintain website security efficiently
- Real-time alerts ensure quick response to downtime issues
Cons:
- Not suited for complex DevOps stacks
- Limited customization in notification settings compared to competitors
Learn more about UptimeRobot: Best for end-to-end performance monitoring for large businesses
- 15-day free trial
- From $7/month
Visit WebsiteCustomer Rating:4.5/5
Dynatrace enables monitoring of your entire stack's performance metrics through a single dashboard. Dynatrace is an application performance monitoring (APM) that uses a built-in AI solution to help DevOps teams pinpoint performance issues. It excels in monitoring multi-platform environments, including multi-cloud, containers, microservices, and user experience.
Why I picked Dynatrace: I picked Dynatrace for its in-depth performance monitoring, which is ideal for large businesses. It offers granular visibility into customers, hybrid environments, and all aspects of your infrastructure.
Dynatrace Standout Features & Integrations:
Features I liked were those that prioritize performance capabilities, such as infrastructure monitoring and application monitoring. Additionally, Dynatrace leverages AI to continuously search for performance issues and pinpoint the root cause.
Integrations that Dynatrace partners with include Akamas, GitLab, Gremlin, NeoLoad, LaunchDarkly, xMatters, JFrog, and PagerDuty using built-in integrations.
Pros and Cons
Pros:
- Very active help support desk which can answer any questions if stuck
- Broad observability scope, which hits down to the code level
- Leverages an AI assistant to enhance troubleshooting and help with problem resolution
Cons:
- Price makes it a downside for many small to mid-sized companies
- Learning curve for operating Dynatrace effectively
 Best for monitoring server disruptions and outages
- 14-day free trial + free plan + free demo available
- From $21/user/month
Visit WebsiteCustomer Rating:4.5/5
You can monitor and calculate API request failure percentages in PagerDuty. PagerDuty is an incident response platform that sends alerts when there's a service disruption or outage. During critical moments, it can send email notifications, SMS notifications, and phone notifications to your development team or customer base.
Why I picked PagerDuty: I picked PagerDuty because it's an excellent tool if you're running mission-critical infrastructure that you want to keep tabs on. The platform enables you to get on-call alert notifications immediately.
PagerDuty Standout Features & Integrations:
Features that stood out to me as the most useful are 100% focused on alerting teams in case systems, nodes, or application services go awry and include email alerts, mobile alerts, root cause analysis, real-time notifications, and prioritization. You can also automatically schedule and escalate issues.
Integrations include pre-built plugins AWS, ServiceNow, Salesforce, Zendesk, Atlassian, Datadog, Slack, Splunk, and more.
Pros and Cons
Pros:
- Filters notifications to prioritize high-profile alerts that indicate genuine threats while reducing false alarms
- Customizable alerts can be sent via email, phone, SMS, or push notifications
- Allows you to allocate incident response to the right person or team
Cons:
- Uses a conventional dashboard that could be more customizable for specific needs and preferences
- Looking for historical alerts can be difficult unless you have an exact ID
Learn more about PagerDuty: Best for continuous monitoring of large port networks
- 30-day free trial
- From $2,595 one-time
Visit WebsiteCustomer Rating:4.6/5
Here’s where you can monitor bandwidth and port status in Nagios. Nagios is an open-source software application that monitors traffic networks continuously. It can track per-port bandwidth usage for inbound and outbound traffic, detect network outages, identify overutilized ports, and discover network abusers.
Why I picked Nagios: Instead of exposing my systems to vulnerabilities or worrying about slow network performance, Nagios gives my DevOps team immediate visibility of our network. I also liked it that logs information like network infrastructure issues and failed processes by the port.
Nagios Standout Features & Integrations
Features offered by Nagios ensure the security of my network ports. This includes SNMP monitoring, switch and router monitoring, network monitoring, and ping monitoring, which help me maintain the integrity and safety of my network infrastructure.
Integrations that are pre-built include Amazon SNS, Prometheus, PagerDuty, Dynatrace, and more. Also, Nagios has over 3,000 official and community plugins developers can add to their stack.
Pros and Cons
Pros:
- Increases the availability of your entire network infrastructure for protocol failures and network outages
- Lightweight for minimal resource usage
- Open-source version is 100% free
Cons:
- Uses files instead of databases to store config files on the backend
- Separate licenses are required for security and network visibility features
Learn more about Nagios: Best for performance monitoring for websites and mobile
- 30-day free trial
- From $6/vCPU/month (billed annually)
Visit WebsiteCustomer Rating:4.3/5
AppDynamics can monitor historical payment details and provide user login ratio data. AppDynamics is a full-stack application performance management tool. It utilizes machine learning algorithms to detect performance issues, compares them to baseline metrics, and triggers alerts when necessary.
Why I picked AppDynamics: I picked AppDynamics because it focuses on application performance while also using monitoring to ensure optimal user experience. Whether you're managing a website or mobile app, AppDynamics ensures your customers don't encounter issues like timeouts or slow page load times.
AppDynamics Standout Features & Integrations:
Features I found that make AppDynamics excellent for performance monitoring include application performance monitoring (APM) and infrastructure visibility with database visibility. Additionally, end-user monitoring also caught my eye as it ensures your clients get the fastest application speeds possible.
Integrations that AppDynamics partners with include pre-built plugins like LoadRunner, Sainapse, and NeoLoad for performance and continuous delivery. AppDynamics also partners with SquaredUp, Medallia, and Quantum Metric to monitor customer experience.
Pros and Cons
Pros:
- Network visibility allows you to see the amount of bandwidth used per node
- Depth of monitoring of web applications and infrastructure is immense
- Gives real-time info on processes that consume CPU and memory
Cons:
- No automatic application scanning; they must be defined in a config file
- Functionality may be overwhelming for small businesses
Learn more about AppDynamics:
Outras ferramentas de monitorização de DevOps
Eis algumas outras ferramentas que não chegaram a entrar nas 12 primeiras, mas que vale certamente a pena conhecer:
- 11New RelicBest for SaaS full-stack observability
- 12SplunkBest for monitoring and searching through big data
- 13PrometheusBest for alerts and aggregating metrics
- 14Grafana CloudBest for monitoring data analytics and visualization
- 15BuddyBest for monitoring websites and mobile apps for small businesses
- 16InfluxDBBest for monitoring time series data in a single, multi-purpose database
- 17SensuBest for monitoring cloud environments
- 18ChaosSearchBest for centralizing log and event data in the cloud
- 19Dotcom MonitorBest for monitoring critical workflows
- 20DatadogDatadog
- 21ZabbixBest for network parameter monitoring
- 22IcingaBest for checking the availability of network resources
Avaliações de software e ferramentas relacionadas
Se ainda não encontrou aqui o que procura, consulte estes outros tipos de ferramentas que testámos e avaliámos.
- Software de monitorização de redes
- Software de monitorização de servidores
- Soluções SD-WAN
- Ferramentas de monitorização de infraestruturas
- Analisador de pacotes
- Ferramentas de monitorização de aplicações
How I Evaluate DevOps Monitoring Tools
I evaluate these tools in two layers: core requirements like metric ingestion, distributed tracing, and alert routing, then differentiators that determine fit for your stack and team.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. Then, I calculate the tool's total score into a percentage. Each tool needs to achieve a minimum total score of 75% to be considered for inclusion.
- Infrastructure & Application Monitoring: I evaluate whether a tool can track hosts, containers, databases, and application services in one place, like watching CPU spikes on Kubernetes nodes alongside API latency.
- Full-Stack Observability: Logs, metrics, and traces should be correlated across services so you can follow a slow request from a frontend error through microservice hops to the root cause.
- Real-Time Alerting & Incident Management: I check for configurable alert conditions, escalation policies, and routing to tools like PagerDuty or Slack so on-call engineers get notified through the right channel.
- CI/CD Pipeline Monitoring: Deployment tracking matters here. I look for visibility into build stages, failure rates, and the ability to correlate a bad deploy with a production incident.
- DevOps Toolchain Integrations: The tool should plug into your existing stack. I look for native connectors to Kubernetes, Terraform, Jenkins, GitHub, and major cloud providers.
- Anomaly Detection & Root Cause Analysis: I evaluate whether the tool goes beyond static thresholds. ML-based anomaly detection and event correlation help SREs cut through alert noise during outages.
Once I have a list of tools that meet this criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
SLO tracking is a major differentiator. I look for tools that let SRE teams define error budgets and monitor burn rates so reliability decisions stay data-driven rather than reactive. Synthetic monitoring also matters—simulating API calls or user flows from multiple regions catches latency problems before real users encounter them. RUM complements this by capturing actual browser and mobile performance, giving you a full picture of how a deployment impacts end-user experience.
Beyond Features
Pricing predictability is something I evaluate closely. Some tools bill per host while others charge by data volume, and log retention costs can spiral when you're ingesting terabytes from a large Kubernetes cluster. OpenTelemetry support is another factor I check, since adopting open standards protects your team from vendor lock-in if needs change. I also consider time-to-value: auto-instrumentation and prebuilt dashboards can mean the difference between going live in days versus spending weeks on manual setup.
Como escolher ferramentas de monitorização de DevOps
É fácil ficar atolado em listas extensas de funcionalidades e estruturas de preços complexas. Para o ajudar a manter o foco enquanto percorre o seu processo único de seleção de software, eis uma lista de verificação dos fatores a ter em conta:
| Fator | O que considerar |
|---|---|
| FatorEscalabilidade | O que considerarCertifique-se de que a ferramenta consegue lidar com o aumento das cargas de trabalho e com mais utilizadores sem perder desempenho. As opções baseadas na nuvem com escalabilidade automática podem ajudar a gerir o crescimento. |
| FatorIntegrações | O que considerarVerifique se a ferramenta se integra com a sua atual stack de DevOps, incluindo pipelines de CI/CD, serviços na nuvem e plataformas de resposta a incidentes. |
| FatorCapacidade de personalização | O que considerarProcure opções para ajustar as definições de monitorização, os limiares de alerta e os painéis de controlo de modo a corresponder aos fluxos de trabalho e às prioridades da sua equipa. |
| FatorFacilidade de utilização | O que considerarA ferramenta deve ter uma interface clara e controlos intuitivos para que a sua equipa possa identificar rapidamente os problemas e agir sobre eles. Configurações complicadas podem atrasar os tempos de resposta. |
| FatorOrçamento | O que considerarCompare os custos das subscrições, as taxas de licenciamento e os encargos adicionais relativos a funcionalidades avançadas ou a limites de dados superiores. Esteja atento a custos ocultos. |
| FatorMedidas de segurança | O que considerarProcure encriptação, controlos de acesso e transmissão segura de dados para proteger informações sensíveis e evitar violações. |
| FatorAlertas em tempo real | O que considerarA ferramenta deve fornecer alertas instantâneos relativos a problemas de desempenho ou interrupções, permitindo que a sua equipa aja rapidamente e minimize o tempo de inatividade. |
| FatorRetenção de dados e elaboração de relatórios | O que considerarCertifique-se de que a ferramenta armazena dados históricos durante tempo suficiente para permitir uma análise significativa e a identificação de tendências. Os relatórios exportáveis são úteis para as análises da equipa. |
Tendências nas ferramentas de monitorização de DevOps
Na minha investigação, recolhi inúmeras atualizações de produtos, comunicados de imprensa e registos de lançamentos de diferentes fornecedores de ferramentas de monitorização de DevOps. Eis algumas das tendências emergentes que tenho acompanhado:
Deteção de anomalias melhorada: Os novos modelos de aprendizagem automática estão a melhorar a deteção de anomalias, ajudando as equipas a identificar padrões irregulares em tempo real e a reduzir os falsos positivos.
Observabilidade de toda a pilha: Os fornecedores estão a ir além da monitorização básica para proporcionar uma visão completa da infraestrutura, das aplicações e da experiência do utilizador num único local. Isto facilita a identificação e a resolução de problemas. Ao avaliar plataformas de observabilidade, procure soluções que ofereçam capacidades de monitorização abrangentes.
Informações baseadas em IA: Um número cada vez maior de ferramentas utiliza IA para analisar dados e prever problemas de desempenho antes de estes ocorrerem. Isto ajuda as equipas a agir de forma proativa em vez de reagirem a falhas.
Rastreio distribuído: As ferramentas estão a adicionar capacidades de rastreio que permitem às equipas acompanhar pedidos em microsserviços e contentores. Isto ajuda a identificar exatamente onde estão a ocorrer atrasos ou falhas.
Sistemas de autocorreção: Algumas ferramentas oferecem agora correção automatizada, permitindo que o sistema detete um problema e o resolva sem intervenção humana. Isto reduz o tempo de inatividade e os tempos de resposta.
O que são as ferramentas de monitorização de DevOps?
As ferramentas de monitorização de DevOps são soluções de software especializadas concebidas para acompanhar e analisar o desempenho e o estado das aplicações e da infraestrutura em tempo real. Estas ferramentas são utilizadas principalmente por engenheiros de DevOps, administradores de sistemas e profissionais de TI para garantir o funcionamento e a disponibilização contínuos dos produtos de software.
As ferramentas de monitorização de DevOps ajudam a automatizar o processo de monitorização, fornecem informações sobre o desempenho do sistema e identificam e resolvem rapidamente os problemas antes de estes afetarem o ambiente de produção. Funcionalidades como alertas em tempo real, ferramentas de observabilidade de dados e análise preditiva apoiam a resolução proativa de problemas e melhoram a eficiência operacional.
Funcionalidades
Eis algumas das funcionalidades mais importantes que procuro nas ferramentas de monitorização de DevOps quando as avalio para a minha lista:
- Alertas e notificações em tempo real: Esta funcionalidade garante que os problemas sejam identificados imediatamente à medida que surgem. É essencial para resolver rapidamente os problemas, evitando que questões menores se transformem em interrupções graves.
- Painéis abrangentes: Os painéis oferecem uma visão unificada de todas as métricas e dos registos. São cruciais para visualizar o estado da cadeia de desenvolvimento e o estado das aplicações, facilitando a identificação de tendências e potenciais problemas.
- Métricas personalizáveis: Opções de personalização para monitorizar métricas específicas. Adaptar as métricas a necessidades específicas permite uma monitorização mais focada, garantindo que as equipas conseguem acompanhar os indicadores de desempenho mais relevantes para os seus projetos.
- Gestão e análise de registos: Gestão eficaz de registos e capacidades analíticas. A análise dos registos ajuda a diagnosticar problemas e a compreender o comportamento das aplicações, o que é essencial para a resolução de problemas e a otimização.
- Escalabilidade: A capacidade de aumentar a escala das soluções de monitorização à medida que os projetos crescem. A escalabilidade garante que a ferramenta de monitorização consegue lidar com cargas acrescidas, evitando a degradação do desempenho ao longo do tempo.
- Capacidades de integração: A capacidade de integração com uma vasta gama de ferramentas de monitorização de API e plataformas. Esta funcionalidade permite uma colaboração harmoniosa entre as ferramentas utilizadas na cadeia de desenvolvimento, melhorando a eficiência do fluxo de trabalho e a consistência dos dados.
- Funcionalidades de segurança e conformidade: Medidas de segurança integradas e relatórios de conformidade. Estas funcionalidades ajudam a proteger dados sensíveis e a garantir que a cadeia de desenvolvimento cumpre os requisitos regulamentares.
- Gestão automatizada de incidentes: Automatização do processo de resposta a incidentes. Ao gerir automaticamente os incidentes, as equipas podem reduzir o tempo de inatividade e melhorar os tempos de resposta, conduzindo a aplicações mais fiáveis.
- Suporte nativo da nuvem: Otimizado para monitorizar ambientes baseados na nuvem. Uma vez que muitas aplicações estão agora alojadas na nuvem, o suporte nativo garante que a monitorização é eficiente e eficaz nestes ambientes.
- Visibilidade de ponta a ponta: A capacidade de monitorizar todos os aspetos da cadeia de desenvolvimento. Esta funcionalidade proporciona uma visão holística da cadeia, desde as confirmações de código até à implementação, o que é crucial para compreender o impacto das alterações e identificar estrangulamentos.
Benefícios
As ferramentas de monitorização desempenham um papel fundamental no ecossistema DevOps. Não só ajudam a identificar e resolver problemas rapidamente, como também fornecem informações que podem conduzir a uma tomada de decisões mais fundamentada e a um melhor desempenho geral. Eis alguns benefícios mais específicos destas ferramentas para a sua equipa de DevOps:
- Maior eficiência operacional: As ferramentas de monitorização DevOps automatizam o acompanhamento e a análise de várias métricas e registos em toda a cadeia de desenvolvimento. Esta automatização liberta tempo valioso para as equipas, permitindo-lhes concentrarem-se em tarefas mais estratégicas em vez de realizarem monitorização e resolução de problemas manuais.
- Maior fiabilidade do sistema: Ao fornecerem alertas e notificações em tempo real, estas ferramentas permitem que as equipas detetem e resolvam prontamente os problemas antes de estes evoluírem para problemas mais significativos. Esta capacidade de resposta imediata reduz significativamente o tempo de inatividade e garante que os sistemas permanecem estáveis e fiáveis.
- Resolução proativa de problemas: A utilização de análise preditiva e deteção de anomalias ajuda as organizações a antecipar problemas antes de estes ocorrerem. Ao identificar antecipadamente potenciais problemas, as equipas podem implementar correções de forma proativa, evitando interrupções e mantendo operações sem problemas.
- Desempenho otimizado: As ferramentas DevOps de bases de dados fornecem informações sobre o desempenho das aplicações e da infraestrutura, identificando estrangulamentos e áreas de melhoria. Estas informações permitem que as equipas otimizem os seus sistemas para obterem um melhor desempenho, melhorando a experiência do utilizador e a eficiência operacional.
- Maior nível de segurança: Com funcionalidades centradas na monitorização de métricas de segurança e normas de conformidade, estas ferramentas desempenham um papel crucial na identificação de vulnerabilidades e na garantia de que os sistemas cumprem as melhores práticas de segurança. Este nível de segurança reforçado protege contra violações e mantém a integridade dos dados e sistemas da organização.
Custos e preços
Com uma variedade de opções de planos disponíveis, compreender os preços e as funcionalidades de cada um pode ajudar os compradores de software a tomar uma decisão informada, alinhada com as suas necessidades e orçamento. Desde versões gratuitas concebidas para projetos pequenos até planos de nível empresarial com funcionalidades avançadas, existem ferramentas de monitorização para todas as dimensões de operação.
Tabela de comparação de planos para ferramentas de monitorização DevOps
Abaixo encontra-se uma análise detalhada das opções de planos e dos preços habituais das ferramentas de monitorização DevOps, destinada a ajudar quem é novo nesta categoria de software a avaliar as suas opções.
| Tipo de plano | Preço médio | Funcionalidades comuns |
|---|---|---|
| Tipo de planoGratuito | Preço médio$0 | Funcionalidades comunsCapacidades básicas de monitorização, métricas e registos limitados, apoio da comunidade, acesso a fóruns |
| Tipo de planoBásico | Preço médio$20-$50/utilizador/mês | Funcionalidades comunsCapacidades de monitorização melhoradas, mais métricas e registos, apoio por e-mail, integração com outras ferramentas |
| Tipo de planoPadrão | Preço médio$50-$100/utilizador/mês | Funcionalidades comunsSuite completa de monitorização, análise avançada, apoio 24 horas por dia, 7 dias por semana, painéis personalizáveis, opções de integração |
| Tipo de planoPremium | Preço médio$100-$200/utilizador/mês | Funcionalidades comunsFuncionalidades premium, incluindo análise preditiva, capacidades de aprendizagem automática, apoio dedicado, integrações personalizadas |
| Tipo de planoEmpresarial | Preço médioPreço personalizado | Funcionalidades comunsTodas as funcionalidades Premium, além de opções de escalabilidade, gestor de conta dedicado, segurança de nível empresarial |
Perguntas frequentes sobre ferramentas de monitorização de DevOps
Eis algumas respostas a perguntas comuns sobre ferramentas de monitorização de DevOps: