

Zarządzanie potokiem DevOps nie jest prostym zadaniem. Dbanie o stabilność środowiska produkcyjnego, śledzenie wąskich gardeł wydajności i zapobieganie przestojom może powodować ogromną presję, aby wszystko działało bez zakłóceń. Być może doświadczyłeś frustrujących opóźnień spowodowanych niewykrytymi problemami albo miałeś trudności z narzędziami, które nie integrują się bezproblemowo z Twoimi procesami pracy. Rzeczywistość jest taka, że bez odpowiednich narzędzi do monitorowania DevOps utrzymanie wydajności i zapewnienie doskonałych doświadczeń użytkowników staje się nieustanną walką.
Narzędzia do monitorowania DevOps zapewniają wgląd w działanie systemów, pomagając identyfikować i rozwiązywać potencjalne problemy, zanim wpłyną one na użytkowników. Są niezbędne do utrzymania płynnego działania, optymalizacji wydajności i zapewnienia zespołowi możliwości skupienia się na innowacjach zamiast na gaszeniu pożarów. Na przestrzeni lat pracowałem z licznymi rozwiązaniami do monitorowania przy realizacji dużych projektów i współpracy z różnorodnymi zespołami. W tym przewodniku przedstawię moje najważniejsze rekomendacje i spostrzeżenia, które pomogą Ci wybrać idealne narzędzie do usprawnienia procesów i utrzymania systemów na najwyższym poziomie wydajności.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Tabela porównawcza narzędzi do monitorowania DevOps
Poniższa tabela porównuje szczegóły cenowe moich najlepszych propozycji narzędzi do monitorowania DevOps.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Najlepsze rozwiązanie do monitorowania infrastruktury hybrydowej | 30-dniowy bezpłatny okres próbny + dostępny bezpłatny plan | Od $200/miesiąc (rozliczane rocznie) | Website | |
| 2 | Najlepsze rozwiązanie do monitorowania rzeczywistych użytkowników | 30-dniowy bezpłatny okres próbny + dostępne bezpłatne demo | Od $10/miesiąc (rozliczane rocznie) | Website | |
| 3 | Najlepsze do monitorowania środowisk wielochmurowych | 30-dniowy bezpłatny okres próbny + bezpłatne demo + bezpłatny plan dostępny | Od $199/rok | Website | |
| 4 | Najlepsze rozwiązanie do uzyskiwania informacji o infrastrukturze w czasie rzeczywistym | 14-dniowy bezpłatny okres próbny + bezpłatny plan + dostępne bezpłatne demo | Od $4.50/węzeł/miesiąc (rozliczane rocznie) | Website | |
| 5 | Najlepsze rozwiązanie do monitorowania certyfikatów SSL | Dostępny bezpłatny plan i bezpłatna wersja demonstracyjna | Od $8/10 monitorów/miesiąc (rozliczenie roczne) | Website | |
| 6 | Najlepsze rozwiązanie do kompleksowego monitorowania wydajności w dużych firmach | 15-dniowy bezpłatny okres próbny | Od $0.08/8 GB/godz. | Website | |
| 7 | Najlepsze rozwiązanie do monitorowania zakłóceń i awarii serwerów | 14-dniowy bezpłatny okres próbny | Od 21 USD/użytkownika/miesiąc | Website | |
| 8 | Najlepsze rozwiązanie do ciągłego monitorowania dużych sieci portów | 30-dniowy bezpłatny okres próbny | Od $1,995/użytkownika | Website | |
| 9 | Najlepsze do monitorowania wydajności stron internetowych i aplikacji mobilnych | 15-dniowy bezpłatny okres próbny | Od $6/rdzeń/miesiąc | Website | |
| 10 | Najlepsze do pełnostosowej obserwowalności aplikacji SaaS | Dostępny bezpłatny plan | Od $49/użytkownika/miesiąc | Website |


Recenzje najlepszych narzędzi do monitorowania DevOps
Oto przegląd najlepszych narzędzi do monitorowania DevOps. Przedstawię funkcje oferowane przez każde narzędzie oraz wyjaśnię, dlaczego zasługują one na miejsce na tej liście.
 Najlepsze rozwiązanie do monitorowania infrastruktury hybrydowej
- 30-dniowy bezpłatny okres próbny + dostępny bezpłatny plan
- Od $200/miesiąc (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.6/5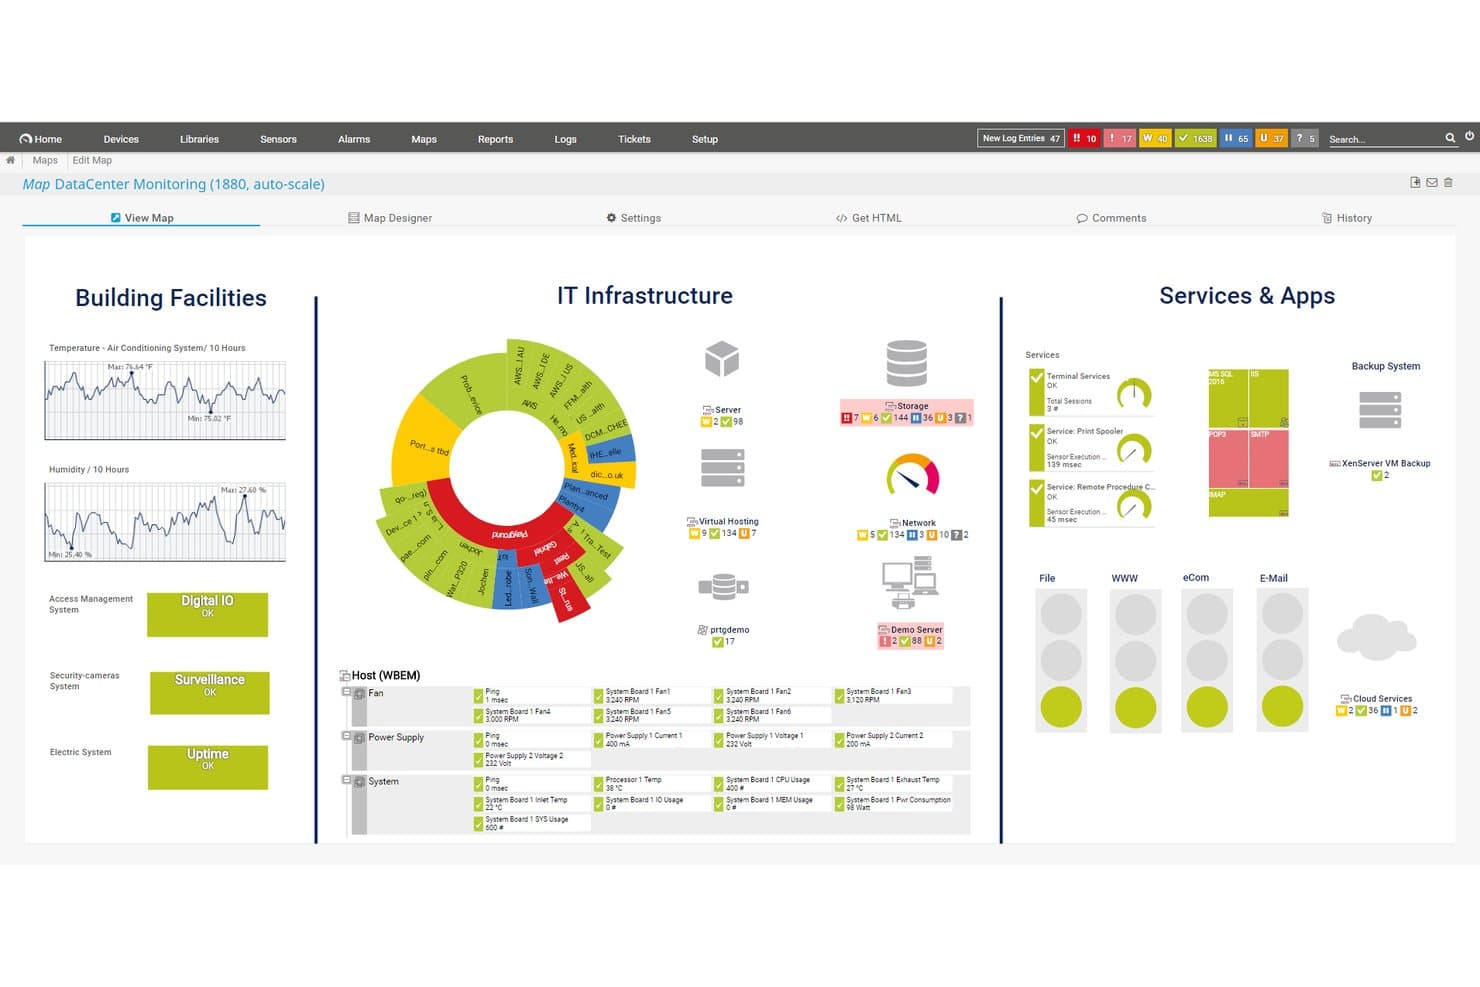
Paessler PRTG oferuje mapę monitorowania centrum danych, wyświetlającą obiekty budynku, infrastrukturę IT oraz usługi i aplikacje na jednym zunifikowanym pulpicie nawigacyjnym. Paessler PRTG to bezagentowa platforma do monitorowania infrastruktury IT, która śledzi urządzenia sieciowe, serwery, aplikacje, bazy danych i zasoby chmurowe za pomocą systemu opartego na czujnikach, z konfigurowalnymi pulpitami nawigacyjnymi i alertami w czasie rzeczywistym.
Dla kogo Paessler PRTG jest najlepszym wyborem?
Zespoły ds. operacji IT w średnich i dużych organizacjach, które potrzebują scentralizowanego wglądu w sieci lokalne, serwery i infrastrukturę hybrydową.
Dlaczego wybrałem Paessler PRTG
Wybrałem Paessler PRTG jako jedno z najlepszych rozwiązań, ponieważ jego architektura oparta na czujnikach pozwala mi pobierać metryki z urządzeń sieciowych, serwerów, aplikacji i zasobów chmurowych w ramach jednej platformy. Podoba mi się, że projektant map PRTG pozwala tworzyć niestandardowe pulpity nawigacyjne w czasie rzeczywistym, które odzwierciedlają rzeczywisty układ mojej infrastruktury, a nie ogólny szablon. Konfiguracja zdalnych sond rozszerza ten zakres na wiele lokalizacji bez konieczności wdrażania oddzielnych narzędzi do monitorowania.
Najważniejsze funkcje Paessler PRTG
- Monitorowanie oparte na czujnikach: Umożliwia śledzenie różnych typów urządzeń, usług i protokołów poprzez przypisywanie poszczególnych czujników do konkretnych metryk.
- Niestandardowe czujniki REST: Umożliwiają pobieranie danych z interfejsów API innych firm lub niestandardowych aplikacji za pośrednictwem żądań HTTP.
- Rozproszone monitorowanie za pomocą zdalnych sond: Umożliwia monitorowanie geograficznie rozproszonej infrastruktury z jednej konsoli.
- Rejestrowanie audytu i jednokrotne logowanie: Umożliwia śledzenie aktywności użytkowników i usprawnia zarządzanie dostępem na potrzeby zgodności w większych organizacjach.
Integracje Paessler PRTG
Paessler PRTG oferuje natywne integracje z Amazon CloudWatch, Microsoft Azure, VMware vSphere i Slack, a także udostępnia interfejs API do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Konfigurowalne czujniki w różnych warstwach infrastruktury
- Rozbudowana obsługa wdrożeń lokalnych i hybrydowych
- Automatyczne wykrywanie automatycznie mapuje całą sieć
Cons:
- Ograniczone natywne monitorowanie kontenerów i Kubernetes
- Interfejs użytkownika wydaje się przestarzały w porównaniu z nowoczesnymi alternatywami
Learn more about Paessler PRTG: Najlepsze rozwiązanie do monitorowania rzeczywistych użytkowników
- 30-dniowy bezpłatny okres próbny + dostępne bezpłatne demo
- Od $10/miesiąc (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.7/5
Site24x7 oferuje konfigurowalne pulpity, dzięki którym zespoły DevOps mogą dostosować widoki monitorowania do swoich konkretnych potrzeb. Site24x7 to oparte na chmurze rozwiązanie do monitorowania, przeznaczone dla zespołów DevOps i operacji IT. Oferuje kompleksowe możliwości monitorowania stron internetowych, serwerów, sieci, aplikacji i usług w chmurze. Dzięki Site24x7 możesz uzyskać wgląd w czasie rzeczywistym w wydajność i stan swojej infrastruktury IT.
Dlaczego wybrałem Site24x7: Podoba mi się funkcja monitorowania wydajności aplikacji (APM). To narzędzie pomaga identyfikować i rozwiązywać problemy z wydajnością aplikacji, zapewniając szczegółowy wgląd w ślady transakcji, zapytania do baz danych i komponenty aplikacji. Kolejną wartościową funkcją jest monitorowanie rzeczywistych użytkowników (RUM). RUM umożliwia śledzenie i analizowanie doświadczeń rzeczywistych użytkowników korzystających z witryn internetowych i aplikacji webowych. Dzięki zrozumieniu sposobu, w jaki użytkownicy korzystają z usług, możesz podejmować świadome decyzje w celu poprawy użyteczności i wydajności.
Najważniejsze funkcje i integracje Site24x7
Funkcje obejmują syntetyczne monitorowanie transakcji internetowych, które pozwala symulować interakcje użytkowników w celu identyfikowania potencjalnych problemów, zanim wpłyną one na rzeczywistych użytkowników. Ponadto monitorowanie sieci zapewnia wgląd w stan urządzeń sieciowych, pomagając utrzymać niezawodność. Zarządzanie logami to kolejna funkcja, która umożliwia zbieranie i analizowanie logów z różnych źródeł, ułatwiając skuteczne rozwiązywanie problemów.
Integracje obejmują ServiceNow, PagerDuty, Jira, Microsoft Teams, Slack, Nagios, AWS, Azure, Google Cloud Platform, Docker, Jenkins i Kubernetes.
Pros and Cons
Pros:
- Oferuje alerty w czasie rzeczywistym za pośrednictwem różnych kanałów
- Konfigurowalne pulpity i raporty
- Kompleksowe monitorowanie różnych systemów
Cons:
- Nadmierna liczba alertów może być przytłaczająca dla użytkowników
- Złożoność początkowej konfiguracji w dużych środowiskach
Learn more about Site24x7: Najlepsze do monitorowania środowisk wielochmurowych
- 30-dniowy bezpłatny okres próbny + bezpłatne demo + bezpłatny plan dostępny
- Od $199/rok
Visit WebsiteCustomer Rating:4.3/5
Rozbudowana platforma do zarządzania wydajnością aplikacji z szerokimi możliwościami monitorowania i integracjami z rozwiązaniami innych firm, zapewniająca lepszy nadzór nad środowiskiem IT. ManageEngine Applications Manager to kompleksowe narzędzie oferujące monitorowanie środowisk wielochmurowych, umożliwiające użytkownikom monitorowanie, zarządzanie, audytowanie i zabezpieczanie infrastruktury wielochmurowej oraz hybrydowej. Jego wyjątkową zaletą jest możliwość zapewnienia ujednoliconego rozwiązania do monitorowania i zarządzania środowiskami wielochmurowymi, co czyni je najlepszym wyborem dla firm, które chcą usprawnić swoje działania związane z monitorowaniem wielu chmur.
Dlaczego wybrałem ManageEngine Applications Manager: ManageEngine Applications Manager wyróżnia się rozbudowanymi funkcjami umożliwiającymi ciągłe monitorowanie, analizę wydajności i rozwiązywanie problemów w całym potoku DevOps. Narzędzie wspiera proaktywne podejście do zarządzania incydentami, umożliwia automatyzację rutynowych kontroli oraz zapewnia szczegółowe analizy usprawniające podejmowanie decyzji. Możliwość płynnej integracji z różnymi narzędziami do tworzenia, testowania i wdrażania oprogramowania sprawia, że jest ono cennym rozwiązaniem dla zespołów DevOps dążących do wysokiej wydajności i minimalnych przestojów.
Najważniejsze funkcje i integracje ManageEngine Applications Manager
Funkcje obejmują szeroką obsługę monitorowania ponad 100 aplikacji i serwerów dostępną od razu po instalacji, od baz danych, serwerów internetowych, serwerów aplikacji i serwerów wirtualnych po platformy chmurowe, kontenery i architektury mikrousług. Ponadto ManageEngine Applications Manager zawiera zaawansowane funkcje analizy przyczyn źródłowych oparte na algorytmach uczenia maszynowego.
Integracje obejmują Amazon Web Services (AWS), Microsoft Azure, Google Cloud Platform, Oracle Database, MySQL, Microsoft SQL Server, VMware, Docker, Apache Tomcat i Redis.
Pros and Cons
Pros:
- Kompleksowe możliwości monitorowania aplikacji, serwerów i środowisk chmurowych
- Konfigurowalne pulpity nawigacyjne i raporty zapewniające wnikliwe analizy
- Automatyczne wykrywanie anomalii i mechanizmy powiadamiania
Cons:
- Konfiguracja i dostosowanie do konkretnych potrzeb może być skomplikowane
- Koszt może być zbyt wysoki dla małych i średnich przedsiębiorstw
Learn more about ManageEngine Applications Manager: Najlepsze rozwiązanie do uzyskiwania informacji o infrastrukturze w czasie rzeczywistym
- 14-dniowy bezpłatny okres próbny + bezpłatny plan + dostępne bezpłatne demo
- Od $4.50/węzeł/miesiąc (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.8/5
Netdata udostępnia w pełni automatyczne pulpity nawigacyjne, które wizualizują każdą pojedynczą metrykę. Netdata to otwartoźródłowa platforma do monitorowania i rozwiązywania problemów, która oferuje wysokorozdzielcze metryki, dzienniki systemowe i wizualizacje w czasie rzeczywistym na potrzeby monitorowania systemów. Jej celem jest zapewnienie opłacalnej i przyjaznej dla użytkownika alternatywy dla droższych i bardziej złożonych platform.
Dlaczego wybrałem Netdata: Podoba mi się, że platforma kładzie nacisk na dane o wysokiej dokładności i zapewnia wizualizacje w czasie rzeczywistym, umożliwiając użytkownikom precyzyjne monitorowanie wydajności i kondycji systemu. Upraszcza również proces monitorowania dla zespołów DevOps i usprawnia go dzięki funkcjom gromadzenia, przechowywania, wyszukiwania, wizualizowania i generowania alertów dla szerokiego zakresu metryk. Netdata może działać na wielu węzłach, a każda jej instancja jest zdolna do autonomicznego działania.
Najważniejsze funkcje i integracje Netdata
Funkcje obejmują alerty powiadamiające użytkowników o wszelkich problemach wykrytych w systemie, automatyczne wykrywanie anomalii oraz automatyczne i konfigurowalne pulpity nawigacyjne. Ponadto rdzeń ekosystemu Netdata jest otwartoźródłowy i obejmuje wszystkie funkcje monitorowania, takie jak baza danych, silnik zapytań, silnik oceniania, silnik kondycji oraz silnik uczenia maszynowego.
Integracje obejmują kontenery, kontenery Kubernetes, maszyny wirtualne, Apache, Consul, Elasticsearch, OpenSearch, MySQL, Redis, pliki dzienników Squid, Windows, macOS i setki innych.
Pros and Cons
Pros:
- Automatyczne alerty
- Monitorowanie nieograniczonej liczby metryk
- Interaktywne wykresy do wizualizacji danych
Cons:
- Pełne wykorzystanie funkcji może wymagać nauki
- Informacje mogą być bardziej kompleksowe
Learn more about Netdata: Najlepsze rozwiązanie do monitorowania certyfikatów SSL
- Dostępny bezpłatny plan i bezpłatna wersja demonstracyjna
- Od $8/10 monitorów/miesiąc (rozliczenie roczne)
Visit WebsiteCustomer Rating:4.7/5
UptimeRobot śledzi stan certyfikatów SSL i dostępność w jednym pulpicie nawigacyjnym działającym w czasie rzeczywistym. Dla zespołów DevOps poszukujących niezawodnego rozwiązania do monitorowania UptimeRobot oferuje praktyczną opcję, która obsługuje monitorowanie certyfikatów SSL oraz sprawdzanie dostępności. Rozwiązanie to odpowiada zespołom każdej wielkości — od pojedynczych operatorów po większe organizacje — które potrzebują wglądu w dostępność usług i wydajność punktów końcowych. Pomagając zespołom wykrywać problemy, takie jak wygaśnięcie certyfikatów, przestoje i długi czas odpowiedzi, UptimeRobot wspiera stabilne działanie i niezawodne świadczenie usług.
Dlaczego wybrałem UptimeRobot
Wybrałem UptimeRobot ze względu na monitorowanie certyfikatów SSL, które pomaga zespołom DevOps unikać problemów powodowanych przez wygasłe lub nieprawidłowo skonfigurowane certyfikaty. Narzędzie śledzi stan certyfikatów i wysyła alerty przed ich wygaśnięciem, zmniejszając ryzyko ostrzeżeń o problemach z dostępem lub przerw w działaniu usług. UptimeRobot zapewnia również alerty o przestojach za pośrednictwem integracji takich jak Slack i PagerDuty, ułatwiając zespołom szybką reakcję i utrzymanie niezawodności usług.
Najważniejsze funkcje UptimeRobot
Oprócz monitorowania certyfikatów SSL UptimeRobot oferuje:
- Sprawdzanie z wielu lokalizacji: Monitoruj swoje usługi z wielu lokalizacji na całym świecie, aby zapewnić ich dostępność na całym globie.
- Monitorowanie czasu odpowiedzi: Śledź szybkość odpowiedzi serwera, aby uzyskać informacje o wąskich gardłach wydajności.
- Konfigurowalne strony stanu: Udostępniaj użytkownikom informacje o stanie w czasie rzeczywistym za pośrednictwem stron stanu oznaczonych marką.
- Zarządzanie incydentami: Sprawnie zarządzaj incydentami i rozwiązuj je dzięki konfigurowalnym alertom oraz poziomom dostępu zespołu.
Integracje UptimeRobot
Integracje obejmują Slack, PagerDuty, Microsoft Teams, Telegram, Discord, Splunk On-Call i inne narzędzia, umożliwiając płynne zarządzanie alertami za pośrednictwem preferowanych platform komunikacyjnych.
Pros and Cons
Pros:
- Alerty w czasie rzeczywistym zapewniają szybką reakcję na problemy z przestojami
- Monitorowanie SSL pomaga skutecznie utrzymywać bezpieczeństwo witryny
- Obsługuje wiele kanałów alertów
Cons:
- Ograniczone możliwości dostosowywania ustawień powiadomień w porównaniu z konkurencją
- Nie jest odpowiedni dla złożonych stosów DevOps
Learn more about UptimeRobot: Najlepsze rozwiązanie do kompleksowego monitorowania wydajności w dużych firmach
- 15-dniowy bezpłatny okres próbny
- Od $0.08/8 GB/godz.
Visit WebsiteCustomer Rating:4.5/5
Dynatrace umożliwia monitorowanie wskaźników wydajności całego stosu za pośrednictwem jednego pulpitu nawigacyjnego. Dynatrace to system monitorowania wydajności aplikacji (APM), który wykorzystuje wbudowane rozwiązanie AI, aby pomagać zespołom DevOps w identyfikowaniu problemów z wydajnością. Doskonale sprawdza się w monitorowaniu środowisk wieloplatformowych, w tym środowisk wielochmurowych, kontenerów, mikrousług i doświadczeń użytkowników.
Dlaczego wybrałem Dynatrace: Wybrałem Dynatrace ze względu na szczegółowe monitorowanie wydajności, które idealnie sprawdza się w dużych firmach. Oferuje ono szczegółowy wgląd w dane klientów, środowiska hybrydowe i wszystkie aspekty infrastruktury.
Najważniejsze funkcje i integracje Dynatrace:
Funkcje, które mi się spodobały, to te, które stawiają na możliwości związane z wydajnością, takie jak monitorowanie infrastruktury i aplikacji. Ponadto Dynatrace wykorzystuje AI do ciągłego wyszukiwania problemów z wydajnością i wskazywania ich przyczyny źródłowej.
Integracje, z którymi współpracuje Dynatrace, obejmują Akamas, GitLab, Gremlin, NeoLoad, LaunchDarkly, xMatters, JFrog i PagerDuty za pośrednictwem wbudowanych integracji.
Pros and Cons
Pros:
- Wykorzystuje asystenta AI, aby usprawnić rozwiązywanie problemów i pomagać w ich usuwaniu
- Szeroki zakres obserwowalności sięgający poziomu kodu
- Bardzo aktywne centrum pomocy, które może odpowiedzieć na wszelkie pytania w przypadku problemów
Cons:
- Krzywa uczenia się związana z efektywną obsługą Dynatrace
- Cena sprawia, że rozwiązanie jest niekorzystne dla wielu małych i średnich firm
 Najlepsze rozwiązanie do monitorowania zakłóceń i awarii serwerów
- 14-dniowy bezpłatny okres próbny
- Od 21 USD/użytkownika/miesiąc
Visit WebsiteCustomer Rating:4.5/5
W PagerDuty możesz monitorować i obliczać odsetek nieudanych żądań API. PagerDuty to platforma reagowania na incydenty, która wysyła alerty w przypadku zakłócenia lub awarii usługi. W krytycznych momentach może wysyłać powiadomienia e-mail, SMS oraz telefoniczne do zespołu programistycznego lub bazy klientów.
Dlaczego wybrałem PagerDuty: Wybrałem PagerDuty, ponieważ jest to doskonałe narzędzie, jeśli korzystasz z infrastruktury o znaczeniu krytycznym, którą chcesz stale monitorować. Platforma umożliwia natychmiastowe otrzymywanie powiadomień o alertach dyżuru.
Najważniejsze funkcje i integracje PagerDuty:
Funkcje, które wydały mi się najbardziej przydatne, koncentrują się w 100% na powiadamianiu zespołów w przypadku awarii systemów, węzłów lub usług aplikacji i obejmują alerty e-mail, alerty mobilne, analizę przyczyn źródłowych, powiadomienia w czasie rzeczywistym oraz ustalanie priorytetów. Możesz także automatycznie planować i eskalować problemy.
Integracje obejmują gotowe wtyczki do AWS, ServiceNow, Salesforce, Zendesk, Atlassian, Datadog, Slack, Splunk i innych usług.
Pros and Cons
Pros:
- Umożliwia przypisanie reagowania na incydent właściwej osobie lub zespołowi
- Konfigurowalne alerty mogą być wysyłane e-mailem, telefonicznie, SMS-em lub jako powiadomienia push
- Filtruje powiadomienia, aby nadać priorytet alertom o wysokim znaczeniu, które wskazują na rzeczywiste zagrożenia, jednocześnie ograniczając liczbę fałszywych alarmów
Cons:
- Wyszukiwanie historycznych alertów może być trudne, chyba że znasz ich dokładny identyfikator
- Korzysta z konwencjonalnego pulpitu, który mógłby oferować więcej możliwości dostosowania do konkretnych potrzeb i preferencji
Learn more about PagerDuty: Najlepsze rozwiązanie do ciągłego monitorowania dużych sieci portów
- 30-dniowy bezpłatny okres próbny
- Od $1,995/użytkownika
Visit WebsiteCustomer Rating:4.6/5
W tym miejscu można monitorować przepustowość i stan portów w Nagios. Nagios to aplikacja typu open source, która w sposób ciągły monitoruje ruch sieciowy. Może śledzić wykorzystanie przepustowości każdego portu dla ruchu przychodzącego i wychodzącego, wykrywać awarie sieci, identyfikować przeciążone porty oraz wykrywać użytkowników nadużywających zasobów sieciowych.
Dlaczego wybrałem Nagios: Zamiast narażać moje systemy na luki w zabezpieczeniach lub martwić się o niską wydajność sieci, Nagios zapewnia mojemu zespołowi DevOps natychmiastowy wgląd w stan sieci. Podobało mi się również to, że rejestruje informacje o problemach infrastruktury sieciowej i nieudanych procesach na portach.
Najważniejsze funkcje i integracje Nagios
Funkcje oferowane przez Nagios zapewniają bezpieczeństwo portów mojej sieci. Obejmują one monitorowanie SNMP, monitorowanie przełączników i routerów, monitorowanie sieci oraz monitorowanie za pomocą polecenia ping, co pomaga mi utrzymać integralność i bezpieczeństwo infrastruktury sieciowej.
Integracje dostępne od razu obejmują Amazon SNS, Prometheus, PagerDuty, Dynatrace i wiele innych. Ponadto Nagios oferuje ponad 3000 oficjalnych wtyczek oraz wtyczek społecznościowych, które deweloperzy mogą dodać do swojego stosu technologicznego.
Pros and Cons
Pros:
- Wersja z otwartym kodem źródłowym jest w 100% bezpłatna
- Niewielkie zużycie zasobów
- Zwiększa dostępność całej infrastruktury sieciowej w przypadku awarii protokołów i przestojów sieci
Cons:
- Funkcje związane z bezpieczeństwem i widocznością sieci wymagają osobnych licencji
- Wykorzystuje pliki zamiast baz danych do przechowywania plików konfiguracyjnych na zapleczu
Learn more about Nagios: Najlepsze do monitorowania wydajności stron internetowych i aplikacji mobilnych
- 15-dniowy bezpłatny okres próbny
- Od $6/rdzeń/miesiąc
Visit WebsiteCustomer Rating:4.3/5
AppDynamics może monitorować historyczne dane dotyczące płatności i dostarczać dane o współczynniku logowania użytkowników. AppDynamics to kompleksowe narzędzie do zarządzania wydajnością aplikacji. Wykorzystuje algorytmy uczenia maszynowego do wykrywania problemów z wydajnością, porównuje je z wartościami bazowymi i w razie potrzeby uruchamia alerty.
Dlaczego wybrałem AppDynamics: Wybrałem AppDynamics, ponieważ koncentruje się na wydajności aplikacji, a jednocześnie wykorzystuje monitorowanie, aby zapewnić optymalne doświadczenia użytkowników. Niezależnie od tego, czy zarządzasz stroną internetową, czy aplikacją mobilną, AppDynamics gwarantuje, że Twoi klienci nie napotkają problemów takich jak przekroczenia limitu czasu lub powolne ładowanie stron.
Najważniejsze funkcje i integracje AppDynamics:
Funkcje , które sprawiają, że AppDynamics doskonale nadaje się do monitorowania wydajności, obejmują monitorowanie wydajności aplikacji (APM) oraz widoczność infrastruktury wraz z widocznością baz danych. Zwróciło również moją uwagę monitorowanie użytkowników końcowych, ponieważ gwarantuje klientom możliwie najwyższą szybkość działania aplikacji.
Integracje , z którymi współpracuje AppDynamics, obejmują gotowe wtyczki, takie jak LoadRunner, Sainapse i NeoLoad, przeznaczone do monitorowania wydajności i ciągłego dostarczania. AppDynamics współpracuje również z SquaredUp, Medallia i Quantum Metric w celu monitorowania doświadczeń klientów.
Pros and Cons
Pros:
- Dostarcza informacji w czasie rzeczywistym o procesach zużywających procesor i pamięć
- Zakres monitorowania aplikacji internetowych i infrastruktury jest ogromny
- Widoczność sieci pozwala sprawdzić ilość przepustowości wykorzystywanej przez każdy węzeł
Cons:
- Funkcjonalność może być przytłaczająca dla małych firm
- Brak automatycznego skanowania aplikacji; należy je zdefiniować w pliku konfiguracyjnym
Learn more about AppDynamics: Najlepsze do pełnostosowej obserwowalności aplikacji SaaS
- Dostępny bezpłatny plan
- Od $49/użytkownika/miesiąc
Visit WebsiteCustomer Rating:4.3/5
W New Relic możesz monitorować każdą instancję swojej usługi. New Relic to narzędzie do monitorowania i analizy stron internetowych, które zapewnia obserwowalność w czasie rzeczywistym każdego komponentu aplikacji rozproszonej między bazami danych i serwerami.
Dlaczego wybrałem New Relic: Wybrałem New Relic, ponieważ zapewnia rozwiązanie 'wszystko w jednym', które monitoruje i analizuje wszystkie aspekty stosu technologicznego. Pełny wgląd od początku do końca pozwala zespołom uzyskiwać praktyczne informacje, gdy pojawiają się problemy, oraz szybko je rozwiązywać.
Najważniejsze funkcje i integracje New Relic:
Funkcje , które sprawiają, że New Relic świetnie nadaje się do monitorowania całego stosu, obejmują monitorowanie aplikacji i baz danych. Dostępne jest również monitorowanie dostępności, aby zapewnić prawidłowe działanie systemów w lokalizacjach publicznych lub prywatnych przez całą dobę.
Integracje są dostępne za pośrednictwem gotowych wtyczek, takich jak AWS, Kubernetes, Azure, Google Cloud Platform i Prometheus. Możesz także korzystać z natywnych integracji, takich jak SQL Server, aby wysyłać zapytania do New Relic.
Pros and Cons
Pros:
- Bardzo bogaty zestaw funkcji oraz możliwość pisania niestandardowych zapytań dotyczących zebranych danych telemetrycznych
- Zapewnia wgląd w metryki i wydajność nawet przy dużym obciążeniu i wysokim poziomie stresu
- Łatwa instalacja agenta, która pozwala przesyłać dane do pulpitu w ciągu kilku minut
Cons:
- Koszt można uznać za wysoki, szczególnie w przypadku startupów i nawet średnich firm
- Interfejs może być nieco skomplikowany ze względu na liczbę opcji wyświetlanych na ekranie
Learn more about New Relic:
Inne narzędzia do monitorowania DevOps
Oto kilka innych narzędzi, które nie znalazły się w pierwszej dwunastce, ale zdecydowanie warto się z nimi zapoznać:
- 11SplunkNajlepsze rozwiązanie do monitorowania dużych zbiorów danych i przeszukiwania ich
- 12PrometheusNajlepszy do alertów i agregowania metryk
- 13Grafana CloudNajlepsze rozwiązanie do monitorowania, analizy i wizualizacji danych
- 14BuddyNajlepsze rozwiązanie do monitorowania witryn internetowych i aplikacji mobilnych w małych firmach
- 15InfluxDBNajlepsze rozwiązanie do monitorowania danych szeregów czasowych w jednej, wielofunkcyjnej bazie danych
- 16SensuNajlepsze do monitorowania środowisk chmurowych
- 17ChaosSearchNajlepsze rozwiązanie do centralizowania danych dziennika i danych o zdarzeniach w chmurze
- 18Dotcom MonitorNajlepsze do monitorowania krytycznych przepływów pracy
Powiązane recenzje oprogramowania i narzędzi
Jeśli nadal nie znalazłeś tutaj tego, czego szukasz, sprawdź inne rodzaje narzędzi, które przetestowaliśmy i oceniliśmy.
- Oprogramowanie do monitorowania sieci
- Oprogramowanie do monitorowania serwerów
- Rozwiązania SD-WAN
- Narzędzia do monitorowania infrastruktury
- Analizator pakietów
- Narzędzia do monitorowania aplikacji
Jak oceniam narzędzia do monitorowania DevOps
Oceniam te narzędzia na dwóch poziomach: podstawowe wymagania, takie jak gromadzenie metryk, śledzenie rozproszone i kierowanie alertów, a następnie czynniki wyróżniające, które decydują o dopasowaniu do używanego stosu technologicznego i zespołu.
Podstawowa funkcjonalność (warunki konieczne na tej liście)
Wybierając narzędzia do mojej listy, oceniam każde z nich w skali od 0 (nie oferuje danej funkcjonalności) do 5 (wyróżnia się w tym obszarze) pod kątem każdej z wymienionych poniżej podstawowych funkcjonalności. Następnie przeliczam łączny wynik narzędzia na wartość procentową. Każde narzędzie musi uzyskać łączny wynik wynoszący co najmniej 75%, aby zostać uwzględnione na liście.
- Monitorowanie infrastruktury i aplikacji: Oceniam, czy narzędzie może śledzić hosty, kontenery, bazy danych i usługi aplikacyjne w jednym miejscu, na przykład obserwować skoki użycia procesora na węzłach Kubernetes jednocześnie z opóźnieniami interfejsu API.
- Obserwowalność całego stosu: Dzienniki, metryki i ślady powinny być korelowane między usługami, aby można było prześledzić powolne żądanie od błędu w interfejsie użytkownika przez kolejne przejścia między mikrousługami aż do przyczyny źródłowej.
- Alerty w czasie rzeczywistym i zarządzanie incydentami: Sprawdzam dostępność konfigurowalnych warunków alertów, zasad eskalacji oraz kierowania powiadomień do narzędzi takich jak PagerDuty lub Slack, aby inżynierowie pełniący dyżur otrzymywali powiadomienia odpowiednim kanałem.
- Monitorowanie potoków CI/CD: Śledzenie wdrożeń ma tu duże znaczenie. Szukam wglądu w etapy kompilacji, wskaźniki niepowodzeń oraz możliwości powiązania nieudanego wdrożenia z incydentem produkcyjnym.
- Integracje z łańcuchem narzędzi DevOps: Narzędzie powinno współpracować z istniejącym stosem technologicznym. Szukam natywnych konektorów do Kubernetes, Terraform, Jenkins, GitHub i głównych dostawców chmury.
- Wykrywanie anomalii i analiza przyczyn źródłowych: Oceniam, czy narzędzie wykracza poza statyczne progi. Wykrywanie anomalii oparte na uczeniu maszynowym i korelacja zdarzeń pomagają zespołom SRE przebić się przez szum alertów podczas awarii.
Gdy mam już listę narzędzi spełniających te kryteria, analizuję, co wyróżnia każdą platformę.
Czynniki różnicujące (co wyróżnia dostawców)
Oto jak porównuję różnych dostawców:
Wyróżniające się funkcje
Śledzenie SLO jest ważnym czynnikiem różnicującym. Szukam narzędzi, które pozwalają zespołom SRE definiować budżety błędów i monitorować tempo ich wykorzystania, aby decyzje dotyczące niezawodności opierały się na danych, a nie na reakcjach. Znaczenie ma również monitorowanie syntetyczne — symulowanie wywołań interfejsu API lub ścieżek użytkownika z wielu regionów pozwala wykrywać problemy z opóźnieniami, zanim zetkną się z nimi prawdziwi użytkownicy. RUM uzupełnia ten proces, rejestrując rzeczywistą wydajność przeglądarek i urządzeń mobilnych, dzięki czemu można uzyskać pełny obraz wpływu wdrożenia na doświadczenia użytkowników końcowych.
Poza funkcjami
Uważnie oceniam przewidywalność cen. Niektóre narzędzia rozliczają się za hosta, podczas gdy inne pobierają opłaty zależne od ilości danych, a koszty przechowywania dzienników mogą gwałtownie wzrosnąć, gdy z dużego klastra Kubernetes gromadzone są terabajty danych. Kolejnym sprawdzanym przeze mnie czynnikiem jest obsługa OpenTelemetry, ponieważ stosowanie otwartych standardów chroni zespół przed uzależnieniem od dostawcy, jeśli potrzeby ulegną zmianie. Biorę również pod uwagę czas do uzyskania wartości: automatyczne oprzyrządowanie i gotowe pulpity mogą decydować o tym, czy uruchomienie nastąpi w ciągu kilku dni, czy też ręczna konfiguracja zajmie całe tygodnie.
Jak wybrać narzędzia do monitorowania DevOps
Łatwo zagubić się w długich listach funkcji i skomplikowanych strukturach cenowych. Aby pomóc Ci zachować koncentrację podczas przeprowadzania indywidualnego procesu wyboru oprogramowania, przygotowałem listę czynników, które warto wziąć pod uwagę:
| Czynnik | Co uwzględnić |
|---|---|
| CzynnikSkalowalność | Co uwzględnićUpewnij się, że narzędzie poradzi sobie ze zwiększającym się obciążeniem i większą liczbą użytkowników bez spadku wydajności. Rozwiązania oparte na chmurze z automatycznym skalowaniem mogą pomóc w zarządzaniu rozwojem. |
| CzynnikIntegracje | Co uwzględnićSprawdź, czy narzędzie integruje się z istniejącym stosem DevOps, w tym z potokami CI/CD, usługami chmurowymi i platformami reagowania na incydenty. |
| CzynnikMożliwość dostosowania | Co uwzględnićPoszukaj opcji dostosowania ustawień monitorowania, progów alertów i pulpitów do przepływów pracy oraz priorytetów zespołu. |
| CzynnikŁatwość obsługi | Co uwzględnićNarzędzie powinno mieć przejrzysty interfejs i intuicyjne elementy sterujące, aby zespół mógł szybko wykrywać problemy i reagować na nie. Skomplikowana konfiguracja może wydłużać czas reakcji. |
| CzynnikBudżet | Co uwzględnićPorównaj koszty subskrypcji, opłaty licencyjne i dodatkowe opłaty za zaawansowane funkcje lub zwiększone limity danych. Zwróć uwagę na ukryte koszty. |
| CzynnikZabezpieczenia | Co uwzględnićPoszukaj szyfrowania, kontroli dostępu i bezpiecznej transmisji danych, aby chronić poufne informacje i zapobiegać naruszeniom bezpieczeństwa. |
| CzynnikAlerty w czasie rzeczywistym | Co uwzględnićNarzędzie powinno zapewniać natychmiastowe alerty dotyczące problemów z wydajnością lub awarii, umożliwiając zespołowi szybką reakcję i minimalizowanie przestojów. |
| CzynnikPrzechowywanie danych i raportowanie | Co uwzględnićUpewnij się, że narzędzie przechowuje dane historyczne wystarczająco długo, aby umożliwić przeprowadzanie wartościowych analiz i identyfikowanie trendów. Raporty możliwe do eksportowania są przydatne podczas przeglądów zespołu. |
Trendy w narzędziach do monitorowania DevOps
W ramach badań zebrałem niezliczone aktualizacje produktów, informacje prasowe i dzienniki wydań od różnych dostawców narzędzi do monitorowania DevOps. Oto niektóre z pojawiających się trendów, które obserwuję:
Udoskonalone wykrywanie anomalii: Nowe modele uczenia maszynowego usprawniają wykrywanie anomalii, pomagając zespołom identyfikować nieregularne wzorce w czasie rzeczywistym i ograniczać liczbę fałszywych alarmów.
Obserwowalność całego stosu: Dostawcy wykraczają poza podstawowe monitorowanie, zapewniając w jednym miejscu pełny wgląd w infrastrukturę, aplikacje i doświadczenia użytkowników. Ułatwia to identyfikowanie i rozwiązywanie problemów. Podczas oceny platform do obserwowalności poszukaj rozwiązań oferujących kompleksowe możliwości monitorowania.
Wnioski oparte na sztucznej inteligencji: Coraz więcej narzędzi wykorzystuje sztuczną inteligencję do analizowania danych i przewidywania problemów z wydajnością, zanim one wystąpią. Pomaga to zespołom działać proaktywnie zamiast reagować na awarie.
Śledzenie rozproszone: Narzędzia dodają funkcje śledzenia, które umożliwiają zespołom monitorowanie żądań w mikrousługach i kontenerach. Pomaga to precyzyjnie określić, gdzie występują opóźnienia lub awarie.
Systemy samonaprawiające się: Niektóre narzędzia oferują obecnie automatyczne usuwanie problemów, dzięki czemu system może wykryć problem i naprawić go bez udziału człowieka. Ogranicza to przestoje i skraca czas reakcji.
Czym są narzędzia do monitorowania DevOps?
Narzędzia do monitorowania DevOps to wyspecjalizowane rozwiązania programowe przeznaczone do śledzenia i analizowania wydajności oraz kondycji aplikacji i infrastruktury w czasie rzeczywistym. Z narzędzi tych korzystają przede wszystkim inżynierowie DevOps, administratorzy systemów i specjaliści IT, aby zapewnić bezproblemowe działanie i dostarczanie produktów programowych.
Narzędzia do monitorowania DevOps pomagają automatyzować proces monitorowania, zapewniają wgląd w wydajność systemu oraz umożliwiają szybkie identyfikowanie i rozwiązywanie problemów, zanim wpłyną one na środowisko produkcyjne. Funkcje takie jak alerty w czasie rzeczywistym, narzędzia do obserwowalności danych i analityka predykcyjna wspierają proaktywne rozwiązywanie problemów oraz zwiększają efektywność operacyjną.
Funkcje
Oto niektóre z najważniejszych funkcji, których szukam w narzędziach do monitorowania DevOps podczas oceniania ich na potrzeby mojej listy:
- Alerty i powiadomienia w czasie rzeczywistym: Ta funkcja zapewnia natychmiastową świadomość problemów w momencie ich wystąpienia. Jest niezbędna do szybkiego ograniczania problemów i zapobiegania przekształcaniu się drobnych usterek w poważne awarie.
- Kompleksowe pulpity nawigacyjne: Pulpity nawigacyjne oferują ujednolicony widok wszystkich metryk i dzienników. Są kluczowe dla wizualizacji stanu potoku programistycznego i kondycji aplikacji, ułatwiając identyfikowanie trendów oraz potencjalnych problemów.
- Dostosowywalne metryki: Opcje dostosowywania monitorowania określonych metryk. Dopasowanie metryk do konkretnych potrzeb umożliwia bardziej ukierunkowane monitorowanie, zapewniając zespołom możliwość śledzenia wskaźników wydajności najistotniejszych dla ich projektów.
- Zarządzanie dziennikami i ich analiza: Skuteczne zarządzanie dziennikami i możliwości analityczne. Analizowanie dzienników pomaga diagnozować problemy i rozumieć zachowanie aplikacji, co ma kluczowe znaczenie dla rozwiązywania problemów i optymalizacji.
- Skalowalność: Możliwość skalowania rozwiązań monitorujących wraz z rozwojem projektów. Skalowalność gwarantuje, że narzędzie monitorujące poradzi sobie ze zwiększonym obciążeniem, zapobiegając pogorszeniu wydajności w czasie.
- Możliwości integracji: Możliwość integracji z szeroką gamą narzędzi do monitorowania interfejsów API i platform. Ta funkcja umożliwia płynną współpracę między narzędziami używanymi w potoku programistycznym, zwiększając efektywność przepływu pracy i spójność danych.
- Funkcje bezpieczeństwa i zgodności: Wbudowane środki bezpieczeństwa i raportowanie zgodności. Funkcje te pomagają chronić poufne dane i zapewniać, że potok programistyczny spełnia wymogi regulacyjne.
- Zautomatyzowane zarządzanie incydentami: Automatyzacja procesu reagowania na incydenty. Dzięki automatycznemu zarządzaniu incydentami zespoły mogą ograniczyć przestoje i skrócić czas reakcji, co prowadzi do większej niezawodności aplikacji.
- Obsługa środowisk natywnych dla chmury: Optymalizacja pod kątem monitorowania środowisk opartych na chmurze. Ponieważ wiele aplikacji jest obecnie hostowanych w chmurze, natywna obsługa gwarantuje, że monitorowanie w tych środowiskach będzie wydajne i skuteczne.
- Widoczność od początku do końca: Możliwość monitorowania każdego aspektu potoku programistycznego. Ta funkcja zapewnia całościowy widok potoku — od zatwierdzania zmian w kodzie po wdrożenie — co ma kluczowe znaczenie dla zrozumienia wpływu zmian i identyfikowania wąskich gardeł.
Korzyści
Narzędzia monitorujące odgrywają kluczową rolę w ekosystemie DevOps. Nie tylko pomagają szybko identyfikować i rozwiązywać problemy, ale także dostarczają informacji, które mogą prowadzić do podejmowania bardziej świadomych decyzji i poprawy ogólnej wydajności. Oto kilka dodatkowych, konkretnych korzyści, jakie te narzędzia zapewniają zespołowi DevOps:
- Zwiększona efektywność operacyjna: Narzędzia monitorujące DevOps automatyzują śledzenie i analizę różnych metryk oraz dzienników w całym potoku programistycznym. Automatyzacja ta uwalnia cenny czas zespołów, pozwalając im skupić się na bardziej strategicznych zadaniach zamiast na ręcznym monitorowaniu i rozwiązywaniu problemów.
- Większa niezawodność systemu: Dzięki alertom i powiadomieniom w czasie rzeczywistym narzędzia te umożliwiają zespołom szybkie wykrywanie problemów i reagowanie na nie, zanim przerodzą się w poważniejsze komplikacje. Możliwość natychmiastowego reagowania znacznie ogranicza przestoje i zapewnia stabilność oraz niezawodność systemów.
- Proaktywne rozwiązywanie problemów: Wykorzystanie analityki predykcyjnej i wykrywania anomalii pomaga organizacjom przewidywać problemy, zanim się pojawią. Dzięki wcześniejszemu identyfikowaniu potencjalnych problemów zespoły mogą proaktywnie wdrażać poprawki, zapobiegać zakłóceniom i utrzymywać płynne działanie.
- Zoptymalizowana wydajność: Narzędzia DevOps baz danych dostarczają informacji na temat wydajności aplikacji i infrastruktury, identyfikując wąskie gardła oraz obszary wymagające poprawy. Informacje te umożliwiają zespołom optymalizację systemów pod kątem lepszej wydajności, poprawiając komfort użytkowania i efektywność operacyjną.
- Wyższy poziom bezpieczeństwa: Dzięki funkcjom skoncentrowanym na monitorowaniu metryk bezpieczeństwa i standardów zgodności narzędzia te odgrywają kluczową rolę w identyfikowaniu luk w zabezpieczeniach i zapewnianiu zgodności systemów z najlepszymi praktykami bezpieczeństwa. Wyższy poziom bezpieczeństwa chroni przed naruszeniami i zachowuje integralność danych oraz systemów organizacji.
Koszty i ceny
Dzięki różnorodnym dostępnym opcjom planów zrozumienie cen i funkcji każdego z nich może pomóc nabywcom oprogramowania podjąć świadomą decyzję zgodną z ich potrzebami i budżetem. Od bezpłatnych wersji przeznaczonych do małych projektów po plany dla przedsiębiorstw z zaawansowanymi funkcjami — dostępne są narzędzia monitorujące dla każdej skali działalności.
Tabela porównawcza planów dla narzędzi monitorujących DevOps
Poniżej przedstawiono szczegółowe zestawienie typowych opcji planów i cen narzędzi monitorujących DevOps, które ma pomóc osobom nowym w tej kategorii oprogramowania w dokonaniu wyboru.
| Typ planu | Średnia cena | Typowe funkcje |
|---|---|---|
| Typ planuBezpłatny | Średnia cena$0 | Typowe funkcjePodstawowe możliwości monitorowania, ograniczone metryki i dzienniki, wsparcie społeczności, dostęp do forów |
| Typ planuPodstawowy | Średnia cena$20-$50/użytkownika/miesiąc | Typowe funkcjeRozszerzone możliwości monitorowania, więcej metryk i dzienników, wsparcie e-mail, integracja z innymi narzędziami |
| Typ planuStandardowy | Średnia cena$50-$100/użytkownika/miesiąc | Typowe funkcjePełny zestaw funkcji monitorowania, zaawansowana analityka, wsparcie 24/7, konfigurowalne pulpity nawigacyjne, opcje integracji |
| Typ planuPremium | Średnia cena$100-$200/użytkownika/miesiąc | Typowe funkcjeFunkcje premium, w tym analityka predykcyjna, możliwości uczenia maszynowego, dedykowane wsparcie, niestandardowe integracje |
| Typ planuKorporacyjny | Średnia cenaNiestandardowa cena | Typowe funkcjeWszystkie funkcje planu Premium oraz opcje skalowalności, dedykowany opiekun klienta, zabezpieczenia klasy korporacyjnej |
Najczęściej zadawane pytania dotyczące narzędzi monitorowania DevOps
Oto odpowiedzi na niektóre często zadawane pytania dotyczące narzędzi monitorowania DevOps: