

10 beste DevOps-monitoringtools beoordeeld voor 2026

10 Shortlist van de beste DevOps-monitoringtools


Het beheren van een DevOps-pijplijn is geen eenvoudige opgave. Tussen het waarborgen van stabiliteit in productie, het volgen van prestatieknelpunten en het voorkomen van downtime kan de druk om alles soepel te laten verlopen overweldigend aanvoelen. Misschien heb je frustrerende vertragingen ervaren door onopgemerkte problemen of geworsteld met tools die niet naadloos in je workflows integreren. De realiteit is dat het zonder de juiste DevOps-monitoringtools een zware opgave wordt om efficiënt te blijven werken en een geweldige gebruikerservaring te bieden.
DevOps-monitoringtools zijn ontworpen om je inzicht in je systemen te geven, zodat je potentiële problemen kunt identificeren en oplossen voordat ze gevolgen hebben voor je gebruikers. Ze zijn essentieel voor het handhaven van een soepele werking, het optimaliseren van prestaties en ervoor zorgen dat je team zich kan richten op innovatie in plaats van op het blussen van brandjes. In de loop der jaren heb ik met talloze monitoringoplossingen gewerkt binnen grote projecten en diverse teams. In deze gids deel ik mijn belangrijkste aanbevelingen en inzichten om je te helpen de perfecte tool te kiezen, je processen te stroomlijnen en je systemen optimaal te laten presteren.
Why Trust Our Software Reviews
We’ve been testing and reviewing software since 2023. As tech leaders ourselves, we know how critical and difficult it is to make the right decision when selecting software.
We invest in deep research to help our audience make better software purchasing decisions. We’ve tested more than 2,000 tools for different tech use cases and written over 1,000 comprehensive software reviews. Learn how we stay transparent & our software review methodology.
Overzicht van de beste DevOps-monitoringtools
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Het meest geschikt voor bewaking van hybride infrastructuur | 30 dagen gratis proefperiode + gratis abonnement beschikbaar | Vanaf $200/maand (jaarlijks gefactureerd) | Website | |
| 2 | Het beste voor het monitoren van echte gebruikers | Gratis proefperiode van 30 dagen + gratis demo beschikbaar | Vanaf $10/maand (jaarlijks gefactureerd) | Website | |
| 3 | Beste voor multicloudmonitoring | 30 dagen gratis proefperiode + gratis demo + gratis abonnement beschikbaar | Vanaf $199/jaar | Website | |
| 4 | Het beste voor realtime-inzichten in infrastructuur | 14 dagen gratis uitproberen + gratis abonnement + gratis demo beschikbaar | Vanaf $4.50/knooppunt/maand (jaarlijks gefactureerd) | Website | |
| 5 | Beste voor monitoring van SSL-certificaten | Gratis abonnement + gratis demo beschikbaar | Vanaf $8/10 monitors/maand (jaarlijks gefactureerd) | Website | |
| 6 | Het beste voor het bewaken van serverstoringen en uitval | 14 dagen gratis proefperiode | Vanaf $21/gebruiker/maand | Website | |
| 7 | Het beste voor continue monitoring van grote poortnetwerken | 30 dagen gratis uitproberen | Vanaf $1,995/gebruiker | Website | |
| 8 | Beste voor prestatiemonitoring van websites en mobiele apparaten | 15 dagen gratis uitproberen | Vanaf $6/kern/maand | Website | |
| 9 | Het beste voor SaaS-observeerbaarheid van de volledige technologiestack | Gratis abonnement beschikbaar | Vanaf $49/gebruiker/maand | Website | |
| 10 | Het beste voor het monitoren en doorzoeken van grote hoeveelheden gegevens | Gratis proefperiode van 60 dagen | Prijs op aanvraag | Website |
Beoordelingen van de beste DevOps-monitoringtools
Hier vind je een overzicht van de beste DevOps-monitoringtools. Ik bespreek de functies die elke tool biedt en waarom ze een plaats op deze lijst verdienen.
Het meest geschikt voor bewaking van hybride infrastructuur

Paessler PRTG is een agentloos IT-infrastructuurbewakingsplatform dat netwerkapparaten, servers, applicaties, databases en cloudbronnen volgt via een sensorgebaseerd systeem met aanpasbare dashboards en realtime waarschuwingen.
Voor wie is Paessler PRTG het meest geschikt?
IT-operatieteams in middelgrote tot grote organisaties die behoefte hebben aan gecentraliseerd inzicht in on-premises netwerken, servers en hybride infrastructuur.
Waarom ik voor Paessler PRTG heb gekozen
Ik heb Paessler PRTG gekozen als een van de beste oplossingen omdat de sensorgebaseerde architectuur mij in staat stelt om statistieken van netwerkapparaten, servers, applicaties en cloudbronnen naar één platform te halen. Ik vind het prettig dat ik met de PRTG-kaartontwerper realtime aangepaste dashboards kan maken die mijn werkelijke infrastructuurlay-out weerspiegelen, in plaats van een generiek sjabloon. De configuratie van externe probes breidt die dekking uit over meerdere locaties zonder afzonderlijke bewakingstools op te zetten.
Belangrijkste functies van Paessler PRTG
- Sensorgebaseerde bewaking: Hiermee kun je verschillende apparaattypen, services en protocollen volgen door afzonderlijke sensoren toe te wijzen aan specifieke statistieken.
- Aangepaste REST-sensoren: Hiermee kun je gegevens ophalen uit API's van derden of aangepaste applicaties via HTTP-verzoeken.
- Gedistribueerde bewaking met externe probes: Ondersteunt het bewaken van geografisch verspreide infrastructuur vanuit één console.
- Auditregistratie en eenmalige aanmelding: Maakt het volgen van gebruikersactiviteiten en gestroomlijnd toegangsbeheer mogelijk voor naleving van regelgeving in grotere organisaties.
Integraties van Paessler PRTG
Paessler PRTG biedt ingebouwde integraties met Amazon CloudWatch, Microsoft Azure, VMware vSphere en Slack, en biedt een API voor aangepaste integraties.
Pros and Cons
Pros:
- Aanpasbare sensoren voor verschillende infrastructuurlagen
- Sterke ondersteuning voor on-premises en hybride implementaties
- Automatische detectie brengt je volledige netwerk automatisch in kaart
Cons:
- Beperkte native bewaking van containers en Kubernetes
- De gebruikersinterface voelt verouderd aan in vergelijking met moderne alternatieven
New Product Updates from Paessler PRTG
PRTG Introduces New Monitoring Sensors In Beta
This week, PRTG introduces three BETA sensors that broaden your monitoring scope for Proxmox VE clusters and SIMATIC S7-300/400 PLCs, giving you deeper operational insights. For more information, visit PRTG’s official site.
 .

Site24x7
Het beste voor het monitoren van echte gebruikers

Site24x7 is een cloudgebaseerde monitoringoplossing die is ontworpen voor DevOps- en IT-operationsteams. Het biedt uitgebreide monitoringmogelijkheden voor websites, servers, netwerken, applicaties en clouddiensten. Met Site24x7 krijgt u realtime inzicht in de prestaties en gezondheid van uw IT-infrastructuur.
Waarom ik voor Site24x7 koos: Ik ben enthousiast over de functie voor het monitoren van applicatieprestaties (APM). Deze tool helpt u prestatieproblemen in uw applicaties te identificeren en op te lossen door gedetailleerde inzichten te bieden in transactietraceringen, databasequery's en applicatiecomponenten. Een andere waardevolle functie is het monitoren van echte gebruikers (RUM). Met RUM kunt u de ervaringen van echte gebruikers op uw websites en webapplicaties volgen en analyseren. Door te begrijpen hoe gebruikers met uw diensten omgaan, kunt u weloverwogen beslissingen nemen om de gebruiksvriendelijkheid en prestaties te verbeteren.
Belangrijkste functies en integraties van Site24x7
Functies omvatten synthetische monitoring van webtransacties, waarmee u gebruikersinteracties kunt simuleren om potentiële problemen te identificeren voordat deze gevolgen hebben voor echte gebruikers. Daarnaast biedt netwerkmonitoring inzicht in de status van uw netwerkapparaten, zodat u de betrouwbaarheid kunt handhaven. Logbeheer is een andere functie waarmee u logs uit verschillende bronnen kunt verzamelen en analyseren, wat efficiënte probleemoplossing en het oplossen van problemen mogelijk maakt.
Integraties omvatten ServiceNow, PagerDuty, Jira, Microsoft Teams, Slack, Nagios, AWS, Azure, Google Cloud Platform, Docker, Jenkins en Kubernetes.
Pros and Cons
Pros:
- Biedt realtime waarschuwingen via verschillende kanalen
- Aanpasbare dashboards en rapporten
- Uitgebreide monitoring voor verschillende systemen
Cons:
- Overmatige waarschuwingen kunnen gebruikers overweldigen
- Complexiteit bij de eerste configuratie voor grote omgevingen
New Product Updates from Site24x7
Site24x7 Adds Cloud Resources Dashboard and ECS Failure Alerts
Site24x7 introduces a Cloud Resources dashboard and new Amazon ECS failure alerts. These updates improve cloud visibility and help teams catch service issues earlier. For more information, visit Site24x7’s official site.
 .
Beste voor multicloudmonitoring
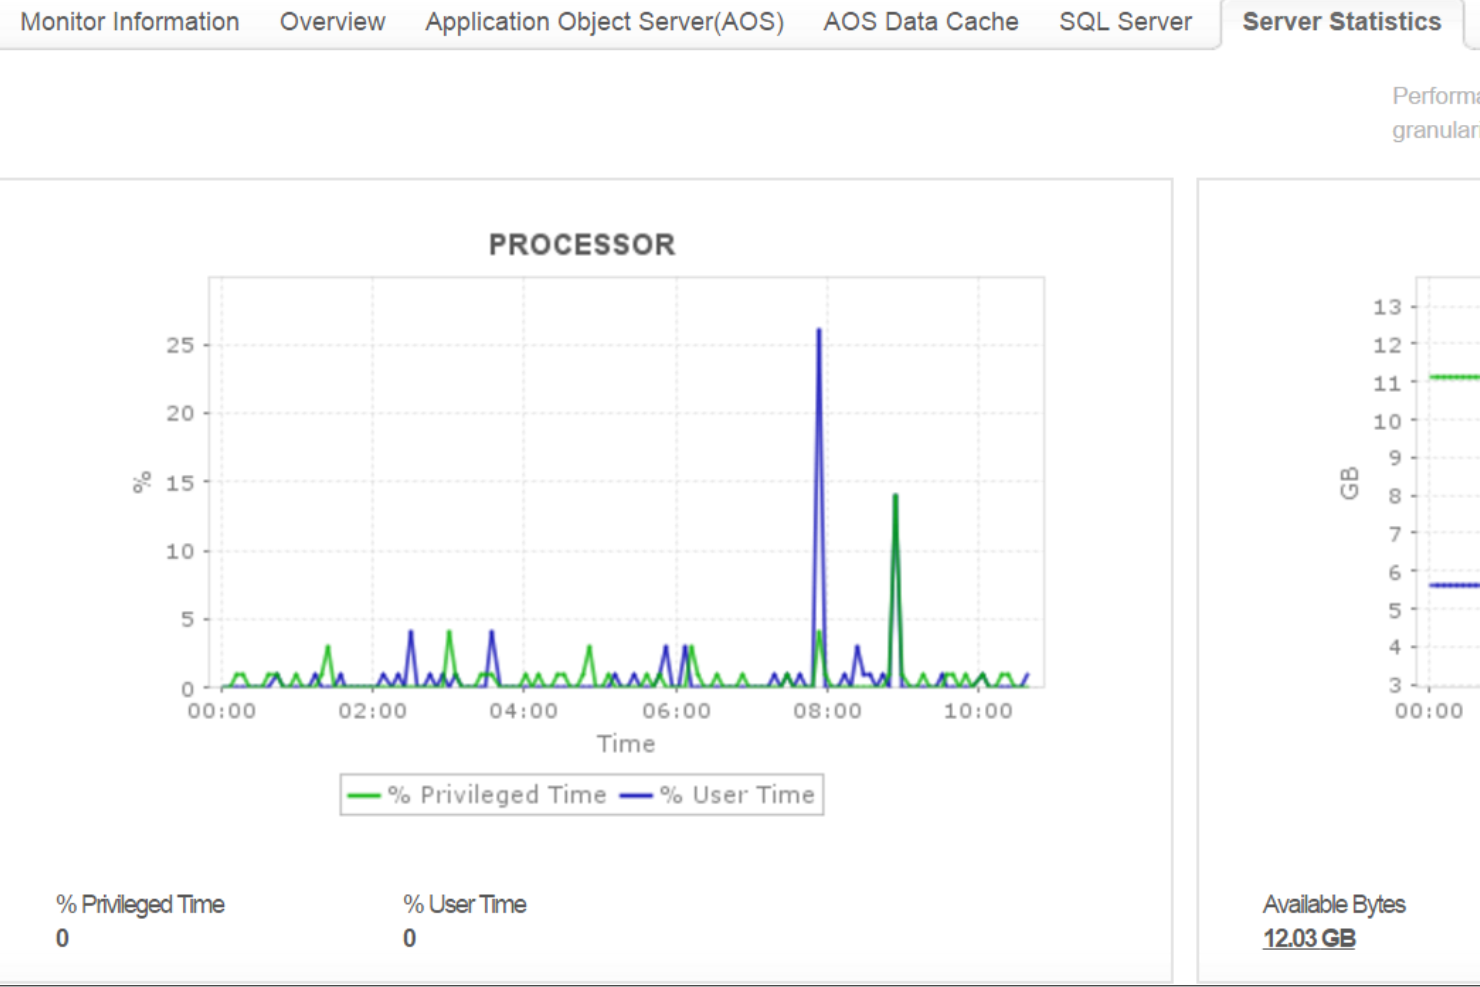
ManageEngine Applications Manager is een uitgebreide tool die multicloudmonitoring biedt, waarmee gebruikers hun multicloud- en hybride infrastructuur kunnen monitoren, beheren, auditen en beveiligen. Het unieke verkoopargument ligt in de mogelijkheid om een uniforme oplossing te bieden voor het monitoren en beheren van multicloudomgevingen, waardoor het de beste keuze is voor bedrijven die hun multicloudmonitoring willen stroomlijnen.
Waarom ik ManageEngine Applications Manager heb gekozen: ManageEngine Applications Manager blinkt uit dankzij robuuste functies die continue monitoring, prestatieanalyse en probleemoplossing in de volledige DevOps-pijplijn mogelijk maken. Het ondersteunt een proactieve aanpak van incidentbeheer, maakt automatisering van routinematige controles mogelijk en biedt gedetailleerde analyses om de besluitvorming te verbeteren. Dankzij de naadloze integratie met verschillende ontwikkel-, test- en implementatietools is het een waardevolle aanwinst voor DevOps-teams die streven naar hoge efficiëntie en minimale uitvaltijd.
Belangrijkste functies en integraties van ManageEngine Applications Manager
Functies omvatten uitgebreide direct beschikbare ondersteuning voor het monitoren van meer dan 100 applicaties en servers, variërend van databases, webservers, applicatieservers en virtuele servers tot cloudplatforms, containers en microservicesarchitecturen. Daarnaast bevat ManageEngine Applications Manager geavanceerde functies voor analyse van hoofdoorzaken, aangedreven door machinelearningalgoritmen.
Integraties omvatten Amazon Web Services (AWS), Microsoft Azure, Google Cloud Platform, Oracle Database, MySQL, Microsoft SQL Server, VMware, Docker, Apache Tomcat en Redis.
Pros and Cons
Pros:
- Uitgebreide monitoringmogelijkheden voor applicaties, servers en cloudomgevingen
- Aanpasbare dashboards en rapporten voor inzichtelijke analyses
- Geautomatiseerde detectie van afwijkingen en waarschuwingsmechanismen
Cons:
- Kan complex zijn om in te stellen en aan specifieke behoeften aan te passen
- De kosten kunnen onbetaalbaar zijn voor kleine en middelgrote ondernemingen
New Product Updates from ManageEngine Applications Manager
ManageEngine Applications Manager Adds ISP Latency Monitoring
ManageEngine Applications Manager introduces ISP Latency Monitoring to measure latency between EUM Agents and target hosts using traceroute and ping, helping pinpoint network-path performance issues. For more information, visit ManageEngine Applications Manager's official site.

Netdata
Het beste voor realtime-inzichten in infrastructuur
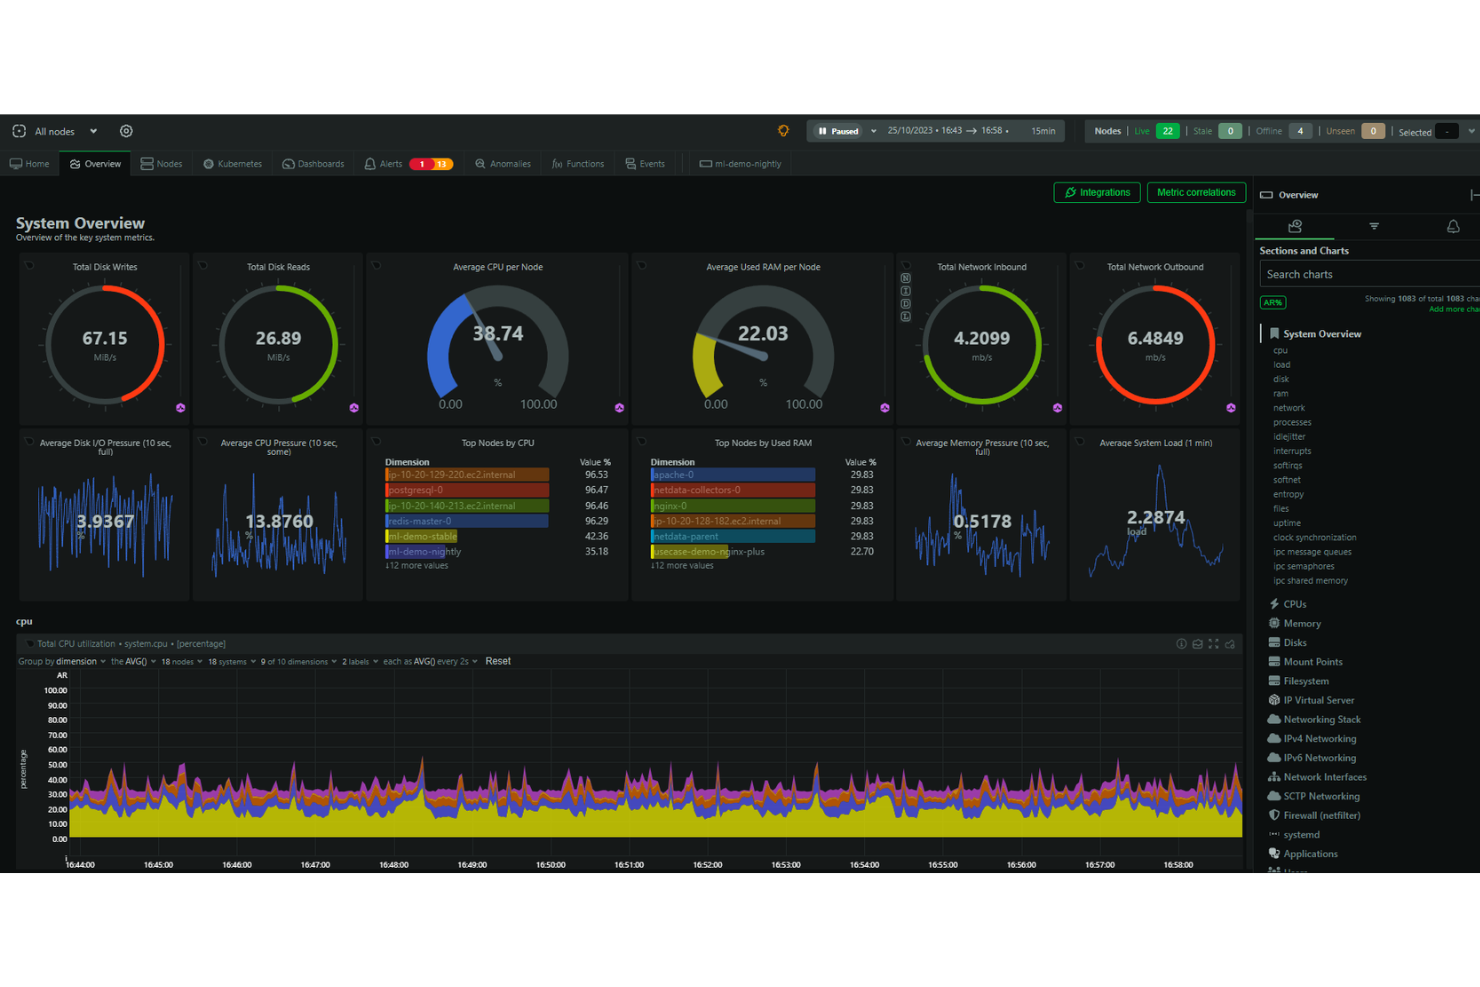
Netdata is een open-sourceplatform voor monitoring en probleemoplossing dat metrische gegevens met hoge resolutie, journaallogboeken en realtimevisualisaties voor systeemmonitoring biedt. Het is bedoeld als kosteneffectief en gebruiksvriendelijk alternatief voor duurdere en complexere platforms.
Waarom ik voor Netdata koos: Ik vind het prettig dat het platform de nadruk legt op gegevens met hoge betrouwbaarheid en realtimevisualisaties biedt, zodat gebruikers de prestaties en status van systemen nauwkeurig kunnen monitoren. Het vereenvoudigt en verbetert ook het monitoringproces voor DevOps met functies voor het verzamelen, opslaan, opvragen, visualiseren en instellen van waarschuwingen voor een breed scala aan metrische gegevens. Netdata kan op meerdere knooppunten worden uitgevoerd en elke instantie van Netdata kan autonoom werken.
Opvallende functies en integraties van Netdata
Functies omvatten waarschuwingen om gebruikers te informeren over problemen die binnen het systeem zijn gedetecteerd, automatische anomaliedetectie en geautomatiseerde en aanpasbare dashboards. Daarnaast is de kern van het Netdata-ecosysteem opensource en bevat deze alle monitoringfuncties, zoals de database, queryverwerkingsengine, scoreberekeningsengine, gezondheidsengine en engine voor machinaal leren.
Integraties omvatten containers, Kubernetes-containers, virtuele machines, Apache, Consul, Elasticsearch, OpenSearch, MySQL, Redis, Squid-logbestanden, Windows, macOS en honderden andere.
Pros and Cons
Pros:
- Geautomatiseerde waarschuwingen
- Onbeperkte monitoring van metrische gegevens
- Interactieve grafieken voor gegevensvisualisatie
Cons:
- Mogelijk is er een leercurve nodig om optimaal gebruik te maken van de functies
- Inzichten kunnen uitgebreider zijn

Beste voor monitoring van SSL-certificaten
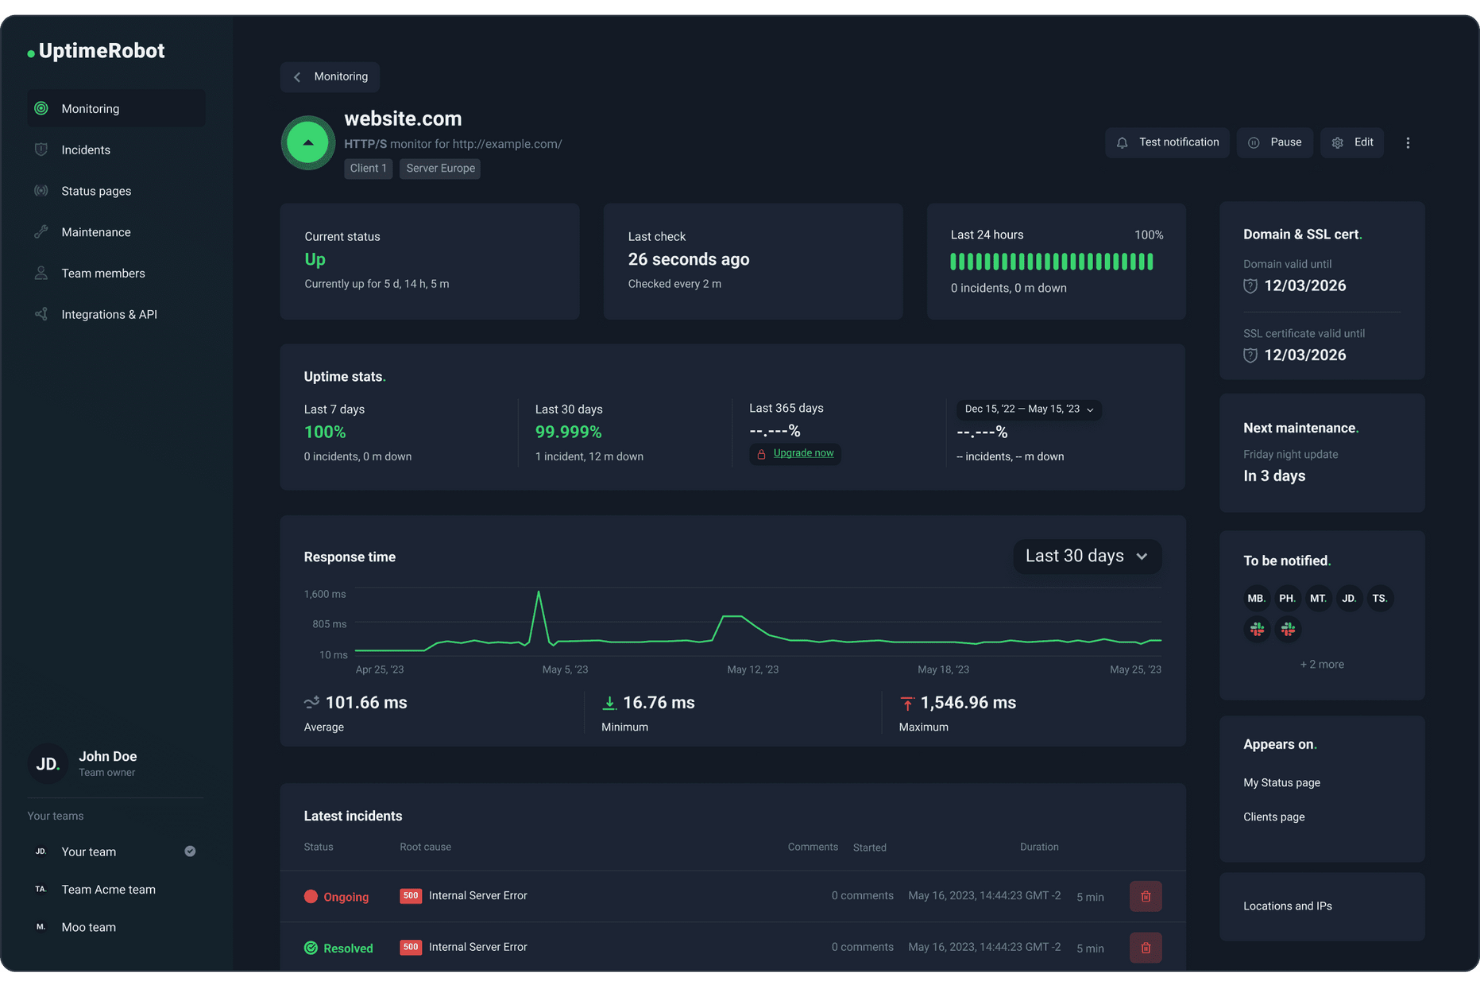
Voor DevOps-teams die op zoek zijn naar een betrouwbare monitoringoplossing biedt UptimeRobot een praktische optie die monitoring van SSL-certificaten naast uptimecontroles ondersteunt. Het is geschikt voor teams van elke omvang, van zelfstandige operators tot grotere organisaties, die inzicht nodig hebben in de beschikbaarheid van services en de prestaties van eindpunten. Door teams te helpen problemen zoals verlopen certificaten, downtime en trage reactietijden te detecteren, ondersteunt UptimeRobot stabiele bedrijfsvoering en een consistente dienstverlening.
Waarom ik voor UptimeRobot heb gekozen
Ik heb voor UptimeRobot gekozen vanwege de monitoring van SSL-certificaten, die DevOps-teams helpt problemen door verlopen of verkeerd geconfigureerde certificaten te voorkomen. Het systeem houdt de certificaatstatus bij en verstuurt waarschuwingen voordat certificaten verlopen, waardoor het risico op toegangswaarschuwingen of serviceonderbrekingen afneemt. UptimeRobot biedt ook downtimewaarschuwingen via integraties zoals Slack en PagerDuty, waardoor teams sneller kunnen reageren en services betrouwbaar kunnen houden.
Belangrijkste functies van UptimeRobot
Naast monitoring van SSL-certificaten biedt UptimeRobot:
- Controles vanaf meerdere locaties: Monitor je services vanaf meerdere locaties wereldwijd om wereldwijde toegankelijkheid te garanderen.
- Monitoring van reactietijden: Houd bij hoe snel je server reageert om inzicht te krijgen in prestatieknelpunten.
- Aanpasbare statuspagina's: Deel realtime statusupdates met gebruikers via statuspagina's in je eigen huisstijl.
- Incidentbeheer: Beheer en los incidenten efficiënt op met aanpasbare waarschuwingen en toegangsniveaus voor teams.
Integraties van UptimeRobot
Integraties omvatten Slack, PagerDuty, Microsoft Teams, Telegram, Discord, Splunk On-Call en meer, waardoor waarschuwingen naadloos kunnen worden beheerd via de communicatieplatforms van je voorkeur.
Pros and Cons
Pros:
- Realtime waarschuwingen zorgen voor een snelle reactie op downtimeproblemen
- Monitoring van SSL-certificaten helpt de beveiliging van websites efficiënt te handhaven
- Ondersteunt meerdere waarschuwingskanalen
Cons:
- Beperkte aanpassingsmogelijkheden voor meldingsinstellingen in vergelijking met concurrenten
- Niet geschikt voor complexe DevOps-stacks

Het beste voor het bewaken van serverstoringen en uitval
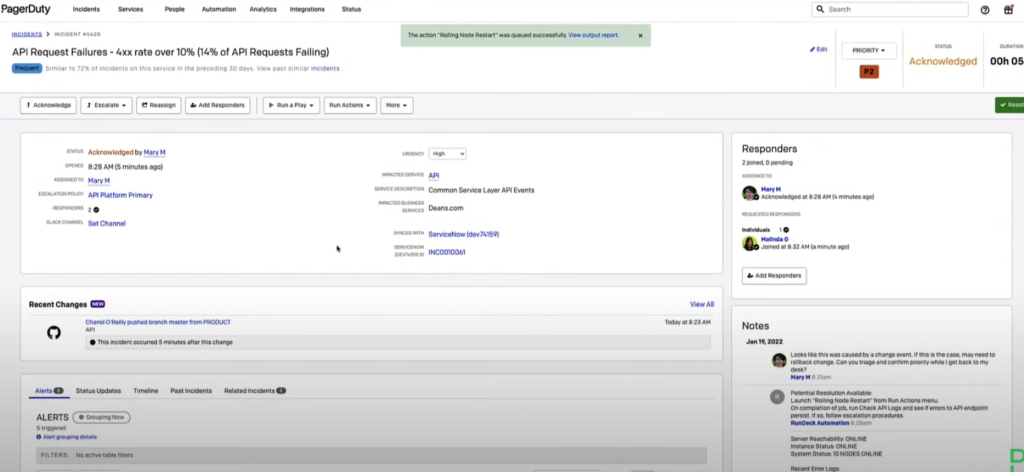
PagerDuty is een platform voor incidentrespons dat waarschuwingen verstuurt wanneer er een servicestoring of uitval optreedt. Tijdens kritieke momenten kan het e-mailmeldingen, sms-meldingen en telefonische meldingen naar je ontwikkelingsteam of klantenbestand sturen.
Waarom ik voor PagerDuty heb gekozen: Ik heb voor PagerDuty gekozen omdat het een uitstekende tool is als je bedrijfskritieke infrastructuur beheert die je nauwlettend in de gaten wilt houden. Met het platform ontvang je onmiddellijk meldingen voor oproepdiensten.
Belangrijkste functies en integraties van PagerDuty:
Functies die voor mij het nuttigst waren, zijn volledig gericht op het waarschuwen van teams wanneer systemen, knooppunten of applicatieservices niet goed functioneren. Ze omvatten e-mailwaarschuwingen, mobiele waarschuwingen, analyse van de hoofdoorzaak, realtime meldingen en prioritering. Je kunt problemen ook automatisch inplannen en escaleren.
Integraties omvatten vooraf gebouwde plug-ins voor AWS, ServiceNow, Salesforce, Zendesk, Atlassian, Datadog, Slack, Splunk en meer.
Pros and Cons
Pros:
- Hiermee kun je de incidentrespons toewijzen aan de juiste persoon of het juiste team
- Aanpasbare waarschuwingen kunnen per e-mail, telefoon, sms of pushmelding worden verzonden
- Filtert meldingen om waarschuwingen met een hoge prioriteit die op echte bedreigingen wijzen voorrang te geven en tegelijkertijd valse alarmen te verminderen
Cons:
- Het zoeken naar historische waarschuwingen kan lastig zijn, tenzij je een exacte ID hebt
- Gebruikt een conventioneel dashboard dat voor specifieke behoeften en voorkeuren verder aanpasbaar zou kunnen zijn

Nagios
Het beste voor continue monitoring van grote poortnetwerken
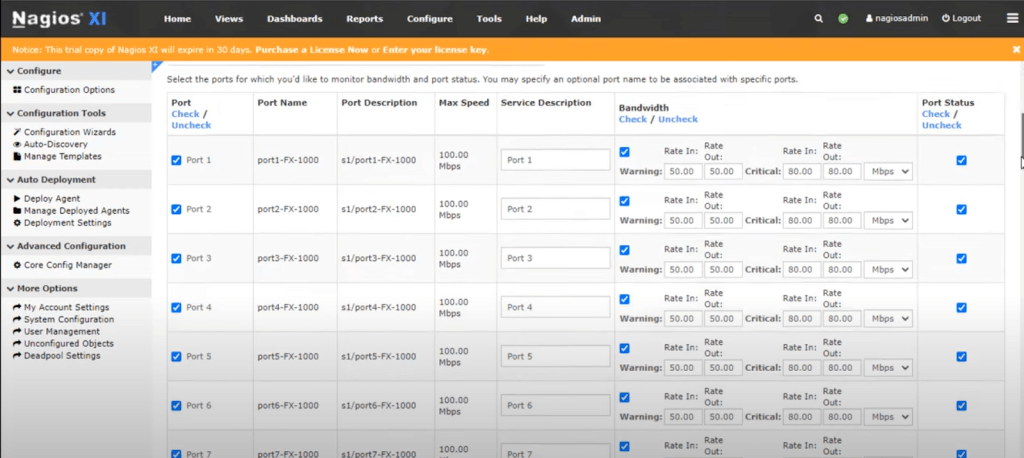
Nagios is een opensource softwaretoepassing die netwerkverkeer continu monitort. Het kan het bandbreedtegebruik per poort voor inkomend en uitgaand verkeer bijhouden, netwerkuitval detecteren, overbelaste poorten identificeren en netwerkmisbruikers opsporen.
Waarom ik voor Nagios koos: In plaats van mijn systemen bloot te stellen aan kwetsbaarheden of me zorgen te maken over trage netwerkprestaties, geeft Nagios mijn DevOps-team direct inzicht in ons netwerk. Ik vond het ook prettig dat het informatie logt over problemen met de netwerkinfrastructuur en processen die via de poort zijn mislukt.
Belangrijkste functies en integraties van Nagios
De door Nagios aangeboden functies zorgen voor de beveiliging van mijn netwerkpoorten. Dit omvat SNMP-monitoring, monitoring van switches en routers, netwerkmonitoring en pingmonitoring, waarmee ik de integriteit en veiligheid van mijn netwerkinfrastructuur kan handhaven.
Vooraf gebouwde integraties zijn onder andere Amazon SNS, Prometheus, PagerDuty, Dynatrace en meer. Daarnaast heeft Nagios meer dan 3.000 officiële en community-plug-ins die ontwikkelaars aan hun stack kunnen toevoegen.
Pros and Cons
Pros:
- De opensourceversie is 100% gratis
- Lichtgewicht voor minimaal resourcegebruik
- Verhoogt de beschikbaarheid van uw volledige netwerkinfrastructuur bij protocolstoringen en netwerkuitval
Cons:
- Voor functies voor beveiliging en netwerkzichtbaarheid zijn afzonderlijke licenties vereist
- Gebruikt bestanden in plaats van databases om configuratiebestanden op de backend op te slaan

Beste voor prestatiemonitoring van websites en mobiele apparaten
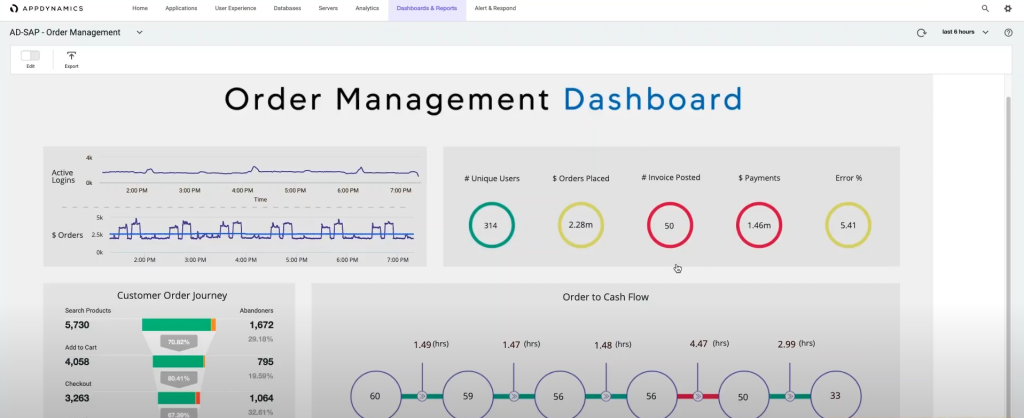
AppDynamics is een tool voor applicatieprestatiebeheer voor de volledige stack. Het maakt gebruik van machinelearningalgoritmen om prestatieproblemen te detecteren, deze te vergelijken met basismetrieken en indien nodig waarschuwingen te activeren.
Waarom ik voor AppDynamics heb gekozen: Ik heb voor AppDynamics gekozen omdat het zich richt op applicatieprestaties en tegelijkertijd monitoring gebruikt om een optimale gebruikerservaring te garanderen. Of je nu een website of mobiele app beheert, AppDynamics zorgt ervoor dat je klanten geen problemen ondervinden zoals time-outs of langzaam ladende pagina's.
Belangrijkste functies en integraties van AppDynamics:
Functies die AppDynamics uitstekend maken voor prestatiemonitoring zijn onder andere applicatieprestatiemonitoring (APM) en inzicht in de infrastructuur, inclusief inzicht in databases. Daarnaast viel eindgebruikersmonitoring mij ook op, omdat deze ervoor zorgt dat je klanten de snelst mogelijke applicatiesnelheden krijgen.
Integraties waarmee AppDynamics samenwerkt, omvatten kant-en-klare plug-ins zoals LoadRunner, Sainapse en NeoLoad voor prestaties en continue levering. AppDynamics werkt ook samen met SquaredUp, Medallia en Quantum Metric om de klantervaring te monitoren.
Pros and Cons
Pros:
- Geeft realtime-informatie over processen die CPU en geheugen verbruiken
- De diepgang van de monitoring van webapplicaties en infrastructuur is enorm
- Netwerkzichtbaarheid stelt je in staat de hoeveelheid bandbreedte te zien die per node wordt gebruikt
Cons:
- De functionaliteit kan overweldigend zijn voor kleine bedrijven
- Geen automatische applicatiescan; deze moet in een configuratiebestand worden gedefinieerd
Het beste voor SaaS-observeerbaarheid van de volledige technologiestack
New Relic is een webtracking- en analysetool die de realtime-observeerbaarheid van elk applicatieonderdeel bewaakt dat over databases en servers is verspreid.
Waarom ik voor New Relic heb gekozen: Ik heb voor New Relic gekozen omdat het een 'alles-in-één'-oplossing biedt die alle aspecten van je technologiestack bewaakt en analyseert. Volledig end-to-end inzicht stelt teams in staat om bruikbare inzichten te verkrijgen wanneer zich problemen voordoen en deze snel aan te pakken en op te lossen.
Belangrijkste functies en integraties van New Relic:
Functies die New Relic volgens mij geweldig maken voor monitoring van de volledige technologiestack zijn applicatiemonitoring en databasemonitoring. Daarnaast is er beschikbaarheidsmonitoring om ervoor te zorgen dat je systemen de klok rond werken op openbare of private locaties.
Integraties zijn beschikbaar met vooraf gebouwde plug-ins zoals AWS, Kubernetes, Azure, Google Cloud Platform en Prometheus. Je kunt ook systeemeigen integraties zoals SQL Server gebruiken om query's naar New Relic te verzenden.
Pros and Cons
Pros:
- Zeer rijk aan functies en biedt de mogelijkheid om aangepaste query's te schrijven op basis van verzamelde instrumentatiegegevens
- Biedt inzicht in statistieken en prestaties, zelfs bij hoge belasting en zware stress
- Eenvoudige installatie van agents waarmee je binnen enkele minuten gegevens naar je dashboard kunt sturen
Cons:
- De kosten kunnen als hoog worden beschouwd, vooral voor startups en zelfs middelgrote bedrijven
- De interface kan wat lastig zijn vanwege het aantal opties op het scherm

Splunk
Het beste voor het monitoren en doorzoeken van grote hoeveelheden gegevens
Splunk is een softwaretool die gegevens vastlegt en indexeert en deze organiseert in een doorzoekbare opslagplaats. Hiermee kunnen waarschuwingen, rapporten en visualisaties worden gegenereerd op basis van grote datasets.
Waarom ik voor Splunk heb gekozen: Ik heb voor Splunk gekozen vanwege de mogelijkheid om op te schalen en grote hoeveelheden gegevens te verwerken. Naarmate moderne applicaties en gedistribueerde systemen complexer worden, zorgt de schaalbaarheid van Splunk ervoor dat je logboeken uit meerdere bronnen effectief kunt beheren en analyseren zonder dat dit ten koste gaat van de prestaties.
Belangrijkste functies en integraties van Splunk:
De functies van Splunk zijn ontworpen om teams meer inzicht te geven in hun applicaties. Ik ben van mening dat de indexering en gegevensverzameling, de mogelijkheden voor werkbelastingsbeheer, de toolkit voor machine learning en de intuïtieve tools voor gegevensverkenning Splunk tot een uitstekend hulpmiddel voor teams maken.
Integraties zijn beschikbaar met vooraf gebouwde plug-ins via Docker, Jenkins, Kubernetes, Ansible, AWS, Azure en ServiceNow. Daarnaast geeft Splunk informatie over de mogelijkheden van elke integratie, zodat je kunt zien of je integraties met Splunk traceringen, logboeken, metingen of metagegevens kunnen leveren.
Pros and Cons
Pros:
- Slaat je zoekopdrachten op en herkent automatisch belangrijke gegevens
- Zeer schaalbaar en eenvoudig te implementeren
- Maakt analytische rapporten en visualiseert gegevens met diagrammen, grafieken en tabellen
Cons:
- Kan kostbaar zijn, vooral als je services veel resources vereisen
- Het optimaliseren van zoekopdrachten voor snelheid kan lastig zijn
- Website bezoeken (opent in een nieuw venster)
Andere DevOps-monitoringtools
Hier zijn enkele andere tools die de top 12 net niet hebben gehaald, maar die zeker het bekijken waard zijn:
- Prometheus
E voor waarschuwingen en het aggregeren van metrische gegevens
- Grafana Cloud
Het beste voor het monitoren van data-analyse en visualisatie
- Buddy
Het beste voor het monitoren van websites en mobiele apps voor kleine bedrijven
- InfluxDB
Het beste voor het monitoren van tijdreeksgegevens in één multifunctionele database
- Sensu
E voor het monitoren van cloudomgevingen
- ChaosSearch
Ideaal voor het centraliseren van log- en gebeurtenisgegevens in de cloud
- Dynatrace
Het beste voor volledige prestatiemonitoring voor grote bedrijven
- Dotcom Monitor
Ideaal voor het monitoren van kritieke workflows
- Icinga
Het meest geschikt voor het controleren van de beschikbaarheid van netwerkbronnen


Gerelateerde beoordelingen van software en tools
Als je hier nog steeds niet hebt gevonden wat je zoekt, bekijk dan deze andere soorten tools die we hebben getest en geëvalueerd.
- Netwerkmonitoringsoftware
- Servermonitoringsoftware
- SD-WAN-oplossingen
- Infrastructuurmonitoringtools
- Pakketsniffer
- Applicatiemonitoringtools
Hoe ik DevOps-monitoringtools beoordeel
Ik beoordeel deze tools in twee lagen: kernvereisten zoals het opnemen van meetgegevens, gedistribueerde tracering en het routeren van waarschuwingen, en vervolgens onderscheidende factoren die bepalen hoe goed ze bij jouw stack en team passen.
Kernfunctionaliteit (Basisvereisten voor deze lijst)
Bij het selecteren van tools voor mijn lijst beoordeel ik elke tool op een schaal van 0 (biedt de functionaliteit niet) tot 5 (blink uit op dit gebied) voor elke hieronder vermelde kernfunctionaliteit. Vervolgens zet ik de totaalscore van de tool om in een percentage. Elke tool moet een minimale totaalscore van 75% behalen om in aanmerking te komen voor opname.
- Infrastructuur- & applicatiemonitoring: Ik beoordeel of een tool hosts, containers, databases en applicatieservices op één plek kan volgen, zoals het bewaken van CPU-pieken op Kubernetes-nodes naast API-latentie.
- Full-stack-observeerbaarheid: Logboeken, meetgegevens en traces moeten over services heen met elkaar in verband worden gebracht, zodat je een trage aanvraag kunt volgen van een frontendfout via sprongen tussen microservices naar de grondoorzaak.
- Realtimewaarschuwingen & incidentbeheer: Ik controleer op configureerbare waarschuwingsvoorwaarden, escalatiebeleid en routering naar tools zoals PagerDuty of Slack, zodat engineers in de bereikbaarheidsdienst via het juiste kanaal worden gewaarschuwd.
- Monitoring van CI/CD-pijplijnen: Het volgen van implementaties is hierbij belangrijk. Ik zoek naar inzicht in bouwfasen, foutpercentages en de mogelijkheid om een mislukte implementatie in verband te brengen met een productie-incident.
- Integraties met de DevOps-toolchain: De tool moet aansluiten op je bestaande stack. Ik zoek naar native koppelingen met Kubernetes, Terraform, Jenkins, GitHub en grote cloudproviders.
- Detectie van afwijkingen & analyse van de grondoorzaak: Ik beoordeel of de tool verder gaat dan statische drempelwaarden. Op machine learning gebaseerde anomaliedetectie en gebeurteniscorrelatie helpen SRE's om tijdens storingen door de ruis van waarschuwingen heen te kijken.
Zodra ik een lijst heb met tools die aan deze criteria voldoen, kijk ik naar wat elk platform onderscheidt.
Onderscheidende factoren (Wat leveranciers onderscheidt)
Zo vergelijk ik verschillende leveranciers met elkaar:
Opvallende functies
Het volgen van SLO's is een belangrijke onderscheidende factor. Ik zoek naar tools waarmee SRE-teams foutbudgetten kunnen definiëren en verbruikssnelheden kunnen bewaken, zodat betrouwbaarheidsbeslissingen datagedreven blijven in plaats van reactief te zijn. Synthetische monitoring is ook belangrijk: door API-aanroepen of gebruikersstromen vanuit meerdere regio's te simuleren, worden latentieproblemen zichtbaar voordat echte gebruikers ermee te maken krijgen. RUM vormt hierop een aanvulling door de werkelijke browser- en mobiele prestaties vast te leggen, zodat je een volledig beeld krijgt van de invloed van een implementatie op de gebruikerservaring.
Meer dan functies
Ik beoordeel de voorspelbaarheid van de prijsstelling nauwlettend. Sommige tools rekenen per host, terwijl andere kosten in rekening brengen op basis van datavolume, en kosten voor het bewaren van logboeken kunnen snel oplopen wanneer je terabytes aan gegevens uit een groot Kubernetes-cluster opneemt. Ondersteuning voor OpenTelemetry is een andere factor die ik controleer, omdat het gebruik van open standaarden je team beschermt tegen afhankelijkheid van een leverancier als de behoeften veranderen. Ik houd ook rekening met de tijd tot waarde: automatische instrumentatie en vooraf gebouwde dashboards kunnen het verschil betekenen tussen binnen enkele dagen live gaan en weken besteden aan handmatige configuratie.
Zo kies je DevOps-monitoringtools
Het is gemakkelijk om verstrikt te raken in lange functielijsten en complexe prijsstructuren. Om je te helpen gefocust te blijven terwijl je je eigen softwareselectieproces doorloopt, vind je hier een checklist met factoren om rekening mee te houden:
| Factor | Waarop te letten |
|---|---|
| Schaalbaarheid | Zorg ervoor dat de tool toenemende workloads en meer gebruikers kan verwerken zonder aan prestaties in te boeten. Cloudgebaseerde opties met automatisch schalen kunnen helpen om groei te beheren. |
| Integraties | Controleer of de tool integreert met je bestaande DevOps-stack, waaronder CI/CD-pipelines, cloudservices en platforms voor incidentrespons. |
| Aanpasbaarheid | Zoek naar opties om monitoringinstellingen, waarschuwingsdrempels en dashboards aan te passen aan de workflows en prioriteiten van je team. |
| Gebruiksgemak | De tool moet een duidelijke interface en intuïtieve bediening hebben, zodat je team problemen snel kan signaleren en aanpakken. Ingewikkelde configuraties kunnen de responstijd vertragen. |
| Budget | Vergelijk abonnementskosten, licentiekosten en extra kosten voor geavanceerde functies of hogere datalimieten. Let op verborgen kosten. |
| Beveiligingsmaatregelen | Let op versleuteling, toegangscontroles en veilige gegevensoverdracht om gevoelige informatie te beschermen en datalekken te voorkomen. |
| Realtimewaarschuwingen | De tool moet direct waarschuwingen geven bij prestatieproblemen of storingen, zodat je team snel kan handelen en downtime tot een minimum kan beperken. |
| Bewaren van gegevens en rapportage | Zorg ervoor dat de tool historische gegevens lang genoeg bewaart voor zinvolle analyses en het identificeren van trends. Exporteerbare rapporten zijn nuttig voor teambeoordelingen. |
Trends in DevOps-monitoringtools
Voor mijn onderzoek heb ik talloze productupdates, persberichten en release-logboeken van verschillende leveranciers van DevOps-monitoringtools verzameld. Dit zijn enkele opkomende trends die ik in de gaten houd:
Verbeterde anomaliedetectie: Nieuwe machinelearningmodellen verbeteren de anomaliedetectie, waardoor teams onregelmatige patronen in realtime kunnen signaleren en het aantal fout-positieven kunnen verminderen.
Observability van de volledige stack: Leveranciers gaan verder dan basismonitoring en bieden een compleet overzicht van infrastructuur, applicaties en gebruikerservaring op één plek. Dit maakt het eenvoudiger om problemen te identificeren en op te lossen. Let bij het beoordelen van observabilityplatforms op oplossingen die uitgebreide monitoringmogelijkheden bieden.
AI-gestuurde inzichten: Meer tools gebruiken AI om gegevens te analyseren en prestatieproblemen te voorspellen voordat ze zich voordoen. Hierdoor kunnen teams proactief handelen in plaats van op storingen te reageren.
Gedistribueerde tracering: Tools voegen traceermogelijkheden toe waarmee teams aanvragen door microservices en containers heen kunnen volgen. Dit helpt om precies vast te stellen waar vertragingen of storingen optreden.
Zelfherstellende systemen: Sommige tools bieden nu geautomatiseerde herstelacties, waarbij het systeem een probleem kan detecteren en oplossen zonder menselijke tussenkomst. Dit vermindert downtime en responstijden.
Wat zijn DevOps-monitoringtools?
DevOps-monitoringtools zijn gespecialiseerde softwareoplossingen die zijn ontworpen om de prestaties en status van applicaties en infrastructuur in realtime te volgen en te analyseren. Deze tools worden voornamelijk gebruikt door DevOps-engineers, systeembeheerders en IT-professionals om de naadloze werking en levering van softwareproducten te waarborgen.
DevOps-monitoringtools helpen het monitoringproces te automatiseren, bieden inzicht in systeemprestaties en maken het mogelijk om problemen snel te identificeren en op te lossen voordat ze de productieomgeving beïnvloeden. Functies zoals realtimewaarschuwingen, tools voor data-observability en voorspellende analyses ondersteunen allemaal proactieve probleemoplossing en verhogen de operationele efficiëntie.
Functies
Dit zijn enkele van de belangrijkste functies waar ik op let in DevOps-monitoringtools wanneer ik ze beoordeel voor mijn lijst:
- Realtimewaarschuwingen en meldingen: Deze functie zorgt ervoor dat problemen onmiddellijk worden opgemerkt zodra ze zich voordoen. Dit is essentieel om problemen snel te beperken en te voorkomen dat kleine problemen uitgroeien tot grote storingen.
- Uitgebreide dashboards: Dashboards bieden een uniform overzicht van alle metingen en logboeken. Ze zijn cruciaal voor het visualiseren van de status van de ontwikkelingspijplijn en de gezondheid van applicaties, waardoor het eenvoudiger wordt om trends en mogelijke problemen te identificeren.
- Aanpasbare metingen: Aanpassingsopties voor het bewaken van specifieke metingen. Door metingen af te stemmen op specifieke behoeften, kunnen teams gerichter monitoren en ervoor zorgen dat ze de prestatie-indicatoren volgen die het meest relevant zijn voor hun projecten.
- Logboekbeheer en -analyse: Effectief logboekbeheer en analytische mogelijkheden. Het analyseren van logboeken helpt bij het diagnosticeren van problemen en het begrijpen van het gedrag van applicaties, wat essentieel is voor probleemoplossing en optimalisatie.
- Schaalbaarheid: De mogelijkheid om monitoringoplossingen op te schalen naarmate projecten groeien. Schaalbaarheid zorgt ervoor dat de monitoringtool toenemende belastingen aankan en voorkomt dat de prestaties na verloop van tijd afnemen.
- Integratiemogelijkheden: De mogelijkheid om te integreren met een breed scala aan API-monitoringtools en platforms. Deze functie maakt naadloze samenwerking mogelijk tussen de tools die in de ontwikkelingspijplijn worden gebruikt, waardoor de efficiëntie van workflows en de consistentie van gegevens worden verbeterd.
- Beveiligings- en nalevingsfuncties: Ingebouwde beveiligingsmaatregelen en rapportage over naleving. Deze functies helpen bij het beschermen van gevoelige gegevens en zorgen ervoor dat de ontwikkelingspijplijn voldoet aan wettelijke vereisten.
- Geautomatiseerd incidentbeheer: Automatisering van het incidentresponsproces. Door incidenten automatisch te beheren, kunnen teams downtime verminderen en reactietijden verbeteren, wat leidt tot betrouwbaardere applicaties.
- Ondersteuning voor cloud-native omgevingen: Geoptimaliseerd voor het monitoren van cloudgebaseerde omgevingen. Omdat veel applicaties tegenwoordig in de cloud worden gehost, zorgt native ondersteuning ervoor dat monitoring in deze omgevingen efficiënt en effectief verloopt.
- End-to-end-zichtbaarheid: De mogelijkheid om elk aspect van de ontwikkelingspijplijn te monitoren. Deze functie biedt een holistisch overzicht van de pijplijn, van codecommits tot implementatie, wat cruciaal is om de impact van wijzigingen te begrijpen en knelpunten te identificeren.
Voordelen
Monitoringtools spelen een essentiële rol in het DevOps-ecosysteem. Ze helpen niet alleen bij het snel identificeren en oplossen van problemen, maar bieden ook inzichten die kunnen leiden tot beter geïnformeerde besluitvorming en verbeterde algehele prestaties. Hier zijn nog enkele specifieke voordelen van deze tools voor je DevOps-team:
- Verbeterde operationele efficiëntie: DevOps-monitoringtools automatiseren het volgen en analyseren van verschillende metingen en logboeken in de ontwikkelingspijplijn. Deze automatisering maakt waardevolle tijd vrij voor teams, zodat ze zich kunnen richten op strategischere taken in plaats van op handmatige monitoring en probleemoplossing.
- Verbeterde systeembetrouwbaarheid: Door realtimewaarschuwingen en meldingen te bieden, stellen deze tools teams in staat om problemen snel te detecteren en aan te pakken voordat ze escaleren tot grotere problemen. Deze mogelijkheid om onmiddellijk te reageren vermindert downtime aanzienlijk en zorgt ervoor dat systemen stabiel en betrouwbaar blijven.
- Proactieve probleemoplossing: Het gebruik van voorspellende analyses en anomaliedetectie helpt organisaties om problemen te voorzien voordat ze zich voordoen. Door mogelijke problemen vooraf te identificeren, kunnen teams proactief oplossingen implementeren, verstoringen voorkomen en een soepele werking behouden.
- Geoptimaliseerde prestaties: Database-DevOps-tools bieden inzicht in de prestaties van applicaties en infrastructuur en identificeren knelpunten en verbeterpunten. Met deze informatie kunnen teams hun systemen optimaliseren voor betere prestaties, waardoor de gebruikerservaring en operationele efficiëntie verbeteren.
- Verbeterde beveiligingspositie: Met functies die gericht zijn op het monitoren van beveiligingsmetingen en nalevingsnormen, spelen deze tools een cruciale rol bij het identificeren van kwetsbaarheden en ervoor zorgen dat systemen voldoen aan de beste beveiligingspraktijken. Deze verbeterde beveiligingspositie beschermt tegen inbreuken en behoudt de integriteit van de gegevens en systemen van de organisatie.
Kosten en prijzen
Met een verscheidenheid aan beschikbare abonnementsopties kan inzicht in de prijzen en functies van elk abonnement softwarekopers helpen een weloverwogen beslissing te nemen die aansluit bij hun behoeften en budget. Van gratis versies voor kleine projecten tot abonnementen op ondernemingsniveau met geavanceerde functies: er zijn monitoringtools voor elke operationele schaal.
Vergelijkingstabel voor DevOps-monitoringtools
Hieronder vind je een gedetailleerd overzicht van de gebruikelijke abonnementsopties en prijzen voor DevOps-monitoringtools, bedoeld om mensen die nieuw zijn in deze softwarecategorie te helpen bij het maken van hun keuze.
| Type abonnement | Gemiddelde prijs | Veelvoorkomende functies |
|---|---|---|
| Gratis | $0 | Basisbewakingsmogelijkheden, beperkte statistieken en logboeken, communityondersteuning, toegang tot forums |
| Basis | $20-$50/user/month | Uitgebreidere bewakingsmogelijkheden, meer statistieken en logboeken, e-mailondersteuning, integratie met andere tools |
| Standaard | $50-$100/user/month | Volledige bewakingssuite, geavanceerde analyses, 24/7-ondersteuning, aanpasbare dashboards, integratiemogelijkheden |
| Premium | $100-$200/user/month | Premiumfuncties, waaronder voorspellende analyses, mogelijkheden voor machine learning, toegewijde ondersteuning, aangepaste integraties |
| Zakelijk | Aangepaste prijzen | Alle Premium-functies plus schaalbaarheidsopties, een toegewijde accountmanager, beveiliging op ondernemingsniveau |
Veelgestelde vragen over DevOps-monitoringtools
Hier vindt u antwoorden op veelgestelde vragen over DevOps-monitoringtools:
Hoe gaan DevOps-monitoringtools om met grootschalige infrastructuur?
Kunnen DevOps-monitoringtools prestaties in verschillende omgevingen volgen?
Hoe helpen DevOps-monitoringtools bij het reageren op incidenten?
Wat is het verschil tussen infrastructuurbewaking en applicatiebewaking?
Hoe kunnen DevOps-monitoringtools fout-positieven verminderen?
Ondersteunen DevOps-monitoringtools aangepaste statistieken?
Wat nu:
Als u bezig bent met het onderzoeken van DevOps-monitoringtools, neem dan gratis contact op met een SoftwareSelect-adviseur voor aanbevelingen.
U vult een formulier in en voert een kort gesprek waarin zij ingaan op de specifieke kenmerken van uw behoeften. Vervolgens ontvangt u een shortlist van software om te beoordelen. Ze ondersteunen u zelfs tijdens het volledige aankoopproces, inclusief prijsonderhandelingen.