

Å administrere en DevOps-pipeline er ingen liten oppgave. Mellom det å sikre stabilitet i produksjon, følge med på ytelsesflaskehalser og forhindre nedetid kan presset med å holde alt i gang uten problemer føles overveldende. Kanskje har du opplevd frustrerende forsinkelser på grunn av uoppdagede problemer, eller hatt vanskeligheter med verktøy som ikke integreres sømløst i arbeidsflytene dine. Realiteten er at det blir en oppoverbakke å opprettholde effektiviteten og levere en god brukeropplevelse uten de riktige verktøyene for DevOps-overvåking.
Verktøy for DevOps-overvåking er utviklet for å gi deg innsyn i systemene dine, slik at du kan identifisere og løse potensielle problemer før de påvirker brukerne dine. De er avgjørende for å opprettholde stabil drift, optimalisere ytelsen og sikre at teamet ditt kan fokusere på innovasjon i stedet for brannslukking. Gjennom årene har jeg arbeidet med en rekke overvåkingsløsninger i store prosjekter og med ulike team. I denne veiledningen deler jeg mine beste anbefalinger og innsikter for å hjelpe deg med å velge det perfekte verktøyet for å effektivisere prosessene dine og holde systemene i gang med maksimal ytelse.
Hvorfor du kan stole på våre programvareanbefalinger
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Teamet vårt har testet og anmeldt programvare siden 2012. Vi er selv teknologiledere, så vi vet hvor vanskelig og hvor viktig det er å velge riktig programvare.
I denne guiden har vi vurdert verktøyene gjennom praktisk testing og uavhengig research og gitt dem poeng ut fra våre utvelgelseskriterier.
Anmeldelsene våre bygger på vår egen redaksjonelle vurdering. De er ikke et salgsargument.
Ekspertanmeldere:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Sammenligningstabell for verktøy for DevOps-overvåking
Tabellen nedenfor sammenligner prisopplysningene for mine beste utvalgte verktøy for DevOps-overvåking.
Sorted by: Default
| Tool | Starting Price | Website | |
|---|---|---|---|
Best for overvåking av hybrid infrastruktur | 4.6 out of 5 | $200/måned 30 dagers gratis prøveperiode + gratisabonnement tilgjengelig | Website |
Best for overvåking sammen med skyoperasjoner | Not rated | $3,500/måned Gratis demonstrasjon tilgjengelig | Website |
Best for overvåking av reelle brukere | 4.7 out of 5 | $10/måned 30 dagers gratis prøveperiode + gratis demonstrasjon tilgjengelig | Website |
Best for overvåking av flere skyer | 4.3 out of 5 | $395/år Gratis abonnement + 30 dagers prøveperiode tilgjengelig | Website |
Best for innsikt i infrastruktur i sanntid | 4.8 out of 5 | $4.50/node/month 14-dagers gratis prøveperiode + gratisabonnement + gratis demo tilgjengelig | Website |
Best for overvåking av SSL-sertifikater | 4.7 out of 5 | $8/10 monitorer/måned Gratisabonnement + gratis demo tilgjengelig | Website |
Best for ende-til-ende-ytelsesovervåking for store virksomheter | 4.5 out of 5 | $0.08/8 GB/time 15 dagers gratis prøveperiode | Website |
Best for overvåking av serverforstyrrelser og driftsstanser | 4.5 out of 5 | $21/bruker/måned 14 dagers gratis prøveperiode | Website |
Best for kontinuerlig overvåking av store portnettverk | 4.6 out of 5 | $1,995/bruker 30 dagers gratis prøveperiode | Website |
Best for ytelsesovervåking av nettsteder og mobilapper | 4.3 out of 5 | $6/kjerne/måned 15 dagers gratis prøveperiode | Website |


Anmeldelser av de beste verktøyene for DevOps-overvåking
Her ser du nærmere på de beste verktøyene for DevOps-overvåking. Jeg fremhever funksjonene hvert verktøy tilbyr, og hvorfor de fortjener en plass på denne listen.
 Best for overvåking av hybrid infrastruktur
- 30 dagers gratis prøveperiode + gratisabonnement tilgjengelig
- Fra $200/måned (fakturert årlig)
Visit WebsiteCustomer Rating:4.6/5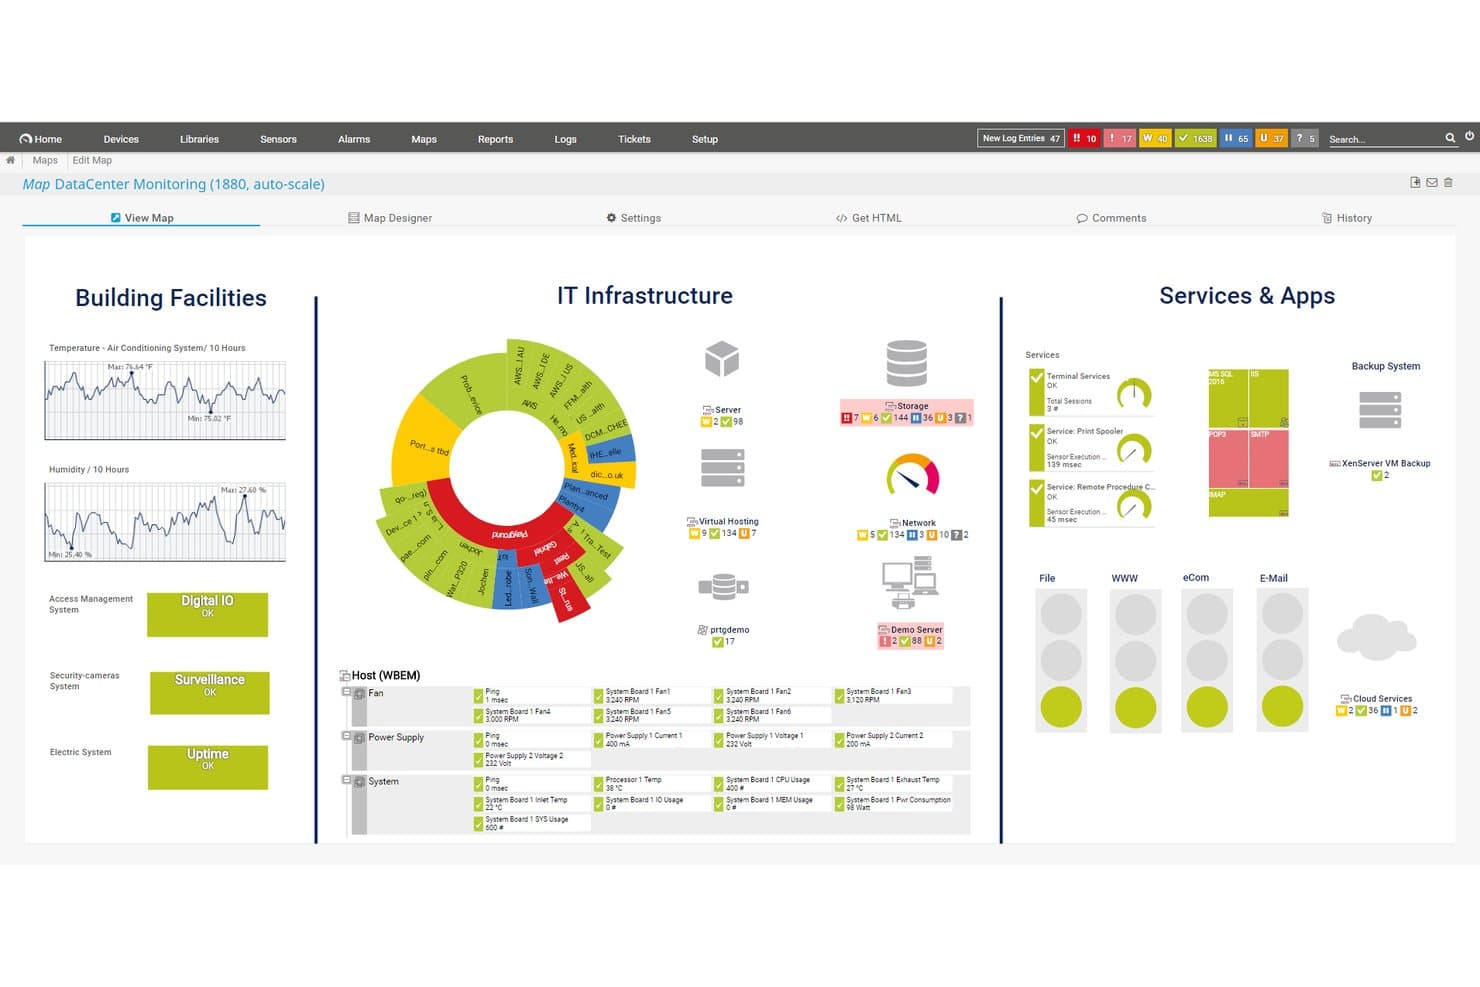
Paessler PRTG tilbyr et overvåkingskart for datasentre som viser bygningsfasiliteter, IT-infrastruktur samt tjenester og apper i ett samlet dashbord. Paessler PRTG er en agentløs plattform for overvåking av IT-infrastruktur som sporer nettverksenheter, servere, applikasjoner, databaser og skyressurser gjennom et sensorbasert system med tilpassbare dashbord og varsler i sanntid.
Hvem passer Paessler PRTG best for?
IT-driftsteam i mellomstore til store virksomheter som trenger sentralisert oversikt over lokale nettverk, servere og hybrid infrastruktur.
Hvorfor jeg valgte Paessler PRTG
Jeg valgte Paessler PRTG som en av de beste fordi den sensorbaserte arkitekturen lar meg hente inn måledata fra nettverksenheter, servere, applikasjoner og skyressurser på én enkelt plattform. Jeg liker hvordan PRTG-kartdesigneren lar meg bygge tilpassede dashbord i sanntid som gjenspeiler den faktiske infrastrukturoppbygningen min, ikke en generisk mal. Oppsettet med eksterne prober utvider denne dekningen på tvers av flere lokasjoner uten å sette opp separate overvåkingsverktøy.
Viktige funksjoner i Paessler PRTG
- Sensorbasert overvåking: Lar deg overvåke en rekke enhetstyper, tjenester og protokoller ved å tildele individuelle sensorer til bestemte måledata.
- REST-tilpassede sensorer: Gjør det mulig å hente data fra tredjeparts-API-er eller tilpassede applikasjoner gjennom HTTP-forespørsler.
- Distribuert overvåking med eksterne prober: Støtter overvåking av geografisk spredt infrastruktur fra én enkelt konsoll.
- Revisjonslogging og enkel pålogging: Muliggjør sporing av brukeraktivitet og strømlinjeformet tilgangsstyring for samsvar i større virksomheter.
Integrasjoner med Paessler PRTG
Paessler PRTG tilbyr innebygde integrasjoner med Amazon CloudWatch, Microsoft Azure, VMware vSphere og Slack, samt et API for tilpassede integrasjoner.
Pros and Cons
Pros:
- Tilpassbare sensorer på tvers av infrastrukturlag
- Sterk støtte for lokale og hybride distribusjoner
- Automatisk oppdagelse kartlegger hele nettverket ditt automatisk
Cons:
- Begrenset innebygd overvåking av containere og Kubernetes
- Brukergrensesnittet føles utdatert sammenlignet med moderne alternativer
Learn more about Paessler PRTG: Best for overvåking sammen med skyoperasjoner
- Gratis demonstrasjon tilgjengelig
- Fra $3,500/måned
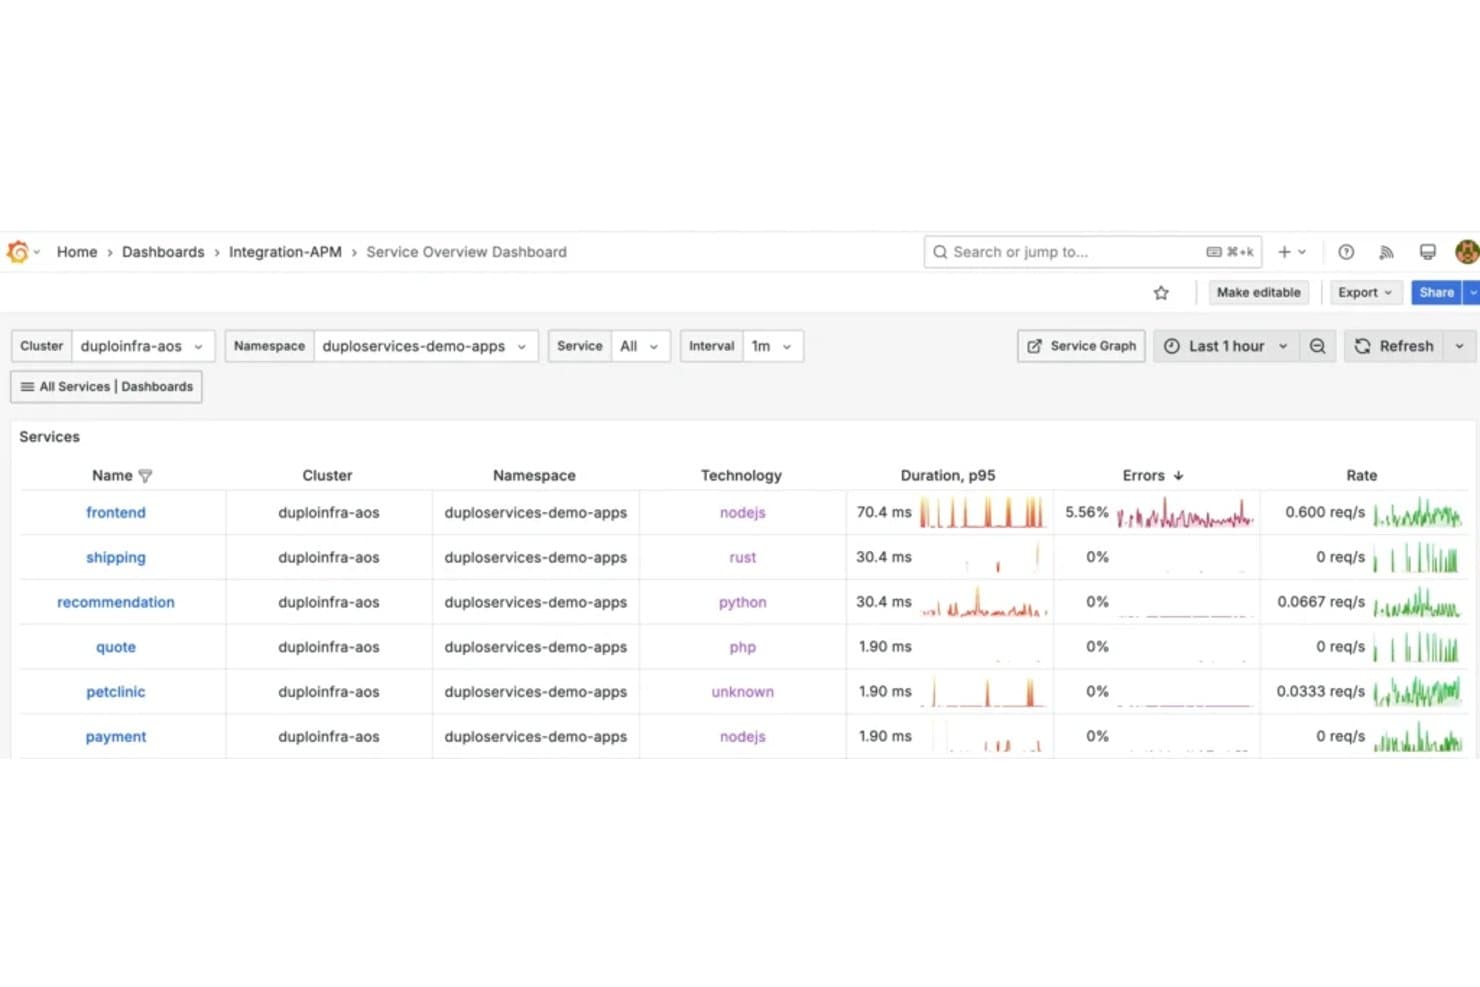
DuploCloud sporer tjenestilstand, feilrater og ventetid i én visning. DuploCloud er en AI-drevet DevOps-plattform som kombinerer automatisering av skyinfrastruktur med en integrert observabilitetspakke som dekker måledata, logger, sporingsdata og varsling på tvers av AWS-, Azure- og GCP-miljøer.
Hvem passer DuploCloud best for?
DuploCloud passer for DevOps-ingeniører og SRE-er som ønsker observabilitet innebygd i den samme plattformen de bruker til å klargjøre og administrere skyinfrastruktur.
Hvorfor jeg valgte DuploCloud
DuploCloud får en plass på kortlisten min fordi det er den eneste plattformen der jeg kan klargjøre skyinfrastruktur og overvåke den på samme sted. Jeg liker at pakken for avansert observabilitet legger Grafana-dashbord, Loki-basert loggkorrelasjon og OpenTelemetry-sporing direkte oppå infrastrukturen jeg allerede administrerer, slik at jeg kan sammenligne måledata før og etter en distribusjon uten å bytte verktøy når en distribusjon fører til en økning i feilraten. Kartleggingen av tjenesteavhengigheter sporer langsomme eller mislykkede transaksjoner tilbake til den nøyaktige tjenesten eller infrastrukturkomponenten som forårsaker problemet.
Viktige funksjoner i DuploCloud
- OpenTelemetry-basert distribuert sporing: Samler inn og korrelerer sporingsdata på tvers av distribuerte tjenester ved hjelp av OpenTelemetry Operator med annotasjonsbasert automatisk instrumentering for .NET, Java, Node.js, Python og Go.
- Loggaggregering med Grafana Loki: Fanger opp logger med automatisk tagging av Kubernetes-metadata og støtter direkte loggstrømming, filtrering etter tidsrom og direkte navigering fra en loggoppføring til det tilknyttede sporet.
- Varsling ved avviksdeteksjon: Overvåker viktige signaler som feilrater og ventetid i sanntid og utløser tilpassbare terskel- eller avviksbaserte varsler når måledata avviker fra forventede mønstre.
- Observabilitetsdashbord per leietaker: Tilbyr Grafana-dashbord for hver leietaker, med visning av skyforbruk, Kubernetes-måledata, logger, sporingsdata og profiler i én samlet visning.
Integrasjoner med DuploCloud
DuploCloud dokumenterer integrasjoner med Prometheus, Grafana, OpenSearch, Datadog, Kubernetes, Terraform, AWS, Azure og Google Cloud Platform. Plattformen støtter CI/CD-arbeidsflyter gjennom REST API-er, inkludert Jenkins, GitHub Actions, Bitbucket og Azure DevOps.
Pros and Cons
Pros:
- Selvbetjening for utviklere reduserer flaskehalser i distribusjoner
- Korrelert telemetri gjør undersøkelser av rotårsaker raskere
- Dashbord for leietakere kombinerer forbruk og tjenestetilstand
Cons:
- Standard overvåking mangler APM og omfattende varsling
- Uvanlige Kubernetes-oppsett kan kreve omveier
Learn more about DuploCloud: Best for overvåking av reelle brukere
- 30 dagers gratis prøveperiode + gratis demonstrasjon tilgjengelig
- Fra $10/måned (fakturert årlig)
Visit WebsiteCustomer Rating:4.7/5
Site24x7 tilbyr tilpassbare instrumentpaneler der DevOps-team kan skreddersy overvåkingsvisningene etter sine spesifikke behov. Site24x7 er en skybasert overvåkingsløsning utviklet for DevOps- og IT-driftsteam. Den tilbyr omfattende overvåkingsfunksjoner for nettsteder, servere, nettverk, applikasjoner og skytjenester. Med Site24x7 kan du få sanntidsinnsikt i ytelsen og tilstanden til IT-infrastrukturen din.
Hvorfor jeg valgte Site24x7: Jeg liker funksjonen for overvåking av applikasjonsytelse (APM). Dette verktøyet hjelper deg med å identifisere og feilsøke ytelsesproblemer i applikasjonene dine ved å gi detaljert innsikt i transaksjonsspor, databasespørringer og applikasjonskomponenter. En annen verdifull funksjon er overvåking av reelle brukere (RUM). RUM lar deg spore og analysere opplevelsene til faktiske brukere på nettstedene og nettapplikasjonene dine. Ved å forstå hvordan brukerne samhandler med tjenestene dine, kan du ta informerte beslutninger for å forbedre brukervennligheten og ytelsen.
Fremtredende funksjoner og integrasjoner i Site24x7
Funksjoner omfatter syntetisk overvåking av netttransaksjoner, som lar deg simulere brukerinteraksjoner for å identifisere potensielle problemer før de påvirker faktiske brukere. I tillegg gir nettverksovervåking innsyn i tilstanden til nettverksenhetene dine, slik at du kan opprettholde påliteligheten. Loggbehandling er en annen funksjon som gjør det mulig å samle inn og analysere logger fra ulike kilder, noe som legger til rette for effektiv feilsøking og problemløsning.
Integrasjoner omfatter ServiceNow, PagerDuty, Jira, Microsoft Teams, Slack, Nagios, AWS, Azure, Google Cloud Platform, Docker, Jenkins og Kubernetes.
Pros and Cons
Pros:
- Tilbyr sanntidsvarsler på tvers av ulike kanaler
- Tilpassbare instrumentpaneler og rapporter
- Omfattende overvåking av ulike systemer
Cons:
- For mange varsler kan virke overveldende for brukerne
- Kompleks innledende konfigurering for store miljøer
Learn more about Site24x7: Best for overvåking av flere skyer
- Gratis abonnement + 30 dagers prøveperiode tilgjengelig
- Fra $395/år (fakturert årlig)
Visit WebsiteCustomer Rating:4.3/5
Robust plattform for administrasjon av applikasjonsytelse med omfattende overvåkingsfunksjoner og tredjepartsintegrasjoner for bedre IT-innsikt. ManageEngine Applications Manager er et omfattende verktøy som tilbyr overvåking av flere skyer, slik at brukere kan overvåke, administrere, revidere og sikre flersky- og hybridinfrastrukturen sin. Det unike salgsargumentet er evnen til å tilby en samlet løsning for overvåking og administrasjon av flerskymiljøer, noe som gjør det til det beste valget for virksomheter som ønsker å effektivisere arbeidet med flerskyovervåking.
Hvorfor jeg valgte ManageEngine Applications Manager: ManageEngine Applications Manager utmerker seg ved å tilby robuste funksjoner som muliggjør kontinuerlig overvåking, ytelsesanalyse og feilsøking gjennom hele DevOps-pipelinen. Det støtter en proaktiv tilnærming til hendelseshåndtering, muliggjør automatisering av rutinekontroller og tilbyr detaljert analyse for å forbedre beslutningstakingen. Evnen til sømløs integrasjon med ulike verktøy for utvikling, testing og distribusjon gjør det til en verdifull ressurs for DevOps-team som ønsker høy effektivitet og minimal nedetid.
Fremtredende funksjoner og integrasjoner i ManageEngine Applications Manager
Funksjoner omfatter omfattende innebygd støtte for overvåking av mer enn 100 applikasjoner og servere, fra databaser, webservere, applikasjonsservere og virtuelle servere til skyplattformer, containere og mikrotjenestearkitekturer. I tillegg har ManageEngine Applications Manager avanserte funksjoner for analyse av rotårsaker, drevet av maskinlæringsalgoritmer.
Integrasjoner omfatter Amazon Web Services (AWS), Microsoft Azure, Google Cloud Platform, Oracle Database, MySQL, Microsoft SQL Server, VMware, Docker, Apache Tomcat og Redis.
Pros and Cons
Pros:
- Omfattende overvåkingsfunksjoner på tvers av applikasjoner, servere og skymiljøer
- Tilpassbare dashbord og rapporter for innsiktsfull analyse
- Automatisert avviksdeteksjon og varslingsmekanismer
Cons:
- Kan være komplisert å konfigurere og tilpasse til spesifikke behov
- Kostnaden kan være uoverkommelig for små og mellomstore virksomheter
Learn more about ManageEngine Applications Manager: Best for innsikt i infrastruktur i sanntid
- 14-dagers gratis prøveperiode + gratisabonnement + gratis demo tilgjengelig
- Fra $4.50/node/month (fakturert årlig)
Visit WebsiteCustomer Rating:4.8/5
Netdata tilbyr helautomatiserte oversikter som visualiserer alle måledata. Netdata er en åpen kildekodebasert plattform for overvåking og feilsøking som tilbyr høyoppløselige måledata, journallogger og visualiseringer i sanntid for systemovervåking. Målet er å tilby et kostnadseffektivt og brukervennlig alternativ til dyrere og mer komplekse plattformer.
Hvorfor jeg valgte Netdata: Jeg liker at plattformen legger vekt på data med høy nøyaktighet og tilbyr visualiseringer i sanntid, slik at brukerne kan overvåke systemytelse og -tilstand med presisjon. Den forenkler og forbedrer også overvåkingsprosessen for DevOps med funksjoner for innsamling, lagring, spørring, visualisering og varsling for et bredt spekter av måledata. Netdata kan kjøres på flere noder, og hver Netdata-instans kan operere autonomt.
Fremtredende funksjoner og integrasjoner i Netdata
Funksjoner inkluderer varsler som informerer brukerne om problemer som oppdages i systemet, automatisk avviksdeteksjon samt automatiserte og tilpassbare oversikter. I tillegg er kjernen i Netdata-økosystemet åpen kildekode, og den inkluderer alle overvåkingsfunksjonene, som databasen, spørringsmotoren, rangeringsmotoren, helsemotoren og maskinlæringsmotoren.
Integrasjoner inkluderer containere, Kubernetes-containere, virtuelle maskiner, Apache, Consul, Elasticsearch, OpenSearch, MySQL, Redis, Squid-loggfiler, Windows, macOS og hundrevis av andre.
Pros and Cons
Pros:
- Automatiserte varsler
- Ubegrenset overvåking av måledata
- Interaktive grafer for datavisualisering
Cons:
- Det kan kreve litt tid å lære for å utnytte funksjonene maksimalt
- Innsikten kunne vært mer omfattende
Learn more about Netdata: Best for overvåking av SSL-sertifikater
- Gratisabonnement + gratis demo tilgjengelig
- Fra $8/10 monitorer/måned (fakturert årlig)
Visit WebsiteCustomer Rating:4.7/5
UptimeRobot sporer SSL-sertifikatstatus og oppetid i ett sanntidsdashbord. For DevOps-team som søker en pålitelig overvåkingsløsning, tilbyr UptimeRobot et praktisk alternativ som støtter overvåking av SSL-sertifikater i tillegg til oppetidssjekker. Det passer for team av alle størrelser, fra enkeltpersoner til større organisasjoner, som trenger innsikt i tjenestetilgjengelighet og endepunktytelse. Ved å hjelpe team med å oppdage problemer som utløpte sertifikater, nedetid og langsomme svartider, bidrar UptimeRobot til stabil drift og konsekvent tjenesteleveranse.
Hvorfor jeg valgte UptimeRobot
Jeg valgte UptimeRobot på grunn av overvåkingen av SSL-sertifikater, som hjelper DevOps-team med å unngå problemer forårsaket av utløpte eller feilkonfigurerte sertifikater. Det sporer sertifikatstatus og sender varsler før utløp, noe som reduserer risikoen for sikkerhetsvarsler eller tjenesteavbrudd. UptimeRobot tilbyr også nedetidsvarsler gjennom integrasjoner som Slack og PagerDuty, slik at team enklere kan reagere raskt og holde tjenestene pålitelige.
Viktige funksjoner i UptimeRobot
I tillegg til overvåking av SSL-sertifikater tilbyr UptimeRobot:
- Sjekker fra flere lokasjoner: Overvåk tjenestene dine fra flere globale lokasjoner for å sikre tilgjengelighet over hele verden.
- Overvåking av svartid: Følg med på hvor raskt serveren svarer, for å få innsikt i ytelsesflaskehalser.
- Tilpassbare statussider: Del statusoppdateringer i sanntid med brukere gjennom profilerte statussider.
- Hendelseshåndtering: Håndter og løs hendelser effektivt med tilpassbare varsler og tilgangsnivåer for teamet.
Integrasjoner med UptimeRobot
Integrasjonene omfatter Slack, PagerDuty, Microsoft Teams, Telegram, Discord, Splunk On-Call og flere, slik at du kan håndtere varsler sømløst på tvers av kommunikasjonsplattformene du foretrekker.
Pros and Cons
Pros:
- Sanntidsvarsler sikrer rask respons på problemer med nedetid
- SSL-overvåking bidrar til å opprettholde nettstedssikkerheten på en effektiv måte
- Støtter flere varslingskanaler
Cons:
- Begrensede tilpasningsmuligheter i varslingsinnstillingene sammenlignet med konkurrentene
- Ikke egnet for komplekse DevOps-stakker
Learn more about UptimeRobot: Best for ende-til-ende-ytelsesovervåking for store virksomheter
- 15 dagers gratis prøveperiode
- Fra $0.08/8 GB/time
Visit WebsiteCustomer Rating:4.5/5
Dynatrace gjør det mulig å overvåke ytelsesmålingene for hele stakken din via ett enkelt instrumentpanel. Dynatrace er en løsning for overvåking av applikasjonsytelse (APM) som bruker en innebygd AI-løsning for å hjelpe DevOps-team med å finne ytelsesproblemer. Den utmerker seg innen overvåking av miljøer på flere plattformer, inkludert flersky, containere, mikrotjenester og brukeropplevelse.
Hvorfor jeg valgte Dynatrace: Jeg valgte Dynatrace på grunn av den grundige ytelsesovervåkingen, som er ideell for store virksomheter. Den gir detaljert innsyn i kunder, hybride miljøer og alle aspekter ved infrastrukturen din.
Dynatraces fremtredende funksjoner og integrasjoner:
Funksjonene jeg likte, var de som prioriterer ytelsesfunksjoner, for eksempel infrastrukturovervåking og applikasjonsovervåking. I tillegg bruker Dynatrace AI til kontinuerlig å søke etter ytelsesproblemer og finne rotårsaken.
Integrasjoner som Dynatrace samarbeider med, inkluderer Akamas, GitLab, Gremlin, NeoLoad, LaunchDarkly, xMatters, JFrog og PagerDuty ved hjelp av innebygde integrasjoner.
Pros and Cons
Pros:
- Bruker en AI-assistent for å forbedre feilsøking og hjelpe med problemløsning
- Bred observasjonsdekning som går helt ned på kodenivå
- Svært aktiv brukerstøtte som kan svare på alle spørsmål hvis du står fast
Cons:
- Læringskurve for å bruke Dynatrace effektivt
- Prisen gjør løsningen mindre attraktiv for mange små og mellomstore virksomheter
 Best for overvåking av serverforstyrrelser og driftsstanser
- 14 dagers gratis prøveperiode
- Fra $21/bruker/måned
Visit WebsiteCustomer Rating:4.5/5
Du kan overvåke og beregne prosentandeler for mislykkede API-forespørsler i PagerDuty. PagerDuty er en plattform for hendelsesrespons som sender varsler når det oppstår et tjenesteavbrudd eller en driftsstans. I kritiske øyeblikk kan den sende e-postvarsler, SMS-varsler og telefonvarsler til utviklingsteamet eller kundebasen din.
Hvorfor jeg valgte PagerDuty: Jeg valgte PagerDuty fordi det er et utmerket verktøy hvis du kjører virksomhetskritisk infrastruktur som du ønsker å holde oversikt over. Plattformen gjør det mulig å motta varsler om beredskapsvakter umiddelbart.
PagerDuty-funksjoner og integrasjoner som skiller seg ut:
Funksjonene som skilte seg ut for meg som de mest nyttige, er 100 % rettet mot å varsle team i tilfeller der systemer, noder eller applikasjonstjenester svikter, og omfatter e-postvarsler, mobilvarsler, rotårsaksanalyse, sanntidsvarsler og prioritering. Du kan også planlegge og eskalere problemer automatisk.
Integrasjoner omfatter ferdigbygde programtillegg for AWS, ServiceNow, Salesforce, Zendesk, Atlassian, Datadog, Slack, Splunk og flere.
Pros and Cons
Pros:
- Lar deg tildele hendelsesrespons til riktig person eller team
- Tilpassbare varsler kan sendes via e-post, telefon, SMS eller push-varsler
- Filtrerer varsler for å prioritere viktige varsler som indikerer reelle trusler, samtidig som falske alarmer reduseres
Cons:
- Det kan være vanskelig å finne historiske varsler med mindre du har en nøyaktig ID
- Bruker et konvensjonelt dashbord som kunne vært mer tilpassbart for spesifikke behov og preferanser
Learn more about PagerDuty: Best for kontinuerlig overvåking av store portnettverk
- 30 dagers gratis prøveperiode
- Fra $1,995/bruker
Visit WebsiteCustomer Rating:4.6/5
Her kan du overvåke båndbredde og portstatus i Nagios. Nagios er en åpen kildekode-programvare som overvåker nettverkstrafikk kontinuerlig. Den kan spore båndbreddebruk per port for innkommende og utgående trafikk, oppdage nettverksavbrudd, identifisere overbelastede porter og finne nettverksmisbrukere.
Hvorfor jeg valgte Nagios: I stedet for å utsette systemene mine for sårbarheter eller bekymre meg for treg nettverksytelse, gir Nagios DevOps-teamet mitt umiddelbar oversikt over nettverket vårt. Jeg likte også at det logger informasjon som problemer med nettverksinfrastrukturen og prosesser som har mislyktes, per port.
Nagios' fremtredende funksjoner og integrasjoner
Funksjonene som tilbys av Nagios, sørger for sikkerheten til nettverksportene mine. Dette omfatter SNMP-overvåking, overvåking av svitsjer og rutere, nettverksovervåking og ping-overvåking, noe som hjelper meg med å opprettholde integriteten og sikkerheten til nettverksinfrastrukturen min.
Integrasjoner som er forhåndsbygd, omfatter Amazon SNS, Prometheus, PagerDuty, Dynatrace og flere. Nagios har også over 3 000 offisielle programtillegg og programtillegg fra fellesskapet som utviklere kan legge til i teknologistakken sin.
Pros and Cons
Pros:
- Åpen kildekode-versjonen er 100 % gratis
- Lite ressurskrevende
- Øker tilgjengeligheten til hele nettverksinfrastrukturen ved protokollfeil og nettverksavbrudd
Cons:
- Separate lisenser kreves for funksjoner for sikkerhet og nettverkssynlighet
- Bruker filer i stedet for databaser til å lagre konfigurasjonsfiler i systemets bakende
Learn more about Nagios: Best for ytelsesovervåking av nettsteder og mobilapper
- 15 dagers gratis prøveperiode
- Fra $6/kjerne/måned
Visit WebsiteCustomer Rating:4.3/5
AppDynamics kan overvåke historiske betalingsdetaljer og gi data om forholdet mellom brukerinnlogginger. AppDynamics er et verktøy for administrasjon av applikasjonsytelse i hele teknologistakken. Det bruker maskinlæringsalgoritmer til å oppdage ytelsesproblemer, sammenligne dem med grunnlinjemålinger og utløse varsler ved behov.
Hvorfor jeg valgte AppDynamics: Jeg valgte AppDynamics fordi det fokuserer på applikasjonsytelse, samtidig som det bruker overvåking for å sikre en optimal brukeropplevelse. Enten du administrerer et nettsted eller en mobilapp, sørger AppDynamics for at kundene dine ikke opplever problemer som tidsavbrudd eller langsomme sideinnlastingstider.
Fremtredende funksjoner og integrasjoner i AppDynamics:
Funksjoner som jeg fant ut at gjør AppDynamics utmerket for ytelsesovervåking, inkluderer overvåking av applikasjonsytelse (APM) og infrastruktursynlighet med databasesynlighet. I tillegg fanget overvåking av sluttbrukere også interessen min, siden det sikrer at kundene dine får de raskest mulige applikasjonshastighetene.
Integrasjoner som AppDynamics samarbeider med, inkluderer ferdigbygde programtillegg som LoadRunner, Sainapse og NeoLoad for ytelse og kontinuerlig levering. AppDynamics samarbeider også med SquaredUp, Medallia og Quantum Metric for å overvåke kundeopplevelsen.
Pros and Cons
Pros:
- Gir sanntidsinformasjon om prosesser som bruker CPU og minne
- Overvåkingsdybden for webapplikasjoner og infrastruktur er enorm
- Nettverkssynlighet gjør det mulig å se hvor mye båndbredde som brukes per node
Cons:
- Funksjonaliteten kan være overveldende for små bedrifter
- Ingen automatisk applikasjonsskanning; de må defineres i en konfigurasjonsfil
Learn more about AppDynamics:
Andre verktøy for DevOps-overvåking
Her er noen andre verktøy som ikke helt kom med blant de 12 beste, men som absolutt er verdt å undersøke:
- 11New RelicBest for fullstack-observerbarhet i SaaS
- 12SplunkBest for overvåking og søk i store datamengder
- 13PrometheusBest for varsler og aggregering av måledata
- 14Grafana CloudBest for overvåking av dataanalyse og visualisering
- 15BuddyBest for overvåking av nettsteder og mobilapper for små bedrifter
- 16InfluxDBBest for overvåking av tidsseriedata i én database for flere formål
- 17SensuBest for overvåking av skymiljøer
- 18ChaosSearchBest for å sentralisere logg- og hendelsesdata i skyen
- 19Dotcom MonitorBest for overvåking av kritiske arbeidsflyter
Relaterte anmeldelser av programvare og verktøy
Hvis du fortsatt ikke har funnet det du leter etter her, kan du se nærmere på disse andre typene verktøy som vi har testet og vurdert.
- Programvare for nettverksovervåking
- Programvare for serverovervåking
- SD-WAN-løsninger
- Verktøy for infrastrukturovervåking
- Pakkesniffer
- Verktøy for applikasjonsovervåking
Slik evaluerer jeg verktøy for DevOps-overvåking
Jeg evaluerer disse verktøyene i to lag: grunnleggende krav som inntak av måledata, distribuert sporing og ruting av varsler, og deretter differensierende faktorer som avgjør hvor godt de passer til teknologistakken og teamet ditt.
Kjernefunksjonalitet (grunnleggende krav for denne listen)
Når jeg velger ut verktøy til listen min, rangerer jeg hvert av dem på en skala fra 0 (tilbyr ikke funksjonaliteten) til 5 (utmerker seg på dette området) for hver av kjernefunksjonene nedenfor. Deretter beregner jeg verktøyets totalscore som en prosentandel. Hvert verktøy må oppnå en minimumsscore på 75 % totalt for å bli vurdert for inkludering.
- Infrastruktur- og applikasjonsovervåking: Jeg evaluerer om et verktøy kan overvåke verter, containere, databaser og applikasjonstjenester på ett sted, for eksempel ved å følge med på CPU-topper på Kubernetes-noder samtidig som API-forsinkelse overvåkes.
- Observasjon på tvers av hele teknologistakken: Logger, måledata og spor bør korreleres på tvers av tjenester, slik at du kan følge en langsom forespørsel fra en frontend-feil via hopp mellom mikrotjenester til den underliggende årsaken.
- Varsling i sanntid og hendelseshåndtering: Jeg ser etter konfigurerbare varslingsbetingelser, eskaleringsregler og ruting til verktøy som PagerDuty eller Slack, slik at vaktgående ingeniører blir varslet gjennom riktig kanal.
- Overvåking av CI/CD-pipeliner: Distribusjonssporing er viktig her. Jeg ser etter innsyn i byggestadier, feilrater og muligheten til å korrelere en mislykket distribusjon med en produksjonshendelse.
- Integrasjoner med DevOps-verktøykjeden: Verktøyet bør kunne kobles til den eksisterende teknologistakken din. Jeg ser etter innebygde koblinger til Kubernetes, Terraform, Jenkins, GitHub og de største skyleverandørene.
- Avviksdeteksjon og analyse av underliggende årsak: Jeg evaluerer om verktøyet går lenger enn statiske terskelverdier. Maskinlæringsbasert avviksdeteksjon og hendelseskorrelasjon hjelper SRE-er med å filtrere bort varslingsstøy under driftsavbrudd.
Når jeg har en liste over verktøy som oppfyller disse kriteriene, vurderer jeg hva som skiller hver plattform fra de andre.
Forskjellsskapende faktorer (det som skiller leverandørene fra hverandre)
Slik sammenligner jeg ulike leverandører:
Fremtredende funksjoner
Sporing av SLO-er er en viktig forskjellsskapende faktor. Jeg ser etter verktøy som lar SRE-team definere feilbudsjetter og overvåke forbrukstakten, slik at beslutninger om pålitelighet forblir datadrevne i stedet for reaktive. Syntetisk overvåking er også viktig – simulering av API-kall eller brukerflyter fra flere regioner avdekker forsinkelsesproblemer før virkelige brukere opplever dem. RUM utfyller dette ved å registrere faktisk ytelse i nettlesere og på mobile enheter, slik at du får et helhetlig bilde av hvordan en distribusjon påvirker sluttbrukeropplevelsen.
Mer enn funksjoner
Forutsigbarhet i prisingen er noe jeg vurderer nøye. Noen verktøy fakturerer per vert, mens andre tar betalt basert på datamengde, og kostnadene for loggoppbevaring kan øke kraftig når du samler inn terabyte med data fra en stor Kubernetes-klynge. Støtte for OpenTelemetry er en annen faktor jeg undersøker, siden bruk av åpne standarder beskytter teamet ditt mot leverandørbinding dersom behovene endrer seg. Jeg vurderer også tiden til verdi: Automatisk instrumentering og forhåndsbygde kontrollpaneler kan være forskjellen mellom å komme i produksjon på noen dager og å bruke flere uker på manuelt oppsett.
Slik velger du verktøy for DevOps-overvåking
Det er lett å gå seg vill i lange funksjonslister og komplekse prismodeller. For å hjelpe deg med å holde fokus mens du arbeider deg gjennom den unike prosessen med å velge programvare, får du her en sjekkliste over faktorer du bør ha i bakhodet:
| Faktor | Hva bør vurderes |
|---|---|
| FaktorSkalerbarhet | Hva bør vurderesKontroller at verktøyet kan håndtere økende arbeidsmengder og flere brukere uten å miste ytelse. Skybaserte alternativer med automatisk skalering kan bidra til å håndtere vekst. |
| FaktorIntegrasjoner | Hva bør vurderesKontroller om verktøyet integreres med den eksisterende DevOps-stakken, inkludert CI/CD-pipelines, skytjenester og plattformer for hendelseshåndtering. |
| FaktorTilpasningsmuligheter | Hva bør vurderesSe etter muligheter for å justere overvåkingsinnstillinger, varselterskler og dashbord slik at de passer teamets arbeidsflyter og prioriteringer. |
| FaktorBrukervennlighet | Hva bør vurderesVerktøyet bør ha et tydelig grensesnitt og intuitive kontroller, slik at teamet raskt kan oppdage problemer og reagere på dem. Kompliserte oppsett kan forsinke responstidene. |
| FaktorBudsjett | Hva bør vurderesSammenlign abonnementskostnader, lisensavgifter og ekstrakostnader for avanserte funksjoner eller økte datagrenser. Vær oppmerksom på skjulte kostnader. |
| FaktorSikkerhetstiltak | Hva bør vurderesSe etter kryptering, tilgangskontroller og sikker dataoverføring for å beskytte sensitiv informasjon og forhindre datainnbrudd. |
| FaktorSanntidsvarsler | Hva bør vurderesVerktøyet bør gi umiddelbare varsler om ytelsesproblemer eller driftsstans, slik at teamet kan handle raskt og minimere nedetid. |
| FaktorDatalagring og rapportering | Hva bør vurderesSørg for at verktøyet lagrer historiske data lenge nok til meningsfull analyse og identifisering av trender. Eksporterbare rapporter er nyttige for teamgjennomganger. |
Trender innen DevOps-overvåkingsverktøy
I undersøkelsen min hentet jeg inn utallige produktoppdateringer, pressemeldinger og utgivelseslogger fra ulike leverandører av DevOps-overvåkingsverktøy. Her er noen av de fremvoksende trendene jeg følger med på:
Forbedret avviksdeteksjon: Nye maskinlæringsmodeller forbedrer avviksdeteksjonen, hjelper team med å oppdage uregelmessige mønstre i sanntid og reduserer falske positiver.
Helhetlig systeminnsikt: Leverandører går lenger enn grunnleggende overvåking for å gi et komplett bilde av infrastruktur, applikasjoner og brukeropplevelse på ett sted. Dette gjør det enklere å identifisere og løse problemer. Når du vurderer plattformer for systeminnsikt, bør du se etter løsninger som tilbyr omfattende overvåkingsfunksjoner.
AI-drevet innsikt: Flere verktøy bruker AI til å analysere data og forutsi ytelsesproblemer før de oppstår. Dette hjelper team med å handle proaktivt i stedet for å reagere på feil.
Distribuert sporing: Verktøy legger til sporingsfunksjoner som lar team følge forespørsler på tvers av mikrotjenester og containere. Dette gjør det enklere å finne ut hvor forsinkelser eller feil oppstår.
Selvhelbredende systemer: Noen verktøy tilbyr nå automatisert utbedring, der systemet kan oppdage et problem og løse det uten menneskelig inngripen. Dette reduserer nedetid og responstid.
Hva er DevOps-overvåkingsverktøy?
DevOps-overvåkingsverktøy er spesialiserte programvareløsninger som er utviklet for å spore og analysere ytelsen og tilstanden til applikasjoner og infrastruktur i sanntid. Disse verktøyene brukes hovedsakelig av DevOps-ingeniører, systemadministratorer og IT-fagfolk for å sikre sømløs drift og levering av programvareprodukter.
DevOps-overvåkingsverktøy bidrar til å automatisere overvåkingsprosessen, gir innsikt i systemytelsen og gjør det mulig å raskt identifisere og løse problemer før de påvirker produksjonsmiljøet. Funksjoner som sanntidsvarsler, verktøy for datainnsikt og prediktiv analyse støtter proaktiv problemløsning og forbedrer driftseffektiviteten.
Funksjoner
Her er noen av de viktigste funksjonene jeg ser etter i DevOps-overvåkingsverktøy når jeg vurderer dem for listen min:
- Sanntidsvarsler og -meldinger: Denne funksjonen sikrer umiddelbar oversikt over problemer når de oppstår. Den er avgjørende for å begrense problemer raskt og forhindre at mindre problemer utvikler seg til større driftsavbrudd.
- Omfattende dashbord: Dashbord gir en samlet oversikt over alle måleverdier og logger. De er avgjørende for å visualisere tilstanden til utviklingsprosessen og applikasjonenes tilstand, noe som gjør det enklere å identifisere trender og potensielle problemer.
- Tilpassbare måleverdier: Tilpasningsmuligheter for overvåking av spesifikke måleverdier. Ved å tilpasse måleverdiene til spesifikke behov blir overvåkingen mer målrettet, slik at teamene kan følge med på ytelsesindikatorene som er mest relevante for prosjektene deres.
- Loggbehandling og -analyse: Effektiv loggbehandling og analytiske funksjoner. Analyse av logger bidrar til å diagnostisere problemer og forstå applikasjonenes atferd, noe som er avgjørende for feilsøking og optimalisering.
- Skalerbarhet: Muligheten til å skalere overvåkingsløsninger etter hvert som prosjektene vokser. Skalerbarhet sikrer at overvåkingsverktøyet kan håndtere økt belastning og forhindrer redusert ytelse over tid.
- Integrasjonsmuligheter: Muligheten til å integrere med et bredt utvalg av API-overvåkingsverktøy og plattformer. Denne funksjonen muliggjør sømløst samarbeid på tvers av verktøyene som brukes i utviklingsprosessen, og forbedrer effektiviteten i arbeidsflyten og datakonsistensen.
- Sikkerhets- og samsvarsfunksjoner: Innebygde sikkerhetstiltak og rapportering av samsvar. Disse funksjonene bidrar til å beskytte sensitive data og sikre at utviklingsprosessen oppfyller regulatoriske krav.
- Automatisert hendelseshåndtering: Automatisering av prosessen for håndtering av hendelser. Ved å håndtere hendelser automatisk kan teamene redusere nedetid og forbedre responstidene, noe som fører til mer pålitelige applikasjoner.
- Støtte for skybaserte miljøer: Optimalisert for overvåking av skybaserte miljøer. Siden mange applikasjoner nå driftes i skyen, sikrer innebygd støtte at overvåkingen er effektiv i disse miljøene.
- Helhetlig oversikt: Muligheten til å overvåke alle aspekter av utviklingsprosessen. Denne funksjonen gir en helhetlig oversikt over prosessen, fra kodeinnsjekkinger til utrulling, noe som er avgjørende for å forstå virkningen av endringer og identifisere flaskehalser.
Fordeler
Overvåkingsverktøy spiller en viktig rolle i DevOps-økosystemet. De bidrar ikke bare til å identifisere og løse problemer raskt, men gir også innsikt som kan føre til mer informerte beslutninger og bedre samlet ytelse. Her er noen flere konkrete fordeler ved disse verktøyene for DevOps-teamet ditt:
- Forbedret driftseffektivitet: DevOps-overvåkingsverktøy automatiserer sporing og analyse av ulike måleverdier og logger i hele utviklingsprosessen. Denne automatiseringen frigjør verdifull tid for teamene, slik at de kan konsentrere seg om mer strategiske oppgaver i stedet for manuell overvåking og feilsøking.
- Forbedret systempålitelighet: Ved å tilby sanntidsvarsler og -meldinger gjør disse verktøyene det mulig for teamene å oppdage og håndtere problemer raskt, før de utvikler seg til mer alvorlige problemer. Denne muligheten for umiddelbar respons reduserer nedetiden betydelig og sikrer at systemene forblir stabile og pålitelige.
- Proaktiv problemløsning: Bruk av prediktiv analyse og avviksdeteksjon hjelper organisasjoner med å forutse problemer før de oppstår. Ved å identifisere potensielle problemer på forhånd kan teamene iverksette proaktive tiltak, forhindre avbrudd og opprettholde stabil drift.
- Optimalisert ytelse: Database-DevOps-verktøy gir innsikt i applikasjons- og infrastrukturytelse og identifiserer flaskehalser og forbedringsområder. Denne informasjonen gjør det mulig for teamene å optimalisere systemene for bedre ytelse, noe som forbedrer brukeropplevelsen og driftseffektiviteten.
- Styrket sikkerhet: Med funksjoner rettet mot overvåking av sikkerhetsmåleverdier og samsvarsstandarder spiller disse verktøyene en avgjørende rolle i å identifisere sårbarheter og sikre at systemene følger beste praksis for sikkerhet. Denne styrkede sikkerheten beskytter mot datainnbrudd og opprettholder integriteten til organisasjonens data og systemer.
Kostnader og priser
Med en rekke tilgjengelige abonnementsalternativer kan en forståelse av prisene og funksjonene i hvert alternativ hjelpe programvarekjøpere med å ta en informert beslutning som samsvarer med behovene og budsjettet deres. Fra gratisversjoner utviklet for små prosjekter til abonnementer på bedriftsnivå med avanserte funksjoner finnes det overvåkingsverktøy for alle driftsstørrelser.
Sammenligningstabell for abonnementer for DevOps-overvåkingsverktøy
Nedenfor finner du en detaljert oversikt over vanlige abonnementsalternativer og priser for DevOps-overvåkingsverktøy, med mål om å hjelpe dem som er nye i denne programvarekategorien, med å vurdere alternativene sine.
| Plantype | Gjennomsnittspris | Vanlige funksjoner |
|---|---|---|
| PlantypeGratis | Gjennomsnittspris$0 | Vanlige funksjonerGrunnleggende overvåkingsfunksjoner, begrensede måledata og logger, brukerstøtte fra fellesskapet, tilgang til forum |
| PlantypeGrunnleggende | Gjennomsnittspris$20-$50/user/month | Vanlige funksjonerForbedrede overvåkingsfunksjoner, flere måledata og logger, e-poststøtte, integrasjon med andre verktøy |
| PlantypeStandard | Gjennomsnittspris$50-$100/user/month | Vanlige funksjonerKomplett overvåkingspakke, avansert analyse, støtte døgnet rundt, tilpassbare dashbord, integrasjonsalternativer |
| PlantypePremium | Gjennomsnittspris$100-$200/user/month | Vanlige funksjonerPremiumfunksjoner, inkludert prediktiv analyse, maskinlæringsfunksjoner, dedikert støtte, tilpassede integrasjoner |
| PlantypeBedrift | GjennomsnittsprisTilpasset pris | Vanlige funksjonerAlle Premium-funksjoner samt skaleringsalternativer, dedikert kundeansvarlig, sikkerhet på bedriftsnivå |
Vanlige spørsmål om DevOps-overvåkingsverktøy
Her er noen svar på vanlige spørsmål om DevOps-overvåkingsverktøy: