

Honeycomb ist ein Tool, das Einblicke in die internen Abläufe Ihres Systems bietet und Ihnen hilft, die Leistung zu optimieren und Probleme zu beheben.
Die Vorteile sind zahlreich: Sie können einzelne Ereignisse nachverfolgen, wodurch komplexe Systeme beobachtbar werden und Sie Ihre Software verstehen, aus ihr lernen und Fehler darin beheben können.
Dennoch kann es Situationen geben, in denen Sie eine Alternative zu Honeycomb suchen. Vielleicht verwenden Sie eine bestimmte Programmiersprache wie PHP oder benötigen ein Tool, das SOC-Konformität bietet. Möglicherweise möchten Sie Zugriff auf den Quellcode oder suchen nach einem anderen Funktionsumfang.
Was auch immer Ihre Gründe sind: Ich habe eine Liste der besten Honeycomb-Alternativen zusammengestellt, einschließlich Produktinformationen und Sternebewertungen, damit Sie die beste Lösung für Ihre spezifischen Anforderungen finden. Sehen wir uns diese Optionen also gemeinsam an.
Was ist Honeycomb?
Honeycomb ist eine Plattform für Beobachtbarkeit, die Ihnen hilft, Ihre Softwaresysteme in Echtzeit zu debuggen, zu überwachen und zu verstehen. Sie wird von Softwareentwicklern, DevOps-Teams und Site-Reliability-Ingenieuren eingesetzt, die Leistungsprobleme und ungewöhnliches Verhalten in Produktionsumgebungen schnell erkennen müssen. Einblicke auf Ereignisebene, Abfragen und Heatmaps helfen dabei, das Systemverhalten zu untersuchen, Engpässe zu erkennen und die Zuverlässigkeit von Anwendungen zu verbessern. Insgesamt vermittelt Honeycomb Ihrem Team ein klareres Bild davon, was in Ihrem Code geschieht, sodass Sie Probleme schneller beheben können.
Warum Sie unseren Software-Empfehlungen vertrauen können
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Unser Team testet und bewertet Software seit 2012. Als Tech-Führungskräfte wissen wir selbst, wie schwierig – und wichtig – es ist, die richtige Software auszuwählen.
Für diesen Leitfaden haben wir Tools mithilfe von praktischen Tests und unabhängiger Recherche bewertet und dabei unsere Bewertungskriterien angewendet.
Unsere Bewertungen spiegeln unser menschliches redaktionelles Urteilsvermögen wider, keine Verkaufsstrategie.
Expertenprüfer:
- Paulo Gardini MiguelTech-Direktor
 Tim FisherVP für KI
 Gabriel RosasTech Lead & Software-Architekt
 Christhian GruhnTech Lead & Plattform-Architekt

Vergleichstabelle der Honeycomb-Alternativen
Diese Vergleichstabelle fasst die Preisinformationen meiner besten ausgewählten Honeycomb-Alternativen zusammen:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Am besten für verteilte Ablaufverfolgung mit umfangreichem Kontext | Kostenloser Tarif verfügbar | Ab $26/Monat (jährlich abgerechnet) | Website | |
| 2 | Am besten geeignet für KI-gestützte automatisierte Überwachung des gesamten Stacks | 15-tägige kostenlose Testversion | $21/user/month für den Tarif zur Überwachung des gesamten Stacks (jährliche Abrechnung) | Website | |
| 3 | Am besten für einheitliche Traces, Protokolle und Metriken in einer Ansicht | Kostenloser Tarif verfügbar | $15/Benutzer/Monat (jährlich abgerechnet) | Website | |
| 4 | Am besten für Open-Source-Infrastrukturüberwachung in großem Maßstab | Kostenloser Tarif verfügbar | Preis auf Anfrage | Website | |
| 5 | Am besten für die durchgängige Verfolgung von Geschäftstransaktionen geeignet | 30-tägige kostenlose Testversion | $3300 pro Einheit pro Jahr (jährlich abgerechnet) | Website | |
| 6 | Am besten geeignet für Einblicke in die Anwendungsleistung und das Tracking des Endnutzererlebnisses | Kostenlose Testversion + kostenlose Demo verfügbar | $99/Monat für den Pro-Tarif (jährlich abgerechnet) | Website | |
| 7 | Am besten für cloudnative Protokollverwaltung und -analyse geeignet | 14-tägige kostenlose Testversion | Preise auf Anfrage | Website | |
| 8 | Am besten für volumenbasierte Protokollüberwachung und Warnmeldungen geeignet | 30-tägige kostenlose Testversion | Preise auf Anfrage | Website | |
| 9 | Am besten für operative Erkenntnisse auf Basis von Maschinendaten | 60-tägige kostenlose Testversion | $150/Monat (jährlich abgerechnet) | Website | |
| 10 | Am besten für Kubernetes-native Metriken und Warnüberwachung geeignet | Kostenloser Tarif verfügbar | Preis auf Anfrage | Website |


Bewertungen der besten Honeycomb-Alternativen
Nachfolgend finden Sie meine ausführlichen Zusammenfassungen der besten Honeycomb-Alternativen, die es in meine Auswahlliste geschafft haben. Meine Bewertungen bieten einen detaillierten Überblick über die wichtigsten Funktionen, Vor- & Nachteile, Integrationen und idealen Anwendungsfälle jedes Tools, damit Sie die beste Lösung für sich finden.
 Am besten für verteilte Ablaufverfolgung mit umfangreichem Kontext
- Kostenloser Tarif verfügbar
- Ab $26/Monat (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.5/5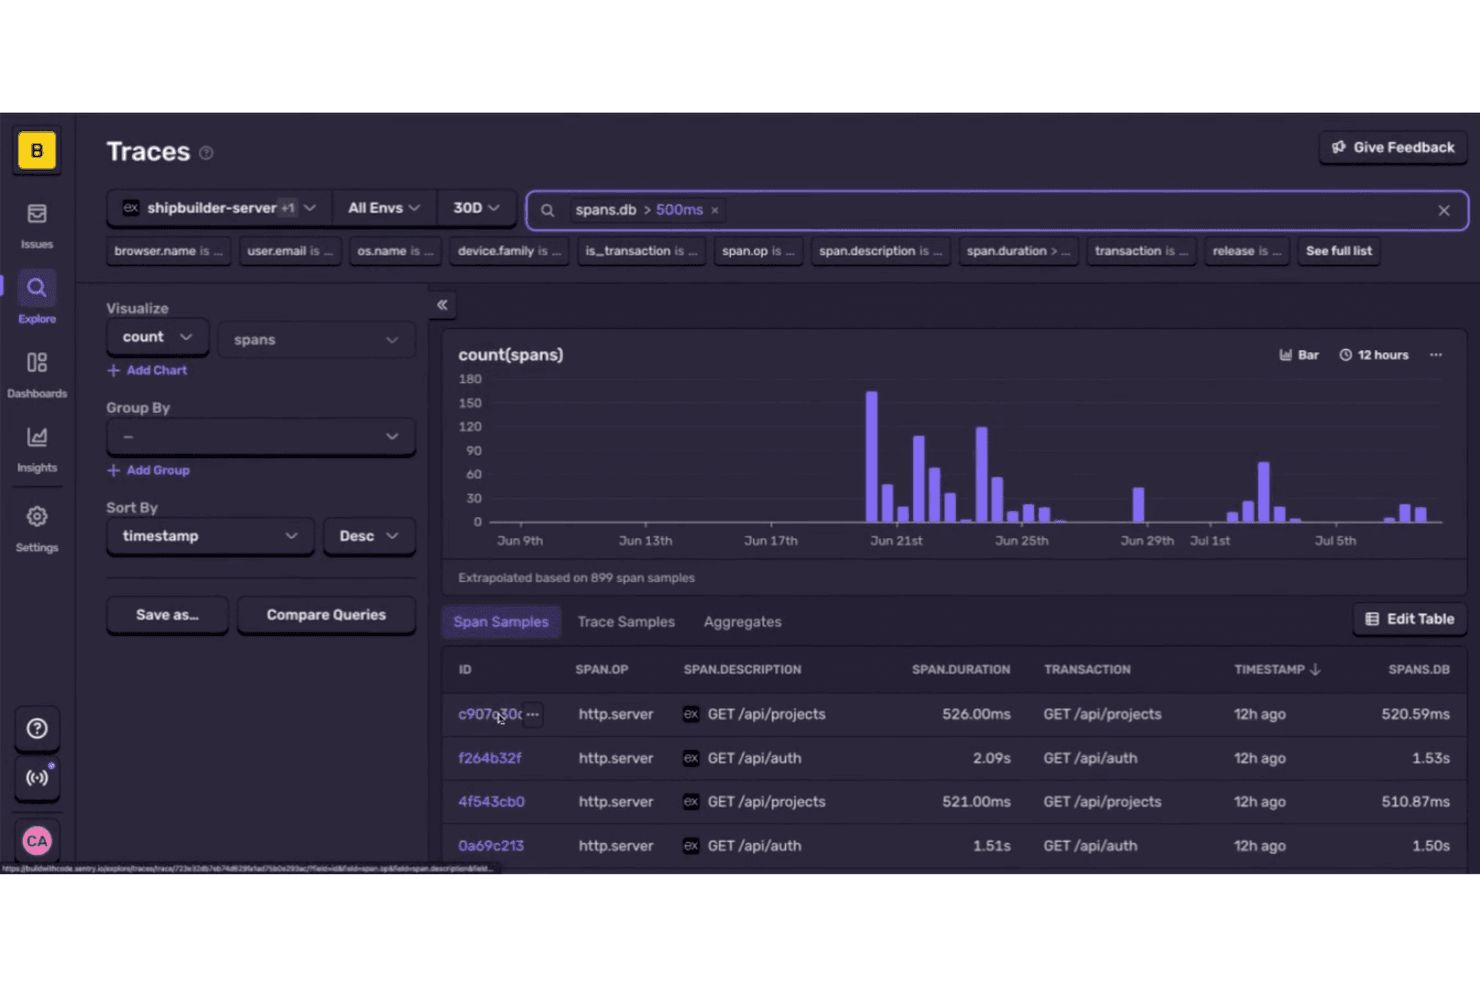
Sentry ermöglicht es Nutzern, langsame Datenbankabschnitte über verschiedene Dienste hinweg im Zeitverlauf zu verfolgen. Sentry ist eine Plattform zur Anwendungsüberwachung für Softwareteams, die Ingenieurinnen und Ingenieuren hilft, Fehler und Leistungsprobleme über verschiedene Dienste hinweg zu finden, Vorfälle zu diagnostizieren und deren Auswirkungen auf Nutzerinnen und Nutzer zu verringern.
Für wen ist Sentry am besten geeignet?
Entwicklungsteams, die verteilte Anwendungen betreiben und Ablaufverfolgungskontext benötigen, um Leistungsprobleme über verschiedene Dienste hinweg zu lokalisieren.
Warum ich Sentry ausgewählt habe
Ich habe Sentry als Honeycomb-Alternative ausgewählt, weil es sich am besten für verteilte Ablaufverfolgung mit umfangreichem Kontext eignet. Die Ablaufansicht bildet Abschnitte über verschiedene Dienste hinweg ab und verknüpft Fehler mit den Transaktionen, die sie ausgelöst haben. Ich finde hilfreich, dass sich dadurch genau bestimmen lässt, an welcher Stelle eine langsame Anfrage zusätzliche Latenz aufnimmt, während sie eine API und die nachgelagerten Dienste durchläuft.
Wichtige Funktionen von Sentry
- Fehlerüberwachung: Erfasst Ausnahmen und gruppiert ähnliche Ereignisse zu Problemen.
- Sitzungswiedergabe: Zeichnet Nutzerinteraktionen auf, damit Teams Ereignisse rund um einen Fehler untersuchen können.
- Versionszustand: Verfolgt absturzfreie Sitzungen und Nutzerinnen und Nutzer über verschiedene Softwareversionen hinweg.
- Problemalarme: Sendet Benachrichtigungen, wenn neue Probleme auftreten oder sich bestehende Probleme ändern.
Sentry-Integrationen
Sentry bietet integrierte Anbindungen an GitHub, Jira, Slack, GitLab, Microsoft Teams, PagerDuty, Vercel, Bitbucket, Azure DevOps und Opsgenie. Die Integrationsplattform unterstützt benutzerdefinierte Integrationen über Webhooks und die REST API.
Pros and Cons
Pros:
- Fehler direkt mit dem Ablaufverfolgungskontext verknüpfen
- Abschnitte nach Attributen und Latenzperzentilen durchsuchen
- Nutzersitzungen neben erfassten Fehlern wiedergeben
Cons:
- Richtet sich hauptsächlich an Anwendungsfehler, nicht an die Infrastruktur
- Die umfangreiche Funktionsvielfalt kann die Benutzeroberfläche überladen
Learn more about Sentry: Am besten geeignet für KI-gestützte automatisierte Überwachung des gesamten Stacks
- 15-tägige kostenlose Testversion
- $21/user/month für den Tarif zur Überwachung des gesamten Stacks (jährliche Abrechnung)
Visit WebsiteCustomer Rating:4.5/5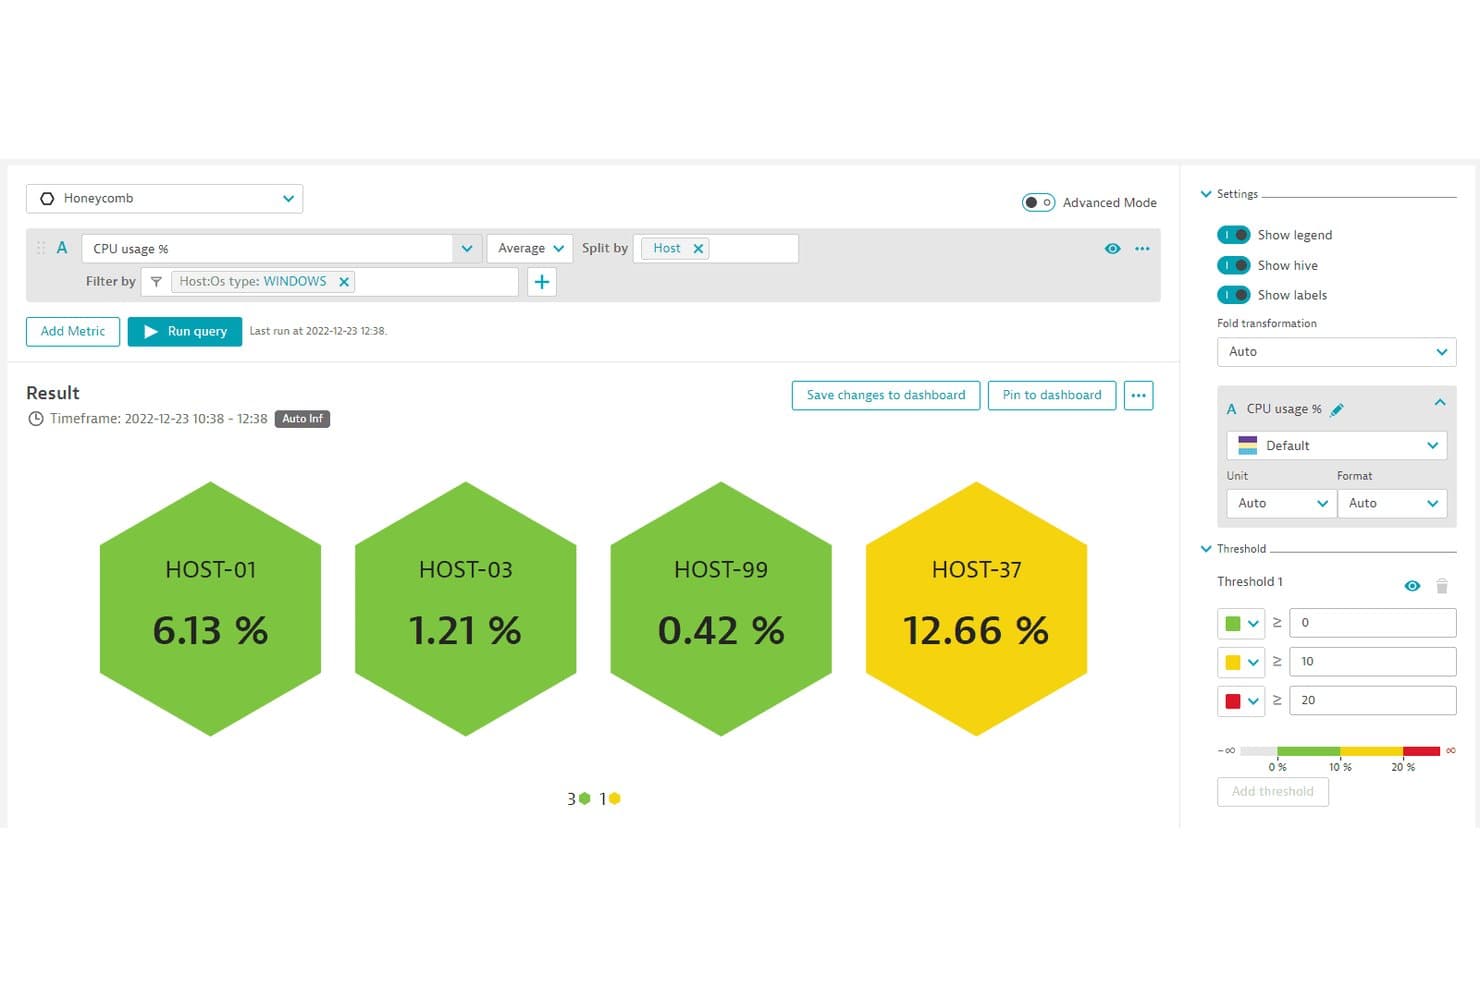
Dynatrace visualisiert die CPU-Auslastung pro Host mithilfe farbcodierter Wabenkacheln. Als Honeycomb-Alternative unterstützt Dynatrace IT- und Engineering-Teams dabei, Anwendungs-, Infrastruktur- und Nutzererfahrungsdaten zu verknüpfen, um Dienstprobleme in komplexen Umgebungen zu diagnostizieren.
Für wen ist Dynatrace am besten geeignet?
Dynatrace eignet sich für IT-Betriebs- und SRE-Teams, die komplexe, verteilte Umgebungen verwalten und eine automatisierte Überwachung von Anwendungen und Infrastruktur benötigen.
Warum ich Dynatrace ausgewählt habe
Ich zähle Dynatrace aufgrund seines Schwerpunkts auf „KI-gestützte automatisierte Überwachung des gesamten Stacks“ zu den besten Honeycomb-Alternativen. Davis AI analysiert Telemetriedaten, um wahrscheinliche Grundursachen zu ermitteln, während OneAgent Dienste auf Hosts und in Cloud-Workloads automatisch erkennt und instrumentiert. Besonders wertvoll finde ich die Abhängigkeitszuordnung, wenn ein Anstieg der API-Latenz auf einen Host oder einen nachgelagerten Dienst zurückzuführen ist.
Die wichtigsten Funktionen von Dynatrace
- Überwachung echter Nutzer: Verfolgt Nutzersitzungen, Seitenladevorgänge und Frontend-Fehler.
- Synthetische Überwachung: Führt geplante Browser- und HTTP-Prüfungen für Endpunkte aus.
- Protokollüberwachung: Sammelt, durchsucht und analysiert Protokolle zusammen mit Telemetriedaten.
- Überwachung der Cloud-Infrastruktur: Verfolgt Metriken und den Zustand von Hosts, Containern und Cloud-Diensten.
Integrationen von Dynatrace
Dynatrace Workflows bietet über den Dynatrace Hub offiziell unterstützte Konnektoren für AWS, Microsoft Azure, GitHub, Jira, Slack, PagerDuty, ServiceNow, Microsoft Teams, GitLab und Jenkins. Dynatrace stellt außerdem eine API für benutzerdefinierte Integrationen bereit.
Pros and Cons
Pros:
- Davis AI verknüpft Anomalien mit Grundursachen
- OneAgent erkennt und instrumentiert Dienste automatisch
- Einheitliche Überwachung von Protokollen, Traces, Infrastruktur und Nutzern
Cons:
- Es dauert, die DQL-Syntax zu beherrschen
- Der Telemetrieverbrauch kann die Kosten unvorhersehbar machen
 Am besten für einheitliche Traces, Protokolle und Metriken in einer Ansicht
- Kostenloser Tarif verfügbar
- $15/Benutzer/Monat (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.5/5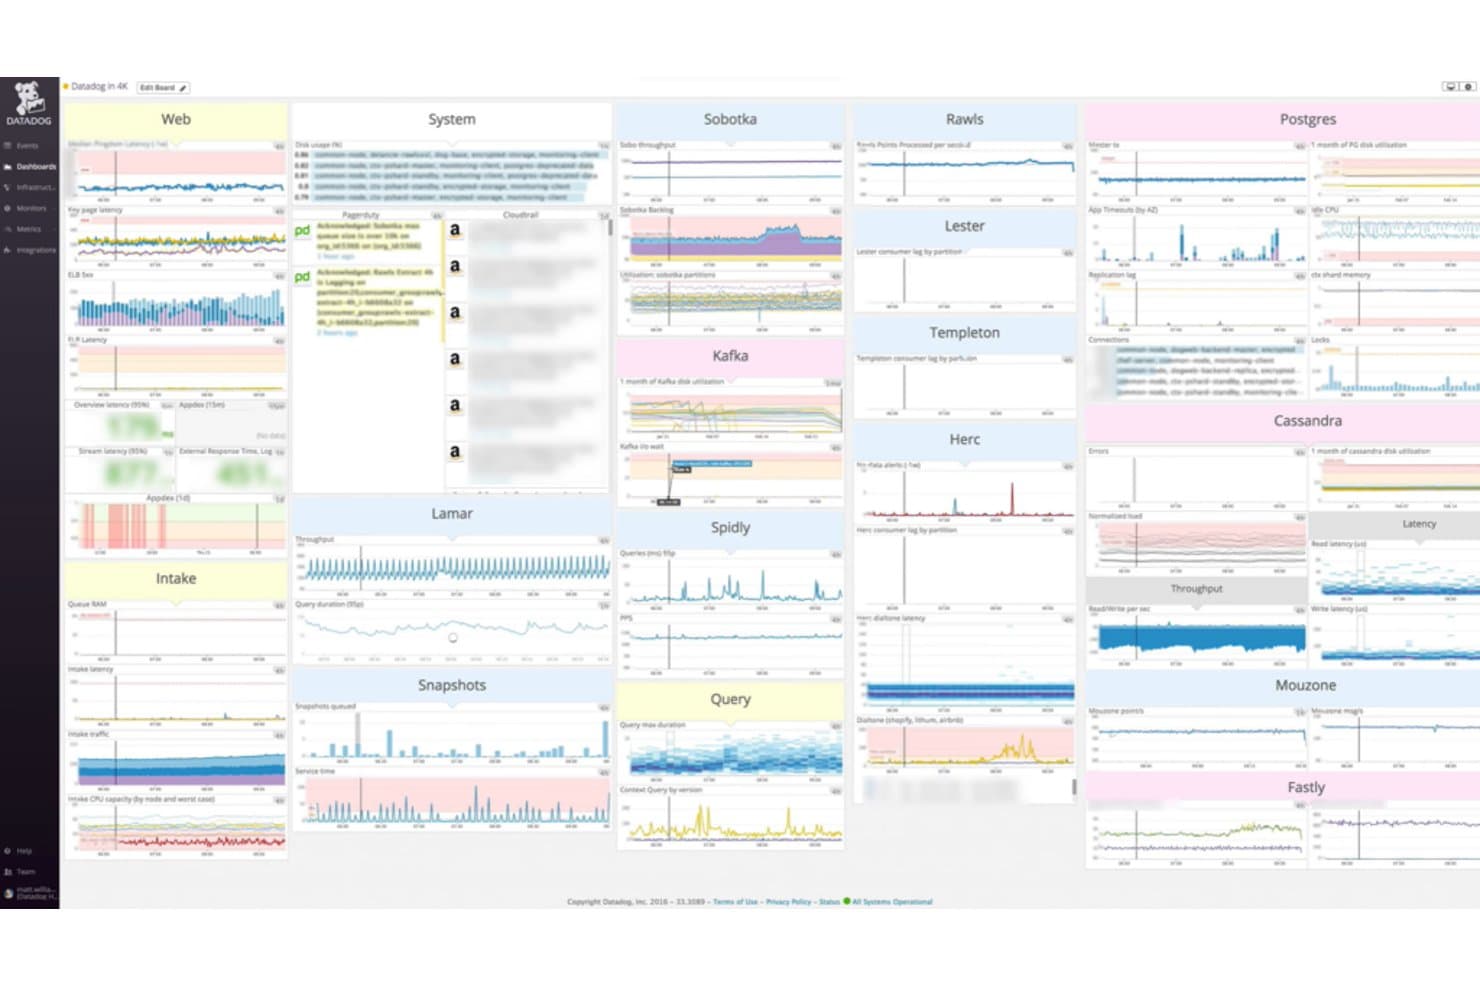
Datadog zentralisiert Metriken aus Web-, System- und Datenbankservices in einem Dashboard. Datadog ist eine Observability-Plattform für IT- und Engineering-Teams, die Anwendungsprobleme untersuchen, Serviceabhängigkeiten nachverfolgen und die Infrastruktur in komplexen Umgebungen überwachen müssen.
Für wen ist Datadog am besten geeignet?
Datadog eignet sich für IT-Betriebsteams, Plattform-Engineering-Teams und SRE-Teams, die verteilte Infrastrukturen und Anwendungen überwachen müssen.
Warum ich Datadog ausgewählt habe
Ich habe Datadog ausgewählt, weil es am besten für einheitliches Monitoring von Servern, Anwendungen und Services geeignet ist. Die Infrastrukturmetriken, APM-Traces und Servicekarten helfen mir dabei, eine langsame Anfrage von einem Host bis zu den davon abhängigen Services zu verfolgen. Dadurch ist Datadog eine nützliche Honeycomb-Alternative für die Untersuchung von Vorfällen über mehrere Ebenen hinweg.
Die wichtigsten Funktionen von Datadog
- Protokollverwaltung: Protokolle aus Anwendungen und der Infrastruktur durchsuchen, filtern und analysieren.
- Synthetisches Monitoring: Browser- und API-Tests ausführen, um Verfügbarkeit und Antwortzeiten zu überprüfen.
- Überwachungsregeln: Bedingungen festlegen, die Benachrichtigungen auslösen, wenn überwachte Daten einen Schwellenwert erreichen.
- Dashboards: Visuelle Darstellungen mit Diagrammen und Widgets für ausgewählte Daten erstellen.
Datadog-Integrationen
Datadog bietet mehr als 1.000 integrierte Integrationen, darunter AWS, Azure, Google Cloud, Kubernetes, Docker, Jenkins, Slack, Jira, GitHub und PagerDuty. Außerdem stellt es eine API für benutzerdefinierte Integrationen bereit.
Pros and Cons
Pros:
- Korreliert Protokolle, Metriken und Traces während der Fehleranalyse
- Servicekarten verbinden Hosts mit abhängigen Services
- Dashboards vereinen Infrastruktur- und Anwendungssignale
Cons:
- Die Feinabstimmung von Benachrichtigungen kann zu einer hohen Anzahl störender Meldungen führen
- Die Verarbeitung von OpenTelemetry kann inkonsistent sein
 Am besten für Open-Source-Infrastrukturüberwachung in großem Maßstab
- Kostenloser Tarif verfügbar
- Preis auf Anfrage
Visit WebsiteCustomer Rating:4.4/5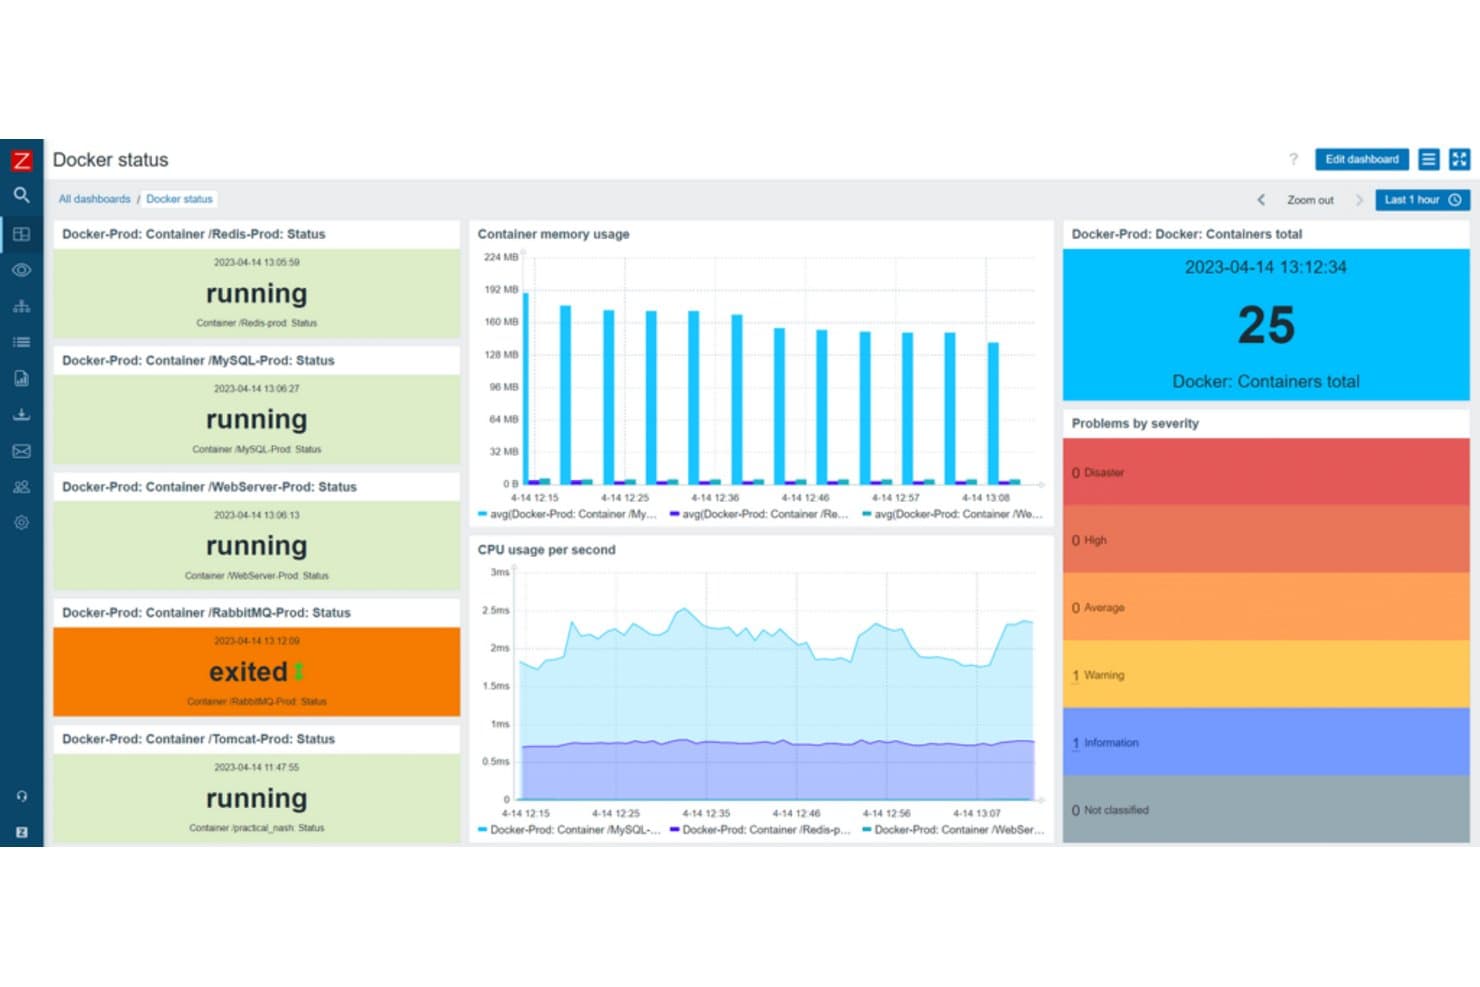
Zabbix überwacht den Zustand und die Ressourcennutzung von Docker-Containern in Echtzeit. Zabbix ist eine Plattform zur Infrastrukturüberwachung für IT-Teams, die Netzwerkgeräte, Server, Anwendungen und Dienste überwachen und Ausfälle oder Leistungsprobleme in komplexen Umgebungen erkennen müssen.
Für wen ist Zabbix am besten geeignet?
Zabbix eignet sich für IT- und Infrastrukturteams in Unternehmen, die eine Open-Source-Überwachung großer, miteinander verbundener Netzwerke und Systeme benötigen.
Warum ich Zabbix ausgewählt habe
Ich habe Zabbix als „Am besten für Open-Source-Netzwerküberwachung auf Unternehmensebene“ ausgewählt, wenn die Transparenz über die Infrastruktur wichtiger ist als die verteilte Ablaufverfolgung. Netzwerkerkennung und SNMP-Überwachung helfen dabei, Switches und Router zu finden, während Vorlagen und Auslöser Prüfungen standardisieren und bei Ausfällen von Schnittstellen oder Diensten Warnmeldungen auslösen. Dadurch ist Zabbix eine nützliche Alternative zu Honeycomb für die Überwachung des Infrastrukturzustands in großen Umgebungen.
Die wichtigsten Funktionen von Zabbix
- Webüberwachung: Konfigurieren Sie Szenarien, um die Verfügbarkeit von Websites, die Antwortzeit und den Seiteninhalt zu überprüfen.
- Protokollüberwachung: Erfassen Sie Protokolleinträge und erkennen Sie übereinstimmende Muster oder Fehler.
- Diensteüberwachung: Ordnen Sie Geschäftsdienste zu und verfolgen Sie deren Status anhand von Dienstleistungszielen.
- Dashboards: Ordnen Sie Widgets an, um Überwachungsdaten, Probleme und den Dienststatus anzuzeigen.
Zabbix-Integrationen
Der Integrationskatalog von Zabbix listet 559 Marken und 1.986 Lösungen auf, darunter AWS, Azure, Kubernetes, PagerDuty, Slack, Microsoft Teams, ServiceNow und Jira. Über die API und konfigurierbare Webhooks werden benutzerdefinierte Verbindungen unterstützt; die Katalogeinträge sind nicht unbedingt native Integrationen.
Pros and Cons
Pros:
- Automatische Erkennung findet SNMP-Netzwerkgeräte
- Vorlagen standardisieren Prüfungen des Infrastrukturzustands
- Proxys erweitern die Überwachung auf entfernte Standorte
Cons:
- Kein nativer Arbeitsablauf zur Fehlersuche bei verteilten Ablaufverfolgungen
- Die komplexe Einrichtung und Feinabstimmung von Warnmeldungen erfordern Fachkenntnisse
 Am besten für die durchgängige Verfolgung von Geschäftstransaktionen geeignet
- 30-tägige kostenlose Testversion
- $3300 pro Einheit pro Jahr (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.3/5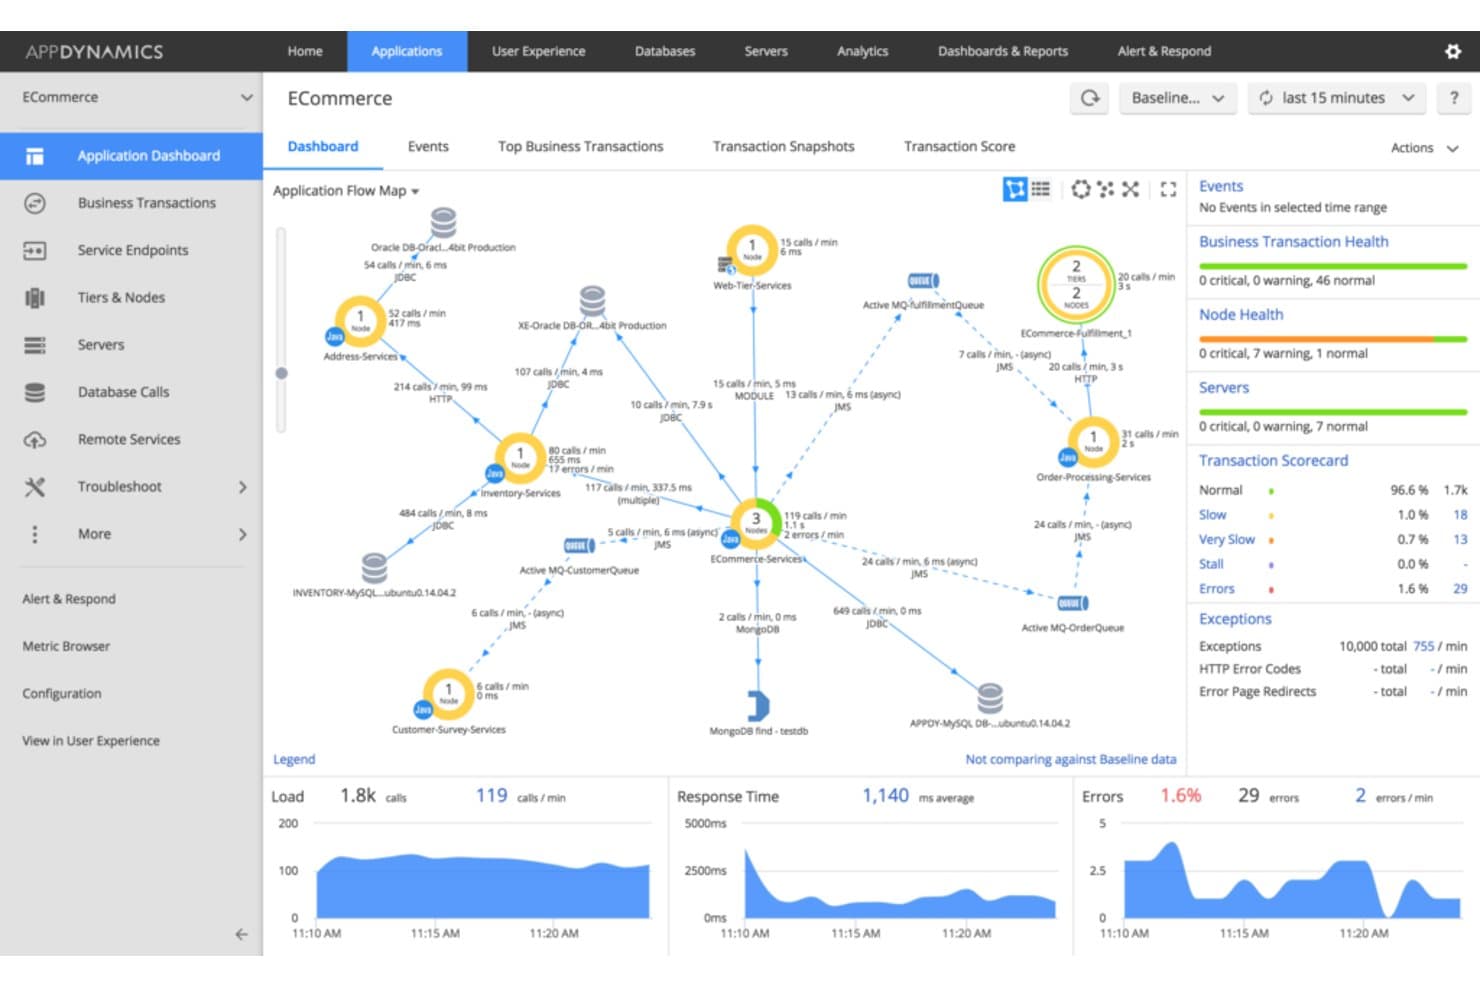
AppDynamics visualisiert Abhängigkeiten und Leistung von Anwendungsdiensten in Echtzeit. AppDynamics ist eine Beobachtungsplattform für IT- und Anwendungsteams, die komplexe Systeme verwalten. Sie hilft ihnen dabei, Leistungsprobleme zu lokalisieren und Infrastrukturprobleme mit der Zuverlässigkeit von Anwendungen und der Benutzererfahrung zu verknüpfen.
Für wen ist AppDynamics am besten geeignet?
AppDynamics eignet sich für Teams, die für Anwendungsleistung und -betrieb zuständig sind und verteilte Anwendungen mit mehreren Ebenen in komplexen Umgebungen verwalten.
Warum ich AppDynamics ausgewählt habe
Ich habe AppDynamics für die durchgängige Verfolgung von Geschäftstransaktionen in komplexen Umgebungen ausgewählt. Die Transaktionsflusskarten zeigen, wie sich Anforderungen durch die Anwendungsebenen bewegen, während Transaktions-Snapshots Details auf Codeebene erfassen, wenn eine Anforderung langsamer wird oder fehlschlägt. Mit dieser Ansicht verfolge ich eine Verzögerung beim Bezahlvorgang vom benutzerseitigen Dienst bis zu der Backend-Ebene, die sie verursacht.
Die wichtigsten Funktionen von AppDynamics
- Infrastrukturüberwachung: Verknüpft Infrastrukturmetriken mit Anwendungsdiensten und Geschäftsmetriken.
- Überwachung der digitalen Erfahrung: Verfolgt Web- und Mobilbenutzer und führt synthetische Prüfungen über Browser, APIs und Dienste von Drittanbietern durch.
- Anwendungssicherheit zur Laufzeit: Erkennt Schwachstellen und blockiert Angriffe.
- SAP-Überwachung: Überwacht hybride und lokale SAP-Systeme mit Verfolgung bis zum ABAP-Code oder zu Datenbankabfragen.
AppDynamics-Integrationen
AppDynamics unterstützt Alarm-Integrationen mit PagerDuty, Slack, ServiceNow über den Service Graph Connector, Jira, BigPanda, Moogsoft und Splunk ITSI; die Integration von PagerDuty wurde vom Anbieter entwickelt, während die Slack-Integration aus der Community stammt. AppDynamics stellt außerdem REST-APIs und vorgefertigte Erweiterungen für benutzerdefinierte Integrationen bereit.
Pros and Cons
Pros:
- Ordnet Geschäftstransaktionen über mehrere Anwendungsebenen hinweg zu
- Snapshots zeigen langsame Methoden und Codezeilen auf
- Verknüpft den Zustand von Transaktionen mit Geschäftsergebnissen
Cons:
- Der Konfigurationsaufwand steigt mit benutzerdefinierten Anwendungshierarchien
- Für benutzerdefinierte Abfragen muss die Abfragesprache von AppDynamics erlernt werden
Learn more about AppDynamics: Am besten geeignet für Einblicke in die Anwendungsleistung und das Tracking des Endnutzererlebnisses
- Kostenlose Testversion + kostenlose Demo verfügbar
- $99/Monat für den Pro-Tarif (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.3/5
New Relic SQL-Übersichts-Dashboard. New Relic ist darauf spezialisiert, tiefgehende Einblicke in die Anwendungsleistung und das Nutzererlebnis zu bieten. Dieses Tool leistet hervorragende Arbeit dabei, Teams ein detailliertes und feingranulares Verständnis von Nutzerinteraktionen und dem Verhalten von Anwendungen zu vermitteln.
Pros and Cons
Pros:
- Detaillierte Überwachung der Anwendungsleistung und Nachverfolgung des Nutzererlebnisses
- Breite Integrationen mit führenden Cloud-Anbietern und Plattformen
- AIOps-Funktionen für vorausschauende Warnungen und Reaktionsmanagement bei Vorfällen
Cons:
- Höhere Preise im Vergleich zu einigen Mitbewerbern
- Kann komplex in der Einrichtung und Konfiguration sein
- Die große Funktionsvielfalt kann neue Nutzer überfordern
Learn more about New Relic: Am besten für cloudnative Protokollverwaltung und -analyse geeignet
- 14-tägige kostenlose Testversion
- Preise auf Anfrage
Visit WebsiteCustomer Rating:4.3/5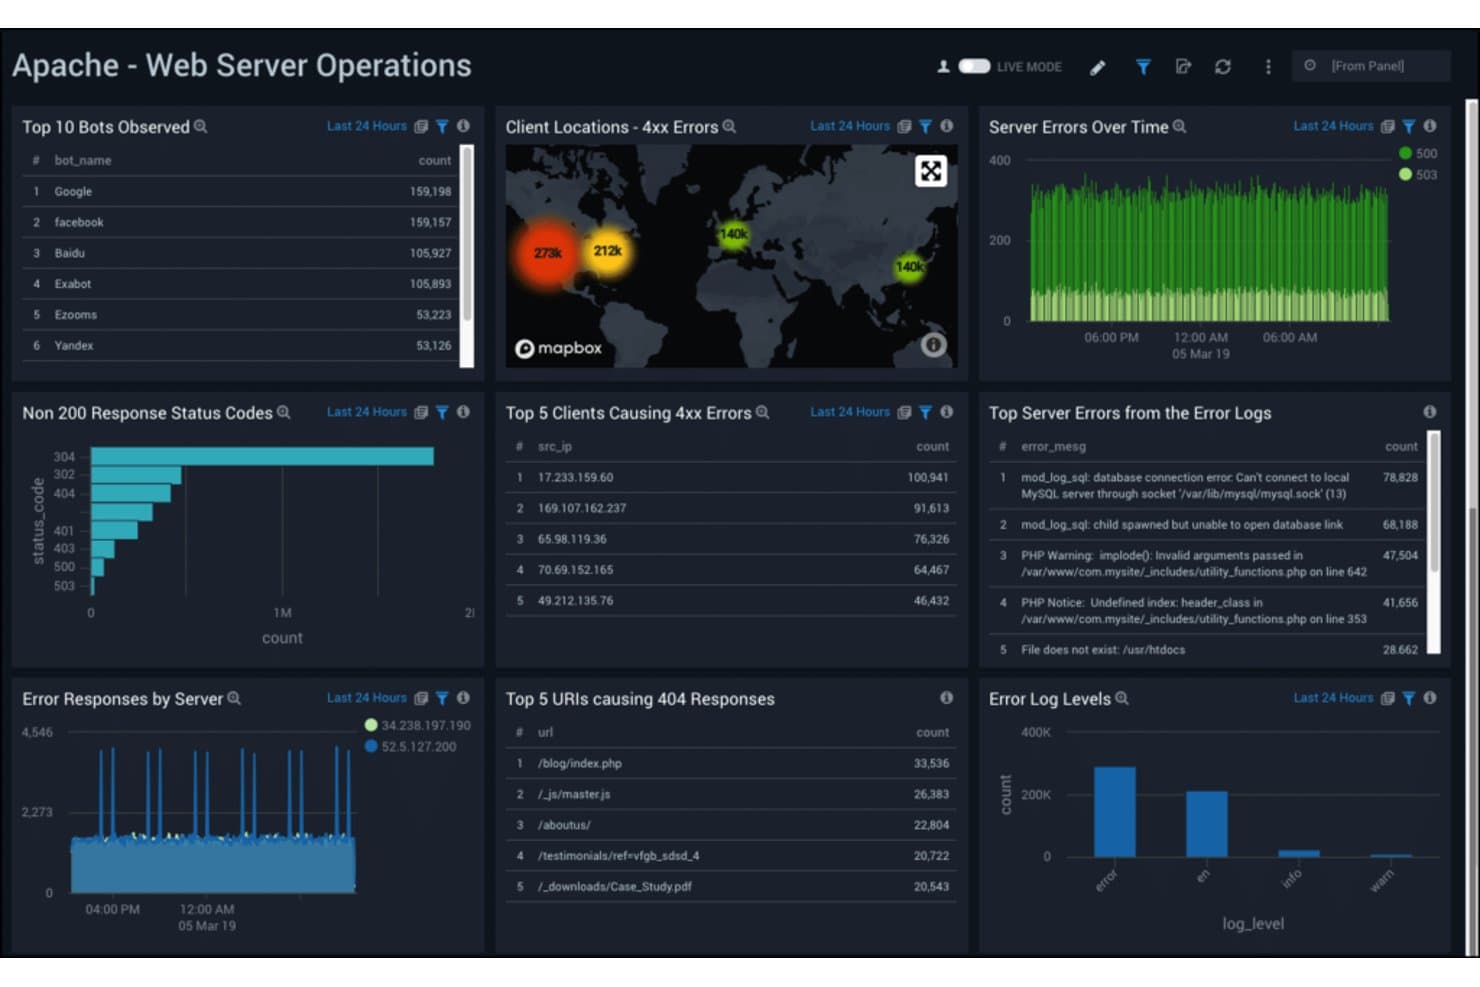
Sumo Logic überwacht Fehler des Apache-Webservers und Bot-Aktivitäten in Echtzeit. Sumo Logic bietet IT- und DevOps-Teams eine Plattform zur Überwachung und Analyse, um Ausfälle zu untersuchen, Probleme über verteilte Dienste hinweg zu verknüpfen und Transparenz in komplexe Cloud-Umgebungen zu gewinnen.
Für wen eignet sich Sumo Logic am besten?
Infrastruktur- und Sicherheitsteams in cloudnativen Unternehmen können Sumo Logic verwenden, um Protokolle über verteilte Dienste hinweg zu analysieren.
Warum ich Sumo Logic ausgewählt habe
Ich habe Sumo Logic als Honeycomb-Alternative ausgewählt, weil es am besten für cloudnative Protokollverwaltung und -analyse geeignet ist. LogReduce gruppiert ähnliche Protokollmeldungen, damit ich wiederkehrende Fehler leichter erkenne, während die Abfragesprache die Untersuchung eines Vorfalls über verteilte Dienste hinweg ermöglicht.
Wichtige Funktionen von Sumo Logic
- Metrikanalyse: Zeitreihenmetriken zusammen mit operativen Telemetriedaten aufnehmen und abfragen.
- Verteilte Ablaufverfolgung: Anfragen über Dienste hinweg verfolgen, um Bereiche und Ablaufverfolgungsdetails zu untersuchen.
- Übersichten: Visuelle Übersichten mit Diagrammen und Bereichen für operative Daten erstellen.
- Überwachungen und Warnmeldungen: Bedingungen für Metriken oder Abfrageergebnisse festlegen, um Benachrichtigungen auszulösen.
Integrationen von Sumo Logic
Der Katalog von Sumo Logic umfasst Hunderte von Anbietern und Produkten sowie Apps, Kollektoren, Cloud-SIEM-Inhalte und Automatisierungsintegrationen für Tools wie AWS, Azure, Kubernetes, Datadog, GitHub, GitLab und Atlassian Jira. Darüber hinaus werden APIs für benutzerdefinierte Integrationen bereitgestellt.
Pros and Cons
Pros:
- LogReduce gruppiert ähnliche Fehler schnell
- Die Suche analysiert JSON- und reguläre Ausdrucksdaten
- Protokolle, Metriken und Ablaufverfolgungen ermöglichen gemeinsame Untersuchungen
Cons:
- Die Sumo-Abfragesyntax erfordert Übung
- Historische Suchen können sich bei großen Datenmengen verlangsamen
 Am besten für volumenbasierte Protokollüberwachung und Warnmeldungen geeignet
- 30-tägige kostenlose Testversion
- Preise auf Anfrage
Visit WebsiteCustomer Rating:4.4/5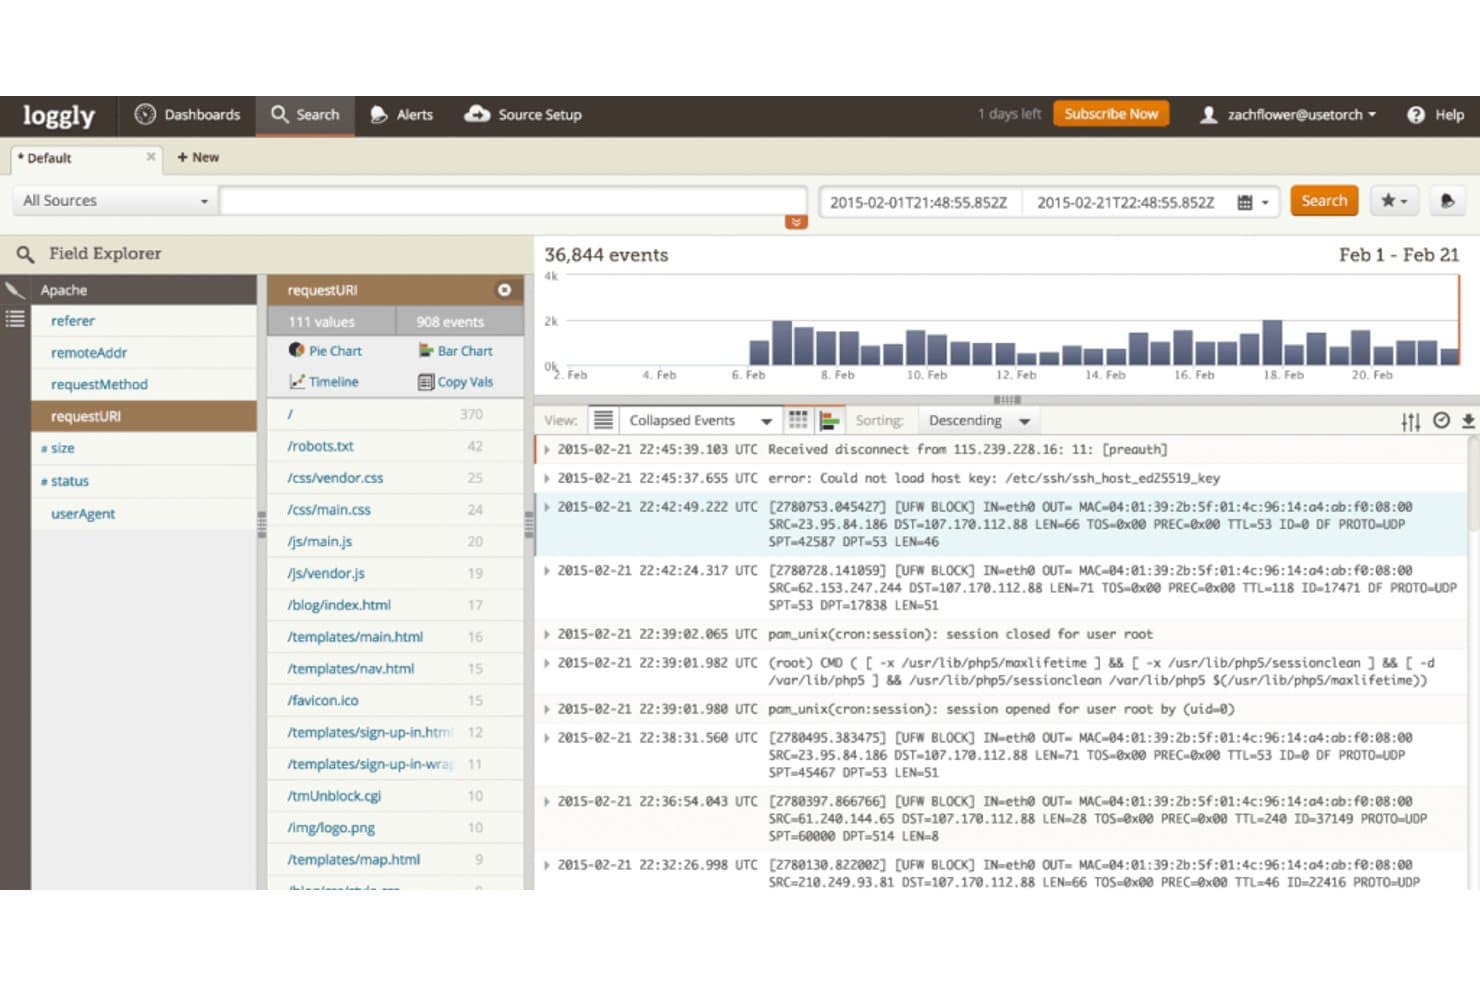
Loggly zentralisiert Protokollereignisse für die Suche und Analyse in Echtzeit. Loggly ist eine cloudbasierte Protokollverwaltungsplattform für IT- und DevOps-Teams, die Anwendungs- und Infrastrukturprobleme untersuchen, Ereignisse über Dienste hinweg verfolgen und Dienstunterbrechungen diagnostizieren müssen.
Für wen ist Loggly am besten geeignet?
Loggly eignet sich für IT- und DevOps-Teams, die Protokolldaten in wachsenden cloudbasierten Umgebungen durchsuchen und visualisieren müssen.
Warum ich mich für Loggly entschieden habe
Ich habe mich für Loggly als Alternative zu Honeycomb entschieden, weil es sich am besten für die skalierbare cloudbasierte Protokollverwaltung und die interaktive Datenvisualisierung eignet. Die Diagramme und Dashboards helfen mir, Trends in Anwendungs- und Infrastrukturprotokollen zu erkennen. Außerdem schätze ich die Tools zur Fehlerbehebung, mit denen sich Probleme über miteinander verbundene Dienste hinweg bis zu ihren Grundursachen zurückverfolgen lassen.
Die wichtigsten Funktionen von Loggly
- Live-Verfolgung: Eingehende Protokollereignisse aus mehreren Quellen nahezu in Echtzeit streamen.
- Suchbasierte Warnmeldungen: Bedingungen für Suchen festlegen und Benachrichtigungen per E-Mail oder an unterstützte Endpunkte senden.
- Integrationen für Team-Tools: Loggly mit Slack, GitHub, Jira, PagerDuty, Microsoft Teams und Webhooks verbinden.
- Unterstützung von Protokollquellen: Protokolle aus Quellen wie AWS, Syslog, PHP, Netzwerkgeräten und Windows-Systemen erfassen.
Loggly-Integrationen
Loggly führt Integrationen mit Slack, GitHub, Jira, PagerDuty und Microsoft Teams auf. Die Zustellung von Warnmeldungen ist außerdem über benutzerdefinierte Webhooks möglich. Für benutzerdefinierte Integrationen steht eine API zur Verfügung.
Pros and Cons
Pros:
- Zentralisierte dienstübergreifende Protokollsuche und Dashboards
- Die Live-Verfolgung streamt Ereignisse aus mehreren Quellen
- Interaktive Diagramme zeigen Protokolltrends
Cons:
- Die Bereitstellung ausschließlich als SaaS schließt Anforderungen an lokale Installationen aus
- Verzögerungen bei der Protokollweiterleitung können die Untersuchung von Vorfällen erschweren
Learn more about Loggly: Am besten für operative Erkenntnisse auf Basis von Maschinendaten
- 60-tägige kostenlose Testversion
- $150/Monat (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.3/5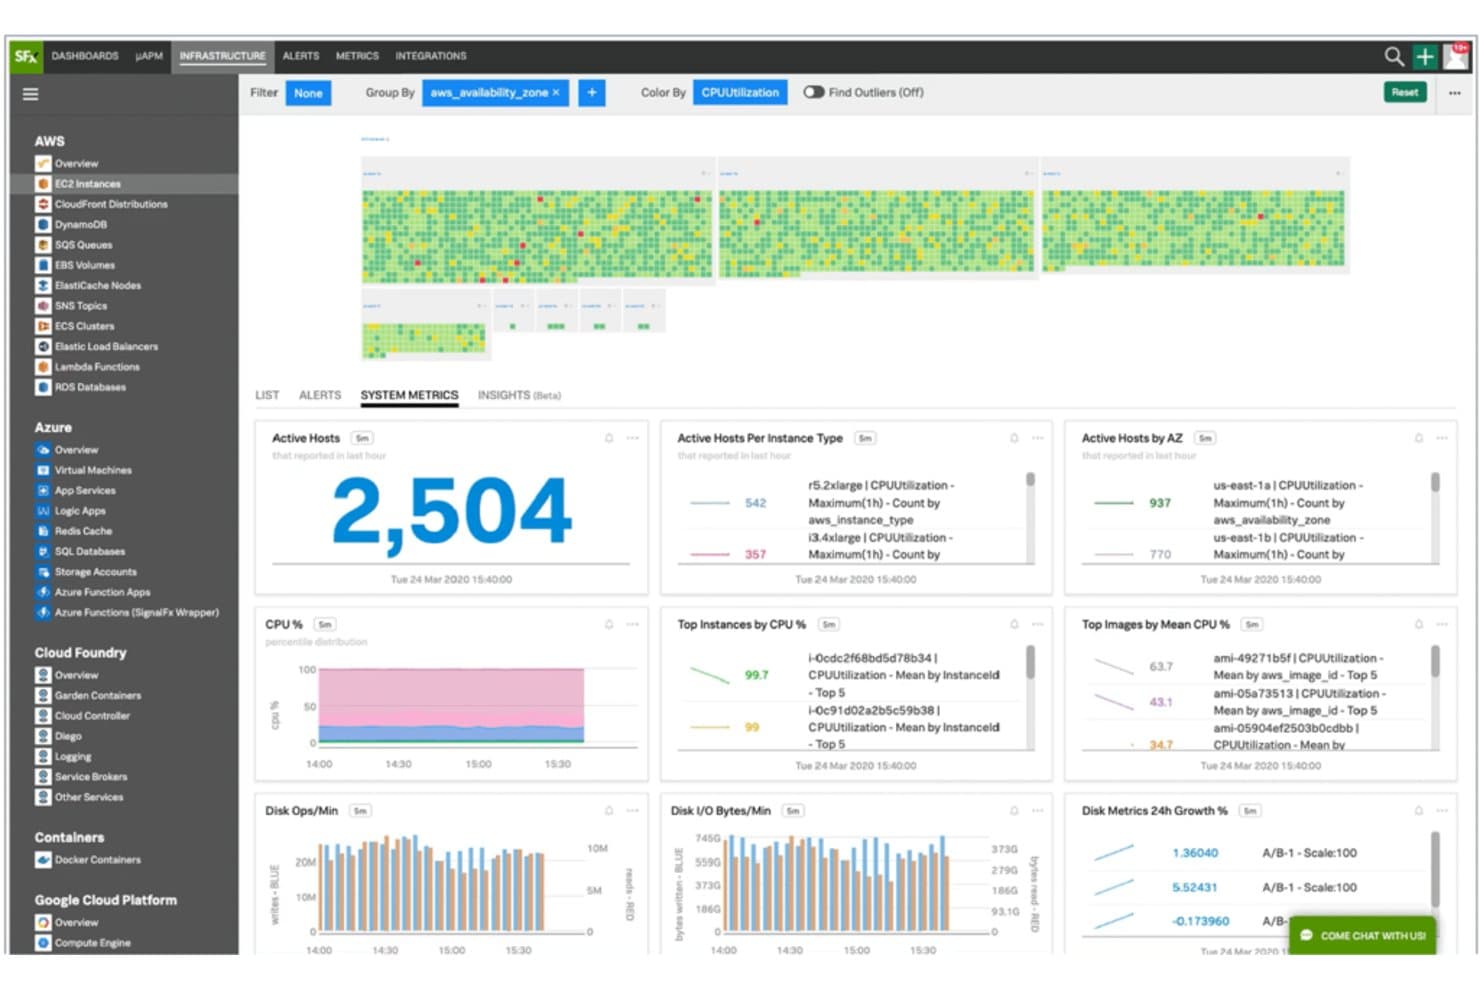
Splunk überwacht AWS-, Azure- und Cloud-Infrastrukturmetriken in Echtzeit. Splunk ist eine Plattform zur Überwachung und Analyse für IT- und Sicherheitsteams, die Maschinendaten in komplexen Umgebungen untersuchen, Dienstprobleme identifizieren und Vorfälle beheben müssen.
Für wen eignet sich Splunk am besten?
IT-Betriebsteams, die verteilte Infrastrukturen überwachen, können Splunk nutzen, um Maschinendaten in verwertbare operative Erkenntnisse umzuwandeln.
Warum ich Splunk ausgewählt habe
Ich habe Splunk als Honeycomb-Alternative für „Am besten geeignet, um Maschinendaten für tiefgehende operative Erkenntnisse zu nutzen“ ausgewählt. Ich verwende SPL-Suchen, um Protokolle in verteilten Diensten zu untersuchen, und verknüpfe die Ergebnisse anschließend in Dashboards, um Probleme wie zunehmende Fehler nach einer Bereitstellung zurückzuverfolgen. Diese umfassendere Sicht auf Maschinendaten hilft mir, operative Probleme zusammen mit zugehörigen Infrastruktur- und Sicherheitsereignissen zu untersuchen.
Wichtige Funktionen von Splunk
- Verteilte Ablaufverfolgung: Verfolgen Sie Anfragen über Dienste hinweg anhand von Ablaufverfolgungsabschnitten und Dienstübersichten.
- Infrastrukturüberwachung: Überwachen Sie Metriken von Hosts, Containern und Kubernetes-Umgebungen.
- Überwachung echter Benutzer: Erfassen Sie die Browserleistung und Benutzerinteraktionen.
- Synthetische Überwachung: Führen Sie skriptbasierte Tests aus, um Dienstverfügbarkeit und Antwortzeiten zu prüfen.
Integrationen von Splunk
Splunk Observability Cloud bietet Hunderte vorkonfigurierte Integrationen, darunter AWS, Microsoft Azure, Google Cloud, Kubernetes, Prometheus, Jira, Microsoft Teams, PagerDuty, ServiceNow und Slack. Splunkbase bietet mehr als 1.000 Marktplatz-Apps und -Erweiterungen, und Splunk stellt APIs für benutzerdefinierte Integrationen bereit.
Pros and Cons
Pros:
- Korrelieren von Protokollen, Metriken und Ablaufverfolgungen
- Analysiert Ablaufverfolgungen ohne Stichprobenverfahren
- Benutzerdefinierte Dashboards beschleunigen die Fehlerbehebung
Cons:
- Aufwendige Abfragen können langsam ausgeführt werden
- Die Kosten steigen bei größeren Datenmengen
Learn more about Splunk: Am besten für Kubernetes-native Metriken und Warnüberwachung geeignet
- Kostenloser Tarif verfügbar
- Preis auf Anfrage
Visit WebsiteCustomer Rating:4.4/5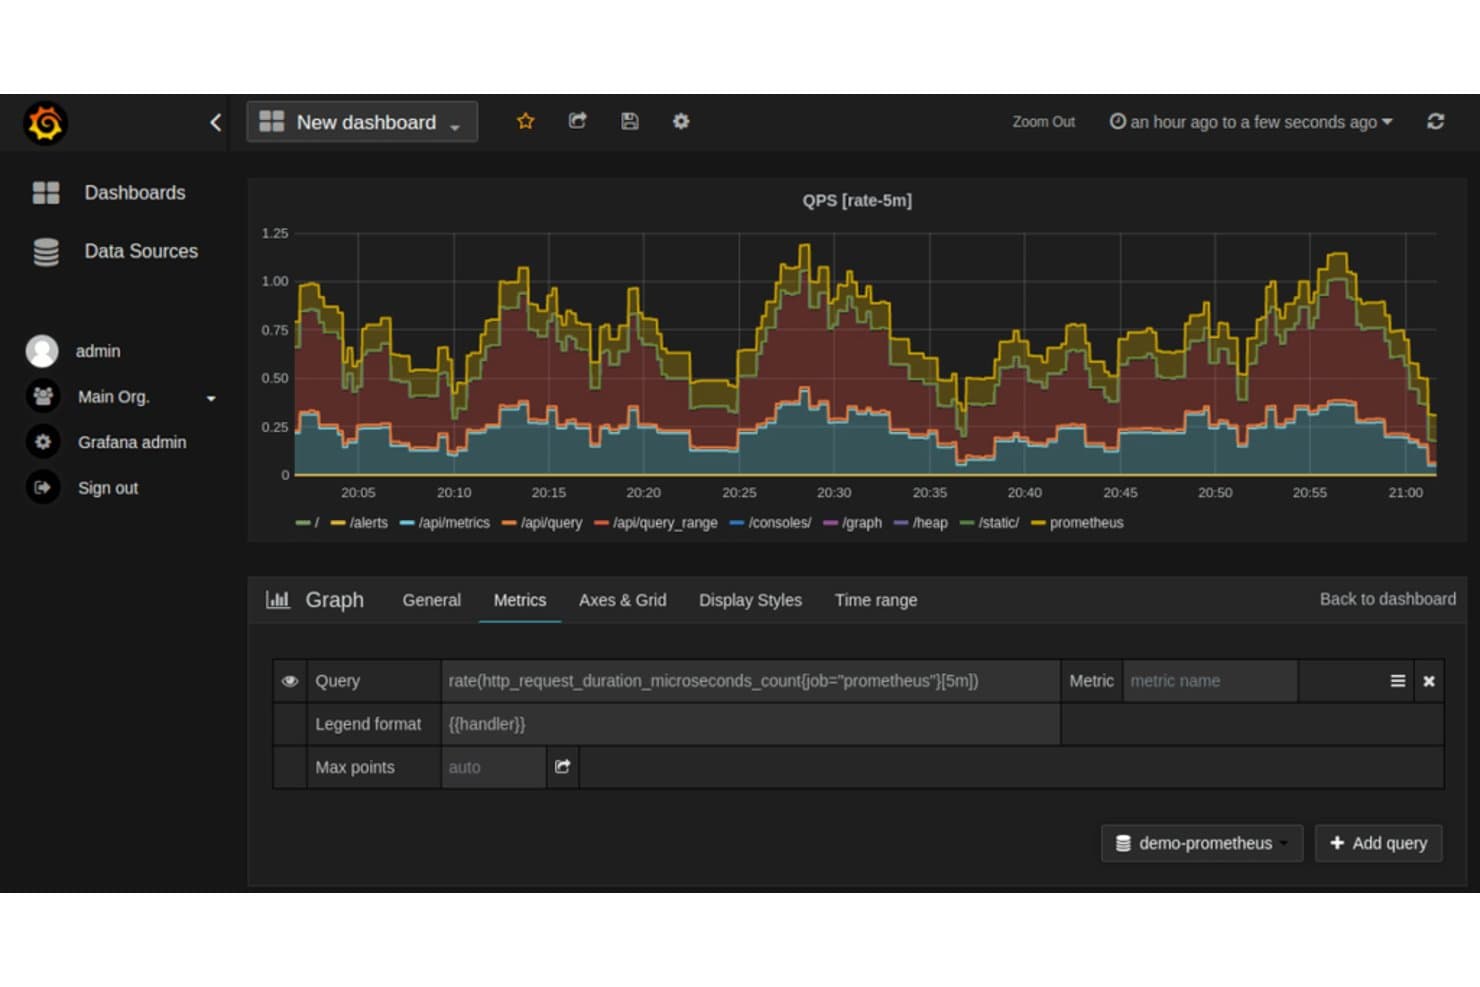
Prometheus visualisiert in Grafana die Raten von HTTP-Anfragen über API-Endpunkte hinweg. Prometheus ist eine Open-Source-Überwachungsplattform für Infrastruktur- und Anwendungsteams, die den Systemzustand überwachen, Leistungsprobleme untersuchen und Beobachtbarkeit in ihre Dienste integrieren müssen.
Für wen eignet sich Prometheus am besten?
Prometheus eignet sich für DevOps- und Teams für die Zuverlässigkeit von Websites, die Metriken erfassen und Warnungen für Kubernetes-Workloads festlegen müssen.
Warum ich Prometheus ausgewählt habe
Ich habe Prometheus für die Erfassung von Metriken und die Warnüberwachung ausgewählt, insbesondere in einer Kubernetes-Umgebung. Die Diensterkennung kann sich ändernde Workloads verfolgen, während PromQL mir hilft, Metrikmuster zu untersuchen und Warnbedingungen zu definieren. Ich verwende Alertmanager, um diese Warnungen weiterzuleiten, wenn sich der Zustand eines Dienstes verschlechtert.
Wichtigste Funktionen von Prometheus
- Zeitreihendatenbank: Speichert mit Zeitstempeln versehene Messwerte in einer lokalen Datenbank.
- Mehrdimensionales Datenmodell: Organisiert Zeitreihen anhand von Metriknamen und Schlüssel-Wert-Bezeichnungen.
- Ökosystem für Datenexporte: Exporter stellen Metriken aus Systemen wie Datenbanken und Hardware bereit.
- Föderation: Ruft ausgewählte Metriken von anderen Prometheus-Servern zur Aggregation ab.
Integrationen von Prometheus
Prometheus umfasst die Kubernetes-Diensterkennung und unterstützt auf Exportern basierende Integrationen mit Kafka, MySQL, PostgreSQL, Redis, Jenkins und AWS CloudWatch. Verbindungen zum Lesen und Schreiben aus der Ferne umfassen Grafana Mimir, Thanos, Google Cloud und New Relic, und seine HTTP-API unterstützt benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- PromQL unterstützt die bezeichnungsbasierte Untersuchung von Metriken
- Die Kubernetes-Diensterkennung verfolgt sich ändernde Workloads
- Alertmanager leitet Metrikwarnungen anhand von Bezeichnungen weiter
Cons:
- Bezeichnungen mit hoher Kardinalität können den lokalen Speicher belasten
- Lokaler Speicher begrenzt Aufbewahrungsdauer und horizontale Skalierung
Learn more about Prometheus:
Weitere Honeycomb-Alternativen
Hier finden Sie einige weitere Honeycomb-Alternativen, die es nicht in meine Auswahlliste geschafft haben, aber dennoch einen Blick wert sind:
- 11Grafana CloudAm besten für interaktive Visualisierung geeignet, um datengestützte Entscheidungen zu ermöglichen
- 12Elastic (ELK Stack)Am besten geeignet für Protokollanalyse, Suche und leistungsstarke Datenkorrelationsfunktionen
- 13WrikeAm besten geeignet für Projektmanagement in Softwareteams
Weitere Softwarebewertungen
- Tools für die Softwareentwicklung
- Tools für Infrastructure as Code
- DataOps-Tools
- Tools zur Datenbanküberwachung
Wie ich Honeycomb-Alternativen bewerte
Ich beurteile jede Option auf zwei Ebenen: die grundlegenden Anforderungen – verteiltes Tracing, Abfragen mit hoher Kardinalität und OTel-Unterstützung – sowie die Differenzierungsmerkmale, die Tools beim Debuggen von Live-Produktionsvorfällen für SREs unterscheiden.
Kernfunktionalitäten (Grundvoraussetzungen für diese Liste)
Bei der Auswahl der Tools für meine Liste bewerte ich jede Funktionalität auf einer Skala von 0 (bietet die Funktion nicht) bis 5 (überzeugt in diesem Bereich) für jede unten aufgeführte Kernfunktionalität. Danach berechne ich die Gesamtnote des Tools als Prozentsatz. Jedes Tool muss eine Mindestgesamtwertung von 65 % erreichen, um berücksichtigt zu werden.
- Verteiltes Tracing: Ich bewerte, wie gut jedes Tool Trace-Wasserfälle über verschiedene Services hinweg visualisiert, da das Debuggen eines langsamen Checkouts, der sich über 15 Microservices erstreckt, detaillierte Span-Informationen erfordert.
- Abfragen mit hoher Kardinalität: Die Analyse von Telemetriedaten beispielsweise nach Benutzer-ID oder Container-Instanz in großem Maßstab ist wichtig – deshalb prüfe ich, ob die Abfrageleistung auch bei Millionen eindeutiger Werte stabil bleibt.
- Unterstützung für einheitliche Telemetrie: Ich achte darauf, dass Tools Logs, Metriken und Traces in einer Ansicht korrelieren – von einer Latenzspitze zur passenden Fehlermeldung sollte es mit einem Klick gehen.
- OpenTelemetry-Kompatibilität: Hier bewerte ich die native OTel-Erfassung für Traces, Metriken und Logs, da Teams keine proprietären Agenten benötigen sollten, um Daten einzuspeisen.
- Echtzeit-Alerting & SLOs: Gute Observability umfasst SLO-Burn-Rate-Alerts und Fehlerbudgets. Ich prüfe daher, ob jedes Tool mehr als nur einfache Benachrichtigungen über statische Schwellenwerte bietet.
- Interaktive Debugging-Workflows: Ich suche nach explorativen Abfrageoberflächen – wie Ausreißererkennung oder Gruppierungs-Breakdowns –, die Ingenieur:innen bei der Diagnose unbekannter Probleme während eines Vorfalls unterstützen.
Wenn ich eine Liste von Tools habe, die diese Kriterien erfüllen, schaue ich, was jede Plattform besonders macht.
Unterscheidungsmerkmale (Was Anbieter voneinander abhebt)
So vergleiche und unterscheiden ich verschiedene Anbieter:
Herausragende Funktionen
KI-gestützte Analysetools können Stunden bei einem Vorfall sparen, indem sie die wahrscheinliche Ursache automatisch anzeigen, noch bevor ein:e Ingenieur:in eine Abfrage formuliert. Ich bewerte auch, ob eine Plattform kontinuierliches Profiling bietet – indem CPU- oder Speicher-Hotspots direkt mit einem Trace verknüpft werden, erkennt man Code-Engpässe, die auf Span-Ebene nicht sichtbar sind. Kollaborative Abfrage-Workflows sind ebenfalls wichtig, besonders für Teams, die Blameless-Postmortems durchführen. Geteilte Untersuchungspfade und kommentierte Boards ermöglichen es dem Bereitschaftsteam, Kontext an die nächste Schicht weiterzugeben, ohne dass Informationen verlorengehen.
Mehr als nur Funktionen
Das Preismodell ist einer der ersten Faktoren, die ich prüfe. Eine Plattform mit Abrechnung pro Host verhält sich im großen Maßstab ganz anders als eine Abrechnung pro GB ingestierter Daten, und ein Traffic Peak beim Produktlaunch sollte das Observability-Budget nicht sprengen. Ich beurteile auch, wie schnell ein Team echten Nutzen erzielt – Tools mit starker Auto-Instrumentierung und klaren OTel-Migrationsanleitungen reduzieren die Onboarding-Zeit drastisch. Integrationen ins Ökosystem runden das Bild ab. Die Anbindung an PagerDuty, Slack und die eigene CI/CD-Pipeline stellt sicher, dass Warnmeldungen die richtigen Personen erreichen und Deploy-Markierungen automatisch auf Dashboards erscheinen.
Warum nach einer Honeycomb-Alternative suchen?
Honeycomb ist ein hochmodernes Tool für Beobachtbarkeit, das Softwareentwicklern hilft, ihre Software in Produktionsumgebungen zu verstehen, zu debuggen und zu verbessern. Es zeichnet sich dadurch aus, Einblicke auf Systemebene zu liefern, wodurch sich Muster und Anomalien leichter erkennen und somit die Leistung optimieren lassen.
Trotz seiner leistungsfähigen Funktionen suchen Nutzer aus verschiedenen Gründen nach Alternativen. Diese können von Budgetbeschränkungen reichen, da die Preise von Honeycomb für einige kleinere Teams möglicherweise zu hoch sind, bis hin zu spezifischen Funktionsanforderungen, die Honeycomb nicht abdeckt, wie etwa herkömmliche Software zur Protokollverwaltung oder eine eingehende Überwachung der Anwendungsleistung.
Zuletzt bevorzugen manche Nutzer möglicherweise einfach eine Open-Source-Alternative oder eine Lösung mit einer anderen Benutzeroberfläche. Die Suche nach der perfekten Honeycomb-Alternative bedeutet, ein Tool zu finden, das ein ausgewogenes Verhältnis zwischen umfassender Funktionalität und nahtloser Benutzererfahrung bietet und gleichzeitig zu den individuellen Anforderungen und Ressourcen der Organisation passt.
Die wichtigsten Funktionen von Honeycomb
Hier sind einige der wichtigsten Funktionen von Honeycomb, die Ihnen dabei helfen sollen, die Angebote alternativer Lösungen gegenüberzustellen und zu vergleichen:
- Ereignisbasierte Telemetrie: Erfasst detaillierte Ereignisdaten, damit Ihr Team jederzeit genau sehen kann, was in Ihren Systemen passiert ist.
- Abfrage-Generator: Ermöglicht es Ihnen, komplexe Fragen zu Ihren Daten zu stellen, ohne Code schreiben zu müssen.
- BubbleUp: Hebt Ausreißer in Ihren Daten automatisch hervor, sodass Sie Probleme schneller erkennen können.
- Unterstützung für Tracing: Verknüpft Traces mit Protokollen und Metriken, damit Sie nachvollziehen können, wie eine einzelne Anfrage Ihren gesamten Technologie-Stack durchläuft.
- Boards und Ansichten: Unterstützt Sie dabei, wichtige Abfragen oder Visualisierungen, die Ihr Team häufig verwendet, zu speichern, zu organisieren und zu teilen.
- Serviceübersicht: Zeigt, wie Ihre Services miteinander interagieren, und ist hilfreich, um Abhängigkeiten und den Systemzustand zu verstehen.
- SLO-Überwachung: Ermöglicht es Ihnen, Service-Level-Ziele festzulegen und zu überwachen, damit Sie Ihre Leistungsziele im Blick behalten.
- Tools für die Teamzusammenarbeit: Ermöglichen es Ihnen, Abfragen zu kommentieren, Links zu teilen und gemeinsam Untersuchungen durchzuführen.
- Schnelle Abfrage-Engine: Reagiert schnell auf große Datensätze, was beim Beheben von Problemen in Live-Systemen hilfreich ist.
- Integrationen mit Tools wie OpenTelemetry: Erleichtern das Einbinden von Daten aus Ihrer bestehenden Umgebung.