

Det er ikke nogen lille opgave at administrere en DevOps-pipeline. Mellem at sikre stabilitet i produktionen, spore ydeevneflaskehalse og forhindre nedetid kan presset for at holde alt kørende problemfrit føles overvældende. Måske har du oplevet frustrerende forsinkelser på grund af uopdagede problemer eller haft svært ved at arbejde med værktøjer, der ikke integreres problemfrit i dine arbejdsgange. Virkeligheden er, at det uden de rette DevOps-overvågningsværktøjer bliver en kamp op ad bakke at opretholde effektiviteten og levere en god brugeroplevelse.
DevOps-overvågningsværktøjer er designet til at give dig indsigt i dine systemer, så du kan identificere og løse potentielle problemer, før de påvirker dine brugere. De er afgørende for at opretholde en problemfri drift, optimere ydeevnen og sikre, at dit team kan fokusere på innovation i stedet for brandslukning. Gennem årene har jeg arbejdet med adskillige overvågningsløsninger på tværs af store projekter og forskellige teams. I denne guide deler jeg mine bedste anbefalinger og indsigter for at hjælpe dig med at vælge det perfekte værktøj til at strømline dine processer og holde dine systemer kørende med maksimal ydeevne.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Sammenligningstabel over DevOps-overvågningsværktøjer
Tabellen nedenfor sammenligner prisoplysninger for mine bedste udvalgte DevOps-overvågningsværktøjer.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bedst til overvågning af hybrid infrastruktur | 30 dages gratis prøveperiode + gratis abonnement tilgængeligt | Fra $200/måned (faktureres årligt) | Website | |
| 2 | Bedst til overvågning af rigtige brugere | 30 dages gratis prøveperiode + gratis demo tilgængelig | Fra $10/måned (faktureres årligt) | Website | |
| 3 | Bedst til overvågning af flere cloudmiljøer | 30-dages gratis prøveperiode + gratis demo + gratis abonnement tilgængeligt | Fra $199/år | Website | |
| 4 | Bedst til indsigt i infrastrukturen i realtid | 14 dages gratis prøveperiode + gratis abonnement + gratis demo tilgængelig | Fra $4.50/node/month (faktureres årligt) | Website | |
| 5 | Bedst til overvågning af SSL-certifikater | Gratis abonnement + gratis demo tilgængelig | Fra $8/10 monitorer/måned (faktureres årligt) | Website | |
| 6 | Bedst til overvågning af serverforstyrrelser og nedbrud | 14-dages gratis prøveperiode | Fra $21/bruger/måned | Website | |
| 7 | Bedst til kontinuerlig overvågning af store portnetværk | 30 dages gratis prøveperiode | Fra $1,995/bruger | Website | |
| 8 | Bedst til ydelsesovervågning af websteder og mobilapps | 15 dages gratis prøveperiode | Fra $6/kerne/måned | Website | |
| 9 | Bedst til observerbarhed af hele SaaS-teknologistakken | Gratis abonnement tilgængeligt | Fra $49/bruger/måned | Website | |
| 10 | Bedst til overvågning og søgning i store datamængder | 60 dages gratis prøveperiode | Pris oplyses på forespørgsel | Website |


Anmeldelser af de bedste DevOps-overvågningsværktøjer
Her får du et overblik over de bedste DevOps-overvågningsværktøjer. Jeg fremhæver de funktioner, hvert værktøj tilbyder, og hvorfor de fortjener en plads på denne liste.
 Bedst til overvågning af hybrid infrastruktur
- 30 dages gratis prøveperiode + gratis abonnement tilgængeligt
- Fra $200/måned (faktureres årligt)
Visit WebsiteCustomer Rating:4.6/5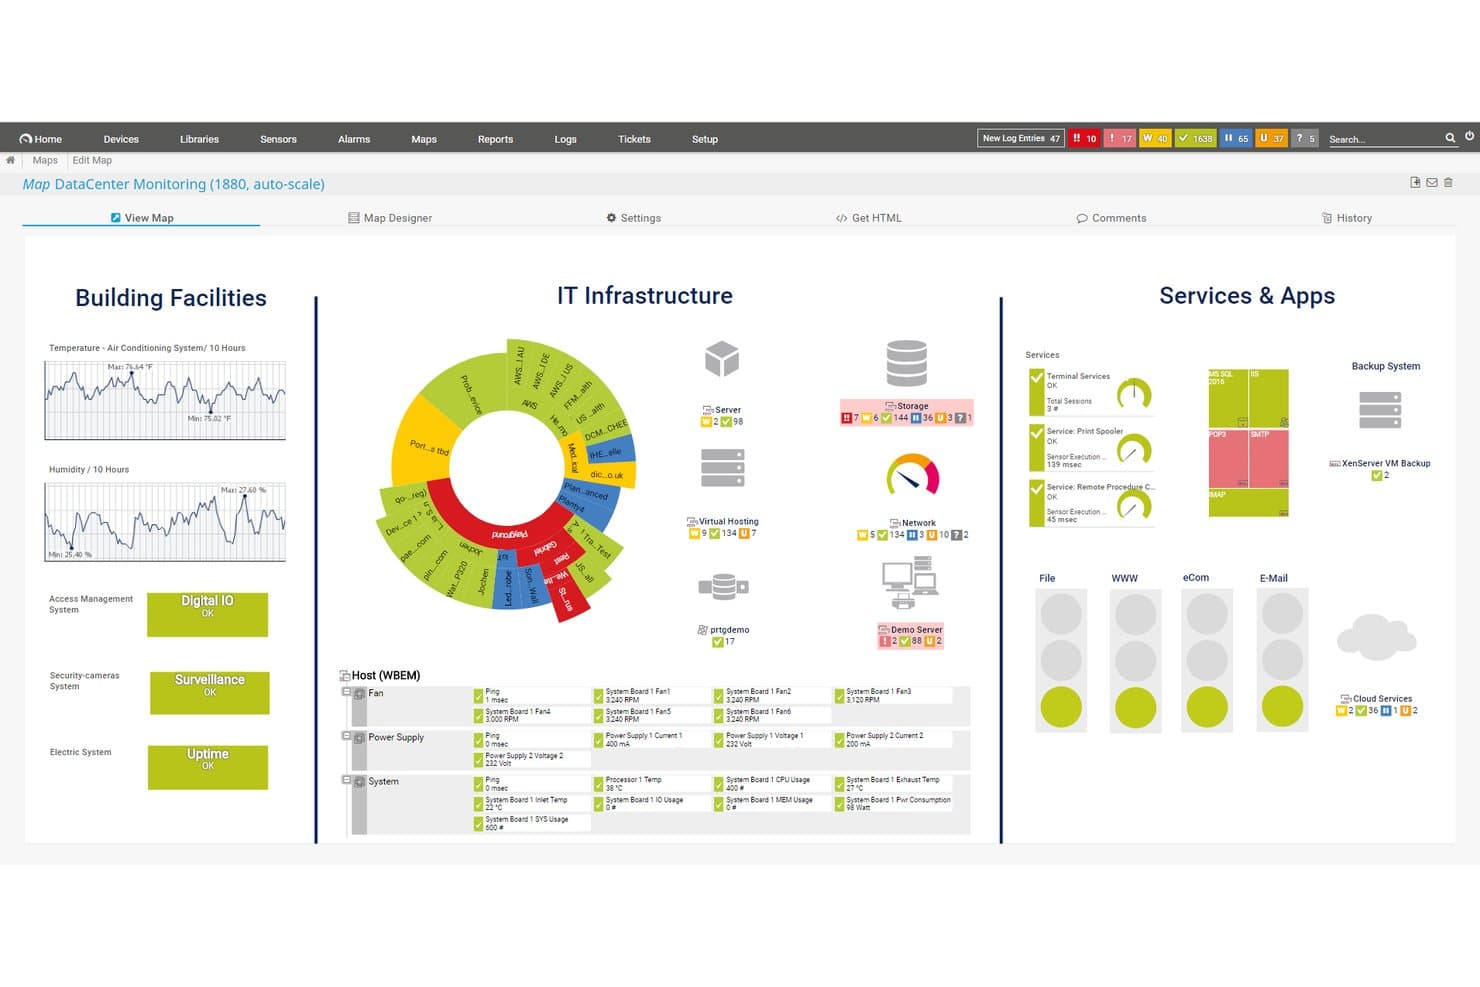
Paessler PRTG tilbyder et overvågningskort til datacentre, der viser bygningsfaciliteter, IT-infrastruktur samt tjenester og applikationer i ét samlet kontrolpanel. Paessler PRTG er en agentløs platform til overvågning af IT-infrastruktur, der sporer netværksenheder, servere, applikationer, databaser og cloudressourcer gennem et sensorbaseret system med brugerdefinerbare kontrolpaneler og realtidsadvarsler.
Hvem er Paessler PRTG bedst egnet til?
IT-driftshold i mellemstore til store organisationer, der har brug for centraliseret indsigt på tværs af lokale netværk, servere og hybrid infrastruktur.
Hvorfor valgte jeg Paessler PRTG?
Jeg valgte Paessler PRTG som en af de bedste løsninger, fordi den sensorbaserede arkitektur lader mig hente målinger fra netværksenheder, servere, applikationer og cloudressourcer ind på én samlet platform. Jeg kan godt lide, hvordan PRTG's kortdesigner lader mig opbygge brugerdefinerbare kontrolpaneler i realtid, der afspejler min faktiske infrastruktur og ikke en generisk skabelon. Opsætningen af fjernprober udvider denne dækning på tværs af flere lokationer uden at skulle tage separate overvågningsværktøjer i brug.
Vigtige funktioner i Paessler PRTG
- Sensorbaseret overvågning: Giver dig mulighed for at spore en række enhedstyper, tjenester og protokoller ved at tildele individuelle sensorer til specifikke målinger.
- REST-baserede brugerdefinerede sensorer: Gør det muligt at hente data fra tredjeparts-API'er eller brugerdefinerede applikationer via HTTP-anmodninger.
- Distribueret overvågning med fjernprober: Understøtter overvågning af geografisk spredt infrastruktur fra én enkelt konsol.
- Revisionslogning og enkeltlogon: Muliggør sporing af brugeraktivitet og strømlinet adgangsstyring med henblik på overholdelse af krav i større organisationer.
Integrationer med Paessler PRTG
Paessler PRTG tilbyder indbyggede integrationer med Amazon CloudWatch, Microsoft Azure, VMware vSphere og Slack samt en API til brugerdefinerede integrationer.
Pros and Cons
Pros:
- Brugerdefinerbare sensorer på tværs af infrastrukturlag
- Stærk understøttelse af lokale og hybride implementeringer
- Automatisk opdagelse kortlægger hele dit netværk automatisk
Cons:
- Begrænset indbygget overvågning af containere og Kubernetes
- Brugerfladen virker forældet sammenlignet med moderne alternativer
Learn more about Paessler PRTG: Bedst til overvågning af rigtige brugere
- 30 dages gratis prøveperiode + gratis demo tilgængelig
- Fra $10/måned (faktureres årligt)
Visit WebsiteCustomer Rating:4.7/5
Site24x7 tilbyder dashboards, der kan tilpasses, så DevOps-teams kan skræddersy deres overvågningsvisninger efter deres specifikke behov. Site24x7 er en cloudbaseret overvågningsløsning designet til DevOps- og IT-driftsteams. Den tilbyder omfattende overvågningsfunktioner til websteder, servere, netværk, applikationer og cloudtjenester. Med Site24x7 kan du få indsigt i realtid i din IT-infrastrukturs ydeevne og tilstand.
Hvorfor jeg valgte Site24x7: Jeg kan godt lide funktionen til overvågning af applikationsydeevne (APM). Dette værktøj hjælper dig med at identificere og fejlfinde problemer med ydeevnen i dine applikationer ved at give detaljeret indsigt i transaktionsspor, databaseforespørgsler og applikationskomponenter. En anden værdifuld funktion er overvågning af rigtige brugere (RUM). RUM giver dig mulighed for at spore og analysere oplevelserne hos faktiske brugere på dine websteder og webapplikationer. Ved at forstå, hvordan brugerne interagerer med dine tjenester, kan du træffe velinformerede beslutninger for at forbedre brugervenligheden og ydeevnen.
Site24x7s fremtrædende funktioner og integrationer
Funktioner omfatter syntetisk overvågning af webtransaktioner, som lader dig simulere brugerinteraktioner for at identificere potentielle problemer, før de påvirker rigtige brugere. Derudover giver netværksovervågning indsigt i tilstanden af dine netværksenheder, så du kan opretholde pålideligheden. Logstyring er en anden funktion, der gør det muligt at indsamle og analysere logfiler fra forskellige kilder, hvilket fremmer effektiv fejlfinding og problemløsning.
Integrationer omfatter ServiceNow, PagerDuty, Jira, Microsoft Teams, Slack, Nagios, AWS, Azure, Google Cloud Platform, Docker, Jenkins og Kubernetes.
Pros and Cons
Pros:
- Tilbyder advarsler i realtid på tværs af forskellige kanaler
- Dashboards og rapporter, der kan tilpasses
- Omfattende overvågning af forskellige systemer
Cons:
- For mange advarsler kan virke overvældende for brugerne
- Kompleksitet ved den indledende opsætning i store miljøer
Learn more about Site24x7: Bedst til overvågning af flere cloudmiljøer
- 30-dages gratis prøveperiode + gratis demo + gratis abonnement tilgængeligt
- Fra $199/år
Visit WebsiteCustomer Rating:4.3/5
Robust platform til administration af applikationsydelse med omfattende overvågningsfunktioner og integrationer fra tredjeparter, der forbedrer IT-overblikket. ManageEngine Applications Manager er et omfattende værktøj, der tilbyder overvågning af flere cloudmiljøer og giver brugerne mulighed for at overvåge, administrere, kontrollere og sikre deres multi-cloud- og hybride infrastruktur. Dets unikke salgsargument er evnen til at levere en samlet løsning til overvågning og administration af multi-cloud-miljøer, hvilket gør det til det bedste valg for virksomheder, der ønsker at effektivisere deres indsats inden for multi-cloud-overvågning.
Hvorfor jeg valgte ManageEngine Applications Manager: ManageEngine Applications Manager udmærker sig ved at tilbyde robuste funktioner, der muliggør kontinuerlig overvågning, ydelsesanalyse og fejlfinding på tværs af hele DevOps-pipelinen. Det understøtter en proaktiv tilgang til hændelseshåndtering, muliggør automatisering af rutinekontroller og leverer detaljerede analyser for at forbedre beslutningstagningen. Dets evne til problemfrit at integrere med forskellige værktøjer til udvikling, test og implementering gør det til et værdifuldt aktiv for DevOps-teams, der sigter efter høj effektivitet og minimal nedetid.
Fremtrædende funktioner og integrationer i ManageEngine Applications Manager
Funktioner omfatter omfattende understøttelse direkte fra start af overvågning af mere end 100 applikationer og servere, lige fra databaser, webservere, applikationsservere og virtuelle servere til cloudplatforme, containere og mikrotjenestearkitekturer. Derudover indeholder ManageEngine Applications Manager avancerede funktioner til analyse af grundårsager, der drives af maskinlæringsalgoritmer.
Integrationer omfatter Amazon Web Services (AWS), Microsoft Azure, Google Cloud Platform, Oracle Database, MySQL, Microsoft SQL Server, VMware, Docker, Apache Tomcat og Redis.
Pros and Cons
Pros:
- Omfattende overvågningsfunktioner på tværs af applikationer, servere og cloudmiljøer
- Tilpasselige dashboards og rapporter til indsigtsfulde analyser
- Automatiseret registrering af afvigelser og alarmmekanismer
Cons:
- Kan være komplekst at konfigurere og tilpasse til specifikke behov
- Omkostningerne kan være uoverkommelige for små og mellemstore virksomheder
Learn more about ManageEngine Applications Manager: Bedst til indsigt i infrastrukturen i realtid
- 14 dages gratis prøveperiode + gratis abonnement + gratis demo tilgængelig
- Fra $4.50/node/month (faktureres årligt)
Visit WebsiteCustomer Rating:4.8/5
Netdata tilbyder fuldt automatiserede kontrolpaneler, der visualiserer hver eneste måling. Netdata er en platform til overvågning og fejlfinding med åben kildekode, der tilbyder højopløselige målinger, journaler og visualiseringer i realtid til systemovervågning. Den har til formål at tilbyde et omkostningseffektivt og brugervenligt alternativ til dyrere og mere komplekse platforme.
Hvorfor jeg valgte Netdata: Jeg kan godt lide, at platformen lægger vægt på data med høj nøjagtighed og tilbyder visualiseringer i realtid, så brugerne kan overvåge systemets ydeevne og tilstand præcist. Den forenkler og forbedrer også overvågningsprocessen for DevOps med funktioner til indsamling, lagring, forespørgsel, visualisering og alarmering for en lang række målinger. Netdata kan køres på flere noder, og hver Netdata-instans kan fungere selvstændigt.
Netdatas fremtrædende funktioner og integrationer
Funktioner omfatter alarmer, der underretter brugerne om problemer, som registreres i systemet, automatisk registrering af anomalier samt automatiserede og tilpasselige kontrolpaneler. Derudover er kernen i Netdata-økosystemet baseret på åben kildekode, og den omfatter alle overvågningsfunktionerne såsom databasen, forespørgselsmotoren, scoringsmotoren, sundhedsmotoren og maskinlæringsmotoren.
Integrationer omfatter containere, Kubernetes-containere, virtuelle maskiner, Apache, Consul, Elasticsearch, OpenSearch, MySQL, Redis, Squid-logfiler, Windows, macOS og hundredvis af andre.
Pros and Cons
Pros:
- Automatiserede alarmer
- Ubegrænset overvågning af målinger
- Interaktive grafer til datavisualisering
Cons:
- Det kan kræve en indlæringskurve at udnytte funktionerne fuldt ud
- Indsigterne kunne være mere omfattende
Learn more about Netdata: Bedst til overvågning af SSL-certifikater
- Gratis abonnement + gratis demo tilgængelig
- Fra $8/10 monitorer/måned (faktureres årligt)
Visit WebsiteCustomer Rating:4.7/5
UptimeRobot sporer SSL-certifikatstatus og oppetid i ét kontrolpanel i realtid. For DevOps-teams, der søger en pålidelig overvågningsløsning, tilbyder UptimeRobot en praktisk mulighed, der understøtter overvågning af SSL-certifikater sammen med oppetidskontroller. Den egner sig til teams i alle størrelser, fra enkeltpersoner til større organisationer, som har brug for indsigt i tjenestetilgængelighed og slutpunktets ydeevne. Ved at hjælpe teams med at opdage problemer såsom udløbne certifikater, nedetid og langsomme svartider understøtter UptimeRobot stabil drift og ensartet levering af tjenester.
Hvorfor jeg valgte UptimeRobot
Jeg valgte UptimeRobot på grund af overvågningen af SSL-certifikater, som hjælper DevOps-teams med at undgå problemer forårsaget af udløbne eller forkert konfigurerede certifikater. Den sporer certifikatstatus og sender advarsler, før certifikater udløber, hvilket reducerer risikoen for adgangsadvarsler eller driftsafbrydelser. UptimeRobot tilbyder også nedetidsadvarsler gennem integrationer som Slack og PagerDuty, hvilket gør det lettere for teams at reagere hurtigt og holde tjenesterne pålidelige.
UptimeRobots vigtigste funktioner
Ud over overvågning af SSL-certifikater tilbyder UptimeRobot:
- Kontroller fra flere placeringer: Overvåg dine tjenester fra flere globale placeringer for at sikre tilgængelighed i hele verden.
- Overvågning af svartid: Følg, hvor hurtigt din server svarer, for at få indsigt i flaskehalse i ydeevnen.
- Tilpasningsbare statussider: Del statusopdateringer i realtid med brugere gennem brandede statussider.
- Hændelseshåndtering: Håndter og løs hændelser effektivt med tilpasningsbare advarsler og adgangsniveauer for teams.
UptimeRobot-integrationer
Integrationer omfatter Slack, PagerDuty, Microsoft Teams, Telegram, Discord, Splunk On-Call og flere, hvilket muliggør problemfri håndtering af advarsler på tværs af dine foretrukne kommunikationsplatforme.
Pros and Cons
Pros:
- Advarsler i realtid sikrer hurtig reaktion på nedetidsproblemer
- SSL-overvågning hjælper med effektivt at opretholde webstedets sikkerhed
- Understøtter flere advarselskanaler
Cons:
- Begrænset tilpasning af meddelelsesindstillinger sammenlignet med konkurrenterne
- Ikke velegnet til komplekse DevOps-stakke
Learn more about UptimeRobot: Bedst til overvågning af serverforstyrrelser og nedbrud
- 14-dages gratis prøveperiode
- Fra $21/bruger/måned
Visit WebsiteCustomer Rating:4.5/5
Du kan overvåge og beregne procentdelen af mislykkede API-anmodninger i PagerDuty. PagerDuty er en platform til hændelsesberedskab, der sender advarsler, når der opstår en serviceforstyrrelse eller et nedbrud. I kritiske øjeblikke kan den sende e-mailnotifikationer, SMS-notifikationer og telefonnotifikationer til dit udviklingsteam eller din kundebase.
Hvorfor jeg valgte PagerDuty: Jeg valgte PagerDuty, fordi det er et fremragende værktøj, hvis du driver missionskritisk infrastruktur, som du vil holde øje med. Platformen gør det muligt for dig at modtage notifikationer om vagtalarmer med det samme.
PagerDuty – fremtrædende funktioner og integrationer:
Funktionerne , der fremstod som de mest nyttige for mig, er 100 % fokuseret på at advare teams, hvis systemer, noder eller applikationstjenester går galt, og omfatter e-mailadvarsler, mobiladvarsler, analyse af den grundlæggende årsag, notifikationer i realtid og prioritering. Du kan også automatisk planlægge og eskalere problemer.
Integrationerne omfatter forudbyggede integrationer til AWS, ServiceNow, Salesforce, Zendesk, Atlassian, Datadog, Slack, Splunk og flere.
Pros and Cons
Pros:
- Gør det muligt for dig at tildele hændelsesberedskab til den rette person eller det rette team
- Tilpassede advarsler kan sendes via e-mail, telefon, SMS eller push-notifikationer
- Filtrerer notifikationer for at prioritere vigtige advarsler, der indikerer ægte trusler, samtidig med at antallet af falske alarmer reduceres
Cons:
- Det kan være vanskeligt at finde historiske advarsler, medmindre du har et præcist ID
- Bruger et konventionelt kontrolpanel, der kunne være mere tilpasningsbart til specifikke behov og præferencer
Learn more about PagerDuty: Bedst til kontinuerlig overvågning af store portnetværk
- 30 dages gratis prøveperiode
- Fra $1,995/bruger
Visit WebsiteCustomer Rating:4.6/5
Her kan du overvåge båndbredde og portstatus i Nagios. Nagios er en softwareapplikation med åben kildekode, der overvåger trafiknetværk kontinuerligt. Den kan spore båndbreddeforbruget pr. port for indgående og udgående trafik, registrere netværksudfald, identificere overbelastede porte og opdage misbrugere af netværket.
Hvorfor jeg valgte Nagios: I stedet for at udsætte mine systemer for sårbarheder eller bekymre mig om langsom netværksydelse giver Nagios mit DevOps-team øjeblikkeligt overblik over vores netværk. Jeg kunne også godt lide, at det logger oplysninger som problemer med netværksinfrastrukturen og processer, der er mislykkedes på porten.
Nagios' fremtrædende funktioner og integrationer
Funktioner tilbudt af Nagios sikrer mine netværksporte. Dette omfatter SNMP-overvågning, overvågning af switches og routere, netværksovervågning og ping-overvågning, som hjælper mig med at bevare integriteten og sikkerheden i min netværksinfrastruktur.
Integrationer omfatter blandt andet færdigbyggede integrationer til Amazon SNS, Prometheus, PagerDuty og Dynatrace. Nagios har desuden over 3.000 officielle plugins og fællesskabsplugins, som udviklere kan føje til deres stak.
Pros and Cons
Pros:
- Versionen med åben kildekode er 100 % gratis
- Ressourcelet med minimalt ressourceforbrug
- Øger tilgængeligheden af hele din netværksinfrastruktur ved protokolfejl og netværksudfald
Cons:
- Der kræves separate licenser til sikkerheds- og netværkssynlighedsfunktioner
- Bruger filer i stedet for databaser til at gemme konfigurationsfiler på backend'en
Learn more about Nagios: Bedst til ydelsesovervågning af websteder og mobilapps
- 15 dages gratis prøveperiode
- Fra $6/kerne/måned
Visit WebsiteCustomer Rating:4.3/5
AppDynamics kan overvåge historiske betalingsoplysninger og levere data om brugerloginforhold. AppDynamics er et værktøj til applikationsydelsesstyring i hele stakken. Det anvender maskinlæringsalgoritmer til at registrere ydelsesproblemer, sammenligner dem med baseline-målinger og udløser advarsler efter behov.
Hvorfor jeg valgte AppDynamics: Jeg valgte AppDynamics, fordi det fokuserer på applikationsydelse og samtidig bruger overvågning til at sikre en optimal brugeroplevelse. Uanset om du administrerer et websted eller en mobilapp, sikrer AppDynamics, at dine kunder ikke oplever problemer som timeout eller langsomme indlæsningstider for sider.
AppDynamics' fremtrædende funktioner og integrationer:
Funktioner som jeg fandt gør AppDynamics fremragende til ydelsesovervågning, omfatter overvågning af applikationsydelse (APM) og infrastruktursynlighed med databasesynlighed. Derudover fangede slutbrugerovervågning også min opmærksomhed, da den sikrer, at dine kunder får de hurtigst mulige applikationshastigheder.
Integrationer som AppDynamics samarbejder med, omfatter præbyggede plugins som LoadRunner, Sainapse og NeoLoad til ydelse og kontinuerlig levering. AppDynamics samarbejder også med SquaredUp, Medallia og Quantum Metric for at overvåge kundeoplevelsen.
Pros and Cons
Pros:
- Giver oplysninger i realtid om processer, der bruger CPU og hukommelse
- Overvågningsdybden for webapplikationer og infrastruktur er enorm
- Netværkssynlighed giver dig mulighed for at se den mængde båndbredde, der bruges pr. node
Cons:
- Funktionaliteten kan være overvældende for små virksomheder
- Ingen automatisk applikationsscanning; de skal defineres i en konfigurationsfil
Learn more about AppDynamics: Bedst til observerbarhed af hele SaaS-teknologistakken
- Gratis abonnement tilgængeligt
- Fra $49/bruger/måned
Visit WebsiteCustomer Rating:4.3/5
Du kan overvåge hver instans af din tjeneste med New Relic. New Relic er et websporings- og analyseværktøj, der overvåger den aktuelle observerbarhed af hver applikationskomponent, som er fordelt på databaser og servere.
Hvorfor jeg valgte New Relic: Jeg valgte New Relic, fordi det tilbyder en 'alt-i-én'-løsning, der overvåger og analyserer alle aspekter af din teknologistak. Fuld synlighed fra ende til anden giver teams mulighed for at få handlingsrettet indsigt, når der opstår problemer, og hurtigt håndtere og løse dem.
New Relics fremtrædende funktioner og integrationer:
Funktioner som jeg fandt gør New Relic fremragende til overvågning af hele teknologistakken, omfatter applikationsovervågning og databaseovervågning. Derudover er der tilgængelighedsovervågning for at sikre, at dine systemer fungerer døgnet rundt fra offentlige eller private placeringer.
Integrationer er tilgængelige med forudbyggede plugins såsom AWS, Kubernetes, Azure, Google Cloud Platform og Prometheus. Du kan også bruge indbyggede integrationer som SQL Server til at sende forespørgsler til New Relic.
Pros and Cons
Pros:
- Meget funktionsrigt og giver mulighed for at skrive brugerdefinerede forespørgsler mod indsamlede instrumenteringsdata
- Giver indsigt i målinger og ydeevne selv under høj belastning og pres
- Nem installation af agenten, som giver dig mulighed for at sende data til dit dashboard på få minutter
Cons:
- Omkostningerne kan betragtes som høje, især for nystartede virksomheder og selv mellemstore virksomheder
- Grænsefladen kan være lidt vanskelig på grund af antallet af indstillinger på skærmen
Learn more about New Relic: 10Bedst til overvågning og søgning i store datamængder
Splunk
- 60 dages gratis prøveperiode
- Pris oplyses på forespørgsel
Visit WebsiteCustomer Rating:4.3/5
Splunk giver brugerne mulighed for at sortere data og leverer statistikker på tværs af forskellige datatyper Splunk er et softwareværktøj, der indsamler og indekserer data og organiserer dem i et søgbart arkiv. Det gør det muligt at generere alarmer, rapporter og visualiseringer fra store datasæt.
Hvorfor jeg valgte Splunk: Jeg valgte Splunk på grund af dets evne til at skalere og håndtere store datamængder. Med den stigende kompleksitet i moderne applikationer og distribuerede systemer sikrer Splunks skalerbarhed, at du effektivt kan administrere og analysere logfiler fra flere kilder uden at gå på kompromis med ydeevnen.
Splunks fremtrædende funktioner & integrationer:
Funktionerne i Splunk er designet til at give teams større indsigt i deres applikationer. Jeg mener, at dets indeksering og dataindsamling, funktioner til arbejdsbelastningsstyring, værktøjssæt til maskinlæring og intuitive værktøjer til dataudforskning gør det til et fremragende værktøj for teams.
Integrationer er tilgængelige med forudbyggede plugins via Docker, Jenkins, Kubernetes, Ansible, AWS, Azure og ServiceNow. Derudover giver Splunk oplysninger om funktionerne i hver integration, så du kan se, om dine integrationer kan levere spor, logfiler, målinger eller metadata til Splunk.
Pros and Cons
Pros:
- Gemmer dine søgninger og genkender automatisk vigtige data
- Meget skalerbar og nem at implementere
- Opretter analyserapporter og visualiserer data med diagrammer, grafer og tabeller
Cons:
- Kan være dyrt, især hvis dine tjenester kræver mange ressourcer
- Det kan være vanskeligt at optimere søgninger med henblik på hastighed
- Besøg webstedet Åbner nyt vindue
Learn more about Splunk:
Andre DevOps-overvågningsværktøjer
Her er nogle andre værktøjer, der ikke helt nåede med blandt de 12 bedste, men som bestemt er værd at undersøge:
- 11PrometheusBedst til alarmer og aggregering af metrikker
- 12Grafana CloudBedst til overvågning af dataanalyse og visualisering
- 13BuddyBedst til overvågning af websteder og mobilapps for små virksomheder
- 14InfluxDBBedst til overvågning af tidsseriedata i en enkelt database med flere formål
- 15SensuBedst til overvågning af cloudmiljøer
- 16ChaosSearchBedst til centralisering af log- og hændelsesdata i skyen
- 17DynatraceBedst til overvågning af ydeevnen fra ende til anden i store virksomheder
- 18Dotcom MonitorBedst til overvågning af kritiske arbejdsgange
Relaterede anmeldelser af software og værktøjer
Hvis du stadig ikke har fundet det, du leder efter her, kan du se nærmere på disse andre typer værktøjer, som vi har testet og evalueret.
- Netværksovervågningssoftware
- Serverovervågningssoftware
- SD-Wan-løsninger
- Infrastrukturovervågningsværktøjer
- Pakkesniffer
- Værktøjer til applikationsovervågning
Sådan evaluerer jeg DevOps-overvågningsværktøjer
Jeg evaluerer disse værktøjer i to lag: kernekrav som indsamling af målepunkter, distribueret sporing og alarmdirigering samt differentierende faktorer, der afgør, om de passer til din stak og dit team.
Grundlæggende funktionalitet (minimumskrav for denne liste)
Når jeg udvælger værktøjer til min liste, vurderer jeg hvert enkelt på en skala fra 0 (tilbyder ikke funktionaliteten) til 5 (udmærker sig på dette område) for hver af de nedenstående kernefunktioner. Derefter omregner jeg værktøjets samlede score til en procentdel. Hvert værktøj skal opnå en samlet minimumsscore på 75 % for at komme i betragtning.
- Overvågning af infrastruktur og applikationer: Jeg vurderer, om et værktøj kan spore værter, containere, databaser og applikationstjenester på ét sted, for eksempel ved at overvåge CPU-spidser på Kubernetes-noder sammen med API-forsinkelse.
- Observerbarhed på hele stakken: Logfiler, målepunkter og spor skal korreleres på tværs af tjenester, så du kan følge en langsom anmodning fra en brugerfladefejl gennem hop mellem mikrotjenester til den grundlæggende årsag.
- Alarmering i realtid og hændelseshåndtering: Jeg undersøger, om der er konfigurerbare alarmbetingelser, eskaleringspolitikker og dirigering til værktøjer som PagerDuty eller Slack, så vagthavende ingeniører får besked via den rette kanal.
- Overvågning af CI/CD-pipelines: Det er vigtigt at kunne spore udrulninger. Jeg ser efter indsigt i byggetrin, fejlrater og muligheden for at korrelere en mislykket udrulning med en hændelse i produktionen.
- Integrationer med DevOps-værktøjskæden: Værktøjet bør kunne integreres med din eksisterende stak. Jeg ser efter indbyggede forbindelser til Kubernetes, Terraform, Jenkins, GitHub og større cloud-udbydere.
- Afvigelsesregistrering og analyse af grundlæggende årsager: Jeg vurderer, om værktøjet går videre end statiske tærskelværdier. ML-baseret afvigelsesregistrering og hændelseskorrelation hjælper SRE'er med at skære igennem alarmstøj under driftsafbrydelser.
Når jeg har en liste over værktøjer, der opfylder disse kriterier, vurderer jeg, hvad der adskiller de enkelte platforme.
Differentierende faktorer (det, der adskiller leverandørerne)
Sådan sammenligner jeg forskellige leverandører:
Fremtrædende funktioner
Sporing af SLO'er er en vigtig differentierende faktor. Jeg ser efter værktøjer, der lader SRE-hold definere fejlbudgetter og overvåge forbrugshastigheder, så beslutninger om pålidelighed forbliver datadrevne i stedet for reaktive. Syntetisk overvågning er også vigtig – simulering af API-kald eller brugerforløb fra flere regioner opdager problemer med forsinkelse, før rigtige brugere oplever dem. RUM supplerer dette ved at registrere den faktiske browser- og mobilydelse, så du får et fuldstændigt billede af, hvordan en udrulning påvirker slutbrugeroplevelsen.
Ud over funktionerne
Jeg vurderer nøje, hvor forudsigelige priserne er. Nogle værktøjer fakturerer pr. vært, mens andre opkræver betaling efter datamængde, og omkostningerne til opbevaring af logfiler kan løbe løbsk, når du indsamler terabyte fra en stor Kubernetes-klynge. Understøttelse af OpenTelemetry er en anden faktor, jeg undersøger, eftersom anvendelse af åbne standarder beskytter dit team mod leverandørlåsning, hvis behovene ændrer sig. Jeg overvejer også tiden til at skabe værdi: automatisk instrumentering og forudbyggede kontrolpaneler kan betyde forskellen på at gå i drift på få dage og at bruge flere uger på manuel opsætning.
Sådan vælger du DevOps-overvågningsværktøjer
Det er nemt at fortabe sig i lange funktionslister og komplekse prisstrukturer. For at hjælpe dig med at holde fokus, mens du arbejder dig gennem din unikke proces for valg af software, får du her en tjekliste over faktorer, du bør have i tankerne:
| Faktor | Hvad skal overvejes |
|---|---|
| FaktorSkalerbarhed | Hvad skal overvejesSørg for, at værktøjet kan håndtere stigende arbejdsbelastninger og flere brugere uden at miste ydeevne. Cloudbaserede løsninger med automatisk skalering kan hjælpe med at håndtere vækst. |
| FaktorIntegrationer | Hvad skal overvejesKontrollér, om værktøjet integreres med jeres eksisterende DevOps-teknologistak, herunder CI/CD-pipelines, cloudtjenester og platforme til hændelsesberedskab. |
| FaktorTilpasningsmuligheder | Hvad skal overvejesSe efter muligheder for at justere overvågningsindstillinger, alarmtærskler og kontrolpaneler, så de passer til jeres teams arbejdsgange og prioriteter. |
| FaktorBrugervenlighed | Hvad skal overvejesVærktøjet bør have en overskuelig grænseflade og intuitive kontroller, så jeres team hurtigt kan opdage problemer og reagere på dem. Komplicerede opsætninger kan forsinke responstiderne. |
| FaktorBudget | Hvad skal overvejesSammenlign abonnementsomkostninger, licensgebyrer og ekstra gebyrer for avancerede funktioner eller øgede datagrænser. Vær opmærksom på skjulte omkostninger. |
| FaktorSikkerhedsforanstaltninger | Hvad skal overvejesSe efter kryptering, adgangskontroller og sikker dataoverførsel for at beskytte følsomme oplysninger og forhindre databrud. |
| FaktorAdvarsler i realtid | Hvad skal overvejesVærktøjet bør give øjeblikkelige advarsler om problemer med ydeevnen eller driftsforstyrrelser, så jeres team kan handle hurtigt og minimere nedetid. |
| FaktorDataopbevaring og rapportering | Hvad skal overvejesSørg for, at værktøjet gemmer historiske data længe nok til meningsfuld analyse og identifikation af tendenser. Eksporterbare rapporter er nyttige til teamevalueringer. |
Tendenser inden for DevOps-overvågningsværktøjer
I min research indsamlede jeg utallige produktopdateringer, pressemeddelelser og udgivelseslogfiler fra forskellige leverandører af DevOps-overvågningsværktøjer. Her er nogle af de nye tendenser, jeg holder øje med:
Forbedret anomalidetektion: Nye maskinlæringsmodeller forbedrer anomalidetektionen, hjælper teams med at opdage uregelmæssige mønstre i realtid og reducerer antallet af falske positiver.
Observérbarhed på tværs af hele teknologistakken: Leverandører bevæger sig ud over grundlæggende overvågning for at give et komplet overblik over infrastruktur, applikationer og brugeroplevelse på ét sted. Det gør det lettere at identificere og løse problemer. Når du evaluerer platforme til observérbarhed, bør du se efter løsninger, der tilbyder omfattende overvågningsfunktioner.
AI-drevne indsigter: Flere værktøjer bruger AI til at analysere data og forudsige problemer med ydeevnen, før de opstår. Det hjælper teams med at handle proaktivt i stedet for at reagere på fejl.
Distribueret sporing: Værktøjer tilføjer sporingsfunktioner, der gør det muligt for teams at følge forespørgsler på tværs af mikrotjenester og containere. Det hjælper med at lokalisere, hvor forsinkelser eller fejl opstår.
Selvreparerende systemer: Nogle værktøjer tilbyder nu automatiseret afhjælpning, hvor systemet kan registrere et problem og løse det uden menneskelig indgriben. Det reducerer nedetid og responstider.
Hvad er DevOps-overvågningsværktøjer?
DevOps-overvågningsværktøjer er specialiserede softwareløsninger, der er udviklet til at spore og analysere ydeevnen og tilstanden af applikationer og infrastruktur i realtid. Disse værktøjer bruges primært af DevOps-ingeniører, systemadministratorer og IT-fagfolk til at sikre problemfri drift og levering af softwareprodukter.
DevOps-overvågningsværktøjer hjælper med at automatisere overvågningsprocessen, giver indsigt i systemets ydeevne og identificerer og løser hurtigt problemer, før de påvirker produktionsmiljøet. Funktioner som advarsler i realtid, værktøjer til dataobservérbarhed og prædiktiv analyse understøtter proaktiv problemløsning og forbedrer den operationelle effektivitet.
Funktioner
Her er nogle af de vigtigste funktioner, jeg ser efter i DevOps-overvågningsværktøjer, når jeg vurderer dem til min liste:
- Advarsler og notifikationer i realtid: Denne funktion sikrer øjeblikkelig opmærksomhed på problemer, efterhånden som de opstår. Den er afgørende for hurtigt at afhjælpe problemer og forhindre, at mindre problemer udvikler sig til større driftsforstyrrelser.
- Omfattende dashboards: Dashboards giver et samlet overblik over alle målinger og logfiler. De er afgørende for at visualisere udviklingspipelineens tilstand og applikationernes sundhedstilstand, hvilket gør det lettere at identificere tendenser og potentielle problemer.
- Tilpasningsbare målinger: Tilpasningsmuligheder til overvågning af specifikke målinger. Ved at tilpasse målingerne til specifikke behov opnås en mere fokuseret overvågning, så teams kan følge de præstationsindikatorer, der er mest relevante for deres projekter.
- Logstyring og -analyse: Effektiv logstyring og analytiske funktioner. Analyse af logfiler hjælper med at diagnosticere problemer og forstå applikationernes adfærd, hvilket er afgørende for fejlfinding og optimering.
- Skalerbarhed: Muligheden for at skalere overvågningsløsninger, efterhånden som projekterne vokser. Skalerbarhed sikrer, at overvågningsværktøjet kan håndtere øgede belastninger og dermed forhindre forringelse af ydeevnen over tid.
- Integrationsfunktioner: Muligheden for at integrere med en lang række værktøjer til API-overvågning og platforme. Denne funktion muliggør problemfrit samarbejde på tværs af de værktøjer, der anvendes i udviklingspipelinen, og forbedrer arbejdsgangens effektivitet og datakonsistensen.
- Sikkerheds- og compliancefunktioner: Indbyggede sikkerhedsforanstaltninger og compliance-rapportering. Disse funktioner hjælper med at beskytte følsomme data og sikre, at udviklingspipelinen opfylder lovgivningsmæssige krav.
- Automatiseret hændelseshåndtering: Automatisering af processen for håndtering af hændelser. Ved automatisk at håndtere hændelser kan teams reducere nedetid og forbedre svartiderne, hvilket fører til mere pålidelige applikationer.
- Cloud-native-understøttelse: Optimeret til overvågning af cloudbaserede miljøer. Da mange applikationer nu hostes i skyen, sikrer indbygget understøttelse, at overvågningen er effektiv i disse miljøer.
- Synlighed fra ende til anden: Muligheden for at overvåge alle aspekter af udviklingspipelinen. Denne funktion giver et helhedsorienteret overblik over pipelinen, fra kode-commits til implementering, hvilket er afgørende for at forstå konsekvenserne af ændringer og identificere flaskehalse.
Fordele
Overvågningsværktøjer spiller en afgørende rolle i DevOps-økosystemet. De hjælper ikke kun med hurtigt at identificere og løse problemer, men giver også indsigt, der kan føre til mere velinformerede beslutninger og forbedret overordnet ydeevne. Her er nogle yderligere specifikke fordele ved disse værktøjer for dit DevOps-team:
- Forbedret driftseffektivitet: DevOps-overvågningsværktøjer automatiserer sporing og analyse af forskellige målinger og logfiler på tværs af udviklingspipelinen. Denne automatisering frigiver værdifuld tid for teams, så de kan fokusere på mere strategiske opgaver i stedet for manuel overvågning og fejlfinding.
- Forbedret systempålidelighed: Ved at levere advarsler og notifikationer i realtid gør disse værktøjer det muligt for teams hurtigt at opdage og løse problemer, før de udvikler sig til mere alvorlige problemer. Denne mulighed for øjeblikkelig reaktion reducerer nedetiden betydeligt og sikrer, at systemerne forbliver stabile og pålidelige.
- Proaktiv problemløsning: Brugen af prædiktiv analyse og anomalidetektion hjælper organisationer med at forudse problemer, før de opstår. Ved at identificere potentielle problemer på forhånd kan teams implementere løsninger proaktivt, forhindre driftsforstyrrelser og opretholde en problemfri drift.
- Optimeret ydeevne: DevOps-værktøjer til databaser giver indsigt i applikations- og infrastrukturens ydeevne og identificerer flaskehalse og områder, der kan forbedres. Disse oplysninger gør det muligt for teams at optimere deres systemer for bedre ydeevne, hvilket forbedrer brugeroplevelsen og driftseffektiviteten.
- Styrket sikkerhed: Med funktioner, der fokuserer på overvågning af sikkerhedsmålinger og compliance-standarder, spiller disse værktøjer en afgørende rolle i identifikationen af sårbarheder og sikringen af, at systemerne følger bedste praksis inden for sikkerhed. Denne styrkede sikkerhed beskytter mod brud og opretholder integriteten af organisationens data og systemer.
Omkostninger og priser
Med en række tilgængelige plantyper kan en forståelse af priserne og funktionerne i hver plan hjælpe softwarekøbere med at træffe en velinformeret beslutning, der passer til deres behov og budget. Fra gratis versioner til små projekter til planer på virksomhedsniveau med avancerede funktioner findes der overvågningsværktøjer til alle driftsstørrelser.
Sammenligningstabel for planer til DevOps-overvågningsværktøjer
Nedenfor finder du en detaljeret oversigt over de almindelige plantyper og priser for DevOps-overvågningsværktøjer, som skal hjælpe nye brugere af denne softwarekategori med at navigere blandt deres valgmuligheder.
| Plantype | Gennemsnitspris | Almindelige funktioner |
|---|---|---|
| PlantypeGratis | Gennemsnitspris$0 | Almindelige funktionerGrundlæggende overvågningsfunktioner, begrænsede målepunkter og logfiler, fællesskabssupport, adgang til fora |
| PlantypeBasis | Gennemsnitspris$20-$50/bruger/måned | Almindelige funktionerUdvidede overvågningsfunktioner, flere målepunkter og logfiler, e-mailsupport, integration med andre værktøjer |
| PlantypeStandard | Gennemsnitspris$50-$100/bruger/måned | Almindelige funktionerKomplet overvågningspakke, avanceret analyse, support døgnet rundt, tilpasningsbare kontrolpaneler, integrationsmuligheder |
| PlantypePremium | Gennemsnitspris$100-$200/bruger/måned | Almindelige funktionerPremiumfunktioner, herunder prædiktiv analyse, maskinlæringsfunktioner, dedikeret support, brugerdefinerede integrationer |
| PlantypeVirksomhed | GennemsnitsprisTilpasset pris | Almindelige funktionerAlle premiumfunktioner samt skaleringsmuligheder, dedikeret kundeansvarlig, sikkerhed i virksomhedsklasse |
Ofte stillede spørgsmål om DevOps-overvågningsværktøjer
Her er nogle svar på almindelige spørgsmål om DevOps-overvågningsværktøjer: