Osoby nietechniczne mogą usłyszeć „przestój” i z rozmarzeniem pomyśleć o urlopie. Jednak dla specjalistów ds. technologii przestój to niepożądane słowo – i słusznie. Przestój sieci oznacza zły dzień w biurze.
Przestój sieci oznacza niezadowolonych klientów, gwałtowny spadek produktywności i inne problemy. Gdy mówimy o aplikacjach skierowanych do klientów, takich jak strona internetowa, przestój jest kosztowny: większe firmy tracą około 9 000 USD na minutę.
Choć przestój może negatywnie wpływać na firmy każdego rodzaju i każdej wielkości, jest szczególnie problematyczny w niektórych branżach. Firma handlowa może stracić 1,1 miliona USD na godzinę przestoju.
TL;DR: Przestój jest zły.
Z drugiej strony ograniczanie przestojów i zapobieganie im jest dobre. Co więcej, jest koniecznością – ponieważ nawet niewielkie przestoje sieci mogą zaszkodzić wynikom finansowym i spowodować szkody uboczne, takie jak pogorszenie reputacji.
W tym artykule zdefiniujemy problem i omówimy, co jest potrzebne do jego rozwiązania – w tym 13-etapowe ramy opracowywania własnego planu ograniczania przestojów sieci. Najpierw warto zacząć od prostej definicji.
Czym jest przestój sieci?
Przestój sieci oznacza, że część lub całość sieci IT staje się niedostępna, przez co takie elementy jak strona internetowa lub aplikacje wewnętrzne, na przykład system ERP, są niedostępne przez pewien czas.
Przestoje można ogólnie podzielić na dwie główne kategorie: planowane i nieplanowane. Planowany przestój jest właśnie tym, na co wskazuje jego nazwa: jest zamierzony i zaplanowany, zwykle w związku z rutynową konserwacją, aktualizacją systemu lub migracją aplikacji.
Kiedy mówimy, że przestój sieci jest zły, tak naprawdę mamy na myśli nieplanowany przestój sieci – czyli sytuację, w której sieć przestaje działać nieoczekiwanie z dowolnej liczby potencjalnych przyczyn. Przyczyny przestojów mogą być bardzo różne: od problemów z infrastrukturą, przez błędy oprogramowania i błędy ludzkie, po cyberataki.
Co i kto jest potrzebny do ograniczenia przestojów sieci?
Biorąc pod uwagę koszty ilościowe i jakościowe, warto podjąć działania mające na celu rozwiązanie problemu nawet rzadkich przestojów sieci. Jeśli zaś sytuacja zaczyna zmieniać się z rzadkich przestojów w częste, nadszedł czas, aby rozwiązać ten problem z większą pilnością.
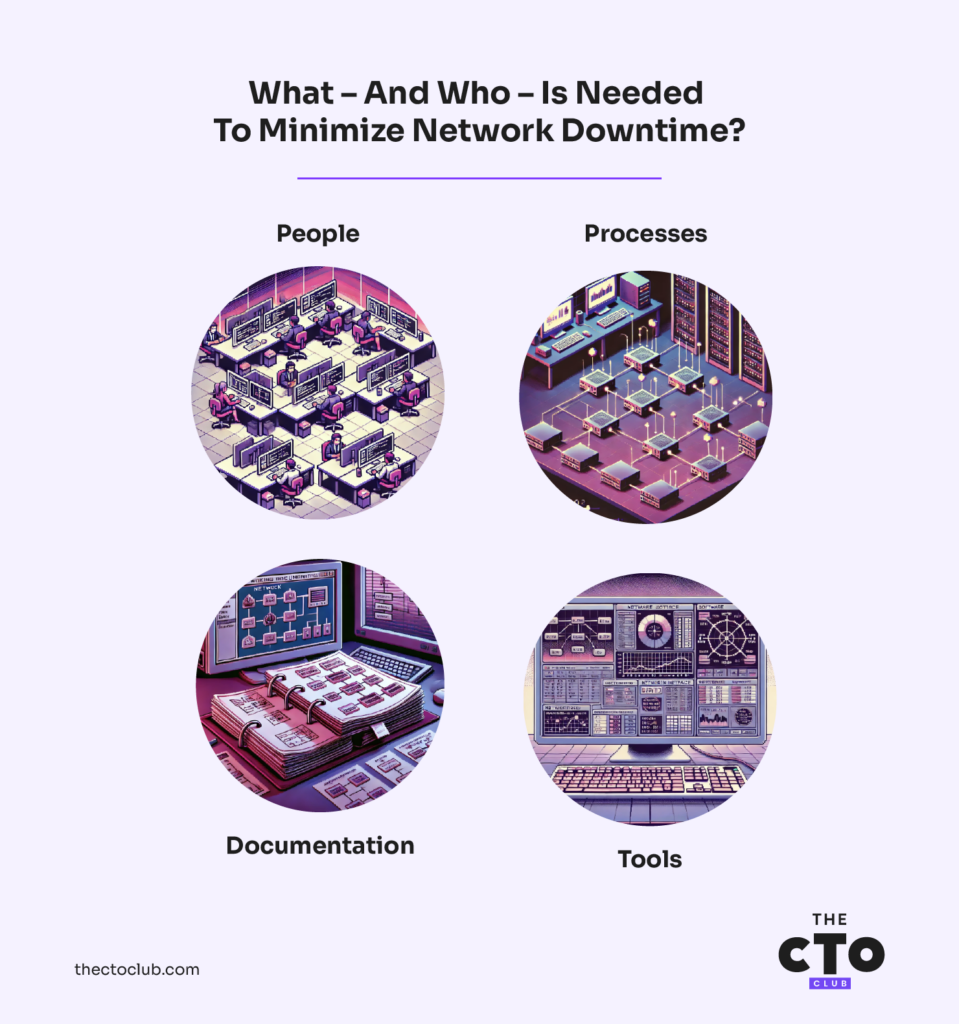
Istnieje zestaw osób, procesów, dokumentacji i narzędzi, które należy najpierw uporządkować, mówi Viacheslav Petrenko, dyrektor ds. technologii w firmie zajmującej się tworzeniem oprogramowania LITSLINK.
Petrenko podzielił się poradami dotyczącymi kluczowych elementów, które należy uporządkować przed rozpoczęciem nowej inicjatywy mającej na celu ograniczenie przestojów sieci. Mogą one dotyczyć zarówno przyszłości, jak i przeszłości. Obejmują:
Dokumentacja
Petrenko zaleca zebranie diagramów topologii sieci, raportów dotyczących incydentów, umów dotyczących poziomu usług (SLA) oraz dzienników zarządzania zmianami jako podstawowej dokumentacji.
Warto również mieć pod ręką wszelką inną dokumentację istotną dla organizacji lub konkretnej sieci.
Procesy
Eksperci zalecają przeanalizowanie kilku procesów – lub ich wdrożenie, jeśli obecnie nie funkcjonują – w ramach inicjatywy na rzecz dostępności sieci. Należą do nich:
Protokół analizy przyczyn źródłowych (RCA): Jest to podstawowy proces ograniczania przestojów sieci, ponieważ jego ostatecznym celem jest zidentyfikowanie konkretnej przyczyny lub przyczyn problemu. Analiza przyczyn źródłowych „zapewnia dokładne zbadanie każdego incydentu związanego z przestojem, aby zapobiec jego ponownemu wystąpieniu”, mówi Petrenko.
Powiązany artykuł: 5 narzędzi do analizy przyczyn źródłowych na potrzeby lepszych testów i kontroli jakości
Proces zarządzania zmianami: Ogranicza ryzyko poprzez staranną kontrolę i dokumentowanie wszystkich zmian w sieci. Uwaga: Należy zachować równowagę między dokładnością a elastycznością, aby uniknąć wąskich gardeł.
Plany odtwarzania po awarii i zapewnienia ciągłości działania: Wszelkie działania mające na celu ograniczenie przestojów sieci powinny uwzględniać – i wzajemnie wspierać – szersze plany organizacji dotyczące odporności na poważne zakłócenia operacyjne.
Powiązany artykuł: Odszyfrowanie 25 najlepszych usług odtwarzania po awarii
Harmonogram konserwacji sieci: Proaktywna konserwacja – która czasami może powodować planowany przestój – „pomaga zapobiegać problemom, zanim wystąpią, poprzez regularną aktualizację i optymalizację sieci”, mówi Petrenko.
Osoby
Praktycznie każdy w organizacji korzysta z jej sieci, ale nie oznacza to, że wszyscy muszą być zaangażowani w optymalizację jej wydajności i niezawodności. Petrenko wymienia poniższe role jako ważne do uwzględnienia w tym procesie. Należy pamiętać, że konkretne nazwy stanowisk mogą różnić się w zależności od firmy.
Inżynierowie sieci: Nie trzeba dodawać, że specjaliści wdrażający i utrzymujący infrastrukturę sieciową muszą być częścią tego procesu.
Administratorzy systemów: Podobnie osoby zarządzające serwerami (i inną infrastrukturą) oraz aplikacjami korzystającymi z sieci powinny być zaangażowane. Powiązane stanowiska mogą obejmować inżyniera DevOps, inżyniera niezawodności witryny i inżyniera infrastruktury.
Specjaliści ds. bezpieczeństwa: Zaangażowanie personelu ds. bezpieczeństwa pomaga „zapewnić bezpieczeństwo sieci i chronić przed przestojami spowodowanymi atakami lub naruszeniami bezpieczeństwa” — mówi Petrenko.
Analitycy danych: Jak wynika z wymienionej powyżej dokumentacji, optymalizacja sieci wymaga analizowania dużych ilości danych dotyczących wydajności oraz innych informacji. Potrzebne są osoby posiadające umiejętności pozwalające interpretować te dane i wyciągać wnioski służące usprawnieniom.
Kierownik projektu: Zwłaszcza w dużych przedsiębiorstwach może być potrzebna osoba koordynująca działania między zespołami i dbająca o realizację harmonogramu.
Have an account? Log In
Narzędzia
Poniżej omówimy szerzej narzędzia służące ograniczaniu przestojów sieci, ale na razie wystarczy powiedzieć, że będą potrzebne — ze szczególnym uwzględnieniem, choć nie tylko, monitorowania, rejestrowania zdarzeń, testowania i planowania. Konkretne kategorie obejmują:
Oprogramowanie do monitorowania sieci: Nie można rozwiązywać problemów, jeśli nawet nie wiadomo o ich istnieniu. Narzędzia te zapewniają wgląd w sieć i jej wydajność w czasie rzeczywistym oraz mogą generować alerty dotyczące potencjalnych problemów.
Narzędzia do zarządzania konfiguracją: Narzędzia do zarządzania konfiguracją mogą automatyzować i śledzić zmiany w infrastrukturze sieciowej oraz urządzeniach, co — jak zauważa Petrenko — może zmniejszyć ryzyko błędu ludzkiego podczas wprowadzania zmian.
Oprogramowanie do zarządzania dziennikami zdarzeń i narzędzia do analizy dzienników: Rejestrowanie zdarzeń jest kluczowym sposobem ustalania wzorców bazowych i „normalnego” zachowania w sieci, a następnie identyfikowania nietypowej aktywności, zanim potencjalnie doprowadzi ona do awarii.
Narzędzia do automatycznego testowania: Automatyzacja testów i działań związanych z zapewnianiem jakości pomaga szybciej wykrywać problemy, a także zmniejsza nakład pracy wymagany od ludzi.
Oprogramowanie do planowania pojemności: Planowanie pojemności — często będące funkcją narzędzi do monitorowania sieci — może pomóc przewidywać przyszłe wymagania sieci i zapobiegać przestojom spowodowanym przeciążeniem. Petrenko zauważa, że aby rozwiązanie to pozostało skuteczne, wymaga ono dokładnych danych wejściowych i regularnych aktualizacji.


Ograniczanie przestojów sieci w 13 krokach
Co więc właściwie zrobić ze wszystkimi powyższymi informacjami? Mamy rozwiązanie: Petrenko podzielił się z nami 13-etapowym planem działania, który można wykorzystać do opracowania własnej strategii na podstawie specyfiki i celów organizacji oraz jej sieci.
Przejdźmy do rzeczy:
- Oceń stan obecny: Na tym etapie należy zebrać, uporządkować i przeanalizować wszystkie omówione powyżej elementy, w tym dokumentację i inne istotne dane.
Rada Petrenki: „Rozważ zaangażowanie zewnętrznych konsultantów w celu uzyskania bezstronnego spojrzenia, ale zadbaj o udział wszystkich wewnętrznych interesariuszy, aby uzyskać pełny obraz sytuacji”.
- Określ swoje cele: „Ograniczenie przestojów” to dobry nadrzędny cel, ale należy rozłożyć go na bardziej szczegółowe cele dotyczące wydajności sieci.
Rada Petrenki: „Cele te powinny być ambitne, ale realistyczne, z uwzględnieniem standardów branżowych i konkretnych potrzeb biznesowych”.
- Zbuduj zespół: Utwórz interdyscyplinarny zespół dysponujący umiejętnościami, wiedzą i uprawnieniami do podejmowania decyzji niezbędnymi do osiągnięcia rezultatów.
Rada Petrenki: „Unikaj tworzenia silosów i ustanów dobre kanały komunikacji między wszystkimi członkami zespołu”.
- Wdróż narzędzia do monitorowania: Kompleksowe oprogramowanie do monitorowania i analizy sieci ma kluczowe znaczenie dla każdej inicjatywy mającej na celu zapewnienie dostępności sieci.
Rada Petrenki: „Musisz zdecydować między rozwiązaniami lokalnymi, chmurowymi lub hybrydowymi na podstawie swojej infrastruktury”.
- Ustal kluczowe wskaźniki i wartości bazowe: Nie możesz zmierzać do celu, jeśli nie wiesz, z jakiego punktu zaczynasz.
Rada Petrenki: „Zmierz bieżącą wydajność, aby ustalić punkt wyjścia do wprowadzania ulepszeń. Kluczowe jest, aby te wskaźniki były spójne i istotne z punktu widzenia określonych celów”.
- Zidentyfikuj i ustal priorytety krytycznych problemów: W zależności od bieżącego stanu sieci jest mało prawdopodobne, że uda Ci się rozwiązać wszystkie problemy leżące u podstaw jednocześnie. Dlatego ustal priorytety najważniejszych przyczyn przestojów. „Znaczenie” można rozumieć całościowo, w oparciu o cele organizacji, jak zauważa poniżej Petrenko.
Rada Petrenki: „Przy ustalaniu priorytetów weź pod uwagę zarówno częstotliwość występowania problemów, jak i ich wpływ”.
- Rozszerz swoją strategię: Opracuj szczegółowy plan rozwiązania wszystkich zidentyfikowanych problemów (po uporaniu się z problemami o najwyższym priorytecie), uwzględniając harmonogramy i przydział zasobów.
Rada Petrenki: „Pamiętaj, aby nie próbować naprawiać wszystkiego naraz; ustalaj priorytety na podstawie wpływu i wykonalności”.
- Opracuj systemy nadmiarowości i przełączania awaryjnego: Nadmiarowość kluczowych komponentów sieci oraz zautomatyzowane procesy przełączania awaryjnego są ważnymi elementami długoterminowej strategii poprawy wydajności i odporności sieci.
Rada Petrenki: „Może to obejmować nadmiarowy sprzęt, wielościeżkowe projekty sieci lub oparte na chmurze systemy przełączania awaryjnego. Uważaj, aby nadmiarowość nie wprowadzała niepotrzebnej złożoności, która sama mogłaby stać się źródłem problemów”.
- Wprowadź zmiany: Nadszedł czas realizacji, zaczynając od elementów o najwyższym priorytecie.
Rada Petrenki: „Pamiętaj, aby postępować zgodnie z procesami zarządzania zmianą i zminimalizować ryzyko wprowadzenia nowych problemów”.
- Monitoruj i dostosowuj działania: Żaden plan nie przebiega idealnie, dlatego przygotuj się na dostosowywanie go w miarę realizacji strategii.
Rada Petrenki: „Nieustannie śledź wskaźniki wydajności i w razie potrzeby dostosowuj plan. Możesz rozważyć wdrożenie automatycznych alertów, aby szybko reagować na pojawiające się problemy”.
- Prowadź regularny rozwój zawodowy: Każda inicjatywa na dużą skalę mająca na celu ograniczenie przestojów nieuchronnie wiąże się z nauką nowych technologii i procesów przez pracowników. Nie oczekuj, że personel po prostu sam sobie poradzi.
Rada Petrenki: „Wdrażaj ciągłe programy szkoleniowe dla personelu, aby pozostawał na bieżąco z najlepszymi praktykami i nowymi technologiami. Powinny one obejmować zarówno szkolenia techniczne, jak i proceduralne, aby zapewnić wszystkim członkom zespołu przygotowanie do zapobiegania przestojom i reagowania na związane z nimi problemy”.
- Przeprowadzaj ćwiczenia z zakresu odzyskiwania po awarii: Podobnie jak w przypadku większości rodzajów planowania awaryjnego, oczywiście masz nadzieję, że nigdy nie będziesz musieć z niego korzystać. Jeśli jednak zajdzie taka potrzeba, warto mieć pewność, że plany zostały przetestowane podczas symulowanych awarii i innych problemów.
Rada Petrenki: „Postaraj się, aby te ćwiczenia były jak najbardziej realistyczne, ale bez ryzyka wystąpienia rzeczywistego przestoju”.
- Śledź i raportuj postępy: Regularnie oceniaj postępy w realizacji celów (krok 2) oraz poprawę bazowych wskaźników i dziel się wynikami z interesariuszami.
Rada Petrenki: „W raportach wykorzystuj zarówno wskaźniki techniczne, jak i miary wpływu na działalność biznesową, aby przedstawić pełny obraz sytuacji”.
Narzędzia ograniczające przestoje sieci
Jakie oprogramowanie i inne narzędzia mogą odegrać kluczową rolę w minimalizowaniu przestojów oraz poprawie ogólnego stanu i wydajności sieci? Uwzględniliśmy przykłady z każdej kategorii.
1. Monitorowanie sieci — narzędzia
- SolarWinds Network Performance Monitor (NPM): Zapewnia kompleksowe monitorowanie wydajności sieci, wykrywanie błędów i wysyłanie alertów.
- Nagios: Oferuje zaawansowane funkcje monitorowania sieci, wysyłania alertów i raportowania.
- PRTG Network Monitor: Wszechstronne narzędzie, które monitoruje wszystkie aspekty infrastruktury sieciowej.
2. Narzędzia do zarządzania siecią i konfiguracji
- Cisco Prime Infrastructure: Pomaga zarządzać infrastrukturą sieciową i ją optymalizować.
- WhatsUp Gold: Zapewnia monitorowanie i zarządzanie siecią, w tym zarządzanie konfiguracją.
3. Zautomatyzowane narzędzia do reagowania na incydenty
- PagerDuty: Integruje się z narzędziami monitorującymi, aby zapewnić reagowanie na incydenty i automatyczne alerty.
- Opsgenie: Oferuje zarządzanie dyżurami, reagowanie na incydenty i alerty.
4. Narzędzia do zarządzania błędami
- Zabbix: Monitoruje wydajność sieci oraz pomaga wykrywać i usuwać błędy.
- ManageEngine OpManager: Zapewnia zarządzanie błędami, monitorowanie wydajności i wizualizację sieci.
5. Narzędzia do tworzenia kopii zapasowych i przywracania konfiguracji sieci
- RANCID (Really Awesome New Cisco confIg Differ): Automatyzuje tworzenie kopii zapasowych konfiguracji urządzeń sieciowych i zarządzanie nimi.
- SolarWinds Network Configuration Manager (NCM): Automatyzuje tworzenie kopii zapasowych i odzyskiwanie konfiguracji oraz pomaga zapewnić zgodność.
6. Zarządzanie dziennikami i narzędzia do ich analizy
- Splunk: Gromadzi i analizuje dzienniki z urządzeń sieciowych w celu identyfikowania i rozwiązywania problemów.
- ELK Stack (Elasticsearch, Logstash, Kibana): Zapewnia zaawansowane możliwości zarządzania dziennikami i ich analizy.
7. Narzędzia do analizy ruchu
- Wireshark: Analizator protokołów sieciowych, który pomaga diagnozować problemy z siecią.
- NetFlow Analyzer: Monitoruje wzorce ruchu sieciowego i pomaga identyfikować wąskie gardła.
8. Rozwiązania zapewniające wysoką dostępność i przełączanie awaryjne
- F5 BIG-IP: Zapewnia równoważenie obciążenia, przełączanie awaryjne i wysoką dostępność usług sieciowych.
- Cisco ASA: Oferuje zaawansowane funkcje zapory sieciowej i przełączania awaryjnego.
9. Narzędzia do testowania wydajności
- iPerf: Mierzy przepustowość i wydajność sieci.
- SolarWinds WAN Killer: Symuluje ruch sieciowy w celu testowania wydajności sieci w różnych warunkach.
More Articles
10. Narzędzia wirtualnej sieci prywatnej (VPN)
- OpenVPN: Zapewnia bezpieczny zdalny dostęp do sieci, gwarantując łączność podczas przestojów.
- Cisco AnyConnect: Bezpieczne rozwiązanie VPN zapewniające zdalny dostęp do zasobów sieciowych.
11. Narzędzia do monitorowania punktów końcowych
- Sysdig: Monitoruje i zabezpiecza środowiska kontenerowe oraz infrastrukturę chmurową.
- Datadog: Zapewnia kompleksowe monitorowanie całego stosu, w tym sieci, serwerów i aplikacji.
12. Oparte na chmurze narzędzia do monitorowania sieci
- ThousandEyes: Zapewnia kompleksowy wgląd w wydajność sieci w internecie i chmurze.
- LogicMonitor: Oparte na chmurze narzędzie monitorujące, które oferuje kompleksowe możliwości monitorowania sieci.
Najważniejsze wnioski
Przestoje sieci są rzeczywistością dla większości organizacji, ale nie oznacza to, że należy je pozostawiać bez kontroli. Skorzystaj z przedstawionego wyżej planu działania i narzędzi, aby zwiększyć wydajność sieci i ograniczyć kosztowne przestoje.
Aby uzyskać więcej informacji na temat sieci, zapisz się do naszego biuletynu. Pomagamy tworzyć zespoły i systemy SaaS, które można skalować!