

Netwerkuitval verminderen

Niet-technici horen misschien “uitvaltijd” en denken weemoedig aan een vakantie. Maar voor technologieprofessionals is uitvaltijd een vies woord – en terecht. Netwerkuitvaltijd betekent een slechte dag op kantoor.
Netwerkuitvaltijd betekent ontevreden klanten, sterk dalende productiviteit en andere problemen. Wanneer je het hebt over apps die op klanten zijn gericht, zoals een website, is uitvaltijd duur: uitvaltijd kost grotere bedrijven ongeveer $9,000 per minuut.
Hoewel uitvaltijd een negatieve impact kan hebben op bedrijven van alle soorten en groottes, is het in bepaalde sectoren bijzonder problematisch. Een retailbedrijf kan $1.1 million per uur uitvaltijd verliezen.

TL;DR: Uitvaltijd is slecht.
Uitvaltijd verminderen en voorkomen is daarentegen goed. Het is zelfs noodzakelijk – want zelfs kleine hoeveelheden netwerkuitvaltijd kunnen de winstgevendheid schaden en bijkomende schade veroorzaken, zoals reputatieschade.
In dit artikel definiëren we het probleem en wat nodig is om het op te lossen – waaronder een raamwerk in 13 stappen voor het ontwikkelen van je eigen plan om netwerkuitvaltijd te verminderen. Eerst helpt het om uit te gaan van een eenvoudige definitie.
Wat is netwerkuitvaltijd?
Netwerkuitvaltijd verwijst naar het gedeeltelijk of volledig niet beschikbaar zijn van een IT-netwerk, waardoor zaken zoals een website of interne applicaties, zoals een ERP-systeem, gedurende een bepaalde periode ontoegankelijk worden.
Uitvaltijd kan over het algemeen worden onderverdeeld in twee grote categorieën: gepland en ongepland. Geplande uitvaltijd is precies dat: het is opzettelijk en ingepland, meestal voor zaken zoals routineonderhoud, systeemupgrades of een applicatiemigratie.
Wanneer we zeggen dat netwerkuitvaltijd slecht is, bedoelen we eigenlijk ongeplande netwerkuitvaltijd – dit is wanneer het netwerk onverwacht uitvalt om allerlei mogelijke redenen. Er kunnen allerlei oorzaken zijn voor uitvaltijd, van infrastructuurproblemen en softwarebugs tot menselijke fouten en cyberaanvallen.
Wat – en wie – is nodig om netwerkuitvaltijd tot een minimum te beperken?
Gezien de kwantitatieve en kwalitatieve kosten is het de moeite waard om zelfs incidentele netwerkuitvaltijd aan te pakken. En als de frequentie begint te verschuiven van incidenteel naar frequent, is het tijd om dat probleem met meer urgentie op te lossen.
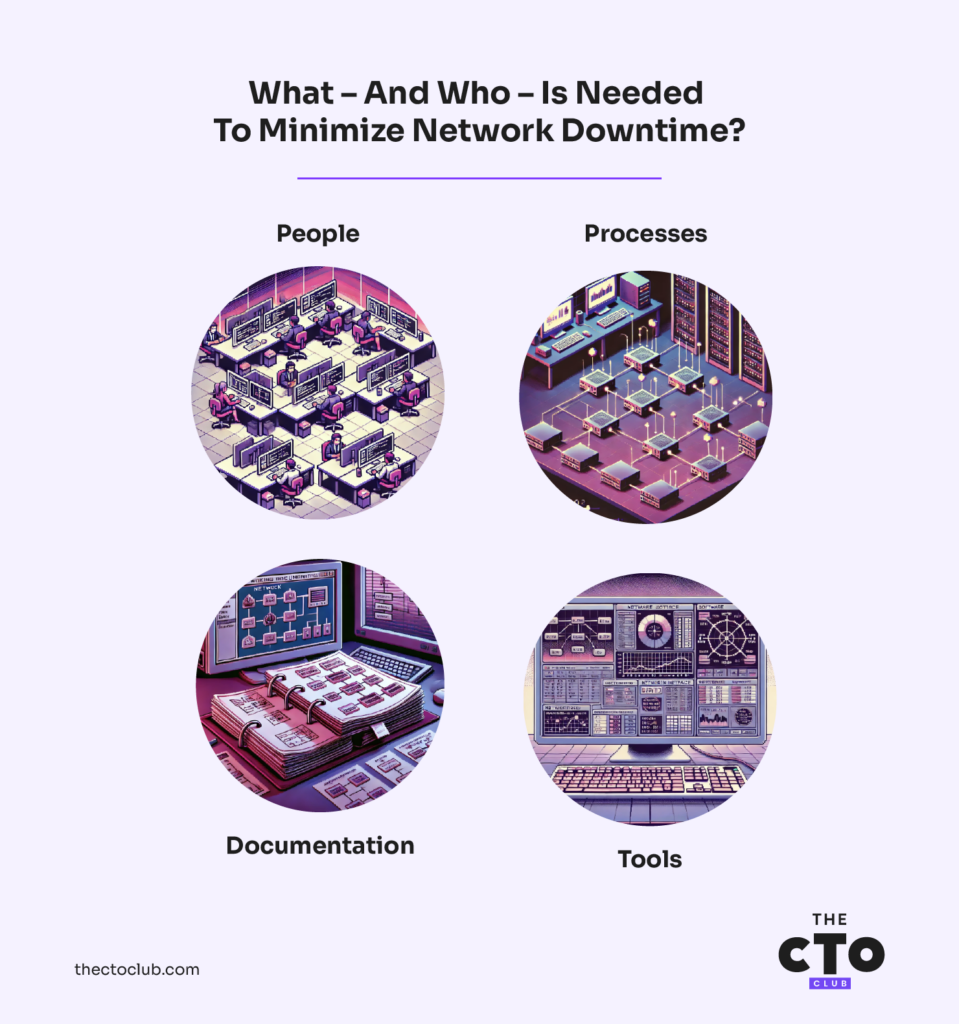
Er is een combinatie van mensen, processen, documentatie en hulpmiddelen die je eerst moet organiseren, zegt Viacheslav Petrenko, technisch directeur bij het softwareontwikkelingsbedrijf LITSLINK.
Petrenko deelde zijn advies over de belangrijkste onderdelen die je op orde moet brengen voordat je aan een nieuw initiatief begint om netwerkuitvaltijd te verminderen. Deze kunnen zowel toekomstgericht als historisch zijn. Ze omvatten:
Documentatie
Petrenko adviseert om netwerk-topologiediagrammen, incidentrapporten, service-levelovereenkomsten (SLA's) en wijzigingsbeheerlogboeken te verzamelen als essentiële documentatie.
Alle andere relevante documentatie die specifiek is voor de organisatie of het netwerk is eveneens de moeite waard om bij de hand te houden.
Processen
Er zijn verschillende processen die experts aanbevelen om te analyseren – of te implementeren als ze momenteel niet aanwezig zijn – als onderdeel van een initiatief voor netwerkbeschikbaarheid. Deze omvatten:
Protocol voor analyse van de hoofdoorzaak (RCA): Dit is een fundamenteel proces om netwerkuitvaltijd te verminderen, omdat het uiteindelijke doel ervan is om de specifieke oorzaak of oorzaken van het probleem vast te stellen. Een analyse van de hoofdoorzaak “zorgt voor grondig onderzoek van elk incident met uitvaltijd om herhaling te voorkomen”, zegt Petrenko.
Gerelateerd artikel: 5 hulpmiddelen voor analyse van de hoofdoorzaak voor beter testen en QA
Proces voor wijzigingsbeheer: Beperkt risico's door alle netwerk wijzigingen zorgvuldig te beheren en te documenteren. Let op: grondigheid moet worden afgewogen tegen wendbaarheid om knelpunten te voorkomen.
Plannen voor herstel na rampen en bedrijfscontinuïteit: Alle inspanningen om netwerkuitvaltijd te verminderen moeten worden afgestemd op – en omgekeerd – de bredere plannen van de organisatie voor veerkracht bij grote operationele verstoringen.
Gerelateerd artikel: De 25 beste diensten voor herstel na rampen ontcijferd
Planning voor netwerkonderhoud: Proactief onderhoud uitvoeren – waarbij soms geplande uitvaltijd kan worden veroorzaakt – “helpt problemen te voorkomen voordat ze zich voordoen door netwerkcomponenten regelmatig bij te werken en te optimaliseren”, zegt Petrenko.
Mensen
Vrijwel iedereen in een organisatie is afhankelijk van het netwerk, maar dat betekent niet dat iedereen betrokken hoeft te zijn bij het optimaliseren van de prestaties en betrouwbaarheid ervan. Petrenko noemt de volgende rollen als belangrijk om bij het proces te betrekken. Houd er rekening mee dat specifieke functietitels per bedrijf kunnen verschillen.
Netwerkingenieurs: Het spreekt voor zich dat de professionals die uw netwerkinfrastructuur implementeren en onderhouden deel moeten uitmaken van het proces.
Systeembeheerders: Ook de mensen die de servers (en andere infrastructuur) en applicaties beheren die afhankelijk zijn van het netwerk, moeten worden betrokken. Verwante functietitels kunnen hier DevOps-ingenieur, ingenieur voor sitebetrouwbaarheid en infrastructuuringenieur zijn.
Beveiligingsprofessionals: Door uw beveiligingspersoneel erbij te betrekken, helpt u “de netwerkbeveiliging te waarborgen en te beschermen tegen uitval veroorzaakt door aanvallen of inbreuken,” zegt Petrenko.
Data-analisten: Zoals blijkt uit de hierboven genoemde documentatie, houdt het optimaliseren van een netwerk in dat grote hoeveelheden prestatiegegevens en andere informatie worden geanalyseerd. U hebt mensen nodig met de vaardigheden om die gegevens te interpreteren en inzichten voor verbetering te genereren.
Projectmanager: Vooral in grote ondernemingen hebt u mogelijk iemand nodig om de inspanningen van verschillende teams te coördineren en ervoor te zorgen dat alles volgens schema verloopt.
Hulpmiddelen
Hieronder gaan we dieper in op hulpmiddelen om netwerkuitval te beperken, maar voor nu volstaat het om te zeggen dat u er enkele nodig hebt, met bijzondere aandacht voor (maar niet beperkt tot) monitoring, logging, testen en planning. Specifieke categorieën zijn onder andere:
Netwerkmonitoringsoftware: U kunt problemen niet oplossen als u niet eens weet dat ze bestaan. Deze hulpmiddelen bieden realtime inzicht in uw netwerk en de prestaties ervan en kunnen waarschuwingen genereren voor mogelijke problemen.
Hulpmiddelen voor configuratiebeheer: Hulpmiddelen voor configuratiebeheer kunnen wijzigingen in netwerkinfrastructuur en apparaten automatiseren en bijhouden. Petrenko wijst erop dat dit het risico op menselijke fouten bij het aanbrengen van wijzigingen kan verkleinen.
Logbeheersoftware en hulpmiddelen voor loganalyse: Logging is een cruciaal middel om basispatronen en “normaal” gedrag op een netwerk vast te stellen – en vervolgens abnormale activiteit te identificeren voordat deze mogelijk een storing veroorzaakt.
Geautomatiseerde testhulpmiddelen: Het automatiseren van test- en QA-inspanningen helpt problemen sneller op te sporen en vermindert ook de hoeveelheid menselijke inspanning die nodig is.
Software voor capaciteitsplanning: Capaciteitsplanning – vaak een functie van netwerkmonitoringhulpmiddelen – kan helpen toekomstige netwerkvereisten te voorspellen en uitval door overbelasting te voorkomen. Petrenko merkt op dat hiervoor nauwkeurige gegevensinvoer en regelmatige updates nodig zijn om effectief te blijven.
-

NinjaOne
Visit WebsiteThis rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.4.7 -
Datadog
Visit WebsiteThis rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.4.5 -
Paessler PRTG
Visit WebsiteThis rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.4.6



Netwerkuitval in 13 stappen beperken
Wat doet u nu eigenlijk met al het bovenstaande? Wij helpen u op weg: Petrenko heeft een actieplan in 13 stappen met ons gedeeld, dat u kunt gebruiken om uw eigen strategie te ontwikkelen op basis van de specifieke kenmerken en doelstellingen van uw organisatie en netwerk.
Laten we beginnen:
- Beoordeel de huidige situatie: Hier verzamelt, ordent en analyseert u alle onderdelen die we hierboven hebben besproken, waaronder documentatie en andere relevante gegevens.
Advies van Petrenko: “Overweeg externe consultants in te schakelen voor een onbevooroordeeld beeld, maar zorg ervoor dat alle interne belanghebbenden worden betrokken om een volledig beeld te krijgen.”
- Bepaal uw doelstellingen: “Netwerkuitval verminderen” is een prima overkoepelende doelstelling, maar splits deze op in specifiekere doelen voor uw netwerkprestaties.
Advies van Petrenko: “Deze doelstellingen moeten ambitieus maar realistisch zijn, waarbij rekening wordt gehouden met industrienormen en specifieke bedrijfsbehoeften.”
- Stel uw team samen: Stel een multidisciplinair team samen met de vaardigheden, kennis en beslissingsbevoegdheid die nodig zijn om resultaten te behalen.
Advies van Petrenko: “Vermijd het creëren van silo’s en zorg voor goede communicatiekanalen tussen alle teamleden.”
- Implementeer monitoringhulpmiddelen: Uitgebreide software voor netwerkmonitoring en -analyse is cruciaal voor elk initiatief gericht op netwerkbeschikbaarheid.
Advies van Petrenko: “U moet op basis van uw infrastructuur kiezen tussen lokale, cloudgebaseerde of hybride oplossingen.”
- Stel je belangrijkste meetwaarden en nulmetingen vast: Je kunt niet naar een doel toe werken als je niet weet waar je bent begonnen.
Advies van Petrenko: “Meet de huidige prestaties om een startpunt voor verbeteringen vast te stellen. Het is cruciaal dat deze meetwaarden consistent zijn en relevant zijn voor je vastgestelde doelstellingen.”
- Identificeer en prioriteer kritieke problemen: Afhankelijk van de huidige staat van je netwerk is het onwaarschijnlijk dat je alle onderliggende problemen tegelijk kunt oplossen. Geef daarom prioriteit aan de belangrijkste oorzaken van uitval. “Belangrijkheid” kan holistisch worden opgevat op basis van de doelstellingen van je organisatie, zoals Petrenko hieronder opmerkt.
Advies van Petrenko: ”Houd bij het stellen van prioriteiten rekening met zowel de frequentie als de impact van problemen.”
- Breid je strategie uit: Ontwikkel een gedetailleerd plan om alle geïdentificeerde problemen aan te pakken (nadat de problemen met hoge prioriteit zijn opgelost), inclusief tijdlijnen en toewijzing van middelen.
Advies van Petrenko: ”Vergeet niet dat je niet alles tegelijk moet proberen op te lossen; stel prioriteiten op basis van impact en haalbaarheid.”
- Ontwikkel redundantie- en failoversystemen: Redundantie in kritieke netwerkcomponenten en geautomatiseerde failoverprocessen zijn beide belangrijke onderdelen van een langetermijnstrategie voor netwerkprestaties en veerkracht.
Advies van Petrenko: “Dit kan redundante hardware, netwerktopologieën met meerdere paden of cloudgebaseerde failoversystemen omvatten. Let erop dat je redundantie geen onnodige complexiteit introduceert die zelf een bron van problemen kan worden.”
- Voer wijzigingen door: Het is tijd voor de uitvoering, te beginnen met items met hoge prioriteit.
Advies van Petrenko: “Zorg ervoor dat je de processen voor wijzigingsbeheer volgt om het risico op nieuwe problemen te minimaliseren.”
- Monitor en pas aan: Geen enkel plan verloopt ooit perfect, dus wees erop voorbereid om je aan te passen terwijl je je strategie uitvoert.
Advies van Petrenko: “Houd de prestatiestatistieken voortdurend bij en pas het plan indien nodig aan. Je kunt geautomatiseerde waarschuwingen instellen voor een snelle reactie op opkomende problemen.”
- Voer regelmatig professionele ontwikkeling uit: Elk grootschalig initiatief om uitvaltijd te verminderen zal onvermijdelijk inhouden dat mensen nieuwe technologieën en processen leren. Verwacht niet dat medewerkers het gaandeweg vanzelf uitzoeken.
Advies van Petrenko: “Implementeer doorlopende trainingsprogramma’s voor medewerkers, zodat ze op de hoogte blijven van beste praktijken en nieuwe technologieën. Dit moet zowel technische als procedurele training omvatten om ervoor te zorgen dat alle teamleden zijn toegerust om problemen met uitvaltijd te voorkomen en erop te reageren.”
- Voer rampenherstel-oefeningen uit: Zoals bij de meeste vormen van noodplanning hoop je natuurlijk dat je deze nooit echt nodig hebt. Maar als dat wel het geval is, wil je zeker weten dat je je plannen hebt getest met gesimuleerde uitval en andere problemen.
Advies van Petrenko: “Probeer deze oefeningen zo realistisch mogelijk te maken zonder daadwerkelijk risico op uitvaltijd te lopen.”
- Volg en rapporteer je voortgang: Evalueer regelmatig je voortgang richting de doelstellingen (stap 2) en verbeteringen in je nulmetingen, en deel de resultaten met belanghebbenden.
Advies van Petrenko: “Gebruik in je rapportage zowel technische meetwaarden als metingen van de bedrijfsimpact om een volledig beeld te geven.”
Hulpmiddelen om netwerkuitvaltijd te verminderen
Welke software en andere hulpmiddelen kunnen een belangrijke rol spelen bij het minimaliseren van uitvaltijd en het verbeteren van de algehele gezondheid en prestaties van het netwerk? We hebben in elke categorie voorbeelden opgenomen.
1. Netwerkbewaking-hulpmiddelen
- SolarWinds Network Performance Monitor (NPM): Biedt uitgebreide bewaking van netwerkprestaties, foutdetectie en waarschuwingen.
- Nagios: Biedt krachtige functies voor netwerkbewaking, waarschuwingen en rapportage.
- PRTG Network Monitor: Een veelzijdig hulpmiddel dat alle aspecten van je netwerkinfrastructuur bewaakt.
2. Hulpmiddelen voor netwerkbeheer en configuratie
- Cisco Prime Infrastructure: Helpt uw netwerkinfrastructuur te beheren en te optimaliseren.
- WhatsUp Gold: Biedt netwerkbewaking en -beheer, inclusief configuratiebeheer.
3. Geautomatiseerde hulpmiddelen voor incidentrespons
- PagerDuty: Integreert met bewakingshulpmiddelen om incidentrespons en geautomatiseerde waarschuwingen te bieden.
- Opsgenie: Biedt beheer van bereikbaarheidsdiensten, incidentrespons en waarschuwingen.
4. Hulpmiddelen voor foutbeheer
- Zabbix: Bewaakt de netwerkprestaties en helpt fouten te detecteren en op te lossen.
- ManageEngine OpManager: Biedt foutbeheer, prestatiebewaking en netwerkvisualisatie.
5. Hulpmiddelen voor back-up en herstel van netwerkconfiguraties
- RANCID (Really Awesome New Cisco confIg Differ): Automatiseert het maken van back-ups en het beheer van netwerkapparaatconfiguraties.
- SolarWinds Network Configuration Manager (NCM): Automatiseert het maken en herstellen van configuratieback-ups en helpt naleving te waarborgen.
6. Hulpmiddelen voor logboekbeheer en analyse
- Splunk: Verzamelt en analyseert logboeken van netwerkapparaten om problemen te identificeren en op te lossen.
- ELK Stack (Elasticsearch, Logstash, Kibana): Biedt krachtige mogelijkheden voor logboekbeheer en -analyse.
7. Hulpmiddelen voor verkeersanalyse
- Wireshark: Een netwerkanalyseprogramma voor netwerkprotocollen dat helpt bij het diagnosticeren van netwerkproblemen.
- NetFlow Analyzer: Bewaakt patronen in netwerkverkeer en helpt knelpunten te identificeren.
8. Oplossingen voor hoge beschikbaarheid en automatische overschakeling
- F5 BIG-IP: Biedt taakverdeling, automatische overschakeling en hoge beschikbaarheid voor netwerkdiensten.
- Cisco ASA: Biedt robuuste firewall- en mogelijkheden voor automatische overschakeling.
9. Hulpmiddelen voor prestatietests
- iPerf: Meet de netwerkbandbreedte en -prestaties.
- SolarWinds WAN Killer: Simuleert netwerkverkeer om de netwerkprestaties te testen onder verschillende omstandigheden.
10. Virtueel privénetwerk (VPN)
- OpenVPN: Biedt veilige externe toegang tot het netwerk en zorgt voor connectiviteit tijdens uitval.
- Cisco AnyConnect: Een veilige VPN-oplossing die externe toegang tot netwerkbronnen biedt.
11. Eindpuntbewaking
- Sysdig: Bewaakt en beveiligt gecontaineriseerde omgevingen en cloudinfrastructuur.
- Datadog: Biedt bewaking van de volledige stack, inclusief netwerk-, server- en toepassingsbewaking.
12. Cloudgebaseerde hulpmiddelen voor netwerkbewaking
- ThousandEyes: Biedt inzicht van begin tot eind in netwerkprestaties via internet en cloud.
- LogicMonitor: Een cloudgebaseerd bewakingshulpmiddel dat uitgebreide mogelijkheden voor netwerkbewaking biedt.
De kern
Netwerkuitval is voor de meeste organisaties een realiteit, maar dat betekent niet dat je het zonder controle moet laten. Gebruik het bovenstaande stappenplan en de tools om de prestaties van je netwerk te verbeteren en kostbare uitvaltijd tot een minimum te beperken.
Abonneer je op onze nieuwsbrief voor meer inzichten in netwerken. We helpen je SaaS-teams en systemen op te bouwen die kunnen opschalen!


