

Lorsqu’on explore le domaine de l’intelligence artificielle, on rencontre souvent une multitude d’outils de traitement automatique du langage naturel, chacun mettant en avant des capacités uniques. Des robots alimentés par des modèles NLP avancés aux applications facilitant la traduction automatique et la synthèse, ces outils constituent l’épine dorsale du paysage actuel de l’automatisation.
Fort de mon expérience en compréhension du langage naturel, en réponse aux questions, en extraction d’entités et dans les subtilités des langages de programmation, j’ai constaté à quel point les assistants virtuels et les applications NLP ont révolutionné les interactions. Examiner ces options peut éliminer la difficulté de trier manuellement les données et combler le fossé entre l’immense volume d’informations disponibles et les informations exploitables.
Pourquoi faire confiance à nos recommandations de logiciels
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Notre équipe teste et évalue des logiciels depuis 2012. En tant que leaders technologiques nous-mêmes, nous savons à quel point il est difficile — et important — de choisir le bon logiciel.
Pour ce guide, nous avons évalué les outils grâce à des tests pratiques et une recherche indépendante, en notant les outils selon nos critères de sélection.
Nos avis reflètent notre jugement éditorial humain, et non un argumentaire de vente.
Réviseurs experts:
- Paulo Gardini MiguelDirecteur technique
 Tim FisherVP de l'IA
 Gabriel RosasTech Lead et architecte logiciel
 Christhian GruhnTech Lead et architecte plateforme

Tableau comparatif : logiciels NLP
Ce tableau comparatif récapitule les détails tarifaires de ma sélection des meilleurs logiciels NLP.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Idéal pour le déploiement sur site du NLP conversationnel | Forfait gratuit + démonstration gratuite disponible | Tarification sur demande | Website | |
| 2 | Idéal pour accéder aux grands modèles de langage de pointe via API | Forfait gratuit disponible | À partir de $20/utilisateur/mois | Website | |
| 3 | Idéal pour l’analyse unifiée des textes et des données structurées | Essai gratuit de 14 jours + démonstration gratuite disponible | Tarification sur demande | Website | |
| 4 | Idéal pour le traitement de documents à contexte long via des LLM ouverts | Non disponible | Tarification sur demande | Website | |
| 5 | Idéal pour l'affinement de bout en bout des LLM à grande échelle | Offre gratuite disponible | À partir de $0.04/crédit | Website | |
| 6 | Idéal pour obtenir des informations textuelles natives d’AWS à grande échelle | Forfait gratuit disponible | À partir de $0.0001/unité | Website | |
| 7 | Idéal pour le déploiement de pipelines NLP prêts pour la production | Formule gratuite disponible | Formule gratuite disponible | Website | |
| 8 | Idéal pour le NLP gouverné dans des déploiements cloud hybrides | Formule gratuite + essai gratuit + démonstration gratuite disponibles | À partir de $1,110/mois | Website | |
| 9 | Idéal pour les pipelines d'analyse de texte natifs de GCP | Forfait gratuit disponible | À partir de $0.90/1,000 caractères (facturé annuellement) | Website | |
| 10 | Idéal pour le réglage fin de modèles à code source ouvert à grande échelle | Formule gratuite disponible | À partir de 9 $/mois | Website |




Avis sur les meilleurs logiciels NLP
 1Idéal pour le déploiement sur site du NLP conversationnel
Rasa
- Forfait gratuit + démonstration gratuite disponible
- Tarification sur demande
Visit WebsiteCustomer Rating:4.2/5
Rasa permet aux utilisateurs de configurer des flux conversationnels à l'aide d'un générateur visuel de flux. Rasa est un cadre logiciel de TAL conversationnel à code source ouvert qui propose une chaîne de traitement NLU modulaire, une classification personnalisée des intentions, la reconnaissance d'entités nommées, l'intégration des LLM via son architecture CALM et des options de déploiement de niveau production, notamment sur site et dans des environnements isolés.
À qui Rasa convient-il le mieux ?
Rasa convient particulièrement aux ingénieurs ML/NLP et aux équipes DevOps des secteurs réglementés qui ont besoin d'un contrôle total sur leur environnement de déploiement d'IA conversationnelle.
Pourquoi j'ai choisi Rasa
J'ai inclus Rasa dans ma sélection principale, car c'est l'option la plus performante que j'ai trouvée pour les équipes qui doivent déployer un traitement NLP conversationnel entièrement sur leur propre infrastructure. Son déploiement natif Kubernetes via des graphiques Helm, sa prise en charge des environnements isolés et sa gestion des secrets avec HashiCorp Vault en font une solution naturellement adaptée aux secteurs réglementés comme la santé et la finance, où les données ne quittent jamais votre périmètre. J'apprécie également l'architecture CALM, qui sépare la compréhension du langage pilotée par les LLM de la logique métier déterministe, afin de conserver un comportement prévisible et auditable des agents en production.
Fonctionnalités clés de Rasa
- Classificateur DIET : modèle basé sur les transformeurs qui gère simultanément la classification des intentions et l'extraction des entités au sein d'une architecture unique pouvant être entraînée.
- Routage multi-LLM : permet d'attribuer différents LLM à différentes tâches au sein d'un même agent, vous donnant le contrôle sur les compromis entre coût et latence.
- Module RAG pour entreprises : se connecte à des bases de données vectorielles personnalisées pour récupérer des connaissances en temps réel et ancrer les réponses dans vos propres données sans réentraîner le modèle.
- Réutilisation des flux multilingues : déploie les mêmes flux conversationnels dans plusieurs langues et prend en charge le changement de langue en cours de conversation sans perdre le contexte.
Intégrations de Rasa
Rasa documente des intégrations avec Hugging Face Transformers, spaCy, scikit-learn, Duckling, GPT-4, Llama, Redis, Apache Kafka, HashiCorp Vault et OpenTelemetry. Les API REST et WebSocket prennent en charge les intégrations personnalisées.
Pros and Cons
Pros:
- Déploiement sur site et dans des environnements isolés pris en charge
- Entièrement à code source ouvert avec des chaînes de traitement personnalisables
- Réutilisation des flux multilingues avec conservation du contexte
Cons:
- Aucune analyse des sentiments ni aucun résumé natifs
- L'édition à code source ouvert est en mode maintenance
Learn more about Rasa: Idéal pour accéder aux grands modèles de langage de pointe via API
- Forfait gratuit disponible
- À partir de $20/utilisateur/mois

L'aire de test d'OpenAI permet aux utilisateurs d'exécuter des requêtes de l'interpréteur de code via des assistants. OpenAI est une plateforme d'IA qui donne aux développeurs un accès par API à un vaste catalogue de grands modèles de langage, de modèles d'intégration et de modèles vocaux pour créer des applications de TAL dans le cadre de tâches telles que la classification de textes, l'extraction d'entités, le résumé, la traduction et la recherche sémantique.
À qui OpenAI convient-il le mieux ?
OpenAI convient particulièrement aux ingénieurs en apprentissage automatique et aux équipes de développement qui ont besoin d'un accès fiable et évolutif par API à des modèles de langage de pointe, sans avoir à gérer l'infrastructure sous-jacente.
Pourquoi j'ai choisi OpenAI
OpenAI figure dans ma sélection parce qu'aucune autre plateforme ne vous donne un accès direct à un catalogue aussi vaste de modèles de pointe offrant ce niveau de qualité. J'apprécie particulièrement la façon dont l'API Responses, l'API Batch et les modèles d'intégration fonctionnent ensemble : vous pouvez exécuter des tâches NER ou de classification à haut volume avec une réduction de 50 % des coûts grâce à l'API Batch, puis transmettre les résultats à
text-embedding-3-largepour effectuer un regroupement sémantique, le tout sans gérer la moindre infrastructure. Le programme Modèles personnalisés est un autre point fort, avec des résultats éprouvés en production, comme le gain de précision de 83 % obtenu par Harvey dans le domaine du TAL juridique.Fonctionnalités clés d'OpenAI
- Tokeniseur Tiktoken : un tokeniseur BPE open source qui reproduit la tokenisation interne d'OpenAI et vous permet de compter les jetons et de gérer les limites de la fenêtre de contexte avant d'effectuer des appels API.
- Sorties structurées via le mode JSON : force les réponses du modèle à respecter un schéma JSON défini, ce qui le rend fiable pour extraire des entités ou des étiquettes de classification à grande échelle.
- API d'intégration : génère des représentations vectorielles denses du texte à l'aide de
text-embedding-3-smalloutext-embedding-3-largepour les tâches de recherche sémantique, de regroupement et de classification. - API Batch : traite de gros volumes de demandes d'inférence de manière asynchrone, avec une réduction de 50 % des coûts par rapport aux appels API synchrones.
Intégrations d'OpenAI
OpenAI s'intègre à LangChain, LlamaIndex, Azure OpenAI Service, Pinecone, Weaviate, Qdrant, Chroma et Temporal. Ses API et ses SDK officiels prennent en charge les connexions personnalisées aux bases de données vectorielles, aux systèmes d'entreprise et aux flux de travail CI/CD.
Pros and Cons
Pros:
- Grands modèles de langage de pointe mis à jour avec des performances de référence parmi les meilleures du secteur
- L'API Batch réduit les coûts de traitement à grande échelle
- Réglage fin avec des études de cas d'entreprise éprouvées
Cons:
- Aucun hébergement sur site ou dans un cloud privé
- Aucun pipeline classique de prétraitement du TAL exposé
Learn more about OpenAI: Idéal pour l’analyse unifiée des textes et des données structurées
- Essai gratuit de 14 jours + démonstration gratuite disponible
- Tarification sur demande

SAS Model Studio permet aux utilisateurs d’organiser les projets d’analyse de texte en un seul endroit. SAS Visual Analytics est une plateforme d’analyse d’entreprise et de TAL qui combine l’exploration visuelle des données, l’analyse de texte, la modélisation de sujets, l’analyse des sentiments et la reconnaissance d’entités nommées (NER) avec un générateur de pipelines sans code et un assistant d’IA générative.
À qui SAS Visual Analytics convient-il le mieux ?
SAS Visual Analytics convient particulièrement aux équipes de science des données des entreprises qui doivent analyser des données textuelles structurées et non structurées au sein d’une même plateforme gouvernée.
Pourquoi ai-je choisi SAS Visual Analytics ?
J’ai choisi SAS Visual Analytics parce qu’il s’agit de l’une des rares plateformes de TAL qui unifient réellement l’analyse des données structurées et l’analyse de texte sans vous obliger à assembler des outils distincts. SAS Visual Text Analytics, qui fonctionne à ses côtés, prend en charge la reconnaissance d’entités nommées, l’analyse des sentiments fondée sur BERT et la modélisation de sujets dans le même environnement gouverné où résident déjà vos données structurées. J’apprécie particulièrement la fonctionnalité d’étalonnage des LLM, qui permet d’ajuster le comportement du modèle pour les pipelines RAG sans modifier le modèle de base, ce qui constitue un véritable avantage lorsqu’on travaille avec des données d’entreprise sensibles.
Principales fonctionnalités de SAS Visual Analytics
- Prétraitement de texte en 33 langues : La tokenisation, la lemmatisation et l’étiquetage morphosyntaxique sont disponibles nativement dans 33 langues, dont l’arabe, l’hindi, le thaï et le vietnamien.
- Générateur de pipelines TAL hybrides : Une interface visuelle sans code permet de combiner des nœuds fondés sur des règles, l’apprentissage automatique et l’apprentissage profond au sein d’un même pipeline d’analyse de texte.
- API SAS Micro Analytic Score : Une API d’évaluation sans état et résidente en mémoire, conçue pour l’inférence de modèles en temps réel et à haute performance dans les environnements de production.
- Fichiers de modèles portables ASTORE : Les modèles entraînés sont exportés sous forme de fichiers binaires ASTORE, ce qui permet de calculer des scores en dehors de l’environnement SAS sur des cibles infonuagiques et sur site.
Intégrations de SAS Visual Analytics
SAS Visual Analytics propose des intégrations natives avec l’écosystème Microsoft, notamment Microsoft 365 et Azure, ainsi qu’une prise en charge du déploiement sur AWS, Google Cloud Platform et Red Hat OpenShift. Les API REST et les SDK de SAS Viya prennent en charge les intégrations personnalisées.
Pros and Cons
Pros:
- Prise en charge multilingue native de 33 langues
- Plateforme unifiée pour les textes et les données structurées
- IA générative avec contrôles intégrés des biais
Cons:
- Les fonctionnalités avancées de TAL nécessitent un module complémentaire distinct
- Moins flexible que les cadres TAL à code source ouvert
Learn more about SAS Visual Analytics: Idéal pour le traitement de documents à contexte long via des LLM ouverts
- Non disponible
- Tarification sur demande

AI21 Studio permet aux utilisateurs de définir des exigences de sortie explicites pour chaque exécution d’API. AI21 Studio est une plateforme de LLM conçue autour de la famille de modèles hybrides Mamba-Transformer Jamba, offrant la génération de texte, le résumé, la réponse aux questions, la classification, l’orchestration RAG et le réglage fin multiniveau via API, SDK et services cloud gérés.
À qui AI21 Studio convient-il le mieux ?
AI21 Studio convient particulièrement aux ingénieurs ML et aux équipes d’entreprise qui construisent des pipelines RAG ou des flux de travail basés sur les connaissances à partir de vastes corpus de documents non structurés.
Pourquoi ai-je choisi AI21 Studio ?
AI21 Studio figure sur ma liste restreinte en raison de l’efficacité avec laquelle la famille de modèles Jamba gère les charges de travail constituées de documents réellement volumineux. La fenêtre de contexte de 256K tokens est la plus grande parmi les modèles à poids ouverts disponibles, ce qui me permet d’intégrer des contrats entiers, des rapports d’essais cliniques ou des dossiers M&A dans un seul appel d’inférence, sans fractionnement. Ajoutez à cela la couche d’orchestration RAG Maestro, qui achemine dynamiquement les requêtes entre la recherche de fichiers, la recherche Web et les LLM tout en fournissant un graphe visuel d’exécution, et vous obtenez un pipeline performant pour extraire des informations structurées à partir de corpus denses et non structurés.
Fonctionnalités clés d’AI21 Studio
- Architecture hybride Jamba : les modèles Jamba combinent des couches SSM Mamba avec l’attention Transformer dans une architecture à mélange d’experts, offrant une inférence jusqu’à 2,5× plus rapide que celle de modèles uniquement fondés sur des Transformers de taille comparable.
- API de réglage fin multiniveau : prend en charge le réglage fin complet, LoRA et QLoRA via les bibliothèques HuggingFace standard, ainsi qu’un service de post-entraînement géré pour les équipes d’entreprise qui souhaitent être propriétaires du modèle obtenu.
- Passerelle intelligente : une couche de routage à intégration directe qui évalue le coût par agent, réduit le contexte redondant et sélectionne de manière adaptative les modèles à chaque tour — actuellement gratuite pendant la phase bêta.
- Poids de modèles ouverts sur Hugging Face : les modèles Jamba sont publiquement disponibles sous la licence Jamba Open Model, ce qui permet à votre équipe de les héberger elle-même, de les inspecter ou de les personnaliser davantage sans dépendance vis-à-vis d’un fournisseur.
Intégrations d’AI21 Studio
AI21 Studio s’intègre à AWS, Microsoft Azure, Google Cloud, NVIDIA NIM, Hugging Face, LangChain, LlamaIndex, Pinecone, Snowflake et Databricks. Son API REST, son SDK Python et son SDK TypeScript prennent en charge les intégrations personnalisées et les flux de déploiement.
Pros and Cons
Pros:
- Gère les entrées de documents longs contenant jusqu’à 256K tokens
- Prend en charge le réglage fin complet, LoRA et QLoRA
- Poids de modèles ouverts pour un hébergement autonome
Cons:
- Ne propose pas d’API dédiée à la reconnaissance d’entités nommées ou à l’analyse des sentiments
- Ne dispose pas d’un générateur visuel sans code de pipelines NLP
Learn more about AI21 Studio: Idéal pour l'affinement de bout en bout des LLM à grande échelle
- Offre gratuite disponible
- À partir de $0.04/crédit
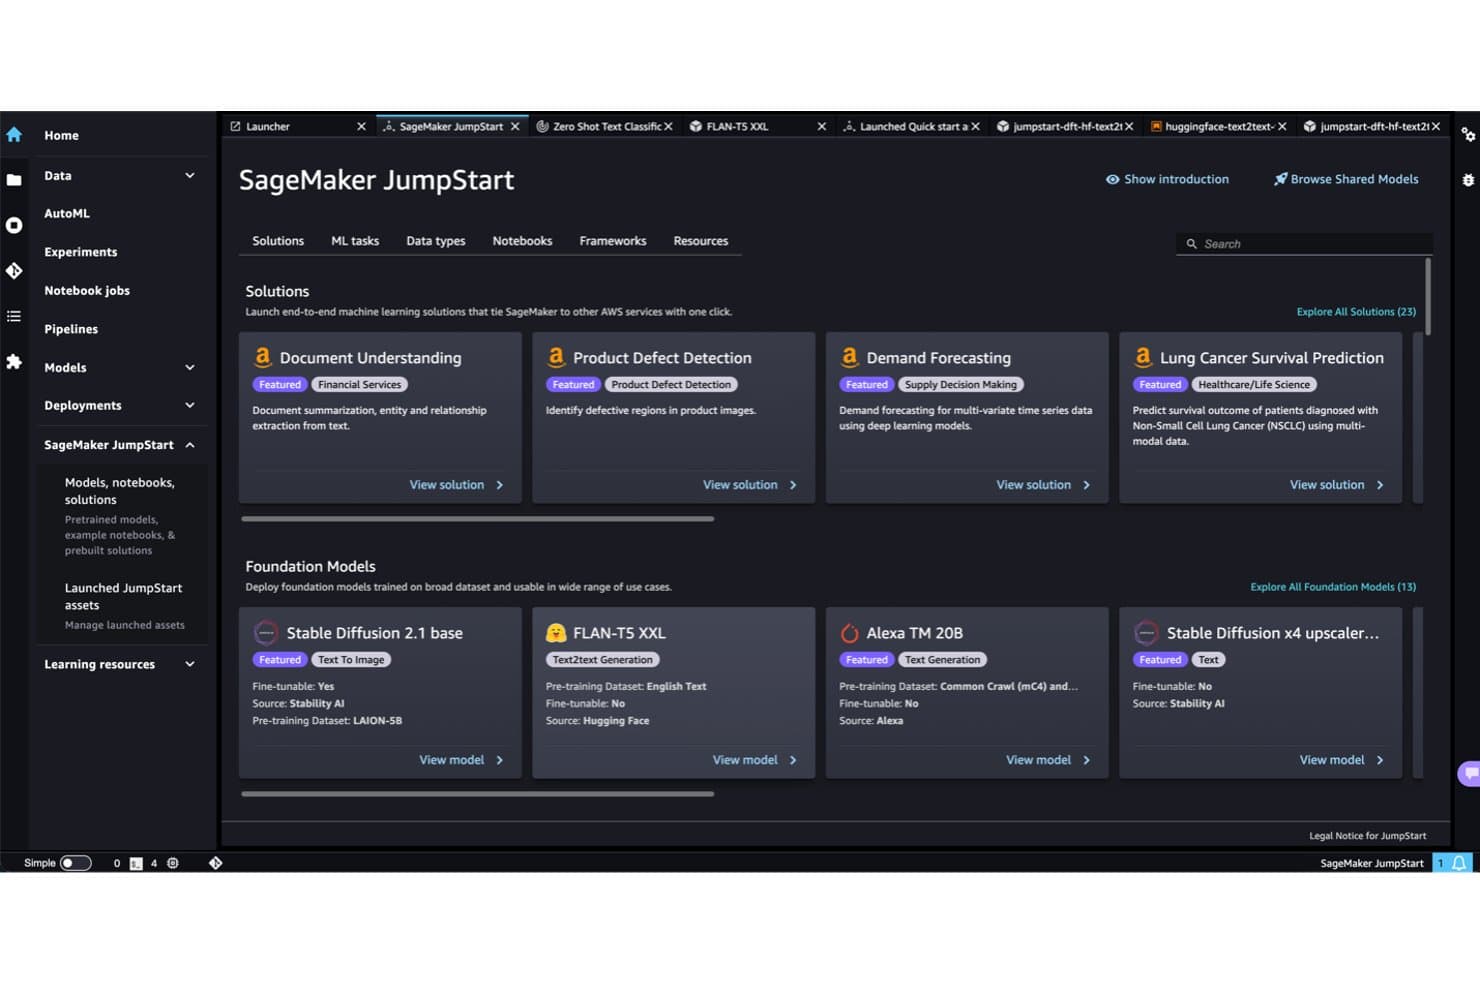
Amazon SageMaker JumpStart propose des modèles NLP préconfigurés prêts à être déployés. Amazon SageMaker est la plateforme ML gérée d'AWS qui couvre l'ensemble du cycle de vie des modèles de traitement automatique du langage naturel (NLP), du prétraitement des données et de la tokenisation à l'entraînement, à l'affinement et au déploiement de grands modèles de langage à grande échelle grâce à des outils tels que JumpStart, HyperPod et les intégrations natives de Hugging Face.
À qui Amazon SageMaker convient-il le mieux ?
Amazon SageMaker convient aux ingénieurs ML et aux équipes MLOps des moyennes et grandes entreprises qui ont besoin d'une plateforme unique pour faire passer les LLM des données brutes à la production à grande échelle.
Pourquoi j'ai choisi Amazon SageMaker
Amazon SageMaker figure sur ma liste restreinte, car aucune autre plateforme ML gérée n'égale sa profondeur pour l'affinement de bout en bout des LLM à grande échelle. Je suis particulièrement impressionné par HyperPod, qui permet d'exécuter un affinement distribué sur des centaines d'accélérateurs grâce à un entraînement élastique sans points de contrôle, réduisant le temps d'entraînement jusqu'à 40 %. Le catalogue de plus de 1,000 modèles de JumpStart, comprenant Llama 4, DeepSeek R1 et les LLM médicaux de John Snow Labs, me permet de sélectionner un modèle de base spécifique à un domaine puis de l'affiner sur des données personnalisées sans quitter la plateforme.
Principales fonctionnalités d'Amazon SageMaker
- SageMaker Clarify : détecte les biais et génère des rapports d'explicabilité pour les modèles NLP pendant l'entraînement, l'évaluation et la surveillance après déploiement.
- SageMaker Data Wrangler : fournit une interface nécessitant peu de code pour importer, transformer et préparer les données textuelles avant l'entraînement du modèle.
- Points de terminaison d'inférence multimodes : prend en charge les options d'inférence en temps réel, sans serveur, asynchrone et par lots sur plus de 70 types d'instances, notamment les puces Inferentia et Trainium.
- Intégration à MLflow géré : suit les expériences, compare les exécutions de modèles et gère la gestion des versions dans les flux de travail NLP sans nécessiter d'infrastructure distincte.
Intégrations d'Amazon SageMaker
Amazon SageMaker propose des intégrations natives avec Amazon S3, Amazon Bedrock, Amazon OpenSearch Service, Amazon EKS, AWS Lambda, Amazon CloudWatch, AWS IAM, Hugging Face et MLflow. Il propose également des API REST, des SDK et un accès à AWS CLI pour les intégrations personnalisées.
Pros and Cons
Pros:
- Le plus grand catalogue de modèles préentraînés disponible
- HyperPod prend en charge l'entraînement distribué massif des LLM
- Cycle de vie de bout en bout avec des outils d'explicabilité
Cons:
- Le suivi des coûts est difficile pour la plupart des équipes
- Risque de dépendance au fournisseur pour les entreprises utilisant plusieurs clouds
Learn more about Amazon SageMaker: Idéal pour obtenir des informations textuelles natives d’AWS à grande échelle
- Forfait gratuit disponible
- À partir de $0.0001/unité
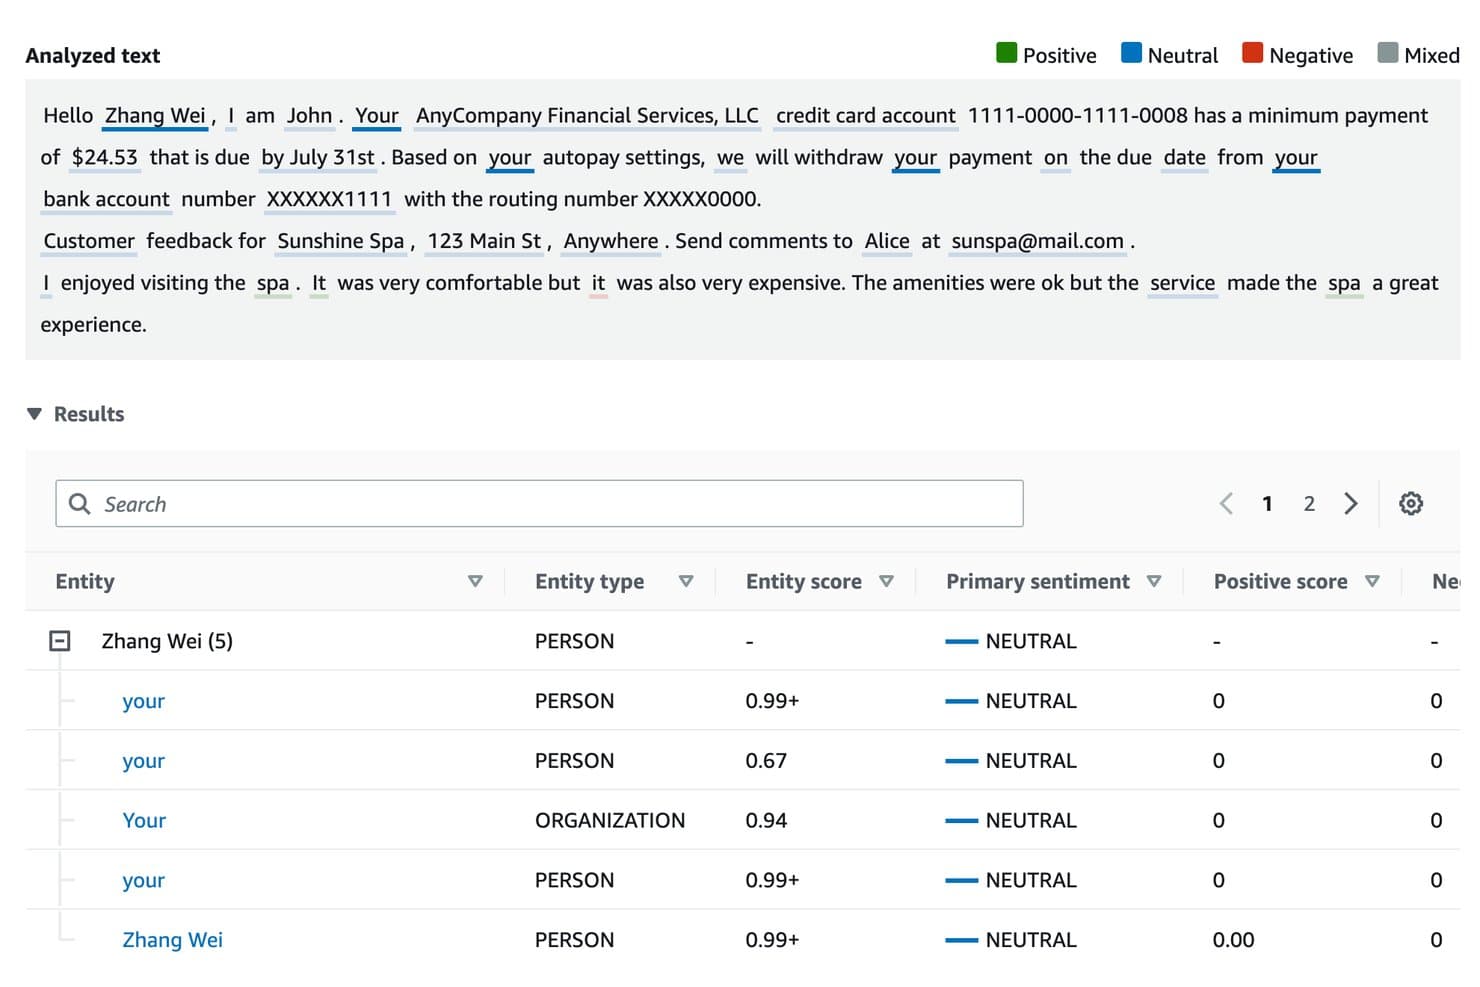
Amazon Comprehend identifie les entités et les sentiments dans le texte analysé. Amazon Comprehend est un service NLP AWS entièrement géré qui fournit des fonctionnalités d’analyse de texte préconfigurées pilotées par API, notamment l’analyse des sentiments, la reconnaissance d’entités nommées, la détection des données personnelles, l’extraction des expressions clés et l’entraînement de modèles personnalisés via AutoML, sans vous obliger à gérer une quelconque infrastructure sous-jacente.
À qui Amazon Comprehend convient-il le mieux ?
Amazon Comprehend convient particulièrement aux équipes d’ingénierie et de DevOps qui exécutent déjà des charges de travail dans AWS et qui ont besoin de fonctionnalités NLP prêtes pour la production sans gérer d’infrastructure de ML.
Pourquoi ai-je choisi Amazon Comprehend ?
Amazon Comprehend figure sur ma liste restreinte parce qu’il s’agit de la solution la plus naturelle pour effectuer une analyse de texte native d’AWS à grande échelle. J’apprécie le fait de pouvoir exécuter l’analyse des sentiments, la reconnaissance ciblée d’entités et la suppression des données personnelles directement via des points de terminaison d’API gérés, sans provisionner un seul serveur. En pratique, cela signifie que mon équipe peut traiter de manière asynchrone des millions d’enregistrements clients provenant de S3, avec une tarification par paliers de volume qui devient réellement moins chère à mesure que le volume analysé augmente.
Principales fonctionnalités d’Amazon Comprehend
- Reconnaissance d’entités personnalisées : entraînez un outil de reconnaissance d’entités spécifique à votre domaine à partir de vos propres exemples étiquetés afin d’extraire des termes tels que des numéros de police ou des codes internes que les modèles préconfigurés ne détectent pas.
- Détection et suppression des données personnelles : identifiez et supprimez automatiquement les données personnelles sensibles — noms, numéros de sécurité sociale, numéros de carte bancaire — directement dans votre pipeline de traitement des documents.
- Automatisation MLOps avec Flywheel : gérez l’intégralité du cycle de vie des modèles personnalisés, de l’ingestion des données au réentraînement et à la promotion des versions, sans créer une couche MLOps distincte.
- Mise en correspondance avec les ontologies de Comprehend Medical : associez les entités cliniques extraites à des systèmes de codage standardisés tels qu’ICD-10-CM, RxNorm et SNOMED CT pour les workflows NLP spécifiques au secteur de la santé.
Intégrations d’Amazon Comprehend
Amazon Comprehend propose des intégrations natives avec Amazon S3, AWS Lambda, AWS KMS, AWS IAM, Amazon Kendra, Amazon Lex, Amazon Connect, AWS CloudTrail et Amazon CloudWatch. Son API REST, ses SDK AWS, AWS CLI, Step Functions et EventBridge prennent en charge les pipelines personnalisés et l’automatisation des workflows.
Pros and Cons
Pros:
- Intégration native aux workflows NLP centrés sur AWS
- NLP médical avec mise en correspondance des ontologies cliniques
- Détection et suppression intégrées des données personnelles
Cons:
- Aucun accès aux mécanismes internes des modèles
- Possibilités limitées de réglage fin au-delà de l’AutoML de base
Learn more about Amazon Comprehend: Idéal pour le déploiement de pipelines NLP prêts pour la production
- Formule gratuite disponible
- Formule gratuite disponible
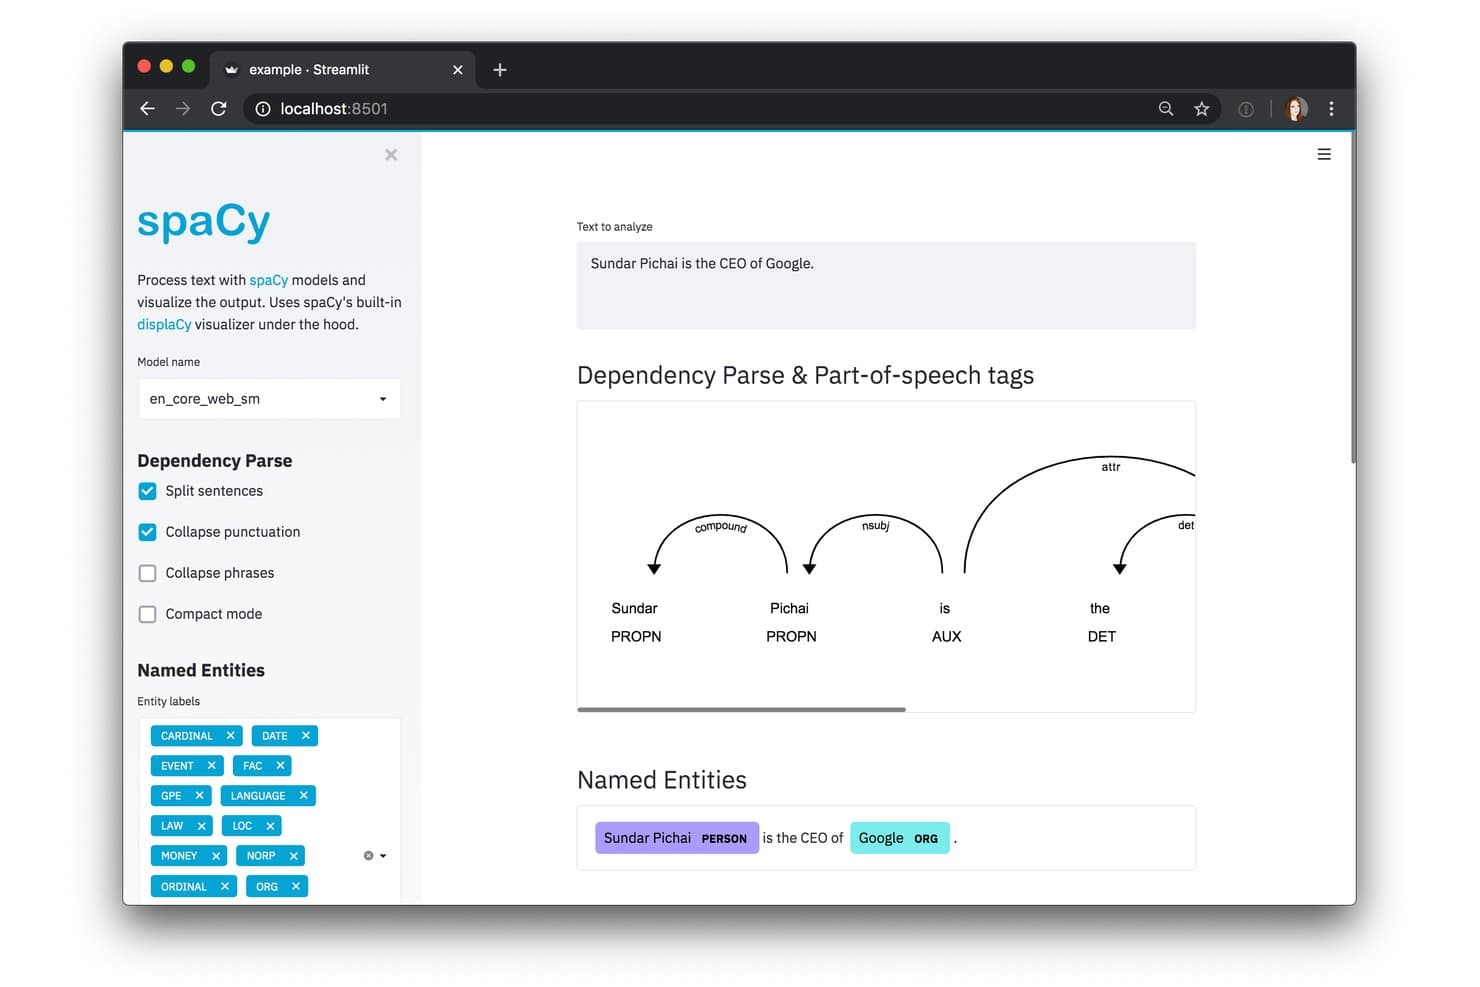
spaCy visualise de manière interactive l’analyse des dépendances et les entités nommées. spaCy est une bibliothèque NLP Python à code source ouvert qui couvre la tokenisation, la reconnaissance d’entités nommées, l’analyse syntaxique des dépendances, la classification de textes et l’entraînement de modèles basés sur des transformeurs dans plus de 75 langues.
À qui spaCy convient-il le mieux ?
spaCy convient particulièrement aux ingénieurs en apprentissage automatique et aux scientifiques des données qui doivent créer, entraîner et déployer des pipelines NLP en Python sans dépendre d’une plateforme gérée.
Pourquoi j’ai choisi spaCy
spaCy figure dans ma sélection parce qu’il a été conçu dès le départ pour la production, et pas seulement pour l’expérimentation. J’apprécie le fait que les pipelines entraînés soient empaquetés sous forme de modules Python installables, ce qui signifie que le déploiement d’un modèle NER personnalisé dans un conteneur Docker ou une couche AWS Lambda devient un processus reproductible et versionné, plutôt qu’une opération improvisée. Le système
spaCy trainpiloté par configuration regroupe chaque hyperparamètre et chaque choix d’architecture dans un seul fichier, ce qui rend mes pipelines reproductibles dans différents environnements. C’est cette combinaison entre une discipline d’empaquetage et un débit de traitement par lots optimisé par Cython vianlp.pipe()qui rend spaCy véritablement prêt pour la production.Principales fonctionnalités de spaCy
- 84 pipelines préentraînés : téléchargez et exécutez des pipelines préentraînés dans 25 langues, allant de modèles compacts optimisés pour le processeur à des variantes complètes basées sur des transformeurs, construites avec RoBERTa et BERT.
- Intégration de
spaCy-LLM: connectez directement les pipelines spaCy aux API de LLM hébergées (OpenAI, Anthropic, Cohere) ou à des modèles à code source ouvert pour exécuter des tâches NLP sans nécessiter de données d’entraînement annotées. - Visualiseur displaCy : affichez dans le navigateur les annotations d’entités nommées et les arbres d’analyse des dépendances à l’aide du composant de visualisation intégré de spaCy.
- Écosystème de pipelines spécialisés par domaine : accédez à des pipelines communautaires prêts à l’emploi pour le secteur de la santé (medspaCy) et les textes juridiques (Blackstone) via la bibliothèque spaCy Universe.
Intégrations de spaCy
spaCy s’intègre à Hugging Face Transformers, PyTorch, TensorFlow, OpenAI, Anthropic, Cohere, LangChain, Prodigy, DVC, Prefect et Ray. Son API Python prend en charge les intégrations personnalisées, mais elle n’inclut pas d’API REST native.
Pros and Cons
Pros:
- S’exécute entièrement sur votre propre infrastructure
- Propose des pipelines spécialisés pour les secteurs de la santé et du droit
- L’empaquetage permet des déploiements de modèles reproductibles et versionnés
Cons:
- Aucune API REST intégrée pour la mise à disposition
- Aucune interface visuelle ou aucun flux de travail sans code
Learn more about spaCy: Idéal pour le NLP gouverné dans des déploiements cloud hybrides
- Formule gratuite + essai gratuit + démonstration gratuite disponibles
- À partir de $1,110/mois

IBM watsonx.ai extrait des faits structurés de documents 10-K de la SEC à l’aide d’invites fournissant quelques exemples. IBM watsonx.ai est une plateforme d’IA d’entreprise qui combine un catalogue de modèles de fondation multi-fournisseurs, la bibliothèque Watson NLP, le réglage fin LoRA/QLoRA, l’AutoML et des options flexibles de déploiement en SaaS, sur site et dans le cloud hybride pour créer et faire évoluer des charges de travail NLP.
À qui IBM watsonx.ai convient-il le mieux ?
IBM watsonx.ai convient particulièrement aux équipes informatiques et de science des données des entreprises qui doivent créer, régler finement et déployer des charges de travail NLP dans des environnements sur site, hybrides et cloud, avec des exigences strictes en matière de gouvernance et de conformité.
Pourquoi j’ai choisi IBM watsonx.ai
IBM watsonx.ai figure sur ma liste restreinte en raison de sa capacité à gérer efficacement le NLP gouverné dans des environnements cloud hybrides, ce qui constitue un véritable facteur de différenciation pour les équipes d’entreprise soumises à des exigences strictes de conformité. Je suis particulièrement impressionné par la bibliothèque Watson NLP, qui couvre la reconnaissance d’entités nommées, l’analyse des sentiments, la classification du ton et l’étiquetage des rôles sémantiques dans plus de 20 langues au sein d’un pipeline unique et auditable. En y associant CP4D sur Red Hat OpenShift pour les déploiements sur site ou hybrides et AI Factsheets pour les pistes d’audit des modèles, on obtient une gouvernance de bout en bout intégrée à chaque niveau.
Principales fonctionnalités d’IBM watsonx.ai
- Catalogue de modèles de fondation multi-fournisseurs : Accédez à des modèles préentraînés d’IBM Granite, Meta Llama, Mistral, DeepSeek et NVIDIA depuis une bibliothèque hébergée unique.
- Réglage fin LoRA/QLoRA : Adaptez les modèles de fondation à des tâches NLP propres à un domaine grâce à un réglage fin économe en paramètres dans des environnements accélérés par GPU.
- Générateur de pipelines AutoAI : Gère automatiquement la préparation des données, l’ingénierie des caractéristiques, la sélection des modèles et le réglage des hyperparamètres pour les flux de travail de ML prédictif.
- Point de terminaison d’API compatible avec OpenAI : Connectez les applications existantes à l’inférence watsonx.ai à l’aide d’un format d’API REST compatible avec OpenAI, ainsi que des SDK Python, Node.js et Java.
Intégrations d’IBM watsonx.ai
IBM watsonx.ai s’intègre à Hugging Face, Red Hat OpenShift, watsonx.data, Watson Assistant, watsonx Orchestrate, Watson Discovery et IBM Cloud Object Storage. Son API REST, ainsi que ses SDK Python, Node.js et Java, prennent en charge les intégrations personnalisées.
Pros and Cons
Pros:
- Large couverture des tâches NLP dans plus de 20 langues
- Indemnisation en cas de violation de propriété intellectuelle pour les modèles IBM d’entreprise
- Prise en charge native de la RAG et de la recherche vectorielle
Cons:
- Les modèles propriétaires d’IBM ne sont pas disponibles pour AWS
- L’interface peut être déroutante pour les nouveaux utilisateurs
Learn more about IBM watsonx.ai: Idéal pour les pipelines d'analyse de texte natifs de GCP
- Forfait gratuit disponible
- À partir de $0.90/1,000 caractères (facturé annuellement)

Google Cloud Natural Language AI annote les entités d'un CV, comme les compétences et les employeurs. Google Cloud Natural Language AI est une API NLP gérée de Google qui fournit une analyse des sentiments, une reconnaissance des entités, une analyse syntaxique, une classification du contenu et une modération de texte préentraînées via des interfaces REST et gRPC, avec des bibliothèques clientes dans huit langages de programmation.
À qui Google Cloud Natural Language AI convient-il le mieux ?
Google Cloud Natural Language AI convient particulièrement aux équipes d'ingénierie qui exécutent déjà des charges de travail sur GCP et qui ont besoin de fonctionnalités NLP prêtes pour la production sans devoir gérer l'infrastructure.
Pourquoi j'ai choisi Google Cloud Natural Language AI
Google Cloud Natural Language AI figure sur ma liste restreinte en raison de son intégration naturelle aux pipelines d'analyse de texte natifs de GCP. Si votre équipe traite déjà des données avec BigQuery, vous pouvez appeler
ML.UNDERSTAND_TEXTdirectement en SQL pour effectuer une analyse des sentiments ou des entités sans jamais quitter l'entrepôt de données. J'apprécie également le fait que l'API v2 utilise un modèle basé sur PaLM pour les tâches liées aux entités et aux sentiments, et que la méthodeannotateTextpermette d'extraire plusieurs fonctionnalités NLP en un seul appel d'API, ce qui réduit considérablement la surcharge liée aux allers-retours.Principales fonctionnalités de Google Cloud Natural Language AI
- Analyse des sentiments associés aux entités : Détecte le sentiment associé à chaque entité nommée dans un texte et renvoie des scores par entité pour l'anglais, le japonais et l'espagnol.
- AutoML Natural Language : Permet d'entraîner des modèles personnalisés de classification de texte et d'extraction d'entités sur vos propres jeux de données étiquetés grâce à une interface visuelle sans code via Vertex AI.
- Points de terminaison multirégion : Achemine les requêtes d'API via des points de terminaison aux États-Unis ou dans l'Union européenne afin que les données soient traitées et stockées dans une région spécifique, conformément aux exigences de résidence des données.
- API éligible à la norme HIPAA : Couverte par l'accord d'association commerciale de Google Cloud, ce qui permet de l'utiliser dans des flux de travail traitant des informations de santé protégées.
Intégrations de Google Cloud Natural Language AI
Google Cloud Natural Language AI s'intègre à Vertex AI, BigQuery, Cloud Composer, Speech-to-Text, Translation API, Vision API, Dataflow, Cloud Run et Cloud Functions. REST, gRPC et huit bibliothèques clientes prennent en charge les intégrations personnalisées.
Pros and Cons
Pros:
- Les modèles préentraînés ne nécessitent aucune donnée d'entraînement
- Les données ne sont jamais stockées après le traitement par l'API
- Prise en charge multilingue des principales fonctionnalités NLP
Cons:
- Aucune explicabilité des modèles ni mesure des biais
- L'affinage est uniquement disponible via Vertex AI
Learn more about Google Cloud Natural Language AI: Idéal pour le réglage fin de modèles à code source ouvert à grande échelle
- Formule gratuite disponible
- À partir de 9 $/mois

HuggingChat permet aux utilisateurs d'interroger des modèles d'IA via une interface de chat en ligne. Hugging Face est une plateforme de traitement automatique du langage naturel (NLP) à code source ouvert qui vous donne accès à plus de 2 millions de modèles préentraînés, ainsi qu'à une suite complète d'outils pour la tokenisation, le réglage fin et le déploiement de modèles dans des environnements cloud et sur site.
À qui Hugging Face convient-il le mieux ?
Hugging Face est la plateforme de référence pour les ingénieurs ML et NLP qui ont besoin d'un accès direct aux modèles à code source ouvert et à la chaîne d'outils complète pour les régler finement, les évaluer et les déployer à grande échelle.
Pourquoi ai-je choisi Hugging Face ?
Hugging Face figure dans ma sélection parce qu'aucune autre plateforme n'arrive à sa hauteur pour le réglage fin de modèles à code source ouvert à grande échelle. J'apprécie particulièrement le fait que PEFT et QLoRA permettent de régler finement des LLM comportant des milliards de paramètres, comme LLaMA ou Mistral, sur un seul GPU, ce qui réduit considérablement les coûts de calcul sans sacrifier la qualité. La bibliothèque TRL ajoute la prise en charge complète de RLHF et de DPO, ce qui permet ainsi d'aligner des modèles spécifiques à un domaine avec une surcharge minimale.
Principales fonctionnalités de Hugging Face
- API de pipeline Transformers : Une interface à une seule ligne pour exécuter des tâches NLP — classification, NER, résumé, traduction et QA — avec n'importe quel modèle disponible sur le Hub.
- AutoTrain : Une interface d'entraînement sans code dans laquelle vous importez un jeu de données étiqueté, sélectionnez une tâche, puis laissez la plateforme gérer automatiquement la sélection et l'entraînement du modèle.
- Inférence de représentations vectorielles textuelles (TEI) : Un moteur d'inférence dédié, optimisé pour la génération de représentations vectorielles à haut débit, prenant en charge la recherche sémantique et les pipelines RAG à grande échelle.
- Fournisseurs d'inférence via l'API : Un point de terminaison unifié compatible avec OpenAI qui achemine les requêtes entre des fournisseurs comme Groq, Together AI et Cerebras à l'aide d'un seul jeton Hugging Face.
Intégrations de Hugging Face
Hugging Face s'intègre à PyTorch, TensorFlow, JAX, AWS SageMaker, Google Cloud, Azure, Weights & Biases, MLflow et Snowflake. Ses API Python, JavaScript, REST et CLI prennent en charge les intégrations personnalisées et les flux de déploiement.
Pros and Cons
Pros:
- Sélection inégalée de modèles NLP à code source ouvert
- Permet de régler finement de très grands modèles sur un seul GPU
- AutoTrain permet d'entraîner des modèles sans code
Cons:
- La qualité et la sécurité des modèles communautaires varient
- Le déploiement adapté aux entreprises nécessite une expertise DevOps
Learn more about Hugging Face:
Autres logiciels NLP
Voici une liste d’autres logiciels NLP que j’ai retenus, mais qui ne figurent pas dans les 10 premiers. Ils méritent certainement d’être examinés.
- 11NLP CloudIdéal pour le déploiement d’API de traitement automatique du langage axé sur la confidentialité
- 12SnorkelIdéal pour l’étiquetage programmatique à l’échelle de l’entreprise
- 13ClaudeIdéal pour le NLP axé sur la sécurité dans tous les principaux environnements cloud
- 14Cohere NorthIdéal pour le déploiement de modèles NLP isolés du réseau
- 15Microsoft Azure AI LanguageIdéal pour le NLP isolé dans les secteurs réglementés
- 16NLTKIdéal pour le traitement automatique du langage naturel classique, sans coût d’infrastructure
- 17Stanford NLPIdéal pour une précision linguistique dans plus de 80 langues
Comment j'évalue les logiciels de TAL
Des pipelines de reconnaissance d’entités nommées aux déploiements de transformeurs en production, j’évalue les outils de TAL sur deux plans : le socle minimum que chaque plateforme doit atteindre pour figurer sur la liste, et les éléments différenciateurs qui placent les meilleurs au-dessus du lot.
Fonctionnalité de base (Pré-requis pour figurer sur cette liste)
Lorsque je sélectionne des outils pour ma liste, j’attribue à chacun une note de 0 (ne fournit pas la fonctionnalité) à 5 (excelle dans ce domaine) pour chaque fonctionnalité de base énumérée ci-dessous. Ensuite, je calcule le score total de l’outil sous forme de pourcentage. Chaque outil doit atteindre un score total minimum de 75 % pour être considéré à l’inclusion.
- Prétraitement et tokenisation du texte : Je vérifie si une plateforme exécute toute la chaîne de nettoyage : tokenisation, racinisation, lemmatisation, suppression des mots vides, afin que le texte brut soit prêt pour le pipeline dans plusieurs langues.
- Modèles de langue pré-entraînés : L’accès aux architectures de transformeurs récentes est essentiel. Je privilégie les catalogues de modèles larges et mis à jour régulièrement, pas quelques options obsolètes.
- Couverture des tâches TAL fondamentales : Chaque outil doit couvrir les tâches essentielles comme la reconnaissance d’entités nommées, l’analyse de sentiment, la classification et la synthèse : ce sont les fondamentaux de la plupart des workflows TAL en production.
- Entraînement et affinage de modèles : J’évalue si vous pouvez apporter votre propre jeu de données et affiner des modèles avec un vrai contrôle des hyperparamètres, pas juste activer quelques préréglages dans un assistant.
- Accès API & SDK : De bons outils TAL exposent des API REST et des SDK en Python ou Java. Je regarde la clarté de la documentation, la gestion des versions et la compatibilité avec les principaux frameworks.
- Déploiement et montée en charge : J’examine la capacité de chaque plateforme à soutenir la production : support de l’auto-scaling en inférence, traitement par lots, et options souples d’infrastructure GPU ou TPU.
Une fois la liste des outils répondant à ces critères établie, j’étudie les éléments qui font la différence entre chaque plateforme.
Facteurs de différenciation (Ce qui distingue les fournisseurs)
Voici comment je compare et distingue les différents fournisseurs :
Fonctionnalités remarquables
Les frameworks RAG et le support de la recherche vectorielle sont aujourd’hui de vrais facteurs différenciateurs. Les équipes qui développent des applications motorisées par des LLM ont besoin de pipelines natifs pour la génération d’embeddings et la recherche d’informations, pas de solutions de contournement ajoutées après coup. Je recherche aussi des outils d’explicabilité et de détection de biais : lorsqu’on déploie des modèles de sentiment en production, les parties prenantes veulent comprendre l’origine d’une prédiction. Les modèles spécialisés par domaine font vraiment gagner du temps, surtout pour les équipes santé ou juridiques qui devraient sinon passer des semaines à adapter des modèles généralistes.
Au-delà des fonctionnalités
La flexibilité de déploiement compte quand vos équipes sécurité demandent des installations sur site ou en environnement fermé. J’évalue si la plateforme propose des déploiements cloud, hybrides et autonomes, avec prise en charge de Kubernetes. La protection des données est tout aussi essentielle : je vérifie la conformité SOC 2, les options de résidence des données et une politique de non‑conservation, notamment lorsque les pipelines traitent des textes sensibles comme des dossiers médicaux. Enfin, l’adéquation à l’écosystème : un outil qui s’intègre à la stack MLOps et à l’infrastructure de données peut faire gagner des mois d’intégration sur-mesure.
Comment choisir un logiciel NLP
Il est facile de se perdre dans de longues listes de fonctionnalités et des structures tarifaires complexes. Pour vous aider à rester concentré tout au long de votre processus personnalisé de sélection d’un logiciel, voici une liste des facteurs à garder à l’esprit :
| Facteur | Points à prendre en compte |
|---|---|
| FacteurÉvolutivité | Points à prendre en compteLe logiciel peut-il évoluer avec votre équipe ? Recherchez des outils capables de gérer des volumes de données croissants sans coûts supplémentaires. Tenez compte de vos besoins futurs et de vos éventuelles extensions. |
| FacteurIntégrations | Points à prendre en compteFonctionne-t-il avec vos systèmes existants ? Vérifiez sa compatibilité avec vos outils actuels afin d’éviter les perturbations de votre flux de travail. |
| FacteurPersonnalisation | Points à prendre en comptePouvez-vous l’adapter à vos besoins ? Assurez-vous de pouvoir ajuster les paramètres ou les fonctionnalités afin de les adapter à vos processus spécifiques. |
| FacteurFacilité d’utilisation | Points à prendre en compteL’interface est-elle conviviale ? Les outils complexes peuvent ralentir l’adoption. Recherchez des conceptions intuitives nécessitant un minimum de formation. |
| FacteurMise en œuvre et intégration | Points à prendre en compteCombien de temps faudra-t-il pour démarrer ? Évaluez le temps nécessaire à la configuration et à la formation. Une intégration rapide peut vous faire économiser du temps et des ressources. |
| FacteurCoût | Points à prendre en compteLe logiciel correspond-il à votre budget ? Comparez les formules tarifaires et soyez attentif aux frais cachés. Prenez en compte le coût total de possession, et pas seulement le prix initial. |
| FacteurMesures de sécurité | Points à prendre en compteVos données sont-elles protégées ? Assurez-vous du respect des normes de confidentialité des données et recherchez des fonctionnalités de chiffrement et d’autres dispositifs de sécurité. |
| FacteurDisponibilité de l’assistance | Points à prendre en compteLes services d’assistance sont-ils accessibles lorsque vous en avez besoin ? Évaluez la disponibilité et la qualité des canaux d’assistance client, tels que le chat, l’e-mail ou le téléphone. |
Qu’est-ce qu’un logiciel NLP ?
Les logiciels de TAL sont des outils qui traitent et analysent les données du langage humain. Des professionnels comme les scientifiques des données, les spécialistes du marketing et les équipes du service client utilisent ces outils pour extraire des informations et améliorer la communication. Les fonctionnalités d’analyse de texte, d’analyse des sentiments et de traduction linguistique facilitent la compréhension des besoins des utilisateurs et la formulation de réponses adaptées.
Dans l’ensemble, ces outils, notamment les logiciels d’intelligence conversationnelle, améliorent la prise de décision et l’efficacité dans les tâches liées au langage.
Fonctionnalités
Lors de la sélection d’un logiciel de TAL, prêtez attention aux principales fonctionnalités suivantes :
- Analyse de texte : Traite de grands volumes de données textuelles afin d’en extraire des informations pertinentes, aidant les équipes à comprendre les tendances et les schémas.
- Analyse des sentiments : Identifie et catégorise les opinions exprimées dans les textes afin d’évaluer les attitudes des clients et d’améliorer les stratégies d’engagement.
- Traduction linguistique : Convertit des textes d’une langue à une autre, facilitant la communication et l’accessibilité à l’échelle mondiale.
- Logiciel de reconnaissance vocale : Transcrit le langage parlé en texte, permettant la saisie vocale et améliorant l’accessibilité.
- Reconnaissance des entités : Identifie et classe les éléments clés d’un texte, tels que les noms et les dates, afin d’améliorer l’organisation des données.
- Prise en charge multilingue : Offre des fonctionnalités dans plusieurs langues, permettant une utilisation plus large dans diverses régions.
- Modèles personnalisables : Permet aux utilisateurs d’adapter les algorithmes à des besoins spécifiques, améliorant ainsi la pertinence et la précision des résultats.
- Traitement en temps réel : Fournit une analyse et un retour immédiats, essentiels pour les applications et la prise de décision soumises à des contraintes de temps.
- Paramètres de confidentialité des données : Garantit le respect des réglementations relatives à la protection des données et sécurise les informations sensibles.
- Intégration au cloud : Permet une collaboration fluide et l’accès aux données sur diverses plateformes et différents appareils.
Avantages
La mise en œuvre d’un logiciel de TAL offre plusieurs avantages à votre équipe et à votre entreprise. Voici quelques-uns de ceux dont vous pouvez bénéficier :
- Amélioration de la communication : Les logiciels de génération de langage naturel et la reconnaissance vocale facilitent une communication mondiale et accessible.
- Amélioration de la prise de décision : L’analyse de texte et l’analyse des sentiments fournissent des informations qui orientent les stratégies et les actions.
- Gain de temps : Le traitement en temps réel fournit rapidement un retour d’information, permettant d’accélérer les réponses et les actions.
- Rentabilité : L’automatisation de tâches telles que la reconnaissance des entités réduit le besoin de traitement manuel des données et permet d’économiser des ressources.
- Précision accrue : Les modèles personnalisables garantissent des résultats adaptés à des besoins spécifiques, améliorant la précision des résultats produits.
- Sécurité des données : Les paramètres de confidentialité des données contribuent à protéger les informations sensibles et à garantir la conformité aux réglementations.
- Évolutivité : La prise en charge multilingue et l’intégration au cloud permettent la croissance et l’adaptation sur différents marchés.
Coûts et tarifs
La sélection d’un logiciel de TAL nécessite de comprendre les différents modèles tarifaires et forfaits disponibles. Les coûts varient en fonction des fonctionnalités, de la taille de l’équipe, des modules complémentaires et d’autres éléments. Le tableau ci-dessous résume les forfaits courants, leurs prix moyens et les fonctionnalités généralement incluses dans les solutions logicielles de TAL :
Tableau comparatif des forfaits de logiciels de TAL
| Type de forfait | Prix moyen | Fonctionnalités courantes |
|---|---|---|
| Type de forfaitForfait gratuit | Prix moyen$0 | Fonctionnalités courantesAnalyse de texte de base, prise en charge limitée des langues et assistance communautaire. |
| Type de forfaitForfait personnel | Prix moyen$10-$30/user/month | Fonctionnalités courantesAnalyse des sentiments, traduction linguistique et assistance par e-mail. |
| Type de forfaitForfait professionnel | Prix moyen$40-$100/user/month | Fonctionnalités courantesReconnaissance vocale, reconnaissance des entités et assistance téléphonique. |
| Type de forfaitForfait entreprise | Prix moyen$150+/user/month | Fonctionnalités courantesModèles personnalisables, traitement en temps réel et gestion de compte dédiée. |
FAQ sur les logiciels de TAL
Voici quelques réponses aux questions fréquentes sur les logiciels de TAL :
Les logiciels de TAL peuvent-ils s’intégrer à mes outils existants ?
La plupart des logiciels de TAL offrent des possibilités d’intégration avec des plateformes populaires comme les systèmes de gestion de la relation client (CRM) et les outils d’analyse de données. Vérifiez la compatibilité avec votre environnement technologique actuel afin de garantir un flux de travail et un partage des données fluides. Certaines solutions peuvent nécessiter le développement d’une API personnalisée pour l’intégration.
Quel est le niveau de sécurité des logiciels de TAL ?
Les fonctionnalités de sécurité varient selon le fournisseur, mais recherchez le chiffrement des données, la conformité aux réglementations relatives à la protection des données et des mises à jour de sécurité régulières. Assurez-vous que le logiciel respecte les normes de votre secteur en matière de confidentialité et de protection des données, en particulier s’il traite des informations sensibles.
Les logiciels de TAL peuvent-ils être personnalisés ?
De nombreux outils de TAL proposent des options de personnalisation permettant d’adapter les fonctionnalités et les modèles à vos besoins. Cela peut inclure l’ajustement des algorithmes ou la création de flux de traitement des données spécifiques. Toutefois, le niveau de personnalisation peut varier : vérifiez donc les possibilités offertes avant de choisir une solution.
Quel type d’assistance est disponible pour les utilisateurs de logiciels de TAL ?
Les services d’assistance vont des ressources en ligne, comme les FAQ et les tutoriels, à l’assistance client en direct par chat, e-mail ou téléphone. Évaluez la disponibilité et la réactivité de ces services, et tenez compte de l’importance de disposer d’une assistance dédiée, notamment lors de la mise en œuvre.
Le TAL est-il la même chose que l’IA ?
Le TAL est un sous-domaine de l’intelligence artificielle. Alors que les logiciels d’IA couvrent un large éventail de fonctionnalités, le TAL concerne spécifiquement le traitement du langage humain.
Les logiciels de TAL peuvent-ils comprendre l’argot ou le langage informel ?
Certains outils de TAL sont entraînés à reconnaître le langage informel, l’argot ou les expressions régionales, mais la précision peut varier en fonction des données utilisées pour entraîner le modèle.