

Honeycomb est un outil conçu pour fournir des informations sur le fonctionnement interne de votre système, afin de vous aider à optimiser les performances et à résoudre les problèmes.
Les avantages sont nombreux : il vous permet de suivre des événements individuels, rendant les systèmes complexes observables et vous permettant de comprendre, d'améliorer et de déboguer vos logiciels.
Cependant, il peut arriver que vous souhaitiez une alternative à Honeycomb. Vous utilisez peut-être un langage de programmation spécifique comme PHP ou avez besoin d'un outil offrant une conformité SOC. Vous souhaitez peut-être accéder au code source ou recherchez un ensemble de fonctionnalités différent.
Quelles que soient vos raisons, j'ai compilé une liste des meilleures alternatives à Honeycomb, accompagnées d'informations sur les produits et de notes en étoiles, afin de vous aider à trouver celle qui répond le mieux à vos besoins spécifiques. Alors, plongeons-nous dans ces options et explorons-les ensemble.
Qu'est-ce que Honeycomb ?
Honeycomb est une plateforme d'observabilité qui vous aide à déboguer, surveiller et comprendre vos systèmes logiciels en temps réel. Elle est utilisée par les ingénieurs logiciels, les équipes DevOps et les ingénieurs en fiabilité des sites qui doivent identifier rapidement les problèmes de performance et les comportements inhabituels en production. Les informations au niveau des événements, les requêtes et les cartes thermiques permettent d'analyser le comportement du système, de repérer les goulots d'étranglement et d'améliorer la fiabilité des applications. Globalement, Honeycomb donne à votre équipe une vision plus claire de ce qui se passe dans votre code, afin que vous puissiez résoudre les problèmes plus rapidement.
Pourquoi faire confiance à nos recommandations de logiciels
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Notre équipe teste et évalue des logiciels depuis 2012. En tant que leaders technologiques nous-mêmes, nous savons à quel point il est difficile — et important — de choisir le bon logiciel.
Pour ce guide, nous avons évalué les outils grâce à des tests pratiques et une recherche indépendante, en notant les outils selon nos critères de sélection.
Nos avis reflètent notre jugement éditorial humain, et non un argumentaire de vente.
Réviseurs experts:
- Paulo Gardini MiguelDirecteur technique
 Tim FisherVP de l'IA
 Gabriel RosasTech Lead et architecte logiciel
 Christhian GruhnTech Lead et architecte plateforme

Tableau comparatif des alternatives à Honeycomb
Ce tableau comparatif résume les informations tarifaires de ma sélection des meilleures alternatives à Honeycomb :
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Idéal pour le traçage distribué riche en contexte | Formule gratuite disponible | À partir de $26/mois (facturé annuellement) | Website | |
| 2 | Idéal pour la surveillance automatisée de bout en bout pilotée par l’intelligence artificielle (AI) | Essai gratuit de 15 jours | $21/utilisateur/mois pour leur forfait de surveillance de bout en bout (facturé annuellement) | Website | |
| 3 | Idéal pour réunir les traces, les journaux et les métriques dans une seule vue | Forfait gratuit disponible | $15/utilisateur/mois (facturé annuellement) | Website | |
| 4 | Idéal pour la surveillance à code source ouvert d’infrastructures à grande échelle | Forfait gratuit disponible | Tarification sur demande | Website | |
| 5 | Idéal pour le suivi de bout en bout des transactions métier | Essai gratuit de 30 jours | $3300 par unité et par an (facturé annuellement) | Website | |
| 6 | Idéal pour les analyses de performance des applications et le suivi de l’expérience utilisateur finale | Essai gratuit + démonstration gratuite disponible | 99 $/mois pour le forfait Pro (facturé annuellement) | Website | |
| 7 | Idéal pour la gestion et l’analyse des journaux dans les environnements cloud natifs | Essai gratuit de 14 jours | Tarification sur demande | Website | |
| 8 | Idéal pour la surveillance et la génération d’alertes fondées sur le volume des journaux | Essai gratuit de 30 jours | Tarifs sur demande | Website | |
| 9 | Idéal pour les renseignements opérationnels fondés sur les données machine | Essai gratuit de 60 jours | $150/mois (facturé annuellement) | Website | |
| 10 | Idéal pour les métriques et les alertes natives de Kubernetes | Formule gratuite disponible | Tarification sur demande | Website |


Avis sur les meilleures alternatives à Honeycomb
Vous trouverez ci-dessous mes résumés détaillés des meilleures alternatives à Honeycomb qui figurent dans ma sélection. Mes avis présentent une analyse approfondie des principales fonctionnalités, des avantages et inconvénients, des intégrations et des cas d’utilisation idéaux de chaque outil, afin de vous aider à trouver celui qui vous convient le mieux.
 Idéal pour le traçage distribué riche en contexte
- Formule gratuite disponible
- À partir de $26/mois (facturé annuellement)
Visit WebsiteCustomer Rating:4.5/5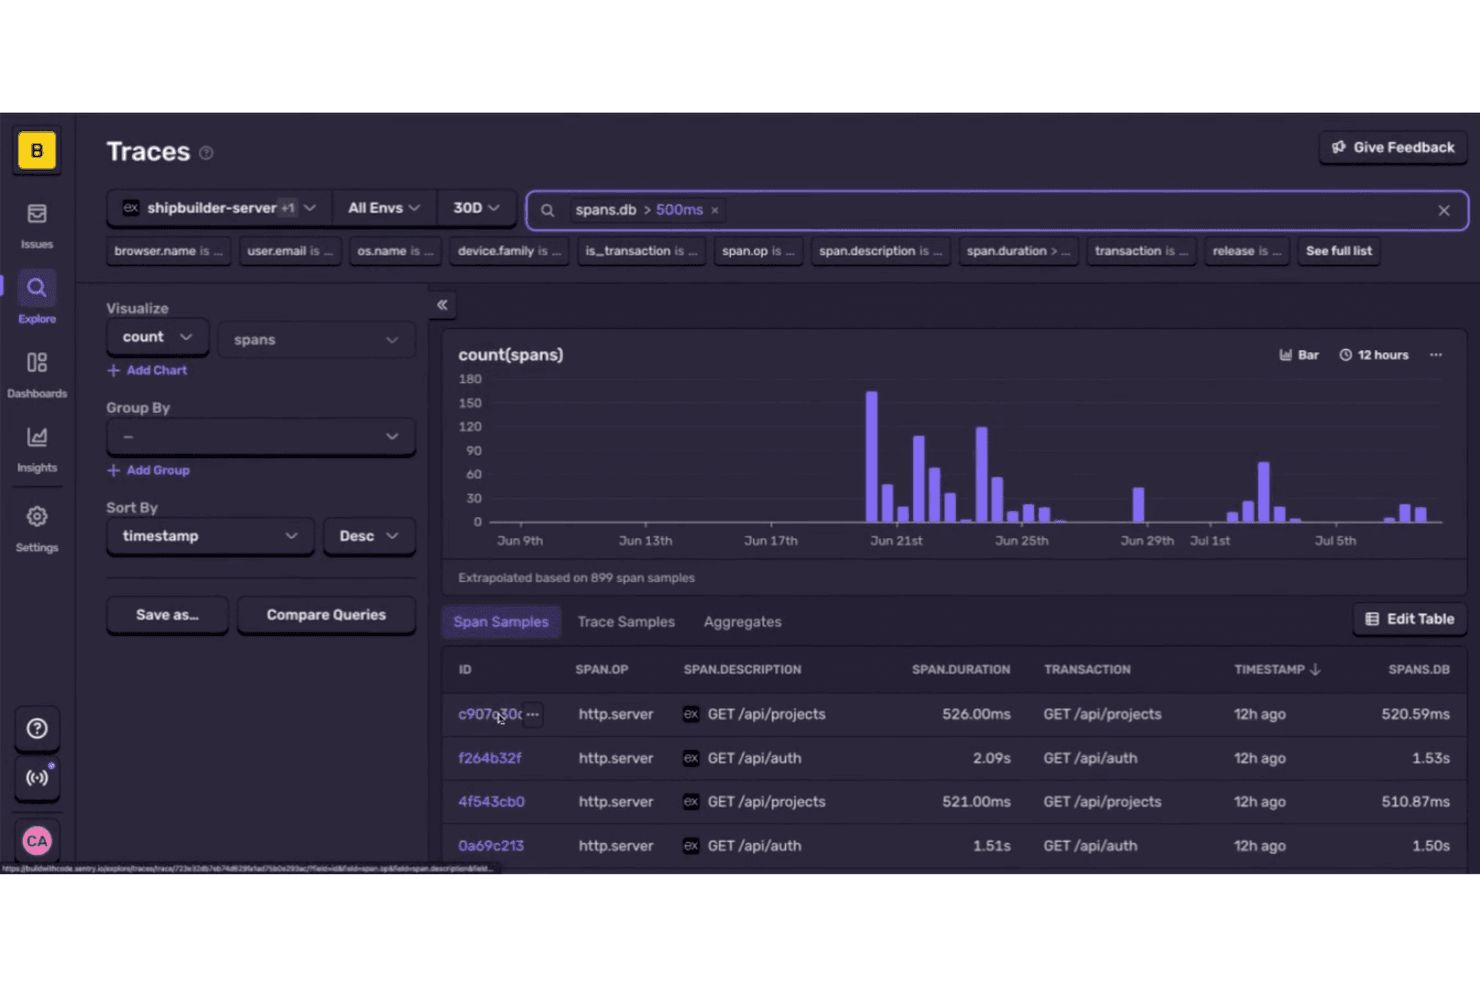
Sentry permet aux utilisateurs de suivre au fil du temps les étendues lentes des bases de données entre les services. Sentry est une plateforme de surveillance des applications destinée aux équipes logicielles. Elle aide les ingénieurs à détecter les erreurs et les problèmes de performances entre les services, à diagnostiquer les incidents et à réduire leur impact sur les utilisateurs.
À qui Sentry convient-il le mieux ?
Aux équipes d’ingénierie qui exécutent des applications distribuées et qui ont besoin du contexte des traces pour localiser les problèmes de performances entre les services.
Pourquoi ai-je choisi Sentry ?
J’ai choisi Sentry comme alternative à Honeycomb, car il est idéal pour le traçage distribué riche en contexte. Sa vue des traces cartographie les étendues entre les services et relie les erreurs aux transactions qui les ont déclenchées. J’apprécie la façon dont cela aide à déterminer où une requête lente accumule de la latence lorsqu’elle traverse une API et ses services en aval.
Fonctionnalités clés de Sentry
- Surveillance des erreurs : capture les exceptions et regroupe les événements similaires en problèmes.
- Lecture des sessions : enregistre les interactions des utilisateurs afin que les équipes puissent examiner les événements autour d’une erreur.
- État des versions : suit les sessions et les utilisateurs sans plantage entre les versions logicielles.
- Alertes sur les problèmes : envoie des notifications lorsque de nouveaux problèmes apparaissent ou que des problèmes existants changent.
Intégrations de Sentry
Sentry propose des intégrations natives avec GitHub, Jira, Slack, GitLab, Microsoft Teams, PagerDuty, Vercel, Bitbucket, Azure DevOps et Opsgenie. Sa plateforme d’intégration prend en charge les intégrations personnalisées via des webhooks et l’API REST.
Pros and Cons
Pros:
- Les erreurs renvoient directement au contexte de la trace
- Rechercher des étendues par attributs et percentiles de latence
- Relire les sessions utilisateur à côté des erreurs capturées
Cons:
- Cible principalement les erreurs des applications, et non l’infrastructure
- L’ensemble dense de fonctionnalités peut encombrer l’interface
Learn more about Sentry: Idéal pour la surveillance automatisée de bout en bout pilotée par l’intelligence artificielle (AI)
- Essai gratuit de 15 jours
- $21/utilisateur/mois pour leur forfait de surveillance de bout en bout (facturé annuellement)
Visit WebsiteCustomer Rating:4.5/5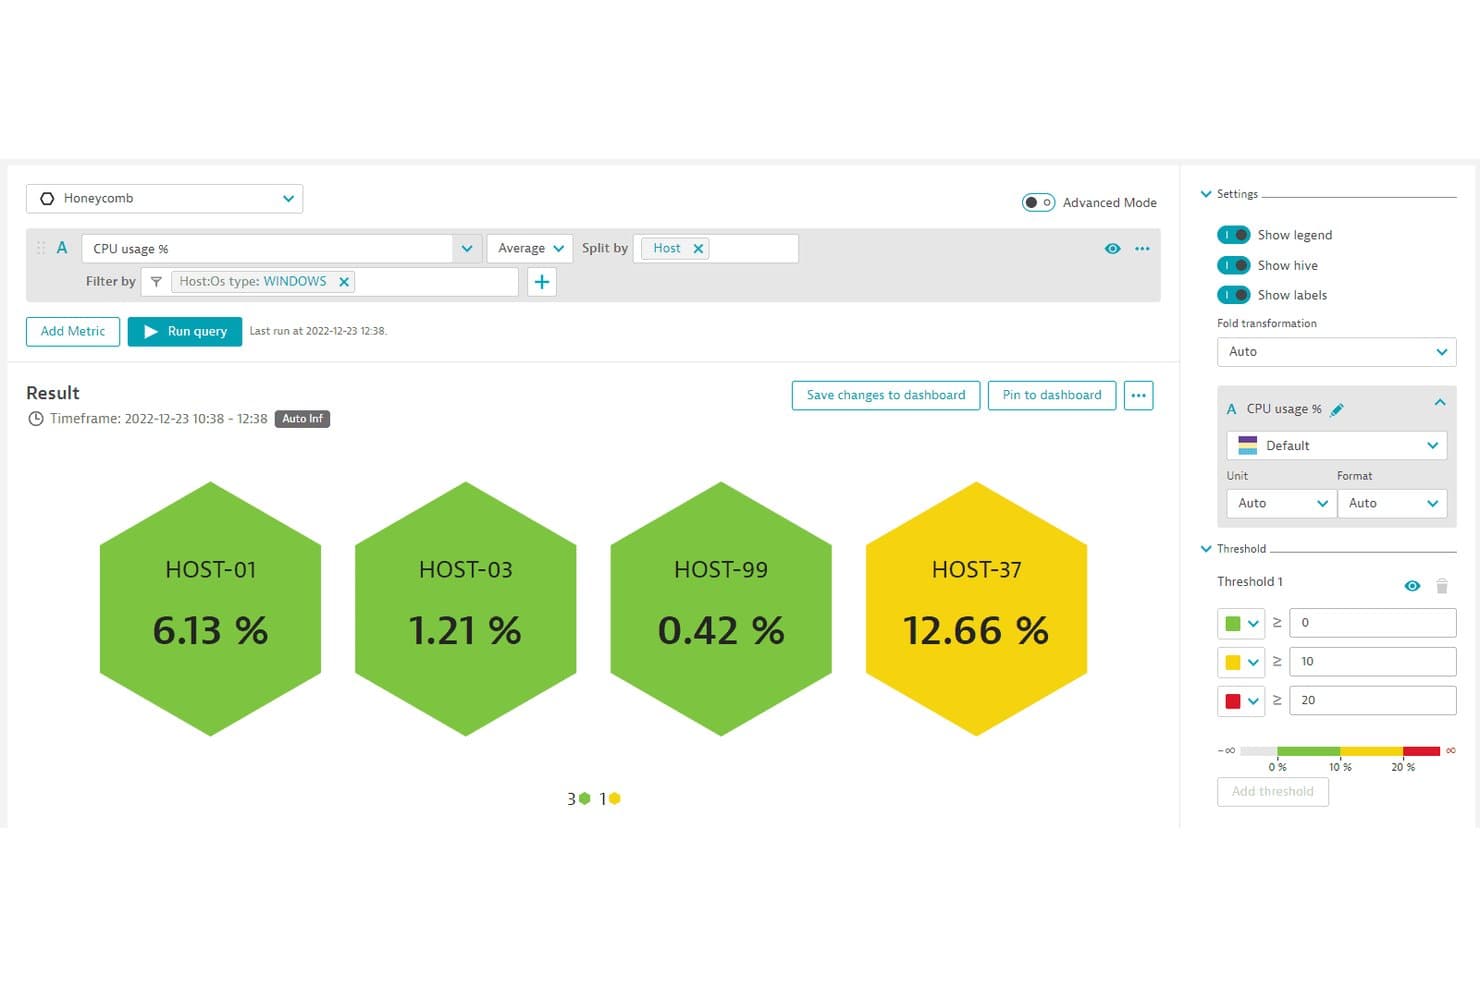
Dynatrace visualise l’utilisation du processeur par hôte à l’aide de tuiles en nid d’abeilles codées par couleur. En tant qu’alternative à Honeycomb, Dynatrace aide les équipes informatiques et d’ingénierie à relier les données des applications, de l’infrastructure et de l’expérience utilisateur afin de diagnostiquer les problèmes de service dans des environnements complexes.
À qui Dynatrace convient-il le mieux ?
Dynatrace convient aux équipes chargées des opérations informatiques et aux équipes SRE qui gèrent des environnements complexes et distribués nécessitant une surveillance automatisée des applications et de l’infrastructure.
Pourquoi j’ai choisi Dynatrace
Je considère Dynatrace comme l’une des meilleures alternatives à Honeycomb en raison de son orientation « Idéal pour les solutions de surveillance automatisée de bout en bout alimentées par l’intelligence artificielle (AI) ». Davis AI analyse la télémétrie afin d’identifier les causes profondes probables, tandis que OneAgent découvre et instrumente automatiquement les services sur les hôtes et les charges de travail cloud. J’apprécie sa cartographie des dépendances lorsqu’un pic de latence d’une API remonte jusqu’à un hôte ou à un service en aval.
Principales fonctionnalités de Dynatrace
- Surveillance des utilisateurs réels : suit les sessions utilisateur, les chargements de pages et les erreurs de l’interface utilisateur.
- Surveillance synthétique : exécute des vérifications planifiées dans le navigateur et via HTTP sur les points de terminaison.
- Surveillance des journaux : collecte, recherche et analyse les journaux parallèlement à la télémétrie.
- Surveillance de l’infrastructure cloud : suit les métriques et l’état des hôtes, des conteneurs et des services cloud.
Intégrations de Dynatrace
Dynatrace Workflows propose des connecteurs officiellement pris en charge pour AWS, Microsoft Azure, GitHub, Jira, Slack, PagerDuty, ServiceNow, Microsoft Teams, GitLab et Jenkins via Dynatrace Hub. Dynatrace fournit également une API pour les intégrations personnalisées.
Pros and Cons
Pros:
- Davis AI relie les anomalies aux causes profondes
- OneAgent découvre et instrumente automatiquement les services
- Unification des journaux, des traces, de l’infrastructure et de la surveillance des utilisateurs
Cons:
- La syntaxe DQL demande du temps pour être maîtrisée
- La consommation de télémétrie peut rendre les coûts imprévisibles
 Idéal pour réunir les traces, les journaux et les métriques dans une seule vue
- Forfait gratuit disponible
- $15/utilisateur/mois (facturé annuellement)
Visit WebsiteCustomer Rating:4.5/5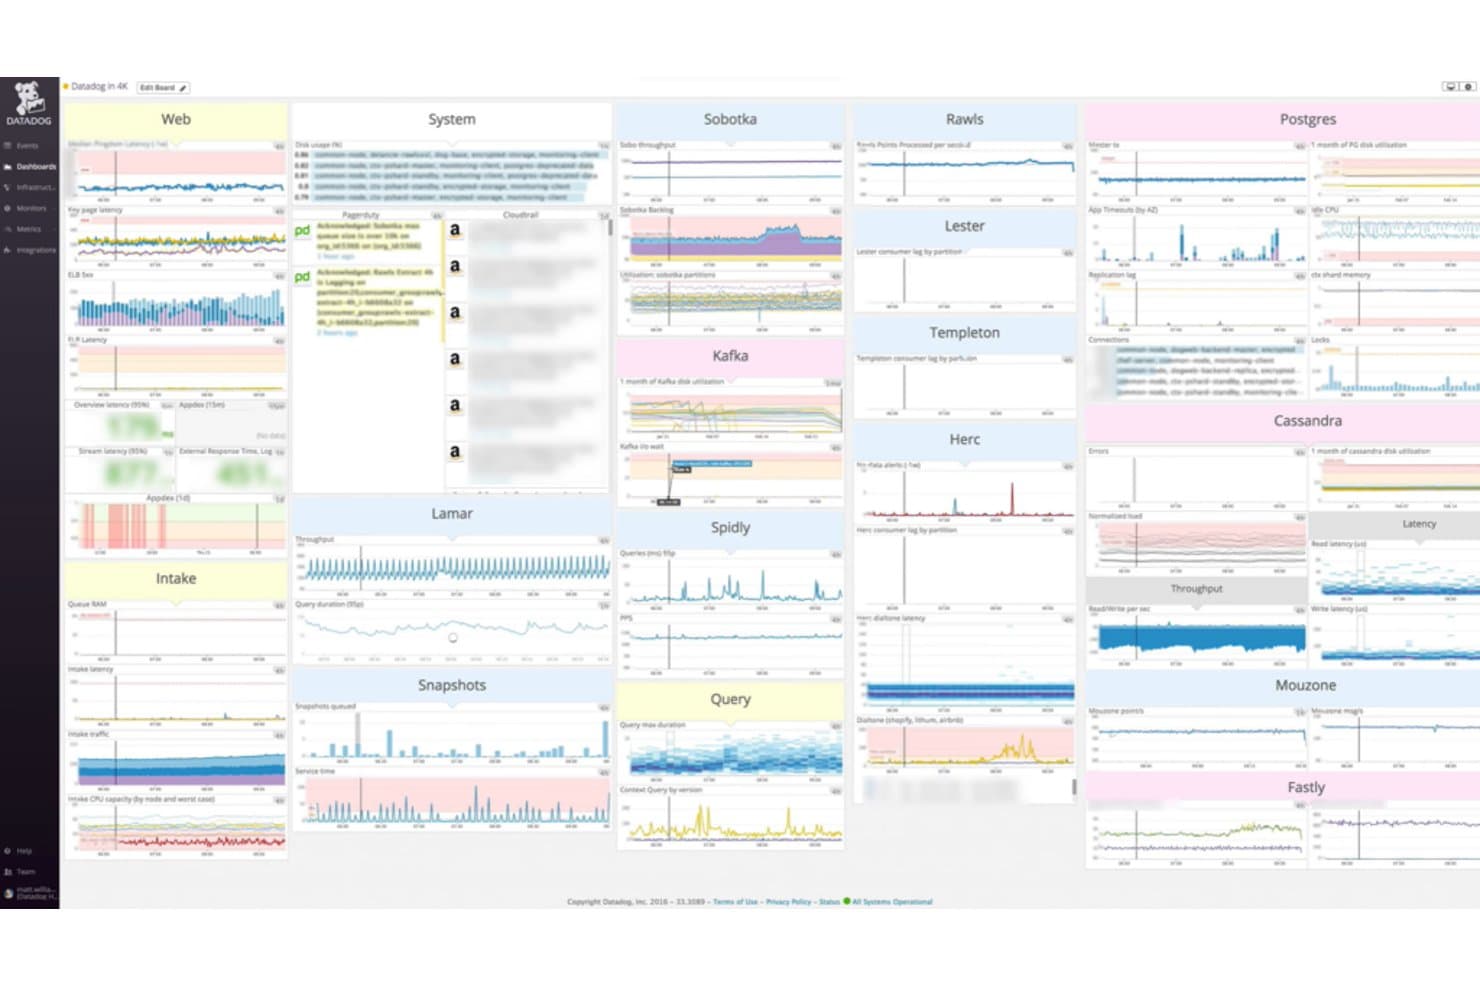
Datadog centralise les métriques des services web, système et de base de données dans un seul tableau de bord. Datadog est une plateforme d’observabilité destinée aux équipes informatiques et d’ingénierie qui doivent examiner les problèmes des applications, retracer les dépendances entre services et surveiller l’infrastructure dans des environnements complexes.
À qui Datadog convient-il le mieux ?
Datadog convient aux équipes des opérations informatiques, de l’ingénierie des plateformes et de SRE qui doivent surveiller des infrastructures et des applications distribuées.
Pourquoi j’ai choisi Datadog
J’ai choisi Datadog parce qu’il est le meilleur choix pour une surveillance unifiée des serveurs, des applications et des services. Ses métriques d’infrastructure, ses traces APM et ses cartes de services m’aident à suivre une requête lente depuis un hôte jusqu’aux services dont elle dépend, ce qui en fait une alternative utile à Honeycomb pour les investigations d’incidents sur plusieurs couches.
Principales fonctionnalités de Datadog
- Gestion des journaux : rechercher, filtrer et analyser les journaux provenant des applications et de l’infrastructure.
- Surveillance synthétique : exécuter des tests de navigateur et d’API pour vérifier la disponibilité et les temps de réponse.
- Moniteurs : définir des conditions qui déclenchent des alertes lorsque les données surveillées atteignent un seuil.
- Tableaux de bord : créer des affichages visuels avec des graphiques et des widgets pour les données sélectionnées.
Intégrations Datadog
Datadog propose plus de 1 000 intégrations intégrées, notamment avec AWS, Azure, Google Cloud, Kubernetes, Docker, Jenkins, Slack, Jira, GitHub et PagerDuty. Il fournit également une API pour les intégrations personnalisées.
Pros and Cons
Pros:
- Met en corrélation les journaux, les métriques et les traces pendant le triage
- Les cartes de services relient les hôtes aux services dont ils dépendent
- Les tableaux de bord réunissent les signaux de l’infrastructure et des applications
Cons:
- Le réglage des alertes peut générer des notifications trop nombreuses
- La gestion d’OpenTelemetry peut être incohérente
 Idéal pour la surveillance à code source ouvert d’infrastructures à grande échelle
- Forfait gratuit disponible
- Tarification sur demande
Visit WebsiteCustomer Rating:4.4/5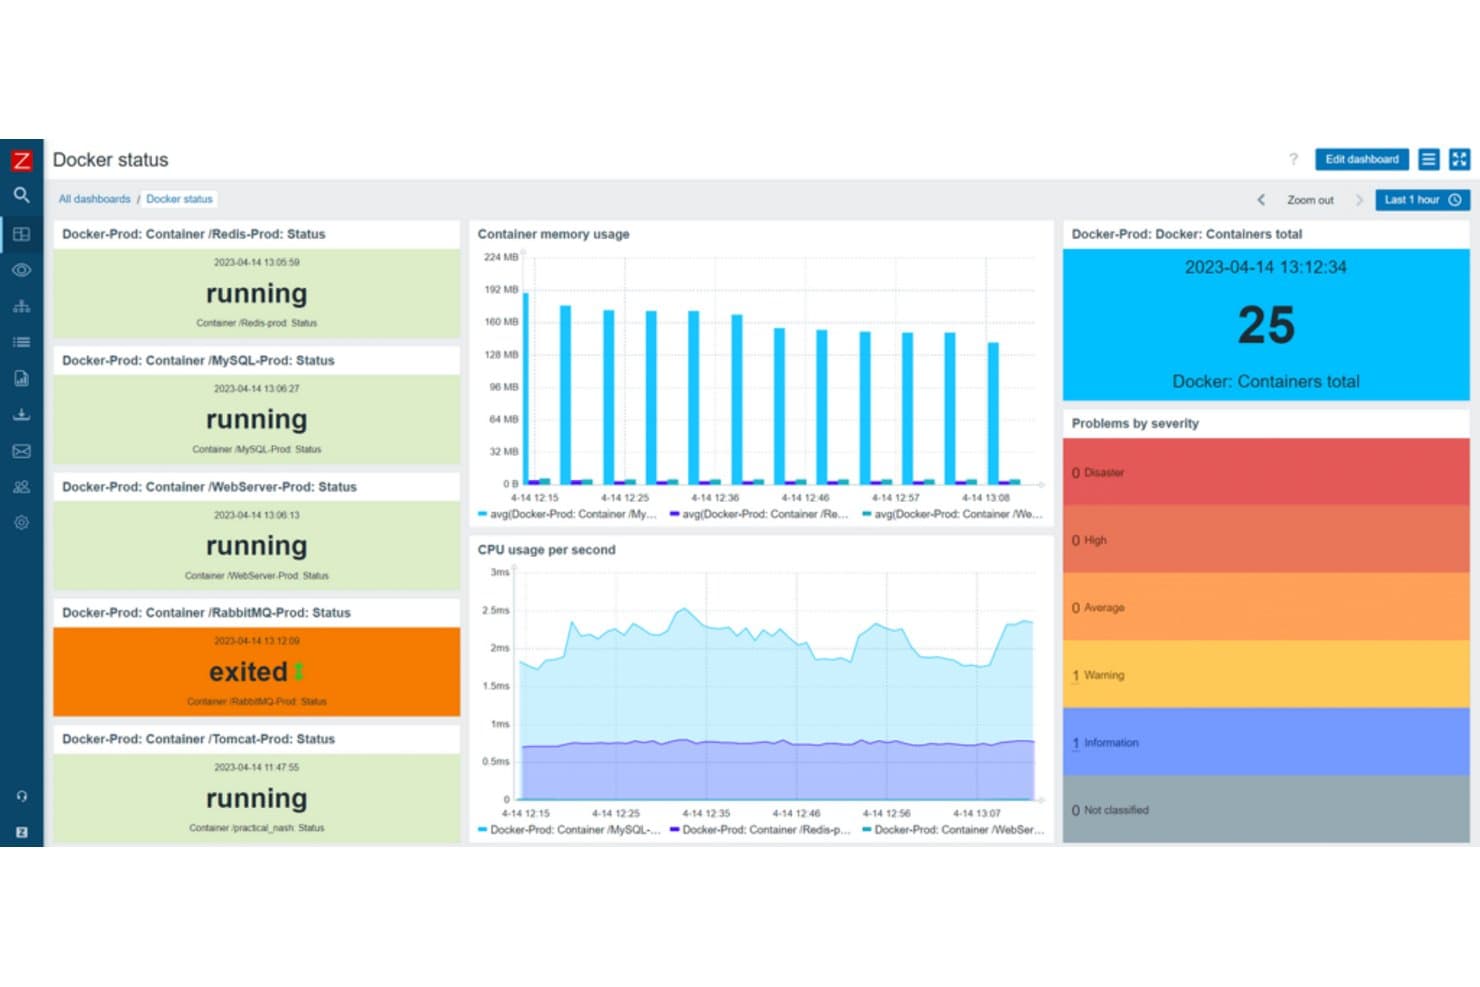
Zabbix surveille en temps réel l’état et l’utilisation des ressources des conteneurs Docker. Zabbix est une plateforme de surveillance de l’infrastructure destinée aux équipes informatiques qui doivent suivre les appareils réseau, les serveurs, les applications et les services, et détecter les pannes ou les problèmes de performances dans des environnements complexes.
À qui Zabbix convient-il le mieux ?
Zabbix convient aux équipes informatiques et d’infrastructure des grandes entreprises qui ont besoin d’une surveillance à code source ouvert sur de vastes réseaux et systèmes interconnectés.
Pourquoi j’ai choisi Zabbix
J’ai choisi Zabbix comme « Meilleur outil de surveillance réseau à code source ouvert au niveau de l’entreprise » lorsque la visibilité sur l’infrastructure est plus importante que le traçage distribué. La découverte du réseau et la surveillance SNMP permettent de localiser les commutateurs et les routeurs, tandis que les modèles et les déclencheurs standardisent les vérifications et alertent en cas de défaillance d’une interface ou d’un service. Cela en fait une alternative utile à Honeycomb pour suivre l’état de l’infrastructure dans un environnement de grande taille.
Principales fonctionnalités de Zabbix
- Surveillance du Web : Configurez des scénarios pour vérifier la disponibilité d’un site Web, le temps de réponse et le contenu des pages.
- Surveillance des journaux : Collectez les entrées des journaux et détectez les schémas correspondants ou les erreurs.
- Surveillance des services : Cartographiez les services métier et suivez leur état par rapport aux objectifs de niveau de service.
- Tableaux de bord : Organisez les widgets pour afficher les données de surveillance, les problèmes et l’état des services.
Intégrations de Zabbix
Le catalogue d’intégrations de Zabbix répertorie 559 marques et 1 986 solutions, notamment AWS, Azure, Kubernetes, PagerDuty, Slack, Microsoft Teams, ServiceNow et Jira. Il prend en charge les connexions personnalisées via son API et des notifications HTTP configurables ; les éléments du catalogue ne sont pas nécessairement des intégrations natives.
Pros and Cons
Pros:
- La découverte automatique détecte les appareils réseau SNMP
- Les modèles standardisent les vérifications de l’état de l’infrastructure
- Les proxys étendent la surveillance aux sites distants
Cons:
- Aucun flux natif de débogage des traces distribuées
- La configuration complexe et le réglage des alertes nécessitent une expertise
 Idéal pour le suivi de bout en bout des transactions métier
- Essai gratuit de 30 jours
- $3300 par unité et par an (facturé annuellement)
Visit WebsiteCustomer Rating:4.3/5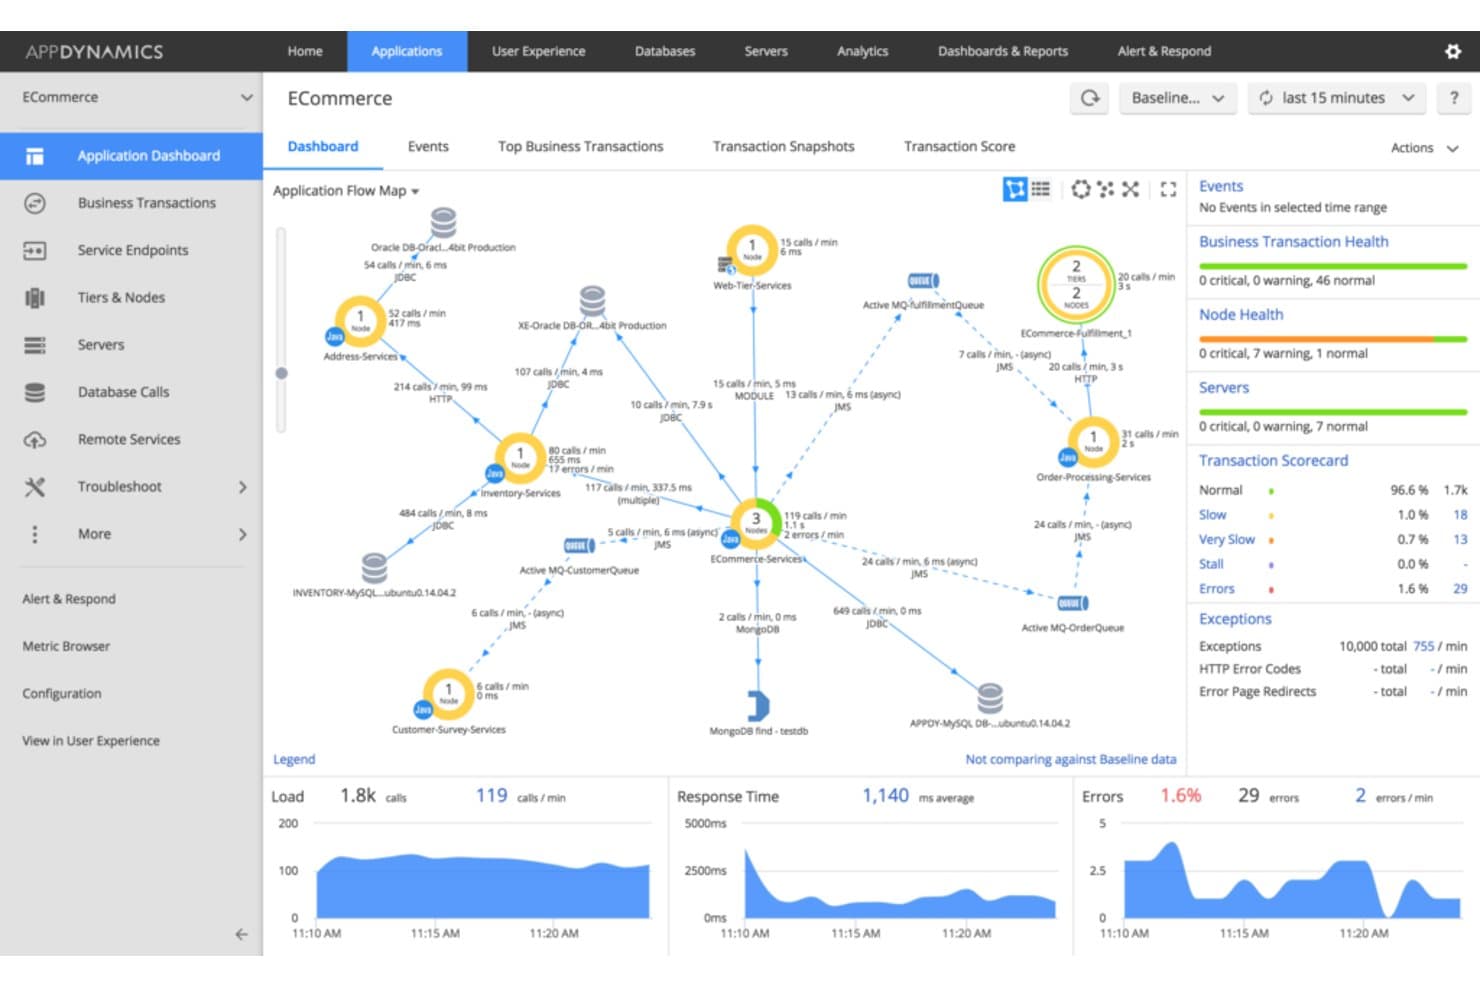
AppDynamics visualise en temps réel les dépendances entre les services applicatifs et leurs performances. AppDynamics est une plateforme d’observabilité destinée aux équipes informatiques et applicatives qui gèrent des systèmes complexes. Elle les aide à identifier précisément les problèmes de performance et à établir le lien entre les problèmes d’infrastructure, la fiabilité des applications et l’expérience utilisateur.
À qui AppDynamics convient-il le mieux ?
AppDynamics convient aux équipes chargées des performances et des opérations applicatives qui gèrent des applications distribuées à plusieurs niveaux dans des environnements complexes.
Pourquoi j’ai choisi AppDynamics
J’ai choisi AppDynamics pour le suivi de bout en bout des transactions métier dans des environnements complexes. Ses cartes de flux des transactions montrent comment les requêtes circulent entre les différents niveaux de l’application, tandis que les instantanés de transactions capturent les détails au niveau du code lorsqu’une requête ralentit ou échoue. J’utilise cette vue pour retracer le retard lors d’un paiement, depuis le service visible par l’utilisateur jusqu’au niveau dorsal qui en est à l’origine.
Principales fonctionnalités d’AppDynamics
- Surveillance de l’infrastructure : met en corrélation les métriques de l’infrastructure avec les services applicatifs et les indicateurs métier.
- Surveillance de l’expérience numérique : suit les utilisateurs web et mobiles et exécute des contrôles synthétiques sur les navigateurs, les API et les services tiers.
- Sécurité des applications à l’exécution : détecte les vulnérabilités et bloque les attaques.
- Surveillance SAP : surveille les systèmes SAP hybrides et sur site, avec un suivi jusqu’au code ABAP ou aux requêtes de base de données.
Intégrations d’AppDynamics
AppDynamics prend en charge les intégrations d’alertes avec PagerDuty, Slack, ServiceNow via Service Graph Connector, Jira, BigPanda, Moogsoft et Splunk ITSI ; l’intégration PagerDuty est développée par le fournisseur, tandis que celle de Slack est développée par la communauté. AppDynamics fournit également des API REST et des extensions préconfigurées pour les intégrations personnalisées.
Pros and Cons
Pros:
- Cartographie les transactions métier entre les différents niveaux de l’application
- Les instantanés révèlent les méthodes lentes et les lignes de code concernées
- Relie l’état des transactions aux résultats métier
Cons:
- L’effort de configuration augmente avec les hiérarchies d’applications personnalisées
- Les requêtes personnalisées nécessitent l’apprentissage du langage de requête d’AppDynamics
Learn more about AppDynamics: Idéal pour les analyses de performance des applications et le suivi de l’expérience utilisateur finale
- Essai gratuit + démonstration gratuite disponible
- 99 $/mois pour le forfait Pro (facturé annuellement)
Visit WebsiteCustomer Rating:4.3/5
Tableau de bord d’aperçu SQL de New Relic. New Relic se spécialise dans la fourniture d'analyses approfondies sur les performances des applications et le suivi de l'expérience utilisateur. Cet outil excelle à aider les équipes à comprendre les interactions des utilisateurs et le comportement de l'application de manière détaillée et granulaire.
Pros and Cons
Pros:
- Surveillance détaillée des performances applicatives et du parcours utilisateur
- Large intégration avec les principaux fournisseurs cloud et plateformes
- Fonctionnalités AIOps pour des alertes prédictives et la gestion des incidents
Cons:
- Tarification plus élevée par rapport à certains concurrents
- Peut être complexe à mettre en place et à configurer
- La grande variété de fonctionnalités peut être déroutante pour les nouveaux utilisateurs
Learn more about New Relic: Idéal pour la gestion et l’analyse des journaux dans les environnements cloud natifs
- Essai gratuit de 14 jours
- Tarification sur demande
Visit WebsiteCustomer Rating:4.3/5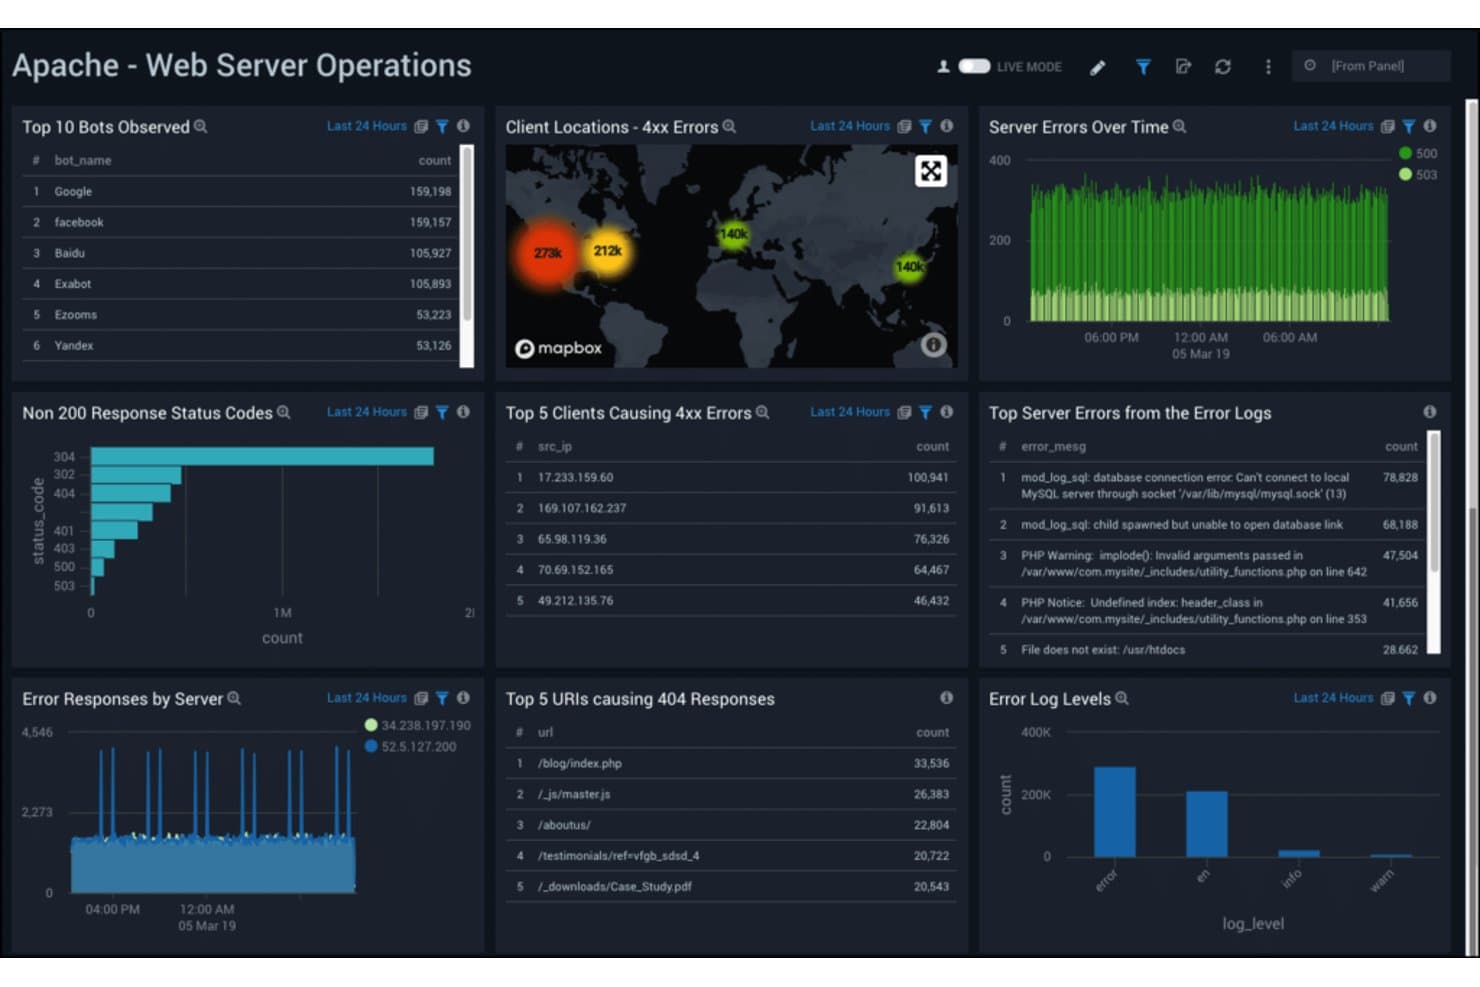
Les moniteurs de Sumo Logic surveillent en temps réel les erreurs du serveur web Apache et l’activité des robots. Sumo Logic fournit aux équipes informatiques et DevOps une plateforme d’observabilité pour enquêter sur les pannes, relier les problèmes entre les services distribués et gagner en visibilité sur les environnements cloud complexes.
À qui Sumo Logic convient-il le mieux ?
Les équipes chargées de l’infrastructure et de la sécurité au sein d’organisations natives du cloud peuvent utiliser Sumo Logic pour analyser les journaux de différents services distribués.
Pourquoi j’ai choisi Sumo Logic
J’ai choisi Sumo Logic comme alternative à Honeycomb, car il est idéal pour la gestion et l’analyse des journaux dans les environnements cloud natifs. LogReduce regroupe les messages de journal similaires pour m’aider à repérer les erreurs récurrentes, tandis que son langage de requête me permet d’enquêter sur un incident à travers des services distribués.
Fonctionnalités clés de Sumo Logic
- Analyse des métriques : ingérez et interrogez des métriques de séries temporelles parallèlement aux données de télémétrie opérationnelle.
- Traçage distribué : suivez les requêtes entre les services pour examiner les étendues et les détails des traces.
- Tableaux de bord : créez des tableaux de bord visuels avec des graphiques et des panneaux pour les données opérationnelles.
- Moniteurs et alertes : définissez des conditions sur les métriques ou les résultats de requêtes afin de déclencher des notifications.
Intégrations de Sumo Logic
Le catalogue de Sumo Logic couvre des centaines de fournisseurs et de produits, avec des applications, des collecteurs, du contenu Cloud SIEM et des intégrations d’automatisation pour des outils tels qu’AWS, Azure, Kubernetes, Datadog, GitHub, GitLab et Atlassian Jira. Il fournit également des API pour les intégrations personnalisées.
Pros and Cons
Pros:
- LogReduce regroupe rapidement les erreurs similaires
- La recherche analyse les données JSON et les expressions régulières
- Les journaux, les métriques et les traces partagent les enquêtes
Cons:
- La syntaxe des requêtes Sumo demande un temps d’apprentissage
- Les recherches historiques peuvent ralentir à grande échelle
 Idéal pour la surveillance et la génération d’alertes fondées sur le volume des journaux
- Essai gratuit de 30 jours
- Tarifs sur demande
Visit WebsiteCustomer Rating:4.4/5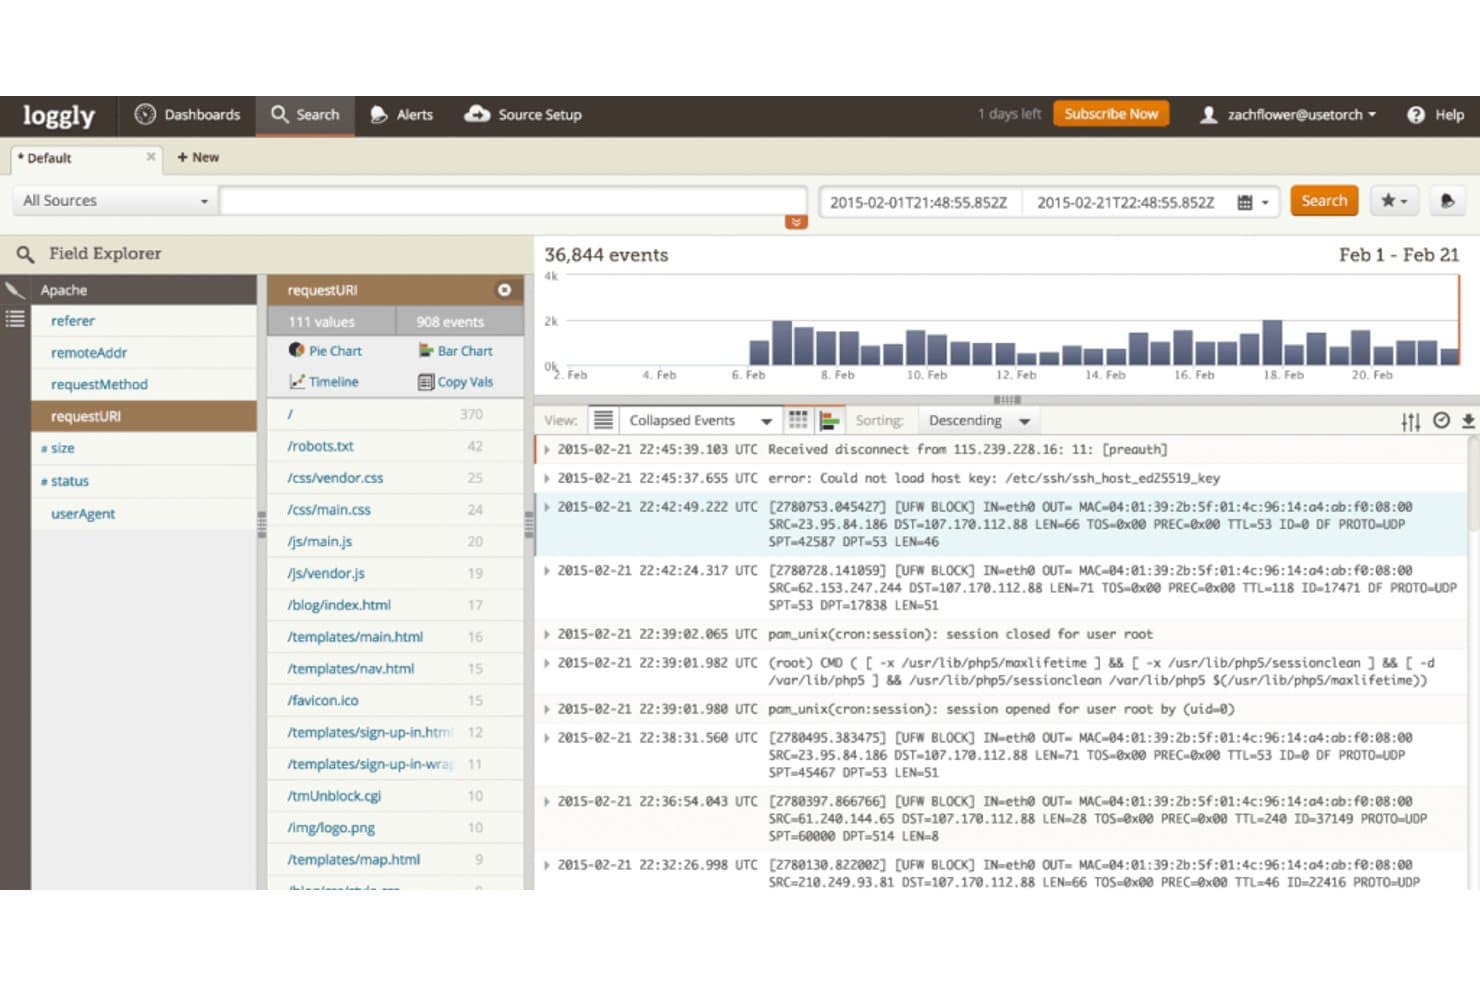
Loggly centralise les événements de journaux pour permettre la recherche et l’analyse en temps réel. Loggly est une plateforme de gestion des journaux basée sur le cloud destinée aux équipes informatiques et DevOps qui doivent enquêter sur les problèmes liés aux applications et à l’infrastructure, suivre les événements entre les services et diagnostiquer les interruptions de service.
À qui Loggly convient-il le mieux ?
Loggly convient aux équipes informatiques et DevOps qui doivent rechercher et visualiser les données de journaux dans des environnements cloud en expansion.
Pourquoi j’ai choisi Loggly
J’ai choisi Loggly comme alternative à Honeycomb, car il est idéal pour la gestion évolutive des journaux cloud et la visualisation interactive des données. Ses graphiques et tableaux de bord m’aident à repérer les tendances dans les journaux des applications et de l’infrastructure. J’apprécie également ses outils de dépannage, qui aident à remonter jusqu’aux causes profondes des problèmes entre des services interconnectés.
Fonctionnalités principales de Loggly
- Flux en direct : Diffuse les événements de journaux entrants provenant de plusieurs sources en quasi-temps réel.
- Alertes fondées sur les recherches : Définissez des conditions dans les recherches et envoyez des notifications par e-mail ou vers des points de terminaison pris en charge.
- Intégrations avec les outils d’équipe : Connectez Loggly à Slack, GitHub, Jira, PagerDuty, Microsoft Teams et aux webhooks.
- Prise en charge des sources de journaux : Collectez les journaux provenant de sources telles qu’AWS, syslog, PHP, les appareils réseau et les systèmes Windows.
Intégrations de Loggly
Loggly répertorie des intégrations avec Slack, GitHub, Jira, PagerDuty et Microsoft Teams. La diffusion des alertes est également possible via des webhooks personnalisés. Une API est fournie pour les intégrations personnalisées.
Pros and Cons
Pros:
- La recherche centralisée dans les journaux interservices et les tableaux de bord facilitent l’analyse
- Le flux en direct diffuse les événements provenant de plusieurs sources
- Les graphiques interactifs révèlent les tendances des journaux
Cons:
- Le déploiement uniquement en SaaS ne répond pas aux exigences sur site
- Les délais de propagation des journaux peuvent compliquer le triage des incidents
Learn more about Loggly: Idéal pour les renseignements opérationnels fondés sur les données machine
- Essai gratuit de 60 jours
- $150/mois (facturé annuellement)
Visit WebsiteCustomer Rating:4.3/5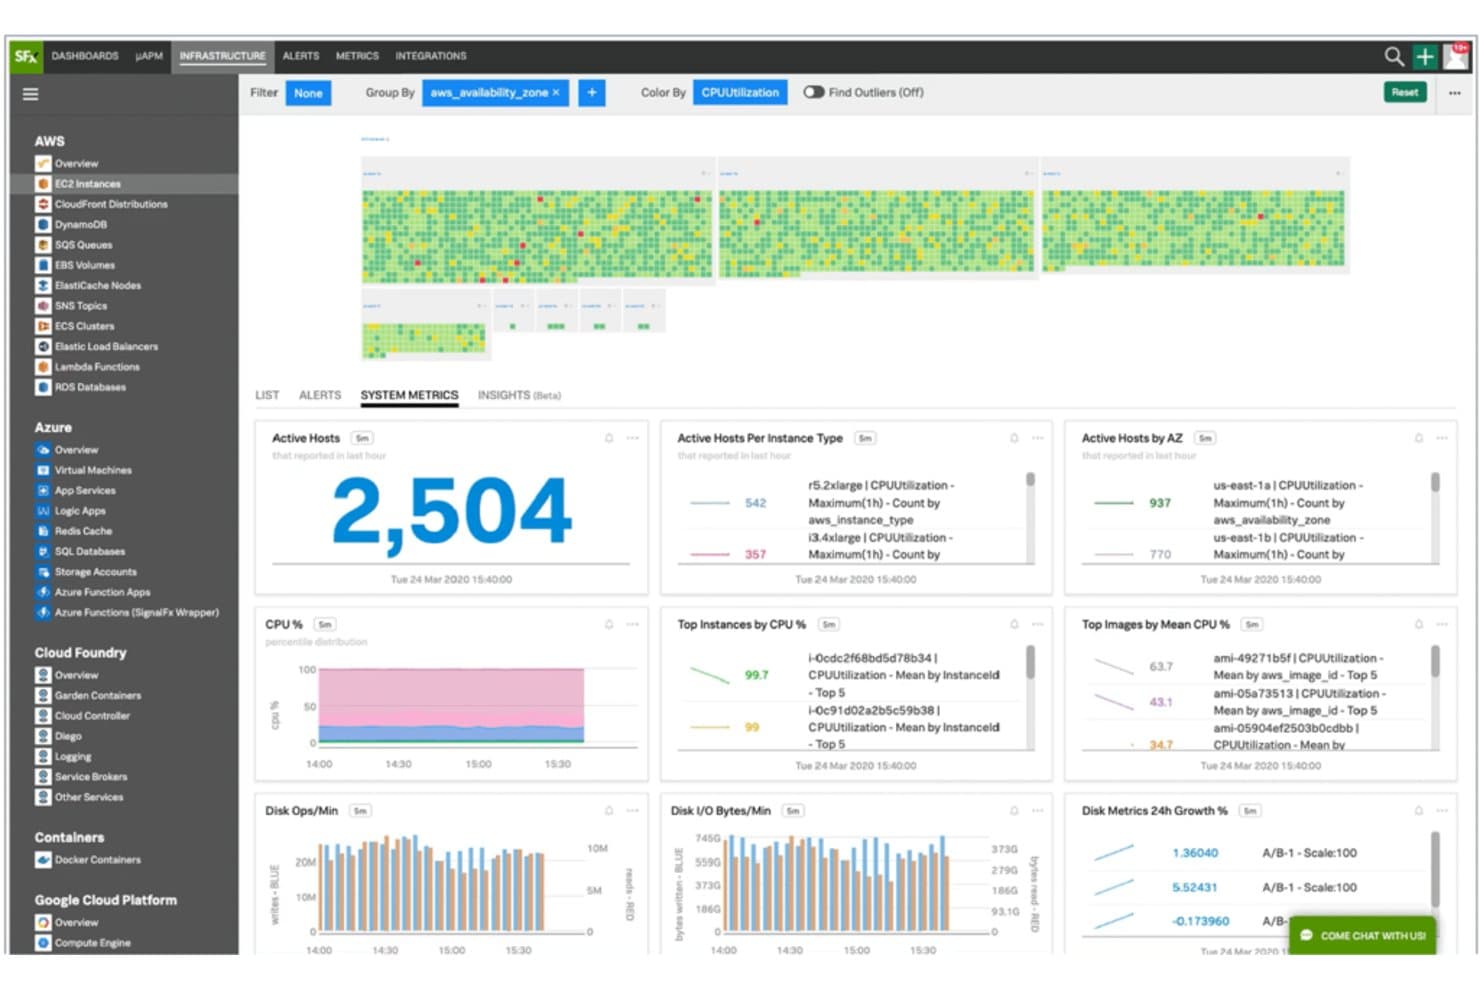
Splunk surveille en temps réel les métriques d’AWS, d’Azure et de l’infrastructure cloud. Splunk est une plateforme d’observabilité destinée aux équipes informatiques et de sécurité qui doivent analyser les données machine dans des environnements complexes, identifier les problèmes de service et résoudre les incidents.
À qui Splunk convient-il le mieux ?
Les équipes chargées des opérations informatiques qui supervisent une infrastructure distribuée peuvent utiliser Splunk pour transformer les données machine en renseignements opérationnels exploitables.
Pourquoi j’ai choisi Splunk
J’ai choisi Splunk comme alternative à Honeycomb dans la catégorie « Meilleur outil pour exploiter les données machine afin d’obtenir des renseignements opérationnels approfondis ». J’utilise des requêtes SPL pour analyser les journaux de services distribués, puis je relie les résultats dans des tableaux de bord afin de suivre les problèmes, comme l’augmentation des erreurs après un déploiement. Cette vue plus large des données machine m’aide à examiner les problèmes opérationnels parallèlement aux événements associés liés à l’infrastructure et à la sécurité.
Fonctionnalités clés de Splunk
- Traçage distribué : suivez les requêtes entre les services grâce aux segments de trace et aux cartes des services.
- Supervision de l’infrastructure : suivez les métriques provenant des hôtes, des conteneurs et des environnements Kubernetes.
- Supervision des utilisateurs réels : capturez les performances des navigateurs et les interactions des utilisateurs.
- Supervision synthétique : exécutez des tests scriptés pour vérifier la disponibilité des services et les temps de réponse.
Intégrations de Splunk
Splunk Observability Cloud propose des centaines d’intégrations préconfigurées, notamment avec AWS, Microsoft Azure, Google Cloud, Kubernetes, Prometheus, Jira, Microsoft Teams, PagerDuty, ServiceNow et Slack. Splunkbase propose plus de 1 000 applications et extensions de place de marché, et Splunk fournit des API pour les intégrations personnalisées.
Pros and Cons
Pros:
- Met en corrélation les journaux, les métriques et les traces
- Analyse les traces sans échantillonnage
- Les tableaux de bord personnalisés accélèrent le dépannage
Cons:
- Les requêtes lourdes peuvent s’exécuter lentement
- Les coûts augmentent avec des volumes de données plus importants
Learn more about Splunk: Idéal pour les métriques et les alertes natives de Kubernetes
- Formule gratuite disponible
- Tarification sur demande
Visit WebsiteCustomer Rating:4.4/5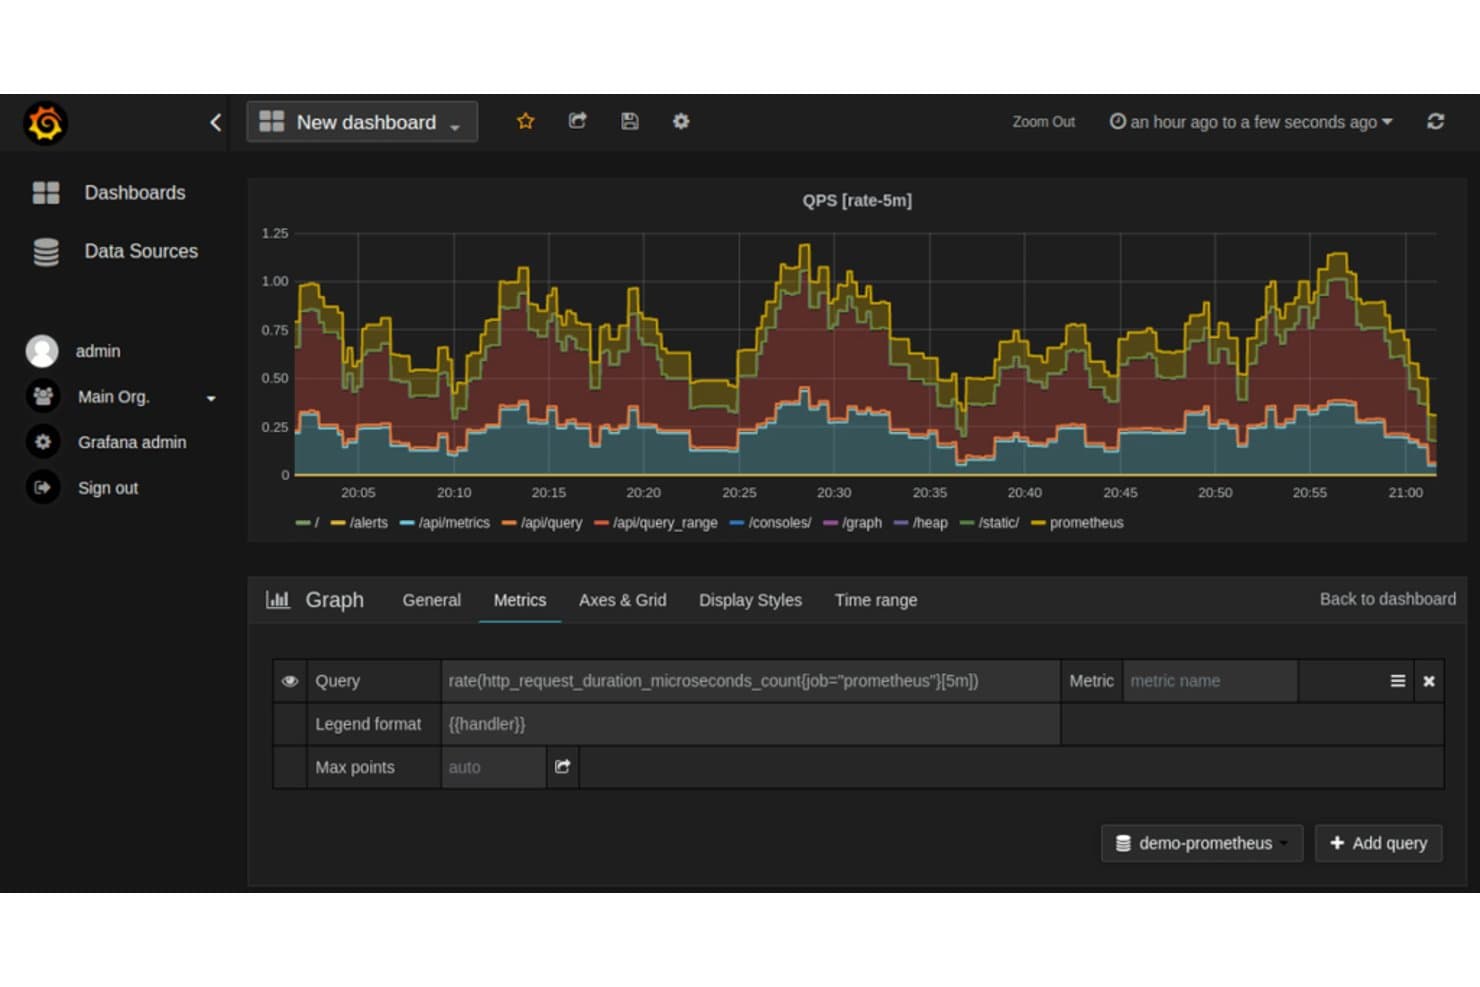
Prometheus visualise les taux de requêtes HTTP sur les points de terminaison d’API dans Grafana. Prometheus est une plateforme de supervision open source destinée aux équipes chargées des infrastructures et des applications qui doivent suivre l’état des systèmes, analyser les problèmes de performances et intégrer l’observabilité à leurs services.
À qui Prometheus convient-il le mieux ?
Prometheus convient aux équipes DevOps et de fiabilité des sites qui doivent collecter des métriques et définir des alertes pour les charges de travail Kubernetes.
Pourquoi ai-je choisi Prometheus ?
J’ai choisi Prometheus pour la collecte des métriques et la gestion des alertes, en particulier dans un environnement Kubernetes. Sa découverte de services peut suivre l’évolution des charges de travail, tandis que PromQL m’aide à analyser les tendances des métriques et à définir les conditions d’alerte. J’utilise Alertmanager pour acheminer ces alertes lorsque l’état d’un service se dégrade.
Principales fonctionnalités de Prometheus
- Base de données de séries temporelles : Stocke des échantillons horodatés dans une base de données locale.
- Modèle de données multidimensionnel : Organise les séries temporelles à l’aide de noms de métriques et d’étiquettes clé-valeur.
- Écosystème d’exportateurs : Les exportateurs exposent les métriques de systèmes tels que les bases de données et le matériel.
- Fédération : Collecte des métriques sélectionnées depuis d’autres serveurs Prometheus à des fins d’agrégation.
Intégrations de Prometheus
Prometheus inclut la découverte de services Kubernetes et prend en charge les intégrations fondées sur des exportateurs avec Kafka, MySQL, PostgreSQL, Redis, Jenkins et AWS CloudWatch. Les connexions de lecture/écriture distantes incluent Grafana Mimir, Thanos, Google Cloud et New Relic, tandis que son API HTTP prend en charge les intégrations personnalisées.
Pros and Cons
Pros:
- PromQL prend en charge l’analyse des métriques fondée sur les étiquettes
- La découverte de services Kubernetes suit l’évolution des charges de travail
- Alertmanager achemine les alertes de métriques selon les étiquettes
Cons:
- Les étiquettes à forte cardinalité peuvent mettre à rude épreuve le stockage local
- Le stockage local limite la conservation et la mise à l’échelle horizontale
Learn more about Prometheus:
Autres alternatives à Honeycomb
Voici quelques alternatives supplémentaires à Honeycomb qui ne figurent pas dans ma sélection, mais qui méritent tout de même votre attention :
- 11Grafana CloudIdéal pour la visualisation interactive, permettant des décisions basées sur les données
- 12Elastic (ELK Stack)Idéal pour l’analyse des journaux, la recherche et des capacités avancées de corrélation de données
- 13WrikeIdéal pour la gestion de projet au sein des équipes logicielles
Autres avis sur les logiciels
- Outils de développement logiciel
- Outils d'infrastructure sous forme de code
- Outils DataOps
- Outils de surveillance des bases de données
Comment j'évalue les alternatives à Honeycomb
J'examine chaque candidat sur deux plans : les exigences de base—traçage distribué, interrogation à forte cardinalité et support OTel—et les différenciateurs qui séparent les outils lorsque les SRE résolvent des incidents en production.
Fonctionnalités principales (Critères indispensables pour cette liste)
Lorsque je sélectionne des outils pour ma liste, je classe chacun sur une échelle de 0 (ne propose pas la fonctionnalité) à 5 (excelle dans ce domaine) pour chaque fonctionnalité clé listée ci-dessous. Ensuite, je calcule le score total de l'outil en pourcentage. Chaque outil doit atteindre un score total minimum de 65 % pour être pris en considération.
- Traçage distribué : J'évalue la capacité de chaque outil à visualiser les cascades de traces entre services, car diagnostiquer un parcours d'achat lent couvrant 15 microservices exige des détails approfondis sur les intervalles.
- Interrogation à forte cardinalité : Filtrer la télémétrie par identifiant utilisateur ou instance de conteneur à grande échelle est crucial, donc je vérifie si les performances de requête tiennent la route face à des millions de valeurs uniques.
- Support unifié de la télémétrie : Je recherche des outils capables de corréler logs, métriques et traces dans une seule vue—passer d'un pic de latence au log d'erreur correspondant doit se faire en un clic.
- Compatibilité OpenTelemetry : J'évalue ici l'ingestion native OTel sur traces, métriques et logs, car les équipes ne devraient pas avoir besoin d'agents propriétaires pour envoyer leurs données.
- Alertes temps réel & SLOs : Une bonne observabilité comprend des alertes d'épuisement SLO et des budgets d'erreur, alors je vérifie si chaque outil offre plus que de simples notifications sur des seuils statiques.
- Workflows de débogage interactif : Je privilégie les interfaces de requêtes exploratoires—comme la détection d'anomalies ou des regroupements par catégorie—qui aident les ingénieurs à diagnostiquer des problèmes inconnus lors d'un incident.
Une fois que j'ai une liste d'outils répondant à ces critères, j'examine ce qui distingue chaque plateforme.
Facteurs différenciants (Ce qui distingue les fournisseurs)
Voici comment je compare et oppose les différents éditeurs :
Fonctionnalités phares
Les outils d'investigation assistés par IA peuvent faire gagner des heures lors d'un incident en détectant automatiquement la cause racine avant même qu'un ingénieur n'écrive une requête. J'évalue également si une plateforme propose du profilage continu—relier les points chauds de CPU ou mémoire directement à une trace aide à identifier les goulets d'étranglement au niveau du code que les données de niveau intervalle seules pourraient manquer. Les workflows collaboratifs pour les requêtes comptent aussi, en particulier pour les équipes menant des post-mortems sans blâme. Les sentiers d'enquête partagés et les tableaux annotés permettent à l'ingénieur d'astreinte de transmettre le contexte au prochain sans rien perdre.
Au-delà des fonctionnalités
Le modèle tarifaire est l'un des premiers aspects que je regarde. Une plateforme qui facture par hôte fonctionne très différemment à grande échelle par rapport à une facturation au GB ingéré, et un pic de trafic lors d'un lancement produit ne devrait pas exploser votre budget d'observabilité. J'évalue aussi la rapidité avec laquelle une équipe peut en tirer un bénéfice—les outils dotés d'une forte auto-instrumentation et de guides de migration OTel clairs réduisent considérablement le temps d'intégration. Les intégrations avec l'écosystème complètent le tableau. Se connecter à PagerDuty, Slack et à votre pipeline CI/CD permet que les alertes parviennent aux bonnes personnes et que les marqueurs de déploiement s'affichent automatiquement sur vos tableaux de bord.
Pourquoi chercher une alternative à Honeycomb ?
Honeycomb est un outil d'observabilité de pointe conçu pour aider les ingénieurs logiciels à comprendre, déboguer et améliorer leurs logiciels en production. Il excelle dans la fourniture d'informations au niveau du système, facilitant la découverte des tendances et des anomalies, et permettant ainsi d'optimiser les performances.
Malgré ses fonctionnalités puissantes, les utilisateurs peuvent rechercher des alternatives pour diverses raisons. Il peut s'agir de contraintes budgétaires, car le prix de Honeycomb peut dépasser les moyens de certaines petites équipes, ou d'exigences fonctionnelles spécifiques auxquelles Honeycomb ne répond pas, comme un logiciel traditionnel de gestion des journaux ou une surveillance approfondie des performances des applications.
Enfin, certains utilisateurs peuvent simplement préférer une alternative open source ou une solution dotée d’une interface utilisateur différente. La recherche de l’alternative parfaite à Honeycomb consiste à trouver un outil qui établit un équilibre entre des fonctionnalités complètes et une expérience utilisateur fluide, tout en répondant aux besoins et aux ressources spécifiques de l’organisation.
Fonctionnalités clés de Honeycomb
Voici quelques-unes des fonctionnalités clés de Honeycomb, pour vous aider à mettre en contraste et à comparer les offres des solutions alternatives :
- Télémétrie basée sur les événements : Capture des données détaillées sur les événements afin que votre équipe puisse voir exactement ce qui s’est passé dans vos systèmes à tout moment.
- Générateur de requêtes : Vous permet de poser des questions complexes sur vos données sans avoir besoin d’écrire du code.
- BubbleUp : Met automatiquement en évidence les valeurs aberrantes dans vos données, afin que vous puissiez repérer les problèmes plus rapidement.
- Prise en charge du traçage : Relie les traces aux journaux et aux métriques afin que vous puissiez comprendre comment une seule requête circule dans votre pile technique.
- Tableaux et vues : Vous aide à enregistrer, organiser et partager les requêtes ou visualisations clés que votre équipe utilise fréquemment.
- Carte des services : Affiche les interactions entre vos services, ce qui est utile pour comprendre les dépendances et l’état du système.
- Suivi des SLO : Vous permet de définir et de surveiller les objectifs de niveau de service afin de rester au fait de vos objectifs de performance.
- Outils de collaboration d’équipe : Vous permettent de commenter les requêtes, de partager des liens et de travailler ensemble sur les investigations.
- Moteur de requêtes rapide : Répond rapidement avec de grands ensembles de données, ce qui est utile lorsque vous déboguez des problèmes en direct.
- Intégrations avec des outils tels qu’OpenTelemetry : Simplifient l’importation de données depuis votre configuration existante.