

Flux ETL : guide de conception & bonnes pratiques

En moyenne, les organisations traitent régulièrement 400 sources de données. Avec littéralement des centaines d’ensembles de données à gérer, l’intégration des données et leur analyse précise peuvent être impossibles sans les bons flux de travail.
Dans ce guide, je vais vous présenter les flux de travail ETL et vous donner des conseils pour créer des pipelines de données ETL qui favorisent des fonctionnalités améliorées et une meilleure qualité des données.
Que sont les flux de travail ETL ?
Notre guide ultime de l’ETL explique les spécificités du processus ETL, notamment les processus d’extraction, de transformation et de chargement. Pour garantir un fonctionnement optimal, ces processus doivent fonctionner ensemble afin que les informations circulent efficacement de la source de données vers l’entrepôt de données.

Les flux de travail ETL sont responsables de l’ensemble de ce processus. Ils impliquent généralement divers outils de gestion des API, des connecteurs et des étapes de traitement des données afin de garantir le bon fonctionnement du processus d’extraction, de transformation et de chargement et de répondre aux besoins de l’organisation.
Avantages des flux de travail ETL
Parmi les avantages des flux de travail ETL performants figurent :
- Accès amélioré aux données. Grâce aux processus ETL appropriés, vous pouvez permettre aux employés d’accéder aux données en temps réel. Le processus d’extraction, de transformation et de chargement garantit que les données sont prêtes à être utilisées dès leur arrivée dans le stockage de données, ce qui facilite l’exécution de rapports SQL, de modèles de données et d’autres requêtes.
- Capacité à gérer les mégadonnées. Les processus ETL avancés peuvent traiter de grands ensembles de données et intégrer des données non structurées sans recourir à des processus manuels chronophages. Les organisations peuvent ainsi gérer plus facilement les mégadonnées et en tirer parti.
- Meilleurs processus de transformation des données. Le flux de travail ETL approprié intègre des éléments tels que le nettoyage et la transformation des données afin d’améliorer la conversion des données brutes en ensembles de données structurés que vous pouvez utiliser.
- Gain d’efficacité grâce à l’automatisation. L’importation des données sources, l’exécution des processus de validation et d’autres tâches peuvent être prises en charge par des outils ETL qui favorisent l’automatisation, réduisant ainsi le temps nécessaire à la gestion des données.
- Possibilité d’appliquer des règles métier aux processus de gestion des données. Vous pouvez personnaliser les solutions ETL pour répondre à divers besoins organisationnels, notamment en intégrant les règles métier et de conformité au flux de travail d’extraction, de transformation et de chargement.
Présentation du processus ETL
Avant d’aborder les composants clés des flux de travail ETL et la manière de les modéliser, examinons d’abord le fonctionnement de ces processus, notamment les objectifs et les difficultés de chaque étape.
Extraction
Lors de la phase d’extraction de l’ETL, les informations sont recueillies à partir d’une ou plusieurs sources de données. L’extraction des données peut porter sur des données brutes ainsi que sur des données déjà traitées, et vous pouvez être amené à gérer différents types de fichiers, notamment CSV et XML.
- Objectif : Capturer les données les plus exhaustives et complètes possibles.
- Difficultés : Identifier les lacs de données et les sources, obtenir un accès approprié aux données et planifier la collecte des données afin de garantir des processus à jour.
Transformation
Le processus de transformation des données consiste à convertir les données dans des formats compatibles avec les bases de données relationnelles et les autres méthodes de stockage et d’analyse des données que vous souhaitez utiliser. Lors de cette étape de l’ETL, vous pouvez envisager des outils pour effectuer la mise en correspondance des données et le nettoyage, la déduplication, le formatage, l’ajout de métadonnées ainsi que d’autres tâches, aussi bien au moyen de l’automatisation que de flux de travail manuels.
- Objectif : Obtenir des données propres et exploitables, formatées pour fonctionner dans votre système ou magasin de données cible.
- Difficultés : La qualité des données est une difficulté courante à laquelle les organisations sont confrontées lors de la transformation des données : plus la qualité est faible, plus le travail de transformation requis est important. Les autres difficultés comprennent les pertes de données potentielles, l’intégration de plusieurs types de données et la garantie de la sécurité tout au long du processus.
Chargement
Lors de l’étape finale des processus ETL, vous chargez les données dans l’entrepôt de données final, afin de les rendre disponibles pour que l’organisation puisse les utiliser selon ses besoins.
- Objectif : Garantir que des données sécurisées et propres sont prêtes à être utilisées pour l’analyse, par les systèmes CRM ou par d’autres logiciels d’entreprise.
- Difficultés : Garantir la qualité et la sécurité des données constitue également une difficulté à cette étape, et les organisations doivent mettre en place des processus de gouvernance des données pour définir qui peut accéder aux données et de quelle manière. Il peut également être important de permettre un accès aux données en temps réel — ou aussi proche du temps réel que possible —, mais le traitement par lots peut entraîner des délais dans le processus.
Composants clés des flux de travail ETL
La première étape de la création de flux de travail ETL consiste à prendre en compte les composants clés qui doivent y être inclus. Les cas d’utilisation de ces flux de travail varient, et vous devrez peut-être tenir compte des dépendances propres aux données et aux processus de votre organisation.
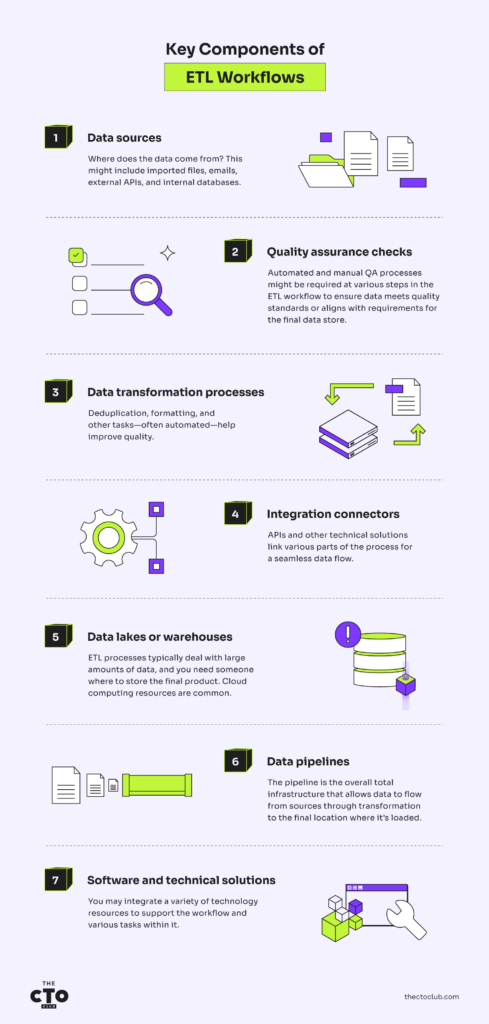
Cependant, certains composants que les ingénieurs des données prennent généralement en compte pour les flux de travail ETL comprennent :
- Sources de données. D’où proviennent les données ? Il peut s’agir de fichiers importés, d’e-mails, d’API externes et de bases de données internes.
- Contrôles d’assurance qualité. Des processus d’assurance qualité automatisés et manuels peuvent être nécessaires à différentes étapes du flux de travail ETL afin de garantir que les données respectent les normes de qualité ou correspondent aux exigences du magasin de données final.
- Processus de transformation des données. La déduplication, le formatage et d’autres tâches — souvent automatisées — contribuent à améliorer la qualité.
- Connecteurs d’intégration. Les API et autres solutions techniques relient les différentes parties du processus pour assurer un flux de données fluide.
- Lacs de données ou entrepôts de données. Les processus ETL traitent généralement de grandes quantités de données, et vous avez besoin d’un emplacement où stocker le produit final. Les ressources de cloud computing sont courantes.
- Pipelines de données. Le pipeline constitue l’ensemble de l’infrastructure qui permet aux données de circuler depuis les sources, à travers la transformation, jusqu’à l’emplacement final où elles sont chargées.
- Logiciels et solutions techniques. Vous pouvez intégrer diverses ressources technologiques pour prendre en charge le flux de travail et les différentes tâches qu’il comprend.
Modélisation des flux de travail ETL
Lors de la modélisation de vos pipelines ETL, vous devez déterminer si vous souhaitez traiter les données par lots ou en flux continu.
Créer un pipeline ETL avec un traitement par lots
Avec le traitement par lots, le flux de travail gère les données par lots ou par segments. Chaque lot est généralement prédéfini en fonction du temps : vous pouvez traiter les données quotidiennement, périodiquement au cours de la journée ou au début de chaque heure, par exemple.
Le traitement par lots constitue une bonne solution lorsque :
- Vous souhaitez tirer parti des économies d’échelle
- Vous disposez d’une automatisation capable de traiter rapidement de grandes quantités de données
- L’accès aux données et leur traitement ne sont pas particulièrement urgents
Créer un pipeline ETL avec un traitement en flux continu
Le traitement en flux continu permet aux données de circuler dans le processus ETL en temps réel, sans constituer de lots de données à une quelconque étape du processus. Il est plus flexible que le traitement par lots, mais il peut être plus difficile de garantir la qualité et la cohérence des données avec ce type de pipeline.
Le traitement en flux continu constitue une bonne solution lorsque :
- Les données entrent dans votre processus par petits segments et à des intervalles irréguliers
- L’accès aux données est urgent, ce qui rend essentiel leur acheminement immédiat dans le processus
- Vous souhaitez accéder à des informations sur les tendances sans attendre le traitement des données par lots
Exemples de flux de travail ETL
La compréhension des besoins spécifiques de votre secteur en matière de flux et de gestion des données est essentielle pour planifier efficacement les flux de travail ETL. Examinez ces exemples issus de différents secteurs afin de comprendre comment les exigences et les dépendances peuvent varier.
ETL pour les flux de données de santé
Les organismes de santé ont besoin d’un accès précis et rapide aux données des patients et aux données de traitement, ce qui rend les processus ETL essentiels à leur réussite. Les données peuvent provenir de diverses sources, notamment les portails patients, les dossiers médicaux électroniques, les équipements d’imagerie et les fournisseurs tiers tels que les entreprises pharmaceutiques.
L’un des principaux défis de l’ETL dans le secteur de la santé consiste à créer des processus sécurisés conformes à des réglementations telles que HIPAA. Ces processus dépendent également de sources de données alimentées par les patients, les prestataires et l’automatisation, ce qui crée des difficultés supplémentaires lors de la transformation des données.
Lors de la modélisation des pipelines de données de santé, vous devrez peut-être utiliser à la fois le traitement en flux continu et le traitement par lots. Par exemple, les prestataires peuvent avoir besoin d’un accès en temps réel aux données diagnostiques, tandis que les données de codage et de facturation peuvent être traitées par lots en fin de journée à des fins de gestion des demandes de remboursement.
ETL pour les flux de données du commerce électronique
Les données du commerce électronique proviennent de nombreuses sources, notamment des e-mails, des portails clients, des API et des applications, des réseaux sociaux, des sites web, des systèmes CRM ainsi que des processus comptables ou de paiement. Cela crée un défi considérable lorsqu’il s’agit de transformer les données sans les dégrader.
Le traitement par lots convient généralement bien à de nombreux processus de commerce électronique. Par exemple, vous pouvez récupérer les données de commande toutes les heures et les intégrer à des processus ETL qui prennent en charge les tâches liées à l’entreposage et à l’expédition. Vous pouvez également extraire quotidiennement les données de paiement afin de mettre à jour les dossiers financiers.
Toutefois, si vous souhaitez proposer un libre-service 24 h/24 et 7 j/7 à vos clients, les flux de travail fondés sur des flux continus peuvent être plus appropriés. Imaginons, par exemple, que vous disposiez d’un chatbot qui fournit aux clients des informations sur les commandes, les paiements, les retours et les crédits. Si vos processus ETL s’exécutent par lots quotidiens, les informations fournies par votre chatbot sont toujours obsolètes d’au moins 24 heures.
ETL pour les flux de données financières
Les banques, les sociétés émettrices de cartes de crédit, les applications de gestion financière et les autres organisations et services du secteur financier dépendent fortement de données exactes. Ces organisations doivent également composer avec des réglementations strictes et des normes de conformité rigoureuses afin de garantir la sécurité des données.
Les sources de données peuvent inclure des données importées d’autres organisations financières, des données ACH et de chambre de compensation, des informations provenant d’applications destinées aux clients ainsi que des formats moins structurés comme les e-mails. Les organisations financières peuvent également souhaiter combiner des pipelines par lots et des pipelines continus pour répondre aux besoins des clients.
Progrès technologiques dans les processus ETL
Il y a plusieurs décennies, la technologie cloud a révolutionné le traitement des données, et elle reste un élément majeur des avancées dans les logiciels d’entrepôt de données et les solutions associées. Toutefois, actuellement, les tendances en matière d’avancées technologiques de l’ETL se concentrent généralement sur l’intégration de l’IA, de l’apprentissage automatique et de l’automatisation dans les flux de travail. Parmi les avancées notables figurent :
- La capacité de l’IA à traiter les mégadonnées. Les outils d’intelligence artificielle peuvent traiter d’énormes volumes de données en quelques secondes, permettant une évolutivité des processus ETL qui n’existait pas auparavant.
- Le traitement du langage naturel. L’apprentissage automatique et le traitement du langage naturel permettent aux solutions automatisées d’aborder la transformation des données avec un ensemble plus complet de compétences de « réflexion critique » qu’il n’était auparavant possible d’obtenir. Cela crée des possibilités d’automatisation de tâches qui nécessitaient historiquement une intervention humaine.
- La prise en charge de la gouvernance des données. Presque tous les secteurs sont aujourd’hui confrontés à des exigences réglementaires renforcées, et les solutions technologiques contribuent de plus en plus à la conformité et à la sécurité des données.
Bonnes pratiques pour optimiser les flux de travail ETL
Ce qui fonctionne le mieux pour une autre organisation n’est pas forcément la meilleure pratique pour votre entreprise en matière d’ETL. Cependant, j’ai rassemblé quelques bonnes pratiques générales que vous pouvez mettre en œuvre pour optimiser les flux de travail ETL dans presque tous les environnements.
- Choisissez les outils adaptés à vos besoins. Effectuez des recherches sur les outils de flux de travail et de processus ETL afin de trouver des partenaires et des solutions qui répondent à vos besoins spécifiques en matière de données. Envisagez de constituer une équipe pour cartographier les flux de travail ETL souhaités, répertorier les difficultés que vous rencontrez et évaluer les solutions potentielles à la lumière de ces facteurs.
- Assurez-vous que vos choix de flux de travail sont appropriés. Prenez le temps de comprendre la différence entre ETL et ELT et de déterminer si vous avez besoin de flux de travail par lots ou continus.
- Surveillez régulièrement vos processus. Utilisez des outils tels que SQL Server Moniteur de performances — ou d’autres outils de surveillance des performances pertinents — pour comprendre les performances de vos flux de travail ETL. Surveillez les indicateurs d’efficacité et de qualité, et apportez les ajustements nécessaires pour une amélioration continue.
- Intégrez une technologie qui favorise la qualité et l’évolutivité. Envisagez des options telles que le calcul parallèle et la compression des données pour optimiser vos flux de travail.
Points clés à retenir
La conception de vos flux de travail ETL peut faire réussir ou échouer vos processus de données. Prenez le temps d’examiner les implications de vos décisions concernant les flux de travail, de définir les flux de travail idéaux et de choisir les outils adaptés pour prendre en charge l’extraction, la transformation et le chargement des données.
Restez informé des technologies et des bonnes pratiques en matière de données en vous abonnant à la newsletter du CTO Club.


