

10 meilleurs outils DataOps évalués en 2026
Sélection des meilleurs outils DataOps


Les meilleurs outils DataOps aident les équipes à créer, surveiller et gérer des pipelines de données qui produisent réellement des résultats fiables. Ils automatisent les contrôles qualité, suivent la traçabilité des données et offrent une visibilité sur les flux de travail afin que les données circulent de manière sécurisée et efficace de la source à la destination.
Si vous avez déjà perdu des heures à déboguer des tâches ETL échouées avec des messages d’erreur vagues, jonglé entre des systèmes cloisonnés qui ne s’intègrent pas ou dû vous démener lors d’un audit de conformité sans suivi clair de la traçabilité des données, vous savez à quel point de mauvaises opérations de données peuvent être perturbatrices. Ces difficultés ralentissent les livraisons, introduisent des risques et sapent la confiance dans les données dont dépend votre entreprise.
J’ai travaillé avec des ingénieurs data et des équipes produit dans des environnements SaaS à forte croissance, en évaluant des plateformes dans des conditions réelles où les performances, la sécurité et l’auditabilité ne peuvent être compromises. J’ai testé des outils dans des environnements de développement, de préproduction et de production afin de distinguer ceux qui se contentent de commercialiser des solutions de ceux qui réduisent réellement les frictions et améliorent la fiabilité.
Dans ce guide, vous découvrirez quelles plateformes DataOps fournissent des informations exploitables, réduisent le bruit et aident votre équipe à avancer plus rapidement en toute confiance.
Pourquoi faire confiance à nos avis logiciels
Nous testons et analysons des logiciels depuis 2023. En tant que dirigeants technologiques, nous savons à quel point il est crucial et difficile de faire le bon choix lors de la sélection d’un logiciel.
Nous investissons dans des recherches approfondies pour aider notre audience à prendre de meilleures décisions d’achat de logiciels. Nous avons testé plus de 2 000 outils pour différents usages technologiques et rédigé plus de 1 000 avis complets. Découvrez comment nous restons transparents & notre méthodologie d’évaluation des logiciels.
Résumé des meilleurs outils DataOps
Ce tableau comparatif résume les informations tarifaires de ma sélection des meilleurs outils DataOps afin de vous aider à trouver celui qui convient le mieux à votre budget et aux besoins de votre entreprise.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Idéal pour l'analyse de données à grande échelle | Non | $99/user/month | Website | |
| 2 | Idéal pour l’orchestration de pipelines de données | Démo gratuite disponible | Tarifs sur demande | Website | |
| 3 | Idéal pour la gestion de la confidentialité des données | Offre gratuite disponible | À partir de 150 $/mois (facturé annuellement) | Website | |
| 4 | Idéal pour la collaboration sur les flux de travail SQL | Essai gratuit de 21 jours | À partir de $199/utilisateur/an (facturé annuellement) | Website | |
| 5 | Idéal pour l'automatisation de la préparation des données | Non | $5,195/utilisateur/an (soit environ $433/utilisateur/mois) | Website | |
| 6 | Idéal pour l'intégration hybride des données | Non | $1/user/hour pour les activités de déplacement de données | Website | |
| 7 | Idéal pour l’intégration des données à grande échelle en entreprise | Non | Tarification sur demande | Website | |
| 8 | Idéal pour des requêtes de type SQL | Not available | Gratuit | Website | |
| 9 | Idéal pour la recherche et l'analyse de données | Non | $16/user/month | Website | |
| 10 | Idéal pour la gestion des flux de données en temps réel | Not available | Gratuit | Website |
Avis sur les meilleurs outils DataOps
Vous trouverez ci-dessous mes résumés détaillés des meilleurs outils DataOps qui ont intégré ma sélection. Mes avis présentent un aperçu détaillé des fonctionnalités clés, des avantages et des inconvénients, des intégrations et des cas d’utilisation idéaux de chaque outil afin de vous aider à trouver celui qui vous convient le mieux.

Idéal pour l'analyse de données à grande échelle
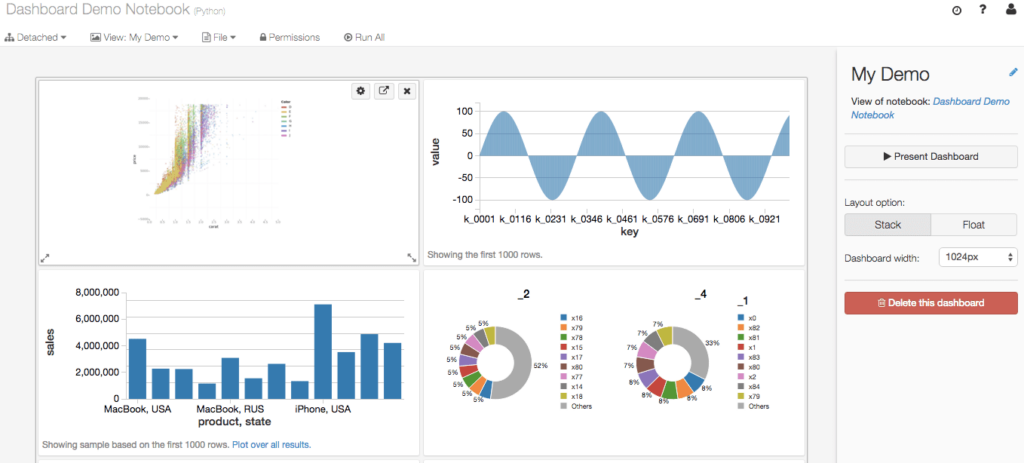
Databricks est une plateforme de données et d'IA conçue pour les entreprises, destinée aux ingénieurs, scientifiques et analystes de données. Elle propose des fonctionnalités de traitement des données, d'analytique et d'apprentissage automatique.
Pourquoi j'ai choisi Databricks : Elle excelle dans l’analyse de données à grande échelle, offrant des notebooks collaboratifs et Delta Lake pour la fiabilité des données. Votre équipe peut bénéficier de ses outils avancés d'apprentissage automatique, renforçant les capacités d’analyse. Le support robuste de la plateforme pour Apache Spark garantit un traitement efficace des données volumineuses. Son intégration flexible avec les principaux fournisseurs de cloud comme AWS, Azure et Google Cloud accroît son attrait pour les opérations à grande échelle.
Fonctionnalités et intégrations remarquables :
Fonctionnalités incluent des notebooks collaboratifs qui favorisent le travail d’équipe et l’innovation. Delta Lake assure la fiabilité et la cohérence des données, ce qui est crucial pour les tâches de big data. Les capacités d'apprentissage automatique de la plateforme permettent à votre équipe de concevoir et de déployer des modèles efficacement.
Intégrations incluent Apache Spark, AWS, Azure, Google Cloud, Tableau, Power BI, Snowflake, MongoDB, Looker et Qlik.
Pros and Cons
Pros:
- Intégrations cloud flexibles
- Prise en charge du traitement des big data
- Outils avancés d'apprentissage automatique
Cons:
- Structure tarifaire complexe
- Problèmes de performance occasionnels

Idéal pour l’orchestration de pipelines de données
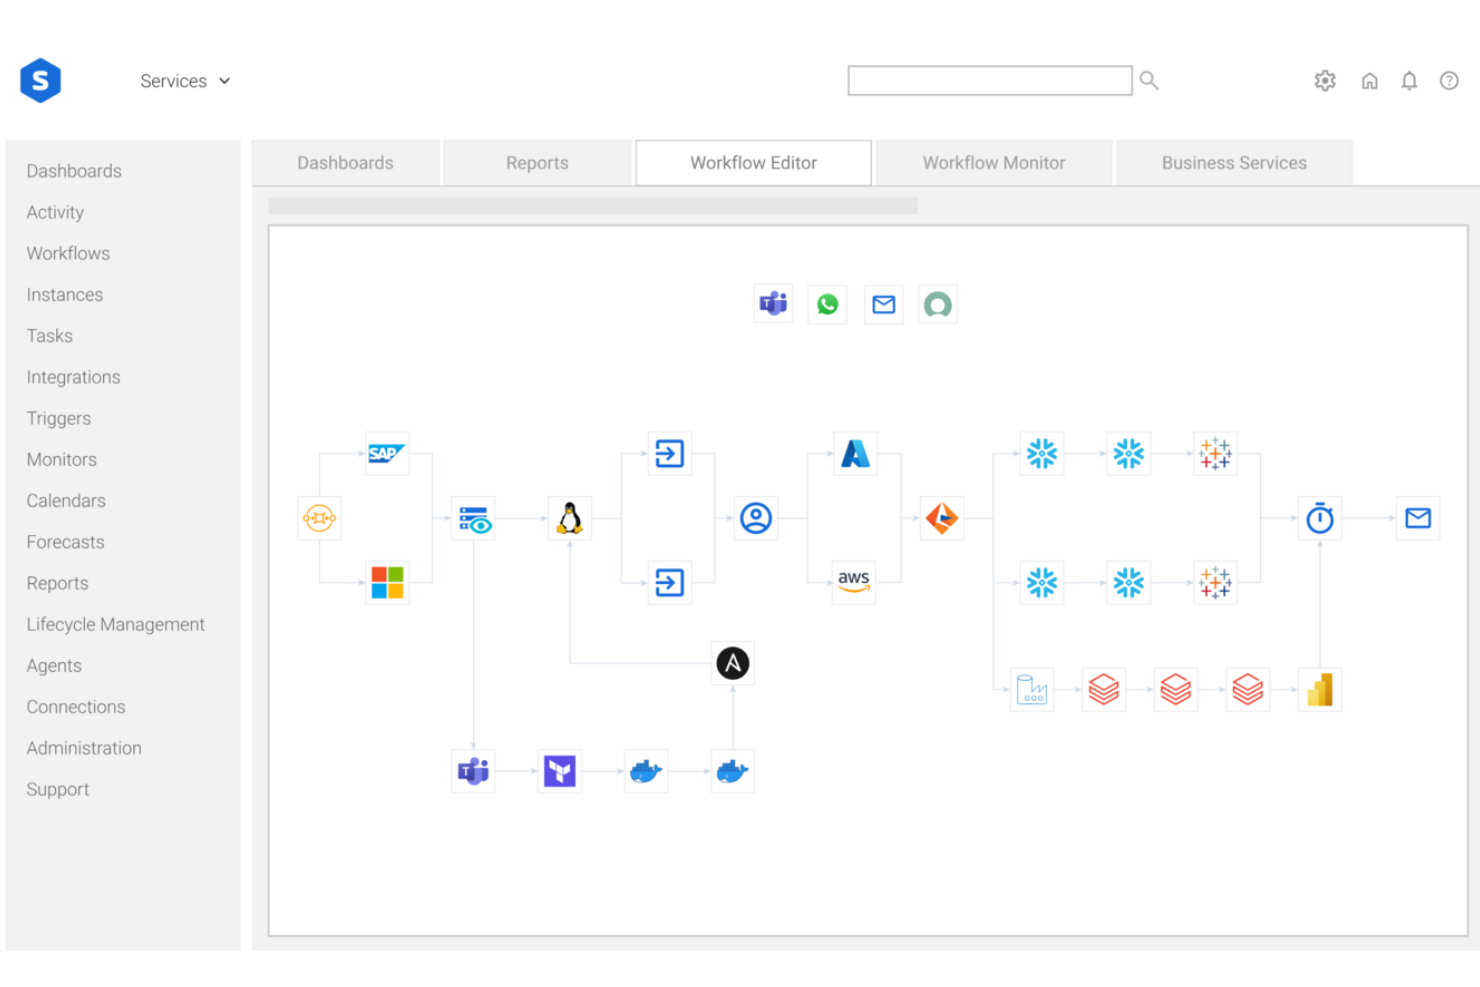
Stonebranch Universal Automation Center offre une solution fiable pour les équipes informatiques souhaitant optimiser leurs opérations de données. Conçu pour les professionnels de l'informatique et les entreprises qui cherchent à rationaliser leurs flux de données, il répond à la complexité des environnements informatiques hybrides en orchestrant sans couture les pipelines de données et en automatisant les workflows sur différentes plateformes. Avec son interface conviviale, l’outil convient particulièrement aux équipes désireuses de réduire la supervision manuelle et d'améliorer l'efficacité opérationnelle.
Pourquoi j'ai choisi Stonebranch Universal Automation Center
J'ai choisi Stonebranch Universal Automation Center pour ses capacités uniques d'orchestration de pipelines de données, un aspect crucial du DataOps. L'automatisation informatique hybride en temps réel de la plateforme permet à votre équipe de gérer des workflows complexes à la fois sur le cloud et sur site. Son automatisation pilotée par les événements garantit que les workflows s’exécutent en réponse à des déclencheurs de données spécifiques, renforçant ainsi l’agilité opérationnelle. Ces fonctionnalités sont adaptées aux besoins des services informatiques qui souhaitent optimiser la gestion des données et rationaliser les processus sans une intervention manuelle importante.
Fonctionnalités clés de Stonebranch Universal Automation Center
En plus de l’orchestration de pipelines de données, Stonebranch Universal Automation Center propose :
- Transfert de fichiers géré : Contrôle de manière sécurisée le flux de données à travers différents environnements, y compris les transferts de fichiers B2B.
- Automatisation de l’infrastructure et des services : Gère de façon transparente les ressources informatiques, réseau et stockage.
- Analytique et observabilité : Offre des capacités avancées de reporting et de prédiction afin d'améliorer les niveaux de service.
Intégrations de Stonebranch Universal Automation Center
Les intégrations incluent Amazon Web Services (AWS), SAP, ServiceNow, Red Hat, Google Cloud, Kubernetes, Microsoft, Docker et Informatica.
Pros and Cons
Pros:
- Supervision avancée sur les mainframes et les environnements cloud
- Des capacités d’automatisation complètes pour des processus IT variés
- La haute disponibilité et les capacités de basculement améliorent la fiabilité
Cons:
- Les utilisateurs signalent une documentation peu adaptée aux débutants
- Disponibilité cloud et évolutivité limitées par rapport aux alternatives

Ketch
Idéal pour la gestion de la confidentialité des données
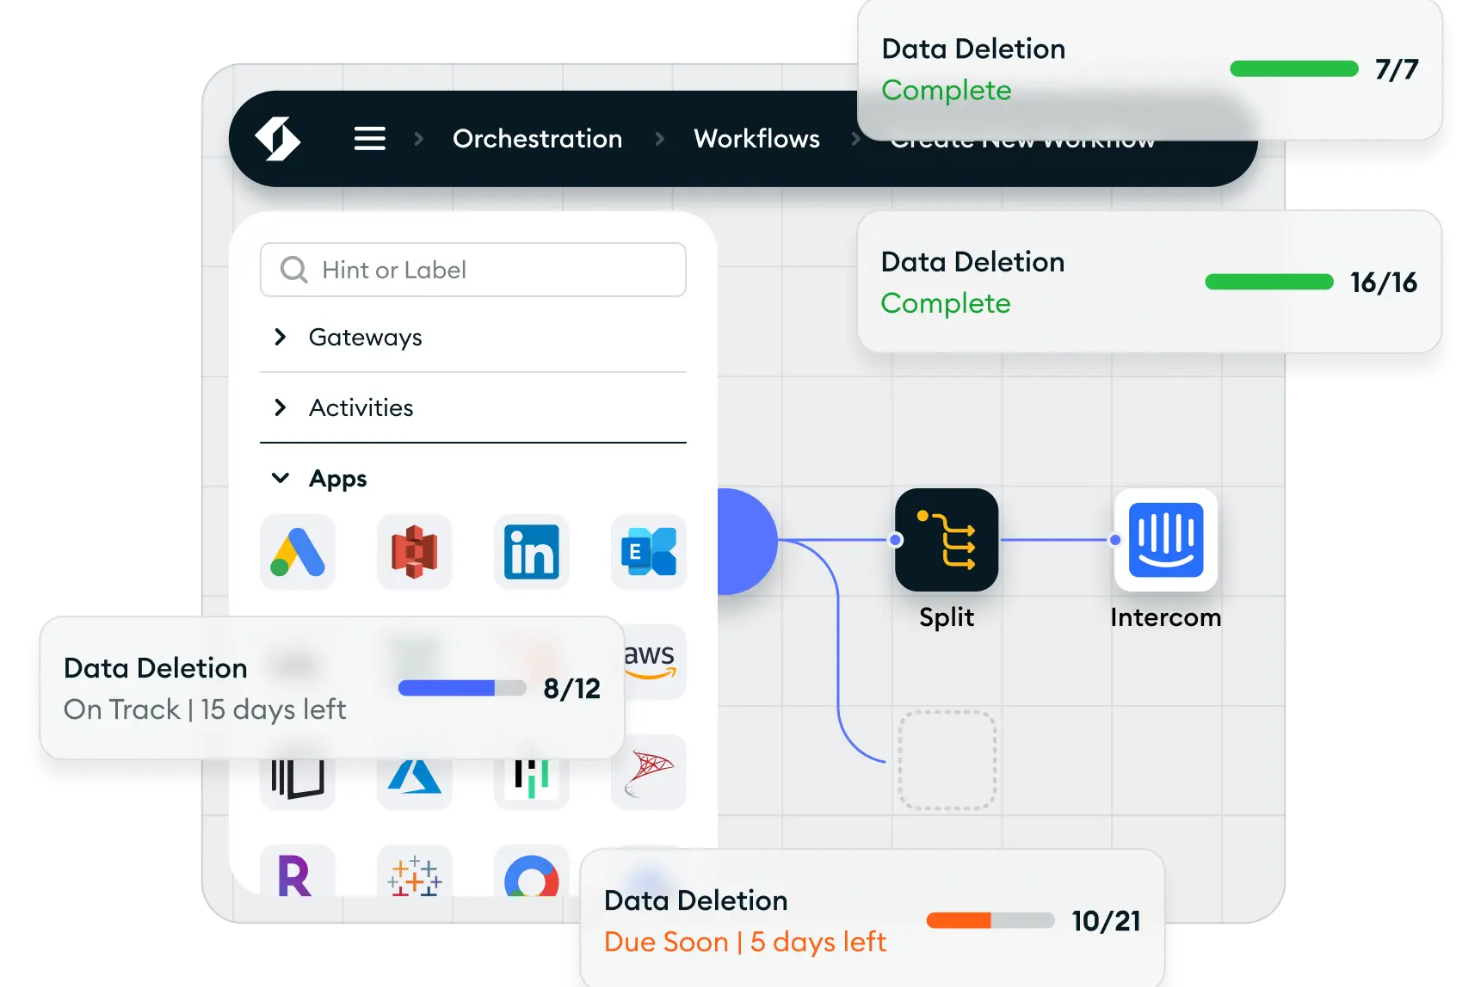
Ketch est un logiciel de gestion de la confidentialité des données conçu pour les entreprises soucieuses de conformité et de protection de la vie privée des utilisateurs. Il s’adresse aux professionnels du juridique, du marketing et de la technologie en proposant des outils tels que la gestion des consentements et la cartographie des données.
Pourquoi j’ai choisi Ketch : Il se concentre sur la conformité aux réglementations telles que le RGPD et la CCPA. Ketch automatise les processus de confidentialité, notamment l’automatisation des demandes des personnes concernées (DSR) et les évaluations des risques, ce qui fait gagner du temps à votre équipe. Vous bénéficiez également de bannières de confidentialité personnalisables pour renforcer les relations avec les clients. Sa capacité à s’intégrer à plus de 1 000 systèmes apporte une grande flexibilité, en faisant une excellente option pour les entreprises axées sur la confidentialité.
Fonctionnalités et intégrations phares :
Fonctionnalités : modèles de confidentialité personnalisables, outils d’évaluation des risques et workflows automatisés. Ketch permet de gérer facilement les consentements et les demandes de personnes concernées, améliorant ainsi la productivité en réduisant les tâches manuelles. La plateforme propose également une interface conviviale qui facilite le déploiement et l’intégration des utilisateurs.
Intégrations : Salesforce, HubSpot, Marketo, Microsoft Dynamics, Google Analytics, Adobe Experience Cloud, Amazon Web Services, Oracle, SAP et Workday.
Pros and Cons
Pros:
- Renforce la relation client
- Compatible avec plus de 1 000 intégrations
- Déploiement et intégration rapides
Cons:
- Options de personnalisation limitées
- Nécessite des mises à jour réglementaires continues
New Product Updates from Ketch
Ketch Launches Iris-Powered Tracker Scanning
Ketch adds Iris-powered tracker scanning to Data Sentry and Consent Management, using cohort-based page grouping and adaptive sampling to expand tracker coverage and keep results current. For more information, visit Ketch’s official site.
 .

Idéal pour la collaboration sur les flux de travail SQL
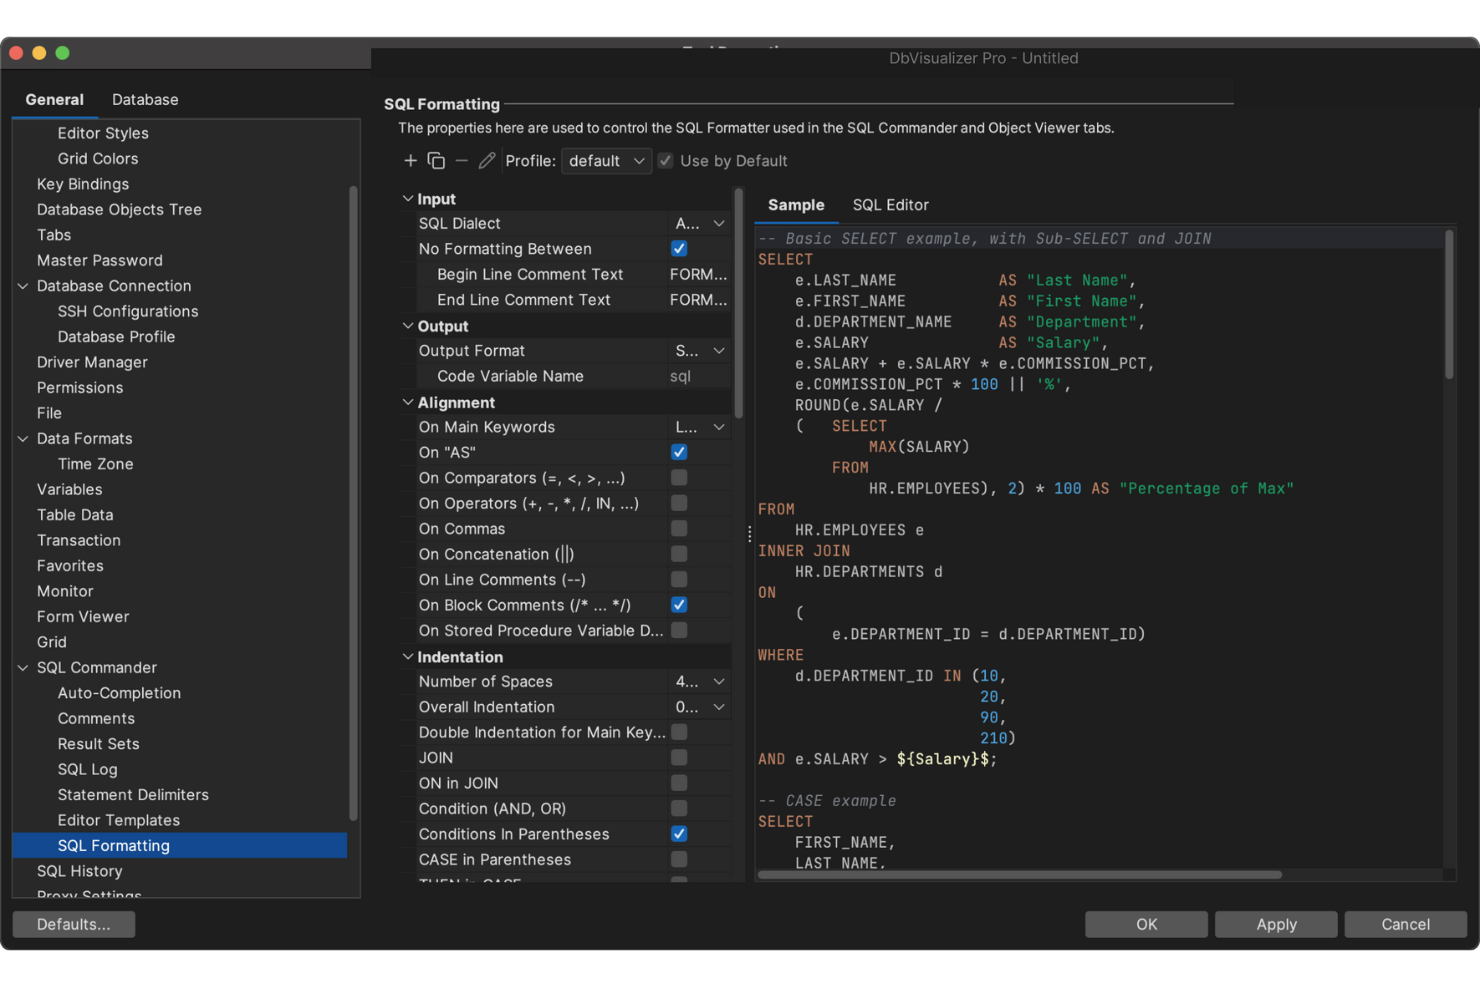
Pour les équipes à la recherche d'une solution DataOps fiable, DbVisualizer propose une plateforme polyvalente répondant à divers besoins en gestion de bases de données. Elle est idéale pour les professionnels des données de tous secteurs nécessitant un outil unifié pour gérer des bases complexes. Grâce à des fonctionnalités telles que l'édition SQL avancée et la visualisation robuste des données, DbVisualizer répond aux défis de l'intégration et de la gestion des données, en faisant un atout précieux pour optimiser les flux de travail de données.
Pourquoi j'ai choisi DbVisualizer
J'ai choisi DbVisualizer car ses outils SQL prêts pour les flux de travail s'adaptent parfaitement à la manière dont les équipes DataOps itèrent, valident et promeuvent les changements à travers les environnements. Vous pouvez collaborer sur des scripts SQL avec la gestion de version intégrée, ce qui facilite le suivi des mises à jour, le travail en branches et le maintien d'une piste d'audit claire des transformations. Les plans d'exécution visuels aident votre équipe à évaluer les performances des requêtes avant que les changements ne soient appliqués, réduisant ainsi les perturbations dans les pipelines. J'apprécie également le fait que vous puissiez automatiser l'exécution des scripts en dehors de l'interface utilisateur grâce à
Fonctionnalités clés de DbVisualizer
J'apprécie aussi que DbVisualizer propose :
- Exploration des données : Permet de parcourir et gérer facilement des structures de données complexes dans vos bases de données.
- Édition en ligne : Offre la possibilité de modifier directement les données dans les tables, simplifiant ainsi la manipulation des données.
- Gestion en ligne de commande : Prend en charge l'exécution de scripts et les tâches de gestion via une interface en ligne de commande, renforçant l'automatisation.
- Exportation/Importation de données : Facilite le transfert de données dans divers formats, favorisant une intégration et un partage des données sans faille.
Intégrations DbVisualizer
Les intégrations incluent DB2, MariaDB, SQL Server, MySQL, PostgreSQL, Oracle, Apache Derby, H2, SQLite et Sybase.
Pros and Cons
Pros:
- Accent mis sur la représentation visuelle des données pour une compréhension plus claire
- Éditeur SQL avancé avec fonctions telles que suggestions automatiques et mise en forme
- Prend en charge plusieurs types de bases de données, offrant une gestion polyvalente
Cons:
- Les ensembles de données volumineux peuvent parfois affecter les performances
- Les nouveaux utilisateurs peuvent rencontrer une courbe d'apprentissage légère
New Product Updates from DbVisualizer

DbVisualizer Adds AI Enhancements, Map Visualization, and SQL Tab Groups
DbVisualizer expands AI capabilities, introduces geospatial map visualization, and adds SQL Commander tab groups. The release also improves audit logging, database connection management, and database support to streamline development workflows. For more information, visit DbVisualizer's official site.
 .

Alteryx
Idéal pour l'automatisation de la préparation des données
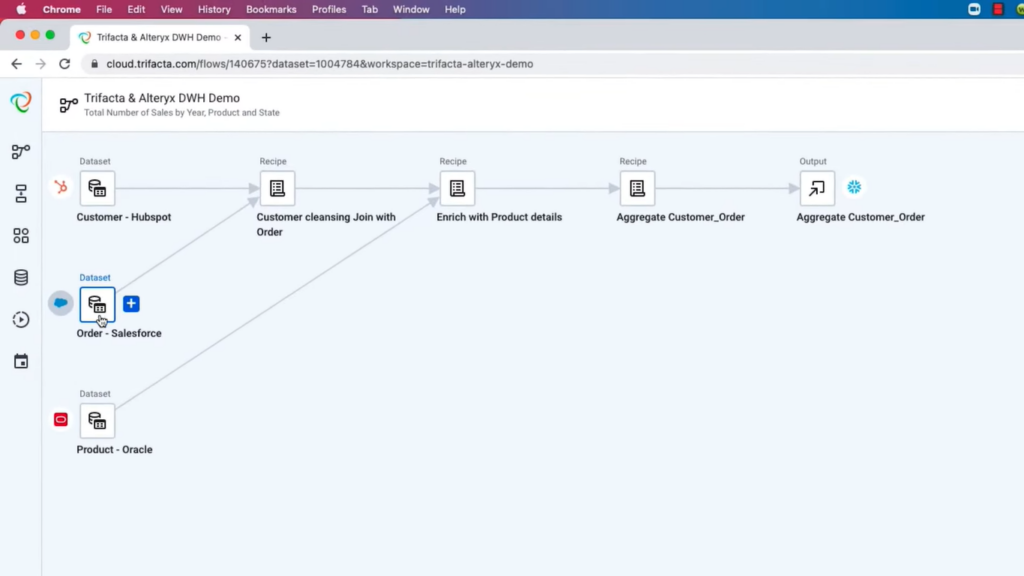
Alteryx est une plateforme d'analyse de données qui aide les utilisateurs à préparer, fusionner et analyser des données provenant de diverses sources. Elle propose des solutions à la fois sur ordinateur et dans le cloud, adaptées aux professionnels qui souhaitent automatiser les flux de travail liés aux données et obtenir des analyses efficaces.
Pourquoi j'ai choisi Alteryx : Vous pouvez automatiser les tâches répétitives de préparation des données grâce à l'interface glisser-déposer d'Alteryx. Elle propose plus de 300 outils sans code et à faible code, permettant à votre équipe de nettoyer, transformer et enrichir les données sans écrire de code. La plateforme prend en charge les données structurées et non structurées, vous permettant de gérer des ensembles de données variés. De plus, Alteryx propose des recommandations optimisées par l'IA pour améliorer vos flux de travail.
Fonctionnalités et intégrations remarquables :
Les fonctionnalités incluent des outils d'analyse géospatiale, permettant à votre équipe de réaliser des analyses basées sur la localisation. Vous pouvez également utiliser des fonctionnalités intégrées d'apprentissage automatique pour créer des modèles prédictifs sans connaissances approfondies en codage. Par ailleurs, Alteryx prend en charge le traitement des données en temps réel, vous permettant de prendre des décisions en fonction de données actuelles.
Les intégrations incluent des connexions avec Salesforce, Snowflake, Amazon Redshift, Google BigQuery, Microsoft Azure, Tableau, Power BI, Oracle, SAP et Databricks.
Pros and Cons
Pros:
- Propose des recommandations de workflow pilotées par IA
- Automatise des tâches complexes de préparation de données
- Gère les données structurées et non structurées
Cons:
- Possibilités limitées de visualisation des données
- Nécessite des licences séparées pour certaines fonctionnalités

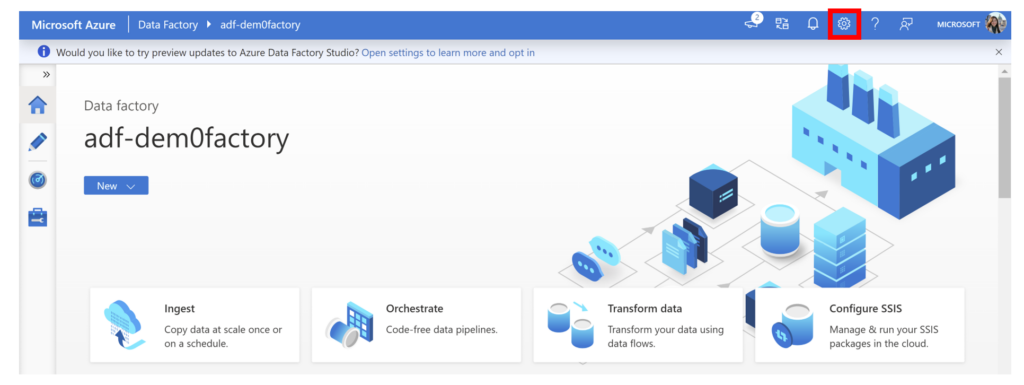
Azure Data Factory est un service d'intégration de données basé sur le cloud, destiné aux ingénieurs et analystes de données. Il facilite la création, la planification et l'orchestration des flux de travail de données, prenant en charge aussi bien les sources de données cloud que locales.
Pourquoi j'ai choisi Azure Data Factory : Il excelle dans l'intégration hybride des données, permettant à votre équipe de connecter des environnements de données variés. L'interface de type glisser-déposer simplifie la création de flux de travail complexes. Vous pouvez utiliser la planification intégrée pour automatiser le déplacement des données, réduisant ainsi les tâches manuelles. Les capacités de surveillance en temps réel offrent une visibilité sur les processus de données, améliorant l'efficacité opérationnelle.
Fonctionnalités et intégrations remarquables :
Les fonctionnalités incluent une interface intuitive de glisser-déposer pour concevoir des pipelines de données. Les outils de planification intégrés permettent d'automatiser les flux de données, ce qui permet de gagner du temps et des efforts. La surveillance en temps réel fournit une visibilité sur les opérations, aidant à identifier et résoudre rapidement les problèmes.
Les intégrations incluent Azure Blob Storage, Azure SQL Database, Azure Synapse Analytics, Amazon S3, Google BigQuery, Oracle, SAP, Salesforce, Teradata et IBM Db2.
Pros and Cons
Pros:
- Interface glisser-déposer facile d'utilisation
- Prise en charge d'environnements de données variés
- Capacités de surveillance en temps réel
Cons:
- Complexité de la configuration initiale
- Fonctionnalités hors ligne limitées

La plateforme DataOps d’IBM est conçue pour les grandes entreprises, destinée aux professionnels de l’informatique et aux ingénieurs en données. Elle met l’accent sur l’intégration, la gouvernance et la qualité des données, garantissant que vos opérations de données sont efficaces et fiables.
Pourquoi j’ai choisi IBM : Elle se distingue dans l’intégration de données d’entreprise, en proposant des outils comme le catalogage des données et la gouvernance. Vous pouvez automatiser les flux de travail, ce qui aide à maintenir la qualité des données dans toute votre organisation. La fonctionnalité de traçabilité (data lineage) de la plateforme offre de la transparence, vous permettant de suivre les sources et les transformations des données. Sa capacité de mise à l’échelle convient parfaitement aux grandes entreprises ayant besoin de gérer efficacement d’importantes quantités de données.
Fonctionnalités clés & intégrations :
Fonctionnalités incluent le catalogage des données pour vous aider à organiser vos actifs de données. Les outils de gouvernance de la plateforme assurent la conformité avec les réglementations sur les données. Des contrôles automatisés de la qualité des données permettent de garantir l’intégrité de vos ensembles de données.
Intégrations incluent IBM Cloud, AWS, Azure, Google Cloud, Hadoop, Apache Spark, Oracle, SAP, Salesforce et Tableau.
Pros and Cons
Pros:
- Outils complets de gouvernance des données
- Gestion des opérations de données à grande échelle
- Contrôles automatisés de la qualité
Cons:
- Peut présenter une courbe d’apprentissage importante
- Options de personnalisation limitées

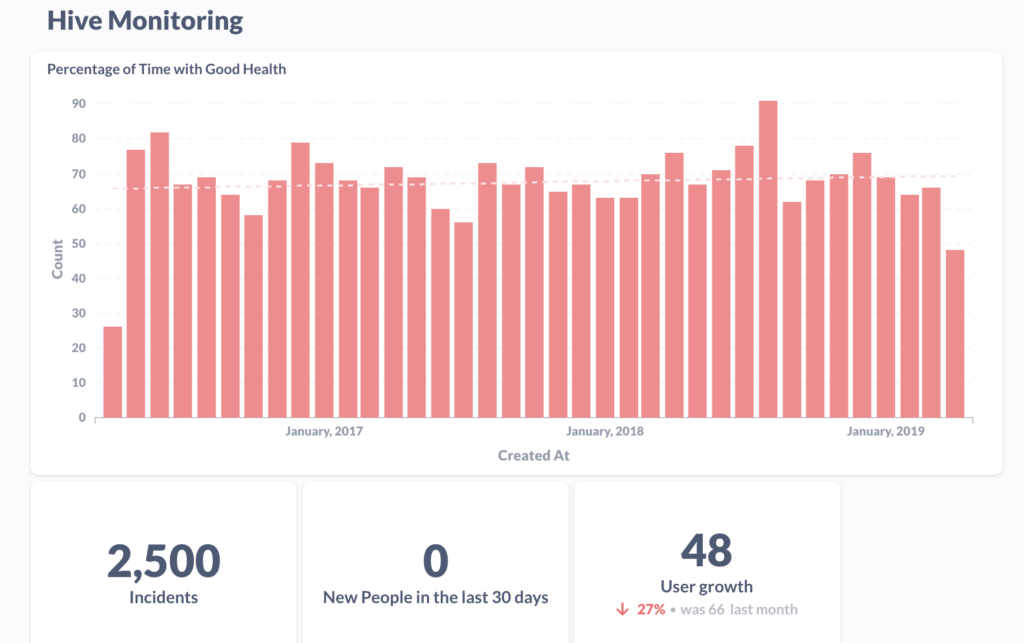
Apache Hive est une solution d'entreposage de données principalement destinée aux analystes et ingénieurs de données. Elle permet d'interroger et de gérer de grands ensembles de données stockés dans un stockage distribué.
Pourquoi j'ai choisi Apache Hive : Il propose des requêtes de type SQL, ce qui est idéal pour les utilisateurs familiers avec SQL. L'intégration de l'outil avec Hadoop le rend adapté à l'analyse efficace de grands ensembles de données. Apache Hive prend en charge divers formats de données, offrant à votre équipe une flexibilité dans la gestion des données. Sa capacité à gérer facilement des requêtes complexes en fait un choix fiable pour les entreprises axées sur les données.
Fonctionnalités et intégrations remarquables :
Fonctionnalités : incluent un langage de requête similaire à SQL, ce qui simplifie l'apprentissage et l'adoption. Il prend en charge l'indexation pour améliorer les performances des requêtes, rendant la récupération des données plus rapide. Apache Hive propose également le partitionnement, ce qui aide à gérer et à interroger efficacement de grands ensembles de données.
Intégrations : incluent Hadoop, HDFS, HBase, Amazon S3, Azure Blob Storage, Google Cloud Storage, Apache Spark, Apache Pig, Apache Tez et Apache Ranger.
Pros and Cons
Pros:
- Langage de requête similaire à SQL
- Prend en charge les requêtes de données complexes
- Gère efficacement de grands ensembles de données
Cons:
- Pas idéal pour l'analyse en temps réel
- Les performances varient selon la taille des données

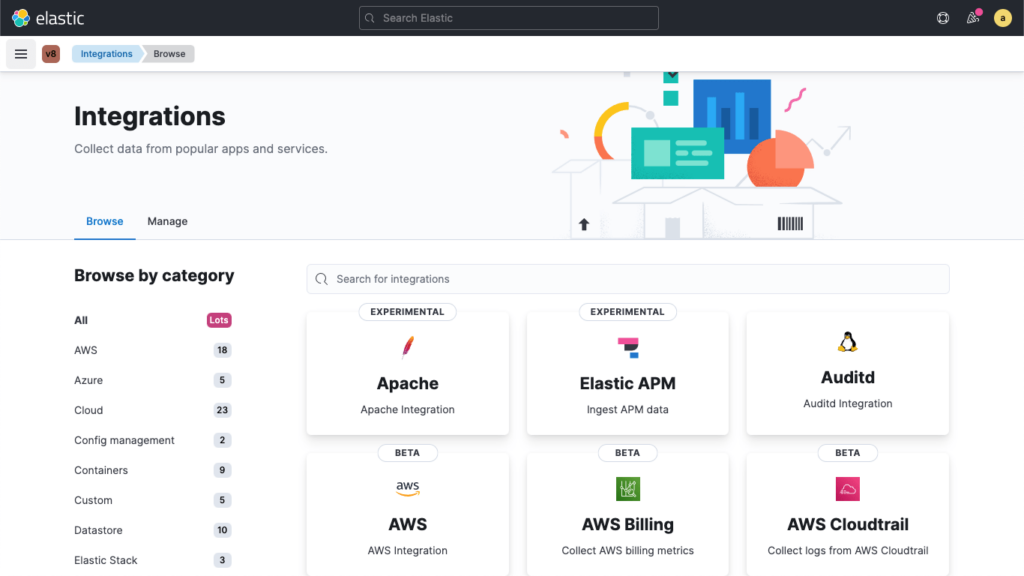
Elastic est un moteur de recherche et d'analyse open source qui fournit des informations en temps réel à partir de vos données. Sa fonction principale est de stocker, rechercher et analyser d'énormes volumes de données rapidement et presque en temps réel. Cela rend Elastic particulièrement performant pour les tâches de recherche et d'analyse de données en temps réel.
Pourquoi j'ai choisi Elastic :
J'ai choisi Elastic en raison de ses capacités de recherche à grande vitesse et de son aptitude à gérer efficacement de vastes ensembles de données. Ses puissantes fonctionnalités de recherche, associées à ses capacités d'analyse en temps réel, permettent à Elastic de se distinguer des autres outils.
Sur la base de ces capacités, j'ai estimé qu'Elastic est le meilleur outil pour la recherche et l'analyse de données en temps réel.
Fonctionnalités et intégrations remarquables :
Parmi les fonctionnalités figurent la recherche en texte intégral, la recherche distribuée et l'analyse en temps réel. Sa fonctionnalité d'agrégation en temps réel et à plusieurs niveaux aide les utilisateurs à explorer et à analyser leurs données de manière plus intuitive.
Les intégrations comprennent de nombreux outils de collecte et de visualisation de données, notamment Logstash pour la centralisation des journaux et Kibana pour la visualisation des données.
Pros and Cons
Pros:
- Fournit des résultats de recherche rapides et efficaces
- Peut gérer de grands ensembles de données
- Flexible avec les formats de données
Cons:
- Configurer et optimiser Elastic pour des cas d'utilisation spécifiques peut être complexe
- Bien que la pile Elastic de base soit gratuite, les fonctionnalités avancées sont payantes

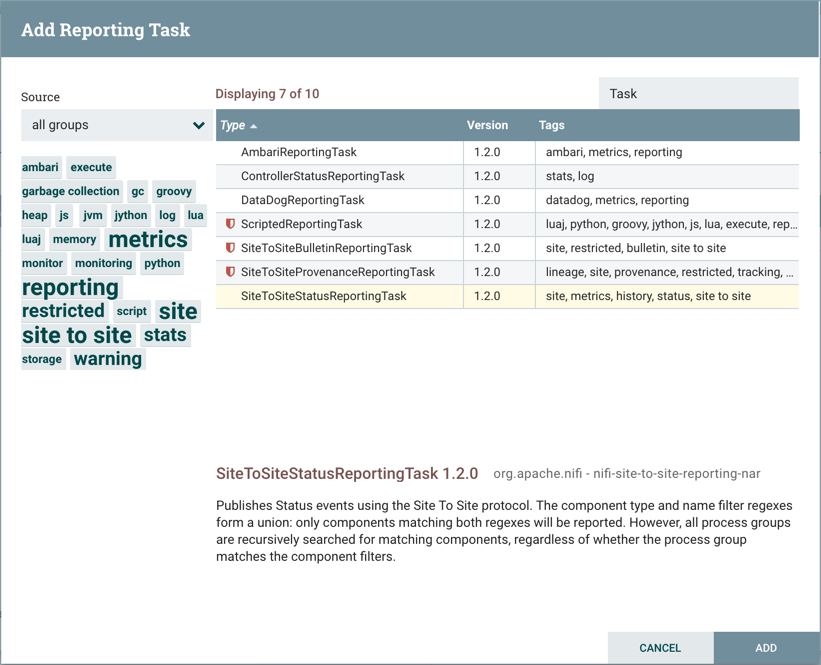
Apache NiFi est une plateforme logistique de données intégrée pour automatiser le déplacement de données entre des systèmes disparates. Elle offre un contrôle en temps réel qui la rend réactive aux flux de big data hautement volatils, ce qui en fait le choix idéal pour l'ingestion et le streaming de données en temps réel.
Pourquoi j'ai choisi Apache NiFi :
J'ai choisi Apache NiFi pour ses capacités de routage et de transformation de données à haute vitesse. Son architecture unique permet de suivre les données en temps réel et de créer des flux de données dynamiques et réactifs. Ces fonctionnalités marquantes sont la raison pour laquelle je considère qu'Apache NiFi est le meilleur choix pour l'ingestion et le streaming de données en temps réel.
Fonctionnalités et intégrations remarquables :
Fonctionnalités : interface web hautement configurable, traçabilité des données depuis leur origine jusqu'à leur consommation (provenance des données), et capacité de mise à l'échelle flexible.
Intégrations : HTTP, AMQP, HDFS et base de données via JDBC.
Pros and Cons
Pros:
- Contrôle en temps réel des flux de données
- Capacités étendues de routage et de transformation des données
- Open-source et personnalisable
Cons:
- La configuration et la mise en place peuvent être complexes
- Absence de support direct par un fournisseur en raison de sa nature open-source
Autres outils DataOps
Voici quelques autres outils DataOps qui n’ont pas intégré ma sélection, mais qui méritent tout de même votre attention :
- RightData
Idéal pour les tests et la validation des données
- StreamSets
Idéal pour le mouvement de données en temps réel
- HighByte
Idéal pour l'intégration de données industrielles
- DataKitchen
Idéal pour l'orchestration DataOps
- Badook
Idéal pour la surveillance de la qualité des données


Comment j'évalue les outils DataOps
Je divise mon évaluation en exigences de base — telles que l'orchestration de pipelines et la prise en charge du CI/CD — et les éléments différenciateurs qui distinguent un bon outil DataOps de celui qui convient le mieux à votre équipe.
Fonctionnalités principales (Critères essentiels pour cette liste)
Lorsque je sélectionne les outils pour ma liste, j'évalue chacun sur une échelle de 0 (ne propose pas la fonctionnalité) à 5 (excellent dans ce domaine) pour chaque fonctionnalité essentielle listée ci-dessous. Ensuite, je calcule le score total de l’outil en pourcentage. Chaque outil doit atteindre un score total minimum de 65 % pour être considéré pour inclusion.
- Orchestration & planification de pipelines : Je recherche une gestion de flux de travail basée sur des DAG avec gestion des dépendances, logique de reprise, et backfills — le type d'orchestration qui garantit un rafraîchissement nocturne d'entrepôt fluide sur des dizaines de sources en amont.
- Observabilité des données & surveillance : Les alertes sur les échecs de tâches sont un minimum, mais j’évalue si l’outil met en avant la fraicheur des données, les anomalies de volumes, et la traçabilité au niveau des colonnes pour qu’une équipe puisse remonter un tableau de bord défectueux jusqu’à une table source précise.
- CI/CD & prise en charge du contrôle de version : Branches basées sur Git, tests automatisés de la logique de transformation, et déploiements par étapes sont essentiels ici — je vérifie si les équipes peuvent publier des changements de pipelines en toute sécurité comme elles le feraient pour du code applicatif.
- Intégration & transformation des données : J’évalue la diversité des connecteurs sur entrepôts, data lakes, applications SaaS, et bases de données, ainsi que la possibilité d’exécuter les transformations en SQL, Python ou les deux — des outils comme Fivetran et Airbyte gèrent l’ingestion différemment que dbt gère la transformation, donc la flexibilité est clé.
- Gestion des environnements & des métadonnées : Je vérifie l’existence d’environnements séparés (développement, test, production) avec catalogage des métadonnées et traçabilité, pour éviter que des ingénieurs ne testent des modèles expérimentaux sur des données de production.
- Collaboration & contrôles d’accès : Permissions basées sur les rôles, journaux d’audit et espaces de travail partagés sont évalués ici — en particulier le niveau de granularité possible pour restreindre l’accès lorsqu’équipes analytics, ingénierie et gouvernance partagent la même plateforme.
Une fois que j'ai une liste d’outils répondant à ces critères, je regarde ce qui distingue chaque plateforme.
Facteurs de différenciation (Ce qui distingue chaque fournisseur)
Voici comment je compare et distingue les différents fournisseurs :
Fonctionnalités remarquables
La prise en charge du streaming et des pipelines temps réel est un élément différenciateur majeur — les outils limités au batch ne suffisent plus quand il faut une latence de moins d’une minute pour la détection de fraude ou des tableaux de bord en temps réel. J’évalue aussi les possibilités de reverse ETL, permettant de réinjecter les données de l’entrepôt dans des outils comme Salesforce ou HubSpot sans scripts sur mesure. Les fonctions d’optimisation des coûts et des ressources de calcul comptent également ; je vérifie si une plateforme vous aide à surveiller les dépenses des requêtes et à adapter la taille des ressources de pipelines avant que la facture d’entrepôt ne s’envole.
Au-delà des fonctionnalités
La compatibilité avec l’écosystème pèse beaucoup dans mon évaluation — un outil DataOps doit s’intégrer à votre stack existant, que ce soit Snowflake, Databricks ou un mélange des deux avec Airflow et dbt. Les certifications de sécurité et de conformité comme SOC 2 Type II et la conformité HIPAA entrent en jeu, en particulier pour ceux qui gèrent des données client ou financières sensibles. Je regarde aussi de près le coût total de possession, en vérifiant si la tarification évolue de façon prévisible au fur et à mesure que le volume des pipelines et la taille de l’équipe augmentent.
Comment choisir des outils DataOps
Il est facile de se perdre dans de longues listes de fonctionnalités et des structures tarifaires complexes. Pour vous aider à rester concentré pendant votre processus unique de sélection de logiciels, voici une liste des facteurs à garder à l’esprit :
| Facteur | Éléments à prendre en compte |
| Évolutivité | Assurez-vous que l'outil peut évoluer avec vos besoins en matière de données. Recherchez des fonctionnalités prenant en charge les grands ensembles de données et l'augmentation du nombre d'utilisateurs. |
| Intégrations | Vérifiez la compatibilité avec les systèmes existants. Vérifiez s'il prend en charge les API, les bases de données et les applications tierces que vous utilisez déjà. |
| Personnalisation | Évaluez dans quelle mesure l'outil s'adapte à vos processus. Recherchez des options permettant d'adapter les tableaux de bord, les flux de travail et les rapports. |
| Facilité d'utilisation | Évaluez l'interface utilisateur et la courbe d'apprentissage. Votre équipe doit la trouver intuitive et pouvoir l'adopter rapidement. |
| Budget | Évaluez le coût total, y compris les frais cachés. Comparez les formules tarifaires pour vous assurer qu'elles correspondent à vos contraintes financières. |
| Mesures de sécurité | Analysez les fonctionnalités de sécurité de l'outil. Assurez-vous qu'il respecte les normes de protection des données et qu'il propose un chiffrement. |
| Services d'assistance | Vérifiez la disponibilité du support client. Recherchez une assistance 24 h/24 et 7 j/7, de la documentation et des ressources de formation. |
| Performances | Testez la vitesse et la fiabilité de l'outil. Il doit traiter les données efficacement, sans ralentissements. |
Tendances des outils DataOps
Dans le cadre de mes recherches, j'ai consulté d'innombrables mises à jour de produits, communiqués de presse et journaux de versions provenant de différents fournisseurs d'outils DataOps. Voici quelques-unes des tendances émergentes que je surveille :
- Informations basées sur l'IA : De plus en plus d'outils utilisent l'IA pour fournir des analyses prédictives et des informations. Cela aide les équipes à anticiper les problèmes et à optimiser les processus. Des fournisseurs comme Alteryx intègrent l'IA afin d'améliorer les capacités d'analyse des données.
- Traitement des données en temps réel : La demande de traitement des données en temps réel augmente. Cela permet aux entreprises de prendre plus rapidement des décisions fondées sur des informations à jour. Des outils comme StreamSets se concentrent sur le déplacement des données en temps réel pour répondre à ce besoin.
- Amélioration de la gouvernance des données : Les entreprises se concentrent sur l'amélioration des fonctionnalités de gouvernance des données. Cela garantit la conformité aux réglementations et améliore la qualité des données. La plateforme DataOps d'IBM propose de solides outils de gouvernance pour répondre à ces enjeux.
- Fonctionnalités en libre-service : On observe une évolution vers l'autonomisation des utilisateurs non techniques grâce à des options en libre-service. Cela rend les tâches liées aux données plus accessibles à l'ensemble des équipes. Talend ajoute des fonctionnalités en libre-service afin de simplifier l'intégration des données.
- Architectures natives du cloud : De plus en plus d'outils sont conçus pour les environnements cloud. Cela offre davantage de flexibilité et d'évolutivité aux entreprises qui gèrent de grands ensembles de données. Azure Data Factory illustre cette tendance avec ses services d'intégration de données natifs du cloud.
Que sont les outils DataOps ?
Les outils DataOps sont des solutions logicielles conçues pour automatiser et améliorer les processus de gestion des données. Les ingénieurs de données, les analystes et les professionnels de l'informatique utilisent généralement ces outils pour améliorer la qualité, la gouvernance et l'intégration des données.
Le traitement en temps réel, les informations basées sur l'IA et les fonctionnalités en libre-service contribuent à optimiser les flux de travail, à garantir la conformité et à rendre les données accessibles. Associées à de puissants outils d'observabilité des données, ces solutions améliorent l'efficacité et la précision des opérations liées aux données, au bénéfice des entreprises, en leur permettant de prendre de meilleures décisions.
Fonctionnalités des outils DataOps
Lors de la sélection d'outils DataOps, prêtez attention aux principales fonctionnalités suivantes :
- Traitement des données en temps réel : Cela permet d'analyser immédiatement les données et aux entreprises de prendre rapidement des décisions fondées sur des informations actuelles.
- Informations basées sur l'IA : Elles fournissent des analyses prédictives, aidant les équipes à anticiper les problèmes et à optimiser les processus de données.
- Gouvernance des données : Elle garantit la conformité aux réglementations et préserve la qualité des données dans l'ensemble des opérations.
- Fonctionnalités en libre-service : Elles permettent aux utilisateurs non techniques de gérer leurs tâches liées aux données de manière autonome, améliorant ainsi l'accessibilité.
- Architecture native du cloud : Elle offre flexibilité et évolutivité pour gérer de grands ensembles de données dans des environnements cloud.
- Flux de travail automatisés : Ils rationalisent les tâches de gestion des données, réduisant les efforts manuels et limitant les erreurs.
- Tableaux de bord personnalisables : Ils permettent aux utilisateurs d'adapter la visualisation des données à leurs besoins spécifiques, améliorant ainsi leur compréhension.
- Suivi de la traçabilité des données : Il garantit la transparence en indiquant l'origine et les transformations des données, assurant ainsi leur exactitude.
- Prise en charge des intégrations : Elle facilite la circulation fluide des données entre différents systèmes et applications, améliorant ainsi la compatibilité.
- Gestion des erreurs : Elle identifie et résout rapidement les problèmes, réduisant au minimum les interruptions du traitement des données.
Avantages des outils DataOps
La mise en œuvre d'outils DataOps offre plusieurs avantages à votre équipe et à votre entreprise. Voici quelques bénéfices auxquels vous pouvez vous attendre :
- Qualité des données améliorée : Les flux de travail automatisés et la gouvernance des données garantissent l’exactitude et la fiabilité de vos données.
- Prise de décision accélérée : Le traitement des données en temps réel permet à votre équipe d’exploiter les informations les plus récentes sans délai.
- Conformité renforcée : Les fonctionnalités robustes de gouvernance des données aident votre entreprise à respecter facilement les exigences réglementaires.
- Accessibilité accrue : Les outils de catalogue de données dotés de fonctionnalités en libre-service permettent aux utilisateurs non techniques de gérer les tâches liées aux données, élargissant ainsi leur accès.
- Évolutivité : L’architecture native du cloud répond à vos besoins croissants en données sans compromettre les performances.
- Réduction des tâches manuelles : La gestion automatisée des erreurs et les flux de travail automatisés réduisent les tâches répétitives et libèrent du temps pour votre équipe.
- Meilleure collaboration : Les tableaux de bord personnalisables et les informations en temps réel favorisent le travail d’équipe et une prise de décision éclairée.
Coûts et tarification des outils DataOps
Le choix d’outils DataOps nécessite de comprendre les différents modèles tarifaires et forfaits disponibles. Les coûts varient en fonction des fonctionnalités, de la taille de l’équipe, des modules complémentaires et d’autres facteurs. Les plateformes populaires vont des solutions natives du cloud aux alternatives à Databricks spécialisées dans les flux de travail unifiés d’analyse et d’apprentissage automatique. Le tableau ci-dessous récapitule les forfaits courants, leurs prix moyens et les fonctionnalités généralement incluses dans les solutions d’outils DataOps :
Tableau comparatif des forfaits pour les outils DataOps
| Type de forfait | Prix moyen | Fonctionnalités courantes |
| Forfait gratuit | $0 | Intégration de données de base, stockage limité et assistance de la communauté. |
| Forfait personnel | $10-$30/utilisateur/mois | Intégration de données, analyses de base, automatisation limitée et assistance par e-mail. |
| Forfait professionnel | $50-$100/utilisateur/mois | Analyses avancées, automatisation, gouvernance des données et assistance prioritaire. |
| Forfait entreprise | $150-$300/utilisateur/mois | Intégrations personnalisées, automatisation complète, sécurité renforcée et assistance dédiée. |
Outils DataOps : FAQ
Voici quelques réponses aux questions courantes sur les outils DataOps :
Quels sont les éléments importants à prendre en compte pour la mise en œuvre de DataOps ?
Lors de la mise en œuvre de DataOps, vous devez constituer des équipes transversales afin d’améliorer la collaboration entre les ingénieurs de données, les développeurs et les analystes. Choisissez les bons outils adaptés à vos besoins et établissez des processus clairs pour votre équipe. Automatisez les tâches répétitives pour gagner du temps, puis surveillez et faites évoluer continuellement vos processus.
Quels sont les trois pipelines de DataOps ?
DataOps implique généralement trois pipelines : Production, Développement et Environnement. Chacun remplit une fonction précise dans la gestion des flux de données. Les pipelines de production traitent les données en temps réel, les pipelines de développement se concentrent sur les tests et la création, tandis que les pipelines d’environnement gèrent les configurations. Leur compréhension contribue à orchestrer des flux de travail efficaces.
Quelle est la différence entre DataOps et DevOps ?
Alors que DevOps se concentre sur l’unification des équipes de développement et des opérations pour la livraison de logiciels, DataOps vise à éliminer les silos entre les producteurs et les consommateurs de données. L’objectif est de rendre les données plus accessibles et plus utiles. DataOps met l’accent sur la collaboration entre les équipes chargées des données afin d’améliorer leur gestion et leur utilisation.
Quels sont les principaux avantages de l'automatisation des tâches DataOps ?
L’automatisation des tâches DataOps peut considérablement améliorer l’efficacité en réduisant les efforts manuels. Ces outils DevOps de bases de données garantissent la cohérence des processus liés aux données et vous aident à maintenir leur qualité. L’automatisation permet également à votre équipe de se concentrer sur des tâches plus stratégiques, ce qui améliore la productivité et accélère la prise de décision.
Comment les outils DataOps soutiennent-ils la gouvernance des données ?
Les outils DataOps proposent des fonctionnalités qui contribuent à faire respecter les politiques de gouvernance des données. Ils offrent une visibilité sur les processus liés aux données et garantissent ainsi la conformité aux réglementations. En suivant la traçabilité des données et en fournissant des journaux d’audit, ces outils contribuent à préserver l’intégrité et la transparence des données dans toute votre organisation.
Pourquoi le traitement des données en temps réel est-il important dans DataOps ?
Le traitement des données en temps réel permet à votre équipe d’accéder aux données les plus récentes et de prendre rapidement des décisions. Il répond aux besoins évolutifs de l’entreprise en fournissant des informations actualisées. Cette capacité est essentielle pour les secteurs dans lesquels l’accès rapide aux données est déterminant pour rester compétitif et réagir aux évolutions du marché.
Quelle est la prochaine étape ?
Développez votre croissance et vos compétences en leadership dans le domaine du SaaS.
Abonnez-vous à notre newsletter pour découvrir les dernières informations des CTO et des leaders technologiques en devenir.
Nous vous aiderons à développer votre activité plus intelligemment et à renforcer votre leadership grâce à des guides, des ressources et des stratégies proposés par les meilleurs experts !