

Les 10 meilleurs outils ETL open source évalués en 2026

Sélection des meilleurs outils ETL open source


Les meilleurs outils ETL open source aident les équipes à automatiser l’extraction, la transformation et le chargement des données afin de maintenir des jeux de données précis et cohérents entre les systèmes. Ils facilitent la gestion de sources de données complexes, l’application de transformations à grande échelle et la réduction des efforts manuels liés à la gestion des pipelines.
Lorsque les pipelines reposent sur des scripts personnalisés, que les modifications de schéma provoquent des échecs silencieux ou que les équipes manquent de visibilité sur la circulation des données entre les systèmes, la qualité et la fiabilité des données peuvent diminuer. Ces problèmes ralentissent les analyses, augmentent le temps consacré à la maintenance et créent des frictions entre les équipes d’ingénierie et de données.
Fort de plus de 20 ans d’expérience dans le secteur en tant que directeur technique, j’ai testé et évalué des dizaines d’outils ETL open source afin d’analyser leurs performances, la qualité de leurs intégrations et leur facilité d’utilisation. Ce guide présente les meilleures options pour prendre en charge des flux de travail évolutifs et des opérations de données plus prévisibles. Chaque évaluation couvre les fonctionnalités, les avantages et les inconvénients, ainsi que les cas d’utilisation les mieux adaptés, afin de vous aider à choisir l’outil approprié.
Pourquoi faire confiance à nos avis logiciels
Nous testons et analysons des logiciels depuis 2023. En tant que dirigeants technologiques, nous savons à quel point il est crucial et difficile de faire le bon choix lors de la sélection d’un logiciel.
Nous investissons dans des recherches approfondies pour aider notre audience à prendre de meilleures décisions d’achat de logiciels. Nous avons testé plus de 2 000 outils pour différents usages technologiques et rédigé plus de 1 000 avis complets. Découvrez comment nous restons transparents & notre méthodologie d’évaluation des logiciels.
Résumé des meilleurs outils ETL open source
Ce tableau comparatif récapitule les informations tarifaires de ma sélection des meilleurs outils ETL open source afin de vous aider à trouver celui qui correspond le mieux à votre budget et aux besoins de votre entreprise.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Idéal pour les tâches de données complexes | Essai gratuit disponible | À partir de $5,500/unité/an | Website | |
| 2 | Idéal pour le traitement des données de logs | Essai gratuit disponible | À partir de 95 $/mois | Website | |
| 3 | Idéal pour le scripting ETL en Python | Not available | Gratuit à utiliser | Website | |
| 4 | Idéal pour la transformation de données | Essai gratuit de 30 jours | À partir de $4/utilisateur/mois | Website | |
| 5 | Idéal pour les modèles d'intégration | Gratuit à utiliser | Website | ||
| 6 | Idéal pour l’intégration automatisée de données | Essai gratuit de 14 jours + démo gratuite | À partir de $239/mois | Website | |
| 7 | Idéal pour les modèles d'intégration | Not available | Gratuit à utiliser | Website | |
| 8 | Idéal pour le streaming de données en temps réel | Offre gratuite disponible | Gratuit | Website | |
| 9 | Idéal pour l'automatisation des flux de données | Not available | Gratuit à utiliser | Website | |
| 10 | Idéal pour des solutions ETL évolutives | Offre gratuite disponible | Gratuit | Website |
Évaluation des meilleurs outils ETL open source
Vous trouverez ci-dessous mes résumés détaillés des meilleurs outils ETL open source qui figurent dans ma sélection. Mes évaluations proposent un examen approfondi des principales fonctionnalités, des avantages & inconvénients, des intégrations et des cas d’utilisation idéaux de chaque outil afin de vous aider à trouver celui qui vous convient le mieux.
CloverDX
Idéal pour les tâches de données complexes
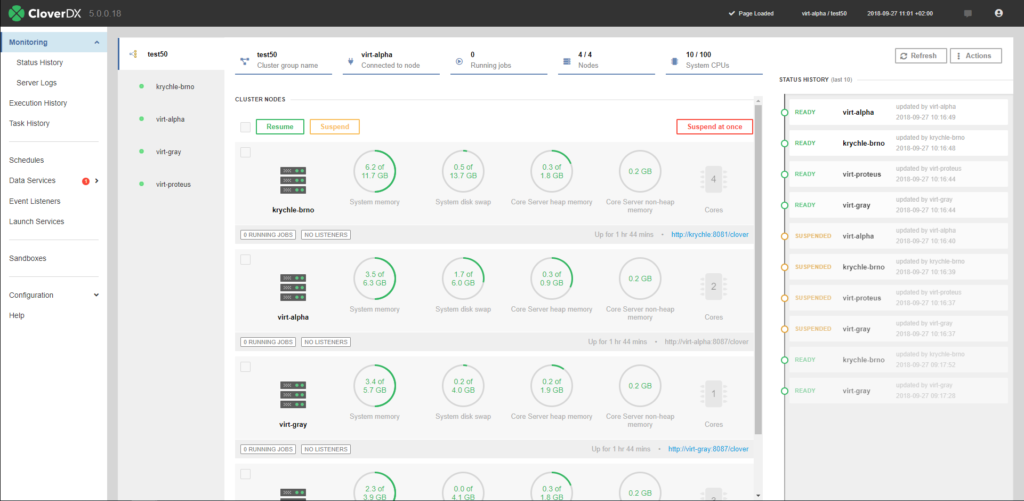
CloverDX est une plateforme d'intégration de données qui s'adresse aux utilisateurs métier et aux équipes informatiques en automatisant, orchestrant et transformant les données. Elle prend en charge diverses options de déploiement, ce qui la rend polyvalente pour différents besoins professionnels.
Pourquoi j'ai choisi CloverDX : CloverDX est conçue pour les tâches de données complexes grâce à son interface intuitive et ses options de déploiement flexibles, incluant sur site et les services cloud tels qu'AWS, Azure et Google Cloud. Elle propose des services de données pour l'accès API et des outils de collaboration, permettant à votre équipe de travailler efficacement dans différents environnements. L'intégration d'un catalogue de données assure un accès fiable aux données, ce qui est essentiel pour maintenir l'intégrité des informations. Ces fonctionnalités font de CloverDX un choix remarquable pour les équipes traitant des processus de données complexes.
Fonctionnalités et intégrations remarquables :
Fonctionnalités incluent une interface intuitive pour les utilisateurs métier, des services de données pour l'accès API, et un catalogue de données pour un accès fiable aux informations. Ces éléments garantissent une gestion et un accès efficaces aux données. La plateforme propose également des outils de collaboration pour renforcer le travail d'équipe.
Intégrations incluent AWS, Azure, Google Cloud, Snowflake, Salesforce, Microsoft SQL Server, Oracle, PostgreSQL, MongoDB et Kafka.
Pros and Cons
Pros:
- Prend en charge des processus de données complexes
- Options de déploiement polyvalentes
- Capacités solides d'accès API
Cons:
- Courbe d'apprentissage potentiellement raide
- Nécessite une expertise technique

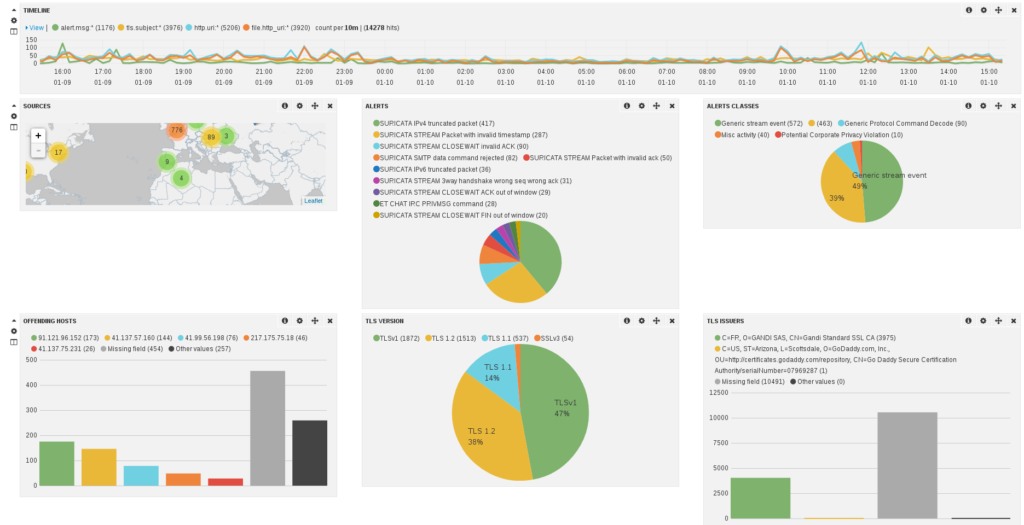
Logstash est un pipeline de traitement de données open source permettant aux développeurs et aux équipes informatiques de collecter, transformer et stocker les journaux provenant de différentes sources. Il est conçu pour gérer de grands volumes de données de journalisation, ce qui le rend idéal pour les organisations cherchant à centraliser et analyser leurs informations de logs.
Pourquoi j’ai choisi Logstash : Logstash excelle dans le traitement des données de logs, offrant une architecture de pipeline flexible qui permet d’agréger les journaux issus de sources multiples. L’outil propose des capacités de filtrage et de transformation puissantes, offrant à votre équipe la possibilité d’adapter les données selon des besoins spécifiques. Le traitement en temps réel de Logstash garantit que vos données de logs sont toujours à jour et exploitables. Sa compatibilité avec Elasticsearch et Kibana en fait un excellent choix pour les utilisateurs de la suite Elastic Stack.
Fonctionnalités et intégrations remarquables :
Fonctionnalités : architecture de pipeline flexible prenant en charge des transformations complexes, permettant de personnaliser le traitement des logs. Les capacités de traitement en temps réel assurent une actualisation constante des données de journalisation. L’outil offre également des options de filtrage robustes pour ajuster les données à vos besoins spécifiques.
Intégrations : Elasticsearch, Kibana, Beats, AWS, Azure, Google Cloud, Kafka, RabbitMQ, JDBC et Redis.
Pros and Cons
Pros:
- Gère de gros volumes de logs
- Traitement des données en temps réel
- Architecture de pipeline flexible
Cons:
- Peut être gourmand en ressources
- Analytique intégrée limitée

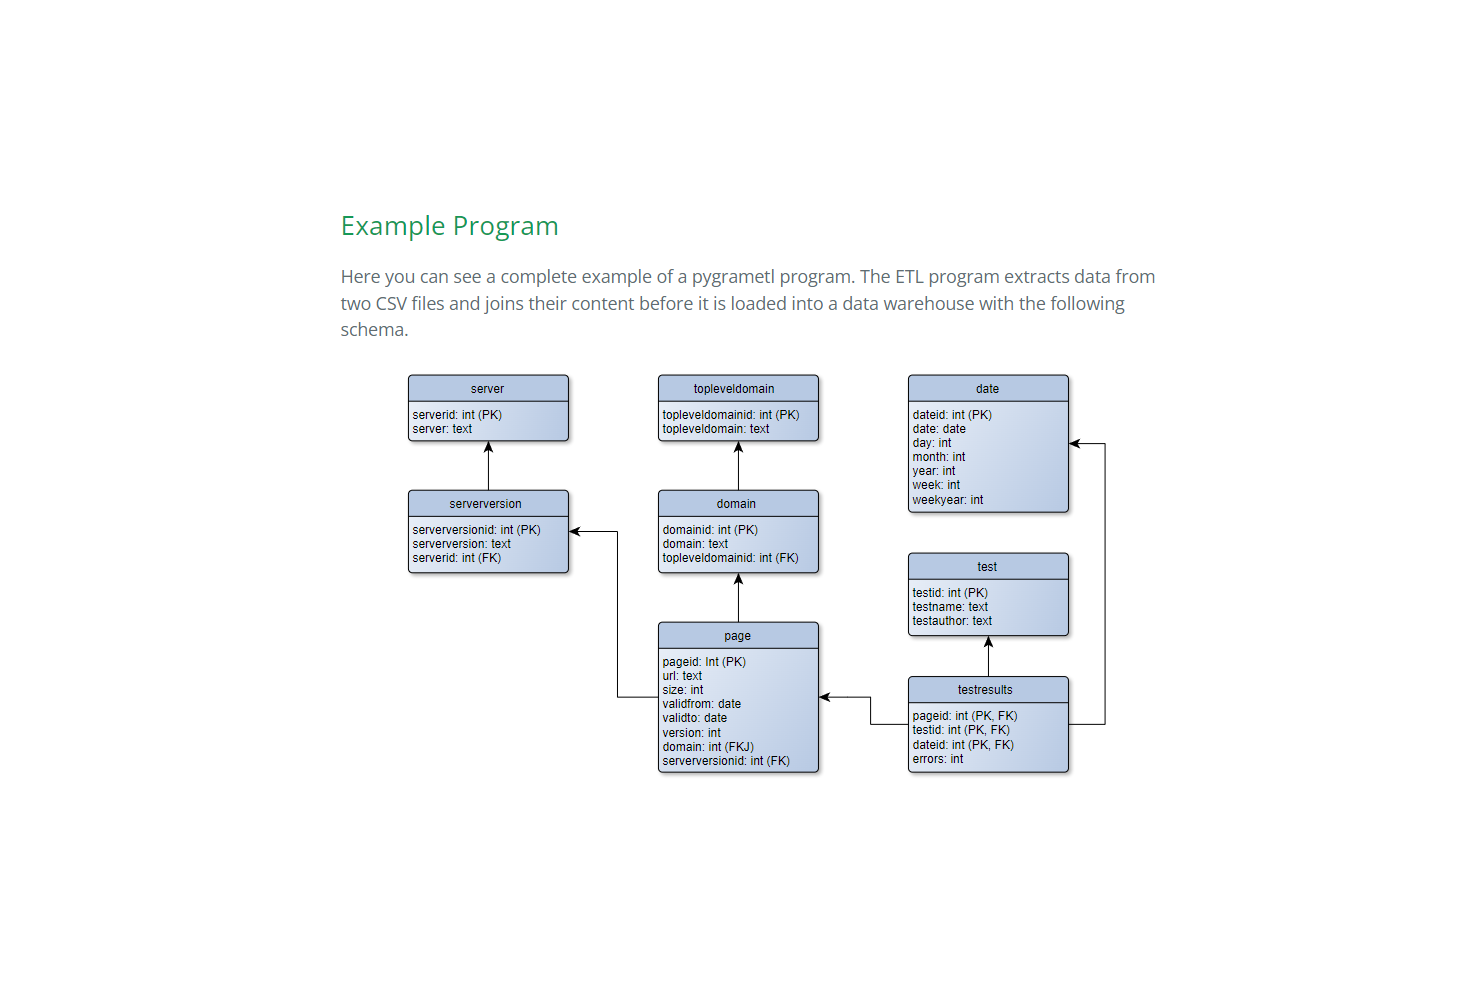
pygrametl est un framework open source en Python pour développer des processus ETL. Il a été conçu comme une alternative aux programmes BI graphiques tout en offrant la même facilité d'utilisation. Il prend en charge CPython et Jython, permettant ainsi aux développeurs ETL d'utiliser du code Java existant et des pilotes JDBC.
Les développeurs peuvent extraire des données à partir de nombreuses sources disponibles dans pygrametl, telles que SQL, CSV et Pandas. Les utilisateurs peuvent également définir leurs propres sources de données. La plateforme propose des filtres et des agrégateurs pour transformer les données. Parmi les agrégateurs par défaut, on trouve AVG, Count, CountDistinct, Max, Min et Sum.
pygrametl peut charger les données transformées dans tout entrepôt de données prenant en charge la modélisation dimensionnelle. Le système fournit des structures pour définir des tables de faits et des dimensions, y compris des dimensions à évolution lente et des dimensions en flocon de neige.
Les développeurs peuvent télécharger pygrametl gratuitement.

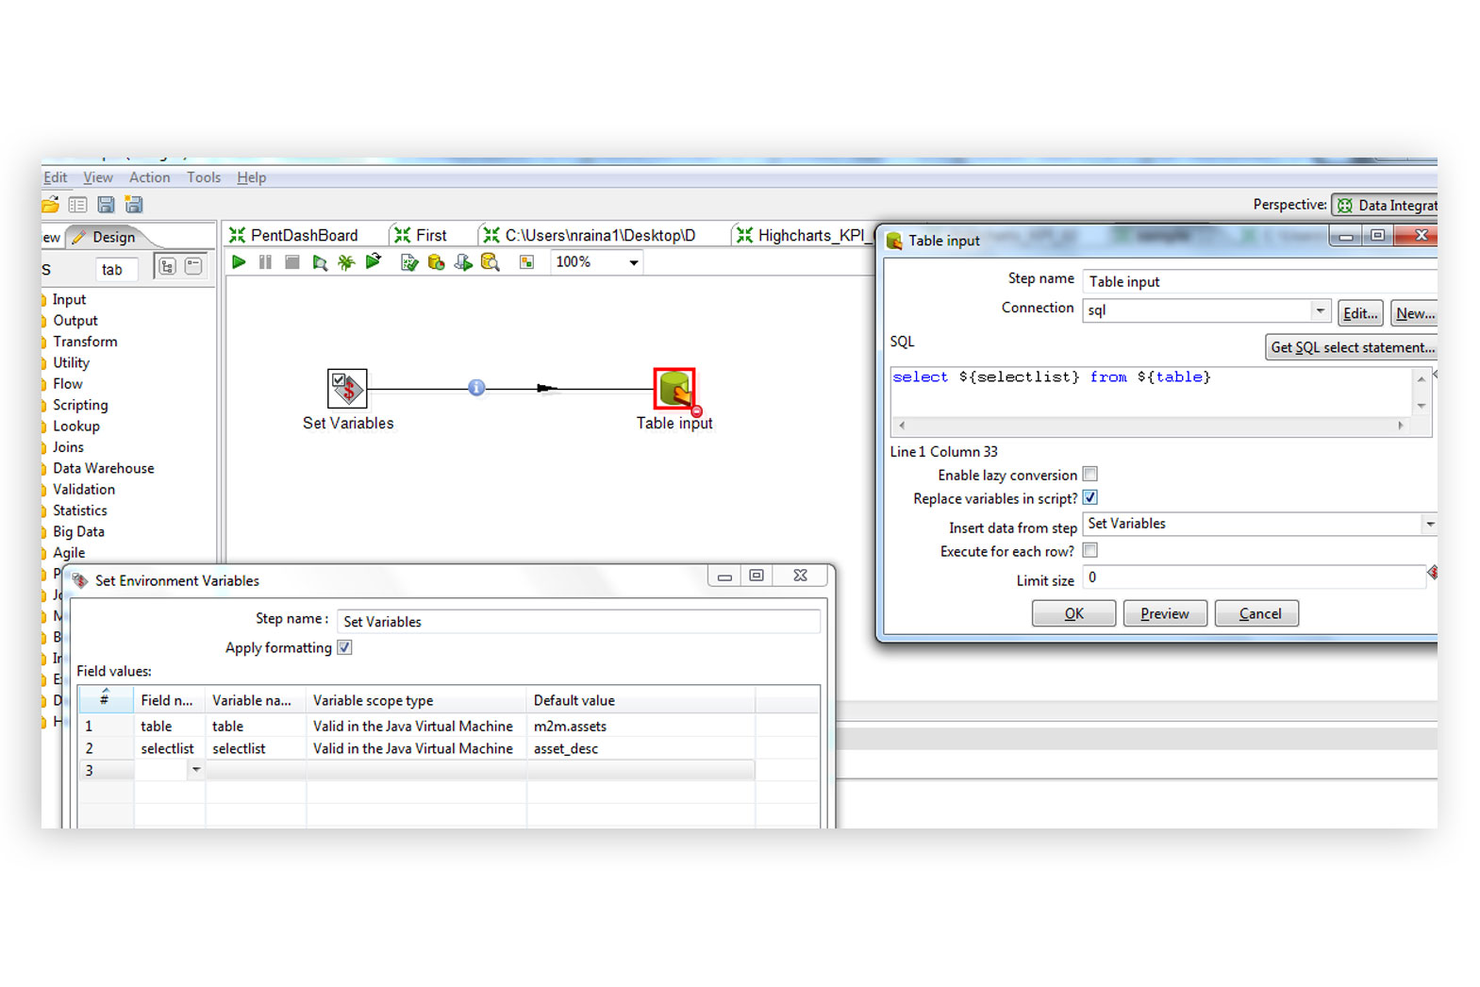
Pentaho Kettle est un outil ETL open-source destiné aux ingénieurs de données et aux analystes métiers ayant besoin d'effectuer des transformations de données complexes. Il propose une interface visuelle pour concevoir des pipelines de données, facilitant ainsi la gestion des flux de données et l'exécution efficace des transformations.
Pourquoi j'ai choisi Pentaho Kettle : Il est reconnu pour ses capacités de transformation de données, offrant une interface visuelle de type glisser-déposer qui simplifie la création de workflows complexes. Kettle propose un support étendu pour de nombreuses sources de données, permettant à votre équipe d'intégrer des données depuis de multiples origines. Son interface graphique réduit la nécessité de coder en profondeur, ce qui est avantageux pour les équipes avec peu de compétences en programmation. La flexibilité de l'outil dans la gestion de différents types et formats de données en fait un choix polyvalent pour divers besoins métiers.
Fonctionnalités remarquables & intégrations :
Fonctionnalités : interface visuelle de type glisser-déposer, simplifiant la création de workflows et permettant de construire des transformations de données complexes sans coder. L'outil accepte un large éventail de sources de données, rendant l'intégration aisée. La flexibilité de Kettle dans la gestion de multiples types et formats de données assure la compatibilité avec des environnements de données variés.
Intégrations : Oracle, MySQL, PostgreSQL, Microsoft SQL Server, MongoDB, Amazon Redshift, Google BigQuery, Salesforce, SAP et Hadoop.
Pros and Cons
Pros:
- Interface visuelle pour les transformations
- Gère différents types de données
- Support étendu des sources de données
Cons:
- Peut être gourmand en ressources
- Configuration initiale complexe

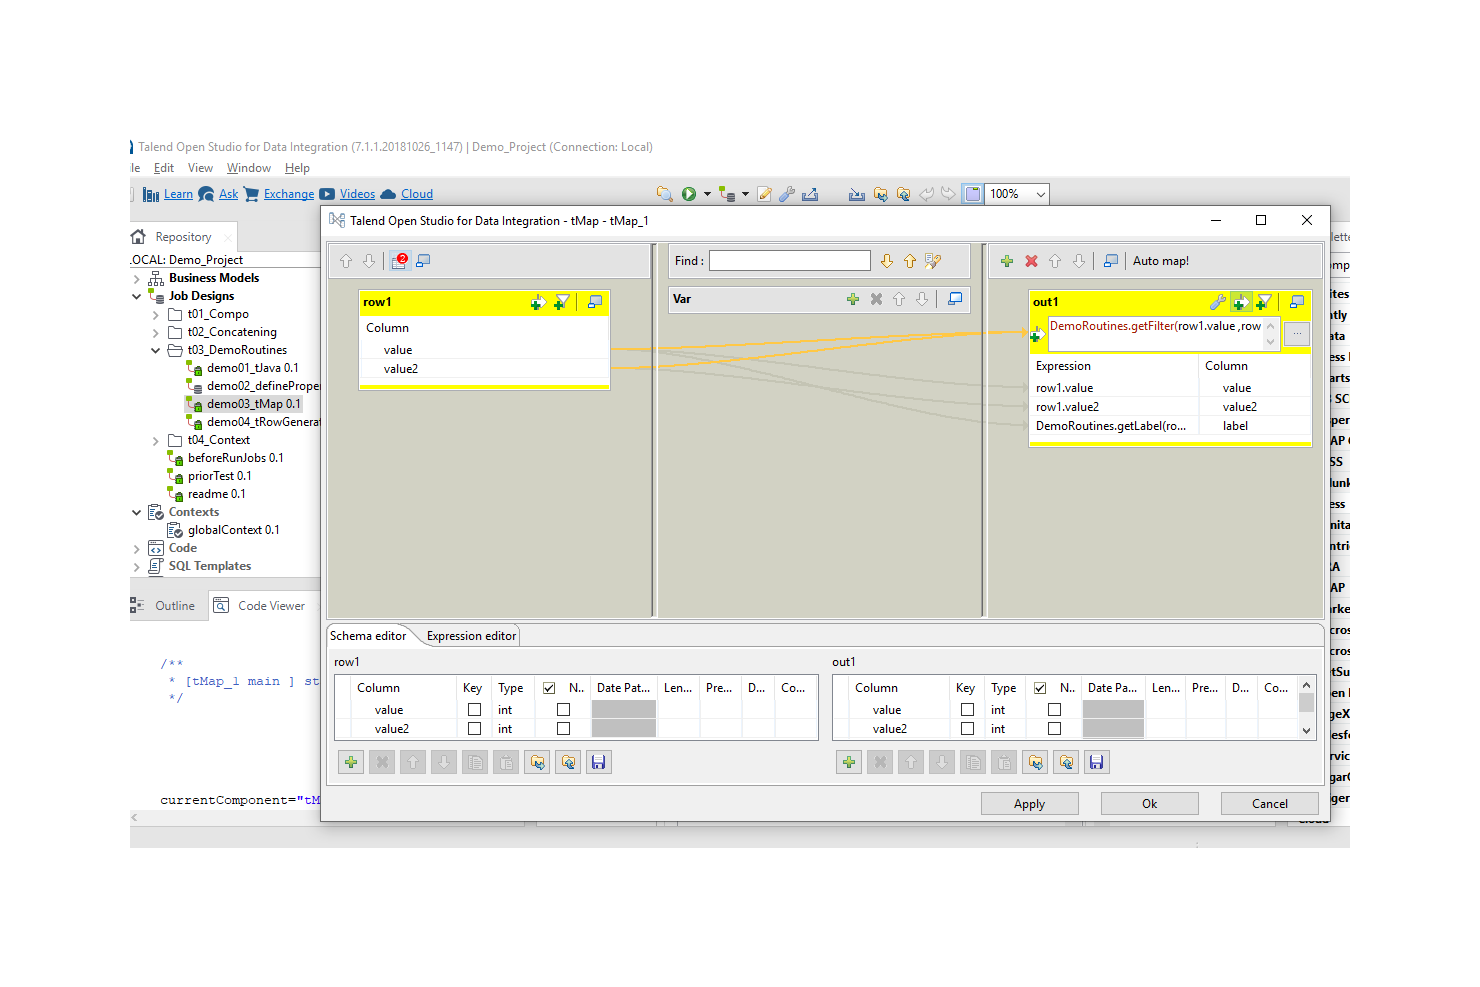
Apache Camel est un framework d'intégration open-source conçu pour les développeurs et architectes ayant besoin de mettre en œuvre des modèles d'intégration d'entreprise. Il facilite le routage et la médiation des messages entre systèmes, ce qui le rend idéal pour des scénarios d'intégration complexes.
Pourquoi j'ai choisi Apache Camel : Il excelle dans l'utilisation de modèles d'intégration pour simplifier la connectivité entre différents systèmes. Camel prend en charge un large éventail de protocoles et de formats de données, garantissant à votre équipe une connexion aisée entre des systèmes disparates. Son langage spécifique au domaine (DSL) offre une façon flexible de définir des règles de routage et de médiation, ce qui est crucial pour gérer des intégrations complexes. La capacité de l'outil à s'intégrer à divers points de terminaison offre une polyvalence inégalée dans la conception de solutions d'intégration.
Fonctionnalités et intégrations remarquables :
Fonctionnalités propose un ensemble riche de modèles d'intégration d'entreprise qui simplifient le processus d'intégration. Le langage spécifique au domaine de l'outil vous permet de définir facilement des règles de routage complexes. Apache Camel prend également en charge une large gamme de formats de données et de protocoles, ce qui assure la compatibilité avec de nombreux systèmes.
Intégrations incluent AWS, Apache Kafka, ActiveMQ, RabbitMQ, Salesforce, Google Cloud, Azure, JMS, File et FTP.
Pros and Cons
Pros:
- Nombreux modèles d'intégration
- Large prise en charge des formats de données
- Intégration polyvalente des points de terminaison
Cons:
- La documentation peut être limitée
- Consomme beaucoup de ressources pour les grandes installations

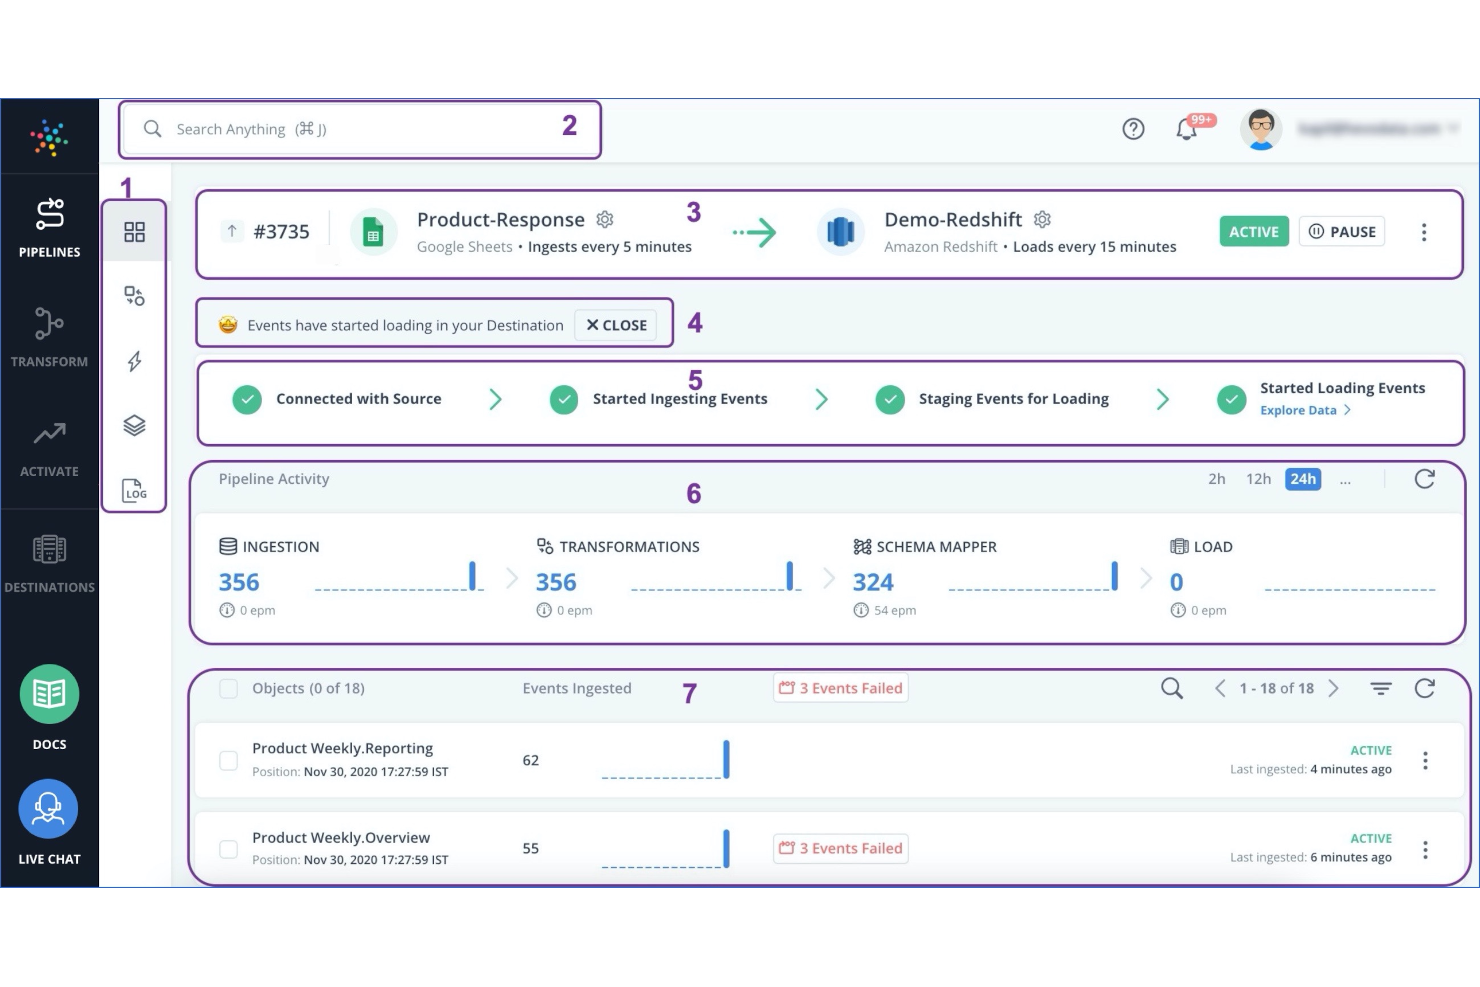
Hevo Data est une plateforme ETL et d’intégration de données destinée aux équipes data à la recherche de pipelines de données fiables et automatisés. Elle facilite l’ingestion de données provenant de diverses sources avec une configuration minimale et sans programmation, améliorant ainsi la précision des données et la prise de décision.
Pourquoi j’ai choisi Hevo Data : Elle se distingue par l’intégration automatisée des données, avec des fonctionnalités telles que la surveillance en temps réel des pipelines et la réplication rapide des données, garantissant à votre équipe des informations à jour avec un minimum d’efforts. Les fonctions de conformité et de sécurité de Hevo offrent une tranquillité d’esprit, en particulier pour les utilisateurs en entreprise. La tarification transparente de la plateforme signifie qu’il n’y a pas de frais cachés, ce qui est un grand avantage pour la gestion des budgets. Son interface conviviale permet de gérer facilement les données sans connaissances approfondies en programmation.
Fonctionnalités et intégrations remarquables :
Fonctionnalités : surveillance en temps réel des pipelines pour maintenir la fraîcheur des données, options de gestion avancées pour un meilleur contrôle, et fonctions de conformité et de sécurité pour protéger les données sensibles. Ces caractéristiques aident votre équipe à travailler efficacement et en toute sécurité. Hevo propose également une réplication rapide des données pour garantir la cohérence des informations.
Intégrations : incluent Salesforce, Google Analytics, Amazon Redshift, Snowflake, BigQuery, MySQL, PostgreSQL, Oracle, MS SQL Server, et HubSpot.
Pros and Cons
Pros:
- Intégration automatisée des données
- Surveillance en temps réel
- Réplication rapide
Cons:
- Options de personnalisation limitées
- Ne convient pas à tous les types de données

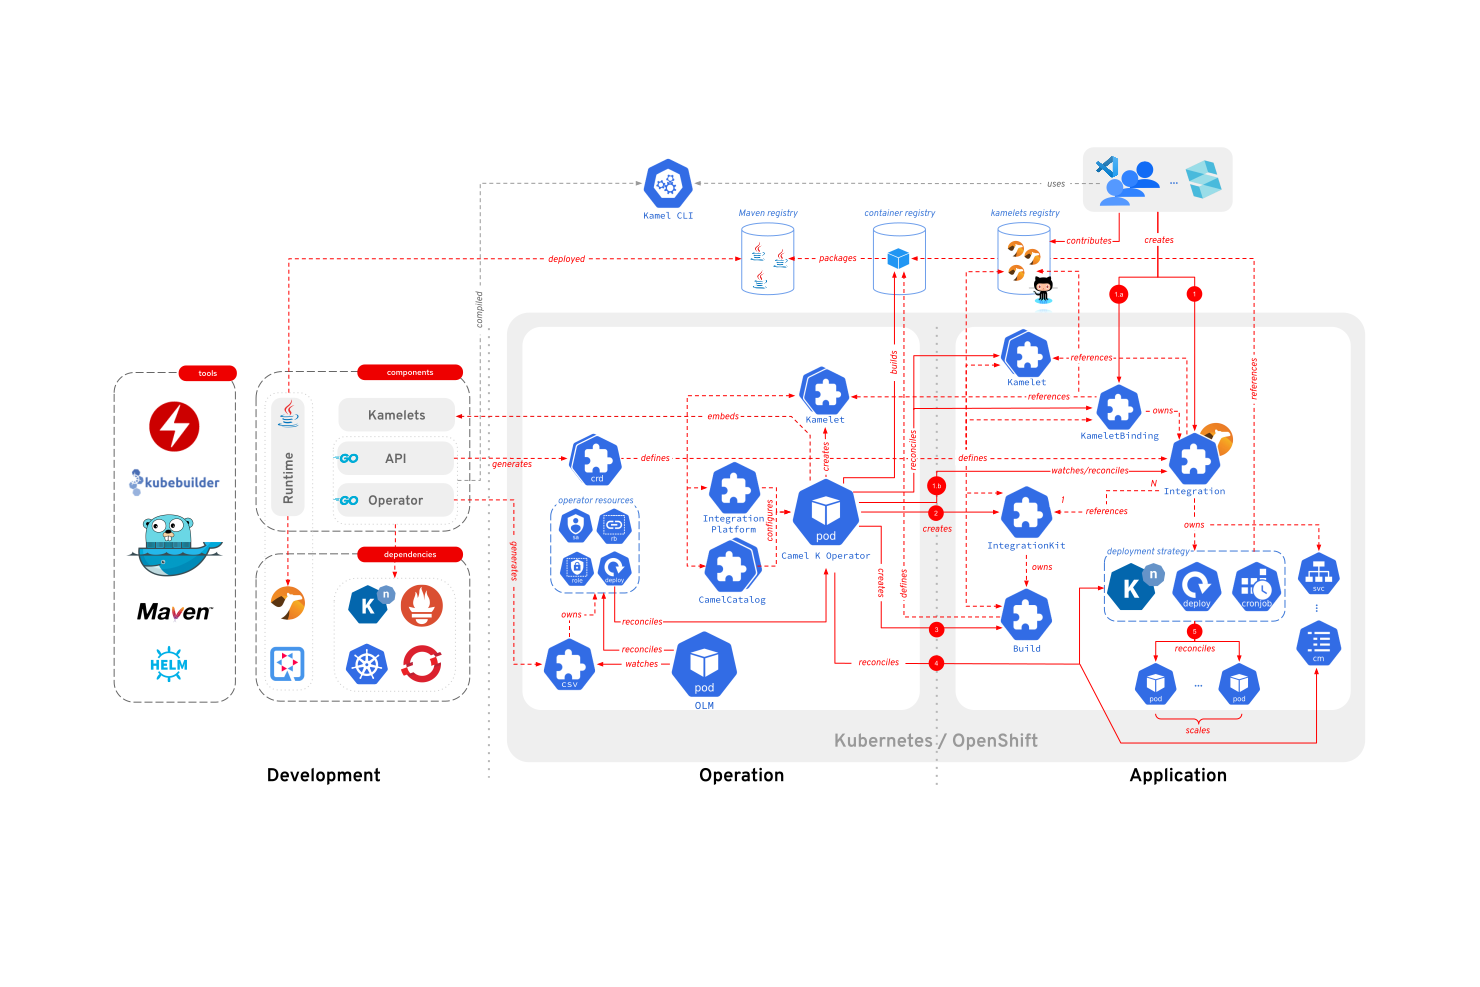
Apache Camel est un framework d'intégration open source conçu pour les développeurs et les architectes qui doivent mettre en œuvre des modèles d'intégration d'entreprise. Il facilite le routage et la médiation des messages entre les systèmes, ce qui le rend idéal pour des scénarios d'intégration complexes.
Pourquoi j'ai choisi Apache Camel : Il excelle dans l'utilisation de modèles d'intégration pour simplifier la connectivité entre différents systèmes. Camel prend en charge une large gamme de protocoles et de formats de données, assurant à votre équipe de pouvoir connecter facilement des systèmes disparates. Son langage spécifique au domaine (DSL) offre une manière flexible de définir les règles de routage et de médiation, ce qui est crucial pour le traitement des intégrations complexes. La capacité de l'outil à s'intégrer à divers points de terminaison offre une polyvalence inégalée dans la conception de solutions d'intégration.
Fonctionnalités phares & intégrations :
Fonctionnalités comprennent un ensemble riche de modèles d'intégration d'entreprise qui simplifient le processus d'intégration. Le langage spécifique au domaine de l'outil permet de définir facilement des règles de routage complexes. Apache Camel prend également en charge de nombreux formats de données et protocoles, garantissant la compatibilité avec plusieurs systèmes.
Intégrations comprennent AWS, Apache Kafka, ActiveMQ, RabbitMQ, Salesforce, Google Cloud, Azure, JMS, File et FTP.
Pros and Cons
Pros:
- Nombreux modèles d'intégration
- Large prise en charge des formats de données
- Intégration polyvalente des points de terminaison
Cons:
- La documentation peut être incomplète
- Consommateur de ressources pour les grandes installations

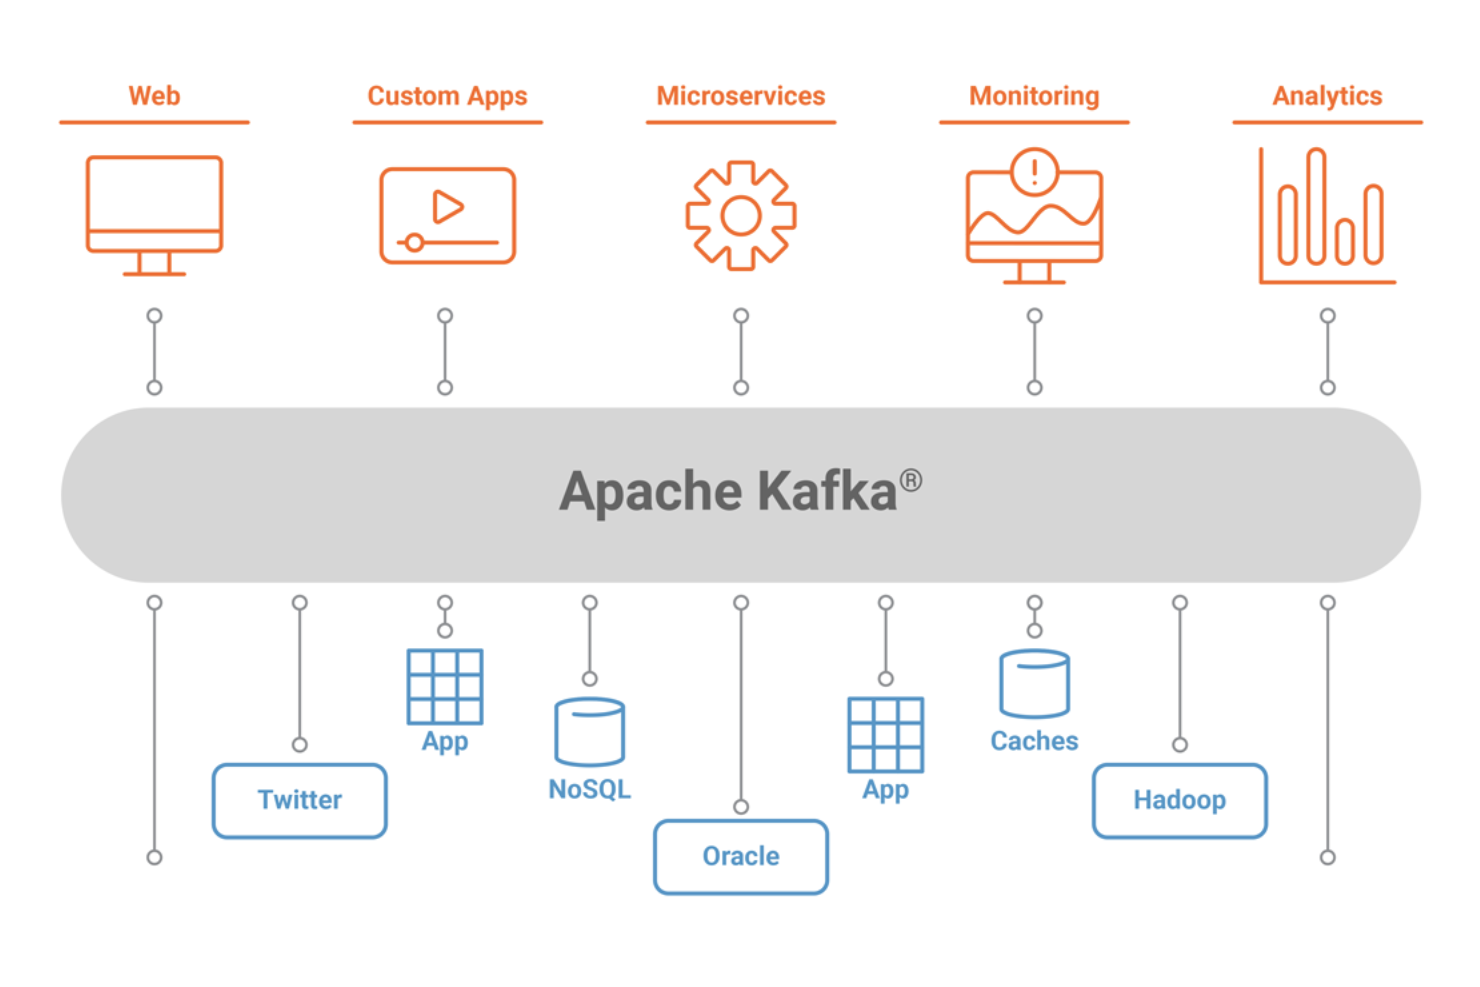
Apache Kafka est une plateforme de diffusion d'événements distribuée utilisée par les développeurs et les entreprises pour construire des pipelines de données en temps réel et des applications de streaming. Elle est conçue pour traiter de grands volumes de données rapidement et efficacement, ce qui la rend idéale pour les entreprises qui ont besoin de traitement de données en temps réel.
Pourquoi j'ai choisi Apache Kafka : Il est conçu pour le streaming de données en temps réel, prenant en charge un traitement à haut débit et à faible latence, ce qui est essentiel pour les applications modernes axées sur les données. L'architecture distribuée de Kafka garantit une haute disponibilité et une tolérance aux pannes, de sorte que vos données sont toujours accessibles. La scalabilité de la plateforme vous permet de gérer des besoins croissants en données sans compromettre les performances. Kafka offre également de fortes garanties de durabilité des données, assurant l'intégrité des données dans le temps.
Fonctionnalités et intégrations clés :
Fonctionnalités comprenant une architecture distribuée qui garantit une haute disponibilité, une réplication de données intégrée pour la tolérance aux pannes, et un système de messagerie robuste pour un traitement de données évolutif. Ces fonctionnalités le rendent particulièrement adapté à la gestion efficace de grands volumes de données. Le système de stockage basé sur les journaux (log) de Kafka garantit la durabilité et la fiabilité des données.
Intégrations : Confluent, AWS, Azure, Google Cloud, MongoDB, Cassandra, Elasticsearch, Splunk, Hadoop et MySQL.
Pros and Cons
Pros:
- Gère un haut débit de données
- Traitement à faible latence
- Forte durabilité des données
Cons:
- Surveillance intégrée limitée
- La configuration peut être complexe

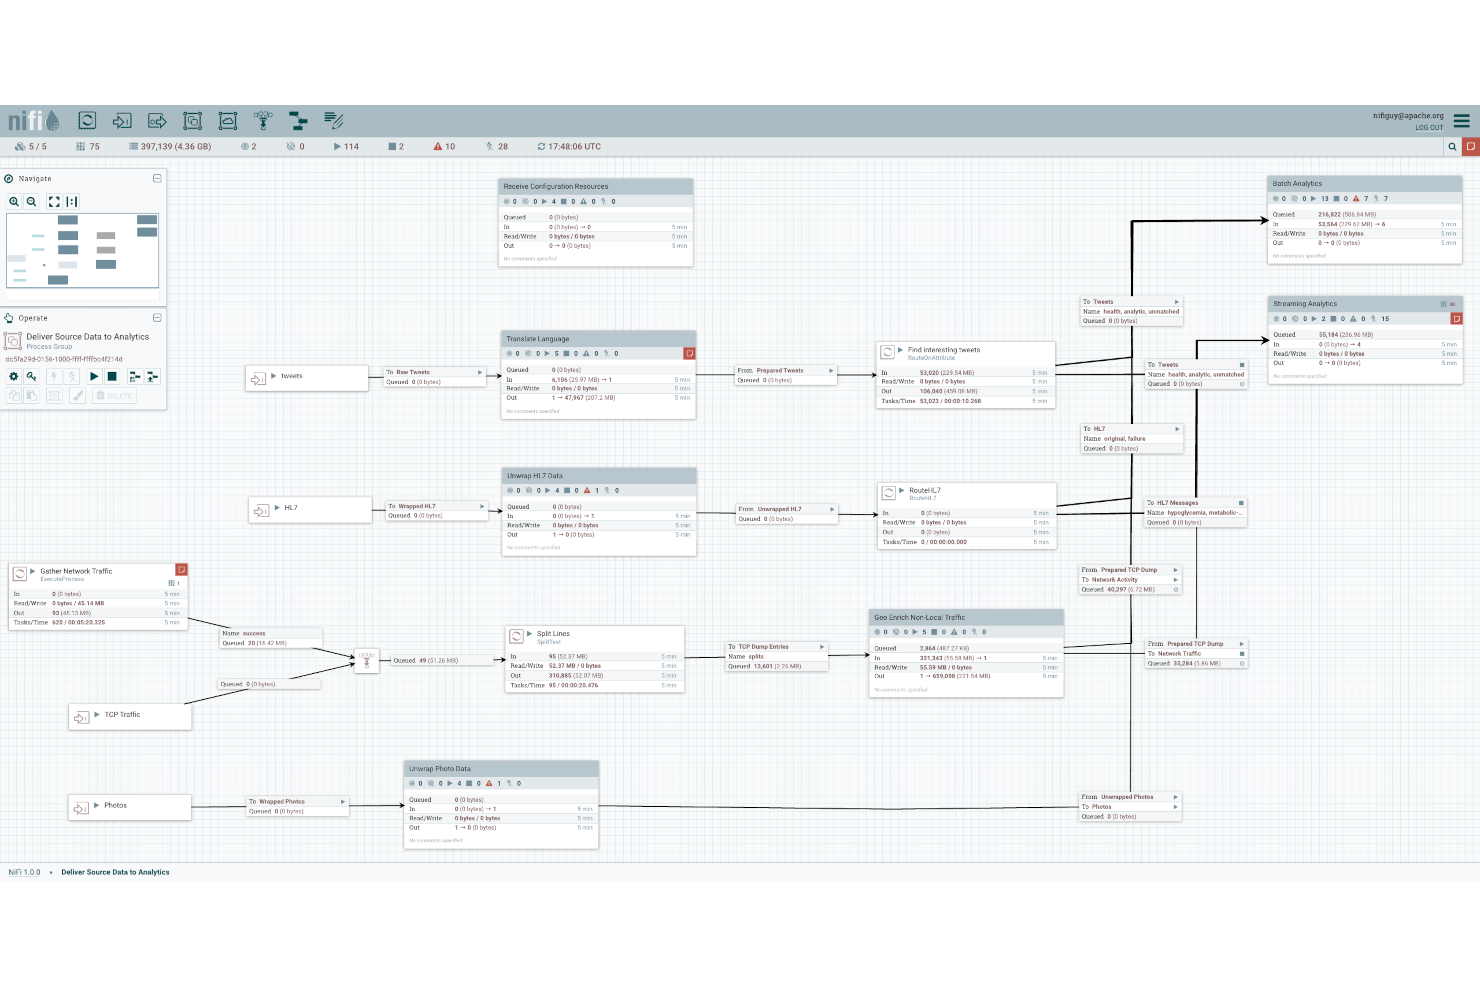
Apache NiFi est un outil d'intégration de données open-source conçu pour les développeurs et ingénieurs de données ayant besoin d'automatiser les flux de données. Il permet la collecte, le traitement et la distribution des données entre différents systèmes, ce qui le rend idéal pour la gestion de données en temps réel.
Pourquoi j'ai choisi Apache NiFi : Il est spécialement conçu pour l'automatisation des flux de données et propose une interface conviviale pour concevoir des workflows complexes. L'interface glisser-déposer de NiFi simplifie la création de pipelines de données, ce qui est essentiel pour les équipes qui ne disposent pas d'une vaste expérience en programmation. L'outil prend en charge la gestion des flux de données en temps réel, garantissant que vos données restent à jour et pertinentes. Ses fonctionnalités de sécurité intégrées offrent une couche de protection supplémentaire pour les données sensibles.
Fonctionnalités et intégrations remarquables :
Fonctionnalités comprennent une interface glisser-déposer qui simplifie la conception de workflows, permettant de créer facilement des pipelines de données. La gestion des flux de données en temps réel de NiFi garantit que vos informations sont toujours à jour. L'outil propose également des fonctionnalités de sécurité intégrées pour protéger vos informations sensibles.
Intégrations incluent AWS, Azure, Google Cloud, Kafka, HDFS, MongoDB, Elasticsearch, MySQL, PostgreSQL et JMS.
Pros and Cons
Pros:
- Automatise efficacement les flux de données
- Interface conviviale avec glisser-déposer
- Gestion des données en temps réel
Cons:
- Peut être gourmand en ressources
- Configuration initiale complexe

KETL est une plateforme ETL open-source conçue pour les ingénieurs de données et les professionnels de l'informatique qui ont besoin de solutions d'intégration et d'ordonnancement des données à grande échelle. Elle fournit une architecture multi-thread basée sur XML qui prend en charge des manipulations de données complexes, la rendant adaptée aux tâches de traitement de données volumineuses.
Pourquoi j'ai choisi KETL : Elle offre des solutions ETL évolutives grâce à sa capacité à gérer de grands volumes de données sur plusieurs serveurs et processeurs. Le gestionnaire d'exécution et d'ordonnancement des tâches de la plateforme garantit une gestion efficace des flux de travail, essentielle pour les opérations à grande échelle. Son référentiel centralisé pour les définitions des tâches aide à maintenir l'organisation et le contrôle des processus de données. De plus, les capacités de suivi des performances de KETL permettent à votre équipe de surveiller et optimiser efficacement les flux de données.
Fonctionnalités et intégrations remarquables :
Fonctionnalités : incluent une architecture multi-thread qui améliore la scalabilité et la performance. KETL prend en charge un large éventail de types de tâches, y compris SQL, OS et XML, offrant une flexibilité dans le traitement de différents formats de données. Le référentiel centralisé des définitions de tâches de la plateforme aide à rationaliser la gestion des flux de travail et à garantir la cohérence.
Intégrations : incluent Oracle, MySQL, PostgreSQL, Microsoft SQL Server, MongoDB, Amazon Redshift, Google BigQuery, Salesforce, SAP et Hadoop.
Pros and Cons
Pros:
- Scalable sur plusieurs serveurs
- Prise en charge de manipulations complexes de données
- Référentiel centralisé des tâches
Cons:
- Soutien communautaire limité
- Documentation parfois limitée
Autres outils ETL open source
Voici quelques autres options d’outils ETL open source qui ne figurent pas dans ma sélection, mais qui méritent tout de même votre attention :
- Singer
Idéal pour les scripts d'extraction de données
- Scriptella
Idéal pour un scripting ETL simple
- Bubbles
Cadriciel ETL Python pour le traitement, l'audit et l'inspection des données


Comment j'évalue les outils ETL open source
Je divise mon évaluation en deux niveaux : les fonctionnalités de base des pipelines ETL/ELT pour qualifier un outil, puis des critères différenciants comme la capture des modifications de données (CDC), la prise en charge de Kubernetes et l'étendue des connecteurs, qui prennent de l'importance à l'échelle de la production.
Fonctionnalités essentielles (critères indispensables pour cette liste)
Lorsque je sélectionne les outils de ma liste, j'évalue chacun d'entre eux sur une échelle allant de 0 (ne propose pas la fonctionnalité) à 5 (excelle dans ce domaine) pour chaque fonctionnalité essentielle répertoriée ci-dessous. Je convertis ensuite le score total de l'outil en pourcentage. Chaque outil doit obtenir un score total minimum de 65 % pour être pris en compte.
- Licence open source : Je vérifie que le projet utilise une licence reconnue et approuvée par l'OSI (Apache 2.0, MIT, GPL, etc.) et que le code source est accessible au public pour l'auto-hébergement, la création de dérivations et les contributions de la communauté.
- Prise en charge complète des pipelines ETL/ELT : Chaque outil doit gérer l'extraction, la transformation et le chargement dans le cadre d'un flux de travail connecté, et pas seulement synchroniser des données d'un point A à un point B sans aucune logique intermédiaire.
- Bibliothèque de connecteurs préconfigurés : J'évalue l'étendue des connecteurs disponibles pour les bases de données, les entrepôts de données cloud, les applications SaaS et les formats de fichiers, car avec un outil qui n'en propose qu'une poignée, votre équipe doit écrire du code personnalisé pour chaque nouvelle source.
- Moteur de transformation des données : Qu'il soit fondé sur SQL, comme les modèles de type dbt, sur des scripts Python ou sur une mise en correspondance visuelle, je recherche une couche de transformation capable de gérer les besoins du monde réel, tels que la conversion de types, la déduplication et les jointures.
- Orchestration et planification des pipelines : Les outils doivent prendre en charge les exécutions planifiées, la gestion des dépendances, les nouvelles tentatives et la surveillance des tâches afin que les pipelines n'échouent pas silencieusement à 2 heures du matin sans que personne ne le sache.
- Extensibilité et connecteurs personnalisés : Je recherche un SDK documenté ou un framework de modules complémentaires permettant à votre équipe de créer des connecteurs vers des API internes ou des systèmes spécialisés qui ne sont pas couverts par le catalogue par défaut.
Une fois que j'ai établi une liste d'outils répondant à ces critères, j'examine ce qui distingue chaque plateforme.
Critères différenciants (ce qui distingue les fournisseurs)
Voici comment je compare les différents fournisseurs :
Fonctionnalités remarquables
La capture des modifications de données est importante lorsque vos pipelines doivent refléter les mises à jour des bases de données sources en quasi-temps réel : il s'agit de synchroniser les changements de statut des commandes dans un entrepôt sans recharger les tables entières toutes les heures. J'évalue également la traçabilité des données et l'observabilité, car le suivi des dépendances au niveau des colonnes et la détection des dérives de schéma avant qu'un tableau de bord ne tombe en panne permettent d'économiser des heures de débogage. Un générateur visuel de pipelines mérite également d'être pris en compte, notamment pour les équipes où les analystes ou les contributeurs moins spécialisés dans le code doivent créer ou modifier des pipelines aux côtés des ingénieurs.
Au-delà des fonctionnalités
La vitalité de la communauté est un indicateur important de la viabilité à long terme : je vérifie la fréquence des validations, le rythme des versions et la manière dont les responsables répondent aux problèmes et aux demandes de tirage. La flexibilité du déploiement compte également : un outil prenant en charge Docker, Kubernetes et les graphiques Helm offre des possibilités à votre équipe, qu'elle fonctionne sur site ou auprès de plusieurs fournisseurs cloud. J'examine aussi attentivement la clarté des licences, car certains projets open core réservent des fonctionnalités clés comme le RBAC ou le SSO à des niveaux payants, ce qui peut prendre les équipes au dépourvu lorsqu'elles se développent.
Comment choisir des outils ETL open source
Il est facile de se perdre dans de longues listes de fonctionnalités et des structures tarifaires complexes. Pour vous aider à rester concentré tout au long de votre processus unique de sélection de logiciels, voici une liste de critères à garder à l’esprit :
| Facteur | Éléments à prendre en compte |
| Évolutivité | Assurez-vous que l’outil peut gérer la croissance du volume de vos données. Tenez compte de vos besoins futurs et vérifiez si l’outil prend efficacement en charge le traitement par lots et le traitement en temps réel. |
| Intégrations | Vérifiez si l’outil s’intègre à vos systèmes et sources de données existants, tels que les bases de données, les services cloud et les applications tierces, afin de fluidifier les flux de travail. |
| Personnalisation | Recherchez la possibilité d’adapter les flux de données à vos processus spécifiques. Plus l’outil est personnalisable, mieux il pourra s’adapter à l’évolution de vos besoins. |
| Facilité d’utilisation | Évaluez l’interface utilisateur. Un outil facile à prendre en main réduira la courbe d’apprentissage de votre équipe et accélérera sa mise en œuvre. |
| Budget | Comparez les tarifs à votre budget. Prenez en compte le coût total de possession, y compris les coûts cachés, afin de vous assurer qu’il respecte vos contraintes financières. |
| Mesures de sécurité | Assurez-vous que l’outil offre des fonctionnalités de sécurité robustes pour protéger vos données sensibles. Recherchez notamment le chiffrement, les contrôles d’accès des utilisateurs et la conformité aux réglementations. |
| Assistance | Vérifiez la disponibilité du service client. Une assistance réactive peut être essentielle lors de la mise en œuvre et du dépannage. |
| Performances | Évaluez la vitesse de traitement et la fiabilité de l’outil. Il doit fournir systématiquement les données dans les délais et sans erreurs afin de soutenir vos activités. |
Tendances des outils ETL open source
Dans le cadre de mes recherches, j’ai consulté d’innombrables mises à jour de produits, communiqués de presse et journaux de versions publiés par différents fournisseurs d’outils ETL open source. Voici quelques-unes des tendances émergentes que je surveille :
- Traitement en temps réel : De plus en plus d’outils se concentrent sur le traitement des données en temps réel, ce qui permet aux entreprises de réagir rapidement aux changements et de prendre des décisions éclairées. Par exemple, Apache Kafka a amélioré ses capacités de diffusion en continu afin de prendre en charge l’analyse en temps réel.
- Observabilité des données : Les fournisseurs ajoutent des fonctionnalités pour améliorer la visibilité et la surveillance des données, afin d’aider les équipes à identifier et à résoudre les problèmes plus rapidement. Des outils comme Apache NiFi proposent désormais des fonctionnalités améliorées de suivi des données et de lignage des données pour garantir leur intégrité.
- Architecture cloud native : Avec le passage à l’informatique cloud, les outils ETL sont conçus pour exploiter efficacement les ressources cloud. Talend Open Studio, par exemple, offre des fonctionnalités cloud natives pour optimiser les performances et l’évolutivité.
- Interfaces low-code : La demande de plateformes low-code ou no-code, qui rendent les outils ETL accessibles aux utilisateurs non techniques, est en pleine croissance. Des outils comme Pentaho Kettle adoptent des interfaces plus visuelles afin de simplifier la création de pipelines de données.
- Gouvernance des données : À mesure que les réglementations relatives à la confidentialité des données se renforcent, les outils ETL intègrent davantage de fonctionnalités de gouvernance. Cela comprend des options de masquage et de chiffrement des données, qui deviennent standard dans des solutions comme Hevo Data afin de garantir la conformité et la sécurité du traitement des données.
Que sont les outils ETL open source ?
Les outils ETL open source facilitent l’extraction, la transformation et le chargement des données provenant de diverses sources vers un emplacement centralisé. Les ingénieurs des données, les analystes et les professionnels de l’informatique utilisent généralement ces outils pour gérer et traiter efficacement de grands volumes de données.
Le traitement en temps réel, l’observabilité des données et les capacités cloud natives favorisent une prise de décision rapide, une résolution efficace des problèmes et une utilisation optimale des ressources. Dans l’ensemble, ces outils offrent la flexibilité et l’évolutivité nécessaires pour gérer des flux de données complexes et soutenir les stratégies fondées sur les données. Pour garantir la fiabilité à grande échelle, les équipes doivent compléter leurs outils ETL avec des outils d’automatisation des tests ETL robustes.
Fonctionnalités des outils ETL open source
Lors de la sélection d’outils ETL open source, soyez attentif aux fonctionnalités clés suivantes :
- Traitement en temps réel : Traite les données au fur et à mesure de leur arrivée, vous aidant à prendre des décisions en temps utile et à réagir rapidement aux changements.
- Observabilité des données : Offre une visibilité sur les flux de données, vous permettant de surveiller et de résoudre rapidement les problèmes.
- Architecture native du cloud : Utilise efficacement les ressources cloud afin d'améliorer l'évolutivité et les performances.
- Interfaces à programmation réduite : Simplifie la création de pipelines de données, rendant les outils accessibles aux utilisateurs non techniques.
- Gouvernance des données : Garantit la conformité et la sécurité grâce à des fonctionnalités telles que le masquage et le chiffrement des données.
- Intégration multi-sources : Se connecte à différentes sources de données afin de centraliser et de rationaliser le traitement des données.
- Évolutivité : Gère des volumes de données croissants et prend en charge le traitement par lots ainsi que le traitement en temps réel.
- Personnalisation : Permet d'adapter les flux de données aux besoins et aux processus spécifiques de l'entreprise.
- Surveillance des performances : Suit et optimise les flux de données afin de maintenir leur efficacité et leur précision.
- Gestionnaire de planification : Automatise l'exécution des tâches et gère les flux de travail afin d'améliorer la productivité.
Avantages des outils ETL à code source ouvert
La mise en œuvre d'outils ETL à code source ouvert offre plusieurs avantages à votre équipe et à votre entreprise. Voici quelques-uns de ceux dont vous pouvez bénéficier :
- Rentabilité : Étant à code source ouvert, ces outils sont souvent exempts de frais de licence, ce qui réduit les coûts globaux de votre entreprise.
- Flexibilité : Les flux de travail personnalisables vous permettent d'adapter les processus de données à vos besoins spécifiques et de les faire évoluer au fur et à mesure que ces besoins changent.
- Évolutivité : Prend en charge le traitement par lots et en temps réel, permettant à votre entreprise de gérer des volumes de données croissants sans sacrifier les performances.
- Amélioration de la prise de décision : Le traitement des données en temps réel garantit que votre équipe dispose d'informations à jour, ce qui lui permet de prendre des décisions éclairées en temps utile.
- Amélioration de la qualité des données : Des fonctionnalités telles que l'observabilité et la gouvernance des données contribuent à maintenir l'exactitude et la conformité des données, renforçant ainsi la confiance que vous leur accordez.
- Assistance de la communauté : Une solide communauté de développeurs accompagne souvent ces outils, en fournissant des ressources et des connaissances partagées pour le dépannage et les améliorations.
- Capacités d'intégration : Se connecte facilement à diverses sources de données et à différents systèmes, rationalisant ainsi la gestion des données dans toute votre organisation.
Coûts et tarifs des outils ETL à code source ouvert
La sélection d'outils ETL à code source ouvert nécessite de comprendre les différents modèles tarifaires et forfaits disponibles. Les coûts varient en fonction des fonctionnalités, de la taille de l'équipe, des modules complémentaires et d'autres facteurs. Le tableau ci-dessous résume les forfaits courants, leurs prix moyens et les fonctionnalités généralement incluses dans les solutions d'outils ETL à code source ouvert :
Tableau comparatif des forfaits d'outils ETL à code source ouvert
| Type de forfait | Prix moyen | Fonctionnalités courantes |
| Forfait gratuit | $0 | Extraction de données de base, intégrations limitées et assistance de la communauté. |
| Forfait personnel | $5-$25/utilisateur/mois | Transformations de données améliorées, assistance personnalisée et personnalisation limitée. |
| Forfait professionnel | $50-$100/utilisateur/mois | Traitement avancé des données, intégrations multiples et outils de collaboration en équipe. |
| Forfait entreprise | $100-$500/utilisateur/mois | Personnalisation complète, assistance de niveau entreprise et fonctionnalités de sécurité complètes. |
Outils ETL open source (FAQ)
Voici quelques réponses aux questions fréquentes sur les outils ETL open source :
Quelles sont les limites des outils ETL ?
Les outils ETL ne stockent souvent pas les données de manière permanente, ce qui signifie que vous avez besoin de solutions de stockage supplémentaires. Ils peuvent également introduire une latence des données, entraînant des retards dans leur disponibilité. La courbe d’apprentissage peut être abrupte, et la mise à l’échelle des outils pour gérer de gros volumes de données peut nécessiter des ressources supplémentaires. En outre, ils peuvent avoir des difficultés à traiter les données non structurées.
Quel est le meilleur outil ETL open source ?
Le meilleur outil ETL open source dépend de vos besoins spécifiques. Des outils comme Apache NiFi sont excellents pour les flux de données en temps réel, tandis que Talend Open Studio convient parfaitement aux tâches générales d’intégration des données. Tenez compte de facteurs tels que l’expertise de votre équipe, la complexité des données et vos besoins d’intégration lors de votre choix.
Dans quoi les outils ETL avancés peuvent-ils charger et convertir les données structurées et non structurées ?
Les outils ETL avancés peuvent charger et convertir des données structurées et non structurées dans des formats compatibles avec des systèmes comme Hadoop. Ils traitent plusieurs fichiers en parallèle, ce qui simplifie le processus de fusion de données diverses dans un flux de travail de transformation unifié.
Quelle est la différence entre les outils API et ETL ?
Les API sont idéales pour l’échange de données en temps réel et la communication entre les applications. En revanche, les outils ETL sont mieux adaptés aux tâches de traitement par lots, lorsque les données provenant de plusieurs sources doivent être consolidées, transformées et chargées dans un système cible à des fins d’analyse.
Comment les outils ETL assurent-ils la sécurité des données ?
Les outils ETL assurent la sécurité des données en mettant en œuvre le chiffrement, des contrôles d’accès et des mesures de conformité. Ils veillent à ce que les données sensibles soient protégées pendant les processus d’extraction, de transformation et de chargement. Certains outils proposent également des fonctions d’audit intégrées pour suivre les accès aux données et leurs modifications.
Les outils ETL peuvent-ils s'intégrer aux services cloud ?
Oui, de nombreux outils ETL s’intègrent parfaitement aux services cloud. Ils prennent en charge le déplacement des données vers et depuis des plateformes cloud comme AWS, Google Cloud et Azure, ce qui vous permet d’exploiter les capacités de stockage et de traitement cloud pour vos flux de travail de données.
Quelle est la prochaine étape ?
Développez la croissance de votre SaaS et vos compétences en leadership. Abonnez-vous à notre newsletter pour découvrir les dernières informations de la part de CTO et de futurs leaders technologiques.
Nous vous aiderons à développer votre activité plus intelligemment et à diriger plus efficacement grâce à des guides, des ressources et des stratégies proposés par les meilleurs experts !