

Honeycomb es una herramienta diseñada para proporcionar información sobre el funcionamiento interno de tu sistema, ayudándote a optimizar el rendimiento y solucionar problemas.
Las ventajas son numerosas; te permite rastrear eventos individuales, haciendo observables los sistemas complejos y permitiéndote comprender, aprender y depurar tu software.
Sin embargo, puede haber situaciones en las que quieras una alternativa a Honeycomb. Quizá estés utilizando un lenguaje de programación específico, como PHP, o necesites una herramienta que ofrezca cumplimiento de SOC. Tal vez quieras acceder al código fuente o busques un conjunto diferente de funciones.
Sean cuales sean tus motivos, he recopilado una lista de las mejores alternativas a Honeycomb, con información sobre los productos y valoraciones por estrellas, para ayudarte a encontrar la opción que mejor se adapte a tus necesidades específicas. Así que vamos a conocer y explorar juntos estas opciones.
¿Qué es Honeycomb?
Honeycomb es una plataforma de observabilidad que te ayuda a depurar, supervisar y comprender tus sistemas de software en tiempo real. La utilizan ingenieros de software, equipos de DevOps e ingenieros de fiabilidad de sitios que necesitan identificar rápidamente problemas de rendimiento y comportamientos inusuales en producción. La información a nivel de evento, las consultas y los mapas de calor ayudan a analizar el comportamiento del sistema, detectar cuellos de botella y mejorar la fiabilidad de las aplicaciones. En general, Honeycomb ofrece a tu equipo una visión más clara de lo que ocurre en tu código para que puedas solucionar los problemas con mayor rapidez.
Por qué confiar en nuestras recomendaciones de software
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Nuestro equipo lleva probando y evaluando software desde 2012. Como líderes tecnológicos, sabemos lo difícil —y lo importante— que es elegir el software adecuado.
Para esta guía, evaluamos las herramientas mediante pruebas prácticas e investigación independiente, puntuando las herramientas según nuestros criterios de selección.
Nuestras reseñas reflejan nuestro criterio editorial humano, no un discurso de ventas.
Revisores expertos:
- Paulo Gardini MiguelDirector técnico
 Tim FisherVP de IA
 Gabriel RosasTech Lead y arquitecto de software
 Christhian GruhnTech Lead y arquitecto de plataforma

Tabla comparativa de alternativas a Honeycomb
Esta tabla comparativa resume los detalles de precios de mi selección de las mejores alternativas a Honeycomb:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Ideal para el rastreo distribuido rico en contexto | Plan gratuito disponible | Desde $26/mes (facturado anualmente) | Website | |
| 2 | Mejor para la monitorización automatizada de pila completa impulsada por IA | Prueba gratuita de 15 días | $21/usuario/mes para su plan de monitorización de pila completa (facturado anualmente) | Website | |
| 3 | La mejor opción para ver trazas, registros y métricas unificados en una sola vista | Plan gratuito disponible | $15/usuario/mes (facturado anualmente) | Website | |
| 4 | La mejor opción para el monitoreo de infraestructura de código abierto a gran escala | Plan gratuito disponible | Precios bajo solicitud | Website | |
| 5 | La mejor opción para el seguimiento integral de transacciones empresariales | Prueba gratuita de 30 días | $3300 por unidad al año (facturado anualmente) | Website | |
| 6 | Ideal para obtener información sobre el rendimiento de aplicaciones y el seguimiento de la experiencia del usuario final | Plan gratuito disponible | $99/mes para el plan Pro (facturado anualmente) | Website | |
| 7 | La mejor opción para la gestión y el análisis de registros nativos de la nube | Prueba gratuita de 14 días | Precios disponibles bajo solicitud | Website | |
| 8 | Ideal para la supervisión y las alertas de registros basadas en el volumen | Prueba gratuita de 30 días | Precios disponibles previa solicitud | Website | |
| 9 | La mejor opción para la inteligencia operativa basada en datos de máquinas | Prueba gratuita de 60 días | $150/mes (facturado anualmente) | Website | |
| 10 | Ideal para métricas y alertas nativas de Kubernetes | Plan gratuito disponible | Precio bajo solicitud | Website |


Reseñas de las mejores alternativas a Honeycomb
A continuación encontrarás mis resúmenes detallados de las mejores alternativas a Honeycomb que se incluyeron en mi lista breve. Mis reseñas ofrecen un análisis detallado de las funciones principales, ventajas \u0026 desventajas, integraciones y casos de uso ideales de cada herramienta para ayudarte a encontrar la mejor opción para ti.
 Ideal para el rastreo distribuido rico en contexto
- Plan gratuito disponible
- Desde $26/mes (facturado anualmente)
Visit WebsiteCustomer Rating:4.5/5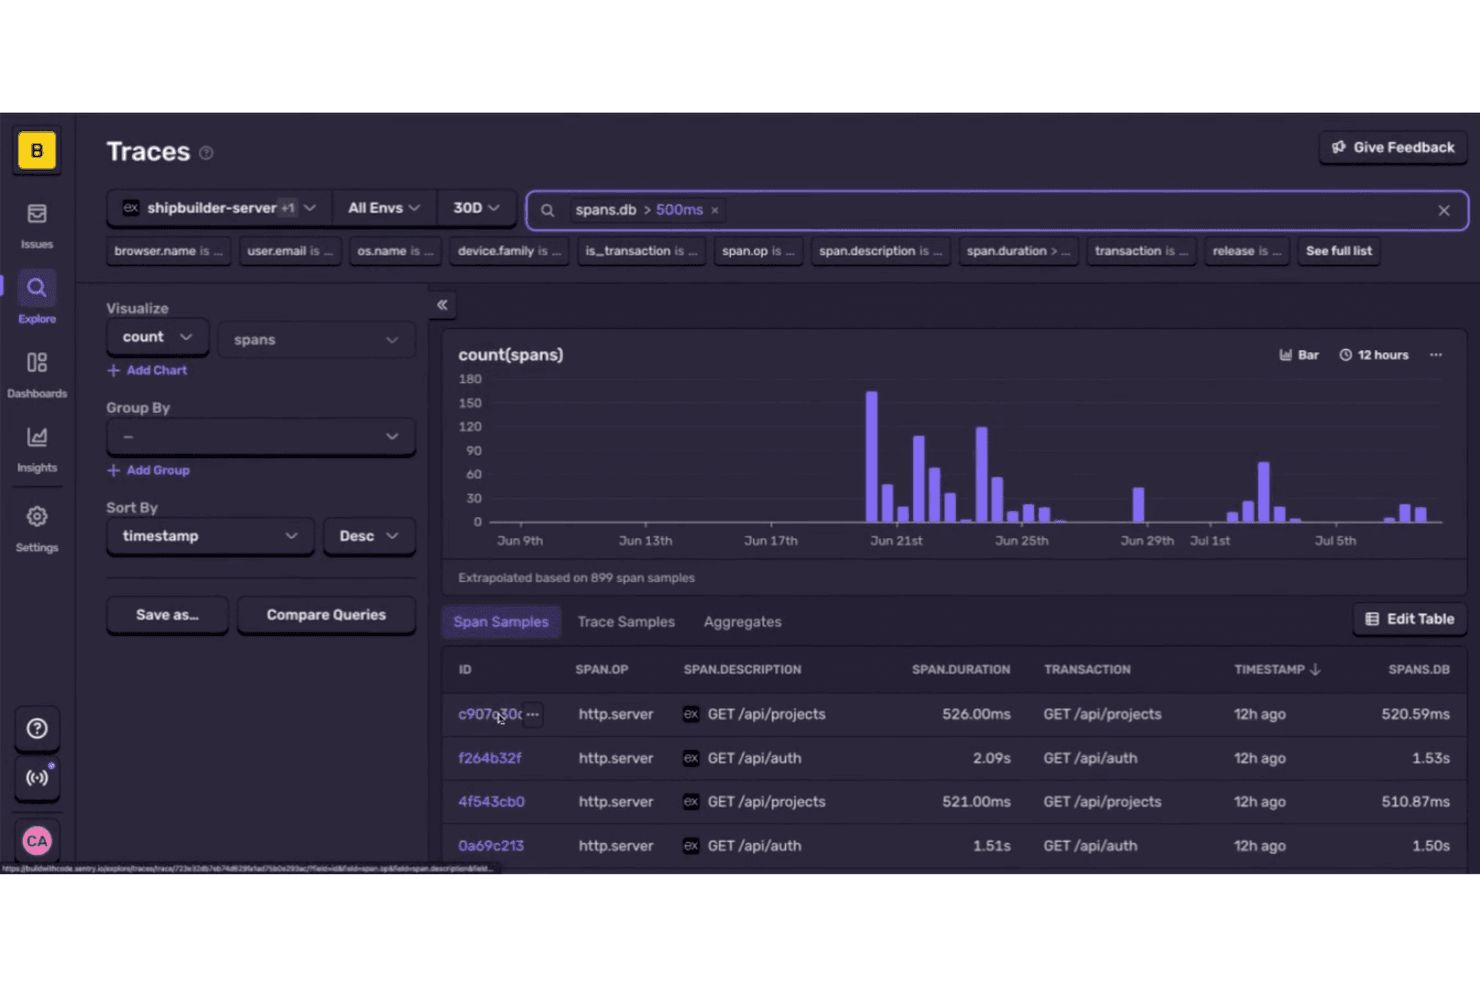
Sentry permite a los usuarios rastrear tramos lentos de bases de datos entre servicios a lo largo del tiempo. Sentry es una plataforma de monitorización de aplicaciones para equipos de software que ayuda a los ingenieros a encontrar errores y problemas de rendimiento en distintos servicios, diagnosticar incidentes y reducir su impacto en los usuarios.
¿Para quién es más adecuado Sentry?
Equipos de ingeniería que ejecutan aplicaciones distribuidas y necesitan contexto de trazas para localizar problemas de rendimiento entre servicios.
Por qué elegí Sentry
Elegí Sentry como alternativa a Honeycomb porque es ideal para el rastreo distribuido rico en contexto. Su vista de trazas muestra los tramos entre servicios y vincula los errores con las transacciones que los desencadenaron. Me gusta cómo esto ayuda a localizar dónde una solicitud lenta acumula latencia a medida que atraviesa una API y sus servicios posteriores.
Funciones principales de Sentry
- Monitorización de errores: Captura excepciones y agrupa eventos similares en incidencias.
- Reproducción de sesiones: Registra las interacciones de los usuarios para que los equipos puedan inspeccionar los eventos relacionados con un error.
- Estado de las versiones: Realiza un seguimiento de las sesiones y los usuarios sin fallos en las distintas versiones del software.
- Alertas de incidencias: Envía notificaciones cuando aparecen nuevas incidencias o cambian las existentes.
Integraciones de Sentry
Sentry ofrece integraciones nativas con GitHub, Jira, Slack, GitLab, Microsoft Teams, PagerDuty, Vercel, Bitbucket, Azure DevOps y Opsgenie. Su plataforma de integración admite integraciones personalizadas mediante webhooks y la API REST.
Pros and Cons
Pros:
- Los errores enlazan directamente con el contexto de la traza
- Buscar tramos por atributos y percentiles de latencia
- Reproducir sesiones de usuario junto a los errores capturados
Cons:
- Se centra principalmente en errores de aplicaciones, no de infraestructura
- El amplio conjunto de funciones puede saturar la interfaz
Learn more about Sentry: Mejor para la monitorización automatizada de pila completa impulsada por IA
- Prueba gratuita de 15 días
- $21/usuario/mes para su plan de monitorización de pila completa (facturado anualmente)
Visit WebsiteCustomer Rating:4.5/5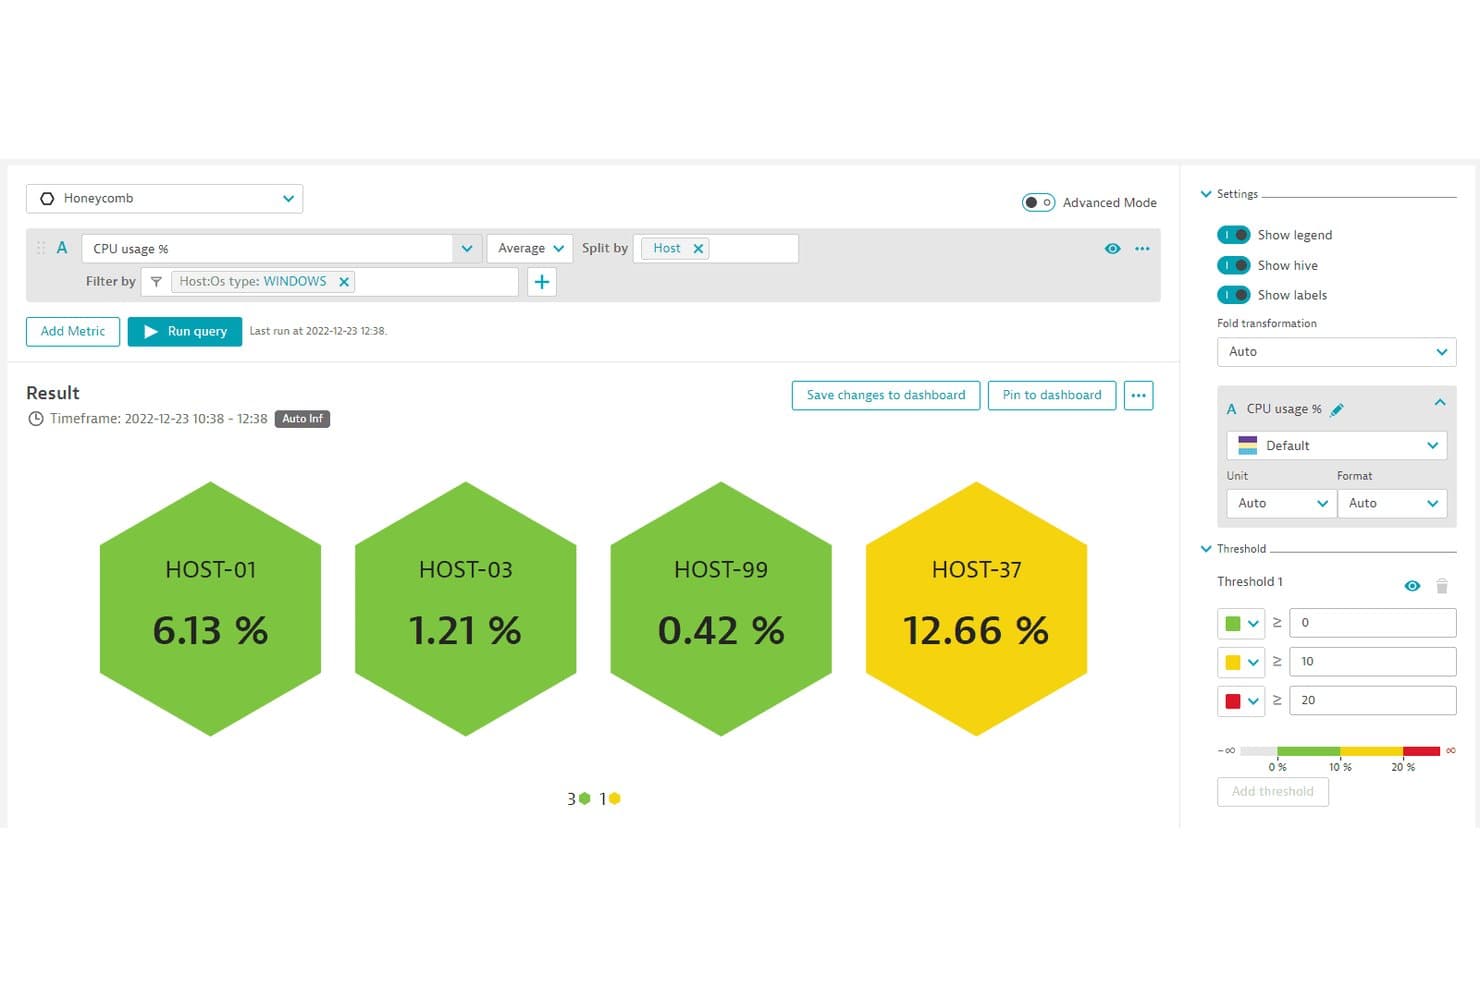
Dynatrace visualiza el uso de la CPU por host mediante mosaicos de panal codificados por colores. Como alternativa a Honeycomb, Dynatrace ayuda a los equipos de TI e ingeniería a conectar datos de aplicaciones, infraestructura y experiencia del usuario para diagnosticar problemas de servicio en entornos complejos.
¿Para quién es Dynatrace más adecuado?
Dynatrace es adecuado para equipos de operaciones de TI y SRE que gestionan entornos complejos y distribuidos, y necesitan una monitorización automatizada de aplicaciones e infraestructura.
Por qué elegí Dynatrace
Considero Dynatrace una de las mejores alternativas a Honeycomb por su enfoque en «la mejor solución de monitorización automatizada de pila completa impulsada por IA». Davis AI analiza la telemetría para identificar las causas raíz probables, mientras que OneAgent descubre e instrumenta automáticamente los servicios en hosts y cargas de trabajo en la nube. Valoro su mapeo de dependencias cuando un aumento repentino de la latencia de una API se remonta a un host o servicio posterior.
Funciones principales de Dynatrace
- Monitorización de usuarios reales: Realiza un seguimiento de las sesiones de los usuarios, las cargas de páginas y los errores del frontend.
- Monitorización sintética: Ejecuta comprobaciones programadas de navegador y HTTP en los endpoints.
- Monitorización de registros: Recopila, busca y analiza registros junto con la telemetría.
- Monitorización de la infraestructura en la nube: Realiza un seguimiento de las métricas y el estado de los hosts, contenedores y servicios en la nube.
Integraciones de Dynatrace
Dynatrace Workflows ofrece conectores con soporte oficial para AWS, Microsoft Azure, GitHub, Jira, Slack, PagerDuty, ServiceNow, Microsoft Teams, GitLab y Jenkins a través de Dynatrace Hub. Dynatrace también proporciona una API para integraciones personalizadas.
Pros and Cons
Pros:
- Davis AI vincula las anomalías con las causas raíz
- OneAgent descubre e instrumenta automáticamente los servicios
- Registros, trazas, infraestructura y monitorización de usuarios unificados
Cons:
- La sintaxis de DQL requiere tiempo para dominarla
- El consumo de telemetría puede hacer que los costes sean impredecibles
 La mejor opción para ver trazas, registros y métricas unificados en una sola vista
- Plan gratuito disponible
- $15/usuario/mes (facturado anualmente)
Visit WebsiteCustomer Rating:4.5/5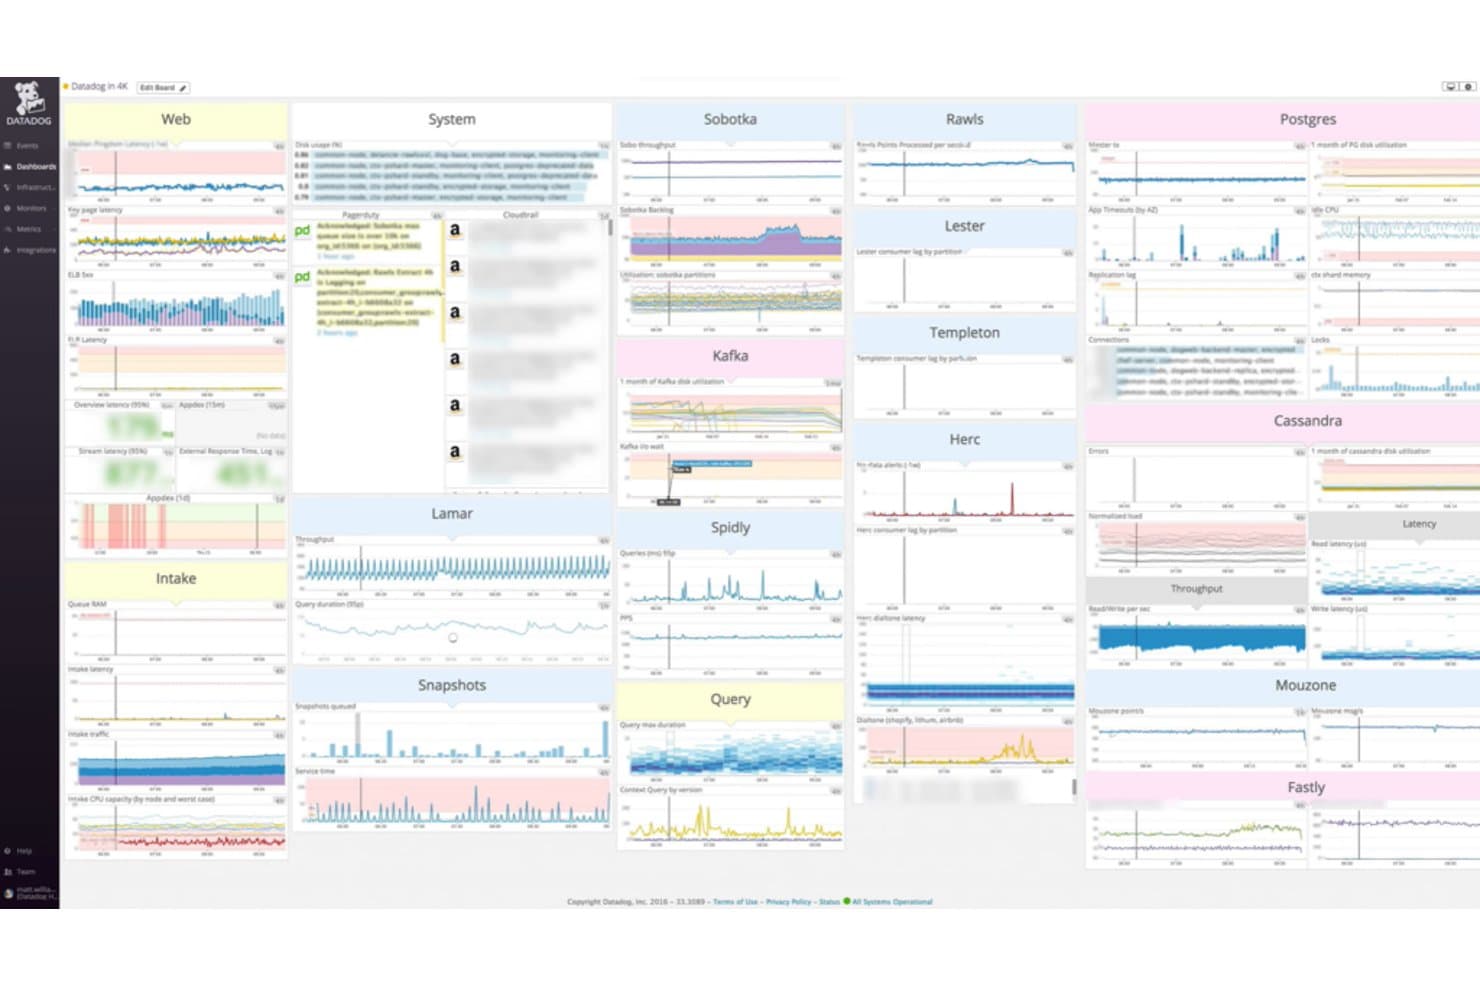
Datadog centraliza las métricas de los servicios web, del sistema y de bases de datos en un solo panel. Datadog es una plataforma de observabilidad para equipos de TI e ingeniería que necesitan investigar problemas de aplicaciones, rastrear dependencias entre servicios y supervisar la infraestructura en entornos complejos.
¿Para quién es más adecuado Datadog?
Datadog es adecuado para equipos de operaciones de TI, ingeniería de plataformas y SRE que necesitan supervisar infraestructuras y aplicaciones distribuidas.
Por qué elegí Datadog
Elegí Datadog porque es la mejor opción para la supervisión unificada de servidores, aplicaciones y servicios. Sus métricas de infraestructura, trazas de APM y mapas de servicios me ayudan a seguir una solicitud lenta desde un anfitrión hasta sus servicios dependientes, lo que lo convierte en una alternativa útil a Honeycomb para investigar incidentes entre distintas capas.
Características principales de Datadog
- Gestión de registros: Busca, filtra y analiza registros de aplicaciones e infraestructura.
- Supervisión sintética: Ejecuta pruebas de navegador y API para comprobar la disponibilidad y los tiempos de respuesta.
- Monitores: Define condiciones que activan alertas cuando los datos supervisados alcanzan un umbral.
- Paneles: Crea representaciones visuales con gráficos y widgets para los datos seleccionados.
Integraciones de Datadog
Datadog ofrece más de 1.000 integraciones integradas, incluidas AWS, Azure, Google Cloud, Kubernetes, Docker, Jenkins, Slack, Jira, GitHub y PagerDuty. También proporciona una API para integraciones personalizadas.
Pros and Cons
Pros:
- Correlaciona registros, métricas y trazas durante la clasificación de incidentes
- Los mapas de servicios conectan los anfitriones con los servicios dependientes
- Los paneles unifican las señales de infraestructura y aplicaciones
Cons:
- El ajuste de las alertas puede generar notificaciones excesivas
- El manejo de OpenTelemetry puede ser inconsistente
 La mejor opción para el monitoreo de infraestructura de código abierto a gran escala
- Plan gratuito disponible
- Precios bajo solicitud
Visit WebsiteCustomer Rating:4.4/5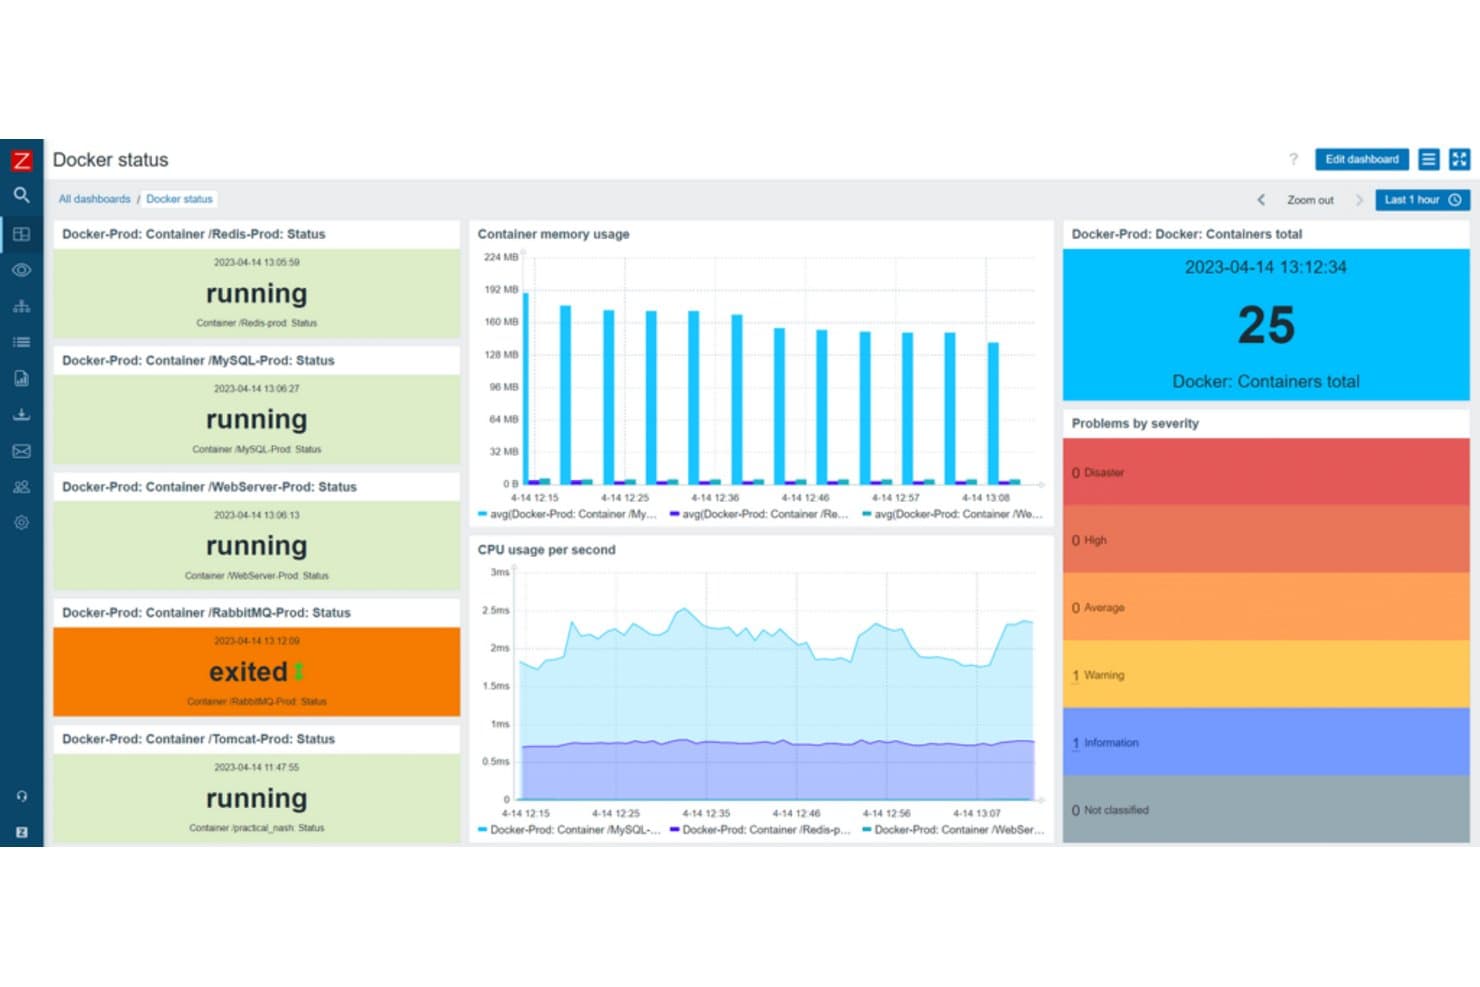
Zabbix monitorea en tiempo real el estado y el uso de recursos de los contenedores de Docker. Zabbix es una plataforma de monitoreo de infraestructura para equipos de TI que necesitan realizar un seguimiento de dispositivos de red, servidores, aplicaciones y servicios, así como detectar interrupciones o problemas de rendimiento en entornos complejos.
¿Para quién es más adecuado Zabbix?
Zabbix es adecuado para equipos de TI e infraestructura empresariales que necesitan monitoreo de código abierto en redes y sistemas grandes e interconectados.
Por qué elegí Zabbix
Elegí Zabbix como “La mejor opción para el monitoreo de redes de código abierto a nivel empresarial” cuando la visibilidad de la infraestructura es más importante que el rastreo distribuido. El descubrimiento de red y el monitoreo SNMP ayudan a localizar conmutadores y enrutadores, mientras que las plantillas y los activadores estandarizan las comprobaciones y alertan sobre fallos de interfaces o servicios. Esto lo convierte en una alternativa útil a Honeycomb para hacer seguimiento del estado de la infraestructura en un entorno grande.
Funciones clave de Zabbix
- Monitoreo web: Configura escenarios para comprobar la disponibilidad del sitio web, el tiempo de respuesta y el contenido de las páginas.
- Monitoreo de registros: Recopila entradas de registro y detecta patrones o errores coincidentes.
- Monitoreo de servicios: Mapea los servicios empresariales y realiza un seguimiento de su estado en relación con los objetivos de nivel de servicio.
- Paneles: Organiza widgets para mostrar datos de monitoreo, problemas y el estado de los servicios.
Integraciones de Zabbix
El catálogo de integraciones de Zabbix incluye 559 marcas y 1.986 soluciones, entre ellas AWS, Azure, Kubernetes, PagerDuty, Slack, Microsoft Teams, ServiceNow y Jira. Admite conexiones personalizadas mediante su API y webhooks configurables; las entradas del catálogo no son necesariamente integraciones nativas.
Pros and Cons
Pros:
- El descubrimiento automático encuentra dispositivos de red SNMP
- Las plantillas estandarizan las comprobaciones del estado de la infraestructura
- Los proxies amplían el monitoreo a sitios remotos
Cons:
- No cuenta con un flujo de trabajo nativo para la depuración de trazas distribuidas
- La configuración compleja y el ajuste de alertas requieren experiencia
 La mejor opción para el seguimiento integral de transacciones empresariales
- Prueba gratuita de 30 días
- $3300 por unidad al año (facturado anualmente)
Visit WebsiteCustomer Rating:4.3/5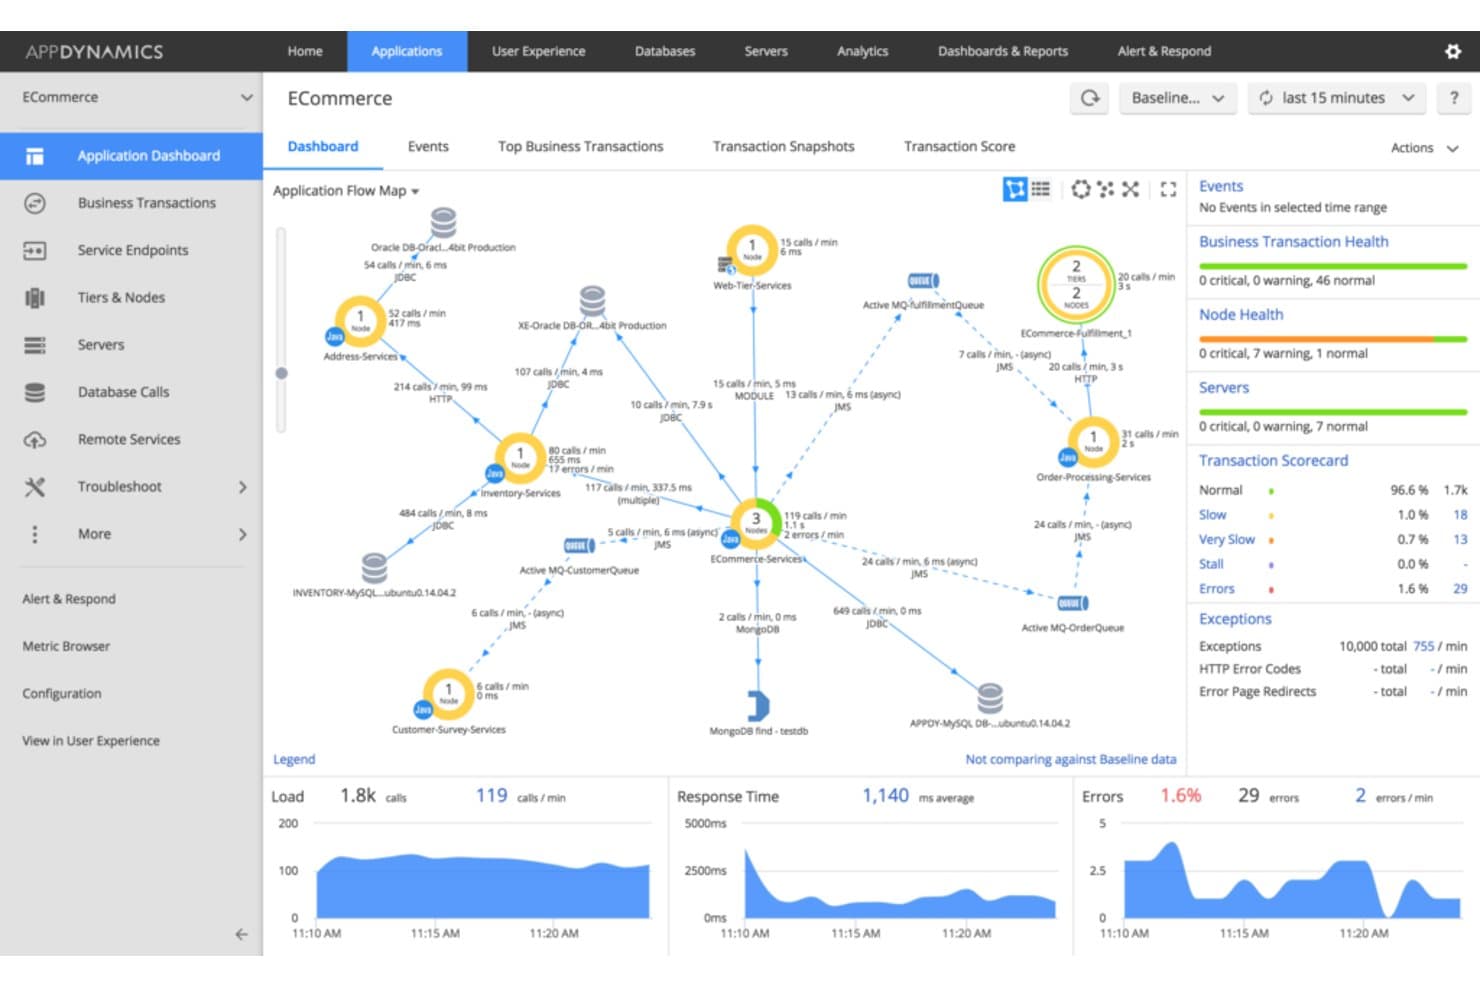
AppDynamics visualiza las dependencias y el rendimiento de los servicios de las aplicaciones en tiempo real. AppDynamics es una plataforma de observabilidad para equipos de TI y aplicaciones que gestionan sistemas complejos, y les ayuda a identificar problemas de rendimiento y relacionar los problemas de infraestructura con la fiabilidad de las aplicaciones y la experiencia del usuario.
¿Para quién es más adecuado AppDynamics?
AppDynamics es adecuado para equipos de rendimiento y operaciones de aplicaciones que gestionan aplicaciones distribuidas y de varios niveles en entornos complejos.
Por qué elegí AppDynamics
Elegí AppDynamics para realizar un seguimiento integral de las transacciones empresariales en entornos complejos. Sus mapas de flujo de transacciones muestran cómo se desplazan las solicitudes entre los distintos niveles de la aplicación, mientras que las instantáneas de transacciones capturan detalles a nivel de código cuando una solicitud se ralentiza o falla. Utilizo esta vista para rastrear un retraso en el proceso de pago desde el servicio orientado al usuario hasta el nivel del backend que lo provoca.
Características principales de AppDynamics
- Supervisión de la infraestructura: Correlaciona las métricas de infraestructura con los servicios de aplicaciones y las métricas empresariales.
- Supervisión de la experiencia digital: Realiza un seguimiento de los usuarios web y móviles, y ejecuta comprobaciones sintéticas en navegadores, API y servicios de terceros.
- Seguridad de las aplicaciones en tiempo de ejecución: Detecta vulnerabilidades y bloquea ataques.
- Supervisión de SAP: Supervisa sistemas SAP híbridos y locales, con trazabilidad hasta el código ABAP o las consultas de bases de datos.
Integraciones de AppDynamics
AppDynamics admite integraciones de alertas con PagerDuty, Slack, ServiceNow mediante Service Graph Connector, Jira, BigPanda, Moogsoft y Splunk ITSI; la integración de PagerDuty está desarrollada por el proveedor, mientras que la de Slack está desarrollada por la comunidad. AppDynamics también proporciona API REST y extensiones prediseñadas para integraciones personalizadas.
Pros and Cons
Pros:
- Mapea las transacciones empresariales entre los distintos niveles de la aplicación
- Las instantáneas revelan los métodos lentos y las líneas de código
- Relaciona el estado de las transacciones con los resultados empresariales
Cons:
- El esfuerzo de configuración aumenta con las jerarquías de aplicaciones personalizadas
- Las consultas personalizadas requieren aprender el lenguaje de consultas de AppDynamics
Learn more about AppDynamics: Ideal para obtener información sobre el rendimiento de aplicaciones y el seguimiento de la experiencia del usuario final
- Plan gratuito disponible
- $99/mes para el plan Pro (facturado anualmente)
Visit WebsiteCustomer Rating:4.3/5
Panel de resumen SQL de New Relic. New Relic se especializa en proporcionar información detallada sobre el rendimiento de aplicaciones y el seguimiento de la experiencia del usuario. Esta herramienta realiza un trabajo sobresaliente ayudando a los equipos a comprender las interacciones de los usuarios y el comportamiento de la aplicación de manera detallada y minuciosa.
Pros and Cons
Pros:
- Monitoreo detallado del rendimiento de aplicaciones y seguimiento de la experiencia del usuario
- Amplias integraciones con los principales proveedores y plataformas en la nube
- Capacidades de AIOps para alertas predictivas y respuesta ante incidentes
Cons:
- Precios más altos en comparación con algunos competidores
- Puede ser complejo de configurar y poner en marcha
- La gran variedad de funciones puede resultar abrumadora para los nuevos usuarios
Learn more about New Relic: La mejor opción para la gestión y el análisis de registros nativos de la nube
- Prueba gratuita de 14 días
- Precios disponibles bajo solicitud
Visit WebsiteCustomer Rating:4.3/5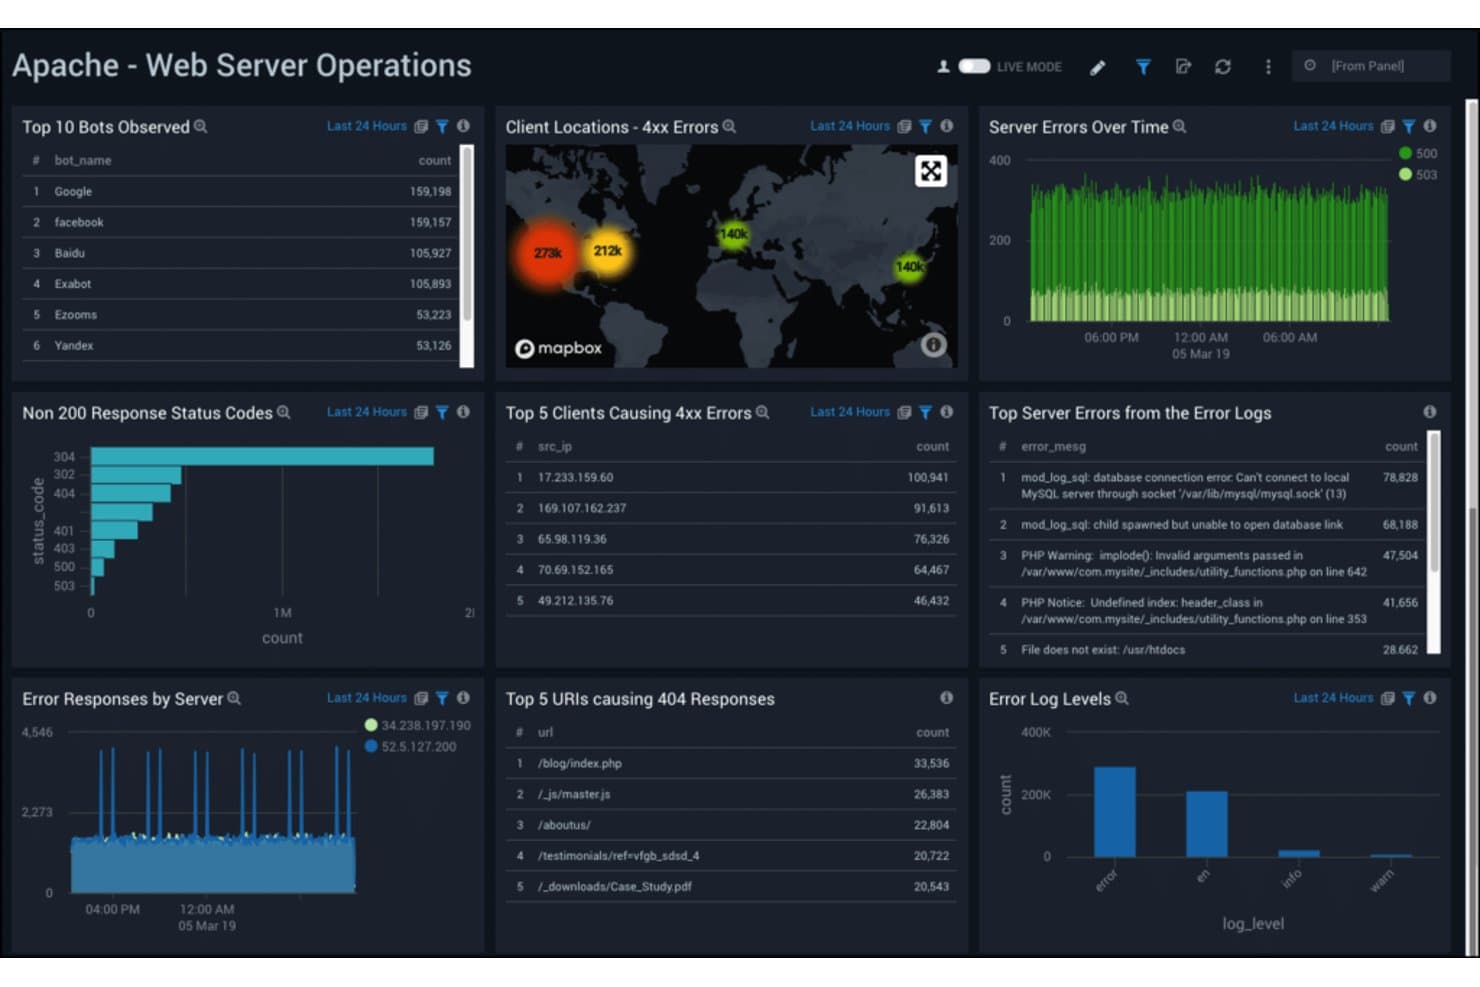
Los monitores de Sumo Logic supervisan en tiempo real los errores del servidor web Apache y la actividad de los bots. Sumo Logic proporciona a los equipos de TI y DevOps una plataforma de observabilidad para investigar interrupciones, conectar problemas entre servicios distribuidos y obtener visibilidad de entornos de nube complejos.
¿Para quién es más adecuado Sumo Logic?
Los equipos de infraestructura y seguridad de organizaciones nativas de la nube pueden usar Sumo Logic para analizar registros en servicios distribuidos.
Por qué elegí Sumo Logic
Elegí Sumo Logic como alternativa a Honeycomb porque es la mejor opción para la gestión y el análisis de registros nativos de la nube. LogReduce agrupa mensajes de registro similares para ayudarme a detectar errores recurrentes, mientras que su lenguaje de consultas de búsqueda me permite investigar un incidente en servicios distribuidos.
Funciones principales de Sumo Logic
- Análisis de métricas: Ingiera y consulte métricas de series temporales junto con datos de telemetría operativa.
- Seguimiento distribuido: Siga las solicitudes entre servicios para inspeccionar intervalos y detalles de las trazas.
- Paneles: Cree paneles visuales con gráficos y módulos para los datos operativos.
- Monitores y alertas: Establezca condiciones en las métricas o en los resultados de las consultas para activar notificaciones.
Integraciones de Sumo Logic
El catálogo de Sumo Logic incluye cientos de proveedores y productos, con aplicaciones, recopiladores, contenido de Cloud SIEM e integraciones de automatización para herramientas como AWS, Azure, Kubernetes, Datadog, GitHub, GitLab y Atlassian Jira. También proporciona API para integraciones personalizadas.
Pros and Cons
Pros:
- LogReduce agrupa rápidamente errores similares
- La búsqueda analiza datos JSON y expresiones regulares
- Los registros, las métricas y las trazas comparten las investigaciones
Cons:
- La sintaxis de consultas de Sumo requiere práctica
- Las búsquedas históricas pueden ralentizarse a gran escala
 Ideal para la supervisión y las alertas de registros basadas en el volumen
- Prueba gratuita de 30 días
- Precios disponibles previa solicitud
Visit WebsiteCustomer Rating:4.4/5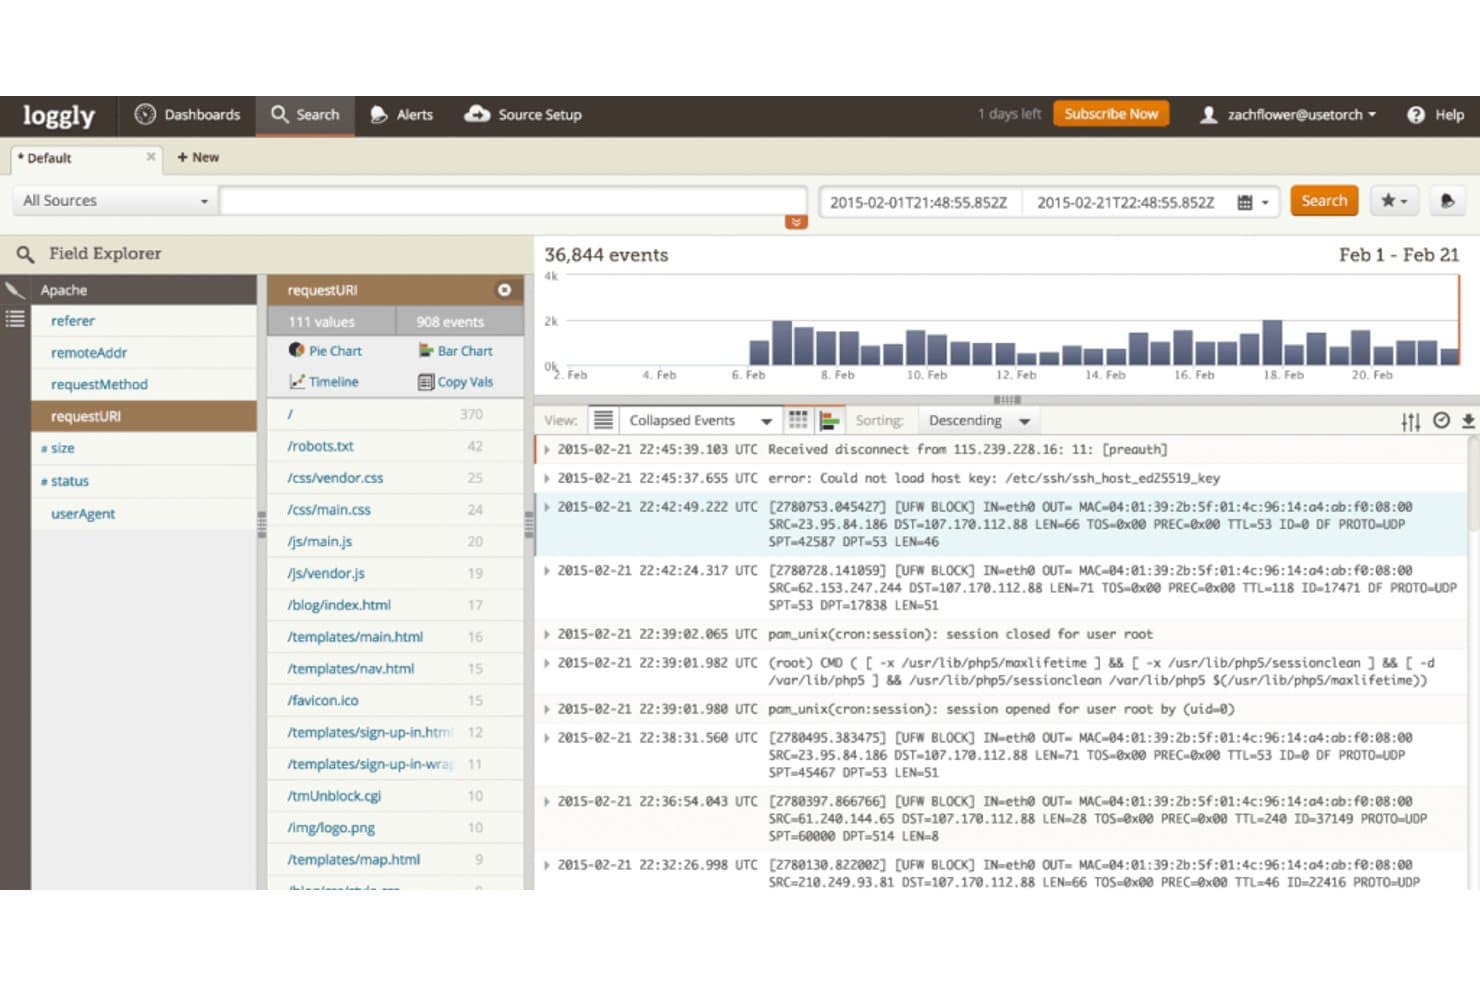
Loggly centraliza los eventos de registro para realizar búsquedas y análisis en tiempo real. Loggly es una plataforma de gestión de registros basada en la nube para equipos de TI y DevOps que necesitan investigar problemas de aplicaciones e infraestructura, rastrear eventos en distintos servicios y diagnosticar interrupciones del servicio.
¿Para quién es más adecuado Loggly?
Loggly es adecuado para equipos de TI y DevOps que necesitan buscar y visualizar datos de registros en entornos basados en la nube en crecimiento.
Por qué elegí Loggly
Elegí Loggly como alternativa a Honeycomb porque es ideal para la gestión escalable de registros basada en la nube y la visualización interactiva de datos. Sus gráficos y paneles me ayudan a detectar tendencias en los registros de aplicaciones e infraestructura. También valoro sus herramientas de resolución de problemas, que ayudan a rastrear las incidencias hasta sus causas raíz en servicios interconectados.
Características principales de Loggly
- Cola en directo: Transmite eventos de registro entrantes desde varias fuentes casi en tiempo real.
- Alertas basadas en búsquedas: Establece condiciones en las búsquedas y envía notificaciones por correo electrónico o a puntos de conexión compatibles.
- Integraciones con herramientas de equipo: Conecta Loggly con Slack, GitHub, Jira, PagerDuty, Microsoft Teams y webhooks.
- Compatibilidad con fuentes de registros: Recopila registros de fuentes como AWS, syslog, PHP, dispositivos de red y sistemas Windows.
Integraciones de Loggly
Loggly incluye integraciones con Slack, GitHub, Jira, PagerDuty y Microsoft Teams, y también permite entregar alertas mediante webhooks personalizados. Proporciona una API para integraciones personalizadas.
Pros and Cons
Pros:
- Búsqueda y paneles centralizados de registros entre servicios
- La cola en directo transmite eventos desde varias fuentes
- Los gráficos interactivos revelan las tendencias de los registros
Cons:
- La implementación exclusivamente SaaS no satisface los requisitos locales
- Los retrasos en la propagación de registros pueden dificultar la clasificación de incidentes
Learn more about Loggly: La mejor opción para la inteligencia operativa basada en datos de máquinas
- Prueba gratuita de 60 días
- $150/mes (facturado anualmente)
Visit WebsiteCustomer Rating:4.3/5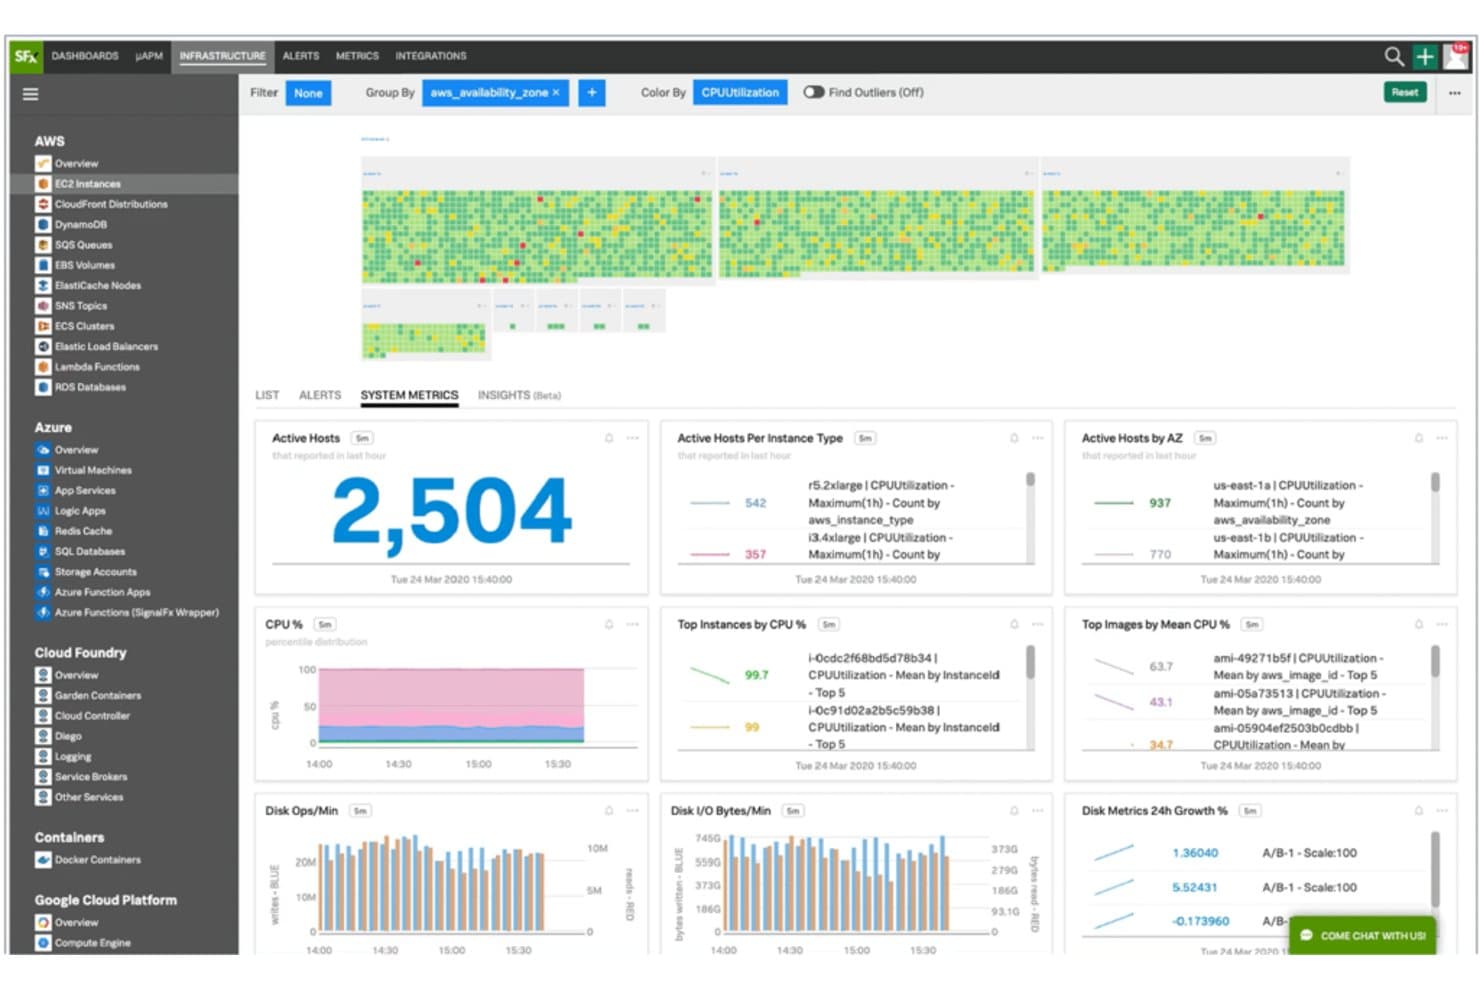
Splunk supervisa en tiempo real las métricas de AWS, Azure y de la infraestructura en la nube. Splunk es una plataforma de observabilidad para equipos de TI y seguridad que necesitan investigar datos de máquinas en entornos complejos, identificar problemas de servicio y resolver incidentes.
¿Para quién es mejor Splunk?
Los equipos de operaciones de TI que supervisan infraestructuras distribuidas pueden usar Splunk para convertir los datos de máquinas en inteligencia operativa práctica.
Por qué elegí Splunk
Elegí Splunk como alternativa a Honeycomb para «La mejor opción para aprovechar los datos de máquinas y obtener inteligencia operativa profunda». Utilizo búsquedas SPL para investigar registros en servicios distribuidos y, después, conecto los hallazgos en paneles para rastrear problemas, como el aumento de errores después de una implementación. Esta visión más amplia de los datos de máquinas me ayuda a examinar los problemas operativos junto con eventos relacionados de infraestructura y seguridad.
Características principales de Splunk
- Seguimiento distribuido: Sigue las solicitudes entre servicios mediante tramos de seguimiento y mapas de servicios.
- Supervisión de infraestructuras: Realiza un seguimiento de las métricas de hosts, contenedores y entornos de Kubernetes.
- Supervisión de usuarios reales: Captura el rendimiento del navegador y las interacciones de los usuarios.
- Supervisión sintética: Ejecuta pruebas mediante scripts para comprobar la disponibilidad de los servicios y los tiempos de respuesta.
Integraciones de Splunk
Splunk Observability Cloud ofrece cientos de integraciones preempaquetadas, incluidas AWS, Microsoft Azure, Google Cloud, Kubernetes, Prometheus, Jira, Microsoft Teams, PagerDuty, ServiceNow y Slack. Splunkbase ofrece más de 1.000 aplicaciones y complementos de marketplace, y Splunk proporciona API para integraciones personalizadas.
Pros and Cons
Pros:
- Correlaciona registros, métricas y seguimientos
- Analiza los seguimientos sin muestreo
- Los paneles personalizados agilizan la resolución de problemas
Cons:
- Las consultas pesadas pueden ejecutarse lentamente
- Los costes aumentan con volúmenes de datos mayores
Learn more about Splunk: Ideal para métricas y alertas nativas de Kubernetes
- Plan gratuito disponible
- Precio bajo solicitud
Visit WebsiteCustomer Rating:4.4/5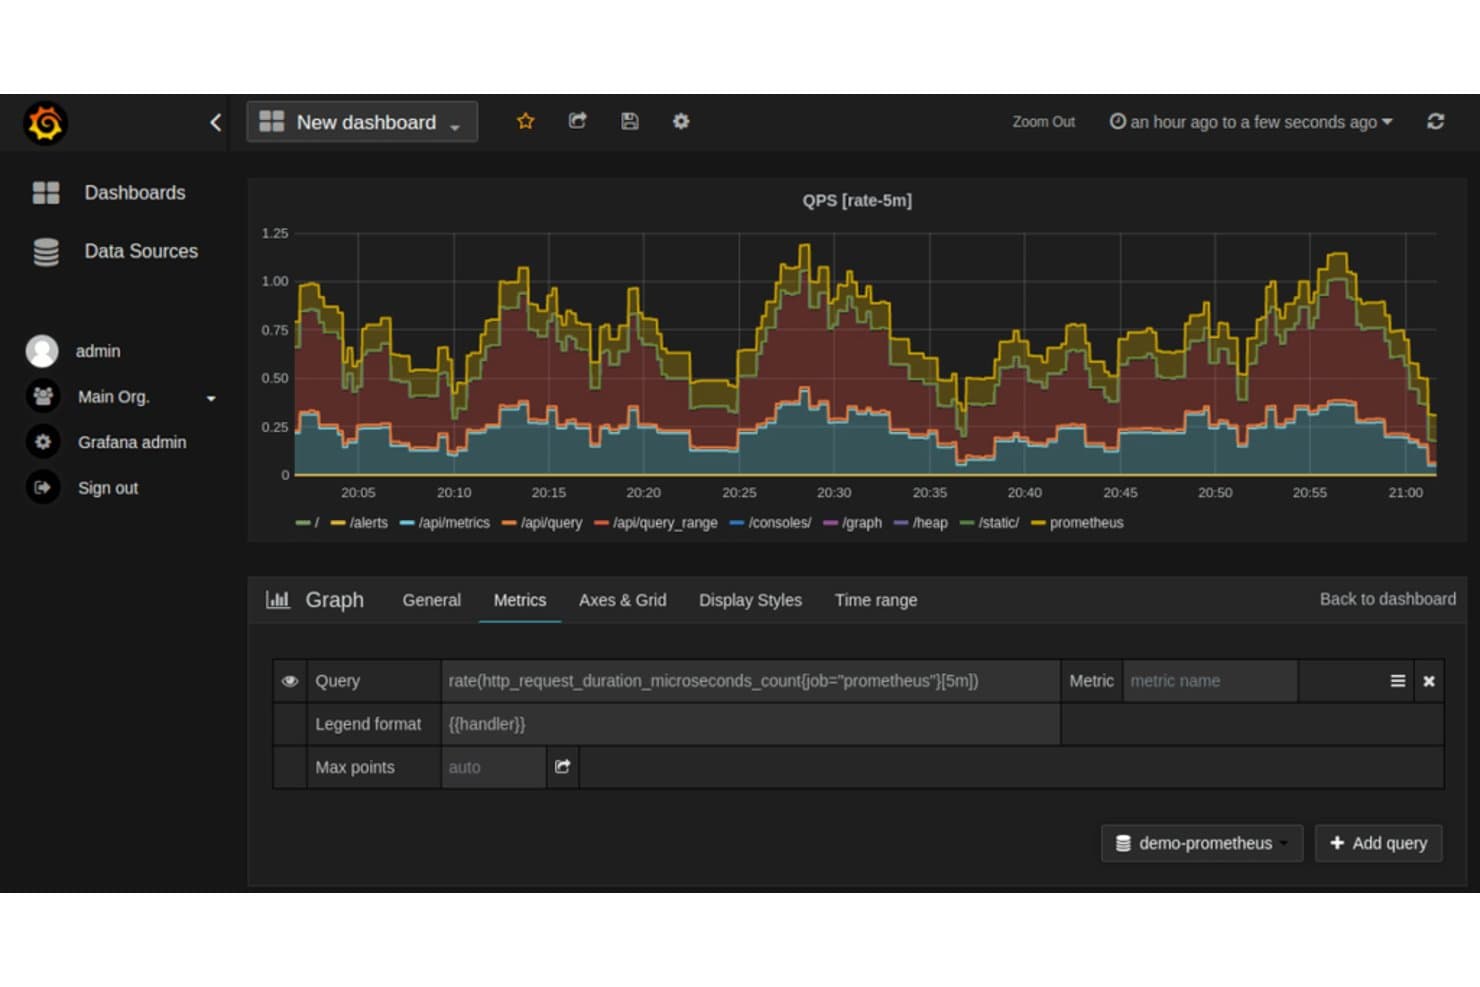
Prometheus visualiza las tasas de solicitudes HTTP en los distintos endpoints de la API en Grafana. Prometheus es una plataforma de monitorización de código abierto para equipos de infraestructura y aplicaciones que necesitan realizar un seguimiento del estado del sistema, investigar problemas de rendimiento e incorporar la observabilidad a sus servicios.
¿Para quién es más adecuado Prometheus?
Prometheus es adecuado para equipos de DevOps y de fiabilidad de sitios que necesitan recopilar métricas y configurar alertas en cargas de trabajo de Kubernetes.
Por qué elegí Prometheus
Elegí Prometheus para la recopilación de métricas y la gestión de alertas, especialmente en un entorno de Kubernetes. Su descubrimiento de servicios puede realizar un seguimiento de las cargas de trabajo cambiantes, mientras que PromQL me ayuda a investigar patrones de métricas y definir condiciones de alerta. Utilizo Alertmanager para dirigir esas alertas cuando el estado del servicio se degrada.
Características principales de Prometheus
- Base de datos de series temporales: Almacena muestras con marcas de tiempo en una base de datos local.
- Modelo de datos multidimensional: Organiza las series temporales mediante nombres de métricas y etiquetas de clave-valor.
- Ecosistema de exportadores: Los exportadores exponen métricas de sistemas como bases de datos y hardware.
- Federación: Recopila métricas seleccionadas de otros servidores de Prometheus para su agregación.
Integraciones de Prometheus
Prometheus incluye el descubrimiento de servicios de Kubernetes y admite integraciones basadas en exportadores con Kafka, MySQL, PostgreSQL, Redis, Jenkins y AWS CloudWatch. Las conexiones de lectura/escritura remotas incluyen Grafana Mimir, Thanos, Google Cloud y New Relic, y su API HTTP admite integraciones personalizadas.
Pros and Cons
Pros:
- PromQL permite investigar métricas basadas en etiquetas
- El descubrimiento de servicios de Kubernetes realiza un seguimiento de las cargas de trabajo cambiantes
- Alertmanager dirige las alertas de métricas según las etiquetas
Cons:
- Las etiquetas con alta cardinalidad pueden sobrecargar el almacenamiento local
- El almacenamiento local limita la retención y el escalado horizontal
Learn more about Prometheus:
Otras alternativas a Honeycomb
Estas son algunas alternativas adicionales a Honeycomb que no se incluyeron en mi lista breve, pero que merece la pena tener en cuenta:
- 11Grafana CloudIdeal para la visualización interactiva, facilitando la toma de decisiones basada en datos
- 12Elastic (ELK Stack)Ideal para el análisis de registros, búsqueda y potentes capacidades de correlación de datos
- 13WrikeIdeal para la gestión de proyectos dentro de equipos de software
Otras reseñas de software
- Herramientas de desarrollo de software
- Herramientas de infraestructura como código
- Herramientas de DataOps
- Herramientas de supervisión de bases de datos
Cómo evalúo las alternativas a Honeycomb
Analizo cada candidato en dos niveles: los requisitos básicos—trazabilidad distribuida, consultas de alta cardinalidad y soporte para OTel—y los diferenciadores que separan las herramientas cuando los ingenieros de SRE depuran incidentes en producción en vivo.
Funcionalidad básica (imprescindibles para esta lista)
Cuando selecciono herramientas para mi lista, clasifico cada una en una escala de 0 (no ofrece la funcionalidad) a 5 (sobresale en esta área) para cada funcionalidad básica que se detalla a continuación. Luego, calculo la puntuación total de la herramienta en porcentaje. Cada herramienta debe alcanzar una puntuación total mínima del 65% para ser considerada para su inclusión.
- Trazabilidad distribuida: Evalúo qué tan bien cada herramienta visualiza las cascadas de trazas entre servicios, ya que depurar un flujo de compra lento que abarca 15 microservicios exige un nivel profundo de detalle en los spans.
- Consultas de alta cardinalidad: Filtrar la telemetría por ID de usuario o instancia de contenedor a gran escala es importante, así que verifico si el rendimiento de las consultas se mantiene sólido entre millones de valores únicos.
- Soporte unificado de telemetría: Busco herramientas que correlacionen logs, métricas y trazas en una sola vista, de modo que pivotar de un pico de latencia al log de error correspondiente requiera solo un clic.
- Compatibilidad con OpenTelemetry: Aquí evalúo la ingestión nativa de OTel para trazas, métricas y logs, ya que los equipos no deberían necesitar agentes propietarios para enviar los datos.
- Alertas en tiempo real y SLOs: Una buena observabilidad incluye alertas de tasa de consumo de SLO y presupuestos de errores, así que compruebo si cada herramienta admite más que simples notificaciones con umbrales estáticos.
- Flujos de trabajo de depuración interactiva: Busco interfaces de consultas exploratorias—como detección de valores atípicos o desgloses por grupos—que ayuden a los ingenieros a diagnosticar problemas desconocidos durante un incidente.
Una vez que tengo una lista de herramientas que cumplen con este criterio, considero qué diferencia a cada plataforma.
Factores diferenciadores (qué distingue a cada proveedor)
Así es como comparo y contrasto a los distintos proveedores:
Características destacadas
Las herramientas de investigación asistidas por IA pueden ahorrar horas en un incidente al mostrar automáticamente la causa raíz probable incluso antes de que un ingeniero escriba una consulta. También evalúo si una plataforma ofrece perfilado continuo—vincular hotspots de CPU o memoria directamente a una traza ayuda a identificar cuellos de botella a nivel de código que los datos a nivel de span pasan por alto. Los flujos de trabajo colaborativos en las consultas también son importantes, especialmente para los equipos que realizan postmortems sin asignar culpa. Los historiales compartidos de investigación y los tableros anotados permiten que el ingeniero de guardia transfiera el contexto al siguiente turno sin que se pierda nada.
Más allá de las funcionalidades
El modelo de precios es una de las primeras cosas que reviso. Una plataforma que factura por host se comporta de manera muy distinta a una que factura por GB ingerido, y un pico de tráfico durante el lanzamiento de un producto no debería disparar tu presupuesto de observabilidad. También evalúo la rapidez con la que un equipo obtiene valor—las herramientas con buena autoinstrumentación y guías claras de migración a OTel reducen dramáticamente el tiempo de incorporación. Las integraciones con el ecosistema completan el cuadro. Conectarse a PagerDuty, Slack y a tu pipeline de CI/CD significa que las alertas llegan a las personas correctas y los marcadores de despliegue aterrizan automáticamente en tus paneles.
¿Por qué buscar una alternativa a Honeycomb?
Honeycomb es una herramienta de observabilidad avanzada diseñada para que los ingenieros de software comprendan, depuren y mejoren su software en producción. Destaca por proporcionar información a nivel de sistema, lo que facilita descubrir patrones y anomalías y, de este modo, optimizar el rendimiento.
A pesar de sus potentes funciones, los usuarios pueden buscar alternativas por diversos motivos. Estos pueden ir desde limitaciones presupuestarias, ya que el precio de Honeycomb podría estar fuera del alcance de algunos equipos pequeños, hasta requisitos específicos de funciones que Honeycomb no cubre, como el software tradicional de gestión de registros o la supervisión detallada del rendimiento de las aplicaciones.
Por último, algunos usuarios pueden simplemente preferir una alternativa de código abierto o una con una interfaz de usuario diferente. La búsqueda de la alternativa perfecta a Honeycomb implica encontrar una herramienta que logre un equilibrio entre una funcionalidad completa y una experiencia de usuario fluida, al tiempo que se adapte a las necesidades y los recursos únicos de la organización.
Características principales de Honeycomb
Estas son algunas de las características principales de Honeycomb, para ayudarte a contrastar y comparar lo que ofrecen las soluciones alternativas:
- Telemetría basada en eventos: Captura datos detallados de eventos para que tu equipo pueda ver exactamente qué ocurrió en tus sistemas en cualquier momento.
- Constructor de consultas: Te permite hacer preguntas complejas sobre tus datos sin necesidad de escribir código.
- BubbleUp: Destaca automáticamente los valores atípicos de tus datos para que puedas detectar los problemas más rápidamente.
- Compatibilidad con trazas: Conecta las trazas con los registros y las métricas para que puedas entender cómo se desplaza una única solicitud por toda tu pila tecnológica.
- Paneles y vistas: Te ayuda a guardar, organizar y compartir las consultas o visualizaciones clave que tu equipo utiliza con frecuencia.
- Mapa de servicios: Muestra cómo interactúan tus servicios, lo que resulta útil para comprender las dependencias y el estado del sistema.
- Seguimiento de SLO: Te permite establecer y supervisar objetivos de nivel de servicio para mantener bajo control los objetivos de rendimiento.
- Herramientas de colaboración en equipo: Te permiten comentar consultas, compartir enlaces y trabajar conjuntamente en las investigaciones.
- Motor de consultas rápido: Responde rápidamente incluso con grandes conjuntos de datos, lo que resulta útil al depurar problemas en directo.
- Integraciones con herramientas como OpenTelemetry: Facilita la incorporación de datos de tu configuración actual.