

ETL-Arbeitsabläufe: Leitfaden zur Konzeption & bewährte Verfahren

Im Durchschnitt arbeiten Unternehmen regelmäßig mit 400 Datenquellen. Bei buchstäblich Hunderten von Datensätzen können Datenintegration und genaue Datenanalyse ohne die richtigen Arbeitsabläufe unmöglich sein.
In diesem Leitfaden stelle ich Ihnen ETL-Arbeitsabläufe vor und gebe Tipps zum Aufbau von ETL-Datenpipelines, die eine verbesserte Funktionalität und Datenqualität unterstützen.
Was sind ETL-Arbeitsabläufe?
Unser ultimativer Leitfaden zu ETL erläutert die Einzelheiten des ETL-Prozesses, einschließlich der Prozesse zum Extrahieren, Transformieren und Laden. Für eine optimale Funktionalität müssen diese Prozesse zusammenarbeiten, damit Informationen effizient von der Datenquelle zur Datenlagerung fließen.

ETL-Arbeitsabläufe sind für diesen Gesamtprozess verantwortlich. Sie umfassen typischerweise verschiedene API-Werkzeuge, Konnektoren und Datenverarbeitungsschritte, um sicherzustellen, dass der Prozess zum Extrahieren, Transformieren und Laden ordnungsgemäß funktioniert und die Anforderungen des Unternehmens unterstützt.
Vorteile von ETL-Arbeitsabläufen
Zu den Vorteilen leistungsstarker ETL-Arbeitsabläufe gehören:
- Verbesserter Datenzugriff. Mit den richtigen ETL-Prozessen können Sie Mitarbeitern den Zugriff auf Daten in Echtzeit ermöglichen. Der Prozess zum Extrahieren, Transformieren und Laden stellt sicher, dass Daten bei ihrer Speicherung sofort verwendet werden können, wodurch sich SQL-Berichte, Datenmodelle und andere Abfragen leichter ausführen lassen.
- Fähigkeit zur Verarbeitung großer Datenmengen. Fortschrittliche ETL-Prozesse können große Datensätze verarbeiten und unstrukturierte Daten integrieren, ohne zeitaufwendige manuelle Prozesse zu erfordern. Dies erleichtert es Unternehmen, große Datenmengen zu verwalten und daraus Nutzen zu ziehen.
- Bessere Datentransformationsprozesse. Der richtige ETL-Arbeitsablauf integriert Elemente wie Datenbereinigung und -transformation, um die Umwandlung von Rohdaten in strukturierte Datensätze zu verbessern, die Sie verwenden können.
- Unterstützung der Effizienz durch Automatisierung. Das Importieren von Quelldaten, das Ausführen von Validierungsprozessen und andere Aufgaben können von ETL-Werkzeugen übernommen werden, die Automatisierung unterstützen und dadurch den Zeitaufwand für die Datenverwaltung reduzieren.
- Fähigkeit, Geschäftsregeln in Datenverwaltungsprozesse zu integrieren. Sie können ETL-Lösungen an verschiedene Unternehmensanforderungen anpassen, einschließlich der Integration von Geschäfts- und Compliance-Regeln in den Arbeitsablauf zum Extrahieren, Transformieren und Laden.
ETL-Prozess-Übersicht
Bevor wir die wesentlichen Komponenten von ETL-Arbeitsabläufen und ihre Modellierung besprechen, betrachten wir zunächst, wie diese Prozesse funktionieren, einschließlich der Ziele und Herausforderungen jedes einzelnen Schritts.
Extrahieren
Während des Extraktionsschritts von ETL werden Informationen aus einer oder mehreren Datenquellen gesammelt. Bei der Datenextraktion können sowohl Rohdaten als auch zuvor verarbeitete Daten angetroffen werden, und Sie können mit verschiedenen Dateitypen arbeiten, darunter CSV und XML.
- Ziel: Die möglichst ganzheitliche und umfassende Datenerfassung.
- Herausforderungen: Datenseen und -quellen identifizieren, angemessenen Zugriff auf Daten erhalten und die Datenerfassung zeitlich so planen, dass aktuelle Prozesse gewährleistet sind.
Transformieren
Der Datentransformationsprozess umfasst die Konvertierung von Daten in Formate, die mit den relationalen Datenbanken und anderen von Ihnen gewünschten Methoden zur Datenspeicherung und -analyse funktionieren. Während dieses ETL-Schritts können Sie Werkzeuge für die Datenzuordnung und -bereinigung, die Entfernung von Duplikaten, die Formatierung, das Hinzufügen von Metadaten und andere Aufgaben in Betracht ziehen – sowohl durch Automatisierung als auch über manuelle Arbeitsabläufe.
- Ziel: Saubere, nutzbare Daten, die für die Verwendung in Ihrem Zielsystem oder Datenspeicher formatiert sind.
- Herausforderungen: Die Datenqualität ist eine häufige Herausforderung für Unternehmen bei der Datentransformation; je niedriger die Qualität, desto mehr Datentransformationsarbeit ist erforderlich. Zu den weiteren Herausforderungen gehören ein möglicher Datenverlust, die Integration mehrerer Datentypen und die Gewährleistung der Sicherheit während des gesamten Prozesses.
Laden
Im letzten Schritt der ETL-Prozesse laden Sie Daten in das endgültige Datenlager, sodass sie dem Unternehmen bei Bedarf zur Verfügung stehen.
- Ziel: Sicherzustellen, dass saubere Daten für die Verwendung in Analysen oder durch CRM-Systeme oder andere Unternehmenssoftware bereitstehen.
- Herausforderungen: Die Gewährleistung von Datenqualität und -sicherheit stellt auch in diesem Schritt eine Herausforderung dar. Unternehmen müssen Prozesse für die Datenverwaltung schaffen, um festzulegen, wer auf Daten zugreifen kann und wie dieser Zugriff erfolgt. Auch die Unterstützung des Datenzugriffs in Echtzeit – oder so nahe an Echtzeit wie möglich – kann wichtig sein, doch die Stapelverarbeitung kann zu Verzögerungen im Prozess führen.
Schlüsselkomponenten von ETL-Workflows
Der erste Schritt beim Erstellen von ETL-Workflows besteht darin, die wichtigsten Komponenten zu berücksichtigen, die enthalten sein sollten. Die Anwendungsfälle für diese Workflows sind unterschiedlich, und Sie müssen möglicherweise die individuellen Daten- und Prozessabhängigkeiten Ihrer Organisation berücksichtigen.
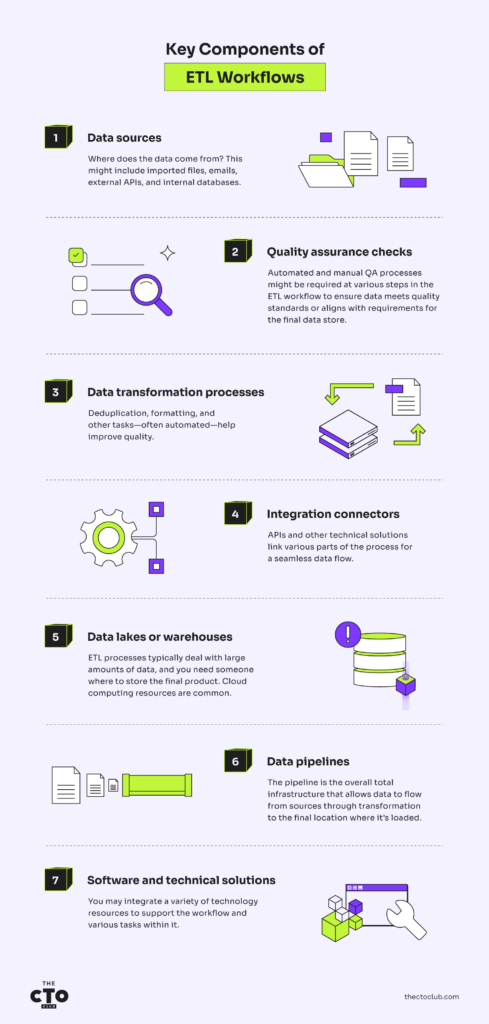
Zu den Komponenten, die Dateningenieure bei ETL-Workflows häufig berücksichtigen, gehören jedoch:
- Datenquellen. Woher stammen die Daten? Dazu können importierte Dateien, E-Mails, externe APIs und interne Datenbanken gehören.
- Qualitätssicherungsprüfungen. An verschiedenen Schritten im ETL-Workflow können automatisierte und manuelle Qualitätssicherungsprozesse erforderlich sein, um sicherzustellen, dass die Daten Qualitätsstandards erfüllen oder den Anforderungen an den endgültigen Datenspeicher entsprechen.
- Datenumwandlungsprozesse. Duplikatentfernung, Formatierung und andere Aufgaben – häufig automatisiert – tragen zur Verbesserung der Qualität bei.
- Integrationskonnektoren. APIs und andere technische Lösungen verbinden verschiedene Teile des Prozesses und ermöglichen einen nahtlosen Datenfluss.
- Data Lakes oder Data Warehouses. ETL-Prozesse verarbeiten typischerweise große Datenmengen, und Sie benötigen einen Ort, an dem das Endprodukt gespeichert werden kann. Cloud-Computing-Ressourcen sind weit verbreitet.
- Datenpipelines. Die Pipeline umfasst die gesamte Infrastruktur, die den Datenfluss von den Quellen über die Umwandlung bis zum endgültigen Speicherort ermöglicht, an dem die Daten geladen werden.
- Software und technische Lösungen. Sie können eine Vielzahl technischer Ressourcen integrieren, um den Workflow und die verschiedenen darin enthaltenen Aufgaben zu unterstützen.
Modellierung von ETL-Workflows
Bei der Modellierung Ihrer ETL-Pipelines müssen Sie berücksichtigen, ob Sie die Verarbeitung im Batch- oder im Stream-Modus durchführen möchten.
Erstellen einer ETL-Pipeline mit Batch-Verarbeitung
Bei der Batch-Verarbeitung verwaltet der Workflow Daten in Batches oder Datenblöcken. Jeder Batch wird typischerweise zeitlich festgelegt – Sie können beispielsweise täglich, mehrmals im Laufe des Tages oder zu Beginn jeder Stunde einen Batch verarbeiten.
Batch-Verarbeitung ist eine gute Lösung, wenn:
- Sie Skaleneffekte nutzen möchten
- Sie über Automatisierung verfügen, die große Datenmengen schnell verarbeiten kann
- Der Datenzugriff und die Datenverarbeitung nicht besonders zeitkritisch sind
Erstellen einer ETL-Pipeline mit Stream-Verarbeitung
Die Stream-Verarbeitung ermöglicht es, Daten in Echtzeit durch den ETL-Prozess fließen zu lassen, ohne dass sich an irgendeinem Punkt des Prozesses Daten-Batches ansammeln. Sie ist flexibler als die Batch-Verarbeitung, allerdings kann es bei diesem Pipeline-Typ schwieriger sein, Datenqualität und -konsistenz sicherzustellen.
Stream-Verarbeitung ist eine gute Lösung, wenn:
- Daten in kleinen Blöcken und in unregelmäßigen Abständen in Ihren Prozess gelangen
- Der Zugriff auf die Daten zeitkritisch ist und es daher entscheidend ist, die Daten sofort in den Prozess zu übernehmen
- Sie Zugriff auf aktuelle Erkenntnisse haben möchten, ohne auf die Verarbeitung von Batch-Daten zu warten
Beispiele für ETL-Workflows
Das Verständnis des spezifischen Datenflusses und der Datenverwaltungsanforderungen Ihrer Branche ist entscheidend für die erfolgreiche Planung von ETL-Workflows. Betrachten Sie diese Beispiele aus verschiedenen Branchen, um zu verstehen, wie Anforderungen und Abhängigkeiten variieren können.
ETL für Datenflüsse im Gesundheitswesen
Organisationen im Gesundheitswesen benötigen einen genauen und zeitnahen Zugriff auf Patienten- und Behandlungsdaten, wodurch ETL-Prozesse für den Erfolg unverzichtbar werden. Daten können aus verschiedenen Quellen stammen, darunter Patientenportale, elektronische Gesundheitsakten, bildgebende Geräte und Drittanbieter wie Pharmaunternehmen.
Eine der größten Herausforderungen bei ETL im Gesundheitswesen besteht darin, sichere Prozesse zu schaffen, die Vorschriften wie HIPAA erfüllen. Diese Prozesse hängen außerdem von Datenquellen ab, die von Patienten, Leistungserbringern und Automatisierung gespeist werden, wodurch zusätzliche Herausforderungen bei der Datenumwandlung entstehen.
Bei der Modellierung von Datenpipelines im Gesundheitswesen müssen Sie möglicherweise Stream- und Batch-Verarbeitung einsetzen. Beispielsweise benötigen Leistungserbringer möglicherweise Echtzeitzugriff auf Diagnosedaten, während Kodierungs- und Abrechnungsdaten für die Schadenabwicklung am Ende des Tages als Batch verarbeitet werden können.
ETL für E-Commerce-Datenflüsse
E-Commerce-Daten stammen aus vielen Quellen, darunter E-Mails, Kundenportale, APIs und Apps, soziale Medien, Websites, CRM-Systeme sowie Buchhaltungs- oder Zahlungsprozesse. Dadurch entsteht eine enorme Herausforderung bei der Umwandlung von Daten, ohne deren Qualität zu beeinträchtigen.
Die Stapelverarbeitung eignet sich typischerweise gut für viele E-Commerce-Prozesse. Beispielsweise können Sie stündlich Bestelldaten abrufen und sie ETL-Prozessen zuführen, die Lager- und Versandaufgaben unterstützen. Sie können Zahlungsdaten auch täglich auslesen, damit die Finanzunterlagen aktualisiert werden.
Wenn Sie Ihren Kunden jedoch einen Self-Service rund um die Uhr bieten möchten, sind Workflow-Prozesse auf Basis von Datenströmen möglicherweise besser geeignet. Angenommen, Sie haben einen Chatbot, der Kunden Informationen zu Bestellungen, Zahlungen, Rücksendungen und Gutschriften bereitstellt. Wenn Ihre ETL-Prozesse in täglichen Stapeln ausgeführt werden, sind die Informationen, die Ihr Chatbot bereitstellt, immer mindestens 24 Stunden veraltet.
ETL für Finanzdatenflüsse
Banken, Kreditkartenunternehmen, Apps zur Geldverwaltung und andere Organisationen und Dienste im Finanzsektor sind in hohem Maße auf genaue Daten angewiesen. Diese Organisationen müssen außerdem strenge Vorschriften und Compliance-Standards einhalten, um die Sicherheit der Daten zu gewährleisten.
Zu den Datenquellen können importierte Daten anderer Finanzorganisationen, ACH- und Clearingdaten, Informationen aus kundenorientierten Apps sowie weniger strukturierte Formate wie E-Mails gehören. Finanzorganisationen möchten möglicherweise auch eine Kombination aus Stapel- und Datenstrom-Pipelines einsetzen, um den Anforderungen ihrer Kunden gerecht zu werden.
Technologische Fortschritte bei ETL-Prozessen
Vor mehreren Jahrzehnten revolutionierte die Cloud-Technologie die Datenverarbeitung, und sie ist nach wie vor ein wesentlicher Bestandteil der Weiterentwicklung von Data-Warehouse-Software und entsprechenden Lösungen. Derzeit konzentrieren sich die Trends bei der Weiterentwicklung der ETL-Technologie jedoch meist auf die Integration von KI, maschinellem Lernen und Automatisierung in Workflows. Zu den spezifischen Fortschritten gehören:
- Die Fähigkeit von KI, mit großen Datenmengen umzugehen. Werkzeuge für künstliche Intelligenz können enorme Datenmengen innerhalb von Sekunden verarbeiten und dadurch die Skalierbarkeit von ETL-Prozessen unterstützen, die bisher nicht möglich war.
- Verarbeitung natürlicher Sprache. Maschinelles Lernen und die Verarbeitung natürlicher Sprache ermöglichen es automatisierten Lösungen, die Datentransformation mit einem umfassenderen Spektrum an Fähigkeiten zum „kritischen Denken“ anzugehen, als dies bisher möglich war. Dadurch entstehen Möglichkeiten zur Automatisierung von Aufgaben, die in der Vergangenheit menschliches Eingreifen erforderten.
- Unterstützung der Datenverwaltung. Nahezu jede Branche ist heute mit erweiterten regulatorischen Anforderungen konfrontiert, und Technologielösungen tragen zunehmend dazu bei, die Einhaltung von Vorschriften und die Sicherheit von Daten zu gewährleisten.
Bewährte Verfahren zur Optimierung von ETL-Workflows
Was für eine andere Organisation am besten funktioniert, muss für Ihr Unternehmen in Bezug auf ETL nicht unbedingt die beste Vorgehensweise sein. Ich habe jedoch einige allgemeine bewährte Verfahren zusammengestellt, die Sie implementieren können, um ETL-Workflows in nahezu jeder Umgebung zu optimieren.
- Wählen Sie die richtigen Werkzeuge für Ihre Anforderungen. Informieren Sie sich über Werkzeuge für ETL-Workflows und -Prozesse, um Partner und Lösungen zu finden, die Ihren individuellen Datenanforderungen gerecht werden. Erwägen Sie, ein Team zusammenzustellen, um die gewünschten ETL-Workflows abzubilden, die Herausforderungen aufzulisten, mit denen Sie konfrontiert sind, und potenzielle Lösungen unter Berücksichtigung dieser Faktoren zu bewerten.
- Stellen Sie sicher, dass Ihre Workflow-Auswahl korrekt ist. Nehmen Sie sich Zeit, um den Unterschied zwischen ETL und ELT zu verstehen und zu prüfen, ob Sie Stapel- oder Datenstrom-Workflows benötigen.
- Überwachen Sie Ihre Prozesse regelmäßig. Verwenden Sie Werkzeuge wie den SQL Server-Leistungsmonitor – oder andere relevante Leistungsüberwachungen –, um zu verstehen, wie Ihre ETL-Workflows funktionieren. Behalten Sie Effizienz- und Qualitätskennzahlen im Auge und nehmen Sie bei Bedarf Anpassungen zur kontinuierlichen Verbesserung vor.
- Integrieren Sie Technologie, die Qualität und Skalierbarkeit unterstützt. Erwägen Sie Optionen wie parallele Datenverarbeitung und Datenkomprimierung, um Ihre Workflows zu optimieren.
Wichtige Erkenntnisse
Die Gestaltung Ihrer ETL-Workflows kann über Erfolg oder Misserfolg Ihrer Datenprozesse entscheiden. Nehmen Sie sich Zeit, die Auswirkungen von Workflow-Entscheidungen zu berücksichtigen, ideale Workflows abzubilden und die richtigen Werkzeuge zur Unterstützung der Datenextraktion, -transformation und des Ladens auszuwählen.
Bleiben Sie über bewährte Verfahren für Technologie und Daten auf dem Laufenden, indem Sie den Newsletter des CTO Club abonnieren.


