

10 beste DataOps-Tools im Test 2026
Auswahl der besten DataOps-Tools


Die besten DataOps-Tools helfen Teams dabei, Datenpipelines zu erstellen, zu überwachen und zu verwalten, die tatsächlich zuverlässige Ergebnisse liefern. Sie automatisieren Qualitätsprüfungen, verfolgen die Datenherkunft und bieten Einblick in Workflows, sodass Daten sicher und effizient von der Quelle zum Ziel gelangen.
Wenn Sie schon einmal stundenlang fehlgeschlagene ETL-Aufträge mit vagen Fehlermeldungen debuggen mussten, mit isolierten Systemen jongliert haben, die sich nicht integrieren lassen, oder ohne klare Nachverfolgung der Datenherkunft durch ein Compliance-Audit hetzen mussten, wissen Sie, wie störend mangelhafte Datenoperationen sein können. Diese Herausforderungen verlangsamen die Bereitstellung, erhöhen die Risiken und untergraben das Vertrauen in die Daten, von denen Ihr Unternehmen abhängt.
Ich habe mit Dateningenieuren und Produktteams in schnell wachsenden SaaS-Umgebungen gearbeitet und Plattformen unter realen Bedingungen bewertet, bei denen Leistung, Sicherheit und Prüfbarkeit nicht beeinträchtigt werden dürfen. Ich habe Tools in Entwicklungs-, Staging- und Produktionsumgebungen getestet, um diejenigen herauszufiltern, die lediglich Lösungen vermarkten, und von denen zu unterscheiden, die tatsächlich Reibungsverluste reduzieren und die Zuverlässigkeit verbessern.
In diesem Leitfaden erfahren Sie, welche DataOps-Plattformen umsetzbare Erkenntnisse liefern, störende Meldungen reduzieren und Ihrem Team helfen, schneller und mit größerer Zuversicht voranzukommen.
Warum Sie unseren Software-Bewertungen vertrauen können
Wir testen und bewerten seit 2023 Software. Als Technologie-Führungskräfte wissen wir, wie kritisch und herausfordernd es ist, die richtige Entscheidung bei der Softwareauswahl zu treffen.
Wir investieren viel in gründliche Recherche, um unserer Zielgruppe zu helfen, bessere Kaufentscheidungen zu treffen. Wir haben über 2.000 Tools für verschiedene Technikanwendungsfälle getestet und mehr als 1.000 umfassende Softwarebewertungen geschrieben. Erfahren Sie wie wir transparent bleiben und unsere Methodik der Softwarebewertung.
Zusammenfassung der besten DataOps-Tools
Diese Vergleichstabelle fasst die Preisdetails meiner besten Auswahl an DataOps-Tools zusammen und hilft Ihnen dabei, das beste Tool für Ihr Budget und Ihre geschäftlichen Anforderungen zu finden.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Am besten für Analysen im großen Maßstab | Nein | $99/user/month | Website | |
| 2 | Am besten für die Orchestrierung von Datenpipelines | Kostenlose Demo verfügbar | Preis auf Anfrage | Website | |
| 3 | Am besten geeignet für Datenschutzmanagement | Kostenloser Tarif verfügbar | Ab $150/Monat (jährlich abgerechnet) | Website | |
| 4 | Am besten für SQL-Workflow-Kollaboration | 21-tägige kostenlose Testversion | Ab $199/Benutzer/Jahr (jährliche Abrechnung) | Website | |
| 5 | Am besten geeignet für die Automatisierung der Datenvorbereitung | Nein | $5,195/user/year (entspricht etwa $433/user/month) | Website | |
| 6 | Am besten für hybride Datenintegration | Nein | $1/User/Stunde für Datenbewegungsaktivitäten | Website | |
| 7 | Am besten geeignet für die Integration von Unternehmensdaten | Nein | Preis auf Anfrage | Website | |
| 8 | Am besten geeignet für SQL-ähnliche Abfragen | Not available | Kostenlos | Website | |
| 9 | Am besten geeignet für Suche und Datenanalyse | Nein | $16/user/month | Website | |
| 10 | Am besten geeignet für das Management von Echtzeitdatenflüssen | Not available | Kostenlos | Website |
Bewertungen der besten DataOps-Tools
Nachfolgend finden Sie meine ausführlichen Zusammenfassungen der besten DataOps-Tools, die es in meine Auswahl geschafft haben. Meine Bewertungen bieten einen detaillierten Einblick in die wichtigsten Funktionen, Vor- & Nachteile, Integrationen und idealen Anwendungsfälle jedes Tools, damit Sie das beste Tool für sich finden.

Am besten für Analysen im großen Maßstab
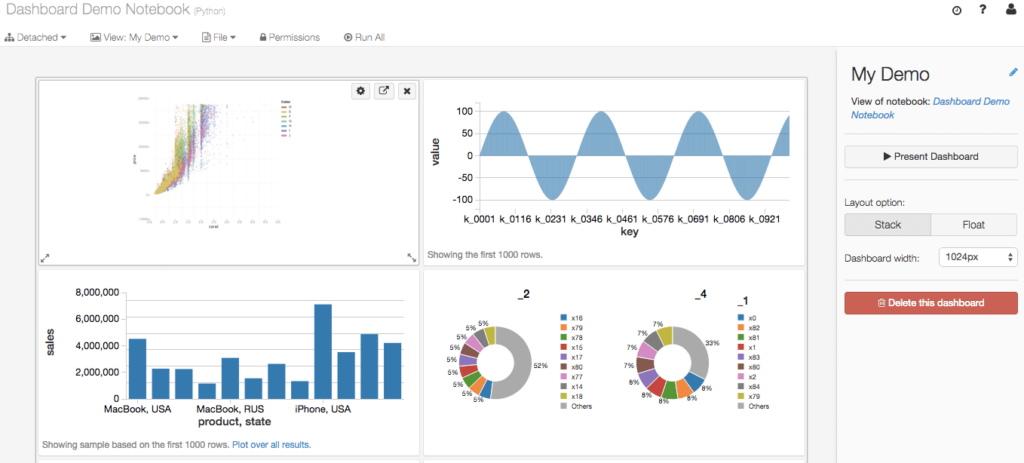
Databricks ist eine Daten- und KI-Plattform, die speziell für den Einsatz in Unternehmen entwickelt wurde und sich an Data Engineers, Data Scientists und Analysten richtet. Sie bietet Funktionen für Datenverarbeitung, Analysen und maschinelles Lernen.
Warum ich Databricks gewählt habe: Die Plattform überzeugt bei Analysen im großen Maßstab und bietet kollaborative Notebooks sowie Delta Lake für eine hohe Datenzuverlässigkeit. Ihr Team profitiert von fortschrittlichen Tools für maschinelles Lernen, die die Analysefähigkeiten erweitern. Die robuste Unterstützung für Apache Spark gewährleistet eine effiziente Verarbeitung großer Datenmengen. Flexible Integrationen mit führenden Cloud-Anbietern wie AWS, Azure und Google Cloud erhöhen die Attraktivität für groß angelegte Einsätze zusätzlich.
Herausragende Funktionen & Integrationen:
Funktionen umfassen kollaborative Notebooks, die Teamarbeit und Innovation fördern. Delta Lake sorgt für Datenzuverlässigkeit und -konsistenz, was bei Big-Data-Aufgaben entscheidend ist. Mit den Funktionen für maschinelles Lernen kann Ihr Team Modelle effizient erstellen und bereitstellen.
Integrationen sind unter anderem Apache Spark, AWS, Azure, Google Cloud, Tableau, Power BI, Snowflake, MongoDB, Looker und Qlik.
Pros and Cons
Pros:
- Flexible Cloud-Integrationen
- Unterstützt Big-Data-Verarbeitung
- Fortschrittliche Werkzeuge für maschinelles Lernen
Cons:
- Komplexe Preisstruktur
- Gelegentliche Leistungsprobleme

Am besten für die Orchestrierung von Datenpipelines
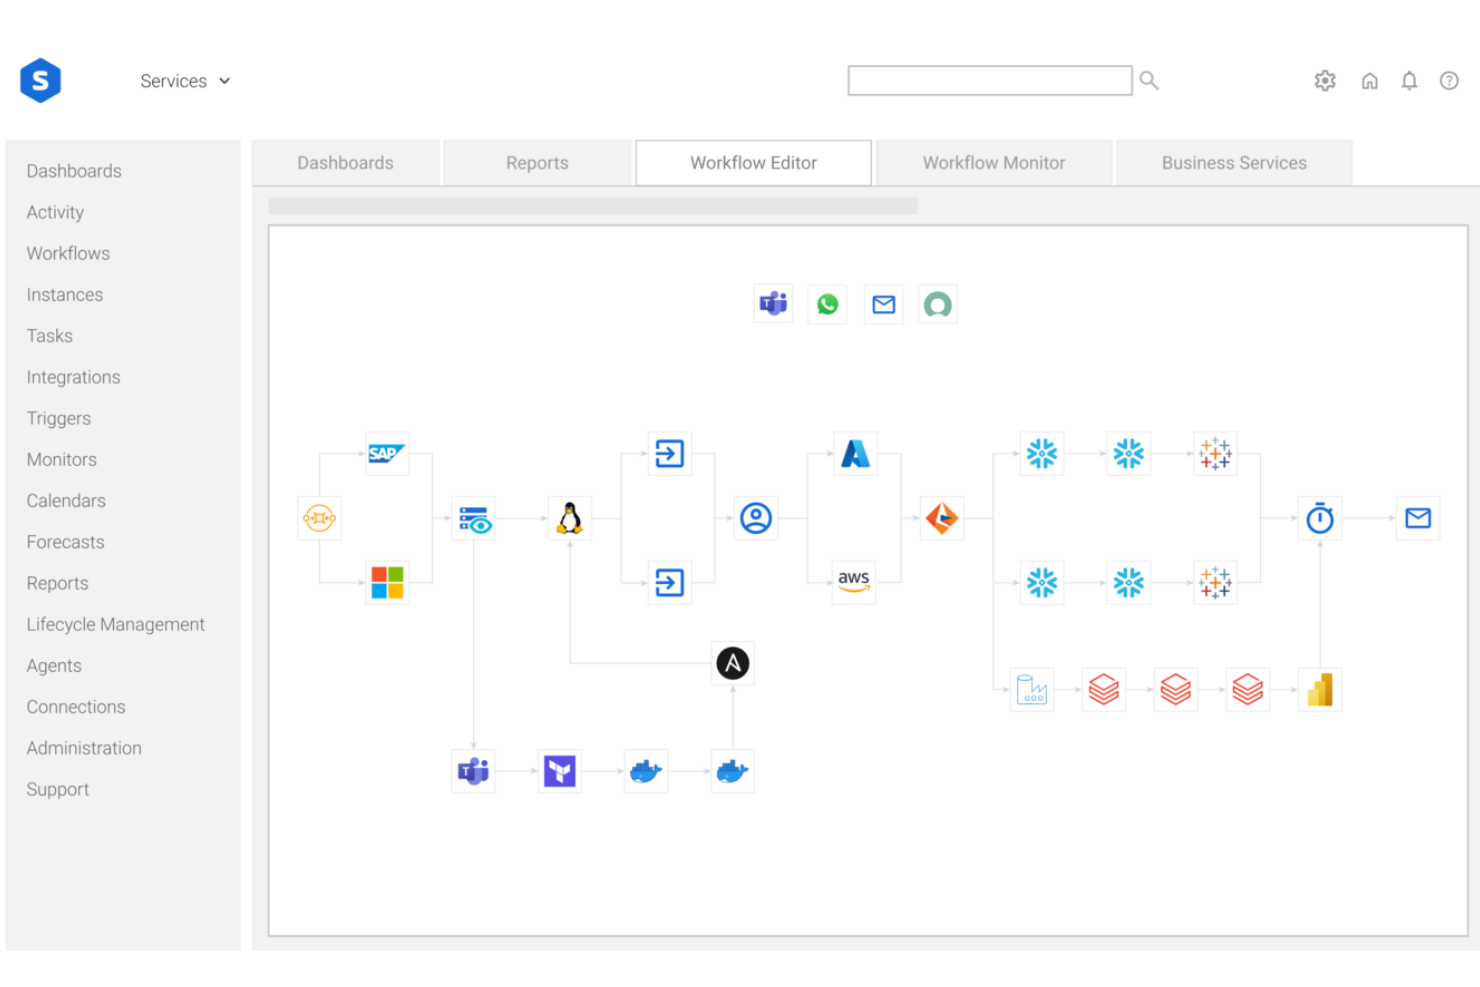
Das Stonebranch Universal Automation Center bietet IT-Teams eine zuverlässige Lösung zur Verbesserung ihrer Datenoperationen. Entwickelt für IT-Fachleute und Unternehmen, die ihre Daten-Workflows optimieren möchten, bewältigt es die Komplexität hybrider IT-Umgebungen, indem es Datenpipelines nahtlos orchestriert und Workflows über verschiedene Plattformen automatisiert. Mit seiner benutzerfreundlichen Oberfläche ist das Tool besonders attraktiv für Teams, die den manuellen Aufwand reduzieren und die betriebliche Effizienz steigern wollen.
Warum ich das Stonebranch Universal Automation Center gewählt habe
Ich habe mich für das Stonebranch Universal Automation Center aufgrund seiner einzigartigen Fähigkeit zur Orchestrierung von Datenpipelines entschieden – ein entscheidender Aspekt von DataOps. Die Echtzeit-Automatisierung in hybriden IT-Umgebungen der Plattform ermöglicht es Ihrem Team, komplexe Workflows sowohl in der Cloud als auch vor Ort zu verwalten. Die ereignisgesteuerte Automatisierung sorgt dafür, dass Workflows als Reaktion auf bestimmte Datenauslöser ausgeführt werden und steigert so die betriebliche Agilität. Diese Funktionen sind ideal für IT-Abteilungen, die ihr Datenmanagement optimieren und Abläufe ohne umfangreiche manuelle Eingriffe rationalisieren möchten.
Wichtige Funktionen des Stonebranch Universal Automation Center
Neben der Orchestrierung von Datenpipelines bietet das Stonebranch Universal Automation Center folgende Funktionen:
- Managed File Transfer: Kontrolliert den Datenfluss zwischen verschiedenen Umgebungen sicher, einschließlich B2B-Dateiübertragungen.
- Infrastruktur- & Serviceautomatisierung: Verwalten von Rechen-, Netzwerk- und Speicherressourcen nahtlos.
- Analyse & Beobachtbarkeit: Bietet fortschrittliche Berichte und prädiktive Funktionen zur Verbesserung des Service-Levels.
Stonebranch Universal Automation Center Integrationen
Integrationen umfassen Amazon Web Services (AWS), SAP, ServiceNow, Red Hat, Google Cloud, Kubernetes, Microsoft, Docker und Informatica.
Pros and Cons
Pros:
- Erweitertes Monitoring auf Mainframes und in Cloud-Umgebungen
- Umfassende Automatisierungsfunktionen für vielfältige IT-Prozesse
- Hohe Verfügbarkeit und Failover-Funktionen erhöhen die Zuverlässigkeit
Cons:
- Nutzer berichten von unzureichender Dokumentation für Einsteiger
- Begrenzte Cloud-Verfügbarkeit und Skalierbarkeit im Vergleich zu Alternativen

Ketch
Am besten geeignet für Datenschutzmanagement
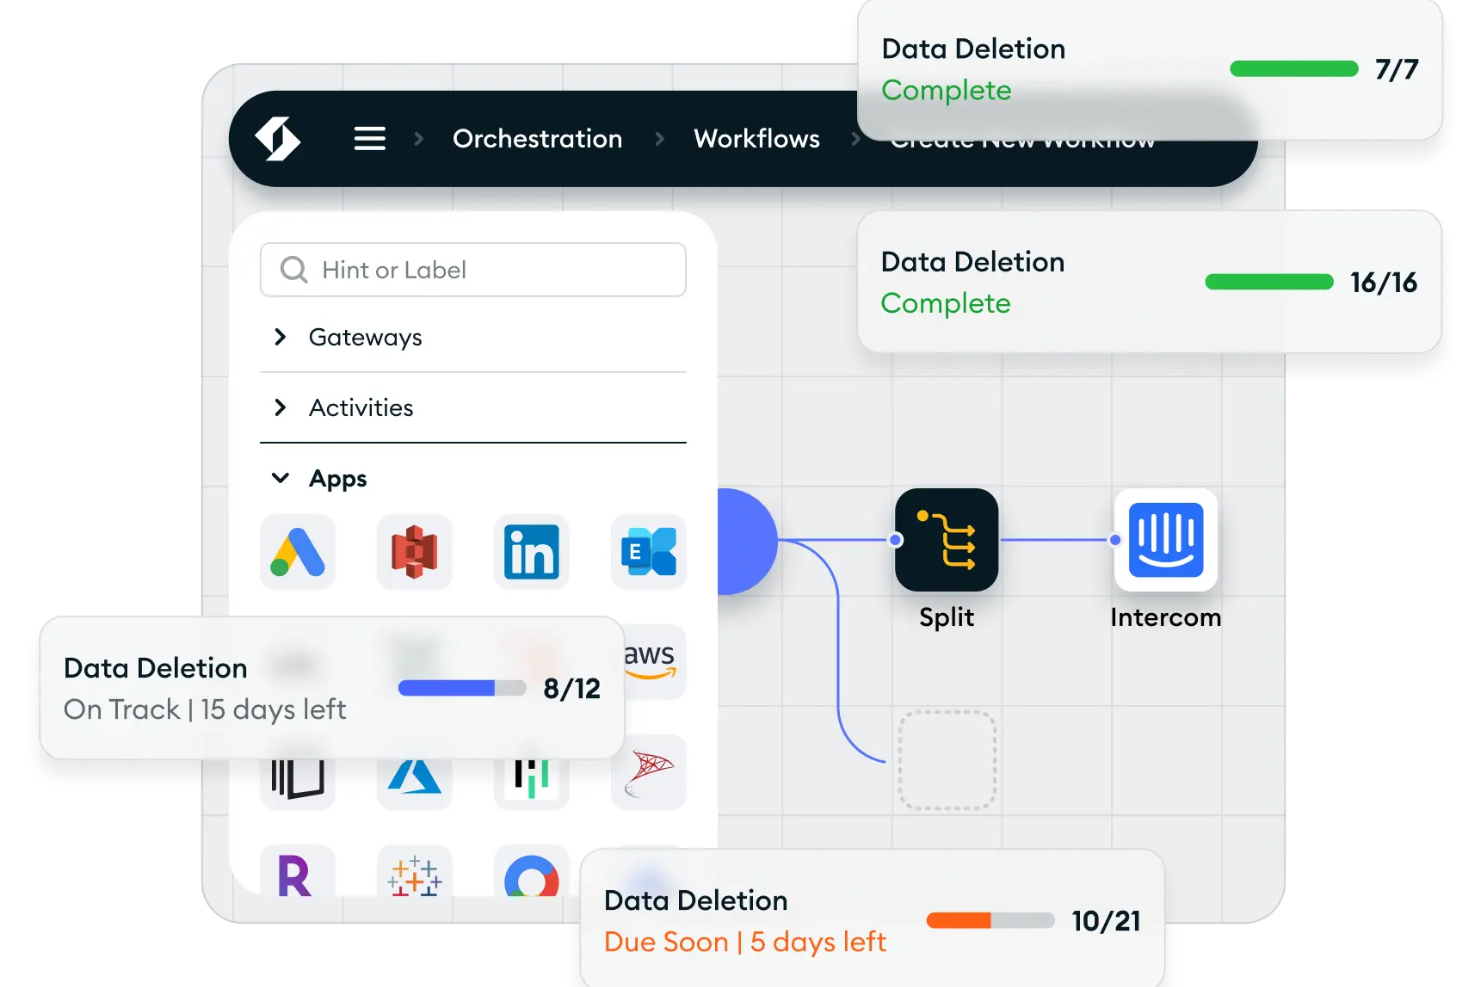
Ketch ist eine Datenschutzmanagement-Software, die speziell für Unternehmen entwickelt wurde, die Wert auf Compliance und den Schutz der Privatsphäre legen. Sie richtet sich an Fachleute aus den Bereichen Recht, Marketing und Technologie und bietet Werkzeuge wie Einwilligungsmanagement und Datenmapping.
Warum ich Ketch gewählt habe: Der Fokus liegt auf der Einhaltung von Vorschriften wie der DSGVO und dem CCPA. Ketch automatisiert Datenschutzprozesse, einschließlich der Automatisierung von Betroffenenanfragen (DSR) und Risikobewertungen, was Ihrem Team Zeit spart. Außerdem erhalten Sie anpassbare Datenschutzhinweise, um die Kundenbeziehungen zu stärken. Dank der Integration mit über 1.000 Systemen ist Ketch flexibel und daher ideal für datenschutzorientierte Unternehmen geeignet.
Hervorstechende Funktionen & Integrationen:
Funktionen umfassen anpassbare Datenschutzvorlagen, Werkzeuge zur Risikobewertung und automatisierte Workflows. Mit Ketch können Sie Einwilligungen und Betroffenenanfragen einfach verwalten und so die Produktivität durch weniger manuelle Aufgaben steigern. Die Plattform bietet außerdem eine benutzerfreundliche Oberfläche, die eine schnelle Einrichtung und Einarbeitung ermöglicht.
Integrationen gibt es mit Salesforce, HubSpot, Marketo, Microsoft Dynamics, Google Analytics, Adobe Experience Cloud, Amazon Web Services, Oracle, SAP und Workday.
Pros and Cons
Pros:
- Verbessert die Kundenbeziehungen
- Unterstützt über 1.000 Integrationen
- Schnelle Einrichtung und Einarbeitung
Cons:
- Begrenzte Anpassungsmöglichkeiten
- Regelmäßige Aktualisierungen hinsichtlich der Gesetzgebung erforderlich
New Product Updates from Ketch
Ketch Launches Iris-Powered Tracker Scanning
Ketch adds Iris-powered tracker scanning to Data Sentry and Consent Management, using cohort-based page grouping and adaptive sampling to expand tracker coverage and keep results current. For more information, visit Ketch’s official site.
 .

Am besten für SQL-Workflow-Kollaboration
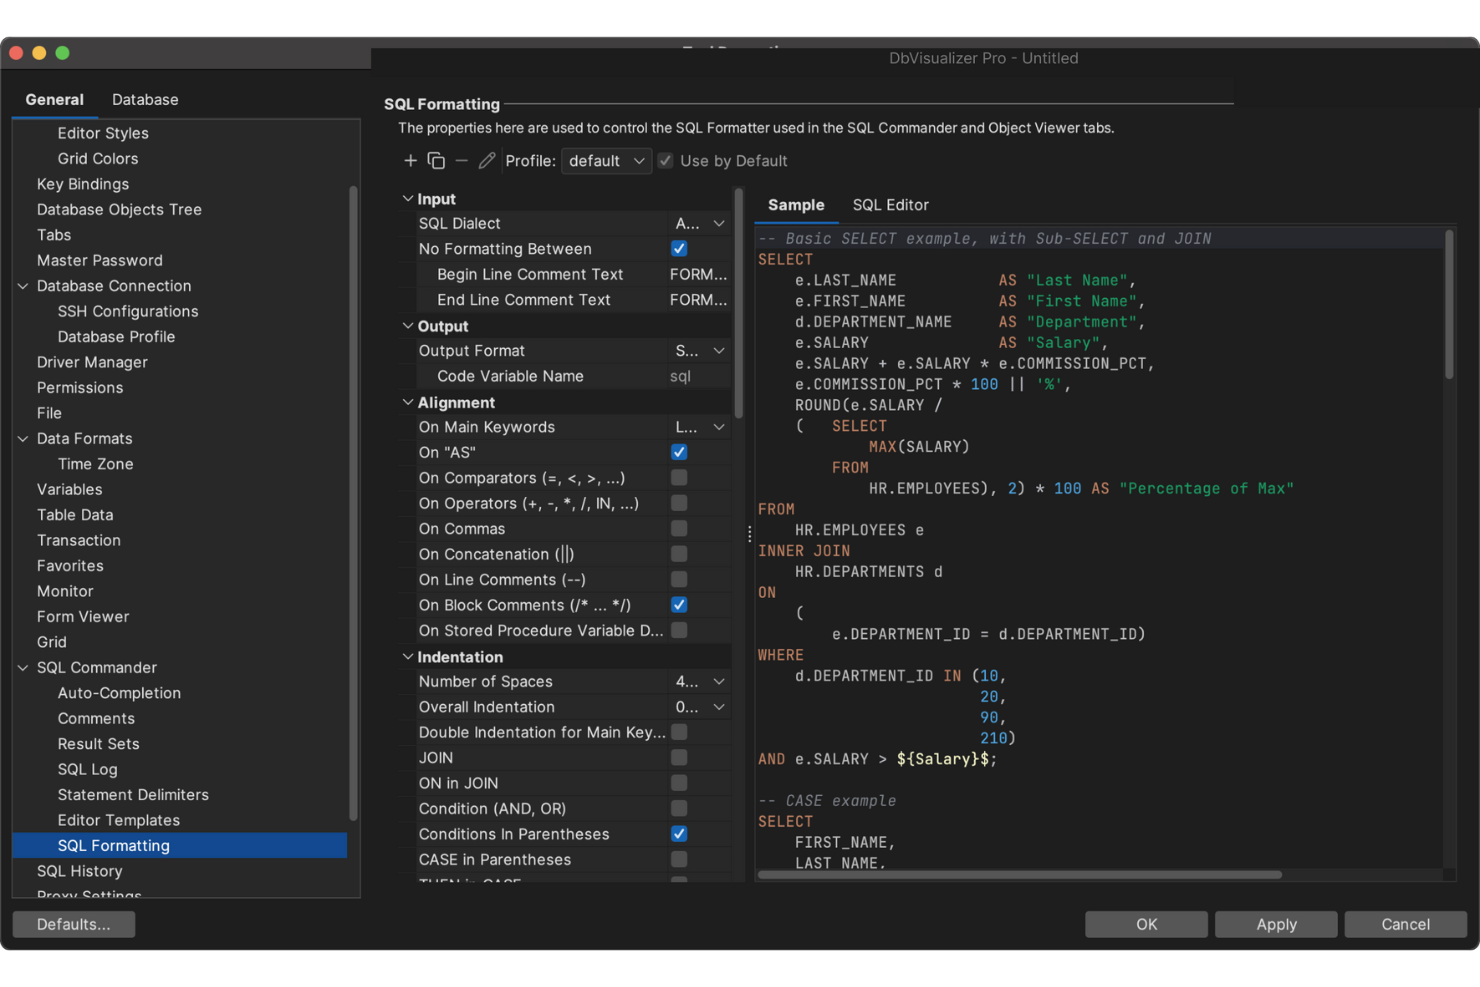
Für Teams, die eine zuverlässige DataOps-Lösung suchen, bietet DbVisualizer eine vielseitige Plattform, die unterschiedlichste Anforderungen im Datenbankmanagement abdeckt. Sie eignet sich ideal für Datenprofis aus verschiedenen Branchen, die ein einheitliches Tool zur Verwaltung komplexer Datenbanken benötigen. Mit Funktionen wie fortschrittlicher SQL-Bearbeitung und leistungsstarker Datenvisualisierung begegnet DbVisualizer Herausforderungen in der Datenintegration und -verwaltung und ist somit ein wertvoller Vorteil zur Optimierung von Daten-Workflows.
Warum ich DbVisualizer gewählt habe
Ich habe DbVisualizer gewählt, weil das auf Workflows ausgerichtete SQL-Tooling optimal zur iterativen Arbeitsweise von DataOps-Teams passt – bei der Validierung und Übernahme von Änderungen über verschiedene Umgebungen hinweg. Sie können an SQL-Skripten gemeinsam arbeiten, dank integrierter Versionsverwaltung, die es leichter macht, Änderungen nachzuvollziehen, Arbeiten aufzuteilen und einen klaren Prüfpfad für Transformationen zu erhalten. Visuelle Erklärungspläne helfen Ihrem Team dabei, die Abfrageleistung vor Änderungen zu bewerten, wodurch Störungen in Datenpipelines minimiert werden. Außerdem gefällt mir, dass Sie die Skriptausführung außerhalb der Benutzeroberfläche automatisieren können mit
Hauptfunktionen von DbVisualizer
Mir gefällt auch, dass DbVisualizer Folgendes bietet:
- Datenexploration: Erlaubt das einfache Durchsuchen und Verwalten komplexer Datenstrukturen innerhalb Ihrer Datenbanken.
- Inline-Bearbeitung: Ermöglicht das direkte Bearbeiten von Daten innerhalb von Tabellen und vereinfacht somit die Datenmanipulation.
- Kommandozeilen-Management: Unterstützt die Ausführung von Skripten und Aufgaben rund um das Datenmanagement über eine Kommandozeilenschnittstelle, was die Automatisierung fördert.
- Datenexport/-import: Erleichtert den Transfer von Daten in verschiedenen Formaten und unterstützt so nahtlose Datenintegration und -weitergabe.
DbVisualizer-Integrationen
Zu den Integrationen gehören DB2, MariaDB, SQL Server, MySQL, PostgreSQL, Oracle, Apache Derby, H2, SQLite und Sybase.
Pros and Cons
Pros:
- Fokus auf visuelle Datenveranschaulichung für klarere Einsichten
- Fortschrittlicher SQL-Editor mit Funktionen wie Auto-Vervollständigung und Formatierung
- Unterstützt verschiedene Datenbanktypen und ermöglicht vielseitiges Datenbankmanagement
Cons:
- Bei größeren Datensätzen kann die Performance gelegentlich beeinträchtigt sein
- Neue Nutzer müssen mit einer leichten Einarbeitungszeit rechnen
New Product Updates from DbVisualizer

DbVisualizer Adds AI Enhancements, Map Visualization, and SQL Tab Groups
DbVisualizer expands AI capabilities, introduces geospatial map visualization, and adds SQL Commander tab groups. The release also improves audit logging, database connection management, and database support to streamline development workflows. For more information, visit DbVisualizer's official site.
 .

Alteryx
Am besten geeignet für die Automatisierung der Datenvorbereitung
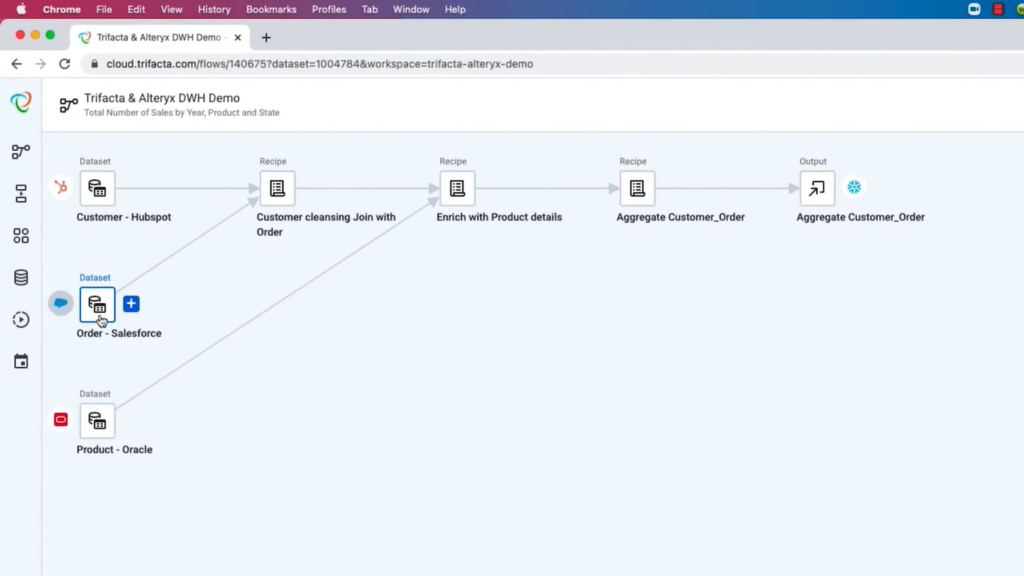
Alteryx ist eine Datenanalyseplattform, die Nutzern hilft, Daten aus verschiedenen Quellen vorzubereiten, zusammenzuführen und zu analysieren. Sie bietet sowohl Desktop- als auch Cloud-basierte Lösungen und richtet sich an Fachleute, die Daten-Workflows automatisieren und effizient Erkenntnisse gewinnen möchten.
Warum ich Alteryx ausgewählt habe: Sie können mit der Drag-and-Drop-Oberfläche von Alteryx sich wiederholende Aufgaben der Datenvorbereitung automatisieren. Die Plattform stellt über 300 No-Code- und Low-Code-Tools bereit, mit denen Ihr Team Daten bereinigen, transformieren und anreichern kann, ohne eine einzige Zeile Code zu schreiben. Sie unterstützt sowohl strukturierte als auch unstrukturierte Daten, sodass Sie mit unterschiedlichsten Datensätzen arbeiten können. Zusätzlich bietet Alteryx KI-gestützte Empfehlungen zur Optimierung Ihrer Workflows an.
Herausragende Funktionen & Integrationen:
Funktionen umfassen Tools für räumliche Analysen, mit denen Ihr Team standortbezogene Auswertungen durchführen kann. Sie können außerdem integrierte Machine-Learning-Funktionen nutzen, um prädiktive Modelle zu erstellen, ohne umfangreiche Programmierkenntnisse zu benötigen. Darüber hinaus unterstützt Alteryx die Verarbeitung von Echtzeitdaten, sodass Sie auf Basis aktueller Daten zeitnah Entscheidungen treffen können.
Integrationen bestehen zu Salesforce, Snowflake, Amazon Redshift, Google BigQuery, Microsoft Azure, Tableau, Power BI, Oracle, SAP und Databricks.
Pros and Cons
Pros:
- Bietet KI-gestützte Empfehlungen für Workflows
- Automatisiert komplexe Aufgaben der Datenvorbereitung
- Verarbeitet sowohl strukturierte als auch unstrukturierte Daten
Cons:
- Begrenzte Möglichkeiten zur Datenvisualisierung
- Für einige Funktionen ist eine eigene Lizenz erforderlich

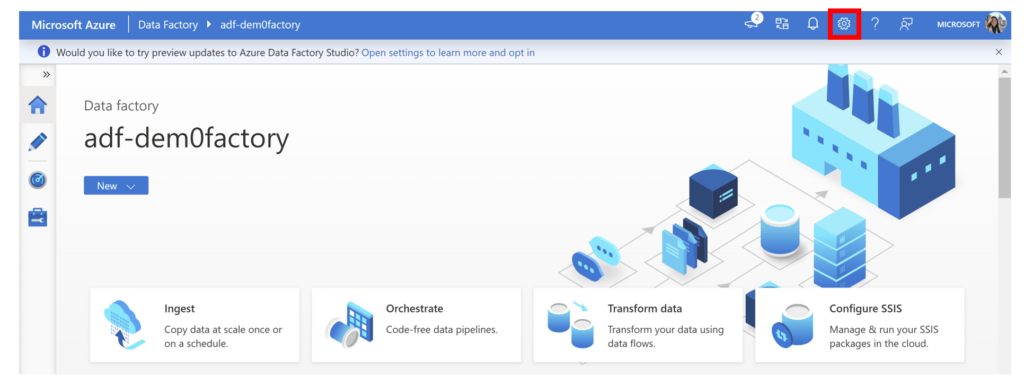
Azure Data Factory ist ein cloudbasierter Dienst zur Datenintegration für Data Engineers und Analysten. Er ermöglicht die Erstellung, Planung und Orchestrierung von Daten-Workflows und unterstützt sowohl Cloud- als auch lokale Datenquellen.
Warum ich Azure Data Factory gewählt habe: Der Dienst glänzt bei der Integration hybrider Datenumgebungen und erlaubt Ihrem Team, verschiedene Datenlandschaften miteinander zu verbinden. Die Drag-and-Drop-Oberfläche vereinfacht das Erstellen komplexer Workflows. Mit den integrierten Planungsfunktionen können Sie Datenbewegungen automatisieren und so manuelle Tätigkeiten reduzieren. Funktionen zur Überwachung in Echtzeit bieten Einblicke in Datenprozesse und steigern die betriebliche Effizienz.
Herausragende Funktionen & Integrationen:
Funktionen umfassen eine intuitive Drag-and-Drop-Oberfläche zum Entwerfen von Datenpipelines. Integrierte Planungstools automatisieren Daten-Workflows und sparen Zeit und Aufwand. Die Überwachung in Echtzeit verschafft Transparenz bei den Datenoperationen und hilft, Probleme schnell zu erkennen und zu lösen.
Integrationen beinhalten Azure Blob Storage, Azure SQL Database, Azure Synapse Analytics, Amazon S3, Google BigQuery, Oracle, SAP, Salesforce, Teradata und IBM Db2.
Pros and Cons
Pros:
- Einfache Drag-and-Drop-Oberfläche
- Unterstützt verschiedene Datenumgebungen
- Echtzeitüberwachung
Cons:
- Komplexität bei der Ersteinrichtung
- Eingeschränkte Offline-Funktionalität

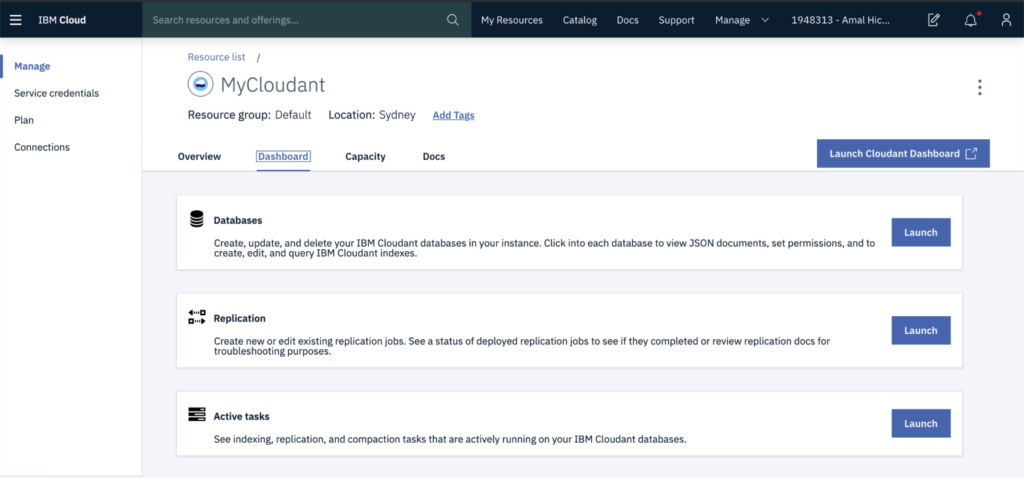
IBMs DataOps-Plattform ist für große Unternehmen konzipiert und richtet sich an IT-Fachleute und Dateningenieure. Sie konzentriert sich auf Datenintegration, Governance und Qualität und stellt sicher, dass Ihre Datenprozesse effizient und zuverlässig ablaufen.
Warum ich IBM gewählt habe: Das Tool überzeugt bei der Integration von Unternehmensdaten und bietet Werkzeuge wie Datenkatalogisierung und Governance. Sie können Workflows automatisieren, was hilft, die Datenqualität im gesamten Unternehmen zu erhalten. Die Datenherkunftsfunktion der Plattform sorgt für Transparenz, sodass Sie Datenquellen und -transformationen nachvollziehen können. Dank der Skalierbarkeit eignet sich die Lösung besonders für große Unternehmen, die große Datenmengen effizient verwalten müssen.
Hervorstechende Funktionen & Integrationen:
Funktionen umfassen Datenkatalogisierung, mit der Sie Ihre Datenbestände organisieren können. Die Governance-Tools der Plattform stellen die Einhaltung von Datenvorschriften sicher. Automatisierte Datenqualitätsprüfungen helfen, die Integrität Ihrer Datensätze zu gewährleisten.
Integrationen umfassen IBM Cloud, AWS, Azure, Google Cloud, Hadoop, Apache Spark, Oracle, SAP, Salesforce und Tableau.
Pros and Cons
Pros:
- Umfassende Tools für Daten-Governance
- Unterstützt groß angelegte Datenoperationen
- Automatisierte Qualitätsprüfungen
Cons:
- Könnte eine hohe Lernkurve haben
- Begrenzte Anpassungsmöglichkeiten

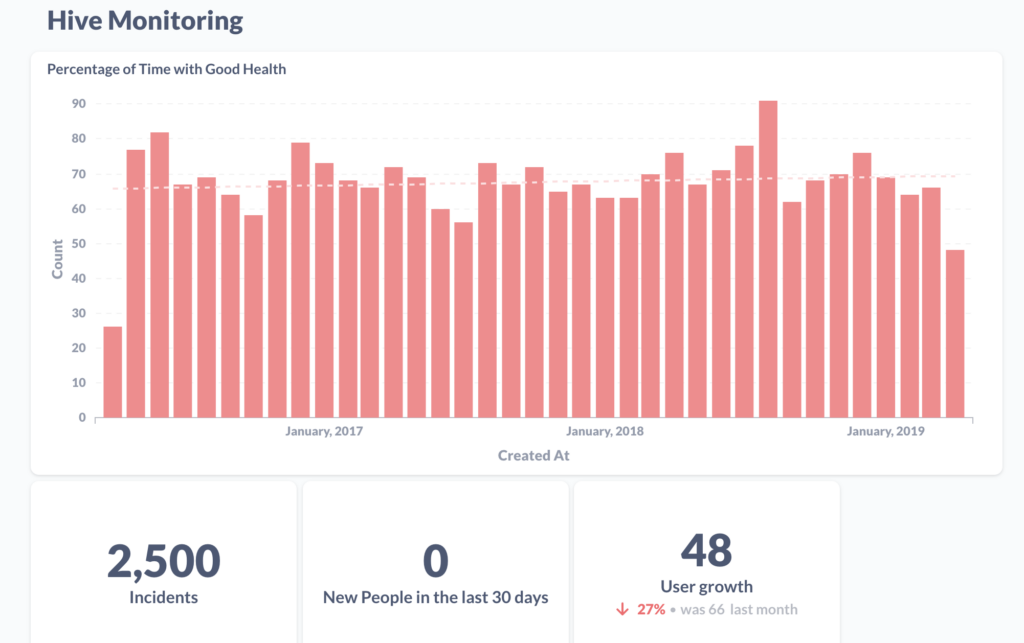
Apache Hive ist eine Data-Warehouse-Lösung, die sich in erster Linie an Datenanalysten und -ingenieure richtet. Sie ermöglicht das Abfragen und Verwalten großer Datensätze, die in verteiltem Speicher abgelegt sind.
Warum ich Apache Hive gewählt habe: Es bietet SQL-ähnliche Abfragen, was ideal für Nutzer ist, die mit SQL vertraut sind. Die Integration des Tools mit Hadoop macht es geeignet für die effiziente Analyse großer Datenmengen. Apache Hive unterstützt verschiedene Datenformate und bietet Ihrem Team somit Flexibilität beim Umgang mit Daten. Die Fähigkeit, komplexe Abfragen problemlos zu verarbeiten, macht es zu einer zuverlässigen Wahl für datengetriebene Unternehmen.
Hervorstechende Funktionen & Integrationen:
Funktionen umfassen eine Abfragesprache, die SQL ähnelt und das Erlernen und die Einführung erleichtert. Es unterstützt Indexierung zur Verbesserung der Abfrageleistung und beschleunigt damit die Datenabfrage. Apache Hive bietet außerdem Partitionierung, was das Management und die Abfrage großer Datensätze effizienter macht.
Integrationen umfassen Hadoop, HDFS, HBase, Amazon S3, Azure Blob Storage, Google Cloud Storage, Apache Spark, Apache Pig, Apache Tez und Apache Ranger.
Pros and Cons
Pros:
- SQL-ähnliche Abfragesprache
- Unterstützt komplexe Datenabfragen
- Verarbeitet große Datensätze effizient
Cons:
- Nicht ideal für Echtzeit-Analysen
- Leistung variiert je nach Datenmenge

Elastic ist eine Open-Source-Such- und Analyse-Engine, die Echtzeit-Einblicke aus Ihren Daten liefert. Ihre Hauptfunktion besteht darin, große Datenmengen schnell und nahezu in Echtzeit zu speichern, zu durchsuchen und zu analysieren. Dadurch eignet sich Elastic hervorragend für Aufgaben im Bereich der Echtzeit-Suche und Datenanalyse.
Warum ich Elastic gewählt habe:
Ich habe mich für Elastic entschieden, weil es besonders schnelle Suchfunktionen bietet und enorme Datenmengen effektiv verarbeiten kann. Die leistungsstarken Suchmechanismen in Kombination mit Echtzeitanalyse-Fähigkeiten heben Elastic von anderen Tools ab.
Aufgrund dieser Fähigkeiten habe ich Elastic als das beste Tool für Echtzeit-Suche und Datenanalysen bewertet.
Hervorzuhebende Funktionen und Integrationen:
Funktionen umfassen Volltextsuche, verteilte Suche und Echtzeit-Analysen. Die mehrstufige Aggregationsfunktion in Echtzeit hilft Anwendern, ihre Daten intuitiver zu erkunden und zu analysieren.
Integrationen umfassen zahlreiche Tools zur Datensammlung und -visualisierung, darunter Logstash für zentrales Logging und Kibana zur Datenvisualisierung.
Pros and Cons
Pros:
- Bietet schnelle und effiziente Suchergebnisse
- Kann große Datenmengen verarbeiten
- Flexibel bei den Datenformaten
Cons:
- Die Konfiguration und Feinabstimmung von Elastic für spezielle Anwendungsfälle kann komplex sein
- Während der grundlegende Elastic Stack kostenlos ist, sind fortgeschrittene Funktionen kostenpflichtig

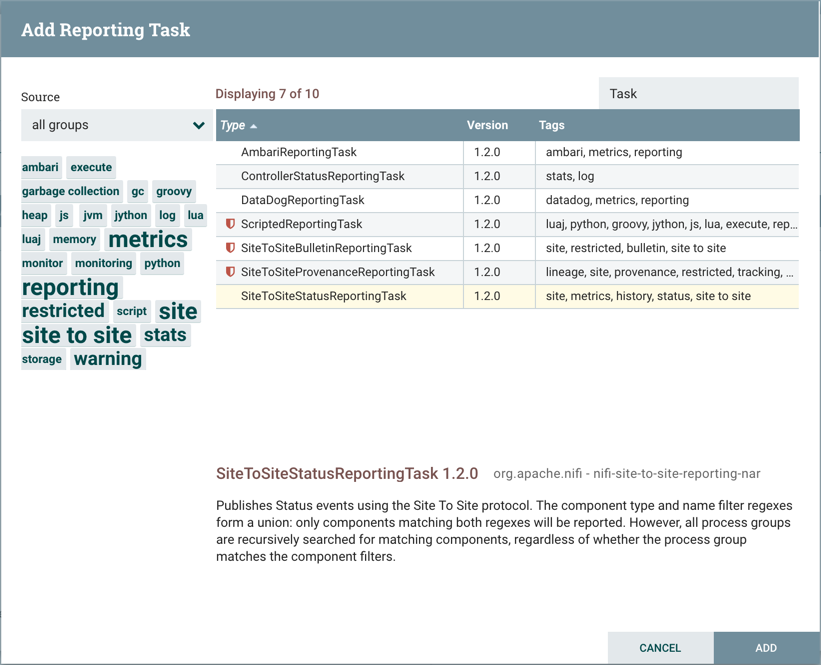
Apache NiFi ist eine integrierte Datenlogistik-Plattform zur Automatisierung der Datenübertragung zwischen unterschiedlichen Systemen. Sie bietet eine Echtzeitsteuerung, die sie besonders anpassungsfähig für hochvolatile Big-Data-Ströme macht und zu einer idealen Wahl für die Erfassung und das Streaming von Echtzeitdaten werden lässt.
Warum ich Apache NiFi gewählt habe:
Ich habe Apache NiFi wegen seiner Hochgeschwindigkeitsfähigkeiten bei der Datenweiterleitung und -transformation ausgewählt. Das einzigartige Design ermöglicht die Nachverfolgung von Daten in Echtzeit und die Erstellung dynamischer, reaktionsfähiger Datenflüsse. Diese herausragenden Funktionen sind der Grund, warum ich Apache NiFi als die beste Lösung für das Echtzeitdaten-Ingest und -Streaming betrachte.
Herausragende Funktionen und Integrationen:
Funktionen umfassen eine hoch konfigurierbare, webbasierte Benutzeroberfläche, Daten-Provenienz zur Rückverfolgung der Daten von der Quelle bis zum Verbrauch sowie flexible Skalierbarkeit.
Integrationen umfassen HTTP, AMQP, HDFS und Datenbankanbindung über JDBC.
Pros and Cons
Pros:
- Bietet Echtzeitsteuerung von Datenflüssen
- Umfangreiche Funktionen zur Datenweiterleitung und -transformation
- Open-Source und anpassbar
Cons:
- Einrichtung und Konfiguration können komplex sein
- Kein direkter Herstellersupport aufgrund von Open-Source
Weitere DataOps-Tools
Hier sind einige zusätzliche DataOps-Tools, die es nicht in meine Auswahl geschafft haben, aber dennoch einen Blick wert sind:
- RightData
Am besten geeignet für Datentests und Validierung
- StreamSets
Am besten für Echtzeit-Datenbewegung geeignet
- HighByte
Am besten für die Integration von Industriedaten
- DataKitchen
Am besten für DataOps-Orchestrierung
- Badook
Am besten geeignet für die Überwachung der Datenqualität


Wie ich DataOps-Tools bewerte
Ich teile meine Bewertung in grundlegende Anforderungen – wie Pipeline-Orchestrierung und CI/CD-Unterstützung – und die Unterscheidungsmerkmale, die ein gutes DataOps-Tool von dem richtigen für Ihr Team unterscheiden.
Kernfunktionen (Grundvoraussetzungen für diese Liste)
Wenn ich Tools für meine Liste auswähle, bewerte ich jedes einzelne auf einer Skala von 0 (bietet die Funktionalität nicht) bis 5 (hervorragend in diesem Bereich) in Bezug auf jede unten aufgeführte Kernfunktion. Anschließend rechne ich die Gesamtpunktzahl des Tools prozentual um. Jedes Tool muss eine Mindestgesamtpunktzahl von 65 % erreichen, um für die Aufnahme in Betracht gezogen zu werden.
- Pipeline-Orchestrierung & Planung: Ich achte auf DAG-basierte Workflow-Verwaltung mit Abhängigkeitsmanagement, Wiederholungslogik und Nachbearbeitungen – die Art von Orchestrierung, die eine nächtliche Datenaktualisierung aus Dutzenden vorgelagerter Quellen zuverlässig steuert.
- Datenbeobachtung & Monitoring: Alarme bei Job-Fehlern sind Pflicht, aber ich bewerte auch, ob das Tool Informationen wie Datenaktualität, Volumenanomalien und Lineage auf Spaltenebene anzeigt, sodass Ihr Team ein fehlerhaftes Dashboard bis zu einer bestimmten Quelltabelle zurückverfolgen kann.
- CI/CD- & Versionskontrollunterstützung: Git-basierte Branches, automatisierte Tests der Transformationslogik und gestaffelte Bereitstellungen sind hier relevant – ich prüfe, ob Teams Pipeline-Änderungen genauso sicher einspielen können wie Applikations-Code.
- Datenintegration & -transformation: Ich bewerte die Bandbreite der Konnektoren zu Data Warehouses, Data Lakes, SaaS-Anwendungen und Datenbanken und ob Transformationen in SQL, Python oder beidem ausführbar sind – Tools wie Fivetran und Airbyte handhaben die Aufnahme anders als dbt die Transformation, also zählt Flexibilität.
- Umgebungs- & Metadatenmanagement: Getrennte Entwicklungs-, Staging- und Produktionsumgebungen mit Metadatenkatalogisierung und Lineage-Tracking sind mir wichtig, damit Ingenieure keine experimentellen Modelle an Live-Produktionsdaten testen.
- Kollaboration & Zugriffskontrolle: Rollenbasierte Berechtigungen, Audit-Logs und gemeinsame Arbeitsbereiche werden hier bewertet – insbesondere wie granular Sie den Zugriff steuern können, wenn mehrere Teams (Analytics, Engineering, Governance) eine Plattform gemeinsam nutzen.
Nachdem ich eine Liste von Tools habe, die diese Kriterien erfüllen, schaue ich mir an, was jede Plattform besonders macht.
Unterscheidungsmerkmale (Was Anbieter voneinander abhebt)
So vergleiche und kontrastiere ich verschiedene Anbieter:
Herausragende Funktionen
Streaming- und Echtzeit-Pipeline-Unterstützung ist ein großer Unterschied – reine Batch-Tools genügen nicht, wenn Ihr Team Latenzzeiten unter einer Minute für Betrugserkennung oder Live-Dashboards benötigt. Auch Reverse-ETL-Funktionen bewerte ich, mit denen Teams kuratierte Warehouse-Daten ohne eigene Skripte in Tools wie Salesforce oder HubSpot zurückspielen können. Kosten- und Computing-Optimierung ist ebenfalls relevant; ich prüfe, ob eine Plattform dabei hilft, Abfragekosten zu überwachen und Pipeline-Ressourcen optimal zu dimensionieren, bevor die Warehouse-Rechnung explodiert.
Über Funktionen hinaus
Ökosystem-Kompatibilität ist für mich entscheidend – ein DataOps-Tool muss sich in Ihren bestehenden Stack einfügen, egal ob das Snowflake, Databricks oder eine Mischung aus beidem mit Airflow und dbt ist. Sicherheits- und Compliance-Zertifizierungen wie SOC 2 Typ II und HIPAA-Bereitschaft spielen ebenfalls eine Rolle, insbesondere bei Teams, die mit sensiblen Kunden- oder Finanzdaten arbeiten. Ich prüfe auch genau die Gesamtkosten des Betriebs, insbesondere ob die Preisstruktur mit zunehmendem Pipeline-Volumen und Teamgröße vorhersehbar skalierbar bleibt.
So wählen Sie DataOps-Tools aus
Es ist leicht, sich in langen Funktionslisten und komplexen Preisstrukturen zu verlieren. Damit Sie sich auf die wesentlichen Punkte konzentrieren können, während Sie Ihren individuellen Auswahlprozess für Software durchlaufen, finden Sie hier eine Checkliste mit Faktoren, die Sie berücksichtigen sollten:
| Faktor | Was zu berücksichtigen ist |
| Skalierbarkeit | Stellen Sie sicher, dass das Tool mit Ihren Datenanforderungen wachsen kann. Achten Sie auf Funktionen, die große Datensätze und eine steigende Anzahl von Benutzern unterstützen. |
| Integrationen | Überprüfen Sie die Kompatibilität mit bestehenden Systemen. Prüfen Sie, ob APIs, Datenbanken und bereits von Ihnen verwendete Anwendungen von Drittanbietern unterstützt werden. |
| Anpassbarkeit | Berücksichtigen Sie, wie gut sich das Tool an Ihre Prozesse anpasst. Achten Sie auf Optionen zur individuellen Gestaltung von Dashboards, Workflows und Berichten. |
| Benutzerfreundlichkeit | Bewerten Sie die Benutzeroberfläche und die Lernkurve. Ihr Team sollte sie intuitiv finden und schnell übernehmen können. |
| Budget | Ermitteln Sie die Gesamtkosten einschließlich versteckter Gebühren. Vergleichen Sie die Preispläne, um sicherzustellen, dass sie Ihren finanziellen Einschränkungen entsprechen. |
| Sicherheitsvorkehrungen | Analysieren Sie die Sicherheitsfunktionen des Tools. Stellen Sie sicher, dass es den Datenschutzstandards entspricht und Verschlüsselung bietet. |
| Supportdienste | Prüfen Sie die Verfügbarkeit des Kundensupports. Achten Sie auf Unterstützung rund um die Uhr, Dokumentation und Schulungsressourcen. |
| Leistung | Testen Sie die Geschwindigkeit und Zuverlässigkeit des Tools. Es sollte die Datenverarbeitung effizient und ohne Verzögerungen bewältigen. |
Trends bei DataOps-Tools
Für meine Recherche habe ich unzählige Produktaktualisierungen, Pressemitteilungen und Versionsprotokolle verschiedener Anbieter von DataOps-Tools zusammengetragen. Hier sind einige der aufkommenden Trends, die ich im Auge behalte:
- KI-gestützte Erkenntnisse: Immer mehr Tools nutzen KI, um prädiktive Analysen und Erkenntnisse bereitzustellen. Dies hilft Teams, Probleme vorherzusehen und Prozesse zu optimieren. Anbieter wie Alteryx integrieren KI, um die Möglichkeiten der Datenanalyse zu verbessern.
- Datenverarbeitung in Echtzeit: Die Nachfrage nach Datenverarbeitung in Echtzeit wächst. Sie ermöglicht es Unternehmen, auf der Grundlage aktueller Informationen schnellere Entscheidungen zu treffen. Tools wie StreamSets konzentrieren sich auf die Datenbewegung in Echtzeit, um diesen Bedarf zu erfüllen.
- Verbesserungen bei der Datenverwaltung: Unternehmen konzentrieren sich auf verbesserte Funktionen zur Datenverwaltung. Dies gewährleistet die Einhaltung von Vorschriften und verbessert die Datenqualität. Die DataOps-Plattform von IBM bietet leistungsstarke Werkzeuge für die Datenverwaltung, um diese Anforderungen zu erfüllen.
- Self-Service-Funktionen: Es zeichnet sich eine Entwicklung hin zur Befähigung nichttechnischer Benutzer durch Self-Service-Optionen ab. Dadurch werden Datenaufgaben teamübergreifend zugänglicher. Talend hat Self-Service-Funktionen ergänzt, um die Datenintegration zu vereinfachen.
- Cloudnative Architekturen: Immer mehr Tools werden für Cloud-Umgebungen entwickelt. Dies bietet Unternehmen, die große Datensätze verwalten, mehr Flexibilität und Skalierbarkeit. Azure Data Factory veranschaulicht diesen Trend mit seinen cloudnativen Diensten für die Datenintegration.
Was sind DataOps-Tools?
DataOps-Tools sind Softwarelösungen, die zur Automatisierung und Verbesserung von Datenverwaltungsprozessen entwickelt wurden. Dateningenieure, Analysten und IT-Fachleute verwenden diese Tools in der Regel, um Datenqualität, Datenverwaltung und Datenintegration zu verbessern.
Verarbeitung in Echtzeit, KI-gestützte Erkenntnisse und Self-Service-Funktionen helfen bei der Optimierung von Workflows, der Sicherstellung der Compliance und der Zugänglichmachung von Daten. In Kombination mit leistungsstarken Tools zur Datenbeobachtbarkeit steigern diese Lösungen die Effizienz und Genauigkeit im Datenbetrieb und unterstützen Unternehmen durch bessere Entscheidungsfindung.
Funktionen von DataOps-Tools
Bei der Auswahl von DataOps-Tools sollten Sie auf die folgenden wichtigen Funktionen achten:
- Datenverarbeitung in Echtzeit: Dies ermöglicht eine sofortige Datenanalyse, sodass Unternehmen auf der Grundlage aktueller Informationen schnelle Entscheidungen treffen können.
- KI-gestützte Erkenntnisse: Diese liefern prädiktive Analysen und helfen Teams, Probleme vorherzusehen und Datenprozesse zu optimieren.
- Datenverwaltung: Sie gewährleistet die Einhaltung von Vorschriften und erhält die Datenqualität über alle Abläufe hinweg.
- Self-Service-Funktionen: Sie befähigen nichttechnische Benutzer, Datenaufgaben selbstständig zu verwalten, und verbessern dadurch die Zugänglichkeit.
- Cloudnative Architektur: Sie bietet Flexibilität und Skalierbarkeit für die Verwaltung großer Datensätze in Cloud-Umgebungen.
- Automatisierte Workflows: Sie optimieren Aufgaben der Datenverwaltung, reduzieren den manuellen Aufwand und minimieren Fehler.
- Anpassbare Dashboards: Sie ermöglichen es Benutzern, die Datenvisualisierung an ihre spezifischen Anforderungen anzupassen, und verbessern dadurch das Verständnis.
- Nachverfolgung der Datenherkunft: Sie sorgt für Transparenz, indem sie den Ursprung und die Umwandlung von Daten zeigt und so die Genauigkeit gewährleistet.
- Integrationsunterstützung: Sie ermöglicht einen reibungslosen Datenfluss zwischen verschiedenen Systemen und Anwendungen und verbessert dadurch die Kompatibilität.
- Fehlerbehandlung: Sie identifiziert und behebt Probleme schnell und minimiert dadurch Unterbrechungen bei der Datenverarbeitung.
Vorteile von DataOps-Tools
Die Implementierung von DataOps-Tools bietet Ihrem Team und Ihrem Unternehmen mehrere Vorteile. Hier sind einige, auf die Sie sich freuen können:
- Verbesserte Datenqualität: Automatisierte Workflows und Daten-Governance gewährleisten, dass Ihre Daten korrekt und zuverlässig sind.
- Schnellere Entscheidungsfindung: Die Datenverarbeitung in Echtzeit ermöglicht es Ihrem Team, ohne Verzögerung auf die neuesten Erkenntnisse zu reagieren.
- Verbesserte Compliance: Leistungsstarke Funktionen für Daten-Governance helfen Ihrem Unternehmen, regulatorische Anforderungen mühelos zu erfüllen.
- Erhöhte Zugänglichkeit: Datenkatalog-Tools mit Selbstbedienungsfunktionen ermöglichen es technisch nicht versierten Benutzern, Datenaufgaben zu erledigen, und erweitern dadurch den Zugriff.
- Skalierbarkeit: Eine cloudnative Architektur unterstützt Ihren wachsenden Datenbedarf, ohne die Leistung zu beeinträchtigen.
- Weniger manueller Aufwand: Automatisierte Fehlerbehandlung und Workflows minimieren sich wiederholende Aufgaben und geben Ihrem Team mehr Zeit.
- Bessere Zusammenarbeit: Anpassbare Dashboards und Echtzeiterkenntnisse fördern Teamarbeit und fundierte Entscheidungsfindung.
Kosten und Preise von DataOps-Tools
Bei der Auswahl von DataOps-Tools ist es wichtig, die verschiedenen verfügbaren Preismodelle und Tarife zu verstehen. Die Kosten variieren je nach Funktionen, Teamgröße, Zusatzoptionen und weiteren Faktoren. Zu den beliebten Plattformen gehören cloudnative Lösungen sowie Databricks-Alternativen , die auf vereinheitlichte Analyse- und Workflows für maschinelles Lernen spezialisiert sind. Die folgende Tabelle fasst gängige Tarife, ihre durchschnittlichen Preise und typische enthaltene Funktionen von DataOps-Tool-Lösungen zusammen:
Vergleichstabelle der Tarife für DataOps-Tools
| Tarifart | Durchschnittlicher Preis | Übliche Funktionen |
| Kostenloser Tarif | $0 | Grundlegende Datenintegration, begrenzter Speicherplatz und Community-Support. |
| Persönlicher Tarif | $10-$30/Benutzer/Monat | Datenintegration, grundlegende Analysen, begrenzte Automatisierung und E-Mail-Support. |
| Geschäftstarif | $50-$100/Benutzer/Monat | Erweiterte Analysen, Automatisierung, Daten-Governance und bevorzugter Support. |
| Unternehmenstarif | $150-$300/Benutzer/Monat | Individuelle Integrationen, vollständige Automatisierung, verbesserte Sicherheit und dedizierter Support. |
DataOps-Tools: Häufig gestellte Fragen
Hier finden Sie einige Antworten auf häufig gestellte Fragen zu DataOps-Tools:
Welche wichtigen Aspekte sollten bei der Implementierung von DataOps berücksichtigt werden?
Bei der Implementierung von DataOps sollten Sie funktionsübergreifende Teams bilden, um die Zusammenarbeit zwischen Dateningenieuren, Entwicklern und Analysten zu verbessern. Wählen Sie die passenden Tools für Ihre Anforderungen aus und etablieren Sie klare Prozesse für Ihr Team. Automatisieren Sie sich wiederholende Aufgaben, um Zeit zu sparen, und überwachen und optimieren Sie Ihre Prozesse kontinuierlich.
Welche drei Pipelines gibt es bei DataOps?
DataOps umfasst typischerweise drei Pipelines: Produktion, Entwicklung und Umgebung. Jede Pipeline erfüllt einen bestimmten Zweck bei der Verwaltung von Datenflüssen. Produktionspipelines verarbeiten Live-Daten, Entwicklungspipelines konzentrieren sich auf Tests und die Erstellung, und Umgebungspipelines verwalten Konfigurationen. Das Verständnis dieser Pipelines hilft bei der Orchestrierung effizienter Workflows.
Wie unterscheidet sich DataOps von DevOps?
Während DevOps darauf abzielt, Entwicklungs- und Betriebsteams für die Softwarebereitstellung zu vereinen, soll DataOps die Silos zwischen Datenproduzenten und -konsumenten aufbrechen. Ziel ist es, Daten zugänglicher und wertvoller zu machen. DataOps legt den Schwerpunkt auf die Zusammenarbeit in Datenteams, um die Verwaltung und Nutzung von Daten zu verbessern.
Welche wesentlichen Vorteile bietet die Automatisierung von DataOps-Aufgaben?
Die Automatisierung von DataOps-Aufgaben kann die Effizienz erheblich steigern, indem sie den manuellen Aufwand reduziert. Diese Datenbank-DevOps-Tools sorgen für konsistente Datenprozesse und helfen Ihnen, die Datenqualität aufrechtzuerhalten. Die Automatisierung ermöglicht es Ihrem Team außerdem, sich auf strategischere Aufgaben zu konzentrieren, was zu einer höheren Produktivität und schnelleren Entscheidungsfindung führt.
Wie unterstützen DataOps-Tools die Data Governance?
DataOps-Tools bieten Funktionen, die bei der Durchsetzung von Data-Governance-Richtlinien helfen. Sie schaffen Transparenz über Datenprozesse und stellen die Einhaltung von Vorschriften sicher. Durch die Nachverfolgung der Datenherkunft und die Bereitstellung von Prüfprotokollen tragen diese Tools dazu bei, Datenintegrität und Transparenz in Ihrer gesamten Organisation zu wahren.
Warum ist die Echtzeit-Datenverarbeitung bei DataOps wichtig?
Die Echtzeit-Datenverarbeitung ermöglicht Ihrem Team den Zugriff auf die aktuellsten Daten und damit eine schnelle Entscheidungsfindung. Sie unterstützt dynamische Geschäftsanforderungen, indem sie aktuelle Erkenntnisse bereitstellt. Diese Fähigkeit ist für Branchen entscheidend, in denen zeitnahe Daten maßgeblich sind, um wettbewerbsfähig zu bleiben und auf Marktveränderungen reagieren zu können.
Was kommt als Nächstes?
Steigern Sie Ihr SaaS-Wachstum und Ihre Führungskompetenzen.
Abonnieren Sie unseren Newsletter für die neuesten Erkenntnisse von CTOs und angehenden Führungskräften im Technologiebereich.
Wir helfen Ihnen, mithilfe von Leitfäden, Ressourcen und Strategien führender Experten intelligenter zu skalieren und stärker zu führen!