

10 beste Open-Source-ETL-Tools im Test 2026

Auswahlliste der besten Open-Source-ETL-Tools


Die besten Open-Source-ETL-Tools unterstützen Teams dabei, die Extraktion, Transformation und das Laden von Daten zu automatisieren, damit sie systemübergreifend genaue und konsistente Datensätze pflegen können. Sie erleichtern den Umgang mit komplexen Datenquellen, die Anwendung von Transformationen im großen Maßstab und die Reduzierung des manuellen Aufwands bei der Verwaltung von Datenpipelines.
Wenn Pipelines auf benutzerdefinierten Skripten basieren, Schemaänderungen zu unbemerkten Fehlern führen oder Teams keinen Einblick in die Datenbewegungen zwischen Systemen haben, können Datenqualität und Zuverlässigkeit abnehmen. Diese Probleme verlangsamen die Arbeit mit Analysen, erhöhen den Wartungsaufwand und erschweren die Zusammenarbeit zwischen Entwicklungs- und Datenteams.
Als Chief Technology Officer mit über 20 Jahren Branchenerfahrung habe ich Dutzende von Open-Source-ETL-Tools getestet und bewertet, um Leistung, Integrationsqualität und Benutzerfreundlichkeit zu beurteilen. Dieser Leitfaden stellt die besten Optionen vor, die skalierbare Workflows und einen besser vorhersehbaren Datenbetrieb unterstützen. Jede Bewertung behandelt Funktionen, Vor- und Nachteile sowie geeignete Anwendungsfälle, damit Sie das richtige Tool auswählen können.
Warum Sie unseren Software-Bewertungen vertrauen können
Wir testen und bewerten seit 2023 Software. Als Technologie-Führungskräfte wissen wir, wie kritisch und herausfordernd es ist, die richtige Entscheidung bei der Softwareauswahl zu treffen.
Wir investieren viel in gründliche Recherche, um unserer Zielgruppe zu helfen, bessere Kaufentscheidungen zu treffen. Wir haben über 2.000 Tools für verschiedene Technikanwendungsfälle getestet und mehr als 1.000 umfassende Softwarebewertungen geschrieben. Erfahren Sie wie wir transparent bleiben und unsere Methodik der Softwarebewertung.
Zusammenfassung der besten Open-Source-ETL-Tools
Diese Vergleichstabelle fasst die Preisdetails meiner Auswahl der besten Open-Source-ETL-Tools zusammen, damit Sie das beste Tool für Ihr Budget und Ihre geschäftlichen Anforderungen finden.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Am besten für komplexe Datenaufgaben | Kostenlose Testversion verfügbar | Ab $5,500/Einheit/Jahr | Website | |
| 2 | Am besten geeignet für die Verarbeitung von Logdaten | Kostenlose Testversion verfügbar | Ab $95/Monat | Website | |
| 3 | Am besten geeignet für Python-ETL-Skripte | Not available | Kostenlos nutzbar | Website | |
| 4 | Am besten geeignet für Datenumwandlung | 30-tägige kostenlose Testversion | Ab $4/Benutzer/Monat | Website | |
| 5 | Am besten geeignet für Big-Data-Integration | 14-tägige Testversion verfügbar | Preis auf Anfrage | Website | |
| 6 | Am besten für automatisierte Datenintegration | 14 Tage kostenlos testen + kostenlose Demo | Ab $239/Monat | Website | |
| 7 | Am besten geeignet für Integrationsmuster | Not available | Kostenlos nutzbar | Website | |
| 8 | Am besten geeignet für Echtzeit-Datenstreaming | Kostenloser Tarif verfügbar | Kostenlos | Website | |
| 9 | Am besten geeignet für die Automatisierung von Datenflüssen | Not available | Kostenlos nutzbar | Website | |
| 10 | Am besten für skalierbare ETL-Lösungen | Kostenloser Tarif verfügbar | Kostenlos | Website |
Bewertungen der besten Open-Source-ETL-Tools
Nachfolgend finden Sie meine ausführlichen Zusammenfassungen der besten Open-Source-ETL-Tools, die es auf meine Auswahlliste geschafft haben. Meine Bewertungen bieten einen detaillierten Einblick in die wichtigsten Funktionen, Vor- & Nachteile, Integrationen und idealen Anwendungsfälle jedes Tools, damit Sie das beste für Ihre Anforderungen finden.
CloverDX
Am besten für komplexe Datenaufgaben
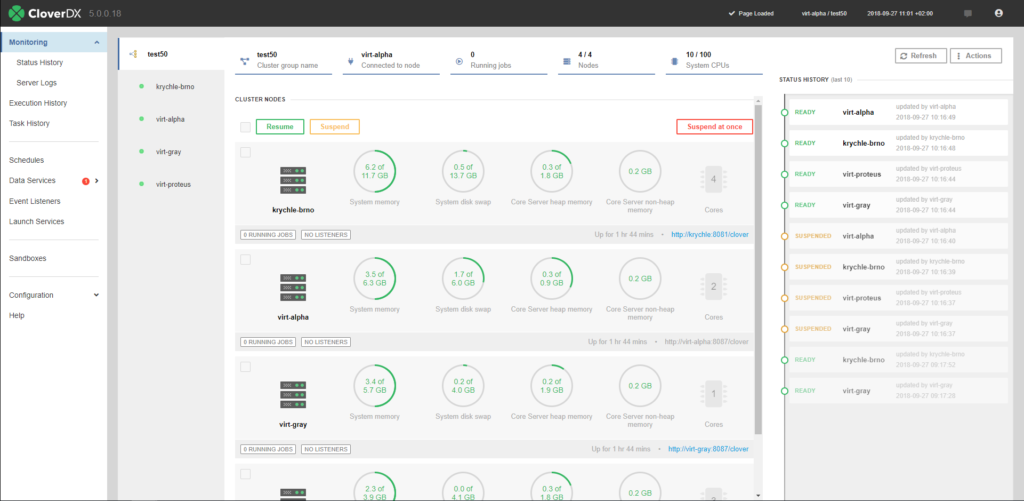
CloverDX ist eine Datenintegrationsplattform, die Geschäftsbenutzern und IT-Teams dient, indem sie Daten automatisiert, orchestriert und transformiert. Sie unterstützt verschiedene Bereitstellungsoptionen und ist dadurch vielseitig für unterschiedliche Geschäftsanforderungen einsetzbar.
Warum ich CloverDX gewählt habe: CloverDX ist auf komplexe Datenaufgaben zugeschnitten, dank seiner intuitiven Benutzeroberfläche und vielseitigen Bereitstellungsmöglichkeiten, einschließlich On-Premise und Cloud-Diensten wie AWS, Azure und Google Cloud. Es bietet Datendienste für den API-Zugriff und Kollaborationstools, damit Ihr Team effizient in unterschiedlichen Umgebungen arbeiten kann. Die Einbindung eines Datenkatalogs sorgt für zuverlässigen Datenzugriff, was entscheidend für die Wahrung der Datenintegrität ist. Diese Merkmale machen CloverDX zur herausragenden Wahl für Teams, die mit komplexen Datenprozessen arbeiten.
Hervorzuhebende Funktionen & Integrationen:
Funktionen sind eine intuitive Benutzeroberfläche für Geschäftsbenutzer, Datendienste für den API-Zugriff und ein Datenkatalog für zuverlässigen Datenzugriff. Diese Elemente gewährleisten ein effizientes Datenmanagement und einen reibungslosen Datenzugriff. Die Plattform bietet zudem Tools zur Zusammenarbeit, um Teamarbeit zu stärken.
Integrationen umfassen AWS, Azure, Google Cloud, Snowflake, Salesforce, Microsoft SQL Server, Oracle, PostgreSQL, MongoDB und Kafka.
Pros and Cons
Pros:
- Unterstützt komplexe Datenprozesse
- Vielseitige Bereitstellungsoptionen
- Starke API-Zugriffsfunktionen
Cons:
- Potentiell steile Lernkurve
- Erfordert technisches Fachwissen

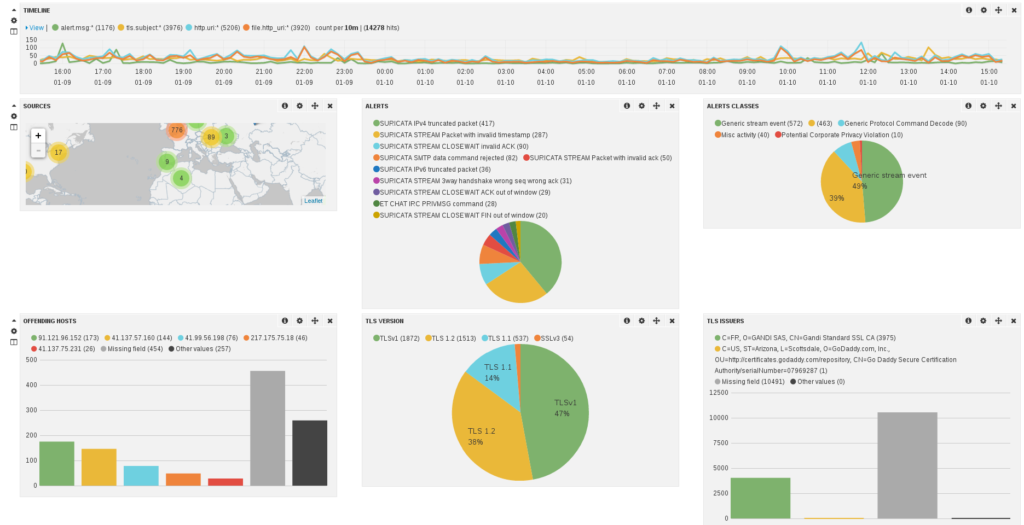
Logstash ist eine Open-Source-Datenverarbeitungspipeline, die es Entwicklern und IT-Teams ermöglicht, Logs aus verschiedenen Quellen zu sammeln, zu transformieren und zu speichern. Sie ist dafür konzipiert, große Mengen an Logdaten zu verarbeiten, was sie ideal für Organisationen macht, die ihre Protokollierungsinformationen zentralisieren und analysieren müssen.
Warum ich Logstash gewählt habe: Logstash glänzt bei der Verarbeitung von Logdaten und bietet eine flexible Pipeline-Architektur, mit der sich Logs aus mehreren Quellen aggregieren lassen. Das Tool stellt leistungsstarke Filter- und Transformationsfunktionen bereit, sodass Ihr Team die Daten an spezifische Anforderungen anpassen kann. Die Echtzeitverarbeitung von Logstash stellt sicher, dass Ihre Logdaten aktuell und verwertbar sind. Durch die Kompatibilität mit Elasticsearch und Kibana ist es eine hervorragende Wahl für alle, die bereits den Elastic Stack nutzen.
Hervorzuhebende Funktionen & Integrationen:
Funktionen umfassen eine flexible Pipeline-Architektur, die komplexe Datentransformationen unterstützt und es Ihnen ermöglicht, die Logverarbeitung individuell anzupassen. Die Echtzeitverarbeitungsfähigkeiten von Logstash stellen sicher, dass Ihre Logdaten stets aktuell sind. Das Tool bietet zudem robuste Filteroptionen, um die Daten nach Ihren spezifischen Anforderungen zu gestalten.
Integrationen umfassen Elasticsearch, Kibana, Beats, AWS, Azure, Google Cloud, Kafka, RabbitMQ, JDBC und Redis.
Pros and Cons
Pros:
- Verarbeitet große Logmengen
- Echtzeitdatenverarbeitung
- Flexible Pipeline-Architektur
Cons:
- Kann ressourcenintensiv sein
- Eingeschränkte integrierte Analysen

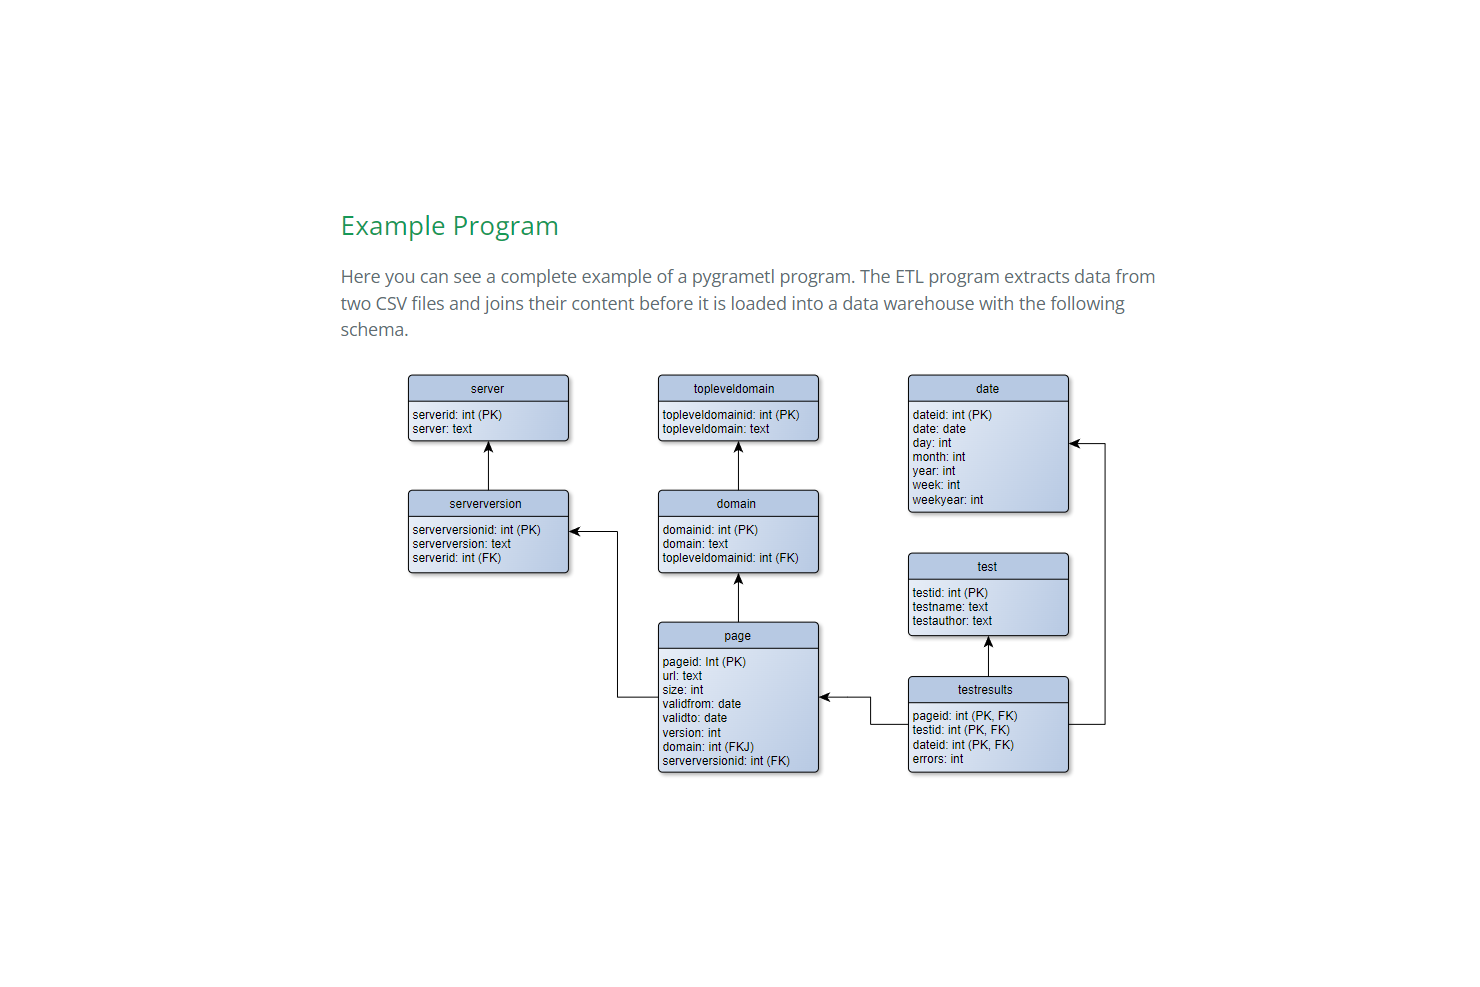
pygrametl ist ein Open-Source-Python-Framework zur Entwicklung von ETL-Prozessen. Es wurde als Alternative zu grafischen BI-Programmen konzipiert, bietet jedoch die gleiche Benutzerfreundlichkeit. Es unterstützt CPython und Jython und ermöglicht ETL-Entwicklern die Nutzung bestehender Java-Codes und JDBC-Treiber.
Entwickler können Daten aus zahlreichen in pygrametl verfügbaren Quellen extrahieren, wie z. B. SQL, CSV und Pandas. Benutzer können auch eigene Datenquellen definieren. Die Plattform bietet Filter und Aggregatoren zur Transformation von Daten. Standard-Aggregatoren sind AVG, Count, CountDistinct, Max, Min und Sum.
pygrametl kann transformierte Daten in jedes Data Warehouse laden, das dimensionales Modellieren unterstützt. Das System stellt Strukturen zur Definition von Faktentabellen und Dimensionen zur Verfügung, einschließlich langsam veränderlicher und 'snowflaked' Dimensionen.
Entwickler können pygrametl kostenlos herunterladen.

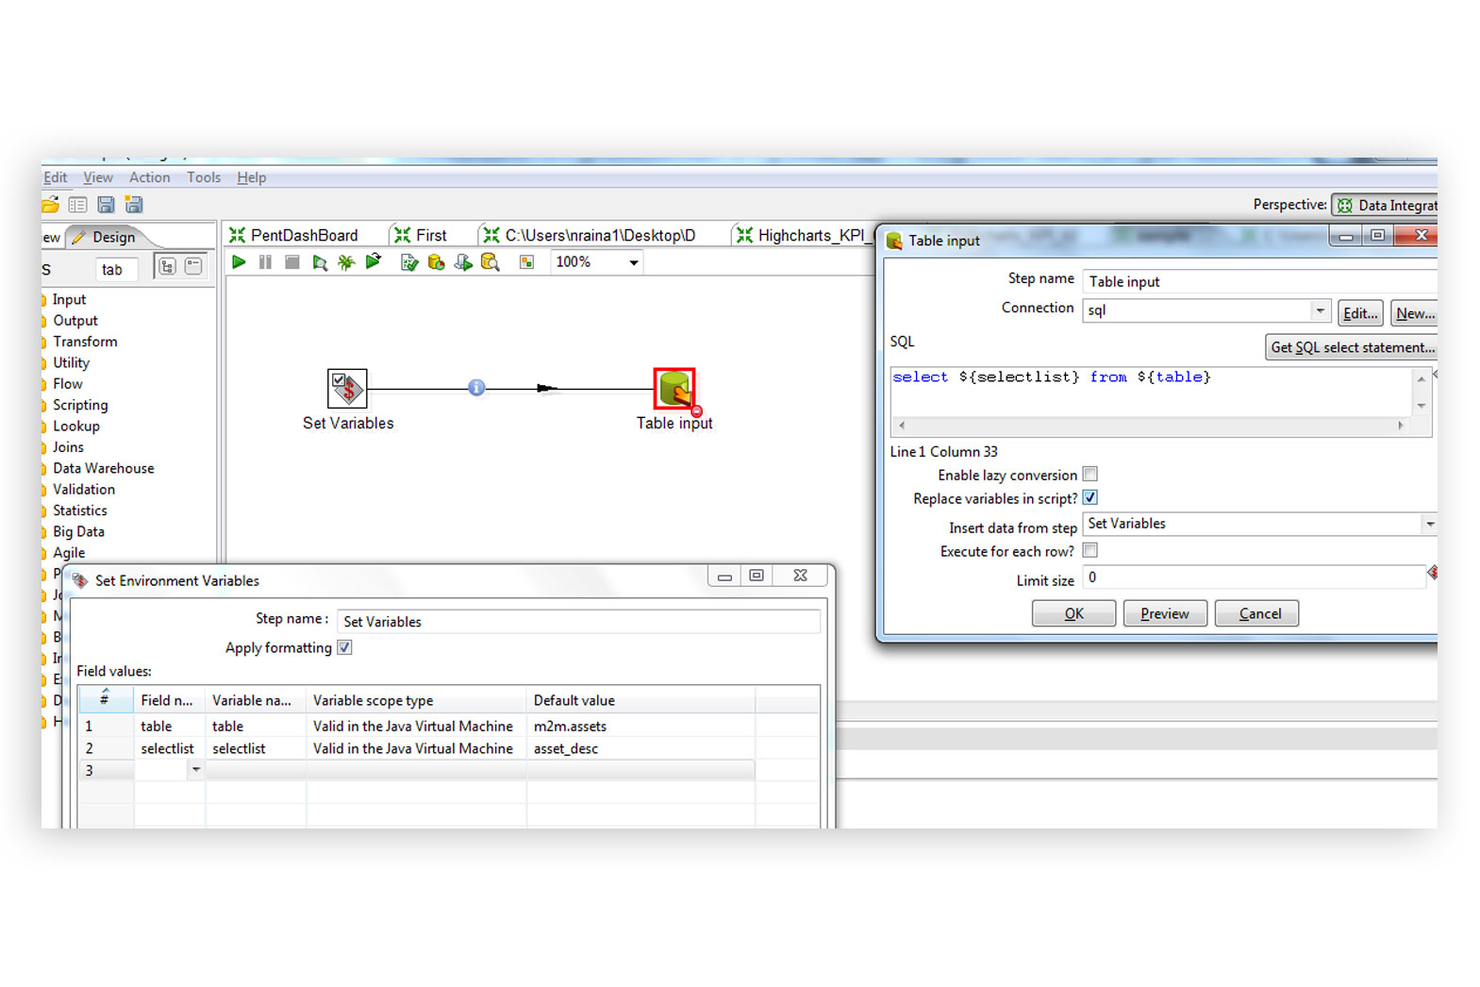
Pentaho Kettle ist ein Open-Source ETL-Tool, das sich an Dateningenieure und Business-Analysten richtet, die komplexe Datenumwandlungen durchführen müssen. Es bietet eine visuelle Oberfläche zum Entwerfen von Datenpipelines, wodurch die Verwaltung von Datenflüssen und die effiziente Ausführung von Transformationen erleichtert werden.
Warum ich Pentaho Kettle gewählt habe: Es ist bekannt für seine Fähigkeiten in der Datenumwandlung und bietet eine visuelle Drag-and-Drop-Oberfläche, die die Erstellung komplexer Workflows vereinfacht. Kettle unterstützt zahlreiche Datenquellen und stellt dadurch sicher, dass Ihr Team Daten aus verschiedenen Ursprüngen integrieren kann. Die grafische Oberfläche reduziert die Notwendigkeit umfangreicher Programmierkenntnisse, was für Teams mit begrenzter Programmiererfahrung vorteilhaft ist. Die Flexibilität des Tools im Umgang mit unterschiedlichen Datentypen und -formaten macht es zu einer vielseitigen Wahl für vielfältige Datenanforderungen.
Hervorstechende Funktionen & Integrationen:
Funktionen umfassen eine visuelle Drag-and-Drop-Oberfläche, die das Design von Workflows vereinfacht und es ermöglicht, komplexe Datenumwandlungen ohne Programmierung zu erstellen. Das Tool unterstützt eine breite Palette von Datenquellen, wodurch die Integration unkompliziert ist. Die Flexibilität von Kettle im Umgang mit mehreren Datentypen und -formaten gewährleistet die Kompatibilität mit unterschiedlichen Datenumgebungen.
Integrationen umfassen Oracle, MySQL, PostgreSQL, Microsoft SQL Server, MongoDB, Amazon Redshift, Google BigQuery, Salesforce, SAP und Hadoop.
Pros and Cons
Pros:
- Visuelle Oberfläche für Transformationen
- Verarbeitet unterschiedliche Datentypen
- Umfangreiche Unterstützung für Datenquellen
Cons:
- Kann ressourcenintensiv sein
- Komplexität bei der Erstinstallation

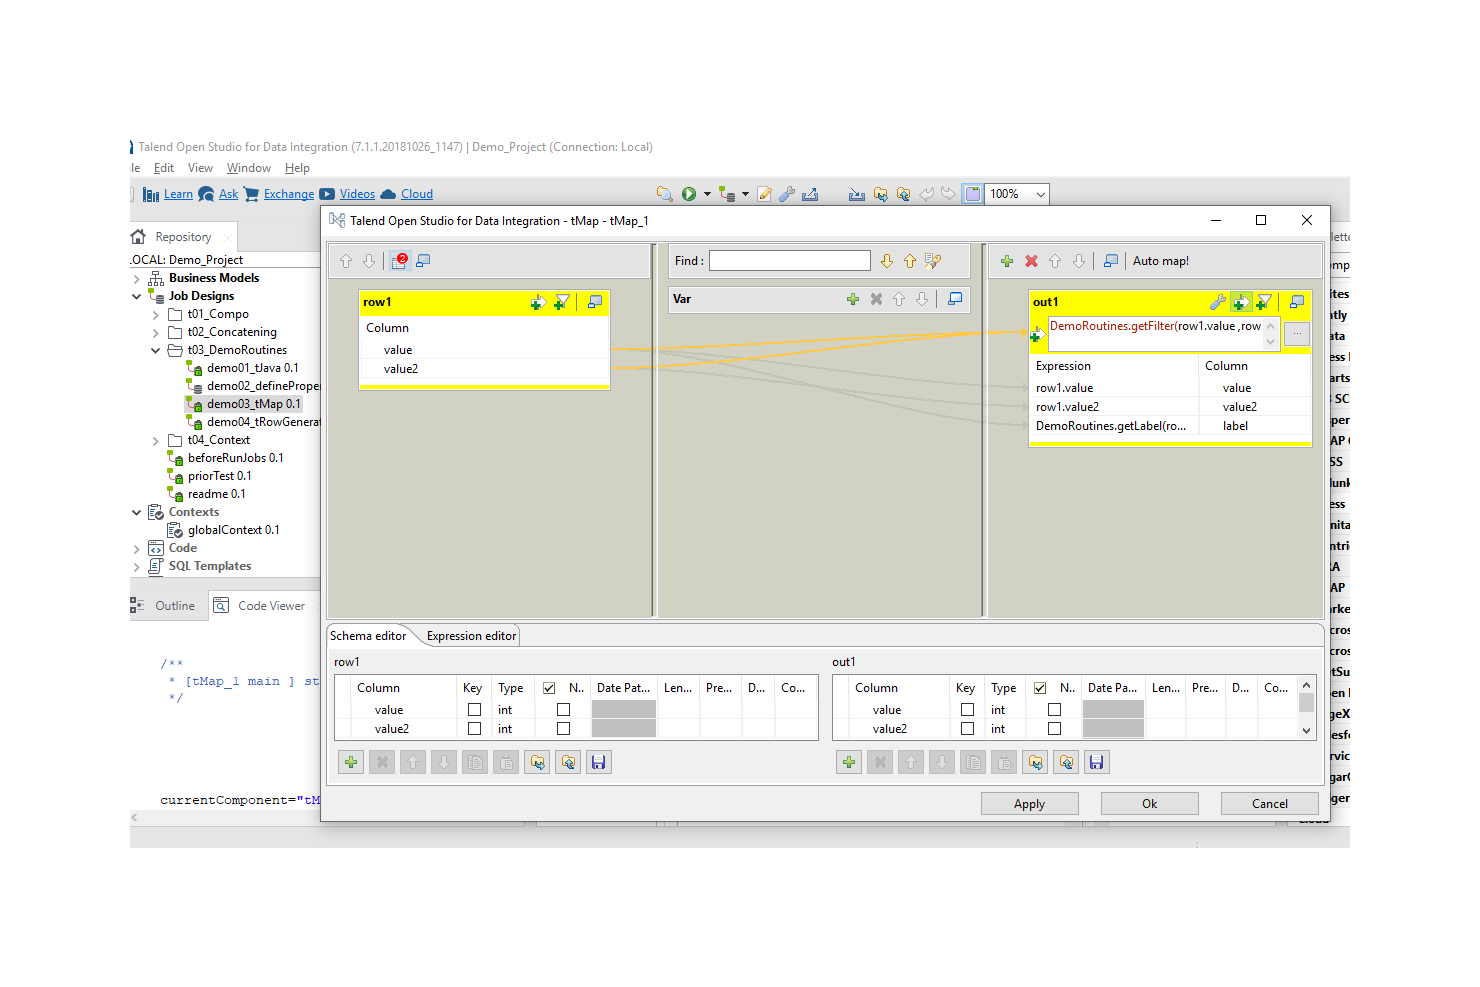
Talend Open Studio ist eine Suite von Open-Source-Tools, die ETL-Entwicklern ermöglicht, grundlegende Datenpipelines in kürzerer Zeit zu erstellen. Sie bietet eine auf Eclipse basierende Entwicklungsumgebung und mehr als 900 vorgefertigte Konnektoren, darunter Oracle, Teradata, Marketo und Microsoft SQL Server. Die Plattform umfasst fünf Komponenten: Talend Open Studio für Datenintegration, Big Data, Datenqualität, Enterprise Service Bus (ESB) und Master Data Management (MDM).
Talend Open Studio ist ein hervorragender Begleiter für viele Business-Intelligence-(BI)-Tools. Es bietet verschiedene Methoden, um mehrere Datensätze in Formate umzuwandeln, die mit gängigen BI-Plattformen wie Jasper, OLAP und SPSS kompatibel sind. Anwender können auch direkt in Talend Open Studio Erkenntnisse gewinnen, da es grundlegende Visualisierungen wie Balkendiagramme erstellen kann.
Talend Open Studio unterstützt Integrationen mit mehreren Datenbanken, darunter Microsoft SQL Server, Postgres, MySQL, Teradata und Greenplum.
Talend Open Studio ist für alle Nutzer kostenlos als Download verfügbar.

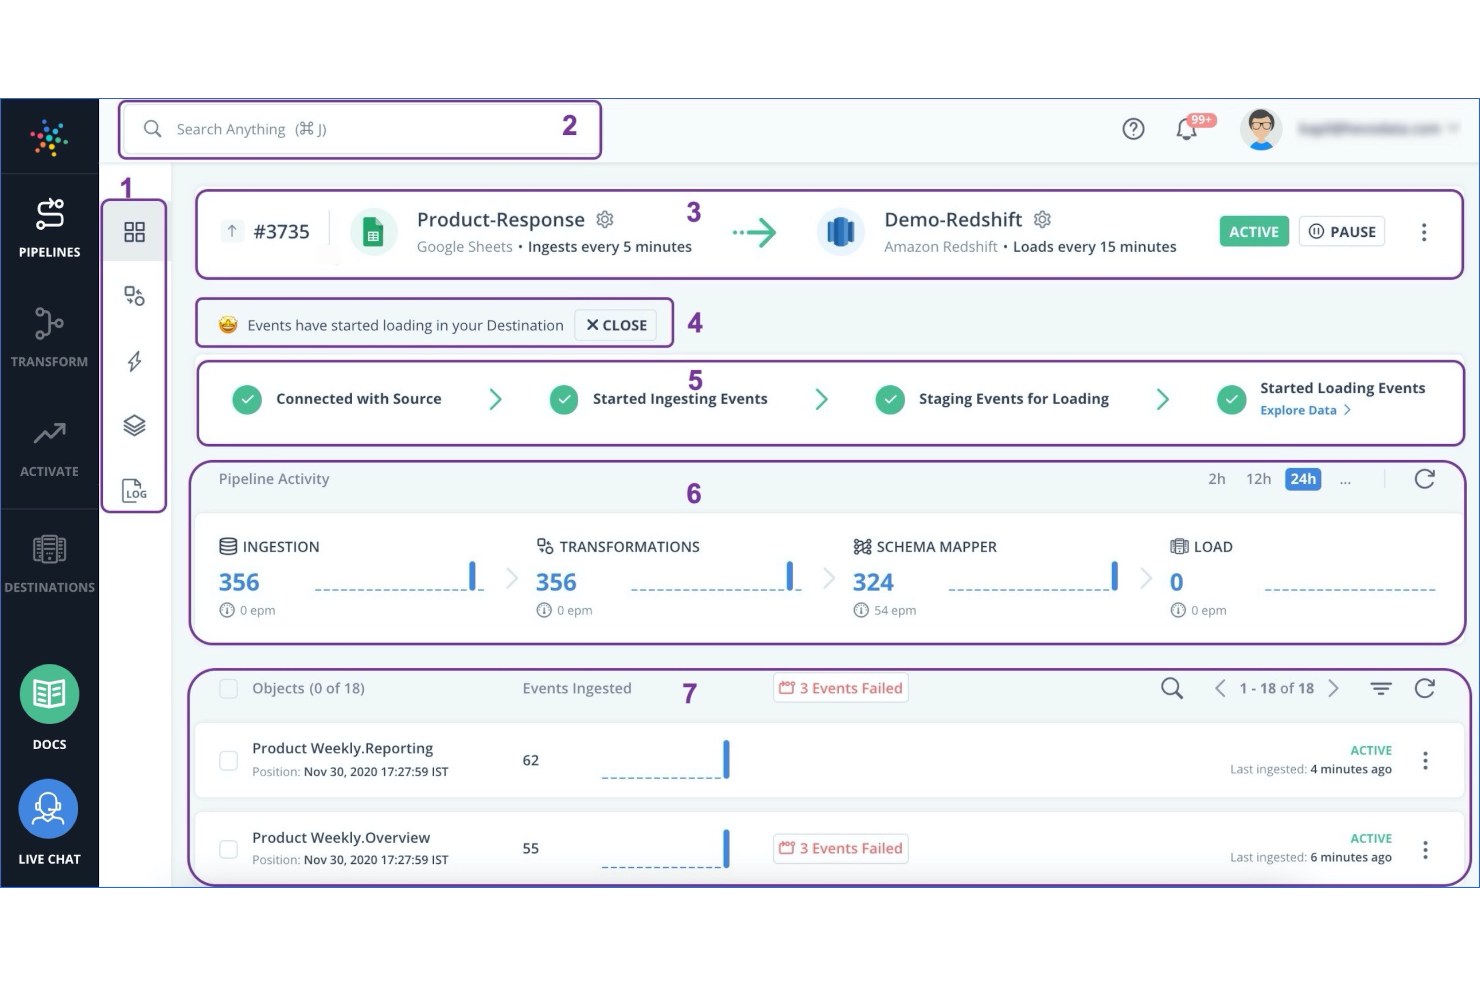
Hevo Data ist eine ETL- und Datenintegrationsplattform, die sich an Datenteams richtet, die zuverlässige und automatisierte Datenpipelines benötigen. Sie ermöglicht die Aufnahme von Daten aus verschiedenen Quellen mit minimalem Aufwand und ohne Programmierkenntnisse, wodurch die Datenqualität und Entscheidungsfindung verbessert werden.
Warum ich Hevo Data ausgewählt habe: Die Plattform überzeugt durch automatisierte Datenintegration, mit Funktionen wie Echtzeitüberwachung der Datenpipelines und Hochgeschwindigkeitsdatenreplikation, sodass Ihr Team immer mit minimalem Aufwand auf dem neuesten Stand bleibt. Die Compliance- und Sicherheitsfunktionen von Hevo sorgen für ein beruhigendes Gefühl, insbesondere bei Unternehmenskunden. Das transparente Preismodell bedeutet keine versteckten Kosten, was für die Budgetierung ein großer Vorteil ist. Die benutzerfreundliche Oberfläche ermöglicht das Datenmanagement ohne umfassende Programmierkenntnisse.
Hervorstechende Funktionen & Integrationen:
Funktionen umfassen die Echtzeitüberwachung der Pipelines, damit Ihre Daten stets aktuell sind, erweiterte Verwaltungsoptionen für mehr Kontrolle sowie Compliance- und Sicherheitsmerkmale zum Schutz sensibler Daten. Diese Funktionen ermöglichen Ihrem Team ein effizientes und sicheres Arbeiten. Hevo bietet außerdem eine Hochgeschwindigkeitsdatenreplikation, um die Konsistenz der Daten sicherzustellen.
Integrationen umfassen Salesforce, Google Analytics, Amazon Redshift, Snowflake, BigQuery, MySQL, PostgreSQL, Oracle, MS SQL Server und HubSpot.
Pros and Cons
Pros:
- Automatisierte Datenintegration
- Echtzeitüberwachung
- Hochgeschwindigkeitsreplikation
Cons:
- Begrenzte Anpassungsmöglichkeiten
- Nicht für alle Datentypen geeignet

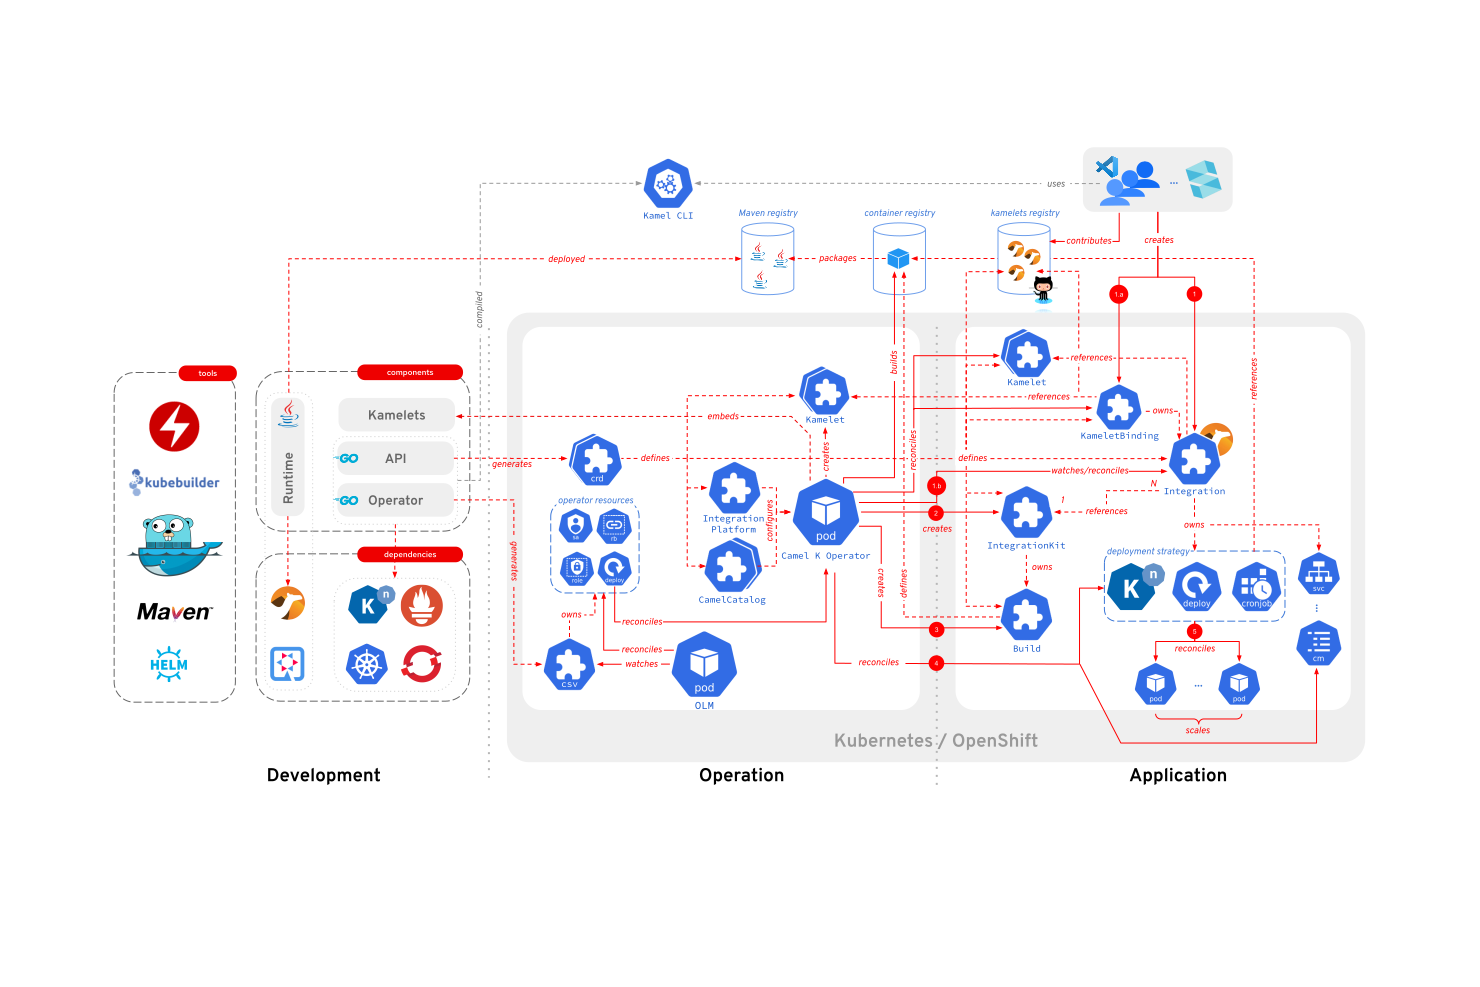
Apache Camel ist ein Open-Source-Integrationsframework, das für Entwickler und Architekten entwickelt wurde, die Unternehmensintegrationsmuster implementieren müssen. Es erleichtert das Routing und die Vermittlung von Nachrichten zwischen Systemen und ist somit ideal für komplexe Integrationsszenarien.
Warum ich Apache Camel gewählt habe: Es zeichnet sich durch die Nutzung von Integrationsmustern aus, um die Konnektivität zwischen verschiedenen Systemen zu vereinfachen. Camel unterstützt eine Vielzahl von Protokollen und Datenformaten, sodass Ihr Team problemlos unterschiedliche Systeme verbinden kann. Die domänenspezifische Sprache (DSL) von Camel bietet eine flexible Möglichkeit, Routing- und Vermittlungsregeln zu definieren – entscheidend für das Management komplexer Integrationen. Die Fähigkeit des Tools, mit diversen Endpunkten zu integrieren, bietet eine beispiellose Vielseitigkeit beim Entwurf von Integrationslösungen.
Herausragende Funktionen & Integrationen:
Funktionen umfassen eine breite Palette von Unternehmensintegrationsmustern, die den Integrationsprozess vereinfachen. Die domänenspezifische Sprache des Tools ermöglicht es, komplexe Routing-Regeln einfach zu definieren. Apache Camel unterstützt außerdem zahlreiche Datenformate und Protokolle, was die Kompatibilität mit verschiedenen Systemen sicherstellt.
Integrationen beinhalten AWS, Apache Kafka, ActiveMQ, RabbitMQ, Salesforce, Google Cloud, Azure, JMS, File und FTP.
Pros and Cons
Pros:
- Umfassende Integrationsmuster
- Breite Unterstützung von Datenformaten
- Vielseitige Endpunktintegration
Cons:
- Dokumentation kann lückenhaft sein
- Ressourcenintensiv bei großen Umgebungen

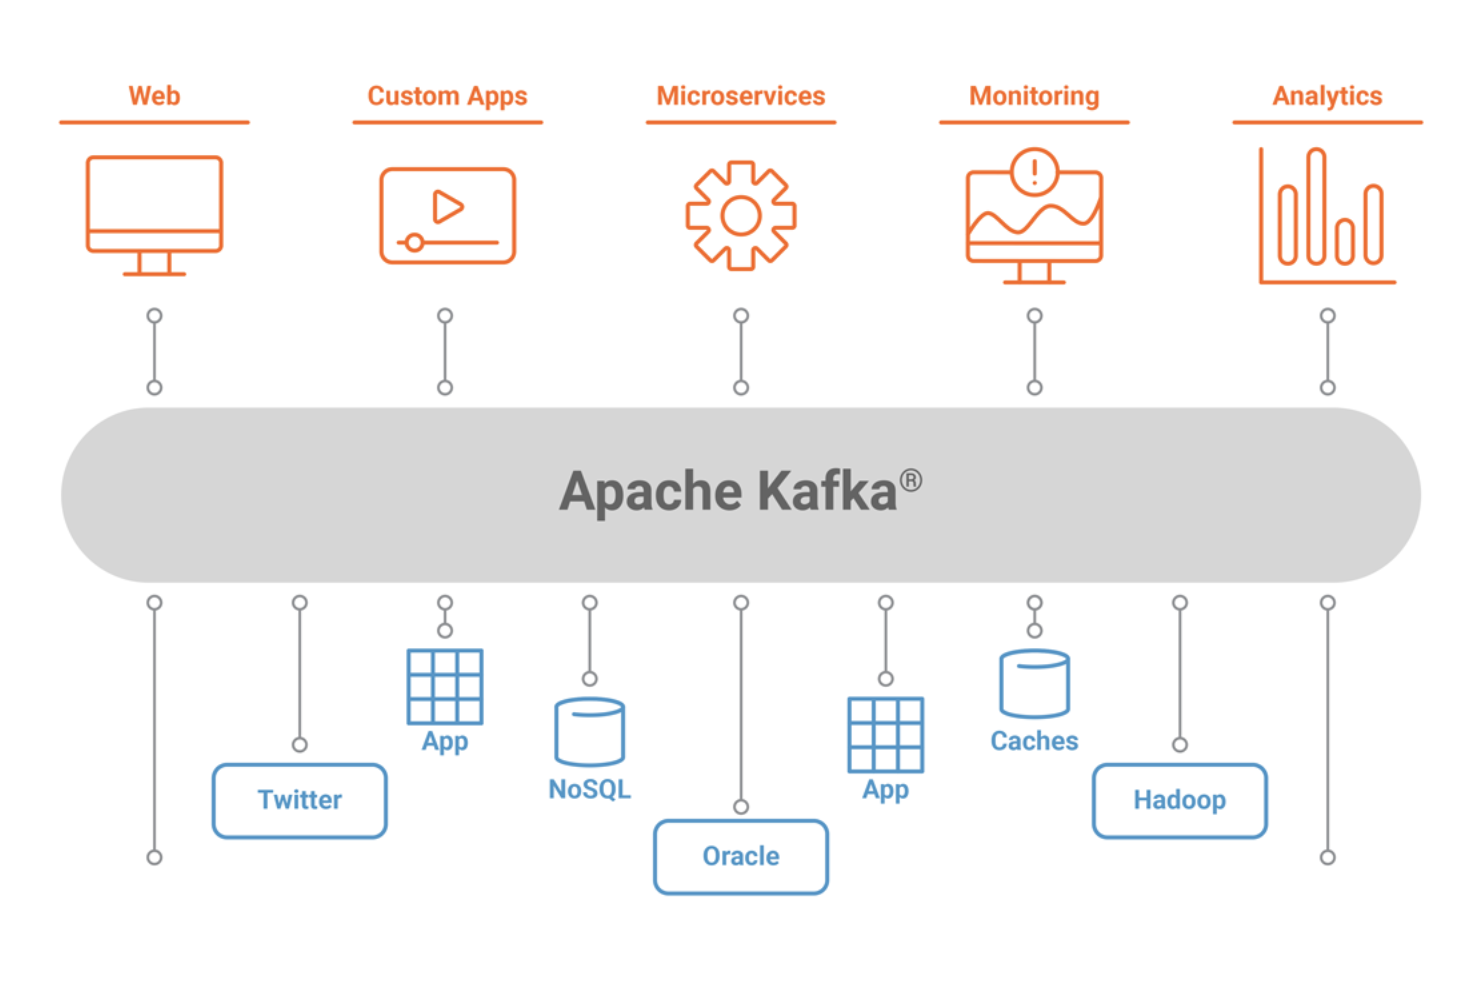
Apache Kafka ist eine verteilte Event-Streaming-Plattform, die von Entwicklern und Unternehmen genutzt wird, um Echtzeit-Datenpipelines und Streaming-Anwendungen zu erstellen. Sie ist darauf ausgelegt, große Datenmengen schnell und effizient zu verarbeiten, was sie ideal für Unternehmen macht, die eine Echtzeit-Datenverarbeitung benötigen.
Warum ich Apache Kafka ausgewählt habe: Es ist speziell für das Echtzeit-Streaming von Daten konzipiert und unterstützt eine hohe Durchsatzrate sowie eine geringe Latenz – beides ist für moderne, datengetriebene Anwendungen unerlässlich. Die verteilte Architektur von Kafka gewährleistet hohe Verfügbarkeit und Ausfallsicherheit, sodass Ihre Daten stets zugänglich sind. Die Plattform ist skalierbar, sodass Sie wachsende Datenmengen bewältigen können, ohne die Leistung zu beeinträchtigen. Zudem bietet Kafka starke Garantien zur Dauerhaftigkeit, was die Integrität Ihrer Daten im Zeitverlauf gewährleistet.
Herausragende Funktionen & Integrationen:
Funktionen umfassen eine verteilte Architektur, die hohe Verfügbarkeit sicherstellt, eingebaute Datenreplikation für Ausfallsicherheit und ein robustes Messaging-System für skalierbare Datenverarbeitung. Diese Eigenschaften erlauben eine effiziente Verarbeitung großer Datenmengen. Das auf Protokollen basierende Speichersystem von Kafka gewährleistet Datenhaltbarkeit und Zuverlässigkeit.
Integrationen umfassen Confluent, AWS, Azure, Google Cloud, MongoDB, Cassandra, Elasticsearch, Splunk, Hadoop und MySQL.
Pros and Cons
Pros:
- Verarbeitet große Datenmengen mit hohem Durchsatz
- Geringe Latenz bei der Verarbeitung
- Hohe Datenhaltbarkeit
Cons:
- Begrenztes integriertes Monitoring
- Konfiguration kann herausfordernd sein

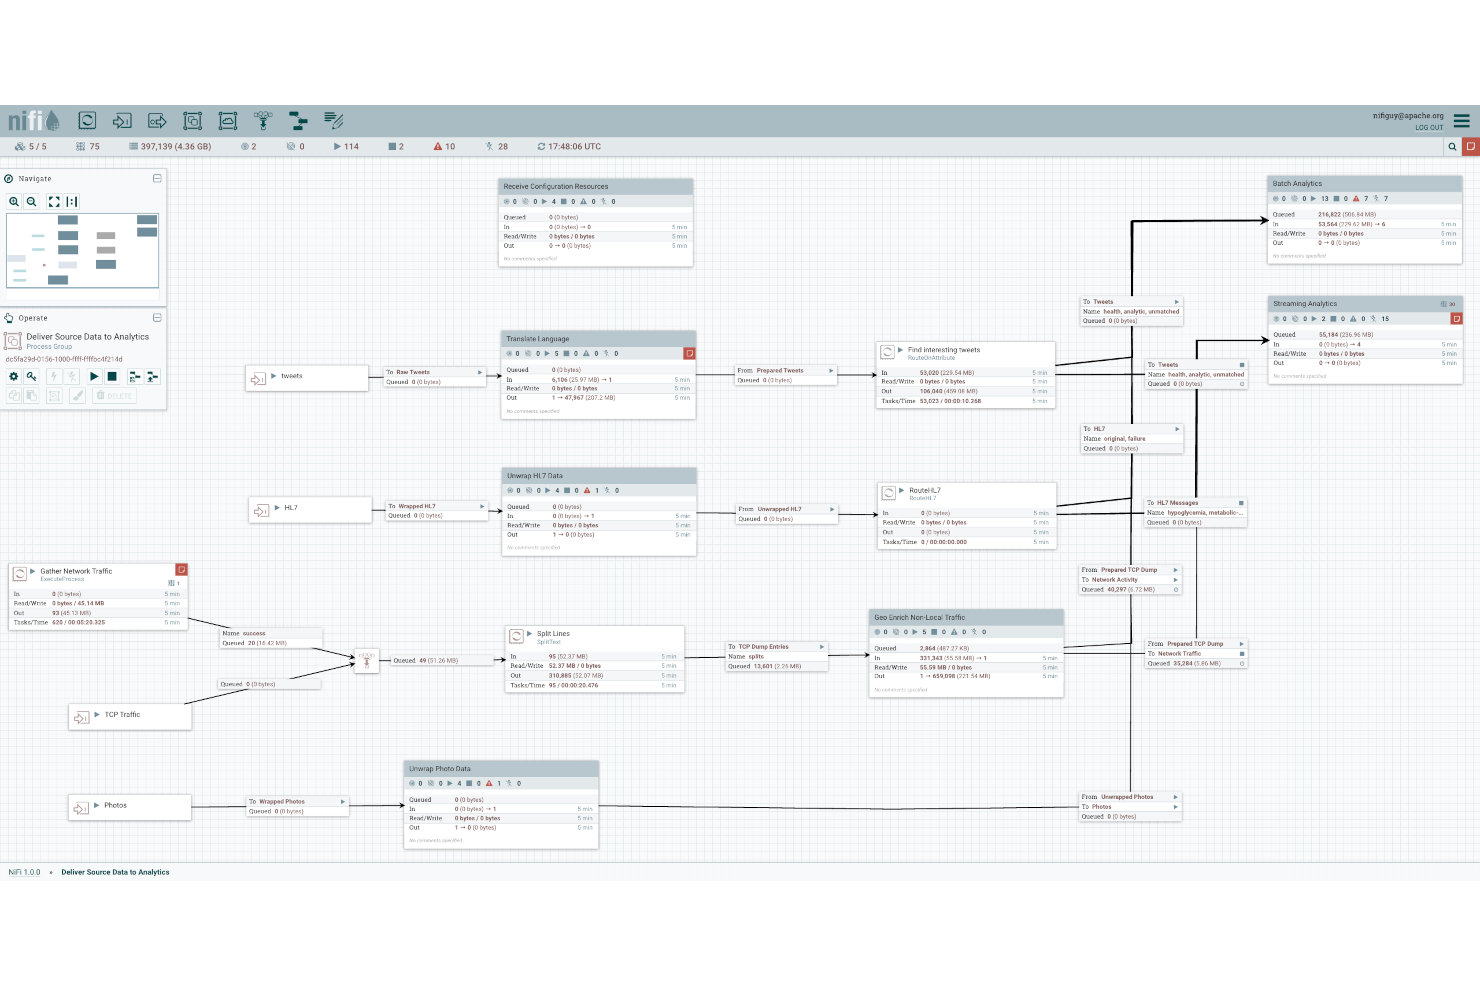
Apache NiFi ist ein Open-Source-Datenintegrationswerkzeug, das für Entwickler und Data Engineers entwickelt wurde, die Datenflüsse automatisieren möchten. Es ermöglicht das Sammeln, Verarbeiten und Verteilen von Daten über verschiedene Systeme hinweg und eignet sich daher ideal für die Verarbeitung von Echtzeitdaten.
Warum ich Apache NiFi gewählt habe: Es ist speziell für die Automatisierung von Datenflüssen konzipiert und bietet eine benutzerfreundliche Oberfläche zur Gestaltung komplexer Workflows. Die Drag-and-Drop-Oberfläche von NiFi vereinfacht die Erstellung von Datenpipelines, was besonders für Teams ohne umfassende Programmierkenntnisse wichtig ist. Das Tool unterstützt das Management von Echtzeit-Datenflüssen und stellt sicher, dass Ihre Daten stets aktuell und relevant sind. Die integrierten Sicherheitsfunktionen bieten zusätzlichen Schutz für sensible Daten.
Hervorstechende Funktionen & Integrationen:
Funktionen umfassen eine Drag-and-Drop-Oberfläche, die die Workflow-Gestaltung vereinfacht und es ermöglicht, Datenpipelines mühelos zu erstellen. Das Echtzeit-Management der Datenflüsse durch NiFi gewährleistet, dass Ihre Daten immer auf dem neuesten Stand sind. Zudem bietet das Tool integrierte Sicherheitsfunktionen zum Schutz sensibler Informationen.
Integrationen umfassen AWS, Azure, Google Cloud, Kafka, HDFS, MongoDB, Elasticsearch, MySQL, PostgreSQL und JMS.
Pros and Cons
Pros:
- Automatisiert Datenflüsse effizient
- Benutzerfreundliche Drag-and-Drop-Oberfläche
- Echtzeit-Datenmanagement
Cons:
- Kann ressourcenintensiv sein
- Komplexität bei der Ersteinrichtung

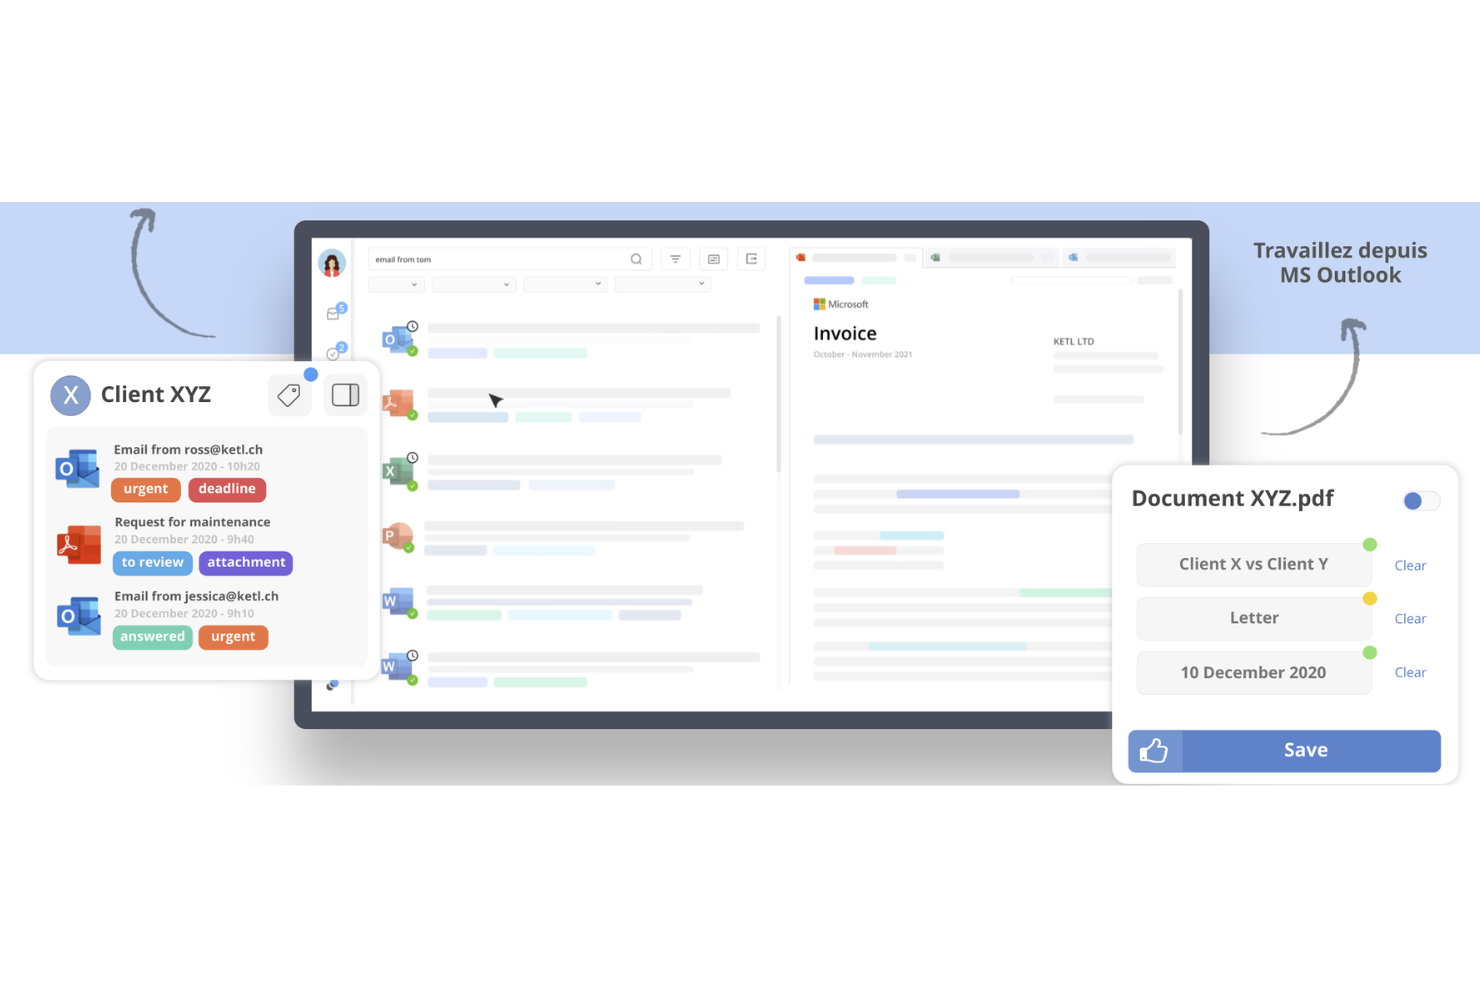
KETL ist eine Open-Source-ETL-Plattform, die für Data Engineers und IT-Profis entwickelt wurde, die skalierbare Datenintegration und Planungsfunktionen benötigen. Sie bietet eine multithreadbasierte, XML-basierte Architektur, die komplexe Datenmanipulationen unterstützt und sich somit für umfangreiche Datenverarbeitungsaufgaben eignet.
Warum ich KETL gewählt habe: Es bietet skalierbare ETL-Lösungen durch die Möglichkeit, große Datenmengen über mehrere Server und CPUs hinweg zu verarbeiten. Der Ausführungs- und Zeitplanungsmanager der Plattform gewährleistet ein effizientes Workflow-Management, das für groß angelegte Abläufe entscheidend ist. Das zentrale Repository für Job-Definitionen hilft dabei, Organisation und Kontrolle über Datenprozesse zu bewahren. Zusätzlich ermöglichen KETLs Leistungsüberwachungsfunktionen Ihrem Team, Datenworkflows effektiv zu verfolgen und zu optimieren.
Herausragende Funktionen & Integrationen:
Funktionen umfassen eine multithreadbasierte Architektur, die Skalierbarkeit und Leistung verbessert. KETL unterstützt eine breite Palette an Job-Typen, darunter SQL, OS und XML, was Flexibilität bei der Verarbeitung unterschiedlicher Datenformate bietet. Das zentrale Repository für Job-Definitionen hilft dabei, das Workflow-Management zu optimieren und Konsistenz sicherzustellen.
Integrationen umfassen Oracle, MySQL, PostgreSQL, Microsoft SQL Server, MongoDB, Amazon Redshift, Google BigQuery, Salesforce, SAP und Hadoop.
Pros and Cons
Pros:
- Skalierbar über mehrere Server hinweg
- Unterstützt komplexe Datenmanipulation
- Zentrales Job-Repository
Cons:
- Begrenzte Community-Unterstützung
- Dokumentation kann lückenhaft sein
Weitere Open-Source-ETL-Tools
Hier sind einige weitere Open-Source-ETL-Tools, die es nicht auf meine Auswahlliste geschafft haben, aber dennoch einen Blick wert sind:
- Singer
Am besten für Datenextraktionsskripte geeignet
- Scriptella
Am besten geeignet für einfaches ETL-Scripting
- Bubbles
Python ETL-Framework zur Verarbeitung, Überprüfung und Inspektion von Daten


Comment j'évalue les outils ETL open source
Je divise mon évaluation en deux niveaux — les capacités de base d'un pipeline ETL/ELT afin de qualifier un outil, puis les différenciateurs comme la capture de données modifiées (CDC), le support de Kubernetes et la couverture des connecteurs, qui deviennent essentiels à l'échelle de production.
Fonctionnalités de base (Critères indispensables pour cette liste)
Lorsque je sélectionne des outils pour ma liste, j'attribue à chacun une note de 0 (la fonctionnalité n'est pas proposée) à 5 (l'outil excelle dans ce domaine) pour chacune des fonctionnalités essentielles listées ci-dessous. Ensuite, je convertis le score total de l'outil en pourcentage. Chaque outil doit obtenir un score total minimum de 65% pour être pris en compte.
- Licence open source : Je vérifie que le projet utilise une licence homologuée par l'OSI (Apache 2.0, MIT, GPL, etc.) et que le code source est disponible publiquement pour l'auto-hébergement, le fork et la contribution de la communauté.
- Support complet du pipeline ETL/ELT : Chaque outil doit gérer l'extraction, la transformation et le chargement comme un flux de travail connecté — pas seulement synchroniser des données de A à B sans logique intermédiaire.
- Bibliothèque de connecteurs préconstruits : J'évalue l'étendue des connecteurs disponibles pour les bases de données, entrepôts cloud, applications SaaS et formats de fichiers, car un outil avec seulement quelques connecteurs signifie que votre équipe devra coder chaque nouvelle source.
- Moteur de transformation de données : Que ce soit basé sur SQL comme les modèles type dbt, des scripts Python ou du mapping visuel, je recherche une couche de transformation pouvant répondre aux besoins réels tels que le changement de type, la déduplication ou les jointures.
- Orchestration et planification des pipelines : Les outils doivent permettre des exécutions planifiées, la gestion des dépendances, des relances automatiques et la supervision des tâches, afin d'éviter que les pipelines échouent en silence à 2h du matin sans alerte.
- Extensibilité et connecteurs personnalisés : Je vérifie l'existence d'un SDK documenté ou d'un framework de plugins permettant à votre équipe de créer des connecteurs pour des API internes ou des systèmes spécifiques non pris en charge par le catalogue par défaut.
Une fois la liste des outils satisfaisant à ces critères établie, j'examine les éléments distinctifs de chaque plateforme.
Facteurs différenciants (ce qui distingue les éditeurs)
Voici comment je compare différents éditeurs :
Fonctionnalités remarquables
La capture de données modifiées est essentielle quand vos pipelines doivent refléter les mises à jour de la base source quasiment en temps réel — par exemple, synchroniser les changements de statut de commande dans un entrepôt sans recharger complètement les tables chaque heure. J'évalue aussi la traçabilité des données et l'observabilité, car suivre les dépendances au niveau des colonnes et détecter les dérives de schéma avant qu'un tableau de bord ne casse fait gagner des heures de débogage. Un concepteur visuel de pipeline est également remarquable, surtout pour les équipes où des analystes ou des contributeurs moins axés code doivent bâtir ou modifier des pipelines aux côtés des ingénieurs.
Au-delà des fonctionnalités
La vitalité de la communauté est un signal fort de stabilité à long terme — je vérifie la fréquence des commits, le rythme des sorties et la réactivité des mainteneurs aux tickets et Pull Requests. La flexibilité de déploiement compte aussi : un outil compatible Docker, Kubernetes et Helm charts offre plus d'options, que l'on soit sur site ou multi-cloud. Enfin, j'examine de près la clarté de la licence, car certains projets "open core" réservent des fonctions clés comme le RBAC ou le SSO aux offres payantes, ce qui peut piéger les équipes en phase de montée en charge.
So wählen Sie Open-Source-ETL-Tools aus
Bei langen Funktionslisten und komplexen Preisstrukturen verliert man leicht den Überblick. Damit Sie sich bei Ihrem individuellen Auswahlprozess auf das Wesentliche konzentrieren können, finden Sie hier eine Checkliste mit Faktoren, die Sie berücksichtigen sollten:
| Faktor | Was zu beachten ist |
| Skalierbarkeit | Stellen Sie sicher, dass das Tool das Wachstum Ihres Datenvolumens bewältigen kann. Berücksichtigen Sie zukünftige Anforderungen und ob das Tool sowohl die Stapelverarbeitung als auch die Echtzeitverarbeitung effizient unterstützt. |
| Integrationen | Prüfen Sie, ob sich das Tool in Ihre bestehenden Systeme und Datenquellen wie Datenbanken, Cloud-Dienste und Anwendungen von Drittanbietern integrieren lässt, um Arbeitsabläufe zu optimieren. |
| Anpassbarkeit | Achten Sie auf die Möglichkeit, Datenarbeitsabläufe an Ihre spezifischen Prozesse anzupassen. Je anpassbarer das Tool ist, desto besser kann es sich an Ihre sich wandelnden Anforderungen anpassen. |
| Benutzerfreundlichkeit | Bewerten Sie die Benutzeroberfläche. Ein einfach zu navigierendes Tool verkürzt die Lernkurve für Ihr Team und beschleunigt die Implementierung. |
| Budget | Vergleichen Sie die Preise mit Ihrem Budget. Berücksichtigen Sie die Gesamtbetriebskosten einschließlich versteckter Kosten, um sicherzustellen, dass sie mit Ihren finanziellen Rahmenbedingungen übereinstimmen. |
| Sicherheitsvorkehrungen | Stellen Sie sicher, dass das Tool robuste Sicherheitsfunktionen zum Schutz Ihrer sensiblen Daten bietet. Achten Sie auf Verschlüsselung, Benutzerzugriffskontrollen und die Einhaltung von Vorschriften. |
| Unterstützung | Prüfen Sie die Verfügbarkeit des Kundensupports. Ein reaktionsschneller Support kann während der Implementierung und bei der Fehlerbehebung entscheidend sein. |
| Leistung | Bewerten Sie die Verarbeitungsgeschwindigkeit und Zuverlässigkeit des Tools. Es sollte Daten zuverlässig und ohne Fehler pünktlich bereitstellen, um Ihre Geschäftsabläufe zu unterstützen. |
Trends bei quelloffenen ETL-Tools
Für meine Recherche habe ich unzählige Produktaktualisierungen, Pressemitteilungen und Versionsprotokolle verschiedener Anbieter quelloffener ETL-Tools ausgewertet. Hier sind einige der aufkommenden Trends, die ich im Auge behalte:
- Echtzeitverarbeitung: Immer mehr Tools konzentrieren sich auf die Echtzeitverarbeitung von Daten, sodass Unternehmen schnell auf Veränderungen reagieren und fundierte Entscheidungen treffen können. Apache Kafka hat beispielsweise seine Streaming-Funktionen erweitert, um Echtzeitanalysen zu unterstützen.
- Datenüberwachung: Anbieter fügen Funktionen hinzu, die die Transparenz und Überwachung von Daten verbessern und Teams dabei helfen, Probleme schneller zu erkennen und zu beheben. Tools wie Apache NiFi bieten inzwischen verbesserte Funktionen zur Datenverfolgung und Datenherkunft, um die Datenintegrität sicherzustellen.
- Cloudnative Architektur: Angesichts des Wechsels zum Cloud-Computing werden ETL-Tools so entwickelt, dass sie Cloud-Ressourcen effizient nutzen. Talend Open Studio bietet beispielsweise cloudnative Funktionen zur Optimierung von Leistung und Skalierbarkeit.
- Schnittstellen mit wenig Programmieraufwand: Die Nachfrage nach Plattformen mit wenig oder ohne Programmieraufwand, die ETL-Tools für technisch weniger versierte Benutzer zugänglich machen, steigt. Tools wie Pentaho Kettle setzen zunehmend auf visuelle Oberflächen, um die Erstellung von Datenpipelines zu vereinfachen.
- Daten-Governance: Da die Datenschutzbestimmungen strenger werden, integrieren ETL-Tools zunehmend Funktionen für die Datenverwaltung. Dazu gehören Optionen zur Datenmaskierung und Verschlüsselung, die in Lösungen wie Hevo Data zum Sicherstellen der Compliance und des sicheren Umgangs mit Daten zum Standard werden.
Was sind quelloffene ETL-Tools?
Quelloffene ETL-Tools ermöglichen die Extraktion, Transformation und das Laden von Daten aus verschiedenen Quellen an einen zentralen Ort. Dateningenieure, Analysten und IT-Fachleute verwenden diese Tools typischerweise, um große Datenmengen effizient zu verwalten und zu verarbeiten.
Echtzeitverarbeitung, Datenüberwachung und cloudnative Funktionen unterstützen schnelle Entscheidungsfindung, Problemlösung und eine effiziente Ressourcennutzung. Insgesamt bieten diese Tools die erforderliche Flexibilität und Skalierbarkeit, um komplexe Datenarbeitsabläufe zu bewältigen und datengestützte Strategien zu unterstützen. Um die Zuverlässigkeit bei der Skalierung sicherzustellen, sollten Teams ihre ETL-Tools durch robuste Tools zur Automatisierung von ETL-Tests ergänzen.
Funktionen quelloffener ETL-Tools
Achten Sie bei der Auswahl quelloffener ETL-Tools auf die folgenden wichtigen Funktionen:
- Verarbeitung in Echtzeit: Verarbeitet Daten, sobald sie eingehen, und hilft Ihnen dabei, zeitnahe Entscheidungen zu treffen und schnell auf Änderungen zu reagieren.
- Datenbeobachtbarkeit: Bietet Einblick in Datenflüsse und ermöglicht es Ihnen, Probleme schnell zu überwachen und zu beheben.
- Cloudnative Architektur: Nutzt Cloud-Ressourcen effizient, um Skalierbarkeit und Leistung zu verbessern.
- Low-Code-Schnittstellen: Vereinfachen die Erstellung von Datenpipelines und machen Tools für technisch nicht versierte Benutzer zugänglich.
- Daten-Governance: Gewährleistet Compliance und Sicherheit durch Funktionen wie Datenmaskierung und Verschlüsselung.
- Integration mehrerer Quellen: Verbindet verschiedene Datenquellen, um die Datenverarbeitung zu zentralisieren und zu optimieren.
- Skalierbarkeit: Bewältigt wachsende Datenmengen und unterstützt sowohl die Stapelverarbeitung als auch die Verarbeitung in Echtzeit.
- Anpassbarkeit: Ermöglicht die Anpassung von Daten-Workflows an spezifische Geschäftsanforderungen und Prozesse.
- Leistungsüberwachung: Überwacht und optimiert Daten-Workflows, um Effizienz und Genauigkeit aufrechtzuerhalten.
- Planungsmanager: Automatisiert die Ausführung von Aufgaben und verwaltet Workflows, um die Produktivität zu steigern.
Vorteile von Open-Source-ETL-Tools
Die Implementierung von Open-Source-ETL-Tools bietet Ihrem Team und Ihrem Unternehmen mehrere Vorteile. Hier sind einige, auf die Sie sich freuen können:
- Kosteneffizienz: Da diese Tools Open Source sind, fallen häufig keine Lizenzgebühren an, wodurch die Gesamtkosten für Ihr Unternehmen sinken.
- Flexibilität: Anpassbare Workflows ermöglichen es Ihnen, Datenprozesse auf Ihre spezifischen Anforderungen zuzuschneiden und sie an sich verändernde Bedürfnisse anzupassen.
- Skalierbarkeit: Unterstützt sowohl die Stapelverarbeitung als auch die Verarbeitung in Echtzeit und ermöglicht es Ihrem Unternehmen, wachsende Datenmengen ohne Leistungseinbußen zu bewältigen.
- Verbesserte Entscheidungsfindung: Die Datenverarbeitung in Echtzeit stellt sicher, dass Ihr Team Zugriff auf aktuelle Informationen hat und dadurch zeitnahe und fundierte Entscheidungen treffen kann.
- Verbesserte Datenqualität: Funktionen wie Datenbeobachtbarkeit und Daten-Governance tragen dazu bei, Datengenauigkeit und Compliance aufrechtzuerhalten, wodurch das Vertrauen in Ihre Daten steigt.
- Unterstützung durch die Community: Eine starke Entwickler-Community unterstützt diese Tools häufig und stellt Ressourcen sowie geteiltes Wissen zur Fehlerbehebung und Weiterentwicklung bereit.
- Integrationsmöglichkeiten: Verbindet sich problemlos mit verschiedenen Datenquellen und Systemen und optimiert so das Datenmanagement in Ihrem gesamten Unternehmen.
Kosten und Preise von Open-Source-ETL-Tools
Bei der Auswahl von Open-Source-ETL-Tools ist es wichtig, die verschiedenen verfügbaren Preismodelle und Tarife zu verstehen. Die Kosten variieren je nach Funktionen, Teamgröße, Add-ons und weiteren Faktoren. Die folgende Tabelle fasst gängige Tarife, deren Durchschnittspreise und typische enthaltene Funktionen von Open-Source-ETL-Tool-Lösungen zusammen:
Vergleichstabelle der Tarife für Open-Source-ETL-Tools
| Tarifart | Durchschnittspreis | Häufige Funktionen |
| Kostenloser Tarif | $0 | Grundlegende Datenextraktion, eingeschränkte Integrationen und Unterstützung durch die Community. |
| Persönlicher Tarif | $5-$25/user/month | Erweiterte Datentransformationen, persönlicher Support und eingeschränkte Anpassungsmöglichkeiten. |
| Geschäftstarif | $50-$100/user/month | Erweiterte Datenverarbeitung, mehrere Integrationen und Tools für die Teamzusammenarbeit. |
| Unternehmenstarif | $100-$500/user/month | Vollständige Anpassungsmöglichkeiten, Support auf Unternehmensebene und umfassende Sicherheitsfunktionen. |