

Så minskar du nätverksavbrott

Icke-tekniker kanske hör ”driftstopp” och tänker längtansfullt på en semester. Men för teknikproffs är driftstopp ett fult ord – och med rätta. Nätverksdriftstopp innebär en dålig dag på jobbet.
Nätverksdriftstopp innebär missnöjda kunder, kraftigt försämrad produktivitet och andra problem. När man talar om kundinriktade appar som en webbplats är driftstopp dyrt: driftstopp kostar större företag cirka 9 000 dollar per minut.
Och även om driftstopp kan påverka företag av alla typer och storlekar negativt är det särskilt problematiskt i vissa branscher. Ett detaljhandelsföretag kan förlora 1,1 miljoner dollar per timme under ett driftstopp.

Kort sagt: Driftstopp är dåligt.
Att minska och förebygga driftstopp är däremot bra. Faktum är att det är ett måste – eftersom även korta nätverksdriftstopp kan påverka resultatet negativt och orsaka följdskador, till exempel skadat anseende.
I den här artikeln definierar vi problemet och vad som krävs för att lösa det – inklusive ett ramverk i 13 steg för att utveckla en egen plan för att minska nätverksdriftstopp. Först är det bra att utgå från en enkel definition.
Vad är nätverksdriftstopp?
Nätverksdriftstopp innebär att delar av eller hela ett IT-nätverk blir otillgängligt, vilket gör att exempelvis en webbplats eller interna applikationer som ett ERP-system inte kan nås under en viss tidsperiod.
Driftstopp kan generellt delas in i två huvudkategorier: planerade och oplanerade. Planerade driftstopp är precis vad det låter som: De är avsiktliga och schemalagda, vanligtvis för sådant som rutinunderhåll, systemuppgraderingar eller migrering av applikationer.
När vi säger att nätverksdriftstopp är dåligt menar vi egentligen oplanerade nätverksdriftstopp – det är när nätverket slutar fungera oväntat av ett antal möjliga orsaker. Det kan finnas många olika orsaker till driftstopp, från infrastrukturproblem och programvarubuggar till mänskliga fel och cyberattacker.
Vad – och vem – behövs för att minimera nätverksdriftstopp?
Med tanke på de kvantitativa och kvalitativa kostnaderna är det värt att vidta åtgärder även vid sällsynta nätverksdriftstopp. Och om utvecklingen börjar gå från sällsynta till frekventa driftstopp är det dags att lösa problemet med större skyndsamhet.
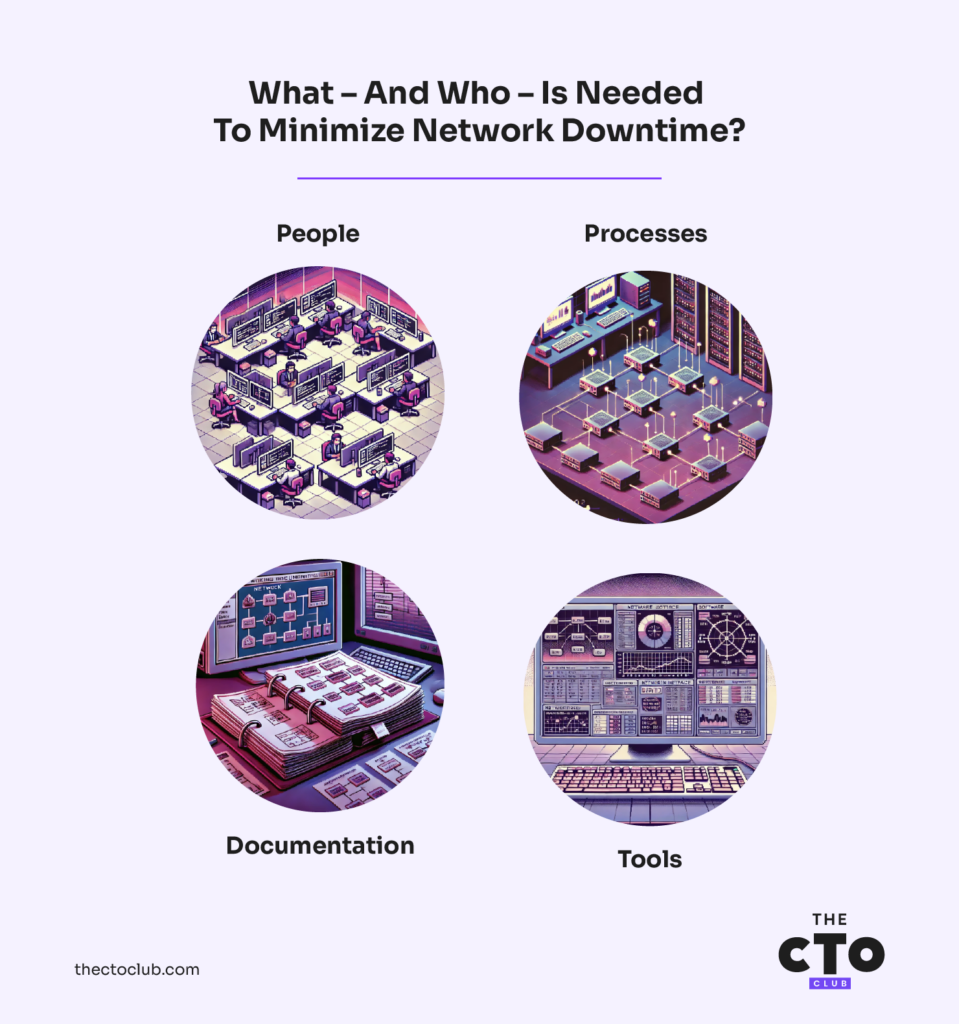
Det finns en blandning av människor, processer, dokumentation och verktyg som ni bör organisera först, säger Viacheslav Petrenko, teknikchef på programvaruutvecklingsföretaget LITSLINK.
Petrenko delade med sig av sina råd om de viktigaste delarna som bör vara på plats innan ni påbörjar ett nytt initiativ för att minska nätverksdriftstopp. Dessa kan vara både framåtblickande och historiska. De omfattar:
Dokumentation
Petrenko rekommenderar att samla in diagram över nätverkstopologin, incidentrapporter, servicenivåavtal (SLAs) och loggar för förändringshantering som grundläggande dokumentation.
All annan relevant dokumentation som är specifik för organisationen eller nätverket är också värd att ha nära till hands.
Processer
Det finns flera processer som experter rekommenderar att analysera – eller införa om de för närvarande saknas – som en del av ett initiativ för nätverkstillgänglighet. Dessa omfattar:
Protokoll för analys av grundorsak (RCA): Detta är en grundläggande process för att minska nätverksdriftstopp, eftersom dess yttersta syfte är att identifiera den eller de specifika orsakerna till problemet. Analys av grundorsak ”säkerställer en grundlig utredning av varje driftstoppsincident för att förhindra att den återkommer”, säger Petrenko.
Relaterad läsning: 5 verktyg för analys av grundorsak för bättre testning och kvalitetssäkring
Process för förändringshantering: Minimerar riskerna genom att noggrant styra och dokumentera alla nätverksförändringar. Observera: Processen måste balansera noggrannhet med flexibilitet för att undvika flaskhalsar.
Planer för katastrofåterställning och verksamhetskontinuitet: Alla insatser för att minska nätverksdriftstopp bör informeras av – och omvänt informera – organisationens bredare planer för motståndskraft vid större verksamhetsstörningar.
Relaterad läsning: En genomgång av de 25 bästa tjänsterna för katastrofåterställning
Schema för nätverksunderhåll: Proaktivt underhåll – som ibland kan innebära planerade driftstopp – ”hjälper till att förebygga problem innan de uppstår genom att regelbundet uppdatera och optimera nätverkets komponenter”, säger Petrenko.
Personer
I princip alla i en organisation är beroende av dess nätverk, men det betyder inte att alla behöver vara involverade i att optimera dess prestanda och tillförlitlighet. Petrenko listar följande roller som viktiga att inkludera i processen. Tänk på att specifika jobbtitlar kan variera från företag till företag.
Nätverksingenjörer: Det säger sig självt att de yrkespersoner som implementerar och underhåller nätverksinfrastrukturen behöver vara en del av processen.
Systemadministratörer: På samma sätt bör de personer som hanterar servrarna (och annan infrastruktur) samt de applikationer som är beroende av nätverket vara involverade. Relaterade titlar kan vara DevOps-ingenjör, tillförlitlighetsingenjör för webbplatser och infrastrukturingenjör.
Säkerhetsexperter: Att involvera säkerhetspersonalen bidrar till att ”säkerställa nätverkssäkerheten och skydda mot driftstopp som orsakas av attacker eller intrång”, säger Petrenko.
Dataanalytiker: Som framgår av dokumentationen ovan innebär optimering av ett nätverk att stora mängder prestandadata och annan information analyseras. Du behöver personer med kompetens att tolka dessa data och ta fram insikter för förbättringar.
Projektledare: Särskilt i stora företag kan du behöva någon som samordnar insatser mellan team och ser till att arbetet följer tidsplanen.
Verktyg
Vi går igenom verktyg för att minska nätverksdriftstopp mer ingående nedan, men det räcker att säga att du kommer att behöva några sådana, med särskilt fokus på (men inte begränsat till) övervakning, loggning, testning och planering. Specifika kategorier omfattar:
Programvara för nätverksövervakning: Du kan inte lösa problem om du inte ens vet att de finns. Dessa verktyg ger insyn i nätverket och dess prestanda i realtid och kan generera varningar om möjliga problem.
Verktyg för konfigurationshantering: Verktyg för konfigurationshantering kan automatisera och spåra ändringar i nätverksinfrastruktur och enheter, vilket enligt Petrenko kan minska risken för mänskliga fel när ändringar görs.
Programvara för logghantering och verktyg för logganalys: Loggning är ett viktigt sätt att fastställa baslinjemönster och ”normalt” beteende i ett nätverk – och sedan identifiera onormal aktivitet innan den eventuellt orsakar ett driftstopp.
Verktyg för automatiserad testning: Automatisering av testning och kvalitetssäkring gör det lättare att upptäcka problem snabbare och minskar även mängden manuellt arbete som krävs.
Programvara för kapacitetsplanering: Kapacitetsplanering – ofta en funktion i verktyg för nätverksövervakning – kan hjälpa till att förutsäga framtida nätverkskrav och förhindra driftstopp på grund av överbelastning. Petrenko påpekar att detta kräver korrekta indata och regelbundna uppdateringar för att förbli effektivt.
-

NinjaOne
Visit WebsiteThis rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.4.7 -
Paessler PRTG
Visit WebsiteThis rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.4.6 -
Atera
Visit WebsiteThis rating combines scores from multiple user review sites to reflect overall customer sentiment about the product.4.6



Minska nätverksdriftstopp i 13 steg
Så vad gör du faktiskt med allt ovanstående? Vi hjälper dig: Petrenko delade med sig av en handlingsplan i 13 steg som du kan använda för att utveckla en egen strategi baserad på din organisation och de specifika egenskaperna hos dess nätverk samt dess mål.
Då sätter vi igång:
- Bedöm nuläget: Här samlar, organiserar och analyserar du alla komponenter vi diskuterade ovan, inklusive dokumentation och annan relevant information.
Petrenkos råd: “Överväg att ta in externa konsulter för att få ett opartiskt perspektiv, men se till att alla interna intressenter är involverade för att få en heltäckande bild.”
- Definiera dina mål: ”Minska driftstopp” är ett bra övergripande mål, men bryt ner det i mer specifika mål för nätverkets prestanda.
Petrenkos råd: “Dessa mål bör vara ambitiösa men realistiska och ta hänsyn till branschstandarder och specifika affärsbehov.”
- Sätt samman ditt team: Skapa ett tvärfunktionellt team med de färdigheter, kunskaper och befogenheter att fatta beslut som krävs för att uppnå resultat.
Petrenkos råd: “Undvik att skapa stuprör och etablera bra kommunikationskanaler mellan alla teammedlemmar.”
- Implementera övervakningsverktyg: Omfattande programvara för nätverksövervakning och -analys är avgörande för alla initiativ för nätverkstillgänglighet.
Petrenkos råd: “Du behöver välja mellan lokala, molnbaserade eller hybrida lösningar baserat på din infrastruktur.”
- Fastställ dina nyckeltal och baslinjer: Du kan inte göra framsteg mot ett mål om du inte vet var du började.
Petrenkos råd: ”Mät den aktuella prestandan för att fastställa en utgångspunkt för förbättringar. Det är avgörande att dessa mätvärden är konsekventa och relevanta för dina definierade mål.”
- Identifiera och prioritera kritiska problem: Beroende på nätverkets aktuella tillstånd är det osannolikt att du kan lösa alla underliggande problem samtidigt. Prioritera därför de viktigaste orsakerna till driftstopp. ”Betydelse” kan förstås holistiskt utifrån organisationens mål, vilket Petrenko påpekar nedan.
Petrenkos råd: ”När du prioriterar bör du ta hänsyn till både problemens frekvens och deras påverkan.”
- Utöka din strategi: Utveckla en detaljerad plan för att hantera alla identifierade problem (när problemen med hög prioritet har åtgärdats), inklusive tidsplaner och resursfördelning.
Petrenkos råd: ”Kom ihåg att inte försöka åtgärda allt på en gång. Prioritera utifrån påverkan och genomförbarhet.”
- Utveckla redundans- och reservsystem: Redundans i kritiska nätverkskomponenter och automatiserade reservprocesser är båda viktiga delar av en långsiktig strategi för nätverksprestanda och motståndskraft.
Petrenkos råd: ”Det kan omfatta redundant maskinvara, nätverksdesigner med flera vägar eller molnbaserade reservsystem. Se till att redundansen inte introducerar onödig komplexitet som i sig kan bli en källa till problem.”
- Genomför förändringar: Det är dags att verkställa planen, med början i de högst prioriterade åtgärderna.
Petrenkos råd: ”Se till att följa processerna för förändringshantering för att minimera risken för att nya problem uppstår.”
- Övervaka och justera: Ingen plan blir någonsin perfekt, så var beredd att anpassa dig medan du arbetar med din strategi.
Petrenkos råd: ”Följ kontinuerligt upp prestandamätvärden och justera planen efter behov. Du kan vilja införa automatiserade aviseringar för snabba svar på nya problem.”
- Genomför regelbunden kompetensutveckling: Alla storskaliga initiativ för att minska driftstopp kommer oundvikligen att innebära att människor lär sig ny teknik och nya processer. Förvänta dig inte att personalen bara ska lista ut det allt eftersom.
Petrenkos råd: ”Inför löpande utbildningsprogram för personalen så att de håller sig uppdaterade om bästa praxis och ny teknik. Detta bör omfatta både teknisk och processrelaterad utbildning för att säkerställa att alla teammedlemmar har de förutsättningar som krävs för att förebygga och hantera driftstopp.”
- Genomför övningar för katastrofåterställning: Precis som vid de flesta typer av beredskapsplanering hoppas du självklart att du aldrig faktiskt ska behöva använda den. Men om du behöver göra det vill du säkerställa att du har testat dina planer genom simulerade driftstopp och andra problem.
Petrenkos råd: ”Försök att göra dessa övningar så realistiska som möjligt utan att riskera faktiska driftstopp.”
- Följ upp och rapportera dina framsteg: Utvärdera regelbundet dina framsteg mot målen (steg 2) och förbättringarna av dina baslinjemätvärden, och dela resultaten med berörda intressenter.
Petrenkos råd: ”Använd både tekniska mätvärden och mått på verksamhetspåverkan i rapporteringen för att ge en fullständig bild.”
Verktyg för att minska nätverkets driftstopp
Vilken programvara och vilka andra verktyg kan spela en avgörande roll för att minimera driftstopp och förbättra nätverkets övergripande hälsa och prestanda? Vi har inkluderat exempel i varje kategori.
1. Verktyg för nätverksövervakning
- SolarWinds Network Performance Monitor (NPM): Tillhandahåller omfattande övervakning av nätverksprestanda, feldetektering och aviseringar.
- Nagios: Erbjuder robusta funktioner för nätverksövervakning, aviseringar och rapportering.
- PRTG Network Monitor: Ett mångsidigt verktyg som övervakar alla aspekter av din nätverksinfrastruktur.
2. Verktyg för nätverkshantering och nätverkskonfiguration
- Cisco Prime Infrastructure: Hjälper till att hantera och optimera din nätverksinfrastruktur.
- WhatsUp Gold: Tillhandahåller nätverksövervakning och -hantering, inklusive konfigurationshantering.
3. Automatiserade verktyg för incidenthantering
- PagerDuty: Integreras med övervakningsverktyg för att tillhandahålla incidenthantering och automatiska aviseringar.
- Opsgenie: Erbjuder jourhantering, incidenthantering och aviseringar.
4. Verktyg för felhantering
- Zabbix: Övervakar nätverksprestanda och hjälper till att upptäcka och åtgärda fel.
- ManageEngine OpManager: Tillhandahåller felhantering, prestandaövervakning och nätverksvisualisering.
5. Verktyg för säkerhetskopiering och återställning av nätverkskonfiguration
- RANCID (Really Awesome New Cisco confIg Differ): Automatiserar säkerhetskopiering och hantering av nätverksenheters konfigurationer.
- SolarWinds Network Configuration Manager (NCM): Automatiserar säkerhetskopiering och återställning av konfigurationer och hjälper till att säkerställa efterlevnad.
6. Logghantering och analysverktyg
- Splunk: Samlar in och analyserar loggar från nätverksenheter för att identifiera och felsöka problem.
- ELK Stack (Elasticsearch, Logstash, Kibana): Tillhandahåller kraftfulla funktioner för logghantering och analys.
7. Trafikanalysverktyg
- Wireshark: En nätverksprotokollanalysator som hjälper till att diagnostisera nätverksproblem.
- NetFlow Analyzer: Övervakar nätverkstrafikens mönster och hjälper till att identifiera flaskhalsar.
8. Lösningar för hög tillgänglighet och redundansväxling
- F5 BIG-IP: Tillhandahåller belastningsbalansering, redundansväxling och hög tillgänglighet för nätverkstjänster.
- Cisco ASA: Erbjuder robusta funktioner för brandvägg och redundansväxling.
9. Prestandatestningverktyg
- iPerf: Mäter nätverksbandbredd och prestanda.
- SolarWinds WAN Killer: Simulerar nätverkstrafik för att testa nätverksprestanda under olika förhållanden.
10. Virtuellt privat nätverk (VPN)-verktyg
- OpenVPN: Tillhandahåller säker fjärråtkomst till nätverket och säkerställer anslutning under driftstopp.
- Cisco AnyConnect: En säker VPN-lösning som tillhandahåller fjärråtkomst till nätverksresurser.
11. Övervakning av slutpunkterverktyg
- Sysdig: Övervakar och säkrar containerbaserade miljöer och molninfrastruktur.
- Datadog: Tillhandahåller övervakning av hela teknikstacken, inklusive nätverks-, server- och programövervakning.
12. Molnbaserade verktyg för nätverksövervakning
- ThousandEyes: Tillhandahåller insyn från början till slut i nätverksprestanda över internet och i molnet.
- LogicMonitor: Ett molnbaserat övervakningsverktyg som erbjuder omfattande funktioner för nätverksövervakning.
Slutsatsen
Nätverksavbrott är en verklighet för de flesta organisationer, men det betyder inte att du bör låta dem fortgå utan åtgärd. Använd handlingsplanen och verktygen ovan för att förbättra nätverkets prestanda och minimera kostsamma avbrott.
För fler insikter om nätverk kan du prenumerera på vårt nyhetsbrev. Vi hjälper dig att bygga SaaS-team och skalbara system!

