

Honeycomb to narzędzie zaprojektowane w celu zapewnienia wglądu w wewnętrzne działanie systemu, pomagające optymalizować wydajność i rozwiązywać problemy.
Korzyści jest wiele — narzędzie umożliwia śledzenie poszczególnych zdarzeń, dzięki czemu złożone systemy stają się obserwowalne, a Ty możesz lepiej rozumieć, wyciągać wnioski i debugować swoje oprogramowanie.
Może się jednak zdarzyć, że będziesz potrzebować alternatywy dla Honeycomb. Być może korzystasz z konkretnego języka programowania, takiego jak PHP, albo potrzebujesz narzędzia oferującego zgodność z SOC. Możliwe też, że chcesz uzyskać dostęp do kodu źródłowego lub szukasz innego zestawu funkcji.
Niezależnie od powodów przygotowałem listę najlepszych alternatyw dla Honeycomb wraz z informacjami o produktach i ocenami w gwiazdkach, aby pomóc Ci znaleźć rozwiązanie najlepiej dopasowane do konkretnych potrzeb. Przejdźmy więc do omówienia tych opcji.
Czym jest Honeycomb?
Honeycomb to platforma obserwowalności, która pomaga debugować, monitorować i rozumieć systemy oprogramowania w czasie rzeczywistym. Korzystają z niej inżynierowie oprogramowania, zespoły DevOps i inżynierowie niezawodności witryn, którzy muszą szybko identyfikować problemy z wydajnością i nietypowe zachowania w środowisku produkcyjnym. Wgląd na poziomie zdarzeń, zapytania i mapy cieplne pomagają analizować działanie systemu, wykrywać wąskie gardła i zwiększać niezawodność aplikacji. Ogólnie rzecz biorąc, Honeycomb zapewnia zespołowi lepszy obraz tego, co dzieje się w kodzie, dzięki czemu można szybciej rozwiązywać problemy.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Tabela porównawcza alternatyw dla Honeycomb
Ta tabela porównawcza podsumowuje informacje o cenach wybranych przeze mnie najlepszych alternatyw dla Honeycomb:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Najlepszy do śledzenia rozproszonego bogatego w kontekst | Dostępny bezpłatny plan | Od $26/miesiąc (przy rozliczeniu rocznym) | Website | |
| 2 | Najlepsze rozwiązanie do automatycznego monitorowania pełnego stosu opartego na AI | 15-dniowy bezpłatny okres próbny | $21/użytkownika/miesiąc za plan monitorowania pełnego stosu (rozliczany rocznie) | Website | |
| 3 | Najlepszy do ujednoliconych śladów, logów i metryk w jednym widoku | Dostępny plan bezpłatny | $15/użytkownika/miesiąc (rozliczane rocznie) | Website | |
| 4 | Najlepszy do skalowalnego monitorowania infrastruktury typu open source | Dostępny bezpłatny plan | Ceny na żądanie | Website | |
| 5 | Najlepszy wybór do kompleksowego śledzenia transakcji biznesowych | 30-dniowy bezpłatny okres próbny | $3300 za jednostkę rocznie (rozliczane rocznie) | Website | |
| 6 | Najlepsze rozwiązanie do uzyskiwania informacji na temat wydajności aplikacji i monitorowania doświadczeń użytkowników końcowych | Bezpłatny plan + bezpłatne demo | $99/miesiąc za plan Pro (rozliczany rocznie) | Website | |
| 7 | Najlepsze rozwiązanie do zarządzania logami i analityki w środowiskach opartych na chmurze | 14-dniowy bezpłatny okres próbny | Ceny dostępne na żądanie | Website | |
| 8 | Najlepsze do monitorowania logów i alertowania na podstawie ich wolumenu | 30-dniowy bezpłatny okres próbny | Ceny na zapytanie | Website | |
| 9 | Najlepszy do uzyskiwania wiedzy operacyjnej opartej na danych maszynowych | Bezpłatny 60-dniowy okres próbny | $150/miesiąc (rozliczane rocznie) | Website | |
| 10 | Najlepszy do natywnych dla Kubernetes metryk i alertów | Dostępny bezpłatny plan | Wycena na życzenie | Website |


Recenzje najlepszych alternatyw dla Honeycomb
Poniżej znajdują się moje szczegółowe podsumowania najlepszych alternatyw dla Honeycomb, które trafiły na moją listę. W recenzjach szczegółowo omawiam najważniejsze funkcje, zalety & wady, integracje i idealne przypadki użycia każdego narzędzia, aby pomóc Ci znaleźć najlepsze rozwiązanie.
 Najlepszy do śledzenia rozproszonego bogatego w kontekst
- Dostępny bezpłatny plan
- Od $26/miesiąc (przy rozliczeniu rocznym)
Visit WebsiteCustomer Rating:4.5/5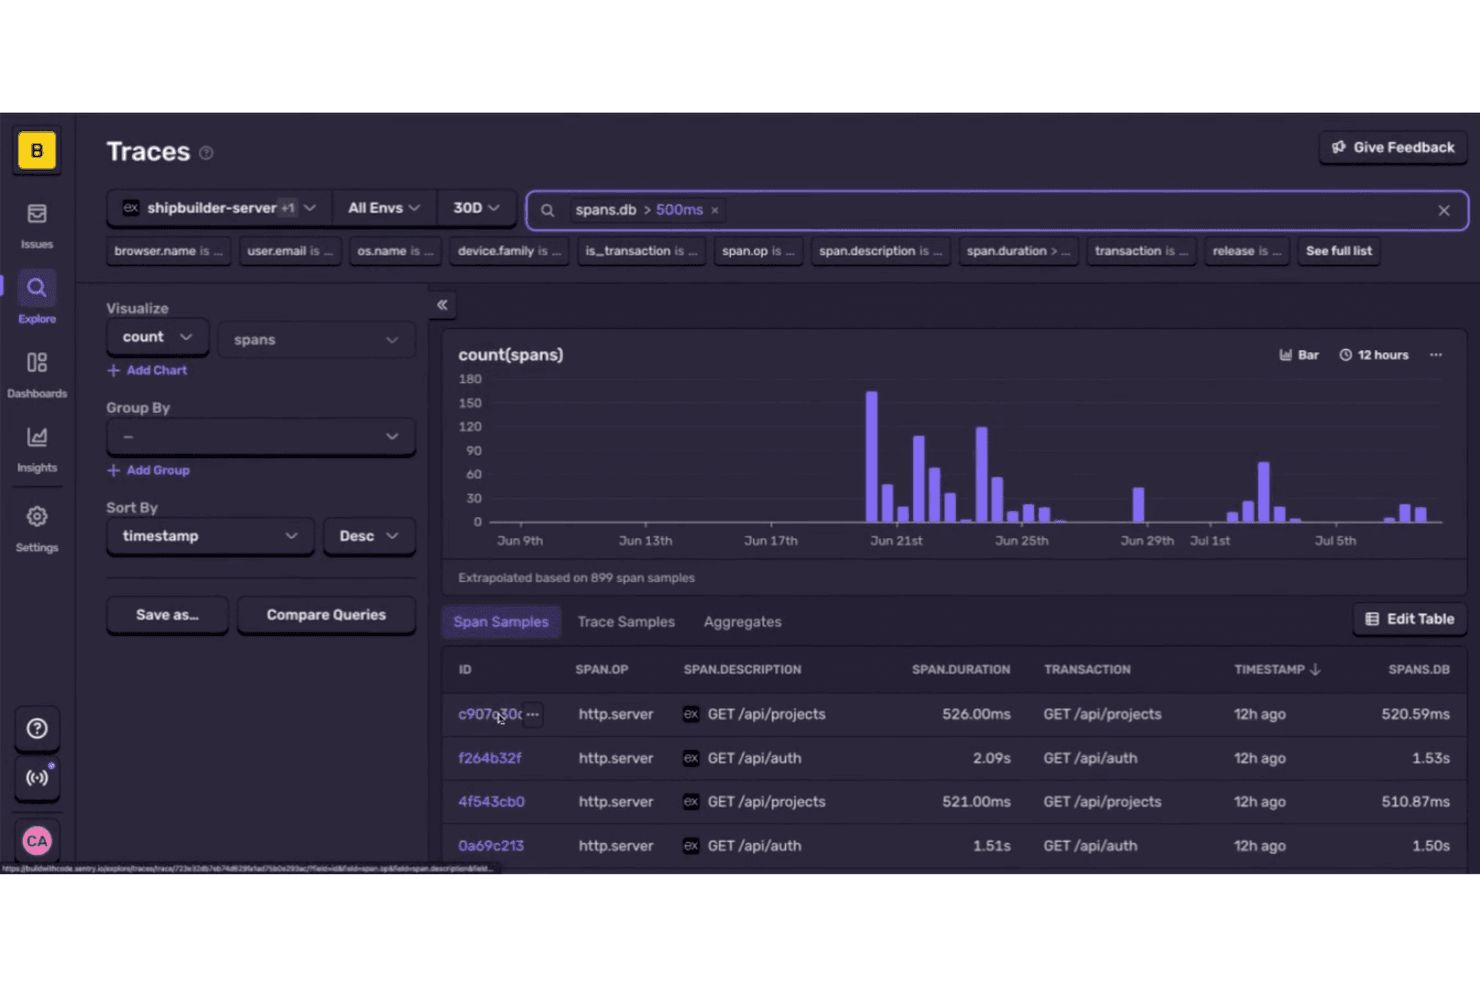
Sentry pozwala użytkownikom śledzić powolne zakresy baz danych w różnych usługach na przestrzeni czasu. Sentry to platforma do monitorowania aplikacji dla zespołów programistycznych, która pomaga inżynierom znajdować błędy i problemy z wydajnością w różnych usługach, diagnozować incydenty oraz ograniczać ich wpływ na użytkowników.
Dla kogo Sentry jest najlepszym wyborem?
Zespoły inżynieryjne obsługujące rozproszone aplikacje, które potrzebują kontekstu śledzenia, aby precyzyjnie lokalizować problemy z wydajnością w różnych usługach.
Dlaczego wybrałem Sentry
Wybrałem Sentry jako alternatywę dla Honeycomb, ponieważ najlepiej sprawdza się w śledzeniu rozproszonym bogatym w kontekst. Widok śledzenia mapuje zakresy między usługami i łączy błędy z transakcjami, które je wywołały. Podoba mi się, że pomaga to wskazać, w którym miejscu powolne żądanie zaczyna generować opóźnienia, gdy przechodzi przez interfejs API i powiązane z nim usługi.
Najważniejsze funkcje Sentry
- Monitorowanie błędów: Przechwytuje wyjątki i grupuje podobne zdarzenia w problemy.
- Odtwarzanie sesji: Rejestruje interakcje użytkowników, aby zespoły mogły analizować zdarzenia występujące w pobliżu błędu.
- Kondycja wydań: Śledzi sesje i użytkowników bez awarii w różnych wydaniach oprogramowania.
- Alerty dotyczące problemów: Wysyła powiadomienia, gdy pojawiają się nowe problemy lub zmieniają się istniejące.
Integracje Sentry
Sentry oferuje natywne integracje z GitHub, Jira, Slack, GitLab, Microsoft Teams, PagerDuty, Vercel, Bitbucket, Azure DevOps i Opsgenie. Jego platforma integracyjna obsługuje niestandardowe integracje za pośrednictwem webhooków i interfejsu REST API.
Pros and Cons
Pros:
- Błędy są bezpośrednio powiązane z kontekstem śledzenia
- Wyszukiwanie zakresów według atrybutów i percentyli opóźnienia
- Odtwarzanie sesji użytkowników obok przechwyconych błędów
Cons:
- Skupia się przede wszystkim na błędach aplikacji, a nie na infrastrukturze
- Duży zestaw funkcji może powodować przeładowanie interfejsu
Learn more about Sentry: Najlepsze rozwiązanie do automatycznego monitorowania pełnego stosu opartego na AI
- 15-dniowy bezpłatny okres próbny
- $21/użytkownika/miesiąc za plan monitorowania pełnego stosu (rozliczany rocznie)
Visit WebsiteCustomer Rating:4.5/5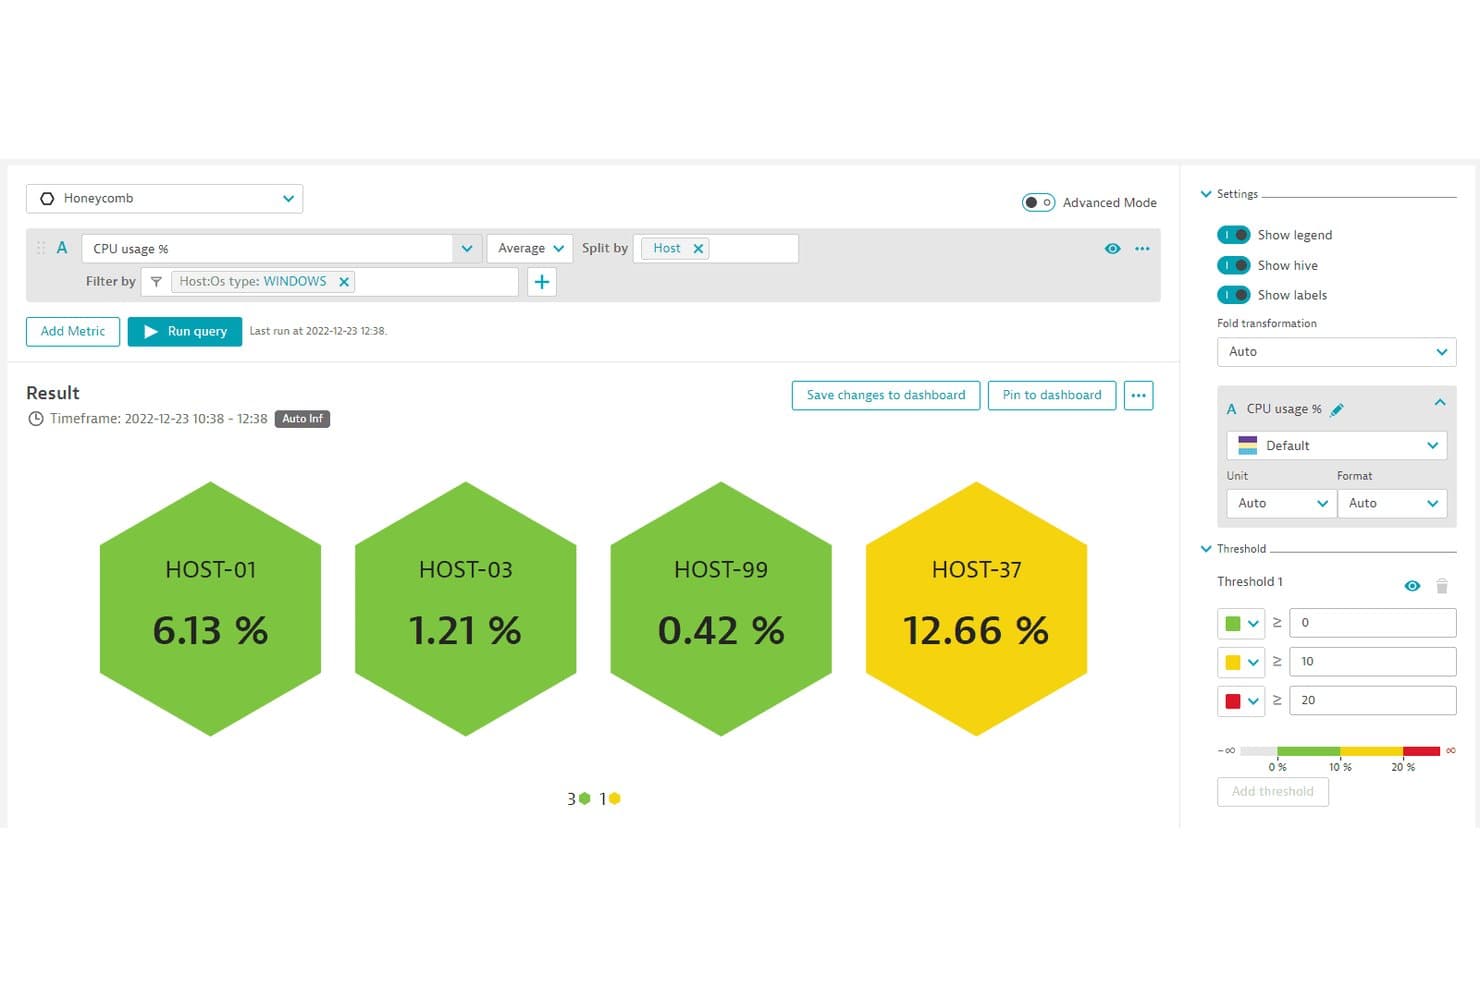
Dynatrace wizualizuje użycie procesora na hostach za pomocą pokolorowanych kafelków w kształcie plastra miodu. Jako alternatywa dla Honeycomb, Dynatrace pomaga zespołom IT i inżynieryjnym łączyć dane dotyczące aplikacji, infrastruktury i doświadczeń użytkowników, aby diagnozować problemy z usługami w złożonych środowiskach.
Komu najlepiej służy Dynatrace?
Dynatrace jest odpowiedni dla zespołów operacji IT i SRE zarządzających złożonymi, rozproszonymi środowiskami, które potrzebują zautomatyzowanego monitorowania aplikacji i infrastruktury.
Dlaczego wybrałem Dynatrace
Uważam Dynatrace za jedną z najlepszych alternatyw dla Honeycomb ze względu na koncentrację na „najlepszych rozwiązaniach do automatycznego monitorowania pełnego stosu opartych na AI”. Davis AI analizuje dane telemetryczne, aby identyfikować prawdopodobne przyczyny źródłowe, podczas gdy OneAgent automatycznie wykrywa usługi i instrumentuje je na hostach oraz w obciążeniach chmurowych. Cenię mapowanie zależności, gdy skok opóźnienia interfejsu API można prześledzić do hosta lub usługi podrzędnej.
Najważniejsze funkcje Dynatrace
- Monitorowanie rzeczywistych użytkowników: Śledzi sesje użytkowników, czas ładowania stron i błędy interfejsu użytkownika.
- Monitorowanie syntetyczne: Uruchamia zaplanowane kontrole przeglądarkowe i HTTP punktów końcowych.
- Monitorowanie dzienników: Gromadzi, przeszukuje i analizuje dzienniki wraz z danymi telemetrycznymi.
- Monitorowanie infrastruktury chmurowej: Śledzi metryki i stan hostów, kontenerów oraz usług chmurowych.
Integracje Dynatrace
Dynatrace Workflows oferuje oficjalnie wspierane konektory do AWS, Microsoft Azure, GitHub, Jira, Slack, PagerDuty, ServiceNow, Microsoft Teams, GitLab i Jenkins za pośrednictwem Dynatrace Hub. Dynatrace udostępnia również interfejs API do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Davis AI łączy anomalie z przyczynami źródłowymi
- OneAgent automatycznie wykrywa usługi i przeprowadza ich instrumentację
- Ujednolicone monitorowanie dzienników, śladów, infrastruktury i użytkowników
Cons:
- Opanowanie składni DQL wymaga czasu
- Zużycie danych telemetrycznych może powodować nieprzewidywalność kosztów
 Najlepszy do ujednoliconych śladów, logów i metryk w jednym widoku
- Dostępny plan bezpłatny
- $15/użytkownika/miesiąc (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.5/5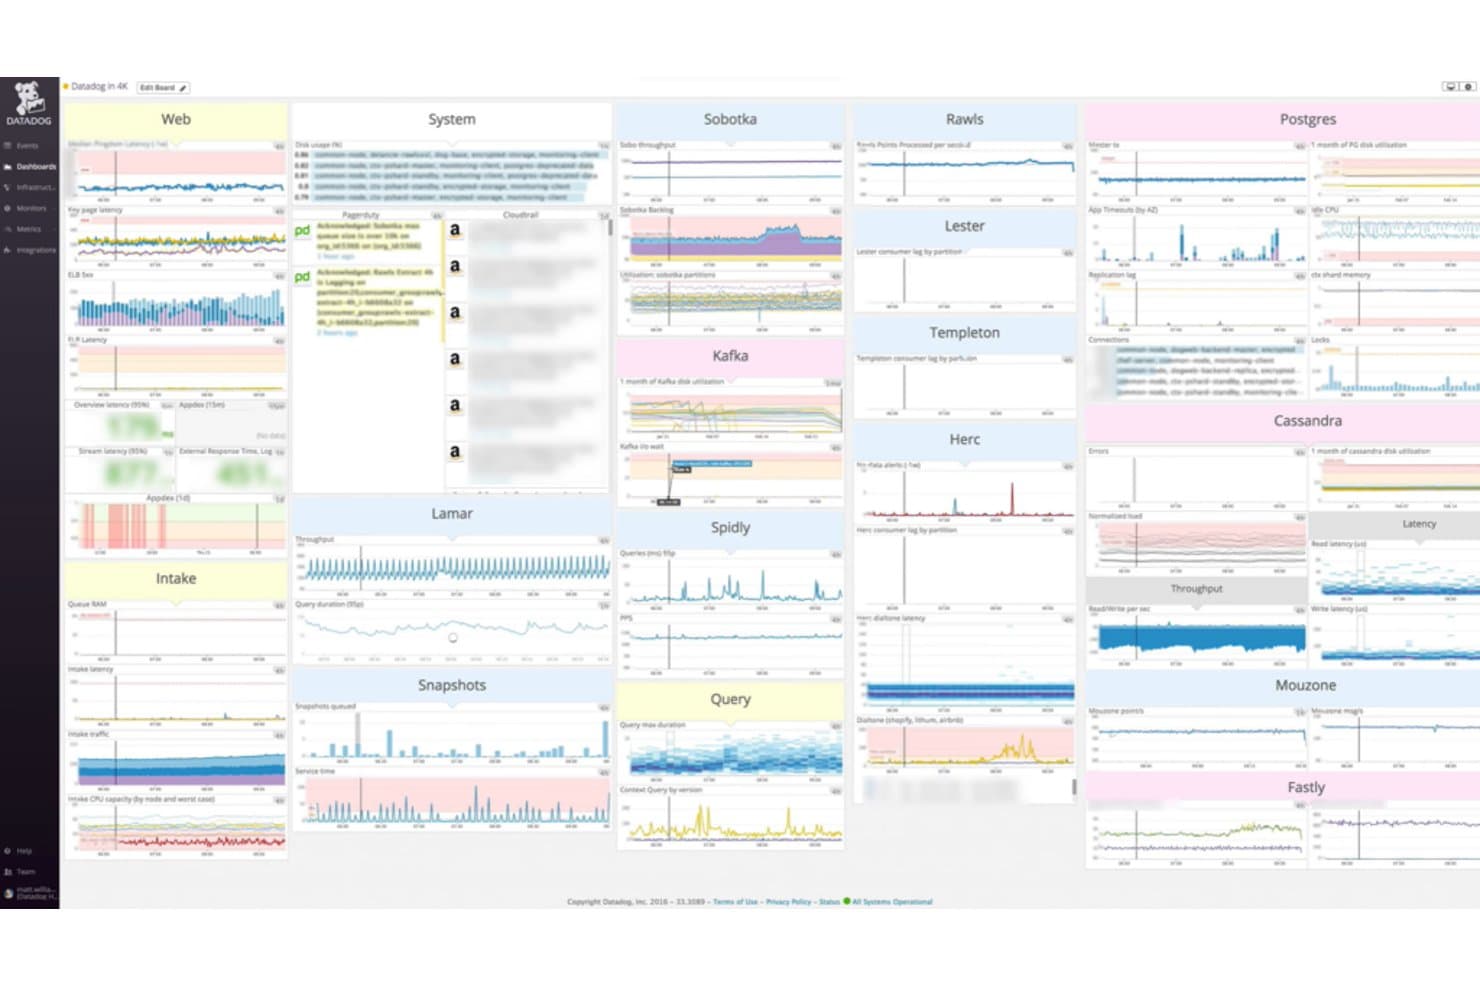
Datadog centralizuje metryki usług internetowych, systemowych i bazodanowych na jednym pulpicie. Datadog to platforma obserwowalności dla zespołów IT i inżynieryjnych, które muszą badać problemy z aplikacjami, śledzić zależności między usługami i monitorować infrastrukturę w złożonych środowiskach.
Dla kogo Datadog jest najlepszym wyborem?
Datadog jest odpowiedni dla zespołów operacji IT, inżynierii platformowej i SRE, które muszą monitorować rozproszoną infrastrukturę i aplikacje.
Dlaczego wybrałem Datadog
Wybrałem Datadog, ponieważ jest najlepszy do ujednoliconego monitorowania serwerów, aplikacji i usług. Jego metryki infrastruktury, ślady APM i mapy usług pomagają mi śledzić powolne żądanie od hosta do zależnych od niego usług, dzięki czemu jest użyteczną alternatywą dla Honeycomb podczas badania incydentów obejmujących wiele warstw.
Najważniejsze funkcje Datadog
- Zarządzanie logami: Wyszukiwanie, filtrowanie i analizowanie logów z aplikacji i infrastruktury.
- Monitoring syntetyczny: Uruchamianie testów przeglądarki i API w celu sprawdzania dostępności oraz czasów odpowiedzi.
- Monitory: Ustawianie warunków, które uruchamiają alerty, gdy monitorowane dane osiągną określony próg.
- Pulpity: Tworzenie wizualnych widoków z wykresami i widżetami dla wybranych danych.
Integracje Datadog
Datadog oferuje ponad 1 000 wbudowanych integracji, w tym z AWS, Azure, Google Cloud, Kubernetes, Docker, Jenkins, Slack, Jira, GitHub i PagerDuty. Udostępnia również API do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Koreluje logi, metryki i ślady podczas analizy problemów
- Mapy usług łączą hosty z zależnymi od nich usługami
- Pulpity łączą sygnały infrastruktury i aplikacji
Cons:
- Dostrajanie alertów może powodować nadmierną liczbę powiadomień
- Obsługa OpenTelemetry może być niespójna
 Najlepszy do skalowalnego monitorowania infrastruktury typu open source
- Dostępny bezpłatny plan
- Ceny na żądanie
Visit WebsiteCustomer Rating:4.4/5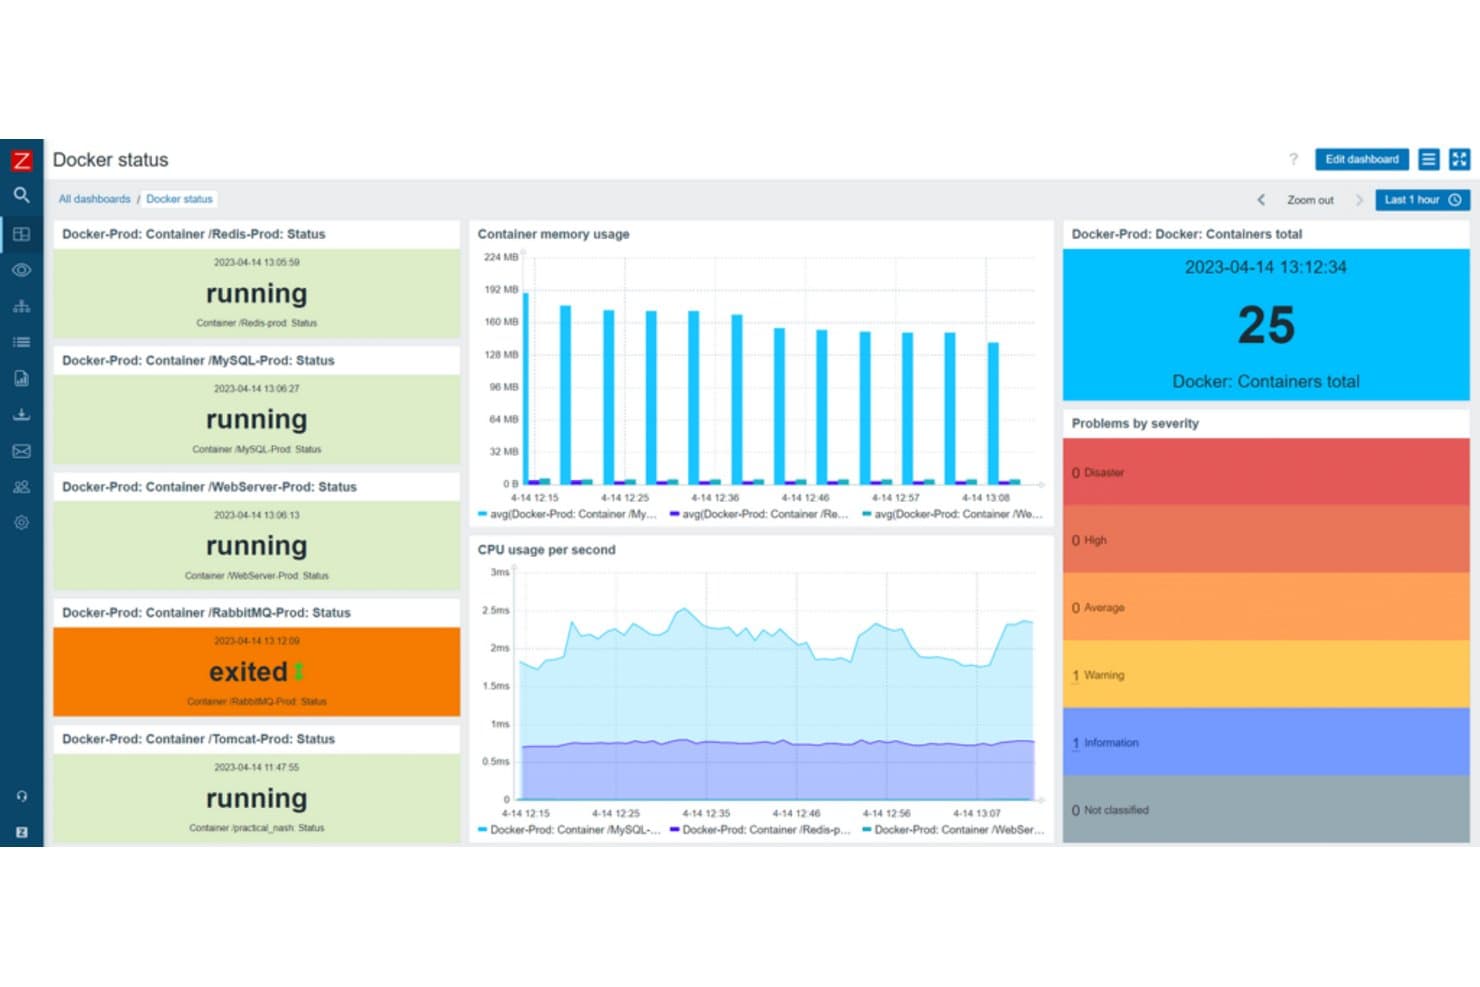
Zabbix monitoruje stan kontenerów Docker i zużycie zasobów w czasie rzeczywistym. Zabbix to platforma monitorowania infrastruktury dla zespołów IT, które muszą śledzić urządzenia sieciowe, serwery, aplikacje i usługi oraz wykrywać awarie lub problemy z wydajnością w złożonych środowiskach.
Dla kogo najlepiej nadaje się Zabbix?
Zabbix jest odpowiedni dla zespołów IT i zespołów zajmujących się infrastrukturą w przedsiębiorstwach, które potrzebują monitorowania typu open source w dużych, połączonych ze sobą sieciach i systemach.
Dlaczego wybrałem Zabbix
Wybrałem Zabbix jako „najlepsze rozwiązanie do monitorowania sieci typu open source na poziomie przedsiębiorstwa”, gdy widoczność infrastruktury jest ważniejsza niż śledzenie rozproszone. Wykrywanie sieci i monitorowanie SNMP pomagają lokalizować przełączniki i routery, a szablony oraz wyzwalacze standaryzują kontrole i ostrzegają o awariach interfejsów lub usług. Dzięki temu Zabbix jest użyteczną alternatywą dla Honeycomb do śledzenia stanu infrastruktury w dużym środowisku.
Najważniejsze funkcje Zabbix
- Monitorowanie stron internetowych: Konfiguruj scenariusze sprawdzające dostępność witryny, czas odpowiedzi i zawartość strony.
- Monitorowanie dzienników: Zbieraj wpisy dzienników i wykrywaj pasujące wzorce lub błędy.
- Monitorowanie usług: Mapuj usługi biznesowe i śledź ich stan w odniesieniu do celów poziomu usług.
- Pulpity: Rozmieszczaj widżety, aby wyświetlać dane monitorowania, problemy i stan usług.
Integracje Zabbix
Katalog integracji Zabbix zawiera 559 marek i 1 986 rozwiązań, w tym AWS, Azure, Kubernetes, PagerDuty, Slack, Microsoft Teams, ServiceNow i Jira. Obsługuje niestandardowe połączenia za pośrednictwem interfejsu API oraz konfigurowalne elementy webhook; pozycje w katalogu nie muszą oznaczać natywnych integracji.
Pros and Cons
Pros:
- Automatyczne wykrywanie znajduje urządzenia sieciowe SNMP
- Szablony standaryzują kontrole stanu infrastruktury
- Serwery proxy rozszerzają monitorowanie na zdalne lokalizacje
Cons:
- Brak natywnego procesu debugowania śladów rozproszonych
- Złożona konfiguracja i dostrajanie alertów wymagają specjalistycznej wiedzy
 Najlepszy wybór do kompleksowego śledzenia transakcji biznesowych
- 30-dniowy bezpłatny okres próbny
- $3300 za jednostkę rocznie (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.3/5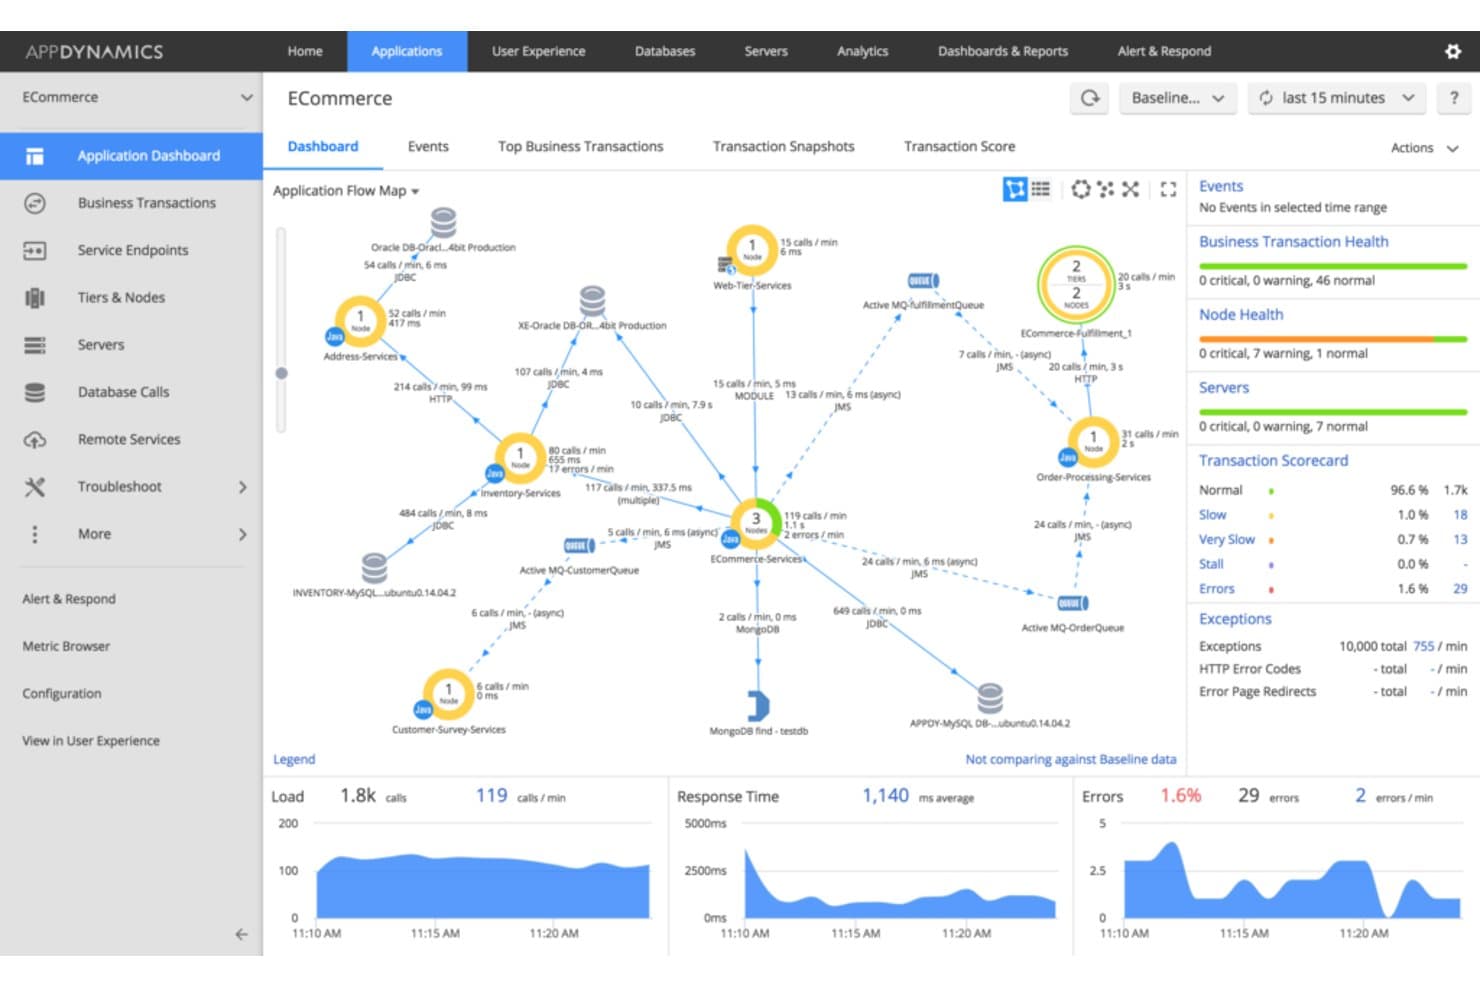
AppDynamics wizualizuje zależności między usługami aplikacji i ich wydajność w czasie rzeczywistym. AppDynamics to platforma obserwowalności dla zespołów IT i zespołów ds. aplikacji zarządzających złożonymi systemami, pomagająca precyzyjnie lokalizować problemy z wydajnością oraz łączyć problemy infrastruktury z niezawodnością aplikacji i doświadczeniem użytkowników.
Dla kogo AppDynamics jest najlepszym wyborem?
AppDynamics sprawdza się w zespołach zajmujących się wydajnością aplikacji i operacjami, zarządzających rozproszonymi aplikacjami wielowarstwowymi w złożonych środowiskach.
Dlaczego wybrałem AppDynamics
Wybrałem AppDynamics do śledzenia kompleksowych transakcji biznesowych w złożonych środowiskach. Mapy przepływu transakcji pokazują, jak żądania przemieszczają się między warstwami aplikacji, a migawki transakcji rejestrują szczegóły na poziomie kodu, gdy żądanie zwalnia lub kończy się niepowodzeniem. Korzystam z tego widoku, aby prześledzić opóźnienie podczas realizacji zakupu od usługi widocznej dla użytkownika do warstwy backendu, która je powoduje.
Najważniejsze funkcje AppDynamics
- Monitorowanie infrastruktury: Koreluje metryki infrastruktury z usługami aplikacji i metrykami biznesowymi.
- Monitorowanie doświadczeń cyfrowych: Śledzi użytkowników stron internetowych i aplikacji mobilnych oraz uruchamia testy syntetyczne w przeglądarkach, interfejsach API i usługach zewnętrznych.
- Bezpieczeństwo aplikacji w czasie działania: Wykrywa luki w zabezpieczeniach i blokuje ataki.
- Monitorowanie SAP: Monitoruje hybrydowe i lokalne systemy SAP, zapewniając śledzenie do kodu ABAP lub zapytań do bazy danych.
Integracje AppDynamics
AppDynamics obsługuje integracje alertów z PagerDuty, Slackiem, ServiceNow za pośrednictwem Service Graph Connector, Jirą, BigPandą, Moogsoftem i Splunk ITSI; integracja z PagerDuty została utworzona przez dostawcę, natomiast integracja ze Slackiem przez społeczność. AppDynamics udostępnia również interfejsy API REST i gotowe rozszerzenia do niestandardowych integracji.
Pros and Cons
Pros:
- Mapuje transakcje biznesowe między warstwami aplikacji
- Migawki ujawniają wolne metody i wiersze kodu
- Łączy kondycję transakcji z wynikami biznesowymi
Cons:
- Nakład pracy związany z konfiguracją rośnie wraz z niestandardowymi hierarchiami aplikacji
- Niestandardowe zapytania wymagają nauczenia się języka zapytań AppDynamics
Learn more about AppDynamics: Najlepsze rozwiązanie do uzyskiwania informacji na temat wydajności aplikacji i monitorowania doświadczeń użytkowników końcowych
- Bezpłatny plan + bezpłatne demo
- $99/miesiąc za plan Pro (rozliczany rocznie)
Visit WebsiteCustomer Rating:4.3/5
Panel przeglądu zapytań SQL w New Relic. New Relic specjalizuje się w dostarczaniu szczegółowych informacji na temat wydajności aplikacji oraz monitorowaniu doświadczeń użytkowników. To narzędzie doskonale pomaga zespołom szczegółowo i z dużą granularnością rozumieć interakcje użytkowników oraz działanie aplikacji.
Pros and Cons
Pros:
- Szczegółowe monitorowanie wydajności aplikacji i śledzenie doświadczeń użytkowników
- Szeroki zakres integracji z głównymi dostawcami chmury i platformami
- Możliwości AIOps umożliwiające predykcyjne alerty i reagowanie na incydenty
Cons:
- Wyższa cena w porównaniu z niektórymi konkurencyjnymi rozwiązaniami
- Konfiguracja i wdrożenie mogą być skomplikowane
- Ogromna liczba funkcji może być przytłaczająca dla nowych użytkowników
Learn more about New Relic: Najlepsze rozwiązanie do zarządzania logami i analityki w środowiskach opartych na chmurze
- 14-dniowy bezpłatny okres próbny
- Ceny dostępne na żądanie
Visit WebsiteCustomer Rating:4.3/5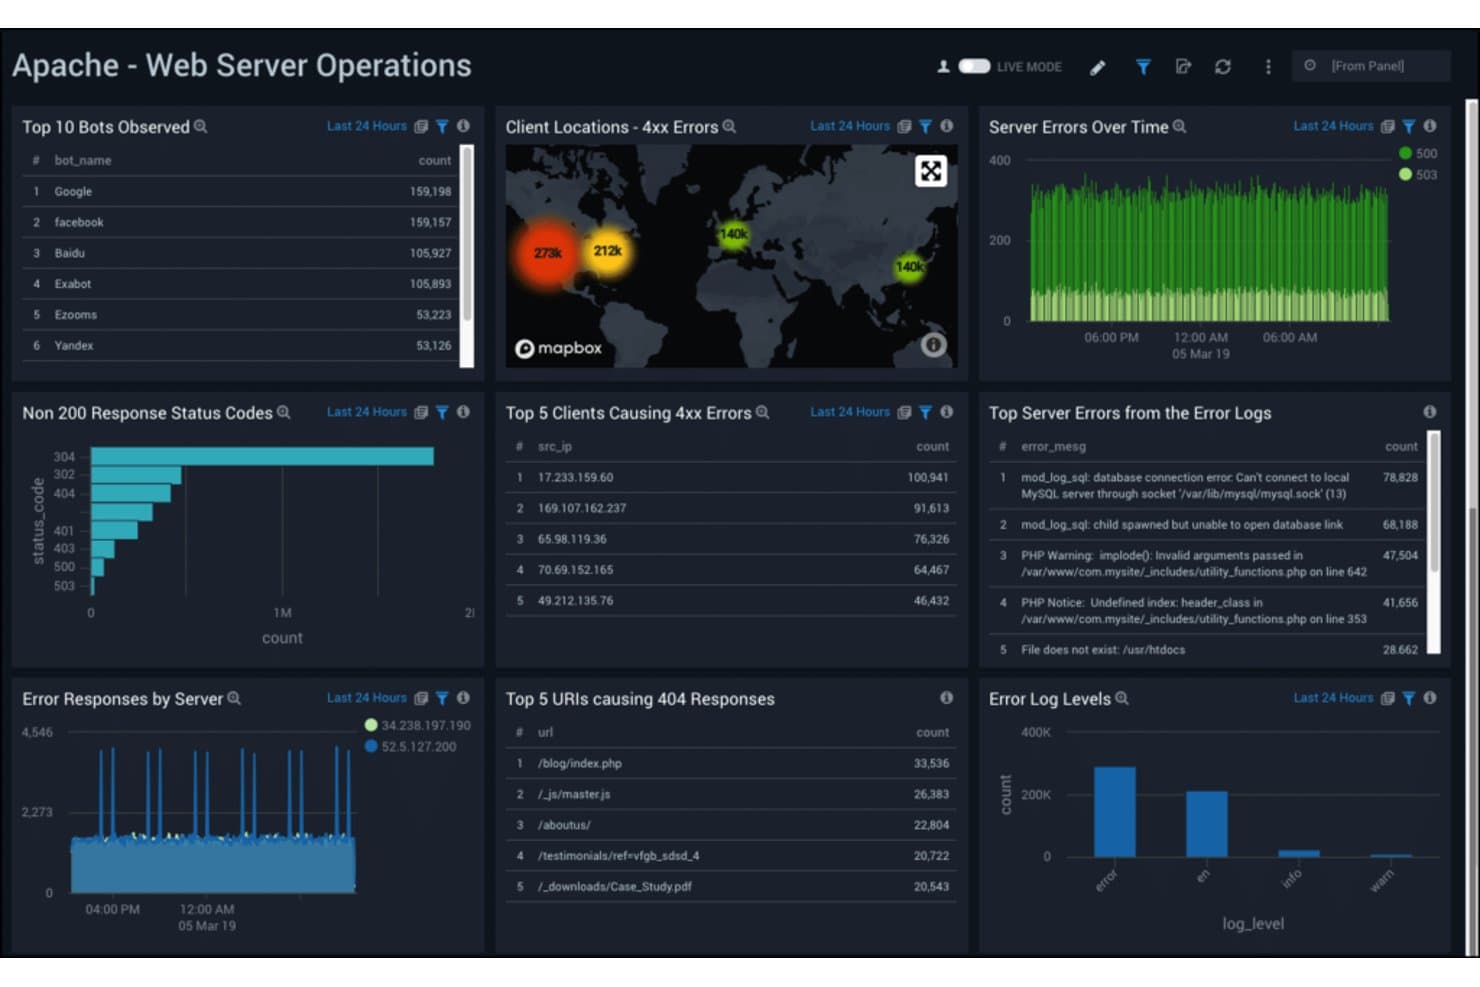
Sumo Logic monitoruje w czasie rzeczywistym błędy serwera WWW Apache i aktywność botów. Sumo Logic zapewnia zespołom IT i DevOps platformę obserwowalności do badania awarii, łączenia problemów w rozproszonych usługach oraz uzyskiwania wglądu w złożone środowiska chmurowe.
Dla kogo Sumo Logic jest najlepszym wyborem?
Zespoły infrastruktury i bezpieczeństwa w organizacjach opartych na chmurze mogą używać Sumo Logic do analizowania logów w rozproszonych usługach.
Dlaczego wybrałem Sumo Logic
Wybrałem Sumo Logic jako alternatywę dla Honeycomb, ponieważ jest to najlepsze rozwiązanie do zarządzania logami i analityki w środowiskach opartych na chmurze. LogReduce grupuje podobne komunikaty logów, pomagając mi wykrywać powtarzające się błędy, a język zapytań umożliwia mi badanie incydentów w rozproszonych usługach.
Najważniejsze funkcje Sumo Logic
- Analityka metryk: Pozyskiwanie metryk szeregów czasowych i wykonywanie dotyczących ich zapytań wraz z telemetrią operacyjną.
- Śledzenie rozproszone: Śledzenie żądań w usługach w celu analizowania zakresów i szczegółów śledzenia.
- Pulpity nawigacyjne: Tworzenie wizualnych pulpitów nawigacyjnych z wykresami i panelami zawierającymi dane operacyjne.
- Monitory i alerty: Ustawianie warunków dotyczących metryk lub wyników zapytań w celu wyzwalania powiadomień.
Integracje Sumo Logic
Katalog Sumo Logic obejmuje setki dostawców i produktów, a także aplikacje, kolektory, treści Cloud SIEM oraz integracje automatyzacji z narzędziami takimi jak AWS, Azure, Kubernetes, Datadog, GitHub, GitLab i Atlassian Jira. Udostępnia również interfejsy API do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- LogReduce szybko grupuje podobne błędy
- Wyszukiwanie analizuje dane JSON i wyrażenia regularne
- Logi, metryki i ślady są uwzględniane we wspólnych analizach
Cons:
- Składnia zapytań Sumo wymaga wprawy
- Wyszukiwanie danych historycznych może działać wolniej przy dużej skali
 Najlepsze do monitorowania logów i alertowania na podstawie ich wolumenu
- 30-dniowy bezpłatny okres próbny
- Ceny na zapytanie
Visit WebsiteCustomer Rating:4.4/5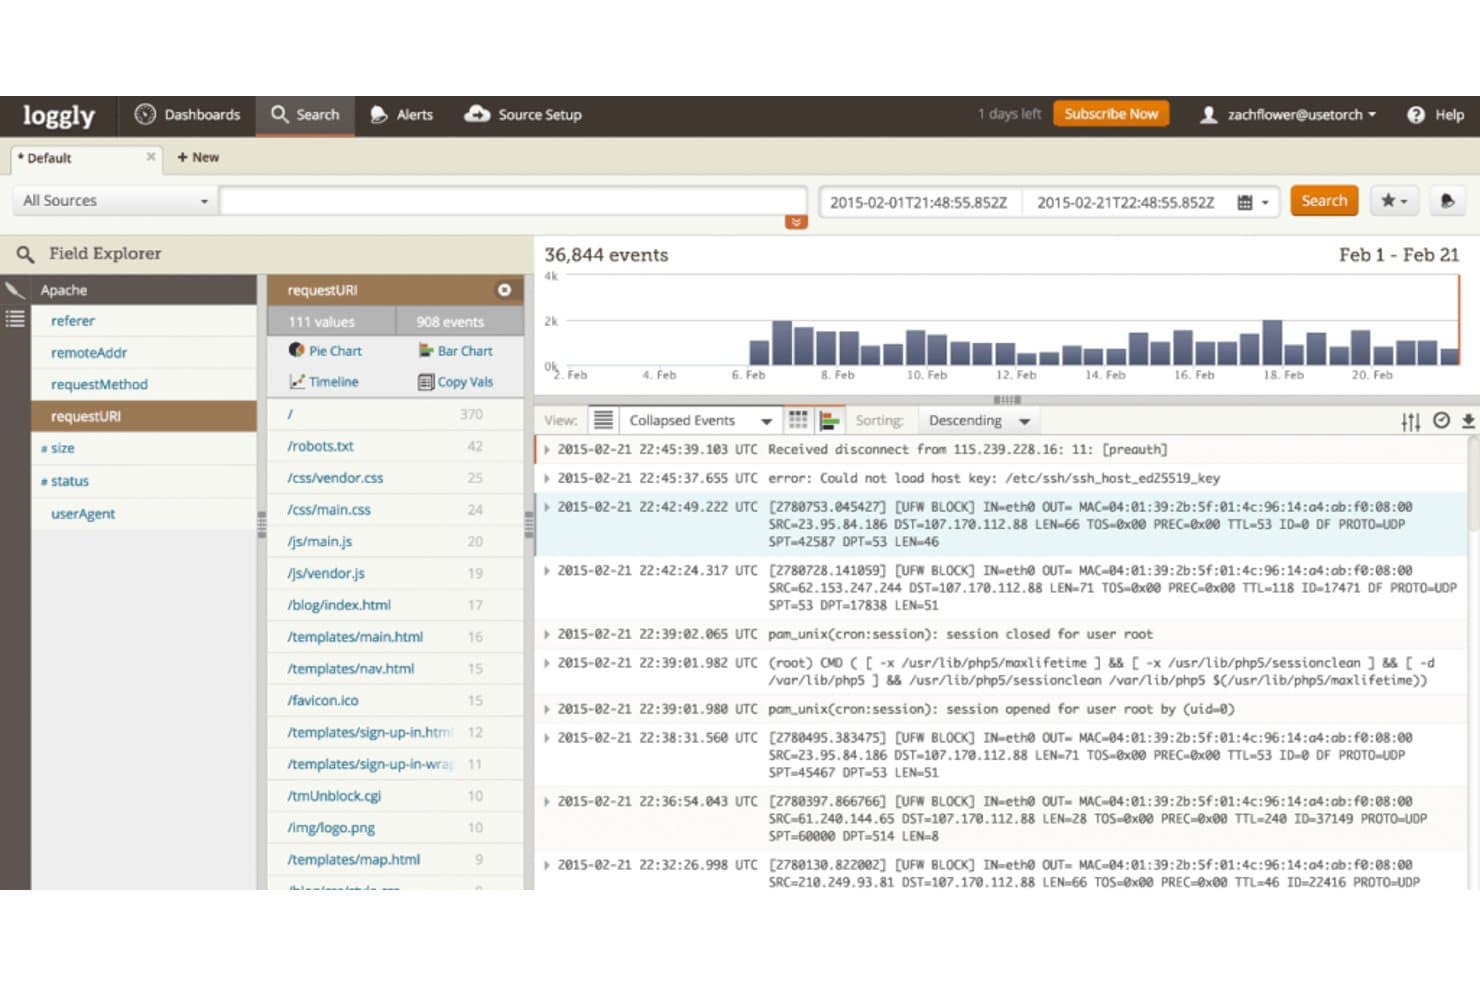
Loggly centralizuje zdarzenia z logów, umożliwiając wyszukiwanie i analizę w czasie rzeczywistym. Loggly to oparta na chmurze platforma do zarządzania logami dla zespołów IT i DevOps, które muszą badać problemy z aplikacjami i infrastrukturą, śledzić zdarzenia w różnych usługach oraz diagnozować zakłócenia w działaniu usług.
Dla kogo Loggly jest najlepszym rozwiązaniem?
Loggly odpowiada potrzebom zespołów IT i DevOps, które muszą wyszukiwać i wizualizować dane z logów w coraz większych środowiskach opartych na chmurze.
Dlaczego wybrałem Loggly
Wybrałem Loggly jako alternatywę dla Honeycomb, ponieważ najlepiej sprawdza się w skalowalnym zarządzaniu logami w chmurze i interaktywnej wizualizacji danych. Jego wykresy i pulpity pomagają mi dostrzegać trendy w logach aplikacji i infrastruktury. Cenię również jego narzędzia do rozwiązywania problemów, które pomagają śledzić przyczyny źródłowe w połączonych ze sobą usługach.
Najważniejsze funkcje Loggly
- Podgląd na żywo: Przesyłaj przychodzące zdarzenia z logów z wielu źródeł niemal w czasie rzeczywistym.
- Alerty oparte na wyszukiwaniu: Ustawiaj warunki dla wyszukiwań i wysyłaj powiadomienia na e-mail lub do obsługiwanych punktów końcowych.
- Integracje z narzędziami zespołowymi: Połącz Loggly ze Slackiem, GitHubem, Jirą, PagerDuty, Microsoft Teams i webhookami.
- Obsługa źródeł logów: Zbieraj logi ze źródeł takich jak AWS, syslog, PHP, urządzenia sieciowe i systemy Windows.
Integracje Loggly
Loggly wymienia integracje ze Slackiem, GitHubem, Jirą, PagerDuty i Microsoft Teams, a dostarczanie alertów jest również dostępne za pośrednictwem niestandardowych webhooków. Platforma udostępnia interfejs API do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Scentralizowane wyszukiwanie logów i pulpity obejmujące różne usługi
- Podgląd na żywo przesyła zdarzenia z wielu źródeł
- Interaktywne wykresy pokazują trendy w logach
Cons:
- Wdrożenie wyłącznie w modelu SaaS nie spełnia wymagań dotyczących środowisk lokalnych
- Opóźnienia w propagacji logów mogą utrudniać ustalanie przyczyn incydentów
Learn more about Loggly: Najlepszy do uzyskiwania wiedzy operacyjnej opartej na danych maszynowych
- Bezpłatny 60-dniowy okres próbny
- $150/miesiąc (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.3/5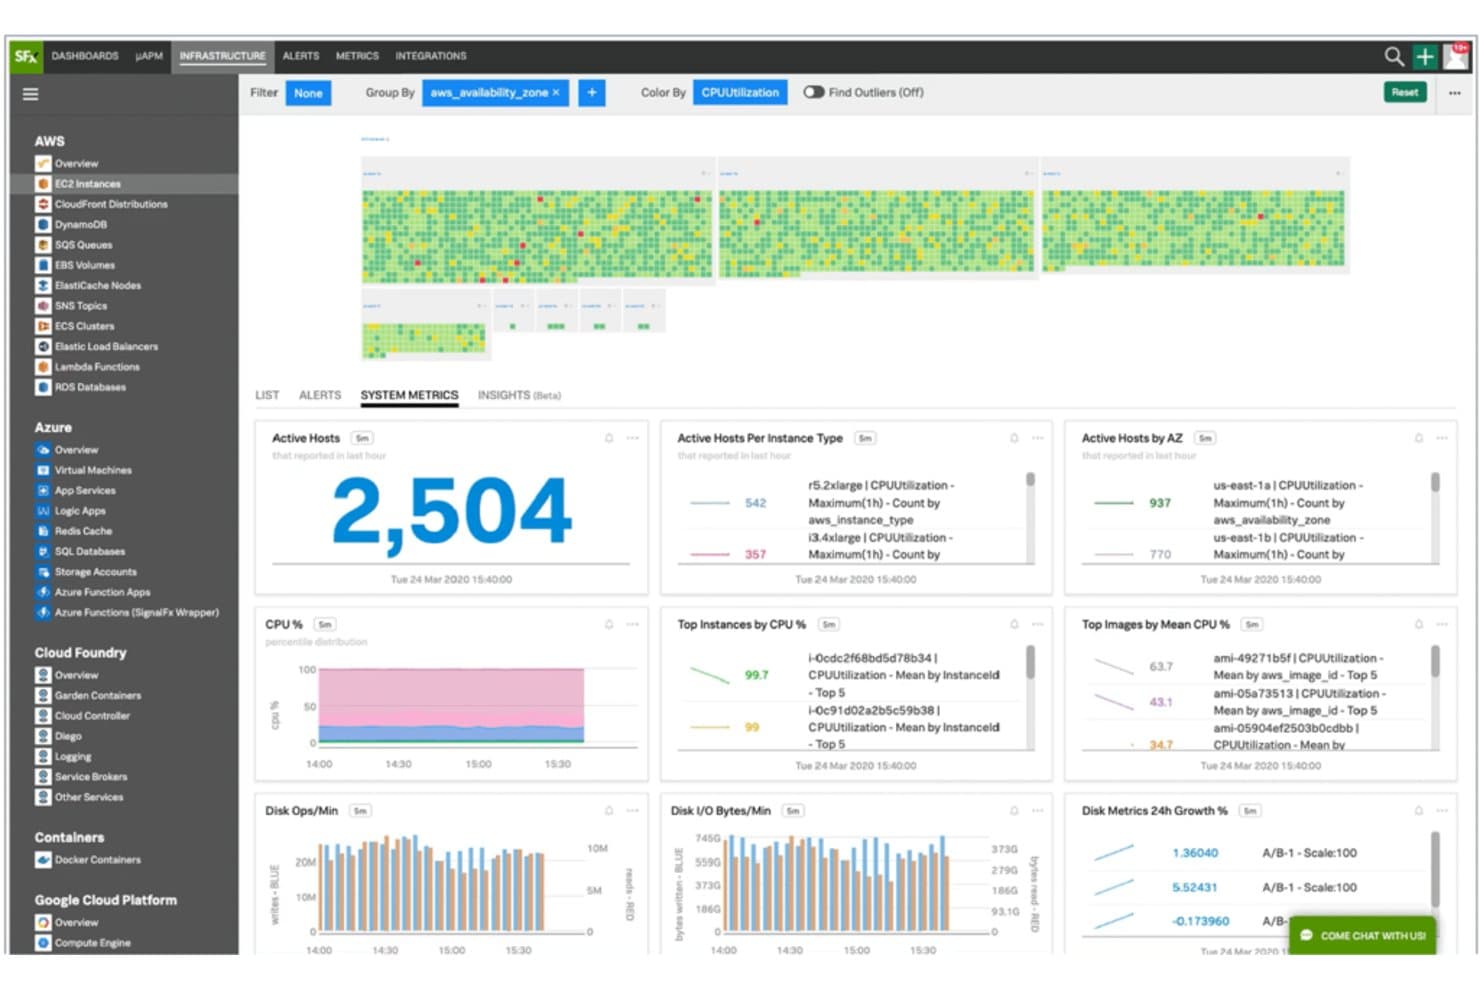
Splunk monitoruje w czasie rzeczywistym metryki AWS, Azure i infrastruktury chmurowej. Splunk to platforma obserwowalności dla zespołów IT i bezpieczeństwa, które muszą badać dane maszynowe w złożonych środowiskach, identyfikować problemy z usługami i rozwiązywać incydenty.
Dla kogo Splunk jest najlepszym wyborem?
Zespoły ds. operacji IT nadzorujące rozproszoną infrastrukturę mogą używać Splunk do przekształcania danych maszynowych w praktyczną wiedzę operacyjną.
Dlaczego wybrałem Splunk
Wybrałem Splunk jako alternatywę dla Honeycomb w kategorii „Najlepszy do wykorzystywania danych maszynowych w celu uzyskania pogłębionej wiedzy operacyjnej”. Używam wyszukiwań SPL do badania logów w rozproszonych usługach, a następnie łączę ustalenia na pulpitach nawigacyjnych, aby śledzić problemy, takie jak wzrost liczby błędów po wdrożeniu. Szerszy wgląd w dane maszynowe pomaga mi analizować problemy operacyjne wraz z powiązanymi zdarzeniami dotyczącymi infrastruktury i bezpieczeństwa.
Kluczowe funkcje Splunk
- Śledzenie rozproszone: Śledź żądania w różnych usługach za pomocą odcinków śledzenia i map usług.
- Monitorowanie infrastruktury: Śledź metryki z hostów, kontenerów i środowisk Kubernetes.
- Monitorowanie rzeczywistych użytkowników: Rejestruj wydajność przeglądarki i interakcje użytkowników.
- Monitorowanie syntetyczne: Uruchamiaj skrypty testów w celu sprawdzania dostępności usług i czasów odpowiedzi.
Integracje Splunk
Splunk Observability Cloud oferuje setki gotowych integracji, w tym AWS, Microsoft Azure, Google Cloud, Kubernetes, Prometheus, Jira, Microsoft Teams, PagerDuty, ServiceNow i Slack. Splunkbase oferuje ponad 1 000 aplikacji i dodatków z marketplace'u, a Splunk udostępnia interfejsy API do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Koreluje logi, metryki i ślady
- Analizuje ślady bez próbkowania
- Niestandardowe pulpity nawigacyjne przyspieszają rozwiązywanie problemów
Cons:
- Złożone zapytania mogą działać powoli
- Koszty rosną wraz ze zwiększaniem ilości danych
Learn more about Splunk: Najlepszy do natywnych dla Kubernetes metryk i alertów
- Dostępny bezpłatny plan
- Wycena na życzenie
Visit WebsiteCustomer Rating:4.4/5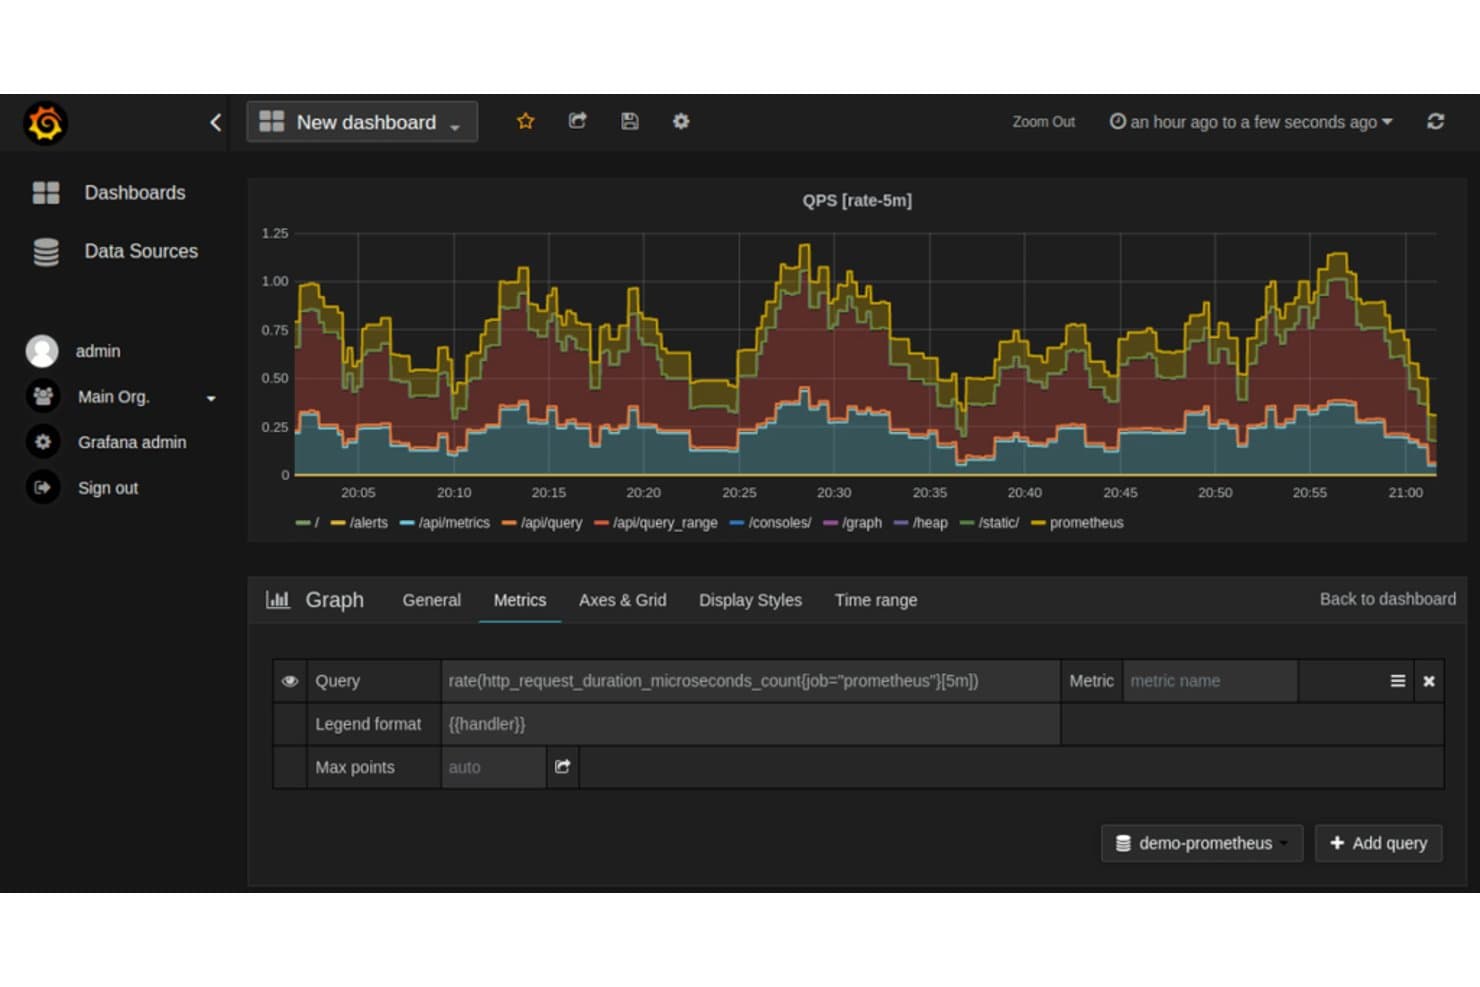
Prometheus wizualizuje w Grafanie wskaźniki żądań HTTP dla punktów końcowych API. Prometheus to platforma monitorowania oparta na otwartym kodzie źródłowym, przeznaczona dla zespołów zajmujących się infrastrukturą i aplikacjami, które muszą śledzić kondycję systemów, badać problemy z wydajnością i zapewniać obserwowalność swoich usług.
Dla kogo najlepiej nadaje się Prometheus?
Prometheus sprawdza się w przypadku zespołów DevOps i zespołów odpowiedzialnych za niezawodność witryn, które muszą zbierać metryki i konfigurować alerty dla obciążeń Kubernetes.
Dlaczego wybrałem Prometheus
Wybrałem Prometheus do zbierania metryk i obsługi alertów, szczególnie w środowisku Kubernetes. Funkcja wykrywania usług może śledzić zmieniające się obciążenia, a PromQL pomaga mi analizować wzorce metryk i definiować warunki alertów. Korzystam z Alertmanagera, aby kierować te alerty, gdy kondycja usługi się pogarsza.
Najważniejsze funkcje Prometheus
- Baza danych szeregów czasowych: Przechowuje oznaczone czasem próbki w lokalnej bazie danych.
- Wielowymiarowy model danych: Organizuje szeregi czasowe za pomocą nazw metryk oraz etykiet w postaci klucz-wartość.
- Ekosystem eksporterów: Eksportery udostępniają metryki z systemów takich jak bazy danych i sprzęt.
- Federacja: Pobiera wybrane metryki z innych serwerów Prometheus w celu agregacji.
Integracje Prometheus
Prometheus obejmuje wykrywanie usług Kubernetes i obsługuje integracje oparte na eksporterach z Kafka, MySQL, PostgreSQL, Redis, Jenkins i AWS CloudWatch. Połączenia zdalnego odczytu i zapisu obejmują Grafana Mimir, Thanos, Google Cloud i New Relic, a jego interfejs API HTTP obsługuje niestandardowe integracje.
Pros and Cons
Pros:
- PromQL obsługuje badanie metryk na podstawie etykiet
- Wykrywanie usług Kubernetes śledzi zmieniające się obciążenia
- Alertmanager kieruje alerty dotyczące metryk na podstawie etykiet
Cons:
- Etykiety o wysokiej kardynalności mogą przeciążać pamięć lokalną
- Pamięć lokalna ogranicza okres przechowywania danych i skalowanie poziome
Learn more about Prometheus:
Inne alternatywy dla Honeycomb
Oto kilka dodatkowych alternatyw dla Honeycomb, które nie trafiły na moją listę, ale nadal warto je sprawdzić:
- 11Grafana CloudNajlepsze rozwiązanie do interaktywnej wizualizacji umożliwiającej podejmowanie decyzji opartych na danych
- 12Grafana CloudNajlepsze rozwiązanie do interaktywnej wizualizacji umożliwiającej podejmowanie decyzji opartych na danych
- 13Elastic (ELK Stack)Najlepszy do analizy dzienników, wyszukiwania i zaawansowanych możliwości korelowania danych
- 14WrikeNajlepsze do zarządzania projektami w zespołach programistycznych
Recenzje innych programów
- Narzędzia do tworzenia oprogramowania
- Narzędzia do infrastruktury jako kodu
- Narzędzia DataOps
- Narzędzia do monitorowania baz danych
Jak oceniam alternatywy dla Honeycomb
Przyglądam się każdemu kandydatowi na dwóch poziomach: podstawowym wymaganiom — rozproszonemu śledzeniu, zapytaniom o wysokiej kardynalności i obsłudze OTel — oraz wyróżnikom, które odróżniają narzędzia od siebie, gdy inżynierowie SRE analizują bieżące incydenty produkcyjne.
Podstawowe funkcje (wymagane na tej liście)
Wybierając narzędzia do mojej listy, oceniam każde z nich w skali od 0 (nie oferuje danej funkcji) do 5 (doskonale radzi sobie w tym obszarze) dla każdej z wymienionych poniżej podstawowych funkcji. Następnie przeliczam łączny wynik narzędzia na wartość procentową. Każde narzędzie musi osiągnąć minimalny łączny wynik wynoszący 65%, aby zostać uwzględnione na liście.
- Rozproszone śledzenie: Oceniam, jak dobrze każde narzędzie wizualizuje przebieg śladów między usługami, ponieważ debugowanie powolnego procesu realizacji zamówienia obejmującego 15 mikrousług wymaga szczegółowych danych o zakresach.
- Zapytania o wysokiej kardynalności: Filtrowanie danych telemetrycznych według identyfikatora użytkownika lub instancji kontenera na dużą skalę ma znaczenie, dlatego sprawdzam, czy wydajność zapytań utrzymuje się na odpowiednim poziomie przy milionach unikalnych wartości.
- Ujednolicona obsługa danych telemetrycznych: Szukam narzędzi, które korelują logi, metryki i ślady w jednym widoku — przejście od skoku opóźnienia do odpowiadającego mu logu błędu powinno wymagać jednego kliknięcia.
- Kompatybilność z OpenTelemetry: W tym obszarze oceniam natywne przyjmowanie danych OTel dotyczących śladów, metryk i logów, ponieważ zespoły nie powinny potrzebować zastrzeżonych agentów, aby przesyłać dane.
- Alertowanie w czasie rzeczywistym i SLO: Dobra obserwowalność obejmuje alerty dotyczące wskaźnika wypalania SLO i budżety błędów, dlatego sprawdzam, czy każde narzędzie obsługuje coś więcej niż podstawowe powiadomienia o statycznych progach.
- Interaktywne procesy debugowania: Szukam interfejsów do eksploracyjnego tworzenia zapytań — takich jak wykrywanie wartości odstających lub zestawienia grup według określonych wymiarów — które pomagają inżynierom diagnozować nieznane problemy podczas incydentu.
Gdy mam już listę narzędzi spełniających te kryteria, analizuję to, co wyróżnia każdą platformę.
Czynniki różnicujące (co wyróżnia dostawców)
Oto jak porównuję różnych dostawców i wskazuję różnice między nimi:
Wyróżniające się funkcje
Narzędzia do analizy wspomaganej przez AI mogą skrócić incydent o wiele godzin, automatycznie wskazując prawdopodobną przyczynę źródłową, zanim inżynier w ogóle utworzy zapytanie. Oceniam również, czy platforma oferuje ciągłe profilowanie — powiązanie miejsc największego wykorzystania procesora lub pamięci bezpośrednio ze śladem pomaga wskazać wąskie gardła na poziomie kodu, których same dane o zakresach mogą nie ujawnić. Współpraca przy tworzeniu zapytań również ma znaczenie, szczególnie w zespołach przeprowadzających analizy po incydentach bez szukania winnych. Współdzielone ścieżki analizy i tablice z adnotacjami pozwalają inżynierowi pełniącemu dyżur przekazać kontekst kolejnej zmianie bez utraty jakichkolwiek informacji.
Nie tylko funkcje
Model cenowy to jedna z pierwszych rzeczy, które sprawdzam. Platforma rozliczana za hosta zachowuje się zupełnie inaczej przy dużej skali niż platforma rozliczana za każdy pozyskany GB, a skok ruchu podczas premiery produktu nie powinien zrujnować budżetu na obserwowalność. Oceniam również, jak szybko zespół może uzyskać wartość — narzędzia z rozbudowaną automatyczną instrumentacją i przejrzystymi przewodnikami migracji do OTel znacząco skracają czas wdrożenia. Integracje z ekosystemem dopełniają obrazu. Połączenie z PagerDuty, Slackiem i potokiem CI/CD oznacza, że alerty automatycznie trafiają do właściwych osób, a znaczniki wdrożeń pojawiają się na pulpitach nawigacyjnych.
Dlaczego szukać alternatywy dla Honeycomb?
Honeycomb to zaawansowane narzędzie do obserwowalności zaprojektowane dla inżynierów oprogramowania, które pomaga rozumieć, debugować i ulepszać oprogramowanie produkcyjne. Doskonale zapewnia wgląd na poziomie systemu, ułatwiając odkrywanie wzorców i anomalii, a tym samym optymalizację wydajności.
Pomimo rozbudowanych funkcji użytkownicy mogą szukać alternatyw z różnych powodów. Mogą one obejmować ograniczenia budżetowe, ponieważ ceny Honeycomb mogą przekraczać możliwości niektórych mniejszych zespołów, a także konkretne wymagania dotyczące funkcji, których Honeycomb nie obsługuje, takie jak tradycyjne oprogramowanie do zarządzania logami lub pogłębione monitorowanie wydajności aplikacji.
Na koniec niektórzy użytkownicy mogą po prostu preferować rozwiązanie typu open source lub takie, które ma inny interfejs użytkownika. Poszukiwanie idealnej alternatywy dla Honeycomb polega na znalezieniu narzędzia, które zapewnia równowagę między kompleksową funkcjonalnością a płynną obsługą, jednocześnie odpowiadając unikalnym potrzebom i zasobom organizacji.
Najważniejsze funkcje Honeycomb
Oto niektóre z najważniejszych funkcji Honeycomb, które pomogą porównać ofertę alternatywnych rozwiązań:
- Telemetria oparta na zdarzeniach: Przechwytuje szczegółowe dane o zdarzeniach, dzięki czemu zespół może dokładnie sprawdzić, co wydarzyło się w systemach w dowolnym momencie.
- Kreator zapytań: Umożliwia zadawanie złożonych pytań dotyczących danych bez konieczności pisania kodu.
- BubbleUp: Automatycznie wyróżnia wartości odstające w danych, dzięki czemu można szybciej wykrywać problemy.
- Obsługa śledzenia: Łączy ślady z dziennikami i metrykami, dzięki czemu można zrozumieć, jak pojedyncze żądanie przechodzi przez stos technologiczny.
- Tablice i widoki: Pomaga zapisywać, porządkować i udostępniać kluczowe zapytania lub wizualizacje, z których zespół często korzysta.
- Mapa usług: Pokazuje, jak usługi współdziałają, co pomaga zrozumieć zależności i kondycję systemu.
- Śledzenie SLO: Umożliwia definiowanie i monitorowanie celów poziomu usług, aby kontrolować realizację założeń dotyczących wydajności.
- Narzędzia do współpracy zespołowej: Umożliwiają komentowanie zapytań, udostępnianie linków i wspólną analizę problemów.
- Szybki silnik zapytań: Szybko przetwarza duże zbiory danych, co pomaga podczas debugowania problemów występujących na żywo.
- Integracje z narzędziami takimi jak OpenTelemetry: Ułatwiają pobieranie danych z istniejącej konfiguracji.