

Honeycomb is een tool die is ontworpen om inzicht te bieden in de interne werking van je systeem, zodat je de prestaties kunt optimaliseren en problemen kunt oplossen.
De voordelen zijn talrijk: je kunt afzonderlijke gebeurtenissen traceren, waardoor complexe systemen observeerbaar worden en je je software kunt begrijpen, ervan kunt leren en fouten kunt opsporen.
Toch kunnen er situaties zijn waarin je een alternatief voor Honeycomb wilt. Misschien gebruik je een specifieke programmeertaal zoals PHP of heb je een tool nodig die SOC-compliance biedt. Misschien wil je toegang tot de broncode of ben je op zoek naar een andere reeks functies.
Wat je redenen ook zijn, ik heb een lijst samengesteld met de beste Honeycomb-alternatieven, inclusief productinformatie en sterbeoordelingen, om je te helpen de beste oplossing voor jouw specifieke behoeften te vinden. Laten we deze opties samen bekijken.
Wat is Honeycomb?
Honeycomb is een platform voor observeerbaarheid waarmee je softwaresystemen in realtime kunt debuggen, monitoren en begrijpen. Het wordt gebruikt door software-engineers, DevOps-teams en engineers voor sitebetrouwbaarheid die prestatieproblemen en ongewoon gedrag in productie snel moeten identificeren. Inzichten op gebeurtenisniveau, query's en warmtekaarten helpen bij het onderzoeken van systeemgedrag, het opsporen van knelpunten en het verbeteren van de betrouwbaarheid van apps. Over het algemeen geeft Honeycomb je team een duidelijker beeld van wat er in je code gebeurt, zodat je problemen sneller kunt oplossen.
Waarom u onze softwareaanbevelingen kunt vertrouwen
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Ons team test en beoordeelt software sinds 2012. Als technologieleiders weten we zelf hoe moeilijk — en belangrijk — het is om de juiste software te kiezen.
Voor deze gids hebben we tools geëvalueerd met behulp van praktijktests en onafhankelijk onderzoek, waarbij we tools beoordeeden aan de hand van onze selectiecriteria.
Onze reviews weerspiegelen ons menselijke redactionele oordeel, geen verkooppraatje.
Deskundige beoordelaars:
- Paulo Gardini MiguelTechnisch directeur
 Tim FisherVP AI
 Gabriel RosasTech Lead & software-architect
 Christhian GruhnTech Lead & platformarchitect

Vergelijkingstabel van Honeycomb-alternatieven
In deze vergelijkingstabel staan de prijsgegevens van mijn beste keuzes als Honeycomb-alternatief:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Beste voor gedistribueerde tracering met veel context | Gratis abonnement beschikbaar | Vanaf $26/maand (jaarlijks gefactureerd) | Website | |
| 2 | Het beste voor AI-aangedreven geautomatiseerde monitoring van de volledige stack | 15 dagen gratis proefperiode | $21/user/month voor hun plan voor monitoring van de volledige stack (jaarlijks gefactureerd) | Website | |
| 3 | Het beste voor uniforme traces, logs en statistieken in één weergave | Gratis abonnement beschikbaar | $15/gebruiker/maand (jaarlijks gefactureerd) | Website | |
| 4 | Het beste voor opensource-infrastructuurmonitoring op grote schaal | Gratis abonnement beschikbaar | Prijs op aanvraag | Website | |
| 5 | Het beste voor volledige tracering van bedrijfstransacties | Gratis proefperiode van 30 dagen | $3300 per eenheid per jaar (jaarlijks gefactureerd) | Website | |
| 6 | Het beste voor inzichten in applicatieprestaties en het volgen van de eindgebruikerservaring | Gratis abonnement beschikbaar | $99/maand voor het Pro-abonnement (jaarlijks gefactureerd) | Website | |
| 7 | Het beste voor cloud-native logbeheer en analyses | Gratis proefperiode van 14 dagen | Prijs op aanvraag | Website | |
| 8 | Het meest geschikt voor volumegerichte logmonitoring en waarschuwingen | Gratis proefperiode van 30 dagen | Prijs op aanvraag | Website | |
| 9 | Het beste voor operationele inzichten op basis van machinegegevens | Gratis proefperiode van 60 dagen | $150/maand (jaarlijks gefactureerd) | Website | |
| 10 | Het beste voor Kubernetes-eigen meetwaarden en waarschuwingen | Gratis abonnement beschikbaar | Prijzen op aanvraag | Website |


Beoordelingen van de beste Honeycomb-alternatieven
Hieronder vind je mijn gedetailleerde samenvattingen van de beste Honeycomb-alternatieven die op mijn shortlist staan. In mijn beoordelingen bespreek ik de belangrijkste functies, plus- en minpunten, integraties en ideale gebruiksscenario’s van elke tool, zodat je de beste keuze voor jou kunt vinden.
 Beste voor gedistribueerde tracering met veel context
- Gratis abonnement beschikbaar
- Vanaf $26/maand (jaarlijks gefactureerd)
Visit WebsiteCustomer Rating:4.5/5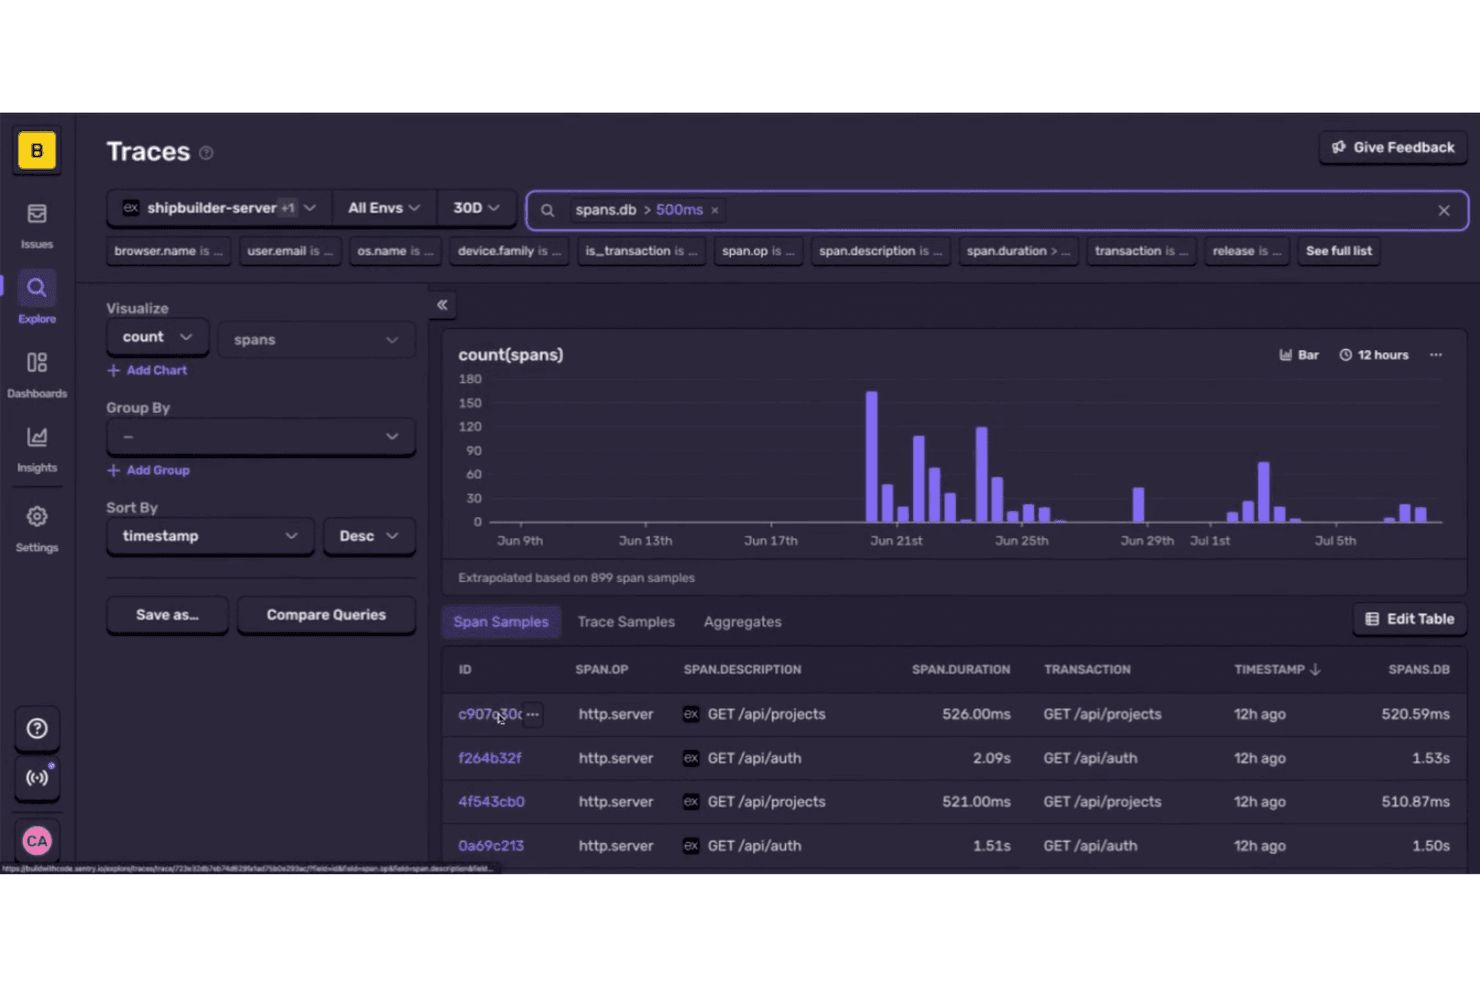
Met Sentry kunnen gebruikers trage database-spans in verschillende services in de loop der tijd traceren. Sentry is een platform voor applicatiemonitoring voor softwareteams, dat engineers helpt fouten en prestatieproblemen in verschillende services te vinden, incidenten te diagnosticeren en de impact ervan op gebruikers te beperken.
Voor wie is Sentry het meest geschikt?
Engineeringteams die gedistribueerde applicaties beheren en tracecontext nodig hebben om prestatieproblemen in verschillende services te lokaliseren.
Waarom ik voor Sentry koos
Ik koos Sentry als alternatief voor Honeycomb omdat het het meest geschikt is voor gedistribueerde tracering met veel context. De traceweergave brengt spans in verschillende services in kaart en koppelt fouten aan de transacties die ze hebben veroorzaakt. Ik vind het prettig dat dit helpt vast te stellen waar een langzaam verzoek latentie oppikt terwijl het zich door een API en de onderliggende services daarvan verplaatst.
Belangrijkste functies van Sentry
- Foutmonitoring: Legt uitzonderingen vast en groepeert vergelijkbare gebeurtenissen in problemen.
- Sessieherhaling: Legt gebruikersinteracties vast zodat teams gebeurtenissen rond een fout kunnen inspecteren.
- Releasestatus: Houdt sessies en gebruikers zonder crashes bij voor verschillende softwareversies.
- Probleemmeldingen: Stuurt meldingen wanneer nieuwe problemen verschijnen of bestaande problemen veranderen.
Integraties van Sentry
Sentry biedt ingebouwde integraties met GitHub, Jira, Slack, GitLab, Microsoft Teams, PagerDuty, Vercel, Bitbucket, Azure DevOps en Opsgenie. Het integratieplatform ondersteunt aangepaste integraties via webhooks en de REST API.
Pros and Cons
Pros:
- Fouten rechtstreeks koppelen aan tracecontext
- Spans zoeken op kenmerken en latentiepercentielen
- Gebruikerssessies naast vastgelegde fouten afspelen
Cons:
- Richt zich voornamelijk op applicatiefouten, niet op infrastructuur
- De uitgebreide functieset kan de interface onoverzichtelijk maken
Learn more about Sentry: Het beste voor AI-aangedreven geautomatiseerde monitoring van de volledige stack
- 15 dagen gratis proefperiode
- $21/user/month voor hun plan voor monitoring van de volledige stack (jaarlijks gefactureerd)
Visit WebsiteCustomer Rating:4.5/5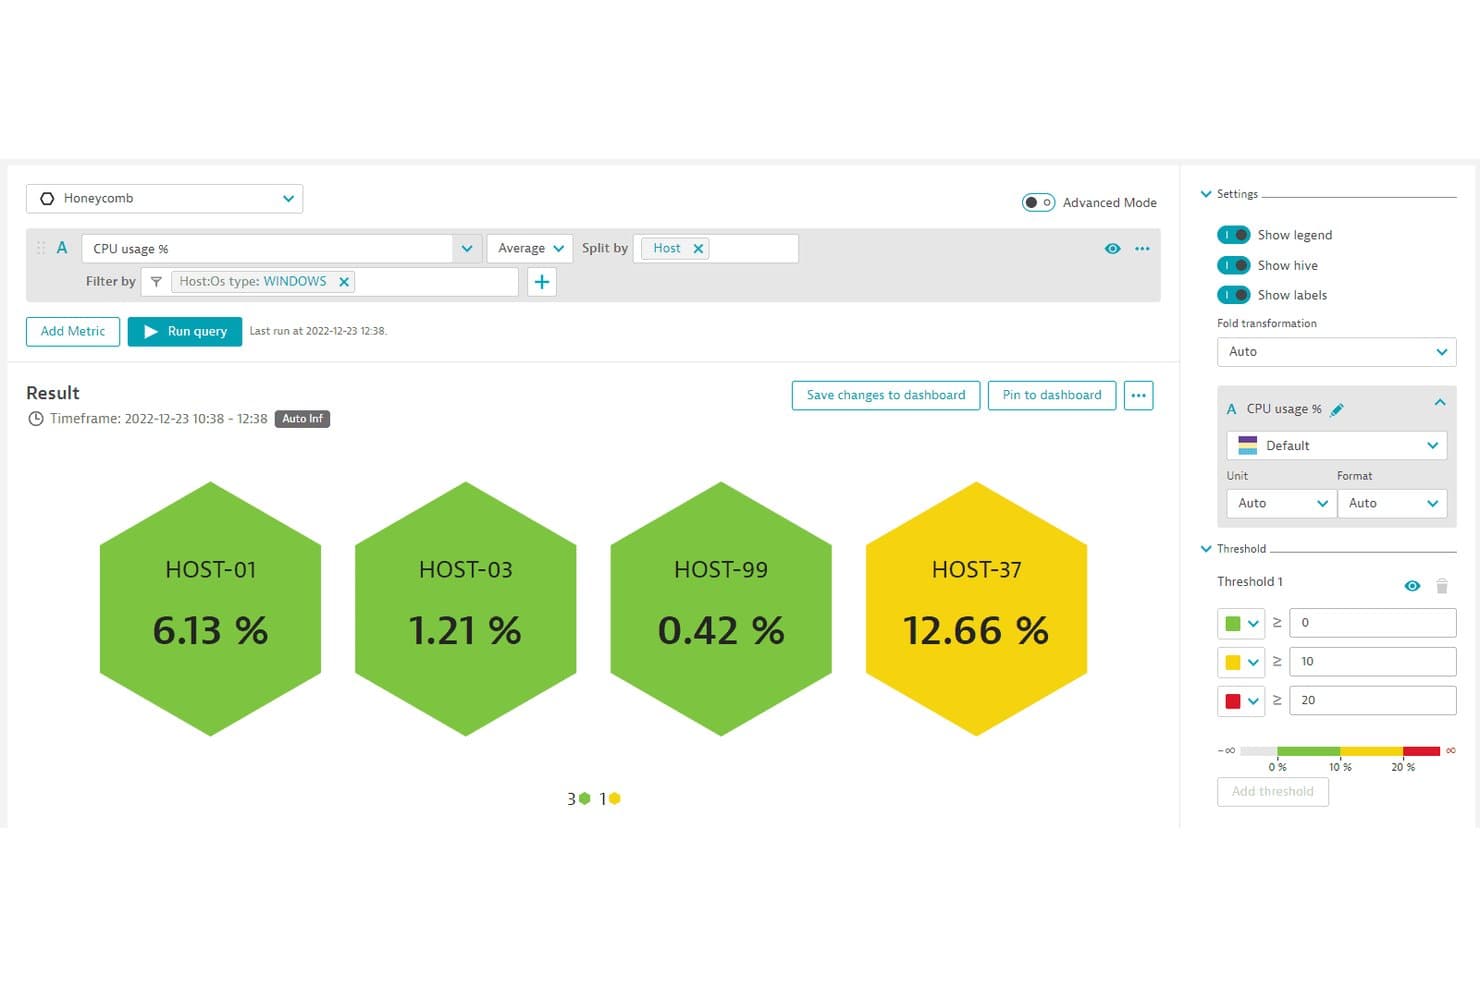
Dynatrace visualiseert CPU-gebruik per host met kleurgecodeerde honingraattegels. Als Honeycomb-alternatief helpt Dynatrace IT- en engineeringteams om applicatie-, infrastructuur- en gebruikerservaringsgegevens met elkaar te verbinden om serviceproblemen in complexe omgevingen te diagnosticeren.
Voor wie is Dynatrace het meest geschikt?
Dynatrace is geschikt voor IT-operations- en SRE-teams die complexe, gedistribueerde omgevingen beheren en geautomatiseerde monitoring van applicaties en infrastructuur nodig hebben.
Waarom ik voor Dynatrace heb gekozen
Ik beschouw Dynatrace als een van de beste Honeycomb-alternatieven vanwege de focus op “de beste AI-aangedreven, geautomatiseerde monitoringoplossingen voor de volledige stack”. Davis AI analyseert telemetrie om waarschijnlijke hoofdoorzaken te identificeren, terwijl OneAgent automatisch services op hosts en cloudwerklasten ontdekt en instrumenteert. Ik waardeer de afhankelijkheidsmapping wanneer een piek in API-latentie te herleiden is tot een host of downstreamservice.
Belangrijkste functies van Dynatrace
- Monitoring van echte gebruikers: Houdt gebruikerssessies, paginaladingen en frontendfouten bij.
- synthetische monitoring: Voert geplande browser- en HTTP-controles uit op endpoints.
- Logmonitoring: Verzamelt, doorzoekt en analyseert logs naast telemetrie.
- Monitoring van cloudinfrastructuur: Houdt metrieken en de status bij van hosts, containers en cloudservices.
Dynatrace-integraties
Dynatrace Workflows biedt officieel ondersteunde connectoren voor AWS, Microsoft Azure, GitHub, Jira, Slack, PagerDuty, ServiceNow, Microsoft Teams, GitLab en Jenkins via Dynatrace Hub. Dynatrace biedt ook een API voor aangepaste integraties.
Pros and Cons
Pros:
- Davis AI koppelt anomalieën aan hoofdoorzaken
- OneAgent ontdekt en instrumenteert services automatisch
- Gecombineerde monitoring van logs, traces, infrastructuur en gebruikers
Cons:
- De syntaxis van DQL kost tijd om onder de knie te krijgen
- Telemetrieverbruik kan kosten onvoorspelbaar maken
 Het beste voor uniforme traces, logs en statistieken in één weergave
- Gratis abonnement beschikbaar
- $15/gebruiker/maand (jaarlijks gefactureerd)
Visit WebsiteCustomer Rating:4.5/5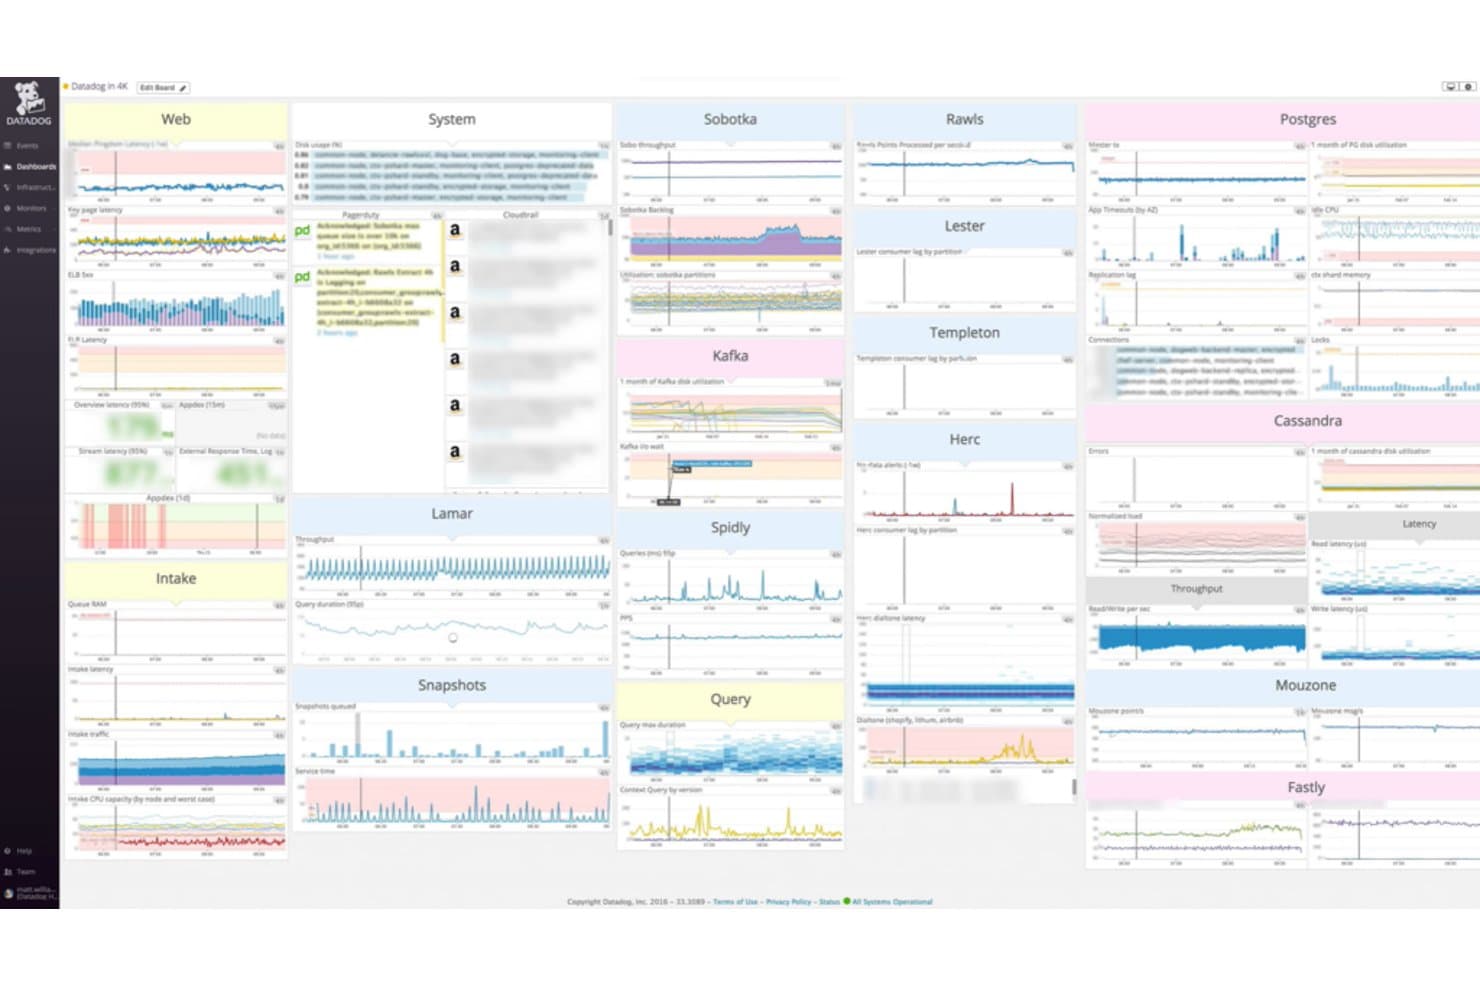
Datadog centraliseert statistieken van web-, systeem- en databaseservices in één dashboard. Datadog is een observabilityplatform voor IT- en engineeringteams die applicatieproblemen moeten onderzoeken, afhankelijkheden tussen services moeten traceren en infrastructuur in complexe omgevingen moeten bewaken.
Voor wie is Datadog het meest geschikt?
Datadog is geschikt voor IT-operaties, platformengineering en SRE-teams die gedistribueerde infrastructuur en applicaties moeten bewaken.
Waarom ik voor Datadog heb gekozen
Ik heb voor Datadog gekozen omdat het het beste is voor uniforme monitoring van servers, apps en services. De infrastructuurstatistieken, APM-traces en servicemaps helpen me een trage aanvraag te volgen van een host naar de afhankelijke services, waardoor het een nuttig alternatief voor Honeycomb is voor incidentonderzoek over meerdere lagen.
Belangrijkste functies van Datadog
- Logbeheer: Zoek, filter en analyseer logs van applicaties en infrastructuur.
- Synthetische monitoring: Voer browser- en API-tests uit om beschikbaarheid en responstijden te controleren.
- Bewakingsfuncties: Stel voorwaarden in die waarschuwingen activeren wanneer bewaakte gegevens een drempelwaarde bereiken.
- Dashboards: Bouw visuele weergaven met grafieken en widgets voor geselecteerde gegevens.
Integraties van Datadog
Datadog biedt meer dan 1.000 ingebouwde integraties, waaronder AWS, Azure, Google Cloud, Kubernetes, Docker, Jenkins, Slack, Jira, GitHub en PagerDuty. Het biedt ook een API voor aangepaste integraties.
Pros and Cons
Pros:
- Combineert logs, statistieken en traces tijdens het onderzoeken van incidenten
- Servicemaps verbinden hosts met afhankelijke services
- Dashboards brengen infrastructuur- en applicatiesignalen samen
Cons:
- Het afstemmen van waarschuwingen kan leiden tot veel onnodige meldingen
- De verwerking van OpenTelemetry kan inconsistent zijn
 Het beste voor opensource-infrastructuurmonitoring op grote schaal
- Gratis abonnement beschikbaar
- Prijs op aanvraag
Visit WebsiteCustomer Rating:4.4/5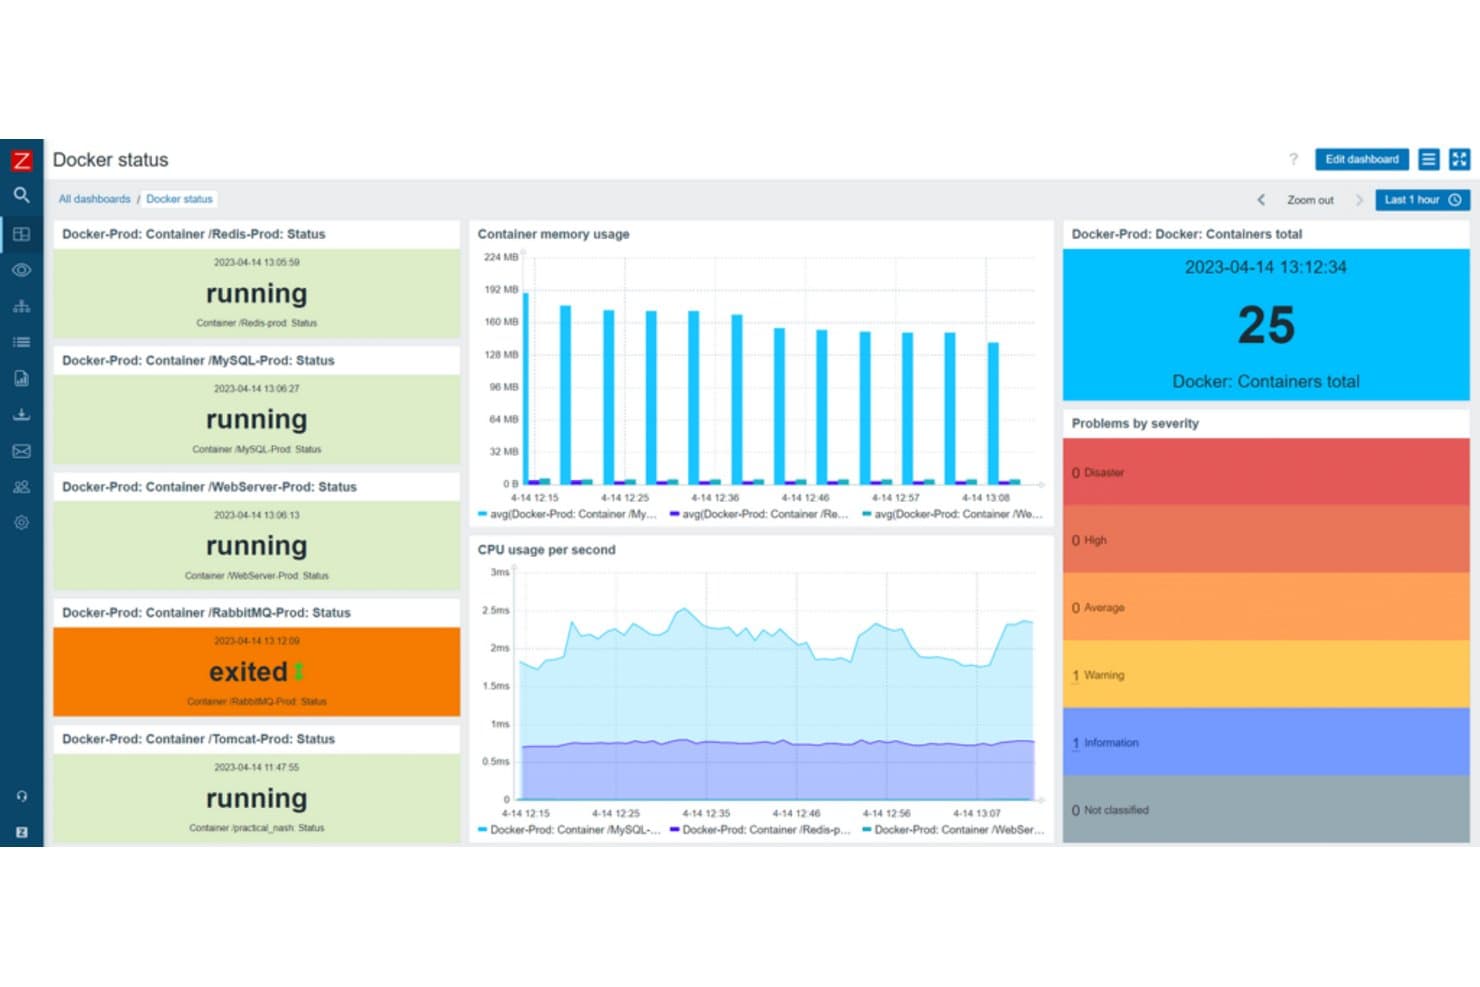
Zabbix monitort de status en het resourcegebruik van Docker-containers in realtime. Zabbix is een infrastructuurmonitoringplatform voor IT-teams die netwerkapparaten, servers, applicaties en services moeten volgen en uitval of prestatieproblemen in complexe omgevingen moeten opsporen.
Voor wie is Zabbix het meest geschikt?
Zabbix is geschikt voor IT- en infrastructuurteams in ondernemingen die opensourcemonitoring nodig hebben voor grote, onderling verbonden netwerken en systemen.
Waarom ik Zabbix koos
Ik koos Zabbix als “Beste voor opensource-netwerkmonitoring op ondernemingsniveau” wanneer inzicht in de infrastructuur belangrijker is dan gedistribueerde tracering. Netwerkdetectie en SNMP-monitoring helpen bij het lokaliseren van switches en routers, terwijl sjablonen en triggers controles standaardiseren en waarschuwen bij storingen in interfaces of services. Daardoor is het een nuttig alternatief voor Honeycomb om de infrastructuurstatus in een grote omgeving te volgen.
Belangrijkste functies van Zabbix
- Webmonitoring: Configureer scenario's om de beschikbaarheid, responstijd en pagina-inhoud van websites te controleren.
- Logmonitoring: Verzamel logboekvermeldingen en detecteer overeenkomende patronen of fouten.
- Servicemonitoring: Breng bedrijfsservices in kaart en volg hun status aan de hand van serviceniveau-doelstellingen.
- Overzichten: Rangschik widgets om monitoringgegevens, problemen en servicestatus weer te geven.
Zabbix-integraties
De integratiecatalogus van Zabbix vermeldt 559 merken en 1.986 oplossingen, waaronder AWS, Azure, Kubernetes, PagerDuty, Slack, Microsoft Teams, ServiceNow en Jira. Het ondersteunt aangepaste verbindingen via de API en configureerbare webhooks; vermeldingen in de catalogus zijn niet noodzakelijk ingebouwde integraties.
Pros and Cons
Pros:
- Automatische detectie vindt SNMP-netwerkapparaten
- Sjablonen standaardiseren controles van de infrastructuurstatus
- Proxies breiden monitoring uit naar externe locaties
Cons:
- Geen ingebouwde werkstroom voor het debuggen van gedistribueerde traceringen
- Complexe installatie en afstemming van waarschuwingen vereisen expertise
 Het beste voor volledige tracering van bedrijfstransacties
- Gratis proefperiode van 30 dagen
- $3300 per eenheid per jaar (jaarlijks gefactureerd)
Visit WebsiteCustomer Rating:4.3/5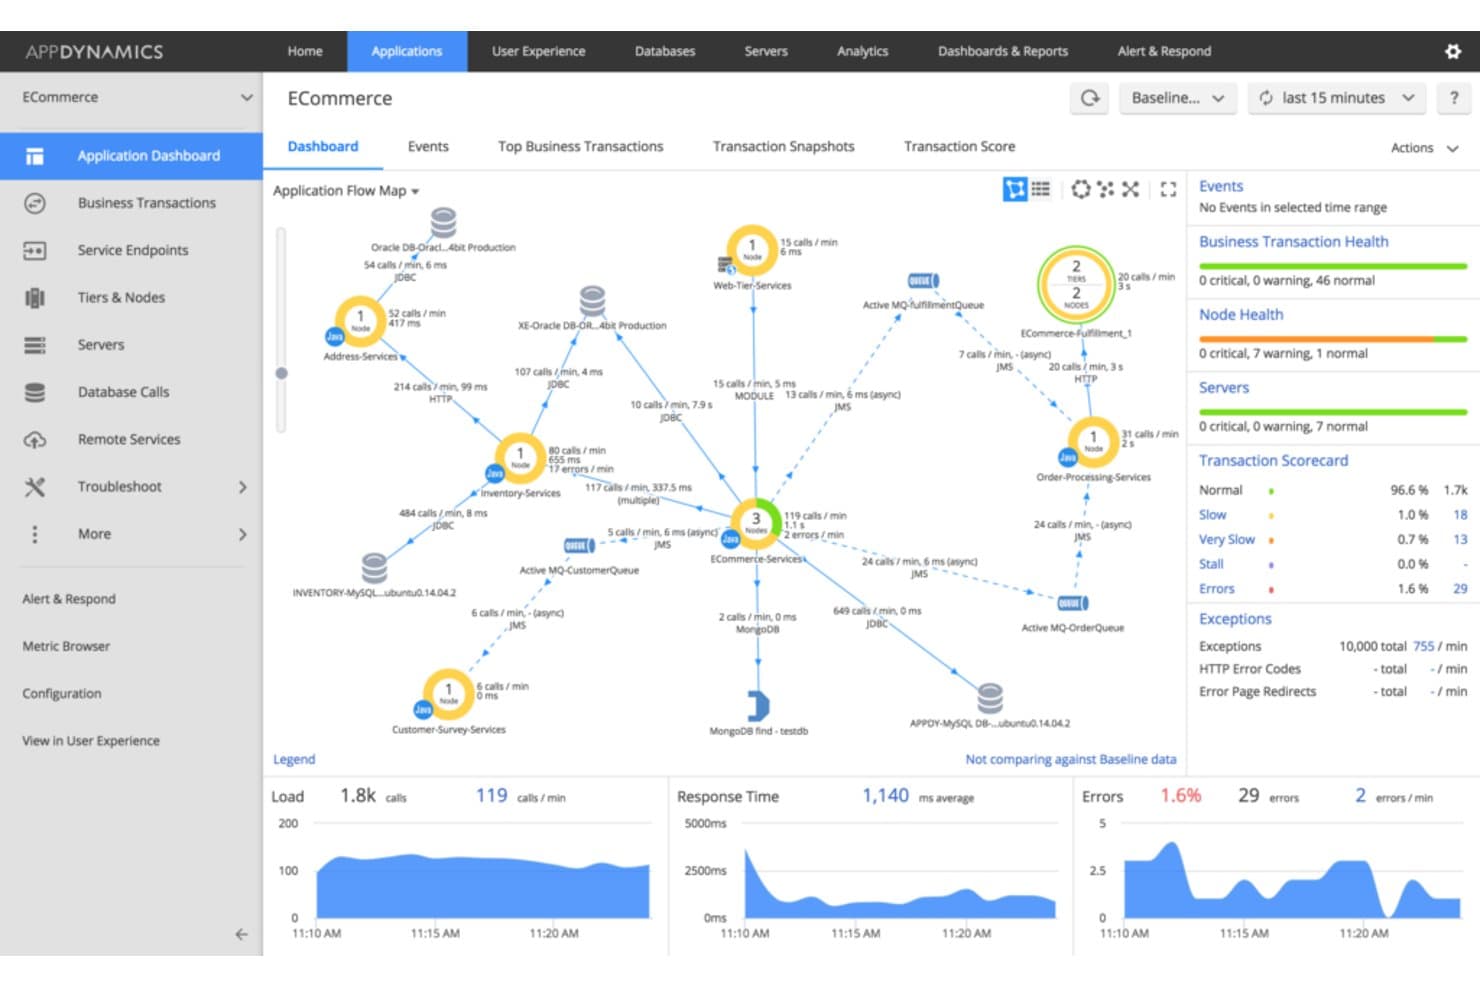
AppDynamics visualiseert afhankelijkheden tussen applicatieservices en prestaties in realtime. AppDynamics is een observabilityplatform voor IT- en applicatieteams die complexe systemen beheren. Het helpt hen prestatieproblemen te lokaliseren en infrastructuurproblemen in verband te brengen met de betrouwbaarheid van applicaties en de gebruikerservaring.
Voor wie is AppDynamics het meest geschikt?
AppDynamics is geschikt voor teams die verantwoordelijk zijn voor applicatieprestaties en -operaties en die gedistribueerde applicaties met meerdere lagen in complexe omgevingen beheren.
Waarom ik voor AppDynamics heb gekozen
Ik heb voor AppDynamics gekozen vanwege de volledige tracering van bedrijfstransacties in complexe omgevingen. De kaarten van de transactiestromen laten zien hoe aanvragen zich door applicatielagen bewegen, terwijl transactiemomentopnamen details op codeniveau vastleggen wanneer een aanvraag vertraagt of mislukt. Ik gebruik dat overzicht om een vertraging tijdens het afrekenen te traceren van de gebruikersgerichte service naar de backendlaag die de vertraging veroorzaakt.
Belangrijkste functies van AppDynamics
- Infrastructuurmonitoring: Brengt infrastructuurmetingen in verband met applicatieservices en bedrijfsmetingen.
- Monitoring van de digitale ervaring: Volgt web- en mobiele gebruikers en voert synthetische controles uit via browsers, API's en services van derden.
- Applicatiebeveiliging tijdens uitvoering: Detecteert kwetsbaarheden en blokkeert aanvallen.
- SAP-monitoring: Monitort hybride en lokale SAP-systemen, met tracering naar ABAP-code of databasequery's.
Integraties van AppDynamics
AppDynamics ondersteunt waarschuwingsintegraties met PagerDuty, Slack, ServiceNow via Service Graph Connector, Jira, BigPanda, Moogsoft en Splunk ITSI; de integratie van PagerDuty is door de leverancier ontwikkeld, terwijl die van Slack door de gemeenschap is ontwikkeld. AppDynamics biedt ook REST-API's en vooraf gebouwde uitbreidingen voor aangepaste integraties.
Pros and Cons
Pros:
- Brengt bedrijfstransacties in kaart over applicatielagen heen
- Momentopnamen maken trage methoden en coderegels zichtbaar
- Brengt de status van transacties in verband met bedrijfsresultaten
Cons:
- De configuratie-inspanning neemt toe bij aangepaste applicatiehiërarchieën
- Voor aangepaste query's moet u de querytaal van AppDynamics leren
Learn more about AppDynamics: Het beste voor inzichten in applicatieprestaties en het volgen van de eindgebruikerservaring
- Gratis abonnement beschikbaar
- $99/maand voor het Pro-abonnement (jaarlijks gefactureerd)
Visit WebsiteCustomer Rating:4.3/5
Overzichtsdashboard van New Relic SQL. New Relic is gespecialiseerd in het bieden van diepgaande inzichten in applicatieprestaties en het volgen van de gebruikerservaring. Deze tool helpt teams uitstekend om gebruikersinteracties en applicatiegedrag op een gedetailleerde, fijnmazige manier te begrijpen.
Pros and Cons
Pros:
- Gedetailleerde monitoring van applicatieprestaties en het volgen van de gebruikerservaring
- Uitgebreide integraties met belangrijke cloudproviders en platforms
- AIOps-mogelijkheden voor voorspellende waarschuwingen en incidentrespons
Cons:
- Hogere prijzen vergeleken met sommige concurrenten
- Kan complex zijn om in te stellen en te configureren
- Het enorme aantal functies kan overweldigend zijn voor nieuwe gebruikers
Learn more about New Relic: Het beste voor cloud-native logbeheer en analyses
- Gratis proefperiode van 14 dagen
- Prijs op aanvraag
Visit WebsiteCustomer Rating:4.3/5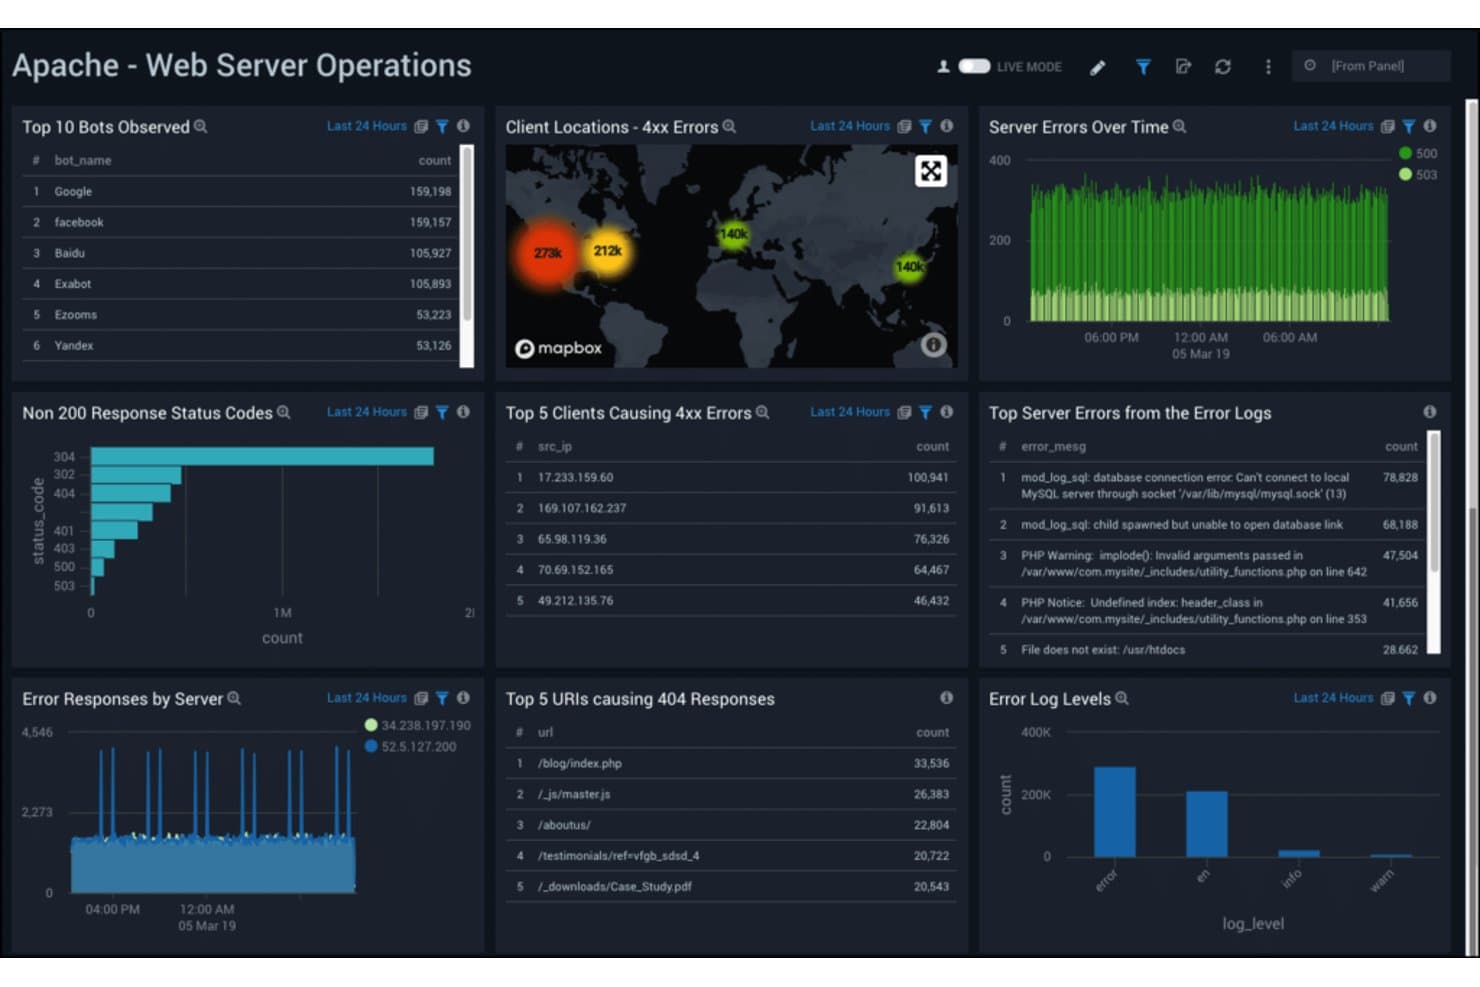
Sumo Logic controleert Apache-webserverfouten en botactiviteiten in realtime. Sumo Logic biedt IT- en DevOps-teams een observabilityplatform om storingen te onderzoeken, problemen in gedistribueerde services met elkaar in verband te brengen en inzicht te krijgen in complexe cloudomgevingen.
Voor wie is Sumo Logic het meest geschikt?
Infrastructuur- en beveiligingsteams in cloud-native organisaties kunnen Sumo Logic gebruiken om logs in gedistribueerde services te analyseren.
Waarom ik voor Sumo Logic heb gekozen
Ik heb Sumo Logic gekozen als alternatief voor Honeycomb omdat het het beste is voor cloud-native logbeheer en analyses. LogReduce groepeert vergelijkbare logberichten, zodat ik terugkerende fouten kan herkennen, terwijl de querytaal voor zoekopdrachten me in staat stelt een incident in gedistribueerde services te onderzoeken.
Belangrijkste functies van Sumo Logic
- Metriekanalyses: Neem tijdreeksmetriek op en voer er query's op uit naast operationele telemetrie.
- Gedistribueerde tracering: Volg verzoeken door services heen om spans en tracegegevens te inspecteren.
- Dashboards: Bouw visuele dashboards met grafieken en panelen voor operationele gegevens.
- Monitoren en waarschuwingen: Stel voorwaarden in voor metriek of queryresultaten om meldingen te activeren.
Integraties van Sumo Logic
De catalogus van Sumo Logic omvat honderden leveranciers en producten, met apps, verzamelaars, Cloud SIEM-inhoud en automatiseringsintegraties voor tools zoals AWS, Azure, Kubernetes, Datadog, GitHub, GitLab en Atlassian Jira. Het biedt ook API's voor aangepaste integraties.
Pros and Cons
Pros:
- LogReduce groepeert vergelijkbare fouten snel
- Zoeken analyseert JSON- en regex-gegevens
- Logs, metriek en traces delen onderzoeken
Cons:
- De querysyntaxis van Sumo vereist oefening
- Historische zoekopdrachten kunnen op schaal trager worden
 Het meest geschikt voor volumegerichte logmonitoring en waarschuwingen
- Gratis proefperiode van 30 dagen
- Prijs op aanvraag
Visit WebsiteCustomer Rating:4.4/5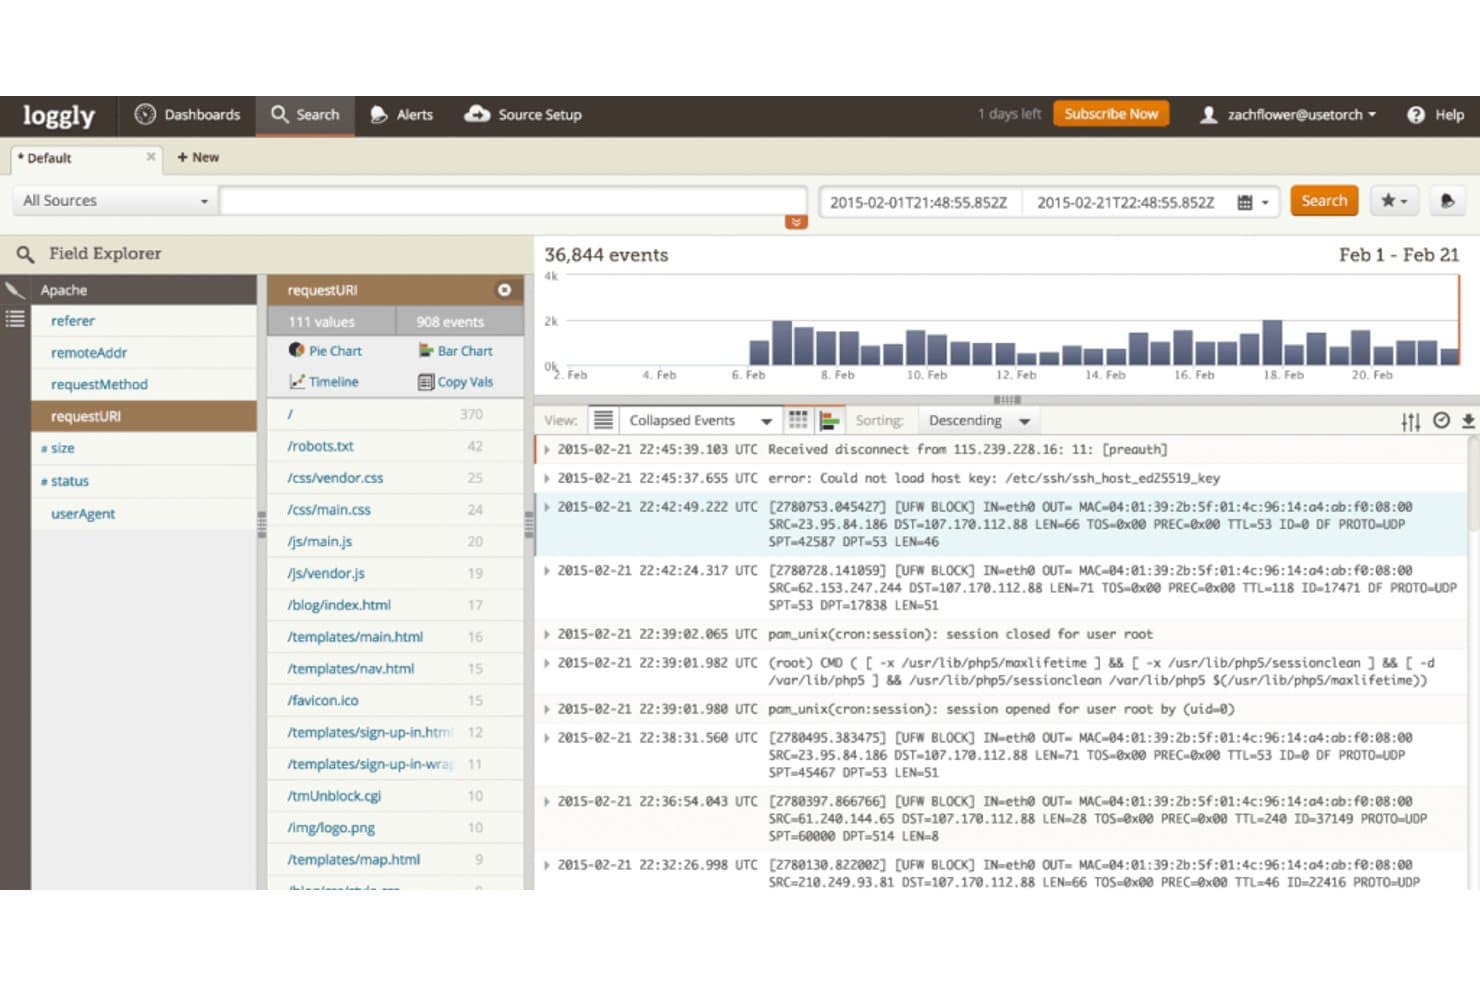
Loggly centraliseert loggebeurtenissen voor realtime zoeken en analyseren. Loggly is een cloudgebaseerd logbeheerplatform voor IT- en DevOps-teams die applicatie- en infrastructuurproblemen moeten onderzoeken, gebeurtenissen tussen services moeten traceren en serviceonderbrekingen moeten diagnosticeren.
Voor wie is Loggly het meest geschikt?
Loggly is geschikt voor IT- en DevOps-teams die loggegevens moeten doorzoeken en visualiseren in groeiende cloudgebaseerde omgevingen.
Waarom ik voor Loggly heb gekozen
Ik heb Loggly gekozen als alternatief voor Honeycomb omdat het het meest geschikt is voor schaalbaar cloudgebaseerd logbeheer en interactieve datavisualisatie. Met de grafieken en dashboards kan ik trends in applicatie- en infrastructuurlogs herkennen. Ik waardeer ook de hulpprogramma's voor probleemoplossing, waarmee ik problemen in onderling verbonden services tot hun hoofdoorzaken kan traceren.
Belangrijkste functies van Loggly
- Live volgen: Stream binnenkomende loggebeurtenissen van meerdere bronnen vrijwel in realtime.
- Zoekgebaseerde waarschuwingen: Stel voorwaarden in voor zoekopdrachten en verstuur meldingen naar e-mail of ondersteunde eindpunten.
- Integraties met teamtools: Verbind Loggly met Slack, GitHub, Jira, PagerDuty, Microsoft Teams en webhooks.
- Ondersteuning voor logbronnen: Verzamel logs uit bronnen zoals AWS, syslog, PHP, netwerkapparaten en Windows-systemen.
Integraties van Loggly
Loggly vermeldt integraties met Slack, GitHub, Jira, PagerDuty en Microsoft Teams. Waarschuwingen kunnen ook via aangepaste webhooks worden afgeleverd. Het biedt een API voor aangepaste integraties.
Pros and Cons
Pros:
- Gecentraliseerd zoeken in logs van verschillende services en dashboards
- Live volgen streamt gebeurtenissen uit meerdere bronnen
- Interactieve grafieken tonen logtrends
Cons:
- Uitsluitend SaaS-implementatie sluit on-premises vereisten uit
- Vertragingen bij het doorgeven van logs kunnen het sorteren van incidenten bemoeilijken
Learn more about Loggly: Het beste voor operationele inzichten op basis van machinegegevens
- Gratis proefperiode van 60 dagen
- $150/maand (jaarlijks gefactureerd)
Visit WebsiteCustomer Rating:4.3/5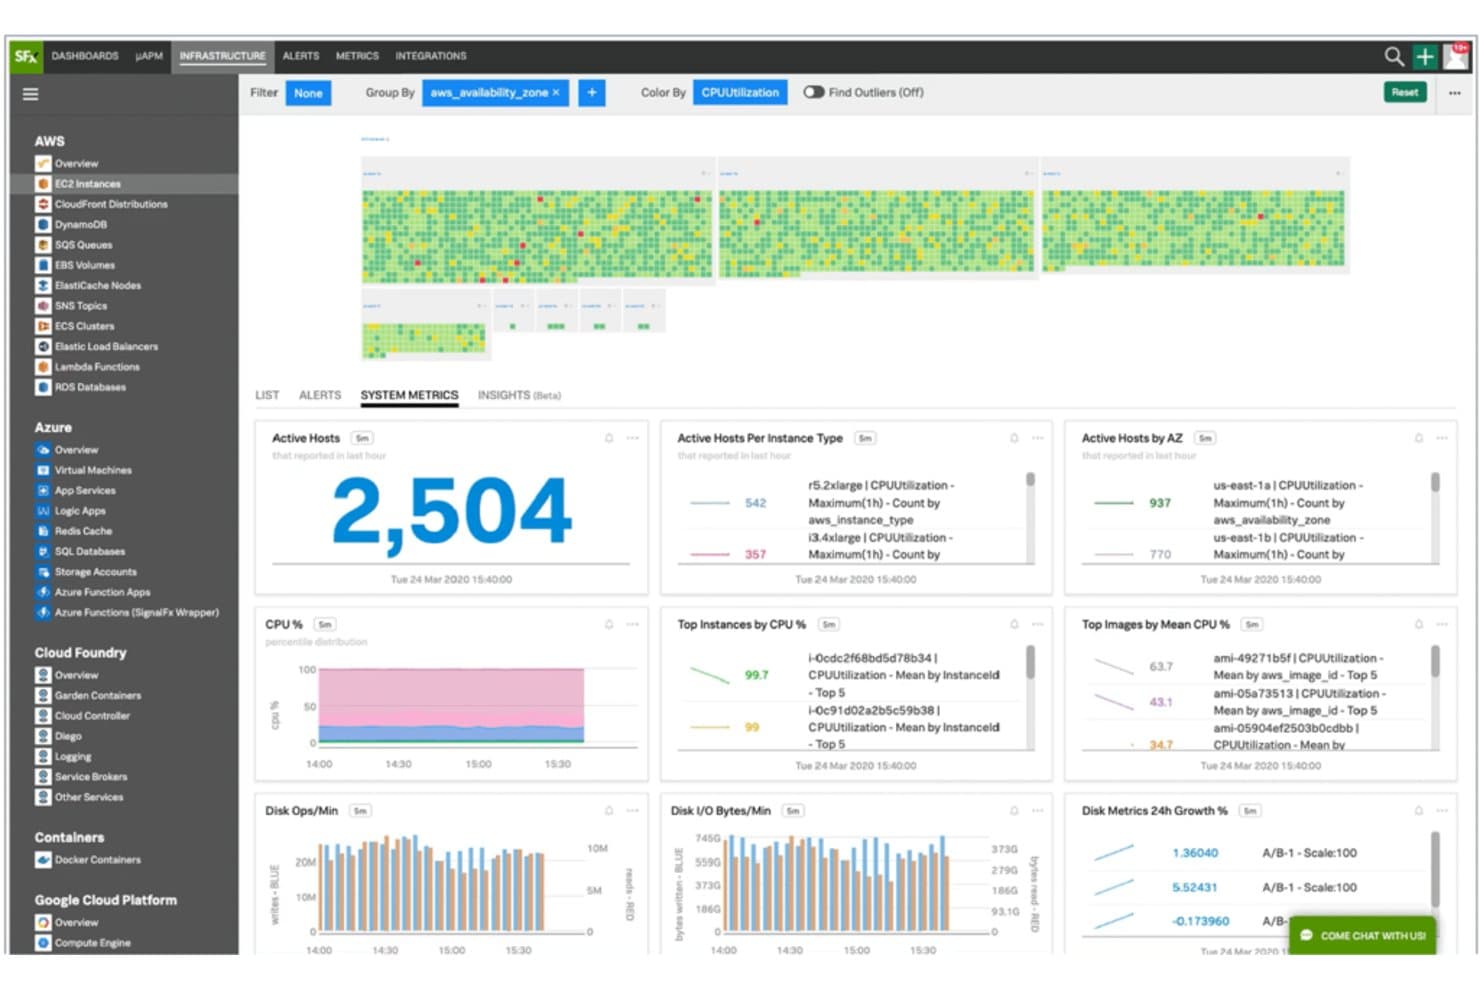
Splunk monitort AWS-, Azure- en cloudinfrastructuurstatistieken in realtime. Splunk is een observabilityplatform voor IT- en securityteams die machinegegevens in complexe omgevingen moeten onderzoeken, serviceproblemen moeten identificeren en incidenten moeten oplossen.
Voor wie is Splunk het meest geschikt?
Operationele IT-teams die toezicht houden op gedistribueerde infrastructuur kunnen Splunk gebruiken om machinegegevens om te zetten in bruikbare operationele inzichten.
Waarom ik Splunk heb gekozen
Ik heb Splunk gekozen als alternatief voor Honeycomb voor “Het beste voor het benutten van machinegegevens voor diepgaande operationele inzichten.” Ik gebruik SPL-zoekopdrachten om logs in gedistribueerde services te onderzoeken en verbind vervolgens de bevindingen in dashboards om problemen te traceren, zoals toenemende fouten na een implementatie. Dankzij dit bredere beeld van machinegegevens kan ik operationele problemen onderzoeken naast gerelateerde infrastructuur- en beveiligingsgebeurtenissen.
Belangrijkste functies van Splunk
- Gedistribueerde tracering: Volg verzoeken door services heen via traces en servicetoewijzingen.
- Infrastructuurbewaking: Houd statistieken bij van hosts, containers en Kubernetes-omgevingen.
- Monitoring van echte gebruikers: Leg browserprestaties en gebruikersinteracties vast.
- Synthetische monitoring: Voer scripts uit om de beschikbaarheid van services en responstijden te controleren.
Integraties van Splunk
Splunk Observability Cloud biedt honderden vooraf verpakte integraties, waaronder AWS, Microsoft Azure, Google Cloud, Kubernetes, Prometheus, Jira, Microsoft Teams, PagerDuty, ServiceNow en Slack. Splunkbase biedt meer dan 1.000 marketplace-apps en add-ons, en Splunk levert API's voor aangepaste integraties.
Pros and Cons
Pros:
- Correlateert logs, statistieken en traces
- Analyseert traces zonder sampling
- Aangepaste dashboards versnellen het oplossen van problemen
Cons:
- Zware query's kunnen langzaam worden uitgevoerd
- De kosten stijgen bij grotere gegevensvolumes
Learn more about Splunk: Het beste voor Kubernetes-eigen meetwaarden en waarschuwingen
- Gratis abonnement beschikbaar
- Prijzen op aanvraag
Visit WebsiteCustomer Rating:4.4/5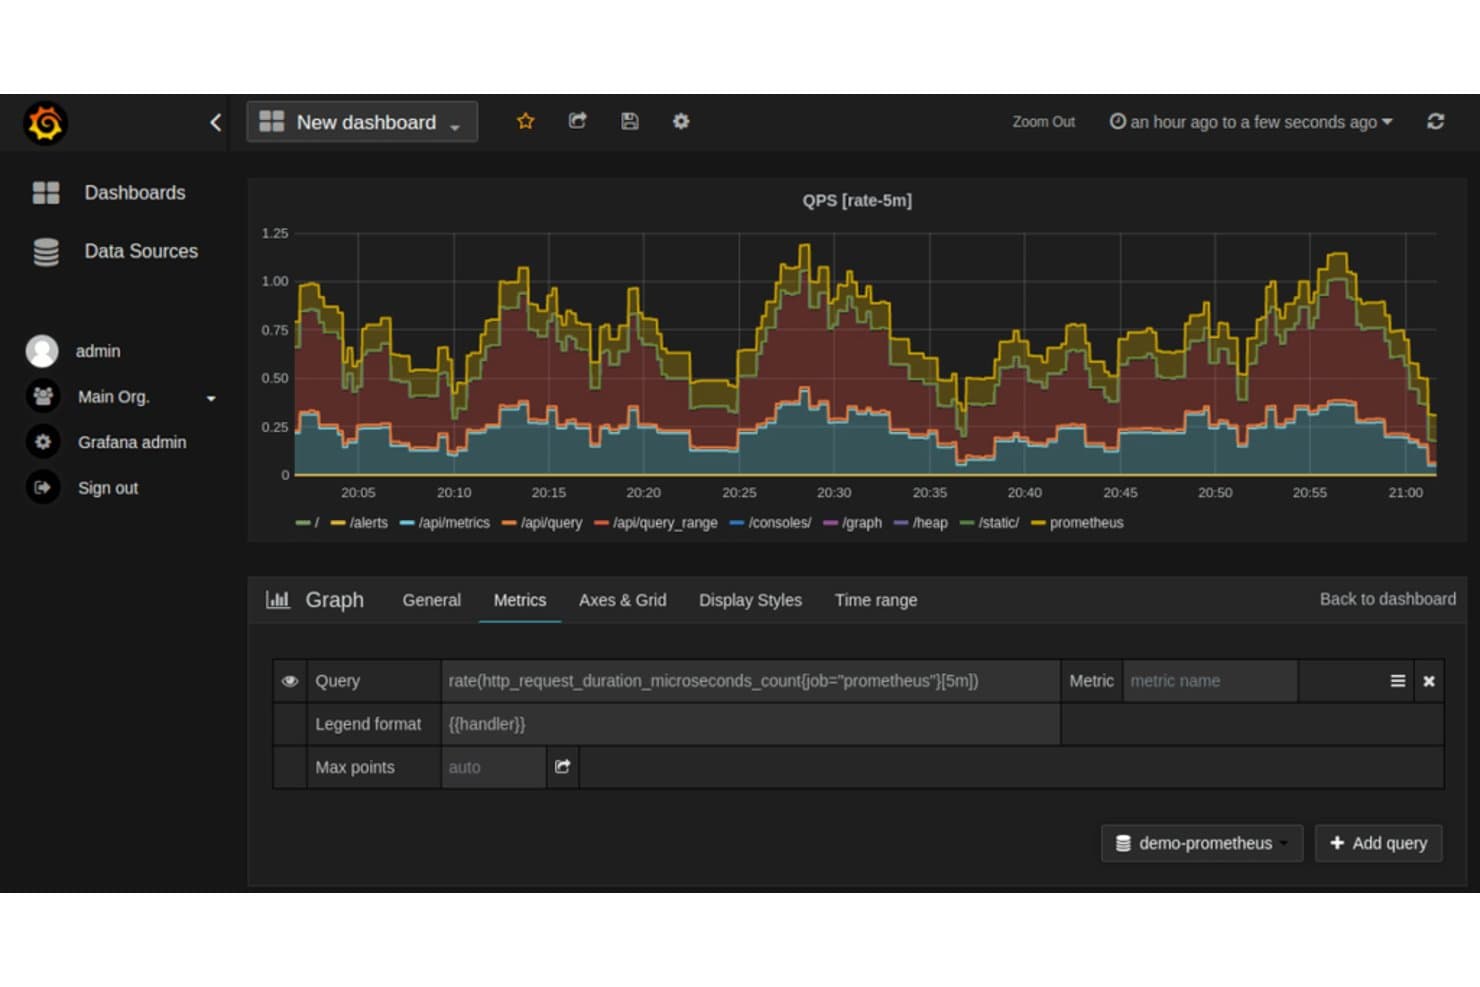
Prometheus visualiseert de snelheid van HTTP-aanvragen voor API-eindpunten in Grafana. Prometheus is een open-source monitoringplatform voor infrastructuur- en applicatieteams die de systeemstatus willen volgen, prestatieproblemen willen onderzoeken en observability in hun services willen integreren.
Voor wie is Prometheus het meest geschikt?
Prometheus is geschikt voor DevOps- en sitebetrouwbaarheidsteams die meetwaarden moeten verzamelen en waarschuwingen moeten instellen voor Kubernetes-werklasten.
Waarom ik voor Prometheus heb gekozen
Ik heb voor Prometheus gekozen voor het verzamelen van meetwaarden en het instellen van waarschuwingen, vooral in een Kubernetes-omgeving. Dankzij de servicedetectie kan het veranderende werklasten volgen, terwijl PromQL me helpt patronen in meetwaarden te onderzoeken en waarschuwingsvoorwaarden te definiëren. Ik gebruik Alertmanager om die waarschuwingen door te sturen wanneer de servicegezondheid verslechtert.
Belangrijkste functies van Prometheus
- Tijdreeksdatabase: Slaat tijdgestempelde metingen op in een lokale database.
- Multidimensionaal datamodel: Ordent tijdreeksen met metrieknamen en labels met sleutel-waardeparen.
- Ecosysteem van exporters: Exporters maken meetwaarden beschikbaar vanuit systemen zoals databases en hardware.
- Federatie: Verzamelt geselecteerde meetwaarden van andere Prometheus-servers voor aggregatie.
Integraties van Prometheus
Prometheus bevat Kubernetes-servicedetectie en ondersteunt op exporters gebaseerde integraties met Kafka, MySQL, PostgreSQL, Redis, Jenkins en AWS CloudWatch. Verbindingen voor op afstand lezen/schrijven omvatten Grafana Mimir, Thanos, Google Cloud en New Relic, en de HTTP-API ondersteunt aangepaste integraties.
Pros and Cons
Pros:
- PromQL ondersteunt op labels gebaseerde onderzoeken van meetwaarden
- Kubernetes-servicedetectie volgt veranderende werklasten
- Alertmanager stuurt waarschuwingen over meetwaarden door op basis van labels
Cons:
- Labels met een hoge cardinaliteit kunnen de lokale opslag belasten
- Lokale opslag beperkt de bewaartermijn en horizontale schaalbaarheid
Learn more about Prometheus:
Andere Honeycomb-alternatieven
Hier zijn enkele aanvullende Honeycomb-alternatieven die mijn shortlist niet hebben gehaald, maar die toch het bekijken waard zijn:
- 11Grafana CloudIdeaal voor interactieve visualisatie en datagestuurde besluitvorming
- 12Elastic (ELK Stack)Het beste voor loganalyse, zoeken en krachtige mogelijkheden voor gegevenscorrelatie
- 13WrikeBeste voor projectmanagement binnen softwareteams
Andere softwarebeoordelingen
- Tools voor softwareontwikkeling
- Tools voor infrastructuur als code
- DataOps-tools
- Tools voor databasemonitoring
Hoe ik Honeycomb-alternatieven beoordeel
Ik bekijk elke kandidaat op twee niveaus: de basiseisen—gedistribueerde tracering, query's met hoge cardinaliteit en OTel-ondersteuning—en de onderscheidende factoren die tools van elkaar onderscheiden wanneer SRE's live productie-incidenten debuggen.
Kernfunctionaliteit (basisvereisten voor deze lijst)
Wanneer ik tools voor mijn lijst selecteer, beoordeel ik elke tool voor elke hieronder vermelde kernfunctionaliteit op een schaal van 0 (biedt de functionaliteit niet) tot 5 (blink uit op dit gebied). Vervolgens bereken ik de totaalscore van de tool als percentage. Elke tool moet een minimale totaalscore van 65% behalen om in aanmerking te komen voor opname.
- Gedistribueerde tracering: Ik beoordeel hoe goed elke tool tracewatervallen over services visualiseert, omdat het debuggen van een traag afrekenproces dat zich over 15 microservices uitstrekt, diepgaande span-details vereist.
- Query's met hoge cardinaliteit: Telemetrie op schaal uitsplitsen op gebruikers-ID of containerinstantie is belangrijk, dus ik controleer of de queryprestaties overeind blijven bij miljoenen unieke waarden.
- Ondersteuning voor uniforme telemetrie: Ik zoek naar tools die logs, metingen en traces in één weergave correleren—van een latentiepiek naar het bijbehorende foutenlogboek schakelen zou met één klik moeten kunnen.
- Compatibiliteit met OpenTelemetry: Hier beoordeel ik native OTel-inname voor traces, metingen en logs, omdat teams geen bedrijfseigen agents nodig zouden moeten hebben om gegevens binnen te krijgen.
- Realtime-alertering en SLO's: Goede observeerbaarheid omvat SLO-meldingen over het verbruikstempo en errorbudgetten, dus ik controleer of elke tool meer ondersteunt dan eenvoudige statische drempelmeldingen.
- Interactieve debugworkflows: Ik zoek naar interfaces voor verkennende query's—zoals detectie van uitschieters of uitsplitsingen per groep—die engineers helpen onbekende problemen tijdens een incident te diagnosticeren.
Zodra ik een lijst heb met tools die aan deze criteria voldoen, kijk ik naar wat elk platform onderscheidt.
Onderscheidende factoren (wat leveranciers van elkaar onderscheidt)
Zo vergelijk ik verschillende leveranciers met elkaar:
Opvallende functies
Tools voor AI-ondersteund onderzoek kunnen uren van een incident afhalen door automatisch de waarschijnlijke hoofdoorzaak naar voren te brengen voordat een engineer zelfs maar een query schrijft. Ik beoordeel ook of een platform continue profilering biedt—CPU- of geheugenknelpunten rechtstreeks aan een trace koppelen helpt knelpunten op codeniveau te lokaliseren die met alleen gegevens op spanniveau onopgemerkt kunnen blijven. Samenwerkende queryworkflows zijn eveneens belangrijk, vooral voor teams die postmortems zonder schuldtoewijzing uitvoeren. Gedeelde onderzoekstrajecten en geannoteerde borden stellen de dienstdoende engineer in staat context aan de volgende ploeg over te dragen zonder dat er iets verloren gaat.
Meer dan functies
Het prijsmodel is een van de eerste dingen die ik controleer. Een platform dat per host factureert, gedraagt zich op schaal heel anders dan een platform dat per opgenomen GB factureert, en een verkeerspiek tijdens de lancering van een product zou je budget voor observeerbaarheid niet mogen opblazen. Ik beoordeel ook hoe snel een team waarde kan realiseren—tools met sterke automatische instrumentatie en duidelijke migratiehandleidingen voor OTel verkorten de inwerktijd aanzienlijk. Integraties met het ecosysteem maken het geheel compleet. Een koppeling met PagerDuty, Slack en je CI/CD-pipeline zorgt ervoor dat meldingen de juiste mensen bereiken en implementatiemarkeringen automatisch op je dashboards verschijnen.
Waarom zoeken naar een Honeycomb-alternatief?
Honeycomb is een geavanceerde tool voor observeerbaarheid die is ontworpen voor software-engineers om hun software in productie te begrijpen, te debuggen en te verbeteren. De tool blinkt uit in het bieden van inzichten op systeemniveau, waardoor het eenvoudiger wordt om patronen en afwijkingen te ontdekken en zo de prestaties te optimaliseren.
Ondanks de krachtige functionaliteit kunnen gebruikers om verschillende redenen op zoek gaan naar alternatieven. Dit kan variëren van budgetbeperkingen, omdat de prijs van Honeycomb voor sommige kleinere teams buiten bereik ligt, tot specifieke vereisten waaraan Honeycomb niet voldoet, zoals traditionele software voor logboekbeheer of diepgaande monitoring van applicatieprestaties.
Tot slot geven sommige gebruikers misschien gewoon de voorkeur aan een opensourcealternatief of aan een alternatief met een andere gebruikersinterface. De zoektocht naar het perfecte Honeycomb-alternatief houdt in dat je een tool vindt die een balans biedt tussen uitgebreide functionaliteit en een naadloze gebruikerservaring, en tegelijkertijd aansluit bij de unieke behoeften en middelen van de organisatie.
Belangrijkste functies van Honeycomb
Hier zijn enkele van de belangrijkste functies van Honeycomb, zodat je kunt vergelijken wat alternatieve oplossingen bieden:
- Telemetrie op basis van gebeurtenissen: Legt gedetailleerde gebeurtenisgegevens vast, zodat je team precies kan zien wat er op elk moment in je systemen is gebeurd.
- Querybouwer: Hiermee kun je complexe vragen over je gegevens stellen zonder code te hoeven schrijven.
- BubbleUp: Markeer automatisch uitschieters in je gegevens, zodat je problemen sneller kunt opsporen.
- Ondersteuning voor tracering: Verbindt traces met logboeken en meetgegevens, zodat je kunt begrijpen hoe één verzoek door je hele technologiestack loopt.
- Borden en weergaven: Helpt je belangrijke query's of visualisaties die je team vaak gebruikt op te slaan, te organiseren en te delen.
- Servicemap: Toont hoe je services met elkaar communiceren, wat helpt om afhankelijkheden en de systeemstatus te begrijpen.
- SLO-monitoring: Hiermee kun je serviceniveaudoelstellingen instellen en bewaken, zodat je zicht houdt op prestatiedoelen.
- Hulpmiddelen voor teamsamenwerking: Hiermee kun je opmerkingen bij query's plaatsen, koppelingen delen en samenwerken aan onderzoeken.
- Snelle query-engine: Reageert snel op grote gegevensverzamelingen, wat helpt bij het opsporen van problemen in liveomgevingen.
- Integraties met hulpmiddelen zoals OpenTelemetry: Maakt het eenvoudig om gegevens uit je bestaande configuratie binnen te halen.