

I 10 migliori software per la gestione delle operazioni IT nel 2026

I migliori software per la gestione delle operazioni IT in una selezione


Il software per la gestione delle operazioni IT aiuta a gestire e comprendere l'intera infrastruttura IT, occupandosi di monitoraggio, automazione, sicurezza e stato dei servizi negli ambienti on-premise e cloud.
Questa lista è pensata per CTO e responsabili IT che hanno bisogno di una visione unificata, di un'analisi più rapida delle cause principali e di soluzioni pronte per le operazioni ibride e multi-cloud. Troverai opzioni per l'automazione basata sull'IA, un'osservabilità approfondita, integrazioni di sicurezza native e la personalizzazione necessaria per ampliare ciò che conta.
Perché Fidarti delle Nostre Recensioni Software
Testiamo e recensiamo software dal 2023. Come leader tecnologici, sappiamo quanto sia cruciale e difficile prendere la decisione giusta nella scelta di un software.
Investiamo in una ricerca approfondita per aiutare il nostro pubblico a effettuare scelte migliori di acquisto software. Abbiamo testato oltre 2.000 strumenti per diversi casi d’uso tecnologici e scritto più di 1.000 recensioni complete. Scopri come restiamo trasparenti e la nostra metodologia di recensione del software.
Confronta i migliori software per la gestione delle operazioni IT
Confronta prezzi e specifiche, fianco a fianco, dei software per la gestione delle operazioni IT inclusi nella mia selezione.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Ideale per le operazioni su log e metriche integrate con SecOps | Prova gratuita disponibile | A partire da $0.15/credit | Website | |
| 2 | Ideale per la visibilità operativa nativa di OTel sull'intero stack | Prova gratuita di 14 giorni | A partire da $99/mese | Website | |
| 3 | Ideale per le operazioni IT ibride multi-tenant di livello MSP | Demo gratuita disponibile | Prezzi su richiesta | Website | |
| 4 | Ideale per una visibilità approfondita sulle operazioni di archiviazione e GPU | Demo gratuita disponibile | Prezzi su richiesta | Website | |
| 5 | Ideale per la convalida dei rilasci dello stack completo basata sull'IA | Prova gratuita di 15 giorni | Da $7/host/mese | Website | |
| 6 | Ideale per la gestione delle cause principali, dagli avvisi alla topologia, basata sull'intelligenza artificiale | Prova gratuita di 14 giorni | Prezzo su richiesta | Website | |
| 7 | La soluzione migliore per l'osservabilità completa a livello di transazione | Piano gratuito disponibile | Da $99/utente/mese | Website | |
| 8 | Ideale per operazioni IT ibride basate su CMDB su larga scala | Demo gratuita disponibile | Prezzi su richiesta | Website | |
| 9 | Ideale per le operazioni di integrità dei servizi tra più domini negli ambienti nativi Cisco | Demo gratuita disponibile | Prezzi su richiesta | Website | |
| 10 | Ideale per l'IA agentica nelle operazioni dal mainframe al cloud | Demo gratuita disponibile | Prezzi su richiesta | Website |
Recensioni dei migliori software per la gestione delle operazioni IT
Di seguito trovi i miei riepiloghi dettagliati dei migliori software per la gestione delle operazioni IT inclusi nella mia selezione. Le mie recensioni offrono un’analisi approfondita delle funzionalità, dei casi d’uso principali e delle integrazioni di ogni piattaforma, per aiutarti a trovare quella più adatta alle tue esigenze.

Ideale per le operazioni su log e metriche integrate con SecOps
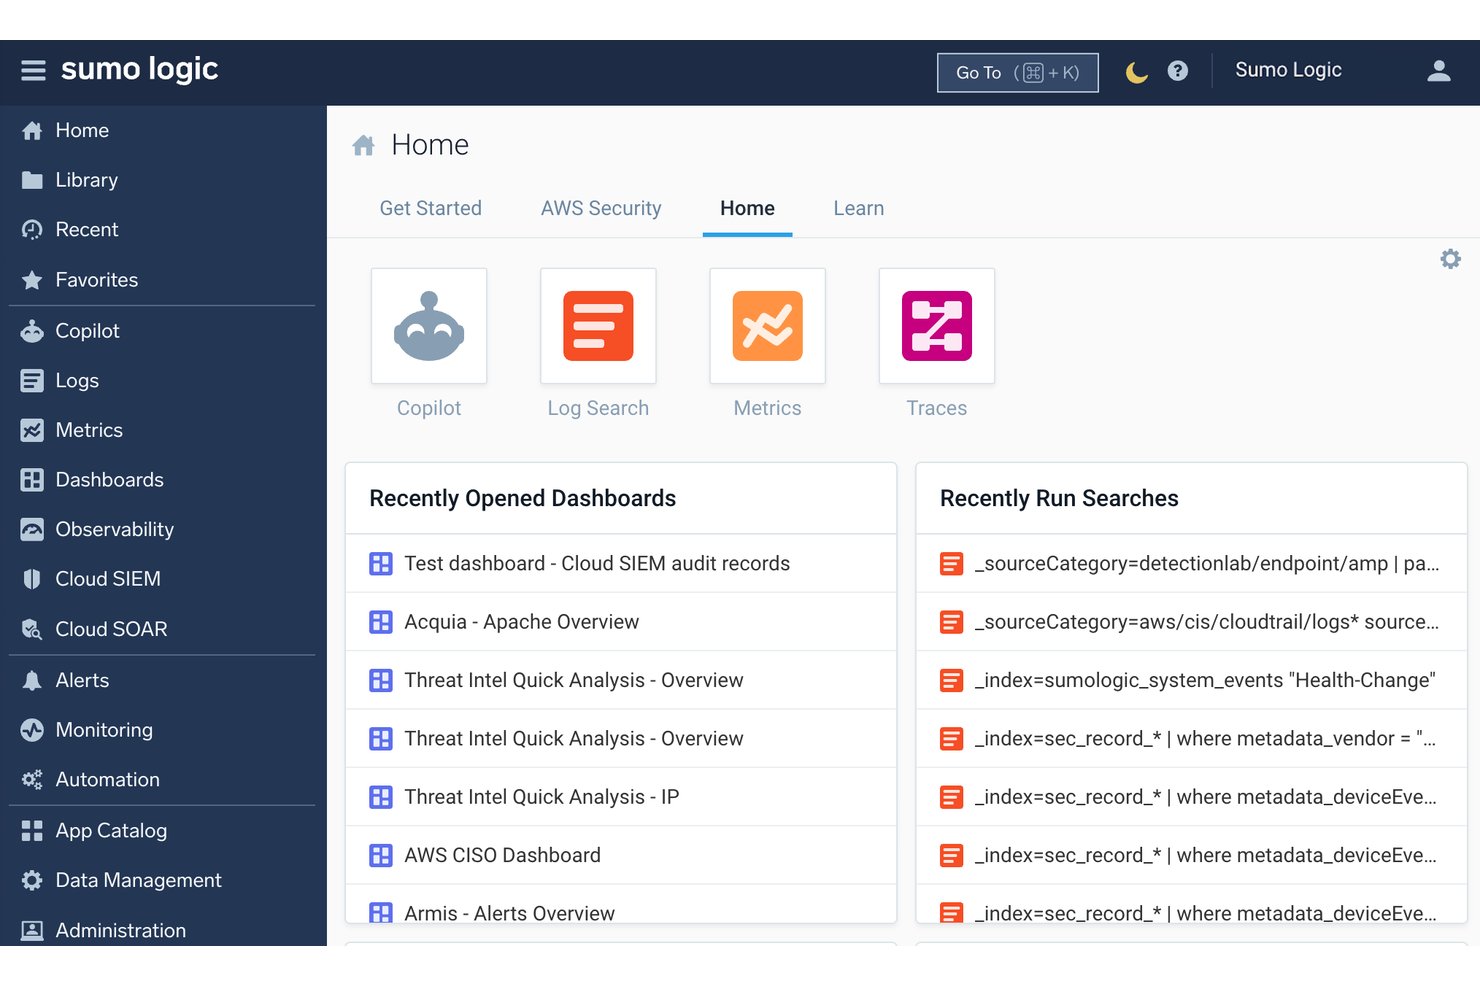
Sumo Logic è una piattaforma nativa del cloud per la gestione delle operazioni IT che unifica analisi dei log, monitoraggio dell'infrastruttura, metriche, tracciamento distribuito e operazioni di sicurezza in un'unica soluzione di osservabilità e SIEM basata su SaaS.
Per chi è più adatto Sumo Logic?
Sumo Logic è particolarmente adatto ai team IT e operativi attenti alla sicurezza che necessitano di funzionalità di analisi dei log, metriche e SIEM in un'unica piattaforma SaaS.
Perché ho scelto Sumo Logic
Sumo Logic si è guadagnato un posto nella mia selezione perché è una delle poche piattaforme che riunisce l'analisi dei log e le operazioni di sicurezza in un unico strumento SaaS realmente unificato. Apprezzo il modo in cui i suoi operatori brevettati LogReduce e LogExplain individuano le cause principali direttamente dai dati grezzi dei log, riducendo la ricerca manuale di schemi che rallenta la risoluzione degli incidenti. Spicca anche la piattaforma multi-agente Dojo AI: l'agente analista SOC automatizza la classificazione iniziale degli avvisi di livello 1 e fornisce valutazioni supportate da prove, una funzione che il mio team considera preziosa quando i flussi di lavoro SecOps e ITOps si sovrappongono.
Funzionalità principali di Sumo Logic
- Monitoraggio delle metriche basato sull'intelligenza artificiale: il rilevamento delle anomalie basato sull'apprendimento automatico ottimizza automaticamente le baseline stagionali dei dati delle metriche, riducendo il volume degli avvisi falsi positivi.
- Gestione multi-organizzazione: un'organizzazione principale controlla monitoraggi, pannelli di controllo, ruoli e accessi nelle organizzazioni secondarie da un'unica interfaccia centralizzata.
- Pannelli di controllo per la reportistica sulla conformità: i pannelli di controllo predefiniti mappano i dati rispetto ai framework PCI, HIPAA, GDPR, SOX e ISO, offrendo una visibilità continua del livello di conformità.
- Agente di distribuzione OpenTelemetry: un unico agente unificato raccoglie log, metriche e tracce su Linux, Windows, macOS e oltre 25 configurazioni di origine.
Integrazioni di Sumo Logic
Sumo Logic offre oltre 450 integrazioni, tra cui ServiceNow, PagerDuty, Jira, Slack, Microsoft Teams, AWS, Microsoft Azure, Google Cloud Platform, Kubernetes e Docker. Fornisce inoltre API REST, webhook, Terraform, SumoQL e un framework di integrazione aperto per la connettività personalizzata.
Pros and Cons
Pros:
- Dojo AI automatizza la classificazione e la risoluzione degli incidenti
- I pannelli di controllo della conformità mappano direttamente i principali framework
- Centralizza log, metriche e tracce in un'unica piattaforma
Cons:
- L'automazione avanzata privilegia la sicurezza rispetto alle operazioni IT
- L'esecuzione di query su grandi set di dati storici può essere lenta

Ideale per la visibilità operativa nativa di OTel sull'intero stack
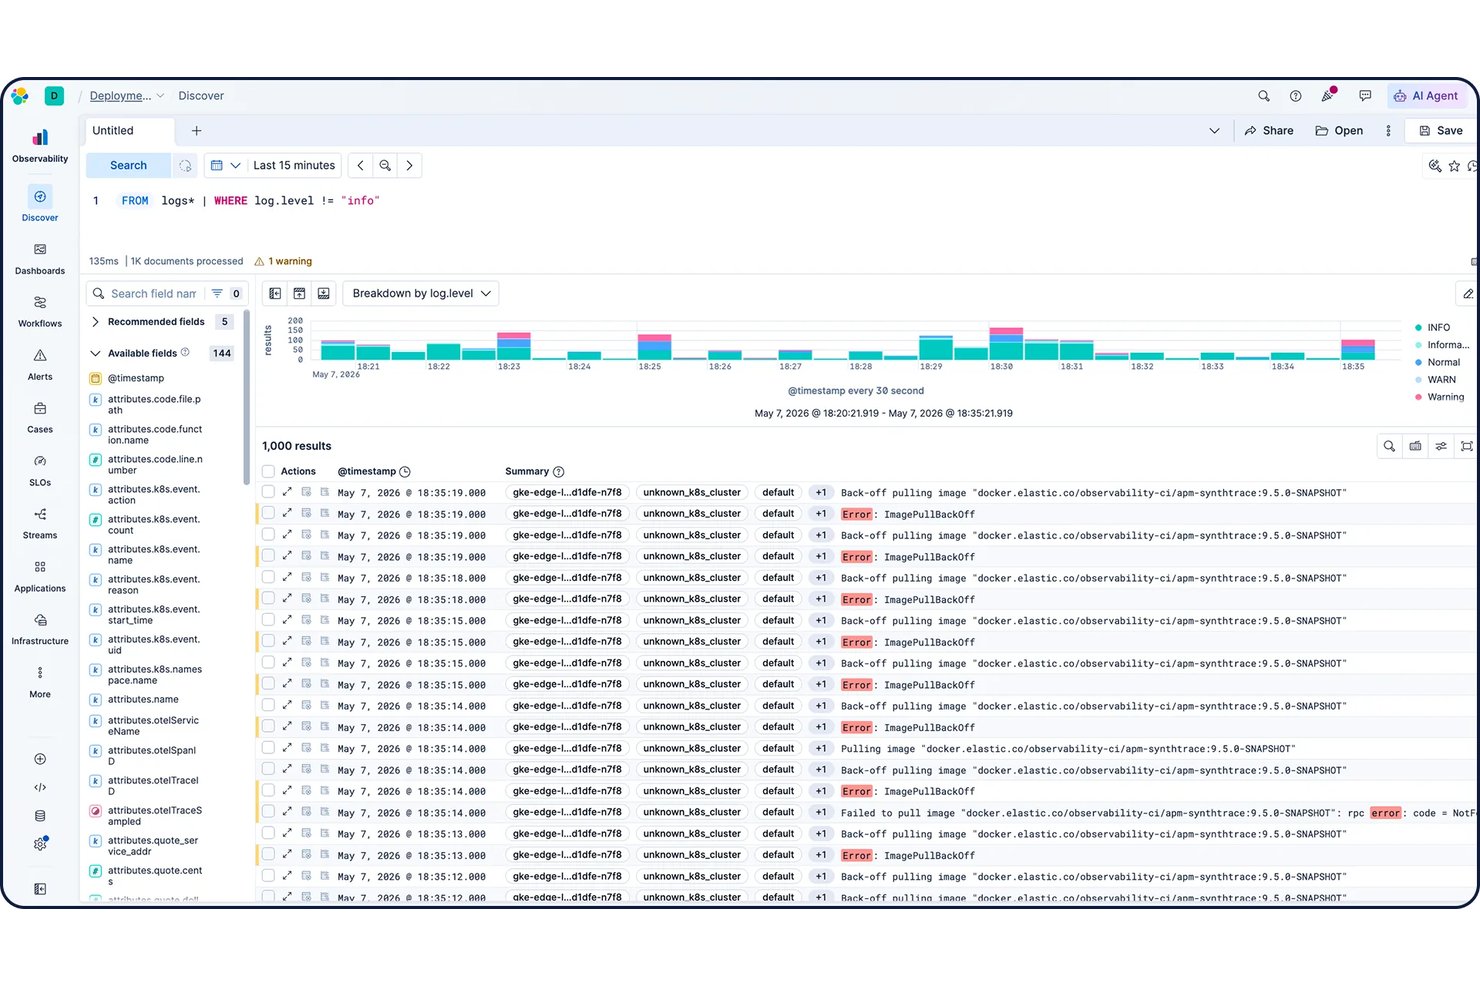
Elastic Observability è una piattaforma di osservabilità sull'intero stack che unifica il monitoraggio dei log, le metriche dell'infrastruttura, l'APM, il tracciamento distribuito, il monitoraggio sintetico e l'AIOps negli ambienti locali, cloud e ibridi.
A chi è più adatta Elastic Observability?
Elastic Observability è una soluzione particolarmente adatta agli SRE e agli ingegneri dell'infrastruttura delle aziende di medie e grandi dimensioni che necessitano di una visibilità unificata su log, metriche, tracce e APM negli ambienti ibridi e multi-cloud, soprattutto per i team che hanno già adottato OpenTelemetry.
Perché ho scelto Elastic Observability
Elastic Observability si è guadagnata un posto nella mia lista ristretta perché è una delle poche piattaforme progettate con OpenTelemetry come priorità, il che significa che log, metriche, tracce e dati APM confluiscono tutti in un unico schema senza costringerti a gestire agenti proprietari. Apprezzo in particolare il livello ML a configurazione zero: oltre 100 processi preconfigurati di rilevamento delle anomalie vengono eseguiti automaticamente su ogni flusso di dati, quindi, quando l'acquisizione avviene su scala Comcast, il tuo team non deve ottimizzare manualmente i modelli. L'analisi dei log basata su Streams e il motore di interrogazione ES|QL rendono davvero rapida l'individuazione delle cause principali negli ambienti ibridi.
Caratteristiche principali di Elastic Observability
- Monitoraggio sintetico: Esegui test leggeri e test completi del browser sui percorsi degli utenti utilizzando un'infrastruttura di test gestita a livello globale o sedi private locali.
- Monitoraggio degli obiettivi del livello di servizio (SLO): Definisci, monitora e crea report sugli obiettivi di affidabilità direttamente in Kibana, insieme ai pannelli di controllo e agli avvisi esistenti.
- Avvisi di Kibana: Configura avvisi basati su regole per dati APM, metriche, disponibilità e sicurezza utilizzando una configurazione basata su moduli, con supporto per le notifiche multicanale.
- Oltre 550 integrazioni predefinite: Connettiti a fornitori cloud, strumenti ITSM, piattaforme di sicurezza e fonti di dati utilizzando agenti predefiniti e raccoglitori senza agenti.
Integrazioni di Elastic Observability
Elastic Observability offre oltre 550 integrazioni predefinite, tra cui AWS, Microsoft Azure, Google Cloud Platform, ServiceNow, Jira, PagerDuty, Slack, Microsoft Teams, Kubernetes e OpenTelemetry. Supporta inoltre API REST, webhook, Elastic Agent, Logstash, Beats e raccoglitori OpenTelemetry per la connettività personalizzata.
Pros and Cons
Pros:
- Visibilità unificata negli ambienti ibridi e multi-cloud
- Il ML a configurazione zero rileva automaticamente le anomalie
- L'acquisizione nativa OTel evita il vincolo verso un fornitore
Cons:
- La pianificazione nativa dei turni di reperibilità non è inclusa
- Documentazione insufficiente per configurazioni OTel complesse

OpsRamp
Ideale per le operazioni IT ibride multi-tenant di livello MSP
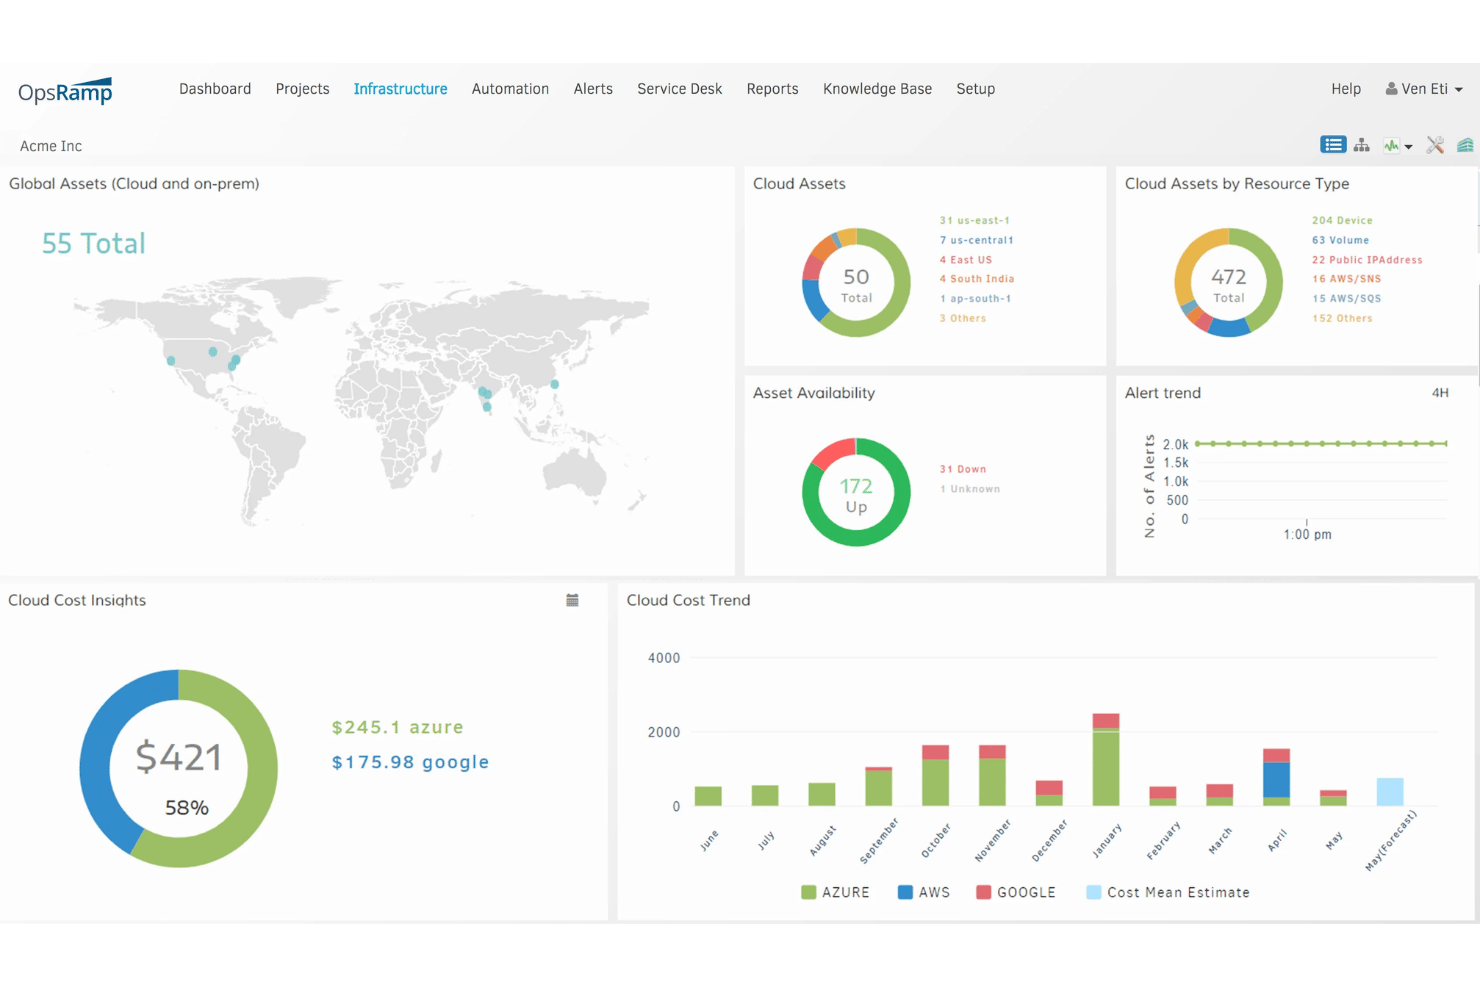
HPE OpsRamp è una piattaforma di gestione delle operazioni IT basata su AIOps che unifica il monitoraggio dell'infrastruttura, la correlazione degli eventi, la gestione degli incidenti, l'automazione dei runbook e la visibilità su ambienti ibridi e multi-cloud, inclusi gli ambienti on-premise, cloud privati e cloud pubblici.
Per chi è più adatto OpsRamp?
OpsRamp è particolarmente adatto ai fornitori di servizi gestiti e alle grandi aziende che gestiscono ambienti IT ibridi complessi distribuiti tra infrastrutture on-premise e ambienti multi-cloud.
Perché ho scelto OpsRamp
OpsRamp si è guadagnato un posto nella mia rosa dei candidati perché la sua architettura multi-tenant è progettata appositamente per gli MSP che gestiscono decine di ambienti cliente da un'unica interfaccia. Apprezzo in particolare il suo motore di correlazione degli eventi AIOps, che raggruppa gli avvisi correlati tra i tenant e riduce il rumore fino al 90%, così il team non viene sommerso dai ticket relativi ai diversi account cliente. Le sue mappe della topologia e dei servizi offrono una visione aggiornata delle dipendenze negli ambienti ibridi che comprendono AWS, Azure, GCP e infrastrutture on-premise, un risultato davvero difficile da replicare su questa scala.
Funzionalità principali di OpsRamp
- Motore di automazione dei runbook: esegue automaticamente script di correzione predefiniti in risposta ai problemi rilevati, con accesso ai processi e ai flussi di lavoro regolato dal controllo degli accessi basato sui ruoli.
- Gestione dei clienti multi-tenant: gestisce più ambienti cliente da un'unica istanza della piattaforma, con configurazione delle integrazioni per tenant e gestione isolata dei dati.
- Report sui costi cloud: suddivide la spesa cloud per account, regione, servizio e tipo di istanza su AWS, Azure e GCP, con intervalli di date personalizzabili.
- Acquisizione OpenTelemetry: importa metriche, log e tracce da qualsiasi origine compatibile con OpenTelemetry, insieme alla strumentazione automatica assistita da eBPF per una visibilità approfondita sui carichi di lavoro.
Integrazioni di OpsRamp
OpsRamp offre oltre 3.000 integrazioni, tra cui ServiceNow, Jira Service Management, Zendesk, AWS, Microsoft Azure, Google Cloud Platform, Kubernetes, OpenTelemetry e Prometheus. La sua API REST OAuth 2.0, i webhook e il supporto all'importazione e all'esportazione JSON consentono di creare connessioni personalizzate.
Pros and Cons
Pros:
- Gestione multi-tenant degli ambienti cliente degli MSP
- Riduzione del rumore degli avvisi fino al 90 percento
- Visualizzazioni della topologia ibrida e multi-cloud
Cons:
- Le funzionalità di monitoraggio delle applicazioni sono ancora in fase di maturazione
- Le prestazioni della dashboard possono rallentare su larga scala
Virtana
Ideale per una visibilità approfondita sulle operazioni di archiviazione e GPU
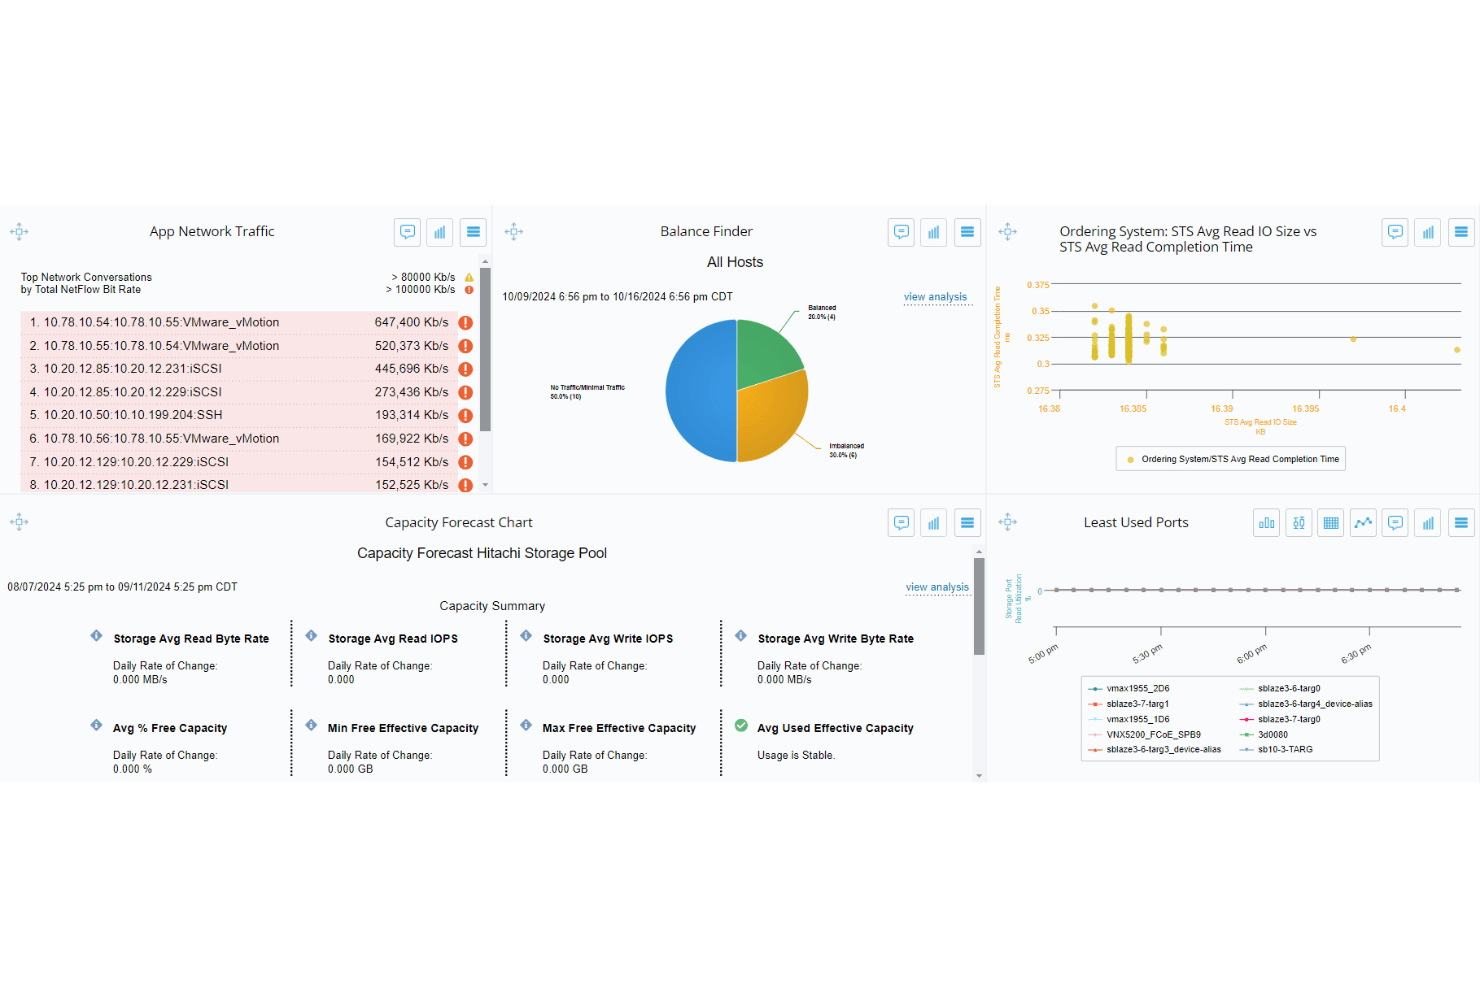
Virtana è una piattaforma di AIOps e osservabilità dell'infrastruttura che monitora ambienti ibridi tra elaborazione, archiviazione, rete, Kubernetes e infrastrutture GPU, con correlazione degli eventi basata sull'intelligenza artificiale, rilevamento delle anomalie e gestione automatizzata degli incidenti integrati nel suo nucleo.
Per chi è più adatta Virtana?
Virtana è particolarmente adatta agli ingegneri dell'infrastruttura e NetOps che gestiscono ambienti ibridi complessi, dove la profondità dei dati di archiviazione, la visibilità sui carichi di lavoro GPU e la correlazione degli incidenti basata sull'intelligenza artificiale sono imprescindibili.
Perché ho scelto Virtana
Ho scelto Virtana come una delle migliori perché nessun'altra piattaforma della mia lista ristretta raccoglie metriche di archiviazione con questo livello di profondità: oltre 16.000 metriche che coprono ambienti a blocchi, NAS, SAN, SDS e HCI, tutte correlate in tempo reale al contesto di elaborazione e rete. Sono particolarmente colpito dal suo modulo dedicato all'osservabilità delle fabbriche di IA, che monitora l'utilizzo delle GPU, la capacità inattiva, la limitazione delle prestazioni e la velocità di trasferimento NVLink/PCIe per i team che eseguono carichi di lavoro di addestramento o inferenza di LLM su larga scala. Il suo rilevamento delle anomalie basato sull'apprendimento automatico raggiunge una precisione fino al 95%, facendo emergere i problemi prima che vengano superate le soglie, anziché dopo che il danno è stato fatto.
Funzionalità principali di Virtana
- Risoluzione dei problemi con IA agentica: gli agenti di IA attraversano il grafo delle dipendenze del sistema per indagare autonomamente sui problemi ed eseguire flussi di lavoro di risoluzione governati senza passaggi manuali.
- Previsione predittiva della capacità: utilizza fino a 12 mesi di dati storici per prevedere il fabbisogno di capacità di elaborazione, archiviazione, rete e GPU fino a un anno nel futuro.
- Sincronizzazione bidirezionale con ServiceNow: crea, aggiorna e chiude automaticamente gli incidenti di ServiceNow in base agli eventi rilevati, con mappatura della criticità aziendale e integrazione con il CMDB.
- Mappatura della topologia e delle dipendenze: rileva automaticamente e mappa continuamente le relazioni tra applicazioni, servizi e infrastruttura per mantenere un modello di sistema aggiornato e interrogabile.
Integrazioni di Virtana
Virtana dispone di un'integrazione nativa con ServiceNow, oltre a integrazioni con Slack, Microsoft Teams, PagerDuty, AWS, Azure, GCP, Kubernetes, VMware e OpenTelemetry. Le API REST e un server MCP supportano le integrazioni personalizzate e l'accesso degli agenti di IA.
Pros and Cons
Pros:
- Raccoglie oltre 16.000 metriche di archiviazione in diversi ambienti
- Monitora nativamente le prestazioni delle GPU e dei carichi di lavoro di IA
- Il rilevamento delle anomalie basato sull'IA raggiunge un'elevata precisione
Cons:
- Le visualizzazioni dell'interfaccia utente possono risultare limitate
- La base di recensioni è più ridotta rispetto a quella dei principali concorrenti
Ideale per la convalida dei rilasci dello stack completo basata sull'IA
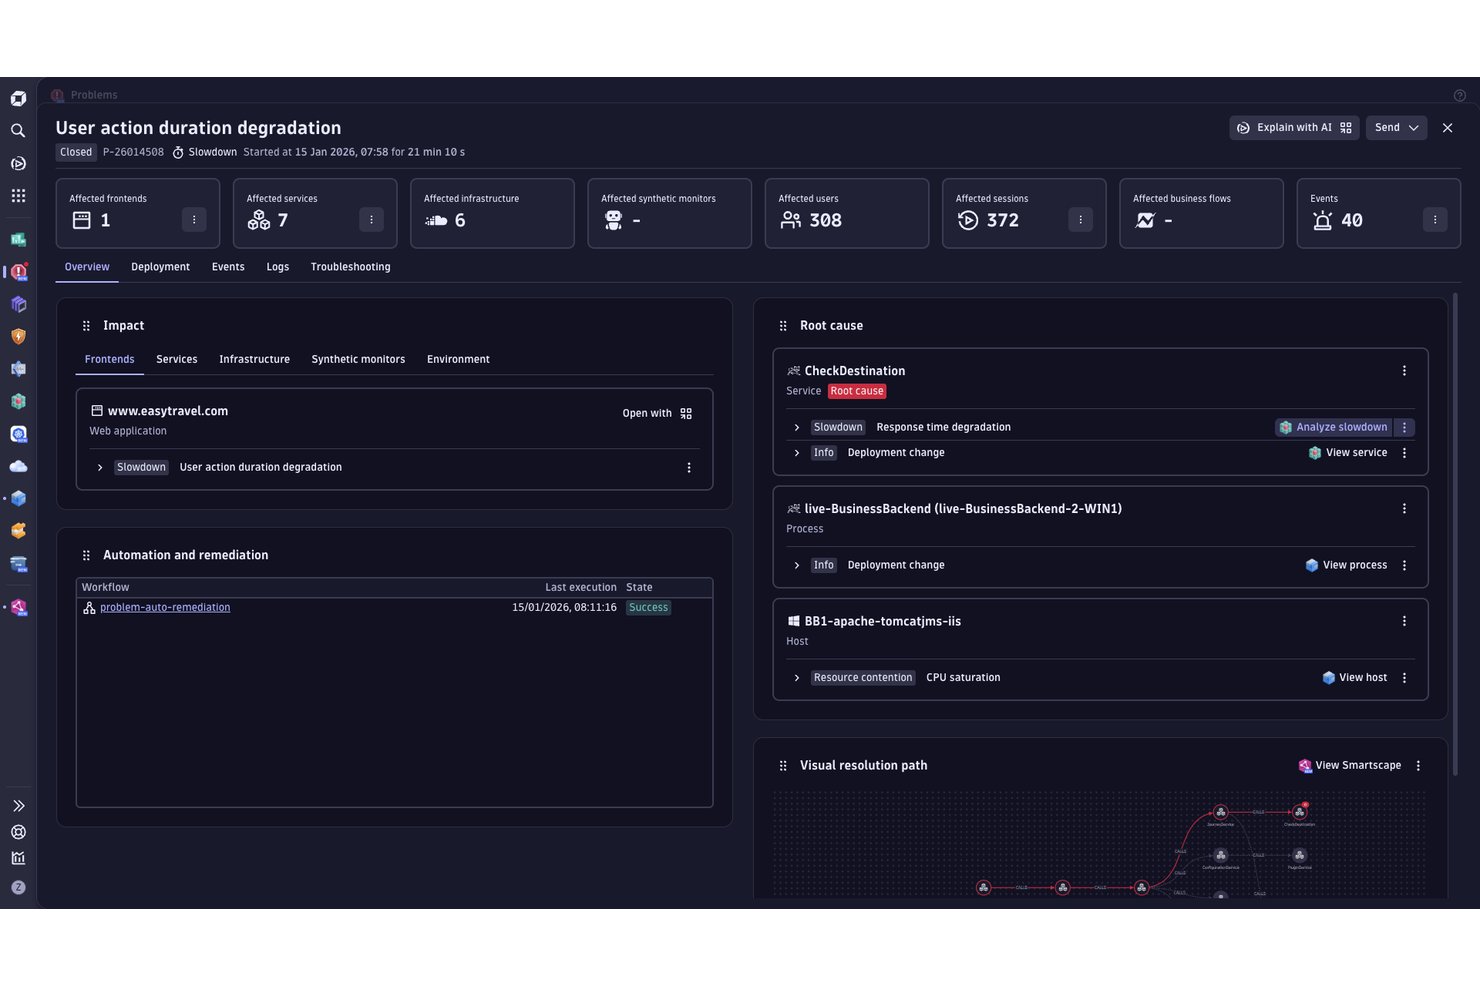
Dynatrace è una piattaforma completa per la gestione delle operazioni IT che comprende il monitoraggio dell'infrastruttura, il rilevamento degli incidenti basato sull'AIOps, l'analisi dei log e l'automazione dei flussi di lavoro in ambienti ibridi e multi-cloud.
Per chi è più adatto Dynatrace?
Dynatrace è particolarmente adatto ai team IT aziendali e SRE che gestiscono ambienti ibridi o multi-cloud complessi e necessitano di osservabilità basata sull'IA, risposta automatizzata agli incidenti e convalida dei rilasci su larga scala.
Perché ho scelto Dynatrace
Ho scelto Dynatrace come una delle soluzioni migliori perché il suo Site Reliability Guardian offre la configurazione di convalida dei rilasci più completa che abbia visto in questa categoria: valuta automaticamente ogni distribuzione rispetto agli SLO e ai KPI predefiniti prima che il codice raggiunga la produzione, bloccando i rilasci problematici senza revisione manuale. Se a questo si aggiunge la capacità dell'IA Davis di ricondurre un'anomalia in produzione a un'unica causa principale tra miliardi di dipendenze attive, si ottiene una piattaforma che individua ciò che supera i controlli di qualità e spiega esattamente il motivo.
Funzionalità principali di Dynatrace
- Mappatura della topologia Smartscape: Rileva e visualizza automaticamente le dipendenze in tempo reale tra host, container, servizi e processi negli ambienti ibridi e multi-cloud.
- Lakehouse di dati Grail: Unifica metriche, log, tracce, eventi e segnali di sicurezza in un unico archivio senza indici, interrogabile tramite DQL senza configurazione dello schema.
- Generatore di flussi di lavoro AutomationEngine: Un editor visivo senza codice/a basso codice per creare flussi di lavoro di automazione basati sugli eventi o pianificati, fondati sui dati di osservabilità in tempo reale.
- Avvisi predittivi: Prevede le violazioni di capacità e prestazioni prima che si verifichino, utilizzando baseline comportamentali apprese continuamente per ogni componente monitorato.
Integrazioni di Dynatrace
Dynatrace offre oltre 900 integrazioni tramite Dynatrace Hub, tra cui ServiceNow, Jira Service Management, PagerDuty, Slack, Microsoft Teams, AWS, Azure, Google Cloud e OpenTelemetry. La sua API REST, i webhook e l'SDK AppEngine supportano integrazioni personalizzate.
Pros and Cons
Pros:
- Un unico agente rileva automaticamente le risorse dello stack completo
- L'IA Davis individua la vera causa principale
- Risoluzione automatizzata con controlli con supervisione umana
Cons:
- I prezzi basati sul consumo rendono difficile la pianificazione del budget
- L'uso esclusivo del modello SaaS limita le opzioni per le esigenze di ambienti isolati
Ideale per la gestione delle cause principali, dagli avvisi alla topologia, basata sull'intelligenza artificiale
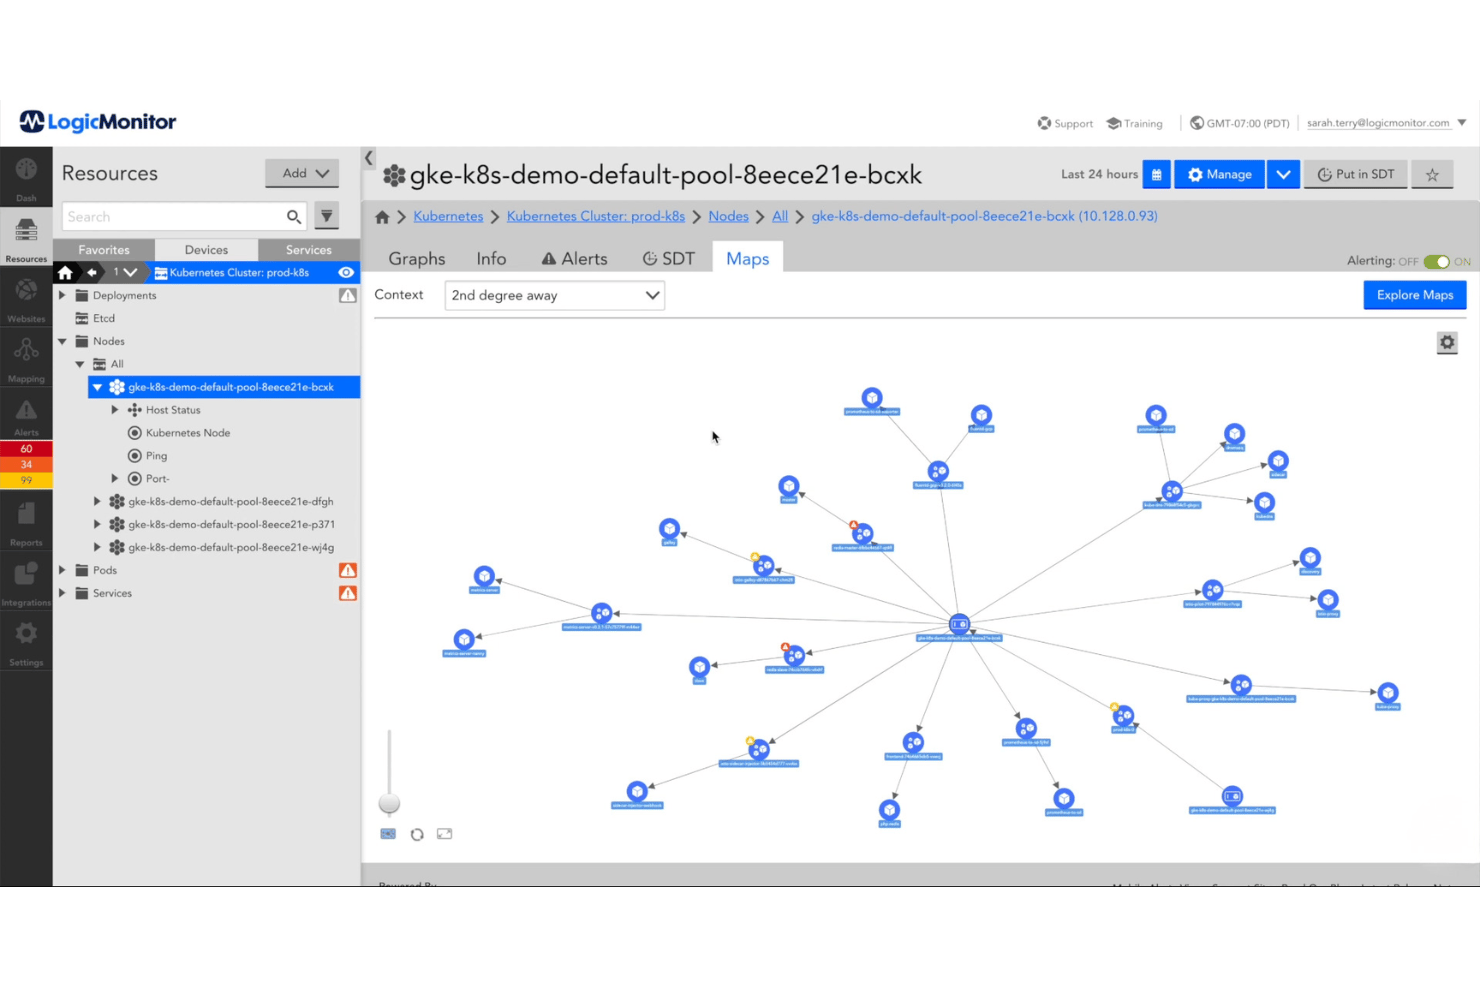
LogicMonitor è una piattaforma completa per la gestione delle operazioni IT che copre il monitoraggio dell'infrastruttura, della rete, del cloud, dei container e delle applicazioni, oltre alla correlazione degli avvisi basata su AIOps, alla mappatura della topologia e all'analisi dei log in un'unica piattaforma unificata.
Per chi è più indicato LogicMonitor?
LogicMonitor è particolarmente adatto ai team responsabili delle operazioni infrastrutturali e di rete che gestiscono grandi ambienti ibridi distribuiti tra infrastrutture locali e più cloud.
Perché ho scelto LogicMonitor
LogicMonitor è entrato nella mia rosa di candidati soprattutto per la stretta integrazione tra la correlazione degli avvisi e l'analisi delle cause principali basata sulla topologia. Edwin AI riduce le ondate di avvisi a incidenti prioritari e spiegabili, mentre il grafo di contesto ITOps combina topologia, dati telemetrici e informazioni sulle modifiche, consentendo di individuare una probabile causa principale in pochi minuti anziché in ore. Ho visto team ridurre il rumore degli avvisi del 78% dopo l'implementazione di Edwin AI, il che significa che gli ingegneri reperibili dedicano meno tempo alla selezione del rumore e più tempo alla risoluzione del problema effettivo.
Funzionalità principali di LogicMonitor
- Monitoraggio completo dell'infrastruttura: Monitora server, dispositivi di rete, macchine virtuali, database, sistemi di archiviazione e container negli ambienti ibridi da un'unica piattaforma.
- LM Exchange: Offre accesso a oltre 2.000 LogicModule preconfigurati per fornitori cloud, apparecchiature di rete, database e applicazioni.
- Analisi e intelligenza dei log: Correla i dati dei log con le metriche in tempo reale, consentendo di analizzare gli incidenti senza passare da uno strumento all'altro.
- Integrazioni ITSM bidirezionali: Sincronizza i cicli di vita degli avvisi e dei ticket con ServiceNow, Jira Service Management, PagerDuty, ConnectWise e Autotask.
Integrazioni di LogicMonitor
LogicMonitor offre oltre 2.000 integrazioni disponibili nel marketplace tramite LM Exchange, oltre a integrazioni native con ServiceNow, Jira Service Management, PagerDuty, ConnectWise e Datto Autotask. Un'API REST documentata supporta le integrazioni personalizzate.
Pros and Cons
Pros:
- Riduce il rumore degli avvisi con Edwin AI
- Mappa la topologia per un'analisi rapida delle cause principali
- Pannelli di controllo personalizzabili per diversi ruoli IT
Cons:
- La struttura dei prezzi è difficile da comprendere
- Le modifiche all'interfaccia rendono difficile la navigazione
La soluzione migliore per l'osservabilità completa a livello di transazione
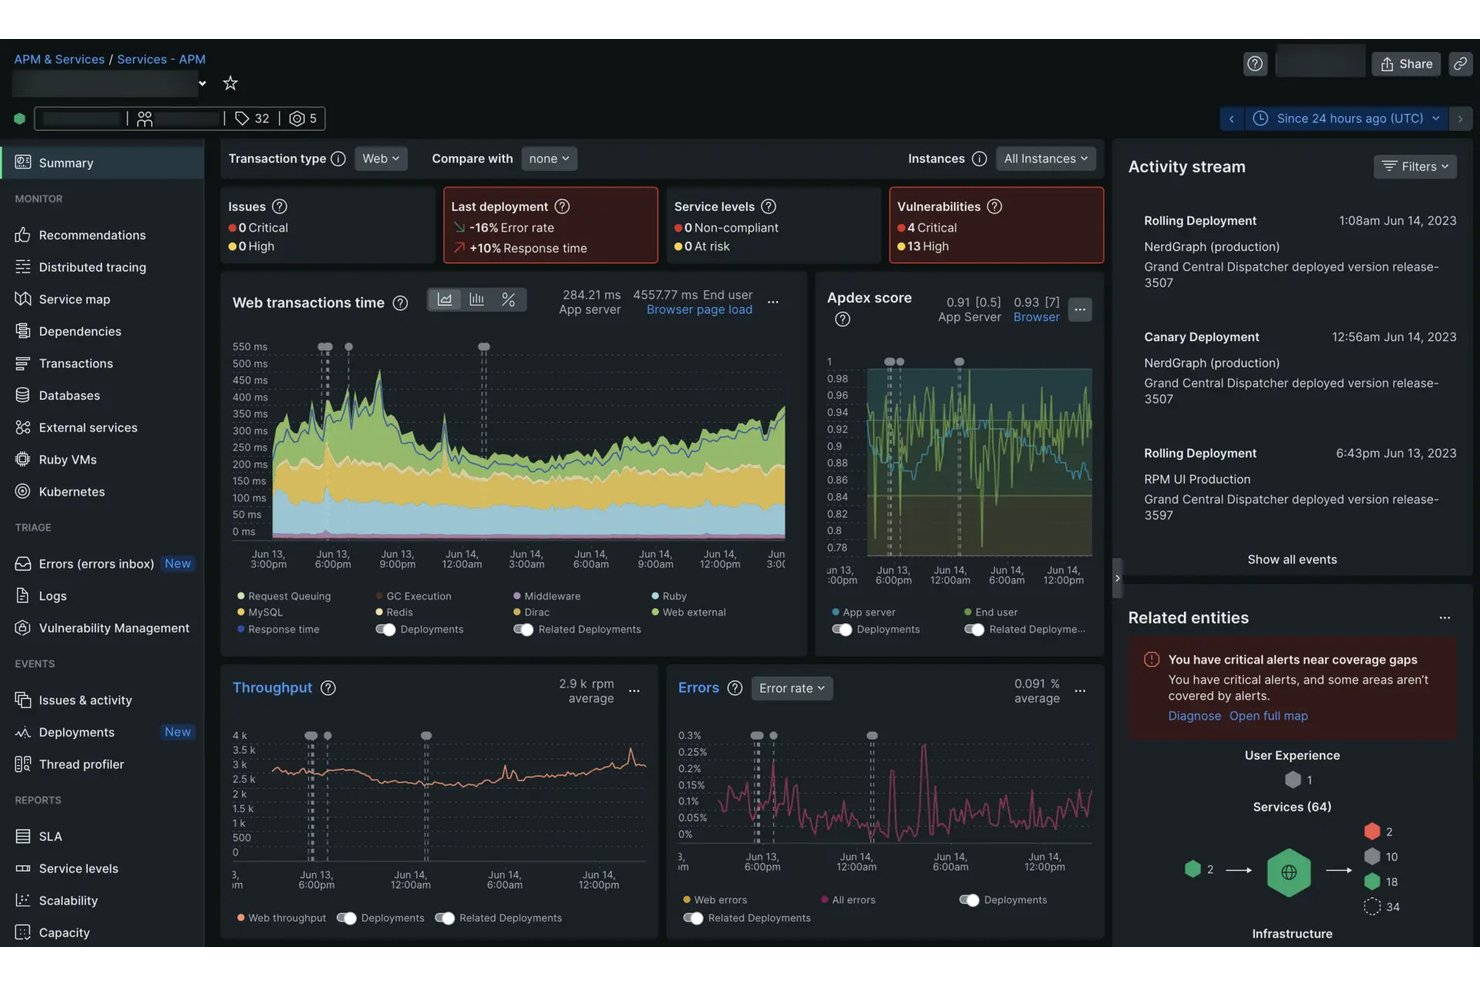
New Relic è una piattaforma di osservabilità dell'intero stack che unifica metriche, log, tracce e dati sull'esperienza digitale provenienti da infrastrutture, applicazioni, ambienti di cloud computing e reti in un'unica interfaccia.
Per chi è più indicato New Relic?
New Relic è particolarmente adatto agli SRE e agli ingegneri delle infrastrutture che gestiscono ambienti di produzione complessi e ad alto traffico, dove la visibilità a livello di transazione sull'intero stack è imprescindibile.
Perché ho scelto New Relic
New Relic è entrato nella mia rosa di candidati soprattutto grazie a Transaction 360, che correla telemetria, avvisi e modifiche alle distribuzioni a livello di singola transazione e riduce l'MTTR fino a 5 volte. Apprezzo anche il modo in cui gli agenti Autopilot analizzano autonomamente gli incidenti utilizzando la telemetria in tempo reale e le procedure operative, quindi presentano un ragionamento trasparente e verificabile invece di limitarsi ad avviare un'azione correttiva. È questa combinazione di tracciamento a livello di transazione e risoluzione agentica degli incidenti a rendere New Relic la mia soluzione di riferimento per l'osservabilità dell'intero stack.
Funzionalità principali di New Relic
- Avvisi intelligenti: La regolazione dinamica delle soglie utilizza la volatilità storica per ridurre al minimo i falsi positivi e indirizza automaticamente gli avvisi al team corretto utilizzando le etichette delle entità.
- Intelligence sui costi del cloud: Monitoraggio dei costi in tempo reale su AWS, Azure, GCP e Kubernetes, con consigli sul dimensionamento ottimale basati sui modelli di utilizzo effettivi e avvisi al superamento delle soglie di budget.
- Automazione dei flussi di lavoro: Un'area di lavoro senza codice con funzionalità di trascinamento consente di creare flussi di lavoro di risoluzione in più passaggi con logica condizionale, cicli e query NRQL in tempo reale.
- Log federati: È possibile interrogare i log direttamente dai contenitori S3 senza reimportazione o spostamento dei dati, supportando i requisiti di localizzazione dei dati e conformità.
Integrazioni di New Relic
New Relic offre oltre 800 integrazioni predefinite, tra cui ServiceNow, Jira, PagerDuty, Slack, Microsoft Teams, AWS, Azure, Google Cloud Platform, Kubernetes e VMware. NerdGraph, REST API, webhook, OpenTelemetry e il supporto Prometheus consentono connettività personalizzata.
Pros and Cons
Pros:
- Correla istantaneamente metriche, log e tracce
- Automatizza l'instradamento degli avvisi utilizzando le etichette delle entità
- Analisi trasparente degli incidenti basata sull'IA
Cons:
- I prezzi basati sul consumo possono aumentare rapidamente
- La conservazione estesa dei dati richiede un aggiornamento a pagamento

Ideale per operazioni IT ibride basate su CMDB su larga scala
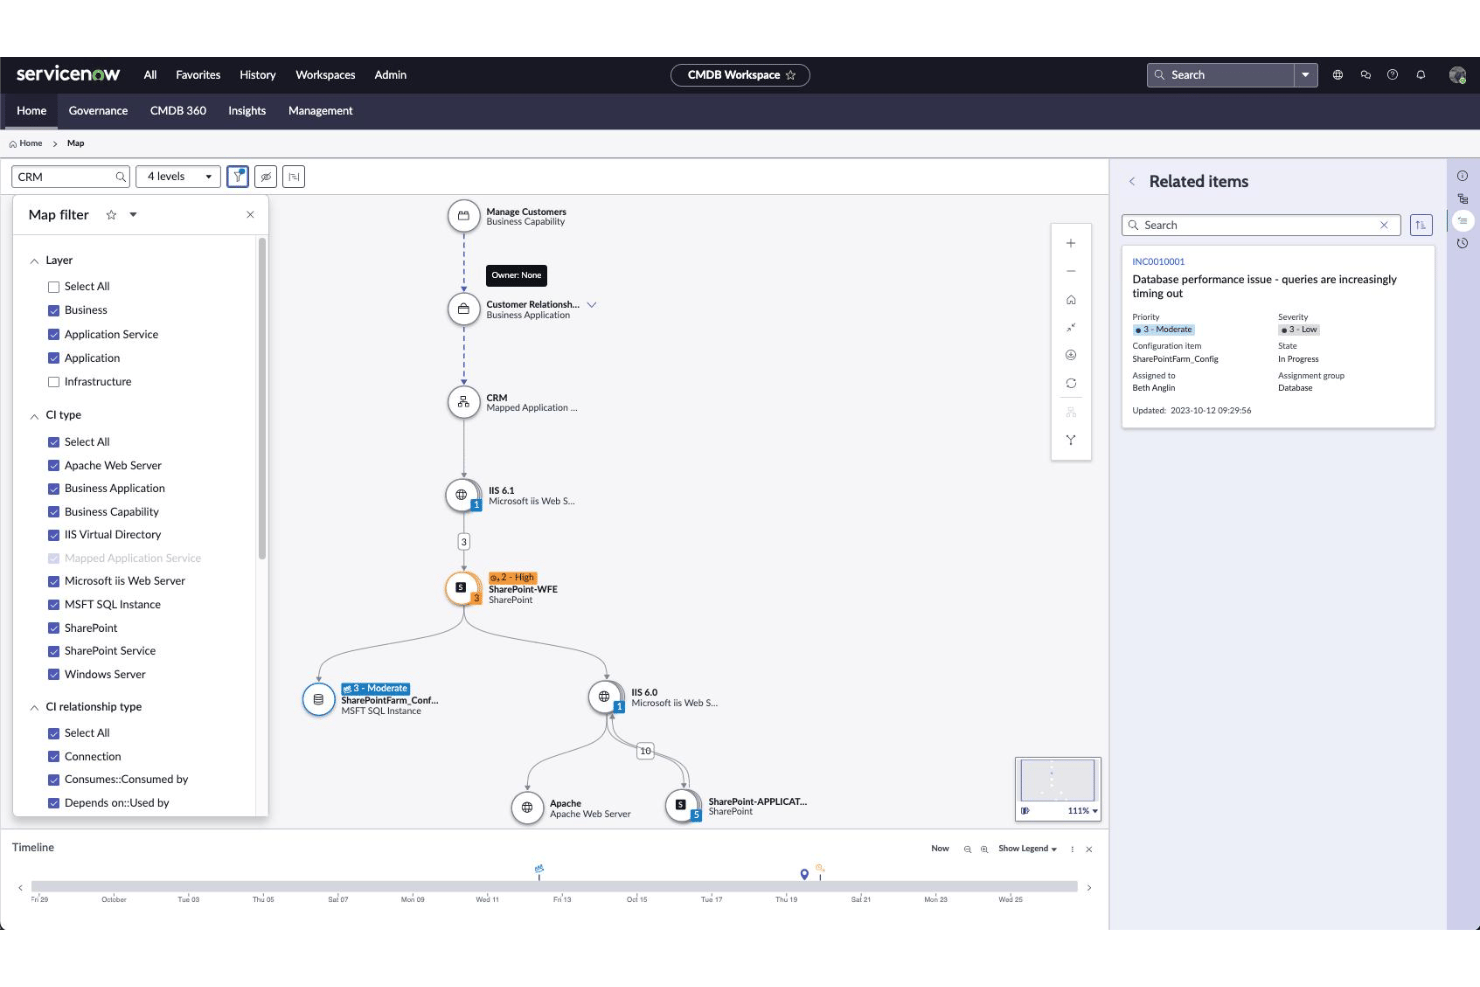
ServiceNow ITOM è una piattaforma aziendale per la gestione delle operazioni IT, basata su una CMDB continuamente aggiornata, che offre rilevamento senza agenti, gestione degli eventi basata sull'AIOps, mappatura dei servizi, visibilità sul cloud e orchestrazione automatizzata negli ambienti ibridi e multi-cloud.
Per chi è più adatto ServiceNow ITOM?
ServiceNow ITOM è progettato per le grandi aziende che gestiscono ambienti IT ibridi complessi, in cui una CMDB continuamente aggiornata costituisce la spina dorsale operativa.
Perché ho scelto ServiceNow ITOM
ServiceNow ITOM si è guadagnato un posto nella mia rosa di prodotti perché qui la CMDB non è solo un database: è la spina dorsale operativa in tempo reale, alimentata continuamente da Discovery e dai Service Graph Connectors con dati reali provenienti dall'intero ambiente ibrido. Apprezzo in particolare il modo in cui Service Mapping crea automaticamente visualizzazioni delle dipendenze tra infrastruttura e servizi aziendali, così quando un'istanza AWS presenta prestazioni degradate è possibile vedere esattamente quali servizi sono interessati prima che gli utenti se ne accorgano. AIOps LEAP fa un ulteriore passo avanti analizzando gli incidenti chiusi per generare e distribuire playbook di rimedio automatizzati, completo di un cruscotto ROI che tiene traccia dei risparmi effettivamente ottenuti.
Funzionalità principali di ServiceNow ITOM
- Analisi dei log dello stato: utilizza l'intelligenza artificiale per analizzare i dati dei log in tempo reale, segnalando le anomalie e mettendo in evidenza i suggerimenti di rimedio prima che i problemi si aggravino.
- Monitoraggio sintetico: simula le transazioni degli utenti finali per rilevare problemi di disponibilità e prestazioni prima che gli utenti reali ne siano interessati.
- Accelerazione del cloud: automatizza il provisioning e il deprovisioning delle risorse cloud, applicando al contempo criteri di tagging, costi e sicurezza in AWS, Azure e GCP.
- Gestione dei certificati: rileva e tiene automaticamente traccia dei certificati TLS/PKI presenti nell'ambiente e attiva i flussi di lavoro di rinnovo prima della scadenza.
Integrazioni di ServiceNow ITOM
ServiceNow ITOM si integra con AWS, Microsoft Azure, Google Cloud Platform, Alibaba Cloud, Datadog, Dynatrace, Splunk, PagerDuty, Jenkins e GitHub. Le API REST e SOAP, i webhook e le integrazioni di ServiceNow Store supportano la connettività personalizzata.
Pros and Cons
Pros:
- La CMDB offre visibilità sulle operazioni in tempo reale
- La GenAI automatizza il triage e il rimedio degli incidenti
- Il rilevamento multi-cloud copre AWS, Azure e GCP
Cons:
- Solo SaaS, senza opzione di installazione autonoma
- Le funzionalità avanzate richiedono licenze separate per i moduli

Ideale per le operazioni di integrità dei servizi tra più domini negli ambienti nativi Cisco
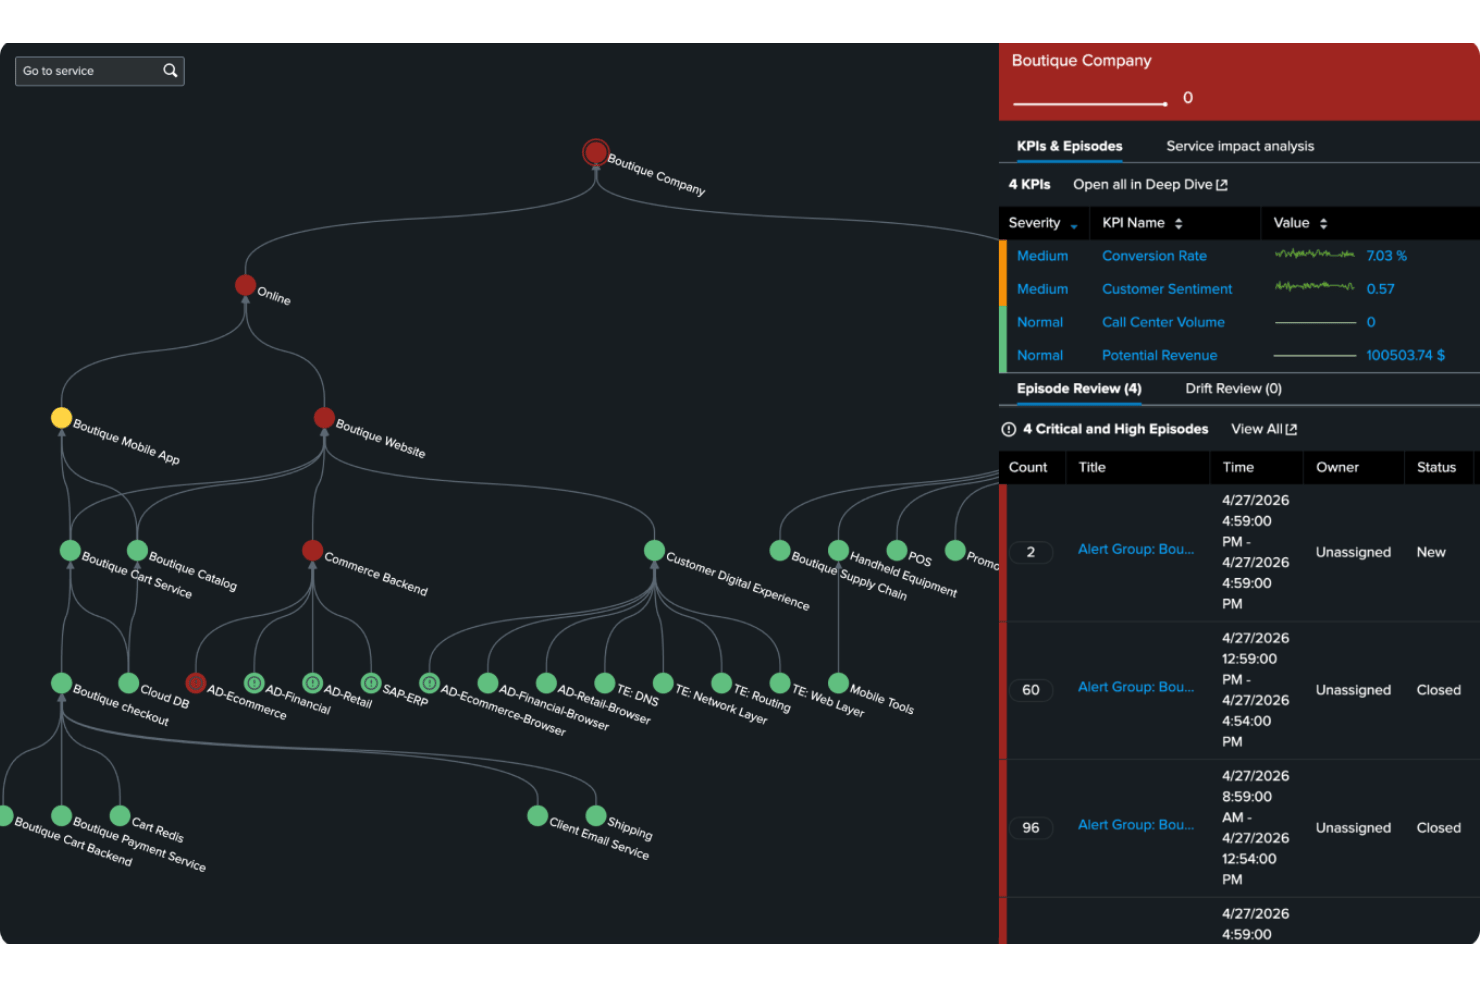
Splunk IT Service Intelligence (ITSI) è una piattaforma di gestione delle operazioni IT basata sull'AIOps che offre una valutazione dell'integrità dei servizi basata su KPI, correlazione degli avvisi tramite IA, mappatura della topologia e visibilità trasversale su infrastrutture, applicazioni e reti.
Per chi è più adatto Splunk IT Service Intelligence?
Splunk ITSI è particolarmente adatto ai team aziendali addetti alle operazioni IT, soprattutto a quelli che utilizzano già Splunk o operano in ambienti Cisco, e che hanno bisogno di correlare l'integrità dei servizi tra infrastrutture, applicazioni e reti su larga scala.
Perché ho scelto Splunk IT Service Intelligence
Splunk ITSI si è guadagnato un posto nella mia rosa di soluzioni preferite per il modo in cui gestisce l'integrità dei servizi tra più domini negli ambienti nativi Cisco. Apprezzo il fatto che acquisisca direttamente i segnali da Cisco ThousandEyes, Meraki e Catalyst Center e li integri nel suo modello di valutazione dell'integrità basato su KPI, evitando di dover assemblare manualmente la visibilità dalla rete alle applicazioni. Il suo motore Event iQ correla quindi questi segnali in episodi consolidati, riducendo il rumore degli avvisi prima che il team perda tempo con i duplicati.
Funzionalità principali di Splunk IT Service Intelligence
- Tabelle di vetro: Crea dashboard perfette al pixel, con elementi trascinabili, che associano i punteggi di integrità dei servizi in tempo reale a KPI aziendali come il raggiungimento degli SLA o l'impatto sui ricavi.
- Soglie adattive: I modelli di apprendimento automatico definiscono nel tempo il comportamento normale di ciascun KPI, attivando avvisi in caso di deviazioni statistiche anziché al superamento di soglie fisse.
- Area di lavoro per la revisione degli episodi: Un'interfaccia centralizzata per il triage in cui i gruppi di avvisi correlati dall'IA vengono presentati con valutazione della gravità, contesto del servizio interessato e passaggi successivi consigliati.
- Modellazione delle dipendenze dei servizi: Definisci e visualizza le relazioni gerarchiche tra servizi aziendali, sottoservizi, host e dispositivi di rete per isolare più rapidamente le cause principali.
Integrazioni di Splunk IT Service Intelligence
Splunk IT Service Intelligence si integra con ServiceNow, PagerDuty, Jira Cloud, Cisco ThousandEyes, Cisco Catalyst Center, Cisco Meraki, Splunk Observability Cloud, AppDynamics e Red Hat Ansible Automation Platform. Offre inoltre integrazioni del marketplace Splunkbase, accesso tramite API REST, SDK Python, webhook e Kafka.
Pros and Cons
Pros:
- Correlazione e triage avanzati degli avvisi basati sull'IA
- Monitoraggio unificato tra più domini per gli ambienti Cisco
- Dashboard altamente personalizzabili per le metriche aziendali
Cons:
- Elevati requisiti di risorse per le implementazioni di grandi dimensioni
- Complessità di implementazione per la modellazione di servizi ed entità
Ideale per l'IA agentica nelle operazioni dal mainframe al cloud
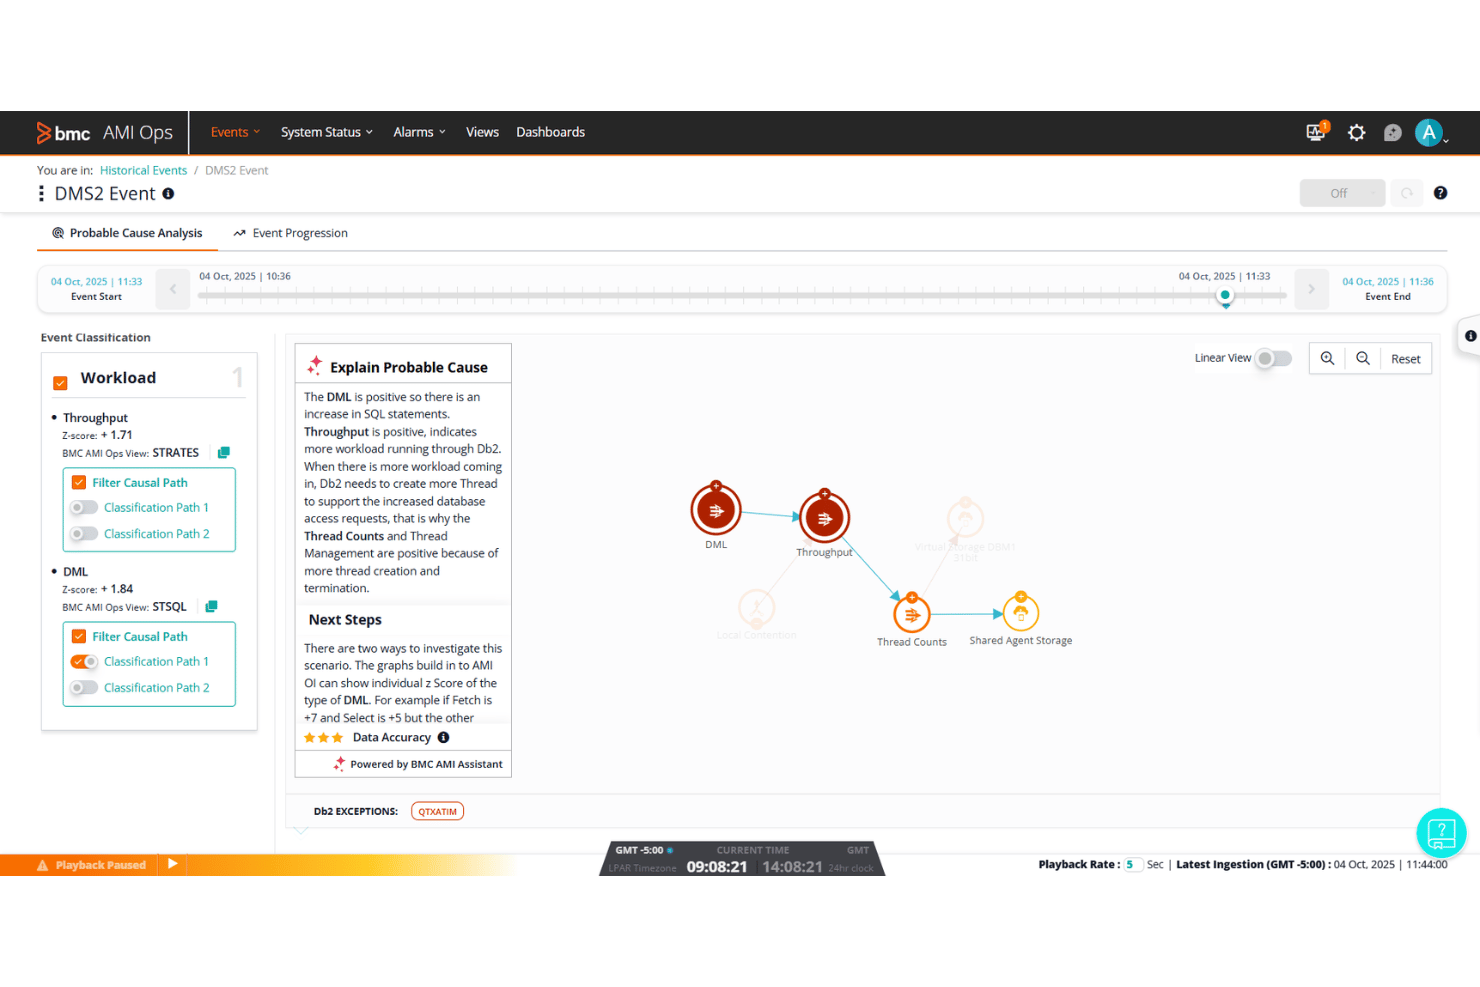
BMC Helix AIOps è una piattaforma di gestione delle operazioni IT nativa per il cloud che unifica il monitoraggio degli eventi, la correlazione degli incidenti basata sull'IA, la correzione automatizzata e la mappatura della topologia negli ambienti locali, cloud e mainframe.
Per chi è più adatto BMC Helix AIOps?
BMC Helix AIOps è progettato per le grandi aziende che gestiscono ambienti ibridi complessi, comprendenti sistemi mainframe, infrastrutture locali e più cloud pubblici.
Perché ho scelto BMC Helix AIOps
BMC Helix AIOps si è guadagnato un posto nella mia lista ristretta perché è una delle poche piattaforme che ho visto coprire realmente l'intero ambito, dal mainframe al cloud, senza trascurare nessuna delle due estremità. Mi affido alle funzionalità di IA agentica di HelixGPT, in particolare Agent Builder e Ops Swarmer, per gestire il triage autonomo degli incidenti negli ambienti z/OS e nei cluster Kubernetes all'interno dello stesso flusso di lavoro. La correlazione delle situazioni basata sull'IA riduce il rumore degli avvisi fino al 90%, il che in pratica significa che il mio team non è sommerso da avvisi duplicati distribuiti su 600 pannelli di controllo.
Funzionalità principali di BMC Helix AIOps
- Analisi della causa probabile: l'IA mette in correlazione i dati della topologia e degli eventi per identificare la causa principale più probabile di una situazione prima che inizi l'indagine manuale.
- Analizzatore HelixGPT per le analisi successive agli incidenti: genera automaticamente riepiloghi dettagliati delle revisioni successive agli incidenti per supportare i team SRE e operativi dopo la risoluzione.
- Creazione dinamica dei modelli dei servizi: si integra con BMC Helix Discovery per generare automaticamente e aggiornare continuamente modelli dei servizi che mappano le dipendenze nel tuo ambiente ibrido.
- Visualizzazioni dei pannelli di controllo basate sui ruoli: segmenta i dati operativi e i report in base al ruolo, offrendo a ogni membro del team una visualizzazione filtrata delle metriche e degli eventi rilevanti per la sua funzione.
Integrazioni di BMC Helix AIOps
BMC Helix AIOps si integra con BMC Helix ITSM, ServiceNow, AWS, Azure, Google Cloud Platform, Microsoft Teams, Slack, BMC Helix Discovery e Jitterbit. Supporta inoltre API REST, connettività CMDB, strumenti di monitoraggio di terze parti e la distribuzione tramite AWS Marketplace.
Pros and Cons
Pros:
- Monitoraggio nativo di ambienti mainframe e cloud ibridi
- Riduzione del rumore degli avvisi basata sull'IA fino al 90%
- Mappatura automatizzata della topologia e delle dipendenze inclusa
Cons:
- La configurazione richiede una notevole competenza tecnica
- La personalizzazione del pannello di controllo è meno intuitiva rispetto a quella dei concorrenti
Altri software per la gestione delle operazioni IT
Ecco alcune opzioni aggiuntive di software per la gestione delle operazioni IT che non sono state incluse nella mia selezione, ma che vale comunque la pena prendere in considerazione:
- Datadog
La scelta migliore per la telemetria unificata con FinOps integrato
- ManageEngine OpManager
La soluzione migliore per l'automazione senza codice dei flussi di lavoro dalla rilevazione degli errori alla risoluzione
- BigPanda
Ideale per la valutazione del rischio dei cambiamenti basata sull'intelligenza artificiale
- PagerDuty
Ideale per la risposta agli incidenti durante la reperibilità su larga scala
- Zabbix
Ideale per il monitoraggio operativo open source a qualsiasi scala
- Moogsoft
Ideale per la riduzione del rumore degli avvisi basata sul ML
- Checkmk
Ideale per prezzi basati sui servizi per infrastrutture ibride
- Ivanti Neurons
Ideale per l'automazione IT e SecOps basata sull'ITSM
- Grafana Cloud
Ideale per l'osservabilità delle operazioni full-stack guidata dal ML
- SolarWinds Observability SaaS
Ideale per l'osservabilità full-stack basata su NetOps


How I Evaluate IT Operations Management Software
When an alert storm hits at 2 a.m. and your team needs to trace a degraded API back to a misconfigured container in a hybrid cluster, the tools either hold up or they don't—so I split my evaluation into baseline functionality every platform must cover and the differentiators that separate good from great.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. I then calculate the tool's total score into a percentage, using 75% as a benchmark to help assess its overall fit for the list.
- Infrastructure & App Monitoring: I check whether the platform covers servers, networks, apps, and cloud resources with real-time metrics, logs, and traces.
- Alerting & Incident Management: Each tool's alert correlation, escalation policies, and incident workflows matter—especially how well it cuts through noise during an outage.
- IT Automation & Orchestration: I look for visual workflow builders, auto-remediation playbooks, and cross-platform runbooks that reduce manual toil on recurring tasks.
- Hybrid & Multi-Cloud Visibility: Unified dashboards across on-prem, AWS, Azure, and GCP are table stakes—I evaluate topology mapping and dynamic discovery depth.
- Reporting & Analytics Dashboards: Customizable dashboards with drill-downs, SLA/SLO tracking, and capacity forecasting tell me how well a tool supports planning conversations.
- Integrations & API Access: I evaluate prebuilt connectors to ITSM, DevOps, and chatops tools, plus REST API coverage for teams that need to build custom workflows.
Once I have a list of tools that meet the criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
I evaluate how well each platform's AIOps engine baselines normal behavior and correlates related events into a single incident—during a noisy outage, the difference between 200 alerts and one actionable incident is hours of recovery time. Topology and dependency mapping matters just as much: I check whether the tool auto-discovers relationships across containers, hosts, and network paths so you can trace a failing checkout API back to an undersized pod without switching screens. I also look at built-in cloud cost visibility, since platforms like Datadog and Dynatrace now tie resource utilization directly to spend, helping you spot idle workloads before finance does.
Beyond Features
I evaluate total cost of ownership closely because ingestion-based pricing can spiral fast—adding custom metrics or doubling log volume in platforms like Datadog or New Relic often triggers surprise overages that dwarf the original quote. Deployment flexibility matters just as much; I check whether a vendor offers SaaS, self-hosted, and air-gapped options, since regulated industries frequently need on-prem control that pure-SaaS tools can't deliver. I also look at ecosystem depth, specifically bidirectional ITSM integrations and open API coverage, so operations data flows into existing DevOps and ChatOps workflows without custom glue code.
Come scegliere il software per la gestione delle operazioni IT
Quando decidi quale software per la gestione delle operazioni IT si adatta meglio al tuo ambiente, inizia concentrandoti sulle sfide operative più urgenti:
| Se la tua priorità è... | Cerca... |
|---|---|
| Un'analisi rapida e accurata delle cause principali | Correlazione degli incidenti basata sull'IA e procedure operative automatizzate |
| Ambienti ibridi e multi-cloud | Connettori nativi per ambienti on-premise, AWS, Azure e GCP |
| Ridurre le attività manuali di risoluzione | Strumenti visivi per la creazione di flussi di lavoro con automazioni preconfigurate |
| Controllare la spesa relativa al monitoraggio | Prezzi trasparenti basati sull'utilizzo e dashboard dei costi |
| Integrazioni approfondite con gli strumenti ITSM | Connettori preconfigurati e documentazione delle API aperte |
Come valutare la tua selezione
- Testa i flussi di lavoro per il triage degli incidenti: Esegui una prova di 48 ore e simula almeno tre tipi di interruzione per verificare il raggruppamento degli incidenti e le risposte automatizzate.
- Richiedi una demo della mappa della topologia: Chiedi al fornitore di generare una mappa delle dipendenze end-to-end, inclusi i cluster ibridi, utilizzando dati di esempio reali o anonimizzati.
- Apri un ticket multipiattaforma: Apri un ticket di supporto facendo riferimento a un'integrazione multi-cloud e documenta l'accuratezza delle risposte e gli SLA in un periodo di 3 giorni.
- Valuta la completezza dei report: Esamina o esporta una dashboard analitica di esempio e conferma la visibilità su costi, SLA e metriche personalizzate per il tuo stack effettivo.
- Agilità del SaaS rispetto al controllo dell'hosting autonomo: Decidi se il rapido rilascio di funzionalità nel SaaS prevale sulle esigenze di conformità e accesso soddisfatte dalle implementazioni on-premise o isolate.
Che cos'è il software per la gestione delle operazioni IT?
Il software per la gestione delle operazioni IT è una categoria di strumenti progettati per monitorare, automatizzare e gestire infrastrutture IT, applicazioni, reti e servizi in ambienti on-premise e cloud. Queste piattaforme aiutano il tuo team a centralizzare gli avvisi, mantenere l'integrità dei sistemi, gestire gli incidenti e ottimizzare l'utilizzo delle risorse. Consolidando i dati delle operazioni e l'automazione, il software per la gestione delle operazioni IT favorisce una risoluzione dei problemi più rapida, migliora l'efficienza e consente alla tua organizzazione di scalare la tecnologia in modo affidabile.
Funzionalità del software per la gestione delle operazioni IT
Quando scegli un software per la gestione delle operazioni IT, presta attenzione alle seguenti funzionalità chiave:
- Monitoraggio dell'infrastruttura e delle applicazioni: Tiene traccia in tempo reale di server, reti, container e applicazioni. Ti aiuta a individuare comportamenti anomali del sistema, prestazioni ridotte o interruzioni prima che gli utenti ne risentano.
- Gestione degli avvisi e degli incidenti: Centralizza gli avvisi e semplifica i flussi di lavoro per l'escalation. Consente al tuo team di rispondere rapidamente, contestualizzare gli incidenti e monitorare la risoluzione dall'inizio alla fine.
- Automazione e orchestrazione: Fornisce strumenti per automatizzare le attività di routine e coordinare i flussi di lavoro tra ambienti diversi. Riduce il lavoro manuale e limita gli errori umani durante le distribuzioni o la manutenzione.
- Supporto per ambienti ibridi e multi-cloud: Offre una visibilità unificata su infrastrutture on-premise, cloud privato e cloud pubblico. Ti aiuta a gestire ambienti complessi come un'unica entità operativa.
- Dashboard e report personalizzabili: Ti consente di creare dashboard e report su misura per le tue esigenze. Supporta l'analisi delle tendenze, il monitoraggio degli SLA e la condivisione degli approfondimenti con gli stakeholder tecnici e aziendali.
- Integrazione e accesso API: Si connette alle piattaforme ITSM, DevOps e di collaborazione. Consente al tuo team di integrare i dati delle operazioni IT direttamente nei sistemi di ticketing, chat e altri sistemi.
- Mappatura della topologia e delle dipendenze: Visualizza le relazioni tra sistemi, servizi e componenti dell'infrastruttura. Semplifica l'individuazione della causa principale degli incidenti e la comprensione del rischio operativo.
- Controllo degli accessi basato su utenti e ruoli: Ti consente di definire chi può visualizzare o modificare parti del tuo ambiente. Protegge i dati sensibili e limita l'esposizione in base alle responsabilità degli utenti.
- Pianificazione e previsione della capacità: Analizza le tendenze nel consumo delle risorse per prevedere le esigenze future. Ti aiuta ad anticipare gli aggiornamenti dell'infrastruttura e a pianificare il budget per la crescita.
- Monitoraggio delle modifiche e registri di controllo: Registra le modifiche alla configurazione e le azioni degli utenti. Supporta i requisiti di conformità e aiuta a risolvere gli incidenti passati fornendo una cronologia chiara delle modifiche.
Funzionalità comuni dell'intelligenza artificiale nei software per la gestione delle operazioni IT
Oltre alle funzionalità standard del software per la gestione delle operazioni IT elencate sopra, molte di queste soluzioni stanno integrando l'intelligenza artificiale con funzionalità come:
- Rilevamento delle anomalie basato sull'intelligenza artificiale: Utilizza l'apprendimento automatico per identificare automaticamente schemi o comportamenti insoliti nelle metriche di sistema, nei registri o nel traffico di rete. Aiuta il tuo team a individuare i problemi emergenti prima che si aggravino, anche quando le soglie non sono state impostate manualmente.
- Analisi automatizzata della causa principale: Applica algoritmi di intelligenza artificiale per correlare eventi, registri e dati sulle prestazioni nell'intero stack. Questa funzionalità individua la probabile origine degli incidenti, riducendo il tempo che il tuo team dedica alle indagini e accelerando il ripristino.
- Previsione predittiva degli incidenti: Utilizza i dati storici e i modelli di intelligenza artificiale per prevedere potenziali interruzioni o cali delle prestazioni. Ciò ti consente di adottare misure proattive per prevenire gli incidenti e pianificare la manutenzione in modo più efficace.
- Riduzione intelligente del rumore degli avvisi: Utilizza l'intelligenza artificiale per raggruppare gli avvisi correlati, eliminare i duplicati e assegnare priorità alle notifiche in base all'impatto e al contesto. Riduce l'affaticamento causato dagli avvisi e garantisce che il tuo team si concentri sui problemi più importanti.
- Suggerimenti di risoluzione basati sull'intelligenza artificiale: Analizza i dati degli incidenti e le risoluzioni precedenti per consigliare i passaggi successivi o le correzioni automatizzate. Aiuta il tuo team a rispondere più rapidamente e standardizza le migliori pratiche nelle operazioni.
Vantaggi del software per la gestione delle operazioni IT
L'implementazione di un software per la gestione delle operazioni IT offre diversi vantaggi al tuo team e alla tua azienda. Eccone alcuni che puoi aspettarti:
- Visibilità centralizzata: Unifica il monitoraggio di server, reti, applicazioni e risorse cloud tramite un'unica dashboard, così il tuo team può anticipare i problemi in tutti gli ambienti.
- Risoluzione più rapida degli incidenti: Utilizza l'aggregazione degli avvisi, la correlazione basata sull'IA e le funzionalità di analisi automatizzata delle cause alla radice per identificare, stabilire la priorità e rispondere rapidamente ai problemi operativi.
- Riduzione delle attività manuali: Automatizza le attività ricorrenti di manutenzione, risoluzione e gestione dei flussi di lavoro utilizzando strumenti preconfigurati di automazione e orchestrazione, liberando tempo per iniziative a maggior valore.
- Gestione proattiva dei rischi: Prevedi le interruzioni e i colli di bottiglia delle risorse con strumenti di rilevamento delle anomalie e previsione basati sull'IA, che evidenziano i potenziali problemi prima che si aggravino.
- Ottimizzazione dei costi e delle risorse: Monitora l'utilizzo dell'infrastruttura, le prestazioni delle applicazioni e la spesa per le risorse tramite funzionalità di reportistica e analisi, che ti aiutano a gestire i budget e a pianificare la capacità.
- Maggiore sicurezza e conformità: Affidati ai controlli degli accessi degli utenti, ai registri di controllo e alle funzionalità di tracciamento delle modifiche per mantenere protetti i dati sensibili e supportare i requisiti normativi.
- Integrazione perfetta con l'ecosistema: Collega le piattaforme ITSM, DevOps e di chat utilizzando integrazioni preconfigurate e API aperte, semplificando l'integrazione dei dati operativi nei processi di lavoro già utilizzati dal tuo team.
Costi e prezzi del software per la gestione delle operazioni IT
La scelta di un software per la gestione delle operazioni IT richiede la comprensione dei vari modelli di prezzo e dei piani disponibili. I costi variano in base alle funzionalità, alle dimensioni del team, ai componenti aggiuntivi e ad altri fattori. La tabella seguente riassume i piani più comuni, i relativi prezzi medi e le funzionalità generalmente incluse nelle soluzioni software per la gestione delle operazioni IT:
Tabella comparativa dei piani per il software di gestione delle operazioni IT
| Tipo di piano | Prezzo medio | Funzionalità comuni |
|---|---|---|
| Piano gratuito | $0 | Monitoraggio di base dell'infrastruttura, avvisi limitati, accesso per piccoli team e assistenza della comunità. |
| Piano personale | $10–$30/user/month | Monitoraggio in tempo reale, automazione di livello base, dashboard essenziali, integrazione con strumenti diffusi e assistenza via e-mail. |
| Piano aziendale | $40–$80/user/month | Monitoraggio dell'intero stack, gestione degli avvisi e degli incidenti, automazione dei flussi di lavoro, dashboard avanzate, accesso API e controllo degli accessi basato sui ruoli. |
| Piano per grandi aziende | $90–$200/user/month | Visibilità su ambienti ibridi e multi-cloud, funzionalità basate sull'IA, SLA personalizzati, supporto alla conformità, integrazioni dedicate e assistenza premium. |
Domande frequenti sul software per la gestione delle operazioni IT
Ecco alcune risposte alle domande comuni sul software per la gestione delle operazioni IT:
Come si confrontano diverse piattaforme software per la gestione delle operazioni IT?
Inizia elencando le funzionalità indispensabili, come il supporto multi-cloud, l’automazione e il livello di integrazione. Successivamente, prova le piattaforme utilizzando scenari di incidenti comuni e confronta il modo in cui ogni strumento gestisce gli avvisi, l’analisi delle cause principali e la reportistica. Anche il costo totale di proprietà, le integrazioni con l’ecosistema e la flessibilità di implementazione sono aspetti importanti da esaminare prima di prendere una decisione definitiva.
Il software per la gestione delle operazioni IT può automatizzare la risposta agli incidenti?
Sì, la maggior parte dei moderni software per la gestione delle operazioni IT consente di automatizzare la risposta agli incidenti tramite runbook, strumenti per la creazione di flussi di lavoro e persino correzioni automatiche basate sull’intelligenza artificiale. Questo aiuta a ridurre le attività manuali e garantisce una risposta coerente ai problemi ricorrenti.
Quali integrazioni dovrei cercare in un software per la gestione delle operazioni IT?
Cerca l’accesso alle API, connettori predefiniti per gli strumenti ITSM, come ServiceNow, le piattaforme di chat, come Slack o Microsoft Teams, e le pipeline DevOps. Le integrazioni avanzate consentono al tuo team di inviare avvisi, attivare flussi di lavoro e sincronizzare i ticket tra i sistemi esistenti senza middleware personalizzato.
Il software per la gestione delle operazioni IT aiuta a garantire la conformità e a effettuare gli audit?
Sì, un valido software per la gestione delle operazioni IT tiene traccia delle modifiche ai sistemi e delle azioni degli utenti e fornisce i registri di audit necessari per la conformità. Questo è particolarmente utile nei settori regolamentati, dove è necessario disporre di prove chiare dei controlli e di una cronologia completa delle modifiche per la reportistica.
Come posso evitare costi imprevisti con un software per la gestione delle operazioni IT?
Verifica sempre il metodo di fatturazione della piattaforma per l’acquisizione dei dati, le metriche personalizzate e le utenze. Scegli strumenti con prezzi trasparenti basati sull’utilizzo e dashboard dei costi integrate nell’applicazione, così da poter monitorare la spesa ed evitare addebiti imprevisti man mano che il tuo ambiente cresce.
Qual è il modo migliore per ottenere il consenso degli stakeholder per una nuova piattaforma di gestione delle operazioni IT?
Mostra in che modo la piattaforma aiuta a raggiungere gli obiettivi aziendali: risoluzione più rapida degli incidenti, gestione proattiva dei rischi e reportistica migliorata. Condividi i risultati di una demo o di un progetto pilota, evidenzia i miglioramenti attesi in termini di efficienza e collega le funzionalità ai problemi che gli stakeholder riconoscono.