

Honeycomb è uno strumento progettato per fornire informazioni sul funzionamento interno del tuo sistema, aiutandoti a ottimizzare le prestazioni e a risolvere i problemi.
I vantaggi sono numerosi: consente di tracciare i singoli eventi, rendendo osservabili i sistemi complessi e permettendoti di comprendere, imparare e correggere il tuo software.
Tuttavia, potrebbero esserci situazioni in cui desideri un'alternativa a Honeycomb. Forse utilizzi un linguaggio di programmazione specifico come PHP o hai bisogno di uno strumento che offra la conformità SOC. Potresti voler accedere al codice sorgente oppure cercare un insieme di funzionalità diverso.
Qualunque sia il motivo, ho compilato un elenco delle migliori alternative a Honeycomb, completo di informazioni sui prodotti e valutazioni a stelle, per aiutarti a trovare la soluzione più adatta alle tue esigenze specifiche. Quindi, entriamo nel vivo ed esploriamo insieme queste opzioni.
Che cos'è Honeycomb?
Honeycomb è una piattaforma di osservabilità che ti aiuta a eseguire il debug, monitorare e comprendere i tuoi sistemi software in tempo reale. Viene utilizzata da ingegneri del software, team DevOps e ingegneri dell'affidabilità dei siti che devono identificare rapidamente problemi di prestazioni e comportamenti insoliti in produzione. Le informazioni a livello di evento, le query e le mappe di calore aiutano ad analizzare il comportamento del sistema, individuare i colli di bottiglia e migliorare l'affidabilità delle applicazioni. Nel complesso, Honeycomb offre al tuo team un quadro più chiaro di ciò che accade nel codice, consentendoti di risolvere i problemi più rapidamente.
Perché fidarsi dei nostri consigli sui software
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Il nostro team testa e recensisce software dal 2012. In quanto leader tecnologici noi stessi, sappiamo quanto sia difficile — e importante — scegliere il software giusto.
Per questa guida, abbiamo valutato gli strumenti attraverso test praticie ricerche indipendenti, assegnando un punteggio agli strumenti in base ai nostri criteri di selezione.
Le nostre recensioni riflettono il nostro giudizio editoriale umano, non un discorso di vendita.
Revisori esperti:
- Paulo Gardini MiguelDirettore tecnico
 Tim FisherVP dell'IA
 Gabriel RosasTech Lead e architetto software
 Christhian GruhnTech Lead e architetto della piattaforma

Tabella di confronto delle alternative a Honeycomb
Questa tabella di confronto riassume i dettagli dei prezzi delle migliori alternative a Honeycomb che ho selezionato:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Ideale per il tracciamento distribuito ricco di contesto | Piano gratuito disponibile | A partire da $26/mese (fatturato annualmente) | Website | |
| 2 | Ideale per il monitoraggio automatizzato completo basato sull'intelligenza artificiale | Prova gratuita di 15 giorni | $21/user/month per il piano di monitoraggio completo (fatturato annualmente) | Website | |
| 3 | Ideale per riunire tracce, log e metriche in un'unica vista | Piano gratuito disponibile | $15/utente/mese (fatturato annualmente) | Website | |
| 4 | Ideale per il monitoraggio dell'infrastruttura open source su larga scala | Piano gratuito disponibile | Prezzi su richiesta | Website | |
| 5 | Ideale per il tracciamento end-to-end delle transazioni aziendali | Prova gratuita di 30 giorni | $3300 per unità all'anno (con fatturazione annuale) | Website | |
| 6 | Ideale per approfondimenti sulle prestazioni applicative e monitoraggio dell'esperienza utente finale | Piano gratuito disponibile | $99/mese per il piano Pro (fatturato annualmente) | Website | |
| 7 | La scelta migliore per la gestione e l'analisi dei log nativi per il cloud | Prova gratuita di 14 giorni | Prezzi su richiesta | Website | |
| 8 | Ideale per il monitoraggio e l'invio di avvisi sui log basati sul volume | Prova gratuita di 30 giorni | Prezzi su richiesta | Website | |
| 9 | Ideale per l’intelligenza operativa basata sui dati delle macchine | Prova gratuita di 60 giorni | $150/mese (con fatturazione annuale) | Website | |
| 10 | Ideale per metriche e avvisi nativi di Kubernetes | Piano gratuito disponibile | Prezzo su richiesta | Website |


Recensioni delle migliori alternative a Honeycomb
Di seguito sono riportati i miei riepiloghi dettagliati delle migliori alternative a Honeycomb incluse nel mio elenco. Le mie recensioni offrono un’analisi dettagliata delle funzionalità principali, dei vantaggi e degli svantaggi, delle integrazioni e dei casi d’uso ideali di ogni strumento, per aiutarti a trovare quello più adatto a te.
 Ideale per il tracciamento distribuito ricco di contesto
- Piano gratuito disponibile
- A partire da $26/mese (fatturato annualmente)
Visit WebsiteCustomer Rating:4.5/5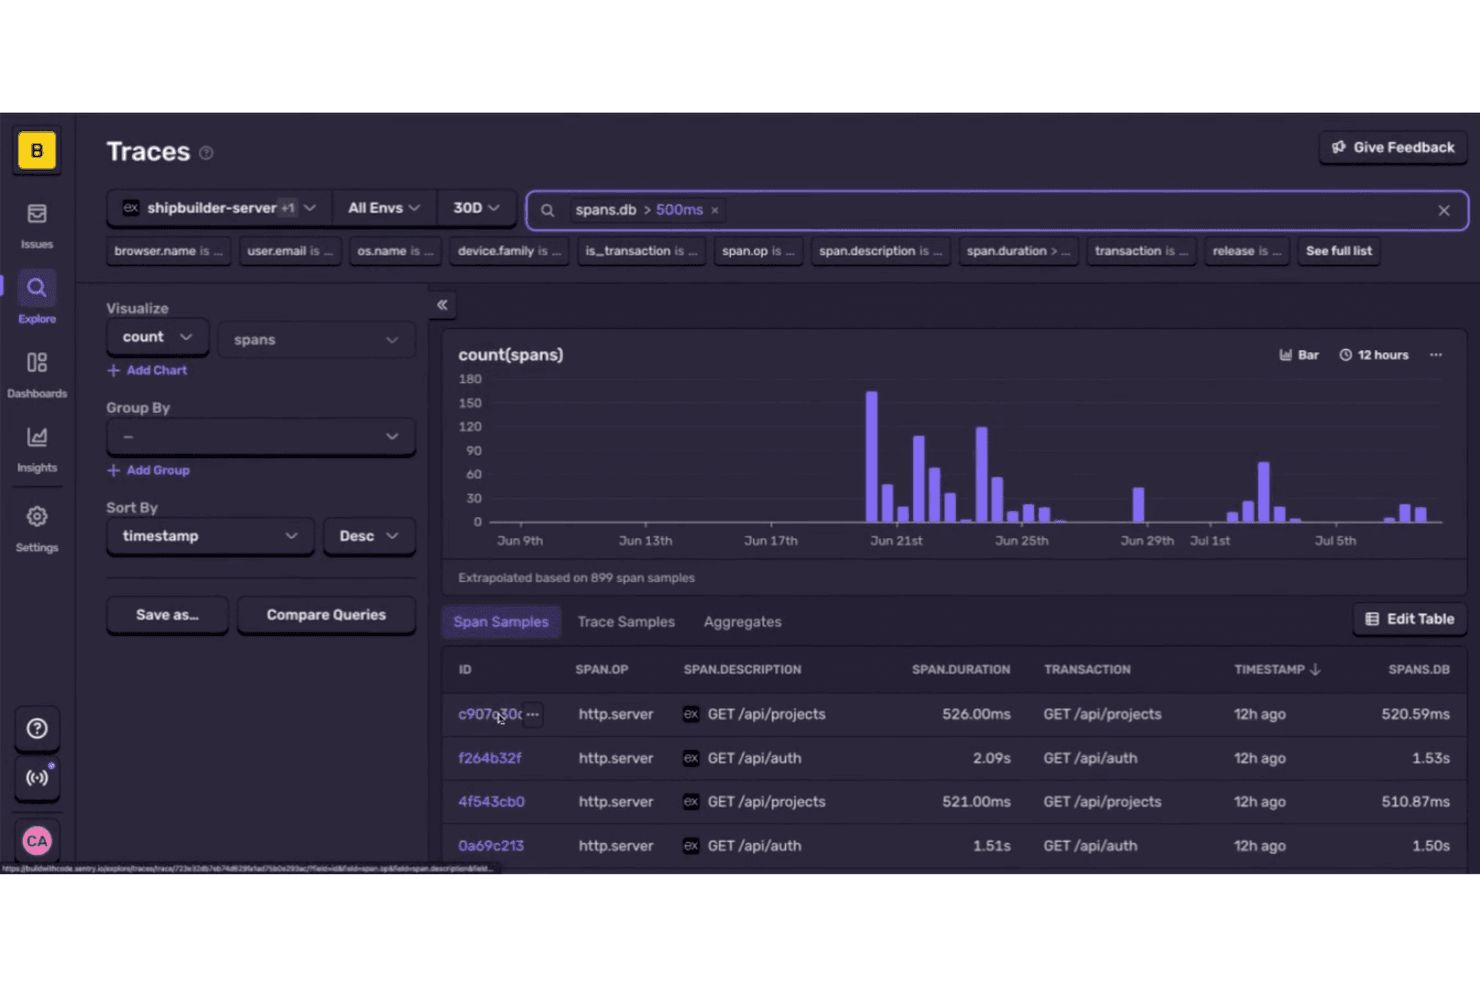
Sentry consente agli utenti di tracciare nel tempo gli span lenti del database tra i servizi. Sentry è una piattaforma di monitoraggio delle applicazioni per i team software che aiuta gli ingegneri a trovare errori e problemi di prestazioni tra i servizi, diagnosticare gli incidenti e ridurne l'impatto sugli utenti.
Per chi è più adatto Sentry?
Team di ingegneria che gestiscono applicazioni distribuite e hanno bisogno del contesto delle tracce per individuare con precisione i problemi di prestazioni tra i servizi.
Perché ho scelto Sentry
Ho scelto Sentry come alternativa a Honeycomb perché è ideale per il tracciamento distribuito ricco di contesto. La sua visualizzazione delle tracce mappa gli span tra i servizi e collega gli errori alle transazioni che li hanno generati. Mi piace il modo in cui aiuta a individuare con precisione il punto in cui una richiesta lenta accumula latenza mentre attraversa un'API e i relativi servizi downstream.
Funzionalità principali di Sentry
- Monitoraggio degli errori: Acquisisce le eccezioni e raggruppa gli eventi simili in problemi.
- Riproduzione delle sessioni: Registra le interazioni degli utenti per consentire ai team di esaminare gli eventi attorno a un errore.
- Stato delle release: Tiene traccia delle sessioni e degli utenti privi di arresti anomali nelle diverse release del software.
- Avvisi sui problemi: Invia notifiche quando compaiono nuovi problemi o cambiano quelli esistenti.
Integrazioni di Sentry
Sentry offre integrazioni native con GitHub, Jira, Slack, GitLab, Microsoft Teams, PagerDuty, Vercel, Bitbucket, Azure DevOps e Opsgenie. La sua piattaforma di integrazione supporta integrazioni personalizzate tramite webhook e l'API REST.
Pros and Cons
Pros:
- Gli errori si collegano direttamente al contesto della traccia
- Ricerca degli span per attributi e percentili di latenza
- Riproduzione delle sessioni utente accanto agli errori acquisiti
Cons:
- Si rivolge principalmente agli errori delle applicazioni, non all'infrastruttura
- L'ampio insieme di funzionalità può rendere l'interfaccia affollata
Learn more about Sentry: Ideale per il monitoraggio automatizzato completo basato sull'intelligenza artificiale
- Prova gratuita di 15 giorni
- $21/user/month per il piano di monitoraggio completo (fatturato annualmente)
Visit WebsiteCustomer Rating:4.5/5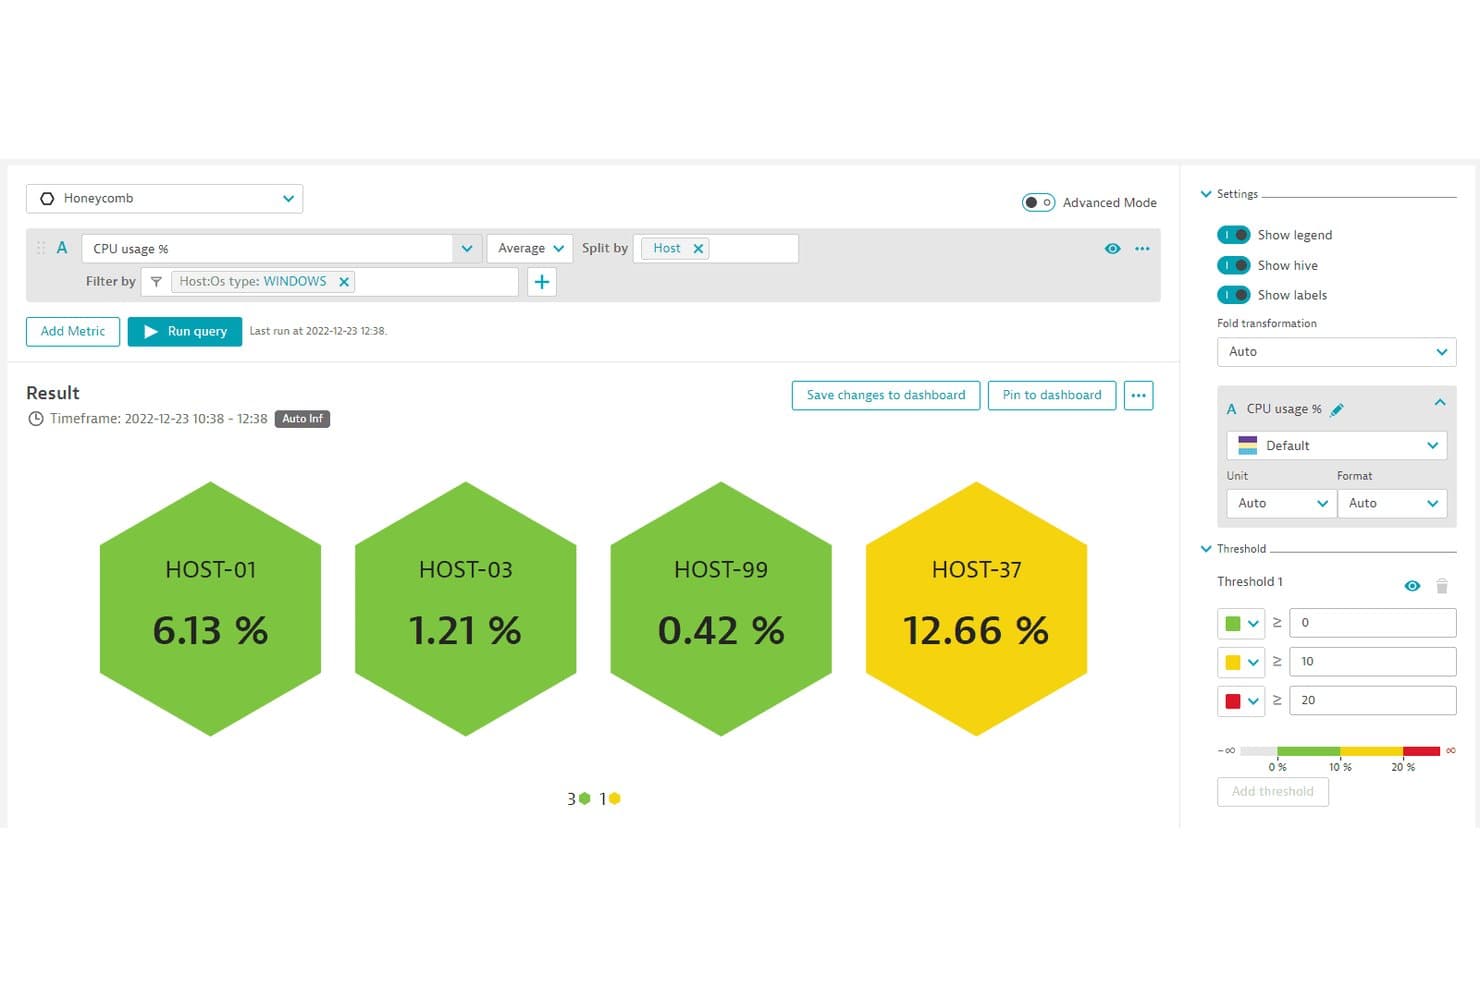
Dynatrace visualizza l'utilizzo della CPU per host utilizzando riquadri a nido d'ape codificati a colori. Come alternativa a Honeycomb, Dynatrace aiuta i team IT e di ingegneria a collegare i dati relativi ad applicazioni, infrastrutture ed esperienza utente per diagnosticare i problemi dei servizi in ambienti complessi.
Per chi è più indicato Dynatrace?
Dynatrace è adatto ai team delle operazioni IT e SRE che gestiscono ambienti complessi e distribuiti e necessitano di un monitoraggio automatizzato di applicazioni e infrastrutture.
Perché ho scelto Dynatrace
Considero Dynatrace una delle migliori alternative a Honeycomb per la sua attenzione alle “migliori soluzioni di monitoraggio automatizzato completo basate sull'intelligenza artificiale”. Davis AI analizza la telemetria per identificare le probabili cause principali, mentre OneAgent rileva e strumenta automaticamente i servizi su host e carichi di lavoro cloud. Apprezzo la sua mappatura delle dipendenze quando un picco di latenza dell'API risale a un host o a un servizio a valle.
Funzionalità principali di Dynatrace
- Monitoraggio degli utenti reali: Tiene traccia delle sessioni degli utenti, dei caricamenti delle pagine e degli errori frontend.
- Monitoraggio sintetico: Esegue controlli programmati del browser e HTTP sugli endpoint.
- Monitoraggio dei log: Raccoglie, ricerca e analizza i log insieme alla telemetria.
- Monitoraggio dell'infrastruttura cloud: Tiene traccia delle metriche e dello stato di host, container e servizi cloud.
Integrazioni di Dynatrace
Dynatrace Workflows offre connettori ufficialmente supportati per AWS, Microsoft Azure, GitHub, Jira, Slack, PagerDuty, ServiceNow, Microsoft Teams, GitLab e Jenkins tramite Dynatrace Hub. Dynatrace fornisce anche un'API per le integrazioni personalizzate.
Pros and Cons
Pros:
- Davis AI collega le anomalie alle cause principali
- OneAgent rileva e strumenta automaticamente i servizi
- Log, tracce, infrastruttura e monitoraggio degli utenti unificati
Cons:
- La sintassi DQL richiede tempo per essere padroneggiata
- Il consumo di telemetria può rendere i costi imprevedibili
 Ideale per riunire tracce, log e metriche in un'unica vista
- Piano gratuito disponibile
- $15/utente/mese (fatturato annualmente)
Visit WebsiteCustomer Rating:4.5/5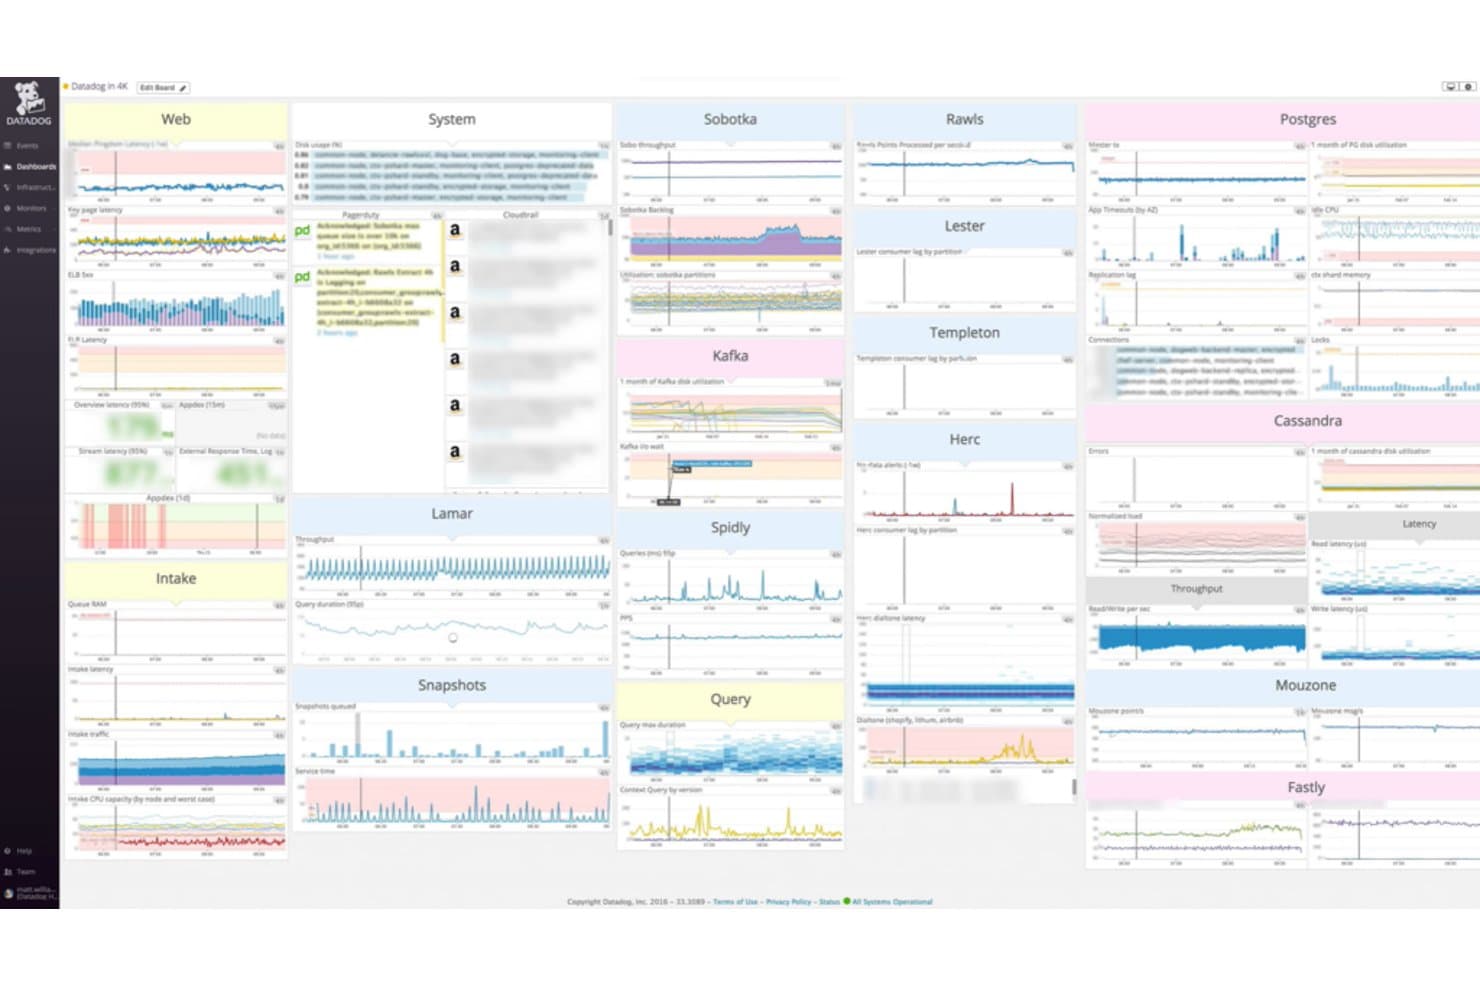
Datadog centralizza le metriche di servizi web, di sistema e di database in un'unica dashboard. Datadog è una piattaforma di osservabilità per i team IT e di ingegneria che devono analizzare i problemi delle applicazioni, tracciare le dipendenze tra i servizi e monitorare l'infrastruttura in ambienti complessi.
Per chi è più adatto Datadog?
Datadog è adatto ai team delle operazioni IT, di ingegneria delle piattaforme e SRE che devono monitorare infrastrutture e applicazioni distribuite.
Perché ho scelto Datadog
Ho scelto Datadog perché è il migliore per il monitoraggio unificato di server, app e servizi. Le sue metriche infrastrutturali, le tracce APM e le mappe dei servizi mi aiutano a seguire una richiesta lenta da un host ai servizi da cui dipende, rendendolo una valida alternativa a Honeycomb per le analisi degli incidenti su più livelli.
Funzionalità principali di Datadog
- Gestione dei log: cerca, filtra e analizza i log delle applicazioni e dell'infrastruttura.
- Monitoraggio sintetico: esegui test del browser e delle API per verificare la disponibilità e i tempi di risposta.
- Monitoraggio: imposta condizioni che attivano avvisi quando i dati monitorati raggiungono una soglia.
- Dashboard: crea rappresentazioni visive con grafici e widget per i dati selezionati.
Integrazioni di Datadog
Datadog offre oltre 1.000 integrazioni integrate, tra cui AWS, Azure, Google Cloud, Kubernetes, Docker, Jenkins, Slack, Jira, GitHub e PagerDuty. Fornisce anche un'API per le integrazioni personalizzate.
Pros and Cons
Pros:
- Mette in correlazione log, metriche e tracce durante il triage
- Le mappe dei servizi collegano gli host ai servizi da cui dipendono
- Le dashboard unificano i segnali dell'infrastruttura e delle applicazioni
Cons:
- La regolazione degli avvisi può generare notifiche rumorose
- La gestione di OpenTelemetry può essere incoerente
 Ideale per il monitoraggio dell'infrastruttura open source su larga scala
- Piano gratuito disponibile
- Prezzi su richiesta
Visit WebsiteCustomer Rating:4.4/5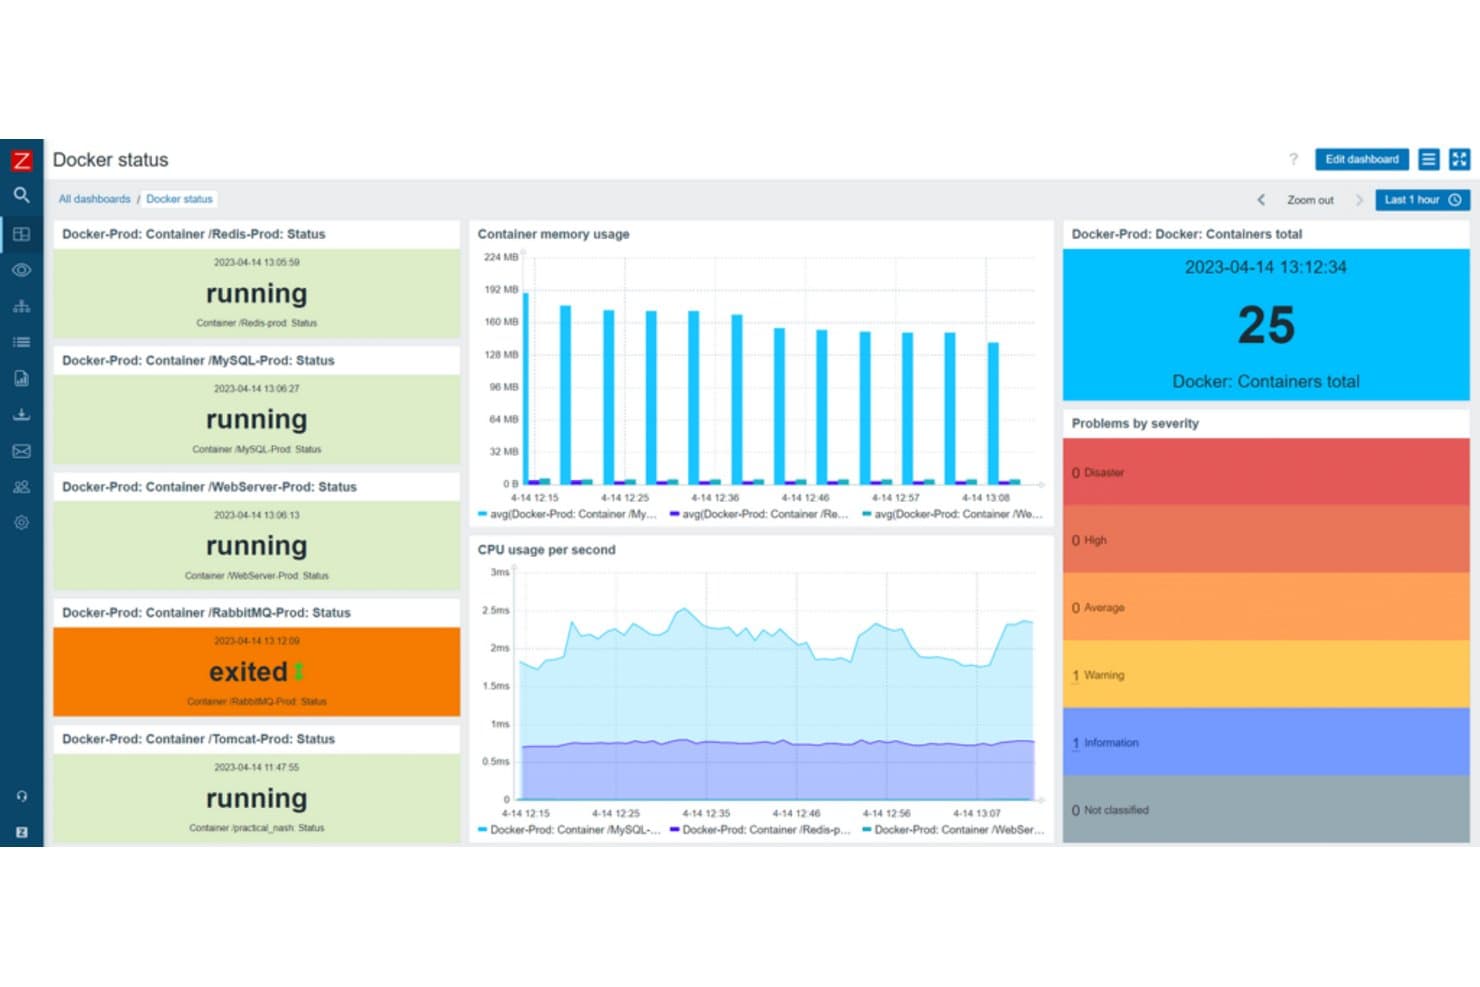
Zabbix monitora in tempo reale lo stato e l'utilizzo delle risorse dei container Docker. Zabbix è una piattaforma di monitoraggio dell'infrastruttura per i team IT che devono monitorare dispositivi di rete, server, applicazioni e servizi e rilevare interruzioni o problemi di prestazioni in ambienti complessi.
Per chi è più adatto Zabbix?
Zabbix è adatto ai team IT e infrastrutturali aziendali che necessitano di un monitoraggio open source su reti e sistemi interconnessi di grandi dimensioni.
Perché ho scelto Zabbix
Ho scelto Zabbix come “Il migliore per il monitoraggio di rete open source a livello aziendale” quando la visibilità sull'infrastruttura è più importante del tracing distribuito. Il rilevamento della rete e il monitoraggio SNMP aiutano a individuare switch e router, mentre i modelli e i trigger standardizzano i controlli e segnalano guasti alle interfacce o ai servizi. Questo lo rende una valida alternativa a Honeycomb per monitorare lo stato dell'infrastruttura in un ambiente di grandi dimensioni.
Funzionalità principali di Zabbix
- Monitoraggio web: configura scenari per verificare la disponibilità dei siti web, il tempo di risposta e il contenuto delle pagine.
- Monitoraggio dei log: raccoglie le voci di registro e rileva modelli o errori corrispondenti.
- Monitoraggio dei servizi: mappa i servizi aziendali e ne monitora lo stato rispetto agli obiettivi a livello di servizio.
- Dashboard: organizza i widget per visualizzare i dati di monitoraggio, i problemi e lo stato dei servizi.
Integrazioni di Zabbix
Il catalogo delle integrazioni di Zabbix elenca 559 marchi e 1.986 soluzioni, tra cui AWS, Azure, Kubernetes, PagerDuty, Slack, Microsoft Teams, ServiceNow e Jira. Supporta connessioni personalizzate tramite API e webhook configurabili; le voci del catalogo non sono necessariamente integrazioni native.
Pros and Cons
Pros:
- Il rilevamento automatico individua i dispositivi di rete SNMP
- I modelli standardizzano i controlli dello stato dell'infrastruttura
- I proxy estendono il monitoraggio ai siti remoti
Cons:
- Nessun flusso di lavoro nativo per il debug delle tracce distribuite
- La configurazione complessa e la messa a punto degli avvisi richiedono competenze
 Ideale per il tracciamento end-to-end delle transazioni aziendali
- Prova gratuita di 30 giorni
- $3300 per unità all'anno (con fatturazione annuale)
Visit WebsiteCustomer Rating:4.3/5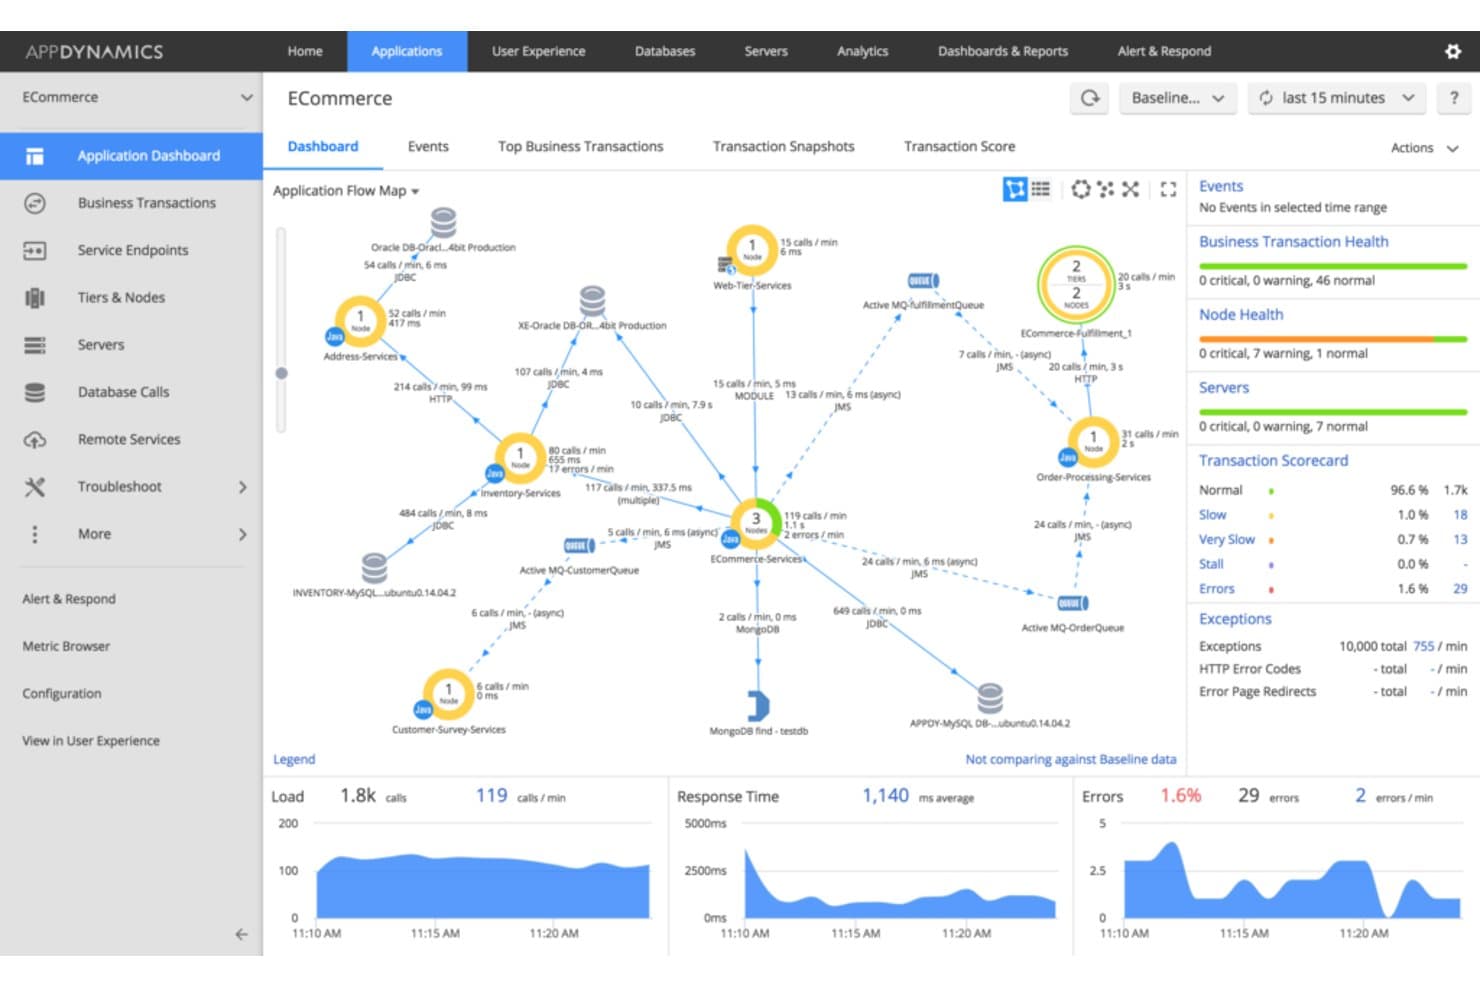
AppDynamics visualizza in tempo reale le dipendenze e le prestazioni dei servizi applicativi. AppDynamics è una piattaforma di osservabilità per i team IT e applicativi che gestiscono sistemi complessi, aiutandoli a individuare con precisione i problemi di prestazioni e a collegare i problemi dell'infrastruttura all'affidabilità delle applicazioni e all'esperienza degli utenti.
Per chi è più adatto AppDynamics?
AppDynamics è adatto ai team che si occupano delle prestazioni e delle operazioni delle applicazioni e che gestiscono applicazioni distribuite e multilivello in ambienti complessi.
Perché ho scelto AppDynamics
Ho scelto AppDynamics per il tracciamento end-to-end delle transazioni aziendali in ambienti complessi. Le sue mappe del flusso delle transazioni mostrano come le richieste si spostano tra i vari livelli dell'applicazione, mentre le istantanee delle transazioni acquisiscono dettagli a livello di codice quando una richiesta rallenta o ha esito negativo. Utilizzo questa visualizzazione per ricondurre un ritardo nel completamento di un acquisto dal servizio rivolto all'utente al livello backend che lo causa.
Funzionalità principali di AppDynamics
- Monitoraggio dell'infrastruttura: Correla le metriche dell'infrastruttura con i servizi applicativi e le metriche aziendali.
- Monitoraggio dell'esperienza digitale: Tiene traccia degli utenti web e mobili ed esegue controlli sintetici su browser, API e servizi di terze parti.
- Sicurezza applicativa in fase di esecuzione: Rileva le vulnerabilità e blocca gli attacchi.
- Monitoraggio SAP: Monitora i sistemi SAP ibridi e on-premise, con tracciamento fino al codice ABAP o alle query del database.
Integrazioni di AppDynamics
AppDynamics supporta integrazioni per gli avvisi con PagerDuty, Slack, ServiceNow tramite Service Graph Connector, Jira, BigPanda, Moogsoft e Splunk ITSI; l'integrazione con PagerDuty è realizzata dal fornitore, mentre quella con Slack è sviluppata dalla community. AppDynamics fornisce inoltre API REST ed estensioni predefinite per le integrazioni personalizzate.
Pros and Cons
Pros:
- Mappa le transazioni aziendali tra i vari livelli dell'applicazione
- Le istantanee mostrano i metodi lenti e le righe di codice
- Collega lo stato delle transazioni ai risultati aziendali
Cons:
- L'impegno di configurazione aumenta con le gerarchie applicative personalizzate
- Le query personalizzate richiedono l'apprendimento del linguaggio di query di AppDynamics
Learn more about AppDynamics: Ideale per approfondimenti sulle prestazioni applicative e monitoraggio dell'esperienza utente finale
- Piano gratuito disponibile
- $99/mese per il piano Pro (fatturato annualmente)
Visit WebsiteCustomer Rating:4.3/5
Dashboard panoramica SQL di New Relic. New Relic è specializzato nel fornire approfondimenti dettagliati sulle prestazioni delle applicazioni e nel monitoraggio dell'esperienza utente. Questo strumento svolge un lavoro eccellente nell'aiutare i team a comprendere in modo dettagliato e granulare le interazioni degli utenti e il comportamento delle applicazioni.
Pros and Cons
Pros:
- Monitoraggio dettagliato delle prestazioni applicative e dell'esperienza utente
- Ampie integrazioni con i principali provider e piattaforme cloud
- Funzionalità AIOps per avvisi predittivi e risposta agli incidenti
Cons:
- Prezzo nella fascia alta rispetto ad alcuni concorrenti
- Può essere complesso da configurare e impostare
- La vasta gamma di funzionalità può risultare opprimente per i nuovi utenti
Learn more about New Relic: La scelta migliore per la gestione e l'analisi dei log nativi per il cloud
- Prova gratuita di 14 giorni
- Prezzi su richiesta
Visit WebsiteCustomer Rating:4.3/5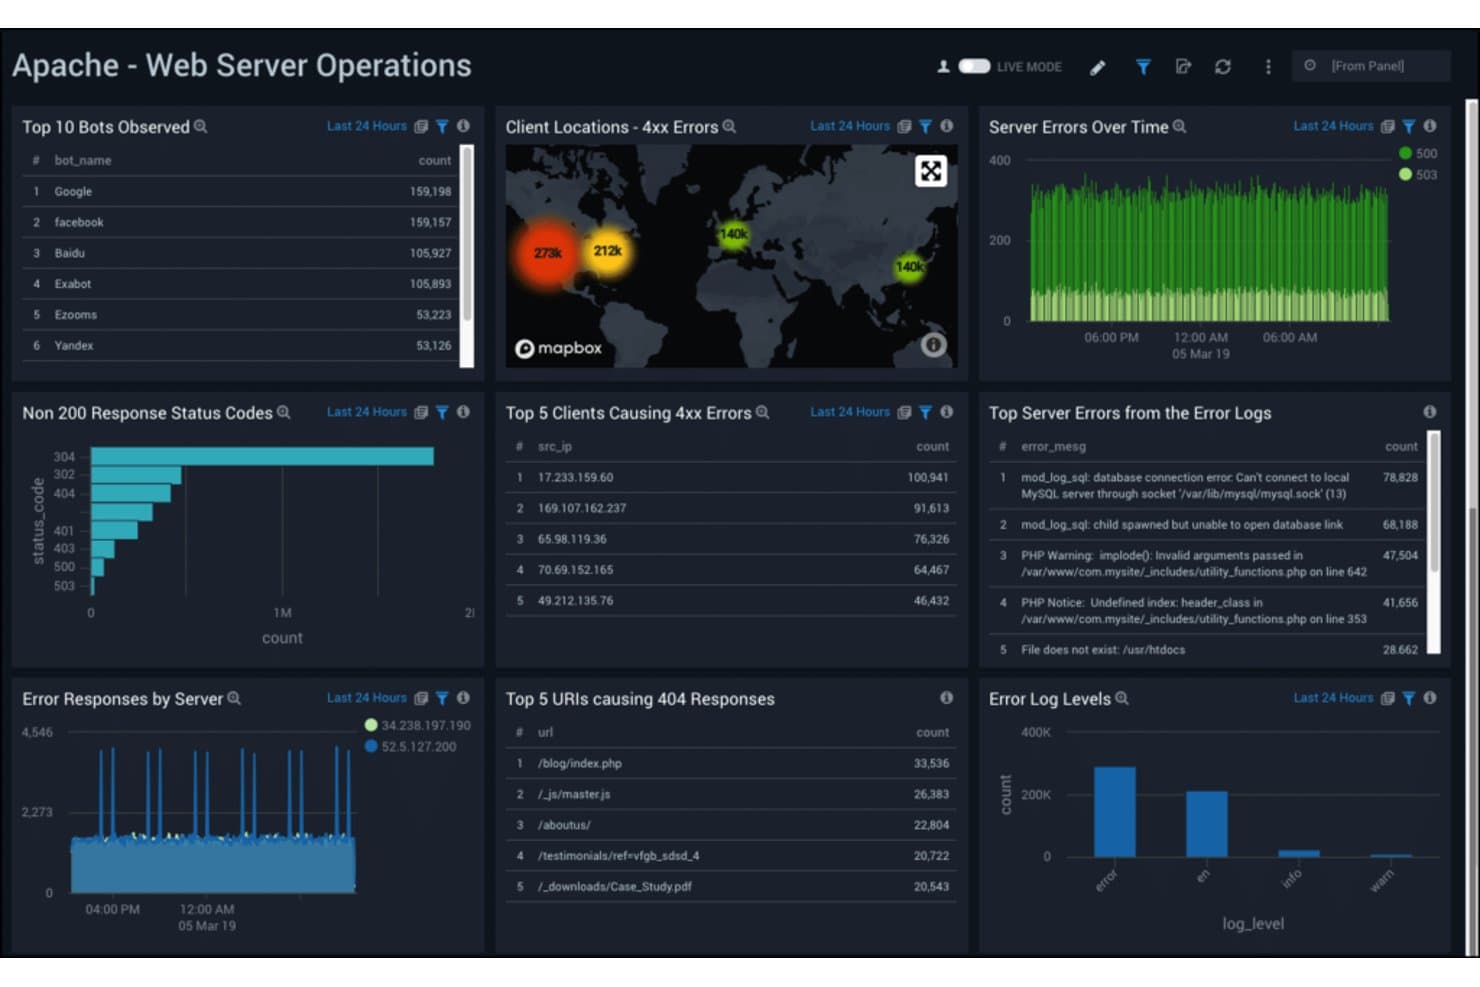
I monitoraggi di Sumo Logic analizzano in tempo reale gli errori del server web Apache e l'attività dei bot. Sumo Logic offre ai team IT e DevOps una piattaforma di osservabilità per analizzare le interruzioni, collegare i problemi tra servizi distribuiti e ottenere visibilità su ambienti cloud complessi.
Per chi è più adatto Sumo Logic?
I team responsabili dell'infrastruttura e della sicurezza nelle organizzazioni native per il cloud possono usare Sumo Logic per analizzare i log tra servizi distribuiti.
Perché ho scelto Sumo Logic
Ho scelto Sumo Logic come alternativa a Honeycomb perché è la scelta migliore per la gestione e l'analisi dei log nativi per il cloud. LogReduce raggruppa i messaggi di log simili per aiutarmi a individuare gli errori ricorrenti, mentre il suo linguaggio per le query di ricerca mi consente di analizzare un incidente tra servizi distribuiti.
Funzionalità principali di Sumo Logic
- Analisi delle metriche: acquisisci e interroga le metriche delle serie temporali insieme ai dati di telemetria operativa.
- Tracciamento distribuito: segui le richieste tra i servizi per esaminare gli intervalli e i dettagli delle tracce.
- Pannelli di controllo: crea pannelli di controllo visivi con grafici e pannelli per i dati operativi.
- Monitoraggi e avvisi: imposta condizioni sulle metriche o sui risultati delle query per attivare le notifiche.
Integrazioni di Sumo Logic
Il catalogo di Sumo Logic comprende centinaia di fornitori e prodotti, con app, collettori, contenuti SIEM cloud e integrazioni per l'automazione con strumenti come AWS, Azure, Kubernetes, Datadog, GitHub, GitLab e Atlassian Jira. Offre inoltre API per le integrazioni personalizzate.
Pros and Cons
Pros:
- LogReduce raggruppa rapidamente gli errori simili
- La ricerca analizza dati JSON ed espressioni regolari
- Log, metriche e tracce condividono le analisi
Cons:
- La sintassi delle query di Sumo richiede pratica
- Le ricerche storiche possono rallentare su larga scala
 Ideale per il monitoraggio e l'invio di avvisi sui log basati sul volume
- Prova gratuita di 30 giorni
- Prezzi su richiesta
Visit WebsiteCustomer Rating:4.4/5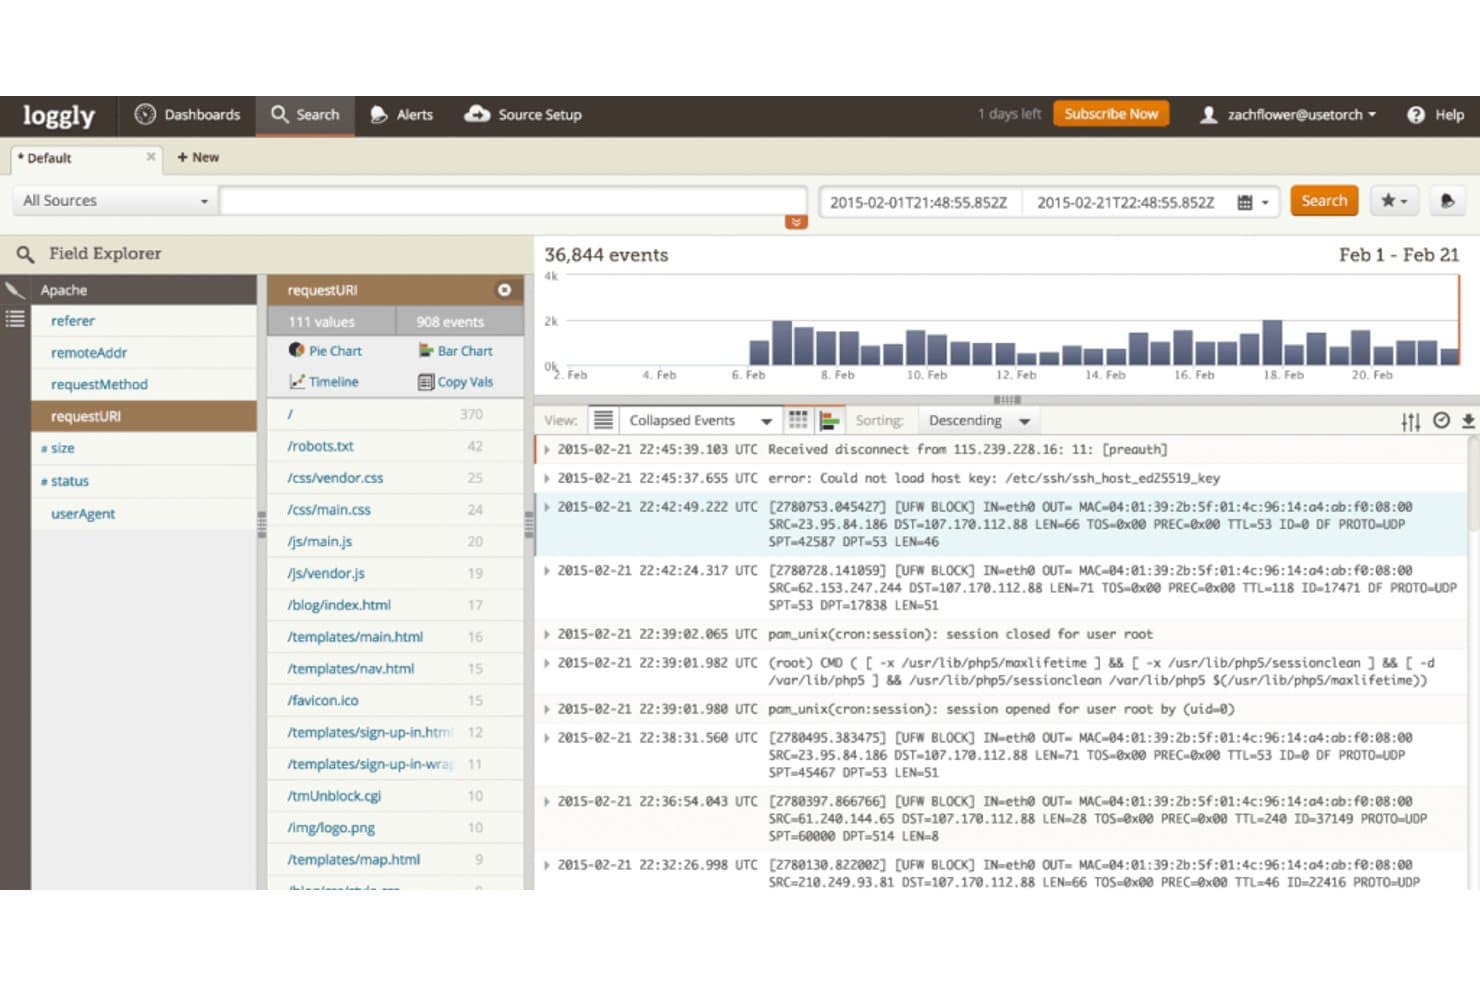
Loggly centralizza gli eventi dei log per la ricerca e l'analisi in tempo reale. Loggly è una piattaforma di gestione dei log basata sul cloud per i team IT e DevOps che devono analizzare i problemi delle applicazioni e dell'infrastruttura, tracciare gli eventi tra i servizi e diagnosticare le interruzioni dei servizi.
Per chi è più adatto Loggly?
Loggly è adatto ai team IT e DevOps che devono cercare e visualizzare i dati dei log in ambienti cloud in espansione.
Perché ho scelto Loggly
Ho scelto Loggly come alternativa a Honeycomb perché è ideale per la gestione scalabile dei log basata sul cloud e la visualizzazione interattiva dei dati. I suoi grafici e dashboard mi aiutano a individuare le tendenze nei log delle applicazioni e dell'infrastruttura. Apprezzo anche i suoi strumenti per la risoluzione dei problemi, che aiutano a ricondurre le anomalie alle cause principali tra servizi interconnessi.
Funzionalità principali di Loggly
- Monitoraggio in tempo reale: Trasmette gli eventi dei log in arrivo da più fonti quasi in tempo reale.
- Avvisi basati sulle ricerche: Imposta condizioni sulle ricerche e invia notifiche via e-mail o agli endpoint supportati.
- Integrazioni con gli strumenti del team: Collega Loggly a Slack, GitHub, Jira, PagerDuty, Microsoft Teams e ai webhook.
- Supporto per le origini dei log: Raccoglie i log da fonti come AWS, syslog, PHP, dispositivi di rete e sistemi Windows.
Integrazioni di Loggly
Loggly elenca le integrazioni con Slack, GitHub, Jira, PagerDuty e Microsoft Teams; la distribuzione degli avvisi è disponibile anche tramite webhook personalizzati. Fornisce un'API per le integrazioni personalizzate.
Pros and Cons
Pros:
- Ricerca centralizzata dei log tra i servizi e dashboard
- Il monitoraggio in tempo reale trasmette gli eventi da più fonti
- I grafici interattivi rivelano le tendenze dei log
Cons:
- La distribuzione esclusivamente SaaS non soddisfa i requisiti on-premise
- I ritardi nella propagazione dei log possono ostacolare la gestione iniziale degli incidenti
Learn more about Loggly: Ideale per l’intelligenza operativa basata sui dati delle macchine
- Prova gratuita di 60 giorni
- $150/mese (con fatturazione annuale)
Visit WebsiteCustomer Rating:4.3/5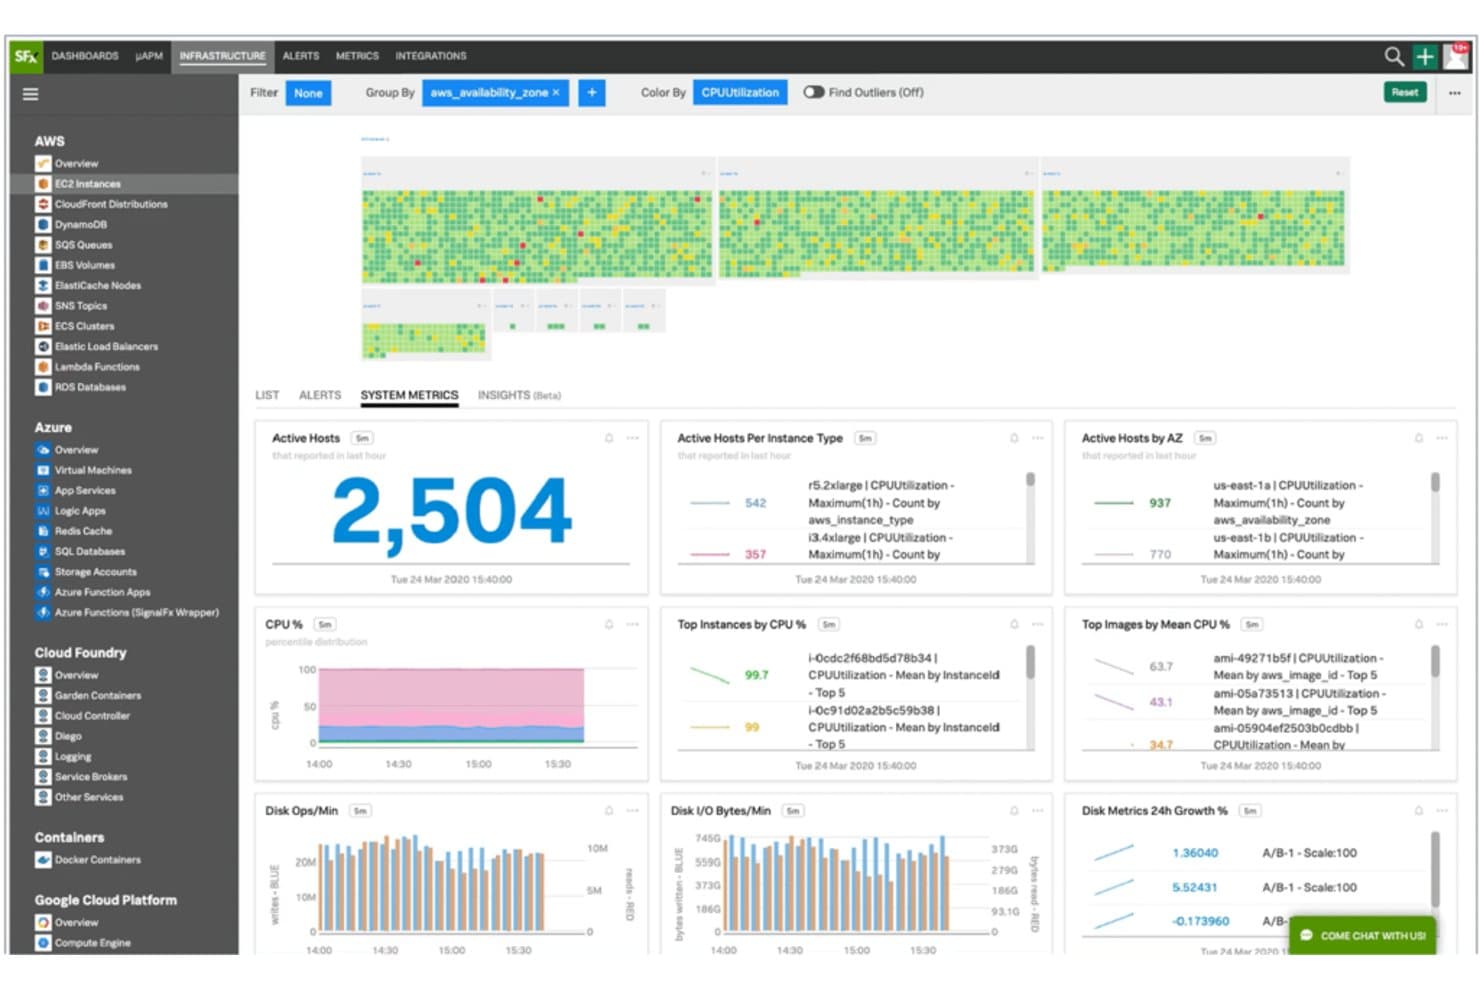
Splunk monitora in tempo reale le metriche dell’infrastruttura cloud e di AWS e Azure. Splunk è una piattaforma di osservabilità per i team IT e di sicurezza che devono analizzare i dati delle macchine in ambienti complessi, identificare i problemi dei servizi e risolvere gli incidenti.
Per chi è più adatto Splunk?
I team delle operazioni IT che gestiscono infrastrutture distribuite possono usare Splunk per trasformare i dati delle macchine in informazioni operative utilizzabili.
Perché ho scelto Splunk
Ho scelto Splunk come alternativa a Honeycomb per la categoria “Ideale per sfruttare i dati delle macchine al fine di ottenere informazioni operative approfondite”. Uso le ricerche SPL per analizzare i log dei servizi distribuiti, quindi collego i risultati nei dashboard per tracciare problemi come l’aumento degli errori dopo una distribuzione. Questa visione più ampia dei dati delle macchine mi aiuta a esaminare i problemi operativi insieme agli eventi correlati dell’infrastruttura e della sicurezza.
Funzionalità principali di Splunk
- Tracciamento distribuito: Segui le richieste tra i servizi attraverso gli intervalli di traccia e le mappe dei servizi.
- Monitoraggio dell’infrastruttura: Monitora le metriche di host, container e ambienti Kubernetes.
- Monitoraggio degli utenti reali: Acquisisci le prestazioni del browser e le interazioni degli utenti.
- Monitoraggio sintetico: Esegui test tramite script per verificare la disponibilità dei servizi e i tempi di risposta.
Integrazioni di Splunk
Splunk Observability Cloud offre centinaia di integrazioni preconfezionate, tra cui AWS, Microsoft Azure, Google Cloud, Kubernetes, Prometheus, Jira, Microsoft Teams, PagerDuty, ServiceNow e Slack. Splunkbase offre oltre 1.000 app e componenti aggiuntivi nel marketplace, mentre Splunk mette a disposizione API per le integrazioni personalizzate.
Pros and Cons
Pros:
- Correla log, metriche e tracce
- Analizza le tracce senza campionamento
- I dashboard personalizzati velocizzano la risoluzione dei problemi
Cons:
- Le query complesse possono essere lente
- I costi aumentano con volumi di dati maggiori
Learn more about Splunk: Ideale per metriche e avvisi nativi di Kubernetes
- Piano gratuito disponibile
- Prezzo su richiesta
Visit WebsiteCustomer Rating:4.4/5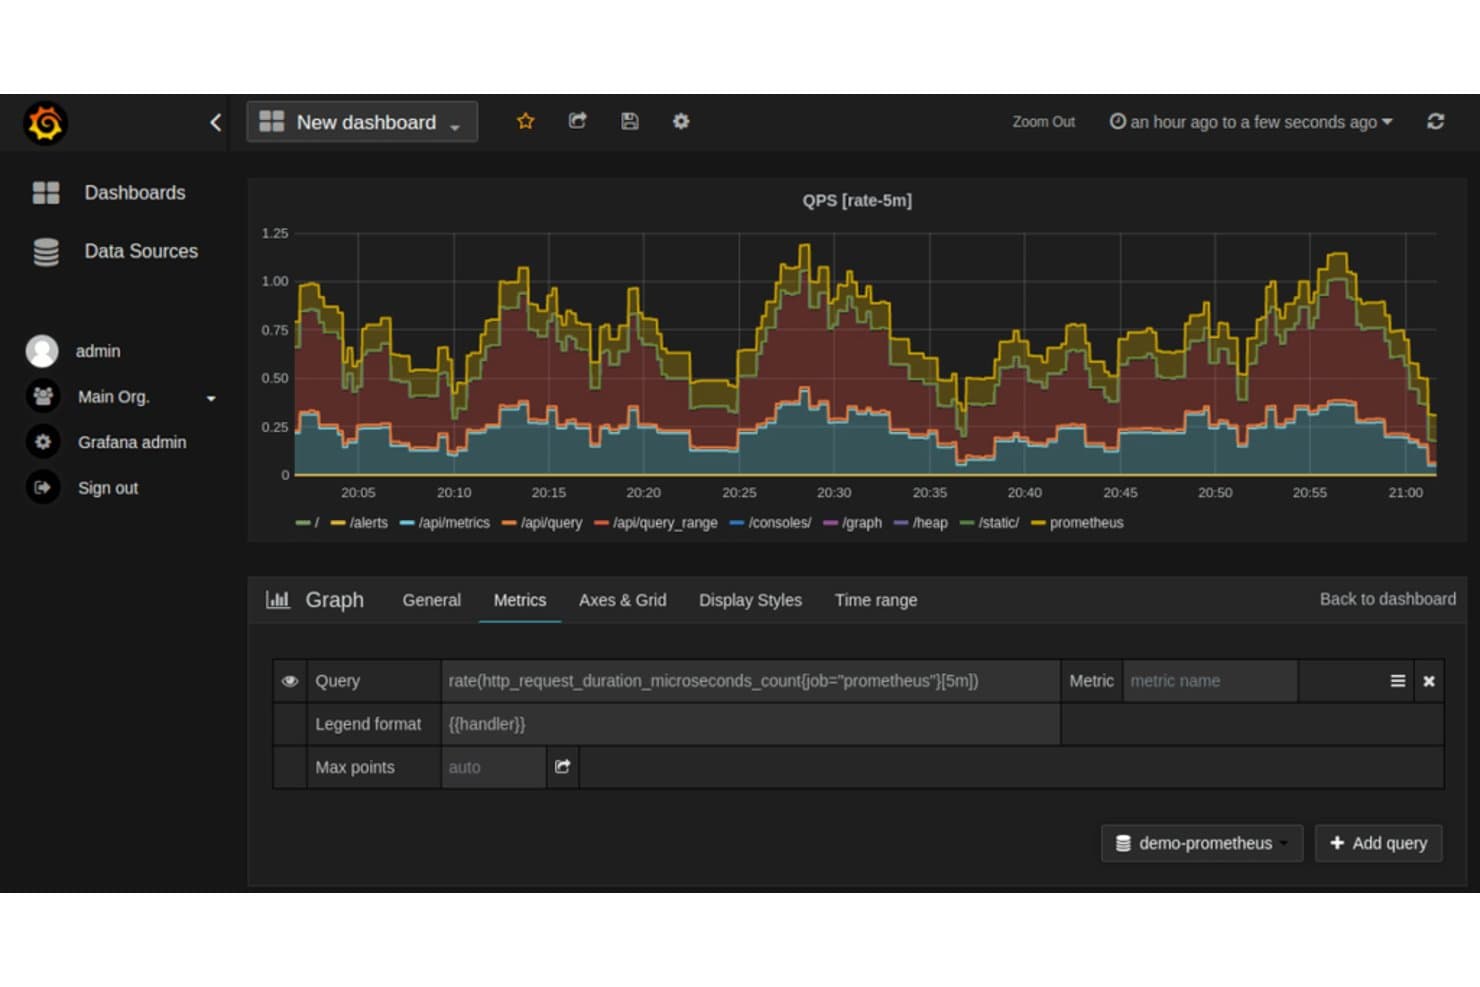
Prometheus visualizza le frequenze delle richieste HTTP tra gli endpoint API in Grafana. Prometheus è una piattaforma di monitoraggio open source per i team addetti all'infrastruttura e alle applicazioni che devono monitorare lo stato dei sistemi, analizzare i problemi di prestazioni e integrare l'osservabilità nei propri servizi.
Per chi è più adatto Prometheus?
Prometheus è adatto ai team DevOps e di affidabilità dei siti che devono raccogliere metriche e impostare avvisi nei carichi di lavoro Kubernetes.
Perché ho scelto Prometheus
Ho scelto Prometheus per la raccolta delle metriche e la gestione degli avvisi, soprattutto in un ambiente Kubernetes. Il rilevamento dei servizi consente di monitorare i carichi di lavoro in continua evoluzione, mentre PromQL mi aiuta ad analizzare i modelli delle metriche e a definire le condizioni degli avvisi. Uso Alertmanager per instradare tali avvisi quando lo stato del servizio peggiora.
Funzionalità principali di Prometheus
- Database di serie temporali: Memorizza campioni con marca temporale in un database locale.
- Modello di dati multidimensionale: Organizza le serie temporali con nomi delle metriche ed etichette chiave-valore.
- Ecosistema degli esportatori: Gli esportatori espongono metriche da sistemi quali database e hardware.
- Federazione: Raccoglie metriche selezionate da altri server Prometheus per l'aggregazione.
Integrazioni di Prometheus
Prometheus include il rilevamento dei servizi Kubernetes e supporta integrazioni basate su esportatori con Kafka, MySQL, PostgreSQL, Redis, Jenkins e AWS CloudWatch. Le connessioni di lettura/scrittura remota includono Grafana Mimir, Thanos, Google Cloud e New Relic, mentre la sua API HTTP supporta integrazioni personalizzate.
Pros and Cons
Pros:
- PromQL supporta l'analisi delle metriche basata sulle etichette
- Il rilevamento dei servizi Kubernetes monitora i carichi di lavoro in continua evoluzione
- Alertmanager instrada gli avvisi sulle metriche in base alle etichette
Cons:
- Le etichette con elevata cardinalità possono sovraccaricare l'archiviazione locale
- L'archiviazione locale limita la conservazione e la scalabilità orizzontale
Learn more about Prometheus:
Altre alternative a Honeycomb
Ecco alcune alternative aggiuntive a Honeycomb che non sono state incluse nel mio elenco, ma che vale comunque la pena prendere in considerazione:
- 11Grafana CloudIdeale per la visualizzazione interattiva, permette di prendere decisioni basate sui dati
- 12Elastic (ELK Stack)Ideale per l'analisi dei log, la ricerca e potenti capacità di correlazione dei dati
- 13WrikeIdeale per la gestione dei progetti nei team software
Altre recensioni di software
- Strumenti per lo sviluppo software
- Strumenti per l'infrastruttura come codice
- Strumenti DataOps
- Strumenti per il monitoraggio dei database
¿Cómo evalúo las alternativas a GitHub?
Divido cada evaluación en requisitos fundamentales—alojamiento de Git, flujos de trabajo de PR, CI/CD—y diferenciadores como la autogestión, el escaneo de seguridad y la transparencia de precios.
Funcionalidad básica (Lo imprescindible para esta lista)
Cuando selecciono herramientas para mi lista, clasifico cada una en una escala de 0 (no ofrece la funcionalidad) a 5 (destaca en esta área) para cada funcionalidad principal mencionada a continuación. Luego, calculo la puntuación total de la herramienta en porcentaje. Cada herramienta debe lograr una puntuación total mínima del 75% para ser considerada para su inclusión.
- Alojamiento de repositorios Git: Verifico si la plataforma admite modelos de implantación en la nube, autogestión o ambos, además de almacenamiento de archivos grandes y soporte para monorepositorios.
- Colaboración y revisión de código: Los flujos de trabajo de pull o merge request, los comentarios en línea, los aprobadores obligatorios y los PR en borrador influyen en qué tan bien gestiona una plataforma la revisión de código en equipo.
- Seguimiento de incidencias y proyectos: Evalúo si los tableros integrados, los hitos y las etiquetas son lo suficientemente maduros como para gestionar ciclos de sprints sin la necesidad de una herramienta adicional como Jira.
- Soporte para pipelines CI/CD: Cada plataforma se evalúa por sus capacidades nativas de pipeline—cosas como compilaciones matriciales, flujos de trabajo reutilizables y opciones de runners autogestionados.
- Control de acceso y permisos: El acceso basado en roles a nivel de repositorio y rama es importante, y busco SSO, registros de auditoría y aprovisionamiento SCIM para equipos empresariales.
- Extensibilidad y APIs: APIs REST o GraphQL, webhooks, herramientas de línea de comandos y un mercado de integraciones muestran qué tan bien se integra la plataforma en una cadena de herramientas DevOps más amplia.
Una vez que tengo una lista de herramientas que cumplen con estos criterios, considero qué diferencia a cada plataforma.
Factores diferenciadores (Lo que distingue a los proveedores)
Así es como comparo y contrasto a los diferentes proveedores:
Características destacadas
El escaneo de seguridad incorporado es un gran diferenciador. Plataformas como GitLab integran SAST, escaneo de dependencias y detección de secretos directamente en los pipelines, lo que ahorra a los equipos tener que unir diferentes herramientas. También evalúo si una plataforma incluye un registro de paquetes y contenedores nativo, ya que consolidar el almacenamiento de artefactos junto al código fuente simplifica la cadena de herramientas DevOps. Para equipos en entornos regulados, las opciones de autogestión son clave—verifico si la plataforma soporta implementaciones locales o aisladas, brindando control total sobre dónde reside el código.
Más allá de las características
La transparencia en los precios es importante al comparar plataformas para los niveles gratuitos, de equipo y empresariales. Analizo si el proveedor separa claramente qué está disponible en cada plan—algunas plataformas restringen los minutos de CI/CD o las funciones de seguridad avanzadas a los planes superiores, lo que puede tomar por sorpresa a los equipos. Las certificaciones de cumplimiento como SOC 2 e ISO 27001 merecen ser revisadas temprano, especialmente si tu organización opera en un sector regulado. También considero la madurez de la comunidad—una base de colaboradores activa, documentación bien mantenida y un ecosistema de plugins saludable sugieren viabilidad a largo plazo.
Perché cercare un'alternativa a Honeycomb?
Honeycomb è uno strumento di osservabilità all'avanguardia progettato per aiutare gli ingegneri del software a comprendere, correggere e migliorare il software in produzione. Eccelle nel fornire informazioni a livello di sistema, facilitando l'individuazione di schemi e anomalie e ottimizzando così le prestazioni.
Nonostante le sue potenti funzionalità, gli utenti potrebbero cercare delle alternative per diversi motivi. Questi possono variare dai vincoli di budget, poiché i prezzi di Honeycomb potrebbero essere fuori dalla portata di alcuni team più piccoli, ai requisiti relativi a funzionalità specifiche che Honeycomb non soddisfa, come i tradizionali software per la gestione dei log o il monitoraggio approfondito delle prestazioni delle applicazioni.
Infine, alcuni utenti potrebbero semplicemente preferire un'alternativa open source o una con un'interfaccia utente diversa. La ricerca dell'alternativa perfetta a Honeycomb consiste nel trovare uno strumento che raggiunga un equilibrio tra funzionalità complete e un'esperienza utente fluida, adattandosi al contempo alle esigenze e alle risorse specifiche dell'organizzazione.
Caratteristiche principali di Honeycomb
Ecco alcune delle caratteristiche principali di Honeycomb, utili per mettere a confronto ciò che offrono le soluzioni alternative:
- Telemetria basata sugli eventi: Acquisisce dati dettagliati sugli eventi, permettendo al team di vedere esattamente cosa è accaduto nei sistemi in qualsiasi momento.
- Generatore di query: Permette di porre domande complesse sui dati senza dover scrivere codice.
- BubbleUp: Evidenzia automaticamente i valori anomali nei dati, consentendo di individuare più rapidamente i problemi.
- Supporto per il tracciamento: Collega le tracce ai log e alle metriche, permettendo di comprendere come una singola richiesta attraversa lo stack.
- Bacheche e visualizzazioni: Aiuta a salvare, organizzare e condividere le query o le visualizzazioni principali utilizzate frequentemente dal team.
- Mappa dei servizi: Mostra come interagiscono i servizi, risultando utile per comprendere le dipendenze e lo stato del sistema.
- Monitoraggio degli SLO: Permette di impostare e monitorare gli obiettivi del livello di servizio per tenere sotto controllo gli obiettivi di prestazione.
- Strumenti di collaborazione del team: Consentono di commentare le query, condividere link e collaborare alle attività di analisi.
- Motore di query veloce: Risponde rapidamente anche su grandi quantità di dati, un aspetto utile durante il debug di problemi in tempo reale.
- Integrazioni con strumenti come OpenTelemetry: Semplifica l'importazione dei dati dalla configurazione esistente.