

Ausführlicher Leitfaden zu den 10 besten NLP-Softwaretools des Jahres 2026

10 Beste NLP-Software – Vorauswahl
- 1. Rasa


Wer sich mit dem Bereich der künstlichen Intelligenz beschäftigt, stößt häufig auf eine Vielzahl von Tools zur Verarbeitung natürlicher Sprache, die jeweils mit einzigartigen Fähigkeiten aufwarten. Von Bots, die auf fortschrittlichen NLP-Modellen basieren, bis hin zu Apps für maschinelle Übersetzung und Zusammenfassungen bilden diese Tools das Rückgrat der heutigen Automatisierungslandschaft.
Auf Grundlage meiner Erfahrung mit dem Verstehen natürlicher Sprache, der Beantwortung von Fragen, der Entitätenerkennung und den Feinheiten von Programmiersprachen habe ich gesehen, wie virtuelle Assistenten und NLP-Anwendungen die Interaktion revolutioniert haben. Die Auseinandersetzung mit diesen Optionen kann die Herausforderung beseitigen, Daten manuell zu durchsuchen, und die Lücke zwischen umfangreichen Informationen und umsetzbaren Erkenntnissen schließen.
Warum Sie unseren Software-Empfehlungen vertrauen können
Unser Team testet und bewertet Software seit 2012. Als Tech-Führungskräfte wissen wir selbst, wie schwierig – und wichtig – es ist, die richtige Software auszuwählen.
Für diesen Leitfaden haben wir Tools mithilfe von praktischen Tests und unabhängiger Recherche bewertet und dabei unsere Bewertungskriterien angewendet.
Unsere Bewertungen spiegeln unser menschliches redaktionelles Urteilsvermögen wider, keine Verkaufsstrategie.
Expertenprüfer:
Zusammenfassung der besten NLP-Software
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Kostenloser Tarif + kostenlose Demo verfügbar | Preise auf Anfrage | Website | ||
| 2 | Am besten für den API-Zugriff auf führende LLMs geeignet | Kostenloser Tarif verfügbar | Ab $20/Benutzer/Monat | Website | |
| 3 | Am besten für die gemeinsame Analyse von Text- und strukturierten Daten geeignet | 14-tägige kostenlose Testversion + kostenlose Demo verfügbar | Preise auf Anfrage | Website | |
| 4 | Am besten geeignet für die Verarbeitung von Dokumenten mit großem Kontext über offene LLMs | Nicht verfügbar | Preise auf Anfrage | Website | |
| 5 | Kostenloser Plan verfügbar | Ab $0.04/Guthaben | Website | ||
| 6 | Am besten für native AWS-Textanalyse im großen Maßstab | Kostenloser Tarif verfügbar | Ab $0.0001/Einheit | Website | |
| 7 | Am besten für die Bereitstellung produktionsreifer NLP-Pipelines | Preise auf Anfrage | Website | ||
| 8 | Am besten für NLP mit Governance in hybriden Cloud-Bereitstellungen geeignet | Kostenloser Tarif + kostenlose Testversion + kostenlose Demo verfügbar | Ab 1.110 $/Monat | Website | |
| 9 | Am besten für Textanalyse-Pipelines geeignet, die nativ auf GCP ausgeführt werden | Website | |||
| 10 | Am besten für die Feinabstimmung quelloffener Modelle in großem Maßstab geeignet | Kostenloser Tarif verfügbar | Ab $9/Monat | Website |
Bewertungen der besten NLP-Software
Rasa
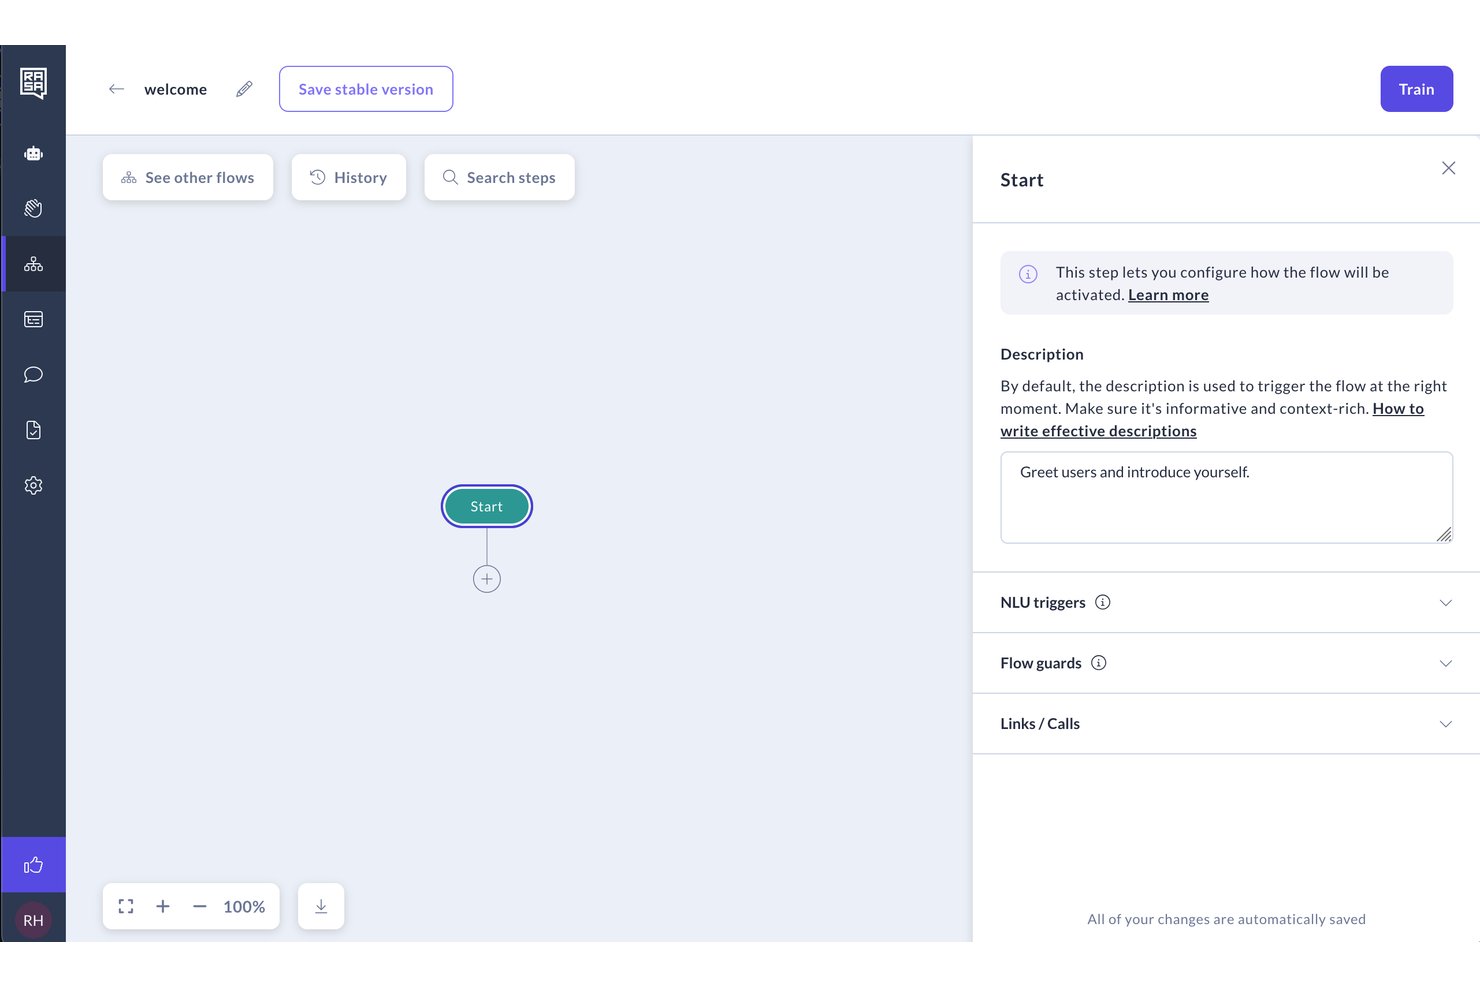
Rasa ist ein Open-Source-Framework für konversationelle NLP-Anwendungen, das eine modulare NLU-Pipeline, eine benutzerdefinierte Intent-Klassifizierung, die Erkennung benannter Entitäten, LLM-Integration über seine CALM-Architektur sowie produktionsreife Bereitstellungsoptionen einschließlich On-Premises- und isolierten Umgebungen bietet.
Für wen ist Rasa am besten geeignet?
Rasa eignet sich besonders für ML/NLP-Ingenieure und DevOps-Teams in regulierten Branchen, die vollständige Kontrolle über ihre Bereitstellungsumgebung für konversationelle KI benötigen.
Warum ich Rasa ausgewählt habe
Ich habe Rasa in meine Top-Auswahl aufgenommen, weil es die stärkste Option ist, die ich für Teams gefunden habe, die konversationelle NLP vollständig auf ihrer eigenen Infrastruktur bereitstellen müssen. Die Kubernetes-native Bereitstellung über Helm-Charts, die Unterstützung isolierter Umgebungen und die Verwaltung von Secrets mit HashiCorp Vault machen Rasa zu einer natürlichen Lösung für regulierte Branchen wie das Gesundheitswesen und das Finanzwesen, in denen Daten den eigenen Perimeter nie verlassen. Ich schätze außerdem die CALM-Architektur, die LLM-gesteuertes Sprachverständnis von deterministischer Geschäftslogik trennt und dadurch das Verhalten von Agenten in der Produktion vorhersehbar und überprüfbar hält.
Wichtige Funktionen von Rasa
- DIET-Klassifikator: Ein transformerbasiertes Modell, das Intent-Klassifizierung und Entitätsextraktion gleichzeitig innerhalb einer einzigen trainierbaren Architektur verarbeitet.
- Routing über mehrere LLMs: Ermöglicht die Zuweisung verschiedener LLMs zu unterschiedlichen Aufgaben innerhalb desselben Agenten und bietet dadurch Kontrolle über das Verhältnis von Kosten und Latenz.
- RAG-Modul für Unternehmen: Verbindet sich mit benutzerdefinierten Vektordatenbanken zur Wissensabfrage in Echtzeit und verankert Antworten in den eigenen Daten, ohne dass das Modell erneut trainiert werden muss.
- Wiederverwendung mehrsprachiger Abläufe: Stellt dieselben Gesprächsabläufe in mehreren Sprachen bereit und unterstützt den Sprachwechsel während eines Gesprächs, ohne den Kontext zu verlieren.
Rasa-Integrationen
Rasa dokumentiert Integrationen mit Hugging Face Transformers, spaCy, scikit-learn, Duckling, GPT-4, Llama, Redis, Apache Kafka, HashiCorp Vault und OpenTelemetry. REST- und WebSocket-APIs unterstützen benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- On-Premises- und Bereitstellung in isolierten Umgebungen unterstützt
- Vollständig Open Source mit anpassbaren Pipelines
- Wiederverwendung mehrsprachiger Abläufe bei Beibehaltung des Kontexts
Cons:
- Keine native Sentimentanalyse oder Zusammenfassung
- Die Open-Source-Edition befindet sich im Wartungsmodus

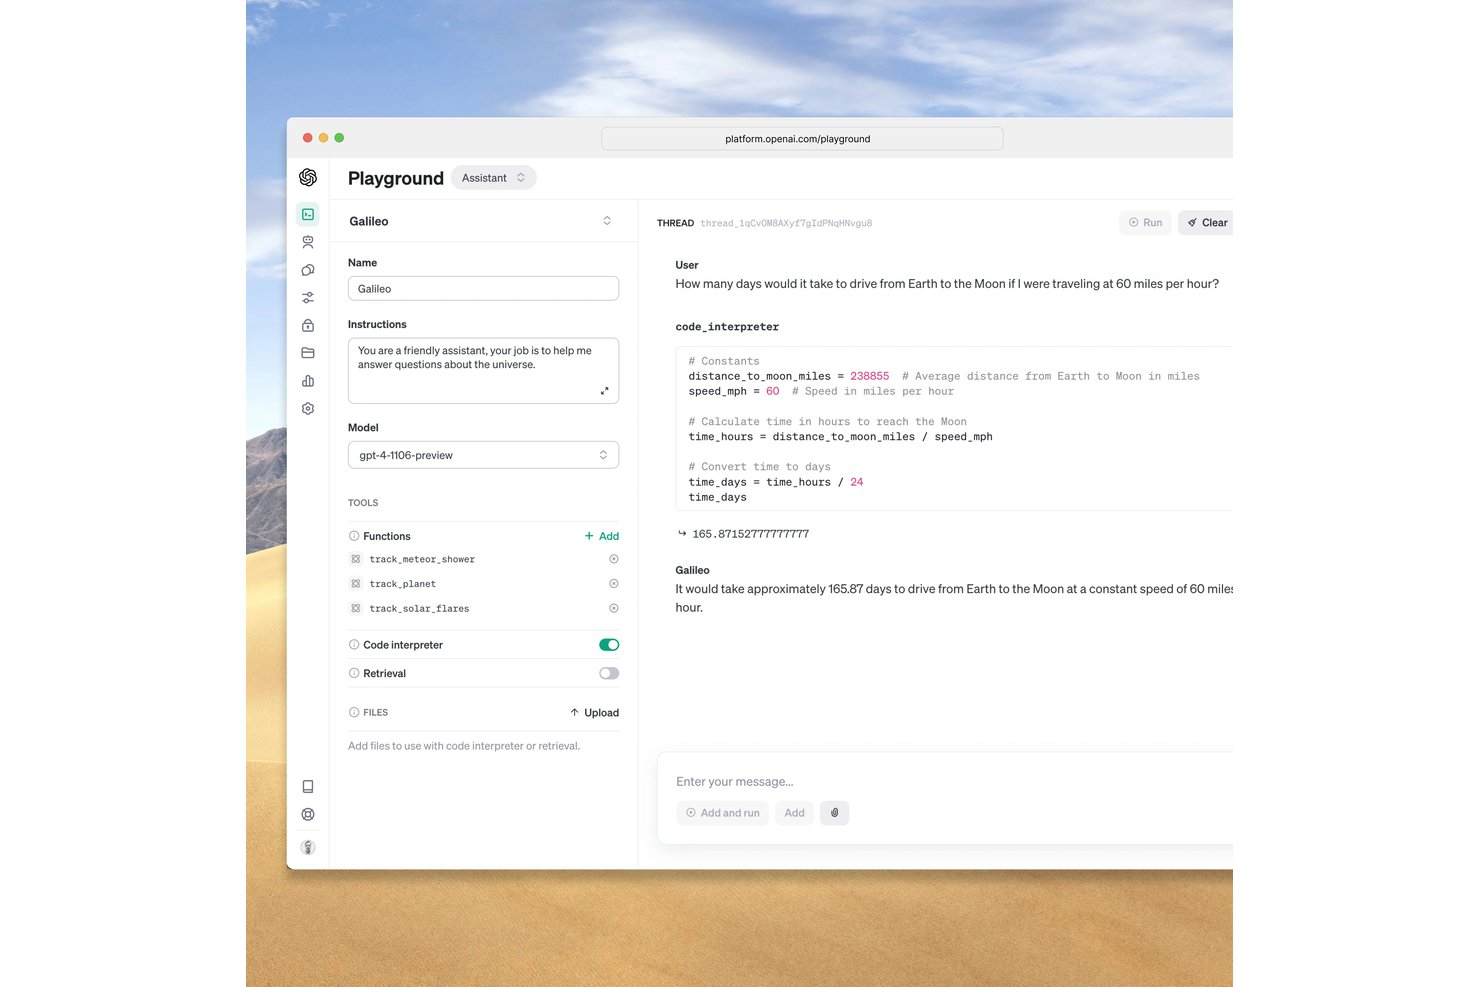
OpenAI ist eine KI-Plattform, die Entwicklern API-Zugriff auf einen umfangreichen Katalog großer Sprachmodelle, Einbettungsmodelle und Sprachmodelle bietet, um NLP-Anwendungen für Aufgaben wie Textklassifizierung, Entitätsextraktion, Zusammenfassung, Übersetzung und semantische Suche zu entwickeln.
Für wen ist OpenAI am besten geeignet?
OpenAI eignet sich besonders für ML-Ingenieure und Entwicklungsteams, die zuverlässigen, skalierbaren API-Zugriff auf führende Sprachmodelle benötigen, ohne die zugrunde liegende Infrastruktur verwalten zu müssen.
Warum ich OpenAI ausgewählt habe
OpenAI gehört zu meiner engeren Auswahl, weil keine andere Plattform direkten API-Zugriff auf einen breiteren Katalog führender Modelle auf diesem Qualitätsniveau bietet. Besonders gefällt mir, wie die Responses API, die Batch API und die Einbettungsmodelle zusammenarbeiten: Sie können umfangreiche NER- oder Klassifizierungsaufgaben über die Batch API mit 50 % geringeren Kosten ausführen und die Ergebnisse anschließend für semantisches Clustering in
text-embedding-3-large
einspeisen – und das alles ohne Verwaltung einer Infrastruktur. Das Programm für benutzerdefinierte Modelle ist ein weiteres herausragendes Merkmal und liefert nachweislich Ergebnisse im Produktiveinsatz, beispielsweise Harveys Genauigkeitssteigerung von 83 % bei juristischem NLP.
Wichtige Funktionen von OpenAI
- Tiktoken-Tokenizer: Ein quelloffener BPE-Tokenizer, der die interne Tokenisierung von OpenAI nachbildet und es Ihnen ermöglicht, Tokens zu zählen und die Grenzen des Kontextfensters vor dem Durchführen von API-Aufrufen zu verwalten.
- Strukturierte Ausgaben über den JSON-Modus: Erzwingt, dass Modellantworten einem definierten JSON-Schema entsprechen, wodurch die Extraktion von Entitäten oder Klassifizierungsbezeichnungen in großem Maßstab zuverlässig möglich wird.
- Einbettungs-API: Erstellt dichte Vektordarstellungen von Text mithilfe von
text-embedding-3-smallodertext-embedding-3-largefür semantische Suche, Clustering und Klassifizierungsaufgaben. - Batch API: Verarbeitet große Mengen von Inferenzanfragen asynchron und bietet dabei einen Kostenrabatt von 50 % gegenüber synchronen API-Aufrufen.
OpenAI-Integrationen
OpenAI lässt sich in LangChain, LlamaIndex, Azure OpenAI Service, Pinecone, Weaviate, Qdrant, Chroma und Temporal integrieren. Die APIs und offiziellen SDKs unterstützen benutzerdefinierte Verbindungen zu Vektordatenbanken, Unternehmenssystemen und CI/CD-Workflows.
Pros and Cons
Pros:
- Führende LLMs, die mit erstklassigen Benchmarks aktualisiert werden
- Die Batch API senkt die Kosten für die Verarbeitung großer Datenmengen
- Feinabstimmung mit nachgewiesenen Fallstudien aus dem Unternehmensbereich
Cons:
- Kein Hosting vor Ort oder in einer privaten Cloud
- Keine klassische NLP-Vorverarbeitungspipeline verfügbar

Am besten für die gemeinsame Analyse von Text- und strukturierten Daten geeignet
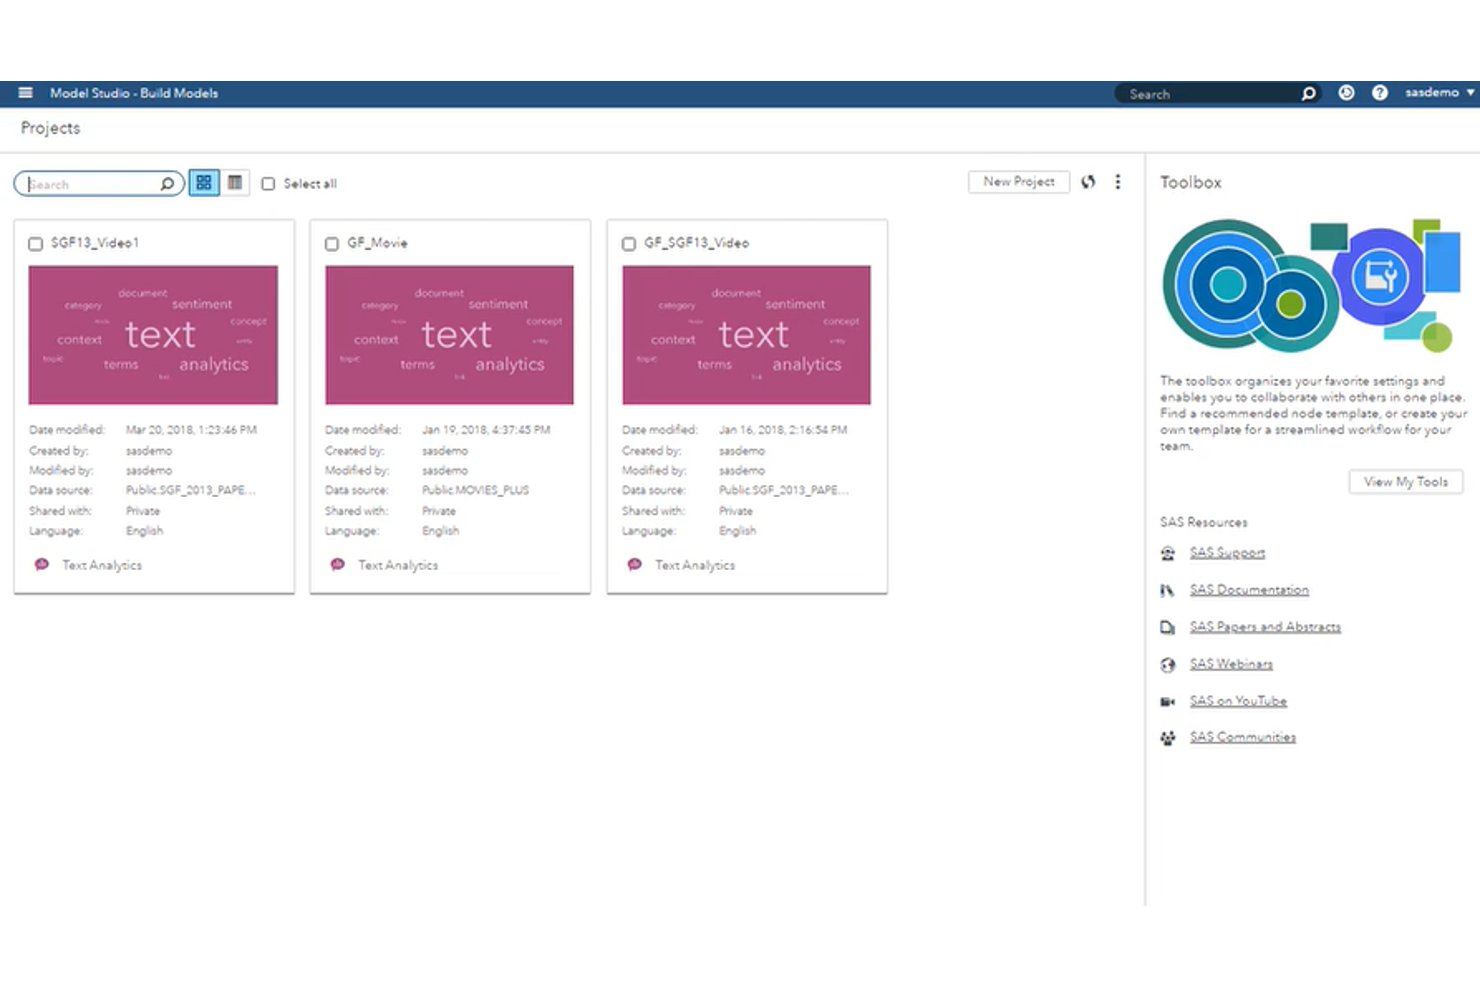
SAS Visual Analytics ist eine Plattform für Unternehmensanalysen und NLP, die visuelle Datenexploration, Textanalysen, Themenmodellierung, Sentimentanalyse und NER mit einem codefreien Pipeline-Editor und einem generativen KI-Assistenten kombiniert.
Für wen eignet sich SAS Visual Analytics am besten?
SAS Visual Analytics eignet sich besonders für Teams für Datenwissenschaft in Großunternehmen, die strukturierte und unstrukturierte Textdaten innerhalb einer einzigen verwalteten Plattform analysieren müssen.
Warum ich SAS Visual Analytics ausgewählt habe
Ich habe SAS Visual Analytics ausgewählt, weil es eine der wenigen NLP-Plattformen ist, die strukturierte Datenanalyse und Textanalysen tatsächlich in einer Lösung vereint, ohne dass separate Tools miteinander verbunden werden müssen. SAS Visual Text Analytics, das parallel dazu ausgeführt wird, übernimmt NER, eine BERT-basierte Sentimentanalyse und Themenmodellierung innerhalb derselben verwalteten Umgebung, in der Ihre strukturierten Daten bereits liegen. Besonders gut gefällt mir die LLM-Kalibrierungsfunktion, mit der Sie das Modellverhalten für RAG-Pipelines anpassen können, ohne das Basismodell selbst zu verändern – ein echter Vorteil bei der Arbeit mit sensiblen Unternehmensdaten.
Wichtige Funktionen von SAS Visual Analytics
- Textvorverarbeitung in 33 Sprachen: Tokenisierung, Lemmatisierung und POS-Kennzeichnung sind nativ für 33 Sprachen verfügbar, darunter Arabisch, Hindi, Thai und Vietnamesisch.
- Hybrider NLP-Pipeline-Editor: Über eine codefreie visuelle Oberfläche können regelbasierte Knoten sowie Knoten für ML und Tiefenlernen zu einer einzigen Textanalyse-Pipeline kombiniert werden.
- SAS Micro Analytic Score API: Eine zustandslose, speicherresidente Bewertungs-API für leistungsstarke Echtzeit-Modellinferenz in Produktionsumgebungen.
- Übertragbare ASTORE-Modelldateien: Trainierte Modelle werden als binäre ASTORE-Dateien exportiert und ermöglichen die Bewertung außerhalb der SAS-Umgebung auf Cloud- und lokalen Zielsystemen.
Integrationen von SAS Visual Analytics
SAS Visual Analytics bietet native Integrationen innerhalb des Microsoft-Umfelds, einschließlich Microsoft 365 und Azure, sowie Unterstützung für Bereitstellungen auf AWS, Google Cloud Platform und Red Hat OpenShift. Die REST-APIs und SDKs von SAS Viya unterstützen benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Native mehrsprachige Unterstützung für 33 Sprachen
- Einheitliche Plattform für Text- und strukturierte Daten
- Generative KI mit integrierten Bias-Kontrollen
Cons:
- Erweiterte NLP-Funktionen erfordern ein separates Add-on
- Weniger flexibel als quelloffene NLP-Frameworks
Am besten geeignet für die Verarbeitung von Dokumenten mit großem Kontext über offene LLMs
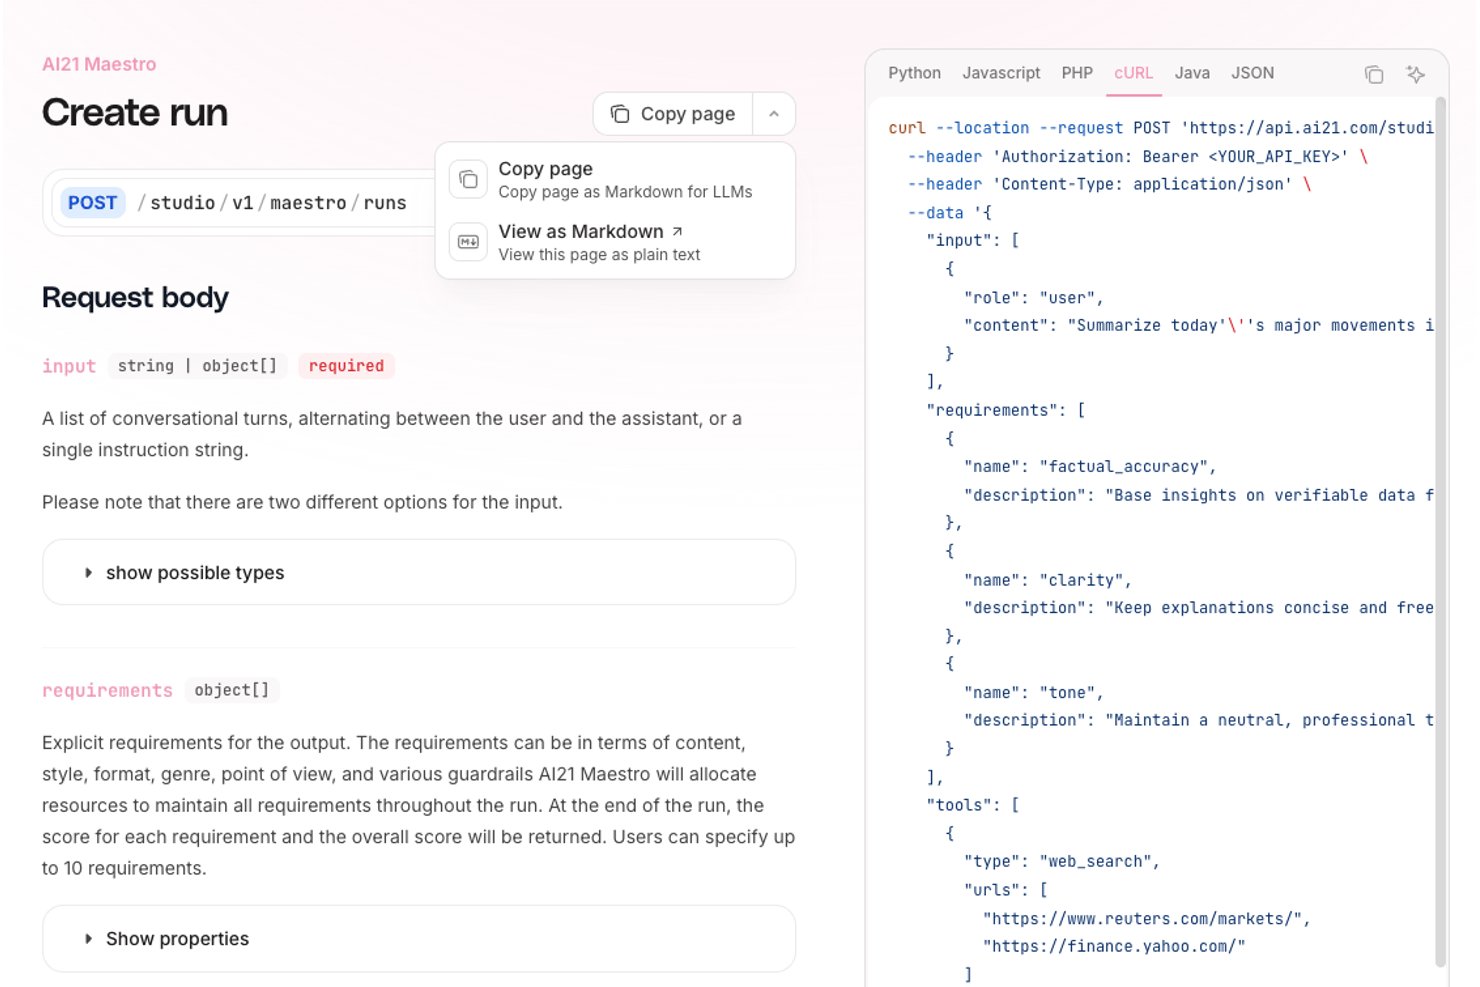
AI21 Studio ist eine LLM-Plattform, die rund um die Jamba-Familie hybrider Mamba-Transformer-Modelle entwickelt wurde und Textgenerierung, Zusammenfassungen, Fragenbeantwortung, Klassifizierung, RAG-Orchestrierung sowie mehrstufige Feinabstimmung über API, SDK und verwaltete Cloud-Dienste bietet.
Für wen ist AI21 Studio am besten geeignet?
AI21 Studio eignet sich besonders für ML-Ingenieurinnen und -Ingenieure sowie Unternehmensteams, die RAG-Pipelines oder wissensbasierte Workflows auf großen, unstrukturierten Dokumentensammlungen entwickeln.
Warum ich AI21 Studio ausgewählt habe
AI21 Studio hat sich einen Platz auf meiner Auswahlliste verdient, weil die Jamba-Modellfamilie wirklich große Dokumentenverarbeitungsaufgaben besonders gut bewältigt. Das Kontextfenster mit 256.000 Tokens ist das größte unter den verfügbaren Modellen mit offenen Gewichten. Dadurch kann ich vollständige Verträge, Berichte zu klinischen Studien oder M&A-Unterlagen in einen einzigen Inferenzaufruf einspeisen, ohne sie in Abschnitte aufteilen zu müssen. Kombiniert man dies mit der Maestro-RAG-Orchestrierungsebene, die dynamisch zwischen Dateisuche, Websuche und LLMs weiterleitet und gleichzeitig ein visuelles Ausführungsdiagramm bereitstellt, erhält man eine leistungsstarke Pipeline zur Extraktion strukturierter Erkenntnisse aus umfangreichen, unstrukturierten Datensammlungen.
Wichtige Funktionen von AI21 Studio
- Hybride Jamba-Architektur: Jamba-Modelle kombinieren Mamba-SSM-Schichten mit Transformer-Aufmerksamkeit in einer Architektur mit Expertenmischung und ermöglichen dadurch eine bis zu 2,5-mal schnellere Inferenz als vergleichbar große Modelle, die ausschließlich auf Transformern basieren.
- API für mehrstufige Feinabstimmung: Unterstützt vollständige Feinabstimmung, LoRA und QLoRA über standardmäßige HuggingFace-Bibliotheken sowie einen verwalteten Post-Training-Dienst für Unternehmensteams, die das resultierende Modell selbst besitzen möchten.
- Intelligentes Gateway: Eine direkt integrierbare Weiterleitungsebene, die die Kosten pro Agent analysiert, redundanten Kontext komprimiert und Modelle adaptiv pro Gesprächsrunde auswählt – derzeit während der Betaphase kostenlos.
- Offene Modellgewichte auf Hugging Face: Jamba-Modelle sind unter der Jamba Open Model License öffentlich verfügbar. Dadurch kann Ihr Team sie selbst hosten, überprüfen oder weiter anpassen, ohne an einen Anbieter gebunden zu sein.
Integrationen von AI21 Studio
AI21 Studio lässt sich in AWS, Microsoft Azure, Google Cloud, NVIDIA NIM, Hugging Face, LangChain, LlamaIndex, Pinecone, Snowflake und Databricks integrieren. Die REST-API, das Python-SDK und das TypeScript-SDK unterstützen benutzerdefinierte Integrationen und Bereitstellungs-Workflows.
Pros and Cons
Pros:
- Verarbeitet lange Dokumenteingaben mit 256.000 Tokens
- Unterstützt vollständige Feinabstimmung sowie LoRA und QLoRA
- Offene Modellgewichte für Selbsthosting
Cons:
- Keine dedizierte NER- oder Sentiment-API
- Kein visueller Baukasten ohne Code für NLP-Pipelines
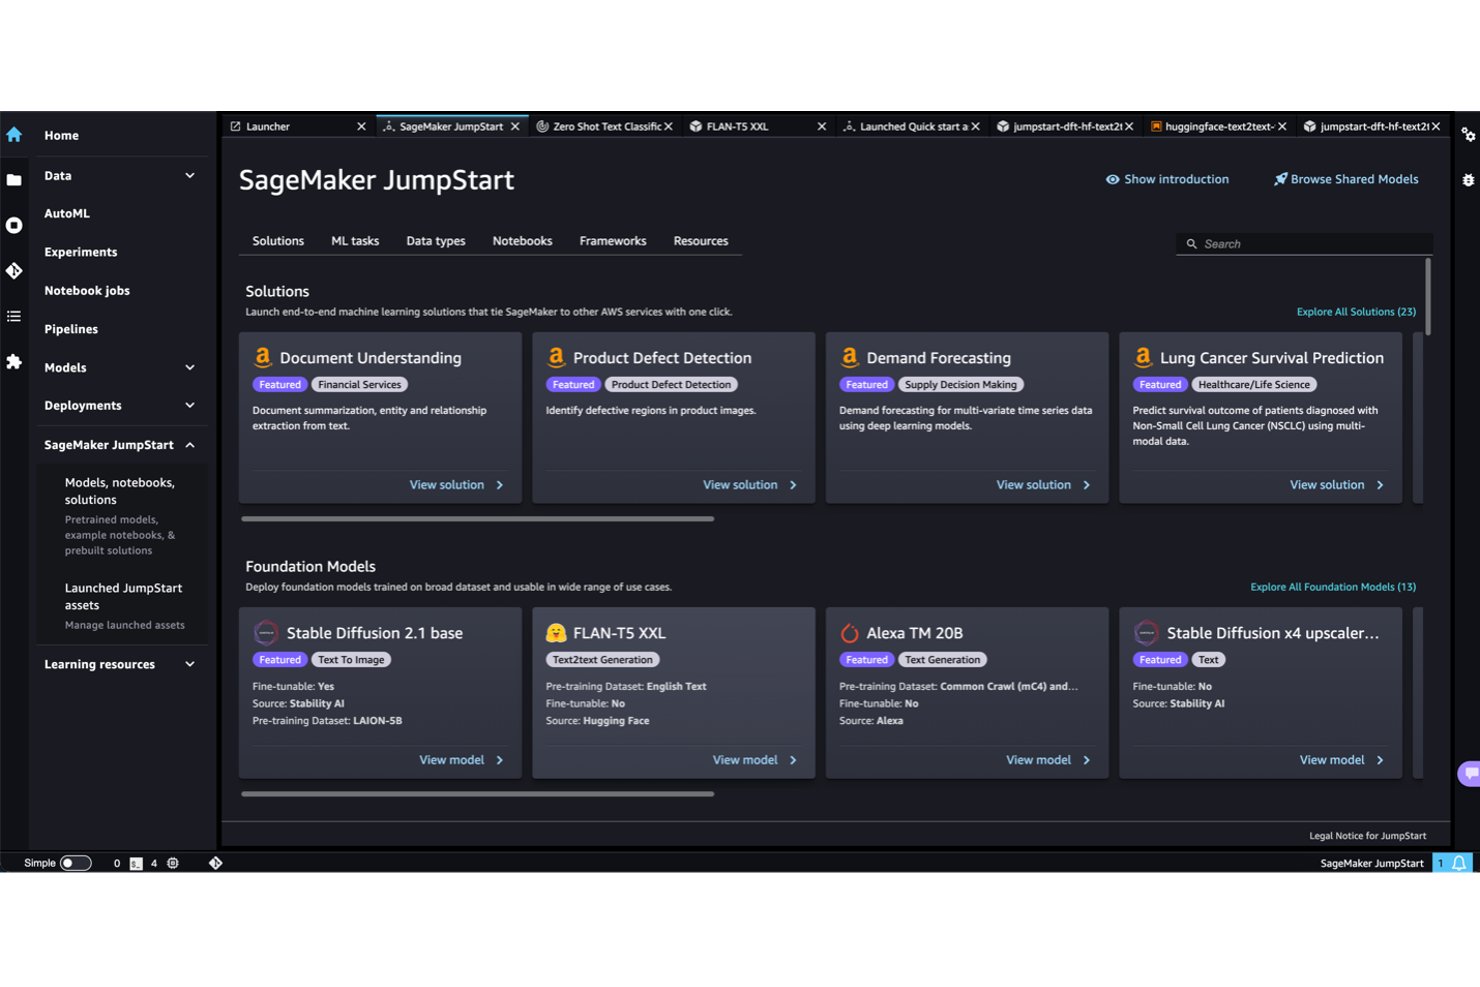
Amazon SageMaker ist die verwaltete ML-Plattform von AWS, die den gesamten Lebenszyklus von NLP-Modellen abdeckt – von der Datenvorverarbeitung und Tokenisierung bis hin zum Training, zur Feinabstimmung und zur Bereitstellung großer Sprachmodelle im großen Maßstab mit Tools wie JumpStart, HyperPod und nativen Integrationen für Hugging Face.
Für wen ist Amazon SageMaker am besten geeignet?
Amazon SageMaker ist die richtige Wahl für ML-Ingenieure und MLOps-Teams in mittleren bis großen Unternehmen, die eine einzige Plattform benötigen, um LLMs von Rohdaten bis zur Produktion im großen Maßstab zu bringen.
Warum ich Amazon SageMaker ausgewählt habe
Amazon SageMaker verdient seinen Platz auf meiner Auswahlliste, weil keine andere verwaltete ML-Plattform eine vergleichbare Tiefe bei der durchgängigen LLM-Feinabstimmung im großen Maßstab bietet. Besonders beeindruckt mich HyperPod, mit dem sich die verteilte Feinabstimmung über Hunderte von Beschleunigern hinweg ausführen lässt. Das checkpointlose, elastische Training verkürzt die Trainingszeit um bis zu 40 %. Der Katalog von JumpStart mit über 1.000 Modellen, darunter Llama 4, DeepSeek R1 und medizinische LLMs von John Snow Labs, ermöglicht es mir, ein domänenspezifisches Basismodell auszuwählen und es mit benutzerdefinierten Daten fein abzustimmen, ohne die Plattform verlassen zu müssen.
Wichtige Funktionen von Amazon SageMaker
- SageMaker Clarify: Erkennt Verzerrungen und erstellt Berichte zur Erklärbarkeit von NLP-Modellen während Training, Evaluierung und Überwachung nach der Bereitstellung.
- SageMaker Data Wrangler: Bietet eine Low-Code-Oberfläche zum Importieren, Transformieren und Vorbereiten von Textdaten vor dem Modelltraining.
- Inferenz-Endpunkte mit mehreren Betriebsarten: Unterstützt Optionen für Echtzeit-, serverlose, asynchrone und Batch-Inferenz auf über 70 Instanztypen, einschließlich Inferentia- und Trainium-Chips.
- Verwaltete MLflow-Integration: Verfolgt Experimente, vergleicht Modelläufe und verwaltet die Versionierung in NLP-Workflows, ohne dass eine separate Infrastruktur erforderlich ist.
Integrationen von Amazon SageMaker
Amazon SageMaker bietet native Integrationen mit Amazon S3, Amazon Bedrock, Amazon OpenSearch Service, Amazon EKS, AWS Lambda, Amazon CloudWatch, AWS IAM, Hugging Face und MLflow. Außerdem stehen REST APIs, SDKs und der AWS CLI für benutzerdefinierte Integrationen zur Verfügung.
Pros and Cons
Pros:
- Größter verfügbarer Katalog vortrainierter Modelle
- HyperPod unterstützt umfangreiches verteiltes LLM-Training
- Durchgängiger Lebenszyklus mit Tools zur Erklärbarkeit
Cons:
- Die Kostenverfolgung ist für die meisten Teams schwierig
- Risiko der Anbieterbindung für Multi-Cloud-Unternehmen

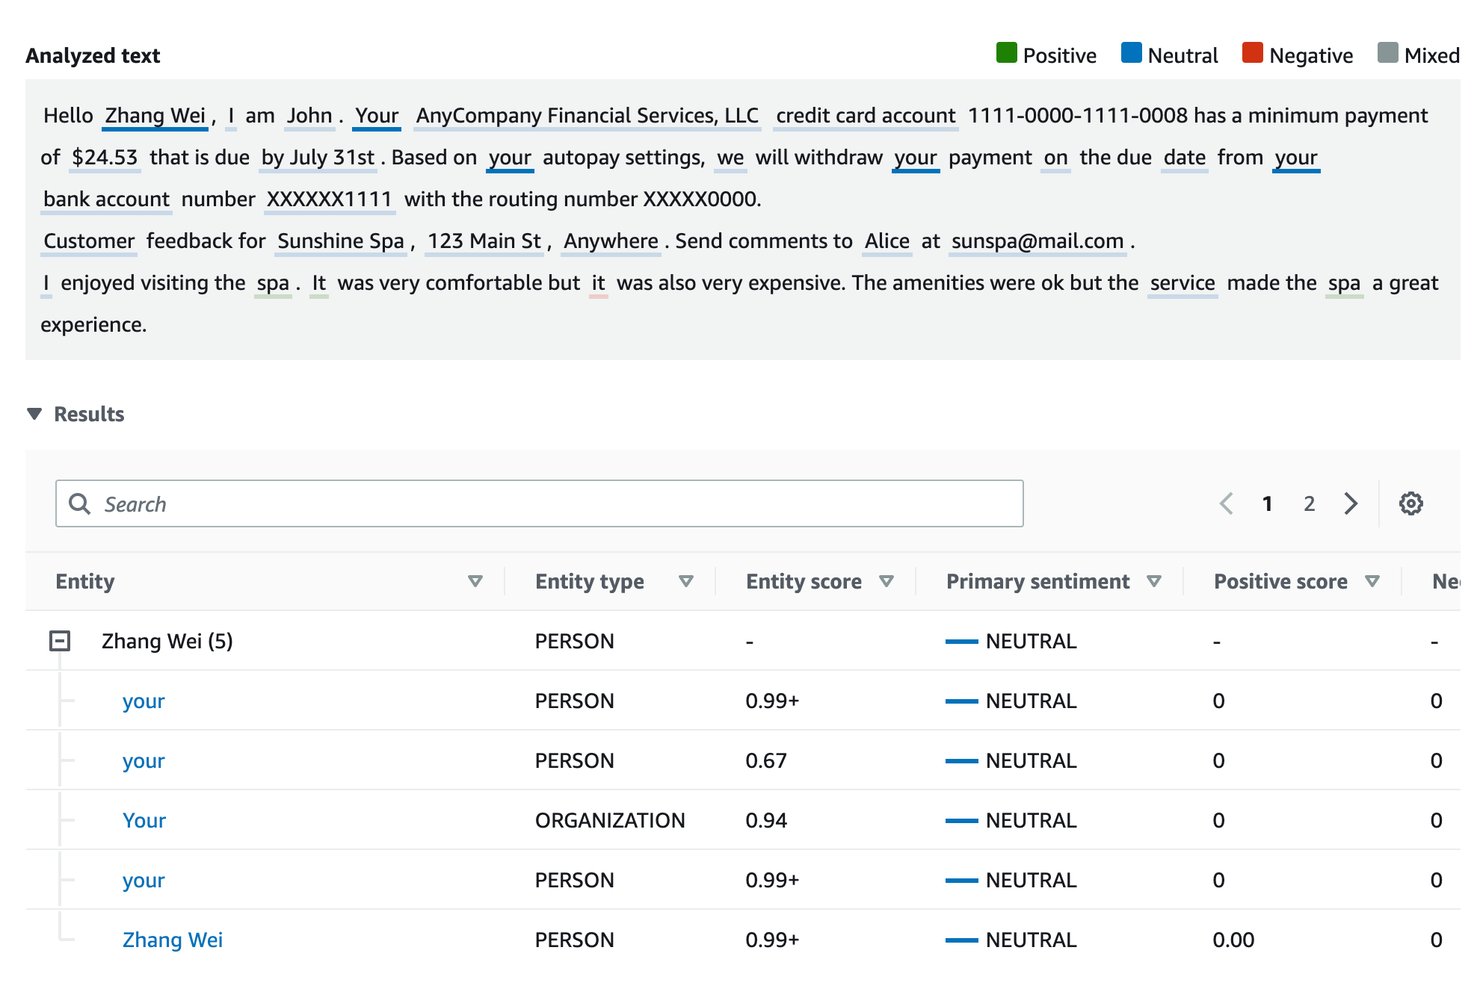
Amazon Comprehend ist ein vollständig verwalteter AWS-NLP-Dienst, der vorgefertigte, API-gesteuerte Funktionen zur Textanalyse bereitstellt – darunter Sentimentanalyse, Erkennung benannter Entitäten, Erkennung personenbezogener Daten, Extraktion von Schlüsselphrasen und das Training benutzerdefinierter Modelle über AutoML – ohne dass Sie die zugrunde liegende Infrastruktur verwalten müssen.
Für wen eignet sich Amazon Comprehend am besten?
Amazon Comprehend eignet sich besonders für Engineering- und DevOps-Teams, die bereits Workloads in AWS ausführen und produktionsbereite NLP-Funktionen benötigen, ohne ML-Infrastruktur verwalten zu müssen.
Warum ich Amazon Comprehend ausgewählt habe
Amazon Comprehend steht auf meiner engeren Auswahl, weil es sich für native AWS-Textanalyse im großen Maßstab am natürlichsten eignet. Mir gefällt, dass Sie Sentimentanalyse, gezielte Entitätserkennung und die Schwärzung personenbezogener Daten direkt über verwaltete API-Endpunkte ausführen können, ohne einen einzigen Server bereitstellen zu müssen. In der Praxis bedeutet das, dass mein Team Millionen von Kundendatensätzen aus S3 asynchron verarbeiten kann – mit volumenabhängiger Preisgestaltung, die tatsächlich günstiger wird, je mehr Sie analysieren.
Die wichtigsten Funktionen von Amazon Comprehend
- Benutzerdefinierte Entitätserkennung: Trainieren Sie einen domänenspezifischen Entitätserkenner mit Ihren eigenen gekennzeichneten Beispielen, um Begriffe wie Policennummern oder interne Codes zu extrahieren, die von vorgefertigten Modellen nicht erkannt werden.
- Erkennung und Schwärzung personenbezogener Daten: Identifizieren und schwärzen Sie automatisch sensible personenbezogene Daten – Namen, Sozialversicherungsnummern und Kreditkartennummern – direkt in Ihrer Dokumentverarbeitungspipeline.
- Flywheel-MLOps-Automatisierung: Verwalten Sie den gesamten Lebenszyklus benutzerdefinierter Modelle, von der Datenaufnahme über das erneute Training bis zur Versionsfreigabe, ohne eine separate MLOps-Schicht entwickeln zu müssen.
- Verknüpfung mit der Comprehend-Medical-Ontologie: Ordnen Sie extrahierte klinische Entitäten standardisierten Kodierungssystemen wie ICD-10-CM, RxNorm und SNOMED CT zu, um NLP-Workflows für das Gesundheitswesen zu realisieren.
Integrationen von Amazon Comprehend
Amazon Comprehend bietet native Integrationen mit Amazon S3, AWS Lambda, AWS KMS, AWS IAM, Amazon Kendra, Amazon Lex, Amazon Connect, AWS CloudTrail und Amazon CloudWatch. Die REST-API, AWS-SDKs, AWS CLI, Step Functions und EventBridge unterstützen benutzerdefinierte Pipelines und die Workflow-Automatisierung.
Pros and Cons
Pros:
- Native Eignung für AWS-zentrierte NLP-Workflows
- NLP für das Gesundheitswesen mit Zuordnung zu klinischen Ontologien
- Integrierte Erkennung und Schwärzung personenbezogener Daten
Cons:
- Kein Zugriff auf die internen Modellkomponenten
- Eingeschränkte Feinabstimmung über grundlegendes AutoML hinaus

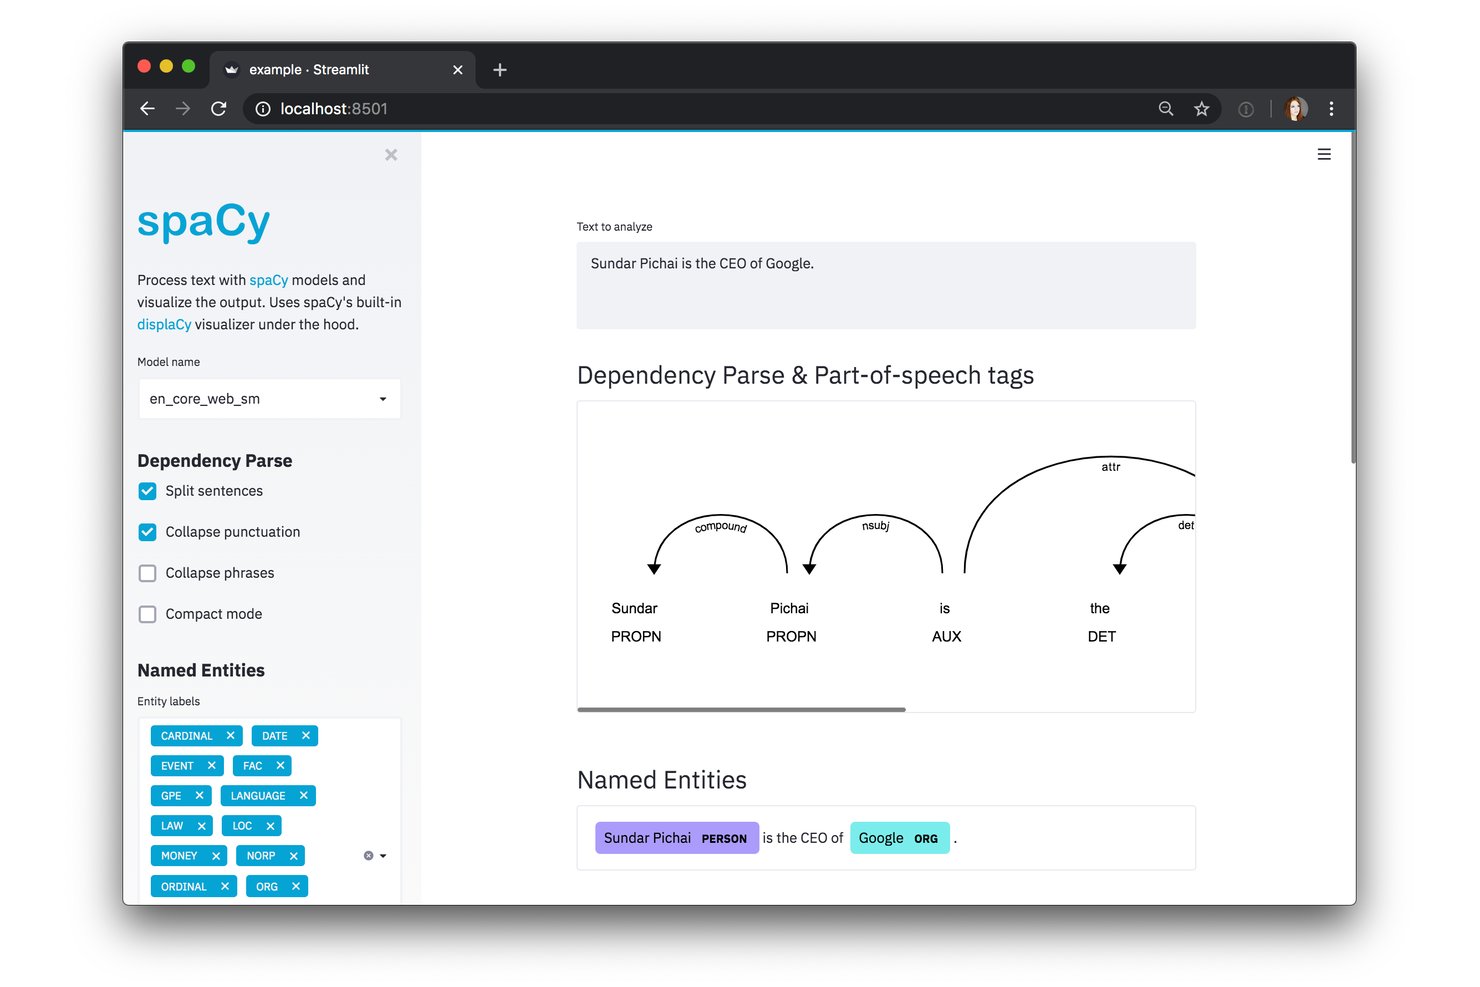
spaCy ist eine weithin anerkannte NLP-Bibliothek, die für professionelle Anwendungen entwickelt wurde. Mit ihrem Fokus auf Leistung und Praxistauglichkeit bietet sie Lösungen, die speziell für die Verarbeitung großer Informationsmengen ausgelegt sind, und ist damit eine erstklassige Wahl für NLP-Aufgaben auf Industrie-Niveau.
Warum ich spaCy ausgewählt habe: Bei der Auswahl der NLP-Bibliotheken für diese Liste stachen die Fähigkeiten von spaCy gegenüber den anderen hervor. Ich habe mich aufgrund der beeindruckenden Leistungswerte und des Rufs in der Community für spaCy entschieden, wenn es um die Verarbeitung riesiger Datensätze geht. Angesichts des Designs besteht für mich kein Zweifel daran, dass spaCy „am besten für NLP-Aufgaben auf Industrie-Niveau geeignet ist“.
Herausragende Funktionen & Integrationen:
spaCy überzeugt mit seinen Fähigkeiten zur Tokenisierung, zur Kennzeichnung von Wortarten und zur Erkennung benannter Entitäten. Die neuronalen Netzwerkmodelle sind sowohl präzise als auch effizient. Im Hinblick auf Integrationen ergänzt spaCy Data-Science-Tools wie Scikit-learn und TensorFlow und lässt sich dadurch in verschiedenen Datenverarbeitungspipelines einsetzen.
Pros and Cons
Pros:
- Hocheffiziente und präzise NLP-Aufgaben
- Leistungsstarke Unterstützung für mehrere Sprachen
- Einfache Integration in beliebte Data-Science-Bibliotheken
Cons:
- Erfordert solide Kenntnisse in der Python-Programmierung
- Einige erweiterte Funktionen oder Tools können zusätzliche Kosten verursachen
- Die Ersteinrichtung und Anpassung kann für Anfänger komplex sein
Am besten für NLP mit Governance in hybriden Cloud-Bereitstellungen geeignet
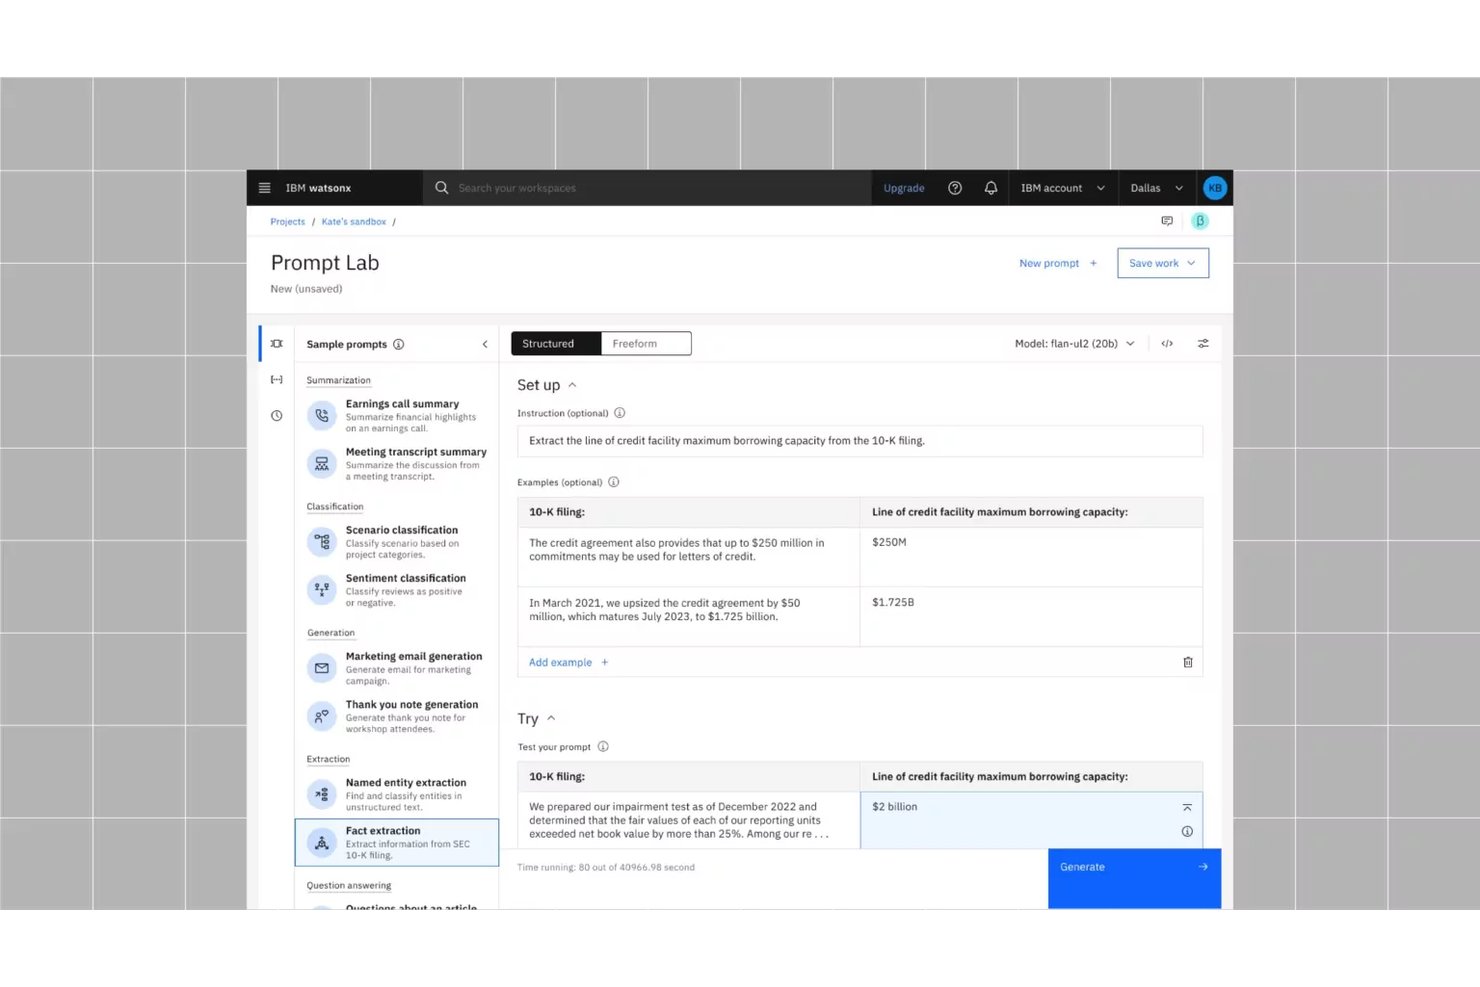
IBM watsonx.ai ist eine KI-Unternehmensplattform, die einen Katalog von Basismodellen mehrerer Anbieter, die Watson-NLP-Bibliothek, LoRA/QLoRA-Feinabstimmung, AutoML sowie flexible SaaS-, lokale und hybride Cloud-Bereitstellungsoptionen zum Erstellen und Skalieren von NLP-Workloads kombiniert.
Für wen ist IBM watsonx.ai am besten geeignet?
IBM watsonx.ai eignet sich besonders für IT- und Data-Science-Teams in Unternehmen, die NLP-Workloads in lokalen, hybriden und Cloud-Umgebungen erstellen, feinabstimmen und bereitstellen müssen und dabei strenge Anforderungen an Governance und Compliance erfüllen.
Warum ich mich für IBM watsonx.ai entschieden habe
IBM watsonx.ai hat sich einen Platz auf meiner engeren Auswahlliste verdient, weil die Plattform NLP mit Governance in hybriden Cloud-Umgebungen besonders gut unterstützt. Das ist ein echter Differenzierungsfaktor für Unternehmensteams mit strengen Compliance-Anforderungen. Besonders beeindruckt mich die Watson-NLP-Bibliothek, die NER, Sentimentanalyse, Tonfallklassifizierung und semantische Rollenkennzeichnung in mehr als 20 Sprachen innerhalb einer einzigen, überprüfbaren Pipeline abdeckt. In Verbindung mit CP4D auf Red Hat OpenShift für lokale oder hybride Bereitstellungen und AI Factsheets für Prüfpfade von Modellen erhalten Sie eine durchgängige Governance auf jeder Ebene.
Wichtige Funktionen von IBM watsonx.ai
- Katalog von Basismodellen mehrerer Anbieter: Greifen Sie über eine einzige gehostete Bibliothek auf vortrainierte Modelle von IBM Granite, Meta Llama, Mistral, DeepSeek und NVIDIA zu.
- LoRA/QLoRA-Feinabstimmung: Passen Sie Basismodelle mithilfe einer parameterschonenden Feinabstimmung in GPU-beschleunigten Umgebungen an domänenspezifische NLP-Aufgaben an.
- AutoAI-Pipeline-Builder: Übernimmt automatisch die Datenaufbereitung, das Feature Engineering, die Modellauswahl und die Abstimmung von Hyperparametern für prädiktive ML-Workflows.
- Mit OpenAI kompatibler API-Endpunkt: Verbinden Sie bestehende Anwendungen über ein mit OpenAI kompatibles REST-API-Format sowie Python-, Node.js- und Java-SDKs mit der Inferenz von watsonx.ai.
Integrationen von IBM watsonx.ai
IBM watsonx.ai lässt sich in Hugging Face, Red Hat OpenShift, watsonx.data, Watson Assistant, watsonx Orchestrate, Watson Discovery und IBM Cloud Object Storage integrieren. Die REST-API sowie Python-, Node.js- und Java-SDKs unterstützen benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Breite Abdeckung von NLP-Aufgaben in mehr als 20 Sprachen
- Schadloshaltung für geistiges Eigentum bei IBM-Unternehmensmodellen
- Native Unterstützung für RAG und Vektorsuche
Cons:
- Proprietäre IBM-Modelle sind für AWS nicht verfügbar
- Die Benutzeroberfläche kann für neue Benutzer verwirrend sein
Am besten für Textanalyse-Pipelines geeignet, die nativ auf GCP ausgeführt werden
Hugging Face
Am besten für die Feinabstimmung quelloffener Modelle in großem Maßstab geeignet
Hugging Face ist eine quelloffene NLP-Plattform, die Ihnen Zugriff auf über 2 Millionen vortrainierte Modelle sowie eine vollständige Suite von Werkzeugen für Tokenisierung, Feinabstimmung und die Bereitstellung von Modellen in Cloud- und lokalen Umgebungen bietet.
Für wen ist Hugging Face am besten geeignet?
Hugging Face ist die bevorzugte Plattform für ML- und NLP-Ingenieure, die direkten Zugriff auf quelloffene Modelle und die vollständige Werkzeugkette benötigen, um diese in großem Maßstab fein abzustimmen, zu bewerten und bereitzustellen.
Warum ich mich für Hugging Face entschieden habe
Hugging Face steht auf meiner Auswahlliste, weil keine andere Plattform bei der Feinabstimmung quelloffener Modelle in großem Maßstab mithalten kann. Ich schätze besonders, dass PEFT und QLoRA die Feinabstimmung von LLMs mit Milliarden Parametern wie LLaMA oder Mistral auf einer einzigen GPU ermöglichen. Dadurch sinken die Rechenkosten drastisch, ohne dass die Qualität beeinträchtigt wird. Die TRL-Bibliothek ergänzt dies um vollständige Unterstützung für RLHF und DPO, sodass Sie domänenspezifische Modelle mit minimalem Aufwand ausrichten können.
Wichtige Funktionen von Hugging Face
- Transformers-Pipeline-API: Eine einzeilige Schnittstelle zur Ausführung von NLP-Aufgaben – Klassifizierung, NER, Zusammenfassung, Übersetzung und QA – mit jedem Modell im Hub.
- AutoTrain: Eine codefreie Trainingsschnittstelle, über die Sie einen gekennzeichneten Datensatz hochladen und eine Aufgabe auswählen. Die Plattform übernimmt die Modellauswahl und das Training automatisch.
- Inferenz für Texteingebettungen (TEI): Eine dedizierte Inferenz-Engine, die für die Erzeugung von Einbettungen mit hohem Durchsatz optimiert ist und semantische Suche sowie RAG-Pipelines in großem Maßstab unterstützt.
- API der Inferenzanbieter: Ein einheitlicher, mit OpenAI kompatibler Endpunkt, der Anfragen mithilfe eines einzigen Hugging-Face-Tokens an Anbieter wie Groq, Together AI und Cerebras weiterleitet.
Integrationen von Hugging Face
Hugging Face lässt sich in PyTorch, TensorFlow, JAX, AWS SageMaker, Google Cloud, Azure, Weights & Biases, MLflow und Snowflake integrieren. Die Python-, JavaScript-, REST- und CLI-APIs unterstützen individuelle Integrationen und Bereitstellungs-Workflows.
Pros and Cons
Pros:
- Unübertroffene Auswahl an quelloffenen NLP-Modellen
- Ermöglicht die Feinabstimmung riesiger Modelle auf einer GPU
- AutoTrain ermöglicht codefreies Modelltraining
Cons:
- Community-Modelle unterscheiden sich hinsichtlich Qualität und Sicherheit
- Die für Unternehmen geeignete Bereitstellung erfordert DevOps-Kenntnisse
Weitere NLP-Software
Nachfolgend finden Sie eine Liste weiterer NLP-Softwarelösungen, die ich in die engere Auswahl genommen habe, die es jedoch nicht unter die Top 10 geschafft haben. Sie sind definitiv einen Blick wert.
- Snorkel
Am besten für programmatische Kennzeichnung im Unternehmensmaßstab geeignet
- Claude
Am besten für sicherheitsorientierte NLP-Anwendungen in allen großen Clouds
- Cohere North
Am besten für die Bereitstellung von NLP-Modellen in isolierten Netzwerken
- NLTK
Am besten für klassische NLP-Anwendungen ohne Infrastrukturkosten
- Stanford NLP
Am besten geeignet für sprachliche Präzision in über 80 Sprachen


Wie ich NLP-Software bewerte
Ich bewerte NLP-Tools auf zwei Ebenen: grundlegende Fähigkeiten – wie Entitätsextraktion, Feintuning und API-Bereitstellung – sowie die Unterscheidungsmerkmale, die gute von hervorragenden Optionen abheben.
Kernfunktionalität (Mindestanforderungen für diese Liste)
Diese Kernfunktionen dienen als Aufnahmekriterien für meine Auswahl der NLP-Software:
- Textvorverarbeitung & Tokenisierung: Ich prüfe, ob die Plattform Tokenisierung, Stemming, Lemmatisierung und Stoppwortentfernung in konfigurierbaren Pipelines unterstützt – besonders bei unstrukturierten Inputs wie Social-Media-Posts oder OCR-Ausgaben.
- Erkennung von benannten Entitäten & Informationsextraktion: Die Extraktion von benutzerdefinierten Entitäten aus Verträgen oder Support-Tickets erfordert mehr als generische NER, daher bewerte ich, wie tiefgreifend das Training eigener Entitäten und die Extraktion von Beziehungen möglich ist.
- Sentiment- & Intent-Klassifikation: Ich achte auf aspektbasierte Sentimentanalyse und mehrstufige Intent-Erkennung, nicht nur auf binäre Positiv/Negativ-Bewertungen, die bei echten Kundenfeedbacks schnell an ihre Grenzen stoßen.
- Modelltraining & Feintuning: Egal ob Sie ein Transformer-Modell an juristische Dokumente oder medizinische Notizen anpassen möchten, ich bewerte, wie viel Kontrolle die Plattform über Feintuning-Workflows und die Architekturwahl bietet.
- Mehrsprachige Sprachunterstützung: Globale Teams benötigen eine gleichwertige Funktionalität für alle Sprachen. Daher prüfe ich, wie viele Sprachen die Plattform abdeckt und ob zentrale NLP-Aufgaben auch jenseits des Englischen zuverlässig funktionieren.
- API/SDK-Bereitstellungsoptionen: Ich schaue auf REST- und gRPC-Endpunkte, SDKs für Python, Java und Node.js sowie darauf, ob skalierbare Produktionsmuster unterstützt werden.
Ich bewerte jeden Anbieter nach einer Skala von 0 (Funktionalität fehlt) bis 5 (exzellent in diesem Bereich) für jedes Kriterium.
Anbieter müssen einen bestimmten Durchschnittswert erreichen, um in meine Liste aufgenommen zu werden. Anschließend schaue ich, wodurch sich die einzelnen Plattformen unterscheiden.
Unterscheidungsmerkmale (Was Anbieter besonders macht)
Nachdem ich meine Auswahl getroffen habe, vergleiche und kontrastiere ich die verschiedenen Anbieter im Bereich NLP-Software folgendermaßen:
Herausragende Funktionen
Ich prüfe auf eine umfangreiche Bibliothek vorkonfigurierter Modelle, insbesondere für branchenspezifische Texte oder vertikale Domänen, da dies das Prototyping und die Implementierung deutlich beschleunigt. Integrierte No-Code-Annotationstools bieten echten Mehrwert für Teams, die ohne aufwändige Programmierung an eigenen Datensätzen arbeiten wollen. Retrieval-augmented-generation (RAG) und Vektorsuchfunktionen werden zunehmend wichtiger, um Ausgaben mit internem Wissen zu unterlegen. Gleichzeitig zählen MLOps-Funktionen wie Modellüberwachung und Drift-Erkennung besonders für größere Produktivumgebungen.
Über Funktionen hinaus
Bereitstellungsflexibilität ist hier ein entscheidender Faktor – ich bewerte, ob eine Plattform Cloud-, On-Premise- und Air-Gap-Optionen bietet, da Teams, die mit sensiblen Daten wie Gesundheitsakten oder Finanzdokumenten arbeiten, diese Kontrolle benötigen. Compliance-Zertifizierungen wie SOC 2, HIPAA und ISO 27001 spielen hier, insbesondere für regulierte Branchen, eine maßgebliche Rolle. Außerdem berücksichtige ich das Integrationsökosystem und prüfe, ob es Konnektoren zu ML-Frameworks wie PyTorch und Hugging Face sowie zu Geschäftsanwendungen wie Salesforce gibt. Auch eine transparente Preisgestaltung im großen Maßstab wird von mir besonders gewichtet.
So wählen Sie NLP-Software aus
Es ist leicht, sich in langen Funktionslisten und komplexen Preisstrukturen zu verlieren. Damit Sie bei der Bearbeitung Ihres individuellen Auswahlprozesses für Software den Fokus behalten, finden Sie hier eine Checkliste mit Faktoren, die Sie berücksichtigen sollten:
| Faktor | Was Sie berücksichtigen sollten |
|---|---|
| Skalierbarkeit | Kann die Software mit Ihrem Team wachsen? Achten Sie auf Tools, die größere Datenmengen ohne zusätzliche Kosten verarbeiten können. Berücksichtigen Sie zukünftige Anforderungen und mögliche Erweiterungen. |
| Integrationen | Funktioniert die Software mit Ihren bestehenden Systemen? Prüfen Sie die Kompatibilität mit Ihren aktuellen Tools, um Unterbrechungen im Arbeitsablauf zu vermeiden. |
| Anpassbarkeit | Können Sie die Software an Ihre Anforderungen anpassen? Stellen Sie sicher, dass Sie Einstellungen oder Funktionen an Ihre spezifischen Prozesse anpassen können. |
| Benutzerfreundlichkeit | Ist die Benutzeroberfläche benutzerfreundlich? Komplexe Tools können die Einführung verlangsamen. Achten Sie auf intuitive Designs, die nur eine minimale Schulung erfordern. |
| Implementierung und Einarbeitung | Wie lange dauert es, bis Sie starten können? Schätzen Sie den Zeitaufwand für Einrichtung und Schulung ein. Eine schnelle Einarbeitung kann Zeit und Ressourcen sparen. |
| Kosten | Passt die Software in Ihr Budget? Vergleichen Sie die Preispläne und achten Sie auf versteckte Gebühren. Berücksichtigen Sie die Gesamtbetriebskosten und nicht nur den anfänglichen Preis. |
| Sicherheitsvorkehrungen | Sind Ihre Daten geschützt? Stellen Sie die Einhaltung von Datenschutzstandards sicher und achten Sie auf Verschlüsselung sowie weitere Sicherheitsfunktionen. |
| Verfügbarkeit des Supports | Sind Supportdienste bei Bedarf erreichbar? Bewerten Sie die Verfügbarkeit und Qualität der Kundenservicekanäle wie Chat, E-Mail oder Telefon. |
Was ist NLP-Software?
NLP-Software ist ein Werkzeug, das menschliche Sprachdaten verarbeitet und analysiert. Fachleute wie Datenwissenschaftler, Marketingteams und Kundendienstteams nutzen diese Tools, um Erkenntnisse zu gewinnen und die Kommunikation zu verbessern. Funktionen zur Textanalyse, Sentimentanalyse und Sprachübersetzung helfen dabei, die Bedürfnisse der Nutzer zu verstehen und darauf zu reagieren.
Insgesamt verbessern diese Tools, einschließlich Software für Konversationsintelligenz, die Entscheidungsfindung und Effizienz bei sprachbezogenen Aufgaben.
Funktionen
Achten Sie bei der Auswahl von NLP-Software auf die folgenden wichtigen Funktionen:
- Textanalyse: Verarbeitet große Mengen an Textdaten, um aussagekräftige Erkenntnisse zu gewinnen, und hilft Teams dabei, Trends und Muster zu verstehen.
- Sentimentanalyse: Erkennt und kategorisiert in Texten ausgedrückte Meinungen, um die Einstellungen von Kunden zu beurteilen und Strategien zur Steigerung der Interaktion zu verbessern.
- Sprachübersetzung: Wandelt Text von einer Sprache in eine andere um und erleichtert so die globale Kommunikation und Zugänglichkeit.
- Spracherkennungssoftware: Transkribiert gesprochene Sprache in Text, ermöglicht Spracheingaben und verbessert die Zugänglichkeit.
- Entitätenerkennung: Erkennt und klassifiziert wichtige Elemente innerhalb eines Textes, etwa Namen und Datumsangaben, zur besseren Organisation von Daten.
- Mehrsprachige Unterstützung: Bietet Funktionen in mehreren Sprachen und ermöglicht dadurch einen breiteren Einsatz in verschiedenen Regionen.
- Anpassbare Modelle: Ermöglicht es Nutzern, Algorithmen an spezifische Anforderungen anzupassen und dadurch die Relevanz und Genauigkeit der Ergebnisse zu erhöhen.
- Verarbeitung in Echtzeit: Liefert sofortige Analysen und Rückmeldungen, was für zeitkritische Anwendungen und die Entscheidungsfindung von entscheidender Bedeutung ist.
- Einstellungen zum Datenschutz: Gewährleisten die Einhaltung von Datenschutzbestimmungen und schützen vertrauliche Informationen.
- Cloud-Integration: Ermöglicht eine nahtlose Zusammenarbeit und den Zugriff auf Daten über verschiedene Plattformen und Geräte hinweg.
Vorteile
Die Implementierung von NLP-Software bietet Ihrem Team und Ihrem Unternehmen mehrere Vorteile. Hier sind einige davon:
- Verbesserte Kommunikation: Software zur Generierung natürlicher Sprache und Spracherkennung erleichtern eine globale und zugängliche Kommunikation.
- Verbesserte Entscheidungsfindung: Textanalyse und Sentimentanalyse liefern Erkenntnisse, die Strategien und Maßnahmen unterstützen.
- Zeiteinsparung: Die Verarbeitung in Echtzeit liefert schnelles Feedback und ermöglicht dadurch schnellere Reaktionen und Maßnahmen.
- Kosteneffizienz: Die Automatisierung von Aufgaben wie der Entitätenerkennung reduziert den Bedarf an manueller Datenverarbeitung und spart Ressourcen.
- Höhere Genauigkeit: Anpassbare Modelle stellen sicher, dass die Ergebnisse auf spezifische Anforderungen zugeschnitten sind, und verbessern die Präzision der Ausgaben.
- Datensicherheit: Einstellungen zum Datenschutz tragen dazu bei, vertrauliche Informationen sicher zu verwahren und die Einhaltung von Vorschriften zu gewährleisten.
- Skalierbarkeit: Mehrsprachige Unterstützung und Cloud-Integration ermöglichen Wachstum und Anpassungsfähigkeit in verschiedenen Märkten.
Kosten & Preise
Die Auswahl von NLP-Software erfordert ein Verständnis der verschiedenen verfügbaren Preismodelle und Tarife. Die Kosten variieren je nach Funktionen, Teamgröße, Zusatzoptionen und weiteren Faktoren. Die folgende Tabelle fasst gängige Tarife, ihre Durchschnittspreise und typische in NLP-Softwarelösungen enthaltene Funktionen zusammen:
Vergleichstabelle der Tarife für NLP-Software
| Tarifart | Durchschnittspreis | Übliche Funktionen |
|---|---|---|
| Kostenloser Tarif | $0 | Grundlegende Textanalyse, eingeschränkte Sprachunterstützung und Community-Unterstützung. |
| Persönlicher Tarif | $10-$30/Benutzer/Monat | Sentimentanalyse, Sprachübersetzung und E-Mail-Unterstützung. |
| Geschäftstarif | $40-$100/Benutzer/Monat | Spracherkennung, Entitätenerkennung und telefonische Unterstützung. |
| Unternehmenstarif | $150+/Benutzer/Monat | Anpassbare Modelle, Verarbeitung in Echtzeit und dedizierte Kontoverwaltung. |
Wie geht es weiter:
Wenn Sie gerade NLP-Software recherchieren, kontaktieren Sie kostenlos einen SoftwareSelect-Berater und erhalten Sie Empfehlungen.
Sie füllen ein Formular aus und führen ein kurzes Gespräch, in dem Ihre konkreten Anforderungen besprochen werden. Anschließend erhalten Sie eine Vorauswahl an Software zur Prüfung. Die Berater unterstützen Sie sogar während des gesamten Kaufprozesses, einschließlich der Preisverhandlungen.