

Software für das IT-Betriebsmanagement hilft Ihnen dabei, Ihre gesamte IT-Infrastruktur zu verwalten und zu verstehen – einschließlich Überwachung, Automatisierung, Sicherheit und Dienstintegrität in lokalen und Cloud-Umgebungen.
Diese Liste richtet sich an CTOs und IT-Führungskräfte, die einheitliche Einblicke, eine schnellere Ursachenanalyse und Lösungen für hybride und Multi-Cloud-Betriebsumgebungen benötigen. Sie finden Optionen für KI-gestützte Automatisierung, umfassende Beobachtbarkeit, native Sicherheitsintegrationen und die Anpassbarkeit, die Sie benötigen, um wichtige Bereiche zu skalieren.
Warum Sie unseren Software-Empfehlungen vertrauen können
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Unser Team testet und bewertet Software seit 2012. Als Tech-Führungskräfte wissen wir selbst, wie schwierig – und wichtig – es ist, die richtige Software auszuwählen.
Für diesen Leitfaden haben wir Tools mithilfe von praktischen Tests und unabhängiger Recherche bewertet und dabei unsere Bewertungskriterien angewendet.
Unsere Bewertungen spiegeln unser menschliches redaktionelles Urteilsvermögen wider, keine Verkaufsstrategie.
Expertenprüfer:
- Paulo Gardini MiguelTech-Direktor
 Tim FisherVP für KI
 Gabriel RosasTech Lead & Software-Architekt
 Christhian GruhnTech Lead & Plattform-Architekt

Vergleichstabelle für Software zum IT-Betriebsmanagement
Vergleichen Sie in der folgenden Tabelle die Preise und wichtigsten technischen Daten meiner Auswahl der besten Software für das IT-Betriebsmanagement.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Am besten für die KI-gestützte Release-Validierung über den gesamten Stack geeignet | 15-tägige kostenlose Testversion | Ab $7/Host/Monat | Website | |
| 2 | Am besten für einheitliche Telemetrie mit integrierten FinOps-Funktionen | 14-tägige kostenlose Testversion | Ab $15/Host/Monat (jährliche Abrechnung) | Website | |
| 3 | Am besten für mit SecOps verbundene Protokoll- und Metrikabläufe geeignet | Kostenlose Testversion verfügbar | Ab $0.15/credit | Website | |
| 4 | OTel-native Betriebstransparenz für den gesamten Stack | 14-tägige kostenlose Testversion | Ab $99/Monat | Website | |
| 5 | Am besten geeignet für mandantenfähige hybride ITOps auf MSP-Niveau | Kostenlose Demo verfügbar | Preis auf Anfrage | Website | |
| 6 | Am besten für KI-gestützte Ursachenanalyse im Betrieb – von Alarmen bis zur Topologie | 14-tägige kostenlose Testversion | Preise auf Anfrage | Website | |
| 7 | Am besten für die Beobachtbarkeit des gesamten Stacks auf Transaktionsebene | Kostenloser Tarif verfügbar | Ab $99/Nutzer/Monat | Website | |
| 8 | Am besten für CMDB-zentrierten hybriden IT-Betrieb in großem Maßstab geeignet | Kostenlose Demo verfügbar | Preis auf Anfrage | Website | |
| 9 | Am besten geeignet für domänenübergreifende Überwachung des Servicezustands in Cisco-nativen Umgebungen | Kostenlose Demo verfügbar | Preis auf Anfrage | Website | |
| 10 | Am besten für agentenbasierte KI im Betrieb vom Mainframe bis zur Cloud | Kostenlose Demo verfügbar | Preise auf Anfrage | Website |


Bewertungen der besten Software für das IT-Betriebsmanagement
Nachfolgend finden Sie meine ausführlichen Zusammenfassungen der besten Softwarelösungen für das IT-Betriebsmanagement, die es in meine engere Auswahl geschafft haben. Meine Bewertungen bieten einen detaillierten Überblick über die Funktionen, besten Anwendungsfälle und Integrationen jeder Plattform, damit Sie die beste Lösung für Ihre Anforderungen finden.
 Am besten für die KI-gestützte Release-Validierung über den gesamten Stack geeignet
- 15-tägige kostenlose Testversion
- Ab $7/Host/Monat
Visit WebsiteCustomer Rating:4.5/5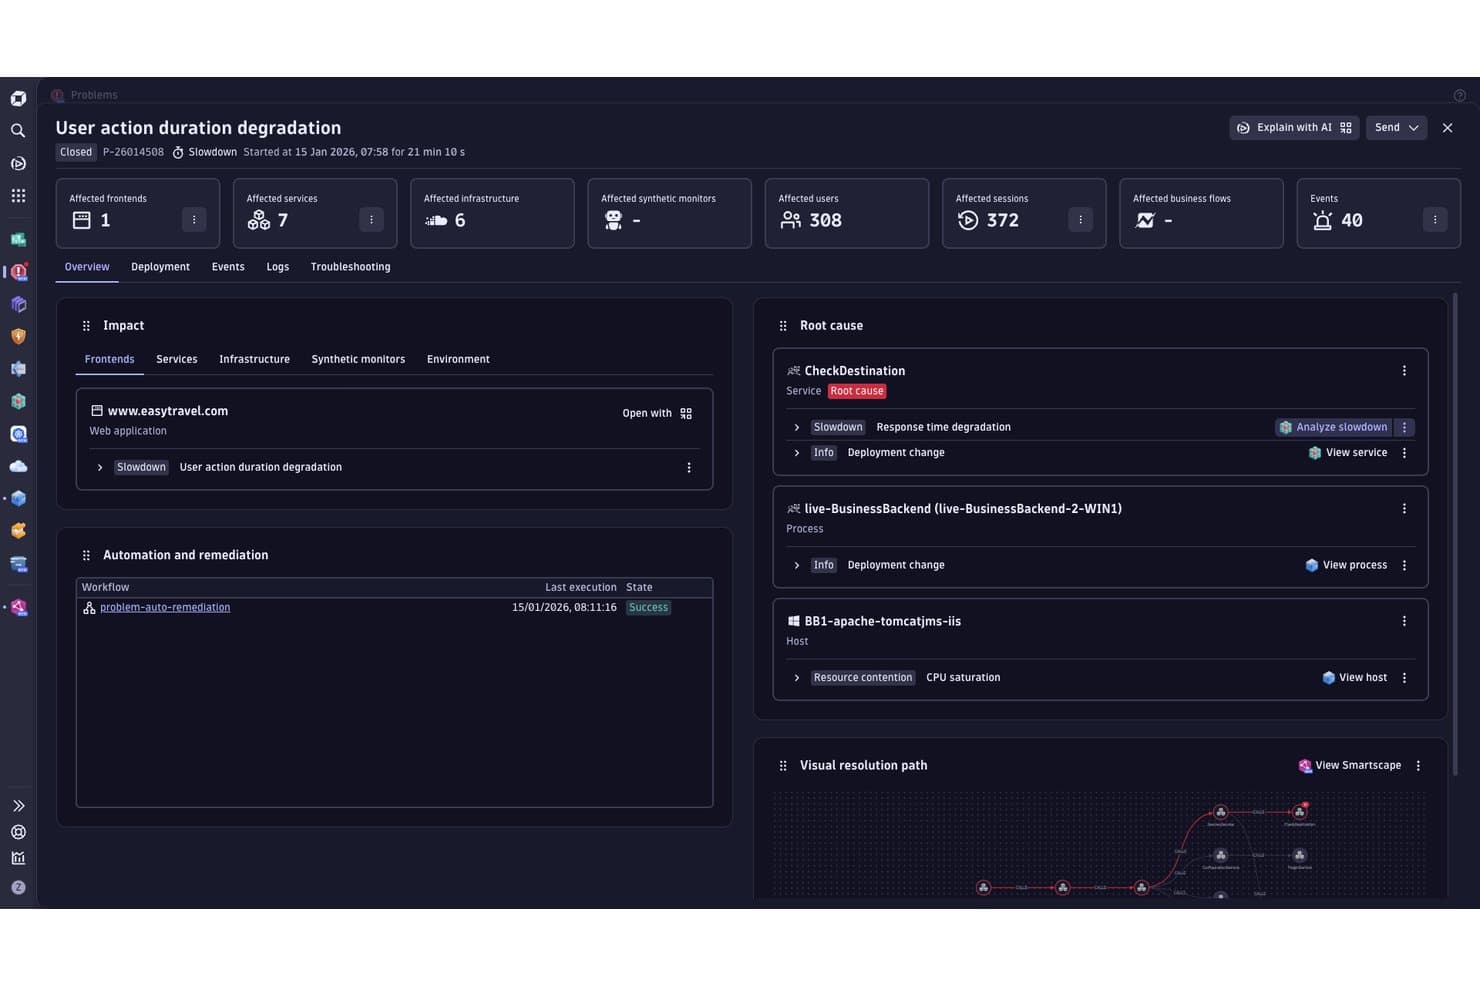
Dynatrace ermittelt die Grundursachen von Leistungsproblemen automatisch. Dynatrace ist eine Plattform für das Management des gesamten IT-Stacks, die Infrastrukturüberwachung, AIOps-gestützte Incident-Erkennung, Protokollanalysen und Workflow-Automatisierung in hybriden und Multi-Cloud-Umgebungen abdeckt.
Für wen ist Dynatrace am besten geeignet?
Dynatrace eignet sich besonders für IT- und SRE-Teams in Unternehmen, die komplexe hybride oder Multi-Cloud-Umgebungen verwalten und KI-gestützte Beobachtbarkeit, automatisierte Incident-Reaktionen sowie eine skalierbare Validierung von Releases benötigen.
Warum ich Dynatrace ausgewählt habe
Ich habe Dynatrace als eine der besten Lösungen ausgewählt, weil der Site Reliability Guardian die umfassendste Einrichtung zur Release-Validierung ist, die ich in dieser Kategorie gesehen habe: Er bewertet jede Bereitstellung automatisch anhand vordefinierter SLOs und KPIs, bevor der Code die Produktionsumgebung erreicht, und blockiert fehlerhafte Releases ohne manuelle Prüfung. Kombiniert man dies mit der Fähigkeit von Davis AI, eine Anomalie in der Produktionsumgebung über Milliarden aktiver Abhängigkeiten bis zu einer einzigen Grundursache zurückzuverfolgen, erhält man eine Plattform, die erkennt, was die Qualitätssicherung übersieht, und genau erklärt, warum.
Wichtige Funktionen von Dynatrace
- Smartscape-Topologiekartierung: Erkennt und visualisiert automatisch Echtzeitabhängigkeiten zwischen Hosts, Containern, Services und Prozessen in hybriden und Multi-Cloud-Umgebungen.
- Grail-Data-Lakehouse: Vereinheitlicht Metriken, Protokolle, Traces, Ereignisse und Sicherheitssignale in einem einzigen indexfreien Speicher, der über DQL ohne Schemakonfiguration abgefragt werden kann.
- AutomationEngine-Workflow-Builder: Ein visueller Editor ohne Code oder mit wenig Code zum Erstellen ereignisgesteuerter oder zeitgesteuerter Automatisierungs-Workflows auf Grundlage von Live-Daten zur Beobachtbarkeit.
- Prädiktive Alarmierung: Prognostiziert Kapazitäts- und Leistungsüberschreitungen, bevor sie auftreten, mithilfe kontinuierlich erlernter Verhaltens-Baselines für jede überwachte Komponente.
Dynatrace-Integrationen
Dynatrace bietet über den Dynatrace Hub mehr als 900 Integrationen, darunter ServiceNow, Jira Service Management, PagerDuty, Slack, Microsoft Teams, AWS, Azure, Google Cloud und OpenTelemetry. Die REST-API, Webhooks und das AppEngine SDK unterstützen benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Ein einziger Agent erkennt Ressourcen des gesamten Stacks automatisch
- Davis AI ermittelt die tatsächliche Grundursache
- Automatisierte Behebung mit Kontrollen unter Einbeziehung von Menschen
Cons:
- Der verbrauchsbasierte Preis erschwert die Budgetplanung
- Nur-SaaS-Betrieb schränkt die Optionen für Umgebungen ohne Netzwerkverbindung ein
 Am besten für einheitliche Telemetrie mit integrierten FinOps-Funktionen
- 14-tägige kostenlose Testversion
- Ab $15/Host/Monat (jährliche Abrechnung)
Visit WebsiteCustomer Rating:4.5/5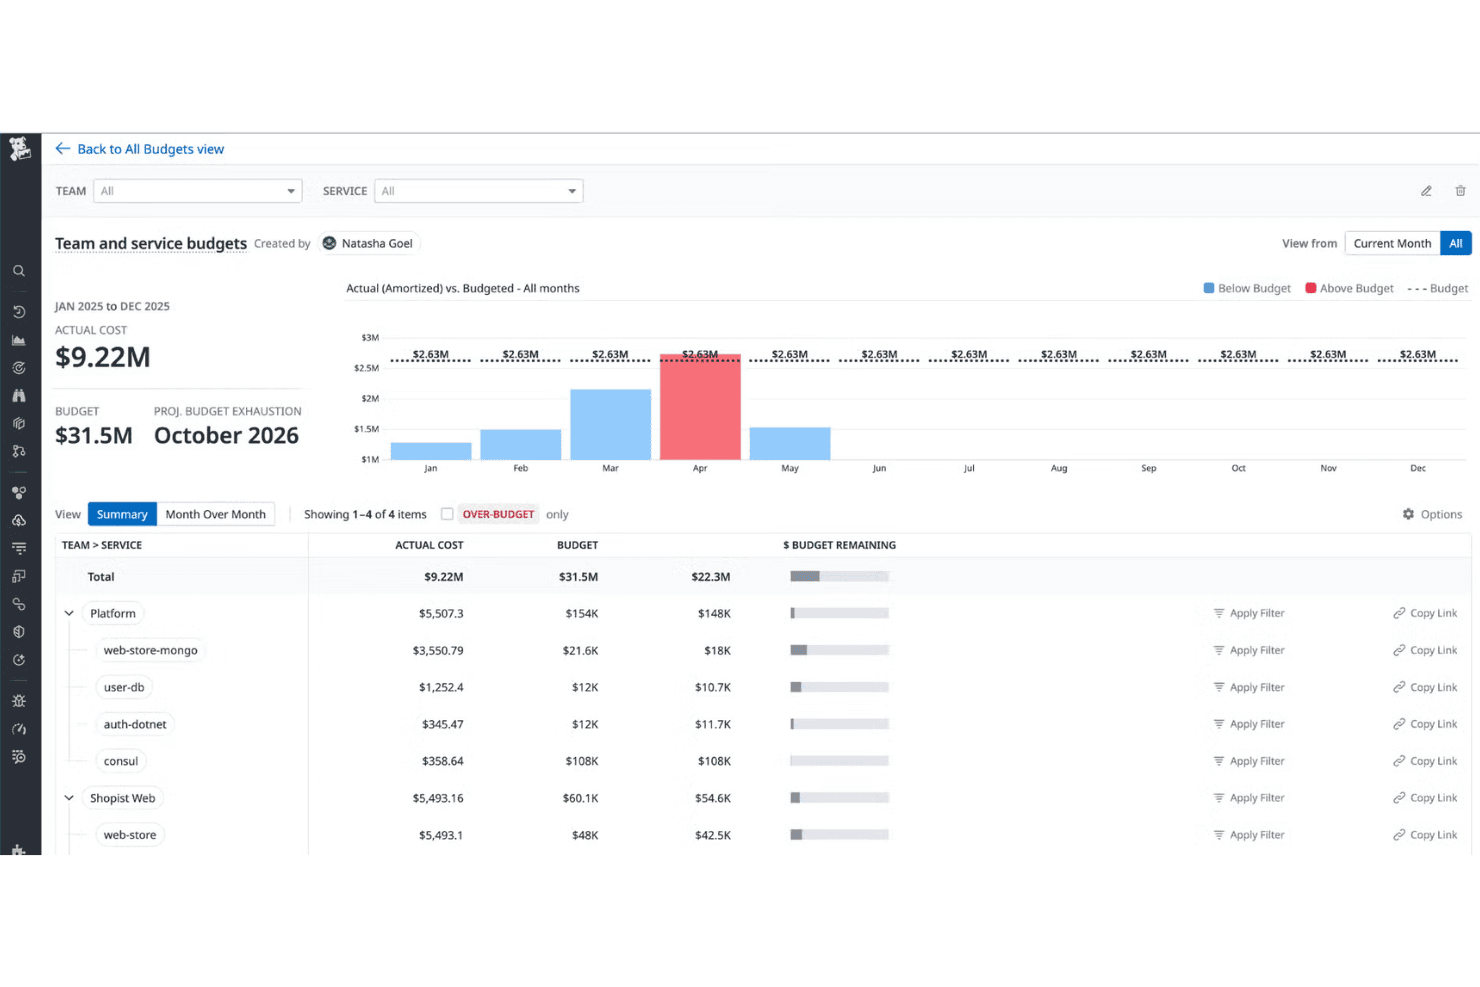
Datadog vergleicht die Budgets von Teams und Services mit den tatsächlichen Cloud-Ausgaben. Datadog ist eine cloudbasierte Plattform für das Management und die Beobachtung von IT-Operationen, die Infrastrukturüberwachung, APM, Protokollverwaltung, Netzwerküberwachung, Incident-Management, AIOps und Workflow-Automatisierung in hybriden und Multi-Cloud-Umgebungen vereint.
Für wen eignet sich Datadog am besten?
Datadog eignet sich besonders für Entwicklungs- und IT-Betriebsteams, die komplexe Multi-Cloud- oder Hybridumgebungen verwalten und Infrastrukturüberwachung, APM sowie Transparenz über Cloud-Kosten an einem Ort benötigen.
Warum ich Datadog ausgewählt habe
Datadog steht auf meiner engeren Auswahl, weil es die einzige Plattform ist, die ich verwendet habe, bei der vollständige Stack-Telemetrie und Transparenz über Cloud-Kosten tatsächlich am selben Ort verfügbar sind. Ich schätze besonders, dass das Cloud-Kostenmanagement Infrastrukturmetriken direkt mit den Ausgaben für AWS, Azure, GCP und OCI verknüpft. Wenn Watchdog also eine CPU-Anomalie in einem Kubernetes-Cluster meldet, kann ich die Kostenauswirkungen sehen, ohne zwischen Tools wechseln zu müssen. Die integrierte FinOps-Ebene in Kombination mit der KI-gestützten Anomalieerkennung für Metriken, Protokolle und Traces macht Datadog einzigartig geeignet für Teams, die operative und finanzielle Verantwortlichkeit in einer Ansicht benötigen.
Wichtige Funktionen von Datadog
- Watchdog-Anomalieerkennung: Eine KI-Engine, die automatisch Leistungsanomalien in Infrastrukturmetriken, APM-Traces und Protokollen erkennt, ohne dass Schwellenwerte manuell konfiguriert werden müssen.
- Rufbereitschaftsplanung und Eskalationsrichtlinien: Konfigurierbare Rufbereitschaftsrotationen mit Weiterleitungsregeln und Benachrichtigungen über mehrere Kanäle per SMS, Sprache, Push und E-Mail.
- Editor für die Workflow-Automatisierung: Eine visuelle Low-Code-Oberfläche mit mehr als 1.750 vorgefertigten Aktionen und mehr als 150 Blaupausen zur Automatisierung von Workflows zur Vorfallreaktion, für DevOps und zur Sicherheit.
- Management der Cloud-Sicherheitslage (CSPM): Kontinuierliche Konfigurationsprüfungen für Cloud-Konten und Container, die mehr als 15 Compliance-Rahmenwerken zugeordnet sind, darunter PCI DSS, HIPAA und SOC 2.
Integrationen von Datadog
Datadog bietet mehr als 1.000 von Anbietern unterstützte Integrationen, darunter AWS, Microsoft Azure, Google Cloud Platform, ServiceNow, Jira, PagerDuty, Slack, Microsoft Teams, Kubernetes und Prometheus. Die REST-API und SDKs unterstützen benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Einheitliche Ansicht von Infrastruktur, Apps und Kosten
- KI-Anomalieerkennung hilft, die Alarmflut zu reduzieren
- Durchgängiges Incident-Management integriert
Cons:
- Das modulare Preismodell führt zu unvorhersehbaren Kosten
- Keine selbst gehostete Bereitstellung für Benutzer außerhalb des Regierungsbereichs
 Am besten für mit SecOps verbundene Protokoll- und Metrikabläufe geeignet
- Kostenlose Testversion verfügbar
- Ab $0.15/credit
Visit WebsiteCustomer Rating:4.3/5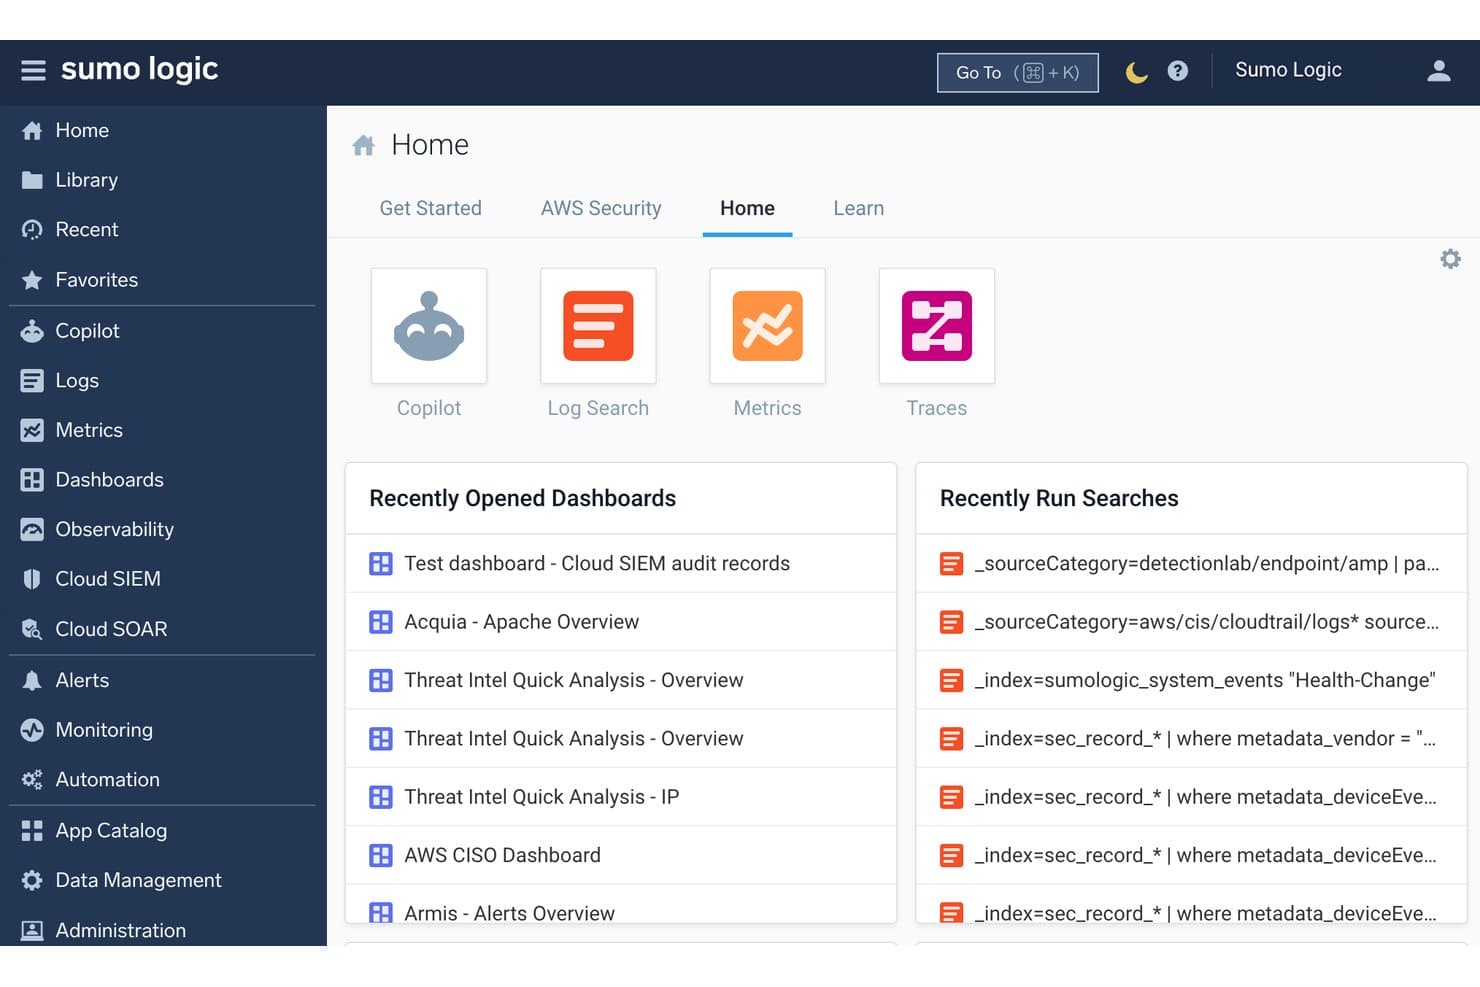
Sumo Logic ermöglicht Teams schnellen Zugriff auf die Protokollsuche, Metriken und aktuelle Aktivitäten. Sumo Logic ist eine cloudnative Plattform für das IT-Betriebsmanagement, die Protokollanalysen, Infrastrukturüberwachung, Metriken, verteiltes Tracing und Sicherheitsbetrieb in einer einzigen SaaS-basierten Observability- und SIEM-Lösung vereint.
Für wen ist Sumo Logic am besten geeignet?
Sumo Logic eignet sich hervorragend für sicherheitsbewusste IT- und Betriebsteams, die Protokollanalysen, Metriken und SIEM-Funktionen in einer einzigen SaaS-Plattform benötigen.
Warum ich mich für Sumo Logic entschieden habe
Sumo Logic hat sich einen Platz auf meiner Auswahlliste verdient, weil es eine der wenigen Plattformen ist, die Protokollanalysen und Sicherheitsbetrieb in einem wirklich einheitlichen SaaS-Tool zusammenführt. Mir gefällt, wie die patentierten Operatoren LogReduce und LogExplain direkt aus Rohprotokolldaten die Grundursachen herausarbeiten und so die manuelle Mustersuche reduzieren, die die Behebung von Vorfällen verlangsamt. Auch die Dojo AI-Plattform mit mehreren Agenten sticht hervor: Der SOC Analyst Agent automatisiert die Triage von Warnmeldungen der ersten Stufe und liefert durch Belege gestützte Bewertungen, was mein Team als äußerst wertvoll empfindet, wenn sich SecOps- und ITOps-Workflows überschneiden.
Wichtige Funktionen von Sumo Logic
- KI-gesteuerte Metriküberwachung: Die ML-basierte Anomalieerkennung passt saisonale Basiswerte für Ihre Metrikdaten automatisch an und reduziert das Volumen von Fehlalarmen.
- Verwaltung mehrerer Organisationen: Eine übergeordnete Organisation steuert Überwachungen, Dashboards, Rollen und Zugriffe für untergeordnete Organisationen über eine einzige zentrale Oberfläche.
- Dashboards für Compliance-Berichte: Vorgefertigte Dashboards ordnen Ihre Daten den Frameworks PCI, HIPAA, GDPR, SOX und ISO zu und ermöglichen eine kontinuierliche Übersicht über den Sicherheitsstatus.
- OpenTelemetry-Verteilungsagent: Ein einziger vereinheitlichter Agent erfasst Protokolle, Metriken und Traces unter Linux, Windows, macOS sowie aus mehr als 25 Quellkonfigurationen.
Integrationen von Sumo Logic
Sumo Logic bietet mehr als 450 Integrationen, darunter ServiceNow, PagerDuty, Jira, Slack, Microsoft Teams, AWS, Microsoft Azure, Google Cloud Platform, Kubernetes und Docker. Außerdem stehen REST-APIs, Webhooks, Terraform, SumoQL und ein Open Integration Framework für benutzerdefinierte Verbindungen zur Verfügung.
Pros and Cons
Pros:
- Dojo AI automatisiert die Triage und Behebung von Vorfällen
- Compliance-Dashboards ordnen Daten direkt den wichtigsten Frameworks zu
- Zentralisiert Protokolle, Metriken und Traces auf einer Plattform
Cons:
- Die erweiterte Automatisierung ist stärker auf Sicherheit als auf IT-Betrieb ausgerichtet
- Das Abfragen großer historischer Datensätze kann langsam sein
 OTel-native Betriebstransparenz für den gesamten Stack
- 14-tägige kostenlose Testversion
- Ab $99/Monat
Visit WebsiteCustomer Rating:4.3/5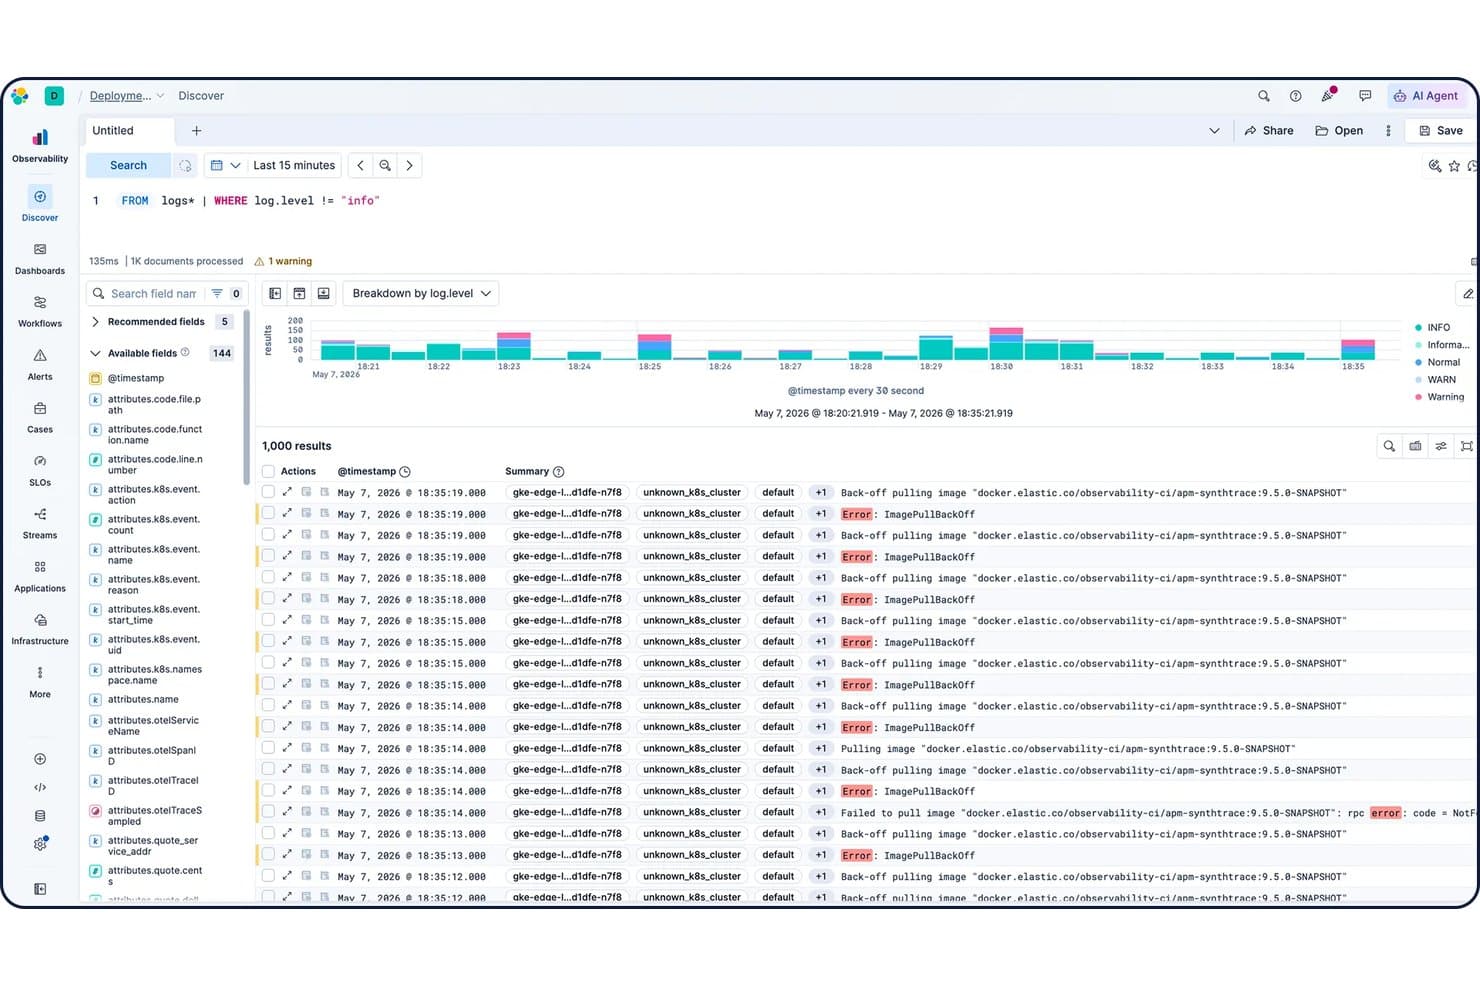
Elastic Observability filtert Protokolle in der Discover-Ansicht nach Ebene. Elastic Observability ist eine Plattform für vollständige Beobachtbarkeit, die Protokollüberwachung, Infrastrukturmetriken, APM, verteiltes Tracing, synthetisches Monitoring und AIOps in lokalen, Cloud- und hybriden Umgebungen vereint.
Für wen ist Elastic Observability am besten geeignet?
Elastic Observability eignet sich besonders für SREs und Infrastrukturingenieure in mittleren bis großen Unternehmen, die eine einheitliche Übersicht über Protokolle, Metriken, Traces und APM in hybriden und Multi-Cloud-Umgebungen benötigen – insbesondere für Teams, die bereits in OpenTelemetry investiert haben.
Warum ich Elastic Observability ausgewählt habe
Elastic Observability hat sich einen Platz auf meiner Auswahlliste verdient, weil es eine der wenigen Plattformen ist, die auf OpenTelemetry ausgerichtet sind. Das bedeutet, dass Ihre Protokolle, Metriken, Traces und APM-Daten in einem einzigen Schema landen, ohne dass Sie sich mit proprietären Agents auseinandersetzen müssen. Besonders gut gefällt mir die ML-Ebene ohne Konfiguration: Über 100 vorkonfigurierte Jobs zur Anomalieerkennung laufen automatisch über jeden Datenstrom hinweg. Wenn also eine Datenerfassung im Maßstab von Comcast stattfindet, muss Ihr Team die Modelle nicht manuell abstimmen. Die auf Streams basierende Protokollanalyse und die ES|QL-Abfrage-Engine machen es wirklich schnell, Ursachen in hybriden Umgebungen zu ermitteln.
Wichtige Funktionen von Elastic Observability
- Synthetisches Monitoring: Führen Sie leichte Tests und vollständige Browser-Tests für Benutzerabläufe über eine global verwaltete Testinfrastruktur oder private lokale Standorte aus.
- Überwachung von Service-Level-Zielen (SLOs): Definieren, überwachen und berichten Sie über Zuverlässigkeitsziele direkt in Kibana neben Ihren bestehenden Dashboards und Warnmeldungen.
- Kibana-Warnmeldungen: Konfigurieren Sie regelbasierte Warnmeldungen für APM-, Metrik-, Uptime- und Sicherheitsdaten mithilfe einer formularbasierten Einrichtung mit Unterstützung für Benachrichtigungen über mehrere Kanäle.
- Über 550 vorgefertigte Integrationen: Verbinden Sie Cloud-Anbieter, ITSM-Tools, Sicherheitsplattformen und Datenquellen mithilfe vorgefertigter Agents und agentenloser Datensammler.
Integrationen von Elastic Observability
Elastic Observability bietet über 550 vorgefertigte Integrationen, darunter AWS, Microsoft Azure, Google Cloud Platform, ServiceNow, Jira, PagerDuty, Slack, Microsoft Teams, Kubernetes und OpenTelemetry. Außerdem werden REST-APIs, Webhooks, Elastic Agent, Logstash, Beats und OpenTelemetry-Collector für benutzerdefinierte Verbindungen unterstützt.
Pros and Cons
Pros:
- Einheitliche Übersicht über hybride und Multi-Cloud-Umgebungen
- ML ohne Konfiguration erkennt Anomalien automatisch
- OTel-native Datenerfassung verhindert die Abhängigkeit von einem Anbieter
Cons:
- Eine native Bereitschaftsplanung ist nicht enthalten
- Für komplexe OTel-Einrichtungen fehlt es an Dokumentation
Learn more about Elastic Observability: Am besten geeignet für mandantenfähige hybride ITOps auf MSP-Niveau
- Kostenlose Demo verfügbar
- Preis auf Anfrage
Visit WebsiteCustomer Rating:4.1/5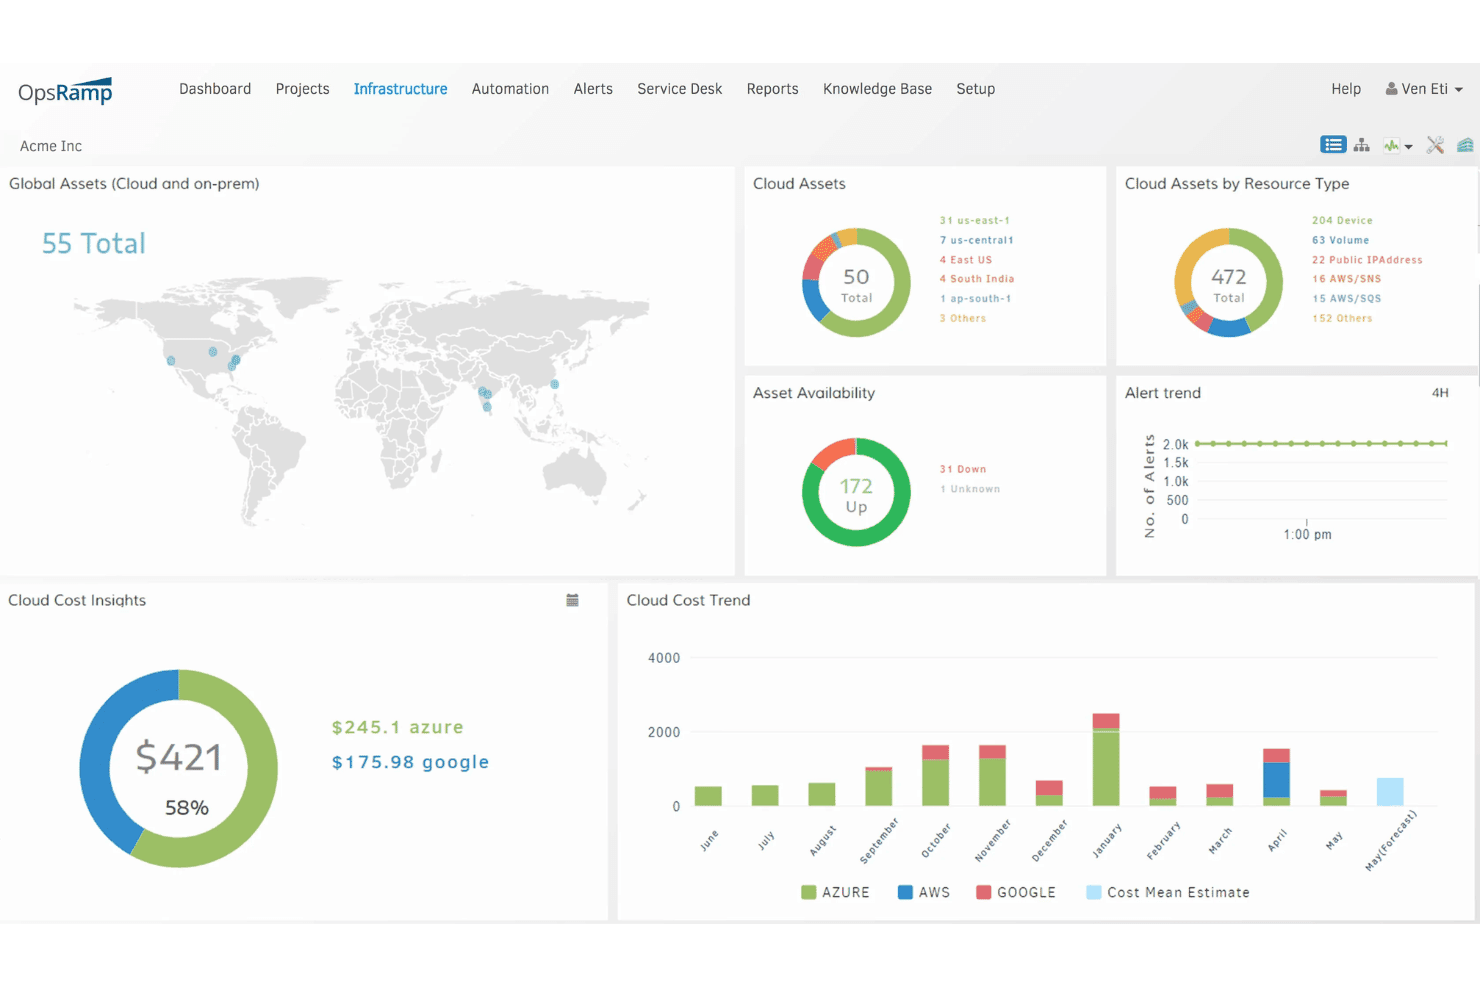
OpsRamp bietet Benutzern eine einheitliche Ansicht von Cloud-Kosten, Assets und Warnmeldungen. HPE OpsRamp ist eine AIOps-gesteuerte Plattform für das Management von IT-Betriebsabläufen, die Infrastrukturüberwachung, Ereigniskorrelation, Vorfallmanagement, Runbook-Automatisierung und Transparenz über hybride Multi-Cloud-Umgebungen hinweg in lokalen, privaten und öffentlichen Cloud-Umgebungen vereint.
Für wen ist OpsRamp am besten geeignet?
OpsRamp eignet sich besonders für Managed-Service-Provider und große Unternehmen, die komplexe hybride IT-Landschaften in lokalen und Multi-Cloud-Umgebungen betreiben.
Warum ich OpsRamp ausgewählt habe
OpsRamp steht auf meiner Auswahlliste, weil seine mandantenfähige Architektur speziell für MSPs entwickelt wurde, die Dutzende von Kundenumgebungen über eine zentrale Oberfläche verwalten. Besonders gefällt mir die AIOps-Engine zur Ereigniskorrelation, die zusammengehörige Warnmeldungen mandantenübergreifend gruppiert und das Rauschen um bis zu 90 % reduziert, sodass Ihr Team nicht in Tickets aus verschiedenen Kundenkonten untergeht. Die Topologie- und Servicemaps bieten eine Live-Ansicht der Abhängigkeiten in hybriden Landschaften über AWS, Azure, GCP und lokale Umgebungen hinweg, was in dieser Größenordnung nur schwer nachzubilden ist.
Die wichtigsten Funktionen von OpsRamp
- Engine zur Runbook-Automatisierung: Führt vordefinierte Behebungsskripte als Reaktion auf erkannte Probleme automatisch aus, mit durch RBAC gesteuertem Zugriff auf Aufträge und Prozessabläufe.
- Mandantenfähige Kundenverwaltung: Verwaltet mehrere Kundenumgebungen über eine einzige Plattforminstanz hinweg, mit mandantenspezifischer Integrationskonfiguration und isolierter Datenverarbeitung.
- Berichte zu Cloud-Kosten: Schlüsselt Cloud-Ausgaben nach Konto, Region, Dienst und Instanztyp für AWS, Azure und GCP auf, mit anpassbaren Datumsbereichen.
- OpenTelemetry-Datenerfassung: Nimmt Metriken, Protokolle und Traces aus jeder OpenTelemetry-kompatiblen Quelle auf und unterstützt zusätzlich die eBPF-gestützte automatische Instrumentierung für eine detaillierte Transparenz über Workloads.
OpsRamp-Integrationen
OpsRamp bietet mehr als 3.000 Integrationen, darunter ServiceNow, Jira Service Management, Zendesk, AWS, Microsoft Azure, Google Cloud Platform, Kubernetes, OpenTelemetry und Prometheus. Die OAuth-2.0-REST-API, Webhooks sowie der JSON-Import und -Export unterstützen benutzerdefinierte Verbindungen.
Pros and Cons
Pros:
- Mandantenverwaltung für MSP-Kundenumgebungen
- Reduzierung des Warnmeldungsrauschens um bis zu 90 Prozent
- Visualisierungen hybrider und Multi-Cloud-Topologien
Cons:
- Funktionen zur Anwendungsüberwachung entwickeln sich noch weiter
- Die Dashboard-Leistung kann bei großem Umfang nachlassen
Learn more about OpsRamp: Am besten für KI-gestützte Ursachenanalyse im Betrieb – von Alarmen bis zur Topologie
- 14-tägige kostenlose Testversion
- Preise auf Anfrage
Visit WebsiteCustomer Rating:4.5/5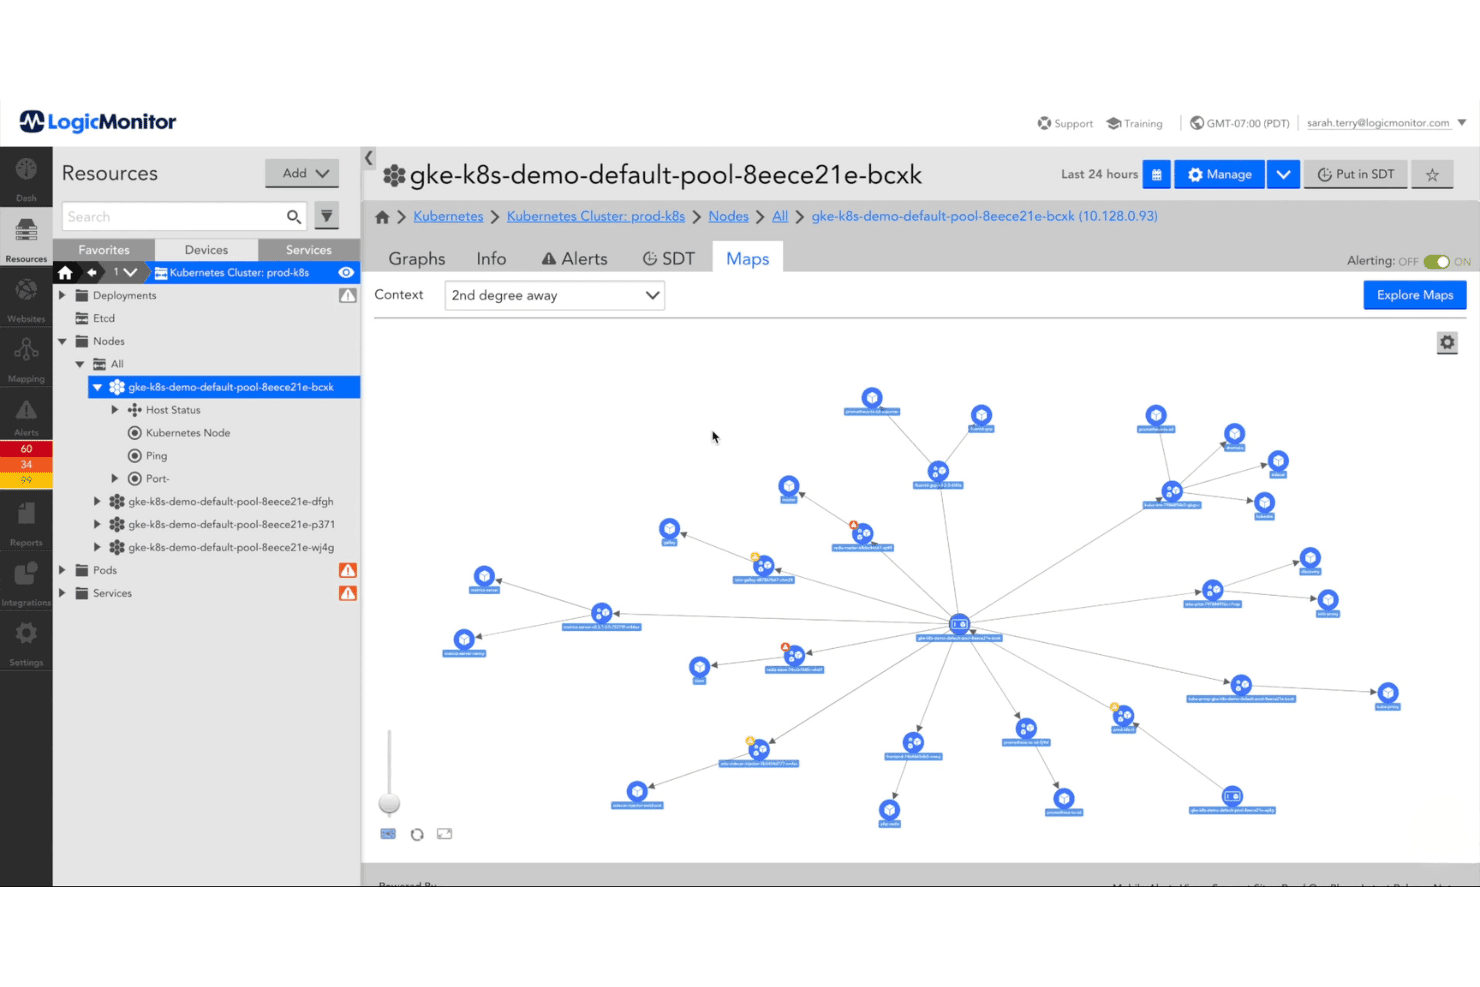
LogicMonitor stellt die Beziehungen zwischen Kubernetes-Knoten in interaktiven Netzwerk-Topologieansichten dar. LogicMonitor ist eine IT-Betriebsmanagementplattform für den gesamten Stack, die Infrastruktur-, Netzwerk-, Cloud-, Container- und Anwendungsüberwachung sowie AIOps-gestützte Alarmkorrelation, Topologiezuordnung und Protokollanalyse in einer einzigen einheitlichen Plattform abdeckt.
Für wen ist LogicMonitor am besten geeignet?
LogicMonitor eignet sich besonders für Infrastruktur- und Netzwerkbetriebsteams, die große hybride Umgebungen vor Ort und über mehrere Clouds hinweg verwalten.
Warum ich LogicMonitor ausgewählt habe
LogicMonitor steht auf meiner Auswahlliste, weil die Plattform Alarmkorrelation eng mit einer topologiebasierten Ursachenanalyse verknüpft. Edwin AI verdichtet Alarmfluten zu priorisierten, nachvollziehbaren Vorfällen, während der ITOps Context Graph Topologie-, Telemetrie- und Änderungsdaten zusammenführt, sodass Sie eine wahrscheinliche Ursache innerhalb von Minuten statt Stunden ermitteln können. Ich habe erlebt, dass Teams die Anzahl von Alarmen nach der Einführung von Edwin AI um 78 % senken konnten. Dadurch verbringen Bereitschaftsingenieure weniger Zeit mit der Erstbewertung von Alarmen und mehr Zeit mit der Behebung des tatsächlichen Problems.
Die wichtigsten Funktionen von LogicMonitor
- Überwachung der Infrastruktur über den gesamten Stack: Überwacht Server, Netzwerkgeräte, VMs, Datenbanken, Speicher und Container in hybriden Umgebungen über eine einzige Plattform.
- LM Exchange: Bietet Zugriff auf mehr als 2.000 vorgefertigte LogicModules für Cloudanbieter, Netzwerkgeräte, Datenbanken und Anwendungen.
- Protokollanalyse und -intelligenz: Verknüpft Protokolldaten in Echtzeit mit Metriken, sodass Sie Vorfälle untersuchen können, ohne zwischen Tools wechseln zu müssen.
- Bidirektionale ITSM-Integrationen: Synchronisiert Alarm- und Ticketlebenszyklen mit ServiceNow, Jira Service Management, PagerDuty, ConnectWise und Autotask.
LogicMonitor-Integrationen
LogicMonitor bietet über LM Exchange mehr als 2.000 Marktplatz-Integrationen sowie native Integrationen mit ServiceNow, Jira Service Management, PagerDuty, ConnectWise und Datto Autotask. Eine dokumentierte REST-API unterstützt benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Reduziert die Anzahl von Alarmen mit Edwin AI
- Bildet die Topologie für eine schnelle Ursachenanalyse ab
- Anpassbare Übersichten für verschiedene IT-Rollen
Cons:
- Die Preisstruktur ist schwer verständlich
- Änderungen an der Benutzeroberfläche erschweren die Navigation
Learn more about LogicMonitor: Am besten für die Beobachtbarkeit des gesamten Stacks auf Transaktionsebene
- Kostenloser Tarif verfügbar
- Ab $99/Nutzer/Monat
Visit WebsiteCustomer Rating:4.3/5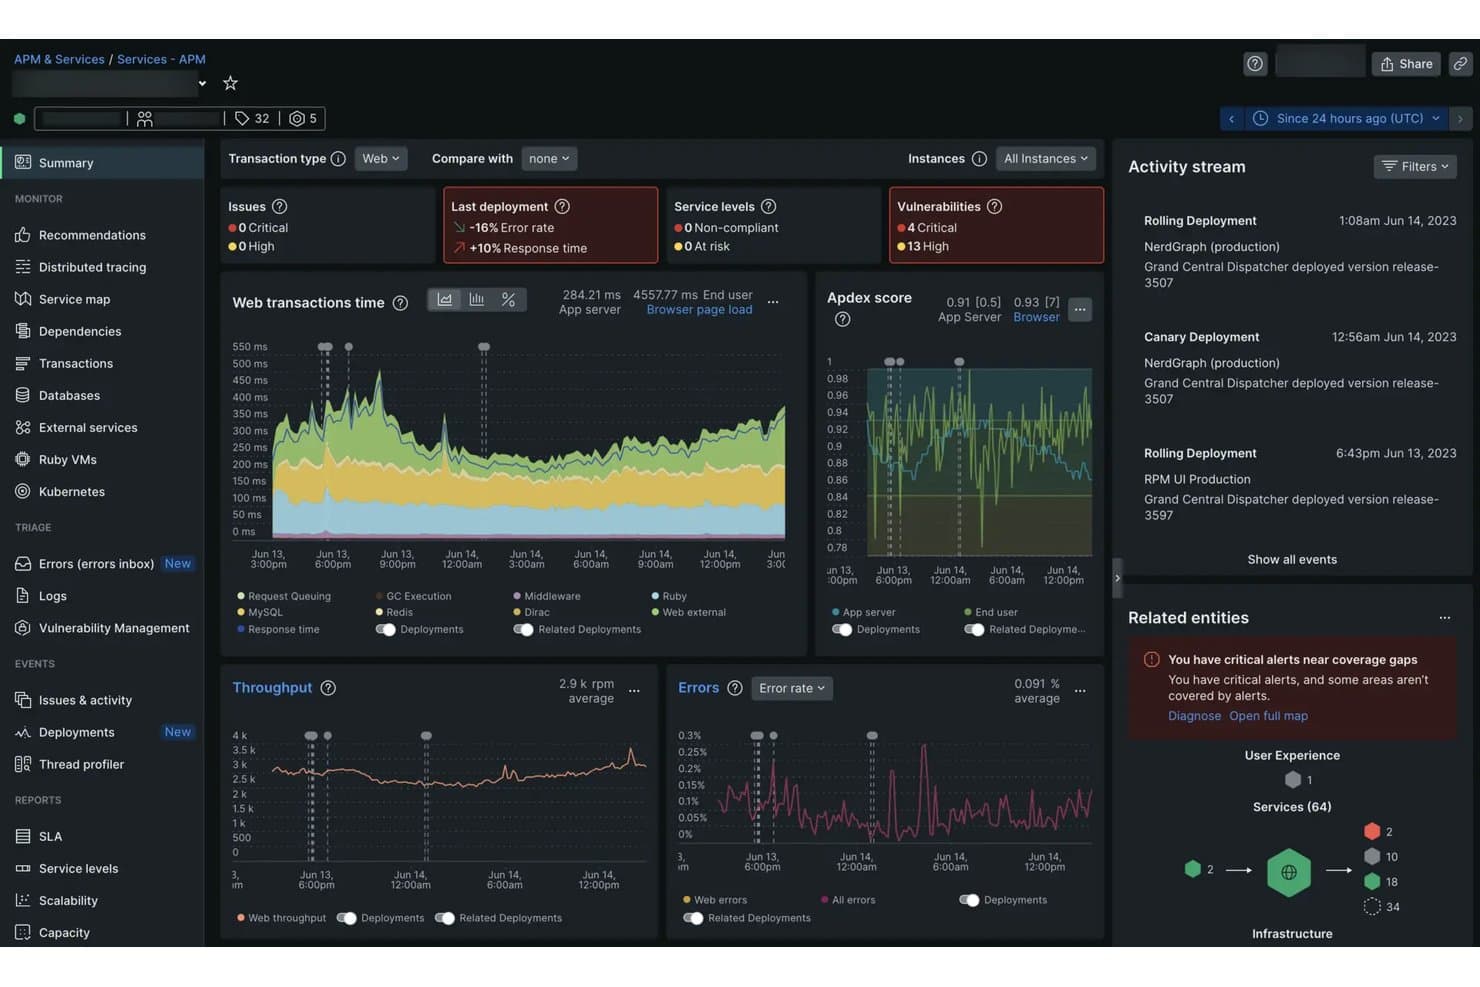
New Relic bietet eine vollständige APM-Zusammenfassung mit Leistungsmetriken. New Relic ist eine Plattform für die Beobachtbarkeit des gesamten Stacks, die Metriken, Protokolle, Ablaufverfolgungen und Daten zur digitalen Nutzungserfahrung aus Infrastruktur, Anwendungen, Cloud-Umgebungen und Netzwerken in einer einzigen Oberfläche vereint.
Für wen eignet sich New Relic am besten?
New Relic eignet sich hervorragend für SREs und Infrastrukturtechniker, die komplexe Produktionsumgebungen mit hohem Datenverkehr verwalten, in denen eine Sichtbarkeit auf Transaktionsebene über den gesamten Stack hinweg unverzichtbar ist.
Warum ich New Relic ausgewählt habe
New Relic steht auf meiner engeren Auswahl, weil Transaction 360 Telemetriedaten, Warnmeldungen und Änderungen an Bereitstellungen auf Ebene einzelner Transaktionen korreliert und die mittlere Zeit zur Behebung (MTTR) um bis zu das Fünffache verkürzt. Außerdem gefällt mir, wie Autopilot-Agenten Vorfälle mithilfe von Live-Telemetriedaten und Runbooks autonom untersuchen und anschließend transparente, prüfbare Begründungen liefern, anstatt lediglich eine Behebungsaktion auszulösen. Diese Kombination aus Ablaufverfolgung auf Transaktionsebene und agentengestützter Vorfallsbehebung macht New Relic zu meiner bevorzugten Lösung für die Beobachtbarkeit des gesamten Stacks.
Die wichtigsten Funktionen von New Relic
- Intelligente Warnmeldungen: Die dynamische Anpassung von Schwellenwerten nutzt historische Schwankungen, um Fehlalarme zu minimieren, und leitet Warnmeldungen mithilfe von Entitäts-Tags automatisch an das richtige Team weiter.
- Intelligenz für Cloud-Kosten: Echtzeit-Kostenverfolgung für AWS, Azure, GCP und Kubernetes mit Empfehlungen zur Größenanpassung auf Grundlage tatsächlicher Nutzungsmuster sowie Warnmeldungen bei Budgetschwellenwerten.
- Workflow-Automatisierung: Eine programmierfreie Drag-and-Drop-Arbeitsfläche ermöglicht die Erstellung mehrstufiger Behebungs-Workflows mit bedingter Logik, Schleifen und Live-NRQL-Abfragen.
- Föderierte Protokolle: Protokolle können direkt aus S3-Buckets abgefragt werden, ohne erneute Aufnahme oder Datenverschiebung, wodurch Anforderungen an Datenresidenz und Compliance unterstützt werden.
Integrationen von New Relic
New Relic bietet mehr als 800 vorgefertigte Integrationen, darunter ServiceNow, Jira, PagerDuty, Slack, Microsoft Teams, AWS, Azure, Google Cloud Platform, Kubernetes und VMware. NerdGraph, REST API, Webhooks, OpenTelemetry und Prometheus unterstützen benutzerdefinierte Verbindungen.
Pros and Cons
Pros:
- Korreliert Metriken, Protokolle und Ablaufverfolgungen sofort
- Automatisiert die Weiterleitung von Warnmeldungen mithilfe von Entitäts-Tags
- Transparente KI-gestützte Untersuchung von Vorfällen
Cons:
- Die verbrauchsabhängige Preisgestaltung kann schnell ansteigen
- Eine verlängerte Datenaufbewahrung erfordert ein kostenpflichtiges Upgrade
Learn more about New Relic: Am besten für CMDB-zentrierten hybriden IT-Betrieb in großem Maßstab geeignet
- Kostenlose Demo verfügbar
- Preis auf Anfrage
Visit WebsiteCustomer Rating:4.4/5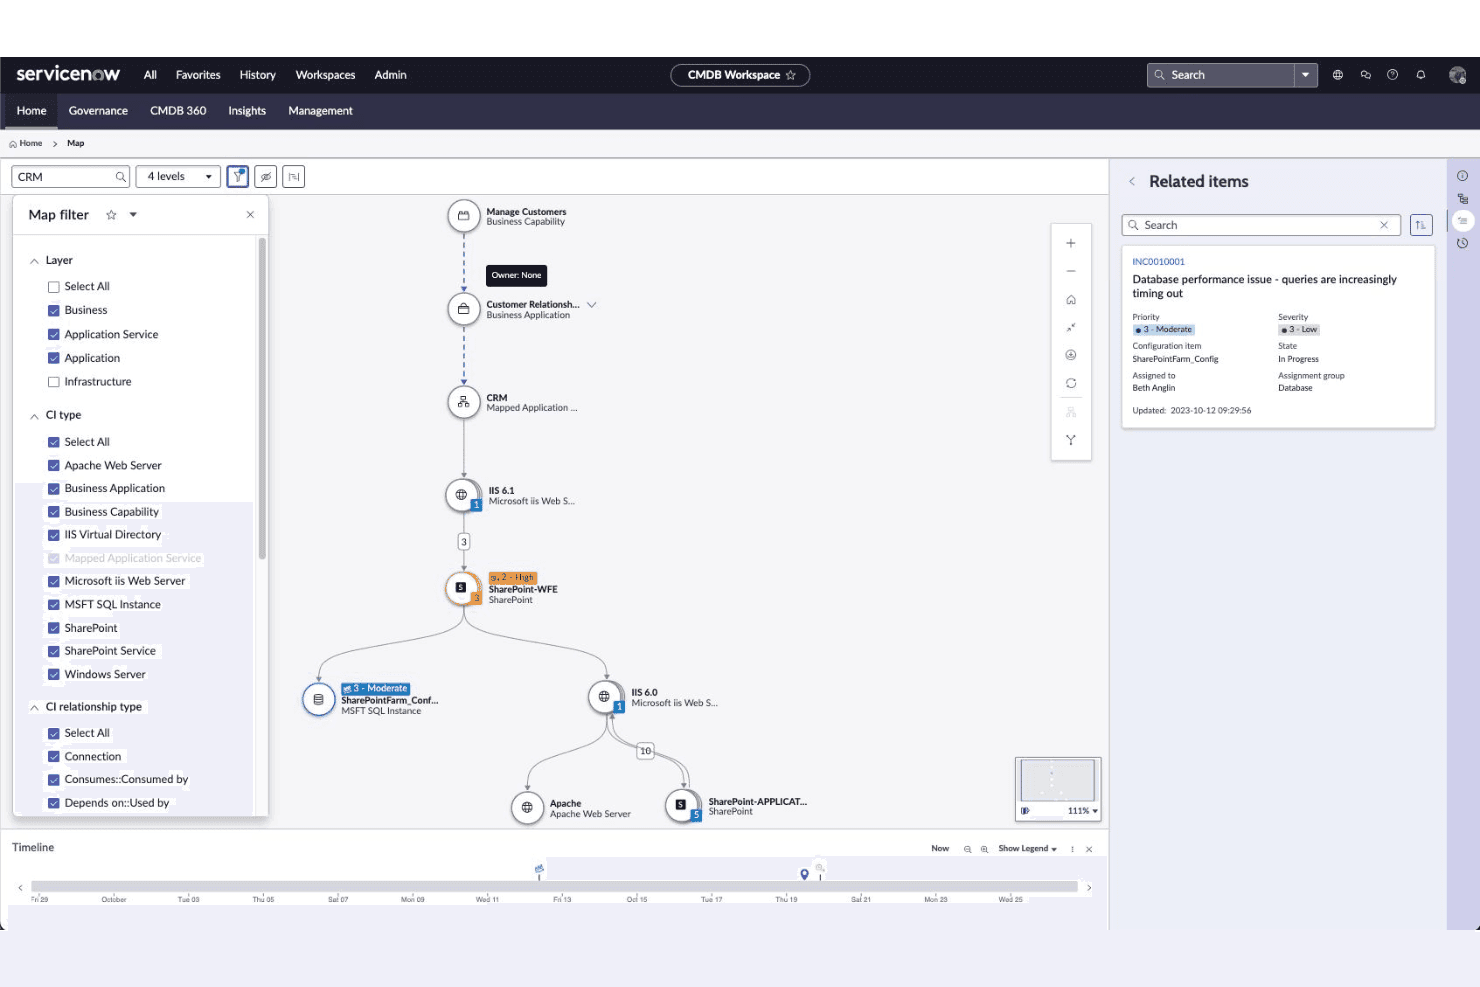
ServiceNow ITOM bildet Abhängigkeiten einer CRM-Anwendung über mehrere Infrastrukturebenen hinweg ab. ServiceNow ITOM ist eine Plattform für das IT-Betriebsmanagement in Unternehmen, die auf einer kontinuierlich aktualisierten CMDB basiert und agentenlose Erkennung, durch AIOps unterstütztes Ereignismanagement, Servicetopologie, Cloud-Transparenz und automatisierte Orchestrierung in hybriden und Multi-Cloud-Umgebungen bietet.
Für wen eignet sich ServiceNow ITOM am besten?
ServiceNow ITOM wurde für große Unternehmen mit komplexen hybriden IT-Landschaften entwickelt, in denen eine kontinuierlich aktualisierte CMDB das operative Rückgrat bildet.
Warum ich mich für ServiceNow ITOM entschieden habe
ServiceNow ITOM verdient seinen Platz auf meiner engeren Auswahl, weil die CMDB hier nicht nur eine Datenbank ist, sondern das operative Rückgrat, das Discovery und Service Graph Connectors kontinuierlich mit echten Daten aus Ihrer gesamten hybriden IT-Landschaft versorgen. Besonders gefällt mir, wie Service Mapping automatisch Abhängigkeitsvisualisierungen zwischen Infrastruktur und Geschäftsdiensten erstellt. Wenn sich beispielsweise eine AWS-Instanz verschlechtert, sehen Sie genau, welche Dienste betroffen sind, bevor die Benutzer etwas bemerken. AIOps LEAP geht noch weiter, indem abgeschlossene Vorfälle analysiert werden, um automatisierte Maßnahmenpläne zu erstellen und bereitzustellen – einschließlich eines ROI-Dashboards, das nachverfolgt, welche Einsparungen tatsächlich erzielt wurden.
Wichtige Funktionen von ServiceNow ITOM
- Protokollanalyse des Systemzustands: Analysiert Protokolldaten mithilfe von KI in Echtzeit, kennzeichnet Anomalien und zeigt Empfehlungen zur Behebung auf, bevor Probleme eskalieren.
- Synthetische Überwachung: Simuliert Transaktionen von Endbenutzern, um Verfügbarkeits- und Leistungsprobleme zu erkennen, bevor echte Benutzer betroffen sind.
- Cloud-Beschleunigung: Automatisiert die Bereitstellung und Aufhebung der Bereitstellung von Cloud-Ressourcen und setzt dabei Kennzeichnungs-, Kosten- und Sicherheitsrichtlinien in AWS, Azure und GCP durch.
- Zertifikatsverwaltung: Erkennt und verfolgt TLS/PKI-Zertifikate in Ihrer Umgebung automatisch und löst vor dem Ablauf Erneuerungsabläufe aus.
Integrationen von ServiceNow ITOM
ServiceNow ITOM lässt sich mit AWS, Microsoft Azure, Google Cloud Platform, Alibaba Cloud, Datadog, Dynatrace, Splunk, PagerDuty, Jenkins und GitHub integrieren. REST- und SOAP-APIs, Webhooks sowie Integrationen mit dem ServiceNow Store unterstützen individuelle Verbindungen.
Pros and Cons
Pros:
- CMDB ermöglicht Transparenz über den IT-Betrieb in Echtzeit
- GenAI automatisiert die Triage und Behebung von Vorfällen
- Multi-Cloud-Erkennung für AWS, Azure und GCP
Cons:
- Nur als SaaS verfügbar, keine selbst gehostete Option
- Für erweiterte Funktionen sind separate Modul-Lizenzen erforderlich
Learn more about ServiceNow ITOM: Am besten geeignet für domänenübergreifende Überwachung des Servicezustands in Cisco-nativen Umgebungen
- Kostenlose Demo verfügbar
- Preis auf Anfrage
Visit WebsiteCustomer Rating:4.9/5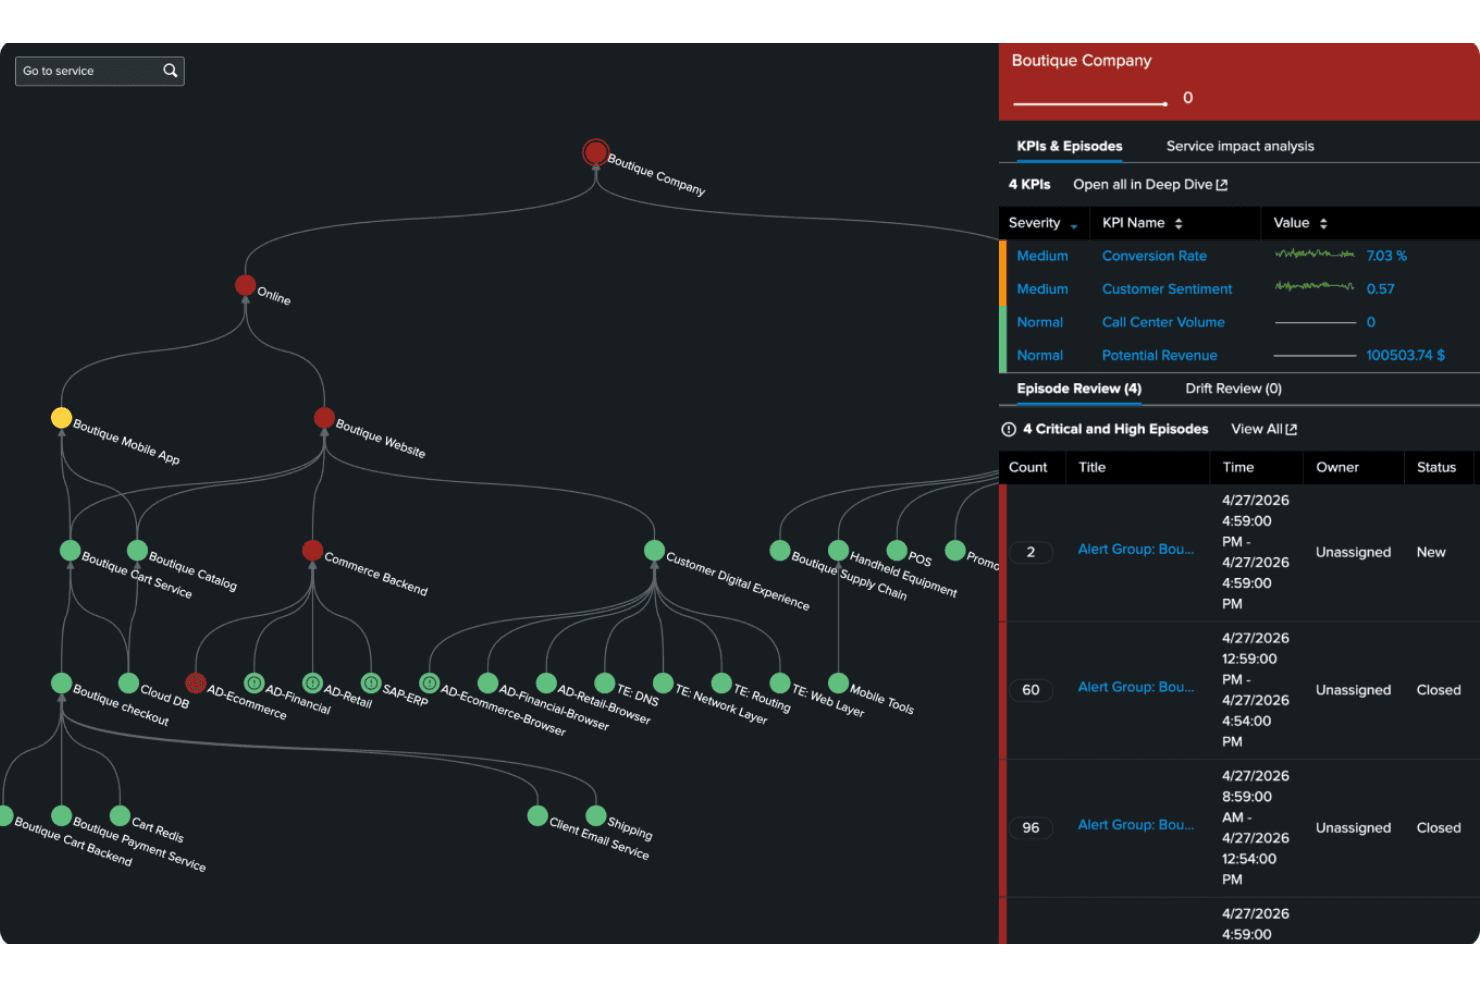
Splunk ITSI visualisiert den Servicezustand und Episoden in einer Abhängigkeitskarte. Splunk IT Service Intelligence (ITSI) ist eine AIOps-gesteuerte Plattform für das IT-Betriebsmanagement, die eine KPI-basierte Bewertung des Servicezustands, KI-gestützte Alarmkorrelation, Topologiemapping und domänenübergreifende Transparenz über Infrastruktur, Anwendungen und Netzwerke hinweg bietet.
Für wen ist Splunk IT Service Intelligence am besten geeignet?
Splunk ITSI eignet sich besonders für IT-Betriebsteams in Unternehmen – insbesondere für solche, die bereits Splunk einsetzen oder in Cisco-Umgebungen arbeiten und den Servicezustand von Infrastruktur, Anwendungen und Netzwerken in großem Maßstab korrelieren müssen.
Warum ich mich für Splunk IT Service Intelligence entschieden habe
Splunk ITSI steht auf meiner Auswahlliste, weil es den domänenübergreifenden Servicezustand in Cisco-nativen Umgebungen besonders gut verarbeitet. Ich schätze, dass es Signale aus Cisco ThousandEyes, Meraki und Catalyst Center direkt in sein KPI-basiertes Zustandsbewertungsmodell einbindet, sodass die Transparenz von Netzwerk bis Anwendung nicht manuell zusammengefügt werden muss. Die Event-iQ-Engine korreliert diese Signale anschließend zu konsolidierten Episoden und filtert Alarmrauschen heraus, bevor Ihr Team Zeit mit Duplikaten verschwendet.
Wichtige Funktionen von Splunk IT Service Intelligence
- Glas-Tabellen: Erstellen Sie pixelgenaue Drag-and-Drop-Dashboards, die Live-Bewertungen des Servicezustands auf Geschäfts-KPIs wie SLA-Erfüllung oder Umsatzwirkung abbilden.
- Adaptive Schwellenwerte: ML-Modelle ermitteln im Zeitverlauf das normale Verhalten jeder KPI und lösen bei statistischen Abweichungen statt bei festen Schwellenwerten Alarme aus.
- Arbeitsbereich für die Episodenprüfung: Eine zentrale Oberfläche zur Triage, auf der KI-korrelierte Alarmgruppen mit Schweregradbewertung, Kontext zum betroffenen Service und empfohlenen nächsten Schritten angezeigt werden.
- Modellierung von Serviceabhängigkeiten: Definieren und visualisieren Sie hierarchische Beziehungen zwischen Geschäftsdiensten, Unterdiensten, Hosts und Netzwerkgeräten, um die Grundursachen schneller zu isolieren.
Integrationen von Splunk IT Service Intelligence
Splunk IT Service Intelligence lässt sich in ServiceNow, PagerDuty, Jira Cloud, Cisco ThousandEyes, Cisco Catalyst Center, Cisco Meraki, Splunk Observability Cloud, AppDynamics und Red Hat Ansible Automation Platform integrieren. Darüber hinaus bietet es Integrationen aus dem Splunkbase-Marktplatz, Zugriff auf die REST-API, Python-SDKs, Webhooks und Kafka.
Pros and Cons
Pros:
- Fortschrittliche KI-gestützte Alarmkorrelation und Triage
- Einheitliche domänenübergreifende Überwachung für Cisco-Umgebungen
- Hochgradig anpassbare Dashboards für Geschäftsmetriken
Cons:
- Hoher Ressourcenbedarf bei umfangreichen Bereitstellungen
- Komplexe Implementierung der Service- und Entitätsmodellierung
Learn more about Splunk IT Service Intelligence: Am besten für agentenbasierte KI im Betrieb vom Mainframe bis zur Cloud
- Kostenlose Demo verfügbar
- Preise auf Anfrage
Visit WebsiteCustomer Rating:4/5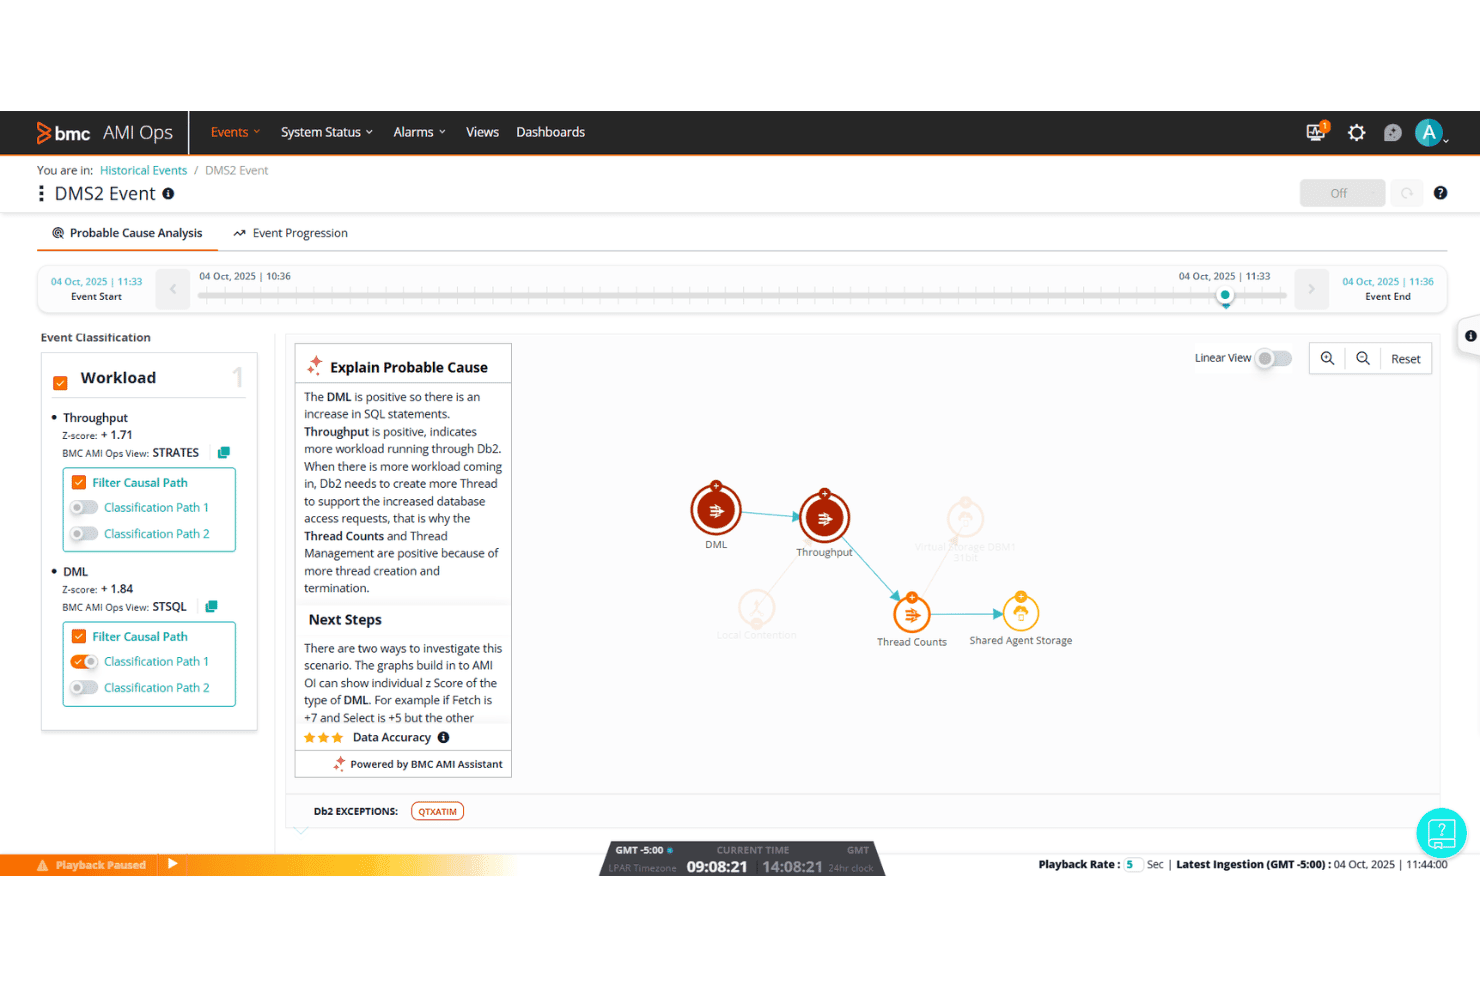
BMC Helix AIOps erklärt wahrscheinliche Ursachen mit KI-gestützter Ereignisanalyse. BMC Helix AIOps ist eine cloudnative Plattform für das IT-Betriebsmanagement, die Ereignisüberwachung, KI-gestützte Vorfallkorrelation, automatisierte Behebung und Topologiekartierung in lokalen, Cloud- und Mainframe-Umgebungen vereinheitlicht.
Für wen ist BMC Helix AIOps am besten geeignet?
BMC Helix AIOps wurde für große Unternehmen entwickelt, die komplexe hybride Umgebungen betreiben, die sich über Mainframe-Systeme, lokale Infrastrukturen und mehrere öffentliche Clouds erstrecken.
Warum ich BMC Helix AIOps ausgewählt habe
BMC Helix AIOps hat sich einen Platz auf meiner Auswahlliste verdient, weil es eine der wenigen Plattformen ist, die ich gesehen habe, die tatsächlich den gesamten Bereich vom Mainframe bis zur Cloud abdeckt, ohne eines der beiden Enden zu vernachlässigen. Ich verlasse mich auf die agentenbasierten KI-Funktionen von HelixGPT, insbesondere den Agent Builder und Ops Swarmer, um die autonome Triage von Vorfällen in z/OS-Umgebungen und Kubernetes-Clustern innerhalb desselben Workflows zu übernehmen. Die KI-gestützte Situationskorrelation reduziert das Alarmrauschen um bis zu 90 %, was in der Praxis bedeutet, dass mein Team nicht in doppelten Alarmen über 600 Dashboards untergeht.
Die wichtigsten Funktionen von BMC Helix AIOps
- Analyse der wahrscheinlichen Ursache: Die KI korreliert Topologie- und Ereignisdaten, um die wahrscheinlichste Grundursache einer Situation zu identifizieren, bevor die manuelle Untersuchung beginnt.
- HelixGPT-Analyse nach dem Vorfall: Erstellt automatisch detaillierte Zusammenfassungen für die Nachbesprechung von Vorfällen, um SRE- und Betriebsteams nach der Behebung zu unterstützen.
- Dynamische Erstellung von Servicemodellen: Integriert sich in BMC Helix Discovery, um Servicemodelle automatisch zu erstellen und kontinuierlich zu aktualisieren, die Abhängigkeiten in Ihrer hybriden Umgebung abbilden.
- Rollenbasierte Dashboard-Ansichten: Segmentiert Betriebsdaten und Berichte nach Rolle und bietet jedem Teammitglied eine gefilterte Ansicht der für seine Funktion relevanten Metriken und Ereignisse.
Integrationen von BMC Helix AIOps
BMC Helix AIOps lässt sich in BMC Helix ITSM, ServiceNow, AWS, Azure, Google Cloud Platform, Microsoft Teams, Slack, BMC Helix Discovery und Jitterbit integrieren. Außerdem werden REST-APIs, CMDB-Konnektivität, Überwachungstools von Drittanbietern und die Bereitstellung über AWS Marketplace unterstützt.
Pros and Cons
Pros:
- Native Überwachung von Mainframes und hybriden Clouds
- KI-gestützte Reduzierung des Alarmrauschens um bis zu 90 %
- Automatisierte Topologie- und Abhängigkeitszuordnung enthalten
Cons:
- Die Konfiguration erfordert umfassende technische Fachkenntnisse
- Dashboard-Anpassung weniger intuitiv als bei Wettbewerbern
Learn more about BMC Helix AIOps:
Weitere Software für das IT-Betriebsmanagement
Hier finden Sie einige weitere Optionen für Software zum IT-Betriebsmanagement, die es nicht in meine engere Auswahl geschafft haben, aber dennoch einen Blick wert sind:
- 11VirtanaAm besten für umfassende Transparenz bei Speicher- und GPU-Operationen
- 12ManageEngine OpManagerAm besten geeignet für die Workflow-Automatisierung ohne Programmierung von der Fehlererkennung bis zur Behebung
- 13BigPandaAm besten für KI-gesteuerte Risikobewertung von Änderungen
- 14PagerDutyIdeal für die skalierbare Reaktion auf Vorfälle im Bereitschaftsdienst
- 15ZabbixAm besten geeignet für die Open-Source-Betriebsüberwachung in jeder Größenordnung
- 16MoogsoftAm besten zur ML-gesteuerten Reduzierung von Alarmrauschen
- 17CheckmkIdeal für servicebasierte Preisgestaltung in hybriden Infrastrukturen
- 18Ivanti NeuronsAm besten für ITSM-verankerte IT- und SecOps-Automatisierung
- 19Grafana CloudAm besten für ML-gestützte Beobachtbarkeit des gesamten Betriebs-Stacks
- 20SolarWinds Observability SaaSAm besten für eine von NetOps ausgehende Überwachung des gesamten Technologie-Stacks
How I Evaluate IT Operations Management Software
When an alert storm hits at 2 a.m. and your team needs to trace a degraded API back to a misconfigured container in a hybrid cluster, the tools either hold up or they don't—so I split my evaluation into baseline functionality every platform must cover and the differentiators that separate good from great.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. I then calculate the tool's total score into a percentage, using 75% as a benchmark to help assess its overall fit for the list.
- Infrastructure & App Monitoring: I check whether the platform covers servers, networks, apps, and cloud resources with real-time metrics, logs, and traces.
- Alerting & Incident Management: Each tool's alert correlation, escalation policies, and incident workflows matter—especially how well it cuts through noise during an outage.
- IT Automation & Orchestration: I look for visual workflow builders, auto-remediation playbooks, and cross-platform runbooks that reduce manual toil on recurring tasks.
- Hybrid & Multi-Cloud Visibility: Unified dashboards across on-prem, AWS, Azure, and GCP are table stakes—I evaluate topology mapping and dynamic discovery depth.
- Reporting & Analytics Dashboards: Customizable dashboards with drill-downs, SLA/SLO tracking, and capacity forecasting tell me how well a tool supports planning conversations.
- Integrations & API Access: I evaluate prebuilt connectors to ITSM, DevOps, and chatops tools, plus REST API coverage for teams that need to build custom workflows.
Once I have a list of tools that meet the criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
I evaluate how well each platform's AIOps engine baselines normal behavior and correlates related events into a single incident—during a noisy outage, the difference between 200 alerts and one actionable incident is hours of recovery time. Topology and dependency mapping matters just as much: I check whether the tool auto-discovers relationships across containers, hosts, and network paths so you can trace a failing checkout API back to an undersized pod without switching screens. I also look at built-in cloud cost visibility, since platforms like Datadog and Dynatrace now tie resource utilization directly to spend, helping you spot idle workloads before finance does.
Beyond Features
I evaluate total cost of ownership closely because ingestion-based pricing can spiral fast—adding custom metrics or doubling log volume in platforms like Datadog or New Relic often triggers surprise overages that dwarf the original quote. Deployment flexibility matters just as much; I check whether a vendor offers SaaS, self-hosted, and air-gapped options, since regulated industries frequently need on-prem control that pure-SaaS tools can't deliver. I also look at ecosystem depth, specifically bidirectional ITSM integrations and open API coverage, so operations data flows into existing DevOps and ChatOps workflows without custom glue code.
So wählen Sie Software für das IT-Betriebsmanagement aus
Wenn Sie entscheiden, welche Software für das IT-Betriebsmanagement am besten zu Ihrer Umgebung passt, sollten Sie zunächst Ihre dringendsten betrieblichen Herausforderungen in den Mittelpunkt stellen:
| Wenn Ihre Priorität ... ist | Achten Sie auf ... |
|---|---|
| Wenn Ihre Priorität ... istSchnelle und präzise Ursachenanalyse | Achten Sie auf ...KI-basierte Korrelation von Vorfällen und automatisierte Runbooks |
| Wenn Ihre Priorität ... istHybride und Multi-Cloud-Umgebungen | Achten Sie auf ...Native Konnektoren für lokale Umgebungen, AWS, Azure und GCP |
| Wenn Ihre Priorität ... istReduzierung manueller Behebungsaufgaben | Achten Sie auf ...Visuelle Workflow-Builder mit vorgefertigter Automatisierung |
| Wenn Ihre Priorität ... istKontrolle der Ausgaben für die Überwachung | Achten Sie auf ...Transparente, nutzungsbasierte Preise und Kosten-Dashboards |
| Wenn Ihre Priorität ... istUmfassende Integrationen mit ITSM-Tools | Achten Sie auf ...Vorgefertigte Konnektoren und offene API-Dokumentation |
So prüfen Sie Ihre engere Auswahl
- Workflows für die Triage von Vorfällen testen: Führen Sie einen 48-stündigen Test durch und simulieren Sie mindestens drei Arten von Ausfällen, um die Gruppierung von Vorfällen und automatisierte Reaktionen zu überprüfen.
- Eine Demo der Topologiekarte anfordern: Bitten Sie den Anbieter, anhand von Live- oder anonymisierten Beispieldaten eine durchgängige Abhängigkeitskarte zu erstellen, einschließlich hybrider Cluster.
- Ein plattformübergreifendes Ticket erstellen: Eröffnen Sie ein Support-Ticket mit Bezug auf eine Multi-Cloud-Integration und dokumentieren Sie die Genauigkeit der Antworten sowie die SLAs über einen Zeitraum von drei Tagen.
- Vollständigkeit der Berichte bewerten: Prüfen oder exportieren Sie ein Beispiel für ein Analyse-Dashboard und bestätigen Sie, dass Kosten, SLA und benutzerdefinierte Metriken für Ihren tatsächlichen Technologie-Stack sichtbar sind.
- Agilität von SaaS im Vergleich zur Kontrolle beim Selbsthosting: Entscheiden Sie, ob die schnelle Bereitstellung von Funktionen in SaaS die Compliance- und Zugriffsanforderungen überwiegt, die durch lokale oder vom Netzwerk getrennte Bereitstellungen erfüllt werden.
Was ist Software für das IT-Betriebsmanagement?
Software für das IT-Betriebsmanagement ist eine Kategorie von Tools, die dazu entwickelt wurden, IT-Infrastruktur, Anwendungen, Netzwerke und Dienste in lokalen sowie Cloud-Umgebungen zu überwachen, zu automatisieren und zu verwalten. Diese Plattformen helfen Ihrem Team, Warnungen zu zentralisieren, den Systemzustand aufrechtzuerhalten, Vorfälle zu verwalten und die Ressourcennutzung zu optimieren. Durch die Zusammenführung von Betriebsdaten und Automatisierung unterstützt Software für das IT-Betriebsmanagement eine schnellere Fehlerbehebung, steigert die Effizienz und ermöglicht es Ihrem Unternehmen, Technologien zuverlässig zu skalieren.
Funktionen von Software für das IT-Betriebsmanagement
Achten Sie bei der Auswahl einer Software für das IT-Betriebsmanagement auf die folgenden wichtigen Funktionen:
- Überwachung von Infrastruktur und Anwendungen: Überwacht Server, Netzwerke, Container und Anwendungen in Echtzeit. Hilft Ihnen, ungewöhnliches Systemverhalten, nachlassende Leistung oder Ausfälle zu erkennen, bevor Benutzer betroffen sind.
- Warnmeldungen und Vorfallmanagement: Zentralisiert Warnmeldungen und optimiert Eskalationsabläufe. Ermöglicht Ihrem Team, schnell zu reagieren, Vorfälle in ihren Kontext einzuordnen und die Behebung von Anfang bis Ende nachzuverfolgen.
- Automatisierung und Orchestrierung: Bietet Tools zur Automatisierung routinemäßiger Aufgaben und zur Koordinierung von Abläufen über verschiedene Umgebungen hinweg. Reduziert den manuellen Aufwand und mindert menschliche Fehler bei Bereitstellungen oder Wartungsarbeiten.
- Unterstützung für hybride Umgebungen und mehrere Clouds: Bietet einheitliche Transparenz über lokale, private Cloud- und öffentliche Cloud-Infrastrukturen hinweg. Hilft Ihnen, komplexe Umgebungen als eine einzige betriebliche Einheit zu verwalten.
- Anpassbare Dashboards und Berichte: Ermöglicht es Ihnen, Dashboards und Berichte passend zu Ihren Anforderungen zu erstellen. Unterstützt die Trendanalyse, die SLA-Überwachung und das Teilen von Erkenntnissen mit technischen und geschäftlichen Beteiligten.
- Integration und API-Zugriff: Verbindet sich mit ITSM-, DevOps- und Plattformen für die Zusammenarbeit. Ermöglicht Ihrem Team, IT-Betriebsdaten direkt in Ticketsysteme, Chats und andere Systeme einzubetten.
- Topologie- und Abhängigkeitszuordnung: Visualisiert die Beziehungen zwischen Systemen, Diensten und Infrastrukturkomponenten. Erleichtert es, die Grundursache von Vorfällen nachzuverfolgen und betriebliche Risiken zu verstehen.
- Benutzer- und rollenbasierte Zugriffskontrolle: Ermöglicht es Ihnen festzulegen, wer Teile Ihrer Umgebung anzeigen oder bearbeiten darf. Schützt sensible Daten und begrenzt den Zugriff entsprechend den Verantwortlichkeiten der Benutzer.
- Kapazitätsplanung und Prognosen: Analysiert Trends beim Ressourcenverbrauch, um den künftigen Bedarf vorherzusagen. Hilft Ihnen, Infrastrukturaktualisierungen vorauszuplanen und das Wachstum zu budgetieren.
- Änderungsnachverfolgung und Prüfprotokolle: Zeichnet Konfigurationsänderungen und Benutzeraktionen auf. Unterstützt Compliance-Anforderungen und hilft bei der Fehlerbehebung früherer Vorfälle, indem eine klare Änderungshistorie bereitgestellt wird.
Gängige KI-Funktionen von Software für das IT-Betriebsmanagement
Über die oben aufgeführten Standardfunktionen von Software für das IT-Betriebsmanagement hinaus integrieren viele dieser Lösungen KI mit Funktionen wie:
- KI-gestützte Anomalieerkennung: Nutzt maschinelles Lernen, um ungewöhnliche Muster oder Verhaltensweisen in Systemmetriken, Protokollen oder Netzwerkverkehr automatisch zu erkennen. Dies hilft Ihrem Team, neu auftretende Probleme zu erkennen, bevor sie sich verschärfen, selbst wenn Schwellenwerte nicht manuell festgelegt wurden.
- Automatisierte Ursachenanalyse: Wendet KI-Algorithmen an, um Ereignisse, Protokolle und Leistungsdaten in Ihrem gesamten Technologie-Stack miteinander zu korrelieren. Diese Funktion grenzt die wahrscheinliche Ursache von Vorfällen ein, verkürzt die Zeit, die Ihr Team für Untersuchungen aufwendet, und beschleunigt die Wiederherstellung.
- Vorhersage von Vorfällen: Nutzt historische Daten und KI-Modelle, um potenzielle Ausfälle oder Leistungseinbußen vorherzusehen. Dadurch können Sie proaktive Maßnahmen ergreifen, um Vorfälle zu verhindern, und Wartungsarbeiten effektiver planen.
- Intelligente Reduzierung von Warnmeldungen: Nutzt KI, um zusammengehörige Warnmeldungen zu gruppieren, Duplikate zu unterdrücken und Benachrichtigungen anhand ihrer Auswirkungen und ihres Kontexts zu priorisieren. Dies verringert die Warnmeldungsüberlastung und stellt sicher, dass sich Ihr Team auf die wichtigsten Probleme konzentriert.
- KI-gestützte Vorschläge zur Problembehebung: Analysiert Vorfalldaten und frühere Lösungen, um nächste Schritte oder automatisierte Korrekturen zu empfehlen. Dies hilft Ihrem Team, schneller zu reagieren, und vereinheitlicht bewährte Vorgehensweisen in Ihrem gesamten Betrieb.
Vorteile von Software für das IT-Betriebsmanagement
Die Implementierung einer Software für das IT-Betriebsmanagement bietet Ihrem Team und Ihrem Unternehmen mehrere Vorteile. Hier sind einige davon:
- Zentralisierte Übersicht: Vereinheitlichen Sie die Überwachung von Servern, Netzwerken, Anwendungen und Cloud-Ressourcen über ein einziges Dashboard, damit Ihr Team umgebungsübergreifend Problemen immer einen Schritt voraus ist.
- Schnellere Behebung von Vorfällen: Nutzen Sie Funktionen zur Alarmaggregation, KI-gestützten Korrelation und automatisierten Ursachenanalyse, um betriebliche Probleme schnell zu identifizieren, zu priorisieren und darauf zu reagieren.
- Weniger manueller Aufwand: Automatisieren Sie wiederkehrende Wartungs-, Behebungs- und Workflow-Aufgaben mithilfe vorgefertigter Automatisierungs- und Orchestrierungswerkzeuge und schaffen Sie so Zeit für Initiativen mit höherem Mehrwert.
- Proaktives Risikomanagement: Sagen Sie Ausfälle und Engpässe bei Ressourcen mit KI-gestützter Anomalieerkennung und Prognosewerkzeugen voraus, die potenzielle Probleme aufzeigen, bevor sie eskalieren.
- Optimierung von Kosten und Ressourcen: Verfolgen Sie die Infrastrukturnutzung, die Anwendungsleistung und die Ressourcenausgaben mithilfe von Berichts- und Analysefunktionen und unterstützen Sie so die Budgetverwaltung und Kapazitätsplanung.
- Mehr Sicherheit und Compliance: Nutzen Sie Benutzerzugriffskontrollen, Audit-Protokolle und Funktionen zur Änderungsverfolgung, um sensible Daten zu schützen und regulatorische Anforderungen zu unterstützen.
- Nahtlose Integration in das Ökosystem: Verbinden Sie ITSM-, DevOps- und Chat-Plattformen mithilfe vorgefertigter Integrationen und offener APIs, sodass sich Betriebsdaten leichter in die Arbeitsweise Ihres Teams integrieren lassen.
Kosten und Preise von Software für das IT-Betriebsmanagement
Die Auswahl einer Software für das IT-Betriebsmanagement erfordert ein Verständnis der verschiedenen verfügbaren Preismodelle und Tarife. Die Kosten variieren je nach Funktionen, Teamgröße, Zusatzoptionen und weiteren Faktoren. Die folgende Tabelle fasst gängige Tarife, ihre Durchschnittspreise und typische enthaltene Funktionen von Lösungen für das IT-Betriebsmanagement zusammen:
Tarifvergleichstabelle für Software für das IT-Betriebsmanagement
| Tariftyp | Durchschnittlicher Preis | Übliche Funktionen |
|---|---|---|
| TariftypKostenloser Tarif | Durchschnittlicher Preis$0 | Übliche FunktionenGrundlegende Infrastrukturüberwachung, eingeschränkte Alarmierung, Zugriff für kleine Teams und Community-Support. |
| TariftypPersönlicher Tarif | Durchschnittlicher Preis$10–$30/Benutzer/Monat | Übliche FunktionenÜberwachung in Echtzeit, Automatisierung für Einsteiger, grundlegende Dashboards, Integration mit beliebten Werkzeugen und E-Mail-Support. |
| TariftypGeschäftstarif | Durchschnittlicher Preis$40–$80/Benutzer/Monat | Übliche FunktionenÜberwachung des gesamten Technologie-Stacks, Alarmierung und Vorfallmanagement, Workflow-Automatisierung, erweiterte Dashboards, API-Zugriff und rollenbasierte Zugriffskontrolle. |
| TariftypUnternehmenstarif | Durchschnittlicher Preis$90–$200/Benutzer/Monat | Übliche FunktionenÜbersicht über hybride Umgebungen und mehrere Clouds, KI-gestützte Funktionen, benutzerdefinierte SLAs, Compliance-Unterstützung, dedizierte Integrationen und Premium-Support. |
Häufig gestellte Fragen zur Software für das IT-Betriebsmanagement
Hier finden Sie Antworten auf häufige Fragen zur Software für das IT-Betriebsmanagement:
Wie vergleicht man verschiedene Plattformen für das IT-Betriebsmanagement?
Beginnen Sie damit, Ihre unverzichtbaren Funktionen aufzulisten – etwa Unterstützung für mehrere Clouds, Automatisierung und Integrationstiefe. Testen Sie die Plattformen anschließend anhand typischer Störungsszenarien und vergleichen Sie, wie die einzelnen Tools mit Warnmeldungen, Ursachenanalysen und Berichten umgehen. Auch die Gesamtbetriebskosten, Integrationen in das Ökosystem und die Flexibilität bei der Bereitstellung sollten Sie vor der endgültigen Entscheidung prüfen.
Kann Software für das IT-Betriebsmanagement die Reaktion auf Störungen automatisieren?
Ja, mit den meisten modernen Lösungen für das IT-Betriebsmanagement lässt sich die Reaktion auf Störungen mithilfe von Runbooks, Workflow-Buildern und sogar KI-gestützter automatischer Fehlerbehebung automatisieren. Dadurch reduzieren Sie manuelle Schritte und stellen eine konsistente Reaktion auf wiederkehrende Probleme sicher.
Auf welche Integrationen sollte ich bei Software für das IT-Betriebsmanagement achten?
Achten Sie auf API-Zugriff, vorgefertigte Konnektoren zu ITSM-Tools (wie ServiceNow), Chat-Plattformen (wie Slack oder Microsoft Teams) und DevOps-Pipelines. Tiefgreifende Integrationen ermöglichen es Ihrem Team, Warnmeldungen weiterzuleiten, Workflows auszulösen und Tickets systemübergreifend mit Ihren vorhandenen Systemen zu synchronisieren – ganz ohne kundenspezifische Middleware.
Unterstützt Software für das IT-Betriebsmanagement die Einhaltung von Compliance-Vorgaben und die Prüfung?
Ja, leistungsfähige Software für das IT-Betriebsmanagement erfasst Systemänderungen und Benutzeraktionen und stellt die für Compliance erforderlichen Prüfprotokolle bereit. Dies ist besonders in regulierten Branchen hilfreich, in denen Sie eindeutige Nachweise für Kontrollen und eine vollständige Änderungshistorie für die Berichterstellung benötigen.
Wie kann ich unerwartete Kosten bei Software für das IT-Betriebsmanagement vermeiden?
Prüfen Sie immer, wie die Plattform die Datenerfassung, benutzerdefinierte Metriken und Benutzerplätze abrechnet. Entscheiden Sie sich für Tools mit transparenter, nutzungsbasierter Preisgestaltung und Kostenübersichten in der Anwendung, damit Sie die Ausgaben überwachen und unerwartete Mehrkosten vermeiden können, wenn Ihre Umgebung wächst.
Wie kann ich Stakeholder für eine neue Plattform für das IT-Betriebsmanagement gewinnen?
Zeigen Sie, wie die Plattform zur Erreichung der Geschäftsziele beiträgt: schnellere Behebung von Störungen, proaktives Risikomanagement und verbesserte Berichterstellung. Präsentieren Sie eine Demo oder Ergebnisse eines Pilotprojekts, heben Sie die erwarteten Effizienzgewinne hervor und verknüpfen Sie die Funktionen mit Problemen, die Ihre Stakeholder kennen.