

Las 10 mejores herramientas de seguimiento de experimentos de aprendizaje automático en 2026
Lista de las mejores herramientas de seguimiento de experimentos de ML


Las herramientas de seguimiento de experimentos de ML te ayudan a registrar, organizar y comparar experimentos de aprendizaje automático para que puedas gestionar los resultados y reproducir los hallazgos con confianza. Si buscas formas prácticas de realizar un seguimiento de los experimentos, compartir el progreso con tu equipo o mantener organizados tus modelos y conjuntos de datos, la herramienta adecuada puede marcar una gran diferencia.
En esta lista encontrarás soluciones adaptadas a diferentes pilas tecnológicas y flujos de trabajo, que te ayudarán a reducir las dificultades, simplificar los informes y centrarte en una gestión fiable de los experimentos de aprendizaje automático.
Por qué confiar en nuestras reseñas de software
Llevamos probando y revisando software desde 2023. Como líderes tecnológicos, sabemos lo crítico y difícil que es tomar la decisión correcta al seleccionar software.
Invertimos en una investigación profunda para ayudar a nuestra audiencia a tomar mejores decisiones de compra de software. Hemos probado más de 2,000 herramientas para diferentes casos de uso tecnológicos y escrito más de 1,000 reseñas de software exhaustivas. Descubre cómo mantenemos la transparencia y nuestra metodología de revisión de software.
Resumen de las mejores herramientas de seguimiento de experimentos de ML
Esta tabla comparativa resume los detalles de precios de mi selección de las mejores herramientas de seguimiento de experimentos de ML para ayudarte a encontrar la más adecuada para tu presupuesto y las necesidades de tu empresa.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Ideal para comparación de experimentos en tiempo real | Plan gratuito disponible | Desde $19/usuario/mes | Website | |
| 2 | Ideal para paneles de visualización personalizables | Plan gratuito disponible | Desde $60/mes | Website | |
| 3 | Ideal para el control de versiones automático de canalizaciones | Prueba gratuita de 14 días disponible | Precio bajo solicitud | Website | |
| 4 | Ideal para la orquestación automática de pipelines | Plan gratuito disponible | From $15/user/month | Website | |
| 5 | Lo mejor para soporte de ciclo de vida de modelos de código abierto | Demo gratis + plan gratuito para siempre disponible | Gratis para siempre (código abierto) | Website | |
| 6 | Ideal para la integración con marcos de aprendizaje profundo | Plan gratuito para siempre disponible | Gratis para siempre (código abierto) | Website | |
| 7 | Ideal para la gestión de flujos de trabajo nativos de Kubernetes | Plan gratuito disponible | Gratuito y de código abierto | Website | |
| 8 | Lo mejor para la integración con el ecosistema de la nube de AWS | Plan gratuito disponible | Desde $0.204/hora | Website | |
| 9 | Ideal por su arquitectura de plugins y gran extensibilidad | Plan gratuito disponible | Desde $399/mes | Website | |
| 10 | Mejor para opciones de implementación híbridas y en local | Plan gratuito + demo gratuita disponible | Desde $450/mes (facturación anual) | Website |
Opiniones sobre las mejores herramientas de seguimiento de experimentos de ML
A continuación se muestran mis resúmenes detallados de las mejores herramientas de seguimiento de experimentos de ML que llegaron a mi lista de selección. Mis reseñas ofrecen un análisis detallado de las funciones, integraciones y mejores casos de uso de cada plataforma para ayudarte a encontrar la más adecuada para ti.

Comet
Ideal para comparación de experimentos en tiempo real
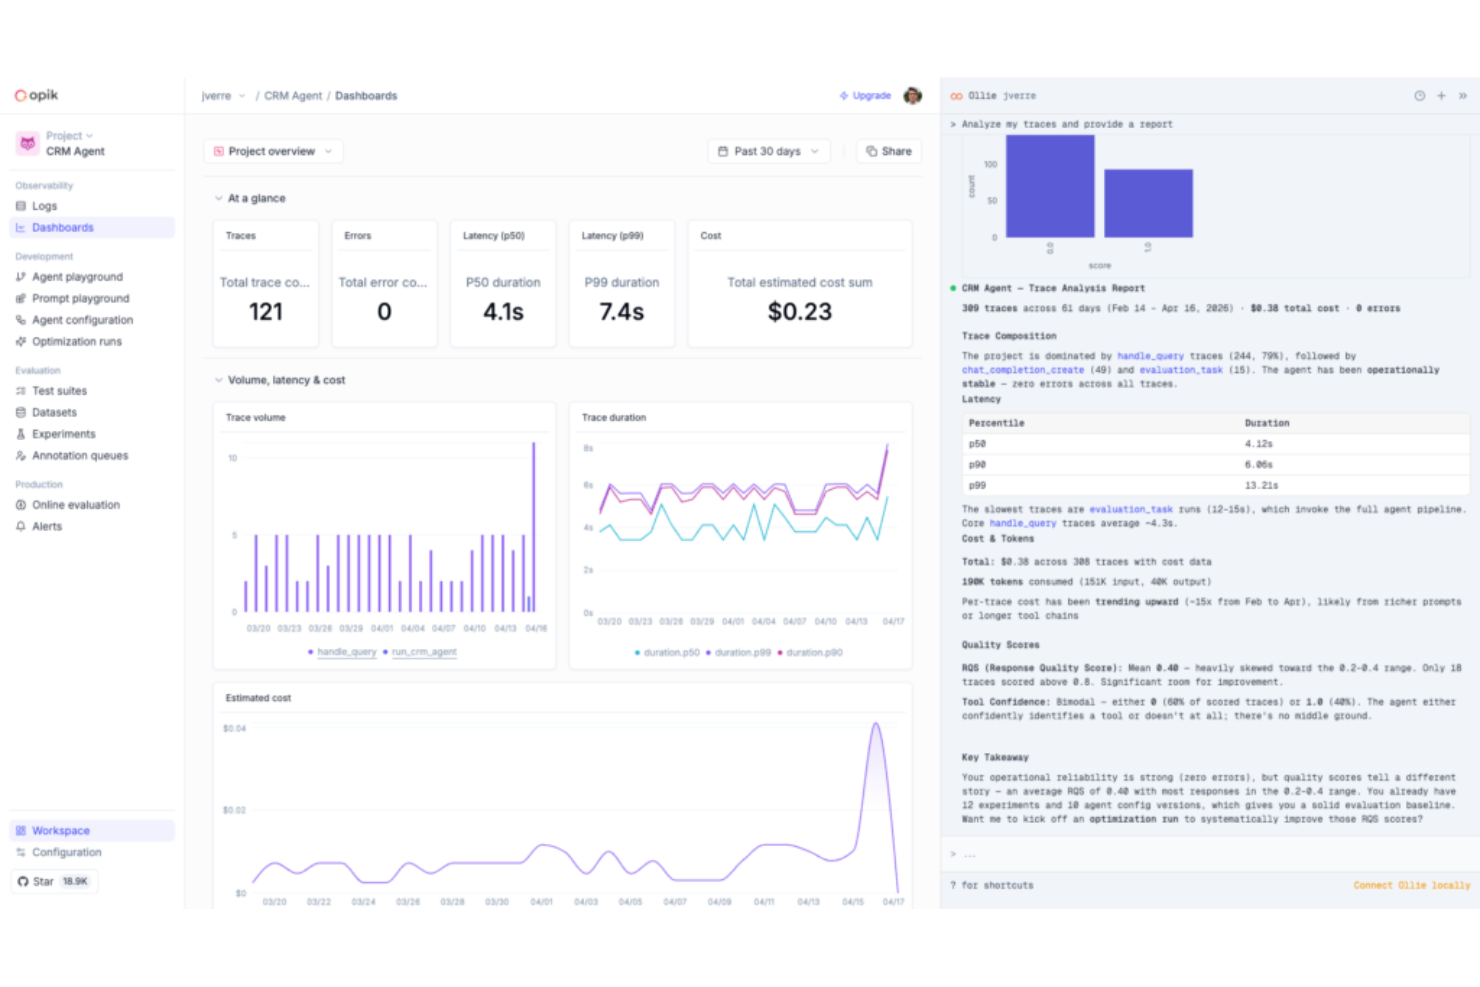
Comet es una plataforma para el seguimiento de experimentos de aprendizaje automático y evaluación de modelos que registra métricas, hiperparámetros y artefactos de los entrenamientos, y se extiende hacia la observabilidad de LLM y la evaluación de IA agentica a través de su producto Opik.
¿Para quién es Comet ideal?
Comet es una excelente opción para equipos de ML e IA de empresas en etapa de crecimiento o grandes empresas que ejecutan un gran volumen de experimentos y necesitan visibilidad en tiempo real sobre los entrenamientos.
Por qué elegí Comet
Elegí Comet como uno de los mejores porque su panel de seguimiento de experimentos en tiempo real actualiza las métricas mientras se entrenan los modelos, por lo que mi equipo puede detectar una curva de pérdida divergente y detener una ejecución problemática antes de desperdiciar recursos de cómputo. También utilizo su vista de comparación lado a lado de experimentos para filtrar entre decenas de ejecuciones por valor de hiperparámetro e identificar inmediatamente qué configuración alcanzó la mejor precisión de validación. Además de las prácticas clásicas de MLOps, Comet ahora amplía sus capacidades hacia la evaluación de LLM con Opik, lo que significa que no tengo que cambiar de herramienta al pasar del entrenamiento de modelos al monitoreo de agentes en producción.
Características clave de Comet
- Registro de modelos: Almacena, versiona y gestiona modelos entrenados en un registro centralizado con etiquetas de etapa como staging y producción.
- Registro de artefactos: Registra y versiona conjuntos de datos, imágenes, matrices de confusión y archivos de audio directamente junto a las ejecuciones de experimentos.
- Paneles personalizados: Crea visualizaciones personalizadas dentro de la interfaz de Comet usando JavaScript para ir más allá de los gráficos de métricas predeterminados.
- Seguimiento de métricas del sistema: Captura automáticamente la utilización de GPU, carga de CPU y uso de memoria en cada ejecución sin necesidad de instrumentación adicional.
Integraciones de Comet
Comet ofrece más de 30 integraciones nativas, incluyendo PyTorch, TensorFlow, Keras, Scikit-learn, XGBoost, Hugging Face Transformers, Ray, Kubeflow, Snowflake y Vertex AI. Está disponible en Zapier y ofrece una API REST junto con SDKs en Python, Java, JavaScript y R para integraciones personalizadas.
Pros and Cons
Pros:
- Registro automático de métricas con mínimo código
- Visualización en tiempo real de ejecuciones de entrenamiento
- Supervisa tanto experimentos de ML como LLMs
Cons:
- El plan Pro limita los equipos a 10 usuarios
- Opciones de personalización de la UI limitadas

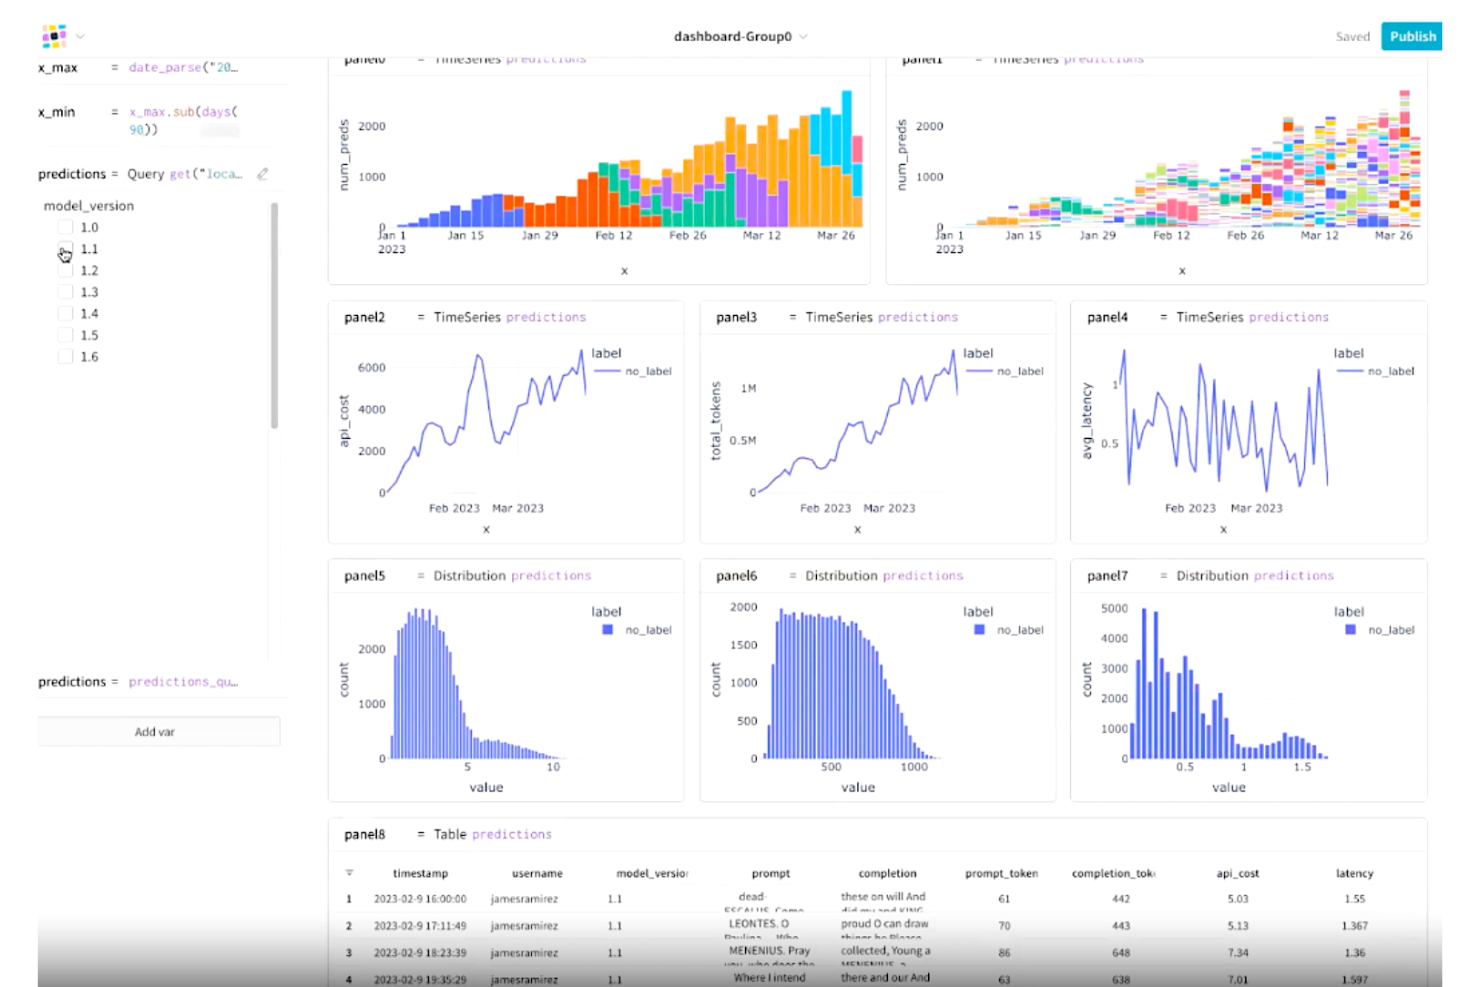
Weights & Biases es una plataforma de seguimiento de experimentos de aprendizaje automático que registra métricas, hiperparámetros y puntos de control del modelo y te permite visualizar y comparar ejecuciones a través de paneles interactivos.
¿Para quién es Weights & Biases?
Weights & Biases es ideal para científicos de datos e ingenieros de aprendizaje automático que realizan experimentos frecuentes y necesitan comparaciones detalladas de ejecuciones en equipos grandes.
Por qué elegí Weights & Biases
Weights & Biases es una de mis principales opciones porque me fascina lo lejos que llega con los paneles de visualización personalizables. Puedo extraer la utilización de GPU en tiempo real, curvas de pérdida y predicciones de muestra en un solo panel interactivo durante una ejecución de entrenamiento, lo que permite detectar cuellos de botella rápidamente. La función Sweeps me permite visualizar los resultados de las búsquedas de hiperparámetros directamente junto a las métricas de mis experimentos, así que comparo todo en una sola vista. Los informes también permiten que mi equipo anote y comparta esos paneles sin salir de la plataforma.
Características clave de Weights & Biases
- Artefactos: Versiona y realiza el seguimiento de conjuntos de datos, modelos y resultados de evaluación en diferentes ejecuciones de experimentos.
- Registro de modelos: Centraliza los modelos entrenados y vincúlalos directamente con los experimentos que los generaron.
- Agrupación de ejecuciones: Organiza ejecuciones relacionadas en grupos para comparar resultados entre configuraciones de entrenamiento.
- Alertas: Establece notificaciones automáticas para umbrales de métricas, fallos de ejecución o eventos de finalización de tareas.
Integraciones de Weights & Biases
Weights & Biases ofrece integraciones nativas con PyTorch, Keras, TensorFlow, Scikit-learn, XGBoost, Hugging Face Transformers y PyTorch Lightning, además de herramientas LLM como LangChain y LlamaIndex. También se integra con Kubeflow, Jenkins, Airflow, GitHub Actions, AWS SageMaker y Google Vertex AI. Hay disponible una API y un SDK de Python para integraciones personalizadas.
Pros and Cons
Pros:
- Transmisión en tiempo real de métricas a paneles en vivo
- Registro automático de commits de git y configuraciones
- Informes colaborativos enriquecidos con gráficos incrustados
Cons:
- La interfaz web se ralentiza con muchas ejecuciones en paralelo
- Faltan detalles en la documentación sobre funcionalidades básicas

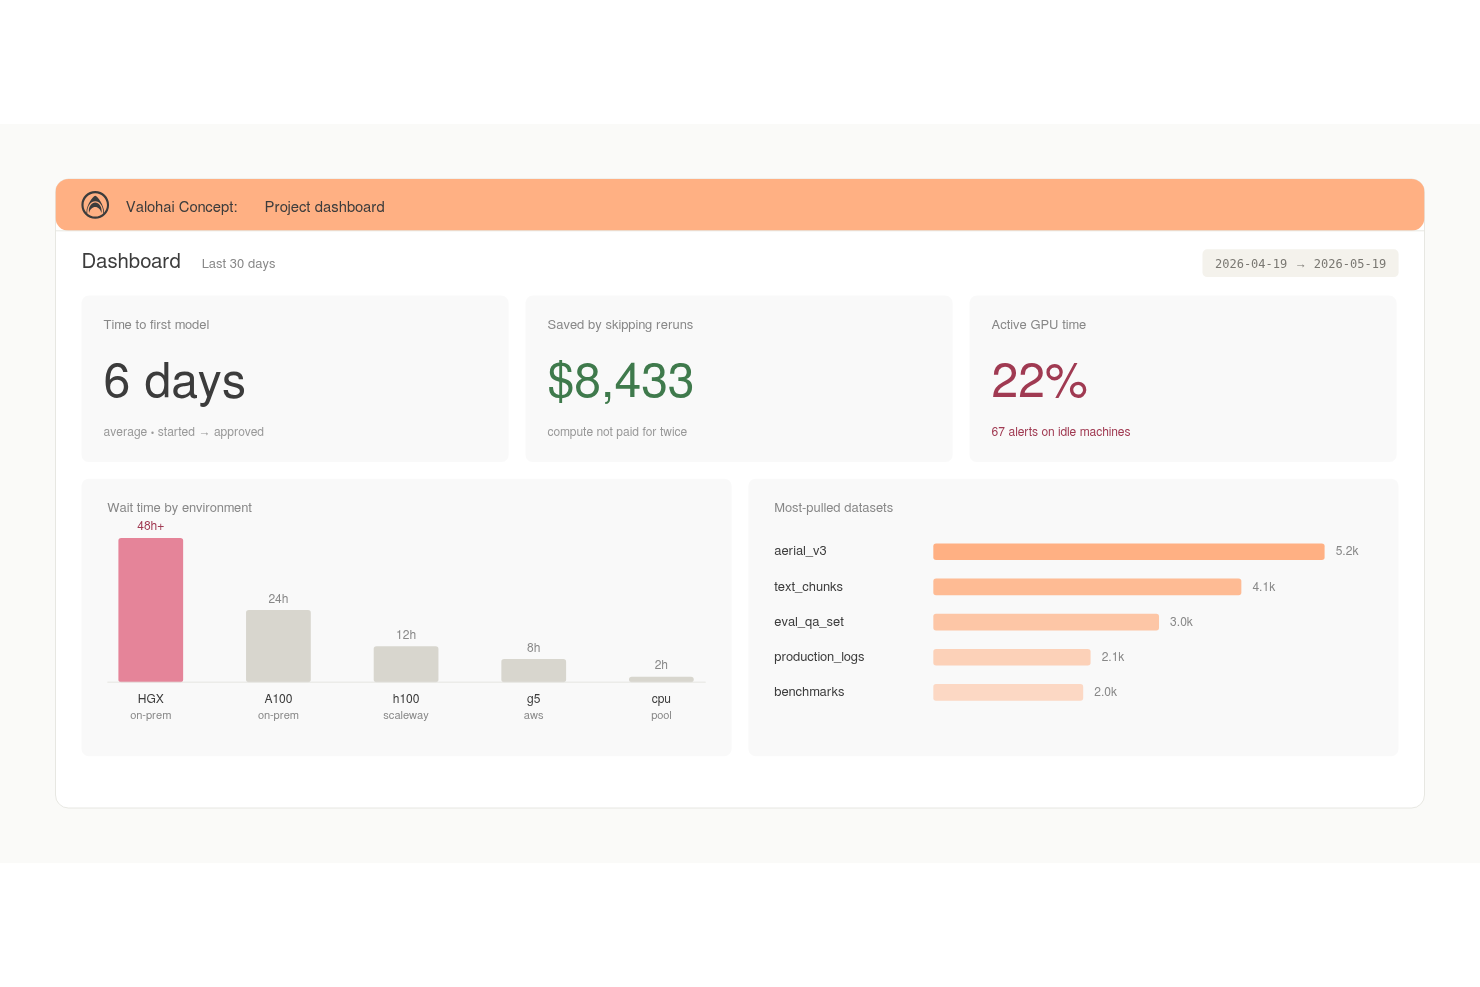
Valohai es una plataforma de ML que combina el seguimiento automático de experimentos, el control de versiones de conjuntos de datos, el linaje de modelos y la orquestación de recursos informáticos en la nube para equipos que crean y entrenan modelos a gran escala.
¿Para quién es más adecuado Valohai?
Valohai es una opción sólida para equipos de ingeniería de ML de empresas medianas y grandes que ejecutan trabajos de entrenamiento frecuentes en varios entornos de nube.
Por qué elegí Valohai
Elegí Valohai como una de las mejores opciones porque el control de versiones automático está realmente integrado en cada ejecución. Las métricas, los metadatos, los registros y los hiperparámetros se versionan sin necesidad de etiquetado manual, así que nunca tengo que reconstruir qué se ejecutó y cuándo. También me gusta que Valohai rastree el linaje completo de los conjuntos de datos y los modelos, lo que significa que puedo identificar exactamente qué versión del conjunto de datos produjo un modelo determinado. Cada ejecución es reproducible por diseño, lo que elimina las conjeturas que dificultan las auditorías de experimentos.
Características principales de Valohai
- Vista comparativa de experimentos: Muestra varias ejecuciones una al lado de la otra, lo que permite comparar hiperparámetros, métricas y resultados de distintos experimentos en una sola tabla.
- Creador de canalizaciones: Un editor visual para construir canalizaciones de ML de varios pasos, donde cada nodo corresponde a un paso de ejecución versionado.
- Orquestación de recursos informáticos en la nube: Aprovisiona y termina automáticamente instancias en la nube en AWS, GCP o Azure para cada ejecución de entrenamiento.
- Activadores de implementación: Promueve los modelos entrenados directamente a un punto de acceso de servicio desde la misma plataforma utilizada para el entrenamiento.
Integraciones de Valohai
Valohai ofrece un pequeño conjunto de integraciones prediseñadas a través de su biblioteca Ecosystem, incluidos conectores para Snowflake, BigQuery y Redshift, una plantilla de Hugging Face e integraciones con Slurm y OVHcloud. Funciona en AWS, GCP, Azure y Oracle Cloud Infrastructure, y proporciona una API REST para crear integraciones personalizadas.
Pros and Cons
Pros:
- Registra automáticamente las métricas de los JSON impresos
- Funciona en cualquier nube o hardware local
- Trazabilidad completa desde el modelo hasta el conjunto de datos
Cons:
- Adaptar los scripts al formato de Valohai requiere esfuerzo
- La vista principal de experimentos resulta visualmente poco destacable

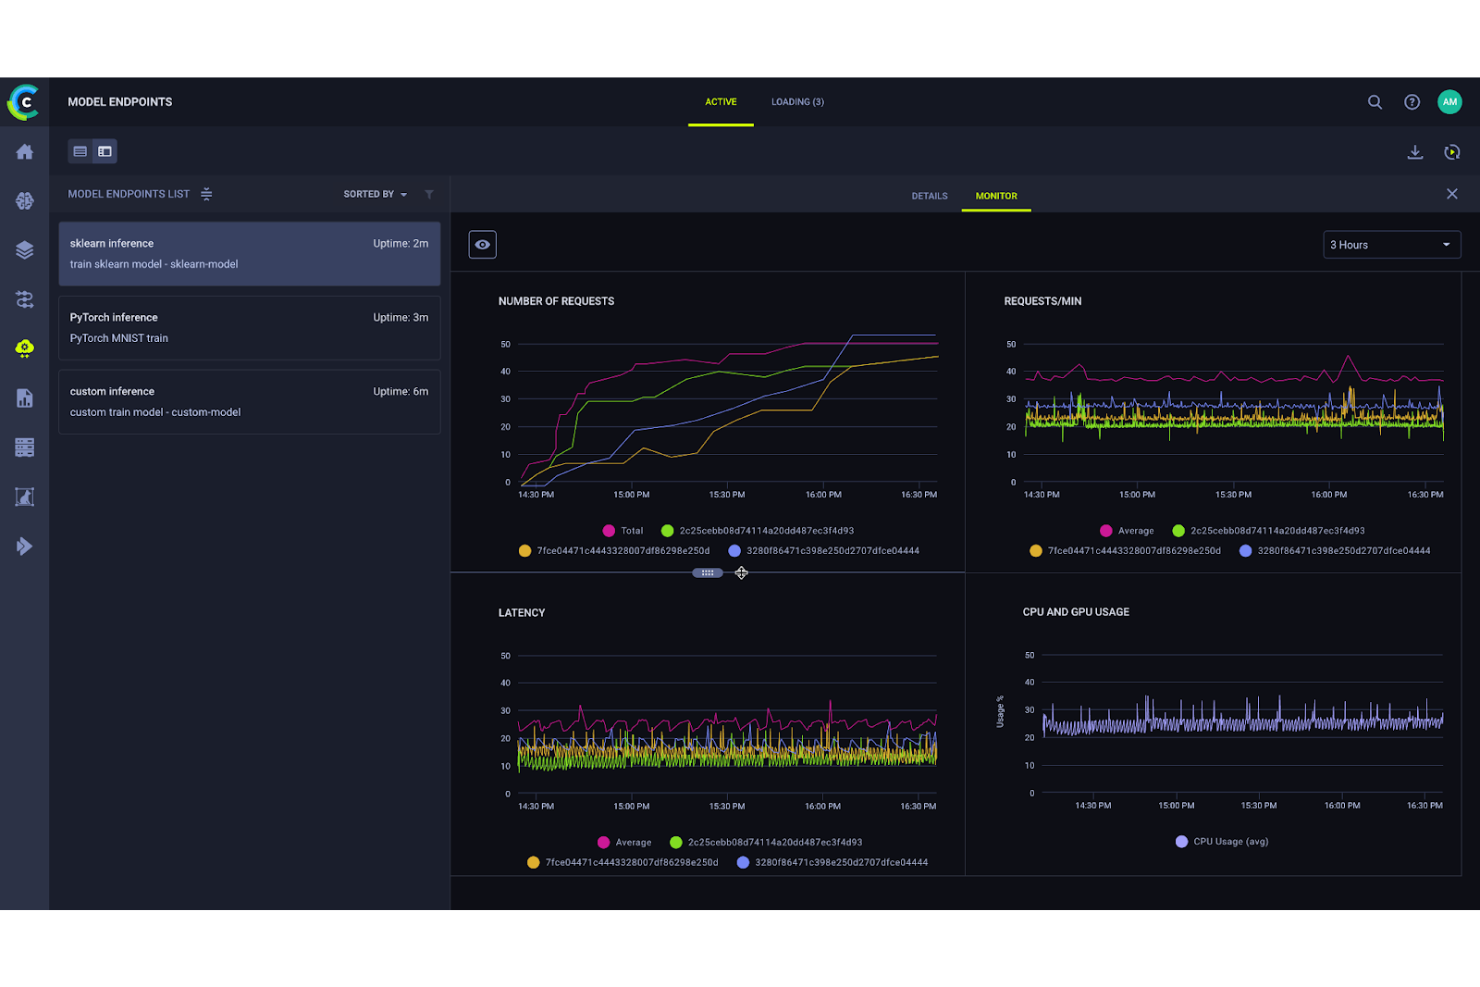
ClearML es una plataforma MLOps de código abierto que cubre el seguimiento de experimentos, versionado de conjuntos de datos, gestión de modelos y orquestación de pipelines a lo largo de todo el ciclo de vida del aprendizaje automático.
¿Para quién es ideal ClearML?
ClearML es una excelente opción para ingenieros de ML y científicos de datos en organizaciones que alojan su propia infraestructura de MLOps y necesitan control total sobre sus flujos de trabajo.
Por qué elegí ClearML
ClearML se ha ganado su lugar en mi lista porque su orquestación automática de pipelines es realmente sin intervención manual. Cuando agrego un trabajo a una cola, ClearML lo contenediza con todo su entorno y gestiona automáticamente la programación y los recursos. No necesito reescribir el código para cambiar entre sistemas locales, la nube o clústeres HPC. También me gusta que los componentes de pipeline en caché me permiten omitir pasos redundantes en las repeticiones, lo que reduce considerablemente el tiempo de ciclo en flujos de trabajo de entrenamiento iterativos.
Características clave de ClearML
- Auto-registro de experimentos: Captura automáticamente métricas, hiperparámetros, salida de consola y código fuente de cada ejecución de entrenamiento sin instrumentación adicional.
- Versionado de datos de ClearML: Versiona y gestiona conjuntos de datos con un completo seguimiento de linaje, vinculando cada versión de dataset directamente a los experimentos que la utilizaron.
- Registro de modelos: Almacena, etiqueta y recupera modelos entrenados con control de versiones y asignación de etapas a través de todo el ciclo de desarrollo.
- Optimización de hiperparámetros: Ejecuta búsquedas automáticas de HPO a través de experimentos utilizando estrategias integradas como optimización bayesiana y búsqueda aleatoria.
Integraciones de ClearML
ClearML ofrece integraciones nativas con PyTorch, TensorFlow, Keras, Scikit-learn, XGBoost, Hugging Face Transformers, FastAI, Optuna y Hydra, además de herramientas de visualización como Matplotlib y TensorBoard. Hay disponible una API y un SDK de Python para integraciones personalizadas.
Pros and Cons
Pros:
- Servidor autoalojado de código abierto elimina costos de suscripción
- Registra automáticamente código, conjuntos de datos e hiperparámetros sin instrumentación
- El diseño modular permite adoptar componentes individuales
Cons:
- Las lagunas en la documentación ralentizan la incorporación de nuevos usuarios
- La navegación entre módulos resulta poco fluida a gran escala
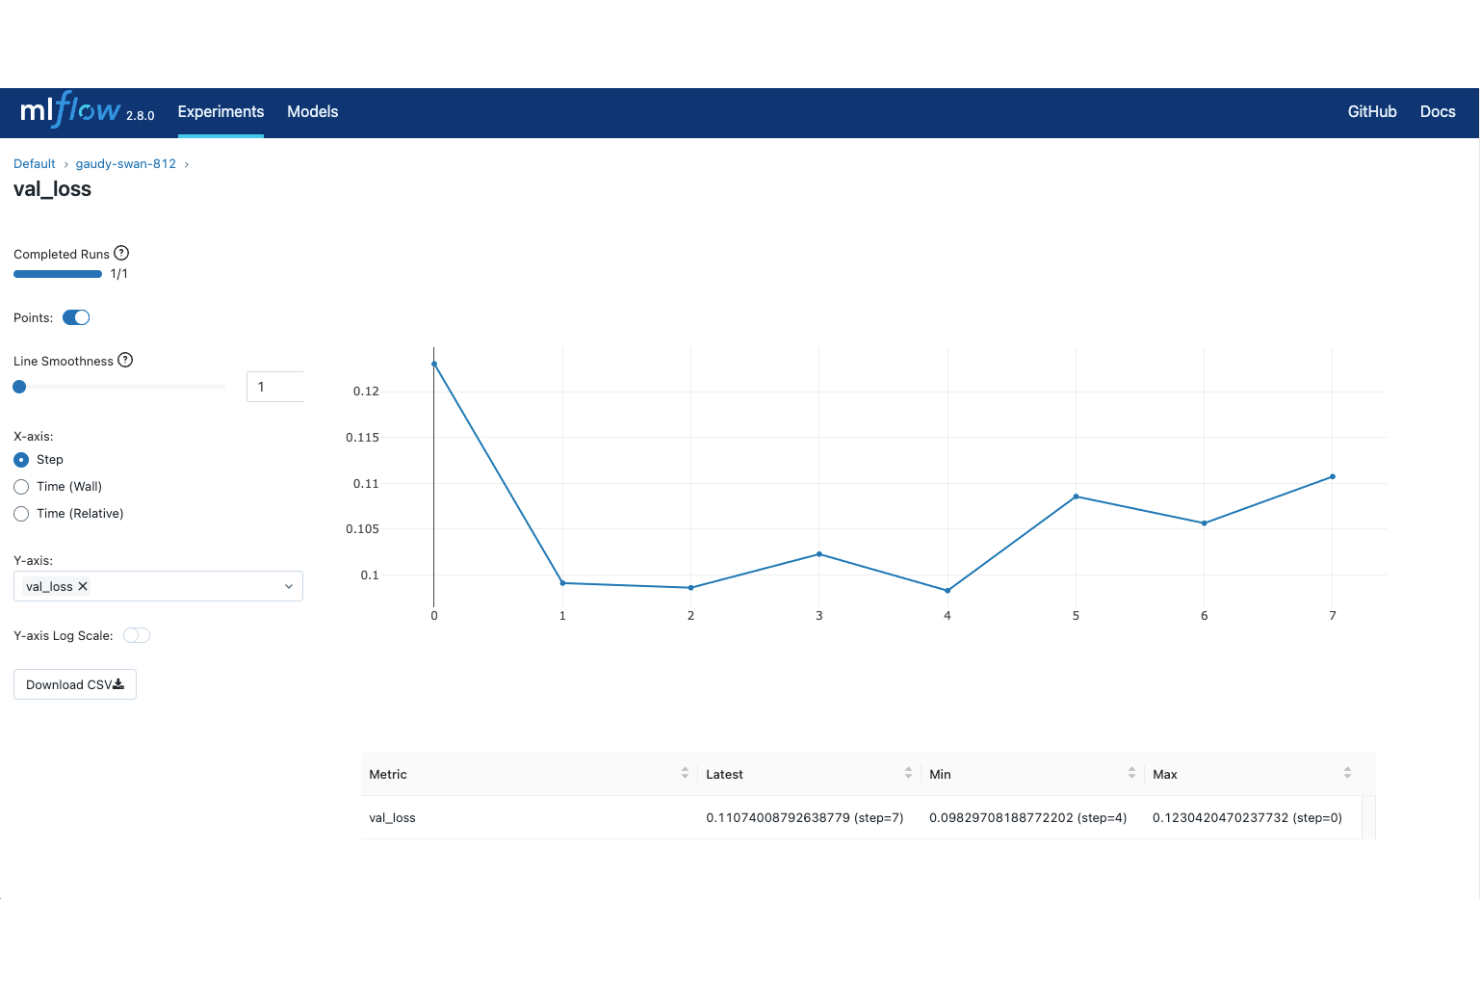
MLflow es una plataforma de seguimiento de experimentos de ML de código abierto que cubre el ciclo de vida completo del modelo, desde el registro de experimentos y la comparación de ejecuciones hasta el empaquetado, versionado y despliegue del modelo.
¿Para quién es mejor MLflow?
MLflow es una opción natural para ingenieros de ML y científicos de datos en organizaciones que alojan sus propias herramientas y desean tener un control total sobre su infraestructura de seguimiento de experimentos sin depender de proveedores.
Por qué elegí MLflow
MLflow se gana su lugar en mi lista porque cubre el ciclo de vida completo del modelo en un solo marco de trabajo de código abierto. Uso la API MLflow Tracking para registrar parámetros, métricas y artefactos de las ejecuciones; luego utilizo el Registro de Modelos para versionar y mover los modelos desde desarrollo a producción. Lo que realmente valoro es que puedo empaquetar modelos usando el formato estándar de MLflow y desplegarlos en cualquier destino sin tener que reescribir el código de servicio.
Funciones clave de MLflow
- Registro automático: Captura automáticamente parámetros, métricas y artefactos de bibliotecas compatibles como Scikit-learn, XGBoost y PyTorch sin llamadas manuales de registro.
- Interfaz de comparación de ejecuciones: Visualiza y compara métricas de múltiples entrenamientos uno al lado del otro en la interfaz web integrada de MLflow.
- MLflow Projects: Empaqueta el código de ML junto con sus dependencias y puntos de entrada para que cualquier ejecución pueda reproducirse exactamente en cualquier máquina.
- Sistema de plugins: Extiende el seguimiento, almacenamiento y despliegue de MLflow a través de plugins creados por la comunidad sin modificar el núcleo del código.
Integraciones de MLflow
MLflow ofrece más de 60 integraciones integradas, incluyendo PyTorch, TensorFlow, Scikit-learn, XGBoost, LightGBM, Hugging Face Transformers, LangChain, LlamaIndex y OpenAI. También es compatible con AWS SageMaker, Azure ML, Databricks y OpenTelemetry. Hay una API REST y un SDK de Python disponibles para integraciones personalizadas.
Pros and Cons
Pros:
- Registro independiente del marco de trabajo en múltiples bibliotecas de ML
- Versionado completo de modelos con transición de estados
- Autoalojable en cualquier infraestructura
Cons:
- Se requiere esfuerzo de DevOps para el despliegue en producción
- Visualización limitada de perfiles de hardware integrada

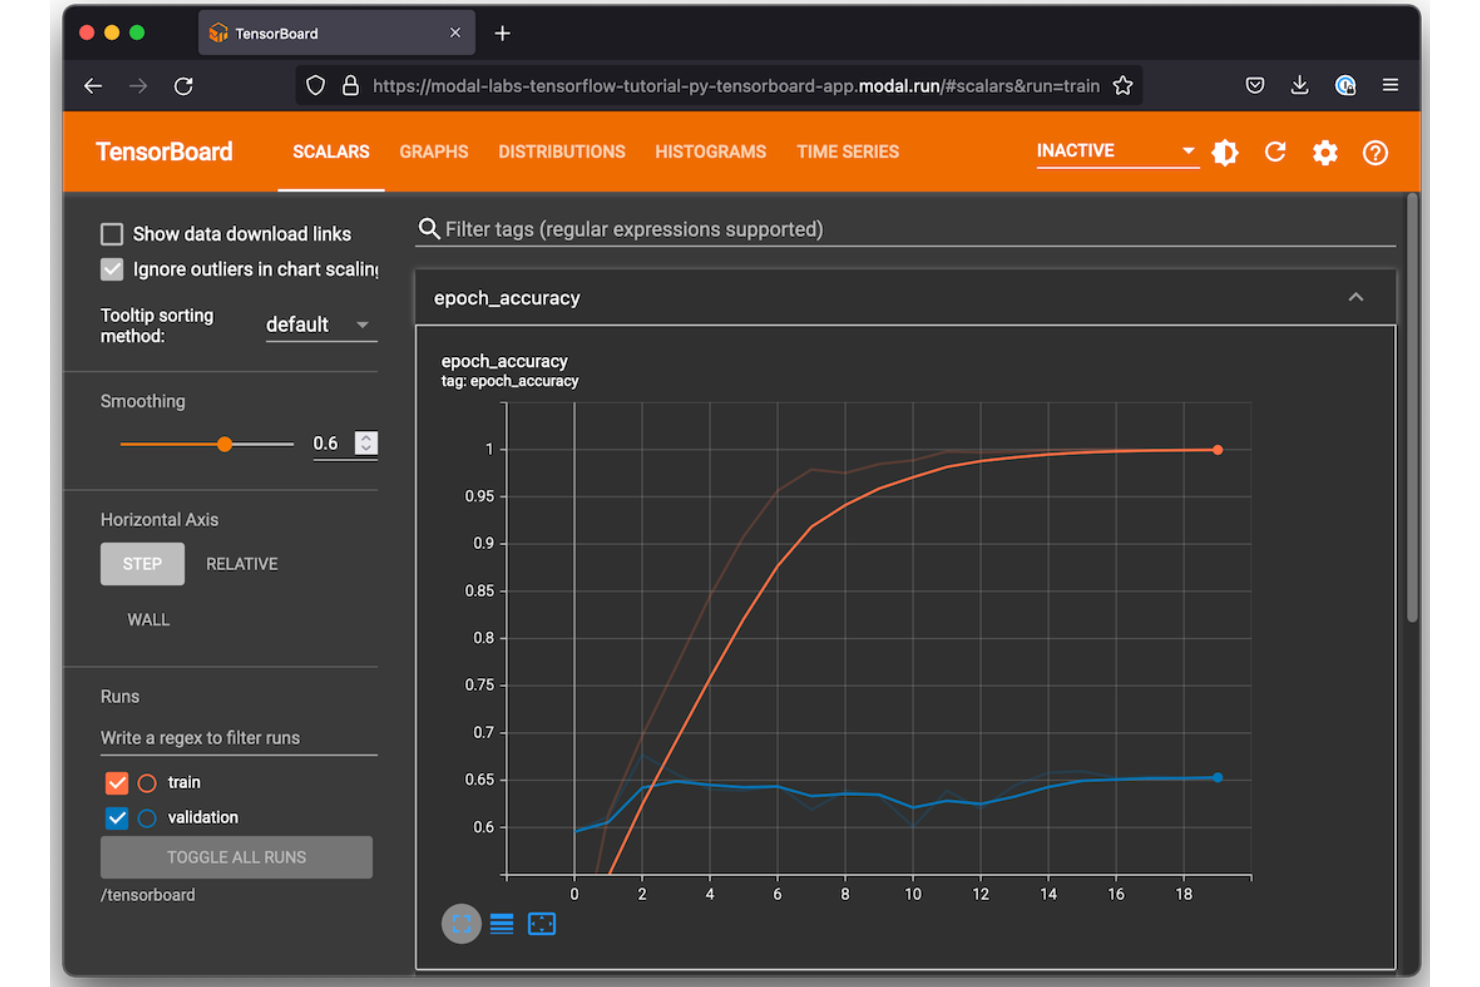
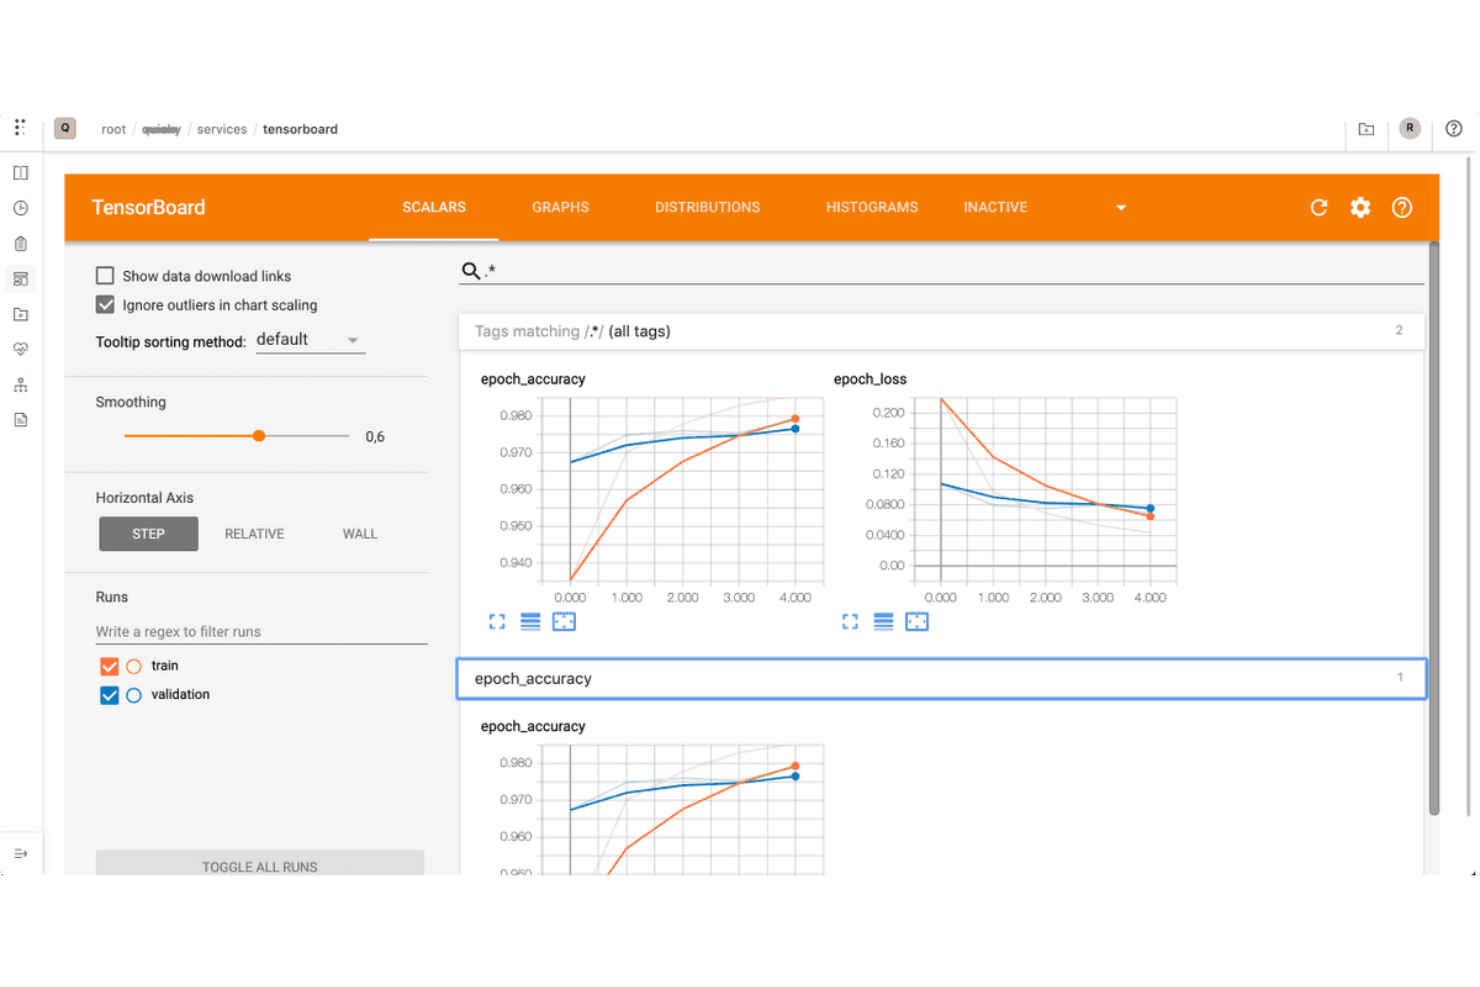
TensorFlow es un marco de aprendizaje automático de código abierto de Google que abarca el diseño, el entrenamiento, la evaluación y la implementación de modelos en flujos de trabajo de aprendizaje profundo y redes neuronales.
¿Para quién es más adecuado TensorFlow?
TensorFlow es una opción natural para equipos de investigación e ingenieros de aprendizaje automático que crean y entrenan modelos de aprendizaje profundo a gran escala, especialmente en entornos de producción.
Por qué elegí TensorFlow
He incluido TensorFlow entre mis principales opciones porque su API nativa de Keras me permite crear e iterar sobre arquitecturas de aprendizaje profundo sin cambiar de contexto ni de marco. También utilizo TensorBoard directamente dentro de TensorFlow para realizar un seguimiento de las métricas de entrenamiento, visualizar gráficos de computación y comparar ejecuciones en paralelo. TensorFlow Hub me da acceso a modelos preentrenados que puedo ajustar, lo que reduce significativamente el tiempo de entrenamiento para los experimentos de aprendizaje por transferencia.
Características principales de TensorFlow
- TensorFlow Extended (TFX): Un marco de canalizaciones de aprendizaje automático para producción que coordina los pasos de validación y transformación de datos, entrenamiento y evaluación de modelos.
- API tf.data: Crea canalizaciones de entrada escalables para cargar, preprocesar y agrupar conjuntos de datos durante las ejecuciones de entrenamiento de modelos.
- TensorFlow Serving: Implementa modelos entrenados en producción mediante puntos de conexión REST o gRPC sin modificar el código del modelo.
- Formato SavedModel: Serializa modelos entrenados con gráficos de computación completos y pesos para volver a cargarlos y compartirlos de forma reproducible.
Integraciones de TensorFlow
TensorFlow es un marco de código abierto en lugar de una plataforma SaaS, por lo que no ofrece integraciones nativas tradicionales con herramientas de terceros. En su lugar, su ecosistema incluye bibliotecas integradas como TensorBoard, TFX, TensorFlow.js, TensorFlow Serving, Keras y ML Metadata, que gestionan el seguimiento de experimentos, la coordinación de canalizaciones y la implementación de modelos dentro del propio marco. Las herramientas de seguimiento de experimentos de terceros, como MLflow y Weights & Biases, ofrecen sus propias integraciones con TensorFlow, y hay una API de Python disponible para extensiones personalizadas.
Pros and Cons
Pros:
- Visualización en tiempo real de métricas y gráficos de entrenamiento
- Herramientas integradas de ajuste y optimización de hiperparámetros
- Implementación en CPU, GPU y TPU
Cons:
- TensorBoard se ralentiza con muchos experimentos
- Almacena los datos localmente sin colaboración integrada
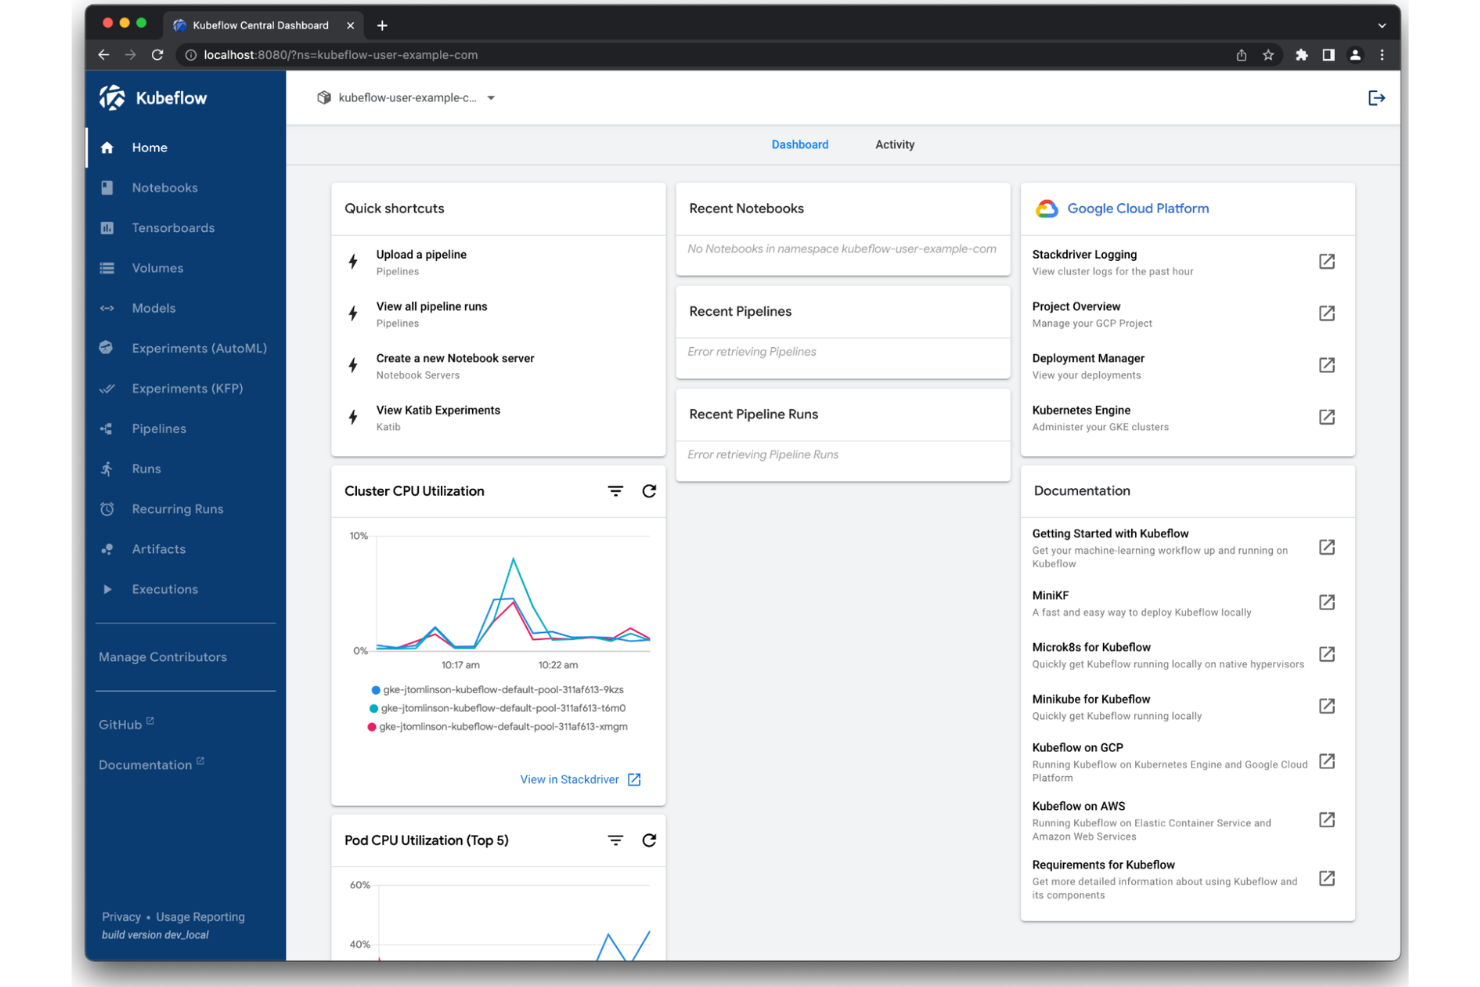
Kubeflow es una plataforma de ML de código abierto basada en Kubernetes que cubre de forma nativa la orquestación de canalizaciones, el seguimiento de experimentos, el entrenamiento de modelos y el ajuste de hiperparámetros dentro de una infraestructura contenerizada.
¿Para quién es más adecuado Kubeflow?
Kubeflow es una opción natural para los equipos de ingeniería de ML que ya ejecutan cargas de trabajo en Kubernetes y quieren mantener su infraestructura de seguimiento de experimentos en la misma plataforma.
Por qué elegí Kubeflow
Kubeflow ocupa un lugar en mi lista de opciones principales porque asigna cada paso de la canalización directamente a un pod de Kubernetes, lo que proporciona a las ejecuciones de experimentos los mismos controles de recursos que cualquier otra carga de trabajo del clúster. Utilizo Kubeflow Pipelines para versionar y reproducir ejecuciones de entrenamiento sin salir del entorno de Kubernetes. Su componente Katib ejecuta en paralelo pruebas de ajuste de hiperparámetros como trabajos nativos de Kubernetes, sin necesidad de infraestructura independiente.
Características principales de Kubeflow
- Aislamiento de espacios de nombres multiusuario: Separa los experimentos y las canalizaciones por equipo o proyecto mediante controles de acceso a nivel de espacio de nombres de Kubernetes.
- Cuadernos de Kubeflow: Inicia servidores de cuadernos de Jupyter directamente en el clúster, manteniendo la exploración de datos en el mismo entorno que las ejecuciones de entrenamiento.
- Seguimiento del linaje de artefactos: Registra las entradas, salidas y metadatos de cada paso de la canalización, vinculando los conjuntos de datos y modelos con ejecuciones específicas.
- Operador de entrenamiento: Gestiona trabajos de entrenamiento distribuido en marcos como PyTorch, TensorFlow y XGBoost como recursos personalizados nativos de Kubernetes.
Integraciones de Kubeflow
Kubeflow no ofrece integraciones nativas tradicionales; en su lugar, funciona dentro del ecosistema de Kubernetes y admite marcos de ML como TensorFlow, PyTorch, JAX, XGBoost, HuggingFace y Apache Spark mediante los operadores de sus subproyectos. También puedes implementarlo en servicios de Kubernetes gestionados de AWS, Google Cloud, Microsoft Azure y Red Hat OpenShift.
Pros and Cons
Pros:
- Ejecuta experimentos directamente en pods de Kubernetes
- El versionado de canalizaciones registra cada ejecución de entrenamiento
- Ajuste paralelo de hiperparámetros mediante el componente Katib
Cons:
- La configuración del clúster exige amplios conocimientos de Kubernetes
- La interfaz de usuario parece anticuada en comparación con las alternativas comerciales

Amazon SageMaker es una plataforma de aprendizaje automático totalmente gestionada en AWS que abarca el seguimiento de experimentos, el entrenamiento de modelos, la optimización de hiperparámetros, el registro de modelos y la implementación a lo largo de todo el ciclo de vida del aprendizaje automático.
¿Para quién es ideal Amazon SageMaker?
Amazon SageMaker es una elección natural para equipos de ciencia de datos e ingeniería de aprendizaje automático que ya ejecutan cargas de trabajo en la infraestructura de AWS.
Por qué elegí Amazon SageMaker
Incluí Amazon SageMaker en mis principales selecciones porque su seguimiento de experimentos está integrado directamente en el ecosistema de AWS de formas que otras herramientas no pueden replicar. SageMaker Experiments registra ejecuciones, parámetros y métricas nativamente junto con el almacenamiento de artefactos en S3 y el acceso controlado por IAM, por lo que no hay infraestructura adicional que gestionar. Mi equipo también utiliza SageMaker Pipelines para encadenar trabajos de entrenamiento, evaluaciones y registro de modelos en un único flujo de trabajo auditable, sin salir de AWS.
Características clave de Amazon SageMaker
- Registro de modelos de SageMaker: Sirve para versionar, aprobar y poner en escena modelos entrenados con seguimiento de metadatos a lo largo de todo el ciclo de vida del modelo.
- Optimización automática de modelos: Ejecuta trabajos de optimización de hiperparámetros mediante estrategias de búsqueda bayesiana, aleatoria o por cuadrícula a gran escala.
- SageMaker Debugger: Monitoriza en tiempo real los trabajos de entrenamiento para detectar problemas como el desvanecimiento de gradientes o el sobreajuste en el momento en que ocurren.
- SageMaker Feature Store: Almacena, comparte y recupera características de ML en cargas de trabajo de entrenamiento e inferencia desde un repositorio centralizado.
Integraciones de Amazon SageMaker
Amazon SageMaker se integra de forma nativa en todo el ecosistema de AWS, incluidos Amazon S3, Amazon Redshift, AWS Glue, Amazon EMR, Amazon Athena, Amazon ECR, AWS Lambda, Amazon CloudWatch y MLflow. Hay una API disponible para integraciones personalizadas.
Pros and Cons
Pros:
- Hace seguimiento de parámetros, datos y versiones de código en cada ejecución
- Puntos de control automáticos durante trabajos largos de entrenamiento
- Monitorización integrada del modelo junto con los registros de experimentos
Cons:
- Los recursos no utilizados pueden acumular cargos silenciosamente
- Los artefactos de los modelos usan formatos específicos de AWS, lo que limita la portabilidad

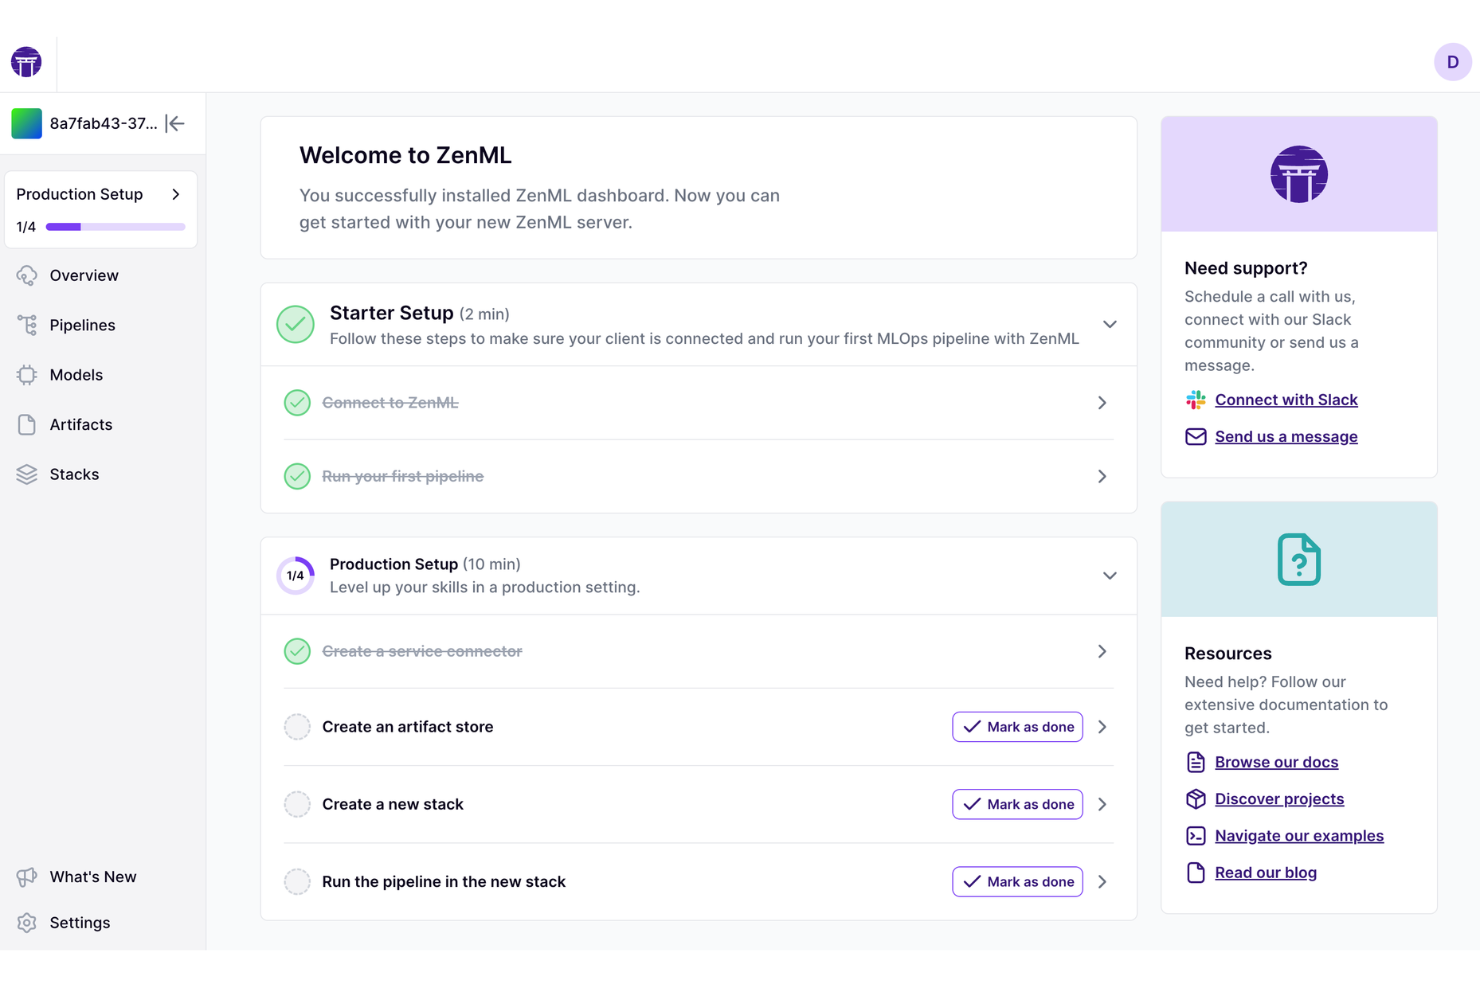
ZenML es una plataforma de orquestación de flujos de trabajo de ML de código abierto que gestiona la orquestación de flujos de trabajo, el versionado de artefactos, el linaje de modelos y el seguimiento de experimentos en cualquier infraestructura en la nube o conjunto de herramientas de ML.
¿Para quién es ideal ZenML?
ZenML es especialmente adecuado para ingenieros de ML y equipos de ciencia de datos que necesitan estandarizar y escalar pipelines de ML en múltiples entornos en la nube o infraestructuras.
Por qué elegí ZenML
ZenML se gana su lugar en mi lista porque su arquitectura basada en componentes me permite cambiar cualquier parte de mi infraestructura de ML sin reescribir el código del pipeline. Puedo conectar MLflow o Weights & Biases como el sistema de seguimiento de experimentos, intercambiar el almacén de artefactos de local a S3 y cambiar el orquestador a Kubeflow, simplemente cambiando el stack activo. Además, utilizo los sabores personalizados de componentes de ZenML para crear integraciones propias de seguimiento que encajan directamente en la misma abstracción de pipelines.
Funciones clave de ZenML
- Cacheo de pasos en pipelines: Almacena automáticamente los resultados de pasos ejecutados previamente, evitando la reejecución de pasos sin cambios durante experimentos iterativos.
- Versionado de artefactos: Realiza el seguimiento de cada artefacto producido por una ejecución del pipeline, incluidos conjuntos de datos, modelos y métricas, con linaje completo al paso de origen.
- Registro de modelos: Almacena y versiona modelos entrenados junto con sus metadatos asociados, ejecuciones de pipelines e historial de despliegue en un registro centralizado.
- Panel de ZenML: Proporciona una interfaz web para explorar ejecuciones de pipelines, comparar resultados de experimentos e inspeccionar los metadatos de artefactos a través de los stacks.
Integraciones de ZenML
ZenML ofrece 66 integraciones nativas en el ecosistema de ML, incluyendo MLflow, Weights & Biases, Neptune, Comet y TensorBoard, junto a orquestadores como Kubeflow, Apache Airflow, Kubernetes y Databricks, y soporte para la infraestructura en la nube de AWS, Google Cloud y Microsoft Azure. Hay una API disponible para integraciones personalizadas.
Pros and Cons
Pros:
- Permite cambiar infraestructura sin reescribir el código del pipeline
- Stack agnóstico en la nube que evita el bloqueo de proveedor
- Versionado automático de artefactos a lo largo de las ejecuciones del pipeline
Cons:
- Depende de herramientas de terceros para la visualización de experimentos
- La configuración inicial del stack requiere un esfuerzo considerable

Polyaxon es una plataforma de seguimiento de experimentos de ML y orquestación de flujos de trabajo que abarca el seguimiento de experimentos, la optimización de hiperparámetros, el versionado de artefactos, el registro de modelos y la programación distribuida de tareas en infraestructuras en la nube y locales.
¿Para quién es mejor Polyaxon?
Polyaxon es ideal para ingenieros de ML en empresas que operan bajo estrictos requisitos de gobernanza de datos o necesitan ejecutar cargas de trabajo en infraestructuras privadas.
Por qué elegí Polyaxon
Incluí Polyaxon en mis selecciones principales porque es una de las pocas plataformas de seguimiento de experimentos de ML diseñadas desde cero para ejecutarse completamente en tu propia infraestructura. Lo ejecuto en un clúster privado de Kubernetes, y cada registro de experimento, artefacto y modelo permanece dentro de nuestra red. Su arquitectura basada en agentes me permite conectar entornos aislados en local a un plano de control central sin exponer datos sin procesar externamente, lo cual es un requisito real en industrias reguladas.
Funciones clave de Polyaxon
- Búsqueda y optimización de hiperparámetros: Ejecuta grupos de experimentos en paralelo usando estrategias de búsqueda distribuidas para encontrar configuraciones óptimas de modelos.
- Centro de componentes: Define módulos reutilizables con entradas y salidas tipadas que se pueden compartir y versionar en los flujos de trabajo de tu equipo.
- Búsqueda potente: Filtra ejecuciones por nombre, descripción, expresiones regulares, campos específicos, métricas o configuraciones para localizar experimentos rápidamente.
- Cumplimiento de SLA: Aplica políticas de vida útil, tiempo de espera y reintentos a operaciones individuales para mantener los flujos de trabajo dentro de los límites definidos.
Integraciones de Polyaxon
Polyaxon ofrece un amplio conjunto de integraciones nativas en seguimiento de ML, orquestación e infraestructura, incluyendo TensorBoard, PyTorch, TensorFlow, Keras, XGBoost, Hugging Face, Kubeflow, Slack, GitHub y Jenkins. También se conecta con Zapier y proporciona una API para integraciones personalizadas y automatización CI/CD.
Pros and Cons
Pros:
- Programación nativa en Kubernetes para tareas de entrenamiento distribuidas
- Multiusuario incorporado con controles de acceso granulares
- Soporta implementaciones en local, en la nube y entornos híbridos
Cons:
- Requiere conocimientos avanzados de Kubernetes para operar
- Comunidad más pequeña que MLflow o W&B
Otras herramientas de seguimiento de experimentos de ML
Estas son algunas herramientas adicionales de seguimiento de experimentos de ML que no llegaron a mi lista de selección, pero que aun así merece la pena conocer:
- Databricks
Mejor para un espacio de trabajo de análisis unificado para equipos
- Domino Data Lab
Mejor para control centralizado en investigación colaborativa
- iguazio
Ideal para el monitoreo de modelos en tiempo real y a gran escala
- Dagster
Ideal para la creación programática de flujos de datos


Cómo evalúo las herramientas de seguimiento de experimentos de ML
Divido mi evaluación en dos capas: lo que toda herramienta debe hacer (como registrar automáticamente ejecuciones de PyTorch) y lo que distingue a las mejores herramientas.
Funcionalidad principal (Requisitos básicos para esta lista)
Al seleccionar herramientas para mi lista, califico cada una en una escala de 0 (no ofrece la funcionalidad) a 5 (destaca en esta área) para cada funcionalidad principal listada a continuación. Luego, calculo la puntuación total de la herramienta como porcentaje. Cada herramienta debe alcanzar una puntuación total mínima del 65% para ser considerada para su inclusión.
- Registro de experimentos: Compruebo si la herramienta captura automáticamente métricas, hiperparámetros y telemetría del sistema de las ejecuciones de entrenamiento o si requiere la instrumentación manual del SDK para cada dato.
- Comparación y visualización de ejecuciones: Las tablas comparativas lado a lado son un punto de partida, pero busco gráficos interactivos como los de coordenadas paralelas que ayudan a identificar patrones entre decenas de ejecuciones en tus proyectos de ML.
- Versionado de artefactos y modelos: Evalúo cómo cada herramienta versiona conjuntos de datos, puntos de control de modelos y salidas, incluyendo si vincula los artefactos con la ejecución exacta que los generó.
- Compatibilidad con frameworks de ML: La herramienta debe cubrir frameworks que realmente utilice tu equipo, desde PyTorch y TensorFlow hasta Hugging Face Transformers y XGBoost, con un código envoltorio mínimo.
- Reproducibilidad y linaje: Busco herramientas que capturen commits de código, snapshots de dependencias y el estado del conjunto de datos para que puedas volver a ejecutar un experimento de hace seis meses y obtener el mismo resultado.
- Colaboración y compartición: Los equipos que trabajan en diferentes husos horarios necesitan espacios de trabajo compartidos, acceso basado en roles y la posibilidad de comentar o compartir ejecuciones específicas sin exportar CSVs de un lado a otro.
Una vez que tengo una lista de herramientas que cumplen estos criterios, considero qué distingue a cada plataforma.
Factores diferenciadores (Lo que distingue a los proveedores)
Así es como comparo y contrasto diferentes proveedores:
Características destacadas
La optimización de hiperparámetros es un factor diferenciador clave. Busco funcionalidad de barrido integrada que automatice la búsqueda en ejecuciones distribuidas y visualice el rendimiento entre configuraciones en una sola vista. El monitoreo de recursos en tiempo real también aporta valor—cuando puedes seguir el uso de GPU y memoria durante el entrenamiento, detectas cuellos de botella antes de que una ejecución desperdicie horas de cómputo. Los reportes colaborativos cierran el ciclo para equipos grandes, donde tableros compartibles reemplazan hojas de cálculo manuales y permiten a los científicos de datos discutir los resultados con los interesados sin cambiar de herramienta.
Más allá de las características
La flexibilidad de despliegue importa más de lo que muchos equipos esperan. Evalúo si una herramienta permite instalaciones autogestionadas o entornos aislados para equipos que trabajan con propiedad intelectual o datos regulados. La escalabilidad es otro factor que reviso: registrar miles de ejecuciones concurrentes no debe degradar el rendimiento de consultas ni generar picos de costos imprevisibles. También destaca la experiencia de incorporación, donde una buena documentación de inicio rápido y foros comunitarios activos permiten a tu equipo instrumentar scripts de entrenamiento en horas, no semanas.
Cómo elegir herramientas de seguimiento de experimentos de ML
Es fácil perderse entre largas listas de funciones y estructuras de precios complejas. Para ayudarte a mantener la atención mientras avanzas en tu proceso único de selección de software, aquí tienes una lista de factores que debes tener en cuenta:
| Factor | Qué debes considerar |
|---|---|
| Escalabilidad | ¿Puede la herramienta gestionar el volumen y la frecuencia de experimentos que esperas a medida que crecen tu equipo y tus datos? |
| Integraciones | ¿Se conectará directamente con tus marcos de ML, herramientas de orquestación y sistemas de implementación preferidos? |
| Personalización | ¿Puedes adaptar los campos de metadatos, los pasos del flujo de trabajo y los informes para que se ajusten a los requisitos específicos de tu equipo? |
| Facilidad de uso | ¿A tus investigadores e ingenieros les resultará intuitiva la interfaz o la curva de aprendizaje es pronunciada? |
| Implementación e incorporación | ¿Con qué rapidez puedes pasar de la compra al seguimiento de tu primer experimento? ¿Qué recursos se necesitan para configurarla? |
| Coste | ¿Los precios basados en el uso, las tarifas de almacenamiento y los complementos necesarios son claros y previsibles para tus necesidades previstas? |
| Medidas de seguridad | ¿La herramienta admite cifrado, permisos detallados y autenticación para proteger los datos confidenciales? |
| Requisitos de cumplimiento | ¿La herramienta te ayudará a cumplir las normativas del sector, de los clientes o geográficas (SOC 2, ISO 27001, GDPR)? |
¿Qué son las herramientas de seguimiento de experimentos de ML?
Las herramientas de seguimiento de experimentos de ML son plataformas de software que registran, organizan y versionan experimentos de modelos de aprendizaje automático, incluidos sus parámetros, código, conjuntos de datos y métricas. Estas herramientas ayudan a tu equipo a almacenar el historial de experimentos, comparar resultados y reproducir por completo ejecuciones anteriores, lo que facilita la colaboración y las auditorías a medida que los flujos de trabajo de los proyectos se vuelven más complejos.
Funciones
Al seleccionar herramientas de seguimiento de experimentos de ML, presta atención a las siguientes características clave:
- Registro de experimentos: Registra los parámetros, las configuraciones, las referencias al código fuente y las métricas de cada ejecución de entrenamiento para conservar un registro de auditoría claro.
- Comparación de ejecuciones: Permite visualizar y analizar varios experimentos en paralelo para comprender cómo los diferentes ajustes o cambios afectan a tus resultados.
- Versionado de artefactos: Crea automáticamente versiones de los conjuntos de datos, los modelos de ML versionados y otros resultados, para que siempre puedas reproducir o ampliar trabajos anteriores.
- Integraciones con frameworks: Se conecta directamente con frameworks de ML populares, lo que facilita comenzar el seguimiento con cambios mínimos en tu flujo de trabajo.
- Seguimiento del linaje: Traza la cadena completa desde los datos sin procesar hasta el modelo final, y respalda los requisitos de reproducibilidad y cumplimiento normativo.
- Herramientas de colaboración: Permite que varios usuarios comenten, documenten información relevante y compartan resultados con todo el equipo.
- Metadatos personalizados: Permite añadir campos o etiquetas específicos del proyecto para categorizar los experimentos según las necesidades de tu flujo de trabajo.
- Control de acceso basado en roles: Restringe el acceso a datos y acciones sensibles, y respalda la gobernanza a nivel organizativo y los estándares de seguridad.
- Paneles y visualizaciones: Genera informes personalizables y visualizaciones de datos para destacar rápidamente tendencias y anomalías en los datos de tus experimentos.
- Búsqueda y filtrado: Permite que tu equipo encuentre fácilmente experimentos, ejecuciones y artefactos relevantes por parámetro, fecha u otros criterios, ahorrando tiempo a medida que crece el proyecto.
Características de IA de las herramientas habituales de seguimiento de experimentos de ML
Además de las características estándar de las herramientas de seguimiento de experimentos de ML mencionadas anteriormente, muchas de estas soluciones están incorporando IA con funciones como:
- Detección automatizada de anomalías: Utiliza IA para supervisar las métricas de los experimentos y señalar patrones inusuales o valores atípicos, ayudando a los equipos a detectar pronto la deriva de datos o comportamientos inesperados del modelo.
- Sugerencias inteligentes de hiperparámetros: Aplica aprendizaje automático para recomendar valores óptimos de hiperparámetros basándose en datos históricos de experimentos, reduciendo las conjeturas manuales y acelerando el ajuste del modelo.
- Consultas de experimentos en lenguaje natural: Permite a los usuarios buscar y filtrar experimentos mediante lenguaje conversacional, facilitando que las partes interesadas no técnicas accedan a los resultados de los experimentos y los comprendan.
- Asignación predictiva de recursos: Utiliza IA para prever las necesidades de capacidad de cómputo y memoria de las próximas ejecuciones, ayudando a los equipos a planificar los recursos y evitar cuellos de botella.
- Resumen automatizado de experimentos: Aprovecha la IA para generar resúmenes concisos de los resultados de los experimentos, destacando hallazgos y tendencias clave para agilizar la elaboración de informes y la toma de decisiones.
Beneficios
Implementar herramientas de seguimiento de experimentos de ML ofrece varios beneficios para tu equipo y tu empresa. Estos son algunos de los que puedes esperar:
- Reproducibilidad de los experimentos: Realiza un seguimiento de los parámetros, los conjuntos de datos y los detalles del entorno para recrear y validar fácilmente experimentos anteriores.
- Colaboración optimizada: Los paneles compartidos, los comentarios y la documentación del proyecto ayudan a los equipos a trabajar juntos y comunicar los resultados de forma eficaz.
- Desarrollo más rápido de modelos: Las comparaciones de ejecuciones en paralelo y el versionado automatizado de artefactos aceleran los ciclos de experimentación y la toma de decisiones.
- Gestión centralizada del conocimiento: Todo el historial del proyecto y los metadatos de los experimentos se almacenan en un solo lugar, preservando el conocimiento institucional a medida que crecen los equipos.
- Mejora del cumplimiento y la auditabilidad: El seguimiento integrado del linaje y los registros de auditoría respaldan las necesidades normativas y los estándares de gobernanza empresarial.
- Control de los costes de recursos: Las funciones de supervisión de recursos en tiempo real y asignación predictiva permiten a los equipos optimizar el uso del hardware y evitar gastos innecesarios.
- Compatibilidad con flujos de trabajo personalizables: Los campos de metadatos y las opciones de flujo de trabajo flexibles se adaptan a los procesos y preferencias existentes de tu equipo.
Costes y precios
Seleccionar herramientas de seguimiento de experimentos de ML requiere comprender los diversos modelos de precios y planes disponibles. Los costes varían según las características, el tamaño del equipo, los complementos y otros factores. La tabla siguiente resume los planes habituales, sus precios medios y las características que suelen incluir las soluciones de herramientas de seguimiento de experimentos de ML:
Tabla comparativa de planes para herramientas de seguimiento de experimentos de ML
| Tipo de plan | Precio promedio | Características comunes |
|---|---|---|
| Plan gratuito | $0 | Seguimiento básico de experimentos, usuarios limitados, soporte de la comunidad y proyectos públicos. |
| Plan personal | $5-$25/usuario/mes | Experimentos ilimitados, mayor almacenamiento, proyectos privados e integraciones básicas. |
| Plan empresarial | $30-$70/usuario/mes | Herramientas de colaboración en equipo, acceso basado en roles, integraciones avanzadas, seguridad mejorada y registros de auditoría. |
| Plan para empresas | $80-$150/usuario/mes | Opciones de implementación personalizadas, SSO/SAML, herramientas de cumplimiento, soporte premium y personalización avanzada. |
Preguntas frecuentes sobre herramientas de seguimiento de experimentos de ML
Estas son algunas respuestas a preguntas comunes sobre las herramientas de seguimiento de experimentos de ML:
¿Estas herramientas requieren mucha configuración o cambios en el código?
No, la mayoría de las herramientas ofrecen SDK ligeros o complementos que permiten empezar a registrar experimentos con cambios mínimos en el código. A menudo puedes integrar el seguimiento en tus scripts con solo unas pocas líneas.
¿Cómo ayudan estas herramientas con el cumplimiento y las auditorías del equipo?
Registran los parámetros, el código y los resultados de cada ejecución, crean historiales de experimentos rastreables y mantienen registros de auditoría, lo que facilita documentar el cumplimiento y compartir pruebas durante las revisiones o auditorías.
¿Funcionarán estas soluciones con los notebooks de Jupyter?
Sí, la mayoría de las herramientas de seguimiento de experimentos de ML están diseñadas para funcionar directamente en notebooks de Jupyter, así como con scripts y canalizaciones, por lo que no tienes que cambiar tu flujo de trabajo.
¿Qué ocurre si mi equipo supera el plan gratuito?
Puedes cambiar a un nivel de pago para obtener más usuarios, límites de almacenamiento superiores, integraciones avanzadas y funciones empresariales. Revisa detenidamente los precios para que la transición no te sorprenda.
¿Puedo almacenar datos sensibles o confidenciales con estas herramientas?
Sí, pero debes revisar las medidas de seguridad del proveedor, como el cifrado, los controles de acceso y las certificaciones de cumplimiento, para garantizar que tus datos permanezcan protegidos. Las opciones locales o de nube privada pueden ofrecer aún más control.