

Databricks es una plataforma potente, pero no siempre es la opción adecuada. Puede que tu equipo se haya encontrado con problemas de precios, haya tenido dificultades con la curva de aprendizaje de la plataforma o necesite algo más flexible para configuraciones multinube o locales. Sea cual sea el caso, si estás aquí, probablemente buscas una alternativa que ofrezca una funcionalidad de lago de datos y almacén de datos similar, sin las desventajas.
He trabajado con equipos de datos de empresas emergentes y grandes compañías para evaluar e implementar plataformas como Databricks, Snowflake y otras. He visto de primera mano lo que se necesita para respaldar análisis a gran escala, unificar fuentes de datos desordenadas y crear canalizaciones fiables que realmente se utilicen.
En esta guía, te presentaré las alternativas a Databricks que merece la pena considerar: herramientas que te ayudan a almacenar, transformar y explorar datos de forma más intuitiva, al tiempo que te ofrecen margen para escalar y adaptarte a medida que crece tu equipo.
Por qué confiar en nuestras recomendaciones de software
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Nuestro equipo lleva probando y evaluando software desde 2012. Como líderes tecnológicos, sabemos lo difícil —y lo importante— que es elegir el software adecuado.
Para esta guía, evaluamos las herramientas mediante pruebas prácticas e investigación independiente, puntuando las herramientas según nuestros criterios de selección.
Nuestras reseñas reflejan nuestro criterio editorial humano, no un discurso de ventas.
Revisores expertos:
- Paulo Gardini MiguelDirector técnico
 Tim FisherVP de IA
 Gabriel RosasTech Lead y arquitecto de software
 Christhian GruhnTech Lead y arquitecto de plataforma

Tabla comparativa: competidores de Databricks
Esta tabla comparativa resume los detalles de precios de mis principales selecciones de competidores de Databricks.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | La mejor opción para el almacenamiento de datos en la nube | No | Precios bajo solicitud | Website | |
| 2 | Mejor opción para la implementación de datos multinube | Plan gratuito disponible | Precios disponibles previa solicitud | Website | |
| 3 | Ideal para tareas de integración de datos | Prueba gratuita disponible | $1,170/usuario/año (facturado anualmente) | Website | |
| 4 | La mejor opción para el procesamiento en memoria | Plan gratuito disponible | Precios bajo petición | Website | |
| 5 | Mejor para consultas SQL rápidas | Sí | Desde $6.25/TiB procesado | Website | |
| 6 | La mejor opción para las necesidades de bases de datos empresariales | Prueba gratuita disponible | $68/usuario/mes (facturado anualmente) | Website | |
| 7 | Mejor para análisis de SQL | Prueba gratuita de 30 días | $30/usuario/mes (facturado anualmente) | Website | |
| 8 | Ideal para el procesamiento de Hadoop | No disponible | Desde $0.007084/vCPU-hour | Website | |
| 9 | La mejor opción para Spark y Hadoop administrados | No disponible | Desde $0.06/DCU-hora | Website | |
| 10 | La mejor opción para soluciones de IA y aprendizaje automático | Demostración gratuita disponible | Precios bajo solicitud | Website |


Análisis de los mejores competidores de Databricks
A continuación encontrarás mis resúmenes detallados de los mejores competidores de Databricks que entraron en mi lista. Mis análisis ofrecen una visión detallada de las funciones principales, las ventajas & desventajas, las integraciones y los casos de uso ideales de cada herramienta para ayudarte a encontrar la mejor opción para ti.
 La mejor opción para el almacenamiento de datos en la nube
- No
- Precios bajo solicitud
Visit WebsiteCustomer Rating:4.6/5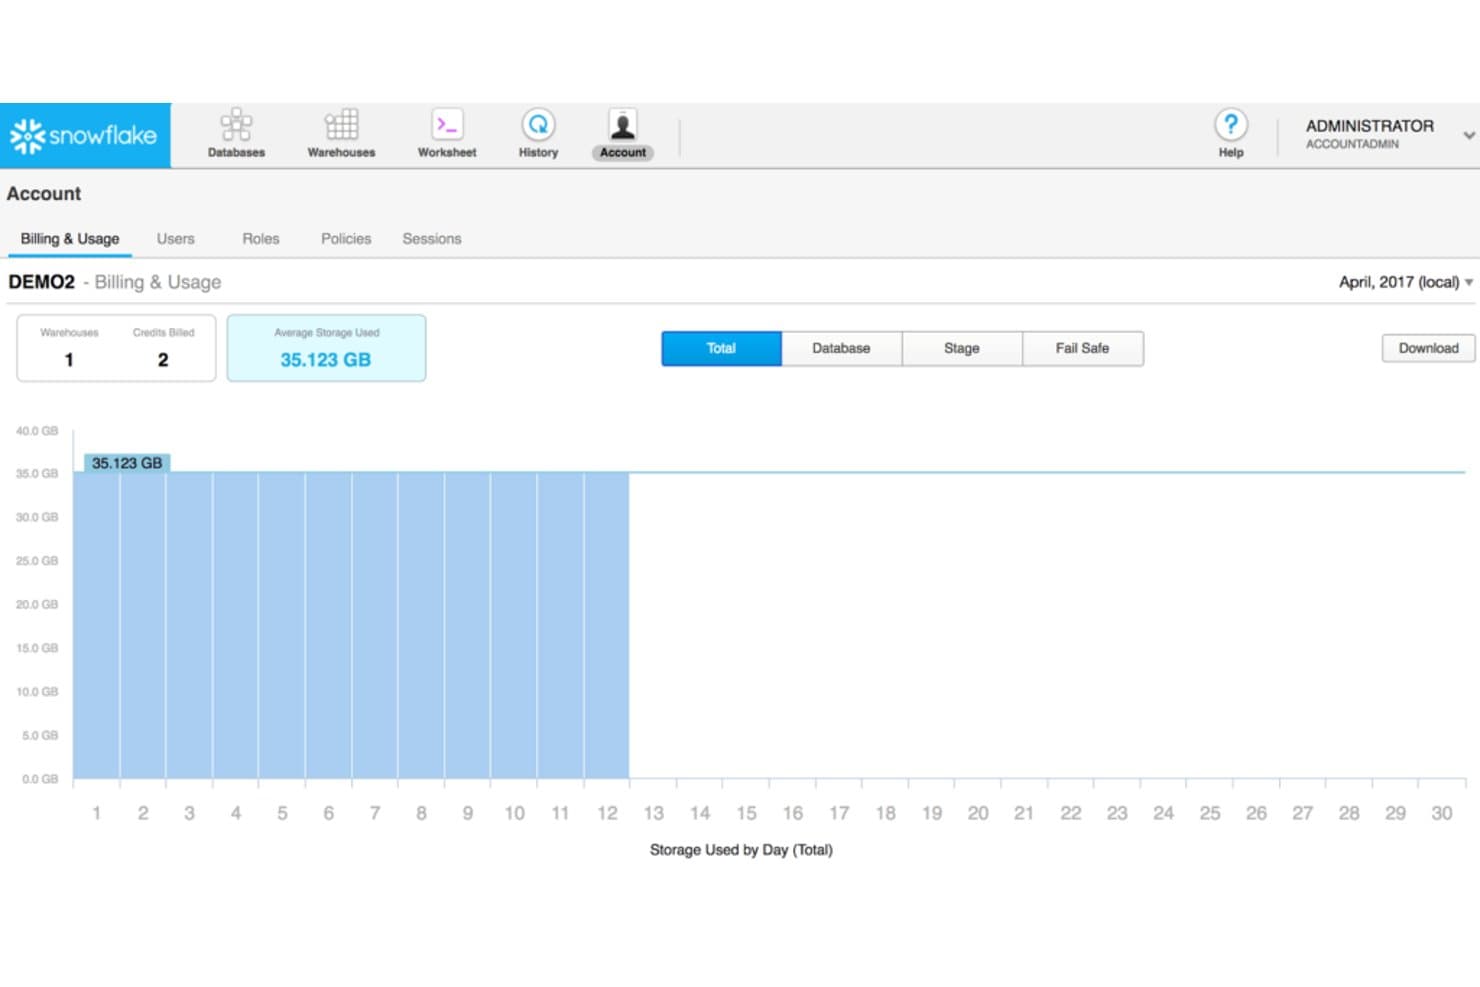
Snowflake registra el uso del almacenamiento y de los créditos por día en un único panel. Snowflake proporciona a los equipos de TI y análisis una plataforma de datos en la nube para combinar conjuntos de datos dispares, ejecutar consultas SQL a gran escala y ofrecer acceso gobernado sin administrar la infraestructura del almacén de datos.
¿Para quién es más adecuado Snowflake?
Equipos de ingeniería de datos y análisis que necesitan un almacén de datos en la nube para consultar y compartir datos entre sistemas empresariales.
Por qué elegí Snowflake
Elegí Snowflake como «la mejor opción para el almacenamiento de datos en la nube» porque la separación entre el almacenamiento y la capacidad de cómputo me permite escalar los análisis SQL sin cambiar el tamaño de la capa de datos. También valoro su uso compartido gobernado de datos cuando los equipos necesitan consultar conjuntos de datos entre sistemas empresariales sin copiarlos en almacenes de datos independientes.
Características principales de Snowflake
- Tablas dinámicas: Define canalizaciones de datos con SQL y establece el retraso de actualización objetivo.
- Snowpipe: Carga datos desde archivos preparados a medida que llegan.
- Viaje en el tiempo: Consulta, clona o restaura datos históricos dentro del periodo de retención.
- Mercado de Snowflake: Descubre y accede a conjuntos de datos y aplicaciones de terceros.
Integraciones de Snowflake
Snowflake ofrece conectores de Openflow para Salesforce, HubSpot, Google Sheets, Jira Cloud, Slack, Shopify, Google BigQuery, MongoDB, PostgreSQL y Microsoft SQL Server. También proporciona conectores nativos para ServiceNow, MySQL y Kafka, además de API REST para integraciones personalizadas.
Pros and Cons
Pros:
- El escalado independiente de la capacidad de cómputo gestiona las variaciones de carga de trabajo
- Los almacenes SQL administrados reducen el mantenimiento de la infraestructura
- El uso compartido seguro evita copiar conjuntos de datos entre equipos
Cons:
- Los picos de uso pueden hacer que el gasto sea impredecible
- Las características propietarias pueden complicar la migración de la plataforma
Learn more about Snowflake: Mejor opción para la implementación de datos multinube
- Plan gratuito disponible
- Precios disponibles previa solicitud
Visit WebsiteCustomer Rating:4.5/5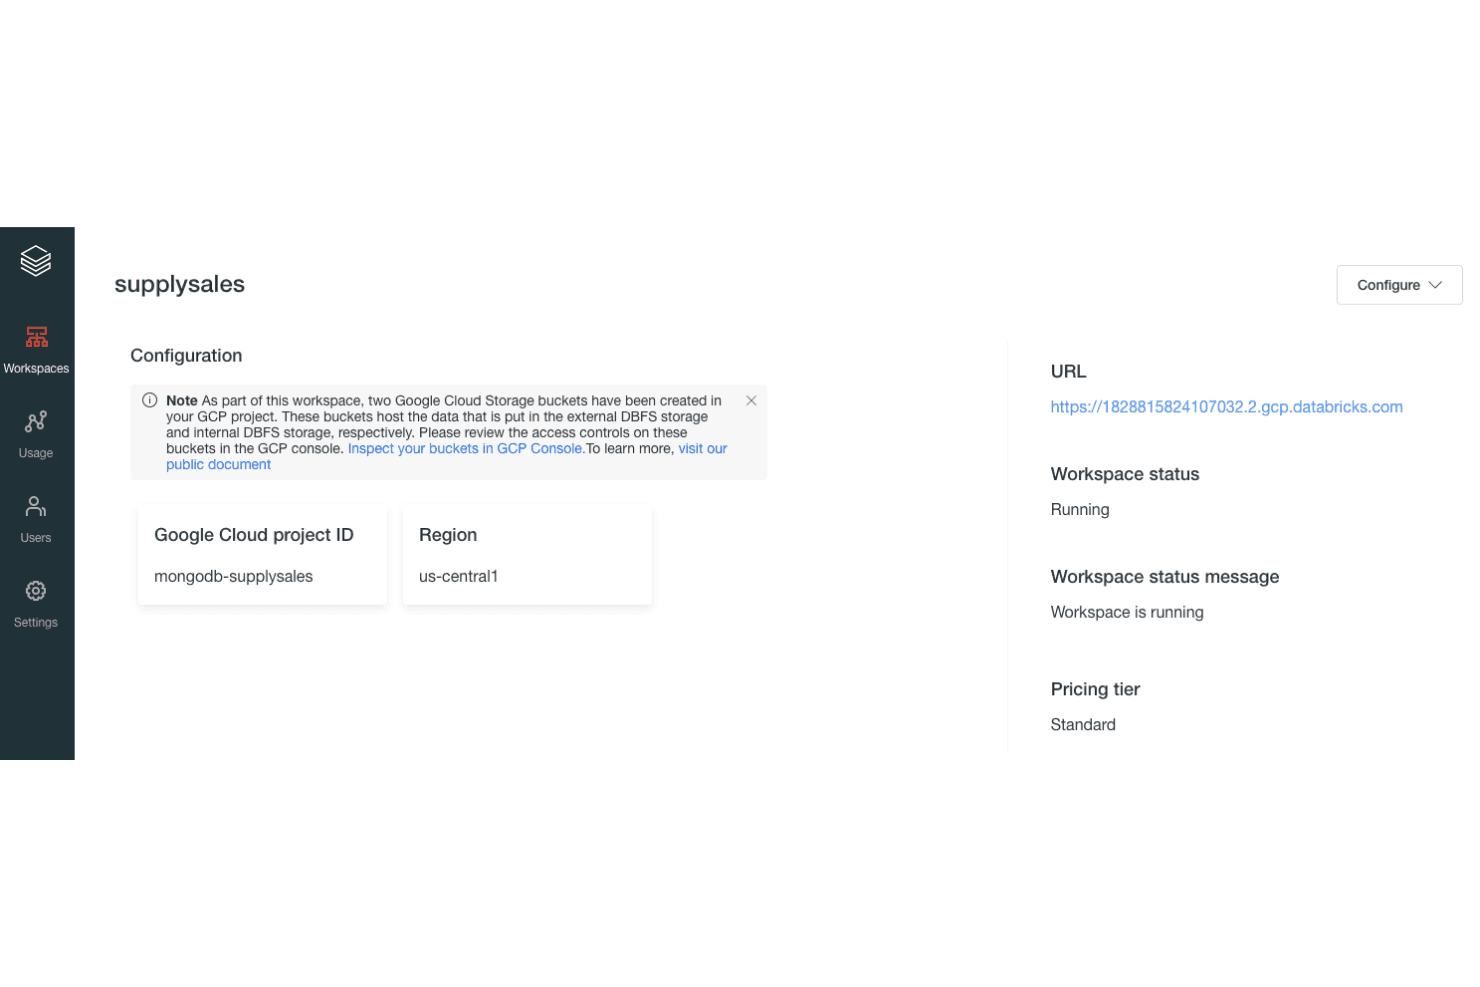
MongoDB Atlas se integra con espacios de trabajo de Databricks en GCP para el procesamiento de datos. MongoDB Atlas proporciona a los equipos de TI y datos una base de datos de documentos administrada para aplicaciones que necesitan modelos de datos flexibles, consultas confiables y menos mantenimiento de bases de datos.
¿Para quién es más adecuado MongoDB Atlas?
Los equipos de TI y de plataformas que implementan aplicaciones en varios proveedores de nube valorarán la base de datos administrada y la flexibilidad multinube de MongoDB Atlas.
Por qué elegí MongoDB Atlas
Elegí MongoDB Atlas como alternativa a Databricks por ser la mejor opción para la implementación de datos multinube. Atlas admite clústeres multinube en AWS, Azure y Google Cloud, mientras que su canalización de agregación permite analizar los datos de aplicaciones almacenados en MongoDB. Lo usaría para consultar datos operativos cerca de los servicios que se ejecutan en distintos proveedores de nube.
Características principales de MongoDB Atlas
- Atlas Search: Crea índices de texto completo y ejecuta búsquedas clasificadas por relevancia.
- Atlas Charts: Crea paneles y visualizaciones a partir de datos de MongoDB.
- Federación de datos: Consulta datos en bases de datos de Atlas y en almacenamiento de objetos en la nube.
- Copias de seguridad automatizadas: Programa instantáneas de la base de datos y restaura a partir de puntos guardados.
Integraciones de MongoDB Atlas
MongoDB Atlas documenta integraciones con Datadog, PagerDuty, Prometheus, Splunk, Slack, Microsoft Teams, HashiCorp Terraform, HashiCorp Vault, Okta y Microsoft Entra ID. También proporciona una API de administración para integraciones personalizadas.
Pros and Cons
Pros:
- Clústeres multinube en AWS, Azure y Google Cloud
- Los documentos flexibles se adaptan a los modelos de datos cambiantes de las aplicaciones
- Las canalizaciones de agregación analizan los datos operativos en el lugar
Cons:
- Menos adecuado para cargas de trabajo amplias de análisis de tipo lago de datos
- El rendimiento de las agregaciones puede requerir un ajuste cuidadoso de las consultas
Learn more about MongoDB Atlas: Ideal para tareas de integración de datos
- Prueba gratuita disponible
- $1,170/usuario/año (facturado anualmente)
Visit WebsiteCustomer Rating:4.2/5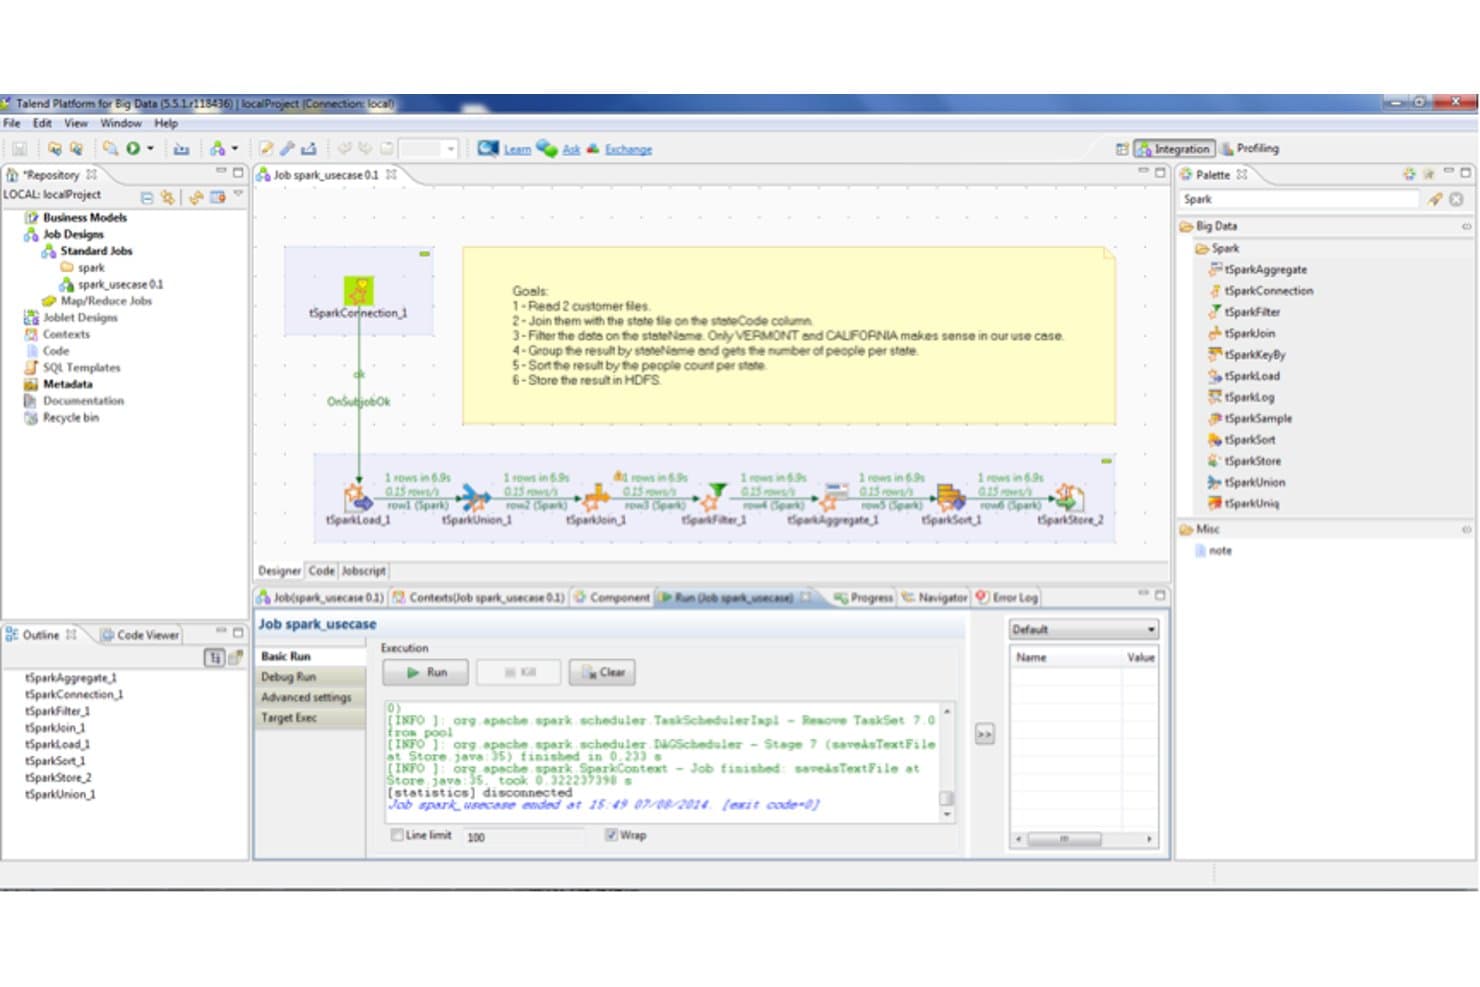
Talend permite a los usuarios crear y ejecutar canalizaciones de datos de Spark visualmente. Talend es una plataforma de integración de datos para equipos de TI y datos que conecta información entre sistemas, lo que ayuda a reducir los silos y a mantener gestionables las canalizaciones de datos a medida que crecen los entornos.
¿Para quién es más adecuado Talend?
Talend es adecuado para equipos de ingeniería de datos y TI que necesitan conectar sistemas en la nube, locales y heredados.
Por qué elegí Talend
Elegí Talend como competidor de Databricks porque «Ideal para tareas de integración de datos» es exactamente el ámbito en el que encaja. Su diseñador visual de trabajos y las transformaciones tMap me permiten unir y remodelar registros entre una base de datos heredada y un almacén de datos en la nube. También valoro los componentes de calidad de datos de Talend para detectar registros con formato incorrecto antes de que lleguen a los sistemas posteriores.
Características principales de Talend
- Conectores: Conecta bases de datos, aplicaciones en la nube, archivos y otros sistemas mediante conectores prediseñados.
- Captura de cambios de datos: Captura las inserciones, actualizaciones y eliminaciones de las bases de datos a medida que se producen.
- Linaje de datos: Rastrea los flujos de datos desde los sistemas de origen, pasando por los trabajos, hasta sus destinos.
- Descubrimiento de metadatos: Analiza las fuentes de datos para identificar conjuntos de datos, formatos y patrones.
Integraciones de Talend
Talend incluye conectores o componentes para sistemas como Salesforce, Snowflake, SAP, Kafka, Amazon S3, Azure Synapse Analytics, PostgreSQL, Microsoft SQL Server, Oracle y MongoDB. También admite servicios REST y SOAP, y Qlik Talend Data Integration proporciona API para gestionar conexiones de datos.
Pros and Cons
Pros:
- Los trabajos visuales gestionan uniones y remodelaciones
- Las canalizaciones por lotes y en tiempo real admiten diversas cargas de trabajo
- Las herramientas de calidad de datos detectan registros con formato incorrecto
Cons:
- Los trabajos grandes pueden requerir ajustes de la JVM
- El código Java generado complica la depuración y las auditorías
Learn more about Talend: La mejor opción para el procesamiento en memoria
- Plan gratuito disponible
- Precios bajo petición
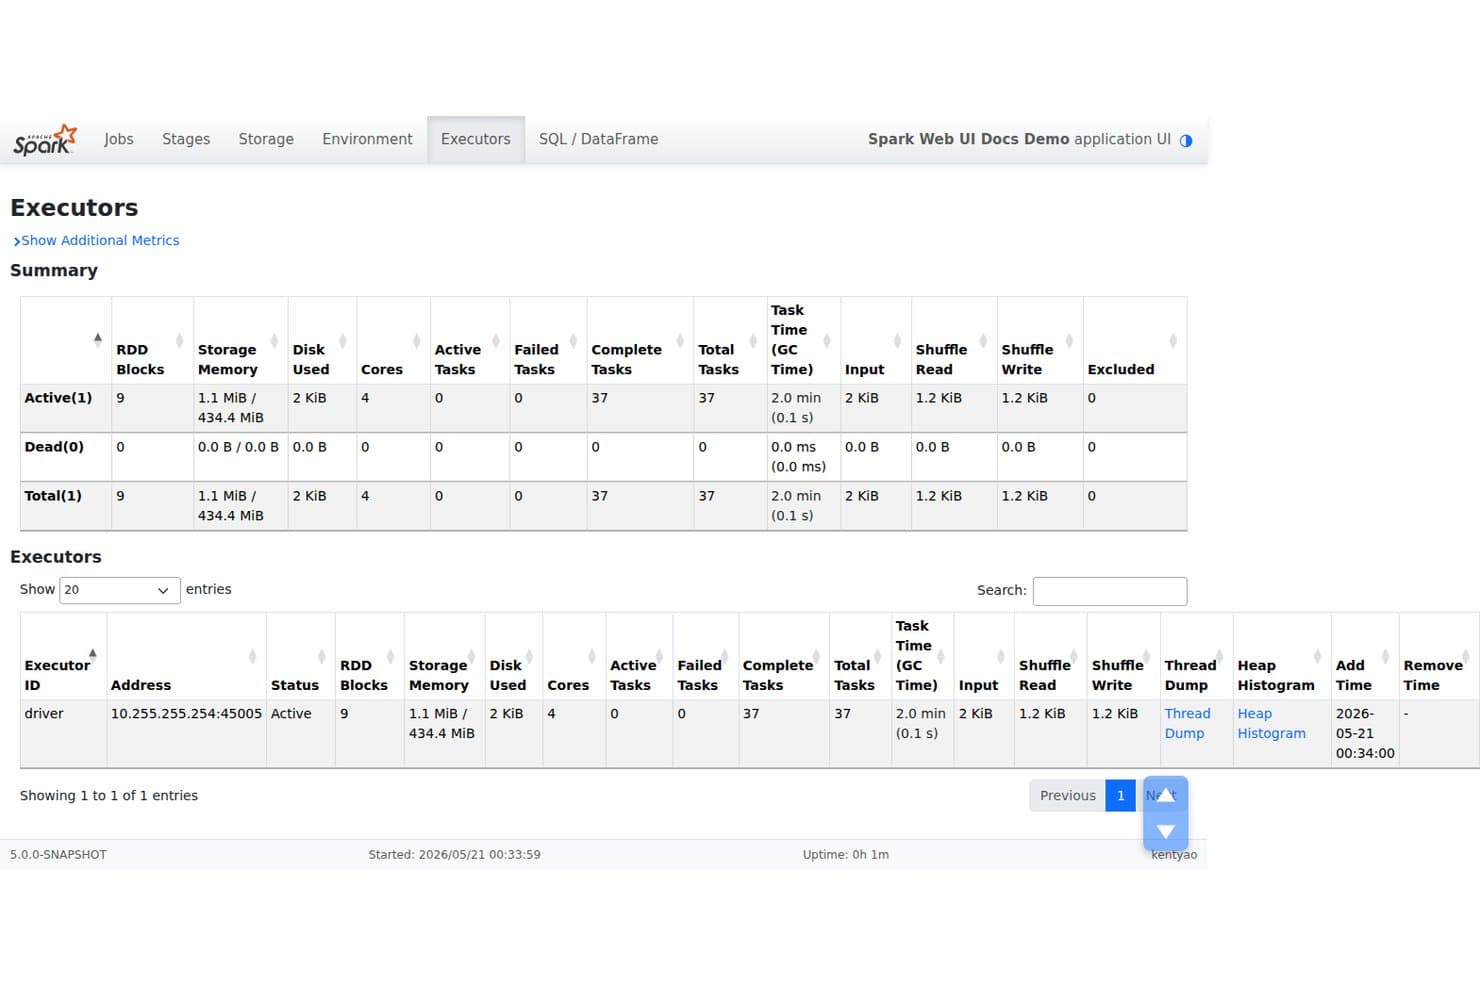
Apache Spark realiza un seguimiento en tiempo real de los recursos de los ejecutores, las tareas y la memoria. Apache Spark es un motor de análisis de código abierto para equipos de datos e infraestructura que necesitan procesar grandes conjuntos de datos, ejecutar cargas de trabajo distribuidas y crear canalizaciones de datos en diversos entornos.
¿Para quién es más adecuado Apache Spark?
Apache Spark es una buena opción para los equipos de ingeniería y análisis de datos que necesitan un procesamiento rápido e iterativo de grandes conjuntos de datos en clústeres.
Por qué elegí Apache Spark
Elegí Apache Spark como alternativa a Databricks porque es la mejor opción para el procesamiento en memoria. Spark puede almacenar en caché o conservar RDD y DataFrame en la memoria, por lo que las consultas repetidas y los cálculos iterativos evitan volver a leer los datos de origen. Esto resulta útil al refinar agregaciones grandes de datos de eventos en varias pasadas de análisis.
Características principales de Apache Spark
- Spark SQL: Consulta datos estructurados con SQL y las API de DataFrame.
- Procesamiento de flujos estructurados: Procesa datos en tiempo real con las API de procesamiento de flujos de Spark.
- MLlib: Crea flujos de trabajo de aprendizaje automático con algoritmos y canalizaciones escalables.
- Administradores de clústeres: Implementa aplicaciones en clústeres independientes, YARN o Kubernetes.
Integraciones de Apache Spark
Apache Spark admite conectores para Apache Kafka y Apache Hive, además de conexiones JDBC con bases de datos como PostgreSQL, MySQL, Oracle y Microsoft SQL Server. Su API de fuentes de datos admite conectores personalizados; es posible que las dependencias del conector de Kafka y los controladores JDBC específicos de cada base de datos deban añadirse por separado.
Pros and Cons
Pros:
- Los conjuntos de datos almacenados en caché aceleran las cargas de trabajo iterativas
- El procesamiento por lotes, los flujos, SQL y el aprendizaje automático comparten un solo motor
- Se ejecuta localmente o en clústeres de Kubernetes y YARN
Cons:
- La presión sobre la memoria puede provocar fallos por falta de memoria
- El ajuste y la depuración de trabajos distribuidos requieren experiencia
Learn more about Apache Spark:
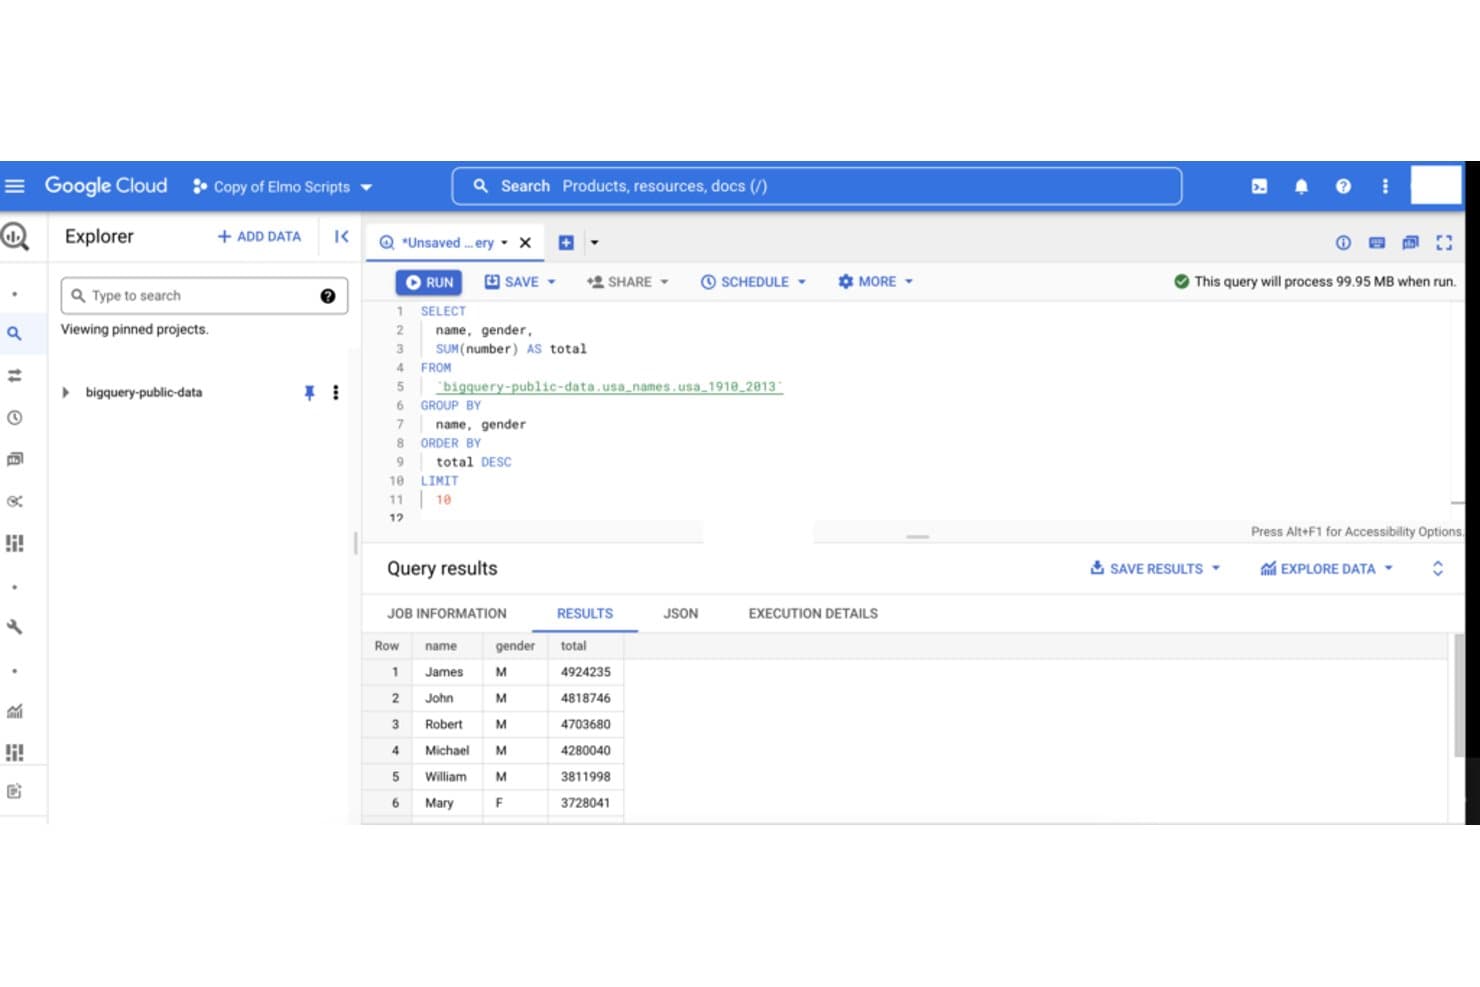
Google BigQuery permite a los usuarios ejecutar consultas SQL en grandes conjuntos de datos públicos. Para los equipos de TI y datos que necesitan análisis escalables sin gestionar la infraestructura del almacén de datos, Google BigQuery es un almacén de datos en la nube para consultar y analizar grandes conjuntos de datos con SQL.
¿Para quién es más adecuado Google BigQuery?
Los analistas e ingenieros de datos que necesitan ejecutar consultas SQL rápidas en grandes conjuntos de datos en la nube encontrarán en Google BigQuery una opción práctica.
Por qué elegí Google BigQuery
Elegí Google BigQuery como la alternativa “Mejor para consultas SQL rápidas” a Databricks. Su motor de consultas sin servidor ejecuta GoogleSQL en grandes conjuntos de datos, mientras que la partición y la agrupación de tablas pueden reducir los datos analizados en los informes recurrentes. Me gusta para consultar registros de aplicaciones o datos de eventos sin gestionar clústeres del almacén de datos.
Características principales de Google BigQuery
- BigQuery ML: Crea y ejecuta modelos de aprendizaje automático con SQL.
- Consultas programadas: Configura trabajos SQL para que se ejecuten en intervalos elegidos.
- BigQuery Data Transfer Service: Programa importaciones de datos desde fuentes compatibles.
- Vistas autorizadas: Comparte los resultados de las consultas sin conceder acceso a las tablas subyacentes.
Integraciones de Google BigQuery
Google documenta integraciones directas de BigQuery con Looker, Looker Studio, Vertex AI Workbench, Managed Service for Apache Spark y Tableau. Las conexiones de datos y los flujos de carga también son compatibles con Cloud Storage, Pub/Sub, Dataflow, Cloud SQL, Spanner, Amazon S3 y Azure Blob Storage; las API REST y de almacenamiento de BigQuery permiten integraciones personalizadas.
Pros and Cons
Pros:
- Consultas SQL rápidas en grandes conjuntos de datos
- La operación sin servidor elimina la gestión de clústeres
- La partición y la agrupación pueden reducir los datos analizados
Cons:
- Los costos de las consultas pueden aumentar considerablemente sin controles
- La exploración para usuarios empresariales suele requerir conocimientos de SQL
Learn more about Google BigQuery: La mejor opción para las necesidades de bases de datos empresariales
- Prueba gratuita disponible
- $68/usuario/mes (facturado anualmente)
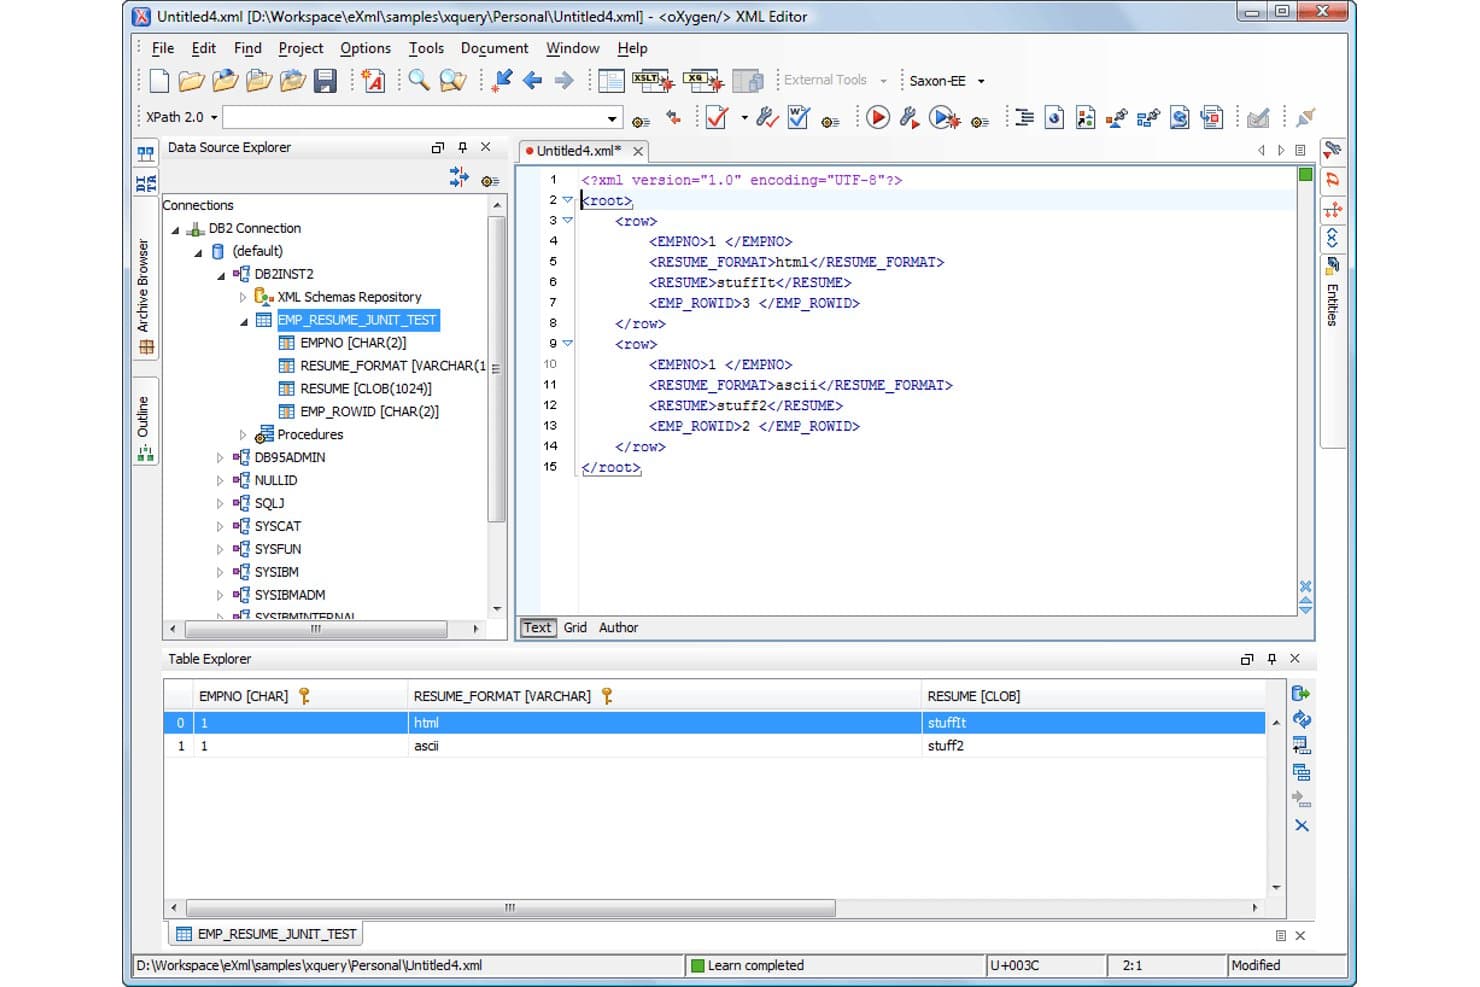
IBM Db2 permite a los usuarios explorar esquemas de bases de datos y consultar visualmente datos XML. IBM Db2 es un sistema de gestión de bases de datos relacionales para organizaciones que necesitan ejecutar cargas de trabajo de datos estructurados en entornos complejos, y brinda soporte a equipos que gestionan aplicaciones empresariales, transacciones y análisis.
¿Para quién es más adecuado IBM Db2?
Administradores de bases de datos y equipos de TI de grandes organizaciones que dan soporte a aplicaciones empresariales de gran volumen.
Por qué elegí IBM Db2
Elegí IBM Db2, la mejor opción para las necesidades de bases de datos empresariales, como alternativa a Databricks para sistemas empresariales esenciales. Admite datos transaccionales, analíticos y vectoriales en una sola plataforma, con optimización de cargas de trabajo impulsada por IA para ERP, facturación y procesamiento de pedidos. Valoro esta compatibilidad cuando las cargas de trabajo relacionales y los análisis necesitan compartir infraestructura.
Características principales de IBM Db2
- Implementación híbrida: Ejecuta Db2 en las instalaciones, en la nube o en entornos híbridos.
- Cifrado nativo: Cifra los datos de la base de datos y gestiona las claves de cifrado mediante un almacén de claves.
- Particionamiento de tablas: Divide los datos de las tablas en particiones según los valores de columna especificados.
- Herramientas de copia de seguridad y recuperación: Db2 Advanced Recovery admite la copia de seguridad, la recuperación y la extracción de datos de la base de datos.
Integraciones de IBM Db2
Las integraciones nativas no están documentadas claramente. Db2 admite el acceso federado a fuentes de datos como Oracle y Microsoft SQL Server, además de conectividad JDBC, ODBC y CLI para aplicaciones.
Pros and Cons
Pros:
- Procesamiento rápido para cargas de trabajo de transacciones empresariales
- Alta disponibilidad con HADR y recuperación
- El particionamiento admite cargas de trabajo grandes y mixtas
Cons:
- La administración y el ajuste requieren conocimientos especializados
- Las operaciones nativas de la nube están por detrás de las plataformas más nuevas
Learn more about IBM Db2: Mejor para análisis de SQL
- Prueba gratuita de 30 días
- $30/usuario/mes (facturado anualmente)
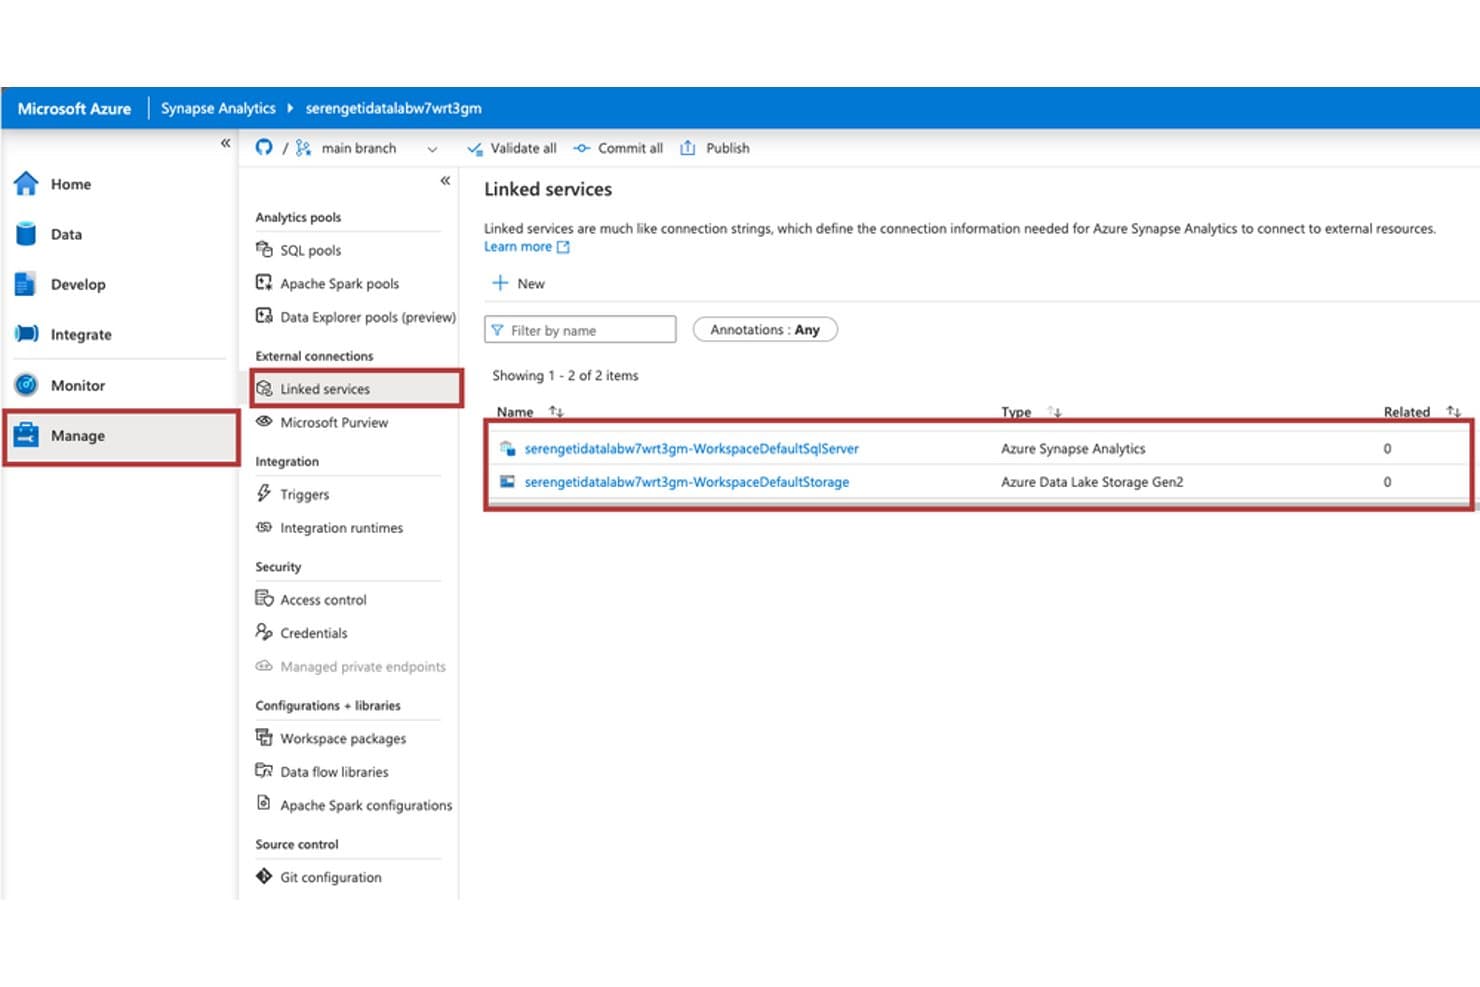
Azure Synapse Analytics administra las conexiones externas mediante Servicios vinculados. Azure Synapse Analytics es una plataforma de análisis en la nube para equipos de datos y TI que necesitan conectar datos empresariales, ejecutar consultas y respaldar informes en cargas de trabajo de almacenes de datos y macrodatos.
¿Para quién es más adecuado Azure Synapse Analytics?
Es adecuado para ingenieros y analistas de datos que necesitan acceso SQL a conjuntos de datos integrados para informes y análisis empresariales.
Por qué elegí Azure Synapse Analytics
Elegí Azure Synapse Analytics para el caso de uso Mejor para análisis de SQL: su grupo de SQL sin servidor consulta archivos del lago de datos con T-SQL, mientras que los grupos de SQL dedicados admiten cargas de trabajo de almacén aprovisionadas. Me gusta esta división cuando necesito inspeccionar conjuntos de datos sin procesar y ofrecer informes de BI recurrentes mediante SQL.
Características principales de Azure Synapse Analytics
- Grupos de Apache Spark: Ejecuta trabajos y cuadernos de Spark para el procesamiento distribuido de datos.
- Canalizaciones: Orquesta el movimiento y la transformación de datos entre fuentes conectadas.
- Synapse Studio: Administra datos, código y recursos de análisis en un espacio de trabajo compartido.
- Integración con Power BI: Conecta los datos de Synapse con Power BI para crear informes.
Integraciones de Azure Synapse Analytics
Azure Synapse Analytics cuenta con conectores de canalización integrados para Azure SQL Database, Azure Data Lake Storage, Azure Cosmos DB, SQL Server, Amazon S3 y SAP HANA, además de una conexión directa con Power BI mediante Synapse Studio. También proporciona API REST para integraciones personalizadas.
Pros and Cons
Pros:
- Las consultas T-SQL sin servidor leen archivos del lago de datos
- Los grupos MPP dedicados gestionan cargas de trabajo de almacén
- Combina consultas SQL con procesamiento de Spark
Cons:
- El ajuste de los grupos de SQL requiere experiencia práctica
- La depuración y la supervisión de canalizaciones pueden ser limitadas
Learn more about Azure Synapse Analytics:
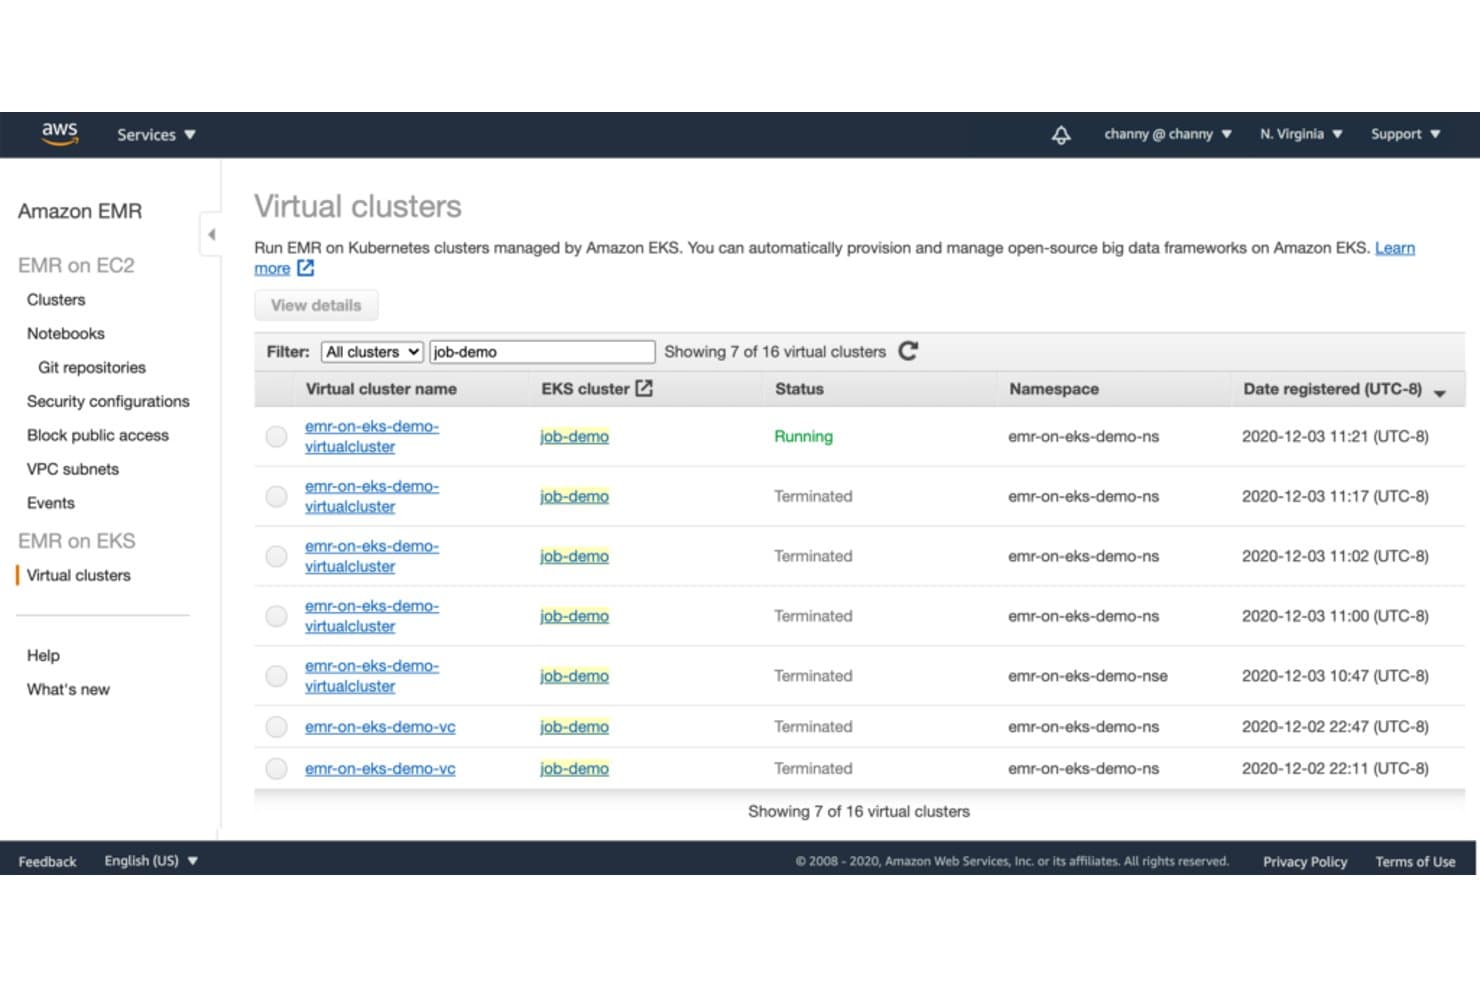
Amazon EMR permite a los usuarios gestionar clústeres virtuales que se ejecutan en Amazon EKS. Amazon EMR es la plataforma de macrodatos administrada de AWS para equipos de ingeniería de datos y análisis que necesitan procesar grandes conjuntos de datos, escalar cargas de trabajo distribuidas y reducir el trabajo de operación de clústeres de computación.
¿Para quién es más adecuado Amazon EMR?
Amazon EMR es adecuado para equipos de ingeniería de datos que ejecutan trabajos de Hadoop o Spark para procesar grandes conjuntos de datos en clústeres distribuidos.
Por qué elegí Amazon EMR
Elegí Amazon EMR como alternativa a Databricks por una razón: es la mejor opción para el procesamiento de Hadoop. Sus clústeres administrados ejecutan Apache Hadoop y Spark, por lo que puedo usar MapReduce para procesar registros de aplicaciones archivados y Spark para analizar los resultados.
Funciones principales de Amazon EMR
- EMR sin servidor: Ejecuta aplicaciones de datos sin aprovisionar ni administrar clústeres.
- Escalado automático: Ajusta la capacidad del clúster en función de la demanda de la carga de trabajo.
- EMR en EKS: Ejecuta cargas de trabajo de EMR en clústeres de Amazon EKS.
- Catálogo de datos de AWS Glue: Usa un catálogo compartido para los metadatos de las tablas.
Integraciones de Amazon EMR
Amazon EMR cuenta con integraciones documentadas con el catálogo de datos de AWS Glue, AWS Lake Formation, Amazon S3 y Amazon CloudWatch. También proporciona una API para el acceso programático y las integraciones personalizadas.
Pros and Cons
Pros:
- Ejecuta cargas de trabajo consolidadas de Hadoop y Spark
- Admite implementaciones en clústeres, sin servidor y en EKS
- Procesa grandes conjuntos de datos en distintas cargas de trabajo
Cons:
- El escalado automático lento puede dejar los trabajos con recursos insuficientes
- El escalado de clústeres a veces requiere ajustes manuales
Learn more about Amazon EMR: La mejor opción para Spark y Hadoop administrados
- No disponible
- Desde $0.06/DCU-hora
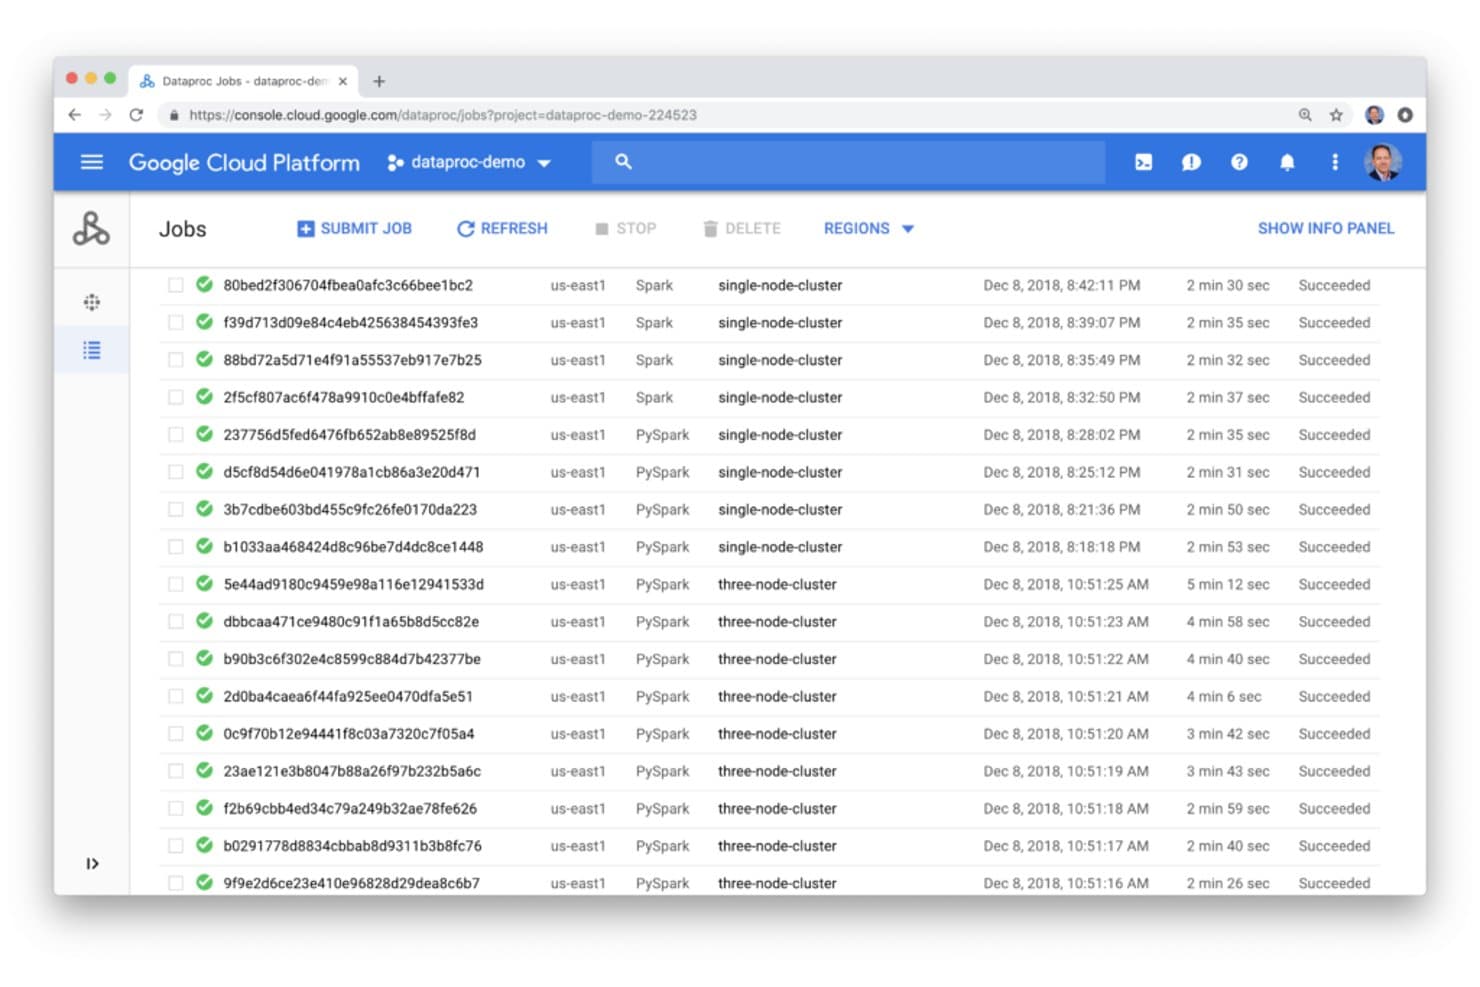
Google Cloud Dataproc permite a los usuarios supervisar y administrar trabajos de Spark de un vistazo. Google Cloud Dataproc proporciona a los equipos de ingeniería de datos y TI una plataforma en la nube administrada para cargas de trabajo de análisis a gran escala, lo que ayuda a reducir la administración de clústeres y permite admitir canalizaciones de datos en Google Cloud.
¿Para quién es más adecuado Google Cloud Dataproc?
Los equipos de ingeniería de datos que ejecutan trabajos de Spark o Hadoop en Google Cloud pueden utilizar Dataproc para administrar las operaciones de los clústeres.
Por qué elegí Google Cloud Dataproc
Elegí Google Cloud Dataproc para cargas de trabajo en las que la prioridad es «la mejor opción para Spark y Hadoop administrados». Los clústeres administrados y las políticas de escalado automático ayudan a gestionar trabajos por lotes con necesidades de recursos variables, mientras que Dataproc Serverless ejecuta lotes de Spark sin aprovisionar clústeres. Por ejemplo, puedes procesar registros de eventos nocturnos con Spark y evitar dejar un clúster inactivo entre ejecuciones.
Características principales de Google Cloud Dataproc
- Lightning Engine: Acelera la ejecución de Spark mediante procesamiento vectorizado, almacenamiento en caché y redistribución optimizada.
- Compatibilidad con Apache Iceberg: Funciona con formatos de tablas abiertos en Google Cloud Storage.
- Aceleración mediante GPU: Admite NVIDIA RAPIDS para el procesamiento de datos habilitado para GPU.
- Controles de seguridad: Se integra con IAM, VPC Service Controls y Kerberos.
Integraciones de Google Cloud Dataproc
Google Cloud Dataproc cuenta con integraciones integradas con BigQuery, Cloud Storage, Bigtable, Cloud Logging y Cloud Monitoring. También proporciona una API REST y Cloud SDK para administrar clústeres y trabajos.
Pros and Cons
Pros:
- Ejecuta trabajos de Spark existentes con reescrituras mínimas
- Creación y desmantelamiento rápidos de clústeres
- Los lotes sin servidor evitan la administración de clústeres
Cons:
- El ajuste de los clústeres aún requiere conocimientos especializados en infraestructura
- Los costes pueden parecer elevados para cargas de trabajo sostenidas
Learn more about Google Cloud Dataproc: 10La mejor opción para soluciones de IA y aprendizaje automático
H2O.ai
- Demostración gratuita disponible
- Precios bajo solicitud
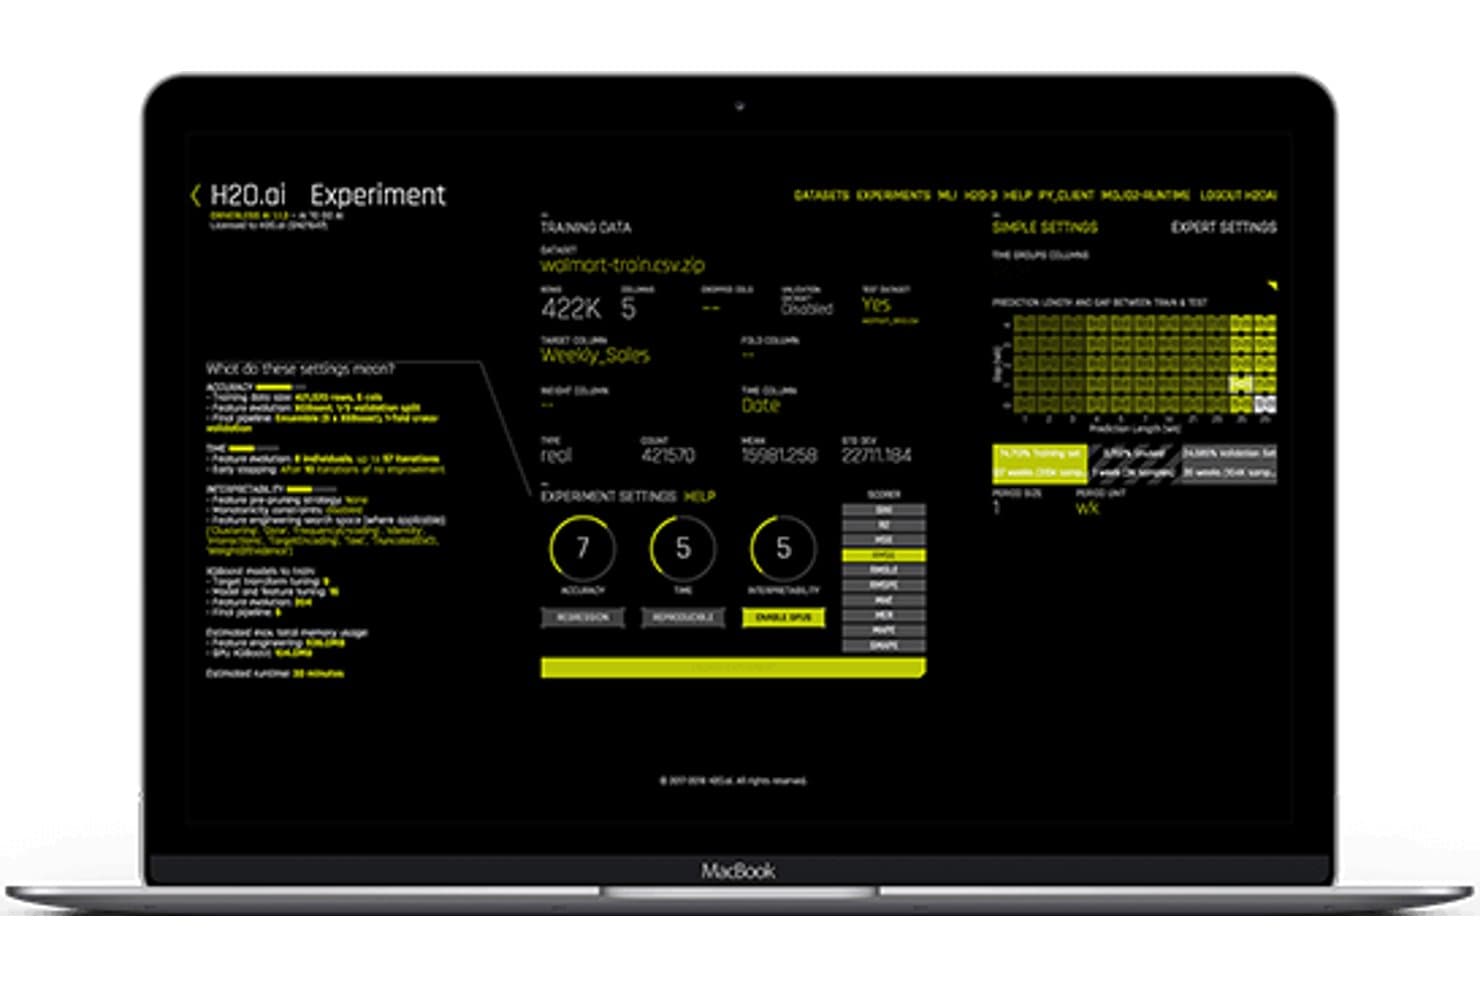
H2O.ai permite a los usuarios configurar y ejecutar visualmente experimentos de AutoML. Para los equipos que evalúan alternativas a Databricks, H2O.ai ofrece una plataforma de IA y aprendizaje automático que ayuda a los equipos de datos y TI a crear modelos predictivos a partir de grandes conjuntos de datos y a poner la analítica en práctica.
¿Para quién es más adecuado H2O.ai?
H2O.ai es adecuado para científicos de datos e ingenieros de aprendizaje automático responsables de desarrollar modelos de IA y ponerlos en producción.
Por qué elegí H2O.ai
Elegí H2O.ai como mi alternativa a Databricks “la mejor para soluciones de IA y aprendizaje automático” porque se centra en crear modelos predictivos a partir de grandes conjuntos de datos. H2O-3 distribuye el aprendizaje automático en memoria entre clústeres, mientras que AutoML prueba algoritmos y clasifica los modelos en una tabla de posiciones. Me gusta esta opción cuando necesito comparar modelos antes de poner uno en producción.
Características principales de H2O.ai
- Implementación flexible: Ejecuta la plataforma en las instalaciones, en una nube privada, en la nube o en entornos aislados de redes.
- Compatibilidad independiente del modelo: Elige, intercambia o ajusta modelos y modelos de lenguaje de gran tamaño.
- Explicabilidad: Revisa las explicaciones de las decisiones basadas en IA.
- Registros de auditoría: Rastrea la actividad de la plataforma mediante registros preparados para auditorías.
Integraciones de H2O.ai
H2O Driverless AI ofrece conectores de datos para Amazon S3, HDFS, Snowflake, Google BigQuery, Databricks, Google Cloud Storage, Azure Blob Storage, Hive, fuentes JDBC y tablas Delta. Estos conectores permiten a los equipos consultar o importar datos de plataformas existentes para flujos de trabajo de aprendizaje automático.
Pros and Cons
Pros:
- AutoML agiliza la comparación y la creación de prototipos de modelos
- El entrenamiento distribuido en memoria escala entre clústeres
- La implementación en entornos aislados de redes permite trabajar en entornos controlados
Cons:
- Las opciones de manipulación de datos son limitadas
- La interfaz de usuario engorrosa puede ralentizar los flujos de trabajo
Learn more about H2O.ai:
Otros competidores de Databricks
Estas son algunas opciones adicionales de competidores de Databricks que no entraron en mi lista, pero que aún merece la pena considerar:
- 11DremioMejor para análisis de autoservicio
- 12QuboleMejor para cargas de trabajo de big data
- 13Azure DatabricksIdeal para análisis colaborativos
Comment j'évalue les concurrents de Databricks
Que votre équipe exécute des pipelines Spark à grande échelle ou gère un cycle de vie ML, j'évalue chaque alternative en deux étapes : d'abord le lac de données et les besoins en calcul essentiels, puis les éléments différenciateurs.
Fonctionnalités essentielles (Pré-requis pour cette liste)
Lorsque je sélectionne des outils pour ma liste, je les évalue sur une échelle de 0 (la fonctionnalité n'est pas proposée) à 5 (excellence dans ce domaine) pour chacune des fonctionnalités principales listées ci-dessous. Ensuite, je convertis le score total de l'outil en pourcentage. Chaque outil doit obtenir un score total minimum de 65 % pour être envisagé dans la sélection.
- Architecture Lakehouse unifiée : Je vérifie si une plateforme peut gérer à la fois les requêtes d'entrepôt structurées et le stockage de données brutes non structurées, avec prise en charge de formats de table ouverts comme Delta, Iceberg ou Hudi.
- Traitement de données distribué : Les traitements batchs ou streaming à grande échelle nécessitent un moteur distribué capable d'autoscaler, c'est pourquoi j'évalue les options de calcul et la façon dont la plateforme gère des jobs comme des ETL de plusieurs téraoctets.
- Workflows ML/IA intégrés : Je recherche un support complet du cycle de vie ML, du suivi d'expériences et du registre de modèles jusqu'au déploiement et à la mise à disposition, plutôt qu'un simple notebook capable d'exécuter des scripts d'entraînement.
- Environnement collaboratif de notebooks : Les équipes de data engineers, analystes et ingénieurs ML ont besoin de notebooks partagés multi-langages, j'évalue donc la collaboration en temps réel, le contrôle de version et la prise en charge de plusieurs langages (SQL, Python, Scala, R).
- Gouvernance des données & sécurité : Un catalogue de données unifié, des contrôles d'accès granulaires et le suivi de la traçabilité sont essentiels ici. J'analyse comment chaque plateforme gère les droits d'accès sur les tables, colonnes et actifs IA en un seul endroit.
- Multi-cloud & intégration ouverte : L'enfermement propriétaire est un vrai risque, donc j'évalue si chaque outil fonctionne sur AWS, Azure et GCP, et comment il s'intègre avec des orchestrateurs comme Airflow, des outils BI comme Tableau, et des couches d'ingestion comme dbt.
Une fois la liste restreinte aux outils répondant à ces critères, j'examine ce qui distingue chaque plateforme.
Facteurs de différenciation (Ce qui distingue les vendeurs)
Voici comment je compare et différencie les différents fournisseurs :
Fonctionnalités marquantes
Le compute serverless est un facteur clé de différenciation. J'examine si une plateforme permet aux équipes d'exécuter des requêtes et des jobs sans gestion des clusters, ce qui réduit la charge pour les groupes aux charges de travail imprévisibles. Les outils GenAI natifs deviennent chaque année plus importants, surtout pour les équipes qui conçoivent des pipelines RAG ou affinent des LLM directement depuis leur plateforme de données. J'observe également les mécanismes d'optimisation des coûts comme le suivi des dépenses par type de charge de travail et les politiques automatiques de gestion des clusters, car les coûts du cloud peuvent vite exploser dans les grandes équipes d'ingénierie.
Au-delà des fonctionnalités
Le coût total de possession fait partie des premiers critères que j'évalue. La tarification à la consommation peut sembler attractive jusqu'à ce que les frais de sortie de données et les niveaux de support premium fassent grimper la facture. La richesse de l'écosystème compte également : je vérifie la qualité d'intégration avec des outils comme Airflow, dbt ou Tableau, étant donné que la plupart des équipes ne remplacent pas tout leur stack. Enfin, la facilité d'implémentation et le délai de valorisation sont inclus dans mon analyse. Des outils de migration depuis des systèmes existants comme Hadoop ou Redshift peuvent faire gagner des semaines lors d'une transition, et une bonne documentation allège considérablement l'intégration de nouveaux ingénieurs.
Cómo elegir un competidor de Databricks
Es fácil perderse entre largas listas de funciones y complejas estructuras de precios. Para ayudarte a mantener la atención mientras avanzas en tu proceso particular de selección de software, aquí tienes una lista de factores que debes tener en cuenta:
| Factor | Qué tener en cuenta |
| Escalabilidad | Asegúrate de que la solución pueda gestionar el crecimiento de tus datos sin perder rendimiento. Comprueba si admite el escalado horizontal y vertical para ofrecer flexibilidad. |
| Integraciones | Busca compatibilidad con tus herramientas actuales, como lagos de datos o herramientas de BI, para garantizar un flujo de datos fluido y evitar procesos aislados. |
| Personalización | Evalúa la capacidad de la plataforma para adaptarse a los flujos de trabajo y procesos específicos de tu equipo. Los paneles personalizables pueden satisfacer las distintas necesidades de los equipos. |
| Facilidad de uso | Ten en cuenta la curva de aprendizaje y lo intuitiva que resulta la interfaz para tu equipo. Una plataforma fácil de usar puede reducir el tiempo de formación y aumentar la adopción. |
| Presupuesto | Compara los modelos de precios y asegúrate de que se ajusten a tu presupuesto. Ten en cuenta los costes ocultos, como el almacenamiento o las tarifas adicionales por usuario, que podrían influir en tu decisión. |
| Medidas de seguridad | Evalúa las funciones de seguridad de la plataforma, como el cifrado de datos y el cumplimiento de los estándares del sector, para proteger los datos confidenciales. |
| Asistencia | Comprueba la disponibilidad de las opciones de asistencia al cliente, incluidos el chat en directo y los foros de la comunidad, para garantizar que tu equipo pueda obtener ayuda cuando la necesite. |
| Rendimiento | Investiga cómo gestiona la plataforma los grandes conjuntos de datos y el procesamiento en tiempo real para asegurarte de que cumple las expectativas de rendimiento de tu equipo. |
Tendencias en los competidores de Databricks
En mi investigación, recopilé innumerables actualizaciones de productos, comunicados de prensa y registros de versiones de distintos proveedores competidores de Databricks. Estas son algunas de las tendencias emergentes a las que estoy prestando atención:
- Análisis en tiempo real: Las empresas demandan cada vez más información de datos en tiempo real. Los proveedores están mejorando sus plataformas para procesar y analizar datos en tiempo real, lo que permite a los usuarios tomar decisiones inmediatas. Soluciones como Google BigQuery están incorporando funciones compatibles con la transmisión de datos en tiempo real.
- Análisis aumentado: Esta tendencia consiste en utilizar la IA y el aprendizaje automático para mejorar los procesos de análisis de datos. Se está popularizando porque ayuda a los usuarios a descubrir información sin esfuerzo manual. IBM Watson Studio es un ejemplo, ya que ofrece funciones de análisis aumentado para automatizar el análisis de datos.
- Democratización de los datos: Cada vez más plataformas se centran en hacer que los datos sean accesibles para los usuarios no técnicos. Esta tendencia es fundamental para fomentar una cultura basada en los datos dentro de las organizaciones. Se están desarrollando herramientas con interfaces intuitivas y funciones de autoservicio, como las de Alteryx.
- Gobernanza de datos: A medida que se endurecen las normativas de privacidad de datos, las funciones de gobernanza de datos adquieren mayor importancia. Los proveedores están integrando herramientas de gobernanza para ayudar a los usuarios a cumplir la normativa y gestionar los datos de forma responsable. Azure Synapse Analytics, por ejemplo, ofrece funciones de gobernanza integradas.
- Compatibilidad con la nube híbrida: Muchas empresas buscan flexibilidad en sus estrategias de nube. La compatibilidad con la nube híbrida está creciendo, lo que permite a los usuarios gestionar datos tanto en entornos locales como en la nube. Cloudera lidera esta tendencia al proporcionar soluciones compatibles con implementaciones de nube híbrida.
¿Qué es un competidor de Databricks?
Los competidores de Databricks son soluciones de software diseñadas para ofrecer capacidades de procesamiento de datos, análisis y aprendizaje automático. Estas herramientas suelen ser utilizadas por científicos de datos, ingenieros y analistas para obtener información y tomar decisiones empresariales.
Las funciones de análisis en tiempo real, análisis aumentado y gobernanza de datos ayudan a procesar los datos de forma eficiente, descubrir información y gestionar los datos de manera responsable. En general, estas herramientas permiten a las empresas aprovechar sus datos para mejorar la toma de decisiones y la planificación estratégica.
Funciones de los competidores de Databricks
Al seleccionar un competidor de Databricks, presta atención a las siguientes funciones clave:
- Análisis en tiempo real: Permite procesar datos y obtener información de inmediato, lo que te permite tomar decisiones empresariales rápidas.
- Análisis aumentado: Utiliza la IA para automatizar el análisis de datos y ayuda a descubrir información útil sin esfuerzo manual.
- Gobernanza de datos: Garantiza el cumplimiento de las normativas de privacidad de datos y una gestión responsable de los datos.
- Compatibilidad con la nube híbrida: Permite gestionar datos tanto en entornos locales como en la nube para ofrecer flexibilidad.
- Colaboración interactiva: Facilita el trabajo en equipo mediante espacios de trabajo compartidos y herramientas para el análisis conjunto de datos.
- Escalado automático: Ajusta los recursos en función de la carga de trabajo, optimizando el rendimiento sin intervención manual.
- Integración del aprendizaje automático: Ofrece capacidades integradas de aprendizaje automático para realizar predicciones avanzadas y obtener información útil de los datos.
- Personalización: Permite crear flujos de trabajo y paneles personalizados que se adapten a las necesidades y los procesos específicos del equipo.
- Medidas de seguridad: Proporciona funciones de cifrado y cumplimiento normativo para proteger los datos confidenciales.
- Interfaz fácil de usar: Garantiza una experiencia sencilla, reduce la curva de aprendizaje y aumenta la adopción dentro del equipo.
Ventajas de un competidor de Databricks
Implementar un competidor de Databricks ofrece varias ventajas para tu equipo y tu empresa. Estas son algunas de las que puedes esperar:
- Mejora de la toma de decisiones: El análisis en tiempo real y el análisis aumentado proporcionan información inmediata y mejoran la capacidad de tu equipo para tomar decisiones.
- Mayor colaboración: Las funciones de colaboración interactiva permiten que tu equipo trabaje conjuntamente de forma eficaz, lo que da lugar a proyectos de datos más cohesionados.
- Escalabilidad: El escalado automático permite que tu sistema gestione el crecimiento de los datos de forma eficiente sin necesidad de realizar ajustes manuales.
- Eficiencia de costes: Los modelos de precios de pago por uso garantizan que solo pagues por los recursos que utilizas, optimizando la gestión del presupuesto.
- Mayor seguridad: Las medidas de seguridad integradas protegen tus datos y garantizan el cumplimiento de los estándares del sector.
- Flexibilidad: La compatibilidad con la nube híbrida ofrece flexibilidad para gestionar datos en distintos entornos y adaptarse a las necesidades de tu empresa.
- Personalización: Las funciones personalizables te permiten adaptar los flujos de trabajo y los paneles a tus requisitos específicos, mejorando la productividad.
Costes y precios de un competidor de Databricks
Seleccionar un competidor de Databricks requiere comprender los distintos modelos de precios y planes disponibles. Los costes varían en función de las funciones, el tamaño del equipo, los complementos y otros factores. La siguiente tabla resume los planes habituales, sus precios medios y las funciones que suelen incluir las soluciones competidoras de Databricks:
Tabla comparativa de planes de un competidor de Databricks
| Tipo de plan | Precio medio | Funciones habituales |
| Plan gratuito | $0 | Procesamiento básico de datos, almacenamiento limitado y asistencia de la comunidad. |
| Plan personal | $10-$30 /usuario /mes | Análisis de datos mejorado, paneles personales y asistencia por correo electrónico. |
| Plan empresarial | $50-$100 /usuario /mes | Herramientas de análisis avanzadas, funciones de colaboración en equipo y asistencia prioritaria. |
| Plan para empresas | $150-$300/usuario /mes | Integraciones personalizadas, gestión de cuentas especializada y seguridad de nivel empresarial. |
Preguntas frecuentes sobre los competidores de Databricks
Aquí encontrarás respuestas a algunas preguntas frecuentes sobre los competidores de Databricks:
¿Quién es el mayor competidor de Databricks?
Snowflake suele considerarse el mayor competidor de Databricks debido a sus capacidades similares como plataforma de datos basada en la nube. Ambas ofrecen amplias funciones de procesamiento y análisis de datos, pero Snowflake es conocida por sus fortalezas en el almacenamiento de datos. En función de tus necesidades específicas, cualquiera de las dos podría ser una opción sólida.
¿Qué reemplazará a Databricks?
Aunque no hay una única herramienta destinada a reemplazar Databricks, alternativas como SQL Server ofrecen funciones muy competitivas. SQL Server se integra bien con herramientas de análisis de datos como Power BI y ofrece un sólido sistema de gestión de bases de datos relacionales. Tu elección dependerá de tus requisitos específicos de procesamiento de datos.
¿Cuáles son las limitaciones de Databricks?
Databricks tiene algunas limitaciones, como las restricciones en el número de widgets de un cuaderno y los límites de caracteres para los nombres y las entradas de los widgets. Estas restricciones pueden afectar a la forma en que diseñas e interactúas con los datos en los cuadernos, así que planifica en consecuencia si estos límites afectan a tus flujos de trabajo.
¿Quiénes son los competidores de Amazon Databricks?
Amazon Databricks compite con plataformas como Snowflake, que ofrecen capacidades similares de procesamiento de datos. Snowflake proporciona una solución de almacenamiento de datos basada en la nube, ampliamente reconocida por su escalabilidad y facilidad de uso, lo que la convierte en una opción sólida en el mercado.
¿Cómo se compara el precio de Databricks con el de sus competidores?
El precio de Databricks puede variar considerablemente en función del uso y de las funciones. Es importante compararlo con el de competidores como Snowflake y Google BigQuery, teniendo en cuenta factores como el almacenamiento de datos, los costes de procesamiento y las funciones adicionales. Evalúa la estructura de precios de cada plataforma para encontrar la que mejor se adapte a tu presupuesto.
¿Qué funciones debo buscar en un competidor de Databricks?
Al evaluar a los competidores de Databricks, busca funciones como análisis en tiempo real, integración del aprendizaje automático y gobierno de datos. Estas capacidades mejoran el procesamiento y el análisis de datos, y aportan valor a tu equipo. Ten en cuenta las necesidades específicas de tu empresa para determinar qué funciones son más importantes.