

Das richtige Überwachungstool zu finden, kann eine Herausforderung sein. Sie möchten etwas, das den Anforderungen Ihres Teams entspricht, ohne unnötige Komplexität. Deshalb suchen viele Unternehmen nach LogicMonitor-Alternativen.
Meiner Erfahrung nach suchen Unternehmen häufig nach anderen Lösungen, die eine bessere Skalierbarkeit, spezielle Funktionen oder ein besseres Preis-Leistungs-Verhältnis bieten. Sie stellen möglicherweise fest, dass LogicMonitor nicht zu ihren aktuellen Zielen oder ihrem Budget passt.
Ich habe mehrere Optionen unabhängig getestet und bewertet, um Ihnen eine unvoreingenommene Einschätzung der verfügbaren Lösungen zu geben. Ich führe Sie durch die besten Tools, mit denen Sie Ihre spezifischen Herausforderungen bewältigen können.
Ganz gleich, ob Sie eine verbesserte Cloud-Integration oder die Flexibilität von Open-Source-Software suchen – diese Übersicht hilft Ihnen dabei, die passende Lösung zu finden. Sehen wir uns die besten Optionen an, mit denen sich Ihre Überwachungsaufgaben leichter bewältigen lassen.
Was ist LogicMonitor?
LogicMonitor ist eine Produktivitätssoftware für IT-Experten und Unternehmen, die effiziente Überwachungslösungen benötigen. IT-Teams nutzen sie zur Überwachung von Infrastruktur, Anwendungen und Netzwerkleistung und erhalten dadurch wertvolle Einblicke in den Systembetrieb.
Automatisierte Überwachung, anpassbare Dashboards und Echtzeitwarnungen helfen dabei, Probleme zu identifizieren und die Leistung zu optimieren. Insgesamt bietet LogicMonitor eine zentrale Plattform, damit Ihre Systeme reibungslos funktionieren.
Vergleichstabelle der LogicMonitor-Alternativen
Diese Vergleichstabelle fasst die Preisinformationen meiner wichtigsten LogicMonitor-Alternativen zusammen:
Score legend (out of 5)
- Excellent4.5–5
- Good4–4.4
- Average3–3.9
- Below average2–2.9
- Poor1–1.9
Sorted by: Default
| Tool | Starting Price | Website | |||||||
|---|---|---|---|---|---|---|---|---|---|
Am besten für KI-gestützte Beobachtbarkeit | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $7/Monat 15-tägige kostenlose Testversion + kostenlose Demo verfügbar | Website |
Am besten für kostengünstige Überwachung | 4.0 out of 5 | 4 | 3 | 4 | 4 | 4 | 5 | $325/Monat Kostenloser Tarif + 5-tägige kostenlose Testversion + kostenlose Demo verfügbar | Website |
Am besten für Cloud-Überwachungsdienste geeignet | 4.3 out of 5 | 4 | 4 | 4 | 4 | 5 | 5 | $15/Host/Monat Kostenloser Tarif + 14-tägige kostenlose Testversion + kostenlose Demo verfügbar | Website |
Am besten für KI-gestützte Datenanalyse | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $15/Host/Monat Kostenloser Tarif verfügbar | Website |
Am besten für automatisierten Echtzeit-Datenzugriff geeignet | 3.8 out of 5 | 4 | 4 | 3 | 4 | 4 | 4 | $0.04/Monat 14-tägige kostenlose Testversion + kostenlose Demo verfügbar | Website |
Am besten für einheitliche, flexible Beobachtbarkeit | 3.8 out of 5 | 4 | 4 | 4 | 3 | 4 | 4 | Ab 19 $/Monat Kostenloser Tarif verfügbar | Website |
Am besten für integrierte IT-Lösungen geeignet | 3.7 out of 5 | 3 | 3 | 4 | 3 | 5 | 4 | Preise auf Anfrage 30-tägige kostenlose Testversion verfügbar | Website |
Am besten für anpassbare Übersichtsseiten | 3.3 out of 5 | 4 | 2 | 4 | 3 | 4 | 3 | $200/Monat Kostenloser Tarif + 30-tägige Testversion + Demo verfügbar | Website |
Am besten für Open-Source-Observability | 3.8 out of 5 | 4 | 4 | 4 | 3 | 4 | 4 | $49/Monat 30-tägige kostenlose Testversion + kostenlose Demo verfügbar | Website |
Am besten für KI-basierte Einblicke | 3.2 out of 5 | 3 | 4 | 3 | 2 | 3 | 4 | Preise auf Anfrage Kostenloser Tarif und kostenlose Demo verfügbar | Website |


Warum Sie unseren Software-Empfehlungen vertrauen können
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Unser Team testet und bewertet Software seit 2012. Als Tech-Führungskräfte wissen wir selbst, wie schwierig – und wichtig – es ist, die richtige Software auszuwählen.
Für diesen Leitfaden haben wir Tools mithilfe von praktischen Tests und unabhängiger Recherche bewertet und dabei unsere Bewertungskriterien angewendet.
Unsere Bewertungen spiegeln unser menschliches redaktionelles Urteilsvermögen wider, keine Verkaufsstrategie.
Expertenprüfer:
- Paulo Gardini MiguelTech-Direktor
 Tim FisherVP für KI
 Gabriel RosasTech Lead & Software-Architekt
 Christhian GruhnTech Lead & Plattform-Architekt

Bewertungen der besten LogicMonitor-Alternativen
Nachfolgend finden Sie meine ausführlichen Zusammenfassungen der besten LogicMonitor-Alternativen, die es in meine Auswahlliste geschafft haben. Meine Bewertungen bieten einen detaillierten Überblick über die wichtigsten Funktionen, Vor- und Nachteile, Integrationen sowie ideale Anwendungsfälle jedes Tools, damit Sie die beste Lösung für sich finden.
 Am besten für KI-gestützte Beobachtbarkeit
- 15-tägige kostenlose Testversion + kostenlose Demo verfügbar
- Ab $7/Monat (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.5/5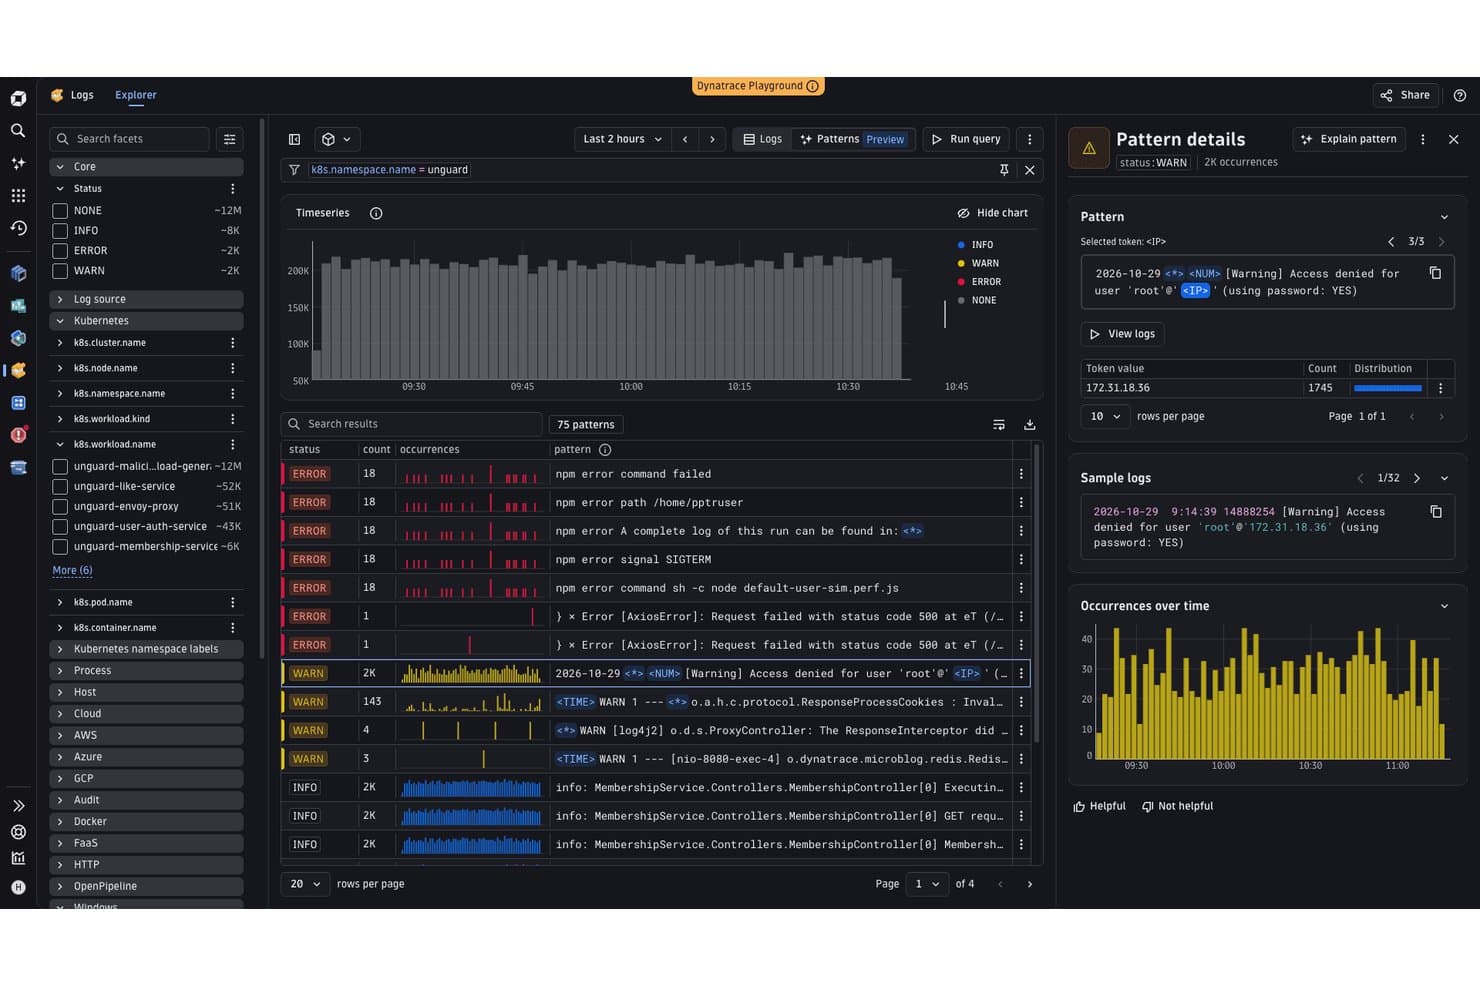
Die Dynatrace-Logs-App gruppiert Protokolleinträge nach Status in Muster und zeigt Diagramme zu deren Auftreten sowie Details an. Dynatrace ist eine KI-gestützte Beobachtungsplattform für den gesamten Stack, die Ihre Anwendungen, Infrastruktur und Cloud-Umgebungen automatisch erkennt, abbildet und überwacht – dadurch eignet sie sich besonders für IT-Betriebs- und DevOps-Teams, die mit komplexen, sich schnell verändernden Systemen arbeiten, bei denen eine manuelle Ursachenanalyse nicht realistisch ist.
Für wen eignet sich Dynatrace am besten?
Dynatrace eignet sich besonders für DevOps- und IT-Betriebsteams, die komplexe, verteilte Umgebungen verwalten, in denen vollständige Transparenz über den gesamten Stack und KI-gestützte Ursachenanalysen wichtiger sind als dedizierte Netzwerküberwachung.
Warum ich Dynatrace ausgewählt habe
Ich habe Dynatrace als eine der besten LogicMonitor-Alternativen ausgewählt, weil die KI-gestützte Beobachtbarkeit weit über schwellenwertbasierte Alarmierungen hinausgeht. Davis AI nutzt die Smartscape-Topologie, um Ereignisse über Hosts, Container und Dienste hinweg automatisch zu korrelieren. Dadurch muss ich nicht Dutzende von Alarmen analysieren, sondern erhalte eine einzige zugrunde liegende Ursache. PurePath verfolgt jede Transaktion auf Codeebene von Anfang bis Ende. So kann ich genau feststellen, wo eine Verlangsamung entsteht, ohne Protokolle manuell durchsuchen zu müssen.
Wichtige Funktionen von Dynatrace
- Automatische Erkennung mit OneAgent: Wird pro Host installiert und erkennt Prozesse, Dienste und Abhängigkeiten automatisch, ohne manuelle Konfiguration.
- Protokollanalyse mit DQL: Nimmt Protokolldaten auf, reichert sie an und fragt sie mithilfe der Dynatrace Query Language ab, mit einer konfigurierbaren Aufbewahrungsdauer von 10 Tagen bis 10 Jahren.
- Synthetisches Monitoring: Simuliert Benutzerabläufe über den Browser-Monitor und prüft die Verfügbarkeit von APIs und Diensten über den HTTP-Monitor von öffentlichen und privaten Standorten aus.
- Automatisierung von Arbeitsabläufen: Löst automatisierte Arbeitsabläufe durch Ereignisse, Zeitpläne oder API-Aufrufe aus und unterstützt Bedingungen, Schleifen und Wiederholungen.
Integrationen von Dynatrace
Dynatrace bietet Integrationen aus dem Marktplatz mit Jira, Slack, Cursor, GitHub Copilot Coding Agent, JetBrains und Windsurf. Außerdem stellt es APIs für die Verwaltung von Umgebungen, Konfigurationen und Konten bereit, um benutzerdefinierte Integrationen und die Anbindung an Arbeitsabläufe zu ermöglichen.
Pros and Cons
Pros:
- Korrelieren von Alarmen über die Smartscape-Topologie
- OneAgent erkennt Abhängigkeiten von Anwendungen und Infrastruktur
- PurePath verfolgt Transaktionen bis zu den Ursachen auf Codeebene
Cons:
- Die Netzwerküberwachung bleibt hinter spezialisierten Plattformen zurück
- Benutzerdefinierte Dashboards erfordern einen gewissen Konfigurationsaufwand
 Am besten für kostengünstige Überwachung
- Kostenloser Tarif + 5-tägige kostenlose Testversion + kostenlose Demo verfügbar
- Ab $325/Monat (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.5/5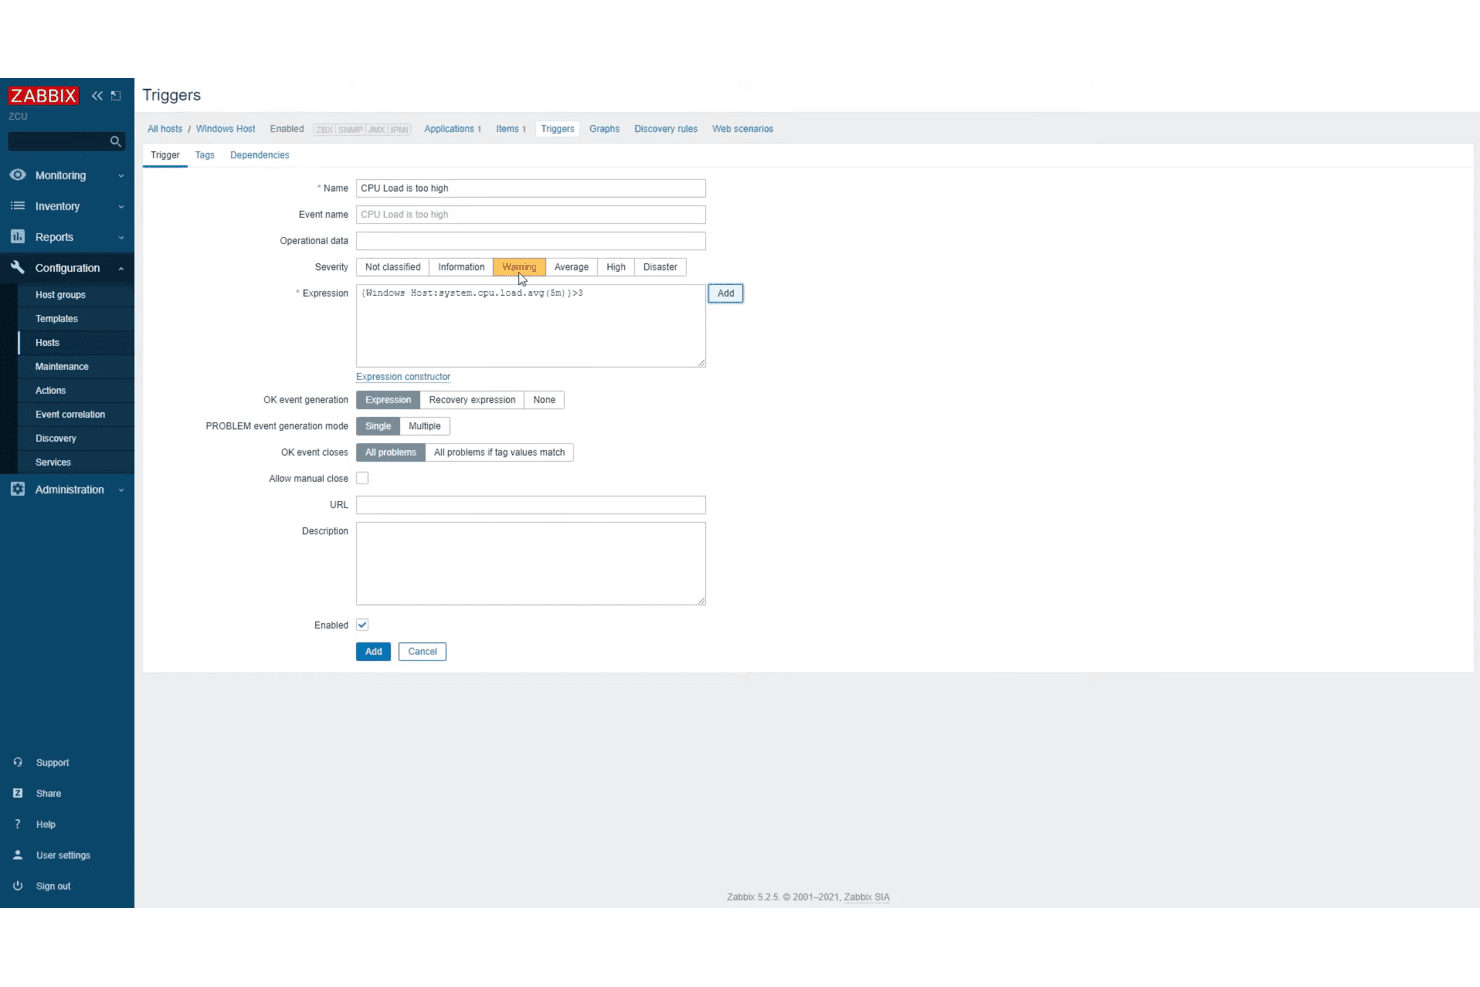
Konfiguration eines Zabbix-Auslösers, der eine Warnung ausgibt, wenn die CPU-Auslastung eines Windows-Hosts einen Schwellenwert überschreitet. Zabbix ist eine quelloffene Überwachungsplattform, die sich an IT-Teams richtet, die umfassende Transparenz über ihre Infrastruktur benötigen – über Server, Netzwerke, Cloudumgebungen, Container und Anwendungen hinweg –, ohne Lizenzgebühren pro Gerät oder Metrik zu zahlen.
Für wen ist Zabbix am besten geeignet?
Zabbix eignet sich hervorragend für IT-Teams, die eine Infrastrukturüberwachung auf Unternehmensniveau benötigen, aber keine Lizenzkosten pro Gerät rechtfertigen können.
Warum ich mich für Zabbix entschieden habe
Ich habe Zabbix als eines der besten Tools ausgewählt, weil kein anderes Tool auf dieser Liste die gerätebezogene Lizenzierung vollständig abschafft und dennoch eine Überwachung auf Unternehmensniveau für Server, Netzwerke, Cloudumgebungen und Container bietet. Der quelloffene Kern hat keine Hostlimits, keine Metrikobergrenzen und keine Funktionsbeschränkungen. Daher zahlt ein Team, das Tausende von Endpunkten verwaltet, genauso wenig Lizenzgebühren wie eines, das zehn verwaltet. Außerdem schätze ich die Funktionen für vorausschauende Auslöser, die anhand historischer Daten abschätzen, wann ein Schwellenwert überschritten wird, bevor dies tatsächlich geschieht.
Wichtige Funktionen von Zabbix
- Regeln zur Ereigniskorrelation: Konfigurieren Sie Regeln, um zusammengehörige Ereignisse zu gruppieren, pendelnde Alarme zu deduplizieren und veraltete Probleme über verschiedene Auslöser und Abfragemethoden hinweg automatisch zu schließen.
- Übersichten für Kosten mehrerer Clouds: Zeigen Sie Infrastrukturkosten für AWS, Azure, Google Cloud und Oracle Cloud in einer einzigen Übersicht an und vergleichen Sie diese.
- Unterstützung für OpenTelemetry APM: Empfangen Sie verteilte Ablaufverfolgungen, Metriken und Protokolle von Anwendungen oder OpenTelemetry-Sammlern über einen Zabbix-Proxy, wobei ClickHouse als Quelle für Telemetriedaten dient.
- Automatisierte Maßnahmen zur Behebung: Führen Sie konfigurierte Skripte oder Befehle als Reaktion auf erkannte Probleme aus, einschließlich des Neustarts von Diensten oder der Neuskalierung von Cloudressourcen.
Zabbix-Integrationen
Zabbix listet 204 offizielle Vorlagen und 570 Marken für 2.010 Lösungen auf, darunter AWS, Azure, Google Cloud Platform, ServiceNow, Slack, PagerDuty, Kafka und RabbitMQ. Die JSON-RPC-API, die REST-Streaming-API, Webhooks und die Python-Bibliothek unterstützen benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Umfassende Transparenz über Server und Netzwerke
- Flexible Warnungen und Ereigniskorrelation
- Prognosen weisen auf bevorstehende Überschreitungen von Metrikschwellenwerten hin
Cons:
- Warnschwellenwerte müssen manuell abgestimmt werden
- Selbst gehostete Bereitstellungen erfordern zusätzliche Datenbankwartung
 Am besten für Cloud-Überwachungsdienste geeignet
- Kostenloser Tarif + 14-tägige kostenlose Testversion + kostenlose Demo verfügbar
- Ab $15/Host/Monat (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.5/5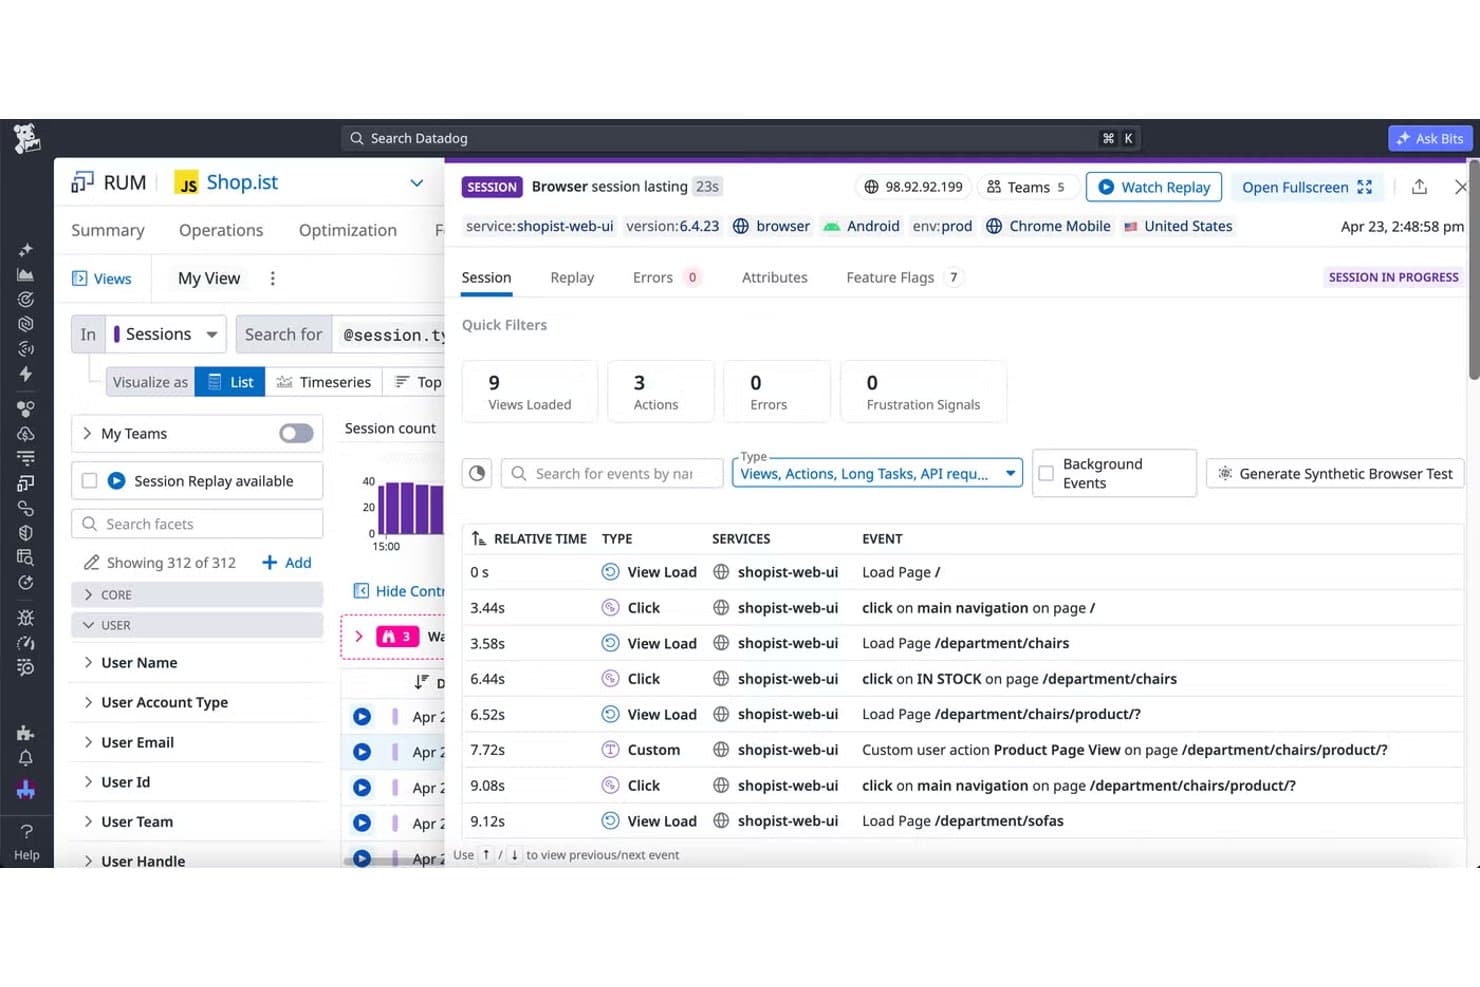
Datadog-RUM-Sitzungsansicht mit den Seitenaufrufen, Klicks und benutzerdefinierten Aktionen eines Nutzers in chronologischer Reihenfolge. Datadog ist eine SaaS-basierte Plattform für die Überwachung, die IT- und DevOps-Teams eine einheitliche Übersicht über Cloud-, hybride und lokale Infrastrukturen bietet – und Metriken, Protokolle, Traces und Sicherheitssignale an einem Ort kombiniert, um den Kontextwechsel während der Reaktion auf Vorfälle zu reduzieren.
Für wen eignet sich Datadog am besten?
Datadog eignet sich besonders für DevOps-Ingenieure und IT-Betriebsteams, die cloudnative oder hybride Umgebungen verwalten und eine einheitliche Übersicht über Infrastruktur, Protokolle, Traces und Sicherheitssignale auf einer Plattform benötigen.
Warum ich Datadog ausgewählt habe
Ich habe Datadog als eine der besten LogicMonitor-Alternativen ausgewählt, weil es speziell für die Cloud-Überwachung entwickelt wurde und Zehntausende von Metriken in AWS, Azure und GCP erfasst und mit Protokollen, Traces und Sicherheitssignalen in einer Ansicht korreliert. Besonders gut gefällt mir Watchdog, das KI-Modul, das automatisch Anomalien erkennt, sodass mein Team während eines Vorfalls nicht manuell eine Flut irrelevanter Daten durchsuchen muss. Auch die Prognosemonitore sind wirklich nützlich: Ich kann CPU- oder Speichertrends mithilfe saisonaler oder linearer Algorithmen modellieren und Alarmschwellen bis zu drei Monate im Voraus festlegen.
Wichtige Funktionen von Datadog
- Infrastruktursuche auf Tag-Basis: Metriken in Ihrer gesamten Infrastruktur mithilfe benutzerdefinierter Tags filtern und analysieren, um Hosts, Container und Cloud-Ressourcen nach beliebigen Dimensionen zu gruppieren.
- Korrelation verschiedener Signale: Infrastrukturmetriken mit Protokollen, Traces und Sicherheitssignalen in einer einzigen Ansicht verknüpfen, um Vorfälle zu untersuchen, ohne zwischen Tools wechseln zu müssen.
- Zuordnung der Gerätetopologie: Netzwerkgeräte, Schnittstellen und physische Verbindungen visualisieren und dabei Datenverkehr, SNMP-Traps, Syslog-Nachrichten und benachbarte Geräte untersuchen.
- Überwachung aktiver Prozesse: Echtzeitaktivitäten auf Prozessebene über Ihre Hosts und Container hinweg anzeigen, einschließlich Ressourcenverbrauch und ausgeführter Befehle, über eine zentrale Oberfläche.
Datadog-Integrationen
Datadog bietet mehr als 1.000 Integrationen, darunter Amazon Web Services, Microsoft Azure, Google Cloud Platform, Kubernetes, Docker, Jira, PagerDuty, OpenTelemetry, PostgreSQL und Redis. Die REST-API und Clientbibliotheken unterstützen benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Korreliert Infrastruktur, Protokolle und Traces
- Benutzerdefinierte Übersichten machen den aktuellen Systemzustand übersichtlich
- Prognosemonitore helfen, Kapazitätstrends vorherzusehen
Cons:
- Nutzungsabhängige Abrechnungen können schwer vorhersehbar sein
- Die Feinabstimmung von Alarmen kann zu Benachrichtigungsmüdigkeit führen
 Am besten für KI-gestützte Datenanalyse
- Kostenloser Tarif verfügbar
- Ab $15/Host/Monat (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.3/5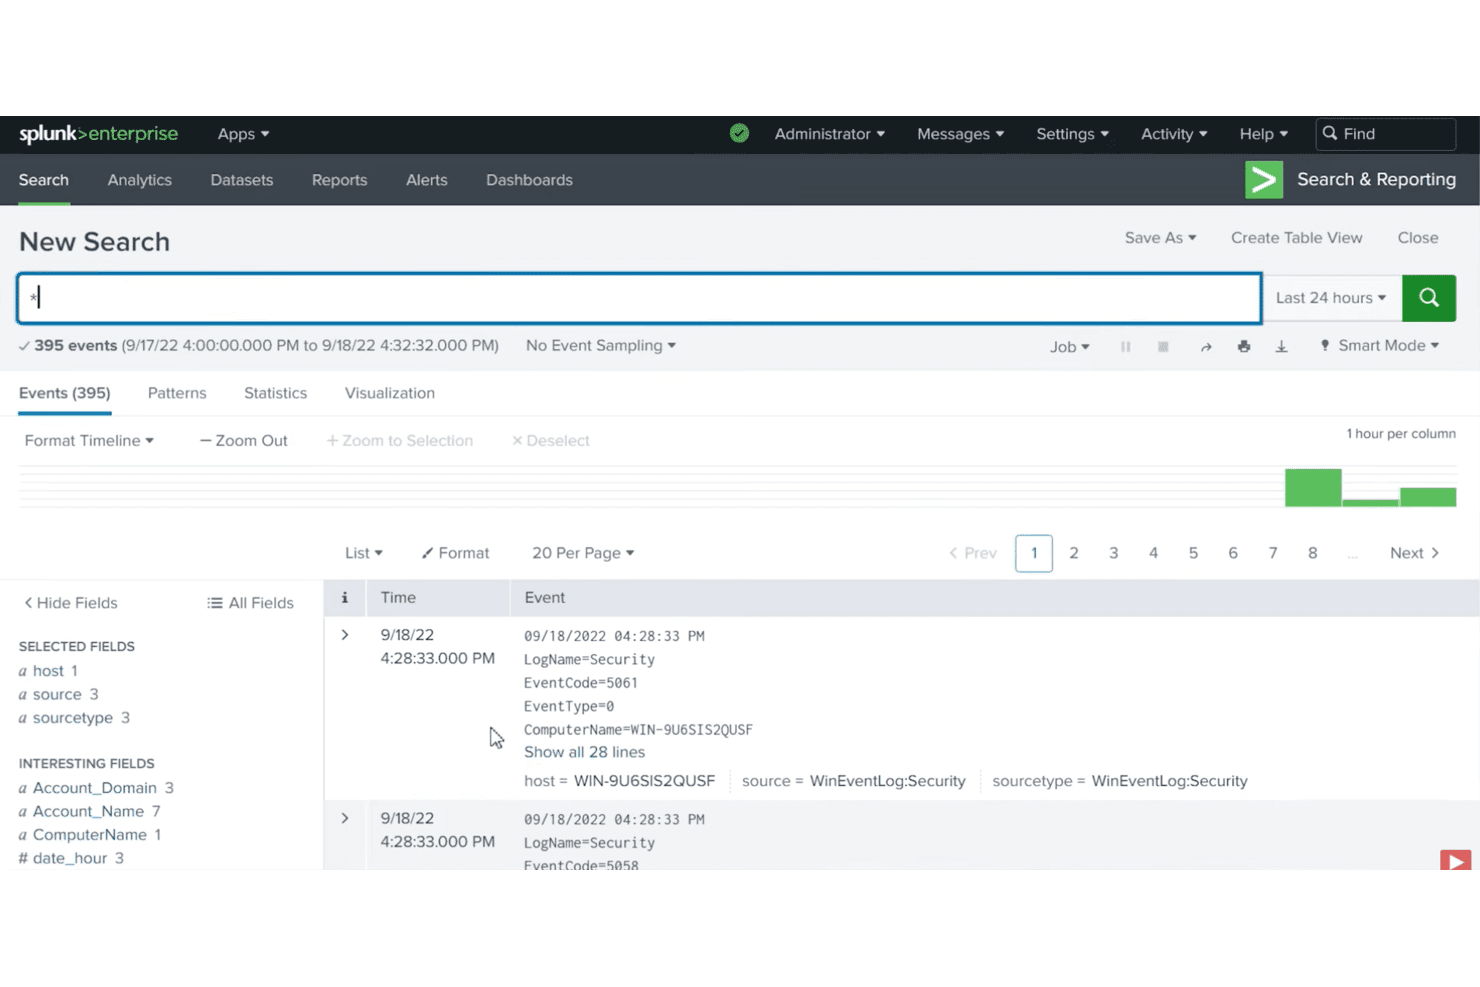
Suchansicht von Splunk Enterprise mit Windows-Sicherheitsereignissen, auswählbaren Feldern und einer Zeitleiste. Splunk Observability Cloud ist eine SaaS-Überwachungsplattform, die Daten zu Infrastruktur, Anwendungsleistung und digitalen Erlebnissen zusammenführt. Damit eignet sie sich besonders für IT- und DevOps-Teams, die eine KI-gestützte Ursachenanalyse in hybriden und Cloud-Umgebungen benötigen.
Für wen ist Splunk am besten geeignet?
Splunk Observability Cloud eignet sich besonders für DevOps- und IT-Betriebsteams in mittelgroßen bis großen Unternehmen, die eine KI-gestützte Ursachenanalyse in hybriden und Cloud-Umgebungen benötigen.
Warum ich Splunk ausgewählt habe
Ich habe Splunk als eine der besten LogicMonitor-Alternativen ausgewählt, weil die KI-SRE-Ebene die Untersuchungsarbeit, die normalerweise bei Ihrem Team liegt, so gut übernimmt. Der KI-Agent zur Fehlerbehebung führt Metriken, Traces und Protokolle zusammen, um wahrscheinliche Ursachen in allgemein verständlicher Sprache aufzuzeigen. Mit dem KI-Assistenten können Sie Daten aus APM, Infrastruktur und Kubernetes abfragen, ohne eine einzige Abfrage schreiben zu müssen. Besonders gefällt mir, dass das NoSample-Tracing 100% der Trace-Daten erfasst, sodass vor der Analyse nichts verloren geht.
Die wichtigsten Funktionen von Splunk
- Infrastruktur-Dashboards: Vorgefertigte Dashboards und Visualisierungen für Cloud-Dienste, Systeme und Kubernetes-Umgebungen bieten Ihrem Team Echtzeittransparenz über den Zustand hybrider Infrastrukturen.
- Dynamische Alarmierung mit Detektoren: Detektoren überwachen Metriksignale und lösen Alarme auf Grundlage von Regeln mit mehreren Bedingungen aus. Benachrichtigungen werden an Tools wie PagerDuty, Slack, ServiceNow und Microsoft Teams gesendet.
- Auf OpenTelemetry basierende Datenerfassung: Erfasst Metriken, Traces und Protokolle mithilfe einer Instrumentierung nach offenen Standards und unterstützt neben mehr als 200 Integrationen auch Prometheus, Telegraf und collectd.
- Log Observer Connect: Verknüpft bereits in der Splunk Cloud Platform oder in Splunk Enterprise gespeicherte Protokolle direkt mit den Workflows zur Fehlerbehebung in Observability Cloud, ohne zusätzliche Kosten.
Splunk-Integrationen
Splunk Observability Cloud dokumentiert mehr als 200 unterstützte Integrationen auf Basis offener Standards, darunter AWS, Microsoft Azure, Google Cloud Platform, Jira, Microsoft Teams, PagerDuty, ServiceNow, Slack und Amazon EventBridge. Außerdem werden OpenTelemetry, Prometheus, Telegraf, collectd und REST-API-Verbindungen unterstützt.
Pros and Cons
Pros:
- Vereinheitlicht Telemetriedaten für eine schnellere Fehlerbehebung
- Fasst wahrscheinliche Ursachen in allgemein verständlicher Sprache zusammen
- Erfasst jeden Trace für Untersuchungen
Cons:
- Die Kosten steigen, wenn mehr Telemetriequellen hinzukommen
- SignalFlow erfordert eine manuelle Feinabstimmung der Detektoren
Learn more about Splunk: Am besten für automatisierten Echtzeit-Datenzugriff geeignet
- 14-tägige kostenlose Testversion + kostenlose Demo verfügbar
- Ab $0.04/Monat
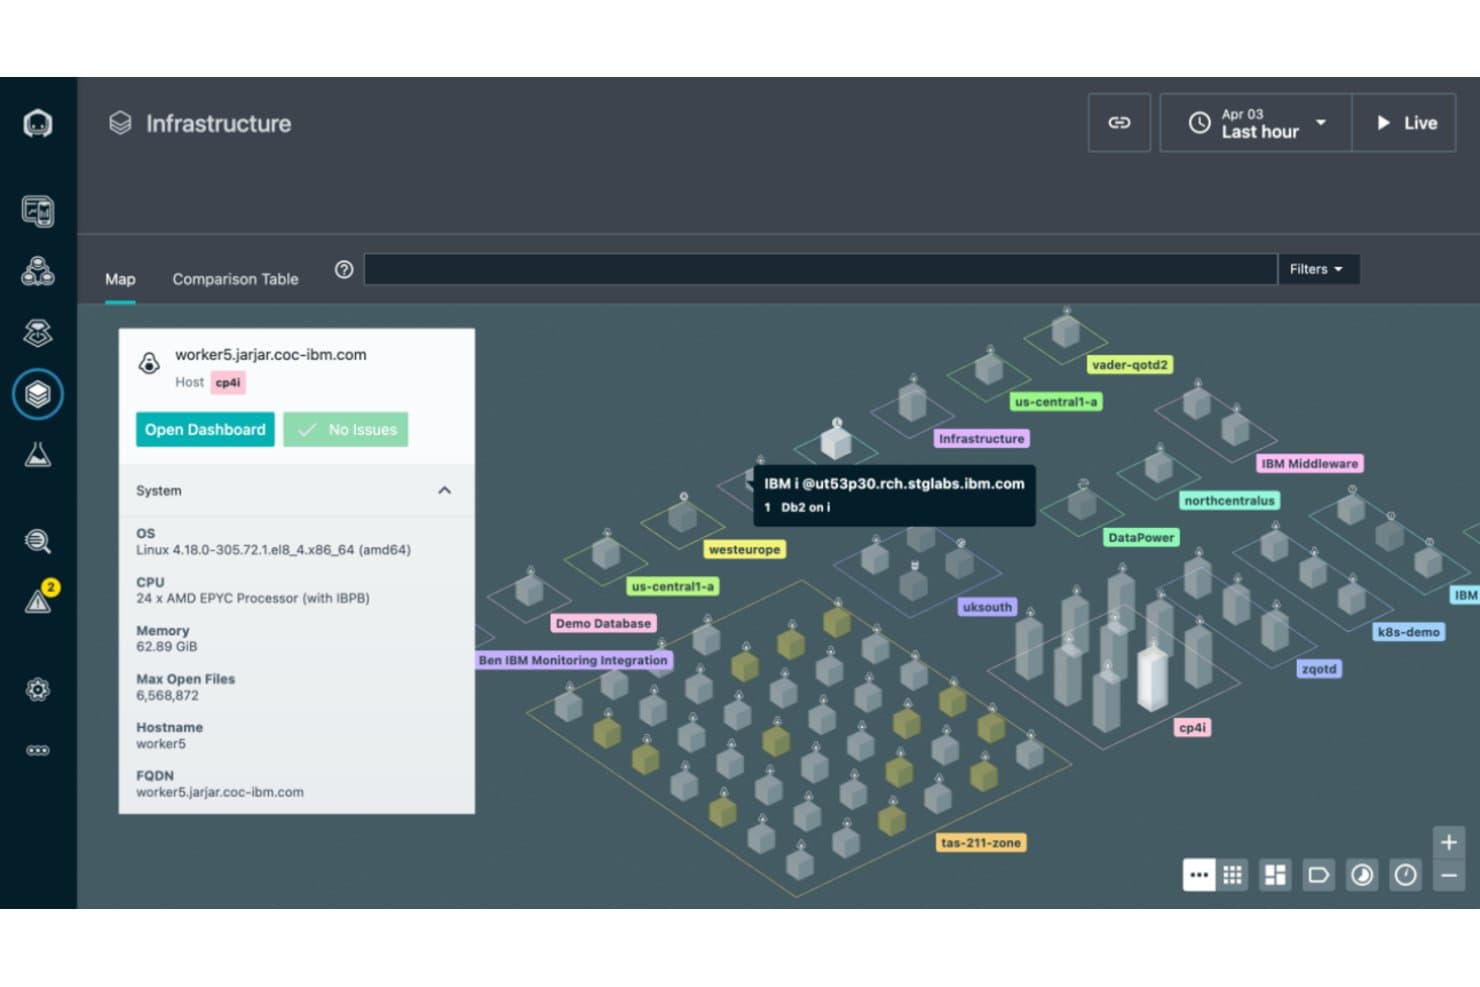
Die Infrastrukturkarte von IBM Instana zeigt nach Zonen gruppierte Hosts mit Hostdetails und Live-Status. IBM Instana ist eine KI-gestützte Observability-Plattform für DevOps-Teams, die automatische Erkennung, Echtzeit-Abbildung von Abhängigkeiten und umfassende Einblicke in die Anwendungsleistung über Cloud-, hybride und containerisierte Umgebungen hinweg benötigen.
Für wen ist IBM Instana am besten geeignet?
IBM Instana eignet sich besonders für DevOps-Ingenieure, die komplexe cloudnative Umgebungen verwalten und automatische Erkennung sowie Abhängigkeitszuordnung in Echtzeit benötigen, ohne manuelle Instrumentierungsarbeit.
Warum ich mich für IBM Instana entschieden habe
Ich habe IBM Instana in meine Top-Auswahl aufgenommen, weil der automatisierte Echtzeit-Datenzugriff tatsächlich einzigartig ist: Der dynamische Graph erkennt kontinuierlich jeden Host, jeden Dienst und jede Abhängigkeit und ordnet sie zu. Dabei wird jede Sekunde aktualisiert, ohne dass eine manuelle Instrumentierung erforderlich ist. Besonders schätze ich die Verbindung mit der agentenbasierten KI zur Ursachenanalyse, die Trace-Statistiken, Topologie und Anomaliesignale korreliert, um schnell wahrscheinliche Ursachen aufzudecken. Bei einem laufenden Vorfall bedeutet das, dass mein Team nicht manuell in Dashboards suchen muss.
Die wichtigsten Funktionen von IBM Instana
- Intelligente Warnmeldungen mit adaptiven Schwellenwerten: Die Warnmeldungs-Engine von Instana verwendet statistische Basiswerte und vordefinierte Vorlagen zur Erkennung von Vorfällen, mit gruppierten Warnmeldungen und Weiterleitung an Slack, PagerDuty, E-Mail und Webhooks.
- Verteiltes Transaktions-Tracing: Instana verfolgt Anfragen über Anwendungskomponenten hinweg ohne Stichprobenbildung und erfasst Details auf Codeebene über Datenbanken sowie Browser- und mobile Ebenen hinweg.
- Integration des OpenTelemetry Collectors: Instana nimmt Telemetriedaten vom OpenTelemetry Collector auf, um Microservices und cloudnative Anwendungen zusammen mit nativ instrumentierten Komponenten zu überwachen.
- Kubernetes-Kosteneinblicke: Instana bietet sofort einsatzbereite Dashboards und historische Ausgabenanalysen zur Überwachung der Ressourcenkosten über Kubernetes-Cluster hinweg.
Integrationen von IBM Instana
IBM Instana unterstützt mehr als 300 Technologien, darunter Slack, PagerDuty, OpenTelemetry Collector, Splunk, Amazon EC2, AWS RDS, Google Cloud, Kubernetes und VMware Tanzu. REST- und GraphQL-APIs sowie SDKs unterstützen benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Echtzeit-Abhängigkeitskarten unterstützen die Untersuchung von Vorfällen
- Automatische Erkennung reduziert den Aufwand für manuelle Instrumentierung
- Schnelle Telemetriedaten helfen bei der Eingrenzung von Dienstproblemen
Cons:
- Lücken bei Netzwerkgeräten können eine separate Überwachung erforderlich machen
- Das Warnmeldungsvolumen erfordert häufig eine manuelle Filterung
Learn more about IBM Instana: Am besten für einheitliche, flexible Beobachtbarkeit
- Kostenloser Tarif verfügbar
- Ab 19 $/Monat
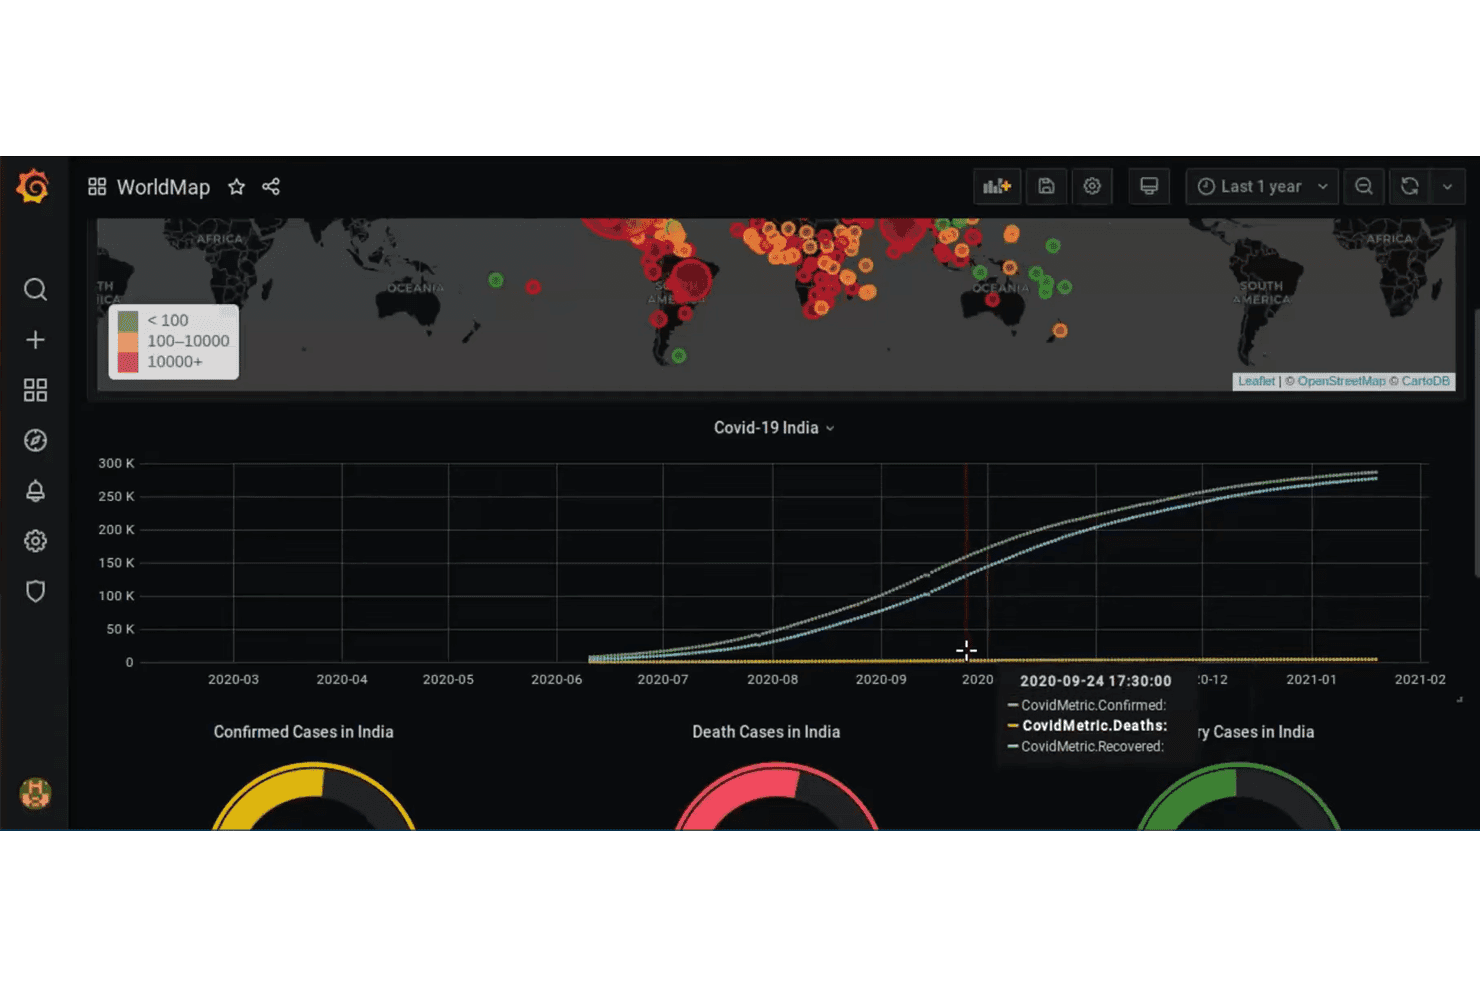
Grafana-Dashboard zur Visualisierung globaler und indischer COVID-19-Falldaten im Zeitverlauf als Karten und Zeitreihendiagramme. Grafana Cloud ist eine verwaltete Plattform zur Beobachtbarkeit, die Metriken, Protokolle, Ablaufspuren und Profile an einem Ort zusammenführt. Damit eignet sie sich besonders für DevOps-Ingenieure und IT-Betriebsteams, die eine flexible, auf offenen Standards basierende Überwachung über Cloud-, Hybrid- und containerisierte Umgebungen hinweg benötigen.
Für wen eignet sich Grafana Cloud am besten?
Grafana Cloud eignet sich besonders für DevOps-Ingenieure und IT-Betriebsteams, die Metriken, Protokolle, Ablaufspuren und Profile in Cloud-nativen und hybriden Umgebungen mithilfe offener Standards wie OpenTelemetry und Prometheus zusammenführen möchten.
Warum ich Grafana Cloud ausgewählt habe
Ich habe Grafana Cloud in meine Top-Auswahl aufgenommen, weil die Plattform Metriken, Protokolle, Ablaufspuren und Profile in einer verwalteten Umgebung zusammenführt. Genau das benötigen Sie, wenn der isolierte Ansatz von LogicMonitor zunehmend einschränkend wirkt. Besonders gut gefällt mir der Wissensgraph, der Beziehungen zwischen Services, Kubernetes-Workloads, Datenbanken und Infrastruktur abbildet. So können Sie einen Latenzanstieg über verteilte Ablaufspuren bis zu einem Engpass in der Datenbank zurückverfolgen, ohne zwischen verschiedenen Tools wechseln zu müssen. Die KI-gestützte Funktion „Untersuchungen“ kann diese Telemetriedaten automatisch analysieren, Hypothesen aufstellen und bei Auslösung eines Alarms einen strukturierten Bericht erstellen.
Wichtige Funktionen von Grafana Cloud
- Adaptive Telemetrie: Aggregiert, sampelt oder verwirft automatisch Telemetriedaten mit geringerem Nutzen aus Metriken, Protokollen, Ablaufspuren und Profilen, um Datenvolumen und Kosten zu kontrollieren.
- Synthetische Überwachung: Prüft API-Endpunkte und Webanwendungen von weltweit verteilten Prüfstellen aus und unterstützt HTTP/HTTPS-, DNS-, TCP- und ICMP-Ping-Prüfungen für Verfügbarkeit und Leistung.
- Grafana-Alloy-Kollektor: Ein quelloffener OpenTelemetry-Kollektor mit Unterstützung für Prometheus-Pipelines, der Metriken, Protokolle, Ablaufspuren und Profile aus Ihrer bestehenden Infrastruktur verarbeitet.
- RBAC mit benutzerdefinierten Rollen: Ermöglicht die Zuweisung detaillierter Berechtigungen zu Benutzern, Teams und Dienstkonten. Benutzerdefinierte Rollen können auf bestimmte Aktionen in Dashboards und Datenquellen beschränkt werden.
Integrationen von Grafana Cloud
Grafana Cloud bietet mehr als 150 Integrationen für Datenquellen, darunter AWS, Microsoft Azure, Google Cloud, SNMP, VMware vSphere und LogicMonitor Devices. REST-, HTTP-, Grafana-Cloud-, Ablaufverfolgungs- und APIs für synthetische Überwachung sowie Webhooks unterstützen benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Flexible Dashboards führen Telemetriedaten zusammen
- Ansichten über mehrere Signale hinweg unterstützen die Untersuchung von Vorfällen
- Der Wissensgraph verknüpft Anomalien mit ihren Ursachen
Cons:
- Die SNMP-Einrichtung erfordert eine manuelle Gerätekonfiguration
- Erweiterte Alarmregeln erfordern Konfigurationsaufwand
Learn more about Grafana Cloud: Am besten für integrierte IT-Lösungen geeignet
- 30-tägige kostenlose Testversion verfügbar
- Preise auf Anfrage
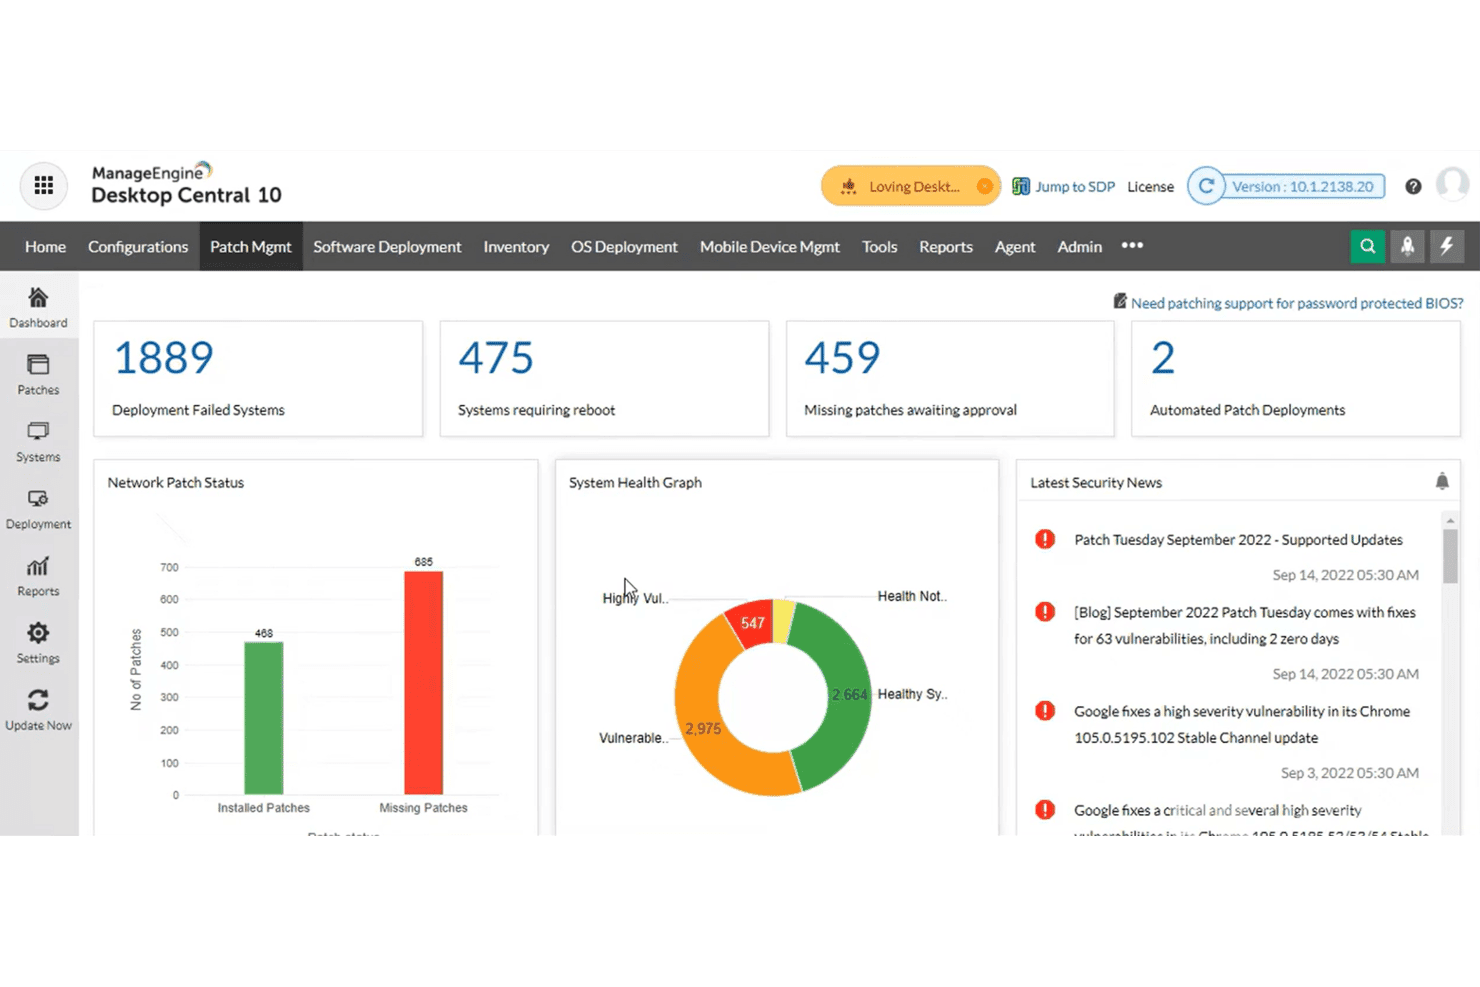
ManageEngine Desktop Central 10 Dashboard für das Patch-Management mit Anzeige des Patch-Status im Netzwerk und des Systemzustands. ManageEngine OpManager ist eine Plattform zur Überwachung von Netzwerken und Infrastrukturen, die sich an IT-Betriebsteams richtet, die komplexe lokale Umgebungen verwalten. Sie bietet umfassende Transparenz über Geräte, Server, Speicher und virtuelle Infrastrukturen sowie KI-gestützte Prognosen und codefreie Workflow-Automatisierung.
Für wen ist ManageEngine am besten geeignet?
ManageEngine OpManager eignet sich besonders für IT-Betriebsteams, die große lokale Umgebungen verwalten und umfassende Transparenz über ihre Infrastruktur benötigen, ohne Preise auf SolarWinds-Niveau zu zahlen.
Warum ich mich für ManageEngine entschieden habe
Ich habe mich für ManageEngine OpManager entschieden, weil es den gesamten Infrastruktur-Stack an einem Ort abdeckt – genau das, was Sie beim Ersetzen von LogicMonitor benötigen. Besonders gut gefällt mir die Topologiekartierung, die automatisch Layer-2-Netzwerkkarten erstellt, sodass Sie einen Fehler direkt von einer Warnung bis zum betroffenen Segment zurückverfolgen können, ohne sich durch separate Tools zu arbeiten. Die KI-gestützte Kapazitätsplanung prognostiziert, wann Geräte Speicherschwellenwerte erreichen, sodass Sie handeln können, bevor es zu einem Ausfall kommt.
Wichtige Funktionen von ManageEngine OpManager
- Codefreie Workflow-Automatisierung: Mit einem Drag-and-drop-Editor können Sie Workflows erstellen, die bei Netzwerkfehlern oder nach einem Zeitplan ausgelöst werden, um Dienste, Prozesse, Dateien und Ordner automatisch zu verwalten.
- 3D-Ansicht der Rechenzentrumsfläche: Erstellt eine 3D-Echtzeitnachbildung Ihres Rechenzentrums und seiner Racks und zeigt den aktuellen Gerätestatus direkt im physischen Layout an.
- Korrelation von Problemen und Ereignissen: Gruppiert zusammengehörige Warnungen in einem einzigen Problemprotokoll mit Schweregrad, Korrelationsmethode und einem Prozentsatz zur Rauschreduzierung, um die Warnungsmüdigkeit zu verringern.
- MCP-Server-Integration: Ermöglicht KI-Clients wie Claude Desktop oder Cursor, über Eingaben in natürlicher Sprache OpManager-Überwachungsdaten einschließlich Gerätezustand, Alarmen und Leistungstrends abzufragen.
Integrationen von ManageEngine
ManageEngine OpManager bietet native Integrationen mit ServiceNow, Jira Service Management, Microsoft Teams, Slack, Grafana, Microsoft Sentinel und ManageEngine ServiceDesk Plus. Die REST-API verwendet eine OpenAPI-Dokumentation, und Webhooks unterstützen benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Einheitliche Transparenz über Netzwerke, Server und Speicher
- Topologiekarten helfen dabei, Fehler bis zu den betroffenen Segmenten zurückzuverfolgen
- Kapazitätsprognosen weisen frühzeitig auf Ressourcenengpässe hin
Cons:
- Standardmäßige Warnungsprofile können übermäßig viele Benachrichtigungen erzeugen
- Die Konfiguration benutzerdefinierter Berichte kann Zeit in Anspruch nehmen
Learn more about ManageEngine: Am besten für anpassbare Übersichtsseiten
- Kostenloser Tarif + 30-tägige Testversion + Demo verfügbar
- Ab $200/Monat (jährlich abgerechnet)
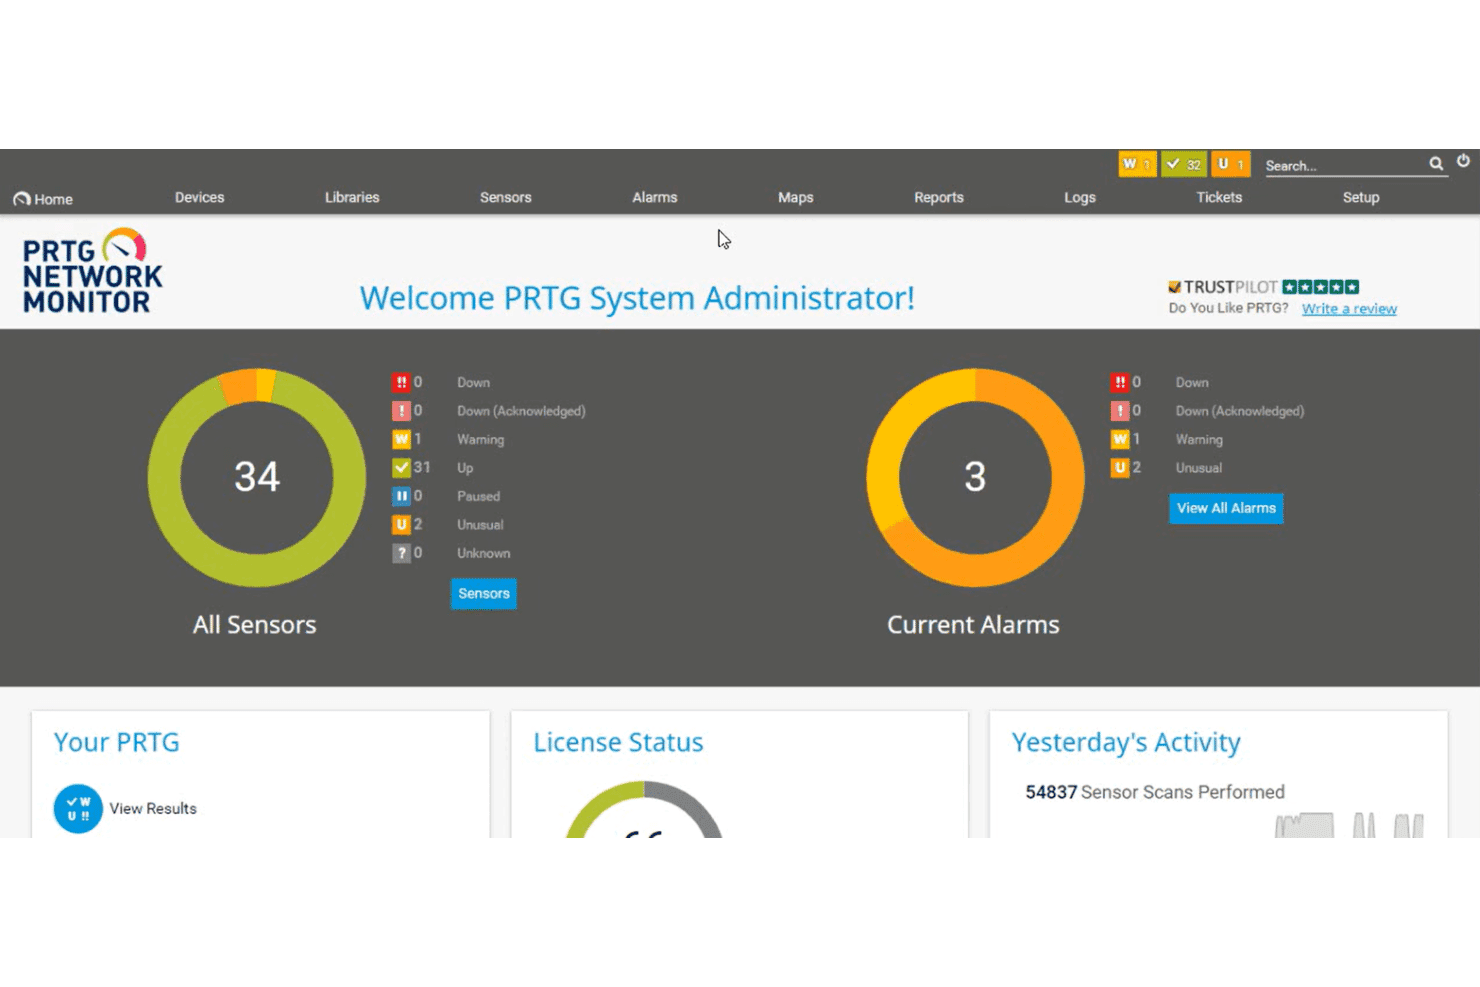
Die Übersichtsseite von PRTG Network Monitor fasst den Sensorstatus und die aktuellen Alarme auf einen Blick zusammen. Paessler PRTG ist ein lokal betriebenes Netzwerküberwachungstool, das Netzwerkadministratoren und IT-Teams anspricht, die umfassende Transparenz über IT-, OT- und IoT-Infrastrukturen benötigen – einschließlich Geräten, Datenverkehr, Servern und Anwendungen von einer einzigen Plattform aus.
Für wen ist Paessler PRTG am besten geeignet?
PRTG eignet sich besonders für Netzwerkadministratoren und IT-Teams, die lokale oder hybride Umgebungen verwalten und eine hochgradig visuelle, sensorbasierte Überwachung benötigen, die sie an ihre Infrastruktur anpassen können.
Warum ich Paessler PRTG ausgewählt habe
Ich habe Paessler PRTG als eine der besten LogicMonitor-Alternativen ausgewählt, weil die Anpassungsmöglichkeiten für Übersichtsseiten und Karten weiter reichen als bei den meisten von mir getesteten Tools. Ich kann mit einem Editor zum Ziehen und Ablegen Infrastrukturansichten erstellen, Symbole für den Gerätestatus, geografische Karten und benutzerdefinierte HTML-Hintergründe integrieren und diese anschließend öffentlich teilen oder per iFrame einbetten. Mit über 300 verfügbaren Elementen kann ich Anzeigen im NOC-Stil erstellen, die standortweite Probleme auf einen Blick sichtbar machen, ohne dass ich mich durch Menüs arbeiten muss.
Die wichtigsten Funktionen von Paessler PRTG
- Sensorbasierte automatische Erkennung: Scannt Netzwerksegmente mit Ping, SNMP und WMI und wendet anschließend automatisch Geräte- und Sensortemplates an, um die Überwachung zu starten.
- Benachrichtigungen über mehrere Kanäle mit Eskalation: Versendet Benachrichtigungen per E-Mail, SMS, Push, Teams oder Slack mit konfigurierbaren Eskalationsstufen und geplanten Zeitfenstern für Alarme.
- KI-gestützte Anomalieerkennung: Analysiert historische Sensordaten, um Basiswerte festzulegen, und benachrichtigt bei Abweichungen der überwachten Werte von den erwarteten Mustern.
- Geplante und bedarfsgesteuerte Berichte: Erstellt Berichte im HTML-, PDF-, CSV- oder XML-Format für einzelne Sensoren oder Gruppen nach einem festgelegten Zeitplan oder manuell ausgelöst.
Integrationen von Paessler PRTG
Paessler PRTG bietet native Integrationen mit Microsoft Teams, Slack und PagerDuty. Außerdem stellt es REST-APIs für benutzerdefinierte Integrationen sowie für die Überwachung von XML- oder JSON-Daten bereit.
Pros and Cons
Pros:
- Benutzerdefinierte Karten machen standortweite Probleme sichtbar
- Die automatische Erkennung deckt vielfältige Infrastruktursensoren ab
- Eskalationsalarme helfen dabei, Serviceprobleme frühzeitig zu erkennen
Cons:
- Die Topologie zur Ursachenanalyse erfordert eine separate kostenpflichtige Erweiterung
- Die Tiefe der Überwachung von Cloud-Umgebungen bleibt hinter anbieterorientierten Plattformen zurück
Learn more about Paessler PRTG: Am besten für Open-Source-Observability
- 30-tägige kostenlose Testversion + kostenlose Demo verfügbar
- Ab $49/Monat
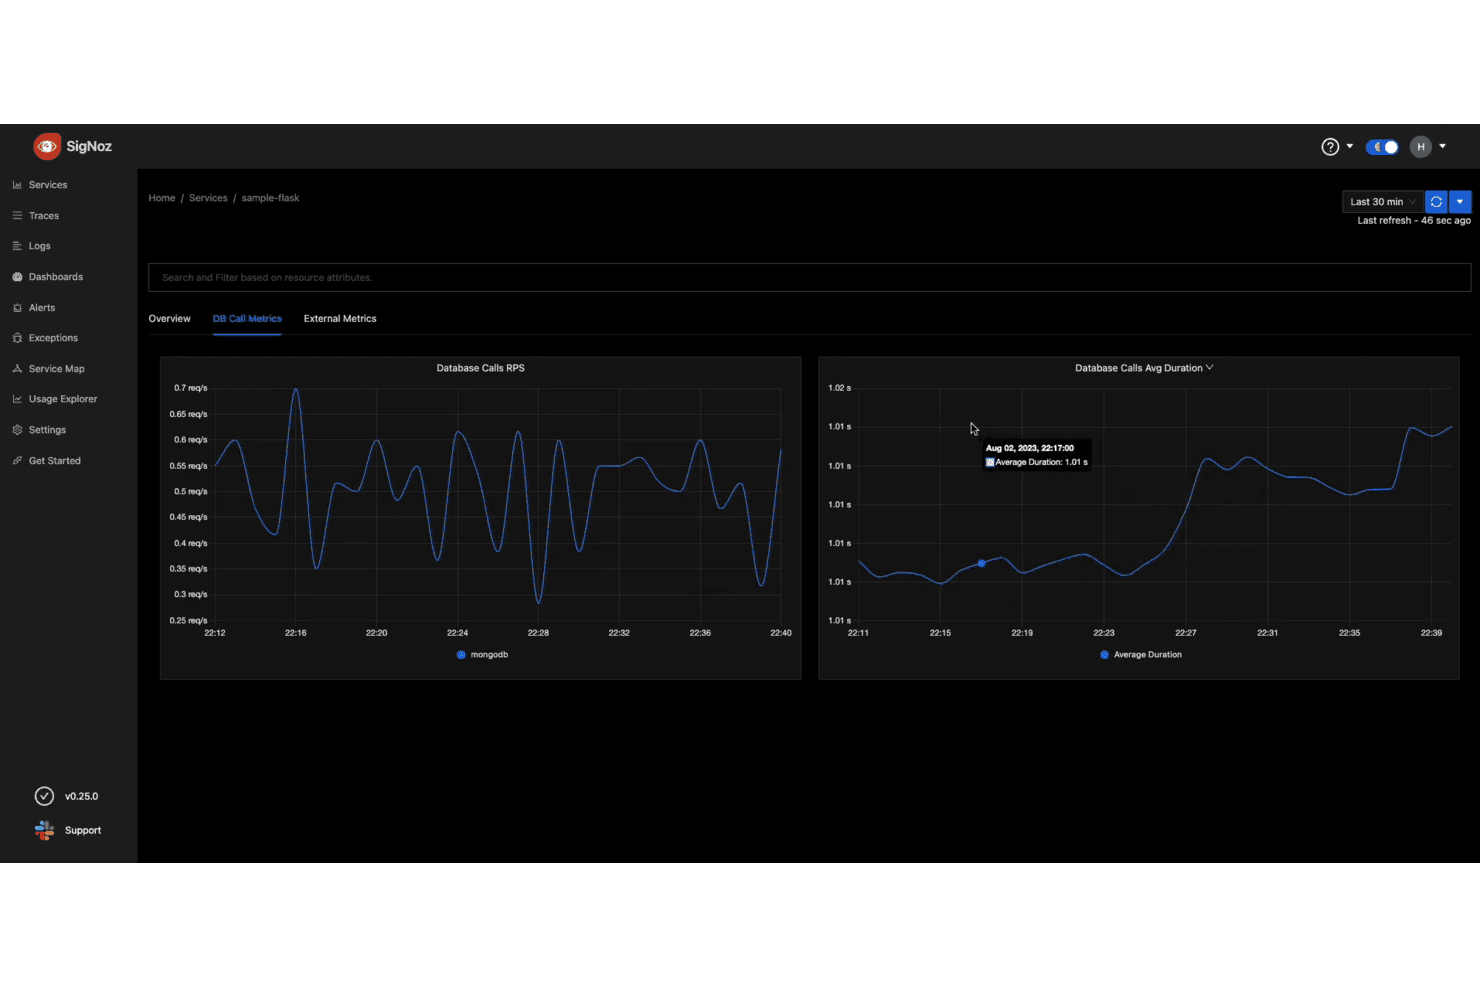
SigNoz-Dienstansicht mit der Aufrufrate und der durchschnittlichen Dauer von MongoDB-Datenbankaufrufen im Zeitverlauf. SigNoz ist eine auf OpenTelemetry basierende Observability-Plattform, die sich an DevOps-Ingenieure und Infrastrukturteams richtet, die einheitliche Protokolle, Metriken und Traces wünschen, ohne die undurchsichtige Abrechnung pro Host, die bei Tools wie Datadog oder New Relic anfällt.
Für wen ist SigNoz am besten geeignet?
SigNoz eignet sich besonders für DevOps-Ingenieure und Plattformteams, die vollständige Kontrolle über ihren Observability-Stack wünschen, ohne Gebühren pro Host zu zahlen.
Warum ich SigNoz ausgewählt habe
Ich habe SigNoz als eine der besten Lösungen ausgewählt, weil es die einzige OpenTelemetry-native Plattform auf dieser Liste ist, mit der sich der gesamte Observability-Stack ohne Gebühren pro Host oder Anbieterbindung selbst hosten lässt. Mir gefällt besonders, dass Protokolle, Metriken und Traces an einem Ort zusammengeführt werden. Wenn ein Alarm ausgelöst wird, kann ich direkt von einer Kante in der Service Map, die eine erhöhte P99-Latenz anzeigt, zum zugehörigen Trace und Protokoll springen, ohne zwischen Tools wechseln zu müssen. Die KI-gestützte Alarmkorrelation über den MCP-Server ist eine wirklich nützliche Ergänzung und ermöglicht es mir, zu ermitteln, welcher vorgelagerte Dienst für einen Ausschlag verantwortlich ist, bevor ich überhaupt ein Terminal öffne.
Wichtige Funktionen von SigNoz
- Alarmierung über mehrere Signaltypen: Erstellen Sie Alarme für Metriken, Protokolle, Traces, Ausnahmen und Anomalien, mit Routing-Richtlinien, die Benachrichtigungen an Slack, PagerDuty, Opsgenie, Microsoft Teams, E-Mail oder Webhooks weiterleiten.
- OpenTelemetry-native Instrumentierung: Erfassen und übertragen Sie Telemetriedaten aus Anwendungen, Hosts, Kubernetes und Cloud-Diensten mithilfe des OpenTelemetry Collectors, ohne proprietäre Agents.
- Abfrage-Builder: Filtern, aggregieren und wenden Sie mathematische Funktionen auf Protokolle, Metriken und Traces über eine einzige Oberfläche an; außerdem werden PromQL und ClickHouse SQL unterstützt.
- SOC 2 Typ II- und HIPAA-Konformität: SigNoz Cloud erfüllt die Standards SOC 2 Typ II und HIPAA; Rechenzentren sind in den USA, der EU und Indien verfügbar.
SigNoz-Integrationen
SigNoz dokumentiert 112 Integrationen, darunter AWS, Azure, Google Cloud Platform, PostgreSQL, MySQL, Redis, MongoDB, NGINX und RabbitMQ. Außerdem bietet es eine API für benutzerdefinierte Integrationen und unterstützt Verbindungen des OpenTelemetry Collectors für SNMP-fähige Firewalls, Router und Switches.
Pros and Cons
Pros:
- Beim Selbst-Hosting behalten Sie die Kontrolle über Ihre Telemetriedaten
- Protokolle, Metriken und Traces werden für Untersuchungen gemeinsam dargestellt
- KI-gestützte Alarmkorrelation beschleunigt die Fehleranalyse
Cons:
- SNMP-Abfragen erfordern eine manuelle Zuordnung von OIDs
- Selbst gehostetes ClickHouse erfordert laufende Optimierung
Learn more about SigNoz: 10Am besten für KI-basierte Einblicke
Last9
- Kostenloser Tarif und kostenlose Demo verfügbar
- Preise auf Anfrage
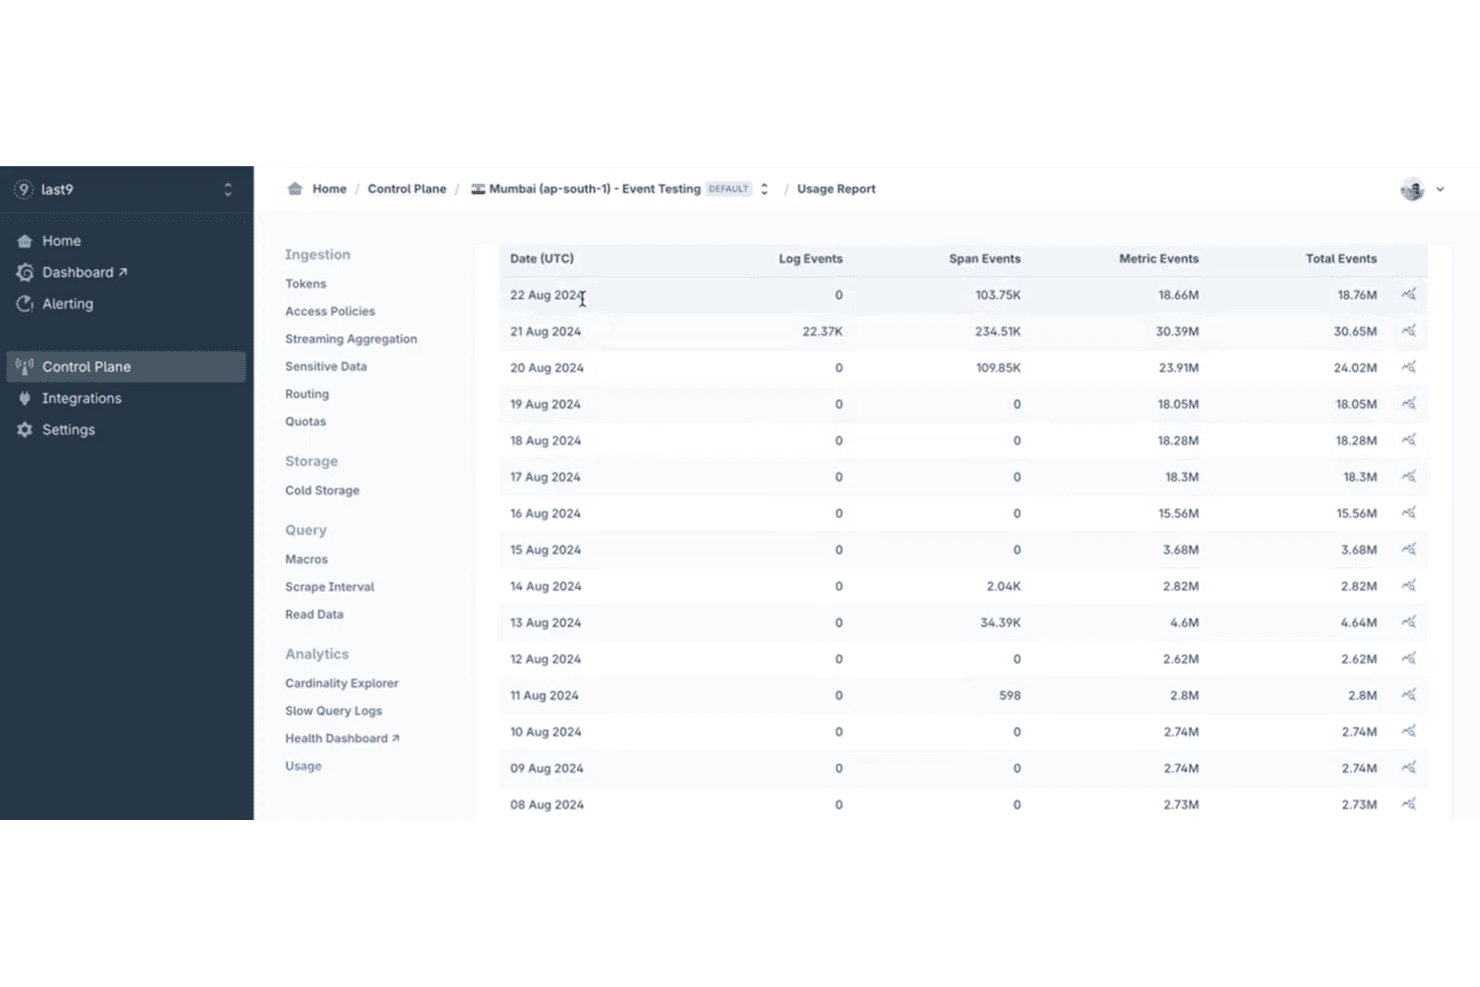
Last9-Steuerungsebenen-Nutzungsbericht mit den täglichen Volumina von Protokoll-, Ablaufverfolgungs- und Metrikereignissen nach Datum. Last9 ist eine auf OpenTelemetry basierende Plattform für Beobachtbarkeit für Entwicklungs- und Betriebsteams, die Metriken, Protokolle und Ablaufverfolgungen vereinheitlichen müssen – mit KI-gestützter Untersuchung und Unterstützung hoher Kardinalität, wodurch die Plattform besonders für Teams geeignet ist, die aus kostenintensiven Überwachungswerkzeugen herauswachsen.
Für wen eignet sich Last9 am besten?
Last9 eignet sich besonders für DevOps-Teams und Teams für die Zuverlässigkeit von IT-Systemen, die eine auf OpenTelemetry basierende Beobachtbarkeit mit integrierter KI-gestützter Untersuchung benötigen.
Warum ich Last9 ausgewählt habe
Ich habe Last9 als eine der besten Lösungen ausgewählt, weil die KI-basierte Untersuchung tiefer geht als eine typische Warnmeldungsübersicht. Last9 AI kann Ihre Echtzeitmetriken, Protokolle und Ablaufverfolgungen gemeinsam abfragen, anschließend korrelierte Belege hervorheben und Warnmeldungsregeln oder Übersichten zur Genehmigung vorschlagen. Die Erkennungskarte visualisiert Echtzeitabhängigkeiten zwischen Diensten mit Fehlerraten und P95-Latenz. Wenn ein Vorfall ausgelöst wird, kann ich dadurch den Auswirkungsbereich über Mikrodienste hinweg verfolgen, ohne die Signale manuell zusammenführen zu müssen.
Wichtige Funktionen von Last9
- Auf OpenTelemetry basierende Datenerfassung: Last9 erfasst Metriken, Protokolle und Ablaufverfolgungen nativ über OpenTelemetry, ohne dass anbieterspezifische Agenten erforderlich sind.
- PromQL- und LogQL-Warnmeldungsregeln: Warnmeldungsregeln können direkt in PromQL oder LogQL geschrieben oder mithilfe eines geführten Editors für Regeldefinitionen erstellt werden.
- Gestaffelte Aufbewahrung von Metriken: Daten werden über die Ebenen Blaze, Hot und Cold gespeichert und standardmäßig bis zu einem Jahr aufbewahrt, ohne Downsampling oder Rollups.
- SNMP-basierte Überwachung von Netzwerkgeräten: Last9 erfasst Telemetriedaten von Switches, Routern, Firewalls und USV-Geräten mithilfe des SNMP-Receivers des OpenTelemetry Collectors oder des Prometheus SNMP Exporters.
Last9-Integrationen
Last9 führt über 100 Integrationen auf, darunter AWS, Azure, Google Cloud, Kubernetes, Prometheus, Grafana, Slack, Datadog und New Relic. Außerdem bietet die Plattform eine REST-API und einen MCP-Server für benutzerdefinierte Integrationen und Workflows mit KI-Agenten.
Pros and Cons
Pros:
- Korreliert Protokolle, Metriken und Ablaufverfolgungen mithilfe von KI
- Rezensenten berichten von schnellerem Debugging über mehrere Dienste hinweg
- Nutzer loben fokussierte, umsetzbare Warnmeldungen
Cons:
- Die lokale Bereitstellung der Plattform ist nicht dokumentiert
- Einige Rezensenten berichten von Verzögerungen bei der Aktualisierung der Übersichtsseite
Learn more about Last9:
Weitere LogicMonitor-Alternativen
Hier sind einige weitere LogicMonitor-Alternativen, die es nicht in meine Auswahlliste geschafft haben, aber dennoch einen Blick wert sind:
- 11NinjaOneBeste Lösung für die Endpunktverwaltung
- 12ObkioAm besten zur Optimierung der Netzwerkleistung geeignet
- 13Azure MonitorIdeal für Einblicke in Azure-Dienste
Wie ich LogicMonitor-Alternativen bewerte
Ich prüfe jede Option anhand von zwei Ebenen: dem Mindeststandard, den ein Tool erfüllen muss—hybrides Monitoring, flexible Datenerfassung, intelligente Alarmierung—und dem, was die besten Lösungen unterscheidet.
Kernfunktionen (Grundvoraussetzungen für diese Liste)
Wenn ich Tools für meine Liste auswähle, bewerte ich jedes einzelne auf einer Skala von 0 (bietet die Funktion nicht) bis 5 (hervorragend in diesem Bereich) für jede unten aufgeführte Kernfunktionalität. Anschließend rechne ich die Gesamtpunktzahl des Tools in einen Prozentsatz um. Jedes Tool muss eine Mindestgesamtpunktzahl von 75 % erreichen, um für die Aufnahme in Betracht gezogen zu werden.
- Hybrides Infrastruktur-Monitoring: Ich prüfe, ob jedes Tool Metriken von lokalen Servern, Cloud-Workloads, Containern und Netzwerkgeräten in einer einzigen Ansicht zusammenführen kann.
- Flexible Methoden zur Datenerfassung: Jedes Tool sollte agentenbasierte und agentenlose Erfassung über Protokolle wie SNMP, WMI und REST-APIs unterstützen, um heterogene Umgebungen abzudecken.
- Intelligente Alarmierung & AIOps: Ich achte auf dynamische Schwellenwerte und Alarmerkennung mit Korrelation, die durch Störgeräusche filtern – und nicht nur auf statische Regeln, die Ihren Posteingang bei normalen Lastspitzen überfluten.
- Dashboards & Reporting: Gute Dashboards ermöglichen SLA-basierte Übersichten für das Management und detaillierte Analyse-Panels für Ingenieure, ohne dass ein separates BI-Tool benötigt wird.
- Integrations-Ökosystem: Ich bewerte, wie gut jedes Tool sich mit ITSM-Plattformen, Chattools und Automatisierungssystemen verbindet, die Ihr Team tagtäglich bereits nutzt.
- Skalierbare Multi-Tenant-Architektur: Für MSPs und verteilte Teams prüfe ich die Granularität der rollenbasierten Zugriffskontrolle, Mandantentrennung sowie ob Ansichten pro Kunde oder Geschäftseinheit eingeschränkt werden können.
Nachdem ich eine Liste von Tools habe, die diese Kriterien erfüllen, betrachte ich, was jedes einzelne von anderen unterscheidet.
Unterscheidungsmerkmale (Was Anbieter differenziert)
Hiermit vergleiche und kontrastiere ich verschiedene Anbieter:
Herausragende Funktionen
Automatische Erkennung mit Topologie-Mapping ist ein wesentliches Unterscheidungsmerkmal. Wenn ein Tool die Service-Abhängigkeiten selbstständig abbildet, verbringt Ihr Team weniger Zeit mit der Dokumentation der Infrastruktur und mehr Zeit mit der Lösung realer Probleme. Ich achte ebenfalls auf integrierte Log-Analyse und APM zusätzlich zu Infrastrukturmetriken – Tools wie Datadog und Dynatrace bündeln dies, sodass weniger Kontextwechsel nötig sind. Ereignisbasierte Automatisierung ist ebenso wichtig, besonders wenn Ihr Team direkt von der Monitoring-Plattform aus Remediation-Runbooks ausführen oder Konfigurationsabweichungen nachverfolgen muss.
Mehr als nur Funktionen
Transparente Preisgestaltung ist wichtig, wenn Sie LogicMonitor hinter sich lassen. Ich prüfe, ob ein Anbieter pro Gerät, pro Host oder nach ingestierten Daten abrechnet – und wie berechenbar die Kosten mit wachsendem Umfang bleiben. Flexibilität beim Deployment ist ein weiterer Schlüsselfaktor. Einige Teams benötigen SaaS, während andere (z.B. regulierte Branchen) selbstgehostete oder abgeschottete Lösungen brauchen; Tools wie Zabbix und PRTG bieten On-Premise-Modelle, während Datadog nur als SaaS verfügbar ist. Ich berücksichtige auch die Time-to-Value: Wie schnell gelangen Sie von der Ersteinrichtung zu aussagekräftigen Dashboards und verwertbaren Alarmen?
Warum nach einer LogicMonitor-Alternative suchen?
Obwohl LogicMonitor eine gute Wahl für Produktivitätssoftware ist, gibt es mehrere Gründe, warum manche Nutzer nach alternativen Lösungen suchen. Möglicherweise suchen Sie aus folgenden Gründen nach einer anderen Option:
- Sie benötigen mehr Anpassungsmöglichkeiten
- Ihr Team benötigt eine bessere Skalierbarkeit
- Sie möchten Kosten sparen
- Ihr Unternehmen benötigt bestimmte Integrationen
- Sie suchen nach einfacheren Benutzeroberflächen
- Sie benötigen besseren regionalen Support
Wenn Sie sich in einem dieser Punkte wiedererkennen, sind Sie hier richtig. Meine Liste enthält mehrere Optionen für Produktivitätssoftware, die besser für Teams geeignet sind, die mit diesen Herausforderungen bei LogicMonitor konfrontiert sind und nach alternativen Lösungen suchen.
Funktionen
Hier sind einige der wichtigsten Funktionen von LogicMonitor, die Ihnen dabei helfen, die Angebote alternativer Lösungen gegenüberzustellen und zu vergleichen:
- Einheitliches Monitoring: Bietet umfassendes Monitoring von Infrastruktur, Cloud und Protokollen und unterstützt die großen Cloud-Anbieter.
- AIOps-Integration: Nutzt KI-gestützte Tools für Ereignisintelligenz und Automatisierung, um die betriebliche Effizienz zu steigern.
- Prädiktive Analysen: Bietet Ursachenanalysen und Einblicke in Services, um die Behebung von Vorfällen zu verbessern.
- Umfangreiche Integrationen: Bietet mehr als 3.000 Technologieintegrationen für dynamische Skalierung und Ausfallsicherheit.
- Anpassbare Dashboards: Ermöglichen es Ihnen, auf Ihre spezifischen Anforderungen zugeschnittene Dashboards in Echtzeit zu erstellen und zu teilen.
- Anomalieerkennung: Erkennt ungewöhnliches Verhalten proaktiv, um Auswirkungen auf Benutzer zu verhindern.
- Dynamische Schwellenwerte: Legt intelligente Schwellenwerte automatisch auf Grundlage historischer Daten fest.
- API und Integrationen: Erweitert die Funktionalität durch APIs und Integrationen über verschiedene Technologien hinweg.
- Unterstützung für Cloud und Multi-Cloud: Überwacht Container und große Cloud-Anbieter wie AWS, Google Cloud, Microsoft Azure und Oracle Cloud.
- Protokollverwaltung: Bietet Funktionen zur Verwaltung und Analyse von Protokollen.