

Als erfahrener Profi, der mit APIs, Microservices und zahlreichen Full-Stack-Technologien arbeitet, weiß ich, welche entscheidende Rolle eine effektive Leistungsüberwachung spielt. Im Laufe der Jahre habe ich die Vorteile umfassender AIOps-Plattformen aus erster Hand erlebt, darunter auch diese Alternativen zu Dynatrace, die eine schnelle Fehlerbehebung und Ursachenanalyse ermöglichen.
Diese Dynatrace-Alternativen sind nicht nur benutzerfreundlich, sondern überzeugen auch mit ihren leistungsstarken Überwachungsfunktionen. Die nahtlose Integration in beliebte Plattformen wie Slack trägt dazu bei, die Teamkommunikation in kritischen Situationen zu verbessern. Mit umfangreichen Profiling-Funktionen und modularen Lösungen steht Ihnen eine leistungsfähige Überwachungsplattform zur Verfügung, die Ihren Technologiestack und Ihre Gesamtproduktivität steigern kann.
Was ist Dynatrace?
Dynatrace ist eine Plattform zur Überwachung der Anwendungsleistung (APM), mit der Sie verfolgen, analysieren und optimieren können, wie Ihre Anwendungen und Ihre Infrastruktur ausgeführt werden. Sie wird von DevOps-Teams, SREs und IT-Verantwortlichen eingesetzt, die Probleme frühzeitig erkennen und die Benutzererfahrung verbessern müssen. Echtzeitüberwachung, KI-gestützte Warnmeldungen und durchgängige Ablaufverfolgung helfen dabei, Verlangsamungen zu erkennen, Ursachen zu ermitteln und den reibungslosen Betrieb von Systemen sicherzustellen. Insgesamt unterstützt Dynatrace Ihr Team dabei, Leistungsprobleme frühzeitig zu erkennen, bevor sie sich auf die Benutzer auswirken.
Warum Sie unseren Software-Empfehlungen vertrauen können
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Unser Team testet und bewertet Software seit 2012. Als Tech-Führungskräfte wissen wir selbst, wie schwierig – und wichtig – es ist, die richtige Software auszuwählen.
Für diesen Leitfaden haben wir Tools mithilfe von praktischen Tests und unabhängiger Recherche bewertet und dabei unsere Bewertungskriterien angewendet.
Unsere Bewertungen spiegeln unser menschliches redaktionelles Urteilsvermögen wider, keine Verkaufsstrategie.
Expertenprüfer:
- Paulo Gardini MiguelTech-Direktor
 Tim FisherVP für KI
 Gabriel RosasTech Lead & Software-Architekt
 Christhian GruhnTech Lead & Plattform-Architekt

Vergleichstabelle der Dynatrace-Alternativen
Diese Vergleichstabelle fasst die Preisinformationen meiner besten ausgewählten Dynatrace-Alternativen zusammen:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Am besten für die Fehlerbehebung in Echtzeit | Kostenloser Tarif verfügbar | Ab $26/Monat (jährlich abgerechnet) | Website | |
| 2 | Am besten für umfassende Technologieunterstützung | Kostenloser Plan verfügbar | Ab $32.92/Monat (jährlich abgerechnet) | Website | |
| 3 | Am besten für vielfältige Anwendungsumgebungen | 30-tägige kostenlose Testversion | Ab $10/Monat | Website | |
| 4 | Am besten für umfassende Überwachung der IT-Infrastruktur | 30-tägige kostenlose Testversion | Ab $2,595 einmalig | Website | |
| 5 | Am besten für die einheitliche Überwachung von Cloud-Diensten | Nein | Ab $15/Monat (jährlich abgerechnet) | Website | |
| 6 | Am besten für die Open-Source-Überwachung auf Unternehmensebene geeignet | Nein | Kostenlos | Website | |
| 7 | Beste Lösung für die Echtzeit-Transparenz der Geschäftsleistung | Nein | Ab $6/vCPU/Monat (jährlich abgerechnet) | Website | |
| 8 | Am besten geeignet für die Abfrage von Telemetriedaten in einem einheitlichen Datenspeicher | Nein | $12/Benutzer/Monat (jährlich abgerechnet) | Website | |
| 9 | Am besten für Protokollverwaltung und Sicherheitsanalysen | Nein | $108 pro Benutzer und Monat (jährlich abgerechnet) | Website | |
| 10 | Am besten für Datenanalyse und Erkenntnisse im großen Maßstab | Nein | $150/user/month | Website |


Bewertungen der besten Dynatrace-Alternativen
Im Folgenden finden Sie meine ausführlichen Zusammenfassungen der besten Dynatrace-Alternativen, die es in meine Auswahl geschafft haben. In meinen Bewertungen erhalten Sie einen detaillierten Überblick über die wichtigsten Funktionen, Vor- und Nachteile, Integrationen und idealen Anwendungsfälle jedes Tools, damit Sie die beste Lösung für sich finden.
 Am besten für die Fehlerbehebung in Echtzeit
- Kostenloser Tarif verfügbar
- Ab $26/Monat (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.5/5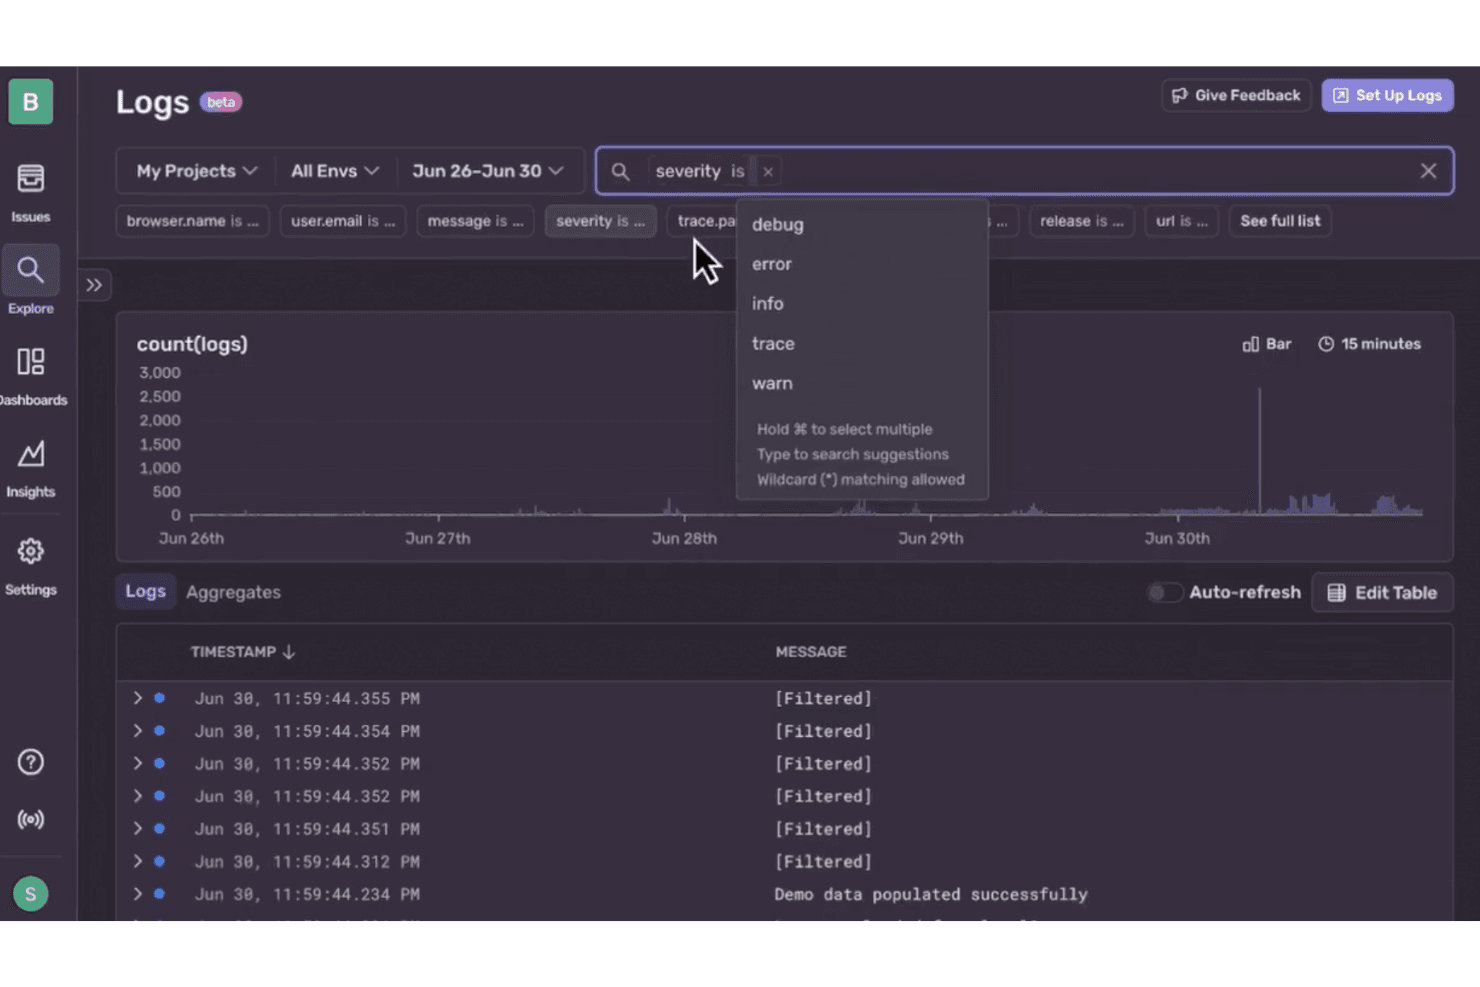
Sentry ermöglicht es Benutzern, Protokolle nach Schweregraden wie Debug, Fehler oder Warnung zu filtern. Sentry kombiniert die Überwachung der Anwendungsleistung mit Fehlerverfolgung und bietet Softwareteams eine entwicklerorientierte Alternative zu Dynatrace zur Diagnose von Problemen in Anwendungen und Diensten.
Für wen ist Sentry am besten geeignet?
Sentry eignet sich gut für Softwareentwicklungs- und DevOps-Teams, die Produktionsfehler in Echtzeit identifizieren und beheben müssen.
Warum ich Sentry ausgewählt habe
Ich habe Sentry als meine Wahl für „Am besten für die Fehlerbehebung in Echtzeit“ ausgewählt, weil es Produktionsfehler mit Stacktraces und Trace-Daten verknüpft und Entwicklern hilft, fehlerhafte Codepfade zu lokalisieren. Die Überwachung des Release-Zustands und von Regressionen kann außerdem aufzeigen, wann eine Bereitstellung neue Probleme verursacht, sodass Teams bei der Überwachung der Anwendungsleistung Korrekturen priorisieren können.
Wichtige Funktionen von Sentry
- Kontinuierliches Profiling: Zeigen Sie CPU-Profile auf Funktionsebene für unterstützte Anwendungen an.
- Web-Vitalwerte: Verfolgen Sie Browsermetriken wie Seitenladezeit und Reaktionsfähigkeit bei Interaktionen.
- Überwachung von Datenbankabfragen: Untersuchen Sie die Abfragedauer und identifizieren Sie langsame Datenbankoperationen.
- Benutzerdefinierte Instrumentierung: Fügen Sie Messungen hinzu, um anwendungsspezifische Vorgänge zu überwachen.
Sentry-Integrationen
Sentry bietet Integrationen mit GitHub, GitLab, Jira, Slack, Microsoft Teams, PagerDuty, Azure DevOps, Bitbucket, Vercel und Opsgenie. Die Integrationsplattform und die REST-API unterstützen benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Stacktraces beschleunigen das Debugging in der Produktion
- Verknüpft Fehler mit Traces und Profilen
- Die Release-Verfolgung kennzeichnet Regressionen bei Bereitstellungen
Cons:
- Keine Überwachung von Hosts oder Infrastruktur
- Die Gruppierung von Problemen und Warnmeldungen kann für Rauschen sorgen
Learn more about Sentry: Am besten für umfassende Technologieunterstützung
- Kostenloser Plan verfügbar
- Ab $32.92/Monat (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.3/5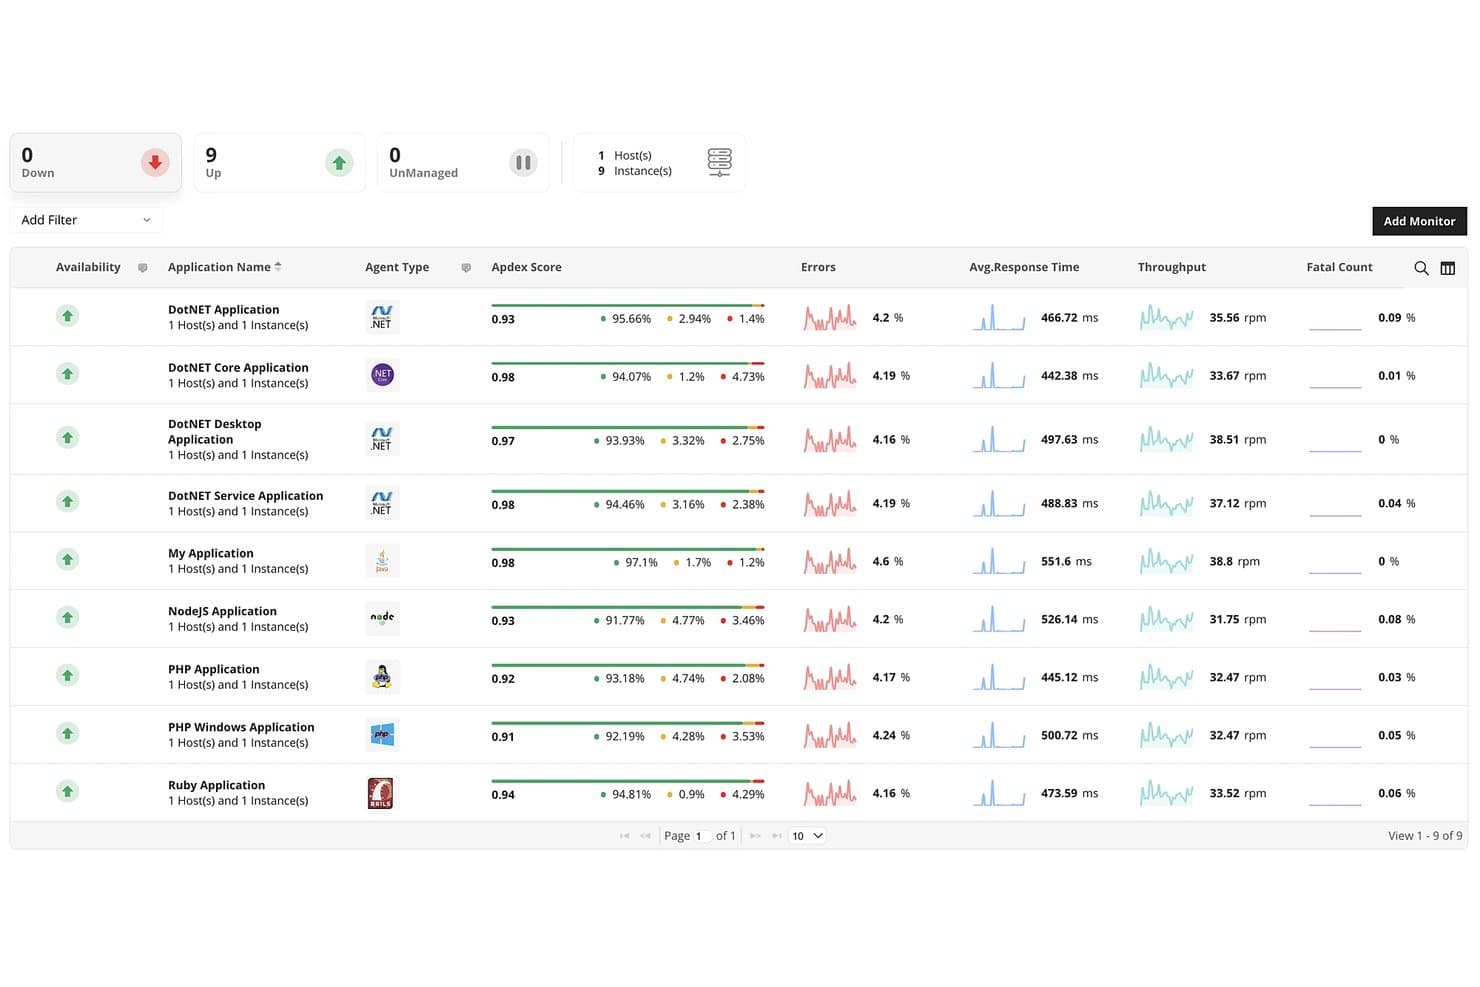
ManageEngine Applications Manager verfolgt Leistungsmetriken von Anwendungen über mehrere Instanzen hinweg. ManageEngine Applications Manager ist eine Plattform zur Überwachung der Anwendungsleistung für IT-Teams, die Verlangsamungen und Ausfälle in Anwendungen, Servern, Datenbanken und Cloud-Diensten nachverfolgen müssen.
Für wen eignet sich ManageEngine Applications Manager am besten?
IT-Betriebsteams, die vielfältige Anwendungs- und Infrastrukturumgebungen in lokalen und Cloud-Systemen betreuen.
Warum ich ManageEngine Applications Manager ausgewählt habe
Ich habe ManageEngine Applications Manager als „Am besten für umfassende Technologieunterstützung“ ausgewählt, weil es Anwendungen zusammen mit Servern, Datenbanken und Cloud-Diensten überwacht. Diese umfassende Abdeckung gefällt mir, da sich damit eine langsame Anfrage über Anwendungs- und Infrastrukturebenen hinweg nachverfolgen lässt und anschließend mithilfe der Transaktionsdiagnose ermittelt werden kann, wo sich die Latenz aufbaut.
Wichtige Funktionen von ManageEngine Applications Manager
- Anomalieerkennung: Leistungsmetriken mit historischen Basiswerten oder benutzerdefinierten Regeln vergleichen.
- Protokollverwaltung: Anwendungs- und Serverprotokolle in Echtzeit durchsuchen, filtern und analysieren.
- Überwachung echter Benutzer: Seitenaufrufe, Klicks, Sitzungsdauer und Apdex-Werte anhand des tatsächlichen Datenverkehrs verfolgen.
- Kapazitätsprognose: Trendberichte und auf maschinellem Lernen basierende Prognosen prüfen, um den Ressourcenbedarf zu planen.
Integrationen von ManageEngine Applications Manager
ManageEngine Applications Manager dokumentiert Integrationen mit ManageEngine ServiceDesk Plus, ManageEngine OpManager, Slack und ServiceNow sowie mit Syslog-kompatiblen SIEM-Plattformen wie Splunk, Microsoft Sentinel und ManageEngine Log360. Außerdem stellt es REST APIs bereit, um interne Portale und Systeme von Drittanbietern anzubinden.
Pros and Cons
Pros:
- Überwacht Anwendungen, Datenbanken, Server und Cloud-Dienste
- Echtzeitwarnungen unterstützen die proaktive Fehlerbehebung
- Breite Abdeckung von Altsystemen und hybriden Umgebungen
Cons:
- Die Feinabstimmung erweiterter Schwellenwerte erfordert Einrichtungszeit
- Weniger Detailtiefe bei cloudnativer Ablaufverfolgung
Learn more about ManageEngine Applications Manager: Am besten für vielfältige Anwendungsumgebungen
- 30-tägige kostenlose Testversion
- Ab $10/Monat
Visit WebsiteCustomer Rating:4.7/5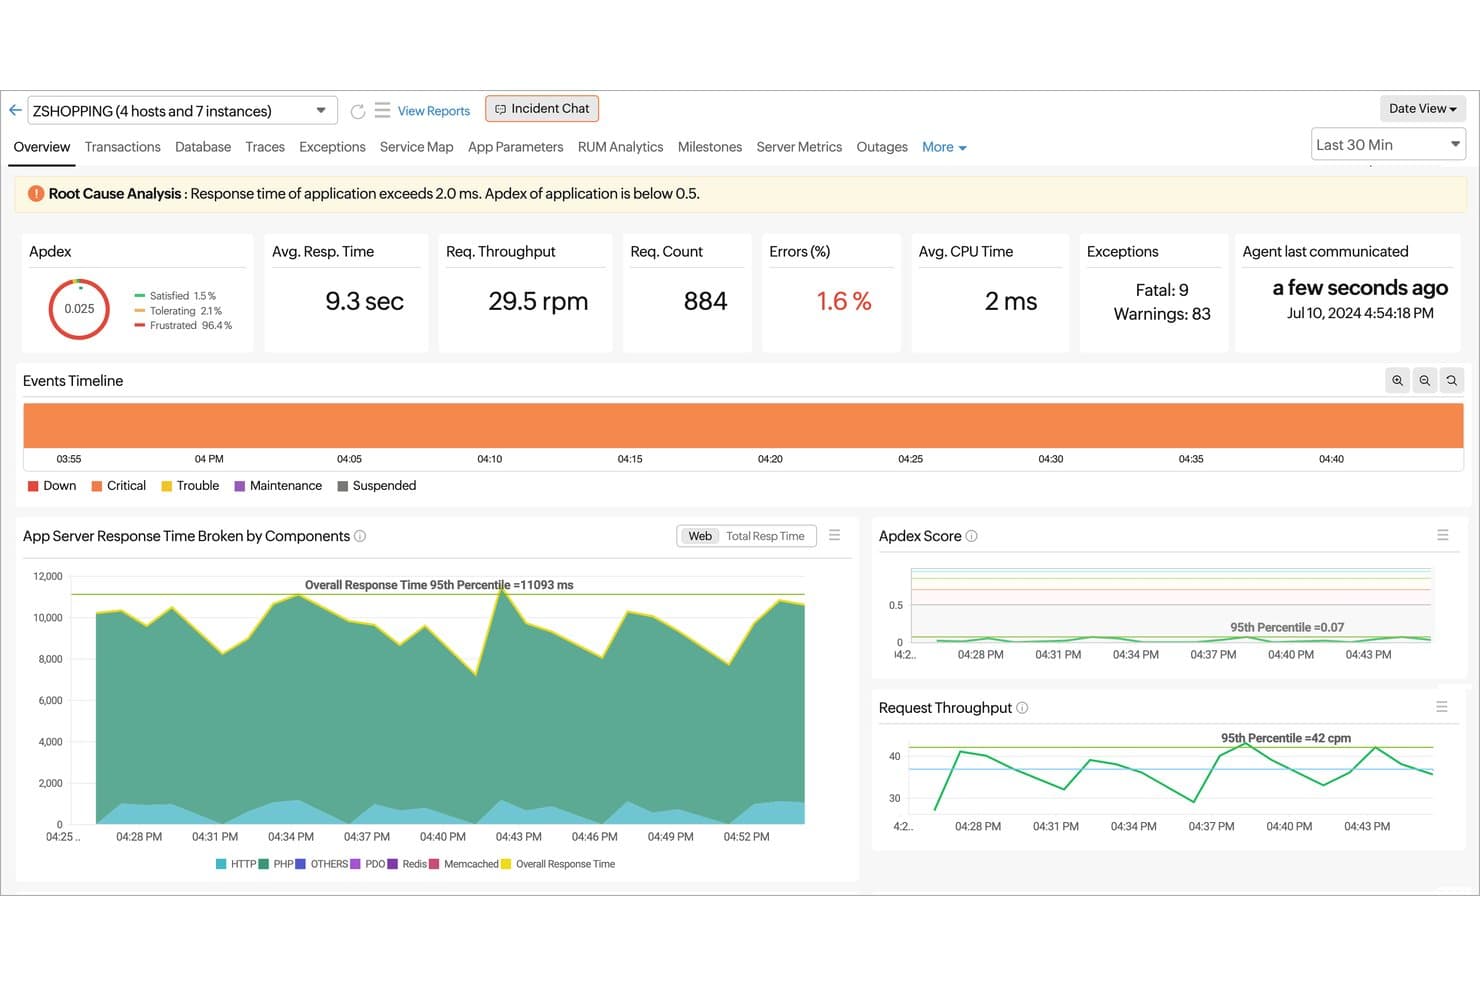
Site24x7 stellt Ursachenanalysen und APM-Metriken in einer Ansicht dar. Site24x7 ist eine IT-Observability- und Monitoring-Plattform für Teams, die Alternativen zu Dynatrace evaluieren. Sie unterstützt IT-Spezialisten dabei, die Performance von Anwendungen und Infrastruktur zu verfolgen, Serviceprobleme zu diagnostizieren und hybride Umgebungen zu überwachen.
Für wen ist Site24x7 am besten geeignet?
Site24x7 eignet sich für IT-Teams, die Anwendungen und Infrastruktur in vielfältigen hybriden Umgebungen überwachen.
Warum ich Site24x7 ausgewählt habe
Ich habe Site24x7 für den Anwendungsfall „Am besten für vielfältige Anwendungsumgebungen“ ausgewählt, weil die APM Java, .NET, PHP, Ruby, Node.js und Python unterstützt. Mir gefällt, wie die verteilte Ablaufverfolgung und Diagnosen auf Codeebene dabei helfen, langsame Transaktionen über mehrere Services hinweg zu verfolgen, während die Unterstützung für OpenTelemetry zu instrumentierten Umgebungen passt.
Die wichtigsten Funktionen von Site24x7
- Serverüberwachung: Verfolgt CPU-, Arbeitsspeicher-, Festplatten- und Netzwerkmetriken auf physischen, virtuellen und Cloud-Servern.
- Netzwerküberwachung: Misst Gerätezustand, Bandbreite, Latenz und Datenverkehr über Router, Switches und Firewalls hinweg.
- Protokollverwaltung: Sammelt und durchsucht Protokolle aus Anwendungen, Systemen und Cloud-Quellen.
- Website-Überwachung: Prüft die Verfügbarkeit von Websites von mehr als 130 Standorten weltweit.
Integrationen von Site24x7
Site24x7 unterstützt Integrationen mit ServiceNow, PagerDuty, Jira, Slack, Microsoft Teams, Opsgenie, Amazon EventBridge und Zapier. Außerdem bietet es REST-APIs für benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Überwacht Anwendungen in vielfältigen hybriden Umgebungen
- Verfolgt Transaktionen über unterstützte Anwendungssprachen hinweg
- Prüft die Verfügbarkeit von Websites an mehr als 130 Standorten
Cons:
- Die Feinabstimmung von Warnmeldungen kann zu Fehlalarmen führen
- Dashboards wirken überladen und bieten nur begrenzte Anpassungsmöglichkeiten
Learn more about Site24x7: Am besten für umfassende Überwachung der IT-Infrastruktur
- 30-tägige kostenlose Testversion
- Ab $2,595 einmalig
Visit WebsiteCustomer Rating:4.6/5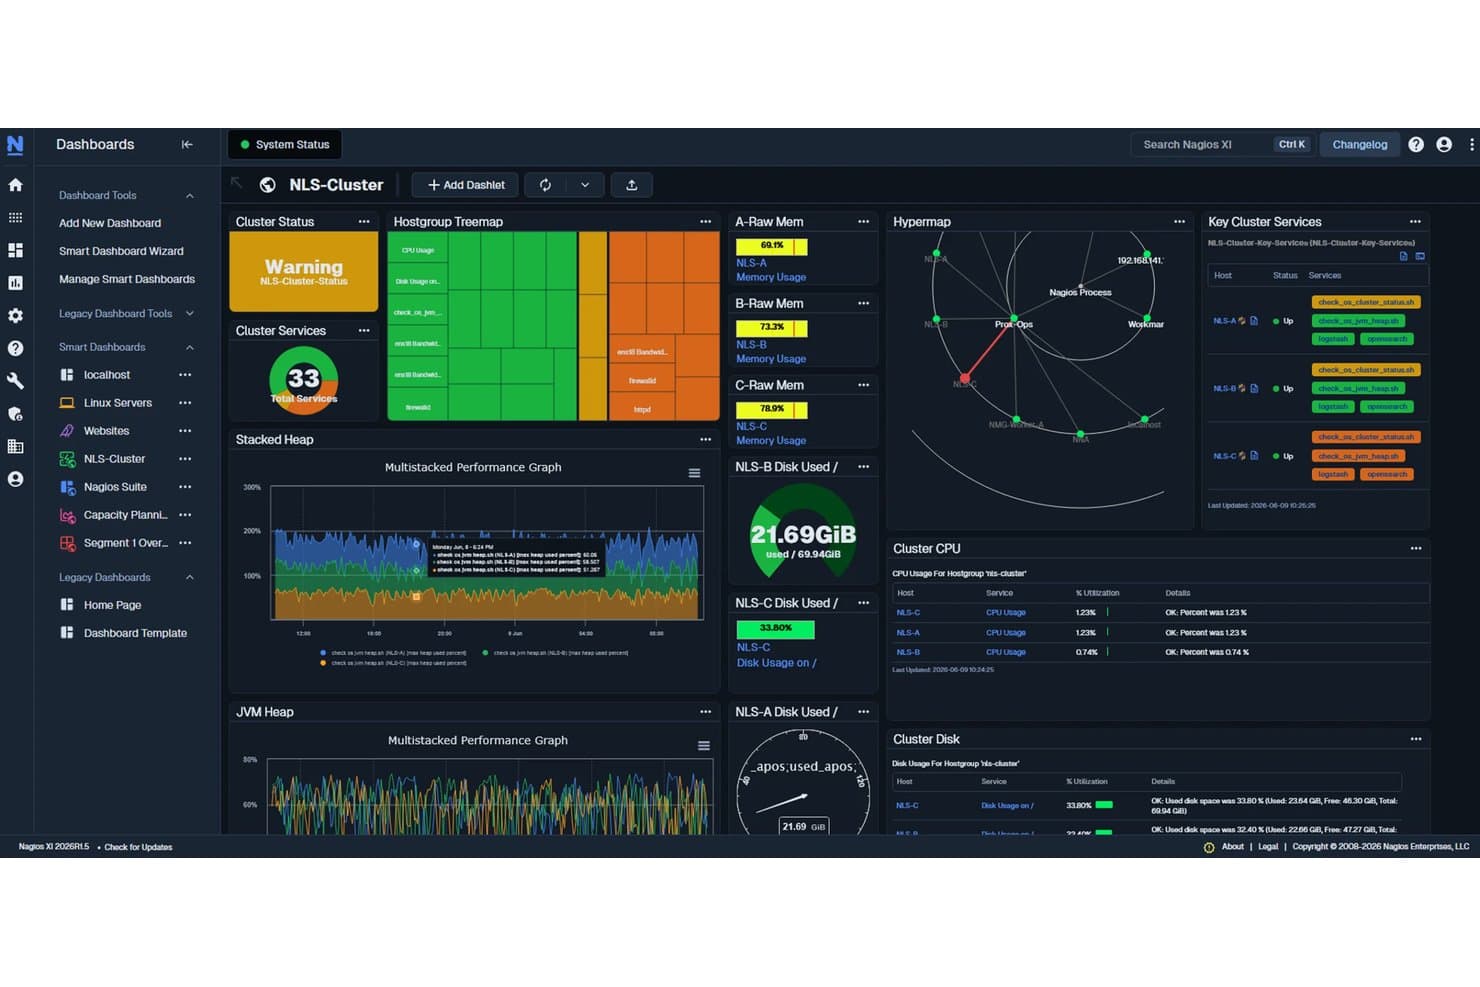
Nagios XI zentralisiert den Zustand von Clustern sowie die Überwachung von CPU, Festplatten und Diensten in einer Übersicht. Nagios bietet IT-Teams konfigurierbare Überwachung von Hosts und Diensten, um Ausfälle auf Servern, Netzwerkgeräten und in Anwendungen in unterschiedlichen Infrastrukturumgebungen zu erkennen.
Für wen ist Nagios am besten geeignet?
Nagios eignet sich für Infrastruktur- und Betriebsteams, die eine konfigurierbare Überwachung in gemischten Umgebungen benötigen, einschließlich etablierter Systeme und Netzwerkgeräte.
Warum ich Nagios ausgewählt habe
Ich habe Nagios für einen Leitfaden zu Alternativen zu Dynatrace ausgewählt, weil es mit pluginbasierten Prüfungen von Hosts und Diensten zu „Am besten für umfassende Überwachung der IT-Infrastruktur“ passt. Ich verwende SNMP-Prüfungen, um Switches und Router zusammen mit dem Serverzustand zu überwachen, und konfiguriere anschließend Warnmeldungen, wenn Prüfungen fehlschlagen. So kann ich gemischte Infrastrukturen in einem Überwachungssystem verfolgen.
Die wichtigsten Funktionen von Nagios
- Automatische Erkennung: Erkennt Geräte und Dienste in Ihrem Netzwerk.
- Konfigurationsassistenten: Unterstützen die Einrichtung gängiger Geräte und Anwendungen.
- Übersichten: Zeigen Statusübersichten, Karten und Diagramme in anpassbaren Ansichten an.
- Leistungsdiagramme: Stellen Überwachungsdaten im Zeitverlauf dar.
Integrationen von Nagios
Nagios XI verfügt über dokumentierte Integrationen mit Slack und PagerDuty für Warnbenachrichtigungen und die Bearbeitung von Vorfällen, die über Skripte und Benachrichtigungseinstellungen konfiguriert werden. Die REST-API unterstützt benutzerdefinierte Verbindungen mit Tools wie CMDB- und Ticketsystemen.
Pros and Cons
Pros:
- Überwacht gemischte Hosts mithilfe benutzerdefinierter Prüfungen
- Zuverlässige Warnmeldungen mit konfigurierbaren Schwellenwerten
- Übersichten zeigen Status und historische Trends
Cons:
- Die Ersteinrichtung erfordert Linux-Kenntnisse im Bereich Überwachung
- Externe Plugins können veraltet oder undokumentiert sein
Learn more about Nagios: Am besten für die einheitliche Überwachung von Cloud-Diensten
- Nein
- Ab $15/Monat (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.5/5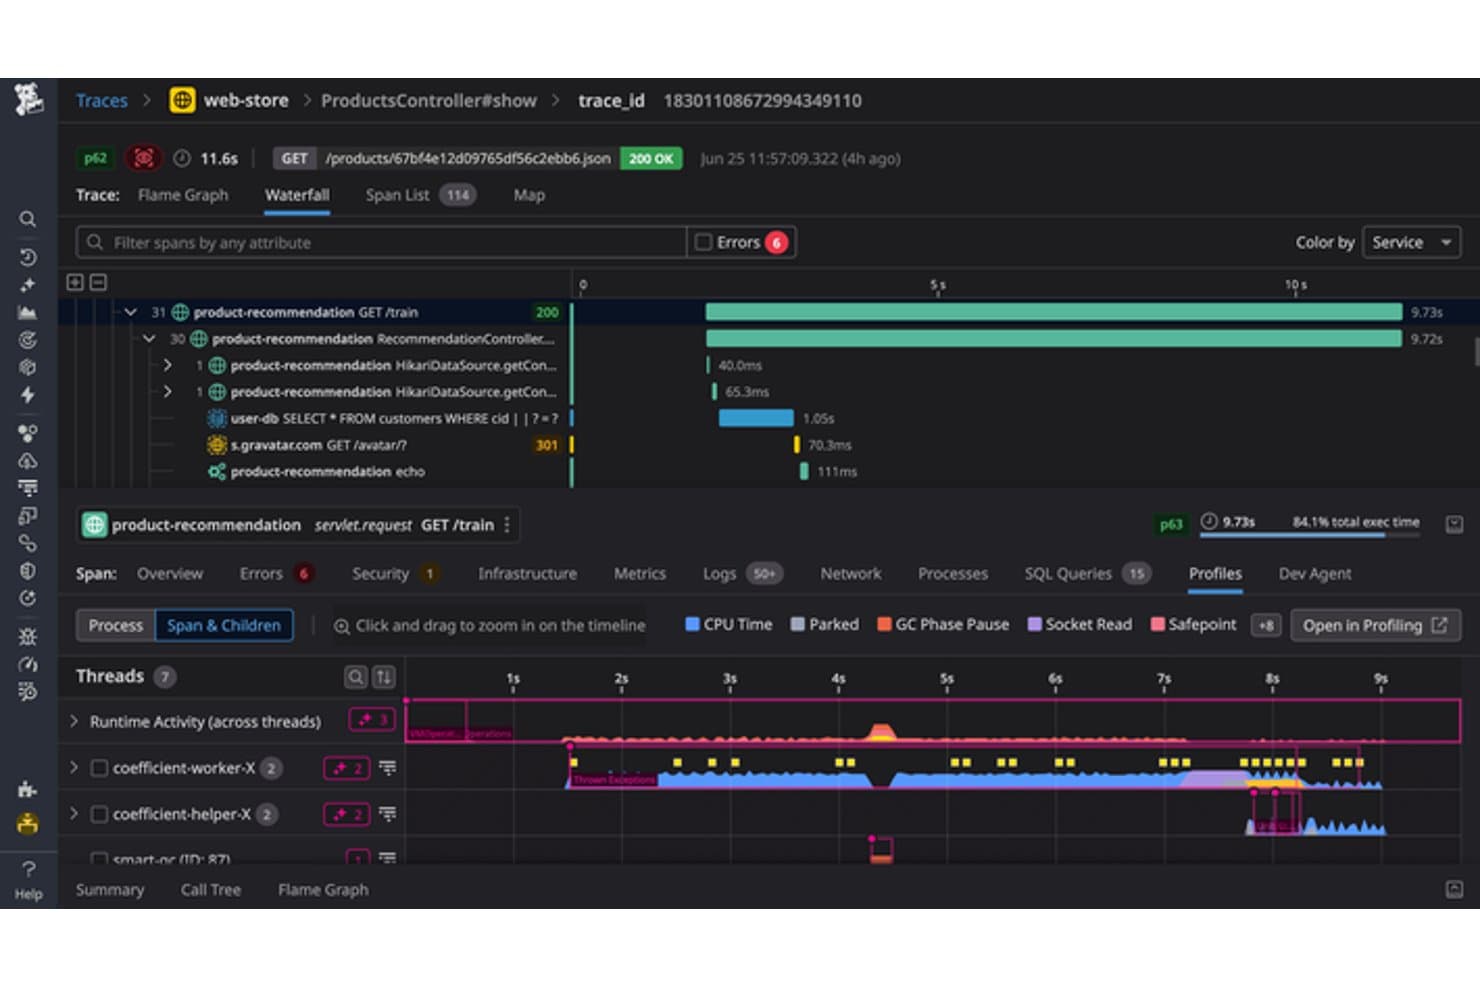
Die APM von Datadog verfolgt CPU, Threads und Span-Zeitachsen im Detail. Datadog ist eine Beobachtungsplattform für IT- und DevOps-Teams, die Anwendungs-, Infrastruktur-, Protokoll- und Sicherheitsdaten zusammenführt, um die Diagnose von Leistungsproblemen in cloudnativen Umgebungen zu unterstützen.
Für wen ist Datadog am besten geeignet?
Cloud-Betriebs- und SRE-Teams können Datadog verwenden, um den Zustand von Diensten in verteilten Infrastrukturen zu verfolgen und Probleme zu identifizieren, die Produktions-Workloads beeinträchtigen.
Warum ich Datadog ausgewählt habe
Ich habe Datadog für einen Leitfaden zu den besten Dynatrace-Alternativen ausgewählt, weil es die Auszeichnung „Am besten für die einheitliche Überwachung von Cloud-Diensten“ erhält. Mir gefällt, wie die Infrastrukturmetriken, verteilten Traces und Protokolle es mir ermöglichen, eine langsame Anfrage von einem Cloud-Host durch abhängige Dienste zu verfolgen und zugehörige Fehler zu untersuchen. Die Dienstübersicht hilft mir, eine vorgelagerte Abhängigkeit zu lokalisieren, die den Zustand der Produktion beeinträchtigt.
Wichtige Funktionen von Datadog
- Überwachung echter Benutzer: Erfasst Browsersitzungen, Frontend-Fehler und die Seitenleistung.
- Synthetische Überwachung: Führt geplante Browser- und API-Tests für Anwendungen aus.
- Datenbanküberwachung: Zeigt Metriken auf Abfrageebene und Ausführungspläne für unterstützte Datenbanken an.
- Überwachungen und Warnmeldungen: Bewertet Telemetriedaten anhand von Schwellenwerten und sendet Benachrichtigungen, wenn Bedingungen ausgelöst werden.
Integrationen von Datadog
Datadog bietet mehr als 1.000 integrierte Integrationen, darunter AWS, Azure, Google Cloud, Kubernetes, Docker, PostgreSQL, GitHub, Jira, Slack und PagerDuty. Außerdem werden benutzerdefinierte Integrationen über die API unterstützt.
Pros and Cons
Pros:
- Stellt bei Vorfällen Zusammenhänge zwischen Metriken, Protokollen und Traces her
- Bildet Abhängigkeiten ab, um Ausfälle vorgelagerter Dienste zu lokalisieren
- Vereinheitlicht Ansichten zum Zustand von Infrastruktur und Anwendungen
Cons:
- Das Wachstum der Telemetriedaten erschwert die Kostenprognose
- Erweiterte Dashboards und Abfragen erfordern Konfigurationsaufwand
 Am besten für die Open-Source-Überwachung auf Unternehmensebene geeignet
- Nein
- Kostenlos
Visit WebsiteCustomer Rating:4.4/5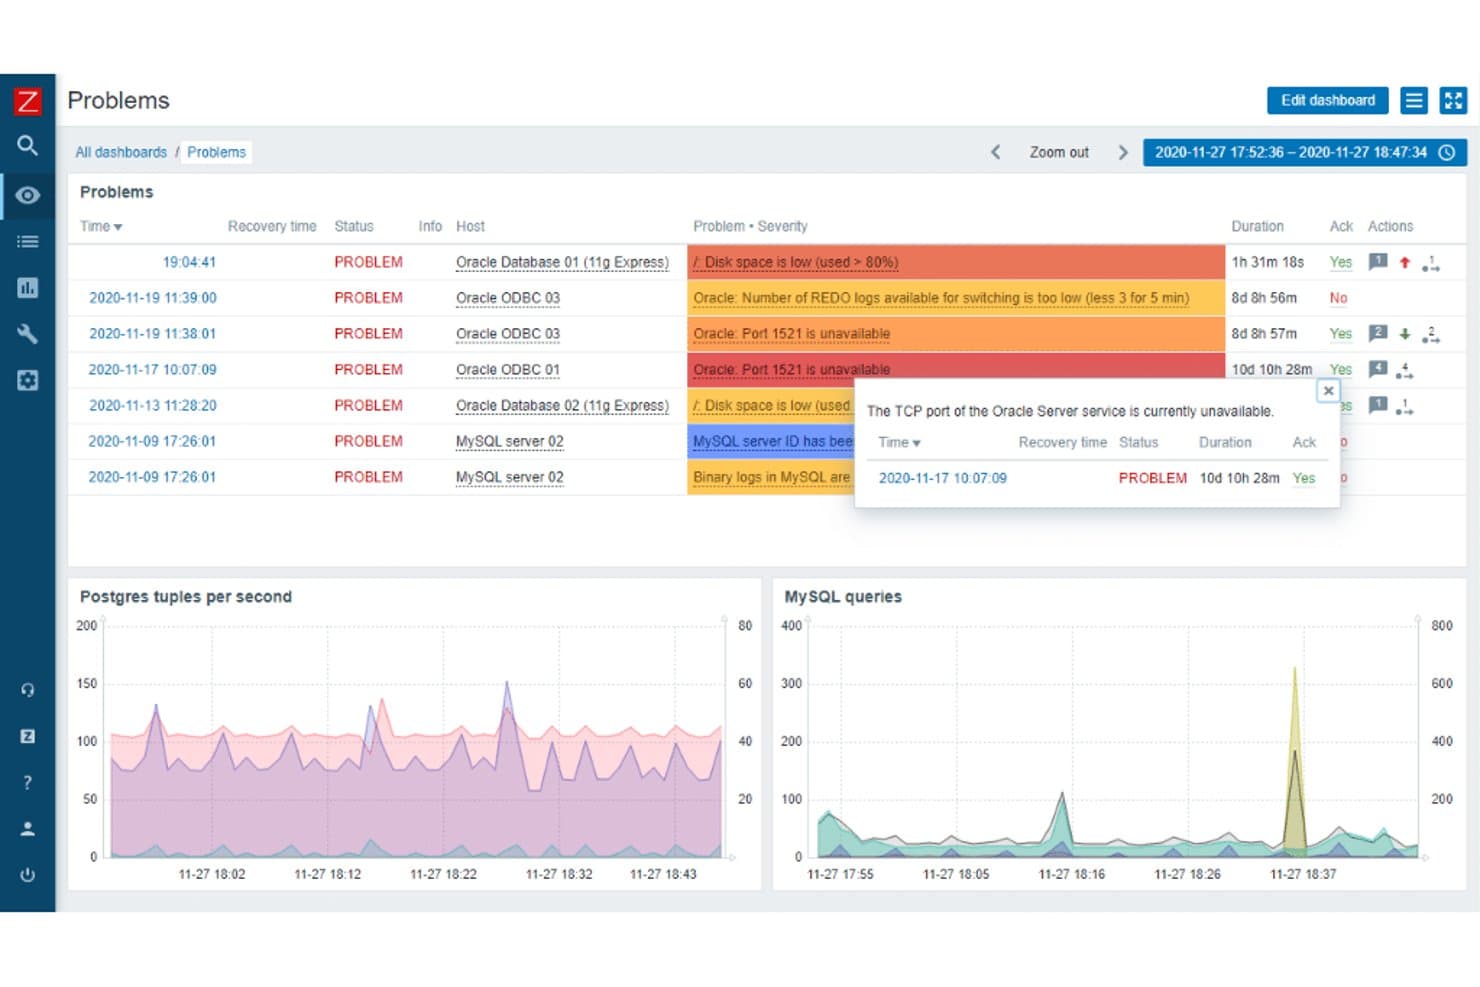
Zabbix zeigt aktive Datenbank- und Serverprobleme mit Angaben zum Schweregrad an. Zabbix ist eine Infrastrukturüberwachungsplattform für IT-Teams, die Server, Netzwerke und Anwendungen überwachen, Dienstprobleme erkennen und den Überblick über komplexe Umgebungen verwalten müssen.
Für wen ist Zabbix am besten geeignet?
Zabbix eignet sich für IT-Betriebsteams in Unternehmen, die anpassbare Open-Source-Überwachung in großen, verteilten Umgebungen benötigen.
Warum ich Zabbix ausgewählt habe
Ich habe Zabbix für diesen Leitfaden zu den besten Dynatrace-Alternativen ausgewählt, weil es sich am besten für die Open-Source-Überwachung auf Unternehmensebene eignet. Mir gefällt, wie verteilte Proxys Daten von entfernten Standorten sammeln, während wiederverwendbare Vorlagen Prüfungen und Auslöser auf Server und Netzwerkgeräte anwenden. Dadurch erhalten Betriebsteams eine Möglichkeit, eine große, heterogene Umgebung zu überwachen, ohne auf eine proprietäre Plattform angewiesen zu sein.
Wichtige Funktionen von Zabbix
- Ereigniskorrelation: Definieren Sie Regeln, um zusammenhängende Probleme zu gruppieren und Symptomereignisse zu unterdrücken.
- Webüberwachung: Verfolgen Sie mehrstufige Webszenarien und Antwortzeiten.
- Netzwerkkarten: Erstellen Sie Karten, auf denen überwachte Hosts, Verbindungen und aktuelle Probleme angezeigt werden.
- Erkennung auf niedriger Ebene: Erkennen Sie automatisch Entitäten wie Netzwerkschnittstellen und erstellen Sie zu deren Überwachung entsprechende Elemente.
Zabbix-Integrationen
Der offizielle Integrationskatalog von Zabbix führt 1.986 Lösungen von 559 Marken auf, darunter AWS, Azure, Kubernetes, ServiceNow, Slack, Jira und PagerDuty. Außerdem bietet Zabbix eine HTTP-basierte JSON-RPC-API und anpassbare JavaScript-Webhooks für benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Skaliert mithilfe von Proxys über verteilte Standorte hinweg
- Wiederverwendbare Vorlagen standardisieren Prüfungen in der gesamten Serverflotte
- Korreliert zusammenhängende Warnungen, um Rauschen zu reduzieren
Cons:
- Die Ersteinrichtung erfordert umfangreiche manuelle Konfiguration
- Große Bereitstellungen erfordern eine Feinabstimmung von Datenbank und Proxys
 Beste Lösung für die Echtzeit-Transparenz der Geschäftsleistung
- Nein
- Ab $6/vCPU/Monat (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.3/5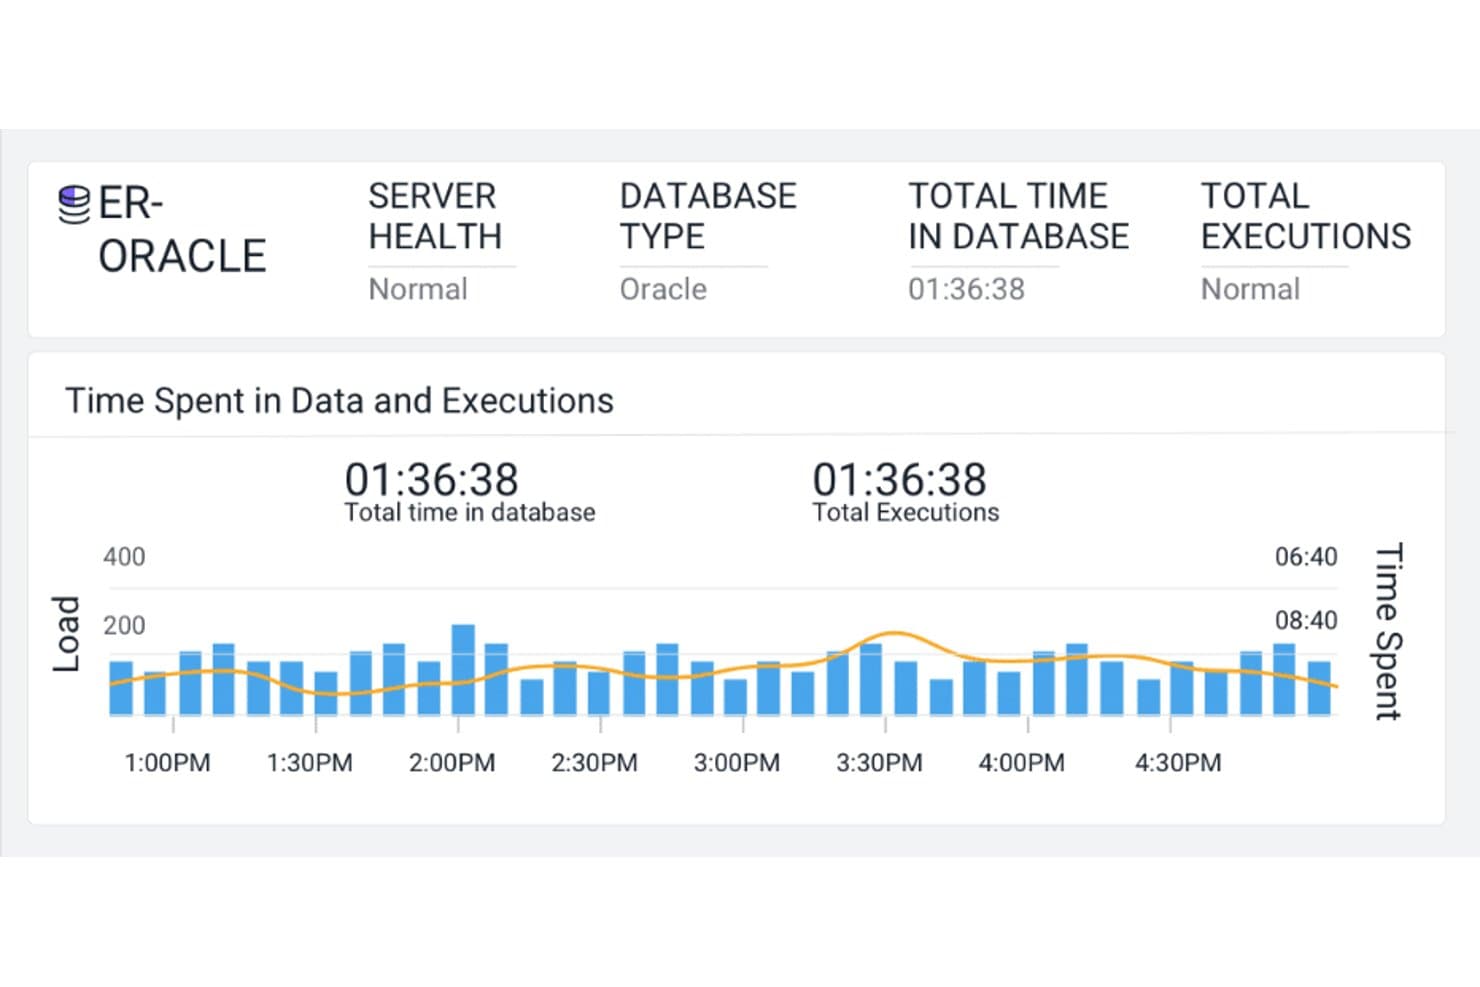
AppDynamics überwacht die Auslastung und Ausführungszeiten einer Oracle-Datenbank visuell. Für IT- und Engineering-Teams, die Alternativen zu Dynatrace vergleichen, kombiniert AppDynamics die Überwachung der Anwendungsleistung mit der Transaktionsverfolgung, um Verlangsamungen und Fehler in komplexen, verteilten Diensten zu lokalisieren.
Für wen ist AppDynamics am besten geeignet?
AppDynamics eignet sich für IT-Betriebs- und Anwendungsteams, die den Zustand laufender Anwendungen mit den Geschäftstransaktionen verknüpfen müssen, auf die Kunden angewiesen sind.
Warum ich AppDynamics ausgewählt habe
Ich habe AppDynamics ausgewählt, weil der Schwerpunkt „Beste Lösung für die Echtzeit-Transparenz der Geschäftsleistung“ den Zustand laufender Anwendungen mit den Transaktionen verknüpft, von denen Kunden abhängig sind. Mir gefällt, wie die Transaktionsverfolgung dabei hilft, Verlangsamungen in verteilten Diensten zu lokalisieren, sodass ich sehen kann, an welcher Stelle eine Anfrage ins Stocken gerät, und dieses Problem mit der Geschäftsaktivität in Verbindung bringen kann.
Wichtige Funktionen von AppDynamics
- Laufzeitsicherheit von Anwendungen: Schwachstellen in Anwendungen erkennen und Angriffe blockieren.
- Überwachung echter Nutzer: Die Web- und Mobilleistung auf verschiedenen Geräten und in unterschiedlichen Browsern erfassen.
- Synthetische Überwachung: Die Leistung von Web-, Mobil- und API-Anwendungen mit simulierten Aktivitäten überwachen.
- Anomalieerkennung: Leistungs-Basiswerte festlegen und Abweichungen mithilfe von KI und maschinellem Lernen kennzeichnen.
Integrationen von AppDynamics
AppDynamics verfügt über eine integrierte bidirektionale Jira-Integration zum Erstellen und Aktualisieren von Vorfall-Tickets sowie über eine Integration mit Splunk Observability Cloud in einer frühen Vorschauphase. Außerdem bietet es vorgefertigte Erweiterungen und REST-APIs für Integrationen und Automatisierung.
Pros and Cons
Pros:
- Geschäftstransaktionskarten verknüpfen Telemetriedaten mit den Auswirkungen
- Aufrufdiagramme unterstützen die Ursachenanalyse auf Codeebene
- Basiswertwarnungen kennzeichnen Abweichungen vom Normalzustand
Cons:
- Instrumentierung und Einrichtung der Agenten erfordern praktische Mitarbeit
- Die Benutzeroberfläche wirkt neben neueren Observability-Tools veraltet
Learn more about AppDynamics: Am besten geeignet für die Abfrage von Telemetriedaten in einem einheitlichen Datenspeicher
- Nein
- $12/Benutzer/Monat (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.3/5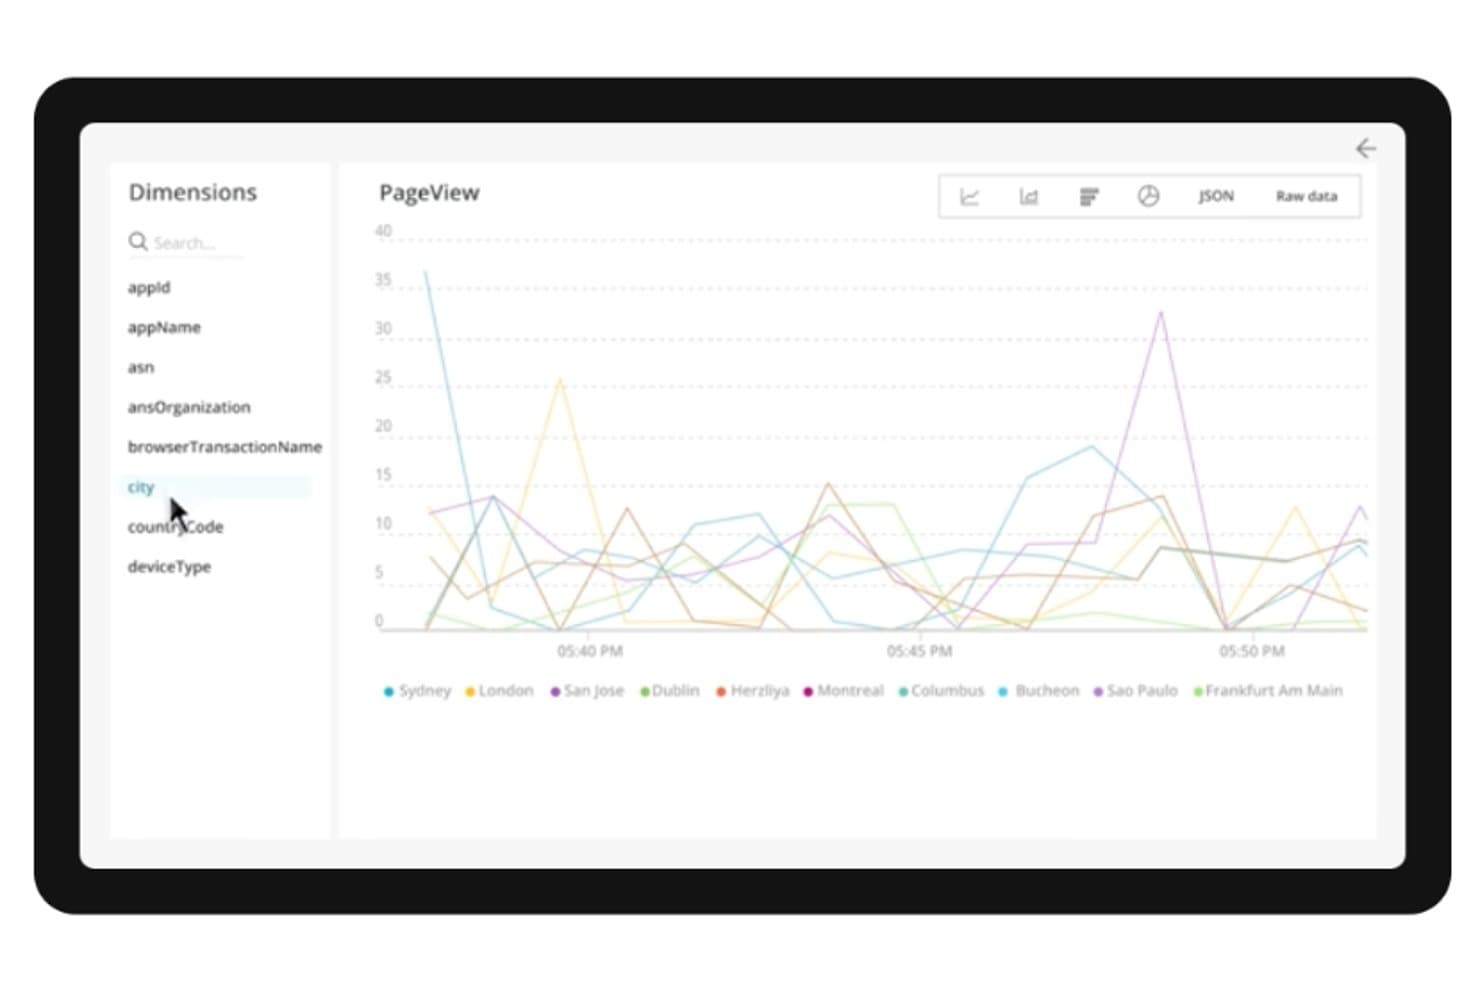
New Relic schlüsselt Seitenaufrufdaten nach Städten über eine Zeitreihe auf. Für IT- und Technikteams, die Alternativen zu Dynatrace bewerten, ist New Relic eine APM-Plattform, die dabei hilft, Anwendungsprobleme nachzuverfolgen, den Zustand von Diensten zu überwachen und Verlangsamungen in verteilten Systemen zu untersuchen.
Für wen ist New Relic am besten geeignet?
New Relic eignet sich für DevOps- und Teams für die Zuverlässigkeit von Websites, die beim Diagnostizieren von Produktionsproblemen Anwendungstraces, Infrastrukturmetriken und Protokolle miteinander verknüpfen müssen.
Warum ich New Relic ausgewählt habe
Ich habe New Relic aufgrund seines Schwerpunkts „Am besten für umfassende Anwendungsleistungsüberwachung“ ausgewählt: Die Plattform verknüpft verteilte Traces mit dem Zustand von Diensten und Protokollen und hilft mir dadurch, Verlangsamungen über mehrere Dienste hinweg nachzuverfolgen. Wenn eine API nach einer Veröffentlichung langsamer wird, kann ich den Pfad ihrer Anfrage nachverfolgen und zugehörige Signale des Dienstes überprüfen, um die betroffene Abhängigkeit zu lokalisieren.
Wichtige Funktionen von New Relic
- Datenbanküberwachung: Langsame Datenbankabfragen und deren Ausführungsdetails untersuchen.
- Diagnose auf Codeebene: Anwendungscode profilieren, um Methoden zu identifizieren, die CPU-Zeit verbrauchen.
- Veröffentlichungsnachverfolgung: Veröffentlichungen markieren, um die Anwendungsleistung vor und nach Änderungen zu vergleichen.
- Alarmbedingungen: Schwellenwerte für Anwendungsmetriken festlegen und Benachrichtigungen erhalten, wenn diese überschritten werden.
Integrationen von New Relic
New Relic unterstützt Integrationen für Alarmbenachrichtigungen mit Atlassian Jira, AWS EventBridge, Microsoft Teams, PagerDuty, ServiceNow und Slack sowie mehr als 400 hostbasierte Integrationen. Außerdem stellt die Plattform APIs und das Flex-Integrationstool bereit, um benutzerdefinierte Daten an New Relic zu senden.
Pros and Cons
Pros:
- Stellt Korrelationen zwischen Traces, Protokollen und Infrastruktursignalen her
- Verfolgt Regressionen nach Veröffentlichungen über verteilte Transaktionen hinweg
- Verknüpft die Anwendungsleistung mit der Browsererfahrung
Cons:
- Eine umfangreiche Navigation kann die Untersuchung von Vorfällen verlangsamen
- Steigendes Datenaufkommen kann die Kosten unvorhersehbar machen
Learn more about New Relic: Am besten für Protokollverwaltung und Sicherheitsanalysen
- Nein
- $108 pro Benutzer und Monat (jährlich abgerechnet)
Visit WebsiteCustomer Rating:4.3/5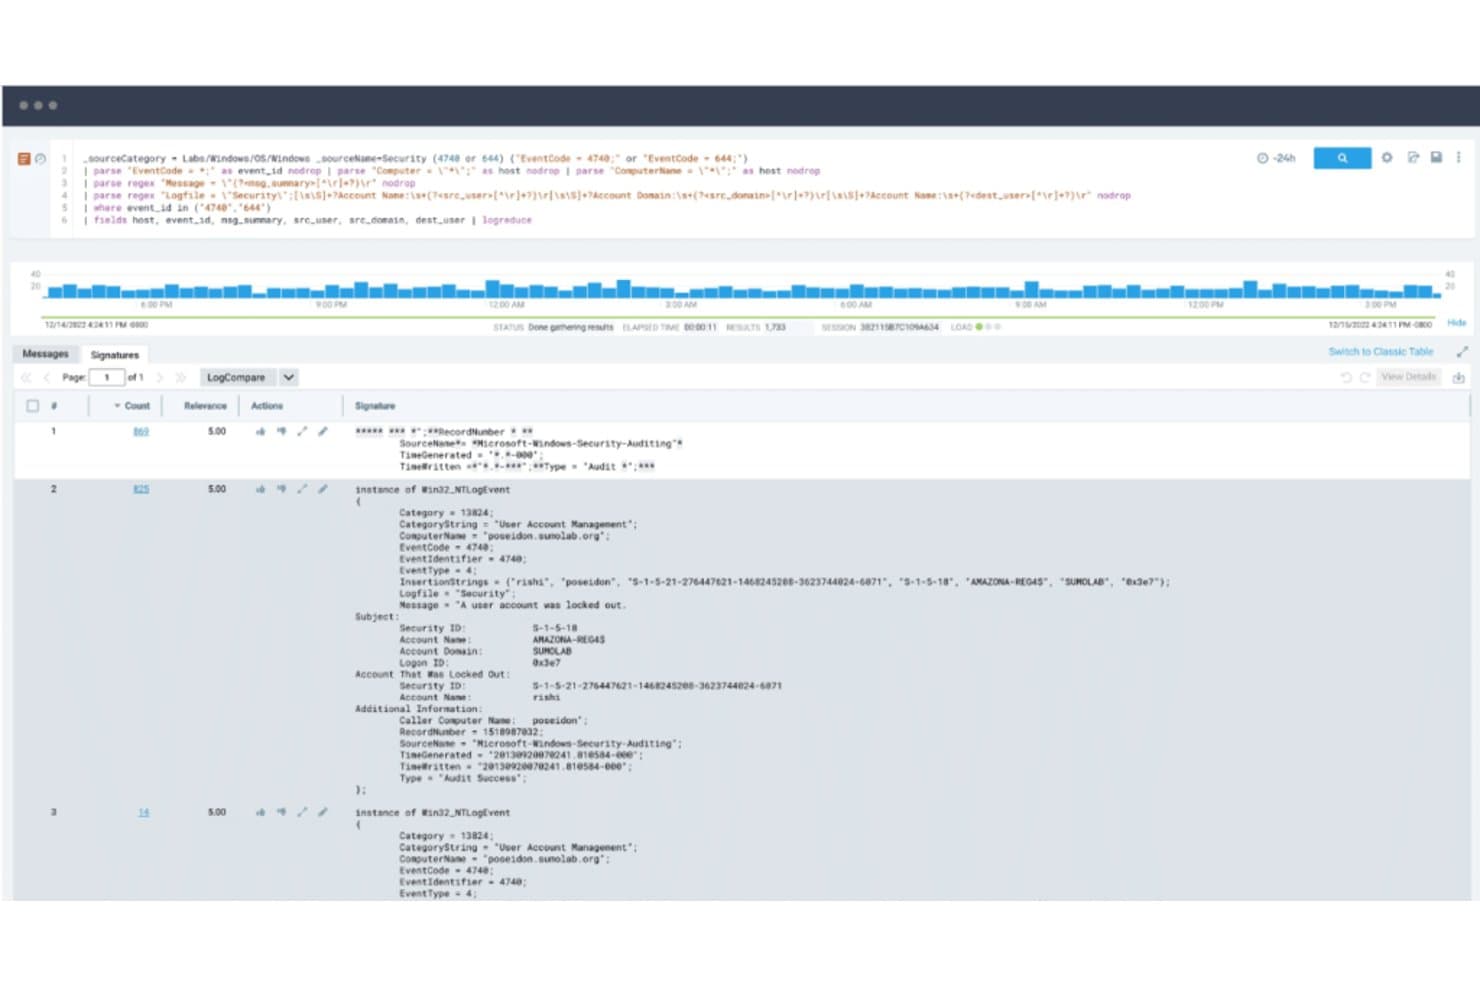
Sumo Logic erkennt Kontosperrungsereignisse mithilfe der Analyse von Sicherheitsprotokollen. Sumo Logic ist eine cloudbasierte Observability-Plattform, die Infrastruktur- und Sicherheitsteams dabei unterstützt, Dienstunterbrechungen zu untersuchen und Aktivitäten in verteilten Anwendungen zu verstehen, und damit eine Option für Teams darstellt, die Alternativen zu Dynatrace bewerten.
Für wen ist Sumo Logic am besten geeignet?
Sicherheitsanalysten und IT-Betriebsteams, die zentrale Protokolldaten zur Fehlerbehebung, Bedrohungserkennung und Untersuchung benötigen, sind für Sumo Logic gut geeignet.
Warum ich mich für Sumo Logic entschieden habe
Ich habe Sumo Logic für diesen Leitfaden zu Dynatrace-Alternativen ausgewählt, weil es der Kategorie „Am besten für Protokollverwaltung und Sicherheitsanalysen“ entspricht. Die Protokollsuche hilft mir, Fehler über verteilte Dienste hinweg nachzuverfolgen, während Cloud-SIEM Sicherheitssignale korreliert, um die Untersuchung verdächtiger Aktivitäten zu unterstützen.
Die wichtigsten Funktionen von Sumo Logic
- Metrikanalyse: Zeitreihenmetriken mit der Metrikabfragesprache von Sumo Logic abfragen.
- Verteiltes Tracing: Trace-Spans untersuchen, um Anfragen über instrumentierte Dienste hinweg zu verfolgen.
- Dashboards: Visualisierungen aus Telemetriedaten erstellen und in benutzerdefinierten Layouts anordnen.
- Überwachungen und Warnmeldungen: Bedingungen für Metriken oder Abfragen definieren, um Benachrichtigungen auszulösen.
Integrationen von Sumo Logic
Der App-Katalog von Sumo Logic umfasst Hunderte von Anbietern und Produkten, darunter AWS, Azure, Datadog, Dynatrace, GitHub und Jira, mit Angeboten wie Datensammlungsquellen, vorgefertigten Apps und Automatisierungsintegrationen. Sumo Logic bietet native Webhook-Integrationen für ServiceNow und Slack sowie REST-APIs für benutzerdefinierte Integrationen.
Pros and Cons
Pros:
- Schnelle Protokollsuchen unterstützen Untersuchungen von Sicherheitsvorfällen
- Zentrale Protokolle ermöglichen Warnmeldungen in Echtzeit
- Cloud-SIEM korreliert Bedrohungen zur Untersuchung
Cons:
- Das Erlernen der Abfragesprache erfordert Zeit
- Protokollerfassung und -analyse müssen verbessert werden
 10Am besten für Datenanalyse und Erkenntnisse im großen Maßstab
Splunk
- Nein
- $150/user/month
Visit WebsiteCustomer Rating:4.3/5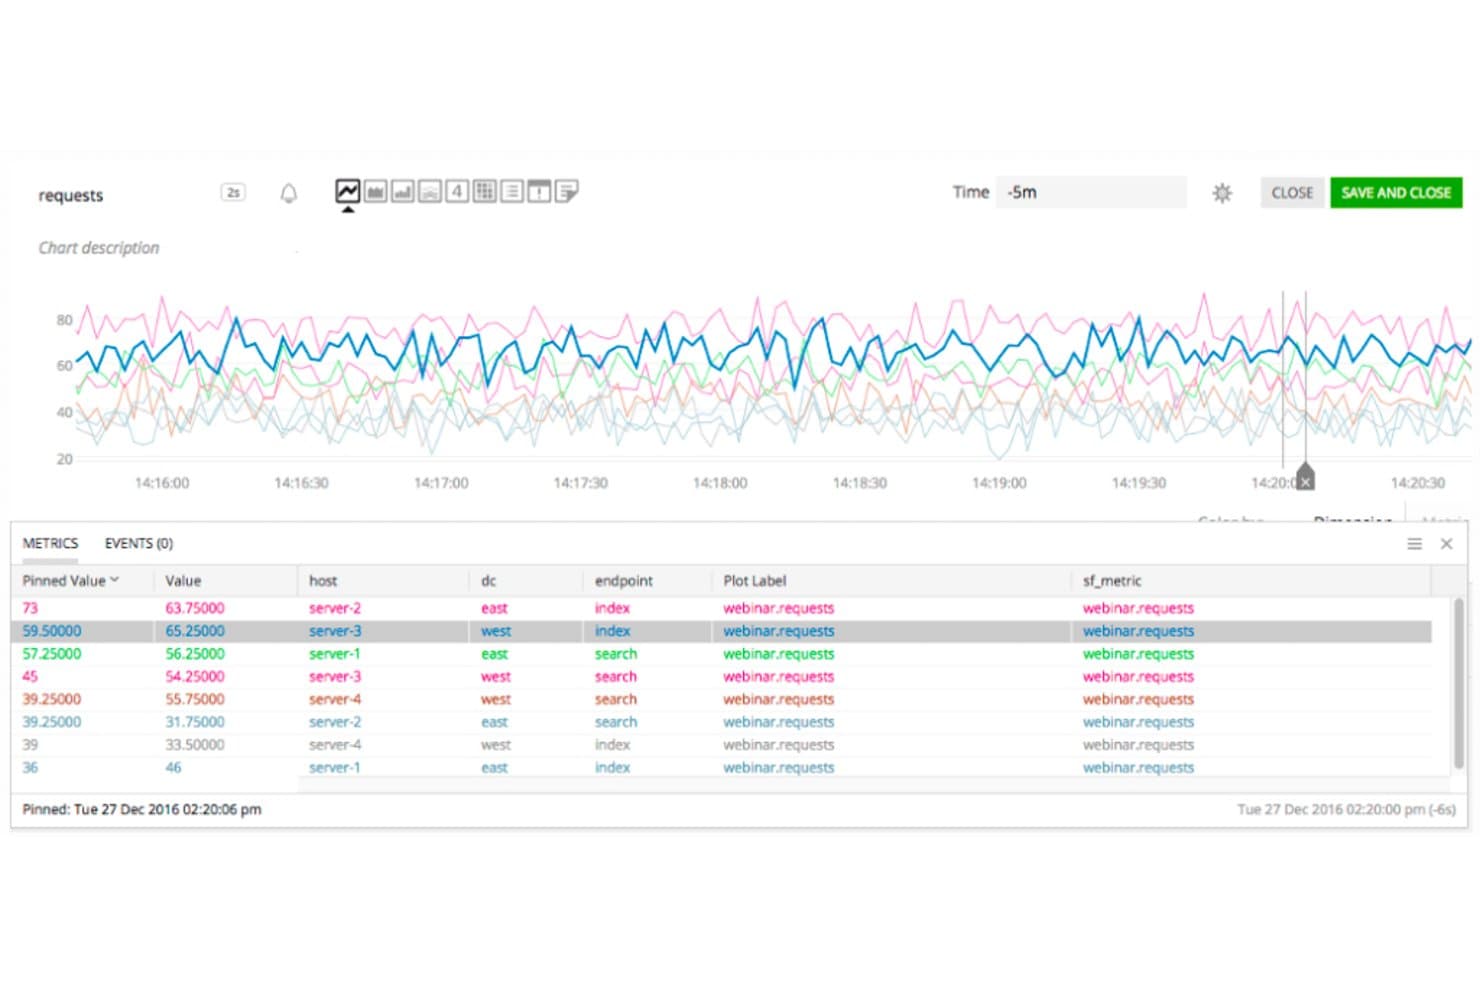
Splunk ermöglicht es Benutzern, Echtzeitmetriken zu Anfragen über Server und Endpunkte hinweg zu überwachen. Splunk kombiniert Infrastrukturüberwachung mit der Analyse von Protokollen, Metriken und Ablaufverfolgungen und unterstützt IT- und Betriebsteams dabei, Vorfälle in komplexen, verteilten Umgebungen zu untersuchen.
Für wen ist Splunk am besten geeignet?
Splunk eignet sich für große IT- und Sicherheitsteams, die große Mengen an Maschinendaten analysieren und Muster in komplexen Umgebungen erkennen müssen.
Warum ich Splunk ausgewählt habe
Ich habe Splunk als Dynatrace-Alternative ausgewählt, weil der Schwerpunkt auf „Am besten für Datenanalyse und Erkenntnisse im großen Maßstab“ liegt. Es kombiniert Infrastrukturüberwachung mit der Analyse von Protokollen, Metriken und Ablaufverfolgungen, sodass ich eine Verlangsamung eines Dienstes über verteilte Systeme hinweg untersuchen und Signale mit zugehörigen Ereignissen verknüpfen kann. Das hilft mir, bei der Untersuchung von Vorfällen große Mengen an Maschinendaten abzufragen.
Wichtige Funktionen von Splunk
- Benutzerdefinierte Dashboards: Erstellen Sie visuelle Ansichten mit Diagrammen, Tabellen und Servicedaten.
- Alarmdetektoren: Legen Sie Bedingungen fest, die Alarme auslösen, wenn überwachte Signale Schwellenwerte überschreiten.
- Kubernetes-Überwachung: Untersuchen Sie den Zustand von Clustern, Knoten und Workloads im Kubernetes Navigator.
- Synthetische Überwachung: Führen Sie skriptbasierte Tests durch, um die Verfügbarkeit von Anwendungen und Antwortzeiten zu überprüfen.
Integrationen von Splunk
Splunk Observability Cloud unterstützt Integrationen mit AWS CloudWatch, Google Cloud Platform, Microsoft Azure, Jira, Microsoft Teams, PagerDuty, ServiceNow und Slack. Die Integrations-API konfiguriert unterstützte Verbindungen, während Splunkbase Anwendungen, Erweiterungen und Konnektoren bereitstellt.
Pros and Cons
Pros:
- Durchsucht große Mengen an Maschinendaten nach Hinweisen auf Vorfälle
- Verknüpft Protokolle, Metriken und Ablaufverfolgungen für Untersuchungen
- Benutzerdefinierte Dashboards und Alarme unterstützen eine gezielte Triage
Cons:
- Die Kosten können steigen, wenn die Telemetrieaufnahme zunimmt
- Aufwendige Abfragen können Dashboards bei großer Skalierung verlangsamen
Learn more about Splunk:
Weitere Dynatrace-Alternativen
Hier sind einige weitere Dynatrace-Alternativen, die es nicht in meine Auswahl geschafft haben, aber dennoch einen Blick wert sind:
- 11PrometheusAm besten geeignet für robustes Monitoring in Kubernetes-Umgebungen
- 12Grafana CloudAm besten geeignet für Open-Source-Visualisierung und Analysen
- 13ElasticAm besten geeignet für Echtzeitsuche und Datenanalysen
- 14SolarWinds Observability SaaSAm besten für KI-gesteuerte Priorisierung von Warnmeldungen
- 15SysdigAm besten geeignet für Container- und Kubernetes-Sicherheit
- 16Dotcom MonitorAm besten für Echt-Browser-Simulationen geeignet
- 17IcingaGut für eine umfassende Überwachung mit starker Unterstützung durch die Community
Weitere Softwarebewertungen
Wie ich Dynatrace-Alternativen bewerte
Ich bewerte jedes Tool auf zwei Ebenen: die unverzichtbaren Funktionen wie Full-Stack-APM und verteiltes Tracing sowie die Besonderheiten, die unterschiedliche Plattformen für verschiedene Teams und Stacks differenzieren.
Kernfunktionalität (Grundvoraussetzung für diese Liste)
Wenn ich Tools für meine Liste auswähle, bewerte ich jedes auf einer Skala von 0 (bietet die Funktion nicht) bis 5 (überzeugt in diesem Bereich) für jede unten aufgeführte Kernfunktionalität. Anschließend rechne ich die Gesamtpunktzahl des Tools in einen Prozentsatz um. Jedes Tool muss eine Mindestgesamtpunktzahl von 75 % erreichen, um berücksichtigt zu werden.
- Full-Stack APM: Ich prüfe, ob das Tool Transaktions-Tracing auf Codeebene für wichtige Sprachen und Frameworks ermöglicht, etwa wenn ein langsamer Datenbankaufruf in einem Java-Microservice verborgen ist.
- Infrastruktur-Monitoring: Jedes Tool sollte Server, Container, Kubernetes-Cluster und Cloud-Services mit automatischer Erkennung abdecken, anstatt eine manuelle Einrichtung je Host zu verlangen.
- Verteiltes Tracing: Ich bewerte, wie gut sich Traces über Service-Grenzen hinweg verfolgen lassen und ob die Plattform OpenTelemetry-Ingestion unterstützt – das ist wichtig für Teams mit polyglotten Stacks.
- Log-Management & -Analyse: Logs müssen mit Traces und Metriken in einer Ansicht korreliert werden, damit ein SRE von einem Anstieg der Fehlerrate direkt zu den zugehörigen Logzeilen springen kann.
- KI-basierte Anomalieerkennung: Ich suche nach maschinellem Lernen, das normales Verhalten als Basislinie nutzt und Vorschläge für die Ursachensuche liefert – nicht nur statische Schwellwert-Alarme, die On-Call-Kanäle überfluten.
- Monitoring echter Nutzer & synthetisches Monitoring: Die Plattform sollte sowohl RUM für die Analyse des Live-Traffics als auch synthetische Prüfungen bieten, um etwa fehlerhafte Checkout-Prozesse oder API-Ausfälle zu erkennen, bevor echte Nutzer betroffen sind.
Sobald ich eine Liste mit Tools habe, die diese Kriterien erfüllen, betrachte ich die Unterschiede zwischen den Plattformen.
Unterscheidungsmerkmale (Was Anbieter voneinander abhebt)
So vergleiche und kontrastiere ich verschiedene Anbieter:
Herausragende Funktionen
Transparente Preisgestaltung ist beim Wechsel von Dynatrace wichtig, daher bewerte ich, ob eine Plattform vorhersehbare nutzungsbasierte Preise mit klaren Kostenkontrollen bietet. Native Unterstützung für OpenTelemetry ist ein weiteres zentrales Unterscheidungsmerkmal – Teams, die bereits OTel-Collector nutzen, sollten nicht alles gegen proprietäre Agenten austauschen müssen. Ich achte außerdem auf automatisierte Remediation-Workflows, die bei einer Anomalie Runbooks auslösen oder über Tools wie PagerDuty eskalieren, sodass Alarme ohne manuelles Zutun in Aktionen umgesetzt werden.
Mehr als nur Funktionen
Flexible Bereitstellungsmöglichkeiten sind entscheidend – ich prüfe, ob eine Plattform SaaS, Selbst-Hosting und hybride Modelle unterstützt, weil Teams in regulierten Branchen oft On-Premises- oder bestimmte Datenresidenz-Optionen benötigen. Das Integrations-Ökosystem beeinflusst ebenfalls, wie gut ein Tool in den vorhandenen Stack passt. Native Connectoren zu CI/CD-Pipelines, ITSM-Plattformen wie ServiceNow und Incident-Tools wie Opsgenie machen während der Einführung einen echten Unterschied. Ich berücksichtige auch Compliance-Zertifizierungen wie SOC 2 Typ II und ISO 27001 sowie SSO und rollenbasierte Zugriffskontrollen.
Warum nach einer Dynatrace-Alternative suchen?
Obwohl Dynatrace eine gute Wahl als Plattform zur Überwachung der Anwendungsleistung (APM) ist, gibt es mehrere Gründe, warum manche Benutzer nach alternativen Lösungen suchen. Vielleicht suchen Sie nach einer Dynatrace-Alternative, weil …
- die Preise für kleinere Teams zu hoch werden können
- die Lernkurve für neue Benutzer zu steil erscheint
- Sie einfachere Dashboards und Berichte wünschen
- Sie flexiblere Optionen für Warnmeldungen und Benachrichtigungen benötigen
- Sie eine hybride Umgebung betreiben und umfassendere Integrationen benötigen
- Sie Tools mit transparenterer Abrechnung bevorzugen
Wenn Sie sich in einem dieser Punkte wiedererkennen, sind Sie hier richtig. Meine Liste enthält mehrere Plattformen zur Überwachung der Anwendungsleistung (APM), die besser für Teams geeignet sind, die mit diesen Herausforderungen bei Dynatrace konfrontiert sind und nach alternativen Lösungen suchen.
Die wichtigsten Funktionen von Dynatrace
Hier sind einige der wichtigsten Funktionen von Dynatrace, die Ihnen dabei helfen, die Angebote alternativer Lösungen gegenüberzustellen und zu vergleichen:
- Überwachung des gesamten Stacks: Ermöglicht Ihnen, die Anwendungsleistung, die Infrastruktur und die Benutzererfahrung an einem Ort zu verfolgen.
- Davis-KI-Engine: Erkennt Probleme automatisch und erklärt deren Ursache, damit Ihr Team Zeit spart.
- Überwachung echter Benutzer: Zeigt, wie echte Benutzer mit Ihrer Anwendung interagieren, damit Sie relevante Probleme beheben können.
- Anwendungssicherheit: Kennzeichnet Schwachstellen in Echtzeit, während Ihr Code in der Produktionsumgebung ausgeführt wird.
- Unterstützung für Cloud-native-Umgebungen: Funktioniert gut mit Kubernetes, AWS, Azure und anderen Cloud-Umgebungen.
- Intelligente Alarmierung: Sendet nur bei Bedarf Warnmeldungen, sodass Ihr Team eine Alarmmüdigkeit vermeidet.
- Benutzerdefinierte Dashboards: Ermöglicht Ihnen, Ansichten zu erstellen, die auf die Bedürfnisse und Metriken Ihres Teams zugeschnitten sind.
- Einblicke auf Codeebene: Hilft Ihnen dabei, die Leistung bis hin zu einzelnen Codezeilen zu untersuchen.
- Protokollverwaltung: Ermöglicht Ihnen, Protokolle zu durchsuchen, zu filtern und zu analysieren, um Probleme schneller zu beheben.
- Synthetische Überwachung: Simuliert Benutzeraktionen, damit Sie die Anwendungsleistung von verschiedenen Standorten aus testen können.
Zusammenfassung
In diesem Einkaufsratgeber haben wir uns eingehend mit Alternativen zu Dynatrace beschäftigt und verschiedene Optionen untersucht, die auf bestimmte Anwendungsfälle zugeschnitten sind. Ganz gleich, ob Sie ein Tool für Open-Source-Überwachung auf Unternehmensebene, für Protokollverwaltung und Sicherheitsanalysen oder für die Sicherheit von Containern und Kubernetes suchen – Sie haben viele leistungsfähige Optionen zur Auswahl.
Hier sind drei wichtige Erkenntnisse aus diesem Ratgeber:
- Bewerten Sie Ihre Anforderungen: Verschiedene Tools wurden für unterschiedliche Anwendungsfälle entwickelt. Einige eignen sich gut für eine umfangreiche Protokollverwaltung, andere für Open-Source-Umgebungen und wieder andere für die Sicherheit von Containern und Kubernetes. Wenn Sie die individuellen Anforderungen Ihres Unternehmens verstehen, finden Sie das passende Tool.
- Sehen Sie sich die Funktionen an: Tools können ähnliche Kernfunktionen bieten, aber der Teufel steckt im Detail. Die einzigartigen Funktionen der einzelnen Tools, ihre Benutzerfreundlichkeit und ihre Integrationen mit anderen von Ihnen verwendeten Tools können Ihre Überwachungserfahrung entscheidend beeinflussen.
- Berücksichtigen Sie die Preise: Auch wenn die Kosten oft ein wichtiger Faktor sind, sollten Sie berücksichtigen, was Sie für Ihr Geld bekommen. Ein teureres Tool bietet möglicherweise die leistungsfähigen Funktionen oder den Support, den Sie benötigen. In manchen Fällen genügt jedoch auch ein günstigeres oder sogar kostenloses Tool Ihren Anforderungen.
Denken Sie daran: Welches Tool das „beste“ ist, hängt vollständig von den spezifischen Anforderungen und Umständen Ihres Unternehmens ab. Mit den Informationen aus diesem Ratgeber sind Sie bestens gerüstet, um eine fundierte Entscheidung zu treffen.