

10 bästa NoSQL-databaserna granskade för 2026

Kortlista över de bästa NoSQL-databaserna


De bästa NoSQL-databaserna hjälper team att hantera stora, ostrukturerade eller snabbt föränderliga datamängder utan de strikta schemakrav som traditionella relationssystem har. De möjliggör snabbare frågor, enklare skalning och bättre stöd för distribuerade arkitekturer, vilket är avgörande för moderna användningsområden som realtidsanalys, innehållshantering och bearbetning av IoT-data.
Team börjar ofta leta efter NoSQL-lösningar när de når relationsdatabasernas begränsningar: långsamma frågor under hög belastning, schemaändringar som bryter arbetsflöden eller svårigheter att synkronisera data mellan regioner. Utmaningar som ojämn prestanda, problem med datareplikering och komplexa skalningskrav kan göra det mycket svårare att hantera tillväxt utan rätt plattform.
Jag har arbetat med teknik- och datateam som utvärderar NoSQL-databaser för allt från analyspipelines till webbappar med hög trafik, där jag har testat deras prestanda, replikeringskonfigurationer och integration med molnmiljöer.
I den här guiden får du lära dig vilka NoSQL-databaser som erbjuder hög prestanda, förenklar skalning och stöder den dataflexibilitet som dina applikationer faktiskt behöver.
Varför du kan lita på våra programvarurekommendationer
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Sammanfattning av de bästa NoSQL-databaserna
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bästa serverlösa NoSQL-databasen | Gratisnivå tillgänglig | Från $1/månad | Website | |
| 2 | Bästa NoSQL-databasen för fullt fungerande ACID-transaktioner | Gratisversioner finns tillgängliga | Från $789/core/year | Website | |
| 3 | Bästa NoSQL-databasen med breda kolumner | Gratisversion tillgänglig | Ingen betalplan | Website | |
| 4 | Bästa NoSQL-databasen när användarvänlighet är viktigt | Gratisversion tillgänglig | Skrivoperationer från $1.25/miljon förfrågningar; läsoperationer från $0.25/miljon förfrågningar. | Website | |
| 5 | Bästa kolumnorienterade databasen för lagring av mycket stora datamängder | Gratisversion tillgänglig | Inget betalalternativ | Website | |
| 6 | Bästa dokumentbaserade NoSQL-databasen | Gratisversion tillgänglig | Dedikerad från $57/månad eller serverlös från $0.10/miljon läsningar | Website | |
| 7 | Bästa moln- och rutnätsbaserade NoSQL-databasen | Gratisversion tillgänglig | Fast licens från $15,456/år | Website | |
| 8 | Bästa grafbaserade NoSQL-databasen | Gratisversion tillgänglig | Pris på begäran | Website | |
| 9 | Bäst för SQL-liknande funktionalitet | Gratis provperiod tillgänglig | Från $0.28/hr per nod | Website | |
| 10 | Bästa NoSQL-databasen för nyckel-värdedata | Gratisversion tillgänglig | Från $7/månad eller $0.881/timme | Website |
Recensioner av de bästa NoSQL-databaserna
Här är mina rekommendationer för de 12 bästa NoSQL-databaserna och de scenarier där jag anser att var och en fungerar bäst.

Bästa serverlösa NoSQL-databasen

IBM Cloudant finns på min lista eftersom det är en av de få NoSQL-databaser som skalas elastiskt som ett renodlat serverlöst erbjudande. För team som kör distribuerade appar som behöver global genomströmning och hanterad replikering fungerar Cloudants automatiska sharding och ständiga tillgänglighet bara. Jag uppskattar att man aldrig behöver hantera infrastrukturen, inte ens vid oförutsägbar tillväxt eller arbetsbelastningar i stor skala.
IBM Cloudant passar bäst för
- Appar som behöver hög tillgänglighet och serverlös skalning
- Team som bygger distribuerade, globalt tillgängliga NoSQL-datalager
IBM Cloudant passar mindre bra för
- Arbetsbelastningar som behöver komplexa relationsfrågor eller kopplingar
- Lokala driftsättningar eller strikta krav på datalagring inom ett visst land eller en viss region
Vad som särskiljer IBM Cloudant
Cloudants grundidé är enkel: du fokuserar bara på dina data och API:er, medan tjänsten hanterar den underliggande infrastrukturen. Till skillnad från MongoDB, där du förväntas hantera sharding, skalning eller patchning, tar Cloudant fullt ansvar för att hålla allt responsivt och distribuerat. Detta fungerar bäst när du vill prioritera global åtkomst, drifttid och låg administrativ belastning.
Avvägningar med IBM Cloudant
Cloudant optimerar för serverlös, hanterad infrastruktur, så du går miste om den djupa anpassningsmöjlighet och kontroll som du skulle få med en självhanterad NoSQL-databas. Detta begränsar avancerad schemaanpassning eller databasoperationer på låg nivå.
Pros and Cons
Pros:
- Omfattande säkerhet
- Serverlöst schema för enkel konfiguration
- Gratisversion tillgänglig
Cons:
- En del av dokumentationen är inaktuell
- Långsam indexering av stora databaser

RavenDB
Bästa NoSQL-databasen för fullt fungerande ACID-transaktioner
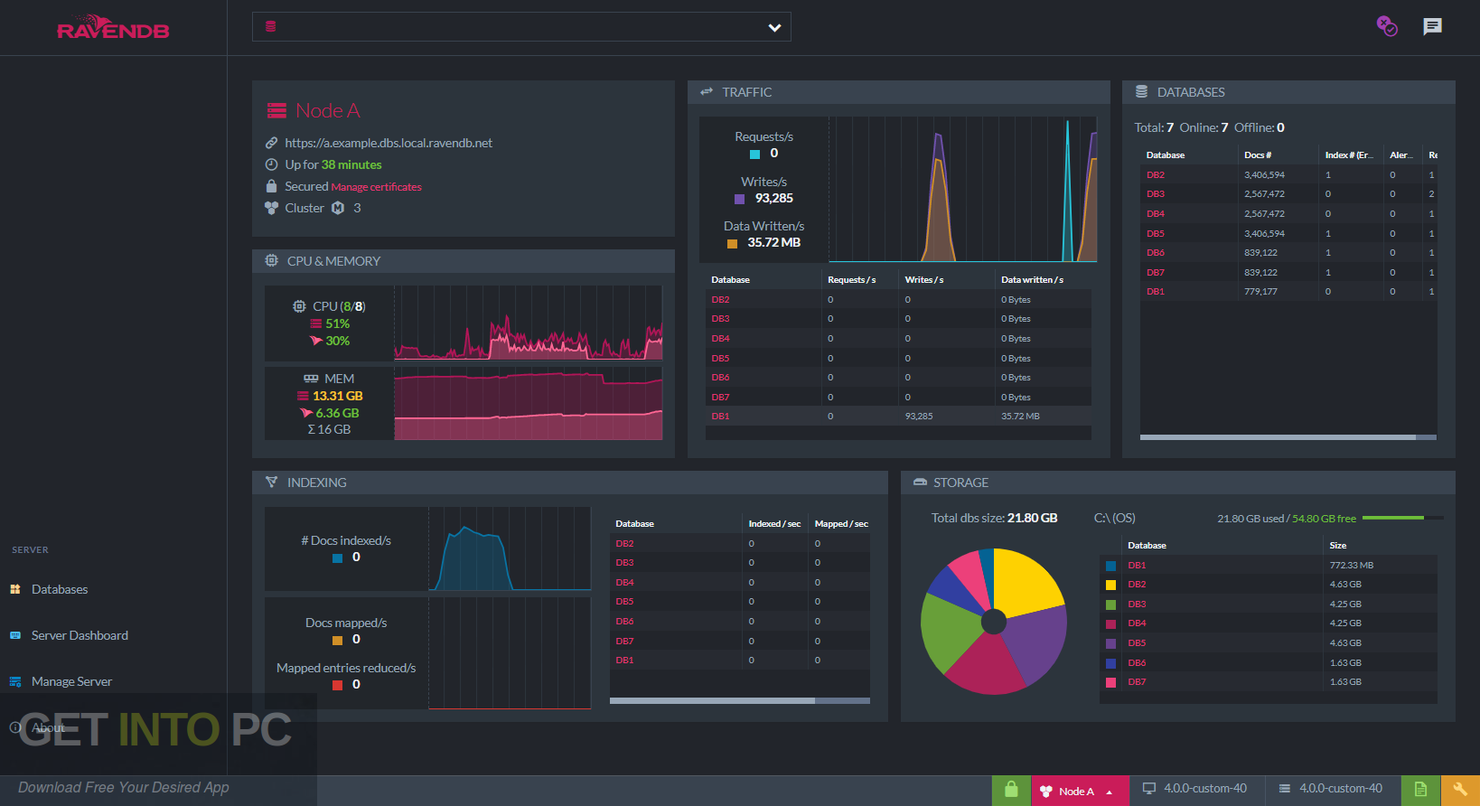
RavenDB förtjänade sin plats eftersom det är den enda NoSQL-databas jag har arbetat med som levererar fullständiga ACID-transaktioner utan att kompromissa med prestandan. För team som bygger appar som kräver transaktionell integritet, särskilt vid hantering av aggregatuppdateringar över flera dokument, fungerar RavenDB tillförlitligt utan de vanliga kompromisserna. Jag har stor respekt för hur den hanterar distribuerade transaktioner och replikering i realtid, vilket sätter en hög standard för datakonsistens och datasäkerhet.
RavenDB passar bäst för
- Applikationer som kräver fullständiga ACID-transaktioner i en NoSQL-databas
- Team som hanterar komplexa uppdateringar över flera dokument
RavenDB passar mindre bra för
- Enkla användningsfall för lagring av nyckel-värde-par
- Projekt som behöver omfattande molnintegrationer direkt ur lådan
Det som skiljer RavenDB från mängden
RavenDB hanterar NoSQL-data med fokus på transaktionell säkerhet, vilket skiljer den från MongoDB och Couchbase, som betonar prestanda eller bredd i datamodeller. I stället för att behandla transaktioner som en avancerad funktion eller ett tillägg förväntar den sig att du ser ACID-garantier som en viktig del av ditt arbetsflöde. I praktiken fungerar detta bäst om ditt team redan är vant vid att tänka enligt relationsdatabasprinciper och vill ha förutsägbar datakonsistens i en dokumentmiljö.
Kompromisser med RavenDB
RavenDB optimerar för transaktionell integritet, men du går miste om den enklare driftsättningen och de omfattande molntjänsteintegrationerna som du skulle få med mer populära NoSQL-alternativ. Om du vill ha en snabb introduktion med färdiga integrationer kommer du att upptäcka att installationen här kräver mer arbete.
Pros and Cons
Pros:
- Lättanvänt gränssnitt
- ACID-transaktioner säkerställer högre datakonsistens och sparar tid
- Lokala installationer och molnversioner
Cons:
- Enterprise-versionen är dyr
- Brist på communitysupport och dokumentation

Bästa NoSQL-databasen med breda kolumner

CASSANDRA förtjänar sin plats här eftersom den hanterar massiva skrivarbetsbelastningar med hög hastighet bättre än någon annan NoSQL-databas jag har testat. Jag brukar rekommendera den när ditt team behöver linjär skalbarhet för tidsseriedata eller IoT och vill ha justerbar konsekvens mellan regioner.
Det jag uppskattar mest är hur CASSANDRA:s arkitektur med breda kolumner hanterar enorma datamängder samtidigt som den förblir responsiv i stor skala.
CASSANDRA passar bäst för
- IoT-, tidsserie- eller händelsedatabelastningar med hög genomströmning
- Distribuerade appar som behöver skalbara datalager i flera regioner
CASSANDRA passar inte bra för
- Relationella datamodeller eller SQL-liknande kopplingar
- Små team utan infrastrukturkompetens
Vad som skiljer CASSANDRA från mängden
CASSANDRA är utformad för massiv skala och ständig tillgänglighet, så den förutsätter att du behöver skriva och läsa data över många noder utan avbrott. Till skillnad från MongoDB, som fokuserar på samlingar och dokumentformat, förväntar sig CASSANDRA att du planerar data i förväg som breda tabeller för snabb inläsning och hämtning. Den här metoden fungerar bäst när din arbetsbelastning handlar om snabbhet och horisontell skalning, inte om flexibla ad hoc-frågor.
Avvägningar med CASSANDRA
CASSANDRA optimerar för skalning och partitionstolerans, men du förlorar de avancerade frågemöjligheter och den kopplingslogik som finns i traditionella relationella eller dokumentorienterade databaser. Det gör rapportering och datautforskning i realtid mycket svårare.
Pros and Cons
Pros:
- Stöd för hybridmoln (privata och offentliga) samt lokala installationer
- Kan hantera stora mängder ostrukturerad data
- Horisontell skalning för att hantera växande databehov
Cons:
- Inga ad hoc-frågor
- Kräver periodiskt manuellt underhåll

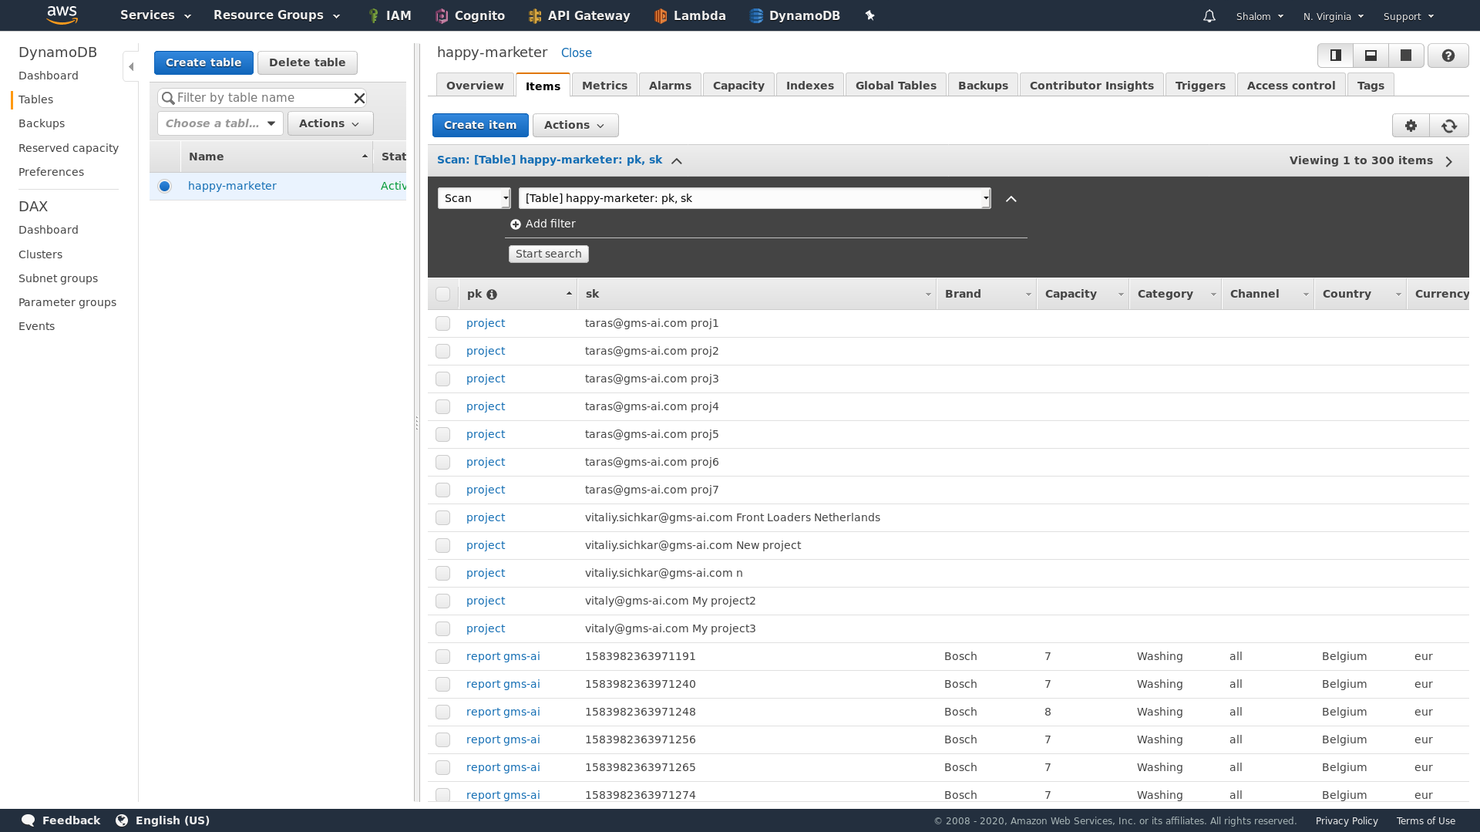
Amazon DynamoDB utmärker sig för mig genom hur väl tjänsten abstraherar infrastrukturhantering för team som börjar använda NoSQL. Jag ser att team dras till den när de vill hantera arbetsbelastningar med hög hastighet och behöver inbyggd skalning för oförutsägbar trafik.
Det jag uppskattar mest är den automatiska kapacitetshanteringen och globala tabeller för replikering över regioner – det avlastar dig betydligt. Du kan fokusera på att bygga funktioner i stället för att kämpa med manuell shardning eller provisionering.
Amazon DynamoDB passar bäst för
- Applikationer med oförutsägbar, hög eller plötsligt ökande trafik
- Team som behöver automatisk skalning och global replikering
Amazon DynamoDB passar mindre bra för
- Arbetsbelastningar som kräver kopplingar mellan flera tabeller eller komplexa frågor
- Team som vill ha funktioner från relationsdatabaser eller SQL-kompatibilitet
Vad som skiljer Amazon DynamoDB från mängden
DynamoDB är utformat för arbetsbelastningar med hög skala och händelsestyrning, där du vill skriva och läsa snabbt utan att hantera några servrar. Tjänsten utgår från att du indexerar data utifrån nyckelattribut och arbetar enligt mönster med en enda tabell och hög hastighet, mer som en hanterad nyckel-värde-databas än en klassisk NoSQL-databas som MongoDB. I stället för att erbjuda flexibilitet vid frågor eller i datastrukturen satsar DynamoDB fullt ut på tillförlitlighet, shardning och global distribution.
Kompromisser med Amazon DynamoDB
DynamoDB optimerar för hastighet och skala, men du avstår från kopplingar av relationsdatabastyp och flexibla ad hoc-frågor. Det innebär att du behöver tänka om kring datamodelleringen om du är van vid SQL eller applikationer som bygger på komplexa relationer.
Pros and Cons
Pros:
- Enkel att konfigurera och använda
- Omfattande dokumentation och support
- AWS-integration för utökad funktionalitet
Cons:
- Inget alternativ för lokal drift
- Begränsad till AWS-molnet

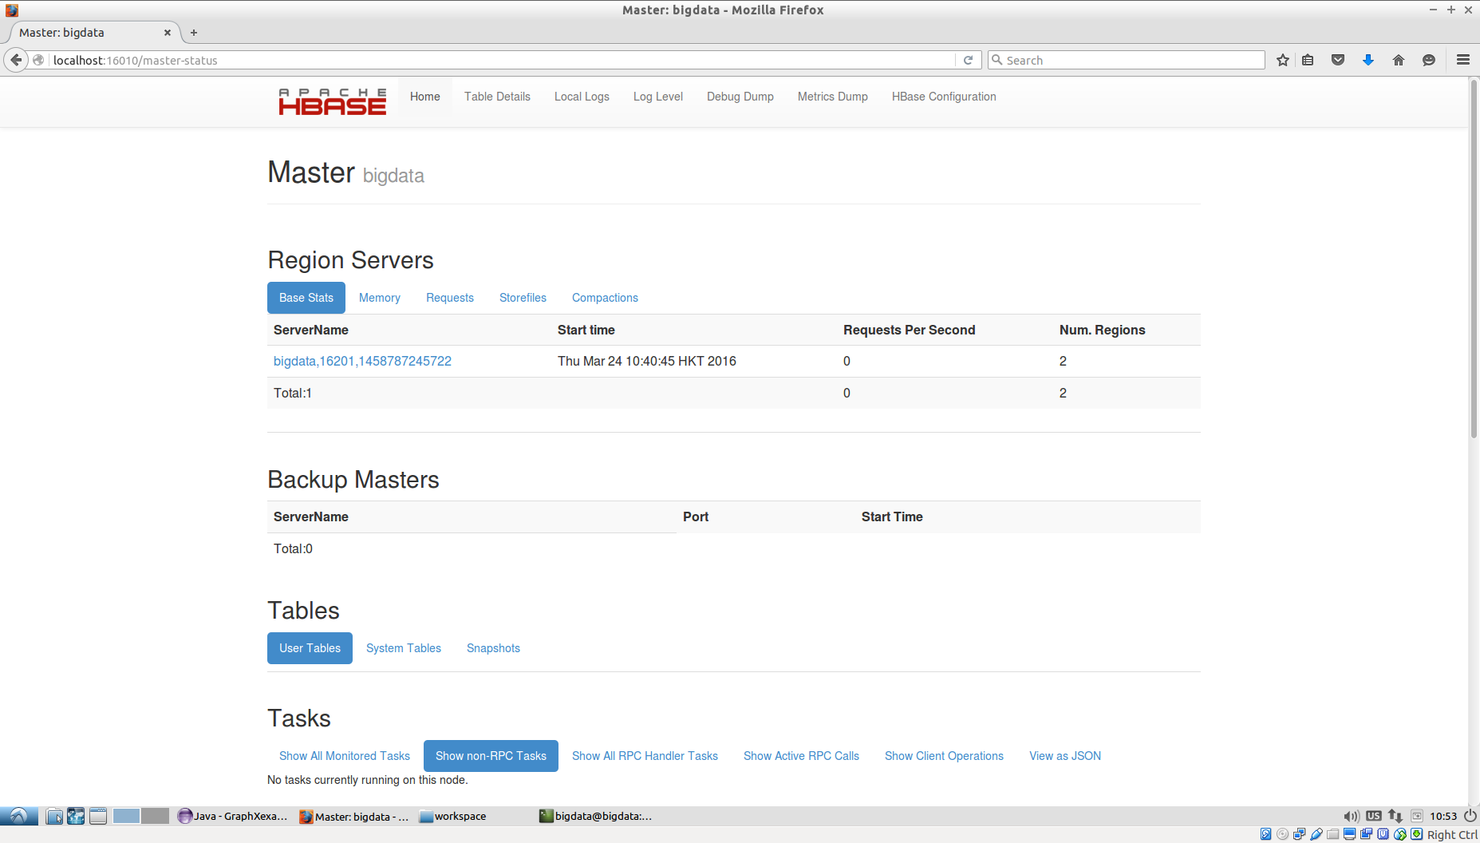
HBase finns med på den här listan eftersom det är utformat specifikt för lagring och hämtning av enorma volymer glesa, distribuerade data. Jag rekommenderar det till team som kör analys-, IoT- eller efterlevnadsarbetsbelastningar där ni behöver snabb åtkomst till breda tabeller över kluster.
Jag uppskattar verkligen hur HBase hanterar horisontell skalning och stark konsekvens. Det låter dig lagra petabyte på ett tillförlitligt sätt och köra realtidsfrågor, även när datamängden fortsätter att växa.
Bäst för HBase
- Lagring av högvolymdata med breda kolumner i realtid
- Datavaruhus, analys och IoT-arbetsbelastningar i stor skala
Mindre lämpligt för HBase
- Enkla nyckel-värde- eller dokumentcentrerade datamodeller
- Projekt som behöver SQL-baserade frågor och transaktioner
Det som skiljer HBase från mängden
HBase är byggt för massiv skalning och förutsätter att du tänker i termer av kolumnfamiljer och distribuerad lagring snarare än traditionella tabeller. Till skillnad från MongoDB, som fungerar bra för snabb dokumentmodellering, passar HBase när du vill lagra biljoner rader och behöver konsekventa uppslag med låg latens över petabyte data. I praktiken passar detta bra för strömningsanalys eller sensordata som du vill hålla tillgängliga.
Kompromisser med HBase
HBase optimerar för skala och genomströmning, men det innebär att du förlorar de bekväma frågemöjligheter och den flexibla datamodellering som finns i dokumentlagringssystem. För den som är van vid SQL-liknande arbetsflöden kan detta tillvägagångssätt göra utvecklingen långsammare och öka behovet av noggrann schemaplanering.
Pros and Cons
Pros:
- Gratis att använda
- Integration med Apache Hadoop
- Horisontellt skalbar över tusentals servrar
Cons:
- Färre inbyggda funktioner än Cassandra – är beroende av tredjepartsintegration
- Kräver mycket CPU och minne

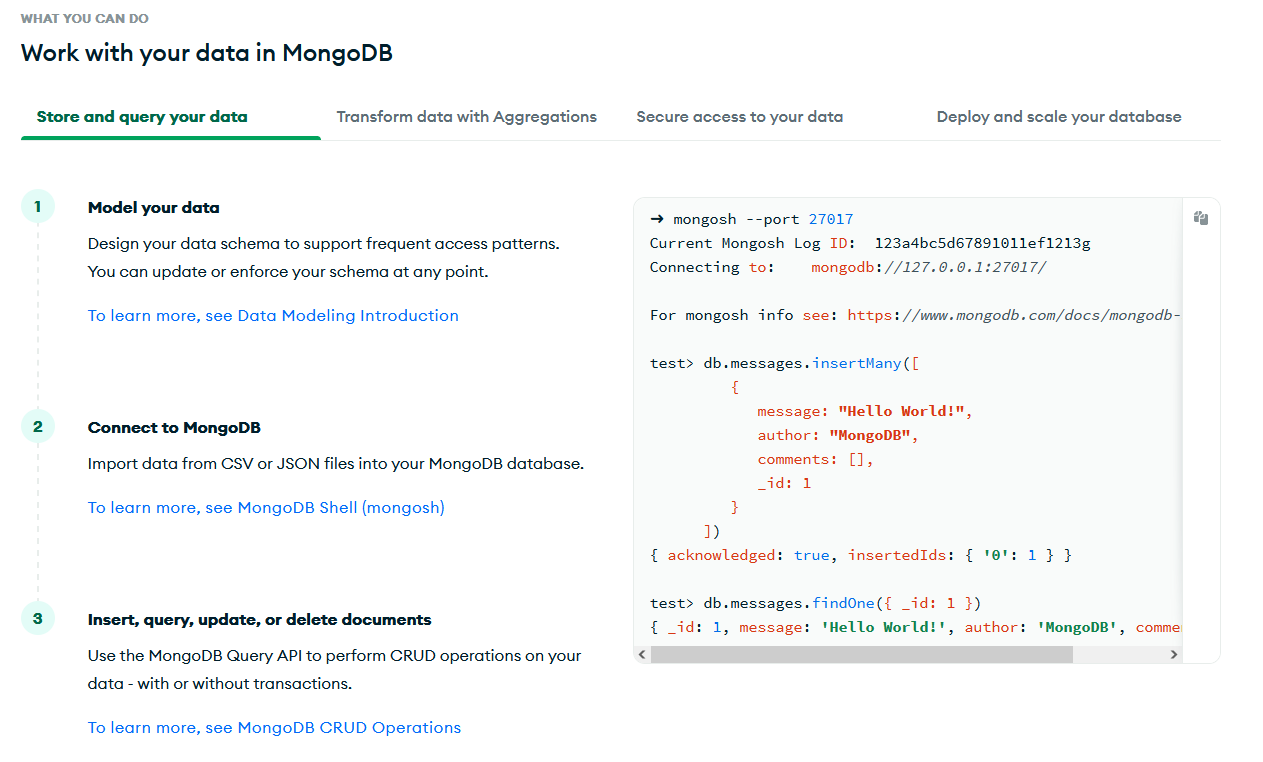
MongoDB hamnar på min kortlista tack vare hur väl det hanterar dokumentbaserade NoSQL-arbetsbelastningar i stor skala. Det använder flexibla JSON-liknande dokument i stället för rigida tabeller, så att du enkelt kan mappa komplexa, nästlade data med scheman som förändras.
Det jag verkligen uppskattar är stödet för replikuppsättningar och automatisk horisontell partitionering. Det fungerar bra när team behöver snabb, skalbar lagring för applikationer med stora datamängder eller dataloggning.
MongoDB passar bäst för
- Team som behöver snabb, flexibel dokumentorienterad datalagring
- Utbyggbara applikationer med dynamiska eller komplexa scheman
MongoDB passar inte lika bra för
- Arbetsbelastningar som kräver strikt transaktionskonsistens över flera rader
- Omfattande relationsdata med komplexa krav på sammanfogningar
Det som skiljer MongoDB från mängden
MongoDB uppmuntrar dig att tänka i dokument, inte tabeller, så att du kan lagra komplexa, nästlade data som enskilda objekt som återspeglar applikationens struktur. I praktiken blir detta mycket mer naturligt när du arbetar med applikationer som förändras ofta, till exempel innehållshantering eller händelseloggning.
Till skillnad från relationsdatabaser som MySQL behöver du inte utforma rigida scheman. Den flexibiliteten tycker jag är särskilt användbar när datastrukturen inte är stabil.
Avvägningar med MongoDB
MongoDB optimerar för flexibilitet i schemat och horisontell skalning, men du förlorar relationslogik med många sammanfogningar och strikta garantier för transaktioner över flera dokument—vilket innebär att det inte passar särskilt bra om dina arbetsflöden är beroende av transaktionsintegritet över många dokument.
Pros and Cons
Pros:
- BSON utökar stödet för datatyper samtidigt som behovet av parsning minskar
- Omfattande dokumentation och stöd från en stor användargrupp
- Avsaknad av förutbestämt schema förbättrar flexibilitet och skalbarhet
Cons:
- BSON använder mer lagringsutrymme än JSON
- Vissa prestandaproblem med större databaser

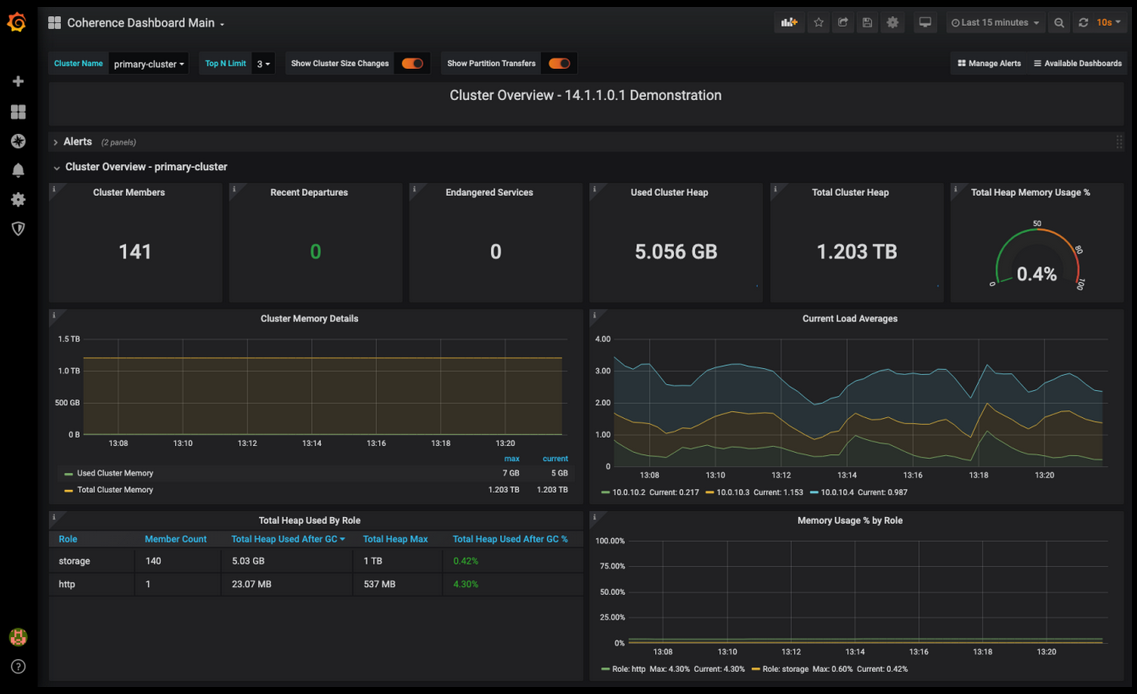
Oracle Coherence är ett av mina främsta val när organisationer behöver ett datarutnät i minnet som skalas över moln- och lokala miljöer. Det jag tycker särskiljer det är fokuset på elastisk klustring och datatillgänglighet i realtid, även vid oförutsägbara belastningar.
Jag uppskattar särskilt den inbyggda integrationen med Oracle Cloud, vilket gör det enkelt för team som hanterar komplexa transaktionsarbetsbelastningar eller användningsfall med stora volymer och låg fördröjning i distribuerade system.
Oracle Coherences bästa användningsområden
- Företag som kör verksamhetskritiska applikationer med hög genomströmning
- Team som behöver datarutnät i realtid över moln- och lokala miljöer
Oracle Coherence passar inte lika bra för
- Små projekt med låga krav på skalbarhet
- Team som vill ha en enkel NoSQL-distribution med ett klick
Vad som särskiljer Oracle Coherence
Oracle Coherence är utvecklat för organisationer som betraktar distribuerade data i realtid som en central del av infrastrukturen. I stället för den plug-and-play-strategi som MongoDB eller DynamoDB erbjuder förväntar sig Coherence att du utformar system som passar krävande scenarier med hög genomströmning. Jag upplever att det är strukturerat för användningsfall där låg fördröjning är viktigare än flexibilitet eller enkel installation.
Det utmärker sig jämfört med Redis, som hanterar cachelagring men inte är lika inriktat på klustring för stora, transaktionsintensiva system.
Avvägningar med Oracle Coherence
Coherence optimerar för skalning och konfigurerbarhet, men det innebär att installation och underhåll kräver mer expertis och löpande finjustering än enklare NoSQL-alternativ.
Pros and Cons
Pros:
- Gratis att använda
- Många funktioner för att upprätthålla datakonsistens
- Starkt stöd från communityn och bra dokumentation
Cons:
- Begränsad standardsäkerhet
- Svår uppgraderingsprocess

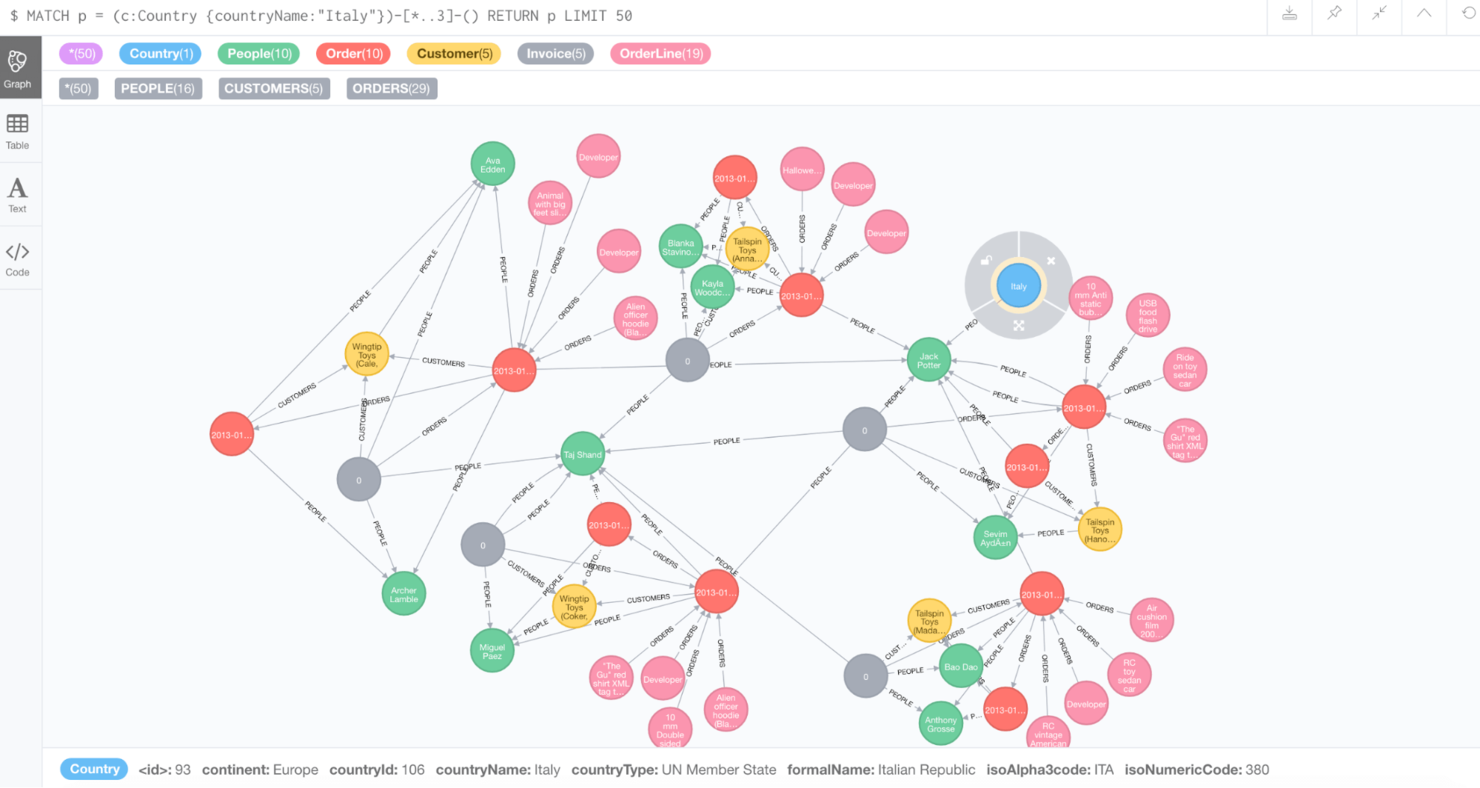
Neo4j får en plats här tack vare sin dedikerade grafbaserade datamodell, som skiljer sig från de flesta NoSQL-alternativ. Jag ser att team får störst nytta av Neo4j när de behöver modellera och fråga efter djupt sammanlänkade data, till exempel relationer mellan IT-tillgångar, behörighetsmappning eller upptäckt av bedrägerivägar.
Det jag gillar mest är frågespråket Cypher och funktionerna för realtidsgenomsökning, som gör att du kan upptäcka komplexa mönster i enorma datamängder utan en massa anpassad kod.
Neo4j:s bästa användningsområden
- Modellering och sökning i komplexa, starkt sammanlänkade datamängder
- IT-, säkerhets- eller analysteam som kartlägger relationer i verkligheten
Neo4j:s mindre lämpliga användningsområden
- Arbetsbelastningar som kräver enkel nyckel-värde- eller dokumentlagring
- Team utan behov av grafdata eller erfarenhet av grafbaserade frågor
Vad som skiljer Neo4j från mängden
Neo4j bygger sin modell kring relationer mellan datapunkter, inte bara lagring av värden eller dokument. Till skillnad från MongoDB eller Cassandra uppmuntrar det dig att tänka i termer av sammanlänkade entiteter och hur de interagerar. Detta fungerar bra när ditt arbete handlar om att kartlägga nätverk i verkligheten – användare, tillgångar, behörigheter eller beroenden – där vägidentifiering eller förståelse av relationsmönster är centralt.
Kompromisser med Neo4j
Neo4j är optimerat för att utforska och analysera kopplingar, men det grafbaserade tankesättet gör enkel lagring och CRUD mer komplext. Om ditt användningsfall handlar om enkel datahämtning känns det vanligtvis som mer databas än du behöver.
Pros and Cons
Pros:
- ACID-transaktioner säkerställer att databasoperationer genomförs över alla noder
- Stark community och omfattande dokumentation
- Överraskande lätt att lära sig och använda
Cons:
- Anpassad prissättning för företagsutgåvan
- Nya versioner kan introducera nya fel

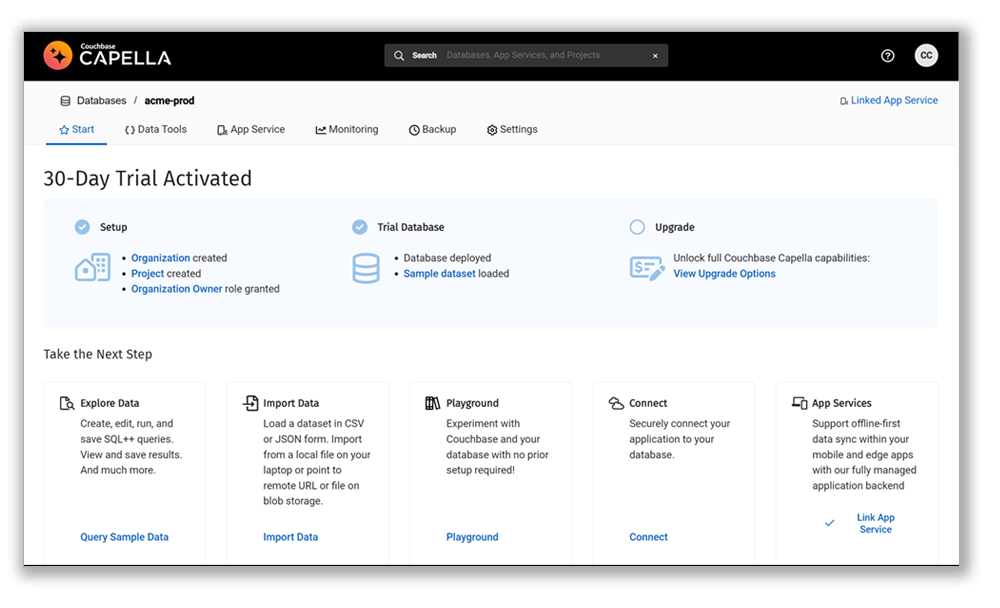
Couchbase Capella tar plats på min lista eftersom det är en av de få NoSQL-plattformarna som erbjuder välbekanta SQL-liknande frågor mot distribuerade JSON-data. Jag gillar hur Capellas N1QL-språk låter team köra uttrycksfulla frågor, kopplingar och aggregeringar som vanligtvis inte är enkla att genomföra i NoSQL-databaser. Det är därför jag rekommenderar det till team som behöver NoSQL-flexibilitet men inte kan överge sina SQL-kunskaper.
Bäst för Couchbase Capella
- Team som använder SQL-kunskaper med NoSQL-datamodeller
- Storskaliga applikationer som behöver flexibla frågor och hög prestanda
Inte särskilt bra för Couchbase Capella
- Mindre projekt med minimala behov av frågor
- Enkla arbetsbelastningar där relationsdatabaser räcker
Vad som skiljer Couchbase Capella från mängden
Capella är utformat för team som vill använda flexibla NoSQL-databaser men behålla sitt välbekanta SQL-liknande sätt att modellera och fråga data. I stället för att överge koncept som kopplingar, aggregeringar eller ad hoc-sökningar behåller du dem med N1QL. Det känns välbekant om du har en bakgrund inom MySQL eller PostgreSQL. Jämfört med något som MongoDB kan du uttrycka mer logik i en enda fråga.
Kompromisser med Couchbase Capella
Capella optimerar för SQL-liknande frågor mot distribuerade JSON-data, men den extra uttryckligheten medför mer omkostnader och komplexitet om du bara behöver ett grundläggande nyckel-värde- eller dokumentlager.
Pros and Cons
Pros:
- Kombinerar fördelarna med SQL- och NoSQL-databaser på en och samma plattform
- Inbyggd tjänst för apputveckling och distribution
- Mycket bra valuta för pengarna
Cons:
- Brant inlärningskurva
- Begränsade integrationer

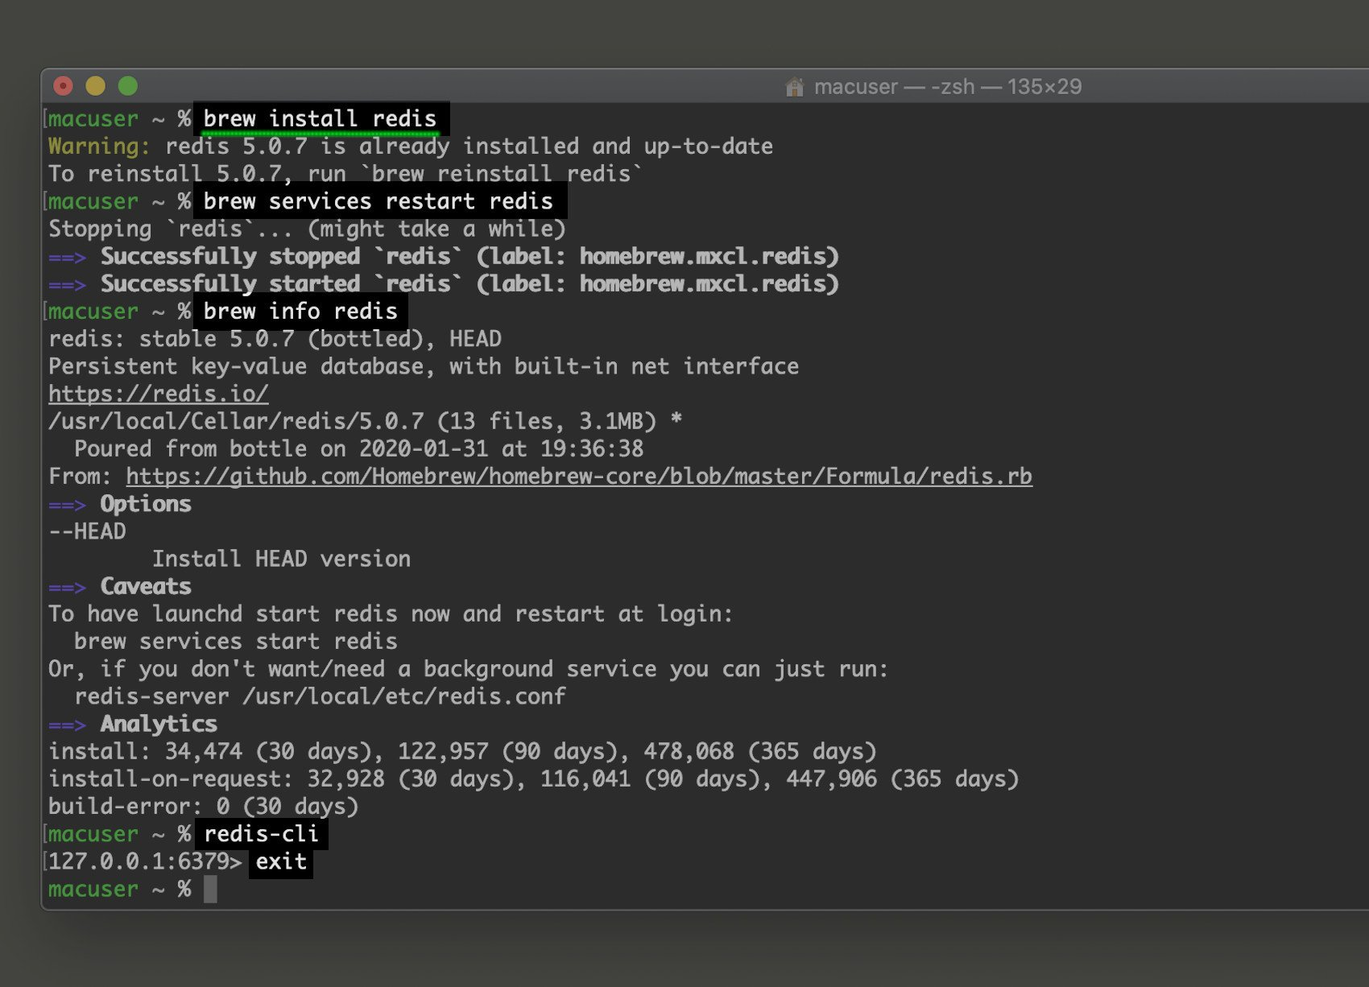
Redis finns här eftersom jag ser team välja det när prestanda och snabba svarstider för nyckel-värdelagring är avgörande. Det är mitt förstahandsval för scenarier som kräver cachelagring med hög genomströmning eller realtidsanalys, där millisekunder spelar roll.
Jag gillar hur Redis kombinerar hastigheten hos minneslagring med funktioner som beständighet, replikering och pub/sub-meddelanden. När prestandaflaskhalsar uppstår, särskilt i webbmiljöer i stor skala, är detta nästan alltid det första NoSQL-verktyget jag rekommenderar.
Det här är Redis bäst för
- Cachelagring med stora datamängder och arbetsbelastningar för realtidsanalys
- Utvecklare som bygger snabba, skalbara nyckel-värdeapplikationer
Det här är Redis inte så bra för
- Projekt som behöver komplexa frågor eller sekundära index
- Organisationer som kräver relationsdatamodeller
Det som skiljer Redis från mängden
Redis är inriktat på enkla nyckel-värdearbetsbelastningar som är beroende av konsekvent snabba svarstider. Till skillnad från MongoDB, som stöder flexibla scheman och bredare datastrukturer, vill Redis att du bygger kring minneslagring med enkla åtkomstmönster. I praktiken fungerar detta bäst för cachelagring, köhantering eller sessionslagring, där du vill ha snabba läsningar och skrivningar med minimal komplexitet.
Avvägningar med Redis
Redis optimerar för snabbhet och enkelhet, så du avstår från avancerade frågor och komplexa datarelationer – om du behöver mer än snabba uppslag stöter du snabbt på begränsningar.
Pros and Cons
Pros:
- Minnesbaserad datalagring ger hög prestanda
- Användbart för realtidsapplikationer som spelresultattavlor och analys
- Automatisk redundansväxling garanterar hög tillgänglighet
Cons:
- Inget grafiskt användargränssnitt (GUI)
- Brist på dokumentation
Andra NoSQL-databaser
Nedan finns en lista över alternativa NoSQL-databaser som jag också rekommenderar:
- OrientDB
Bästa NoSQL-databasen med flera modeller
- AstraDB
Bäst för att bygga och skala appar i realtid
- DataStax Enterprise
Bäst för noll driftstopp på servern


Relaterade recensioner av programvara och verktyg
Om du fortfarande inte har hittat det du letar efter här kan du ta en titt på dessa andra typer av verktyg som vi har testat och utvärderat.
- Programvara för nätverksövervakning
- Programvara för serverövervakning
- SD-WAN-lösningar
- Verktyg för infrastrukturövervakning
- Paketanalysator
- Verktyg för applikationsövervakning
Så utvärderar jag NoSQL-databaser
Jag delar upp min utvärdering i grundläggande krav – som horisontell skalning och flexibla datamodeller – och de särskiljande faktorer som skiljer verktyg för realtidsarbetsbelastningar med hög genomströmning från andra.
Grundläggande funktioner (minimikrav för denna lista)
När jag väljer verktyg till min lista rangordnar jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärker sig inom området) för varje grundläggande funktion som listas nedan. Därefter omvandlar jag verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå en minsta totalpoäng på 75 % för att övervägas för inkludering.
- Flexibel datamodell: Jag kontrollerar om en databas stöder dokument-, nyckel-värde-, bredkolumns- eller grafstrukturer – och om den hanterar schemauppdateringar utan tvingande migreringar.
- Horisontell skalbarhet: Att distribuera data över noder är viktigt för växande arbetsbelastningar, så jag utvärderar hur varje verktyg hanterar horisontell uppdelning, partitionering och elastisk utökning av kluster.
- Hög tillgänglighet och replikering: Jag undersöker beteendet vid felövergång och alternativen för replikering, särskilt för installationer i flera regioner där ett avbrott i en zon inte får slå ut applikationen.
- Fråge- och indexeringsfunktioner: Utöver grundläggande nyckelsökningar utvärderar jag sekundär indexering, aggregeringspipelines och filtrering – funktioner du kommer att förlita dig på för analyspaneler eller sökning.
- Prestanda i stor skala: Fördröjning och genomströmning under hög samtidighet säger mycket, så jag jämför dokumenterade riktmärken och beteendet i verkligheten vid stora datamängder.
- API:er och SDK-stöd för utvecklare: God språkbredd för Python, Java, Node.js, Go och andra språk påskyndar införandet, så jag kontrollerar kvaliteten på officiella SDK:er och djupet i API-dokumentationen.
När jag har en lista över verktyg som uppfyller dessa kriterier tittar jag på vad som särskiljer varje plattform.
Särskiljande faktorer (vad som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer och skiljer dem åt:
Utmärkande funktioner
Justerbar konsistens är en betydelsefull särskiljande faktor. Jag utvärderar om en databas låter dig konfigurera konsistensen per fråga – användbart när realtidsläsningar och bakgrundsanalyser körs samtidigt. Inbyggd vektorsökning är viktig för team som bygger AI-drivna funktioner, som rekommendationsmotorer eller semantisk sökning, utan att behöva lägga till extra verktyg. Jag kontrollerar också om det finns inbyggd infångning av dataändringar, eftersom strömning av dataförändringar till plattformar som Kafka är avgörande för händelsedrivna arkitekturer.
Mer än funktioner
Flexibilitet vid driftsättning är något jag väger in tidigt – om en databas körs som en hanterad molntjänst, lokalt eller hos flera leverantörer påverkar hur väl den passar din infrastrukturstrategi. Säkerhet och regelefterlevnad väger också tungt; jag kontrollerar RBAC, kryptering av data i vila och under överföring samt certifieringar som SOC 2 eller HIPAA för team som hanterar känsliga data. Ekosystemets bredd kompletterar bilden. Anslutningar för Kafka, Terraform-leverantörer och Kubernetes-operatorer visar hur smidigt en databas kan integreras i befintliga DevOps-arbetsflöden.
Så väljer du en NoSQL-databas
När du tar fram en kortlista, testar och väljer NoSQL-databaser bör du tänka på följande:
- Vilket problem försöker du lösa - Börja med att identifiera funktionsluckan i NoSQL-databasen som du försöker fylla, så att du kan tydliggöra vilka funktioner och vilken funktionalitet verktyget behöver tillhandahålla.
- Vem kommer att behöva använda det - För att utvärdera kostnader och krav bör du överväga vilka som kommer att använda plattformen och hur många licenser du behöver. Du behöver utvärdera om det bara är datateamet eller hela organisationen som kommer att behöva åtkomst. När det står klart är det värt att överväga om du prioriterar användarvänlighet för alla eller snabbhet för dina tekniskt avancerade användare.
- Vilka andra verktyg behöver det fungera med - Klargör vilka verktyg du ersätter, vilka verktyg som blir kvar och vilka verktyg du behöver integrera med. Det kan omfatta din befintliga datainfrastruktur, olika datakällor och hela din tekniska stack. Du kan också behöva besluta om verktygen ska integreras med varandra eller om du i stället kan ersätta flera verktyg med en enda konsoliderad NoSQL-databas.
- Vilka resultat är viktiga - Överväg vilket resultat verktyget behöver leverera för att anses vara framgångsrikt. Fundera på vilken kapacitet du vill få eller vad du vill förbättra, och hur du kommer att mäta framgång. Du kan jämföra funktioner i NoSQL-databaser tills du blir blå i ansiktet, men om du inte funderar på vilka resultat du vill uppnå kan du slösa bort mycket värdefull tid.
- Hur det skulle fungera inom din organisation - Överväg lösningarna tillsammans med dina arbetsflöden och din metod för datahantering. Utvärdera vad som fungerar bra och vilka områden som orsakar problem och behöver åtgärdas. Kom ihåg att alla företag är olika — anta inte att ett verktyg kommer att fungera i din organisation bara för att det är populärt.
Trender inom NoSQL-databaser
I min research har jag samlat in otaliga produktuppdateringar, pressmeddelanden och versionsloggar från olika leverantörer av NoSQL-databaser. Här är några av de framväxande trender jag håller ett öga på:
- Databaser redo för edge: Vissa NoSQL-verktyg stöder nu edge computing-konfigurationer där data lagras och bearbetas närmare användarna. Det är användbart för appar med krav på låg latens eller för distributioner på avlägsna platser.
- Stöd för flera modeller: Allt fler NoSQL-databaser lägger till stöd för flera datamodeller, till exempel nyckel-värde, dokument, graf och kolumn, i ett och samma system. Det ger team flexibilitet att köra olika typer av arbetsbelastningar utan att byta plattform.
- Serverlös arkitektur: Vissa leverantörer erbjuder nu serverlösa NoSQL-databaser som skalas automatiskt och debiteras baserat på användningen. Det är ett bra alternativ för team som inte vill hantera infrastruktur, som med Amazon DynamoDB eller Azure Cosmos DB.
- Starkare alternativ för konsekvens: Traditionellt har NoSQL prioriterat tillgänglighet framför konsekvens, men verktygen erbjuder nu justerbara konsekvensnivåer. Det är till hjälp när du behöver större kontroll över hur aktuella eller korrekta dina dataavläsningar är.
- Inbyggd fulltextsökning: Leverantörer börjar bygga in sökfunktioner så att du inte behöver lägga till en separat motor som Elasticsearch. Det sparar tid vid konfigureringen och håller allt på samma plats.
Vad är NoSQL-databaser?
Databaser utan Structured Query Language (SQL) är icke-relationella databaser som möjliggör lagring, hämtning och hantering av data utan behov av ett fast schema. Dessa verktyg används främst av programvaruutvecklare, dataarkitekter och IT-specialister som arbetar med stora mängder strukturerade, halvstrukturerade eller ostrukturerade data.
Övergången till NoSQL-databaser drivs av behovet av att hantera begränsningarna hos traditionella relationsdatabaser när det gäller att hantera dagens datamängd, datahastighet och datamångfald. Det övergripande värdet hos dessa verktyg ligger i deras förmåga att tillhandahålla robusta, flexibla och kostnadseffektiva lösningar för komplexa behov av datahantering inom olika branscher.
Funktioner i NoSQL-databaser
Här är de viktigaste funktionerna jag tittar efter när jag utvärderar NoSQL-databaser:
- Skalbarhet: Den här funktionen gör det möjligt för databasen att utökas i takt med växande databehov. Möjligheten att skala ut med hjälp av en distribuerad arkitektur är avgörande för att sömlöst hantera enorma datamängder utan att prestandan försämras.
- Flexibla datamodeller: NoSQL-databaser erbjuder flexibla datamodeller för lagring och hantering av olika datatyper. Denna flexibilitet är avgörande för att hantera ostrukturerade datas varierande och dynamiska karaktär utan behov av fördefinierade scheman.
- Hög prestanda: Optimerade för specifika datamodeller och åtkomstmönster, vilket säkerställer snabb datahämtning och hög genomströmning. Hög prestanda är avgörande i situationer där tidskänslig åtkomst till data är viktig för beslutsfattande och operativ effektivitet.
- Hög tillgänglighet: Den här funktionen säkerställer att databasen förblir tillgänglig även vid maskinvarufel eller underhållshändelser. Hög tillgänglighet är avgörande för applikationer som kräver ständig drifttid och åtkomst till data i realtid.
- Datareplikering: Underlättar kopiering av data mellan flera servrar, vilket förbättrar datatillgängligheten och katastrofåterställningen. Datareplikering är viktig för att upprätthålla dataintegriteten och säkerställa kontinuerlig åtkomst till data i geografiskt distribuerade system.
- Partitionstolerans: Möjligheten att fortsätta fungera trots nätverks- eller partitionsfel. Partitionstolerans är avgörande i distribuerade system och säkerställer att systemet förblir operativt även när delar av det inte kommunicerar effektivt.
- Stöd för flera modeller: Stödjer olika datamodeller, såsom dokument, nyckel-värde, grafer och kolumnfamiljer, i en och samma databas. Stöd för flera modeller ger flexibilitet att hantera olika typer av data och åtkomstmönster, vilket förenklar dataarkitekturen.
- Schemalös: Gör det möjligt att lagra data utan ett fördefinierat schema och erbjuder flexibilitet vid hantering av förändringar i datastrukturer. Schemalösa databaser är idealiska för applikationer som behöver kunna utvecklas snabbt utan behov av frekvent omdesign av databasen.
- Integrerad cachning: Förbättrar prestandan genom att lagra data som ofta används i minnet. Integrerad cachning minskar åtkomsttiderna avsevärt, vilket förbättrar användarupplevelsen och systemets effektivitet.
- Säkerhetsfunktioner: Omfattande säkerhetsåtgärder, inklusive kryptering, åtkomstkontroll och granskning. Robusta säkerhetsfunktioner skyddar känsliga data mot obehörig åtkomst och dataintrång, vilket är avgörande för att upprätthålla förtroende och efterlevnad.
Fördelar med NoSQL-databaser
NoSQL-databaser erbjuder ett flexibelt, skalbart och effektivt sätt att hantera data, vilket gör dem till ett attraktivt alternativ för organisationer och utvecklare som hanterar stora volymer av olika datatyper. Till skillnad från traditionella relationsdatabaser är NoSQL-databaser utformade för att hantera ostrukturerade och semi-strukturerade data och erbjuder unika fördelar som avsevärt kan förbättra affärsverksamheten och strategierna för datahantering. Här är fem huvudsakliga fördelar med NoSQL-databaser för användare och organisationer:
- Skalbarhet: Hantera enkelt datatillväxt med en distribuerad arkitektur. NoSQL-databaser är i grunden utformade för att skalas ut över flera servrar och datacenter, vilket gör det möjligt för företag att hantera ökande datamängder utan problem, stödja tillväxt och säkerställa att prestandan bibehålls.
- Flexibilitet: Anpassa dig till förändrade datamodeller utan driftstopp. NoSQL-databasers schemalösa natur gör det möjligt att lagra ostrukturerade och semi-strukturerade data, vilket ger flexibilitet att snabbt vidareutveckla applikationen utan att behöva ändra ett strikt databasschema och därmed påskynda utvecklingscyklerna.
- Hög prestanda: Uppnå snabbare åtkomst till och bearbetning av data. NoSQL-databaser kan ge överlägsen prestanda för vissa typer av operationer, däribland sådana som involverar stora datamängder och realtidsapplikationer, genom att utnyttja optimerade mekanismer för lagring, cachning och hämtning som är anpassade till specifika datamodeller.
- Kostnadseffektivitet: Minska kostnaderna genom effektiv datalagring och databearbetning. NoSQL-databasers distribuerade natur, i kombination med deras förmåga att effektivt hantera stora volymer av olika data, kan leda till betydande besparingar på maskinvara, lagring och underhåll jämfört med traditionella databassystem.
- Hantering av olika datatyper: Lagra och ställ frågor mot ett brett spektrum av datatyper. NoSQL-databaser stöder flera datamodeller, inklusive nyckel-värde, dokument, breda kolumner och grafer, vilket gör det möjligt för organisationer att använda en enda databas för en mängd olika datatyper och applikationer, förenkla datahanteringen och förbättra analysmöjligheterna.
Kostnader och priser för NoSQL-databaser
NoSQL-databaser erbjuder en mängd olika plan- och prisalternativ som är utformade för att tillgodose behoven hos företag av alla storlekar, från nystartade företag till stora koncerner. Dessa databaser är anpassade för att effektivt hantera stora volymer av strukturerade och ostrukturerade data och erbjuder skalbarhet, flexibilitet och hög prestanda.
Prismodellerna varierar avsevärt mellan olika NoSQL-databasleverantörer och baseras vanligtvis på faktorer som datalagring, läs- och skrivgenomströmning, antal transaktioner och vilken supportnivå som krävs.
Prisjämförelsetabell för NoSQL-databaser
Här är en sammanfattning av de olika prisplanerna och kostnadsintervallen som vanligtvis är tillgängliga för dessa verktyg:
| Plantyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| Gratis | $0 | Grundläggande åtkomst, begränsad lagring och kapacitet, communitysupport |
| Standard | $100 - $1,000/månad | Ökad lagring och kapacitet, teknisk support, grundläggande säkerhet |
| Professionell | $1,000 - $10,000/månad | Förbättrade säkerhetsfunktioner, högre gränser för kapacitet och lagring, support dygnet runt |
| Företag | Anpassad prissättning | Anpassade lösningar, dedikerad support, obegränsad lagring och kapacitet |
Vanliga frågor om NoSQL-databaser
Här är de vanligaste frågorna som människor ställer när de söker information om NoSQL-databaser.
Vad händer härnäst?
Om du håller på att undersöka NoSQL-databaser kan du kontakta en SoftwareSelect-rådgivare för kostnadsfria rekommendationer.
Du fyller i ett formulär och har ett kort samtal där de går igenom dina specifika behov. Därefter får du en kortlista över programvara att granska. De hjälper dig även genom hela köpprocessen, inklusive prisförhandlingar.