

10 bästa DataOps-verktygen granskade 2026

Kortlista över de bästa DataOps-verktygen


De bästa DataOps-verktygen hjälper team att bygga, övervaka och hantera datapipelines som faktiskt levererar tillförlitliga resultat. De automatiserar kvalitetskontroller, spårar datahärkomst och ger insyn i arbetsflöden, så att data kan förflyttas säkert och effektivt från källa till destination.
Om du någon gång har förlorat timmar på att felsöka misslyckade ETL-jobb med vaga felmeddelanden, jonglerat med isolerade system som inte kan integreras eller kämpat dig igenom en efterlevnadsrevision utan tydlig spårning av datahärkomst, vet du hur störande bristande datahantering kan vara. Dessa utmaningar bromsar leveranser, ökar risken och urholkar förtroendet för den data som verksamheten är beroende av.
Jag har arbetat med dataingenjörer och produktteam i snabbväxande SaaS-miljöer och utvärderat plattformar under verkliga förhållanden där prestanda, säkerhet och granskningsbarhet inte kan äventyras. Jag har testat verktyg i utvecklings-, test- och produktionsmiljöer för att skilja dem som bara marknadsför lösningar från dem som faktiskt minskar friktionen och förbättrar tillförlitligheten.
I den här guiden får du se vilka DataOps-plattformar som levererar användbara insikter, minskar bruset och hjälper ditt team att arbeta snabbare med större trygghet.
Varför du kan lita på våra programvarurekommendationer
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Sammanfattning av de bästa DataOps-verktygen
Den här jämförelsetabellen sammanfattar prisuppgifterna för mina främsta val av DataOps-verktyg för att hjälpa dig hitta det bästa alternativet utifrån din budget och verksamhetens behov.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för storskalig dataanalys | Nej | $99/user/month | Website | |
| 2 | Bäst för samordning av datapipelines | Kostnadsfri demonstration tillgänglig | Pris på begäran | Website | |
| 3 | Bäst för hantering av datasekretess | Gratisabonnemang tillgängligt | Från $150/månad (faktureras årsvis) | Website | |
| 4 | Bäst för samarbete kring SQL-arbetsflöden | 21 dagars kostnadsfri provperiod | Från $199/användare/år (faktureras årsvis) | Website | |
| 5 | Bäst för automatisering av dataförberedelse | Nej | $5,195/användare/år (motsvarande cirka $433/användare/månad) | Website | |
| 6 | Bäst för hybrid dataintegrering | Nej | $1/användare/timme för dataförflyttningsaktiviteter | Website | |
| 7 | Bäst för dataintegration för företag | Nej | Pris på begäran | Website | |
| 8 | Bäst för SQL-liknande frågehantering | Not available | Gratis | Website | |
| 9 | Bäst för sökning och dataanalys | Nej | $16/user/month | Website | |
| 10 | Bäst för hantering av dataflöden i realtid | Not available | Gratis | Website |


Recensioner av de bästa DataOps-verktygen
Nedan hittar du mina detaljerade sammanfattningar av de bästa DataOps-verktygen som kom med på min kortlista. I mina recensioner får du en detaljerad genomgång av de viktigaste funktionerna, för- och nackdelarna, integrationerna och de idealiska användningsområdena för varje verktyg, så att du kan hitta det bästa alternativet för dig.
Bäst för storskalig dataanalys
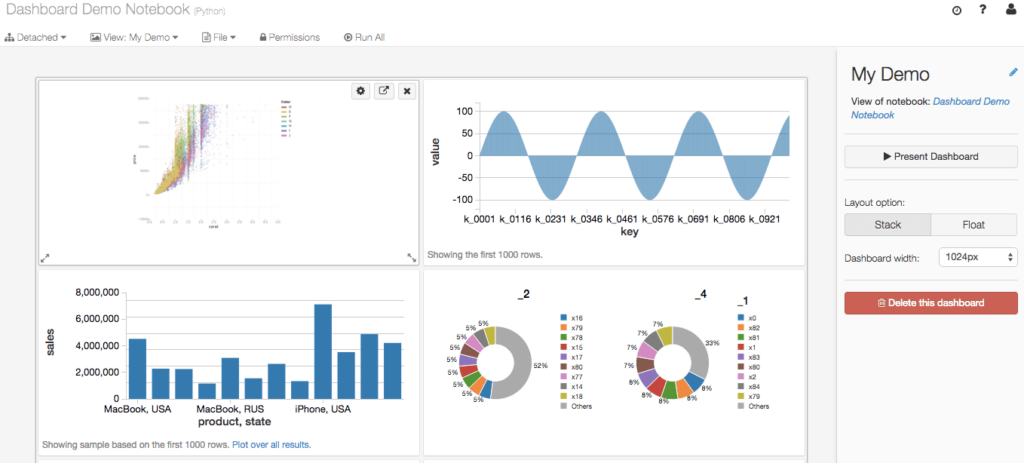
Databricks är en data- och AI-plattform utformad för företag och riktar sig till dataingenjörer, dataforskare och analytiker. Den erbjuder funktioner för databearbetning, analys och maskininlärning.
Varför jag valde Databricks: Plattformen utmärker sig inom storskalig dataanalys och erbjuder samarbetsanteckningsböcker samt Delta Lake för datatillförlitlighet. Ditt team kan dra nytta av dess avancerade verktyg för maskininlärning, vilket förbättrar analyskapaciteten. Plattformens robusta stöd för Apache Spark säkerställer effektiv bearbetning av stora datamängder. Flexibel integration med stora molnleverantörer som AWS, Azure och Google Cloud gör den ännu mer attraktiv för storskalig verksamhet.
Utmärkande funktioner & integrationer:
Funktioner omfattar samarbetsanteckningsböcker som främjar lagarbete och innovation. Delta Lake säkerställer datatillförlitlighet och konsekvens, vilket är avgörande för uppgifter som rör stora datamängder. Plattformens funktioner för maskininlärning gör det möjligt för ditt team att effektivt bygga och distribuera modeller.
Integrationer omfattar Apache Spark, AWS, Azure, Google Cloud, Tableau, Power BI, Snowflake, MongoDB, Looker och Qlik.
Pros and Cons
Pros:
- Flexibla molnintegrationer
- Stöd för bearbetning av stora datamängder
- Avancerade verktyg för maskininlärning
Cons:
- Komplex prisstruktur
- Tillfälliga prestandaproblem

Bäst för samordning av datapipelines
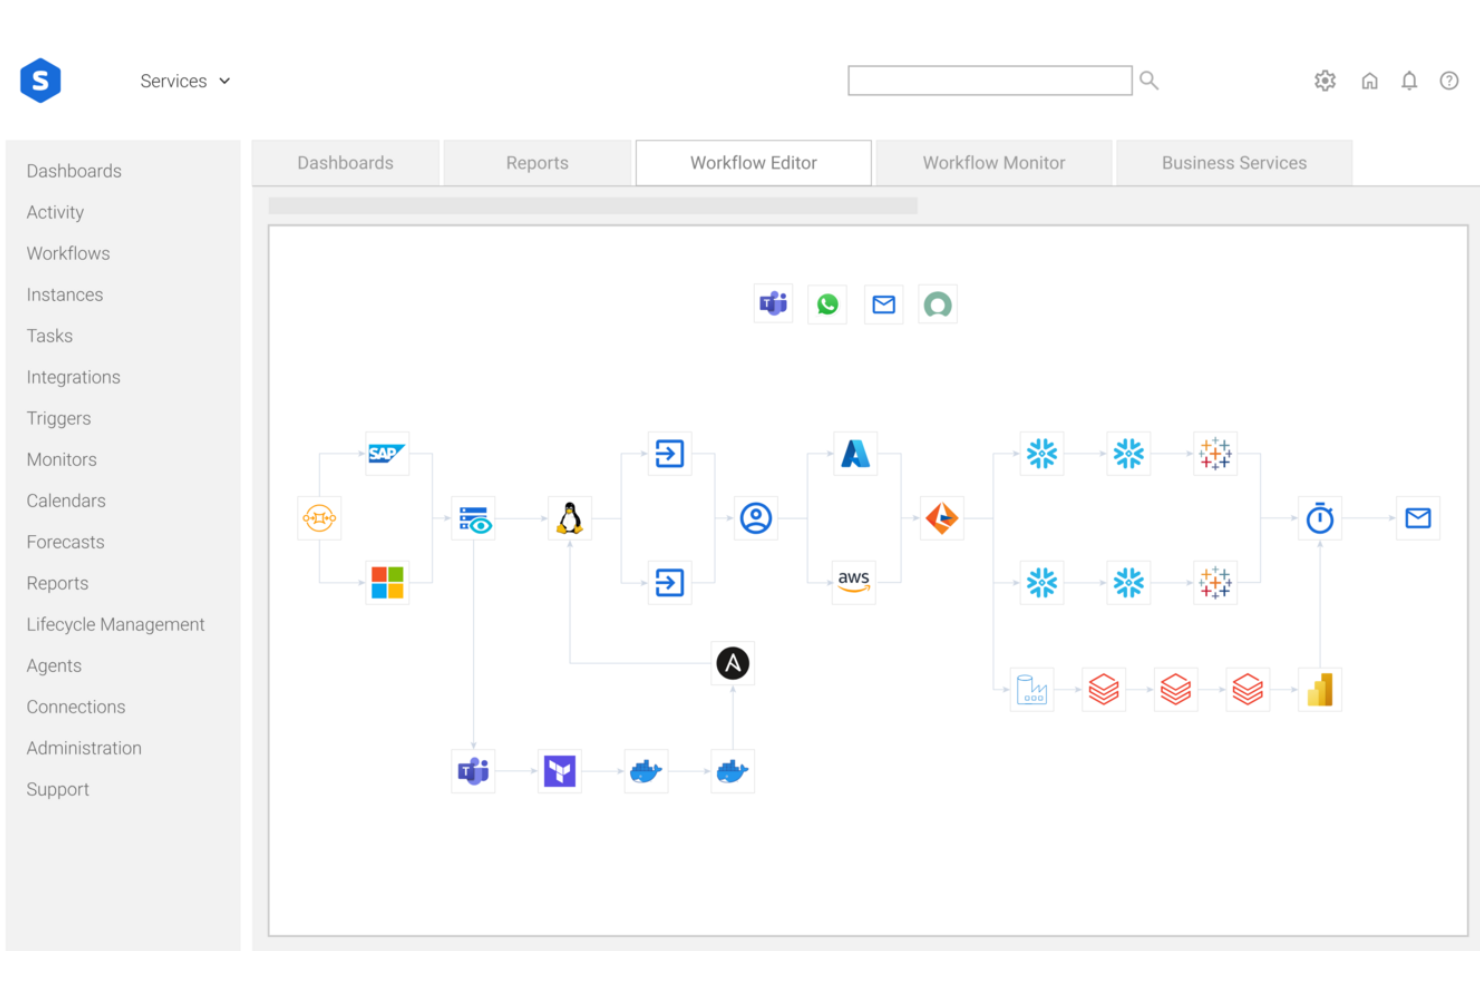
Stonebranch Universal Automation Center erbjuder en tillförlitlig lösning för IT-team som vill förbättra sin datahantering. Verktyget är utformat för IT-proffs och företag som vill effektivisera sina dataarbetsflöden och hanterar komplexiteten i hybrida IT-miljöer genom att sömlöst samordna datapipelines och automatisera arbetsflöden på olika plattformar. Med sitt användarvänliga gränssnitt tilltalar verktyget särskilt team som vill minska behovet av manuell övervakning och förbättra den operativa effektiviteten.
Varför jag valde Stonebranch Universal Automation Center
Jag valde Stonebranch Universal Automation Center för dess unika förmåga att samordna datapipelines, vilket är en viktig aspekt av DataOps. Plattformens realtidsautomation för hybrid-IT gör det möjligt för ditt team att hantera komplexa arbetsflöden i både moln- och lokala miljöer. Den händelsestyrda automatiseringen säkerställer att arbetsflöden körs som svar på specifika datasignaler, vilket förbättrar den operativa smidigheten. Dessa funktioner är utformade för att möta behoven hos IT-avdelningar som vill optimera datahanteringen och effektivisera processerna utan omfattande manuella insatser.
Viktiga funktioner i Stonebranch Universal Automation Center
Utöver samordning av datapipelines erbjuder Stonebranch Universal Automation Center följande:
- Hanterad filöverföring: Styr dataströmmar säkert mellan olika miljöer, inklusive B2B-filöverföringar.
- Infrastruktur- och tjänsteautomation: Hanterar dator-, nätverks- och lagringsresurser sömlöst.
- Analys och observerbarhet: Tillhandahåller avancerad rapportering och prediktiva funktioner för att förbättra servicenivåerna.
Integrationer med Stonebranch Universal Automation Center
Integrationer omfattar Amazon Web Services (AWS), SAP, ServiceNow, Red Hat, Google Cloud, Kubernetes, Microsoft, Docker och Informatica.
Pros and Cons
Pros:
- Avancerad övervakning av stordatorer och molnmiljöer
- Omfattande automatiseringsfunktioner för olika IT-processer
- Hög tillgänglighet och redundansfunktioner förbättrar tillförlitligheten
Cons:
- Användare rapporterar bristfällig dokumentation för nybörjare
- Begränsad molntillgänglighet och skalbarhet jämfört med alternativ

Ketch
Bäst för hantering av datasekretess
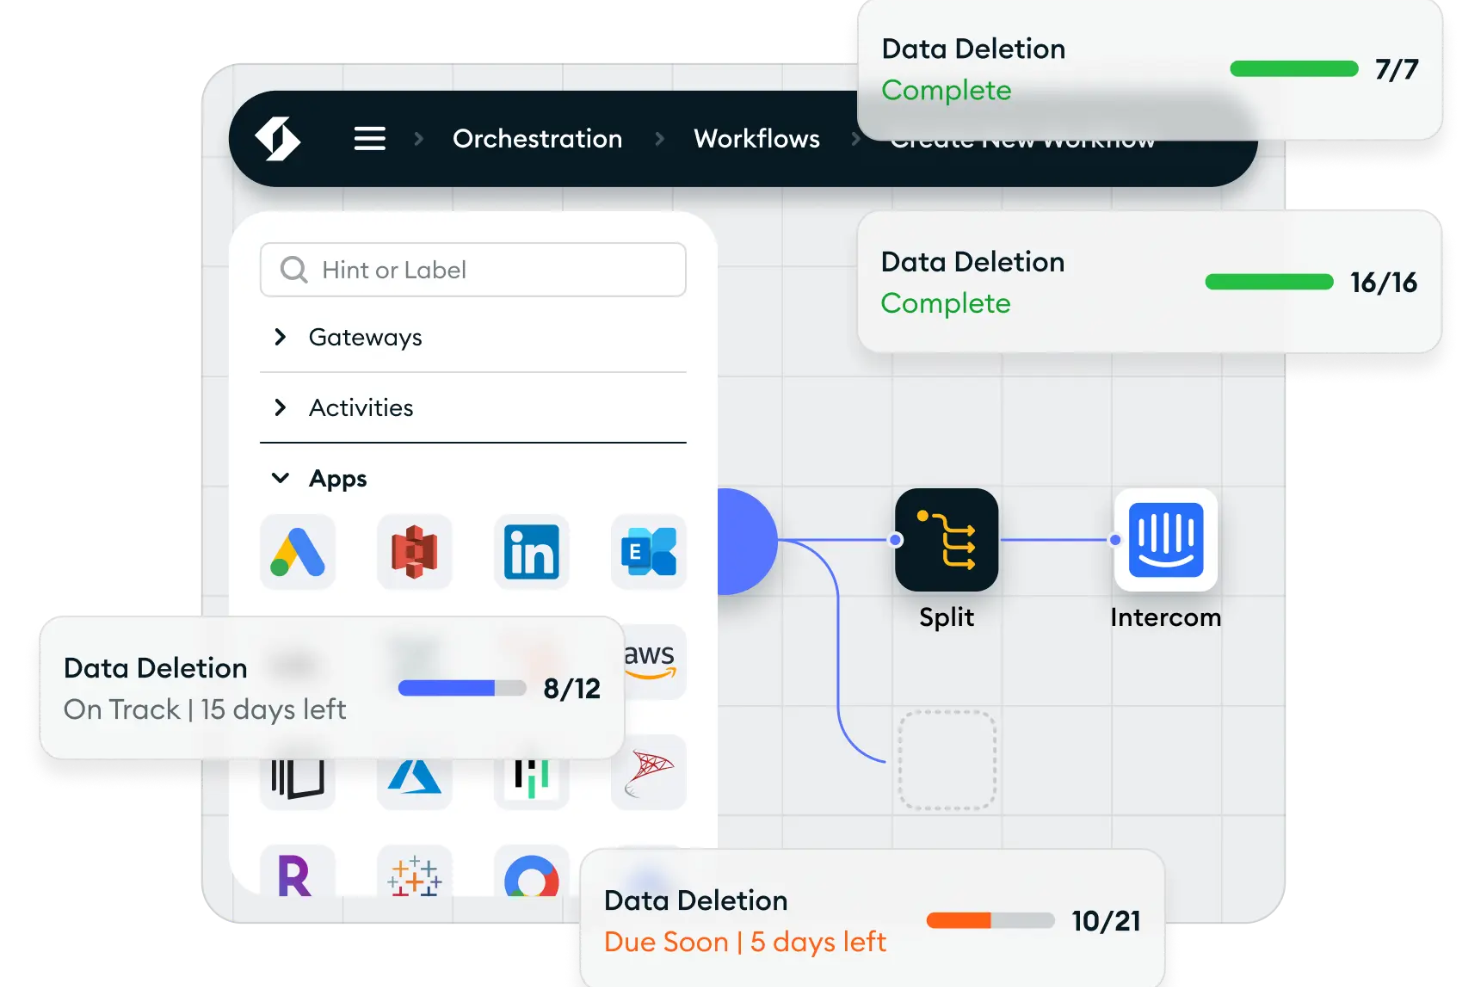
Ketch är en programvara för hantering av datasekretess som är skräddarsydd för företag med fokus på efterlevnad och användarnas integritet. Den riktar sig till yrkesverksamma inom juridik, marknadsföring och teknik genom att erbjuda verktyg som samtyckeshantering och datakartläggning.
Varför jag valde Ketch: Fokus ligger på att säkerställa efterlevnad av regler som GDPR och CCPA. Ketch automatiserar integritetsprocesser, inklusive automatisering av begäranden från registrerade (DSR) och riskbedömningar, vilket sparar tid för ditt team. Du får även anpassningsbara integritetsbanners som stärker kundrelationerna. Möjligheten att integrera med över 1 000 system ger flexibilitet och gör Ketch till ett utmärkt val för företag med fokus på integritet.
Utmärkande funktioner & integrationer:
Funktioner omfattar anpassningsbara integritetsmallar, verktyg för riskbedömning och automatiserade arbetsflöden. Du kan använda Ketch för att enkelt hantera samtycken och begäranden från registrerade, vilket förbättrar produktiviteten genom att minska manuella uppgifter. Plattformen har även ett användarvänligt gränssnitt som möjliggör snabb installation och introduktion.
Integrationer omfattar Salesforce, HubSpot, Marketo, Microsoft Dynamics, Google Analytics, Adobe Experience Cloud, Amazon Web Services, Oracle, SAP och Workday.
Pros and Cons
Pros:
- Stärker kundrelationerna
- Stöd för över 1 000 integrationer
- Snabb installation och introduktion
Cons:
- Begränsade anpassningsmöjligheter
- Kräver löpande uppdateringar av regelverk
New Product Updates from Ketch
Ketch Launches Iris-Powered Tracker Scanning
Ketch adds Iris-powered tracker scanning to Data Sentry and Consent Management, using cohort-based page grouping and adaptive sampling to expand tracker coverage and keep results current. For more information, visit Ketch’s official site.
 .

Bäst för samarbete kring SQL-arbetsflöden
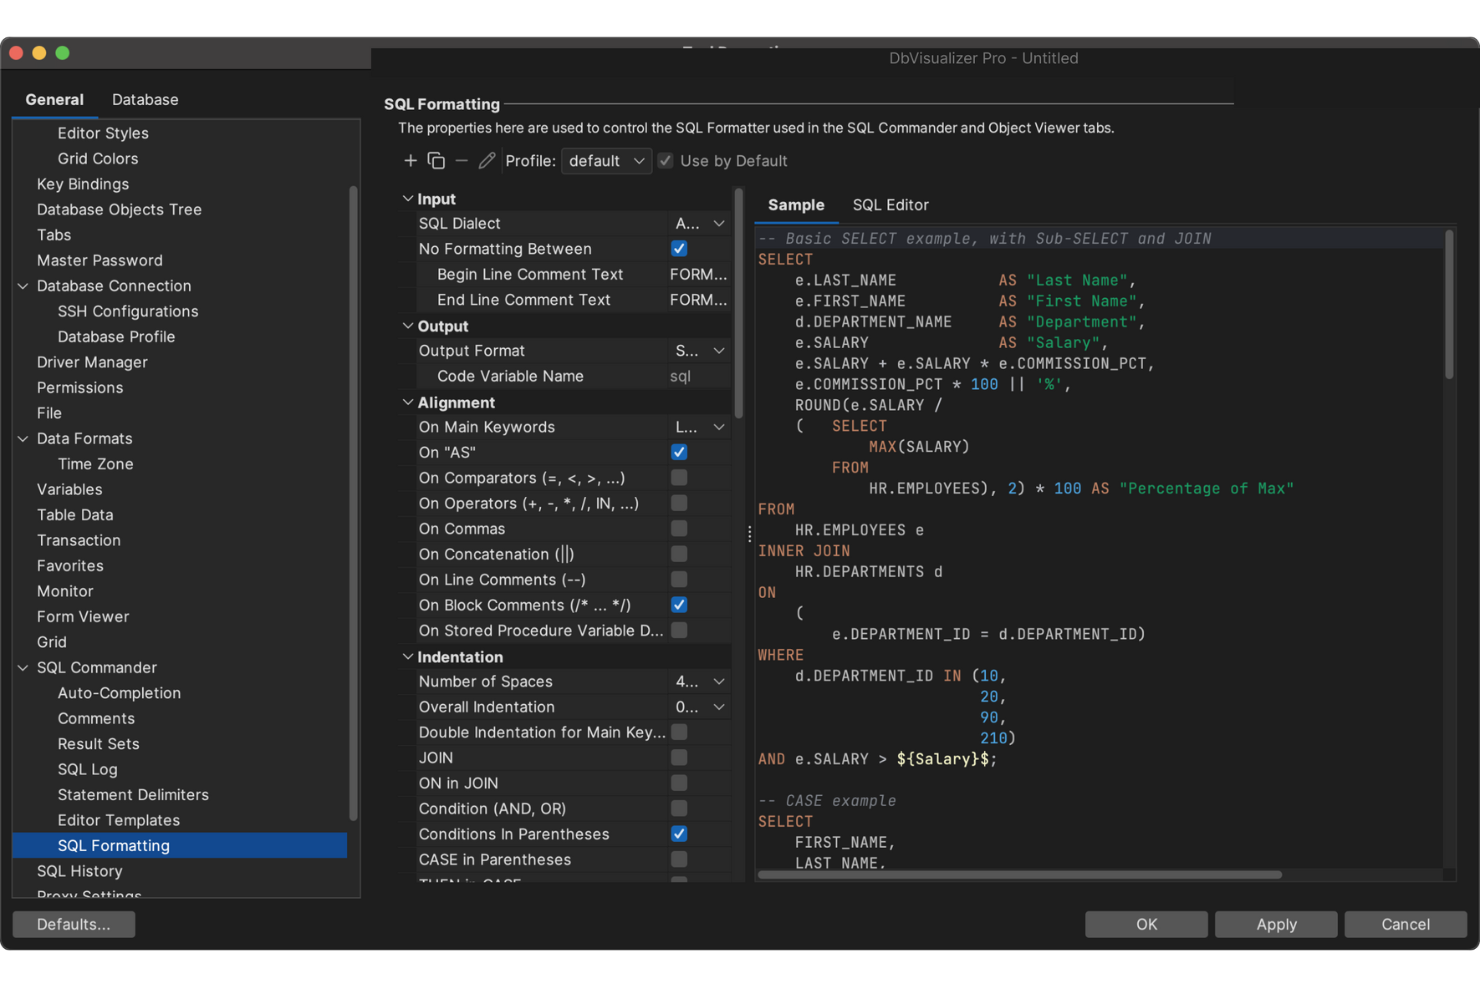
För team som söker en tillförlitlig DataOps-lösning erbjuder DbVisualizer en mångsidig plattform som tillgodoser olika behov inom databashantering. Den är idealisk för dataprofessionella inom alla branscher som behöver ett enhetligt verktyg för att hantera komplexa databaser. Med funktioner som avancerad SQL-redigering och robust datavisualisering hanterar DbVisualizer utmaningar inom dataintegration och datahantering, vilket gör det till en värdefull resurs för att optimera dataarbetsflöden.
Varför jag valde DbVisualizer
Jag valde DbVisualizer eftersom dess SQL-verktyg, anpassade för arbetsflöden, passar väl med hur DataOps-team itererar, validerar och distribuerar ändringar mellan miljöer. Du kan samarbeta kring SQL-skript med inbyggd versionskontroll, vilket gör det enklare att spåra uppdateringar, skapa grenar för arbete och upprätthålla en tydlig granskningshistorik över transformationer. De visuella förklaringsplanerna hjälper teamet att bedöma frågeprestanda innan ändringar förs vidare i pipelinen, vilket minskar störningar. Jag uppskattar också att du kan automatisera körningen av skript utanför användargränssnittet med hjälp av kommandoraden.
Viktiga funktioner i DbVisualizer
Jag uppskattar också att DbVisualizer erbjuder:
- Datautforskning: Gör det möjligt att enkelt bläddra i och hantera komplexa datastrukturer i dina databaser.
- Redigering direkt i tabeller: Ger möjlighet att redigera data direkt i tabeller, vilket effektiviserar datahanteringen.
- Hantering via kommandorad: Stöder körning av skript och datahanteringsuppgifter via ett kommandoradsgränssnitt, vilket förbättrar automatiseringen.
- Dataexport/import: Underlättar överföring av data i olika format och stöder smidig dataintegration och delning.
Integrationer med DbVisualizer
Integrationer omfattar DB2, MariaDB, SQL Server, MySQL, PostgreSQL, Oracle, Apache Derby, H2, SQLite och Sybase.
Pros and Cons
Pros:
- Fokus på visuell datapresentation för tydligare insikter
- Avancerad SQL-redigerare med funktioner som automatiska förslag och formatering
- Stöder flera databastyper, vilket möjliggör mångsidig databashantering
Cons:
- Större datamängder kan ibland påverka prestandan
- Nya användare kan behöva genomgå en viss inlärningskurva
New Product Updates from DbVisualizer

DbVisualizer Adds AI Enhancements, Map Visualization, and SQL Tab Groups
DbVisualizer expands AI capabilities, introduces geospatial map visualization, and adds SQL Commander tab groups. The release also improves audit logging, database connection management, and database support to streamline development workflows. For more information, visit DbVisualizer's official site.
 .

Alteryx
Bäst för automatisering av dataförberedelse
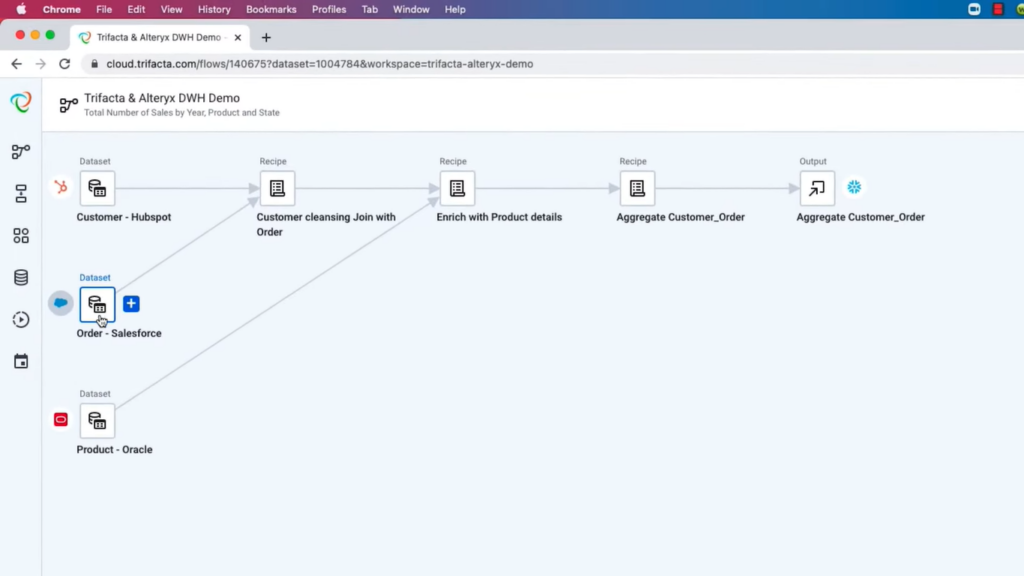
Alteryx är en plattform för dataanalys som hjälper användare att förbereda, kombinera och analysera data från olika källor. Den erbjuder både datorbaserade och molnbaserade lösningar för yrkesverksamma som behöver automatisera dataarbetsflöden och effektivt ta fram insikter.
Varför jag valde Alteryx: Du kan automatisera repetitiva dataförberedelseuppgifter med hjälp av Alteryx dra-och-släpp-gränssnitt. Det erbjuder över 300 verktyg utan kod och med lite kod, vilket gör att ditt team kan rensa, omvandla och berika data utan att skriva kod. Plattformen stöder både strukturerade och ostrukturerade data, så att du kan hantera olika typer av datamängder. Dessutom erbjuder Alteryx AI-drivna rekommendationer för att optimera dina arbetsflöden.
Utmärkande funktioner & integrationer:
Funktioner omfattar verktyg för geospatial analys, vilket gör det möjligt för ditt team att utföra platsbaserade analyser. Du kan även använda inbyggda funktioner för maskininlärning för att skapa prediktiva modeller utan omfattande kunskaper i programmering. Dessutom stöder Alteryx databearbetning i realtid, så att du kan fatta välgrundade beslut baserade på aktuella data.
Integrationer omfattar anslutningar till Salesforce, Snowflake, Amazon Redshift, Google BigQuery, Microsoft Azure, Tableau, Power BI, Oracle, SAP och Databricks.
Pros and Cons
Pros:
- Erbjuder AI-drivna rekommendationer för arbetsflöden
- Automatiserar komplexa dataförberedelseuppgifter
- Hanterar både strukturerade och ostrukturerade data
Cons:
- Begränsade funktioner för datavisualisering
- Kräver separata licenser för vissa funktioner

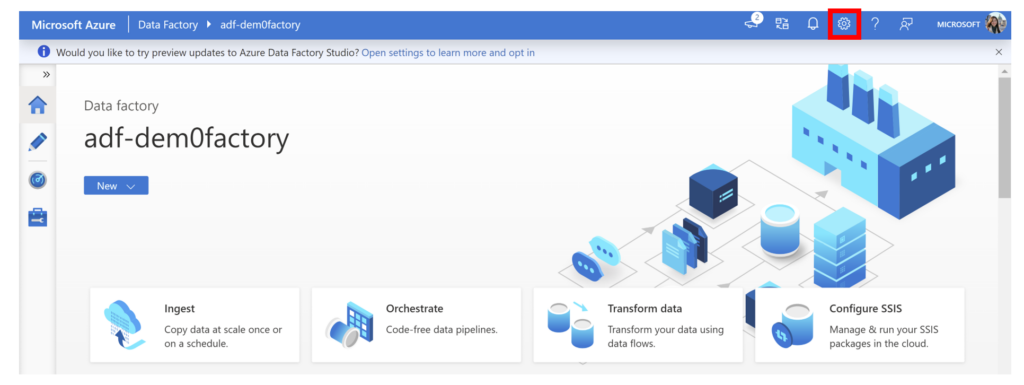
Azure Data Factory är en molnbaserad dataintegreringstjänst för dataingenjörer och analytiker. Den underlättar skapandet, schemaläggningen och orkestreringen av dataarbetsflöden och har stöd för både molnbaserade och lokala datakällor.
Varför jag valde Azure Data Factory: Tjänsten utmärker sig inom hybrid dataintegrering och gör det möjligt för ditt team att ansluta olika datamiljöer. Plattformens dra-och-släpp-gränssnitt förenklar skapandet av komplexa arbetsflöden. Du kan använda den inbyggda schemaläggningen för att automatisera dataförflyttningar, vilket minskar manuella uppgifter. Funktioner för övervakning i realtid ger insyn i dataprocesserna och förbättrar den operativa effektiviteten.
Framstående funktioner & integreringar:
Funktioner omfattar ett intuitivt dra-och-släpp-gränssnitt för att utforma datapipelines. Inbyggda schemaläggningsverktyg låter dig automatisera dataarbetsflöden och sparar tid och arbete. Övervakning i realtid ger insyn i dataoperationerna och hjälper dig att snabbt identifiera och lösa problem.
Integreringar omfattar Azure Blob Storage, Azure SQL Database, Azure Synapse Analytics, Amazon S3, Google BigQuery, Oracle, SAP, Salesforce, Teradata och IBM Db2.
Pros and Cons
Pros:
- Lättanvänt dra-och-släpp-gränssnitt
- Stöd för olika datamiljöer
- Funktioner för övervakning i realtid
Cons:
- Komplex initial konfiguration
- Begränsad funktionalitet offline


IBM:s DataOps-plattform är utformad för stora företag och riktar sig till IT-specialister och dataingenjörer. Den fokuserar på dataintegration, styrning och kvalitet för att säkerställa att din datahantering är effektiv och tillförlitlig.
Varför jag valde IBM: Plattformen utmärker sig inom dataintegration för företag och erbjuder verktyg som datakatalogisering och datastyrning. Du kan automatisera arbetsflöden, vilket hjälper till att upprätthålla datakvaliteten i hela organisationen. Plattformens funktion för datahärkomst ger transparens och gör det möjligt att spåra datakällor och omvandlingar. Skalbarheten passar stora företag som behöver hantera stora datamängder effektivt.
Utmärkande funktioner och integrationer:
Funktionerna omfattar datakatalogisering som hjälper dig att organisera dina datatillgångar. Plattformens styrningsverktyg säkerställer efterlevnad av dataregler. Automatiserade datakvalitetskontroller hjälper till att upprätthålla integriteten hos dina datamängder.
Integrationerna omfattar IBM Cloud, AWS, Azure, Google Cloud, Hadoop, Apache Spark, Oracle, SAP, Salesforce och Tableau.
Pros and Cons
Pros:
- Omfattande verktyg för datastyrning
- Stöd för storskalig datahantering
- Automatiserade kvalitetskontroller
Cons:
- Kan ha en brant inlärningskurva
- Begränsade anpassningsmöjligheter


Apache Hive är en datalagerlösning som främst riktar sig till dataanalytiker och ingenjörer. Den gör det möjligt att fråga efter och hantera stora datamängder som lagras i distribuerad lagring.
Varför jag valde Apache Hive: Det erbjuder SQL-liknande frågehantering, vilket är idealiskt för användare som är bekanta med SQL. Verktygets integration med Hadoop gör det lämpligt för effektiv analys av stora datamängder. Apache Hive stöder olika dataformat, vilket ger ditt team flexibilitet vid datahantering. Dess förmåga att enkelt hantera komplexa frågor gör det till ett tillförlitligt val för datadrivna företag.
Utmärkande funktioner & integreringar:
Funktioner inkluderar ett frågespråk som liknar SQL, vilket förenklar inlärning och införande. Det stöder indexering för att förbättra frågeprestandan, vilket gör datahämtningen snabbare. Apache Hive erbjuder även partitionering, vilket hjälper till att hantera och fråga efter stora datamängder effektivt.
Integreringar inkluderar Hadoop, HDFS, HBase, Amazon S3, Azure Blob Storage, Google Cloud Storage, Apache Spark, Apache Pig, Apache Tez och Apache Ranger.
Pros and Cons
Pros:
- SQL-liknande frågespråk
- Stöder komplexa datafrågor
- Hanterar stora datamängder effektivt
Cons:
- Inte idealiskt för realtidsanalys
- Prestandan varierar beroende på datamängden


Elastic är en sökmotor och analysmotor med öppen källkod som ger insikter i realtid från dina data. Dess kärnfunktion är att lagra, söka i och analysera stora datamängder snabbt och i nära realtid. Detta gör Elastic särskilt lämpat för sökning i realtid och dataanalys.
Varför jag valde Elastic:
Jag valde Elastic på grund av dess höghastighetssökning och förmåga att effektivt hantera enorma datamängder. Dess kraftfulla sökfunktioner, tillsammans med dess analysfunktioner i realtid, gör att Elastic skiljer sig från andra verktyg.
Utifrån dessa funktioner fastställde jag att Elastic är det bästa verktyget för sökning i realtid och dataanalys.
Utmärkande funktioner och integrationer:
Funktioner omfattar fulltextsökning, distribuerad sökning och analys i realtid. Dess funktion för aggregering i flera nivåer i realtid hjälper användare att utforska och analysera sina data på ett mer intuitivt sätt.
Integrationer omfattar många verktyg för datainsamling och visualisering, inklusive Logstash för centraliserad loggning och Kibana för datavisualisering.
Pros and Cons
Pros:
- Ger snabba och effektiva sökresultat
- Kan hantera stora datamängder
- Flexibelt vad gäller dataformat
Cons:
- Det kan vara komplext att konfigurera och finjustera Elastic för specifika användningsområden
- Även om den grundläggande Elastic-stacken är kostnadsfri medför avancerade funktioner en kostnad


Apache NiFi är en integrerad plattform för datalogistik som automatiserar förflyttningen av data mellan olika system. Den ger kontroll i realtid, vilket gör den responsiv vid mycket varierande stora dataströmmar och till det idealiska valet för dataimport och strömning i realtid.
Varför jag valde Apache NiFi:
Jag valde Apache NiFi för dess funktioner för snabb dirigering och transformering av data. Dess unika utformning gör det möjligt att spåra data i realtid och skapa dynamiska, responsiva dataflöden. Dessa utmärkande funktioner är anledningen till att jag anser att Apache NiFi är bäst för dataimport och strömning i realtid.
Utmärkande funktioner och integrationer:
Funktioner omfattar ett mycket konfigurerbart webbaserat användargränssnitt, spårning av datas ursprung från källa till användning samt flexibla skalningsmöjligheter.
Integrationer omfattar HTTP, AMQP, HDFS och databaser via JDBC.
Pros and Cons
Pros:
- Ger kontroll över dataflöden i realtid
- Omfattande funktioner för dirigering och transformering av data
- Öppen källkod och anpassningsbar
Cons:
- Installation och konfiguration kan vara komplexa
- Brist på direkt leverantörssupport på grund av öppen källkod
Andra DataOps-verktyg
Här är några ytterligare DataOps-verktyg som inte kom med på min kortlista, men som ändå är värda att ta en titt på:
- RightData
Bäst för datatestning och validering
- StreamSets
Bäst för dataförflyttning i realtid
- HighByte
Bäst för integration av industriella data
- DataKitchen
Bäst för dataops-orkestrering
- Badook
Bäst för övervakning av datakvalitet


Så utvärderar jag DataOps-verktyg
Jag delar upp min utvärdering i grundläggande krav – som pipelineorkestrering och stöd för CI/CD – och de särskiljande faktorer som skiljer ett bra DataOps-verktyg från det rätta för ditt team.
Kärnfunktionalitet (grundkrav för denna lista)
När jag väljer ut verktyg till min lista poängsätter jag varje verktyg på en skala från 0 (erbjuder inte funktionaliteten) till 5 (utmärkt inom området) för varje kärnfunktionalitet som anges nedan. Därefter omvandlar jag verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå en minsta totalpoäng på 65 % för att övervägas för inkludering.
- Pipelineorkestrering och schemaläggning: Jag letar efter DAG-baserad arbetsflödeshantering med beroendehantering, återförsökslogik och återfyllningar – den typ av orkestrering som håller en nattlig uppdatering av datalagret igång utan problem över dussintals uppströmskällor.
- Dataobserverbarhet och övervakning: Aviseringar om jobb som misslyckas är grundläggande, men jag utvärderar om verktyget visar datans aktualitet, volymanomalier och kolumnnivåbaserad härstamning, så att ditt team kan spåra en trasig instrumentpanel tillbaka till en specifik källtabell.
- Stöd för CI/CD och versionskontroll: Git-baserad förgrening, automatiserad testning av transformationslogik och driftsättningar i steg är viktiga här – jag kontrollerar om team kan skicka ut pipelineändringar på ett säkert sätt, på samma sätt som de skulle leverera programkod.
- Dataintegration och -transformering: Jag utvärderar bredden på anslutningsmöjligheterna mellan datalager, datasjöar, SaaS-appar och databaser, samt om transformationer kan köras i SQL, Python eller båda – verktyg som Fivetran och Airbyte hanterar inläsning på ett annat sätt än dbt hanterar transformering, så flexibilitet räknas.
- Miljö- och metadatahantering: Separata utvecklings-, test- och produktionsmiljöer med metadatakatalogisering och spårning av härstamning är det jag letar efter, så att ingenjörer inte testar experimentella modeller mot data i liveproduktionen.
- Samarbete och åtkomstkontroller: Rollbaserade behörigheter, granskningsloggar och gemensamma arbetsytor utvärderas här – särskilt hur detaljerat du kan begränsa åtkomsten när flera team (analys, teknik och styrning) delar samma plattform.
När jag har en lista över verktyg som uppfyller dessa kriterier tittar jag på vad som särskiljer varje plattform.
Särskiljande faktorer (det som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer:
Utmärkande funktioner
Stöd för strömmande data och realtidspipelines är en viktig särskiljande faktor – verktyg som endast stöder batchbearbetning räcker inte när ditt team behöver latenser på under en minut för bedrägeridetektering eller liveinstrumentpaneler. Jag utvärderar också funktioner för omvänd ETL, som gör det möjligt för team att skicka kurerade data från datalagret tillbaka till verktyg som Salesforce eller HubSpot utan anpassade skript. Funktioner för kostnads- och beräkningsoptimering är också viktiga; jag kontrollerar om en plattform hjälper dig att övervaka kostnaderna för frågor och anpassa pipeline-resursernas storlek innan kostnaden för datalagret skenar iväg.
Mer än funktioner
Ekosystemkompatibilitet väger tungt för mig – ett DataOps-verktyg måste passa in i din befintliga tekniska stack, oavsett om den består av Snowflake, Databricks eller en kombination av båda tillsammans med Airflow och dbt. Säkerhets- och efterlevnadscertifieringar som SOC 2 typ II samt beredskap för HIPAA spelar också in, särskilt för team som hanterar känsliga kund- eller ekonomiska data. Jag granskar även den totala ägandekostnaden noggrant och kontrollerar om prissättningen skalar förutsägbart när pipelinevolymen och teamets storlek ökar.
Så väljer du DataOps-verktyg
Det är lätt att fastna i långa funktionslistor och komplexa prismodeller. För att hjälpa dig att behålla fokus när du arbetar dig igenom din unika process för programvaruval kommer här en checklista över faktorer att tänka på:
| Faktor | Vad du bör tänka på |
| Skalbarhet | Säkerställ att verktyget kan växa med dina databehov. Leta efter funktioner som stöder stora datamängder och ett ökande antal användare. |
| Integrationer | Verifiera kompatibiliteten med befintliga system. Kontrollera om det stöder API:er, databaser och tredjepartsapplikationer som du redan använder. |
| Anpassningsbarhet | Överväg hur väl verktyget kan anpassas till dina processer. Leta efter alternativ för att skräddarsy instrumentpaneler, arbetsflöden och rapporter. |
| Användarvänlighet | Utvärdera användargränssnittet och inlärningskurvan. Ditt team bör uppleva det som intuitivt och snabbt kunna börja använda det. |
| Budget | Bedöm den totala kostnaden, inklusive dolda avgifter. Jämför prisplaner för att säkerställa att de ryms inom dina ekonomiska begränsningar. |
| Säkerhetsåtgärder | Analysera verktygets säkerhetsfunktioner. Säkerställ att det följer standarder för dataskydd och erbjuder kryptering. |
| Supporttjänster | Kontrollera tillgången till kundsupport. Leta efter hjälp dygnet runt, dokumentation och utbildningsresurser. |
| Prestanda | Testa verktygets hastighet och tillförlitlighet. Det bör kunna behandla data effektivt utan fördröjningar. |
Trender inom DataOps-verktyg
I min undersökning hämtade jag in otaliga produktuppdateringar, pressmeddelanden och versionsloggar från olika leverantörer av DataOps-verktyg. Här är några framväxande trender som jag håller ögonen på:
- AI-drivna insikter: Allt fler verktyg använder AI för att tillhandahålla prediktiv analys och insikter. Detta hjälper team att förutse problem och optimera processer. Leverantörer som Alteryx integrerar AI för att förbättra funktionerna för dataanalys.
- Databearbetning i realtid: Efterfrågan på databearbetning i realtid ökar. Det gör det möjligt för företag att fatta snabbare beslut baserat på aktuell information. Verktyg som StreamSets fokuserar på dataförflyttning i realtid för att möta detta behov.
- Förbättringar av datastyrning: Företag fokuserar på förbättrade funktioner för datastyrning. Detta säkerställer efterlevnad av regler och förbättrar datakvaliteten. IBMs DataOps-plattform erbjuder kraftfulla verktyg för datastyrning för att hantera dessa frågor.
- Funktioner för självbetjäning: Det sker en förskjutning mot att ge icke-tekniska användare fler möjligheter genom självbetjäningsalternativ. Detta gör datauppgifter mer tillgängliga för team i hela organisationen. Talend har lagt till funktioner för självbetjäning för att förenkla dataintegration.
- Molnbaserade arkitekturer: Allt fler verktyg utformas för molnmiljöer. Detta ger större flexibilitet och skalbarhet för företag som hanterar stora datamängder. Azure Data Factory exemplifierar denna trend med sina molnbaserade tjänster för dataintegration.
Vad är DataOps-verktyg?
DataOps-verktyg är programvarulösningar som är utformade för att automatisera och förbättra processer för datahantering. Dataingenjörer, analytiker och IT-specialister använder vanligtvis dessa verktyg för att förbättra datakvalitet, datastyrning och integration.
Bearbetning i realtid, AI-drivna insikter och funktioner för självbetjäning bidrar till att optimera arbetsflöden, säkerställa efterlevnad och göra data tillgängliga. I kombination med robusta verktyg för dataobserverbarhet ökar dessa lösningar effektiviteten och noggrannheten i datahanteringen, vilket gynnar företag genom att möjliggöra bättre beslutsfattande.
Funktioner hos DataOps-verktyg
När du väljer DataOps-verktyg bör du hålla utkik efter följande viktiga funktioner:
- Databearbetning i realtid: Detta möjliggör omedelbar dataanalys, så att företag kan fatta snabba beslut baserat på aktuell information.
- AI-drivna insikter: Dessa tillhandahåller prediktiv analys och hjälper team att förutse problem och optimera dataprocesser.
- Datastyrning: Säkerställer efterlevnad av regler och upprätthåller datakvaliteten i hela verksamheten.
- Funktioner för självbetjäning: Ger icke-tekniska användare möjlighet att självständigt hantera datauppgifter, vilket ökar tillgängligheten.
- Molnbaserad arkitektur: Erbjuder flexibilitet och skalbarhet för hantering av stora datamängder i molnmiljöer.
- Automatiserade arbetsflöden: Effektiviserar datahanteringsuppgifter, minskar det manuella arbetet och begränsar antalet fel.
- Anpassningsbara instrumentpaneler: Gör det möjligt för användare att anpassa datavisualisering efter sina specifika behov, vilket förbättrar förståelsen.
- Spårning av datahärkomst: Ger transparens genom att visa var data kommer ifrån och hur den har omvandlats, vilket säkerställer korrekthet.
- Integrationsstöd: Underlättar ett smidigt dataflöde mellan olika system och applikationer, vilket förbättrar kompatibiliteten.
- Felhantering: Identifierar och löser snabbt problem, vilket minimerar störningar i databearbetningen.
Fördelar med DataOps-verktyg
Att implementera DataOps-verktyg ger flera fördelar för ditt team och ditt företag. Här är några av de fördelar du kan se fram emot:
- Förbättrad datakvalitet: Automatiserade arbetsflöden och datastyrning säkerställer att dina data är korrekta och tillförlitliga.
- Snabbare beslutsfattande: Databehandling i realtid gör att ditt team kan agera utifrån de senaste insikterna utan dröjsmål.
- Förbättrad efterlevnad: Effektiva funktioner för datastyrning hjälper ditt företag att utan ansträngning uppfylla regulatoriska krav.
- Ökad tillgänglighet: Datakatalogverktyg med självbetjäningsfunktioner gör det möjligt för icke-tekniska användare att hantera datauppgifter, vilket breddar åtkomsten.
- Skalbarhet: Molnbaserad arkitektur stöder dina växande databehov utan att prestandan försämras.
- Minskat manuellt arbete: Automatiserad felhantering och automatiserade arbetsflöden minimerar repetitiva uppgifter och frigör tid för ditt team.
- Bättre samarbete: Anpassningsbara instrumentpaneler och insikter i realtid främjar lagarbete och välgrundat beslutsfattande.
Kostnader och priser för DataOps-verktyg
För att välja DataOps-verktyg krävs en förståelse för de olika prismodellerna och tillgängliga abonnemangen. Kostnaderna varierar beroende på funktioner, teamets storlek, tillägg och annat. Populära plattformar sträcker sig från molnbaserade lösningar till alternativ till Databricks som är specialiserade på enhetliga analys- och maskininlärningsarbetsflöden. Tabellen nedan sammanfattar vanliga abonnemang, deras genomsnittliga priser och typiska funktioner som ingår i DataOps-verktygslösningar:
Jämförelsetabell för abonnemang för DataOps-verktyg
| Abonnemangstyp | Genomsnittligt pris | Vanliga funktioner |
| Gratisabonnemang | $0 | Grundläggande dataintegration, begränsad lagring och support från communityn. |
| Personligt abonnemang | $10-$30/användare/månad | Dataintegration, grundläggande analys, begränsad automatisering och e-postsupport. |
| Företagsabonnemang | $50-$100/användare/månad | Avancerad analys, automatisering, datastyrning och prioriterad support. |
| Enterprise-abonnemang | $150-$300/användare/månad | Anpassade integrationer, fullständig automatisering, förbättrad säkerhet och dedikerad support. |
DataOps-verktyg: vanliga frågor
Här är några svar på vanliga frågor om DataOps-verktyg:
Vilka är några viktiga aspekter att tänka på när man implementerar DataOps?
När du implementerar DataOps bör du skapa tvärfunktionella team för att förbättra samarbetet mellan dataingenjörer, utvecklare och analytiker. Välj rätt verktyg som passar dina behov och etablera tydliga processer för ditt team. Automatisera repetitiva uppgifter för att spara tid och övervaka samt förbättra kontinuerligt dina processer.
Vilka är de tre pipelines som ingår i DataOps?
DataOps omfattar vanligtvis tre pipelines: produktion, utveckling och miljö. Var och en har ett specifikt syfte när det gäller att hantera dataflöden. Produktionspipelines hanterar aktiva data, utvecklingspipelines fokuserar på testning och utveckling, och miljöpipelines hanterar konfigurationer. Att förstå dessa hjälper till att samordna effektiva arbetsflöden.
Hur skiljer sig DataOps från DevOps?
Medan DevOps fokuserar på att förena utvecklings- och driftteam för leverans av programvara, syftar DataOps till att bryta ned silor mellan dataproducenter och datakonsumenter. Målet är att göra data mer tillgängliga och värdefulla. DataOps betonar samarbete mellan datateam för att förbättra datahantering och dataanvändning.
Vilka är de viktigaste fördelarna med att automatisera DataOps-uppgifter?
Att automatisera DataOps-uppgifter kan avsevärt förbättra effektiviteten genom att minska det manuella arbetet. Dessa databasverktyg för DevOps säkerställer konsekvens i dataproduktionen och hjälper dig att upprätthålla datakvaliteten. Automatisering gör också att ditt team kan fokusera på mer strategiska uppgifter, vilket leder till förbättrad produktivitet och snabbare beslutsfattande.
Hur stöder DataOps-verktyg datastyrning?
DataOps-verktyg erbjuder funktioner som hjälper till att upprätthålla policyer för datastyrning. De ger insyn i dataproduktionsprocesser och säkerställer efterlevnad av regelverk. Genom att spåra datahärkomst och erbjuda granskningsspår hjälper dessa verktyg till att upprätthålla dataintegritet och transparens i hela organisationen.
Varför är databehandling i realtid viktig inom DataOps?
Databehandling i realtid ger ditt team tillgång till de senaste uppgifterna, vilket möjliggör snabba beslut. Den stöder dynamiska affärsbehov genom att tillhandahålla aktuella insikter. Denna funktion är avgörande för branscher där aktuell data är viktig för att förbli konkurrenskraftig och snabbt kunna reagera på marknadsförändringar.
Vad händer härnäst?
Öka din SaaS-tillväxt och utveckla dina ledarskapsförmågor.
Prenumerera på vårt nyhetsbrev för de senaste insikterna från CTO:er och blivande teknikledare.
Vi hjälper dig att skala smartare och leda starkare med guider, resurser och strategier från ledande experter!