

Gli strumenti per data lake consentono di archiviare, organizzare e analizzare enormi quantità di dati strutturati e non strutturati in tutta l'azienda. Se stai confrontando i migliori strumenti per data lake, non puoi permetterti di scegliere alla cieca: quale piattaforma manterrà il tuo team in controllo dei costi, della conformità e delle prestazioni man mano che i dati aumentano?
In questa guida ti presenterò opzioni collaudate che aiutano i responsabili IT a garantire governance, scalabilità, integrazione e preparazione al futuro, così potrai scegliere con sicurezza la base giusta per i carichi di lavoro di analisi e IA nel 2026.
Perché fidarsi dei nostri consigli sui software
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Il nostro team testa e recensisce software dal 2012. In quanto leader tecnologici noi stessi, sappiamo quanto sia difficile — e importante — scegliere il software giusto.
Per questa guida, abbiamo valutato gli strumenti attraverso test praticie ricerche indipendenti, assegnando un punteggio agli strumenti in base ai nostri criteri di selezione.
Le nostre recensioni riflettono il nostro giudizio editoriale umano, non un discorso di vendita.
Revisori esperti:
- Paulo Gardini MiguelDirettore tecnico
 Tim FisherVP dell'IA
 Gabriel RosasTech Lead e architetto software
 Christhian GruhnTech Lead e architetto della piattaforma

Tabella comparativa degli strumenti per data lake
Questa tabella comparativa riassume i dettagli sui prezzi delle mie migliori selezioni di strumenti per data lake:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Ideale per lakehouse Apache Iceberg ottimizzati automaticamente | Prova gratuita disponibile | A partire da $300/mese (con fatturazione annuale) | Website | |
| 2 | Ideale per la governance di lakehouse ibridi nelle aziende regolamentate | Prova gratuita di 60 giorni disponibile | A partire da $0.04/CCU/ora | Website | |
| 3 | Ideale per un lakehouse Iceberg aperto senza vincoli | Prova gratuita di 30 giorni | A partire da $0.20/DCU | Website | |
| 4 | Ideale per la governance dei data lake nei settori regolamentati | Demo gratuita disponibile | Prezzo su richiesta | Website | |
| 5 | Ideale per la governance tra motori diversi su tabelle aperte del data lake | Prova gratuita di 90 giorni | A partire da $0.12 per ora-DCU | Website | |
| 6 | Ideale per lakehouse nativi GCP con archiviazione a livelli | Piano gratuito disponibile | A partire da $0.020/GB/mese | Website | |
| 7 | Ideale per la condivisione di dati senza copia tra cloud | Prova gratuita di 30 giorni | A partire da $2.00/credito | Website | |
| 8 | Ideale per un lakehouse basato su formati di tabelle aperti | Versione di prova gratuita di 14 giorni | A partire da $0.22/DBU | Website | |
| 9 | Ideale per l'archiviazione di oggetti alla base dei laghi di dati AWS | Non disponibile | Da $0.023/GB/month | Website | |
| 10 | Ideale per laghi dati aziendali nativi Microsoft | Credito di $200 per 30 giorni (nessun livello gratuito dedicato) | A partire da $0.023/GB/mese | Website |




Recensioni degli strumenti per data lake
Di seguito trovi i miei riepiloghi dettagliati dei migliori strumenti per data lake entrati nella mia selezione. Le mie recensioni offrono un’analisi approfondita delle funzionalità, delle capacità e dei migliori casi d’uso di ciascuna piattaforma, per aiutarti a trovare quella più adatta a te.
 1Ideale per lakehouse Apache Iceberg ottimizzati automaticamente
Qlik
- Prova gratuita disponibile
- A partire da $300/mese (con fatturazione annuale)
Visit WebsiteCustomer Rating:4.4/5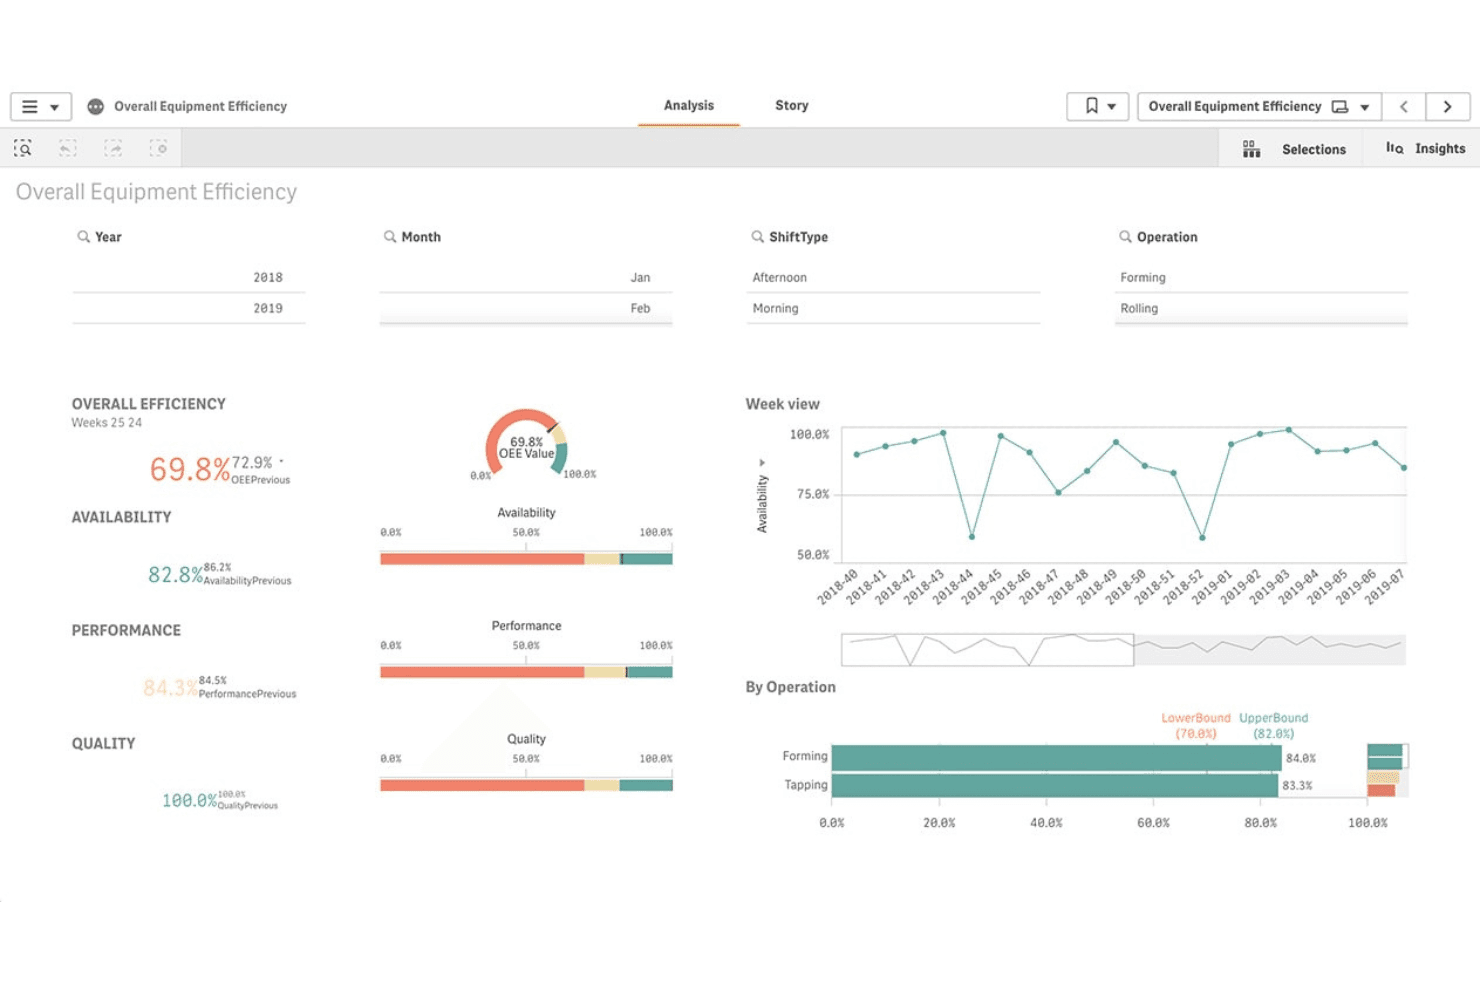
Qlik monitora l'efficienza complessiva delle apparecchiature con dashboard KPI in tempo reale. Qlik è una piattaforma di integrazione dei dati e lakehouse, sviluppata nativamente su Apache Iceberg, che combina l'acquisizione basata su CDC, l'evoluzione automatica degli schemi, pipeline di dati multiformato e governance integrata negli ambienti di archiviazione di oggetti cloud.
Per chi è più adatto Qlik?
Qlik è particolarmente adatto alle grandi aziende dei settori regolamentati che necessitano di integrazione dei dati end-to-end, governance e gestione del lakehouse su un'unica piattaforma.
Perché ho scelto Qlik
Ho scelto Qlik perché il suo Adaptive Iceberg Optimizer lo distingue: esegue continuamente la compattazione, l'indicizzazione e la pulizia degli snapshot sulle tabelle Iceberg senza alcuna ottimizzazione manuale, offrendo velocità delle query da 2,5x a 5x superiori e un risparmio sui costi di archiviazione fino al 50%. Mi affido inoltre al suo mirroring senza copia per trasferire tabelle Iceberg attive direttamente in Snowflake senza duplicare i dati né aggiungere complessità alle pipeline.
Funzionalità principali di Qlik
- Replica CDC basata sui log: Qlik Replicate acquisisce le modifiche direttamente dai log delle transazioni del database senza richiedere agenti, mantenendo aggiornati i dati nel lake senza influire sulle prestazioni del sistema di origine.
- Pipeline di acquisizione multiformato: Acquisisci dati in Parquet, Avro, ORC, JSON e CSV da oltre 200 fonti, tra cui database, applicazioni SaaS, SAP, mainframe e piattaforme di streaming come Kafka e Kinesis.
- Provenienza a livello di colonna e analisi dell'impatto: Tieni traccia dei dati dalla fonte al consumo a livello di colonna, ottenendo una chiara traccia di audit per la governance e la reportistica di conformità.
- Gestione automatizzata delle zone bronze/silver/gold: Qlik Compose for Data Lakes automatizza la generazione degli schemi, la creazione del catalogo Hive e gli aggiornamenti continui delle zone tramite CDC, eliminando la codifica manuale delle pipeline per le architetture lake multilivello.
Integrazioni di Qlik
Qlik supporta oltre 200 fonti di acquisizione, tra cui Amazon S3, Azure Data Lake Storage, Google Cloud Storage, Snowflake, Kafka, Oracle, SAP e Salesforce. Le sue tabelle Iceberg si integrano con Spark, Amazon Athena, Trino, Presto, Databricks, Dremio e Tableau.
Pros and Cons
Pros:
- Gestione automatizzata e ottimizzata delle tabelle Apache Iceberg
- Replica CDC avanzata in tempo reale basata sui log
- Controlli approfonditi di conformità e governance aziendale
Cons:
- Piattaforma complessa con requisiti tecnici elevati
- Processo di concessione delle licenze e stima dei costi poco trasparente
Learn more about Qlik: Ideale per la governance di lakehouse ibridi nelle aziende regolamentate
- Prova gratuita di 60 giorni disponibile
- A partire da $0.04/CCU/ora
Visit WebsiteCustomer Rating:4.1/5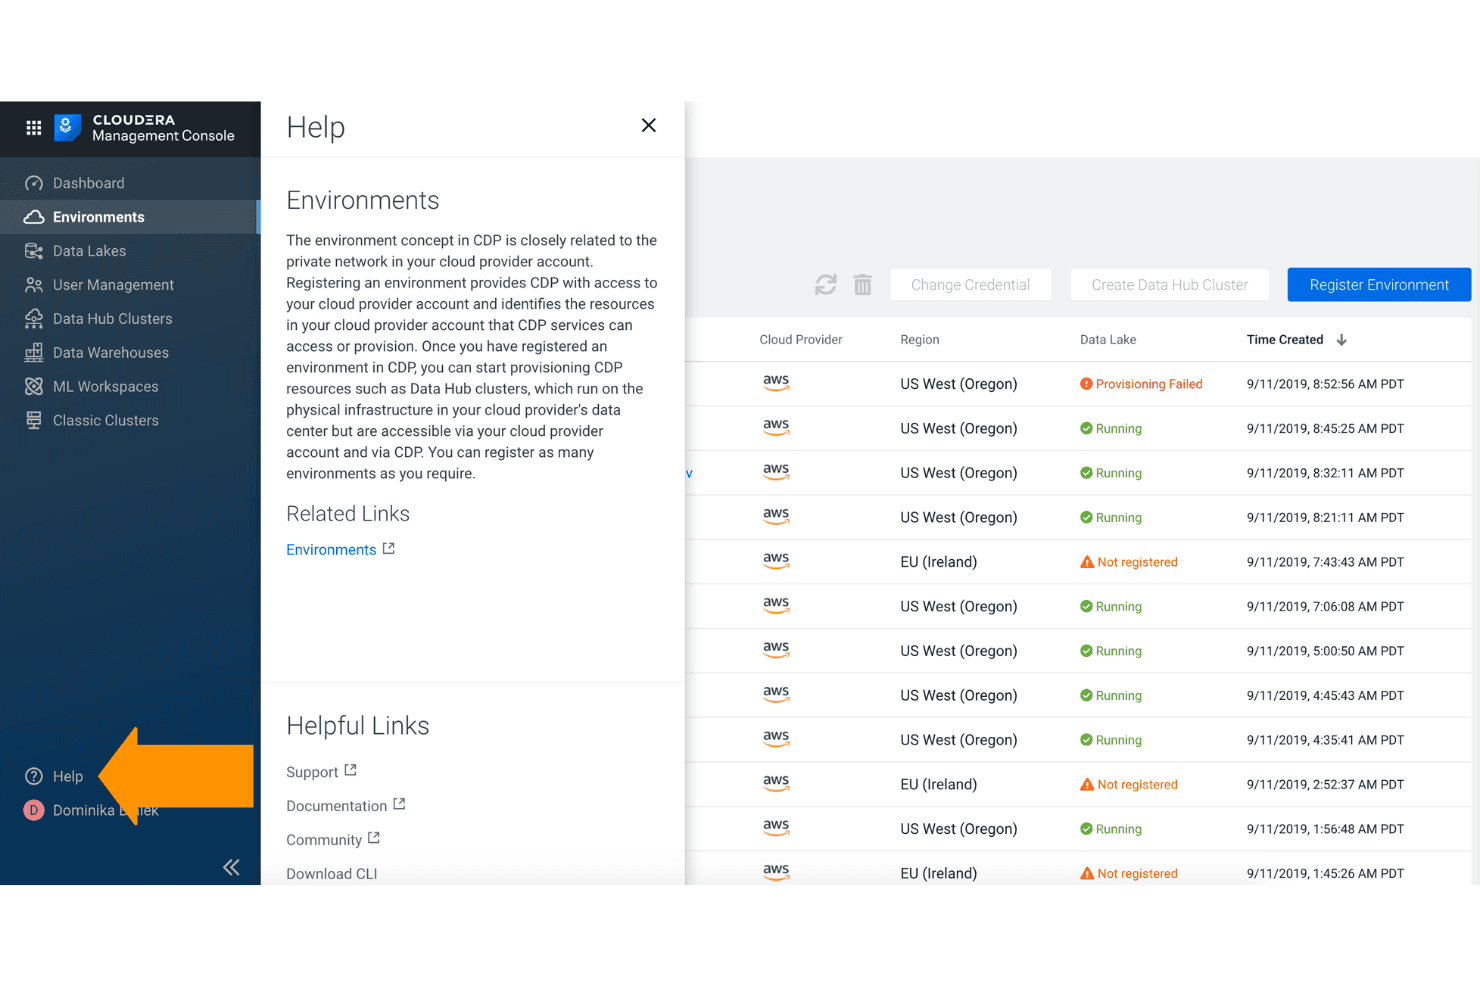
Cloudera consente agli utenti di gestire e monitorare gli ambienti cloud tra diverse regioni. Cloudera è una piattaforma aperta per l'archiviazione di dati con architettura lakehouse, che offre archiviazione scalabile su più cloud e in locale, acquisizione di dati in più formati tramite oltre 450 connettori, schema alla lettura basato su Apache Iceberg e governance centralizzata negli ambienti ibridi.
Per chi è più adatta Cloudera?
Cloudera è particolarmente adatta alle grandi aziende dei settori regolamentati—banche, enti governativi, telecomunicazioni—che necessitano di una governance unificata negli ambienti locali e su più cloud.
Perché ho scelto Cloudera
Cloudera si è guadagnata un posto nella mia selezione perché nessun'altra piattaforma offre lo stesso livello di profondità nella governance degli ambienti ibridi. Sono particolarmente colpito da Cloudera SDX, che applica una sola volta le policy di Apache Ranger e Apache Atlas e le fa rispettare ovunque, sia che i dati risiedano in un cluster HDFS locale, in Azure ADLS o in AWS S3. Le banche e gli enti governativi che gestiscono infrastrutture miste possono definire centralmente regole di mascheramento a livello di colonna e policy ABAC, con le certificazioni FedRAMP Moderate e PCI DSS 4.0 a supporto della conformità.
Funzionalità principali di Cloudera
- Viaggio nel tempo di Apache Iceberg: Consente di interrogare le istantanee storiche dei dati in qualsiasi momento utilizzando il controllo delle versioni integrato e le funzionalità di viaggio nel tempo di Iceberg.
- Ottimizzatore del lakehouse: Automatizza la compattazione delle tabelle Iceberg, l'ordinamento Z e l'eliminazione delle partizioni per migliorare le prestazioni delle interrogazioni e ridurre i costi di calcolo.
- Generatore visivo di pipeline di Cloudera Data Flow (NiFi): Progetta e distribuisce pipeline di acquisizione dati utilizzando un'interfaccia con funzionalità di trascinamento e rilascio, con oltre 450 processori e connettori preconfigurati.
- Condivisione dei dati senza copia tramite Iceberg REST Catalog: I motori esterni come Databricks, Snowflake e Athena possono interrogare direttamente le tabelle Iceberg gestite da Cloudera senza spostare o duplicare i dati.
Integrazioni di Cloudera
Cloudera Data Flow offre oltre 450 connettori preconfigurati, tra cui Apache Kafka, MongoDB, Salesforce, Snowflake e Google BigQuery. Si integra inoltre con AWS, Microsoft Azure, Google Cloud Platform, Databricks, Tableau e Power BI tramite Iceberg REST Catalog.
Pros and Cons
Pros:
- Il supporto per ambienti ibridi e locali è senza pari
- Governance aziendale per rigorosi requisiti di conformità
- Condivisione senza copia tra motori di interrogazione esterni
Cons:
- La configurazione iniziale richiede spesso competenze specialistiche
- La soddisfazione per la gestione dei metadati è inferiore alla media dei concorrenti
Learn more about Cloudera: Ideale per un lakehouse Iceberg aperto senza vincoli
- Prova gratuita di 30 giorni
- A partire da $0.20/DCU
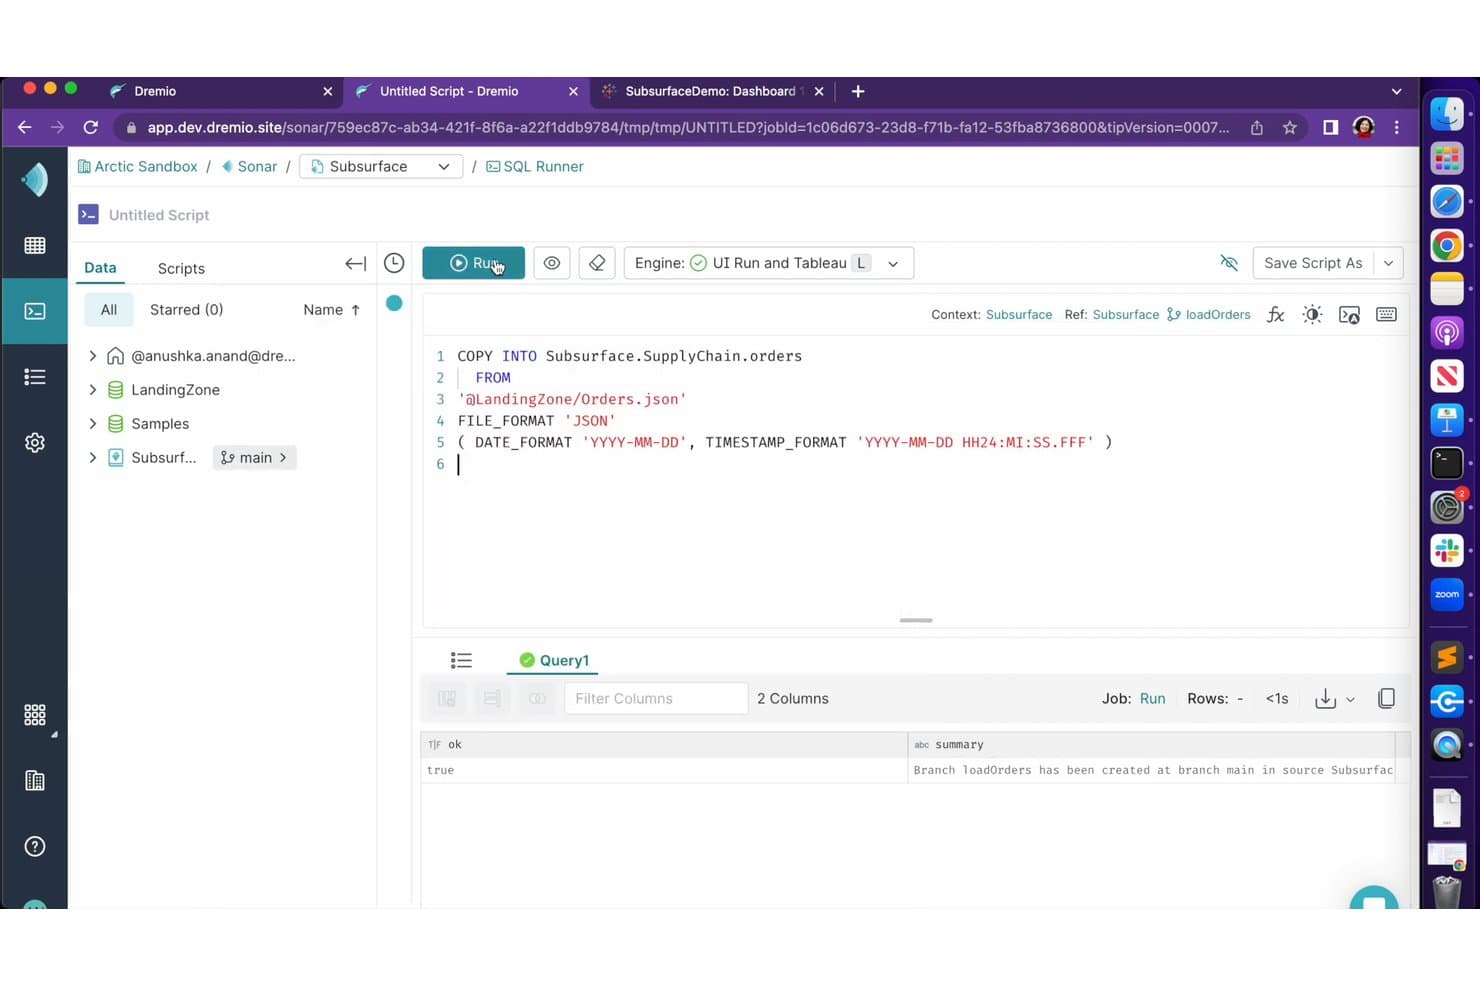
Dremio consente agli utenti di caricare dati JSON nelle tabelle utilizzando comandi SQL COPY INTO. Dremio è una piattaforma lakehouse aperta basata nativamente su Apache Iceberg e Apache Arrow, che combina un motore di query SQL, l'accesso federato ai dati, l'accelerazione automatizzata delle query, il controllo delle versioni dei dati in stile Git e un catalogo aperto multi-motore.
Per chi è più adatto Dremio?
Dremio è particolarmente adatto ai team di ingegneria e architettura dei dati che realizzano lakehouse aperti su Apache Iceberg e necessitano di accedere alle query tramite più motori senza essere vincolati a un catalogo proprietario o a un formato di archiviazione specifico.
Perché ho scelto Dremio
Dremio si è guadagnato un posto nella mia selezione perché è basato nativamente su Apache Iceberg, il che significa che i dati restano nei propri bucket S3 o ADLS e qualsiasi motore (Spark, Flink, Trino, DuckDB) può leggerli e scriverli tramite il catalogo aperto Polaris senza conversione del formato. Apprezzo particolarmente le riflessioni autonome, che osservano silenziosamente i modelli di query e materializzano le accelerazioni in background, così i dashboard BI restituiscono risultati rapidamente senza ottimizzazione manuale o estratti proprietari.
Funzionalità principali di Dremio
- Catalogo aperto (Apache Polaris): un catalogo multi-motore basato su Apache Polaris che consente a Spark, Flink, Trino e DuckDB di leggere e scrivere tabelle Iceberg tramite un'API REST standard.
- Ramificazione dei dati come codice: il controllo delle versioni in stile Git tramite Project Nessie crea rami di dati isolati senza duplicazione per lo sviluppo, i test e la sperimentazione con il machine learning, con unioni e ripristini atomici.
- Acquisizione con COPY INTO: un comando SQL nativo che carica in blocco file CSV, JSON e Parquet dall'archiviazione a oggetti direttamente nelle tabelle Iceberg, con evoluzione dello schema e gestione delle partizioni.
- Controllo degli accessi granulare: sicurezza a livello di riga e mascheramento delle colonne applicati al momento della query e in modo coerente su ogni motore che interroga il catalogo.
Integrazioni di Dremio
Dremio si integra con Apache Spark, Apache Flink, Trino, DuckDB, Tableau, Power BI, dbt Core, Amazon S3, Azure Data Lake Storage e Google Cloud Storage. Il catalogo REST Polaris, le interfacce ODBC, JDBC e Arrow Flight supportano le connessioni con motori e applicazioni personalizzati.
Pros and Cons
Pros:
- Elabora Apache Iceberg nativamente senza conversione
- Ramificazione dei dati in stile Git per il viaggio nel tempo
- Il catalogo REST aperto si connette a qualsiasi motore di query
Cons:
- La complessità dell'amministrazione è maggiore rispetto agli strumenti concorrenti
- Nessun archivio di feature ML integrato dedicato
Learn more about Dremio: Ideale per la governance dei data lake nei settori regolamentati
- Demo gratuita disponibile
- Prezzo su richiesta
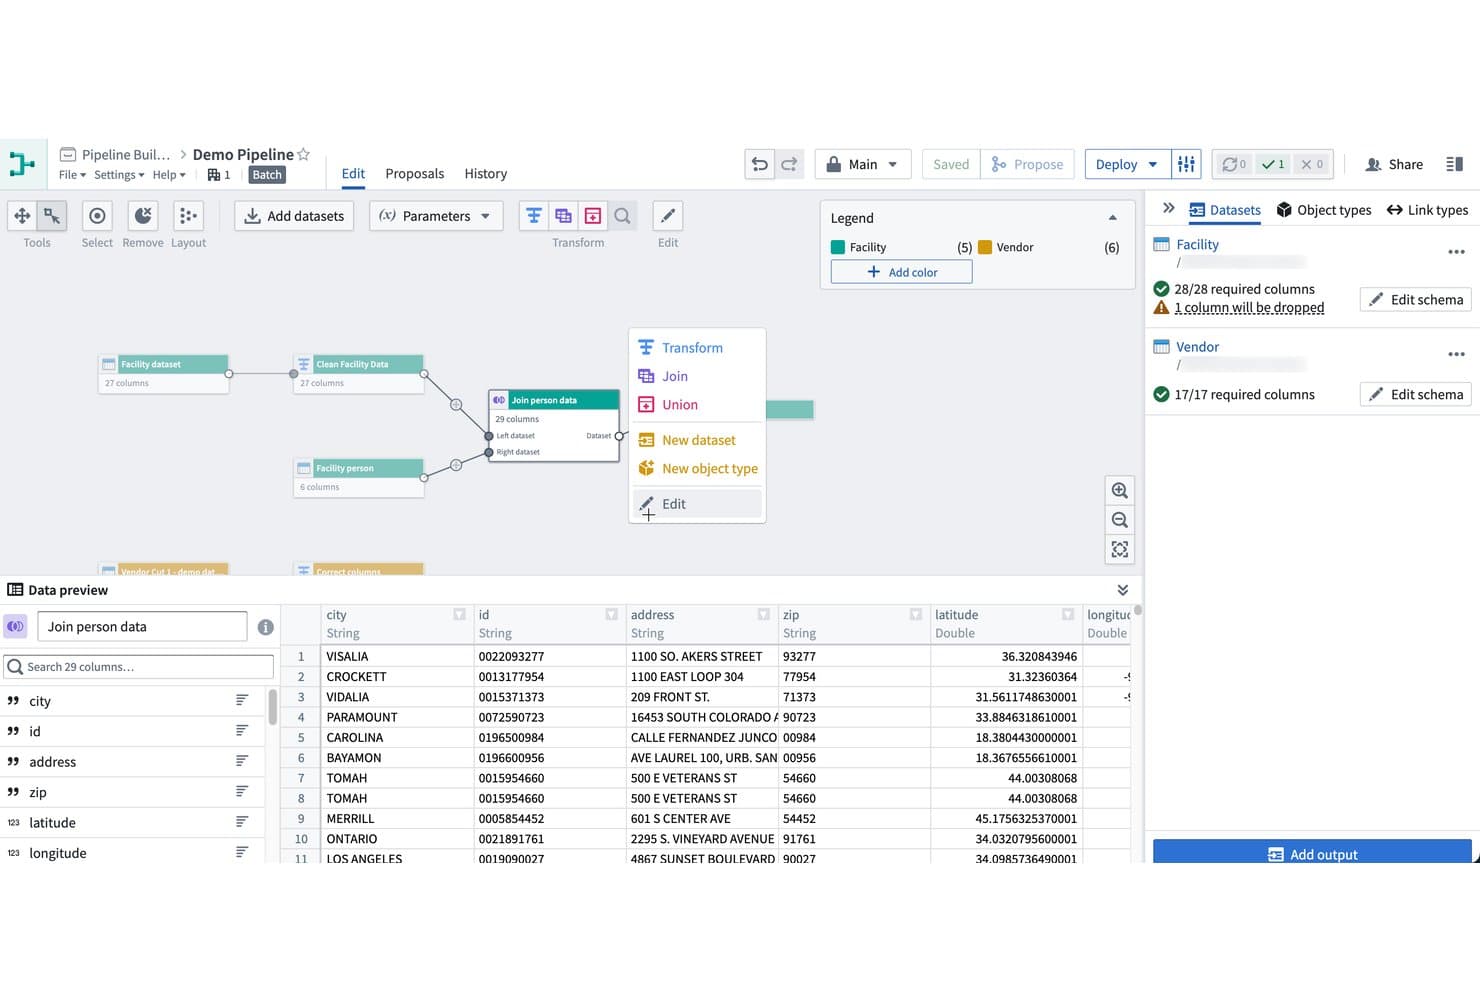
Palantir Foundry consente agli utenti di creare e unire visivamente i dataset nelle pipeline. Palantir Foundry è una piattaforma di data lake che combina l'acquisizione in più formati, l'orchestrazione delle pipeline, la modellazione semantica dei dati tramite il suo livello Ontology e controlli di governance integrati in ambienti cloud, on-premise e air-gapped.
Per chi è più adatto Palantir Foundry?
Palantir Foundry è progettato specificamente per le grandi aziende di settori regolamentati—finanza, sanità, difesa e pubblica amministrazione—che necessitano di una governance granulare dei dati in ambienti complessi e multi-sorgente.
Perché ho scelto Palantir Foundry
Ho scelto Palantir Foundry perché la sua architettura di governance non ha davvero eguali nei settori regolamentati. La piattaforma combina controlli degli accessi basati sulla finalità, sulla classificazione e sul ruolo, con marcature dei dati che si propagano automaticamente lungo la derivazione, in modo che un tag PII su un dataset di origine segua i dati attraverso ogni trasformazione a valle. A questo si aggiungono le certificazioni FedRAMP High, HIPAA, ITAR e SOC 2 Type 2, nonché il livello Ontology, che associa i dati grezzi del lake a oggetti aziendali verificabili: il risultato è una piattaforma costruita fin dalle fondamenta per ambienti in cui la governance non è facoltativa.
Funzionalità principali di Palantir Foundry
- Oltre 200 connettori dati predefiniti: Collegati a database, data warehouse, piattaforme di streaming, sistemi ERP, storage cloud, fonti IoT e strumenti geospaziali tramite un'unica interfaccia di acquisizione.
- Catalogo REST Apache Iceberg: Espone i dataset di Foundry a motori di elaborazione esterni compatibili con Iceberg—tra cui Trino, Spark, Flink, Databricks e Snowflake—senza duplicare i dati.
- Tabelle virtuali per la federazione senza copia: Interroga direttamente da Foundry le tabelle esterne in Databricks, Snowflake e negli archivi compatibili con S3, senza acquisire o spostare i dati sottostanti.
- Studio dei modelli AIP: Crea, addestra, valuta e distribuisci modelli ML all'interno di Foundry, con accesso nativo agli LLM e supporto per ambienti di sviluppo Python e R.
Integrazioni di Palantir Foundry
Palantir Foundry offre oltre 200 connettori dati nativi, tra cui Amazon S3, Snowflake, Databricks, PostgreSQL, SAP, Apache Kafka, Amazon Kinesis, Tableau e Power BI. Supporta inoltre la connettività personalizzata tramite la sua API compatibile con S3, il Catalogo REST Iceberg e le tabelle virtuali.
Pros and Cons
Pros:
- Governance dei dati ai vertici del settore per la conformità
- Il livello Ontology consente l'accesso ai dati da parte degli utenti aziendali
- Condivisione dei dati senza copia con tabelle virtuali
Cons:
- Prezzi contrattuali elevati con costi totali non chiari
- Rischio di dipendenza dalla piattaforma a causa dei modelli proprietari
Learn more about Palantir Foundry: Ideale per la governance tra motori diversi su tabelle aperte del data lake
- Prova gratuita di 90 giorni
- A partire da $0.12 per ora-DCU
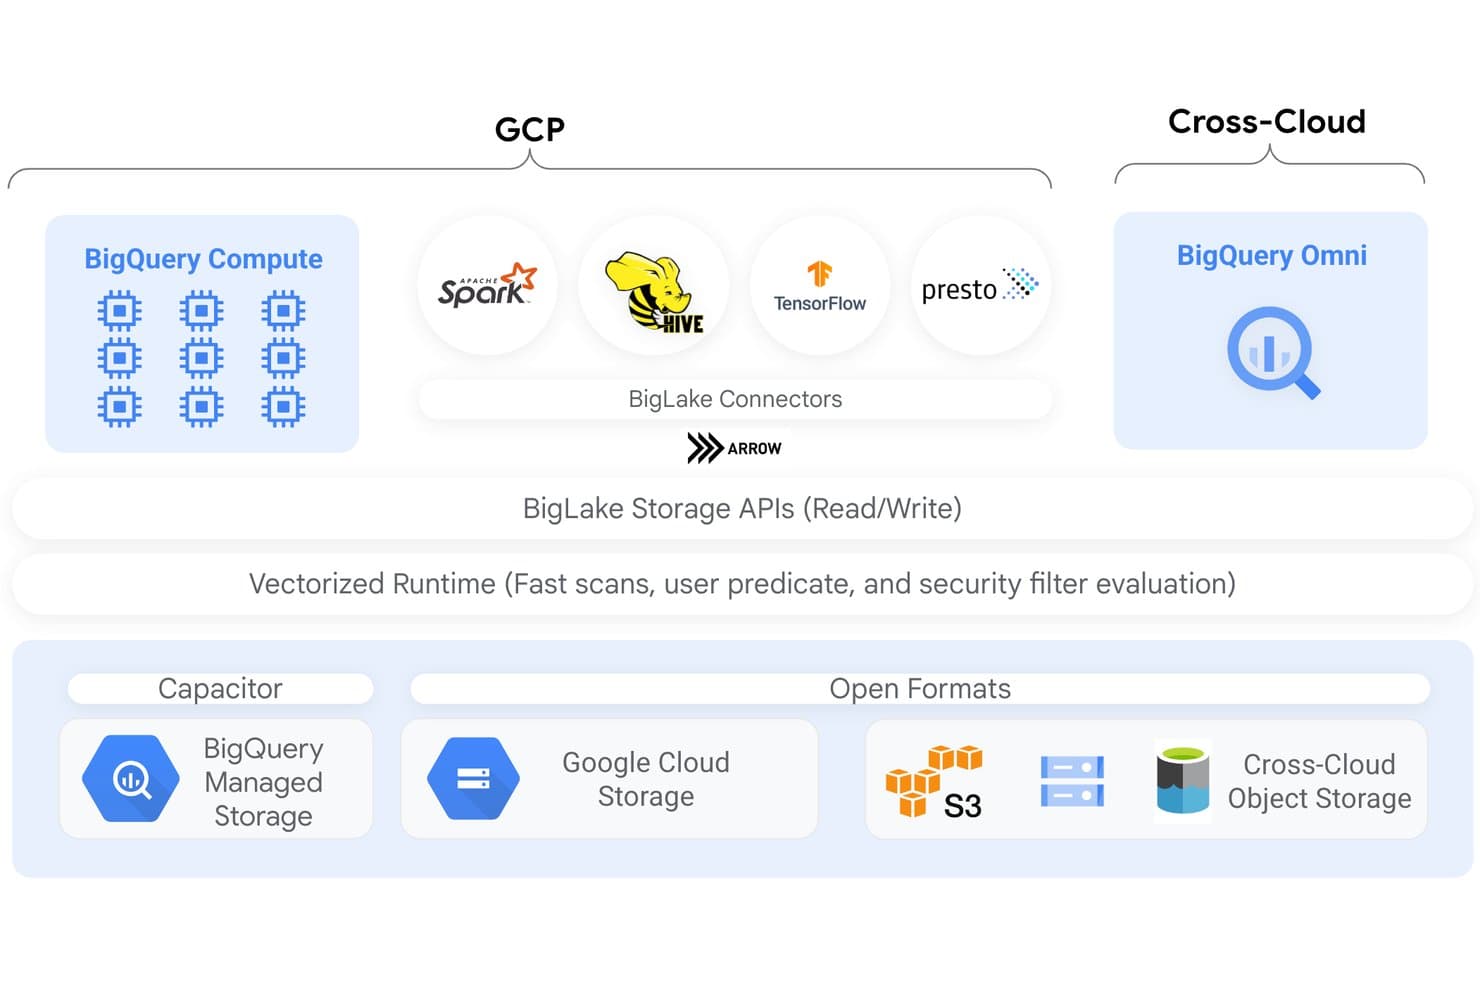
BigLake unifica elaborazione e archiviazione tra GCP e gli ambienti tra cloud. BigLake è la piattaforma lakehouse di Google Cloud che estende BigQuery con il supporto per tabelle in formato aperto, l'accesso alle query tra motori diversi, la gestione unificata dei metadati e una governance granulare su GCS, S3 e Azure Blob Storage.
A chi è più adatto BigLake?
BigLake è particolarmente adatto ai team di ingegneria e architettura dei dati che hanno già investito in Google Cloud e necessitano di una governance coerente tra più motori di query e formati di tabelle aperti.
Perché ho scelto BigLake
Ho scelto BigLake come una delle soluzioni migliori perché è l'unica piattaforma lakehouse che abbia visto applicare in modo coerente i criteri di accesso a livello di riga e colonna tra BigQuery, Spark, Trino e Presto, non solo all'interno di un singolo motore. Ciò significa che un tag dei criteri applicato a una colonna sensibile segue i dati indipendentemente dal motore attraverso cui il team esegue le query. Il Catalogo REST Iceberg della piattaforma lakehouse lo rende possibile fungendo da singolo endpoint consapevole della governance per tutti i motori open source che leggono e scrivono nelle stesse tabelle Iceberg.
Funzionalità principali di BigLake
- Manutenzione automatizzata delle tabelle: BigLake gestisce automaticamente la compattazione dei file, la clusterizzazione, la raccolta dei dati inutilizzati e la generazione dei metadati per le tabelle Iceberg archiviate in GCS.
- Acquisizione in più formati: acquisisci dati in Parquet, ORC, Avro, CSV, JSON e formati di tabelle aperti come Apache Iceberg, Delta Lake e Apache Hudi tramite file manifest.
- Query tra cloud con BigQuery Omni: esegui query SQL di BigQuery direttamente sui dati archiviati in Amazon S3 o Azure Data Lake Storage Gen 2 senza trasferirli in GCS.
- Replica dei dati con acquisizione delle modifiche: trasmetti i dati operativi da Cloud Spanner, AlloyDB e Cloud SQL direttamente nelle tabelle BigLake per analisi quasi in tempo reale.
Integrazioni di BigLake
BigLake offre integrazioni native con BigQuery, Apache Spark, Apache Flink, Trino, Presto, Google Cloud Storage, Amazon S3, Azure Data Lake Storage Gen2, Looker e Vertex AI. Il suo Catalogo REST Iceberg collega i motori open source alle tabelle condivise del data lake.
Pros and Cons
Pros:
- Sicurezza a livello di riga e colonna applicata tra i motori
- Formati di tabelle aperti con supporto completo per Iceberg
- Federazione dei cataloghi per la gestione dei metadati multi-cloud
Cons:
- DML non supportato per le tabelle esterne non Iceberg
- CMEK non disponibile per le tabelle memorizzate nella cache di S3 o Azure
Learn more about BigLake: Ideale per lakehouse nativi GCP con archiviazione a livelli
- Piano gratuito disponibile
- A partire da $0.020/GB/mese
Visit WebsiteCustomer Rating:4.7/5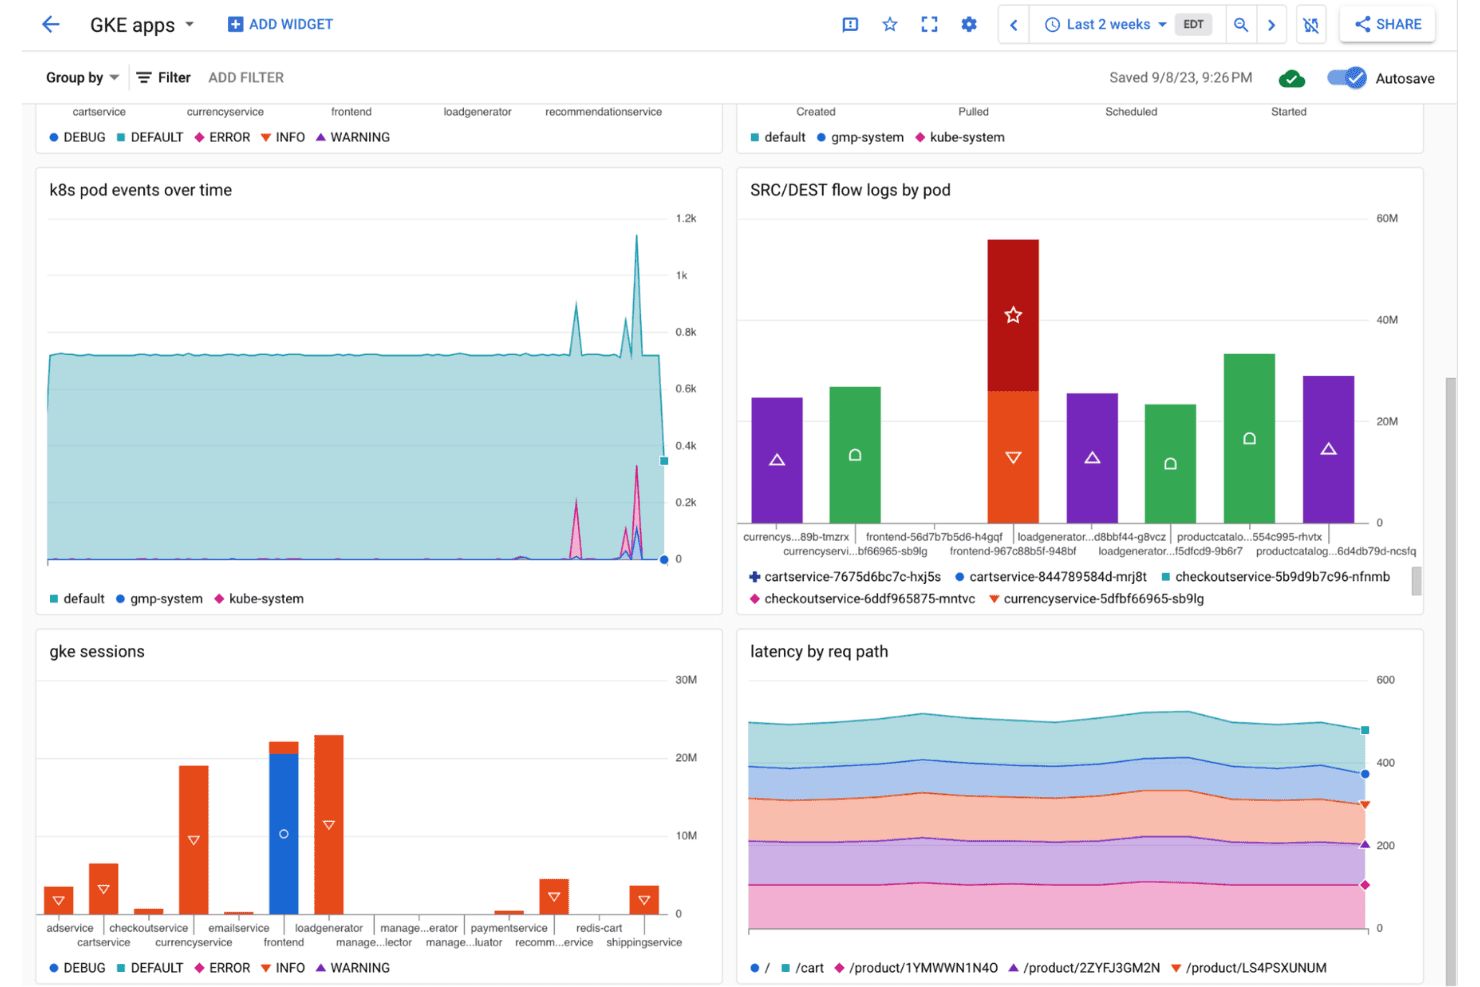
Google Cloud Storage mostra dashboard di monitoraggio delle app GKE con eventi dei pod e metriche di latenza. Google Cloud Storage è un servizio gestito di archiviazione di oggetti progettato per le architetture di data lake, che offre classi di archiviazione a livelli, supporto per formati di tabelle aperti tramite Apache Iceberg e BigLake e una profonda integrazione con BigQuery, Dataflow, Dataproc e Vertex AI.
Per chi è più indicato Google Cloud Storage?
Google Cloud Storage è particolarmente adatto ai team di ingegneria dei dati e infrastrutturali che operano già nell'ecosistema GCP e hanno bisogno di un archivio di oggetti scalabile come base di un'architettura lakehouse.
Perché ho scelto Google Cloud Storage
Ho scelto Google Cloud Storage perché è la base nativa per una lakehouse basata su GCP, con classi di archiviazione a livelli (da Standard fino ad Archive a $0.0012/GB/mese) e Autoclass, che sposta automaticamente gli oggetti tra i livelli in base ai modelli di accesso. Ciò che trovo particolarmente interessante è BigLake: aggiunge transazioni ACID, viaggio nel tempo ed evoluzione dello schema direttamente alle tabelle Apache Iceberg basate su GCS, trasformando l'archiviazione grezza di oggetti in una lakehouse interrogabile senza spostare i dati. BigQuery esegue quindi query sulle stesse tabelle Iceberg direttamente sul posto, senza bisogno di esportazione.
Funzionalità principali di Google Cloud Storage
- Acquisizione in più formati: Storage Transfer Service, Dataflow, Pub/Sub e Datastream supportano l'acquisizione in batch, in streaming e CDC da database come MySQL, PostgreSQL e Oracle in GCS.
- Governance e controlli degli accessi: le autorizzazioni basate su IAM, la crittografia CMEK/CSEK, VPC Service Controls, Cloud DLP e la registrazione degli audit applicano la sicurezza a tutti i dati archiviati.
- Rilevamento dei metadati tramite Knowledge Catalog: Dataplex analizza automaticamente i bucket GCS per estrarre gli schemi, creare glossari aziendali e generare la derivazione dei dati end-to-end tra GCS e BigQuery.
- Supporto per query eseguite da più motori: le tabelle Iceberg basate su GCS possono essere interrogate da BigQuery, Serverless Spark, Trino, Flink e Presto tramite Iceberg REST Catalog.
Integrazioni di Google Cloud Storage
Google Cloud Storage offre integrazioni native con BigQuery, Dataproc, Dataflow, Pub/Sub, Datastream, Vertex AI, Looker e Knowledge Catalog. Le API REST, XML, gRPC e delle librerie client supportano integrazioni personalizzate con piattaforme di dati e motori di elaborazione.
Pros and Cons
Pros:
- Supporto per architetture lakehouse con tabelle Apache Iceberg
- Analisi con più motori tramite BigQuery e Spark
- Opzioni automatizzate di archiviazione e suddivisione in livelli
Cons:
- La maggior parte delle funzionalità richiede più servizi GCP
- Fatturazione complessa con costi separati per operazioni ed egress
Learn more about Google Cloud Storage: Ideale per la condivisione di dati senza copia tra cloud
- Prova gratuita di 30 giorni
- A partire da $2.00/credito
Visit WebsiteCustomer Rating:4.6/5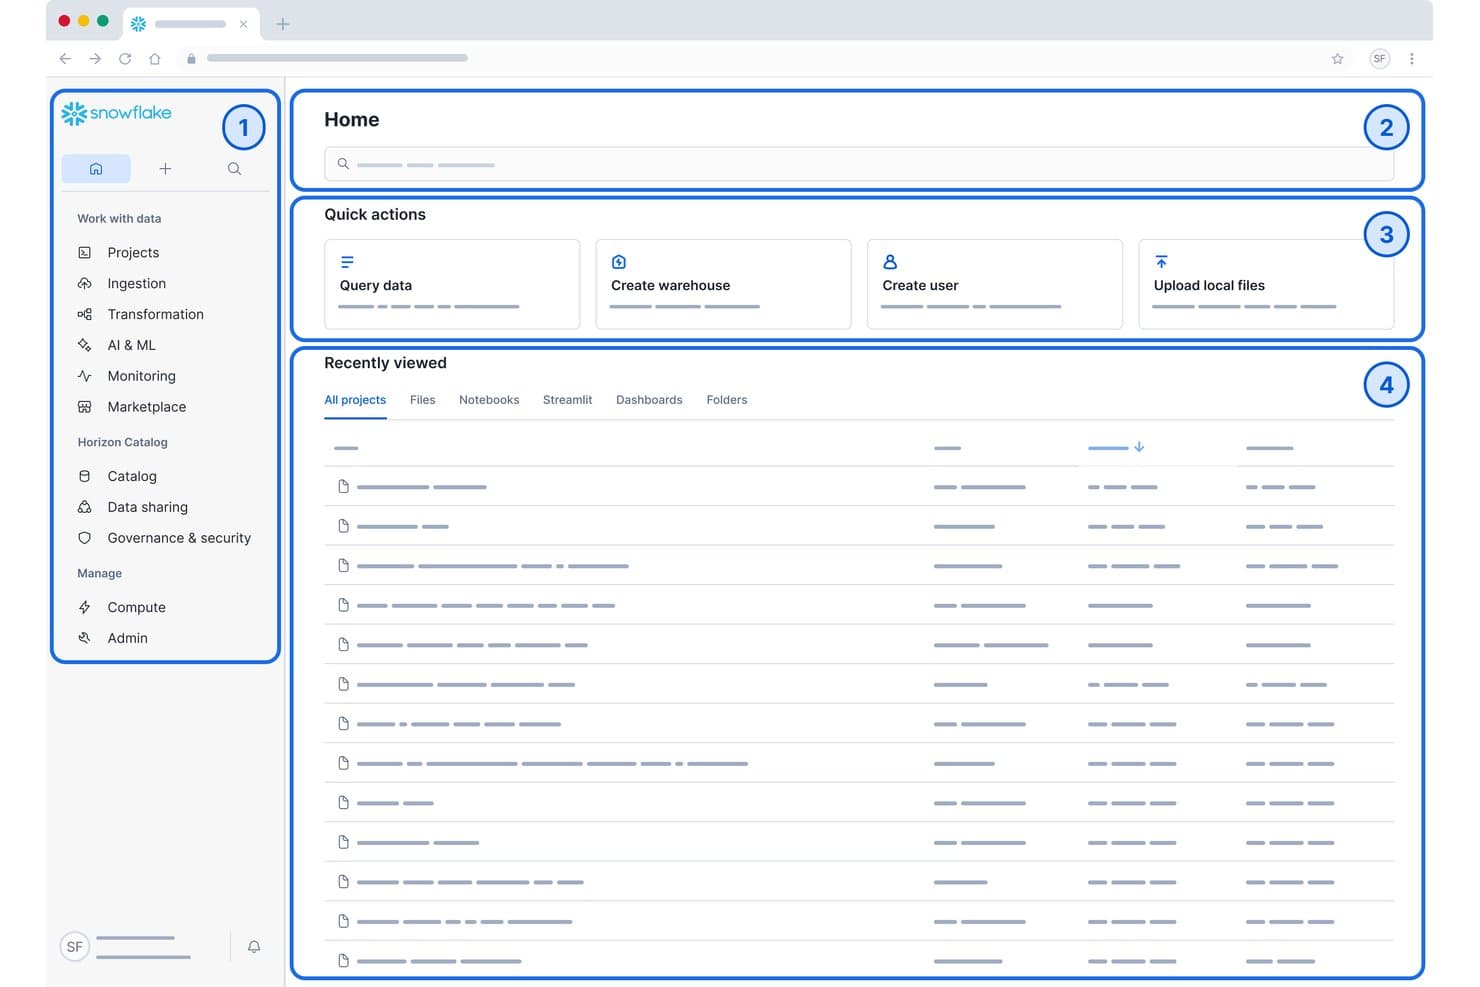
La dashboard principale di Snowflake centralizza le query sui dati, la creazione di warehouse e i progetti recenti. Snowflake è un lago dati e una piattaforma di analisi nativi per il cloud che combinano archiviazione elastica, un motore di interrogazioni SQL integrato, Snowpark per i carichi di lavoro Python/Java/Scala, il supporto per Apache Iceberg e la condivisione di dati senza copia tra AWS, Azure e GCP.
A chi è più adatto Snowflake?
Snowflake è particolarmente adatto ai team aziendali che gestiscono ambienti multicloud su larga scala, in cui governance, conformità e condivisione dei dati tra organizzazioni sono requisiti imprescindibili.
Perché ho scelto Snowflake
Snowflake si è guadagnato un posto nella mia lista ristretta perché la sua condivisione dei dati senza copia consente di condividere set di dati attivi tra account AWS, Azure e GCP senza duplicare o spostare un solo byte. Ho lavorato con Snowflake Marketplace, che si connette a oltre 820 fornitori di dati, e la distribuzione automatica tra cloud rende la condivisione tra regioni davvero fluida. Se a questo si aggiungono il supporto nativo per Apache Iceberg e Snowpipe Streaming, che gestisce oltre 1 milione di transazioni al secondo, si ottiene una piattaforma per laghi dati progettata per la reale scalabilità aziendale.
Caratteristiche principali di Snowflake
- Ambiente di esecuzione multilingue Snowpark: Scrivi carichi di lavoro di ingegneria dei dati e apprendimento automatico in Python, Java o Scala ed eseguili direttamente all'interno del motore di interrogazioni di Snowflake senza spostare i dati all'esterno.
- Supporto per le tabelle Apache Iceberg: Archivia e gestisci i dati nel formato aperto delle tabelle Iceberg sullo spazio di archiviazione gestito da Snowflake, con evoluzione dello schema, viaggio nel tempo e interoperabilità con Spark, Trino e Flink.
- Catalogo Horizon: Un livello di governance integrato con tracciamento della derivazione a livello di colonna, classificazione automatizzata dei dati personali identificabili (PII), arricchimento dei metadati assistito dall'IA e funzioni delle metriche dei dati per il monitoraggio continuo della qualità dei dati.
- Snowpipe Streaming: Acquisisci dati a livello di riga in tempo reale a oltre 1 milione di transazioni al secondo direttamente nelle tabelle Snowflake o Apache Iceberg senza ritardi dovuti all'elaborazione a lotti.
Integrazioni di Snowflake
Snowflake offre integrazioni native con Apache Kafka, dbt, Tableau, Microsoft Power BI, Looker e Apache Airflow. Si connette ad Apache Spark, Trino, Amazon S3, Azure Blob Storage e Google Cloud Storage, con API per integrazioni personalizzate.
Pros and Cons
Pros:
- Condivisione di dati senza copia tra cloud
- Governance integrata e derivazione a livello di colonna
- Separazione elastica di archiviazione e calcolo
Cons:
- Nessun supporto per la distribuzione on-premise
- Il monitoraggio dei costi può essere complesso
Learn more about Snowflake: Ideale per un lakehouse basato su formati di tabelle aperti
- Versione di prova gratuita di 14 giorni
- A partire da $0.22/DBU
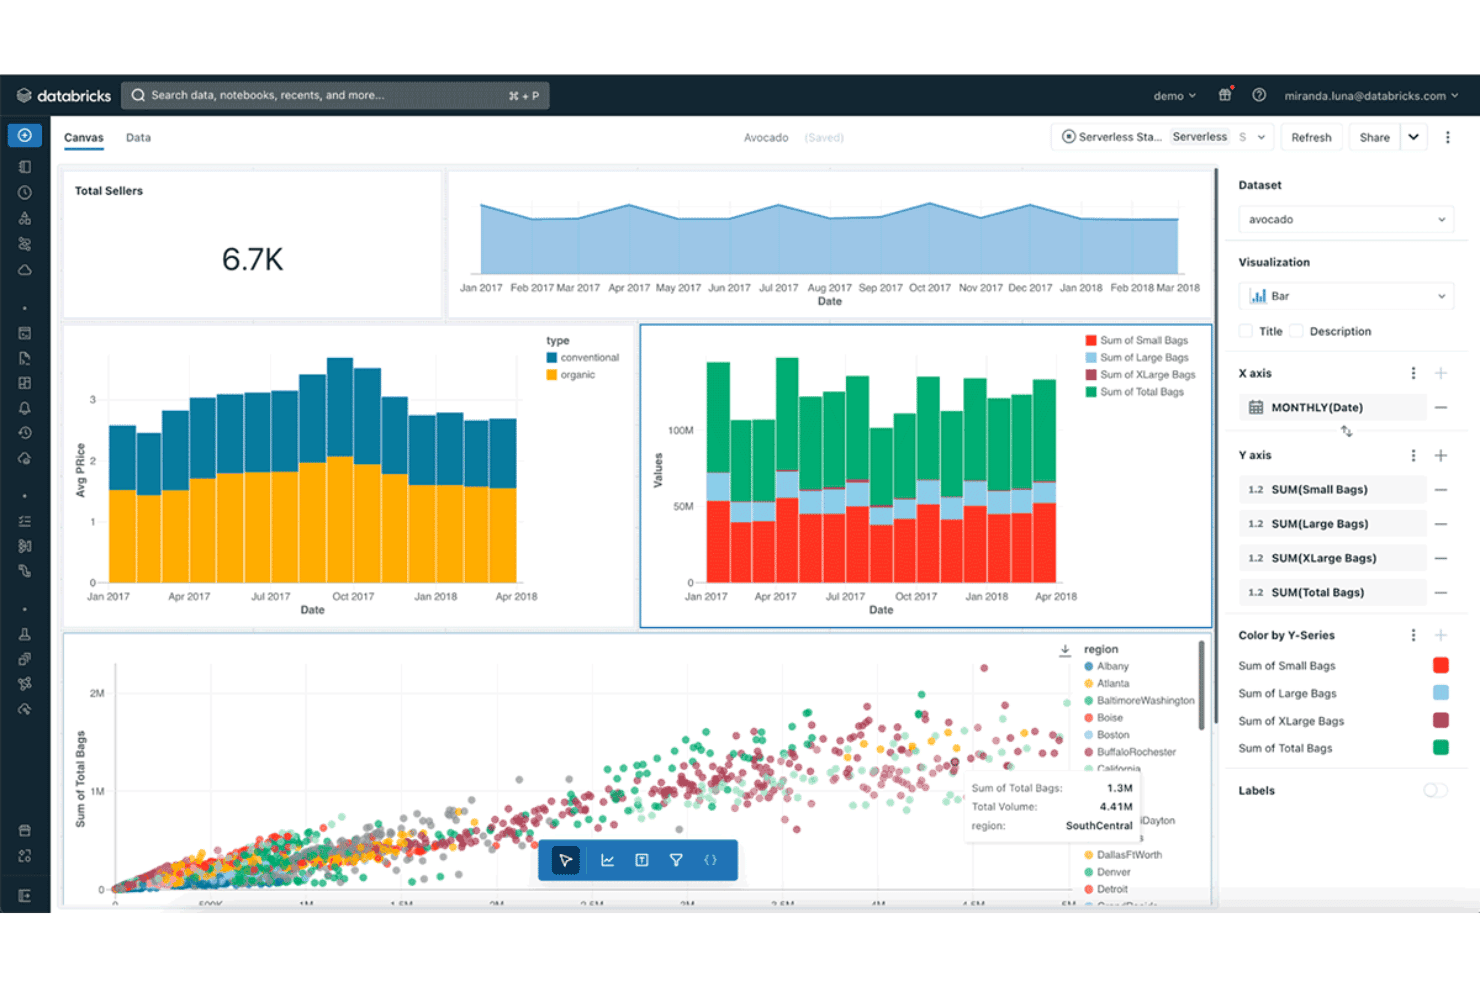
Databricks visualizza i dati sulle vendite di avocado attraverso grafici interattivi di dashboard. Databricks Lakehouse Platform è una piattaforma lakehouse di dati nativa del cloud che unifica l'ingegneria dei dati, l'analisi SQL, l'apprendimento automatico e lo sviluppo di applicazioni di intelligenza artificiale su formati di tabelle aperti come Delta Lake, Apache Iceberg e Apache Hudi.
Per chi è più adatta Databricks Lakehouse Platform?
Databricks è una soluzione ideale per i team aziendali che si occupano di dati e ML e che devono eseguire pipeline di ingegneria, analisi SQL e carichi di lavoro di intelligenza artificiale su un'unica piattaforma, senza spostare i dati tra sistemi diversi.
Perché ho scelto Databricks Lakehouse Platform
Databricks si è guadagnata un posto nella mia lista ristretta perché è il team che ha letteralmente inventato Delta Lake, e questa origine è importante quando si valuta il supporto ai formati di tabelle aperti. Ho lavorato con il supporto nativo della piattaforma per Delta Lake, Iceberg e Hudi, e ciò che la distingue è che le transazioni ACID, il viaggio nel tempo e l'evoluzione dello schema non sono componenti aggiuntivi. Unity Catalog aggiunge direttamente il lineage automatizzato a livello di colonna e il controllo degli accessi basato sugli attributi, così la governance segue i dati tra i diversi cloud.
Caratteristiche principali di Databricks Lakehouse Platform
- Lakeflow Connect: Un livello di acquisizione gestito e senza server con oltre 100 connettori nativi per applicazioni SaaS, database, archiviazione cloud e fonti di streaming, tra cui Kafka, Kinesis ed Event Hubs.
- Pipeline dichiarative Apache Spark: Un framework per creare pipeline ETL batch e di streaming in tempo reale, con applicazione integrata della qualità dei dati basata su vincoli e CDC automatizzato.
- Data warehouse SQL di Databricks: Un motore SQL accelerato da Photon che supporta ANSI SQL per i carichi di lavoro di analisi, con connettività JDBC/ODBC per strumenti di BI come Tableau, Power BI e Looker.
- Integrazione con MLflow: Un ambiente MLflow gestito per il monitoraggio degli esperimenti, il registro dei modelli e la distribuzione, ospitato insieme ai dati del lake e connesso a Feature Store e Model Serving.
Integrazioni di Databricks Lakehouse Platform
Databricks offre oltre 100 connettori nativi Lakeflow Connect, tra cui Salesforce Sales Cloud, Workday, HubSpot, Jira, ServiceNow, Microsoft SQL Server, Google Drive e Google Analytics. Si connette inoltre a Kafka, Kinesis, Event Hubs, S3, ADLS e GCS, con JDBC/ODBC e API per la connettività personalizzata.
Pros and Cons
Pros:
- Supporto nativo per Delta Lake, Iceberg e Hudi
- Lineage automatizzato a livello di colonna con Unity Catalog
- MLflow integrato e piattaforma di intelligenza artificiale unificata
Cons:
- I costi di DBU, sommati a quelli del cloud, possono aumentare rapidamente
- Nessuna opzione di distribuzione in sede disponibile
Learn more about Databricks Lakehouse Platform: Ideale per l'archiviazione di oggetti alla base dei laghi di dati AWS
- Non disponibile
- Da $0.023/GB/month
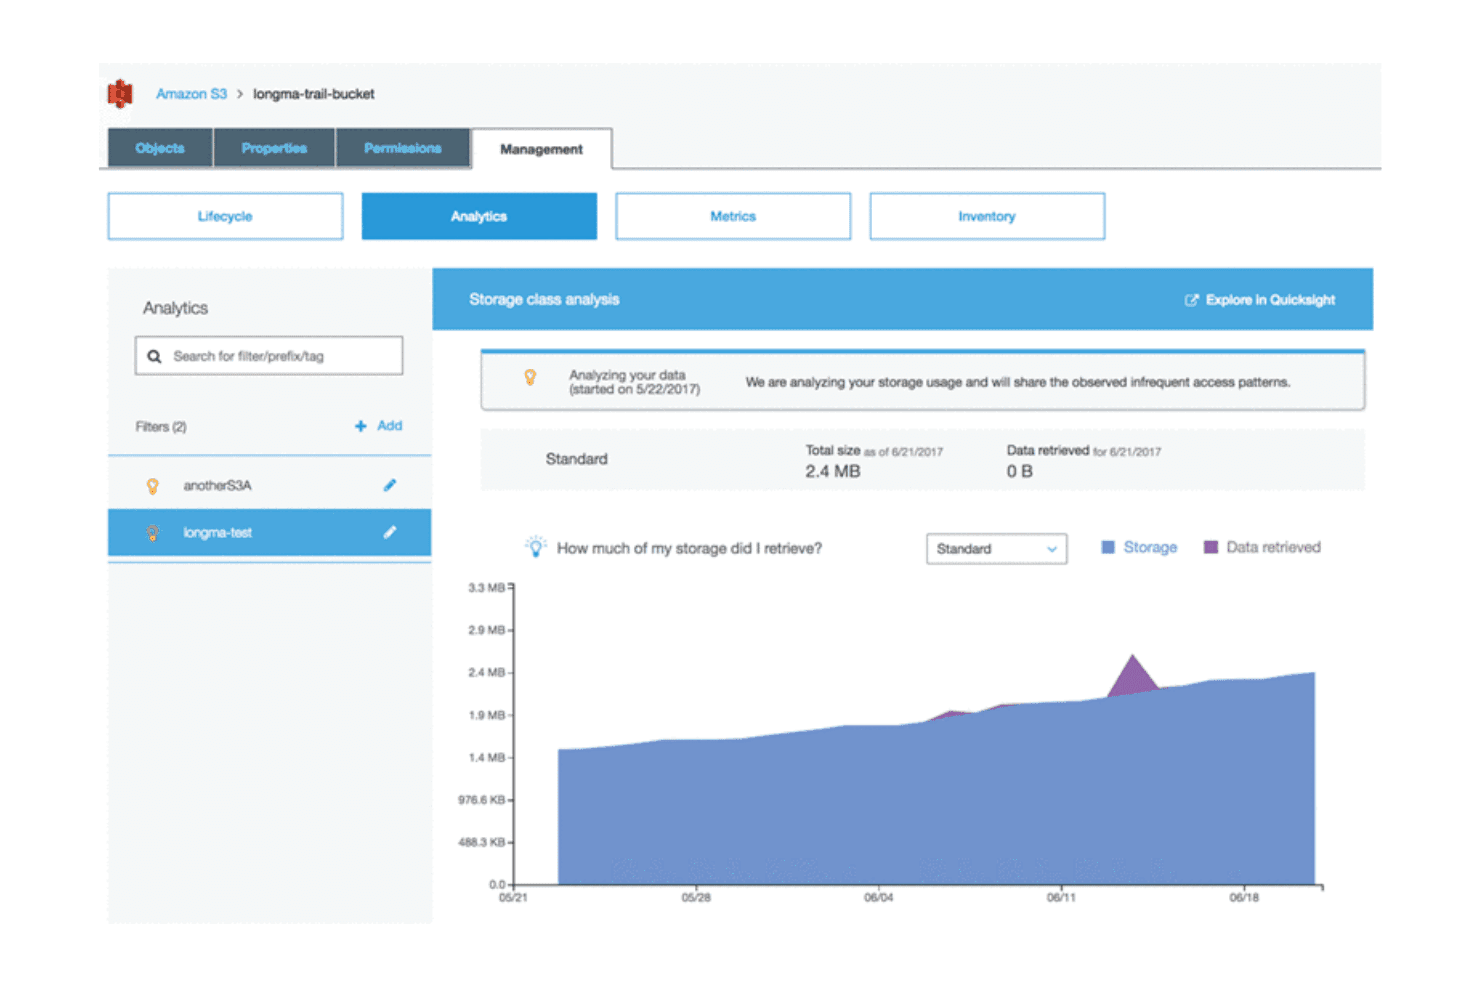
Amazon S3 analizza i modelli di utilizzo dell'archiviazione per ottimizzare i costi di recupero dei dati. Amazon S3 è il servizio di archiviazione di oggetti di AWS che funge da livello di archiviazione fondamentale per i laghi di dati, supportando qualsiasi formato di dati su scala exabyte con classi di archiviazione a più livelli, gestione nativa delle tabelle Apache Iceberg tramite S3 Tables e un'integrazione approfondita nell'intero ecosistema di analisi AWS.
Per chi è più adatto Amazon S3?
Amazon S3 è la scelta giusta per i team di ingegneria dei dati e infrastruttura che realizzano pipeline di analisi su AWS e necessitano di una base di archiviazione collaudata, su scala exabyte, che si colleghi direttamente al resto dell'ecosistema AWS.
Perché ho scelto Amazon S3
Amazon S3 si è guadagnato un posto nella mia rosa di strumenti perché è il livello di archiviazione degli oggetti su cui è già costruita la maggior parte dei laghi di dati in produzione. Apprezzo molto il fatto che S3 Tables offra il supporto nativo per Apache Iceberg con transazioni ACID, viaggio nel tempo e compattazione automatica integrati, risolvendo il problema dei file di piccole dimensioni che affligge la maggior parte delle architetture di laghi di dati. Abbinando il tutto a S3 Intelligent-Tiering, che sposta automaticamente i dati inattivi a $0.00099/GB/month, si ottiene un controllo significativo dei costi di archiviazione senza interventi manuali.
Funzionalità principali di Amazon S3
- Acquisizione in più formati: S3 accetta qualsiasi tipo di file—Parquet, ORC, Avro, JSON, CSV e formati non strutturati—tramite caricamenti batch, flussi continui attraverso Kinesis e MSK oppure attivatori basati su eventi che utilizzano S3 Event Notifications.
- Controllo degli accessi granulare con Lake Formation: Applica criteri di accesso ai dati a livello di tabella, colonna, riga e cella nell'intero lago di dati basato su S3 senza duplicare i dati.
- S3 Vectors: Un servizio nativo di archiviazione e interrogazione degli indici vettoriali integrato direttamente in S3, progettato per i carichi di lavoro di ricerca semantica e generazione aumentata dal recupero, con costi fino al 90% inferiori rispetto agli approcci tradizionali.
- S3 Inventory: Genera report pianificati sugli attributi degli oggetti, sulla classe di archiviazione, sullo stato della crittografia e sullo stato della replica nei bucket, per i flussi di lavoro di verifica e gestione.
Integrazioni di Amazon S3
Amazon S3 offre integrazioni native nell'ambiente AWS, tra cui AWS Glue, Amazon Athena, Amazon EMR, AWS Lake Formation, Amazon Kinesis, Amazon Redshift Spectrum e Amazon SageMaker. Si connette inoltre ad Apache Spark, Trino, Snowflake, Databricks, Tableau e Power BI tramite connettori e API documentati.
Pros and Cons
Pros:
- L'archiviazione di oggetti su scala exabyte supporta qualsiasi formato di dati
- Tabelle Iceberg ACID integrate con compattazione automatica
- 143 certificazioni di conformità e controllo degli accessi a livello di oggetto
Cons:
- I prezzi sono complessi e richiedono una gestione attenta
- La creazione di laghi di dati richiede l'assemblaggio di più servizi AWS
Learn more about Amazon S3: Ideale per laghi dati aziendali nativi Microsoft
- Credito di $200 per 30 giorni (nessun livello gratuito dedicato)
- A partire da $0.023/GB/mese
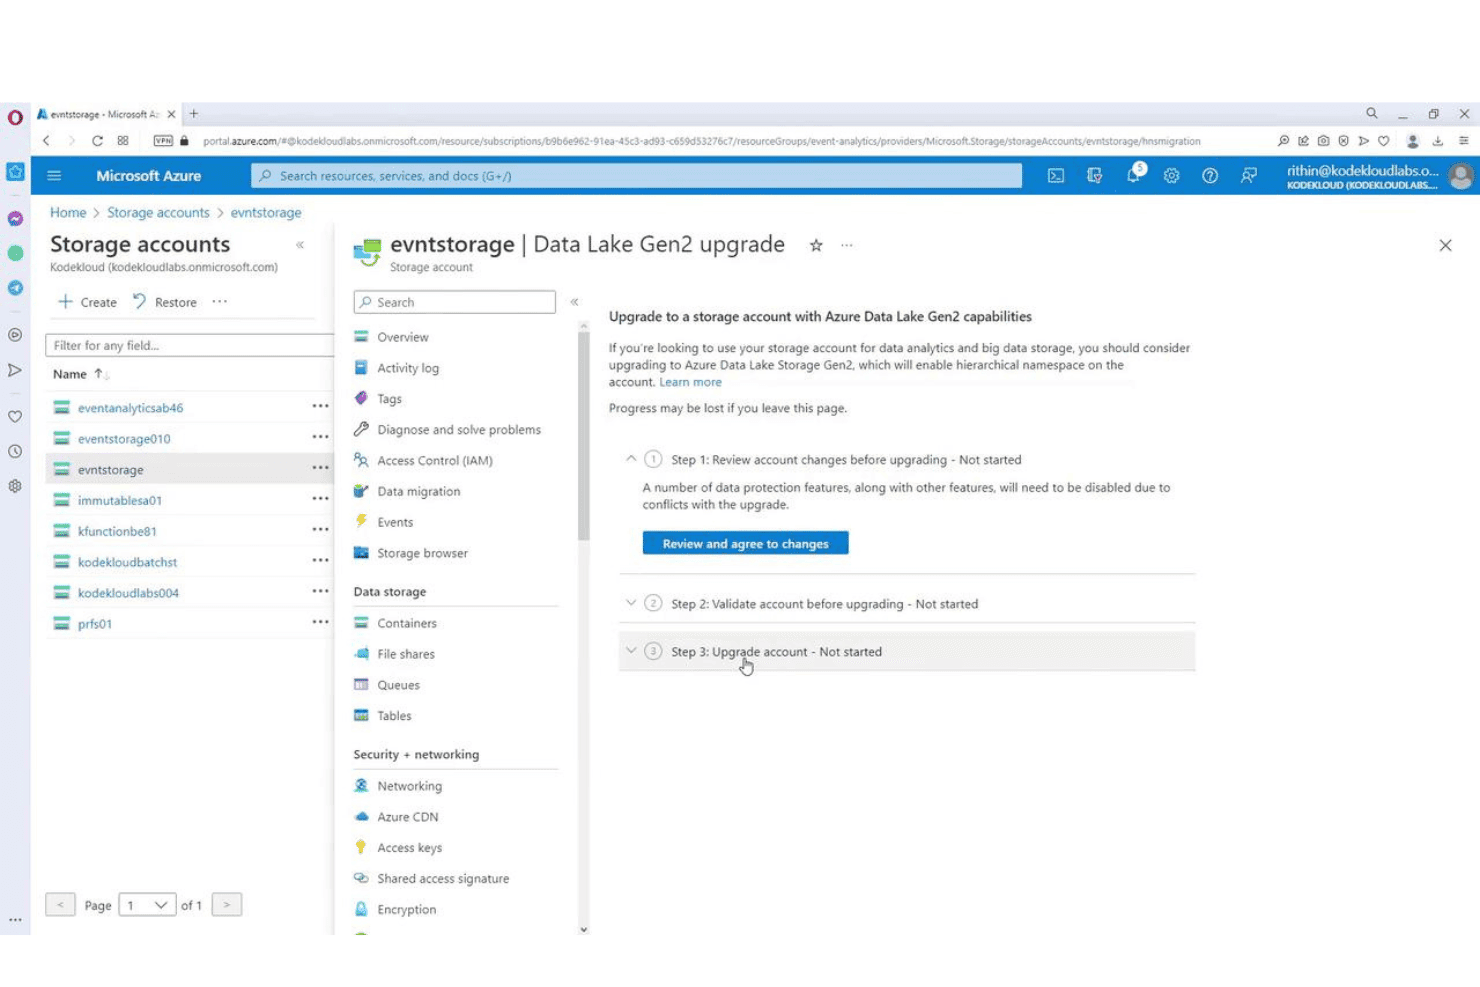
Azure Storage consente agli utenti di aggiornare gli account alle funzionalità di Data Lake Gen2. Azure Data Lake Storage Gen2 è il servizio di archiviazione di lago dati basato sul cloud di Microsoft, costruito su Azure Blob Storage con uno spazio dei nomi gerarchico, che supporta l'archiviazione su scala exabyte, l'acquisizione di dati in più formati, i controlli di accesso conformi a POSIX e l'integrazione nativa con l'ecosistema di analisi e apprendimento automatico di Azure.
Per chi è più adatto Azure Data Lake Storage?
Azure Data Lake Storage Gen2 è la scelta naturale per i team IT e dati aziendali che utilizzano già Microsoft Azure e hanno bisogno di un'archiviazione su scala exabyte strettamente integrata con Synapse, Databricks e Microsoft Fabric.
Perché ho scelto Azure Data Lake Storage
Ho scelto Azure Data Lake Storage Gen2 come una delle migliori soluzioni perché è la base di archiviazione nativa per l'intero stack di analisi Microsoft e questa stretta integrazione è importante su scala aziendale. Quando l'organizzazione utilizza Synapse, Databricks e Microsoft Fabric, ADLS Gen2 è già il livello sottostante a tutti questi servizi, il che significa che una singola copia dei dati può essere interrogata da ogni motore tramite il driver ABFS. Apprezzo in particolare gli elenchi di controllo degli accessi conformi a POSIX, che consentono di impostare autorizzazioni di lettura/scrittura/esecuzione a livello del singolo file e della singola directory, non solo del contenitore.
Funzionalità principali di Azure Data Lake Storage
- Suddivisione automatica in livelli in base al ciclo di vita: Imposta criteri che spostano automaticamente i dati tra i livelli di accesso frequente, sporadico, raro e archivio in base all'età o all'ultimo accesso, per gestire i costi di archiviazione su vasta scala.
- Compatibilità con il driver ABFS: Il driver Azure Blob File System consente ai carichi di lavoro basati su Hadoop, Spark, Hive e HDFS di accedere nativamente in lettura e scrittura ad ADLS Gen2 senza modifiche al codice.
- Collegamenti OneLake: Crea riferimenti dinamici a dati presenti in altri spazi di lavoro OneLake, in Amazon S3 o nei contenitori Azure Blob Storage senza copiare o spostare i dati sottostanti.
- Integrazione con l'archivio dati di Azure Machine Learning: Registra direttamente i contenitori ADLS Gen2 come archivi dati negli spazi di lavoro Azure ML, offrendo agli scienziati dei dati accesso diretto ai dati del lago dati per l'addestramento dei modelli e la sperimentazione.
Integrazioni di Azure Data Lake Storage
Azure Data Lake Storage offre integrazioni native nell'ecosistema Microsoft, tra cui Azure Data Factory, Azure Databricks, Azure Synapse Analytics, Microsoft Fabric, Microsoft Purview, Azure Machine Learning e Azure Event Hubs. Supporta inoltre Apache Spark e Kafka tramite connettori documentati, oltre ad ABFS e alle API per l'accesso personalizzato ai dati.
Pros and Cons
Pros:
- Integrazione nativa con gli strumenti di analisi Microsoft
- Lo spazio dei nomi gerarchico supporta un controllo granulare degli accessi
- Formati di tabella aperti tramite il livello di elaborazione
Cons:
- Richiede Purview per la catalogazione avanzata dei dati
- Disponibile solo su Microsoft Azure
Learn more about Azure Data Lake Storage:
Altri strumenti per data lake
Ecco alcune opzioni aggiuntive di strumenti per data lake che non sono entrate nella mia selezione, ma che vale comunque la pena prendere in considerazione:
- 11IBM watsonx.dataIdeale per lakehouse aperti con accesso ai dati dei mainframe
- 12Microsoft FabricIdeale per l'integrazione del data lake con lo stack Microsoft
- 13StarburstIdeale per SQL federato tra data lake multi-cloud
- 14Alibaba Cloud Hybrid CloudIdeale per le implementazioni di data lake cloud ibridi nell'area APAC
- 15Teradata VantageIdeale per carichi di lavoro AI/ML su dati di data lake su scala petabyte
- 16MinIOIdeale per l'IA e l'archiviazione locale in architettura lakehouse
How I Evaluate Data Lake Tools
When a pipeline needs to land petabytes of raw events reliably and make them queryable without locking your team into one vendor's schema, the platform underneath that decision matters enormously—so I split my evaluation into baseline capabilities every tool must cover and the differentiators that separate a good fit from the wrong one.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. I then calculate the tool's total score into a percentage, using 75% as a benchmark to help assess its overall fit for the list.
- Scalable Object Storage: I check whether the platform can handle petabyte-scale volumes and support tiered or cold storage options across cloud and on-prem environments.
- Schema-on-Read Support: The tool needs to let teams land raw data and apply structure at query time, with schema evolution and format-level versioning like Delta Lake or Iceberg.
- Multi-Format Data Ingestion: I look for broad format coverage (Parquet, Avro, JSON, ORC, CSV) plus both batch and real-time streaming ingestion with prebuilt connectors.
- Query Engine Integration: Each tool should integrate with engines like Spark, Trino, Presto, or Athena so analytics and ML teams can query lake data without extra middleware.
- Metadata and Catalog Management: I evaluate whether the platform offers a data catalog with search, lineage tracking, and tagging to keep lake assets discoverable as data volumes grow.
- Governance and Access Controls: Fine-grained permissions matter here—row- and column-level access, encryption, audit logging, and compliance certifications like HIPAA or SOC 2.
Once I have a list of tools that meet the criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
I check whether a platform supports open table formats like Delta Lake or Apache Iceberg, since ACID transactions and time travel on object storage turn a basic lake into a reliable lakehouse. Zero-copy data sharing matters just as much—when teams can share live datasets across business units or clouds without duplicating data, you cut storage costs and eliminate pipeline sprawl. I also evaluate auto-optimization capabilities like file compaction, partition pruning, and query cost governance, because at petabyte scale, performance and budgets fall apart without them.
Beyond Features
I evaluate each platform's deployment model first—whether it runs across AWS, Azure, GCP, and on-prem matters when your data residency requirements span multiple regions. Compliance posture is just as important; I check for SOC 2 Type II, HIPAA, and GDPR certifications, plus customer-managed encryption keys, since a missing certification can disqualify a tool before you even trial it. I also look at ecosystem depth, specifically native connectors to orchestrators like Airflow and BI tools like Tableau, because gaps there mean your team builds and maintains custom glue code indefinitely.
Come scegliere gli strumenti per data lake
Quali fattori incidono realmente sulla capacità di uno strumento per data lake di offrire la scalabilità, la governance e l'integrazione di cui il tuo team ha bisogno per i carichi di lavoro di analisi nel mondo reale?
| Se la tua priorità è... | Cerca... |
|---|---|
| Se la tua priorità è...Conformità normativa | Cerca...Registrazione degli audit integrata e criteri di accesso |
| Se la tua priorità è...Implementazione multi-cloud o ibrida | Cerca...Supporto nativo per più provider cloud |
| Se la tua priorità è...Indipendenza dal fornitore | Cerca...Compatibilità con formati di tabella aperti |
| Se la tua priorità è...Prestazioni di analisi su larga scala | Cerca...Archiviazione a livelli e integrazione nativa delle query |
| Se la tua priorità è...Preparazione per IA e apprendimento automatico | Cerca...Connettori diretti a strumenti e motori di IA/apprendimento automatico |
Come valutare la tua selezione
- Conferma le funzionalità di governance: chiedi schermate della console di amministrazione che mostrino il controllo degli accessi basato sui ruoli e la configurazione dei registri di audit.
- Testa il supporto dei formati aperti: esegui un'importazione dal vivo di file Parquet o Iceberg e verifica l'evoluzione dello schema in un ambiente di prova.
- Convalida le dichiarazioni sul multi-cloud: chiedi documentazione pubblica che mostri i passaggi di implementazione su almeno due provider cloud.
- Verifica l'integrazione con gli strumenti di analisi: chiedi un esempio di flusso di lavoro o una configurazione per Spark, Trino o Presto, con risultati delle query documentati.
- Compromesso: suite aziendale o lakehouse aperto: decidi se hai bisogno della conformità e del supporto immediati di una suite completa o se, per la tua architettura, sono più importanti la flessibilità e la compatibilità con uno stack aperto.
Cosa sono gli strumenti per data lake?
Gli strumenti per data lake sono piattaforme e software che aiutano ad archiviare, gestire e analizzare grandi volumi di dati strutturati e non strutturati in un repository centralizzato. Questi strumenti consentono al tuo team di acquisire dati grezzi, applicare lo schema quando necessario e organizzare le risorse per progetti di analisi o IA. Puoi aspettarti funzionalità che supportano la governance, la scalabilità e l'integrazione con i più diffusi motori di query e le piattaforme di analisi.
Funzionalità degli strumenti per i data lake
Quando selezioni gli strumenti per i data lake, presta attenzione alle seguenti funzionalità chiave:
- Archiviazione di oggetti scalabile: consente di archiviare e gestire petabyte di dati strutturati e non strutturati, con opzioni per l'archiviazione a più livelli o a freddo, così da controllare i costi man mano che aumentano le esigenze di archiviazione.
- Supporto dello schema alla lettura: consente di caricare prima i dati grezzi e applicare in seguito uno schema al momento dell'esecuzione della query, semplificando la gestione di set di dati diversificati e in continua evoluzione senza doverli ricaricare.
- Acquisizione di dati in più formati: supporta l'importazione di dati in vari formati come Parquet, Avro, JSON, ORC e CSV, e accoglie sia origini di dati in batch sia in streaming, offrendo maggiore flessibilità nella modalità di arrivo dei dati.
- Integrazione con i motori di query: offre compatibilità con motori come Spark, Trino, Presto o Athena, permettendo di eseguire direttamente sul data lake i carichi di lavoro di analisi e reporting senza middleware aggiuntivo.
- Gestione dei metadati e dei cataloghi: include strumenti per la catalogazione dei dati, la ricerca degli asset, il monitoraggio della derivazione e l'assegnazione di tag, aiutandoti a mantenere i dati organizzati e facilmente reperibili man mano che vengono aggiunti nuovi set di dati.
- Governance e controlli degli accessi: offre autorizzazioni granulari, crittografia e registri di controllo, consentendoti di controllare chi accede a quali dati, monitorare l'utilizzo e rispettare i requisiti normativi.
- Versionamento dei dati e viaggio nel tempo: consente di monitorare le modifiche, ripristinare versioni precedenti dei set di dati e mantenere viste storiche, aspetti preziosi per il controllo, il ripristino e la riproducibilità.
- Integrazione con gli strumenti di orchestrazione: si connette nativamente con orchestratori dei flussi di lavoro come Apache Airflow, consentendo di automatizzare le pipeline di dati e coordinare le attività tra i sistemi.
- Strumenti di monitoraggio e gestione dei costi: fornisce dashboard e avvisi per l'utilizzo dello spazio di archiviazione, i modelli di accesso e i costi, così da mantenere l'ambiente efficiente e rispettoso del budget.
- Supporto per i formati di tabelle aperti: supporta formati come Delta Lake o Apache Iceberg, abilitando funzionalità avanzate come le transazioni ACID e l'interoperabilità con diversi strumenti di analisi.
Funzionalità comuni degli strumenti per i data lake basate sull'IA
Oltre alle funzionalità standard degli strumenti per i data lake elencate sopra, molte di queste soluzioni stanno integrando l'IA con funzionalità come:
- Classificazione automatizzata dei dati: utilizza modelli di IA per analizzare e categorizzare i dati in arrivo in base al contenuto, alla sensibilità o ai requisiti di conformità. Questo aiuta il tuo team a organizzare gli asset più rapidamente e ad applicare i corretti controlli degli accessi senza dover assegnare tag manualmente.
- Rilevamento delle anomalie per la qualità dei dati: applica algoritmi di apprendimento automatico per monitorare i flussi di dati e segnalare modelli insoliti, valori mancanti o valori anomali. Ciò consente di individuare tempestivamente i problemi di integrità dei dati e ridurre il rischio di analisi errate o errori nei sistemi a valle.
- Ottimizzazione predittiva dei carichi di lavoro: sfrutta l'IA per analizzare i modelli storici delle query e l'utilizzo dello spazio di archiviazione, quindi consiglia o applica automaticamente ottimizzazioni come il partizionamento, la memorizzazione nella cache o il ridimensionamento delle risorse. Questo ti aiuta a mantenere le prestazioni e controllare i costi con la crescita dell'utilizzo.
- Interfacce per query in linguaggio naturale: integra strumenti di chat o ricerca basati sull'IA che consentono agli utenti di porre domande sui dati usando un linguaggio semplice. Questo riduce la barriera per gli utenti non tecnici che desiderano esplorare i set di dati e generare informazioni utili senza scrivere SQL o codice.
- Arricchimento automatizzato dei metadati: utilizza l'IA per estrarre contesto, relazioni e termini aziendali dai dati grezzi, quindi popola il catalogo dei dati con descrizioni più ricche e informazioni sulla derivazione. Questo semplifica per i team l'individuazione, la verifica dell'affidabilità e il riutilizzo degli asset di dati.
Vantaggi degli strumenti per i data lake
L'implementazione di strumenti per i data lake offre diversi vantaggi al tuo team e alla tua azienda. Eccone alcuni che puoi aspettarti:
- Gestione centralizzata dei dati: Gli strumenti per data lake consentono di archiviare dati strutturati e non strutturati in un unico luogo, semplificando l'organizzazione delle risorse e supportando i progetti di analisi o di intelligenza artificiale.
- Scalabilità per carichi di lavoro su scala petabyte: Queste piattaforme possono gestire enormi volumi di dati e supportare livelli di archiviazione sia cloud sia locali, consentendo di adattarsi alle esigenze in crescita senza dover riprogettare l'architettura.
- Acquisizione flessibile dei dati: È possibile acquisire dati da un'ampia gamma di formati e fonti e gestire flussi sia in batch sia in tempo reale, grazie ai connettori integrati e al supporto dei formati.
- Governance granulare e controllo degli accessi: Le autorizzazioni granulari, la crittografia e la registrazione degli audit aiutano a mantenere la sicurezza e la conformità a standard come HIPAA, SOC 2 e GDPR.
- Integrazione con strumenti di analisi e intelligenza artificiale: La compatibilità nativa con motori di interrogazione come Spark, Trino e Presto, oltre ai connettori diretti per gli strumenti di intelligenza artificiale e apprendimento automatico, consente di analizzare i dati senza ritardi o ulteriore lavoro di integrazione.
- Gestione automatizzata dei metadati e della qualità dei dati: Molte piattaforme includono cataloghi, tracciamento della provenienza e strumenti basati sull'intelligenza artificiale che aiutano ad arricchire i metadati, classificare i dati e rilevare anomalie per mantenere l'integrità dei dati.
- Supporto per formati di tabelle aperti e casi d'uso avanzati: Funzionalità come la compatibilità con Delta Lake o Apache Iceberg consentono transazioni ACID, versionamento dei dati e condivisione dei dati senza copia, per supportare analisi più avanzate e architetture multi-cloud.
Costi e prezzi degli strumenti per data lake
La scelta degli strumenti per data lake richiede la comprensione dei vari modelli e piani tariffari disponibili. I costi variano in base alle funzionalità, alle dimensioni del team, ai componenti aggiuntivi e ad altri fattori. La tabella seguente riepiloga i piani più comuni, i relativi prezzi medi e le funzionalità generalmente incluse nelle soluzioni di strumenti per data lake:
Tabella comparativa dei piani per gli strumenti per data lake
| Tipo di piano | Prezzo medio | Funzionalità comuni |
|---|---|---|
| Tipo di pianoPiano gratuito | Prezzo medio$0 | Funzionalità comuniArchiviazione di oggetti di base, acquisizione limitata dei dati, supporto allo schema in lettura e integrazione con un motore di interrogazione. |
| Tipo di pianoPiano personale | Prezzo medio$50–$300/mese | Funzionalità comuniLimiti di archiviazione maggiori, supporto per più formati di dati, catalogazione di base e integrazione con strumenti di analisi. |
| Tipo di pianoPiano aziendale | Prezzo medio$1,000–$5,000/mese | Funzionalità comuniArchiviazione su scala petabyte, controlli di governance avanzati, opzioni multi-cloud e funzionalità di catalogazione dei dati. |
| Tipo di pianoPiano enterprise | Prezzo medio$10,000+/mese | Funzionalità comuniArchiviazione illimitata, funzionalità complete di conformità, automazione basata sull'intelligenza artificiale, integrazione con strumenti di orchestrazione e supporto premium. |
Domande frequenti sugli strumenti per data lake
Ecco alcune risposte alle domande più comuni sugli strumenti per data lake:
In che modo gli strumenti per data lake gestiscono i requisiti di sicurezza e conformità?
Gli strumenti per data lake applicano misure di sicurezza tramite controlli degli accessi, crittografia e registrazione degli audit. La maggior parte delle piattaforme leader supporta autorizzazioni granulari fino al livello di riga o colonna, oltre alle integrazioni con SSO e i provider di identità. Per la conformità, cerca certificazioni dei fornitori come SOC 2, HIPAA o GDPR e opzioni per chiavi di crittografia gestite dal cliente. Queste funzionalità aiutano a soddisfare i requisiti normativi senza dover creare livelli aggiuntivi.
Gli strumenti per data lake possono integrarsi con le piattaforme di analisi o BI esistenti?
Sì, la maggior parte degli strumenti per data lake offre connettori diretti per le piattaforme di analisi e BI. Dovresti aspettarti il supporto immediato per Spark, Trino, Presto e Athena, oltre alle integrazioni con Tableau e Power BI. Se i tuoi team utilizzano strumenti specializzati, verifica la disponibilità di API aperte o driver ODBC/JDBC che consentano di collegare flussi di lavoro personalizzati.
Qual è la differenza tra gli strumenti per data lake e i data warehouse?
Gli strumenti per data lake si concentrano sull’archiviazione di dati grezzi, semistrutturati e non strutturati utilizzando lo schema alla lettura, mentre i data warehouse archiviano dati strutturati con schemi predefiniti (schema alla scrittura). I data lake sono più adatti all’acquisizione flessibile dei dati e ai carichi di lavoro di AI/ML, mentre i data warehouse sono indicati per analisi curate con prestazioni di query ottimizzate. Alcuni fornitori offrono oggi architetture lakehouse che combinano entrambi gli approcci.
Gli strumenti per data lake supportano più formati di dati e tipi di acquisizione?
Sì, la maggior parte degli strumenti per data lake accetta un’ampia gamma di formati, come Parquet, Avro, JSON, ORC e CSV. Troverai inoltre il supporto sia per le origini dati batch sia per quelle in streaming, rendendo possibile gestire qualsiasi situazione, dai processi di acquisizione giornalieri ai flussi di eventi in tempo reale, utilizzando connettori predefiniti o personalizzati.
Come si valutano gli strumenti per data lake in termini di scalabilità?
Esamino le opzioni di archiviazione a oggetti di ciascuna piattaforma, le prestazioni con carichi su scala petabyte e il supporto per il multicloud. La possibilità di organizzare l’archiviazione su più livelli, elaborare i dati tra regioni ed evitare colli di bottiglia con formati come Delta Lake o Iceberg è fondamentale. Assicurati di verificare i benchmark documentati e di raccogliere referenze da clienti con volumi di dati simili ai tuoi.
I formati di tabella aperti come Delta Lake o Apache Iceberg sono importanti?
Sì, i formati di tabella aperti sono importanti se vuoi transazioni ACID, gestione delle versioni e gestione dei dati indipendente dal fornitore. Consentono di abilitare funzionalità come il viaggio nel tempo e la condivisione dei dati senza copia. Se punti a un modello lakehouse o vuoi rendere la tua architettura a prova di futuro, assicurati che il tuo strumento per data lake sia compatibile con i formati aperti.