

En tant que professionnel expérimenté travaillant avec des API, des microservices et toute une gamme de technologies full stack, je reconnais le rôle essentiel d'une surveillance efficace des performances. Au fil des années, j'ai pu constater directement les avantages de l'utilisation de plateformes AIOps complètes, telles que ces alternatives à Dynatrace, qui offrent des capacités rapides de résolution des problèmes et d'analyse des causes profondes.
Ces substituts à Dynatrace sont non seulement faciles à utiliser, mais impressionnent également par leurs fonctionnalités de surveillance robustes. L'intégration transparente avec des plateformes populaires telles que Slack contribue à améliorer la communication entre les équipes dans les situations critiques. Grâce au profilage étendu et aux solutions modulaires à votre disposition, vous bénéficiez d'une plateforme de surveillance puissante capable d'améliorer votre pile technologique et votre productivité globale.
Qu'est-ce que Dynatrace ?
Dynatrace est une plateforme de surveillance des performances des applications (APM) qui vous aide à suivre, analyser et optimiser le fonctionnement de vos applications et de votre infrastructure. Elle est utilisée par les équipes DevOps, les SRE et les responsables informatiques qui doivent détecter rapidement les problèmes et améliorer l'expérience utilisateur. La surveillance en temps réel, les alertes alimentées par l'IA et le traçage de bout en bout permettent de repérer les ralentissements, d'identifier les causes profondes et de maintenir le bon fonctionnement des systèmes. Globalement, Dynatrace aide votre équipe à anticiper les problèmes de performances avant qu'ils n'affectent les utilisateurs.
Pourquoi faire confiance à nos recommandations de logiciels
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Notre équipe teste et évalue des logiciels depuis 2012. En tant que leaders technologiques nous-mêmes, nous savons à quel point il est difficile — et important — de choisir le bon logiciel.
Pour ce guide, nous avons évalué les outils grâce à des tests pratiques et une recherche indépendante, en notant les outils selon nos critères de sélection.
Nos avis reflètent notre jugement éditorial humain, et non un argumentaire de vente.
Réviseurs experts:
- Paulo Gardini MiguelDirecteur technique
 Tim FisherVP de l'IA
 Gabriel RosasTech Lead et architecte logiciel
 Christhian GruhnTech Lead et architecte plateforme

Résumé des meilleures alternatives à Dynatrace
Ce tableau comparatif résume les détails tarifaires de ma sélection des meilleures alternatives à Dynatrace afin de vous aider à trouver celle qui correspond le mieux à votre budget et aux besoins de votre entreprise.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Idéal pour la résolution des erreurs en temps réel | Formule gratuite disponible | À partir de $26/mois (facturé annuellement) | Website | |
| 2 | Le meilleur pour une prise en charge étendue des technologies | Forfait gratuit disponible | À partir de $32.92/mois (facturé annuellement) | Website | |
| 3 | Idéal pour les environnements applicatifs diversifiés | Essai gratuit de 30 jours | À partir de $10/mois | Website | |
| 4 | Meilleur choix pour une surveillance complète de l’infrastructure informatique | Essai gratuit de 30 jours | À partir de $2,595 en paiement unique | Website | |
| 5 | Meilleur pour le suivi unifié des services cloud | Non | À partir de $15/mois (facturé annuellement) | Website | |
| 6 | Idéal pour la supervision open source de niveau entreprise | Non | Gratuit | Website | |
| 7 | Idéal pour une visibilité en temps réel des performances commerciales | Non | À partir de $6/vCPU/mois (facturé annuellement) | Website | |
| 8 | Idéal pour interroger la télémétrie dans un magasin de données unifié | Non | $12/utilisateur/mois (facturé annuellement) | Website | |
| 9 | Idéal pour la gestion des journaux et l’analyse de sécurité | Non | $108 par utilisateur et par mois (facturé annuellement) | Website | |
| 10 | Idéal pour l’analyse et les informations issues de données à grande échelle | Non | $150/user/month | Website |


Avis sur les meilleures alternatives à Dynatrace
Vous trouverez ci-dessous mes résumés détaillés des meilleures alternatives à Dynatrace qui figurent dans ma sélection. Mes avis présentent en détail les principales fonctionnalités, les avantages & inconvénients, les intégrations et les cas d’utilisation idéaux de chaque outil afin de vous aider à trouver celui qui vous convient le mieux.
 Idéal pour la résolution des erreurs en temps réel
- Formule gratuite disponible
- À partir de $26/mois (facturé annuellement)
Visit WebsiteCustomer Rating:4.5/5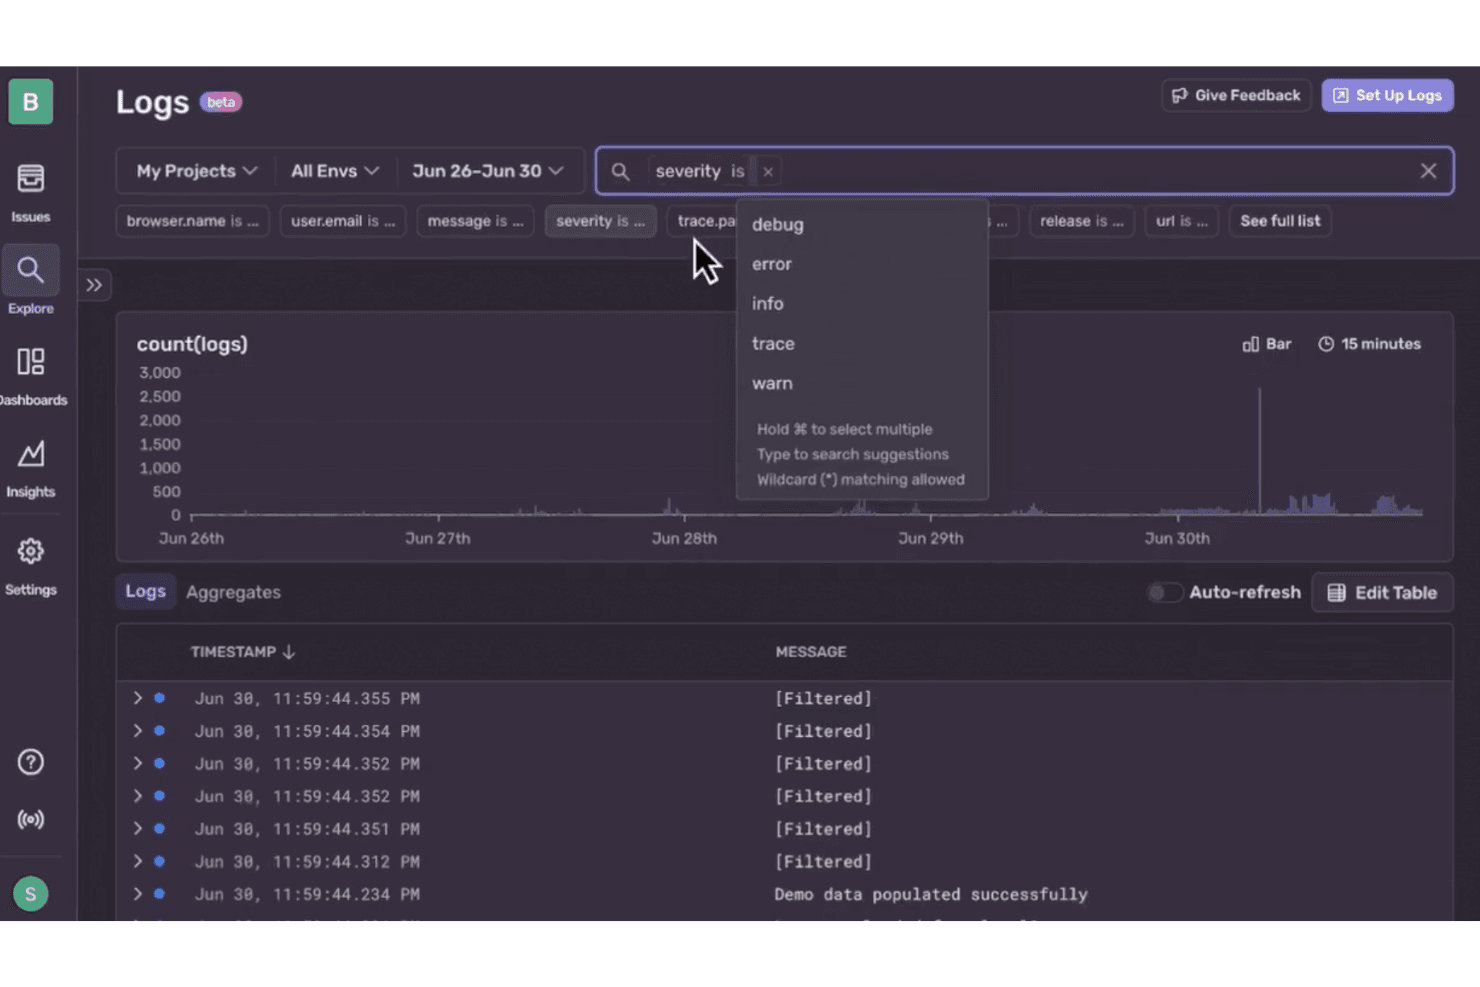
Sentry permet aux utilisateurs de filtrer les journaux par niveaux de gravité tels que débogage, erreur ou avertissement. Sentry associe la surveillance des performances des applications au suivi des erreurs, offrant aux équipes logicielles une alternative axée sur les développeurs à Dynatrace pour diagnostiquer les problèmes dans les applications et les services.
À qui Sentry convient-il le mieux ?
Sentry convient bien aux équipes d’ingénierie logicielle et de DevOps qui doivent identifier et résoudre les erreurs de production en temps réel.
Pourquoi j’ai choisi Sentry
J’ai choisi Sentry comme solution « idéale pour la résolution des erreurs en temps réel » parce qu’il relie les erreurs de production aux traces de pile et aux données de traçage, aidant ainsi les développeurs à localiser les chemins de code défaillants. Le suivi de la santé des versions et des régressions peut également révéler lorsqu’un déploiement introduit de nouveaux problèmes, afin que les équipes puissent prioriser les correctifs tout en surveillant les performances des applications.
Fonctionnalités clés de Sentry
- Profilage continu : affichez les profils CPU au niveau des fonctions pour les applications prises en charge.
- Indicateurs essentiels du Web : suivez les métriques du navigateur telles que le chargement des pages et la réactivité lors des interactions.
- Surveillance des requêtes de base de données : examinez la durée des requêtes et identifiez les opérations lentes sur la base de données.
- Instrumentation personnalisée : ajoutez des mesures pour surveiller les opérations propres à l’application.
Intégrations de Sentry
Sentry propose des intégrations avec GitHub, GitLab, Jira, Slack, Microsoft Teams, PagerDuty, Azure DevOps, Bitbucket, Vercel et Opsgenie. Sa plateforme d’intégration et son API REST prennent en charge les intégrations personnalisées.
Pros and Cons
Pros:
- Les traces de pile accélèrent le débogage en production
- Met les erreurs en corrélation avec les traces et les profils
- Le suivi des versions signale les régressions liées aux déploiements
Cons:
- Aucune surveillance des hôtes ou de l’infrastructure
- Le regroupement des problèmes et les alertes peuvent générer du bruit
Learn more about Sentry: Le meilleur pour une prise en charge étendue des technologies
- Forfait gratuit disponible
- À partir de $32.92/mois (facturé annuellement)
Visit WebsiteCustomer Rating:4.3/5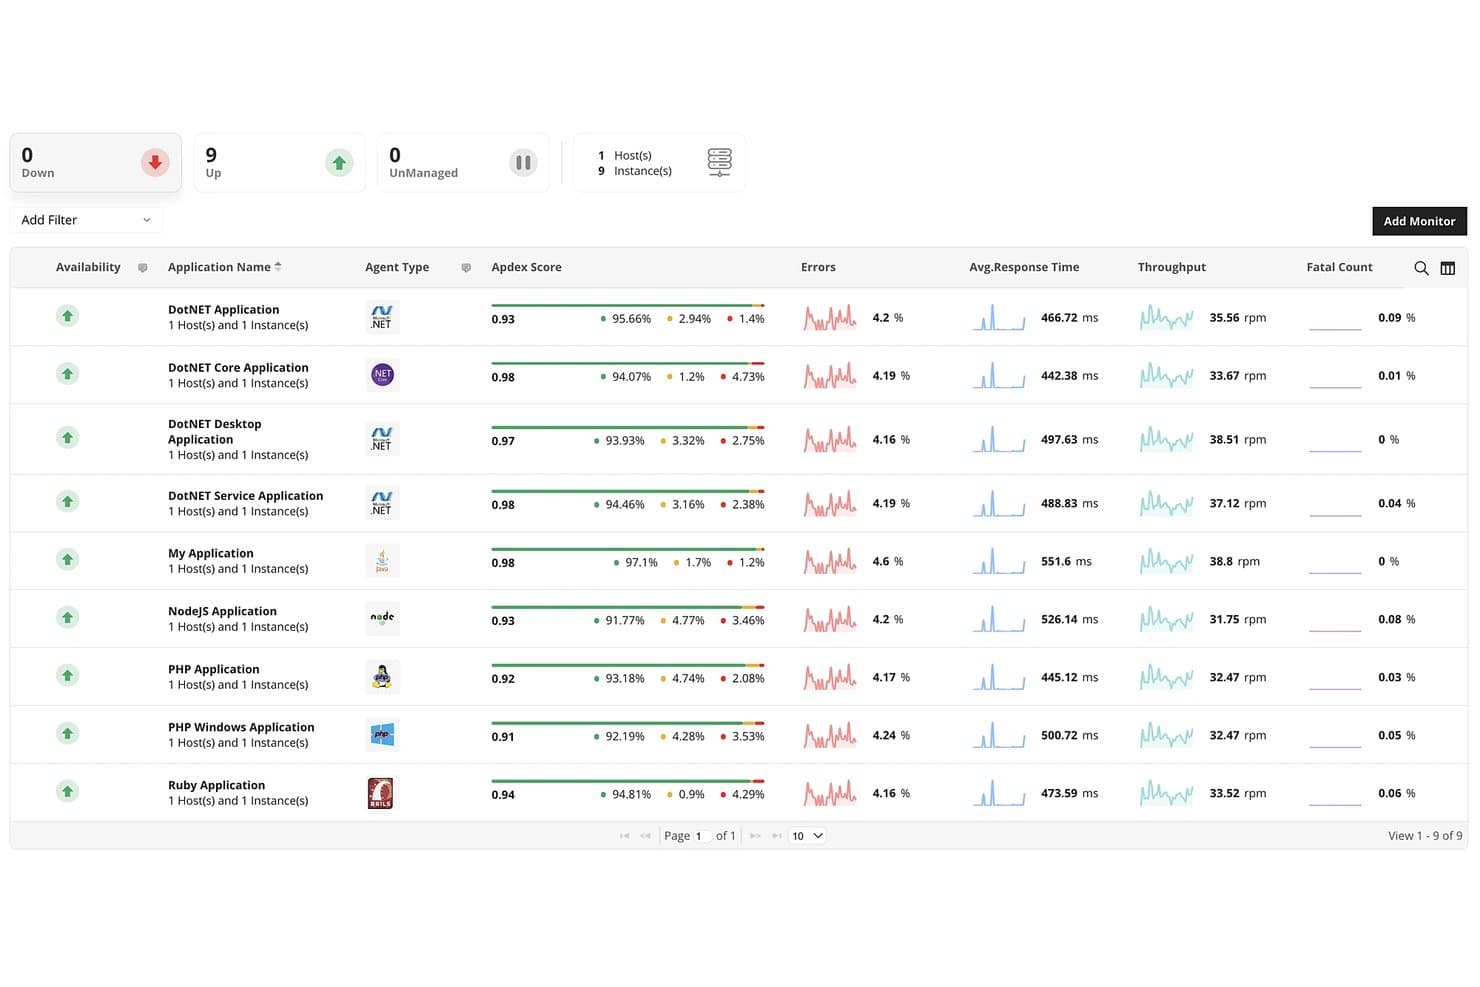
ManageEngine Applications Manager suit les indicateurs de performance des applications sur plusieurs instances. ManageEngine Applications Manager est une plateforme de surveillance des performances des applications destinée aux équipes informatiques qui doivent suivre les ralentissements et les pannes dans les applications, les serveurs, les bases de données et les services en nuage.
À qui ManageEngine Applications Manager convient-il le mieux ?
Aux équipes chargées des opérations informatiques qui supervisent des environnements applicatifs et d’infrastructure variés sur des systèmes sur site et en nuage.
Pourquoi j’ai choisi ManageEngine Applications Manager
J’ai choisi ManageEngine Applications Manager, « le meilleur pour une prise en charge étendue des technologies », car il surveille les applications ainsi que les serveurs, les bases de données et les services en nuage. J’apprécie cette couverture pour suivre une requête lente à travers les différents niveaux applicatifs et d’infrastructure, puis utiliser les diagnostics des transactions afin de repérer où la latence s’accumule.
Fonctionnalités clés de ManageEngine Applications Manager
- Détection des anomalies : Comparez les indicateurs de performance aux références historiques ou à des règles personnalisées.
- Gestion des journaux : Recherchez, filtrez et analysez les journaux des applications et des serveurs en temps réel.
- Surveillance des utilisateurs réels : Suivez les consultations de pages, les clics, la durée des sessions et les scores Apdex à partir du trafic réel.
- Prévision de la capacité : Consultez les rapports de tendance et les prévisions basées sur l’apprentissage automatique afin de planifier les besoins en ressources.
Intégrations de ManageEngine Applications Manager
ManageEngine Applications Manager documente des intégrations avec ManageEngine ServiceDesk Plus, ManageEngine OpManager, Slack et ServiceNow, ainsi qu’avec des plateformes SIEM compatibles avec Syslog telles que Splunk, Microsoft Sentinel et ManageEngine Log360. Il fournit également des API REST pour connecter des portails internes et des systèmes tiers.
Pros and Cons
Pros:
- Surveille les applications, les bases de données, les serveurs et les environnements en nuage
- Les alertes en temps réel favorisent un dépannage proactif
- Large couverture des environnements existants et hybrides
Cons:
- Le réglage avancé des seuils demande du temps de configuration
- Moins de profondeur pour le suivi des applications natives du nuage
Learn more about ManageEngine Applications Manager: Idéal pour les environnements applicatifs diversifiés
- Essai gratuit de 30 jours
- À partir de $10/mois
Visit WebsiteCustomer Rating:4.7/5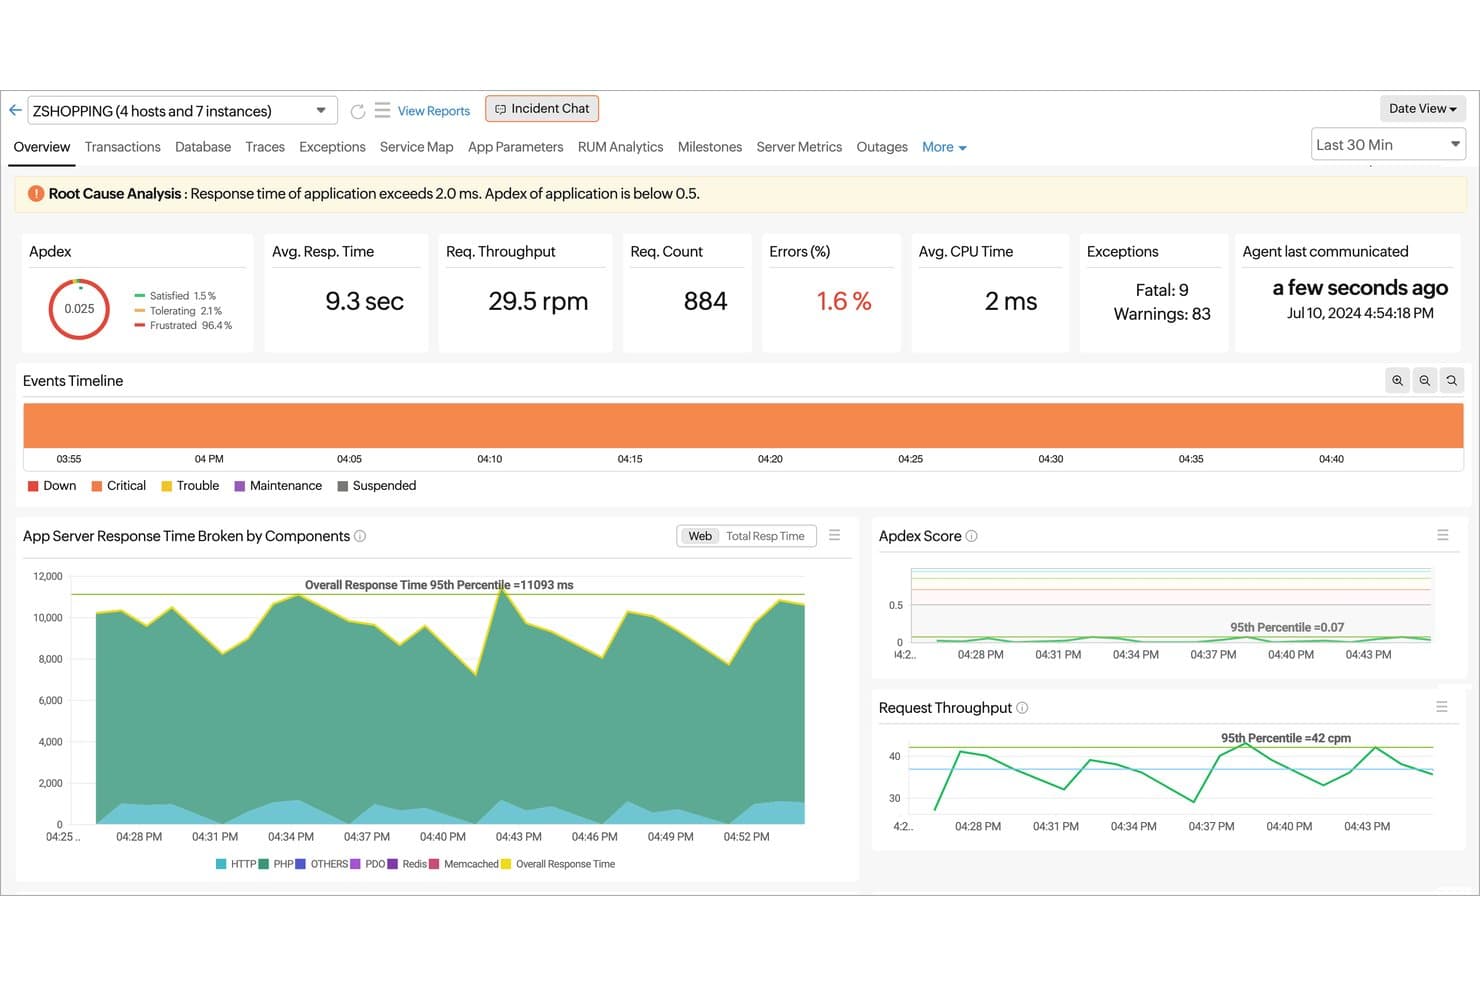
Site24x7 présente l’analyse des causes profondes et les métriques APM dans une seule vue. Site24x7 est une plateforme d’observabilité et de surveillance informatique destinée aux équipes qui évaluent des alternatives à Dynatrace, et qui aide les spécialistes informatiques à suivre les performances des applications et de l’infrastructure, à diagnostiquer les problèmes de service et à surveiller les environnements hybrides.
À qui Site24x7 convient-il le mieux ?
Site24x7 convient aux équipes informatiques qui surveillent des applications et des infrastructures dans des environnements diversifiés et hybrides.
Pourquoi j’ai choisi Site24x7
J’ai choisi Site24x7 pour le cas d’utilisation « Idéal pour les environnements applicatifs diversifiés », car son APM prend en charge Java, .NET, PHP, Ruby, Node.js et Python. J’apprécie la manière dont le traçage distribué et les diagnostics au niveau du code m’aident à suivre les transactions lentes entre les services, tandis que la prise en charge d’OpenTelemetry s’adapte aux environnements instrumentés.
Fonctionnalités clés de Site24x7
- Surveillance des serveurs : suit les métriques du processeur, de la mémoire, des disques et du réseau sur les serveurs physiques, virtuels et en nuage.
- Surveillance du réseau : mesure l’état des appareils, la bande passante, la latence et le trafic sur les routeurs, les commutateurs et les pare-feu.
- Gestion des journaux : collecte et recherche les journaux provenant des applications, des systèmes et des sources en nuage.
- Surveillance des sites web : vérifie la disponibilité des sites web depuis plus de 130 emplacements dans le monde.
Intégrations de Site24x7
Site24x7 prend en charge les intégrations avec ServiceNow, PagerDuty, Jira, Slack, Microsoft Teams, Opsgenie, Amazon EventBridge et Zapier. Il fournit également des API REST pour les intégrations personnalisées.
Pros and Cons
Pros:
- Surveille les applications dans des environnements hybrides diversifiés
- Suit les transactions entre les langages applicatifs pris en charge
- Vérifie la disponibilité des sites web depuis plus de 130 emplacements
Cons:
- Le réglage des alertes peut générer des faux positifs
- Les tableaux de bord semblent encombrés et offrent peu de possibilités de personnalisation
Learn more about Site24x7: Meilleur choix pour une surveillance complète de l’infrastructure informatique
- Essai gratuit de 30 jours
- À partir de $2,595 en paiement unique
Visit WebsiteCustomer Rating:4.6/5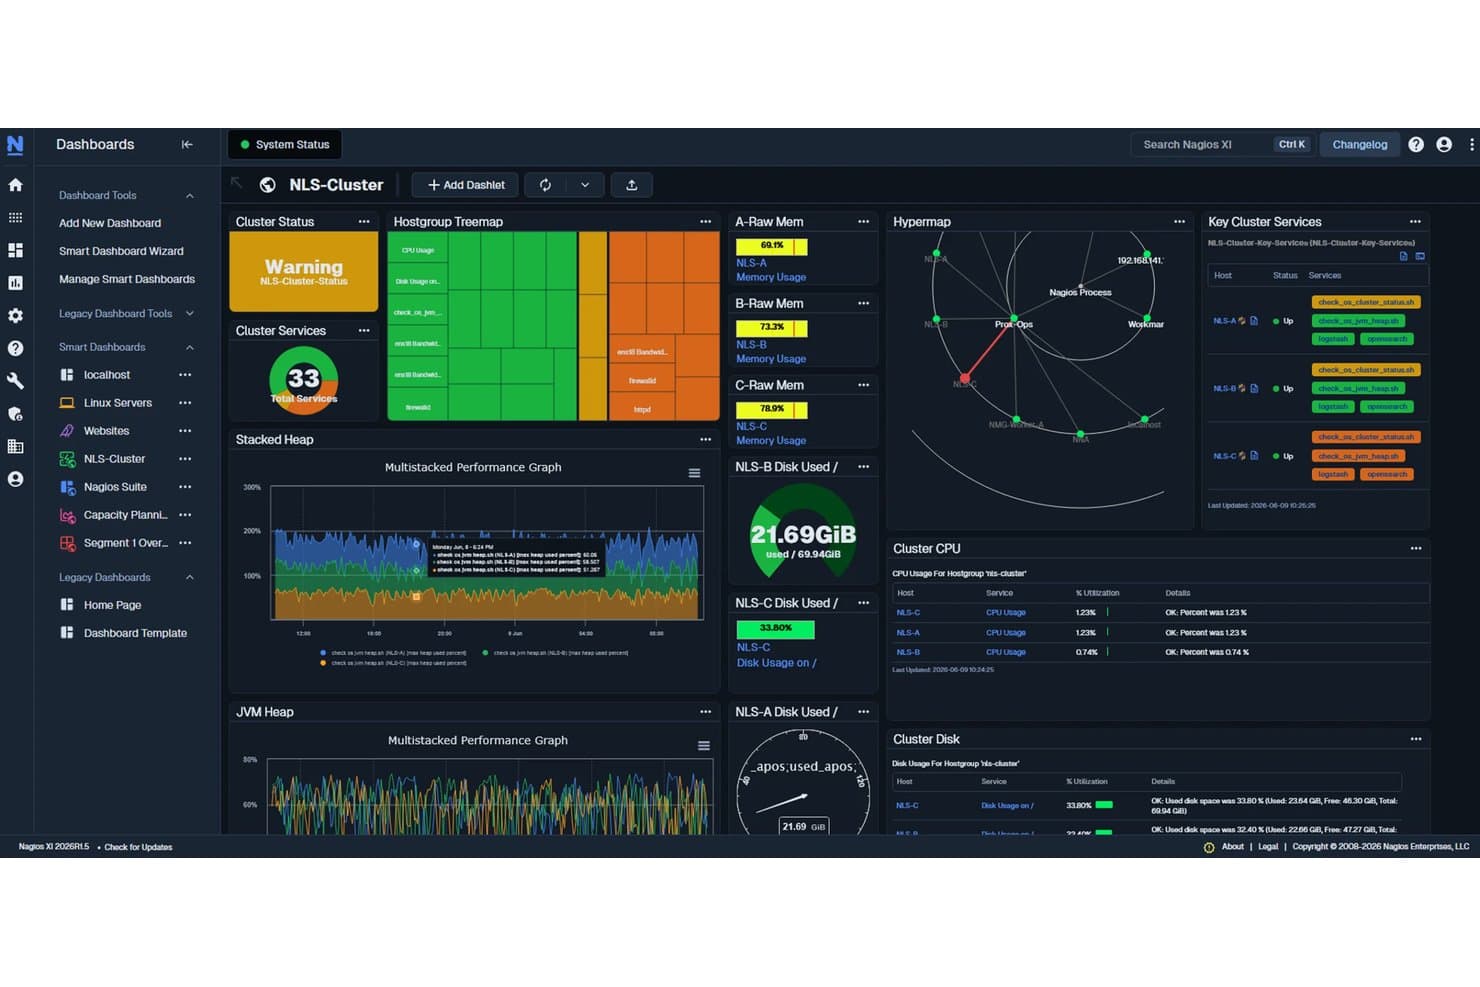
Nagios XI centralise l’état du cluster ainsi que la surveillance du processeur, des disques et des services dans un seul tableau de bord. Nagios offre aux équipes informatiques une surveillance configurable des hôtes et des services afin de détecter les pannes sur les serveurs, les appareils réseau et les applications dans des environnements d’infrastructure variés.
À qui Nagios convient-il le mieux ?
Nagios convient aux équipes chargées de l’infrastructure et des opérations qui ont besoin d’une surveillance configurable dans des environnements mixtes, notamment des systèmes existants et des équipements réseau.
Pourquoi j’ai choisi Nagios
J’ai choisi Nagios pour un guide des alternatives à Dynatrace, car il correspond à la catégorie « Meilleur choix pour une surveillance complète de l’infrastructure informatique » grâce à ses contrôles des hôtes et des services fondés sur des plug-ins. J’utilise des contrôles SNMP pour surveiller les commutateurs et les routeurs en parallèle de l’état des serveurs, puis je configure des alertes lorsque les contrôles échouent. Cela me permet de suivre une infrastructure mixte dans un seul système de surveillance.
Principales fonctionnalités de Nagios
- Détection automatique : détecte les appareils et les services sur votre réseau.
- Assistants de configuration : guident la configuration des appareils et applications courants.
- Tableaux de bord : affichent des récapitulatifs d’état, des cartes et des graphiques dans des vues personnalisables.
- Graphiques de performance : représentent les données de surveillance au fil du temps.
Intégrations de Nagios
Nagios XI dispose d’intégrations documentées avec Slack et PagerDuty pour les notifications d’alerte et la gestion des incidents, configurées au moyen de scripts et de paramètres de notification. Son API REST prend en charge les connexions personnalisées avec des outils tels que les systèmes de gestion de configuration (CMDB) et de billetterie.
Pros and Cons
Pros:
- Surveille des hôtes mixtes au moyen de contrôles personnalisés
- Des alertes fiables avec des seuils configurables
- Les tableaux de bord affichent l’état et les tendances historiques
Cons:
- La configuration initiale nécessite une expertise de la surveillance Linux
- Les plug-ins externes peuvent être obsolètes ou dépourvus de documentation
Learn more about Nagios: Meilleur pour le suivi unifié des services cloud
- Non
- À partir de $15/mois (facturé annuellement)
Visit WebsiteCustomer Rating:4.5/5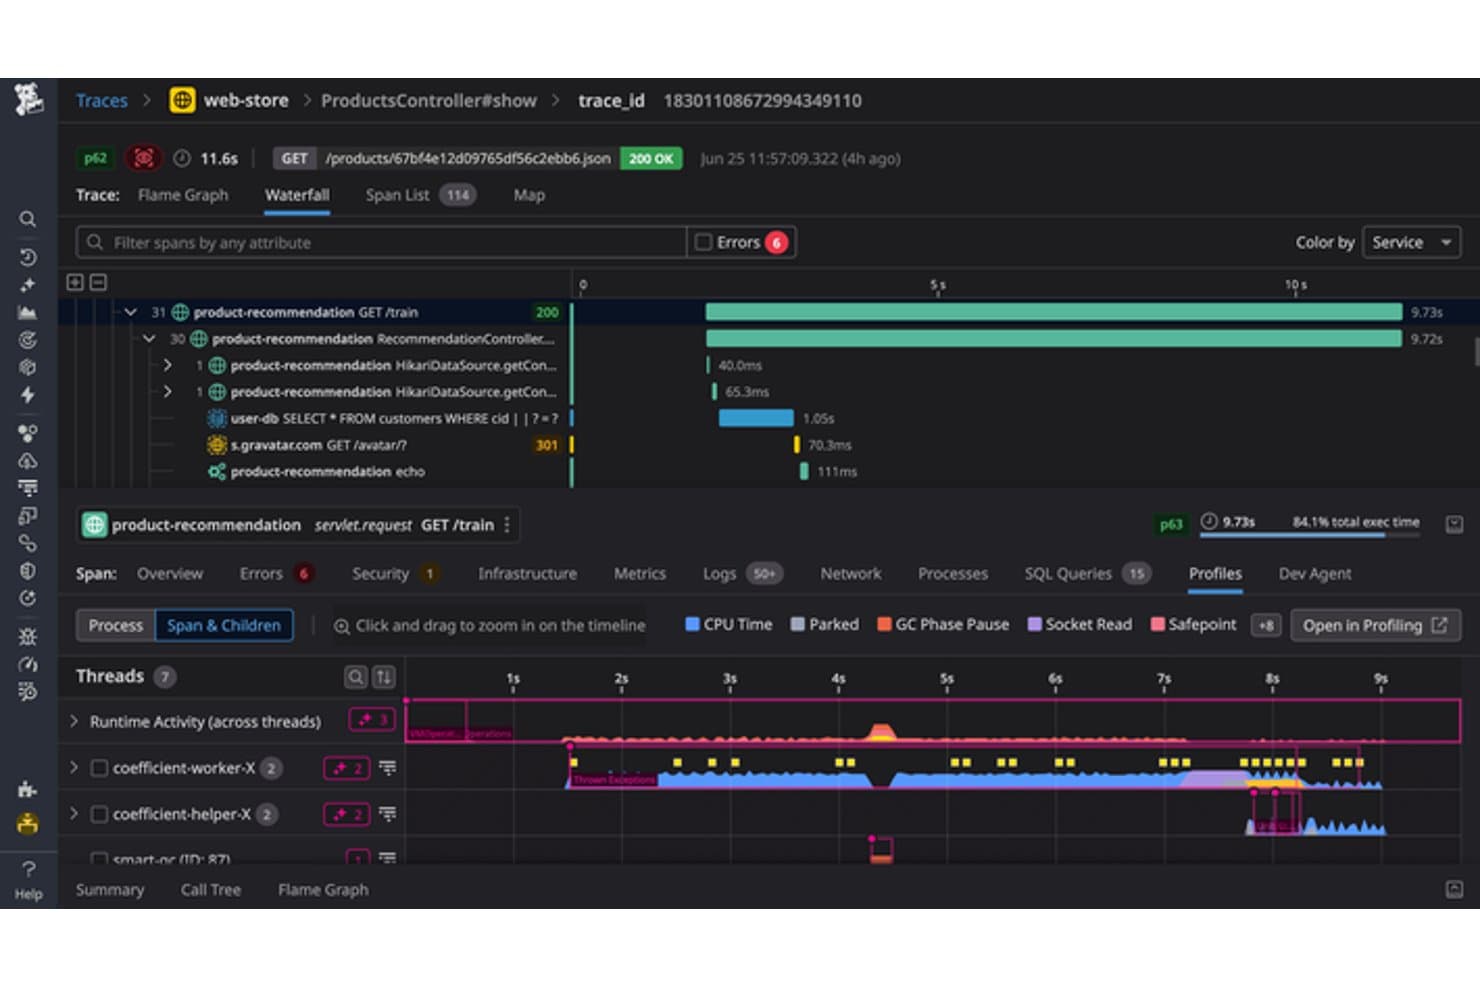
Les traces APM de Datadog détaillent le processeur, les threads et les chronologies des spans. Datadog est une plateforme d’observabilité destinée aux équipes informatiques et DevOps qui regroupe les données des applications, de l’infrastructure, des journaux et de la sécurité afin d’aider à diagnostiquer les problèmes de performance dans les environnements cloud natifs.
À qui Datadog convient-il le mieux ?
Les équipes d’exploitation cloud et SRE peuvent utiliser Datadog pour suivre l’état des services dans une infrastructure distribuée et identifier les problèmes affectant les charges de travail en production.
Pourquoi j’ai choisi Datadog
J’ai choisi Datadog pour un guide des meilleures alternatives à Dynatrace, car il mérite la distinction « Meilleur pour le suivi unifié des services cloud ». J’apprécie la manière dont ses métriques d’infrastructure, ses traces distribuées et ses journaux me permettent de suivre une requête lente depuis un hôte cloud à travers les services dépendants et d’examiner les erreurs associées. Sa carte des services m’aide à localiser une dépendance en amont qui affecte l’état de la production.
Fonctionnalités clés de Datadog
- Surveillance des utilisateurs réels : capture les sessions de navigation, les erreurs frontend et les performances des pages.
- Surveillance synthétique : exécute des tests planifiés de navigateur et d’API sur les applications.
- Surveillance des bases de données : affiche les métriques au niveau des requêtes et les plans d’exécution pour les bases de données prises en charge.
- Moniteurs et alertes : évalue les données de télémétrie par rapport à des seuils et envoie des notifications lorsque les conditions sont remplies.
Intégrations de Datadog
Datadog propose plus de 1 000 intégrations natives, notamment avec AWS, Azure, Google Cloud, Kubernetes, Docker, PostgreSQL, GitHub, Jira, Slack et PagerDuty. Il prend également en charge les intégrations personnalisées via son API.
Pros and Cons
Pros:
- Met en corrélation les métriques, les journaux et les traces pendant les incidents
- Cartographie les dépendances pour identifier les défaillances des services en amont
- Unifie les vues de l’état de l’infrastructure et des applications
Cons:
- La croissance de la télémétrie rend les factures difficiles à prévoir
- Les tableaux de bord et les requêtes avancés nécessitent du temps de configuration
 Idéal pour la supervision open source de niveau entreprise
- Non
- Gratuit
Visit WebsiteCustomer Rating:4.4/5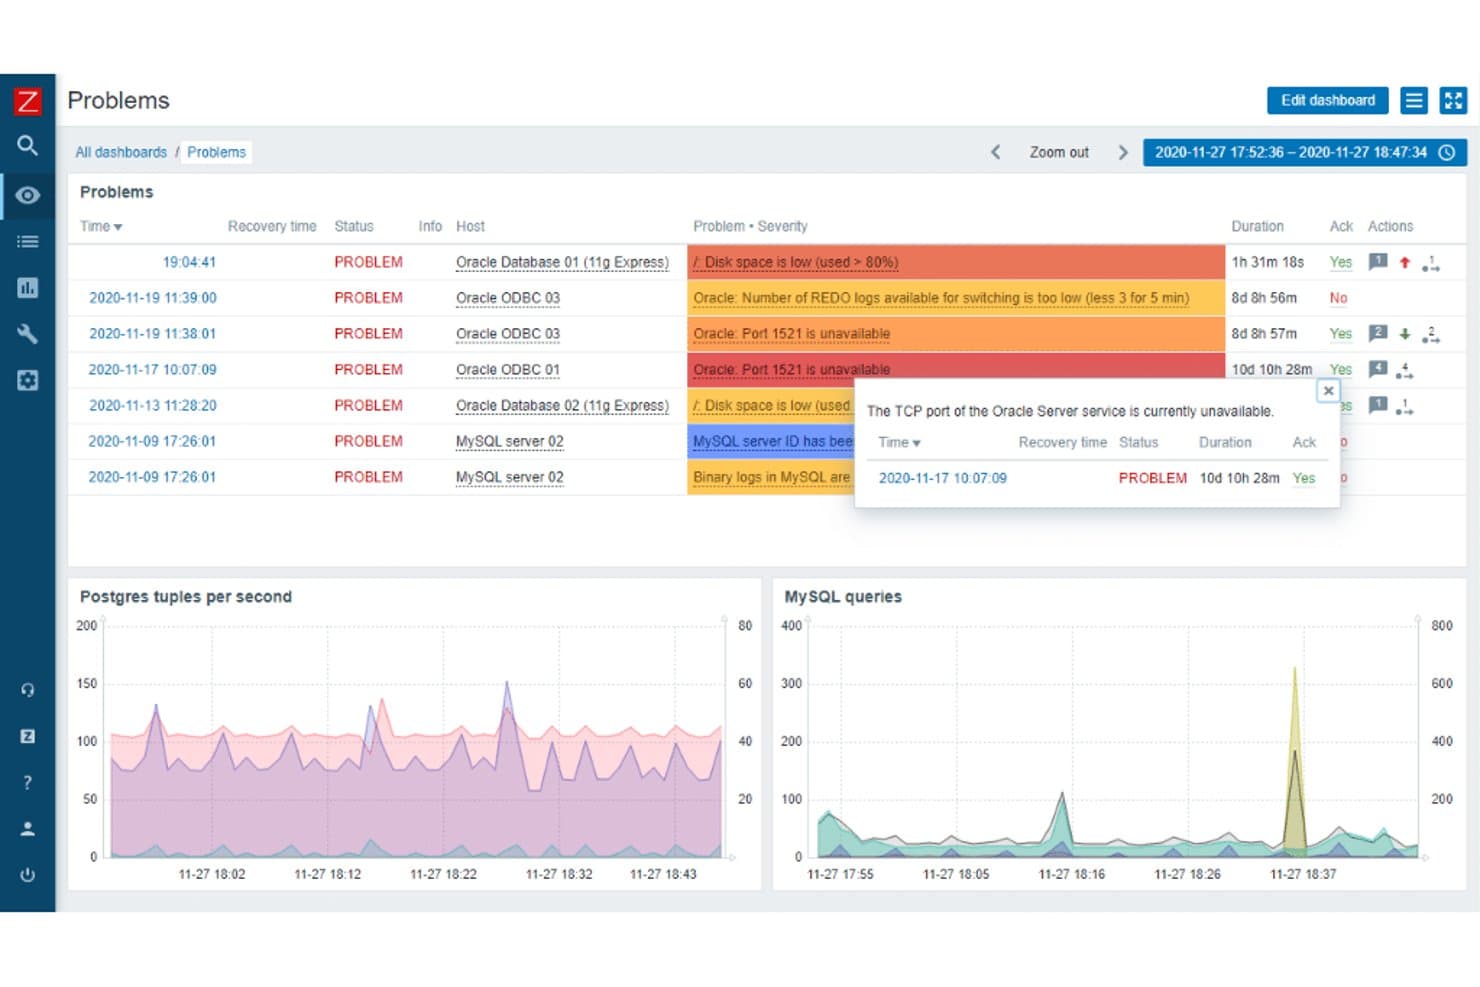
Zabbix met en évidence les problèmes actifs des bases de données et des serveurs avec des détails sur leur gravité. Zabbix est une plateforme de supervision de l’infrastructure destinée aux équipes informatiques qui doivent suivre les serveurs, les réseaux et les applications, détecter les problèmes de service et assurer la visibilité dans des environnements complexes.
À qui Zabbix convient-il le mieux ?
Zabbix convient aux équipes d’exploitation informatique des grandes entreprises qui ont besoin d’une supervision personnalisable et open source dans des environnements vastes et distribués.
Pourquoi j’ai choisi Zabbix
J’ai choisi Zabbix pour ce guide des meilleures alternatives à Dynatrace, car c’est la meilleure solution de supervision open source de niveau entreprise. J’apprécie la façon dont les proxys distribués collectent les données des sites distants, tandis que des modèles réutilisables appliquent des contrôles et des déclencheurs aux serveurs et aux périphériques réseau. Les équipes d’exploitation peuvent ainsi superviser un environnement vaste et hétérogène sans dépendre d’une plateforme propriétaire.
Principales fonctionnalités de Zabbix
- Corrélation des événements : Définissez des règles pour regrouper les problèmes associés et supprimer les événements symptomatiques.
- Supervision web : Suivez les scénarios web à plusieurs étapes et les temps de réponse.
- Cartes réseau : Créez des cartes affichant les hôtes supervisés, les liens et les problèmes actuels.
- Découverte de bas niveau : Détectez automatiquement des entités telles que les interfaces réseau et créez des éléments pour les superviser.
Intégrations de Zabbix
Le catalogue officiel des intégrations de Zabbix répertorie 1 986 solutions issues de 559 marques, notamment AWS, Azure, Kubernetes, ServiceNow, Slack, Jira et PagerDuty. Il fournit également une API JSON-RPC basée sur HTTP et des webhooks JavaScript personnalisables pour les intégrations personnalisées.
Pros and Cons
Pros:
- Évolue dans les sites distribués grâce aux proxys
- Les modèles réutilisables standardisent les contrôles sur l’ensemble des parcs
- Corrèle les alertes associées pour réduire le bruit
Cons:
- La configuration initiale exige un travail manuel conséquent
- Les déploiements importants nécessitent un réglage de la base de données et des proxys
 Idéal pour une visibilité en temps réel des performances commerciales
- Non
- À partir de $6/vCPU/mois (facturé annuellement)
Visit WebsiteCustomer Rating:4.3/5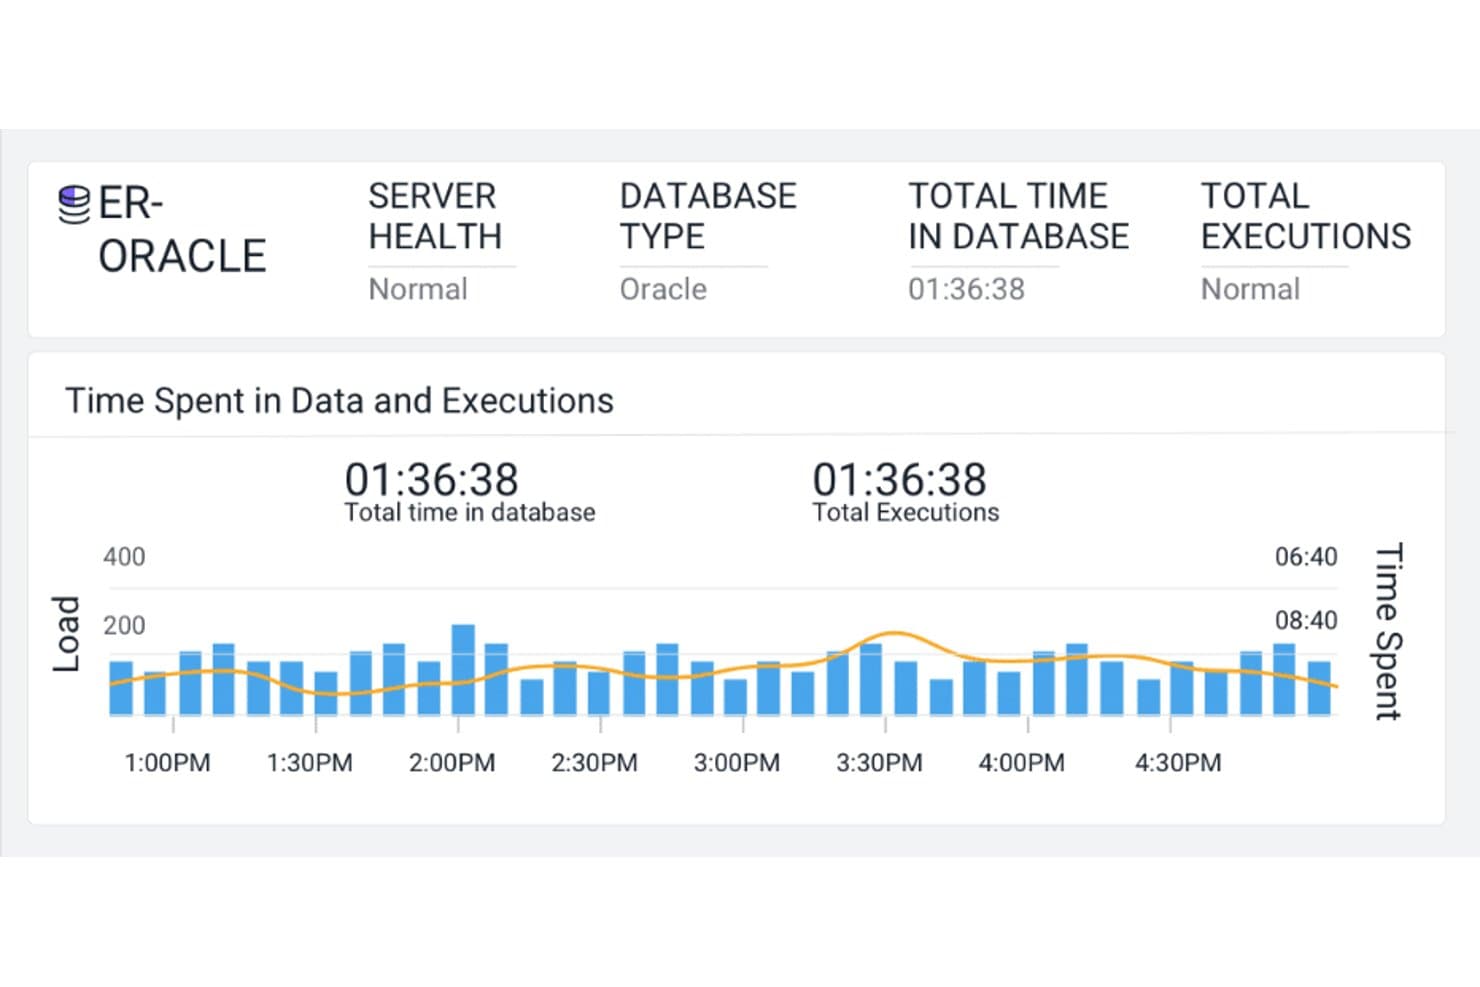
AppDynamics surveille visuellement la charge et les temps d’exécution d’une base de données Oracle. Pour les équipes informatiques et d’ingénierie qui comparent les alternatives à Dynatrace, AppDynamics associe la surveillance des performances des applications au traçage des transactions afin d’aider à localiser les ralentissements et les erreurs dans des services complexes et distribués.
À qui AppDynamics convient-il le mieux ?
AppDynamics convient aux équipes chargées des opérations informatiques et des applications qui doivent relier l’état de santé en temps réel des applications aux transactions commerciales dont dépendent les clients.
Pourquoi j’ai choisi AppDynamics
J’ai choisi AppDynamics parce que son positionnement, « Idéal pour une visibilité en temps réel des performances commerciales », relie l’état de santé en temps réel des applications aux transactions dont dépendent les clients. J’apprécie la façon dont le traçage des transactions aide à localiser les ralentissements dans les services distribués, afin de voir où une requête se bloque et de relier ce problème à l’activité commerciale.
Fonctionnalités clés d’AppDynamics
- Sécurité des applications à l’exécution : Détecter les vulnérabilités des applications et bloquer les attaques.
- Surveillance des utilisateurs réels : Capturer les performances Web et mobiles sur différents appareils et navigateurs.
- Surveillance synthétique : Surveiller les performances Web, mobiles et des API à l’aide d’une activité simulée.
- Détection des anomalies : Définir des références de performance et signaler les écarts grâce à l’IA et à l’apprentissage automatique.
Intégrations d’AppDynamics
AppDynamics dispose d’une intégration Jira bidirectionnelle intégrée pour créer et mettre à jour des tickets d’incident, ainsi que d’une intégration en avant-première avec Splunk Observability Cloud. La solution propose également des extensions préconfigurées et des API REST pour les intégrations et l’automatisation.
Pros and Cons
Pros:
- Les cartes des transactions commerciales relient la télémétrie à l’impact
- Les graphes d’appels facilitent l’analyse de la cause racine au niveau du code
- Les alertes de référence signalent les écarts par rapport à la normale
Cons:
- L’instrumentation et la configuration des agents nécessitent une intervention manuelle
- L’interface semble désuète comparée à celle des outils d’observabilité plus récents
Learn more about AppDynamics: Idéal pour interroger la télémétrie dans un magasin de données unifié
- Non
- $12/utilisateur/mois (facturé annuellement)
Visit WebsiteCustomer Rating:4.3/5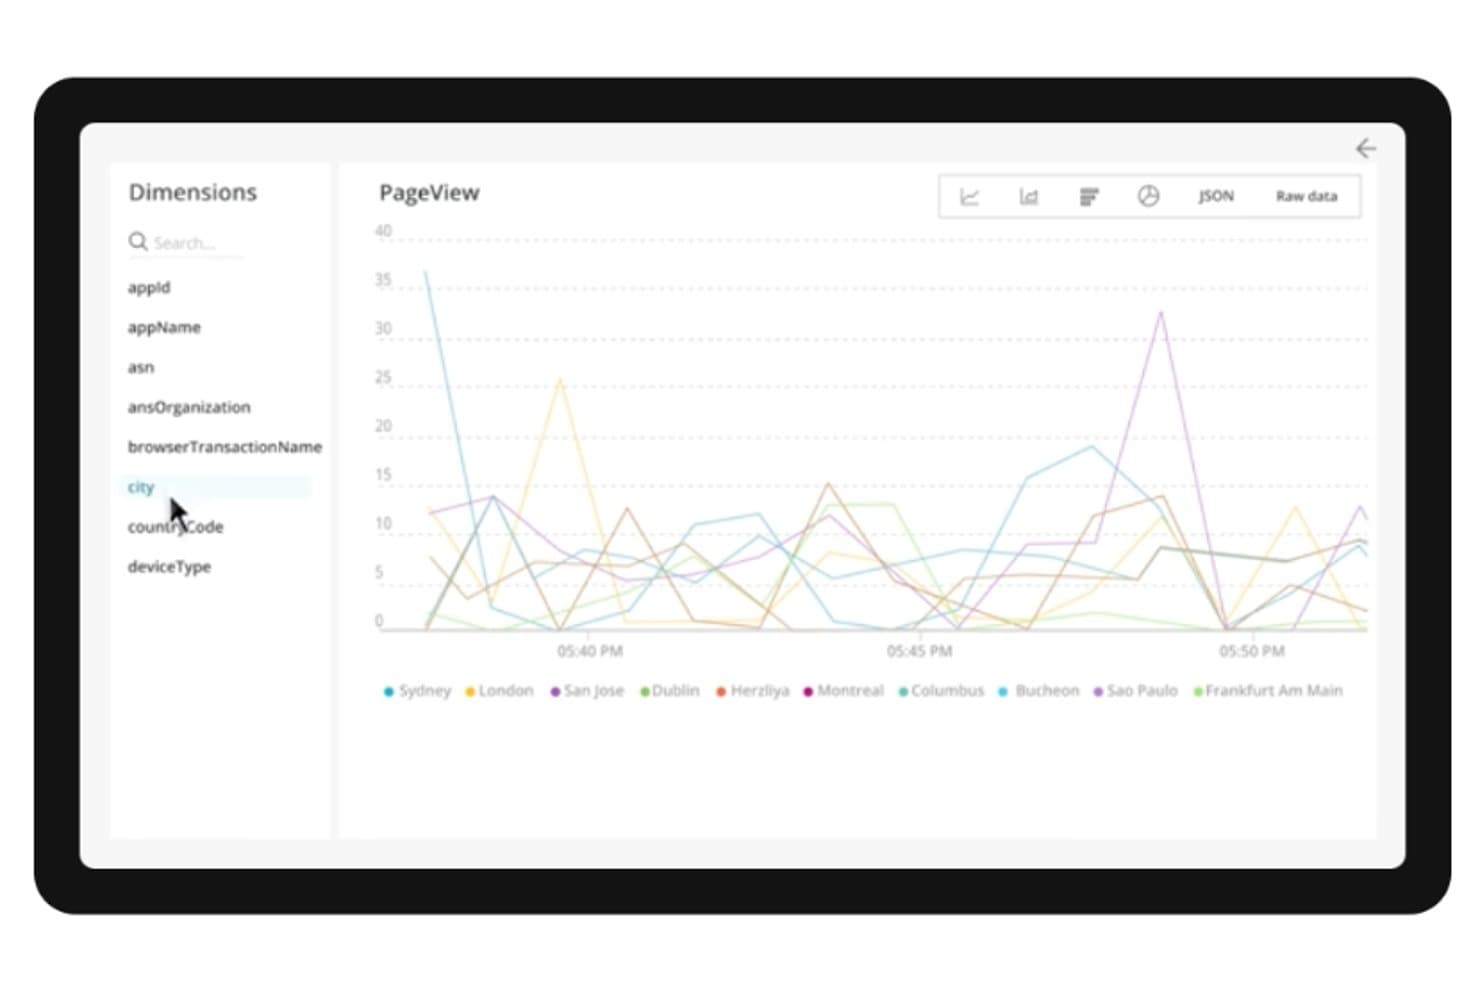
New Relic ventile les données PageView par ville sur une série chronologique. Pour les équipes informatiques et d’ingénierie qui évaluent des alternatives à Dynatrace, New Relic est une plateforme de gestion des performances applicatives qui aide à suivre les problèmes des applications, à surveiller l’état des services et à analyser les ralentissements dans les systèmes distribués.
À qui New Relic convient-il le mieux ?
New Relic convient aux équipes DevOps et de fiabilité des sites qui doivent corréler les traces des applications, les métriques de l’infrastructure et les journaux tout en diagnostiquant les problèmes en production.
Pourquoi ai-je choisi New Relic ?
J’ai choisi New Relic pour son orientation « Idéal pour une surveillance complète des performances applicatives » : il relie les traces distribuées à l’état des services et aux journaux, ce qui m’aide à suivre les ralentissements entre les services. Lorsqu’une API ralentit après une mise en production, je peux suivre le chemin de sa requête et vérifier les signaux des services associés afin de localiser la dépendance affectée.
Fonctionnalités clés de New Relic
- Surveillance des bases de données : Examinez les requêtes lentes des bases de données et les détails de leur exécution.
- Diagnostics au niveau du code : Analysez le profil du code de l’application afin d’identifier les méthodes qui utilisent le temps processeur.
- Suivi des déploiements : Marquez les mises en production pour comparer les performances de l’application avant et après les modifications.
- Conditions d’alerte : Définissez des seuils pour les métriques de l’application et recevez des notifications lorsqu’ils sont dépassés.
Intégrations de New Relic
New Relic prend en charge les intégrations de notification d’alerte avec Atlassian Jira, AWS EventBridge, Microsoft Teams, PagerDuty, ServiceNow et Slack, ainsi que plus de 400 intégrations sur hôte. Il fournit également des API et l’outil d’intégration Flex pour envoyer des données personnalisées à New Relic.
Pros and Cons
Pros:
- Corrèle les traces, les journaux et les signaux de l’infrastructure
- Suit les régressions liées aux mises en production dans les transactions distribuées
- Relie les performances des applications à l’expérience du navigateur
Cons:
- Une navigation dense peut ralentir l’analyse des incidents
- L’augmentation du volume d’ingestion peut rendre les coûts imprévisibles
Learn more about New Relic: Idéal pour la gestion des journaux et l’analyse de sécurité
- Non
- $108 par utilisateur et par mois (facturé annuellement)
Visit WebsiteCustomer Rating:4.3/5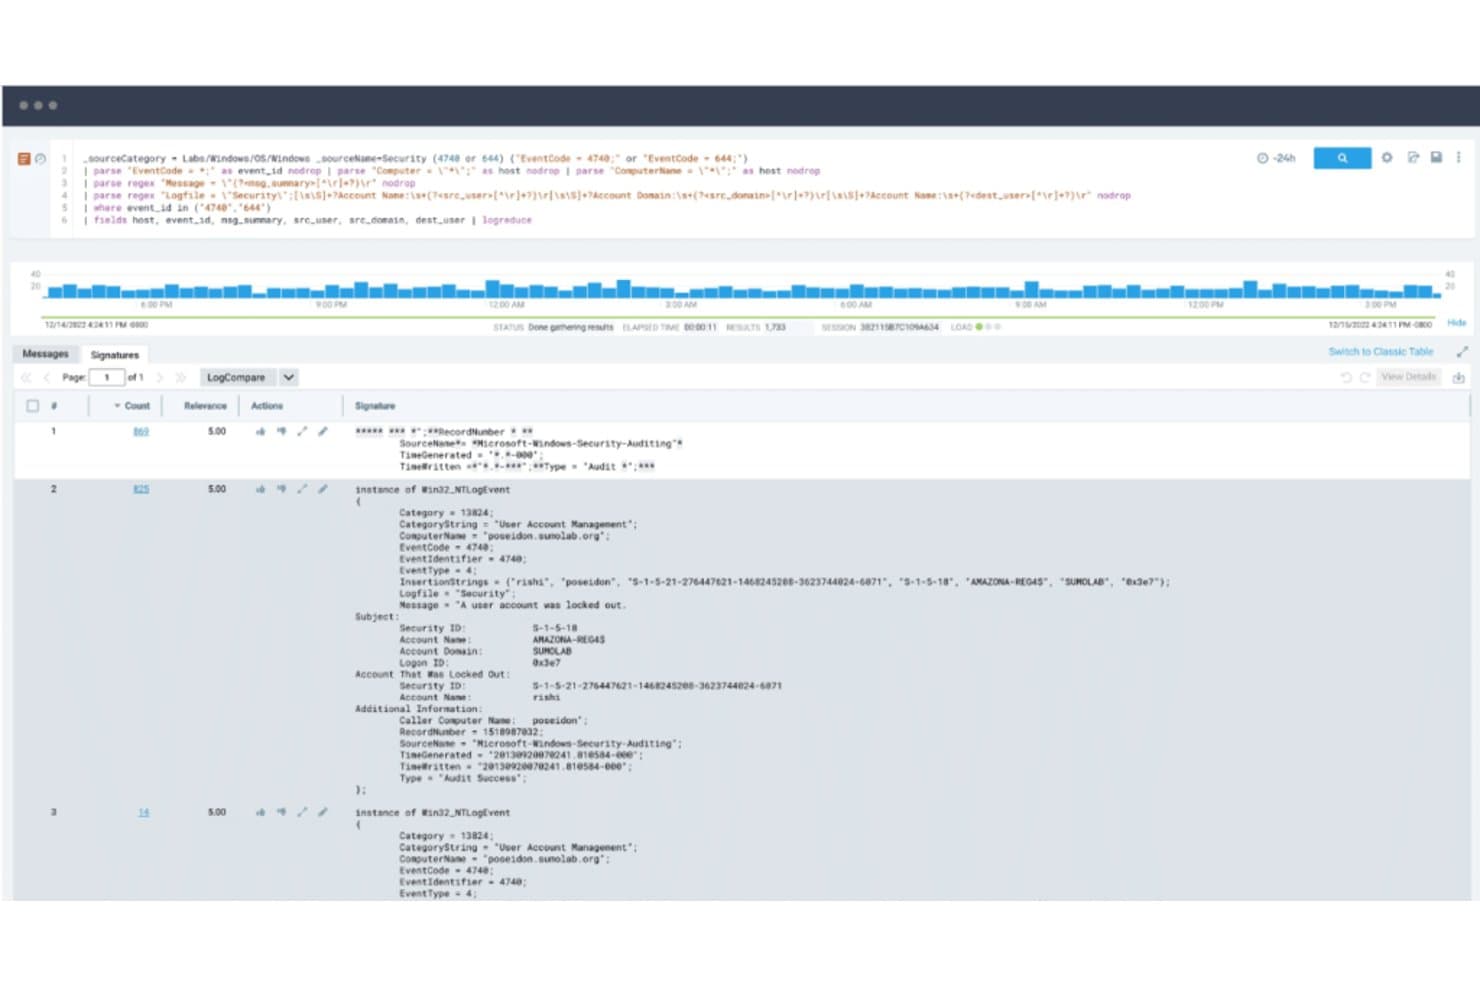
Sumo Logic détecte les événements de verrouillage de compte grâce à l’analyse des journaux de sécurité. Sumo Logic est une plateforme d’observabilité basée sur le cloud qui aide les équipes chargées de l’infrastructure et de la sécurité à enquêter sur les interruptions de service et à comprendre l’activité au sein des applications distribuées, ce qui en fait une option pour les équipes qui évaluent des alternatives à Dynatrace.
À qui Sumo Logic convient-il le mieux ?
Sumo Logic convient bien aux analystes de sécurité et aux équipes chargées des opérations informatiques qui ont besoin de données de journaux centralisées pour le dépannage, la détection des menaces et les enquêtes.
Pourquoi j’ai choisi Sumo Logic
J’ai choisi Sumo Logic pour ce guide des alternatives à Dynatrace, car il correspond à la catégorie « Idéal pour la gestion des journaux et l’analyse de sécurité ». Sa recherche dans les journaux m’aide à suivre les erreurs au sein des services distribués, tandis que Cloud SIEM met en corrélation les signaux de sécurité pour faciliter l’enquête sur les activités suspectes.
Fonctionnalités clés de Sumo Logic
- Analyse des métriques : Interrogez les métriques de séries temporelles avec le langage de requête des métriques de Sumo Logic.
- Traçage distribué : Inspectez les segments de trace pour suivre les requêtes à travers les services instrumentés.
- Tableaux de bord : Créez des visualisations à partir des données de télémétrie et organisez-les dans des mises en page personnalisées.
- Moniteurs et alertes : Définissez des conditions sur les métriques ou les requêtes afin de déclencher des notifications.
Intégrations de Sumo Logic
Le catalogue d’applications de Sumo Logic couvre des centaines de fournisseurs et de produits, notamment AWS, Azure, Datadog, Dynatrace, GitHub et Jira, avec des offres telles que des sources de collecte de données, des applications prédéfinies et des intégrations d’automatisation. Il fournit des intégrations natives par webhook pour ServiceNow et Slack, ainsi que des API REST pour les intégrations personnalisées.
Pros and Cons
Pros:
- Les recherches rapides dans les journaux facilitent les enquêtes sur les incidents
- Les journaux centralisés alimentent les alertes en temps réel
- Cloud SIEM met les menaces en corrélation pour faciliter les enquêtes
Cons:
- Le langage de requête demande du temps pour être maîtrisé
- La collecte et l’analyse syntaxique des journaux doivent être améliorées
 10Idéal pour l’analyse et les informations issues de données à grande échelle
Splunk
- Non
- $150/user/month
Visit WebsiteCustomer Rating:4.3/5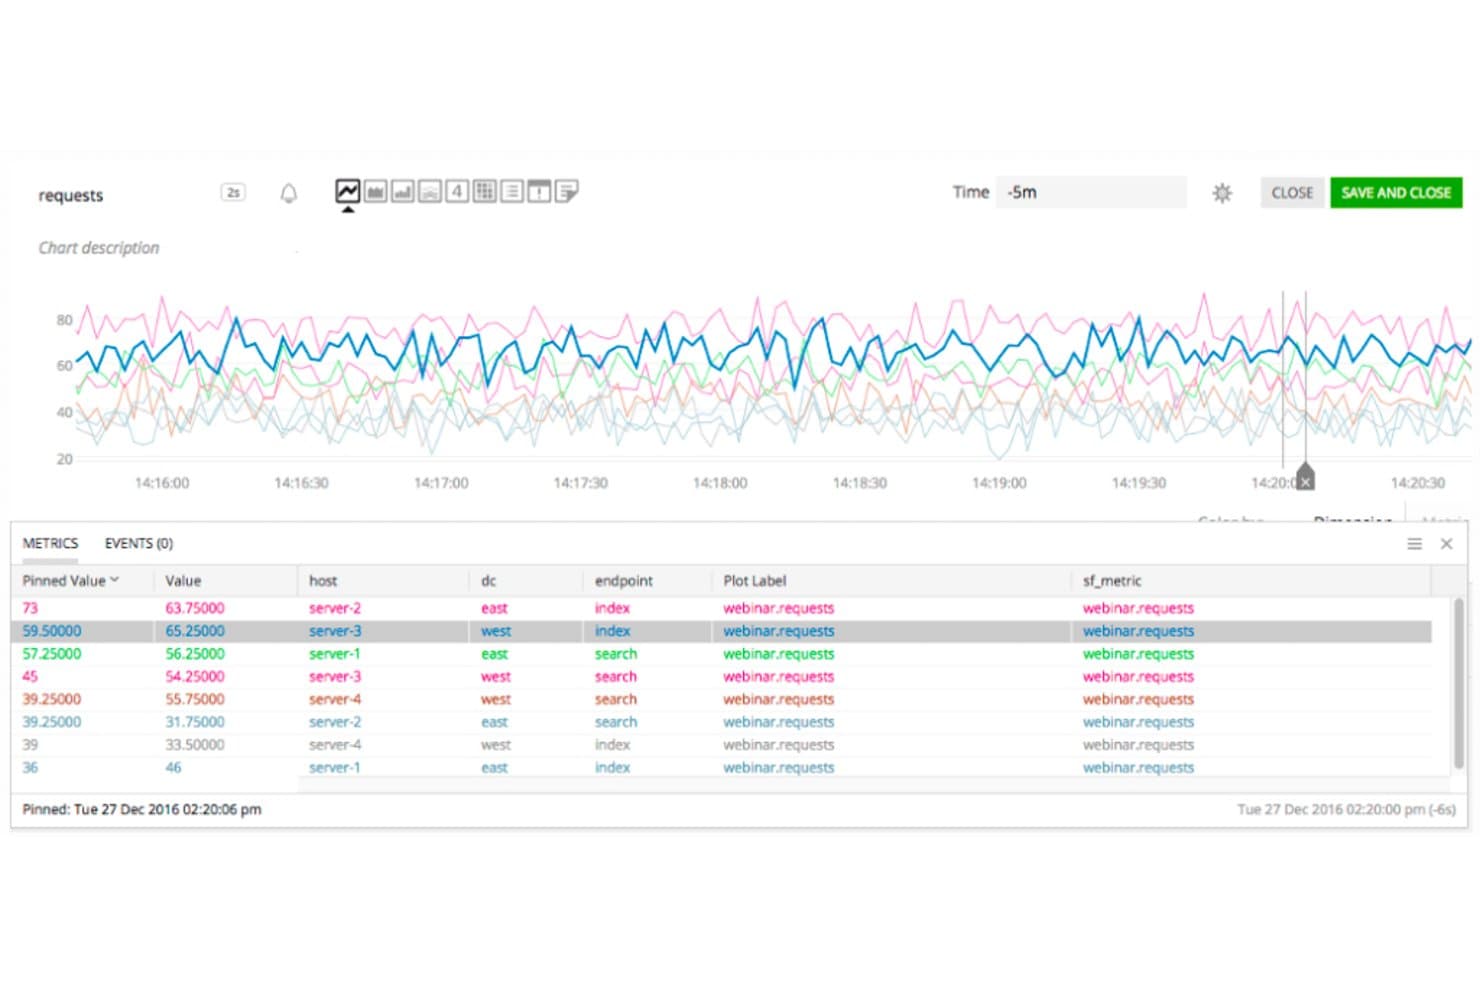
Splunk permet aux utilisateurs de surveiller en temps réel les métriques des requêtes sur les serveurs et les points de terminaison. Splunk associe la surveillance de l’infrastructure à l’analyse des journaux, des métriques et des traces, aidant les équipes informatiques et opérationnelles à enquêter sur les incidents dans des environnements complexes et distribués.
À qui Splunk convient-il le mieux ?
Splunk convient aux grandes équipes informatiques et de sécurité qui doivent analyser d’importants volumes de données machine et découvrir des tendances dans des environnements complexes.
Pourquoi j’ai choisi Splunk
J’ai choisi Splunk comme alternative à Dynatrace pour son positionnement « Idéal pour l’analyse et les informations issues de données à grande échelle ». Il associe la surveillance de l’infrastructure à l’analyse des journaux, des métriques et des traces, ce qui me permet d’enquêter sur le ralentissement d’un service dans des systèmes distribués et de relier les signaux aux événements associés. Cela m’aide à interroger d’importants volumes de données machine lors des investigations d’incidents.
Fonctionnalités clés de Splunk
- Tableaux de bord personnalisés : Créez des panneaux visuels avec des graphiques, des tableaux et des données de service.
- Détecteurs d’alertes : Définissez des conditions qui déclenchent des alertes lorsque les signaux surveillés dépassent certains seuils.
- Surveillance de Kubernetes : Explorez l’état des clusters, des nœuds et des charges de travail dans le navigateur Kubernetes.
- Surveillance synthétique : Exécutez des tests scriptés pour vérifier la disponibilité des applications et les temps de réponse.
Intégrations de Splunk
Splunk Observability Cloud prend en charge les intégrations avec AWS CloudWatch, Google Cloud Platform, Microsoft Azure, Jira, Microsoft Teams, PagerDuty, ServiceNow et Slack. Son API d’intégration configure les connexions prises en charge, tandis que Splunkbase fournit des applications, des modules complémentaires et des connecteurs.
Pros and Cons
Pros:
- Recherche des données machine en grands volumes pour identifier les indices liés aux incidents
- Corrèle les journaux, les métriques et les traces pour les investigations
- Les tableaux de bord et les alertes personnalisés facilitent le triage ciblé
Cons:
- Les coûts peuvent augmenter avec la croissance de l’ingestion de données de télémétrie
- Les requêtes lourdes peuvent ralentir les tableaux de bord à grande échelle
Learn more about Splunk:
Autres alternatives à Dynatrace
Voici quelques alternatives supplémentaires à Dynatrace qui ne figurent pas dans ma sélection, mais qui méritent tout de même votre attention :
- 11PrometheusIdéal pour une surveillance robuste dans les environnements Kubernetes
- 12Grafana CloudIdéal pour la visualisation et l’analyse open-source
- 13ElasticIdéal pour la recherche en temps réel et l’analyse de données
- 14SolarWinds Observability SaaSIdéal pour la hiérarchisation des alertes basée sur l'IA
- 15SysdigIdéal pour la sécurité des conteneurs et de Kubernetes
- 16Dotcom MonitorIdéal pour les simulations en navigateur réel
- 17IcingaAdapté à une surveillance complète avec un solide soutien de la communauté
Autres avis sur les logiciels
- Outils de revue de code pour les développeurs
- Outils de développement web
- Outils d'automatisation de l'infrastructure
Comment j’évalue les alternatives à Dynatrace
J’évalue chaque outil sur deux niveaux : les indispensables comme l’APM full-stack et la traçabilité distribuée, puis les éléments différenciateurs qui distinguent les plateformes selon les équipes et les environnements techniques.
Fonctionnalité de base (Critères essentiels pour cette liste)
Lorsque je sélectionne des outils pour ma liste, je note chacun sur une échelle de 0 (ne propose pas la fonctionnalité) à 5 (excelle dans ce domaine) pour chacune des fonctionnalités de base listées ci-dessous. Ensuite, je calcule le score total de l’outil en pourcentage. Chaque outil doit atteindre un score total minimum de 75 % pour être retenu.
- APM Full-Stack : Je vérifie si l’outil permet une traçabilité des transactions au niveau du code sur les principaux langages et frameworks, par exemple pour identifier un appel base de données lent enfoui dans un microservice Java.
- Supervision de l’infrastructure : Chaque outil doit couvrir les serveurs, conteneurs, clusters Kubernetes et services cloud avec de la découverte automatique plutôt que via une configuration manuelle hôte par hôte.
- Traçabilité distribuée : J’évalue la façon dont les tracés circulent à travers les frontières des services et si la plateforme prend en charge l’ingestion OpenTelemetry, aspect important pour les équipes travaillant avec des environnements polyglottes.
- Gestion et analyse des logs : Les journaux doivent pouvoir être corrélés aux tracés et métriques dans une vue unique, afin qu’un SRE puisse passer d’un pic de taux d’erreur aux lignes de logs responsables.
- Détection d’anomalies pilotée par l’IA : Je recherche des fonctions d’apprentissage automatique qui établissent une base de comportement normal et proposent des causes racines, au lieu de simples alertes à seuil qui saturent les canaux d’astreinte.
- Supervision utilisateur réelle & synthétique : La plateforme doit proposer à la fois le monitoring des utilisateurs réels (RUM) pour l’analyse du trafic en direct et des tests synthétiques afin de détecter des parcours de paiement défectueux ou des échecs d’API avant que les utilisateurs finaux ne soient impactés.
Une fois ma sélection d’outils conforme à ces critères, j’analyse ce qui distingue chaque plateforme.
Facteurs différenciants (Ce qui démarque les fournisseurs)
Voici comment je compare et distingue les différents fournisseurs :
Fonctionnalités remarquables
La transparence tarifaire est essentielle lorsqu’on envisage de quitter Dynatrace, donc j’évalue si la plateforme offre une tarification prévisible, basée sur l’usage, avec des mécanismes clairs de contrôle des coûts. Le support natif d’OpenTelemetry est également un atout : les équipes qui utilisent déjà des collecteurs OTel ne devraient pas avoir à tout remplacer par des agents propriétaires. Je recherche aussi la présence de workflows de remédiation automatisés, déclenchant des runbooks ou une escalade via des outils comme PagerDuty en cas d’anomalie, afin de transformer les alertes en actions sans intervention manuelle.
Au-delà des fonctionnalités
La flexibilité de déploiement est un critère clé—je vérifie si la plateforme supporte les modèles SaaS, auto-hébergé ou hybrides, car les équipes de secteurs réglementés ont souvent besoin d’options sur site ou de localisations de données spécifiques. L’écosystème d’intégrations conditionne aussi la compatibilité de l’outil avec votre stack existante : des connecteurs natifs vers les pipelines CI/CD, les plateformes ITSM comme ServiceNow ou des outils d’incident comme Opsgenie facilitent l’adoption. J’évalue également les certifications de conformité comme SOC 2 Type II et ISO 27001, ainsi que la présence de l’authentification unique (SSO) et du contrôle d’accès basé sur les rôles.
Pourquoi chercher une alternative à Dynatrace ?
Bien que Dynatrace soit un bon choix de plateforme de surveillance des performances des applications (APM), plusieurs raisons peuvent pousser certains utilisateurs à rechercher d'autres solutions. Vous recherchez peut-être une alternative à Dynatrace parce que…
- Le prix peut devenir trop élevé pour les petites équipes
- La courbe d'apprentissage semble trop importante pour les nouveaux utilisateurs
- Vous souhaitez des tableaux de bord et des rapports plus simples
- Vous avez besoin d'options d'alerte et de notification plus flexibles
- Vous utilisez une configuration hybride et avez besoin d'intégrations plus étendues
- Vous préférez les outils dont la facturation est plus transparente
Si l'un de ces points vous correspond, vous êtes au bon endroit. Ma liste contient plusieurs options de plateformes de surveillance des performances des applications (APM) mieux adaptées aux équipes confrontées à ces difficultés avec Dynatrace et à la recherche de solutions alternatives.
Fonctionnalités clés de Dynatrace
Voici quelques-unes des fonctionnalités clés de Dynatrace, pour vous aider à comparer les offres des solutions alternatives :
- Surveillance de l’ensemble de la pile : vous permet de suivre les performances des applications, l’infrastructure et l’expérience utilisateur au même endroit.
- Moteur d’IA Davis : détecte automatiquement les problèmes et en explique la cause racine pour faire gagner du temps à votre équipe.
- Surveillance des utilisateurs réels : montre comment les utilisateurs réels interagissent avec votre application afin que vous puissiez résoudre les problèmes qui comptent.
- Sécurité des applications : signale les vulnérabilités en temps réel pendant que votre code s’exécute en production.
- Prise en charge des environnements infonuagiques natifs : fonctionne efficacement avec Kubernetes, AWS, Azure et d’autres environnements infonuagiques.
- Alertes intelligentes : envoie des alertes uniquement lorsque cela est nécessaire afin d’éviter la lassitude liée aux alertes.
- Tableaux de bord personnalisés : vous permet de créer des vues adaptées aux besoins et aux indicateurs de votre équipe.
- Informations au niveau du code : vous aide à examiner les performances jusque dans les lignes de code individuelles.
- Gestion des journaux : vous permet de rechercher, filtrer et analyser les journaux afin de résoudre les problèmes plus rapidement.
- Surveillance synthétique : simule les actions des utilisateurs afin que vous puissiez tester les performances de votre application depuis différents emplacements.
Résumé
Dans ce guide d’achat, nous avons examiné en profondeur l’univers des alternatives à Dynatrace, en explorant différentes options adaptées à des cas d’usage spécifiques. Que vous recherchiez un outil de surveillance à code source ouvert de niveau entreprise, de gestion des journaux et d’analyse de sécurité, ou de sécurité des conteneurs et de Kubernetes, de nombreuses options performantes s’offrent à vous.
Voici trois points clés à retenir de ce guide :
- Évaluez vos besoins : les différents outils sont conçus pour répondre à divers cas d’usage. Certains sont adaptés à une gestion étendue des journaux, d’autres aux environnements à code source ouvert, et d’autres encore à la sécurité des conteneurs et de Kubernetes. Comprendre les besoins propres à votre organisation vous orientera vers l’outil approprié.
- Examinez les fonctionnalités : les outils peuvent avoir des fonctions principales similaires, mais les détails font toute la différence. Les fonctionnalités propres à chaque outil, leur facilité d’utilisation et leurs intégrations avec les autres outils que vous utilisez peuvent transformer votre expérience de surveillance.
- Tenez compte du prix : même si le coût est souvent un facteur important, il est essentiel de considérer ce que vous obtenez en échange de votre investissement. Un outil plus coûteux peut fournir les fonctionnalités ou l’assistance robustes dont vous avez besoin et, dans certains cas, un outil moins cher, voire gratuit, peut répondre à vos besoins.
Gardez à l’esprit que le « meilleur » outil dépend entièrement des exigences et des circonstances propres à votre organisation. Fort des informations contenues dans ce guide, vous êtes sur la bonne voie pour prendre une décision éclairée.
Qu’en pensez-vous ?
Il est certain qu’aucune liste ne peut recenser toutes les excellentes alternatives à Dynatrace disponibles. Il existe peut-être d’excellentes alternatives à Dynatrace ou à New Relic que je n’ai pas abordées dans ce guide. Si vous avez utilisé un outil ou entendu parler d’un outil qui, selon vous, mérite de figurer sur cette liste, n’hésitez pas à nous faire part de votre avis.
Vos idées et vos expériences pourraient être précieuses pour les autres personnes qui étudient leurs options. Je me réjouis de vous lire.