

Las 10 mejores herramientas de implementación de modelos de aprendizaje automático en 2026
Lista de las mejores herramientas de implementación de modelos de ML


Las herramientas de implementación de modelos de ML permiten tomar modelos de aprendizaje automático entrenados y convertirlos en servicios listos para producción que realmente puedes utilizar. Si buscas formas de lanzar, supervisar y gestionar de manera fiable tus aplicaciones basadas en IA, elegir la plataforma de implementación adecuada es importante. La seguridad, la escalabilidad, la automatización y la transparencia pueden hacer que tu flujo de trabajo sea un éxito o un fracaso.
En esta lista, analizaré las herramientas de implementación de ML en las que más confío y te mostraré exactamente dónde encaja cada una en tu conjunto de herramientas, para que puedas elegir la plataforma que se ajuste a las necesidades de tu proyecto y a las expectativas de tu equipo.
Por qué confiar en nuestras reseñas de software
Llevamos probando y revisando software desde 2023. Como líderes tecnológicos, sabemos lo crítico y difícil que es tomar la decisión correcta al seleccionar software.
Invertimos en una investigación profunda para ayudar a nuestra audiencia a tomar mejores decisiones de compra de software. Hemos probado más de 2,000 herramientas para diferentes casos de uso tecnológicos y escrito más de 1,000 reseñas de software exhaustivas. Descubre cómo mantenemos la transparencia y nuestra metodología de revisión de software.
Resumen de las mejores herramientas de implementación de modelos de ML
Esta tabla comparativa resume los detalles de precios de mis principales selecciones de herramientas de implementación de modelos de ML para ayudarte a encontrar la mejor opción para tu presupuesto y las necesidades de tu empresa.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Ideal para la orquestación de modelos nativa de Kubernetes | Plan gratuito disponible | Uso gratuito | Website | |
| 2 | Ideal para API de inferencia estandarizadas en Kubernetes | Plan gratuito disponible | Uso gratuito | Website | |
| 3 | Ideal para empaquetar modelos como APIs de producción | Plan gratuito + demo gratuita disponible | Precio bajo solicitud | Website | |
| 4 | Ideal para alojar modelos transformer a escala | Plan gratuito + demo gratuita disponible | Desde $9/mes | Website | |
| 5 | Ideal para desplegar funciones Python sin servidor | Plan gratuito disponible | Desde $250 + cómputo/mes | Website | |
| 6 | Mejor para la gestión automatizada de modelos de extremo a extremo | Plan gratuito disponible | Desde $0.204/hora | Website | |
| 7 | Ideal para flujos de trabajo unificados de datos e IA | Plan gratuito disponible | Desde $0.085/hora | Website | |
| 8 | Ideal para crear interfaces web personalizadas para modelos | Plan gratuito disponible | Precio disponible bajo solicitud | Website | |
| 9 | Ideal para prestación distribuida con Python y Ray | Crédito gratuito de $100 disponible | Precios bajo consulta | Website | |
| 10 | Mejor para gestionar modelos en industrias reguladas | Not available | Precios bajo solicitud | Website |
Reseñas de las mejores herramientas de implementación de modelos de ML
A continuación se muestran mis resúmenes detallados de las mejores herramientas de implementación de modelos de ML que llegaron a mi lista de preseleccionadas. Mis reseñas ofrecen un análisis detallado de las funciones, integraciones y mejores casos de uso de cada plataforma para ayudarte a encontrar la mejor opción para ti.
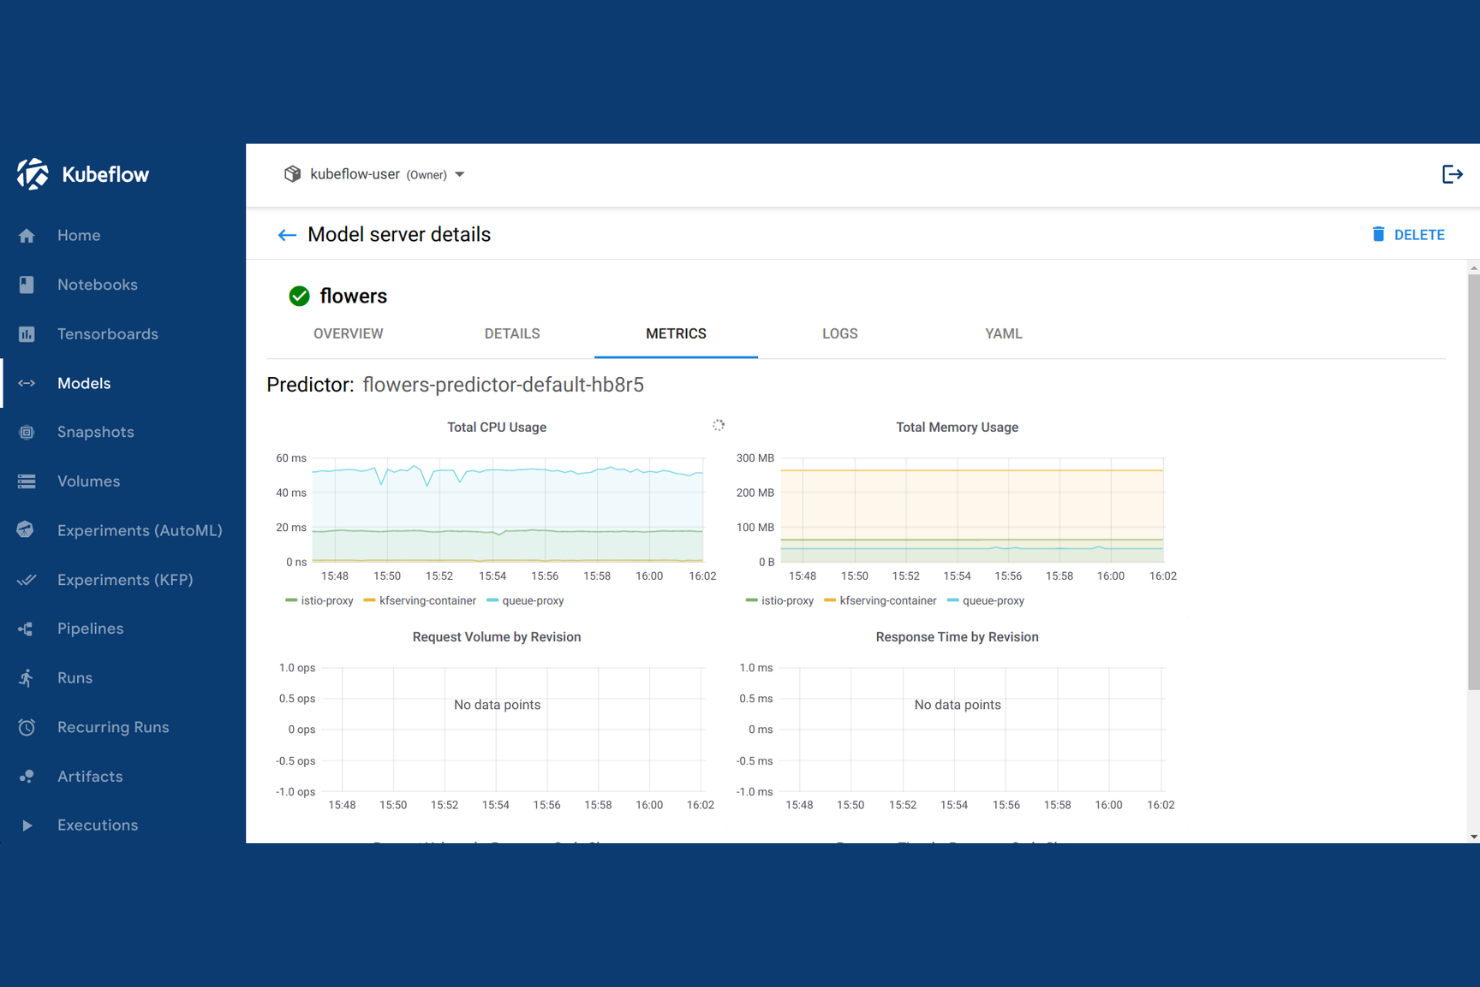
Kubeflow es una plataforma de ML de código abierto basada en Kubernetes que abarca la orquestación de canalizaciones, el entrenamiento de modelos, el ajuste de hiperparámetros y el servicio de modelos con múltiples marcos en infraestructuras en la nube y locales.
¿Para quién es más adecuado Kubeflow?
Kubeflow es una excelente opción para equipos de ingeniería de ML que ya utilizan Kubernetes y necesitan gestionar trabajos de entrenamiento a gran escala y el servicio de modelos en producción en su propia infraestructura.
Por qué elegí Kubeflow
Elegí Kubeflow como una de las mejores opciones porque está diseñado específicamente para Kubernetes, lo que significa que cada componente se ejecuta como una carga de trabajo nativa de Kubernetes. Me gusta que Kubeflow Pipelines me permita definir flujos de trabajo de ML integrales como DAG en contenedores, de modo que cada paso se escale de forma independiente. Kubeflow Trainer gestiona el entrenamiento distribuido en PyTorch, JAX y DeepSpeed sin necesidad de configurar el clúster manualmente. También puedo usar Katib para ejecutar búsquedas automatizadas de hiperparámetros directamente en trabajos de entrenamiento en ejecución dentro del mismo clúster.
Características principales de Kubeflow
- KServe: Implementa modelos entrenados como servicios de inferencia escalables en Kubernetes mediante entornos de ejecución de servicio prediseñados para TensorFlow, PyTorch y scikit-learn.
- Registro de modelos: Almacena, versiona y realiza el seguimiento de modelos registrados en distintas ejecuciones de entrenamiento antes de promoverlos a entornos de servicio.
- Servidores de cuadernos: Inicia instancias de cuadernos de Jupyter directamente en el clúster con asignaciones configurables de CPU, GPU y memoria.
- Aislamiento multiusuario: Gestiona espacios de nombres y controles de acceso independientes para diferentes equipos o proyectos dentro de un clúster compartido.
Integraciones de Kubeflow
Kubeflow no ofrece integraciones nativas tradicionales; en su lugar, funciona dentro del ecosistema de Kubernetes y admite marcos de ML como TensorFlow, PyTorch, JAX, XGBoost, HuggingFace y Apache Spark mediante los operadores de sus subproyectos. También puedes implementarlo en servicios de Kubernetes administrados de AWS, Google Cloud, Microsoft Azure y Red Hat OpenShift.
Pros and Cons
Pros:
- Se implementa en los principales proveedores de Kubernetes en la nube
- Cada paso de la canalización se ejecuta en un contenedor aislado
- Obtiene una puntuación alta en entrenamiento distribuido y orquestación
Cons:
- La configuración inicial compleja requiere conocimientos de Kubernetes
- Requiere un equipo de plataforma dedicado para su mantenimiento

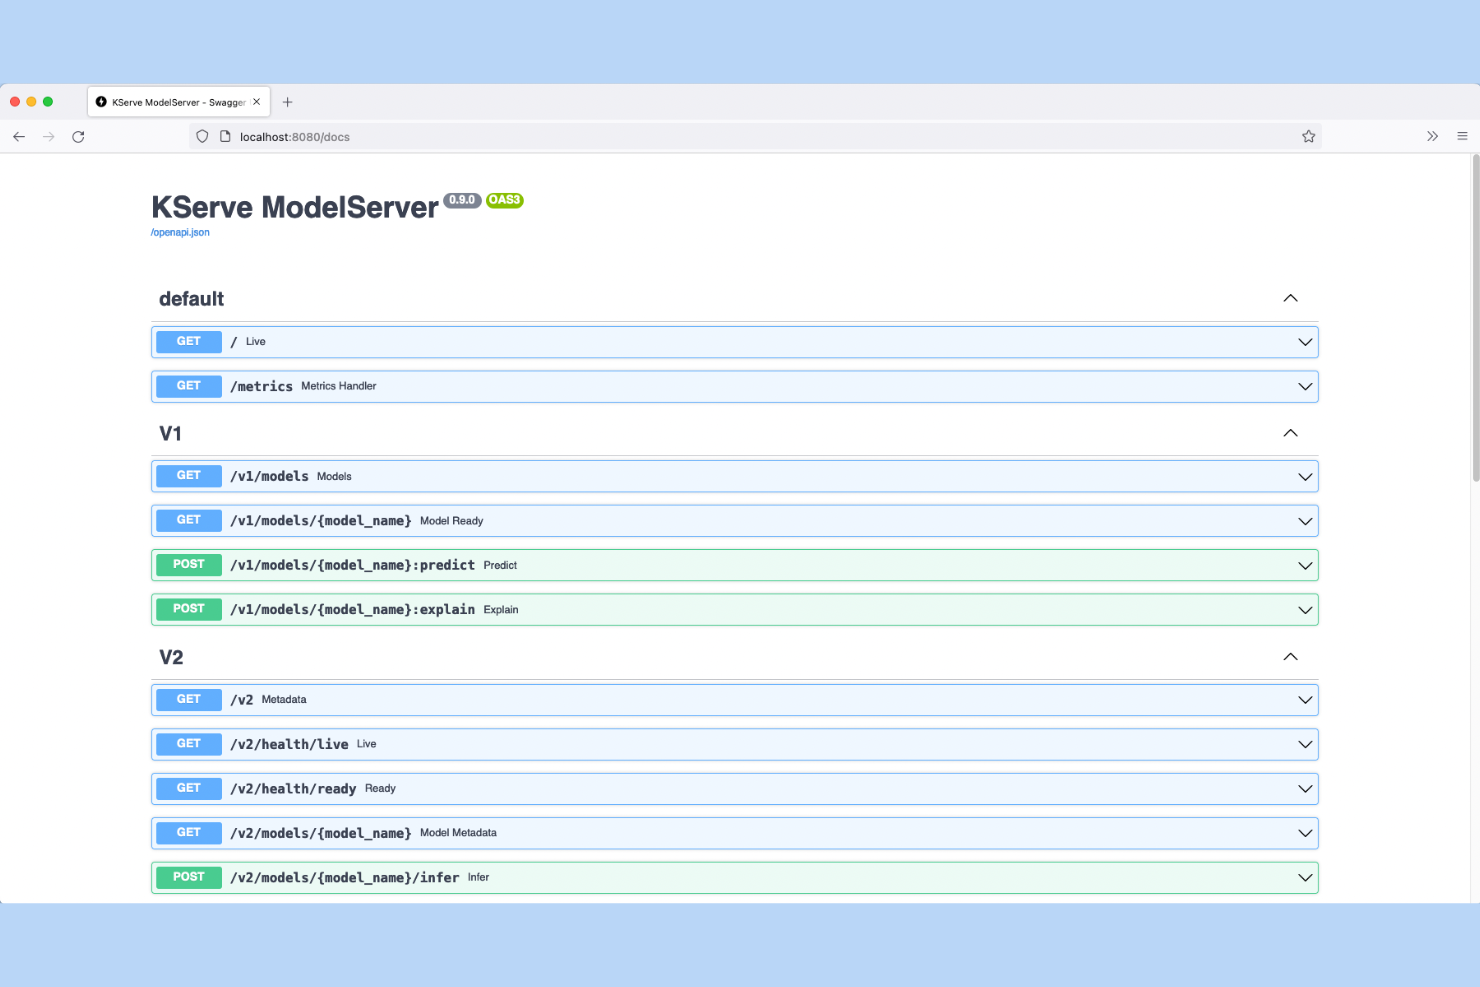
KServe es una plataforma de código abierto y nativa de Kubernetes para la inferencia de modelos que gestiona el servicio de modelos de múltiples marcos, los lanzamientos canarios, el escalado automático y la explicabilidad de modelos mediante una capa de API de inferencia estandarizada.
¿Para quién es más adecuado KServe?
KServe es una opción especialmente adecuada para equipos de ingeniería de aprendizaje automático de organizaciones medianas y grandes que ejecutan el servicio de modelos a escala en Kubernetes y necesitan una capa de inferencia independiente del marco.
Por qué elegí KServe
Elegí KServe como una de las mejores opciones porque está basado en el Protocolo de inferencia abierta (V2), una especificación de API estandarizada que permite a mi equipo cambiar los sistemas de servicio, como Triton o vLLM, sin reescribir el código del cliente. También utilizo su CRD InferenceService para definir declarativamente los lanzamientos canarios y dirigir un porcentaje del tráfico activo a una nueva versión del modelo antes de promocionarla por completo. Se admiten endpoints de inferencia REST y gRPC, por lo que no estoy limitado a una sola capa de transporte.
Características principales de KServe
- Escalado automático hasta cero: El escalado automático basado en Knative reduce a cero los pods de inferencia cuando están inactivos y los vuelve a activar bajo demanda.
- Transformadores de solicitudes/respuestas: La lógica de preprocesamiento y posprocesamiento se ejecuta como un contenedor transformador independiente junto al servidor de modelos.
- Lanzamientos canarios: Desplaza gradualmente el tráfico a una nueva versión del modelo, lo que permite probar cambios en producción sin exponerlos por completo.
- Registro de cargas útiles: Las solicitudes y respuestas de inferencia se registran en destinos configurables para crear registros de auditoría y supervisar los modelos.
Integraciones de KServe
KServe incluye integraciones nativas con Knative, Istio y la API de Gateway de Kubernetes para el escalado sin servidor y el enrutamiento de entrada. Incluye entornos de ejecución de servicio integrados para vLLM, llm-d, NVIDIA Triton Inference Server, Seldon MLServer, TorchServe y Hugging Face, y admite el almacenamiento de modelos en Amazon S3, Google Cloud Storage y Azure Blob Storage. También están disponibles un SDK de servicio de Python y API de inferencia REST/gRPC para integraciones personalizadas.
Pros and Cons
Pros:
- El escalado automático hasta cero reduce los costes de GPU inactiva
- Servicio independiente del marco mediante un protocolo de inferencia estandarizado
- Lanzamientos canarios integrados para realizar actualizaciones seguras
Cons:
- Requiere conocimientos especializados sobre clústeres de Kubernetes para su funcionamiento
- El modo sin servidor limita la personalización de los montajes de volúmenes

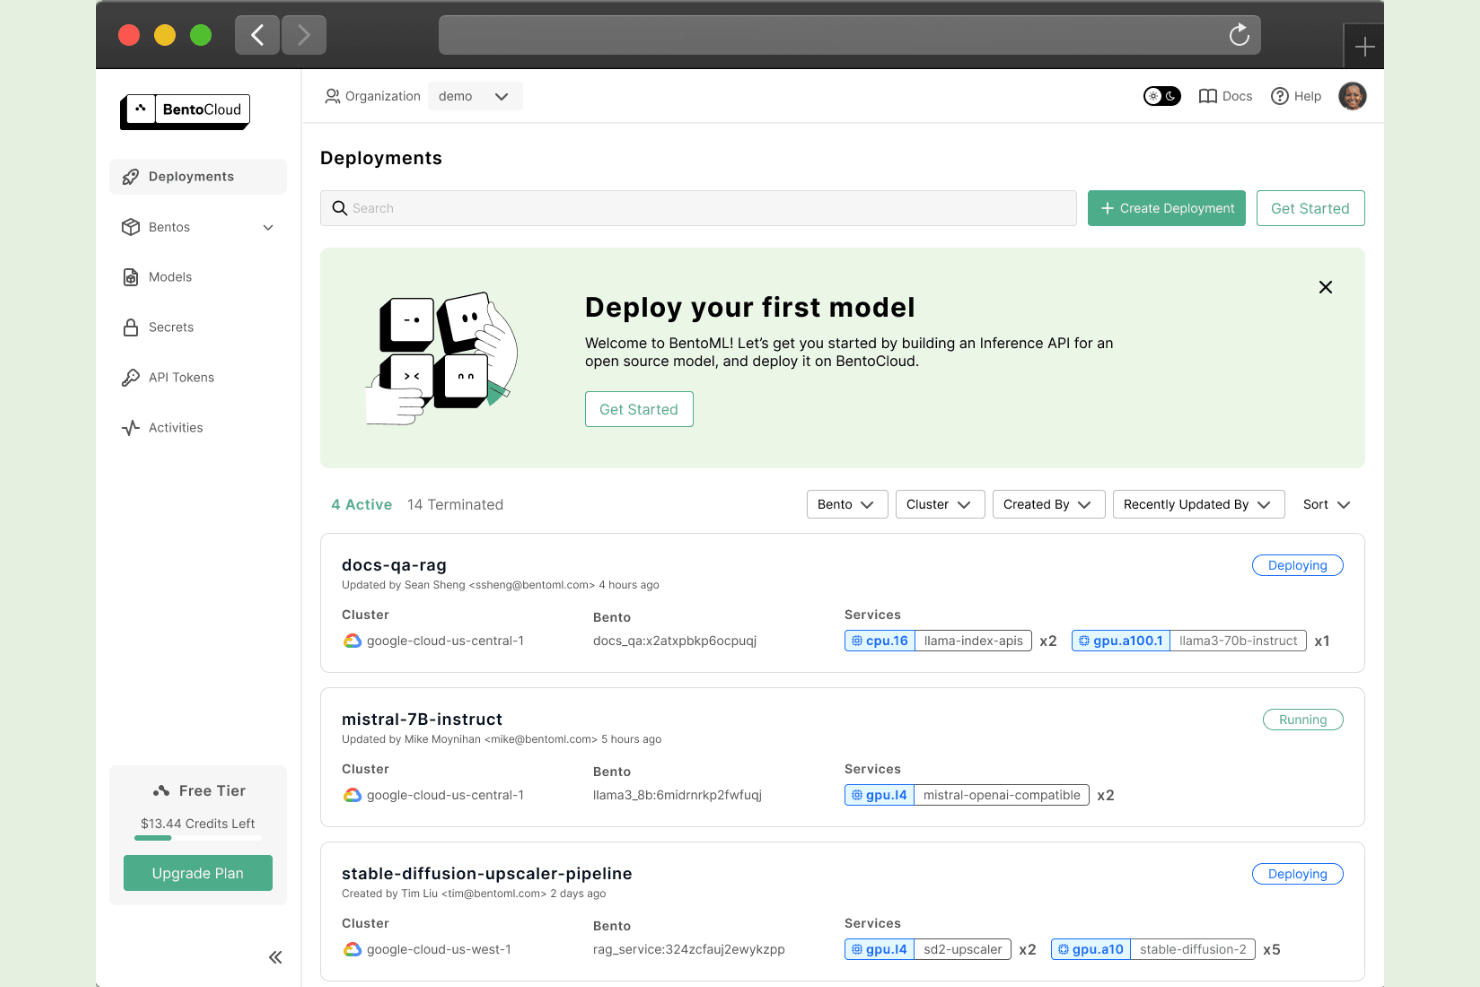
Construido en torno al concepto de un artefacto “Bento”, BentoML es un framework nativo de Python para la puesta en producción de modelos que gestiona la definición del servicio, la contenerización y el empaquetado de modelos de múltiples frameworks para su despliegue en producción.
¿Para quién es mejor BentoML?
BentoML es una excelente opción para equipos de aprendizaje automático en empresas en crecimiento que necesitan pasar rápidamente de un modelo entrenado a una API lista para producción sin una plataforma MLOps dedicada.
Por qué elegí BentoML
He incluido BentoML entre mis mejores opciones porque es uno de los pocos frameworks que trata el artefacto del modelo y la capa de servicio como una sola unidad versionada. Me gusta que BentoML genere automáticamente tanto endpoints REST como gRPC a partir de la misma definición de servicio, por lo que mi equipo no necesita mantener especificaciones de API separadas. La abstracción runner también me permite aislar cada modelo en su propio proceso, lo que significa que un paso de preprocesamiento basado en CPU no competirá por recursos con un runner de modelo en GPU.
Características clave de BentoML
- Batching adaptativo: Agrupa automáticamente solicitudes de inferencia concurrentes en un solo lote, reduciendo la sobrecarga de GPU por solicitud sin necesidad de cambios en el código.
- Métricas integradas con Prometheus: Expone un endpoint /metrics listo para usar para que puedas monitorizar la latencia de las solicitudes y el rendimiento sin instrumentación personalizada.
- Puerta de enlace LLM: Proporciona una interfaz API unificada para varios proveedores de LLM, otorgando control centralizado sobre el enrutamiento y los costes.
- Construcción de imágenes contenerizadas: Genera una imagen Docker lista para producción directamente desde un artefacto Bento usando un solo comando CLI.
Integraciones de BentoML
BentoML ofrece integraciones documentadas con herramientas del ecosistema MLOps, incluyendo Airflow, MLflow, Ray, Spark, Arize AI, Flink y Triton Inference Server. También se integra con Datadog para recopilar métricas de servicios BentoML. Hay una API disponible para integraciones personalizadas, y la salida contenerizada de BentoML funciona de forma nativa con Kubernetes y Docker para ofrecer flexibilidad de despliegue.
Pros and Cons
Pros:
- Versionado de modelos y seguimiento de rollback integrado
- Genera contenedores Docker a partir de configuración YAML
- Gestiona solicitudes concurrentes mediante escalado de workers
Cons:
- Los archivos de configuración pueden resultar innecesariamente complejos
- Los cargadores de modelos personalizados requieren configuración adicional

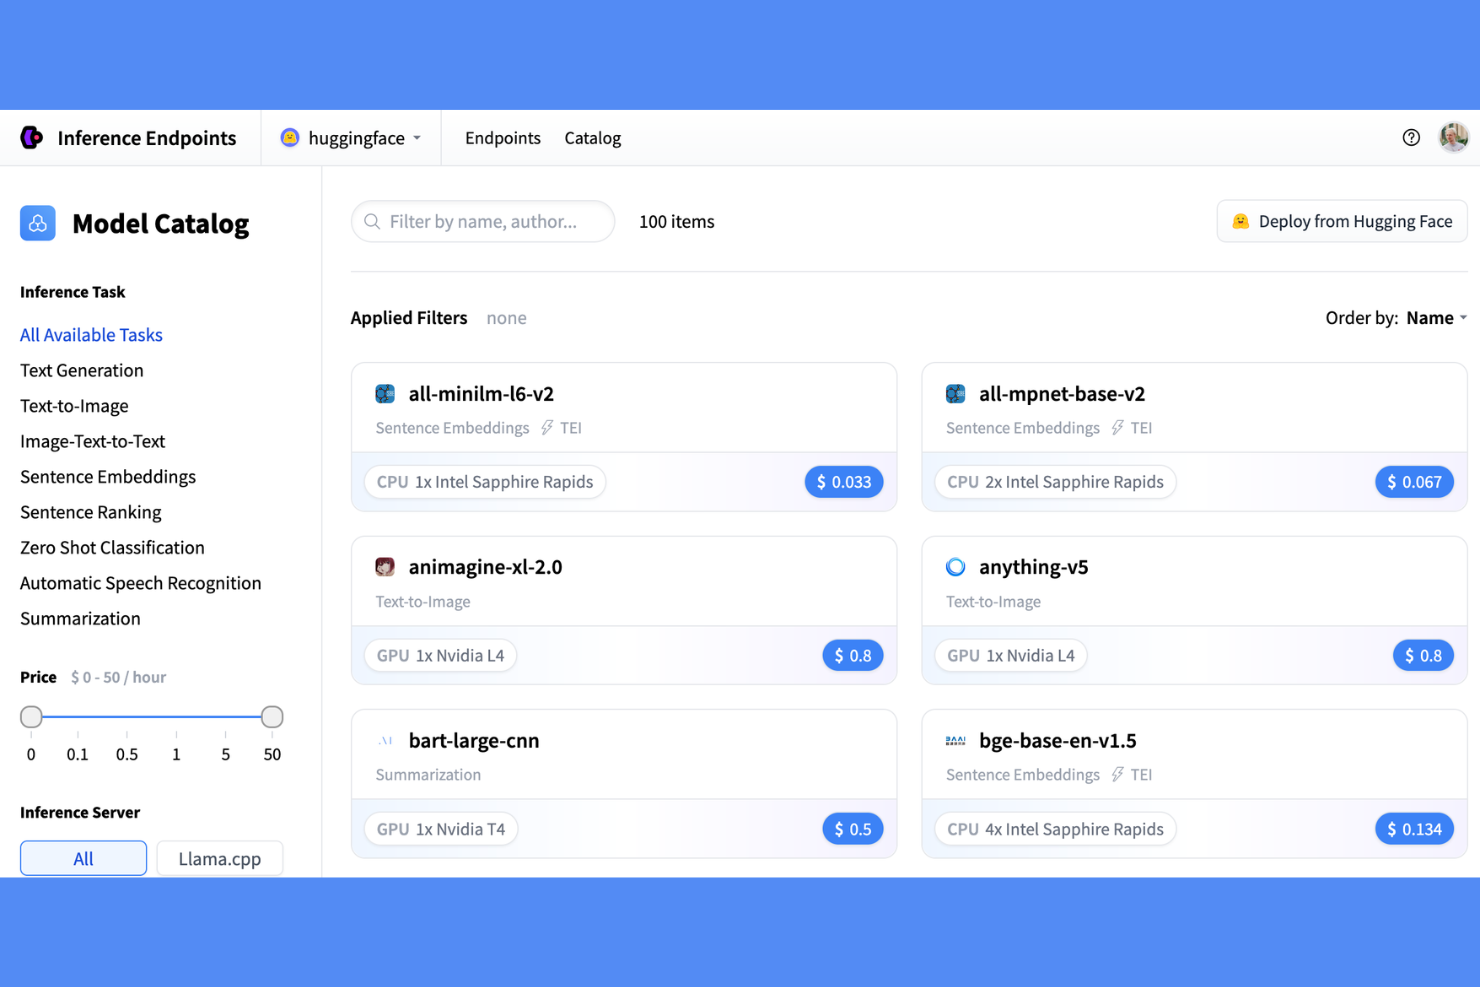
Una plataforma de inferencia gestionada construida sobre Hugging Face Hub, Hugging Face Inference Endpoints se encarga del despliegue dedicado en la nube, la configuración de los endpoints y la selección de hardware para modelos de ML en AWS, Azure y Google Cloud.
¿Para quién es ideal Hugging Face Inference Endpoints?
Es ideal para startups orientadas a la IA y empresas tecnológicas medianas que necesitan alojamiento de modelos listo para producción sin tener que construir y mantener su propia infraestructura de servicio.
Por qué elegí Hugging Face Inference Endpoints
Hugging Face Inference Endpoints se gana un lugar en mi lista porque está diseñado específicamente para el ecosistema de modelos transformer como ninguna otra plataforma de despliegue. Mi equipo puede tomar cualquier modelo del Hub, incluidos LLMs a gran escala y transformers multimodales, y servirlo a escala de producción con reglas de autoescalado configurables que responden al tráfico real. También me gusta la rapidez de pasar de cero al endpoint: un modelo que podría tardar días en contenerizar y desplegarse manualmente está activo en minutos.
Características clave de Hugging Face Inference Endpoints
- Despliegue multi-nube: Elige desplegar tu endpoint en AWS, Azure o Google Cloud sin gestionar cuentas independientes en la nube.
- Red privada: Aísla los endpoints dentro de una VPC dedicada para que solo tus sistemas internos puedan acceder a la API del modelo.
- Autenticación basada en tokens: Protege cada endpoint con un token de API para controlar qué servicios o usuarios pueden enviar solicitudes de inferencia.
- Monitorización de uso: Supervisa el volumen de solicitudes, la latencia y las tasas de error directamente desde el panel del endpoint en tiempo real.
Integraciones de Hugging Face Inference Endpoints
Hugging Face Inference Endpoints funciona con un ecosistema creciente de herramientas de desarrollo, frameworks y plataformas, y las herramientas sin soporte explícito suelen ser compatibles a través de su API compatible con OpenAI. Las integraciones documentadas incluyen AWS Bedrock y SageMaker, Google Gemini Enterprise Agent Platform y Azure AI Foundry, junto con frameworks de LLM como LangChain, LlamaIndex, Haystack, CrewAI y PydanticAI. Inference Endpoints puede gestionarse completamente mediante API, con endpoints documentados a través de Swagger, lo que permite crear integraciones personalizadas. El soporte con Zapier no está claramente documentado.
Pros and Cons
Pros:
- Despliegue con un clic desde el Hugging Face Hub
- Soporta múltiples motores de inferencia
- Autoescalado con facturación scale-to-zero
Cons:
- Arranques en frío cuando escala desde cero
- El coste del cómputo GPU aumenta rápidamente a escala

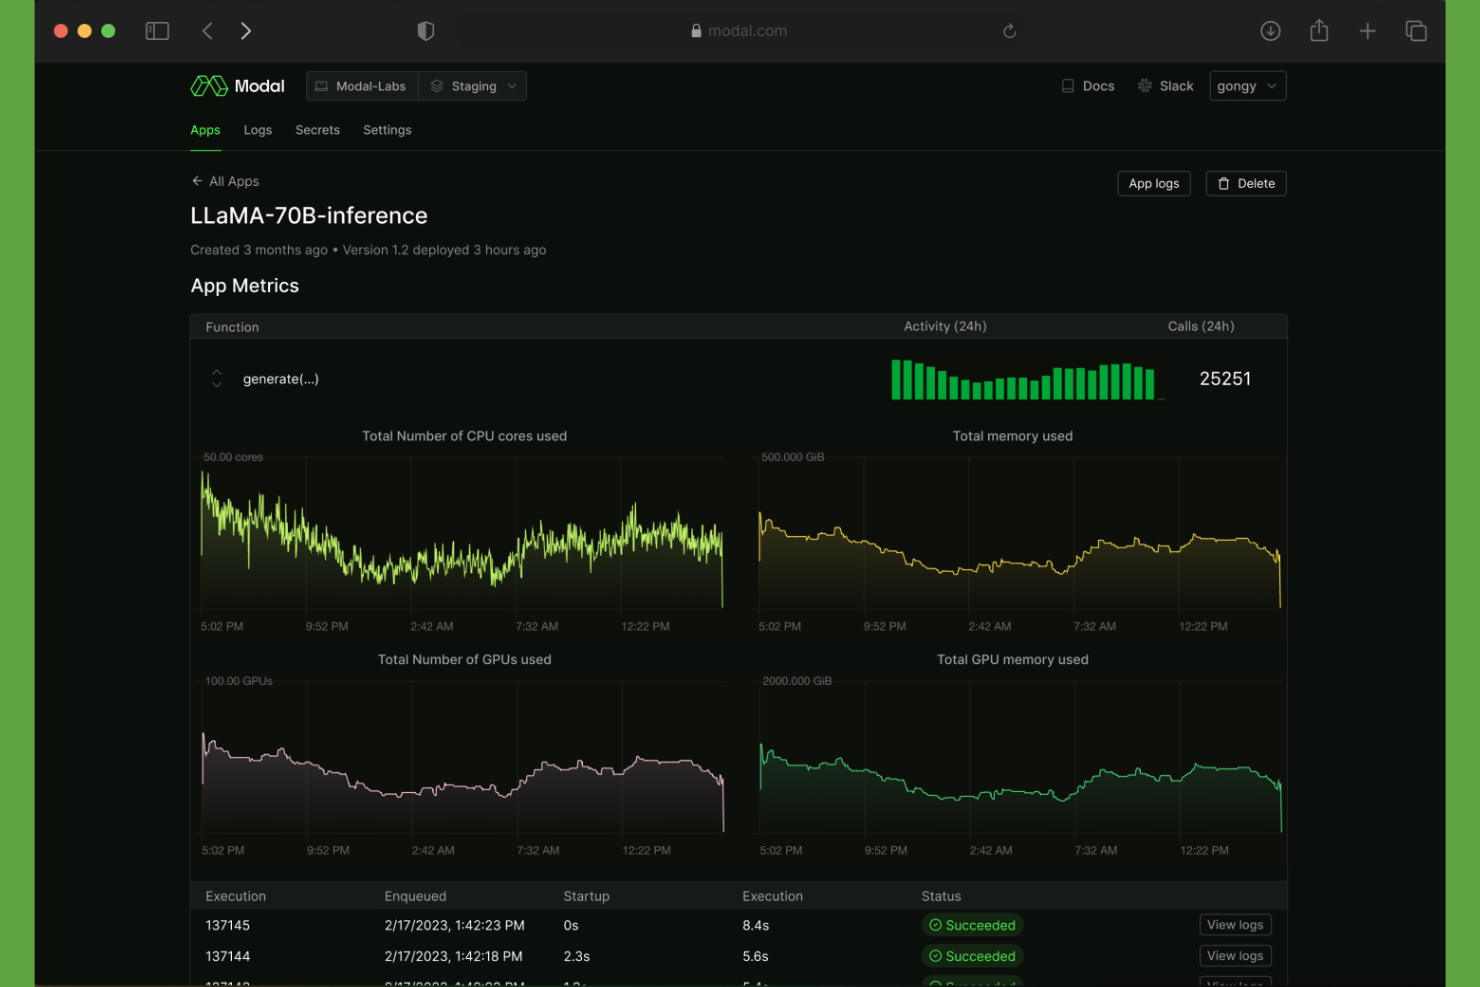
Modal es una plataforma en la nube sin servidor para ejecutar cargas de trabajo de aprendizaje automático basadas en Python, que abarca inferencias aceleradas por GPU, trabajos por lotes, ejecuciones de entrenamiento y tareas programadas sin necesidad de gestionar contenedores o infraestructura.
¿Para quién es ideal Modal?
Es una opción natural para startups y equipos en etapa de crecimiento que necesitan implementar modelos de aprendizaje automático rápidamente sin contratar ingenieros de infraestructura dedicados.
Por qué elegí Modal
He incluido Modal en mis mejores selecciones porque elimina la brecha entre escribir Python y ejecutarlo a escala en GPUs. Puedo solicitar hardware específico, como una A100 o H100, directamente en mi definición de función y Modal lo aprovisiona bajo demanda. No hay clústeres que gestionar ni archivos YAML que escribir. También me gusta que la misma función se ejecute de forma idéntica localmente y en producción, lo que reduce drásticamente el tiempo destinado a depuración.
Características clave de Modal
- Imágenes de contenedor personalizadas: Define dependencias, variables de entorno y paquetes de sistema directamente en el código, garantizando entornos de ejecución coherentes en todos los despliegues.
- Volúmenes persistentes: Monta volúmenes en la nube para almacenar en caché los pesos del modelo entre ejecuciones, reduciendo los tiempos de inicio en frío en implementaciones repetidas.
- Gestión de secretos: Almacena e inyecta claves API y credenciales de forma segura en tiempo de ejecución sin tener que codificarlas en tu base de código.
- Ejecución paralela por lotes: Utiliza .map() para ejecutar inferencia en grandes conjuntos de datos en paralelo a través de múltiples contenedores simultáneamente.
Integraciones de Modal
Modal ofrece un pequeño conjunto de integraciones documentadas centradas en la observabilidad y notificaciones, incluyendo Datadog, cualquier proveedor compatible con OpenTelemetry, Slack y Okta SSO. También es compatible con el montaje de buckets en la nube para AWS S3, Google Cloud Storage y Cloudflare R2, además de flujos de trabajo CI/CD a través de GitHub Actions. El soporte para Zapier no está documentado, pero Modal proporciona un SDK de Python y endpoints web que permiten integraciones personalizadas.
Pros and Cons
Pros:
- No se necesitan archivos Dockerfile ni configuración de Kubernetes
- Gestiona entrenamiento, procesamiento por lotes e inferencia
- Dirige cargas de trabajo a través de nubes y regiones
Cons:
- El código basado en decoradores crea dependencia de proveedor
- Las funciones empresariales requieren un precio de nivel premium

Amazon SageMaker (también conocido como AWS Sagemaker) es una plataforma de aprendizaje automático de AWS que abarca todo el ciclo de vida del modelo, desde el entrenamiento y ajuste fino hasta el despliegue, monitoreo y gobierno, dentro de un entorno de desarrollo unificado basado en arquitectura lakehouse.
¿Para Quién es Mejor Amazon SageMaker?
Amazon SageMaker es una excelente opción para equipos de ciencia de datos e ingeniería de ML que ya trabajan en el ecosistema de AWS.
Por Qué Elegí Amazon SageMaker
Amazon SageMaker se gana su lugar como uno de los mejores en mi lista porque cubre la gestión automatizada del modelo de extremo a extremo sin requerir la integración de herramientas separadas. Me gusta especialmente SageMaker MLOps, que gestiona la orquestación de pipelines, el registro de modelos y el seguimiento de despliegues en un solo lugar. También confío en las capacidades integradas de inferencia, operaciones de IA y observabilidad de SageMaker AI para monitorear los modelos después del despliegue y detectar desviaciones antes de que se conviertan en un problema en producción.
Funciones Clave de Amazon SageMaker
- SageMaker JumpStart: Accede a más de 1,000 modelos de IA preconstruidos de proveedores líderes y despliega o ajusta directamente en SageMaker.
- SageMaker HyperPod: Escala tareas de entrenamiento y ajuste fino a través de clústeres con cientos o miles de aceleradores de IA con gestión automatizada de clústeres.
- Inferencia multimodal: Despliega modelos usando inferencia en tiempo real, sin servidor, asíncrona o por lotes en más de 70 tipos de instancias.
- MLflow gestionado: Haz seguimiento, organiza y compara experimentos iterativos sin aprovisionamiento de infraestructura ni gestión de servidores.
Integraciones de Amazon SageMaker
Amazon SageMaker se integra de forma nativa en todo el ecosistema de AWS, incluyendo Amazon S3, Amazon Redshift, Amazon Athena, Amazon EMR y AWS Glue, junto con Amazon Bedrock y Amazon Q Developer. También funciona con herramientas de terceros como Datadog, Hugging Face, MLflow y Pinecone. Hay disponible una API para integraciones personalizadas.
Pros and Cons
Pros:
- Múltiples modos de inferencia para diferentes cargas de trabajo
- AutoML y ajuste de hiperparámetros integrados
- Pruebas en sombra para despliegues de modelos seguros
Cons:
- Está muy acoplado al ecosistema de AWS
- Es difícil depurar trabajos de entrenamiento fallidos

Ideal para flujos de trabajo unificados de datos e IA
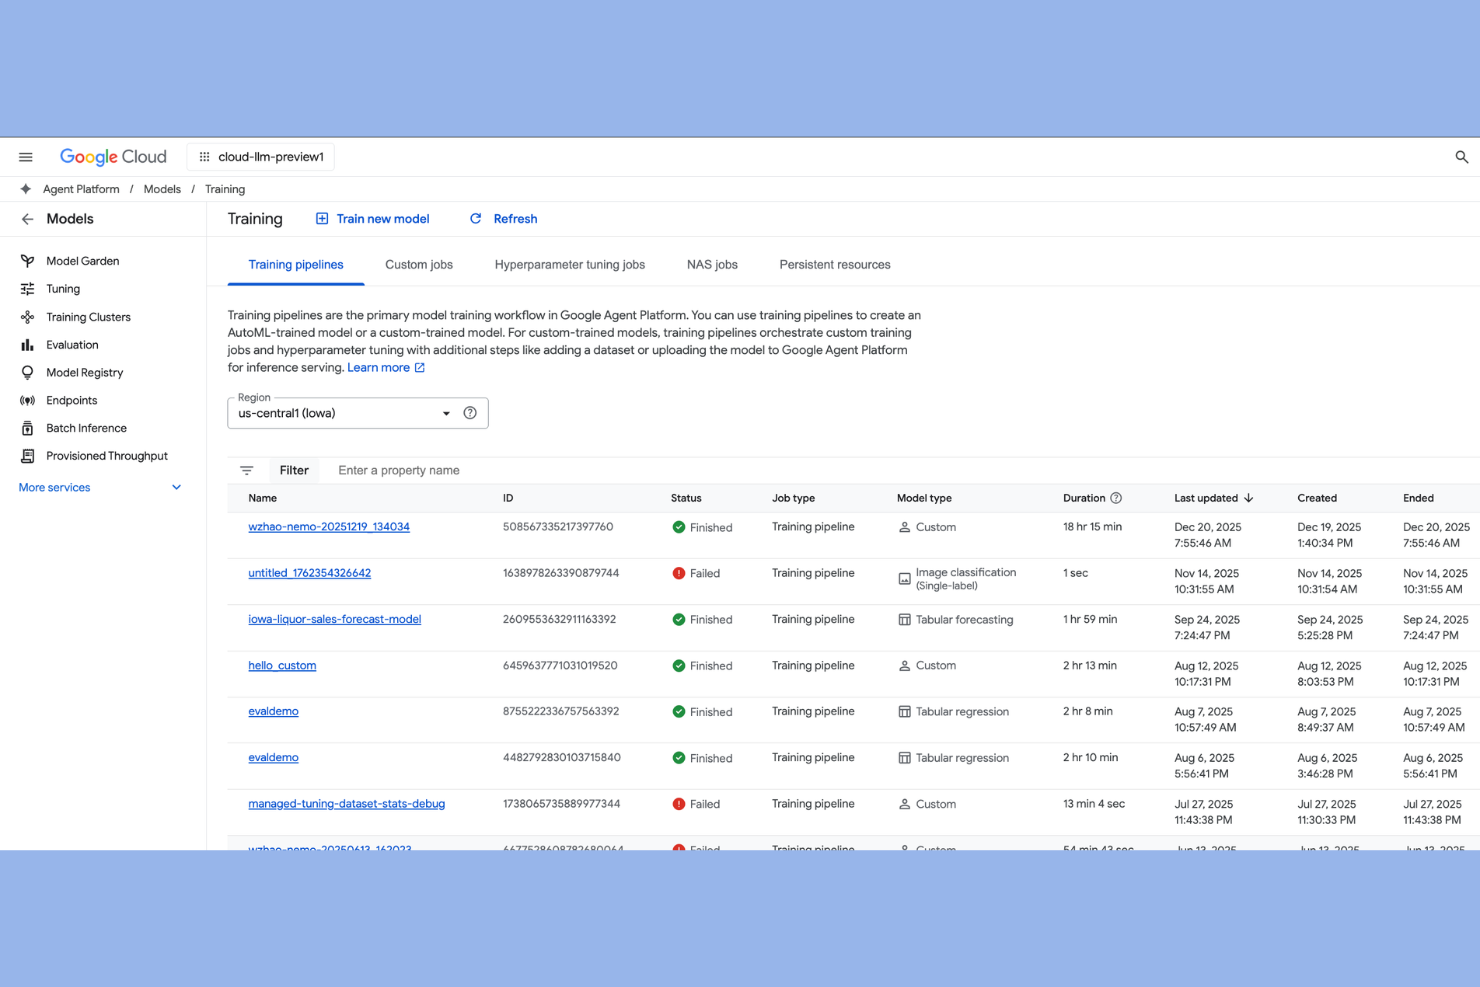
Gemini Enterprise Agent Platform (anteriormente Vertex AI) es la plataforma integral de aprendizaje automático de Google Cloud que abarca el entrenamiento, el ajuste fino, la evaluación y la implementación de modelos, así como el desarrollo de agentes de IA, todo dentro de un único entorno administrado.
¿Para quién es más adecuada Gemini Enterprise Agent Platform?
Gemini Enterprise Agent Platform es una opción natural para los equipos de ingeniería de aprendizaje automático y ciencia de datos que ya ejecutan su infraestructura de datos en Google Cloud Platform.
Por qué elegí Gemini Enterprise Agent Platform
He incluido Gemini Enterprise Agent Platform entre mis principales opciones porque realmente reduce la brecha entre la gestión de datos y la de modelos. Me gusta especialmente cómo las canalizaciones de Gemini Enterprise Agent Platform se conectan directamente con BigQuery, lo que permite a mi equipo crear canalizaciones de entrenamiento sobre datos activos del almacén sin exportar nada. El almacén de características de Gemini Enterprise Agent Platform también nos permite definir, ofrecer y supervisar características de forma coherente tanto durante el entrenamiento como durante la inferencia, lo que elimina una fuente importante de discrepancias entre el entrenamiento y el servicio.
Características principales de Gemini Enterprise Agent Platform
- Registro de modelos de Gemini Enterprise Agent Platform: Un repositorio centralizado para versionar, organizar y gestionar modelos durante todo su ciclo de vida, antes y después de la implementación.
- Puntos de conexión de predicción en línea: Implementa modelos en puntos de conexión dedicados que ofrecen predicciones en tiempo real, con capacidad de cómputo configurable y distribución del tráfico entre versiones de modelos.
- Supervisión de modelos de Gemini Enterprise Agent Platform: Detecta discrepancias en las características y desviaciones en las predicciones de los modelos implementados al comparar el tráfico activo con una línea base de datos de entrenamiento.
- Experimentos de Gemini Enterprise Agent Platform: Registra, compara y visualiza ejecuciones de entrenamiento iterativas para ayudar a los equipos a identificar las configuraciones de modelos con mejor rendimiento.
Integraciones de Gemini Enterprise Agent Platform
Gemini Enterprise Agent Platform se integra de forma nativa en todo el ecosistema de Google Cloud, incluidos BigQuery, Cloud Storage, Dataflow y Pub/Sub, además de ofrecer compatibilidad con Kubeflow Pipelines y contenedores prediseñados para TensorFlow, scikit-learn, XGBoost y PyTorch. Sus almacenes de datos también admiten conectores de datos de terceros para herramientas como Jira y Shopify. Está disponible en Zapier y cuenta con una API para integraciones personalizadas.
Pros and Cons
Pros:
- Model Garden ofrece más de 200 modelos implementables
- La implementación basada en puntos de conexión desde Model Garden es sencilla
- Integración nativa con BigQuery para flujos de trabajo de datos
Cons:
- Los puntos de conexión dedicados inactivos siguen generando cargos
- Las discrepancias en la región generan mensajes de error poco claros


Baseten es una plataforma de inferencia de modelos que permite a los equipos de aprendizaje automático (ML) implementar modelos personalizados, de código abierto y ajustados finamente con servicio acelerado por GPU, escalado automático y herramientas de optimización del rendimiento integradas directamente en la plataforma.
¿Para quién es ideal Baseten?
Baseten es adecuado para equipos de productos de IA en empresas en etapa de crecimiento que necesitan control total sobre el rendimiento de inferencia para implementaciones de modelos sensibles a la latencia o de alto rendimiento.
Por qué elegí Baseten
Baseten se gana su lugar en mi lista porque permite construir e implementar interfaces web personalizadas sobre tus modelos dentro de la misma plataforma, sin necesidad de una pila frontend independiente. Uso el generador de aplicaciones de Baseten para crear interfaces interactivas que llaman directamente a los endpoints de los modelos, lo que resulta útil para herramientas internas o demostraciones a partes interesadas. El modelo y su interfaz permanecen bajo control de versiones e implementados juntos.
Funciones clave de Baseten
- Empaquetado de modelos Truss: Empaqueta cualquier modelo personalizado o ajustado finamente como un artefacto de Python reproducible con gestión de dependencias incorporada y recarga en vivo para pruebas locales.
- Baseten Chains: Construye flujos de trabajo de IA compuestos de varios pasos donde cada paso se ejecuta en hardware configurado independientemente con su propia política de escalado automático.
- Gestión de secretos: Almacena e inyecta claves API y credenciales de entorno directamente en las implementaciones de modelos sin tener que incluirlas en el código de servicio.
- División de tráfico A/B: Deriva tráfico de inferencia en vivo entre varias versiones de modelos simultáneamente para comparar el rendimiento antes de promover completamente un nuevo despliegue.
Integraciones de Baseten
Baseten permite exportar métricas a Prometheus, Datadog, Grafana Cloud y New Relic a través de su endpoint de métricas basado en OpenTelemetry. Es totalmente compatible con OpenAI, por lo que puedes conectarlo a cualquier cliente o pasarela que utilice el SDK de OpenAI, incluyendo LiteLLM, LlamaIndex y Cloudflare AI Gateway. Hay una API disponible para integraciones personalizadas.
Pros and Cons
Pros:
- El empaquetado open-source Truss simplifica el despliegue de modelos
- Implementación con un clic desde checkpoints de entrenamiento
- Inicios en frío en menos de un segundo en instancias de GPU
Cons:
- La tarifa basada en uso puede variar de forma impredecible
- Requiere experiencia en ingeniería de ML para operar


Construido sobre el framework de código abierto Ray, Anyscale es una plataforma administrada para la prestación de modelos de ML que gestiona inferencias distribuidas, escalado automático y despliegues de múltiples modelos en clústeres de GPU y CPU.
¿Para quién es ideal Anyscale?
Anyscale es especialmente adecuado para ingenieros de ML y equipos de ciencia de datos en organizaciones medianas y grandes que ejecutan cargas de trabajo basadas en Python a escala y necesitan gestión de clústeres de GPU sin la sobrecarga manual de infraestructura.
Por qué elegí Anyscale
Elegí Anyscale como uno de los mejores porque es la única plataforma administrada construida directamente sobre Ray, lo que significa que mi equipo puede escribir Python estándar para definir la lógica distribuida de prestación sin aprender un DSL de orquestación separado. Me gusta especialmente la API de gráficos de despliegue de Ray Serve, que me permite componer múltiples modelos en una única canalización de inferencia con rutas de solicitud explícitas. La asignación fraccionaria de GPU es otra característica que uso habitualmente para empaquetar modelos ligeros en hardware compartido sin tener que iniciar instancias dedicadas.
Características clave de Anyscale
- Escalado automático: Escala automáticamente el número de réplicas hacia arriba o hacia abajo según el rendimiento de solicitudes en tiempo real y la profundidad de la cola.
- División de tráfico: Dirige un porcentaje configurable del tráfico en vivo a nuevas versiones de modelos para implementaciones graduales sin tiempo de inactividad.
- Agrupación de solicitudes: Agrupa las solicitudes de inferencia entrantes en lotes para maximizar el uso de GPU entre llamadas concurrentes.
- Prestación de modelos multi-nodo: Distribuye un solo modelo grande entre varios nodos cuando este supera los límites de memoria de una sola GPU.
Integraciones de Anyscale
Anyscale se integra con las bibliotecas y frameworks de IA/ML más populares, con más de 50 integraciones que abarcan plataformas de datos, orquestación, frameworks de ML, observabilidad y frameworks para aplicaciones LLM. Entre ellas se incluyen MLflow, Weights & Biases, MongoDB, Snowflake, Databricks, Hugging Face, PyTorch y TensorFlow, además de Airflow, Prefect, Dagster, Datadog, LangChain y LlamaIndex. Hay una API disponible para integraciones personalizadas, y la plataforma también se despliega como servicio de primera parte en Amazon EKS, Google GKE, Azure AKS y OCI Kubernetes Engine.
Pros and Cons
Pros:
- Escala código Python en clústeres distribuidos de GPU
- Prestación de modelos independiente del framework a través de Ray Serve
- Soporte para instancias spot con tolerancia a fallos automática
Cons:
- Estrechamente acoplado al ecosistema Ray
- Requiere amplios conocimientos de sistemas distribuidos

Otras herramientas de implementación de modelos de ML
Estas son algunas herramientas adicionales de implementación de modelos de ML que no llegaron a mi lista de preseleccionadas, pero que aun así vale la pena consultar:


Cómo evalúo las herramientas de despliegue de modelos de ML
Evalúo cada herramienta en dos niveles: la base para desplegar un modelo PyTorch en un endpoint REST con escalado automático y monitoreo de deriva, y los diferenciadores que importan para los equipos de MLOps.
Funcionalidad principal (Requisitos básicos para esta lista)
Cuando selecciono herramientas para mi lista, califico cada una en una escala del 0 (no ofrece la funcionalidad) al 5 (destaca en esta área) para cada funcionalidad principal que se lista a continuación. Luego, calculo la puntuación total de la herramienta como un porcentaje. Cada herramienta necesita alcanzar una puntuación mínima total del 65% para ser considerada.
- Servicio de modelos e inferencia: Analizo si la herramienta puede alojar modelos detrás de endpoints REST o gRPC para predicciones en tiempo real y si también gestiona inferencia por lotes para trabajos de puntuación en modo offline.
- Soporte para múltiples frameworks: Verifico qué frameworks de ML se incluyen de forma nativa—como TensorFlow, PyTorch, XGBoost y ONNX—y si hay opción de contenedores personalizados para runtimes menos comunes.
- Versionado y registro de modelos: Un registro sólido te permite rastrear artefactos de modelos, metadatos y linaje para que puedas revertir un despliegue problemático en minutos en vez de buscar a ciegas el artefacto correcto.
- Escalabilidad y gestión de recursos: Evalúo cómo funciona el escalado automático bajo carga, si la asignación de GPU y CPU es configurable y si la herramienta soporta escalado hasta cero para reducir costes cuando está inactiva.
- Monitoreo y observabilidad: Los modelos en producción se degradan en silencio, así que busco detección de deriva de datos, seguimiento de latencia de predicción y alertas que señalen problemas de rendimiento antes de que afecten a los usuarios finales.
- CI/CD y automatización del despliegue: Considero si la herramienta soporta pipelines automatizados con estrategias de despliegue progresivo como canary o pruebas A/B, además de triggers basados en Git para el re-despliegue de modelos.
Una vez tengo una lista de herramientas que cumplen estos criterios, considero qué distingue a cada plataforma.
Factores diferenciadores (Lo que distingue a los proveedores)
Así es como comparo y contrasto diferentes proveedores:
Características sobresalientes
Los despliegues canary y en sombra distinguen a las herramientas. Busco la capacidad de enrutar una porción del tráfico en vivo a una nueva versión del modelo mientras la versión actual sigue sirviendo; esto permite detectar regresiones de precisión antes de que lleguen a todos los usuarios. La optimización para GPU es otra clave: el batching dinámico y el soporte de cuantización mediante aceleradores como NVIDIA Triton o TensorRT pueden reducir drásticamente el coste por predicción en volúmenes altos. Escalar a cero también es fundamental, ya que los endpoints inactivos consumiendo horas de GPU pueden elevar rápidamente los costes en cargas de trabajo con alta demanda de inferencias.
Más allá de las características
La integración al ecosistema MLOps es clave: reviso si la herramienta conecta con rastreadores de experimentos como MLflow o Weights & Biases, orquestadores como Airflow y sistemas de CI/CD como GitHub Actions. La flexibilidad de infraestructura es igualmente importante: los equipos en industrias reguladas suelen requerir opciones de Kubernetes autogestionado o BYOC en vez de un SaaS puro. También evalúo políticas de gobernanza y cumplimiento, especialmente RBAC, registros de auditoría y certificaciones como SOC 2 o HIPAA, que los equipos de seguridad empresarial exigirán durante la adquisición.
Cómo elegir herramientas de implementación de modelos de ML
Es fácil perderse entre largas listas de funciones y estructuras de precios complejas. Para ayudarte a mantener la atención mientras avanzas en tu proceso único de selección de software, aquí tienes una lista de factores que debes tener en cuenta:
| Factor | Qué debes considerar |
|---|---|
| Escalabilidad | ¿La herramienta gestionará aumentos repentinos del tráfico de inferencia sin intervención manual? Comprueba que admita tanto situaciones de máxima demanda como de bajo volumen. |
| Integraciones | ¿La plataforma se conecta de forma nativa con tus sistemas de seguimiento de experimentos, herramientas de CI/CD o almacenes de datos, o tendrás que crear y mantener código personalizado? |
| Personalización | ¿Puedes adaptar los flujos de trabajo de implementación, los controles de acceso a los modelos y la gestión de recursos para ajustarlos a tus políticas específicas y a la estructura de tu equipo? |
| Facilidad de uso | ¿Qué tan pronunciada es la curva de aprendizaje para tu equipo? Considera la complejidad de la interfaz de usuario, la calidad de la documentación y si la incorporación ralentizará otros proyectos. |
| Implementación e incorporación | ¿Cuánto tiempo de ingeniería se necesitará para pasar de la prueba a la producción? Presta atención a pasos de configuración ocultos, requisitos previos de red o formación obligatoria. |
| Coste | ¿Los modelos de precios son transparentes y predecibles a medida que aumenta el uso? Compara los métodos de facturación —por predicción, por hora de cómputo o por punto de conexión— para tus cargas de trabajo. |
| Medidas de seguridad | ¿Qué mecanismos de cifrado, control de acceso y auditoría existen? Evalúa si la oferta cumple tus estándares internos de seguridad y las necesidades de tus clientes. |
| Requisitos de cumplimiento | ¿Necesitarás HIPAA, GDPR o SOC 2 Type II? Confirma que el proveedor proporcione las certificaciones necesarias y admita los registros de auditoría requeridos para tu sector. |
¿Qué son las herramientas de implementación de modelos de ML?
Las herramientas de implementación de modelos de ML son plataformas que ayudan a poner en funcionamiento modelos de aprendizaje automático entrenados, haciéndolos disponibles mediante API o puntos de conexión por lotes para su uso en el mundo real. Estas herramientas gestionan tareas como la entrega de modelos, el escalado, la supervisión y el control de versiones, para que puedas ofrecer predicciones precisas y mantener la fiabilidad a medida que evolucionan las cargas de trabajo.
Características
Al seleccionar herramientas de implementación de modelos de ML, presta atención a las siguientes características clave:
- Compatibilidad con múltiples marcos de trabajo: Implementa modelos creados con TensorFlow, PyTorch, scikit-learn, XGBoost y ONNX sin tener que rehacer el código del modelo ni realizar pasos de conversión.
- Inferencia con escalado automático: Asigna automáticamente recursos informáticos según los patrones de tráfico, gestionando aumentos repentinos o períodos de poca actividad para mantener tanto el rendimiento como la rentabilidad.
- Control de versiones de modelos: Realiza un seguimiento de las distintas versiones de los modelos, lo que facilita revertir cambios, compararlos o promover modelos en canalizaciones de producción con una interrupción mínima.
- Implementaciones canary y en segundo plano: Permite realizar implementaciones graduales o replicar el tráfico en directo, para que puedas validar nuevos modelos de forma segura con datos del mundo real antes de la implementación completa.
- Entrega por lotes y en tiempo real: Admite casos de uso de API en tiempo real y procesamiento por lotes asíncrono, lo que proporciona flexibilidad en aplicaciones empresariales o flujos de trabajo de ciencia de datos.
- Gestión de recursos: Permite asignar y supervisar el uso de CPU, GPU y memoria por modelo, lo que ayuda a optimizar los costes y mantener el estado del servicio en producción.
- Medidas de seguridad: Incluye control de acceso, cifrado y aislamiento de red para proteger los artefactos de los modelos y los datos confidenciales de inferencia.
- Compatibilidad con integraciones: Se conecta de forma nativa o mediante API con herramientas de MLOps, canalizaciones de CI/CD e infraestructura de datos para agilizar la entrega y la supervisión continuas.
- Registro y supervisión: Proporciona visibilidad sobre los registros de solicitudes, las métricas de latencia y las tasas de error para facilitar la resolución proactiva de problemas y la fiabilidad operativa.
- Cumplimiento y capacidad de auditoría: Ofrece funciones como registros de auditoría y compatibilidad con el cumplimiento normativo, lo que ayuda a cumplir los requisitos del sector sanitario, financiero u otros ámbitos regulados.
Características comunes de AI
Además de las características estándar de las herramientas de implementación de modelos de ML mencionadas anteriormente, muchas de estas soluciones están incorporando AI con funciones como:
- Detección automatizada de desviaciones: Utiliza AI para supervisar los datos entrantes y las predicciones en busca de cambios en la distribución, y alerta a los equipos cuando es necesario volver a entrenar el modelo o realizar una investigación para mantener su precisión.
- Asignación inteligente de recursos: Aplica algoritmos de AI para predecir los patrones de carga de trabajo y asignar dinámicamente recursos informáticos, reduciendo costes y minimizando la latencia sin ajustes manuales.
- Implementaciones con autorreparación: Utiliza AI para detectar puntos de conexión de modelos que han fallado o cuyo rendimiento se ha degradado, y redirige automáticamente el tráfico o activa una nueva implementación, minimizando el tiempo de inactividad y la intervención manual.
- Escalado predictivo: Utiliza AI para pronosticar aumentos o disminuciones del tráfico basándose en el uso histórico, y escala de forma proactiva la infraestructura para garantizar un rendimiento constante y controlar los costes.
- Detección de anomalías en la inferencia: Emplea AI para señalar en tiempo real solicitudes de predicción inusuales o sospechosas, ayudando a los equipos a identificar posibles problemas de calidad de los datos o amenazas de seguridad.
- Análisis automatizado de la causa raíz: Utiliza AI para analizar registros y métricas, identificando el origen de las disminuciones de rendimiento o los errores para que los equipos puedan resolver los problemas más rápido y con menos conjeturas.
Beneficios
La implementación de herramientas de implementación de modelos de ML ofrece varias ventajas para tu equipo y tu empresa. Estas son algunas de las que puedes esperar:
- Ciclos de implementación acelerados: El empaquetado y el control de versiones automatizados, junto con la integración con canalizaciones de CI/CD, permiten a los equipos trasladar rápidamente los modelos del desarrollo a la producción.
- Escalabilidad coherente: El autoescalado y la gestión dinámica de recursos garantizan que las implementaciones mantengan su estabilidad y capacidad de respuesta a medida que cambia la demanda.
- Postura de seguridad más sólida: Los controles de acceso integrados, el cifrado y el registro de auditoría ayudan a proteger los modelos y los datos confidenciales de acuerdo con los requisitos organizativos y normativos.
- Menor carga operativa: La supervisión, las alertas y el registro centralizados minimizan la resolución manual de problemas y liberan recursos de ingeniería para tareas de mayor valor.
- Gobernanza fiable de modelos: La gestión de versiones y el registro de implementaciones facilitan el seguimiento de los modelos, la reversión de cambios y la demostración del cumplimiento durante las auditorías.
- Integración flexible de flujos de trabajo: La compatibilidad con múltiples marcos de trabajo, estrategias de implementación y configuraciones de entornos permite a los equipos adaptar las capacidades de las herramientas a sus necesidades empresariales.
- Mejor preparación para el cumplimiento: Los registros de auditoría integrales y las funciones de cumplimiento simplifican el cumplimiento de los requisitos de HIPAA, GDPR o de sectores específicos, reduciendo el riesgo para las empresas reguladas.
Costes y precios
La selección de herramientas de implementación de modelos de ML requiere comprender los distintos modelos de precios y planes disponibles. Los costes varían en función de las funciones, el tamaño del equipo, los complementos y otros factores. La tabla siguiente resume los planes habituales, sus precios medios y las funciones que suelen incluir las soluciones de herramientas de implementación de modelos de ML:
Tabla comparativa de planes
| Tipo de plan | Precio medio | Funciones habituales |
|---|---|---|
| Plan gratuito | $0 | Implementaciones limitadas, supervisión básica, acceso para un solo usuario y asistencia de la comunidad. |
| Plan personal | $10-$30/usuario/mes | Uso individual, control de versiones estándar de modelos, asignación moderada de recursos y asistencia por correo electrónico. |
| Plan empresarial | $40-$100/usuario/mes | Colaboración en equipo, autoescalado, asistencia para la integración, seguridad mejorada y controles de acceso basados en roles. |
| Plan corporativo | $150-$500+/usuario/mes | Cumplimiento avanzado, asistencia premium, infraestructura dedicada, SLA personalizados y herramientas ampliadas de auditoría y seguridad. |
Preguntas frecuentes sobre herramientas de implementación de modelos de ML
Estas son algunas respuestas a preguntas frecuentes sobre las herramientas de implementación de modelos de ML:
¿En qué se diferencian las herramientas de implementación de modelos de ML de las herramientas tradicionales de implementación de aplicaciones?
Las herramientas de implementación de modelos de ML están diseñadas para abordar los desafíos específicos de servir, supervisar y actualizar modelos de aprendizaje automático, como gestionar las versiones de los modelos, realizar un seguimiento de los registros de inferencia, admitir el autoescalado del tráfico de los modelos e integrarse con canalizaciones de datos. Las herramientas tradicionales de implementación de aplicaciones normalmente no gestionan este tipo de requisitos.
¿Puedo implementar modelos creados con distintos marcos de trabajo utilizando la misma herramienta de implementación?
Sí, la mayoría de las herramientas de implementación de modelos de ML ofrecen compatibilidad con múltiples marcos de trabajo, lo que permite implementar modelos de TensorFlow, PyTorch, XGBoost y otros sin conversiones ni reescrituras manuales. Esto facilita que los equipos trabajen con distintas tecnologías y estandaricen los procesos de producción.
¿Qué funciones de seguridad conviene buscar en estas herramientas?
Busca funciones como controles de acceso, puntos de conexión cifrados, registros de auditoría y aislamiento de red. Estas funciones ayudan a garantizar que solo los usuarios autorizados puedan implementar o actualizar modelos y a mantener seguros los activos de los modelos y los datos de las predicciones.
¿Admiten estas herramientas tanto la inferencia en tiempo real como la inferencia por lotes?
Sí, las principales herramientas de implementación de modelos de ML admiten tanto la prestación de predicciones en tiempo real mediante API como los modos de procesamiento por lotes. Esto proporciona a tu equipo flexibilidad para gestionar distintos casos de uso, desde aplicaciones orientadas al usuario hasta grandes tareas de puntuación sin conexión.
¿Cómo ayudan estas herramientas a supervisar y mantener los modelos?
Proporcionan paneles de supervisión integrados, alertas, registros y detección automatizada de deriva. Estas funciones permiten detectar a tiempo la degradación del rendimiento, los problemas de datos o los errores operativos, a menudo antes de que afecten a los usuarios finales o a los resultados empresariales.