

Como profesional experimentado en el uso de API, microservicios y toda una serie de tecnologías de pila completa, reconozco el papel fundamental de una supervisión eficaz del rendimiento. A lo largo de los años, he experimentado de primera mano las ventajas de utilizar plataformas AIOps integrales, como estas alternativas a Dynatrace, que ofrecen capacidades rápidas de resolución de problemas y análisis de la causa raíz.
Estos sustitutos de Dynatrace no solo son fáciles de usar, sino que también impresionan por sus sólidas funciones de supervisión. La integración fluida con plataformas populares como Slack ayuda a mejorar la comunicación del equipo durante situaciones críticas. Con amplias funciones de creación de perfiles y soluciones modulares a tu disposición, contarás con una potente plataforma de supervisión capaz de impulsar tu pila tecnológica y tu productividad general.
¿Qué es Dynatrace?
Dynatrace es una plataforma de supervisión del rendimiento de aplicaciones (APM) que te ayuda a realizar un seguimiento, analizar y optimizar el funcionamiento de tus aplicaciones e infraestructura. La utilizan equipos de DevOps, SRE y responsables de TI que necesitan detectar los problemas con antelación y mejorar la experiencia del usuario. La supervisión en tiempo real, las alertas basadas en IA y el rastreo integral ayudan a encontrar ralentizaciones, identificar las causas raíz y mantener los sistemas funcionando sin problemas. En general, Dynatrace ayuda a tu equipo a anticiparse a los problemas de rendimiento antes de que afecten a los usuarios.
Por qué confiar en nuestras recomendaciones de software
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Nuestro equipo lleva probando y evaluando software desde 2012. Como líderes tecnológicos, sabemos lo difícil —y lo importante— que es elegir el software adecuado.
Para esta guía, evaluamos las herramientas mediante pruebas prácticas e investigación independiente, puntuando las herramientas según nuestros criterios de selección.
Nuestras reseñas reflejan nuestro criterio editorial humano, no un discurso de ventas.
Revisores expertos:
- Paulo Gardini MiguelDirector técnico
 Tim FisherVP de IA
 Gabriel RosasTech Lead y arquitecto de software
 Christhian GruhnTech Lead y arquitecto de plataforma

Tabla comparativa de alternativas a Dynatrace
Esta tabla comparativa resume los detalles de precios de mis principales alternativas seleccionadas a Dynatrace:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | La mejor solución para resolver errores en tiempo real | Plan gratuito disponible | Desde $26/mes (facturado anualmente) | Website | |
| 2 | Ideal para una amplia compatibilidad tecnológica | Plan gratuito disponible | Desde $32.92/mes (facturado anualmente) | Website | |
| 3 | Mejor para entornos de aplicaciones diversos | Prueba gratuita de 30 días | Desde $10/mes | Website | |
| 4 | Mejor para la monitorización integral de infraestructuras de TI | Prueba gratuita de 30 días | Desde $2,595 pago único | Website | |
| 5 | Mejor para el seguimiento unificado de servicios en la nube | No | Desde $15/mes (facturado anualmente) | Website | |
| 6 | La mejor opción para la supervisión de código abierto a nivel empresarial | No | Gratis | Website | |
| 7 | La mejor opción para obtener visibilidad del rendimiento empresarial en tiempo real | No | Desde $6/vCPU/mes (facturado anualmente) | Website | |
| 8 | La mejor opción para consultar la telemetría en un almacén de datos unificado | No | $12/user/month (facturado anualmente) | Website | |
| 9 | Más adecuado para la gestión de registros y el análisis de seguridad | No | $108 por usuario al mes (facturado anualmente) | Website | |
| 10 | Ideal para el análisis de datos y la obtención de información a gran escala | No | $150/usuario/mes | Website |


Análisis de las mejores alternativas a Dynatrace
A continuación encontrarás mis resúmenes detallados de las mejores alternativas a Dynatrace que han llegado a mi lista. Mis análisis ofrecen una visión detallada de las funciones principales, ventajas & desventajas, integraciones y casos de uso ideales de cada herramienta para ayudarte a encontrar la mejor opción para ti.
 La mejor solución para resolver errores en tiempo real
- Plan gratuito disponible
- Desde $26/mes (facturado anualmente)
Visit WebsiteCustomer Rating:4.5/5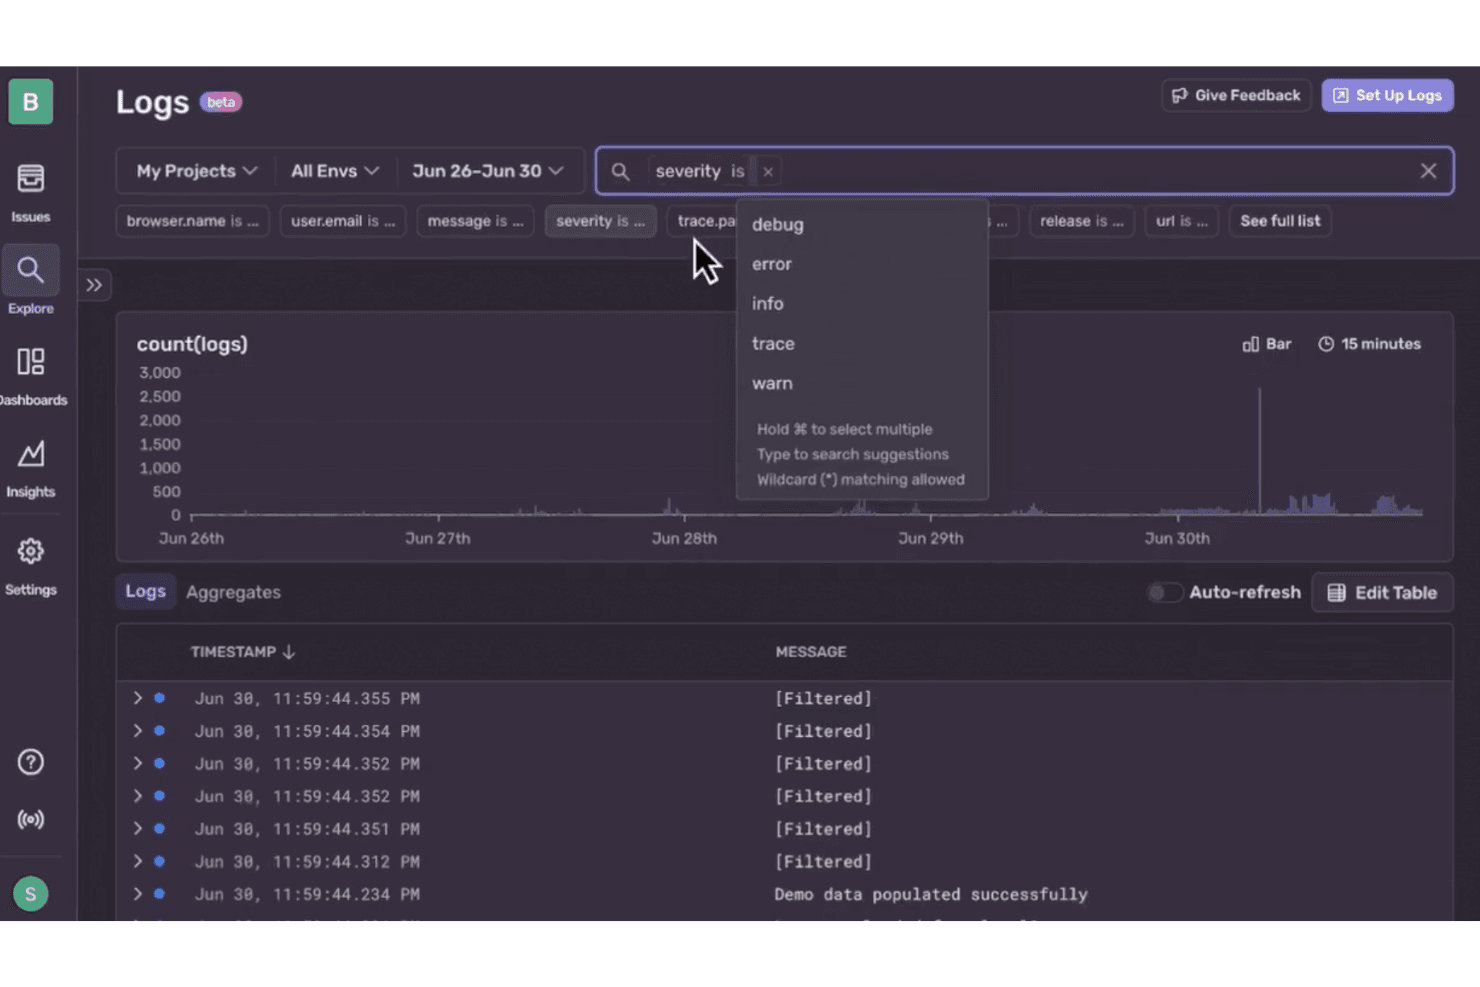
Sentry permite a los usuarios filtrar los registros por niveles de gravedad, como depuración, error o advertencia. Sentry combina la supervisión del rendimiento de las aplicaciones con el seguimiento de errores, ofreciendo a los equipos de software una alternativa centrada en los desarrolladores a Dynatrace para diagnosticar problemas en aplicaciones y servicios.
¿Para quién es mejor Sentry?
Sentry es una buena opción para los equipos de ingeniería de software y DevOps que necesitan identificar y resolver errores de producción en tiempo real.
Por qué elegí Sentry
Elegí Sentry como mi opción para “La mejor solución para resolver errores en tiempo real” porque vincula los errores de producción con los seguimientos de pila y los datos de trazas, lo que ayuda a los desarrolladores a localizar las rutas de código que fallan. La supervisión del estado de las versiones y el seguimiento de regresiones también pueden revelar cuándo una implementación introduce nuevos problemas, de modo que los equipos pueden priorizar las correcciones mientras supervisan el rendimiento de las aplicaciones.
Características principales de Sentry
- Perfilado continuo: Consulta perfiles de CPU a nivel de función para las aplicaciones compatibles.
- Métricas web esenciales: Realiza un seguimiento de métricas del navegador, como la carga de las páginas y la capacidad de respuesta a las interacciones.
- Supervisión de consultas de bases de datos: Inspecciona la duración de las consultas e identifica operaciones lentas de las bases de datos.
- Instrumentación personalizada: Añade mediciones para supervisar operaciones específicas de la aplicación.
Integraciones de Sentry
Sentry ofrece integraciones con GitHub, GitLab, Jira, Slack, Microsoft Teams, PagerDuty, Azure DevOps, Bitbucket, Vercel y Opsgenie. Su plataforma de integración y su API REST admiten integraciones personalizadas.
Pros and Cons
Pros:
- Los seguimientos de pila agilizan la depuración en producción
- Correlaciona los errores con las trazas y los perfiles
- El seguimiento de versiones señala las regresiones de las implementaciones
Cons:
- No ofrece supervisión de servidores ni de infraestructura
- La agrupación de problemas y las alertas pueden generar ruido
Learn more about Sentry: Ideal para una amplia compatibilidad tecnológica
- Plan gratuito disponible
- Desde $32.92/mes (facturado anualmente)
Visit WebsiteCustomer Rating:4.3/5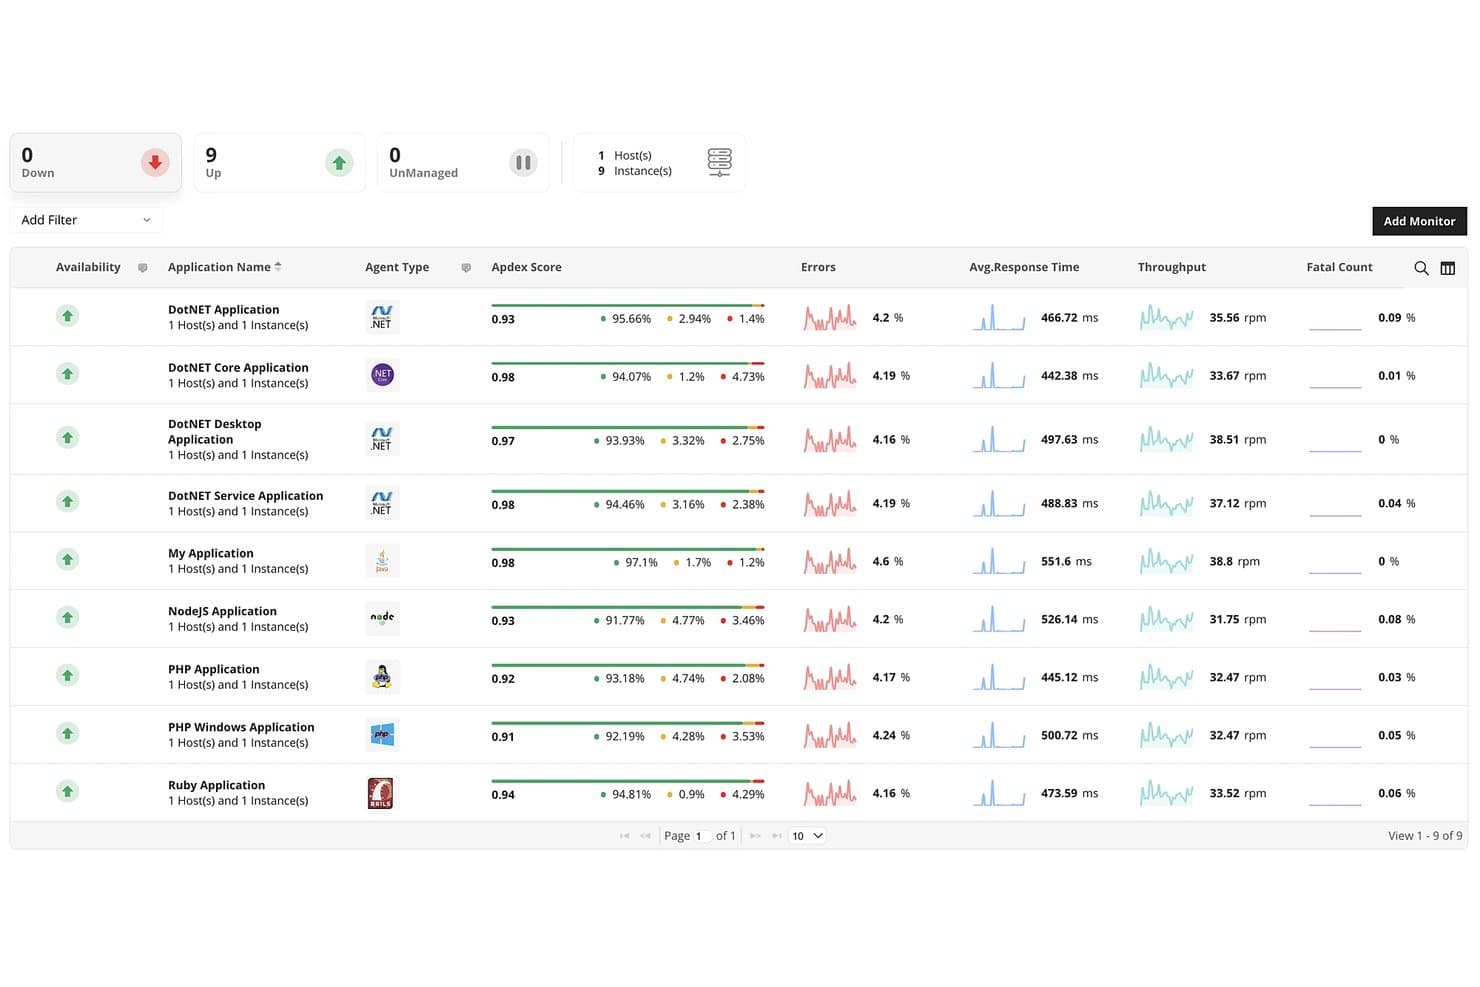
ManageEngine Applications Manager realiza un seguimiento de las métricas de rendimiento de las aplicaciones en varias instancias. ManageEngine Applications Manager es una plataforma de monitorización del rendimiento de aplicaciones para equipos de TI que necesitan rastrear ralentizaciones y cortes en aplicaciones, servidores, bases de datos y servicios en la nube.
¿Para quién es más adecuado ManageEngine Applications Manager?
Equipos de operaciones de TI que supervisan diversos entornos de aplicaciones e infraestructura en sistemas locales y en la nube.
Por qué elegí ManageEngine Applications Manager
Elegí ManageEngine Applications Manager, «ideal para una amplia compatibilidad tecnológica», porque supervisa aplicaciones junto con servidores, bases de datos y servicios en la nube. Me gusta esa amplitud para rastrear una solicitud lenta a través de los niveles de aplicación e infraestructura y, después, utilizar los diagnósticos de transacciones para localizar dónde se acumula la latencia.
Características principales de ManageEngine Applications Manager
- Detección de anomalías: Compare las métricas de rendimiento con líneas base históricas o reglas personalizadas.
- Gestión de registros: Busque, filtre y analice registros de aplicaciones y servidores en tiempo real.
- Monitorización de usuarios reales: Realice un seguimiento de las visitas a páginas, los clics, la duración de las sesiones y las puntuaciones de Apdex a partir del tráfico real.
- Previsión de capacidad: Revise informes de tendencias y previsiones basadas en aprendizaje automático para planificar las necesidades de recursos.
Integraciones de ManageEngine Applications Manager
ManageEngine Applications Manager documenta integraciones con ManageEngine ServiceDesk Plus, ManageEngine OpManager, Slack y ServiceNow, además de plataformas SIEM compatibles con Syslog, como Splunk, Microsoft Sentinel y ManageEngine Log360. También proporciona API REST para conectar portales internos y sistemas de terceros.
Pros and Cons
Pros:
- Monitoriza aplicaciones, bases de datos, servidores y la nube
- Las alertas en tiempo real favorecen la resolución proactiva de problemas
- Amplia cobertura de entornos heredados e híbridos
Cons:
- El ajuste avanzado de los umbrales requiere tiempo de configuración
- Menor profundidad para el rastreo nativo de la nube
Learn more about ManageEngine Applications Manager: Mejor para entornos de aplicaciones diversos
- Prueba gratuita de 30 días
- Desde $10/mes
Visit WebsiteCustomer Rating:4.7/5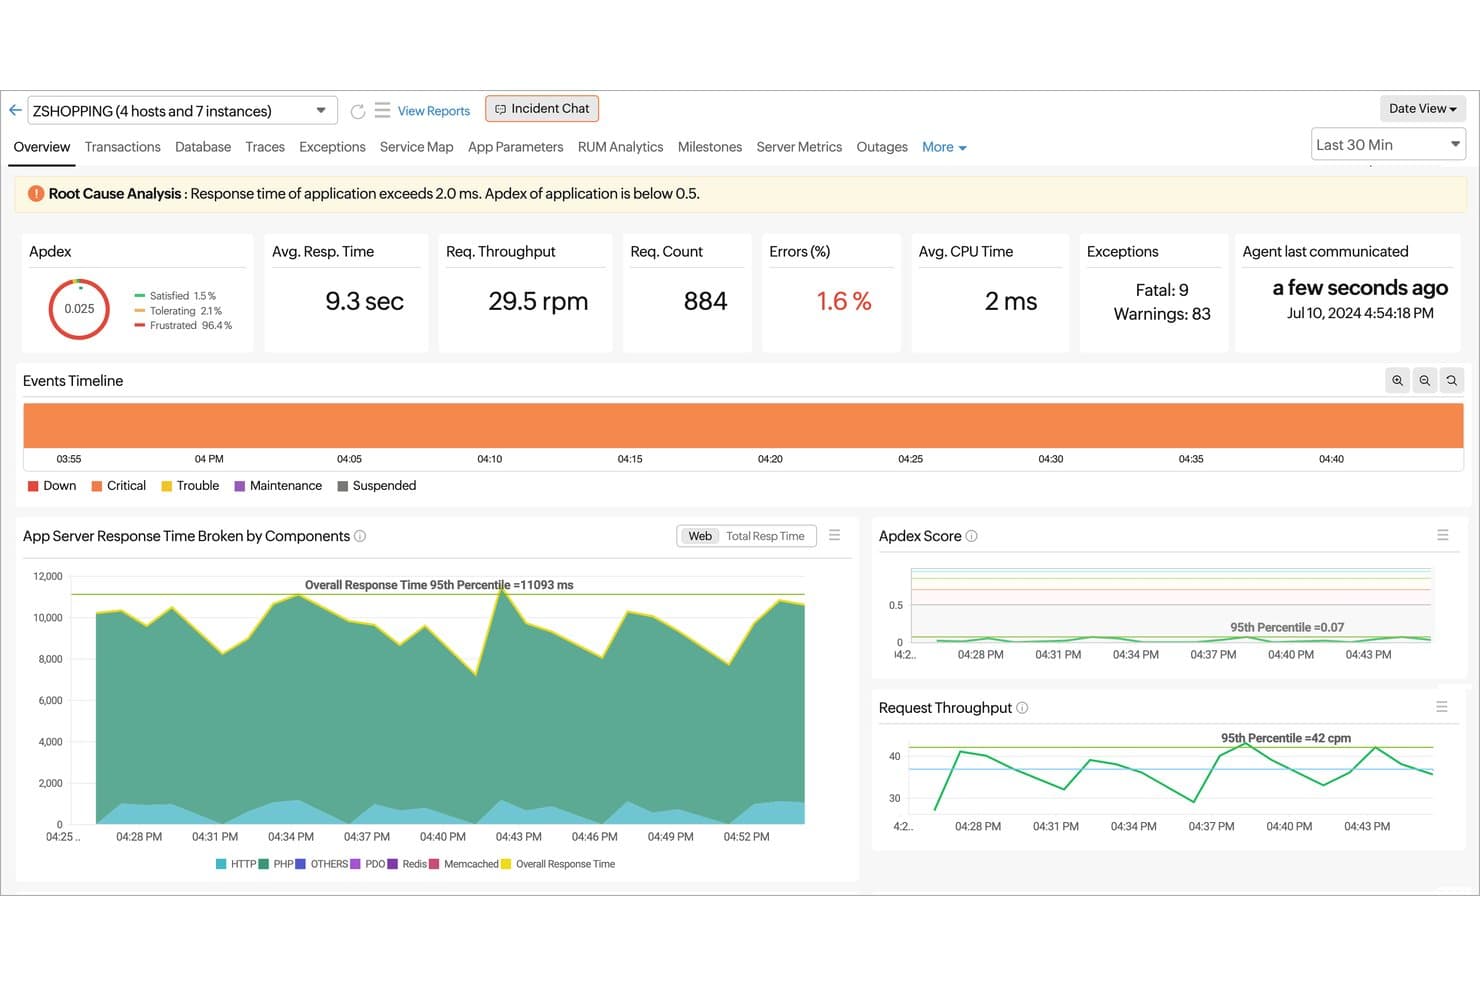
Site24x7 muestra el análisis de la causa raíz y las métricas de APM en una sola vista. Site24x7 es una plataforma de observabilidad y monitorización de TI para equipos que evalúan alternativas a Dynatrace, y ayuda a los especialistas de TI a realizar un seguimiento del rendimiento de las aplicaciones y la infraestructura, diagnosticar problemas de los servicios y monitorizar entornos híbridos.
¿Para quién es mejor Site24x7?
Site24x7 es adecuado para equipos de TI que monitorizan aplicaciones e infraestructura en diversos entornos híbridos.
Por qué elegí Site24x7
Elegí Site24x7 para el caso de uso «Mejor para entornos de aplicaciones diversos» porque su APM es compatible con Java, .NET, PHP, Ruby, Node.js y Python. Me gusta cómo el rastreo distribuido y los diagnósticos a nivel de código me ayudan a seguir las transacciones lentas entre servicios, mientras que la compatibilidad con OpenTelemetry se adapta a entornos instrumentados.
Características principales de Site24x7
- Monitorización de servidores: Realiza un seguimiento de las métricas de CPU, memoria, disco y red en servidores físicos, virtuales y en la nube.
- Monitorización de redes: Mide el estado de los dispositivos, el ancho de banda, la latencia y el tráfico en routers, switches y firewalls.
- Gestión de registros: Recopila y permite buscar registros de aplicaciones, sistemas y fuentes en la nube.
- Monitorización de sitios web: Comprueba la disponibilidad de los sitios web desde más de 130 ubicaciones globales.
Integraciones de Site24x7
Site24x7 admite integraciones con ServiceNow, PagerDuty, Jira, Slack, Microsoft Teams, Opsgenie, Amazon EventBridge y Zapier. También proporciona APIs REST para integraciones personalizadas.
Pros and Cons
Pros:
- Monitoriza aplicaciones en diversos entornos híbridos
- Rastrea transacciones en los lenguajes de aplicaciones compatibles
- Comprueba la disponibilidad de los sitios web desde más de 130 ubicaciones
Cons:
- El ajuste de las alertas puede generar falsos positivos
- Los paneles parecen saturados y ofrecen una personalización limitada
Learn more about Site24x7: Mejor para la monitorización integral de infraestructuras de TI
- Prueba gratuita de 30 días
- Desde $2,595 pago único
Visit WebsiteCustomer Rating:4.6/5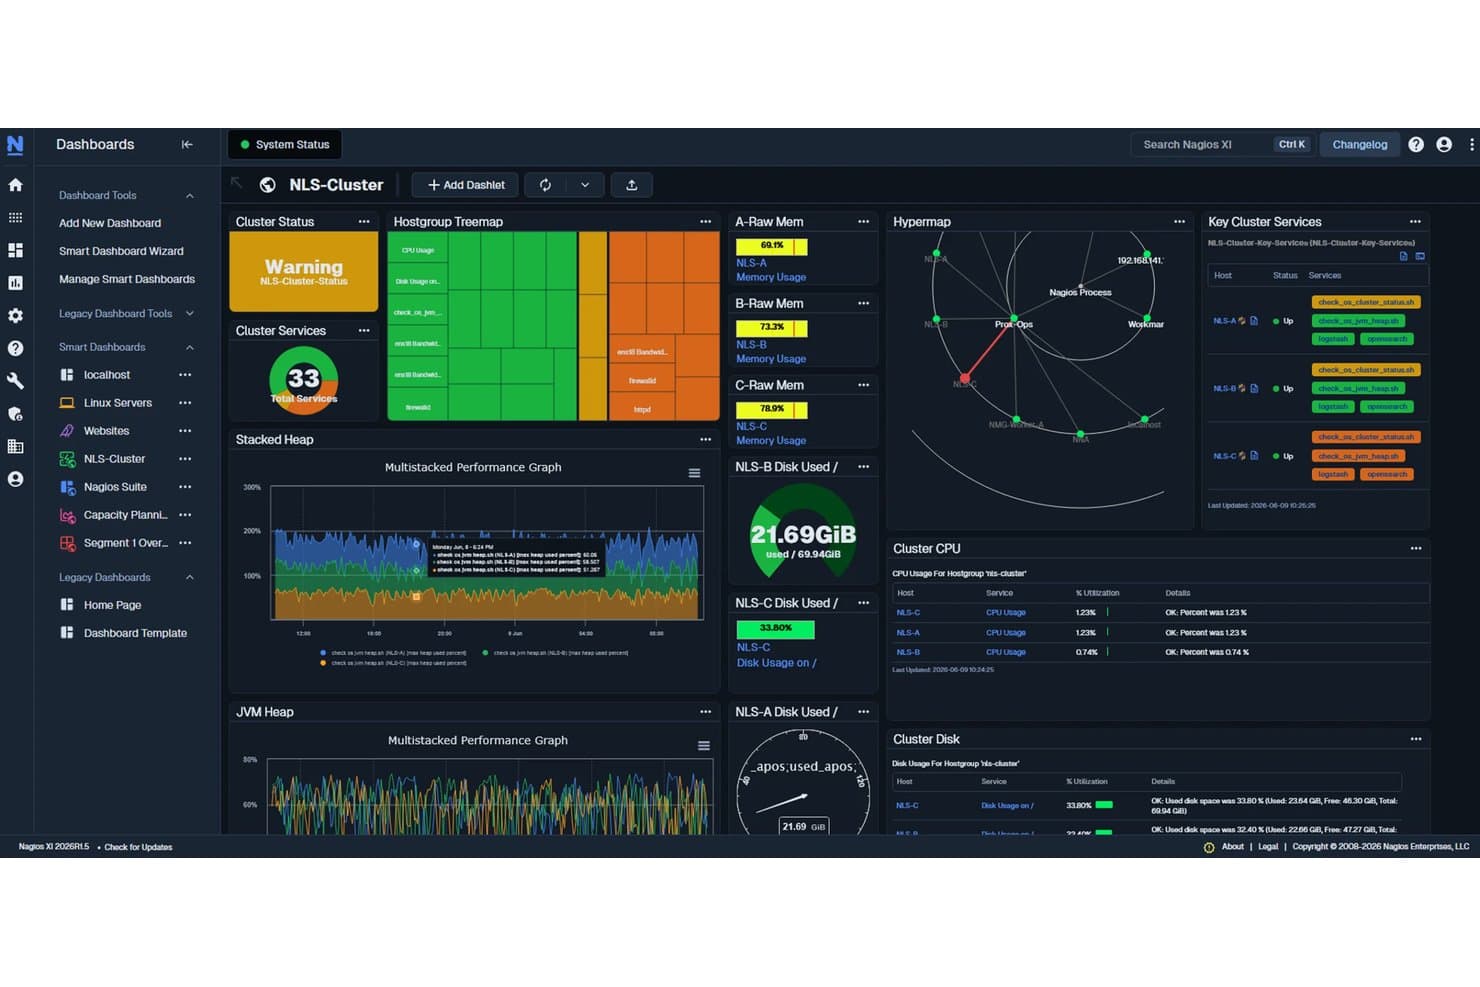
Nagios XI centraliza el estado del clúster y la monitorización de la CPU, el disco y los servicios en un único panel. Nagios proporciona a los equipos de TI monitorización configurable de hosts y servicios para detectar interrupciones en servidores, dispositivos de red y aplicaciones en distintos entornos de infraestructura.
¿Para quién es más adecuado Nagios?
Nagios es adecuado para equipos de infraestructura y operaciones que necesitan monitorización configurable en entornos mixtos, incluidos sistemas consolidados y equipos de red.
Por qué elegí Nagios
Elegí Nagios para una guía de alternativas a Dynatrace porque encaja con la categoría “Mejor para la monitorización integral de infraestructuras de TI” gracias a sus comprobaciones de hosts y servicios basadas en complementos. Utilizo comprobaciones SNMP para monitorizar conmutadores y enrutadores junto con el estado de los servidores, y después configuro alertas cuando las comprobaciones fallan. Esto me permite supervisar infraestructuras mixtas en un único sistema de monitorización.
Funciones principales de Nagios
- Detección automática: Detecta dispositivos y servicios en la red.
- Asistentes de configuración: Guían la configuración de dispositivos y aplicaciones habituales.
- Paneles: Muestran resúmenes de estado, mapas y gráficos en vistas personalizables.
- Gráficos de rendimiento: Representan los datos de monitorización a lo largo del tiempo.
Integraciones de Nagios
Nagios XI cuenta con integraciones documentadas con Slack y PagerDuty para las notificaciones de alertas y la gestión de incidentes, configuradas mediante scripts y ajustes de notificación. Su API REST admite conexiones personalizadas con herramientas como sistemas de gestión de bases de datos de configuración (CMDB) y sistemas de gestión de tickets.
Pros and Cons
Pros:
- Monitoriza hosts mixtos mediante comprobaciones personalizadas
- Alertas fiables con umbrales configurables
- Los paneles muestran el estado y las tendencias históricas
Cons:
- La configuración inicial requiere conocimientos especializados de monitorización en Linux
- Los complementos externos pueden estar obsoletos o carecer de documentación
Learn more about Nagios: Mejor para el seguimiento unificado de servicios en la nube
- No
- Desde $15/mes (facturado anualmente)
Visit WebsiteCustomer Rating:4.5/5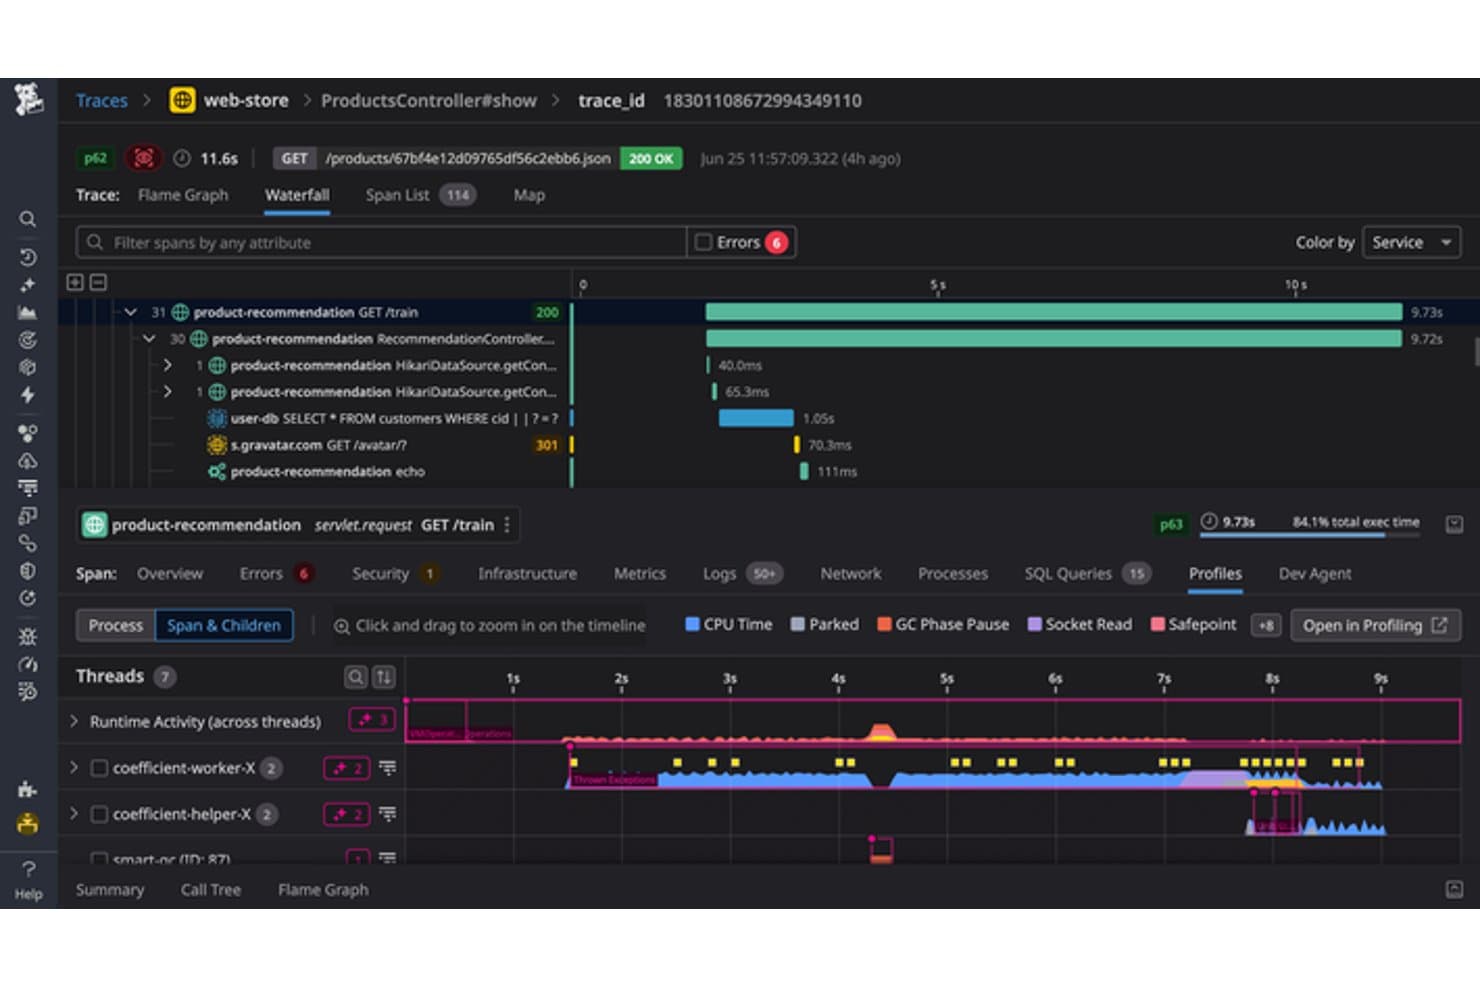
Las trazas de APM de Datadog muestran con detalle la CPU, los hilos y las líneas de tiempo de los spans. Datadog es una plataforma de observabilidad para equipos de TI y DevOps que reúne datos de aplicaciones, infraestructura, registros y seguridad para ayudar a diagnosticar problemas de rendimiento en entornos nativos de la nube.
¿Para quién es más adecuado Datadog?
Los equipos de operaciones en la nube y SRE pueden usar Datadog para supervisar el estado de los servicios en infraestructuras distribuidas y localizar problemas que afectan a las cargas de trabajo en producción.
Por qué elegí Datadog
Elegí Datadog para una guía de las principales alternativas a Dynatrace porque obtiene el reconocimiento de “Mejor para el seguimiento unificado de servicios en la nube”. Me gusta cómo sus métricas de infraestructura, trazas distribuidas y registros me permiten seguir una solicitud lenta desde un host en la nube a través de los servicios dependientes e inspeccionar los errores relacionados. Su mapa de servicios me ayuda a localizar una dependencia ascendente que afecta al estado de producción.
Características principales de Datadog
- Monitoreo de usuarios reales: Captura sesiones del navegador, errores del frontend y rendimiento de las páginas.
- Monitoreo sintético: Ejecuta pruebas programadas de navegador y API en las aplicaciones.
- Monitoreo de bases de datos: Muestra métricas a nivel de consulta y planes de ejecución para las bases de datos compatibles.
- Monitores y alertas: Evalúa la telemetría según umbrales y envía notificaciones cuando se activan determinadas condiciones.
Integraciones de Datadog
Datadog ofrece más de 1.000 integraciones integradas, incluidas AWS, Azure, Google Cloud, Kubernetes, Docker, PostgreSQL, GitHub, Jira, Slack y PagerDuty. También admite integraciones personalizadas mediante su API.
Pros and Cons
Pros:
- Correlaciona métricas, registros y trazas durante los incidentes
- Asigna dependencias para localizar fallos en los servicios ascendentes
- Unifica las vistas del estado de la infraestructura y las aplicaciones
Cons:
- El crecimiento de la telemetría dificulta la previsión de las facturas
- Los paneles y las consultas avanzadas requieren tiempo de configuración
 La mejor opción para la supervisión de código abierto a nivel empresarial
- No
- Gratis
Visit WebsiteCustomer Rating:4.4/5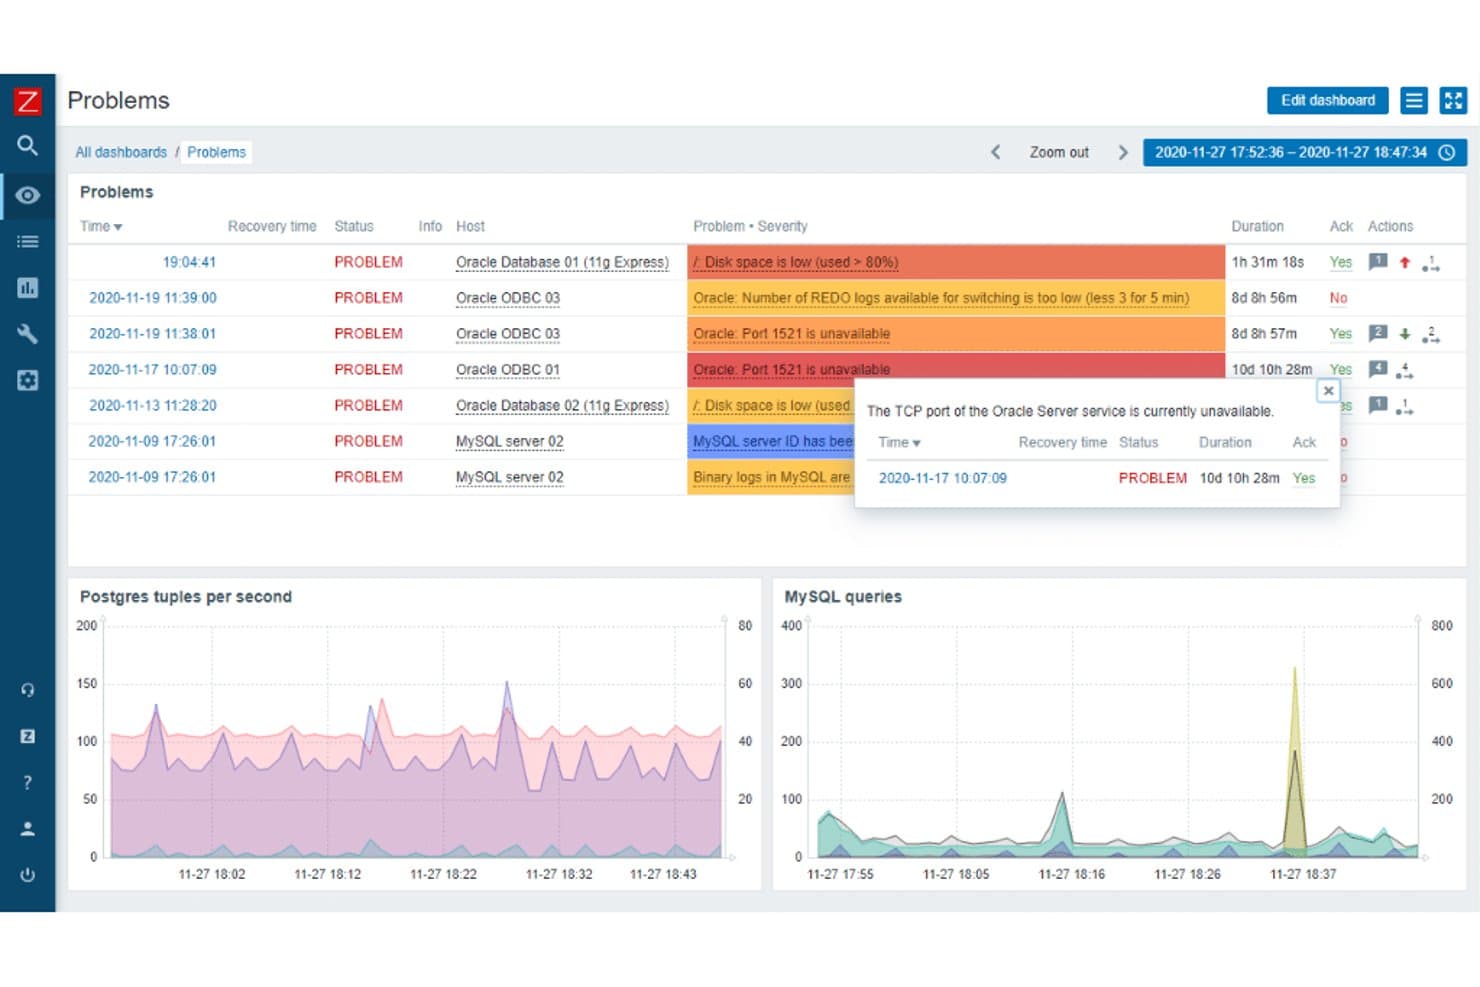
Zabbix muestra los problemas activos de bases de datos y servidores con detalles sobre su gravedad. Zabbix es una plataforma de supervisión de infraestructura para equipos de TI que necesitan realizar un seguimiento de servidores, redes y aplicaciones, detectar problemas en los servicios y gestionar la visibilidad en entornos complejos.
¿Para quién es más adecuado Zabbix?
Zabbix es adecuado para equipos de operaciones de TI empresariales que necesitan una supervisión personalizable y de código abierto en entornos grandes y distribuidos.
Por qué elegí Zabbix
Elegí Zabbix para esta guía sobre las principales alternativas a Dynatrace porque es la mejor opción para la supervisión de código abierto a nivel empresarial. Me gusta cómo los proxies distribuidos recopilan datos de sitios remotos, mientras que las plantillas reutilizables aplican comprobaciones y activadores en servidores y dispositivos de red. Esto proporciona a los equipos de operaciones una forma de supervisar un entorno grande y heterogéneo sin depender de una plataforma propietaria.
Características principales de Zabbix
- Correlación de eventos: Define reglas para agrupar problemas relacionados y suprimir eventos sintomáticos.
- Supervisión web: Realiza un seguimiento de escenarios web de varios pasos y de los tiempos de respuesta.
- Mapas de red: Crea mapas que muestran los hosts supervisados, los enlaces y los problemas actuales.
- Descubrimiento de bajo nivel: Detecta automáticamente entidades como interfaces de red y crea elementos para supervisarlas.
Integraciones de Zabbix
El catálogo oficial de integraciones de Zabbix incluye 1.986 soluciones de 559 marcas, entre ellas AWS, Azure, Kubernetes, ServiceNow, Slack, Jira y PagerDuty. También proporciona una API JSON-RPC basada en HTTP y webhooks de JavaScript personalizables para integraciones personalizadas.
Pros and Cons
Pros:
- Se adapta a sitios distribuidos mediante proxies
- Las plantillas reutilizables estandarizan las comprobaciones en todas las flotas
- Correlaciona las alertas relacionadas para reducir el ruido
Cons:
- La configuración inicial requiere una cantidad considerable de configuración manual
- Las implementaciones grandes necesitan ajustes en la base de datos y los proxies
 La mejor opción para obtener visibilidad del rendimiento empresarial en tiempo real
- No
- Desde $6/vCPU/mes (facturado anualmente)
Visit WebsiteCustomer Rating:4.3/5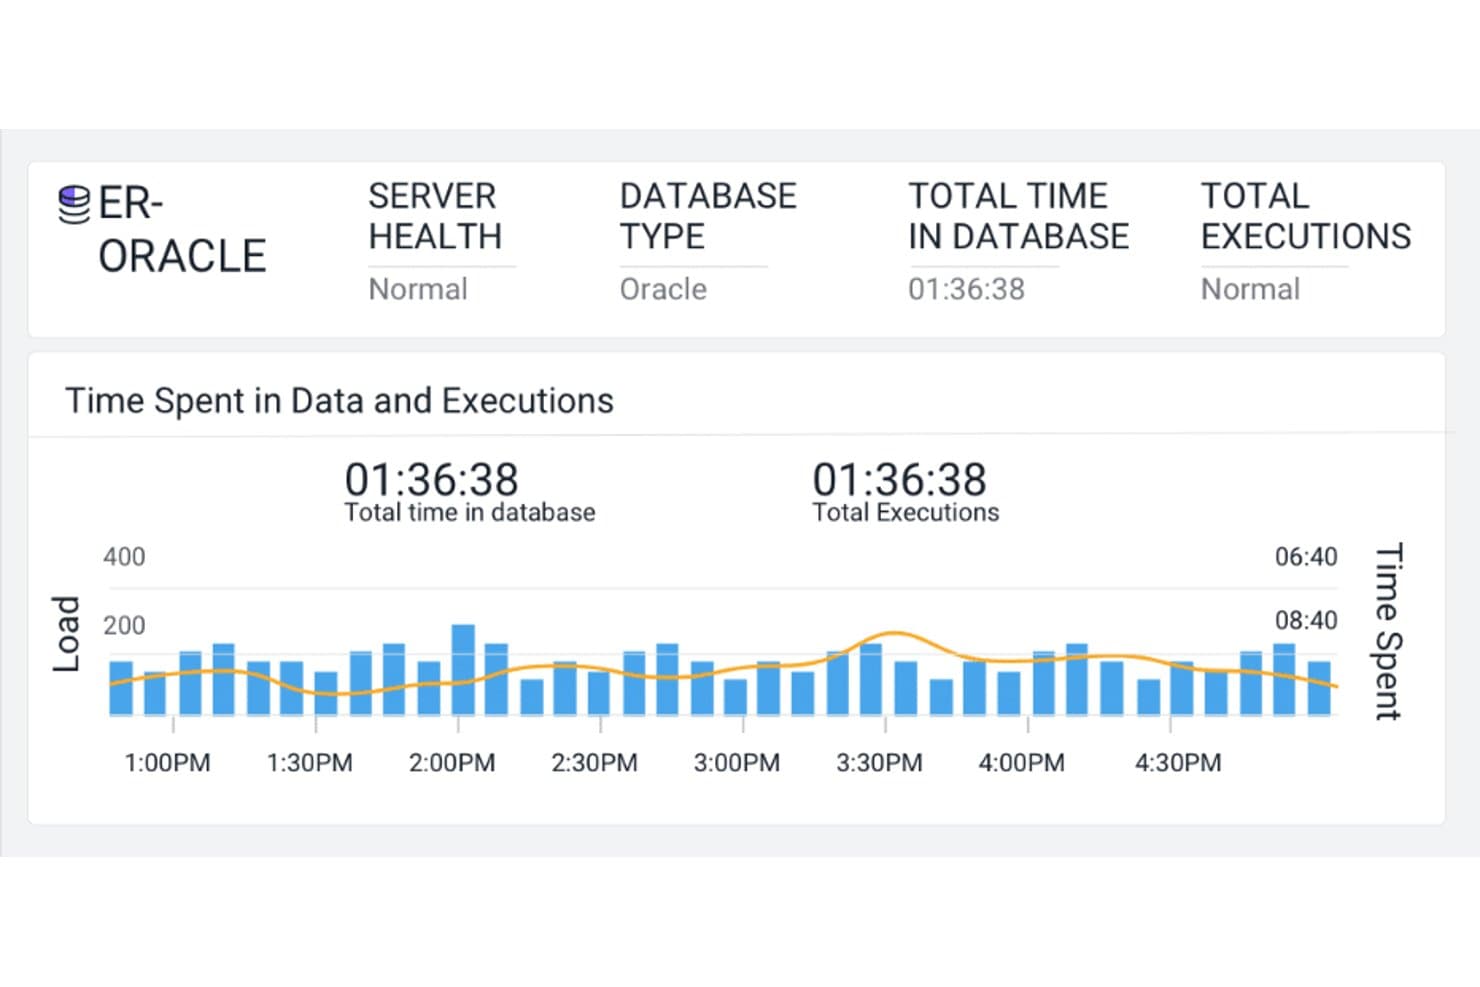
AppDynamics supervisa visualmente la carga y los tiempos de ejecución de la base de datos Oracle. Para los equipos de TI e ingeniería que comparan alternativas a Dynatrace, AppDynamics combina la supervisión del rendimiento de las aplicaciones con el rastreo de transacciones para ayudar a localizar ralentizaciones y errores en servicios complejos y distribuidos.
¿Para quién es más adecuado AppDynamics?
AppDynamics es adecuado para los equipos de operaciones de TI y aplicaciones que necesitan conectar el estado de las aplicaciones en tiempo real con las transacciones comerciales de las que dependen los clientes.
Por qué elegí AppDynamics
Elegí AppDynamics porque su enfoque, “La mejor opción para obtener visibilidad del rendimiento empresarial en tiempo real”, conecta el estado de las aplicaciones en tiempo real con las transacciones de las que dependen los clientes. Me gusta cómo el rastreo de transacciones ayuda a localizar ralentizaciones en servicios distribuidos, de modo que puedo ver dónde se detiene una solicitud y relacionar ese problema con la actividad empresarial.
Funciones principales de AppDynamics
- Seguridad de las aplicaciones en tiempo de ejecución: Detecta vulnerabilidades de las aplicaciones y bloquea ataques.
- Supervisión de usuarios reales: Captura el rendimiento web y móvil en distintos dispositivos y navegadores.
- Supervisión sintética: Supervisa el rendimiento web, móvil y de las API mediante actividad simulada.
- Detección de anomalías: Establece líneas base de rendimiento y señala desviaciones mediante IA y aprendizaje automático.
Integraciones de AppDynamics
AppDynamics cuenta con una integración bidireccional integrada con Jira para crear y actualizar tickets de incidentes, además de una integración en fase de vista previa inicial con Splunk Observability Cloud. También ofrece extensiones prediseñadas y API REST para integraciones y automatización.
Pros and Cons
Pros:
- Los mapas de transacciones comerciales conectan la telemetría con el impacto
- Los gráficos de llamadas permiten analizar la causa raíz a nivel de código
- Las alertas de línea base señalan desviaciones respecto a lo normal
Cons:
- La instrumentación y la configuración de agentes requieren trabajo manual
- La interfaz parece anticuada frente a las herramientas de observabilidad más recientes
Learn more about AppDynamics: La mejor opción para consultar la telemetría en un almacén de datos unificado
- No
- $12/user/month (facturado anualmente)
Visit WebsiteCustomer Rating:4.3/5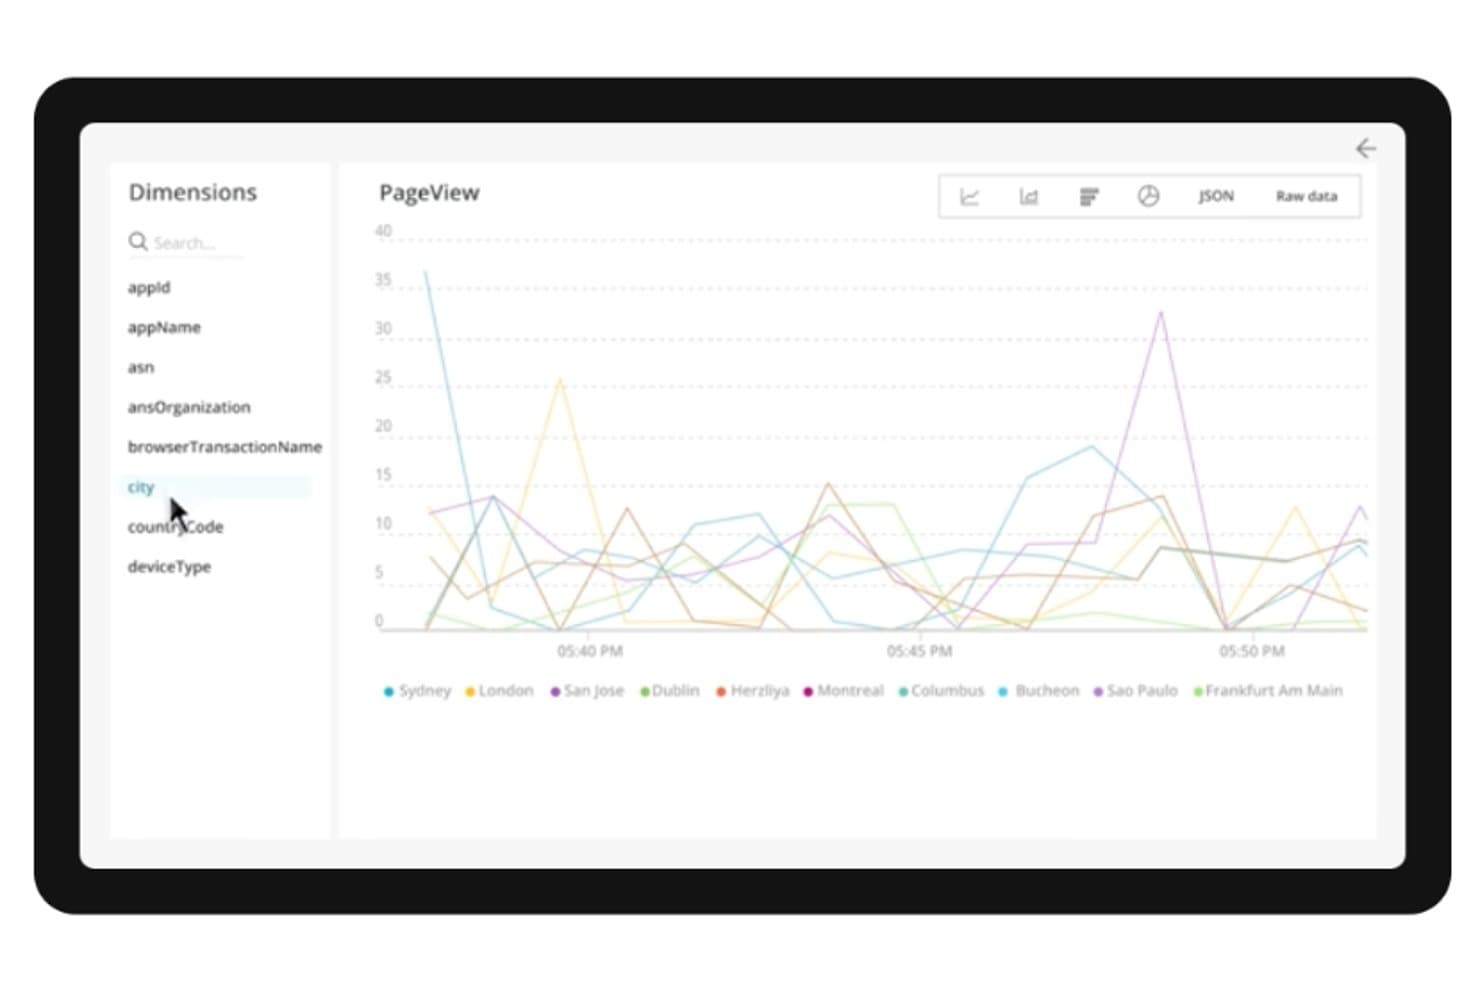
New Relic desglosa los datos de PageView por ciudad en una serie temporal. Para los equipos de TI e ingeniería que evalúan alternativas a Dynatrace, New Relic es una plataforma de APM que ayuda a rastrear problemas de las aplicaciones, supervisar el estado de los servicios e investigar ralentizaciones en sistemas distribuidos.
¿Para quién es más adecuado New Relic?
New Relic es adecuado para equipos de DevOps y de fiabilidad del sitio que necesitan conectar trazas de aplicaciones, métricas de infraestructura y registros mientras diagnostican problemas en producción.
Por qué elegí New Relic
Elegí New Relic por su enfoque de «La mejor opción para una supervisión integral del rendimiento de las aplicaciones»: conecta trazas distribuidas con el estado de los servicios y los registros, lo que me ayuda a seguir las ralentizaciones entre servicios. Cuando una API se ralentiza después de una versión, puedo rastrear su recorrido de solicitud y comprobar las señales de los servicios relacionados para localizar la dependencia afectada.
Características principales de New Relic
- Supervisión de bases de datos: Inspecciona las consultas lentas de la base de datos y sus detalles de ejecución.
- Diagnóstico a nivel de código: Perfila el código de la aplicación para identificar los métodos que consumen tiempo de CPU.
- Seguimiento de implementaciones: Marca las versiones para comparar el rendimiento de la aplicación antes y después de los cambios.
- Condiciones de alerta: Establece umbrales para las métricas de la aplicación y recibe notificaciones cuando se superan.
Integraciones de New Relic
New Relic admite integraciones de notificaciones de alertas con Atlassian Jira, AWS EventBridge, Microsoft Teams, PagerDuty, ServiceNow y Slack, además de más de 400 integraciones en el equipo anfitrión. También proporciona API y la herramienta de integración Flex para enviar datos personalizados a New Relic.
Pros and Cons
Pros:
- Correlaciona trazas, registros y señales de infraestructura
- Realiza un seguimiento de las regresiones de las versiones en transacciones distribuidas
- Conecta el rendimiento de las aplicaciones con la experiencia del navegador
Cons:
- Una navegación densa puede ralentizar la investigación de incidentes
- El crecimiento de la ingesta puede hacer que los costes sean impredecibles
Learn more about New Relic: Más adecuado para la gestión de registros y el análisis de seguridad
- No
- $108 por usuario al mes (facturado anualmente)
Visit WebsiteCustomer Rating:4.3/5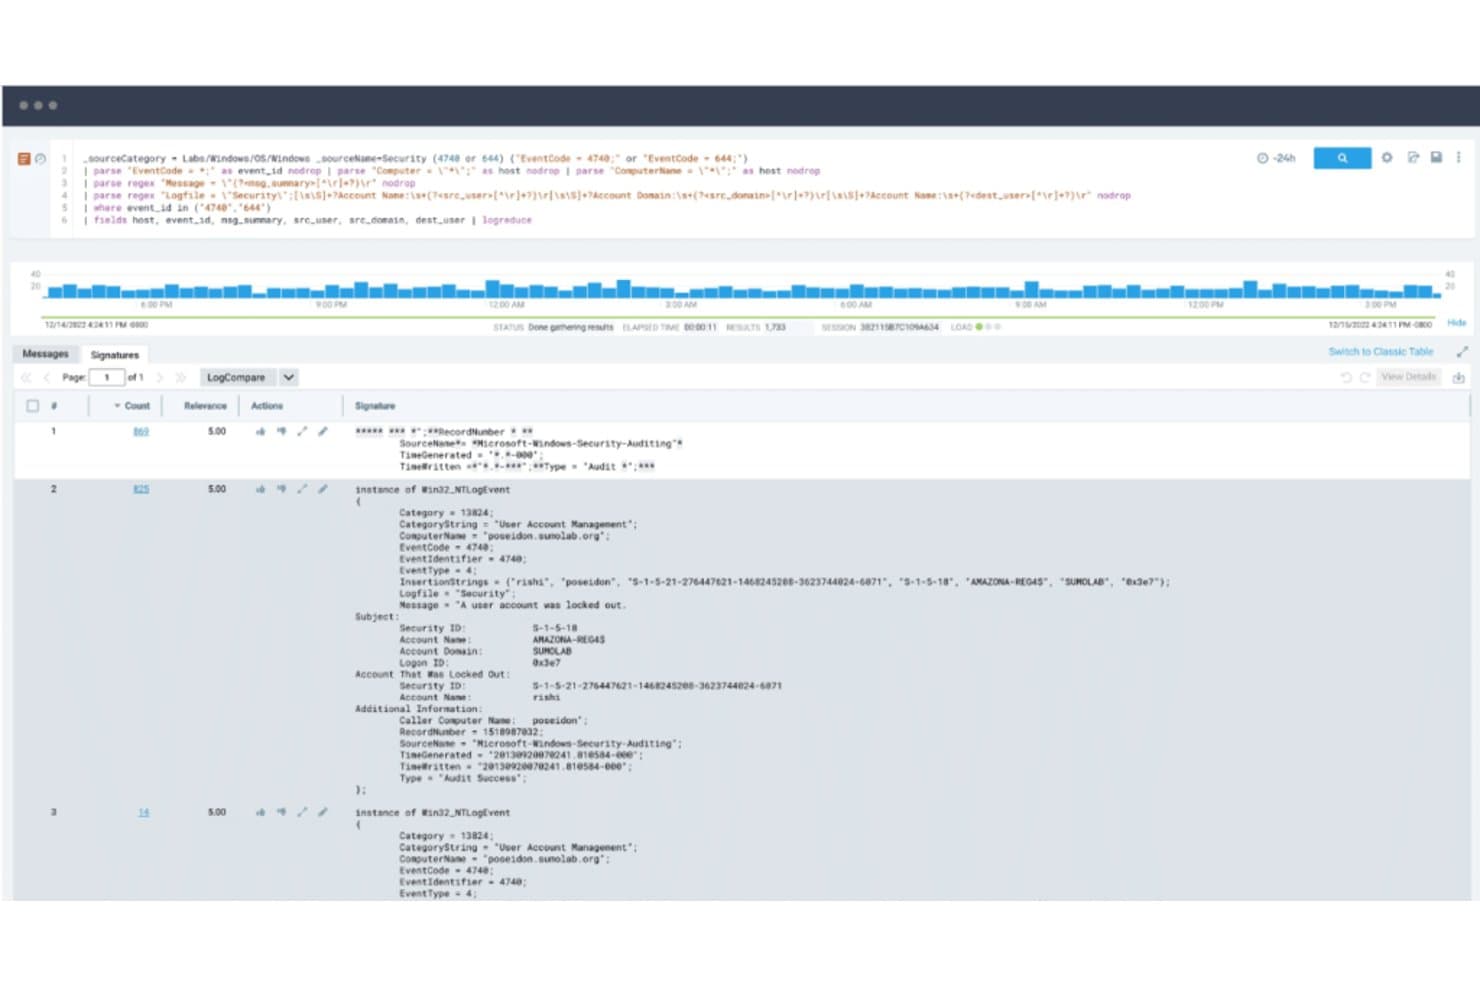
Sumo Logic detecta eventos de bloqueo de cuentas mediante el análisis de registros de seguridad. Sumo Logic es una plataforma de observabilidad basada en la nube que ayuda a los equipos de infraestructura y seguridad a investigar interrupciones de servicios y comprender la actividad en aplicaciones distribuidas, por lo que es una opción para los equipos que evalúan alternativas a Dynatrace.
¿Para quién es más adecuado Sumo Logic?
Los analistas de seguridad y los equipos de operaciones de TI que necesitan datos de registro centralizados para la resolución de problemas, la detección de amenazas y la investigación son buenos candidatos para Sumo Logic.
Por qué elegí Sumo Logic
Elegí Sumo Logic para esta guía de alternativas a Dynatrace porque coincide con “Más adecuado para la gestión de registros y el análisis de seguridad”. Su búsqueda de registros me ayuda a rastrear errores en servicios distribuidos, mientras que Cloud SIEM correlaciona señales de seguridad para facilitar la investigación de actividades sospechosas.
Funciones principales de Sumo Logic
- Análisis de métricas: Consulta métricas de series temporales con el lenguaje de consulta de métricas de Sumo Logic.
- Trazado distribuido: Inspecciona los tramos de las trazas para seguir las solicitudes en los servicios instrumentados.
- Paneles: Crea visualizaciones a partir de datos de telemetría y organízalas en diseños personalizados.
- Monitores y alertas: Define condiciones en métricas o consultas para activar notificaciones.
Integraciones de Sumo Logic
El Catálogo de aplicaciones de Sumo Logic incluye cientos de proveedores y productos, como AWS, Azure, Datadog, Dynatrace, GitHub y Jira, con ofertas como fuentes de recopilación de datos, aplicaciones prediseñadas e integraciones de automatización. Proporciona integraciones de webhook nativas para ServiceNow y Slack, además de API REST para integraciones personalizadas.
Pros and Cons
Pros:
- Las búsquedas rápidas de registros facilitan las investigaciones de incidentes
- Los registros centralizados permiten generar alertas en tiempo real
- Cloud SIEM correlaciona amenazas para la investigación
Cons:
- El lenguaje de consulta requiere tiempo para dominarlo
- La recopilación y el análisis de registros necesitan mejoras
 10Ideal para el análisis de datos y la obtención de información a gran escala
Splunk
- No
- $150/usuario/mes
Visit WebsiteCustomer Rating:4.3/5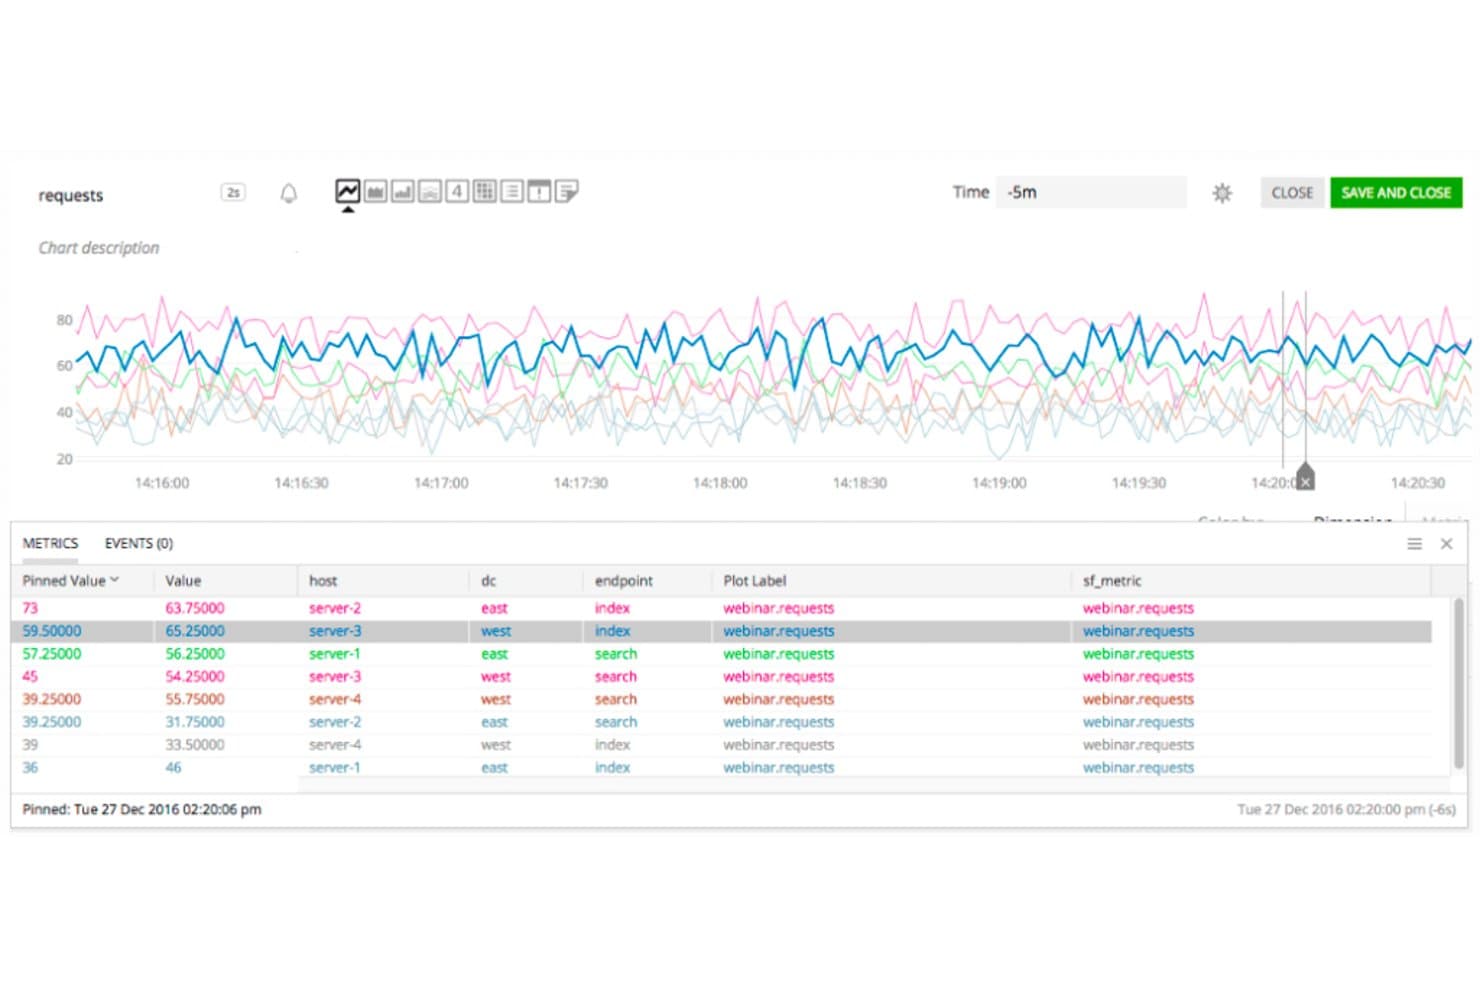
Splunk permite a los usuarios supervisar métricas de solicitudes en tiempo real en servidores y puntos finales. Splunk combina la supervisión de la infraestructura con el análisis de registros, métricas y trazas, lo que ayuda a los equipos de TI y operaciones a investigar incidentes en entornos complejos y distribuidos.
¿Para quién es más adecuado Splunk?
Splunk es adecuado para equipos grandes de TI y seguridad que necesitan analizar grandes volúmenes de datos de máquinas y descubrir patrones en entornos complejos.
Por qué elegí Splunk
Elegí Splunk como alternativa a Dynatrace por su enfoque en ser la «mejor opción para el análisis de datos y la obtención de información a gran escala». Combina la supervisión de la infraestructura con el análisis de registros, métricas y trazas, por lo que puedo investigar la ralentización de un servicio en sistemas distribuidos y conectar las señales con eventos relacionados. Esto me ayuda a consultar grandes volúmenes de datos de máquinas durante las investigaciones de incidentes.
Características principales de Splunk
- Paneles personalizados: Crea paneles visuales con gráficos, tablas y datos de servicios.
- Detectores de alertas: Establece condiciones que activan alertas cuando las señales supervisadas superan los umbrales.
- Supervisión de Kubernetes: Explora el estado del clúster, los nodos y las cargas de trabajo en Kubernetes Navigator.
- Supervisión sintética: Ejecuta pruebas programadas para comprobar la disponibilidad de las aplicaciones y los tiempos de respuesta.
Integraciones de Splunk
Splunk Observability Cloud admite integraciones con AWS CloudWatch, Google Cloud Platform, Microsoft Azure, Jira, Microsoft Teams, PagerDuty, ServiceNow y Slack. Su API de integraciones configura las conexiones compatibles, mientras que Splunkbase ofrece aplicaciones, complementos y conectores.
Pros and Cons
Pros:
- Busca datos de máquinas de gran volumen para encontrar indicios de incidentes
- Correlaciona registros, métricas y trazas para las investigaciones
- Los paneles personalizados y las alertas permiten realizar un triaje específico
Cons:
- Los costes pueden aumentar a medida que crece la ingesta de telemetría
- Las consultas pesadas pueden ralentizar los paneles a gran escala
Learn more about Splunk:
Otras alternativas a Dynatrace
Estas son algunas alternativas adicionales a Dynatrace que no han llegado a mi lista, pero que aun así merece la pena conocer:
- 11PrometheusMejor opción para monitoreo robusto en entornos Kubernetes
- 12Grafana CloudLa mejor opción para la visualización y el análisis de código abierto
- 13ElasticMejor opción para búsqueda y análisis de datos en tiempo real
- 14SolarWinds Observability SaaSIdeal para priorización de alertas impulsada por IA
- 15SysdigMejor para seguridad de contenedores y Kubernetes
- 16Dotcom MonitorMejor para simulaciones con navegador real
- 17IcingaAdecuado para una supervisión integral con un sólido respaldo de la comunidad
Otros análisis de software
- Herramientas de revisión de código para desarrolladores
- Herramientas de desarrollo web
- Herramientas de automatización de la infraestructura
Cómo evalúo las alternativas a Dynatrace
Evalúo cada herramienta en dos niveles: los aspectos imprescindibles, como el APM de pila completa y el rastreo distribuido, y después los elementos diferenciadores que separan las plataformas para distintos equipos y pilas tecnológicas.
Funcionalidad principal (aspectos imprescindibles para esta lista)
Al seleccionar herramientas para mi lista, clasifico cada una en una escala de 0 (no ofrece la funcionalidad) a 5 (sobresale en esta área) para cada funcionalidad principal que se indica a continuación. Después, calculo la puntuación total de la herramienta en forma de porcentaje. Cada herramienta debe alcanzar una puntuación total mínima del 75% para que se considere su inclusión.
- APM de pila completa: Compruebo si la herramienta proporciona rastreo de transacciones a nivel de código en los principales lenguajes y marcos de trabajo, como detectar una llamada lenta a una base de datos oculta en un microservicio de Java.
- Supervisión de la infraestructura: Cada herramienta debería cubrir servidores, contenedores, clústeres de Kubernetes y servicios en la nube con descubrimiento automático, en lugar de requerir una configuración manual host por host.
- Rastreo distribuido: Evalúo cómo fluyen los rastreos entre los límites de los servicios y si la plataforma admite la ingesta de OpenTelemetry, algo importante cuando los equipos ejecutan pilas políglotas.
- Gestión y análisis de registros: Los registros deben correlacionarse con los rastreos y las métricas en una sola vista, para que un SRE pueda pasar de un aumento en las tasas de error a las líneas de registro exactas que lo provocan.
- Detección de anomalías basada en IA: Busco aprendizaje automático que establezca una línea base del comportamiento normal y muestre sugerencias sobre la causa raíz, no solo alertas de umbral estáticas que inundan los canales de guardia.
- Supervisión de usuarios reales y sintética: La plataforma debería ofrecer tanto RUM para el análisis del tráfico en vivo como comprobaciones sintéticas que detecten flujos de pago interrumpidos o fallos de API antes que los usuarios reales.
Una vez que tengo una lista de herramientas que cumplen estos criterios, considero qué distingue a cada plataforma.
Factores diferenciadores (lo que distingue a los proveedores)
Así es como comparo y contrasto los distintos proveedores:
Funciones destacadas
La transparencia de precios es importante al cambiar de Dynatrace, así que evalúo si una plataforma ofrece precios predecibles basados en el uso, con controles de costes claros. La compatibilidad nativa con OpenTelemetry es otro factor diferenciador clave: los equipos que ya están instrumentados con recopiladores de OTel no deberían tener que eliminarlo todo para utilizar agentes propietarios. También busco flujos de trabajo de remediación automatizada que activen manuales de procedimientos o escalen mediante herramientas como PagerDuty cuando se dispara una anomalía, convirtiendo las alertas en acciones sin intervención manual.
Más allá de las funciones
La flexibilidad de implementación es un aspecto importante: compruebo si una plataforma admite modelos SaaS, autoalojados e híbridos, ya que los equipos de sectores regulados a menudo necesitan opciones locales o requisitos específicos de residencia de datos. El ecosistema de integraciones también determina en qué medida una herramienta encaja en tu pila actual. Los conectores nativos con canalizaciones de CI/CD, plataformas de ITSM como ServiceNow y herramientas de gestión de incidentes como Opsgenie marcan una diferencia real durante la adopción. También evalúo certificaciones de cumplimiento como SOC 2 Type II e ISO 27001, junto con SSO y controles de acceso basados en roles.
¿Por qué buscar una alternativa a Dynatrace?
Aunque Dynatrace es una buena opción como plataforma de supervisión del rendimiento de aplicaciones (APM), hay varias razones por las que algunos usuarios buscan soluciones alternativas. Es posible que estés buscando una alternativa a Dynatrace porque…
- El precio puede resultar demasiado elevado para los equipos pequeños
- La curva de aprendizaje parece demasiado pronunciada para los nuevos usuarios
- Quieres paneles y funciones de generación de informes más sencillos
- Necesitas opciones de alertas y notificaciones más flexibles
- Utilizas una configuración híbrida y necesitas integraciones más amplias
- Prefieres herramientas con una facturación más transparente
Si alguna de estas situaciones te resulta familiar, has llegado al lugar adecuado. Mi lista contiene varias opciones de plataformas de supervisión del rendimiento de aplicaciones (APM) más adecuadas para equipos que afrontan estos desafíos con Dynatrace y buscan soluciones alternativas.
Funciones principales de Dynatrace
Estas son algunas de las características clave de Dynatrace que te ayudarán a contrastar y comparar lo que ofrecen las soluciones alternativas:
- Supervisión de pila completa: Te permite realizar un seguimiento del rendimiento de las aplicaciones, la infraestructura y la experiencia del usuario en un solo lugar.
- Motor de IA Davis: Detecta los problemas automáticamente y explica la causa raíz para ahorrar tiempo a tu equipo.
- Supervisión de usuarios reales: Muestra cómo interactúan los usuarios reales con tu aplicación para que puedas solucionar los problemas importantes.
- Seguridad de las aplicaciones: Señala las vulnerabilidades en tiempo real mientras tu código se ejecuta en producción.
- Compatibilidad nativa con la nube: Funciona bien con Kubernetes, AWS, Azure y otros entornos en la nube.
- Alertas inteligentes: Envía alertas solo cuando es necesario para que tu equipo evite la fatiga por alertas.
- Paneles personalizados: Te permite crear vistas adaptadas a las necesidades y métricas de tu equipo.
- Información detallada a nivel de código: Te ayuda a analizar el rendimiento hasta llegar a líneas de código individuales.
- Gestión de registros: Te permite buscar, filtrar y analizar registros para solucionar problemas más rápidamente.
- Supervisión sintética: Simula las acciones de los usuarios para que puedas probar el rendimiento de la aplicación desde distintas ubicaciones.
Resumen
En esta guía para compradores, analizamos en profundidad el ámbito de las alternativas a Dynatrace y exploramos diversas opciones adaptadas a casos de uso específicos. Tanto si buscas una herramienta para la supervisión de código abierto a nivel empresarial, la gestión de registros y el análisis de seguridad, como para la seguridad de contenedores y Kubernetes, tienes muchas opciones sólidas que considerar.
Estas son tres conclusiones clave de esta guía:
- Evalúa tus necesidades: Las distintas herramientas están diseñadas pensando en diferentes casos de uso. Algunas son adecuadas para una gestión exhaustiva de registros, otras para entornos de código abierto y otras para la seguridad de contenedores y Kubernetes. Comprender las necesidades específicas de tu organización te orientará hacia la herramienta adecuada.
- Examina las características: Las herramientas pueden tener funciones básicas similares, pero los detalles son importantes. Las características únicas de cada herramienta, su facilidad de uso y sus integraciones con otras herramientas que utilizas pueden marcar la diferencia en tu experiencia de supervisión.
- Considera el precio: Aunque el coste suele ser un factor importante, es fundamental considerar lo que obtienes a cambio de tu inversión. Una herramienta más cara puede ofrecer las funciones avanzadas o la asistencia que necesitas y, en algunos casos, una herramienta más económica o incluso gratuita puede satisfacer tus necesidades.
Recuerda que la herramienta «mejor» depende por completo de los requisitos y las circunstancias específicos de tu organización. Con la información de esta guía, estás bien encaminado para tomar una decisión fundamentada.