

Som erfaren yrkesperson med insyn i API:er, mikrotjänster och en mängd fullstacktekniker är jag medveten om den avgörande betydelsen av effektiv prestandaövervakning. Under årens lopp har jag på nära håll upplevt fördelarna med att använda heltäckande AIOps-plattformar, till exempel dessa alternativ till Dynatrace, som erbjuder snabba möjligheter till felsökning och analys av grundorsaker.
Dessa ersättare till Dynatrace är inte bara användarvänliga, utan imponerar också med sina robusta övervakningsfunktioner. Den sömlösa integrationen med populära plattformar som Slack bidrar till att förbättra teamkommunikationen i kritiska situationer. Med omfattande profilering och modulära lösningar till hands får du en kraftfull övervakningsplattform som kan lyfta din teknikstack och den övergripande produktiviteten.
Vad är Dynatrace?
Dynatrace är en plattform för övervakning av applikationsprestanda (APM) som hjälper dig att spåra, analysera och optimera hur dina appar och din infrastruktur fungerar. Den används av DevOps-team, SRE:er och IT-ledare som behöver upptäcka problem tidigt och förbättra användarupplevelsen. Övervakning i realtid, AI-drivna aviseringar och spårning från början till slut hjälper till att hitta långsamma delar, fastställa grundorsaker och hålla systemen igång smidigt. Sammantaget hjälper Dynatrace ditt team att ligga steget före prestandaproblem innan de påverkar användarna.
Varför du kan lita på våra programvarurekommendationer
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Expertgranskare:
- Paulo Gardini MiguelTeknikdirektör
 Tim FisherVP för AI
 Gabriel RosasTech Lead & mjukvaruarkitekt
 Christhian GruhnTech Lead & plattformsarkitekt

Jämförelsetabell över alternativ till Dynatrace
Den här jämförelsetabellen sammanfattar prisuppgifterna för mina främsta alternativ till Dynatrace:
Score legend (out of 5)
- Excellent4.5–5
- Good4–4.4
- Average3–3.9
- Below average2–2.9
- Poor1–1.9
Sorted by: Default
| Tool | Starting Price | Website | |||||||
|---|---|---|---|---|---|---|---|---|---|
Bäst för felåtgärd i realtid | 3.3 out of 5 | 4 | 4 | 1 | 3 | 4 | 4 | $26/månad Gratisversion tillgänglig | Website |
Bäst för omfattande tekniskt stöd | 3.3 out of 5 | 3 | 3 | 4 | 3 | 3 | 4 | $32.92/månad Gratisabonnemang tillgängligt | Website |
Bäst för olika applikationsmiljöer | 3.2 out of 5 | 3 | 3 | 3 | 4 | 2 | 4 | $10/månad 30 dagars kostnadsfri provperiod | Website |
Bäst för övervakning med öppen källkod på företagsnivå | 3.3 out of 5 | 2 | 4 | 5 | 4 | 3 | 2 | Gratis Nej | Website |
Bäst för omfattande övervakning av IT-infrastruktur | Not rated | Not rated | 4 | 4 | 2 | 1 | 2 | $2,595 som engångsavgift 30 dagars kostnadsfri provperiod | Website |
Bäst för enhetlig spårning av molntjänster | 4.2 out of 5 | 5 | 4 | 3 | 4 | 4 | 5 | $15/månad Nej | Website |
Bäst för insyn i affärsprestanda i realtid | 3.2 out of 5 | 2 | 3 | 4 | 4 | 2 | 4 | $6/vCPU/månad Nej | Website |
Bäst för att fråga efter telemetri i ett enhetligt datalager | 4.0 out of 5 | 4 | 4 | 4 | 3 | 4 | 5 | $12/användare/månad Nej | Website |
Bäst för logghantering och säkerhetsanalys | 3.5 out of 5 | 3 | 4 | 4 | 3 | 4 | 3 | $108 per användare och månad Nej | Website |
Bäst för storskalig dataanalys och insikter | 3.7 out of 5 | 4 | 3 | 4 | 4 | 3 | 4 | $150/user/month Nej | Website |


Recensioner av de bästa alternativen till Dynatrace
Nedan hittar du mina detaljerade sammanfattningar av de bästa alternativen till Dynatrace som kom med på min kortlista. Mina recensioner ger en detaljerad överblick över de viktigaste funktionerna, fördelarna & nackdelarna, integrationerna och de ideala användningsområdena för varje verktyg, så att du kan hitta det bästa alternativet för dig.
 Bäst för felåtgärd i realtid
- Gratisversion tillgänglig
- Från $26/månad (faktureras årsvis)
Visit WebsiteCustomer Rating:4.5/5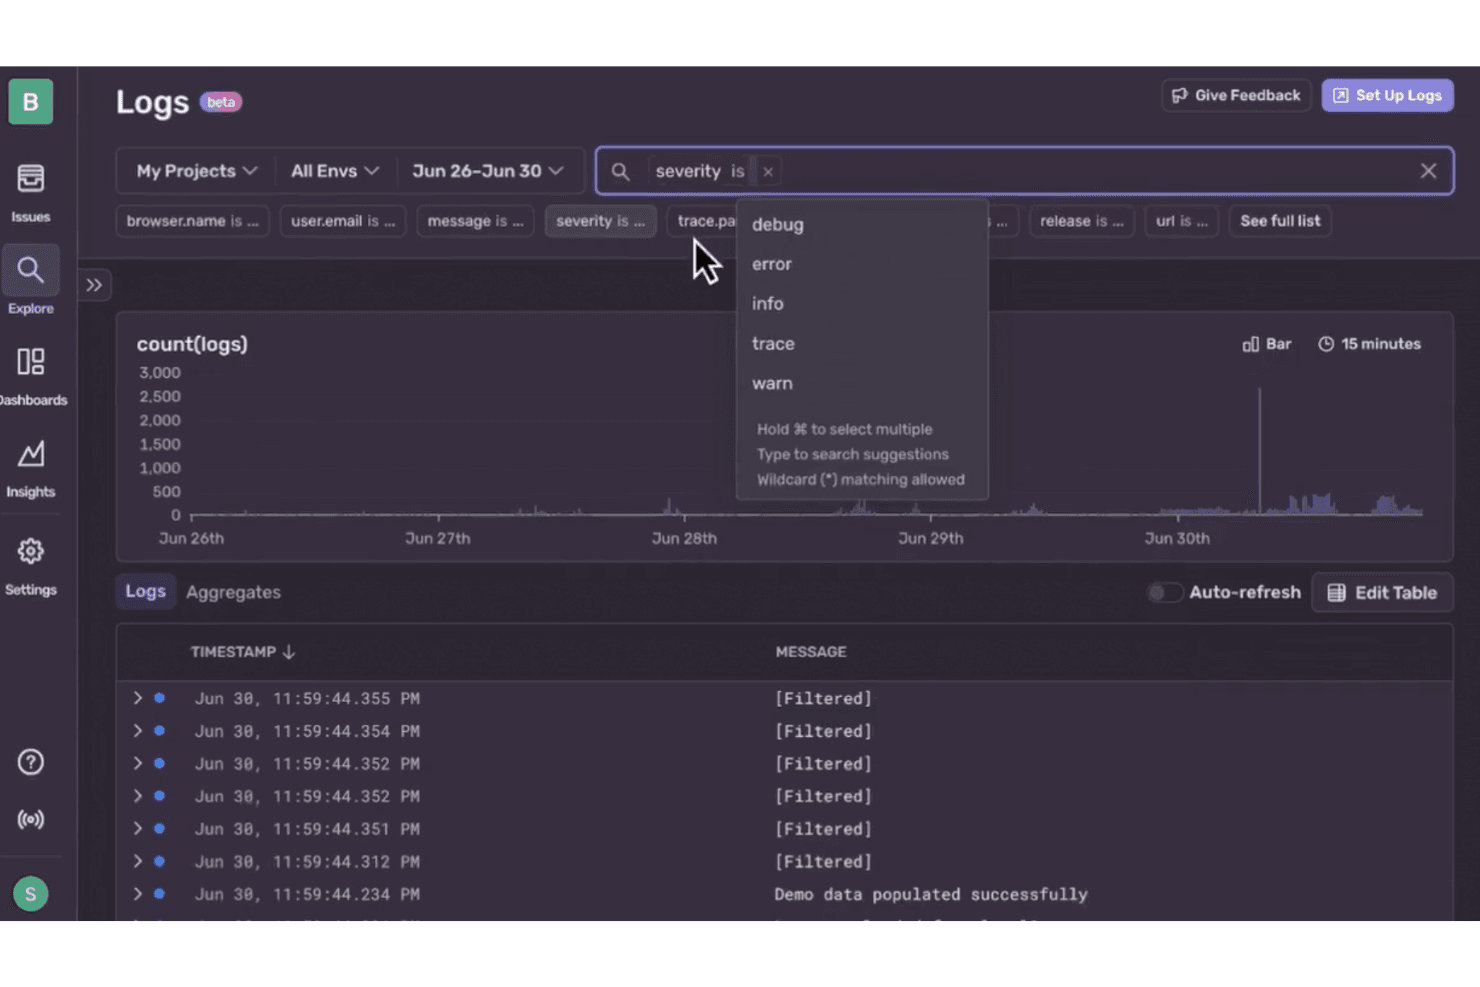
Sentry låter användare filtrera loggar efter allvarlighetsnivåer som felsökning, fel eller varning. Sentry kombinerar övervakning av applikationsprestanda med felspårning och ger mjukvaruteam ett utvecklarfokuserat alternativ till Dynatrace för att diagnostisera problem i applikationer och tjänster.
Vem passar Sentry bäst för?
Sentry passar bra för mjukvaruutvecklings- och DevOps-team som behöver identifiera och lösa produktionsfel i realtid.
Varför jag valde Sentry
Jag valde Sentry som mitt alternativ för ”Bäst för felåtgärd i realtid” eftersom tjänsten kopplar produktionsfel till stackspårningar och spårningsdata, vilket hjälper utvecklare att hitta felande kodvägar. Versionshälsa och regressionsspårning kan också visa när en driftsättning introducerar nya problem, så att team kan prioritera åtgärder samtidigt som de övervakar applikationens prestanda.
Sentrys viktigaste funktioner
- Kontinuerlig profilering: Visa CPU-profiler på funktionsnivå för applikationer som stöds.
- Webbprestandamått: Följ webbläsarmått som sidladdning och svarstid vid interaktioner.
- Övervakning av databasfrågor: Granska frågornas varaktighet och identifiera långsamma databasoperationer.
- Anpassad instrumentering: Lägg till mätningar för att övervaka applikationsspecifika operationer.
Sentrys integrationer
Sentry erbjuder integrationer med GitHub, GitLab, Jira, Slack, Microsoft Teams, PagerDuty, Azure DevOps, Bitbucket, Vercel och Opsgenie. Dess integrationsplattform och REST API stöder anpassade integrationer.
Pros and Cons
Pros:
- Stackspårningar påskyndar felsökning i produktion
- Korrelerar fel med spårningar och profiler
- Versionsspårning flaggar regressionsproblem efter driftsättningar
Cons:
- Ingen övervakning av värdar eller infrastruktur
- Problemgruppering och aviseringar kan skapa brus
Learn more about Sentry: Bäst för omfattande tekniskt stöd
- Gratisabonnemang tillgängligt
- Från $32.92/månad (faktureras årsvis)
Visit WebsiteCustomer Rating:4.3/5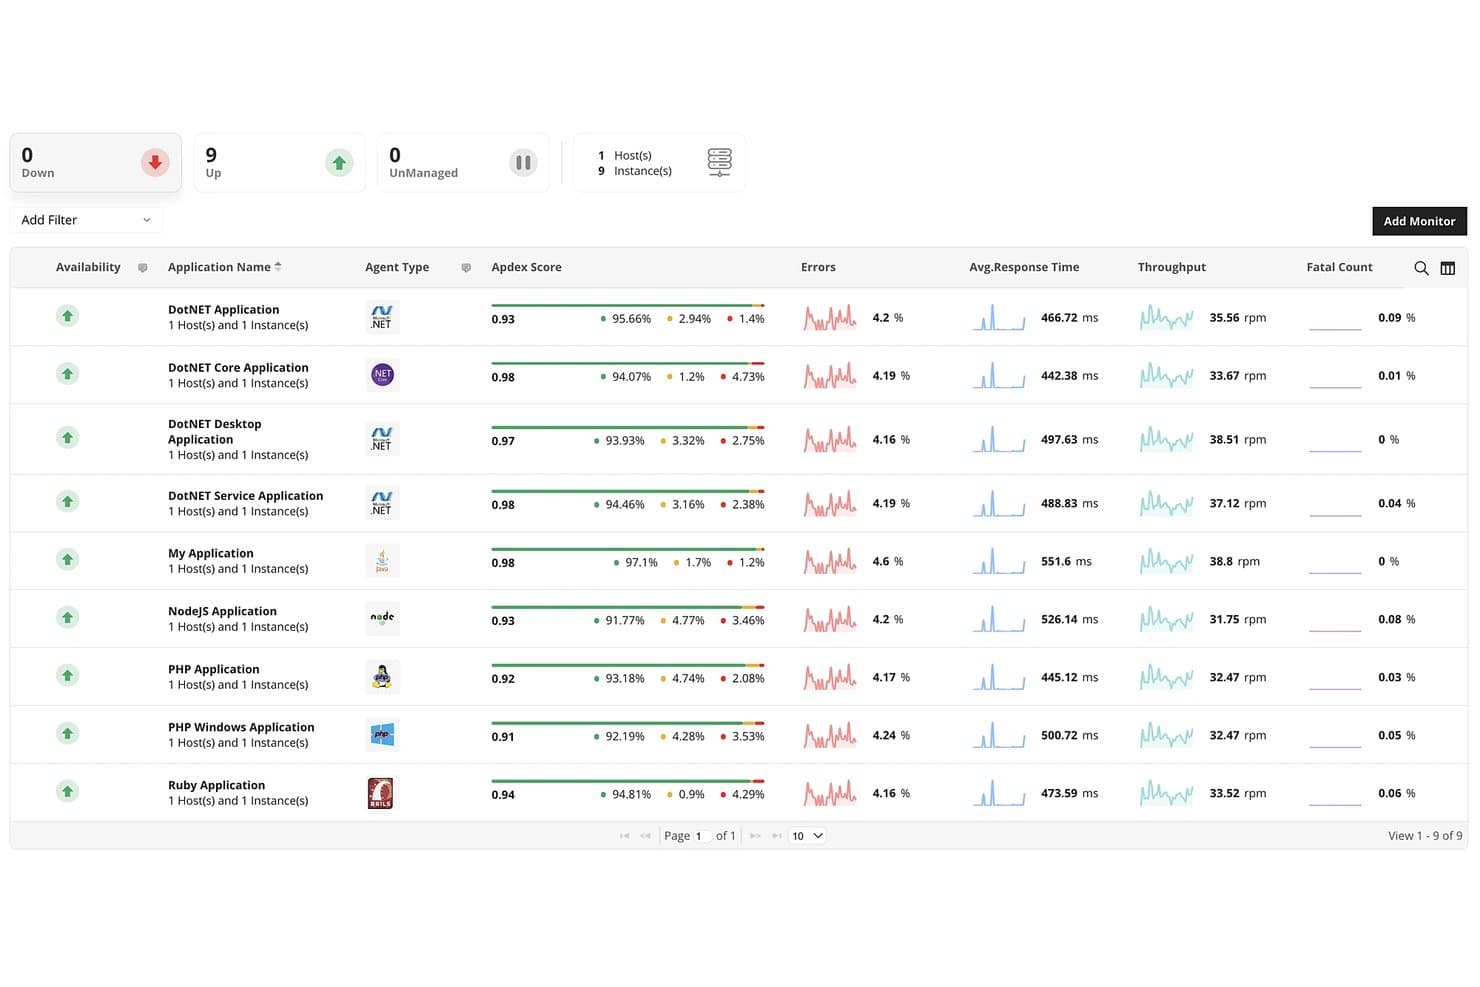
ManageEngine Applications Manager spårar mått för applikationsprestanda i flera instanser. ManageEngine Applications Manager är en plattform för övervakning av applikationsprestanda för IT-team som behöver spåra avmattningar och avbrott i applikationer, servrar, databaser och molntjänster.
För vem passar ManageEngine Applications Manager bäst?
IT-driftteam som övervakar olika applikations- och infrastruktursmiljöer i lokala system och molnsystem.
Varför jag valde ManageEngine Applications Manager
Jag valde ManageEngine Applications Manager, ”Bäst för omfattande tekniskt stöd”, eftersom det övervakar applikationer tillsammans med servrar, databaser och molntjänster. Jag uppskattar den bredden för att spåra en långsam begäran genom applikations- och infrastrukturlagren och sedan använda transaktionsdiagnostik för att lokalisera var fördröjningen byggs upp.
Viktiga funktioner i ManageEngine Applications Manager
- Avvikelsedetektering: Jämför prestandamått med historiska baslinjer eller anpassade regler.
- Logghantering: Sök i, filtrera och tolka applikations- och serverloggar i realtid.
- Övervakning av verkliga användare: Spåra sidvisningar, klick, sessionslängd och Apdex-poäng från faktisk trafik.
- Kapacitetsprognoser: Granska trendrapporter och maskininlärningsbaserade prognoser för att planera resursbehov.
Integrationer med ManageEngine Applications Manager
ManageEngine Applications Manager dokumenterar integrationer med ManageEngine ServiceDesk Plus, ManageEngine OpManager, Slack och ServiceNow samt Syslog-kompatibla SIEM-plattformar som Splunk, Microsoft Sentinel och ManageEngine Log360. Det tillhandahåller även REST API:er för anslutning av interna portaler och tredjepartssystem.
Pros and Cons
Pros:
- Övervakar applikationer, databaser, servrar och moln
- Realtidsaviseringar stödjer proaktiv felsökning
- Bred täckning av äldre och hybrida miljöer
Cons:
- Avancerad tröskeljustering kräver tid för konfiguration
- Mindre djupgående stöd för spårning i molnnativa miljöer
Learn more about ManageEngine Applications Manager: Bäst för olika applikationsmiljöer
- 30 dagars kostnadsfri provperiod
- Från $10/månad
Visit WebsiteCustomer Rating:4.7/5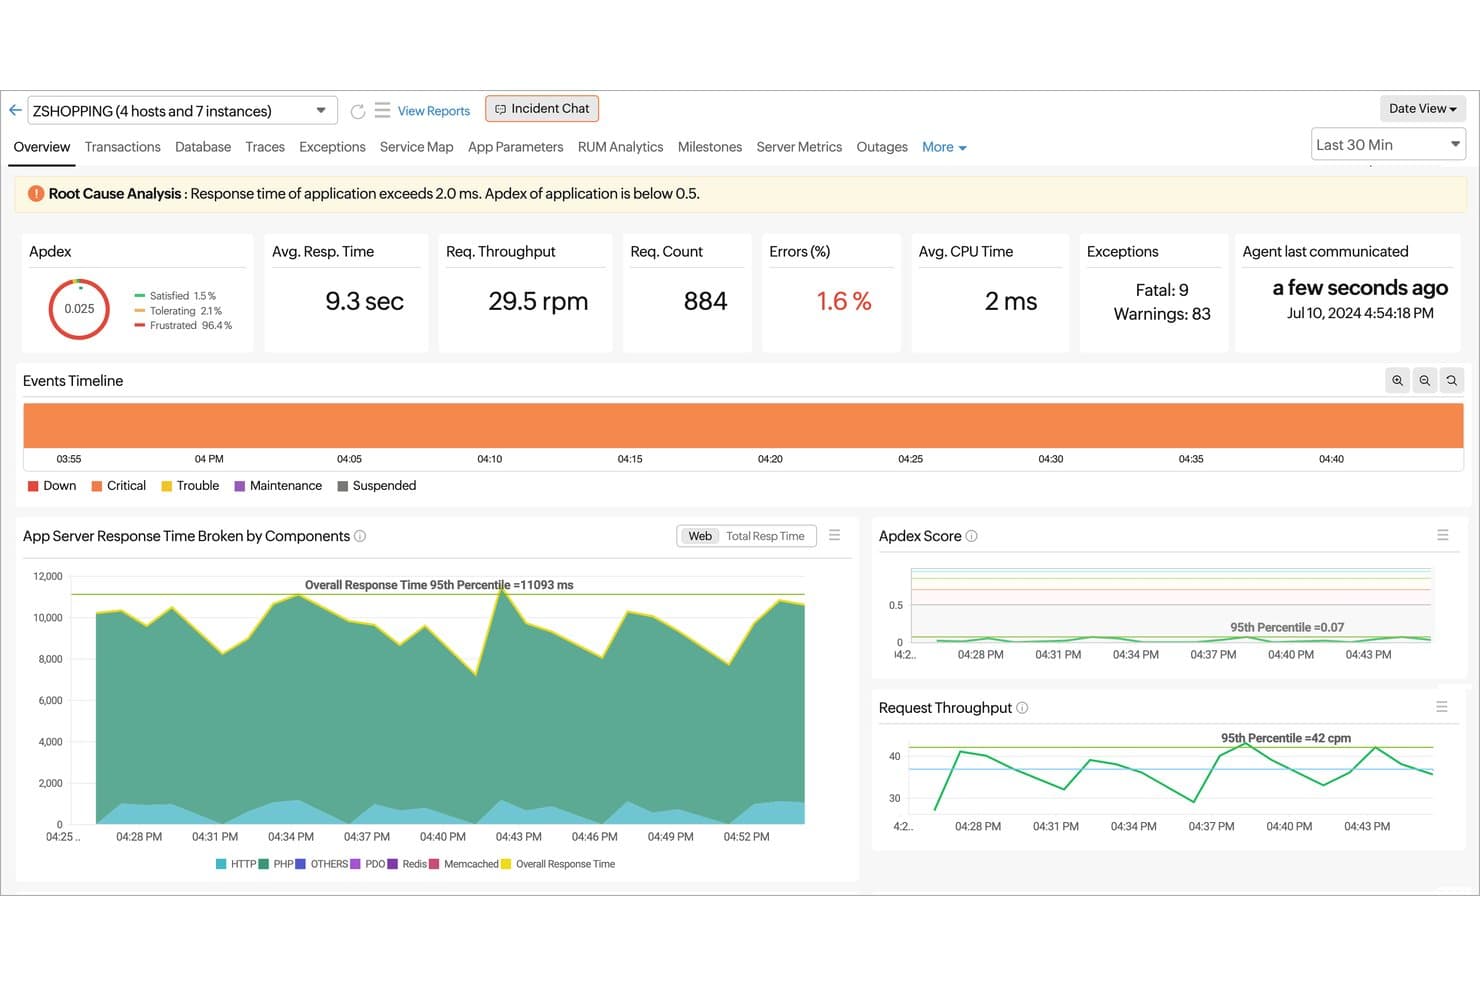
Site24x7 visar rotorsaksanalys och APM-mätvärden i en vy. Site24x7 är en plattform för IT-observabilitet och övervakning för team som utvärderar alternativ till Dynatrace och hjälper IT-specialister att följa applikations- och infrastrukturprestanda, diagnostisera tjänsteproblem och övervaka hybrida miljöer.
För vem passar Site24x7 bäst?
Site24x7 passar IT-team som övervakar applikationer och infrastruktur i olika hybrida miljöer.
Därför valde jag Site24x7
Jag valde Site24x7 för användningsfallet ”Bäst för olika applikationsmiljöer” eftersom deras APM har stöd för Java, .NET, PHP, Ruby, Node.js och Python. Jag uppskattar hur distribuerad spårning och diagnostik på kodnivå hjälper mig att följa långsamma transaktioner genom olika tjänster, medan stödet för OpenTelemetry passar instrumenterade miljöer.
Viktiga funktioner i Site24x7
- Serverövervakning: Följer CPU-, minnes-, disk- och nätverksmätvärden på fysiska, virtuella och molnbaserade servrar.
- Nätverksövervakning: Mäter enheters hälsa, bandbredd, latens och trafik i routrar, switchar och brandväggar.
- Logghantering: Samlar in och söker i loggar från applikationer, system och molnkällor.
- Webbplatsövervakning: Kontrollerar webbplatsers tillgänglighet från över 130 platser världen över.
Integreringar med Site24x7
Site24x7 har stöd för integreringar med ServiceNow, PagerDuty, Jira, Slack, Microsoft Teams, Opsgenie, Amazon EventBridge och Zapier. Plattformen tillhandahåller även REST-API:er för anpassade integreringar.
Pros and Cons
Pros:
- Övervakar applikationer i olika hybrida miljöer
- Spårar transaktioner i applikationer med olika programmeringsspråk
- Kontrollerar webbplatstillgänglighet från 130+ platser
Cons:
- Finjustering av aviseringar kan ge falska positiva resultat
- Panelerna känns röriga och har begränsade anpassningsmöjligheter
Learn more about Site24x7:
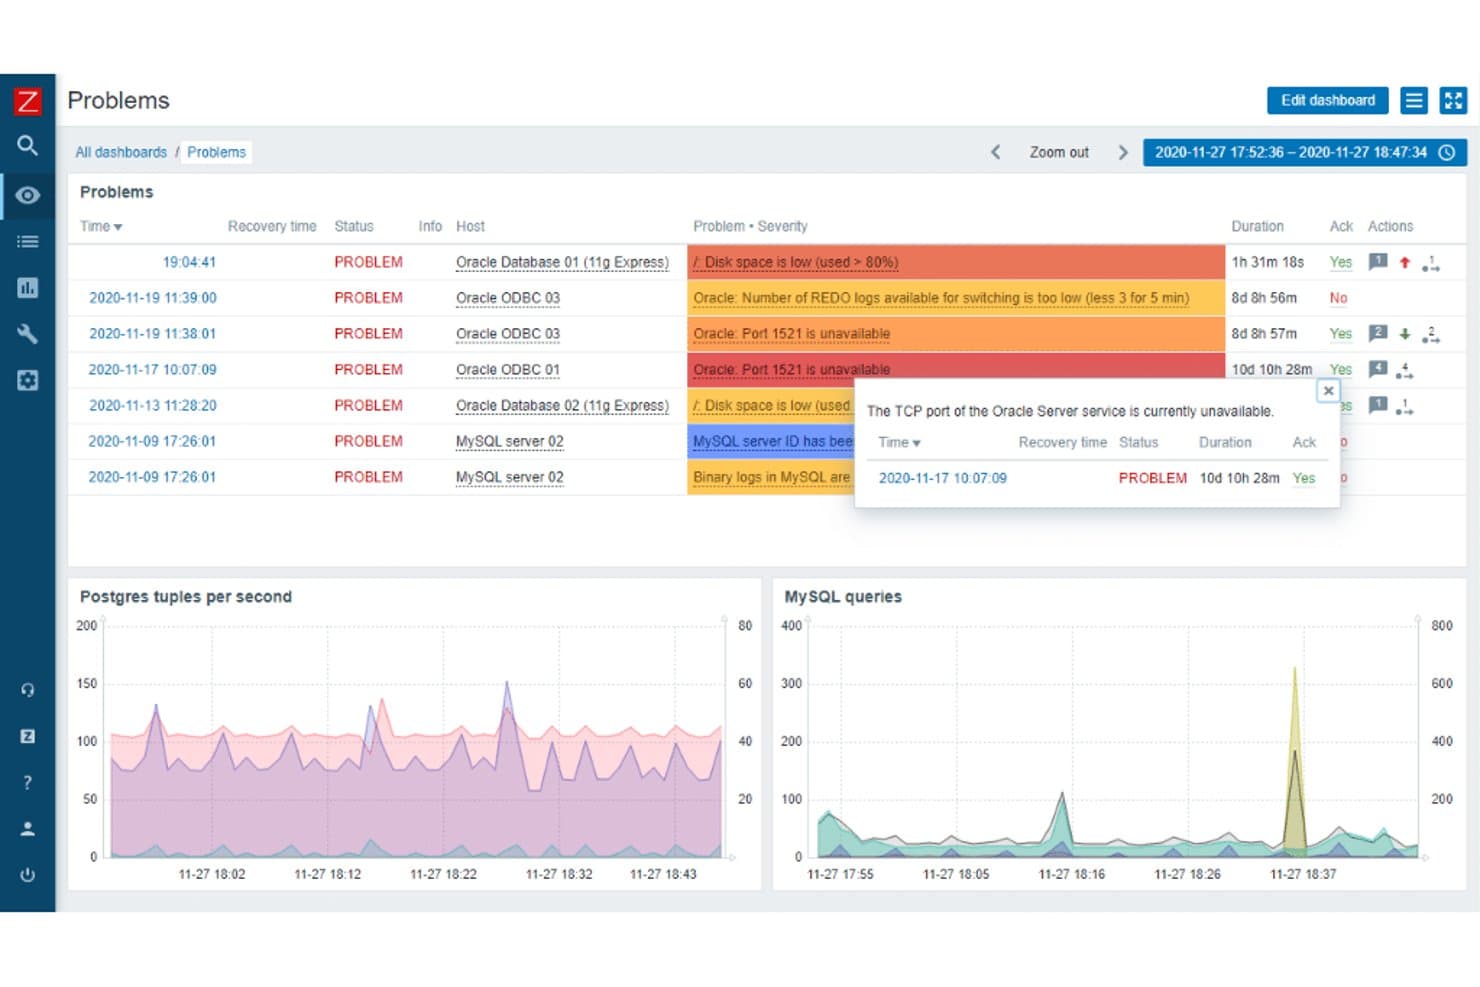
Zabbix visar aktiva databas- och serverproblem med detaljer om allvarlighetsgrad. Zabbix är en plattform för infrastrukturövervakning för IT-team som behöver spåra servrar, nätverk och applikationer, upptäcka tjänsteproblem och hantera insyn i komplexa miljöer.
Vem passar Zabbix bäst för?
Zabbix passar IT-driftteam på företagsnivå som behöver anpassningsbar övervakning med öppen källkod i stora, distribuerade miljöer.
Varför jag valde Zabbix
Jag valde Zabbix för denna guide till de främsta alternativen till Dynatrace eftersom det är bäst för övervakning med öppen källkod på företagsnivå. Jag uppskattar hur distribuerade proxyservrar samlar in data från fjärrplatser, medan återanvändbara mallar tillämpar kontroller och utlösare på servrar och nätverksenheter. Det ger driftteam möjlighet att övervaka en stor och blandad miljö utan att vara beroende av en proprietär plattform.
Viktiga funktioner i Zabbix
- Händelsekorrelation: Definiera regler för att gruppera relaterade problem och undertrycka symtomrelaterade händelser.
- Webbövervakning: Följ flerstegswebbscenarier och svarstider.
- Nätverkskartor: Skapa kartor som visar övervakade värdar, länkar och aktuella problem.
- Upptäckt på låg nivå: Identifiera automatiskt entiteter som nätverksgränssnitt och skapa objekt för att övervaka dem.
Zabbix-integrationer
Zabbix officiella katalog över integrationer listar 1 986 lösningar från 559 varumärken, däribland AWS, Azure, Kubernetes, ServiceNow, Slack, Jira och PagerDuty. Plattformen tillhandahåller även ett HTTP-baserat JSON-RPC-API och anpassningsbara JavaScript-webbhakar för anpassade integrationer.
Pros and Cons
Pros:
- Skalar över distribuerade platser med proxyservrar
- Återanvändbara mallar standardiserar kontroller i serverparker
- Korrelerar relaterade varningar för att minska brus
Cons:
- Den inledande installationen kräver omfattande manuell konfiguration
- Stora distributioner kräver optimering av databaser och proxyservrar
 Bäst för omfattande övervakning av IT-infrastruktur
- 30 dagars kostnadsfri provperiod
- Från $2,595 som engångsavgift
Visit WebsiteCustomer Rating:4.6/5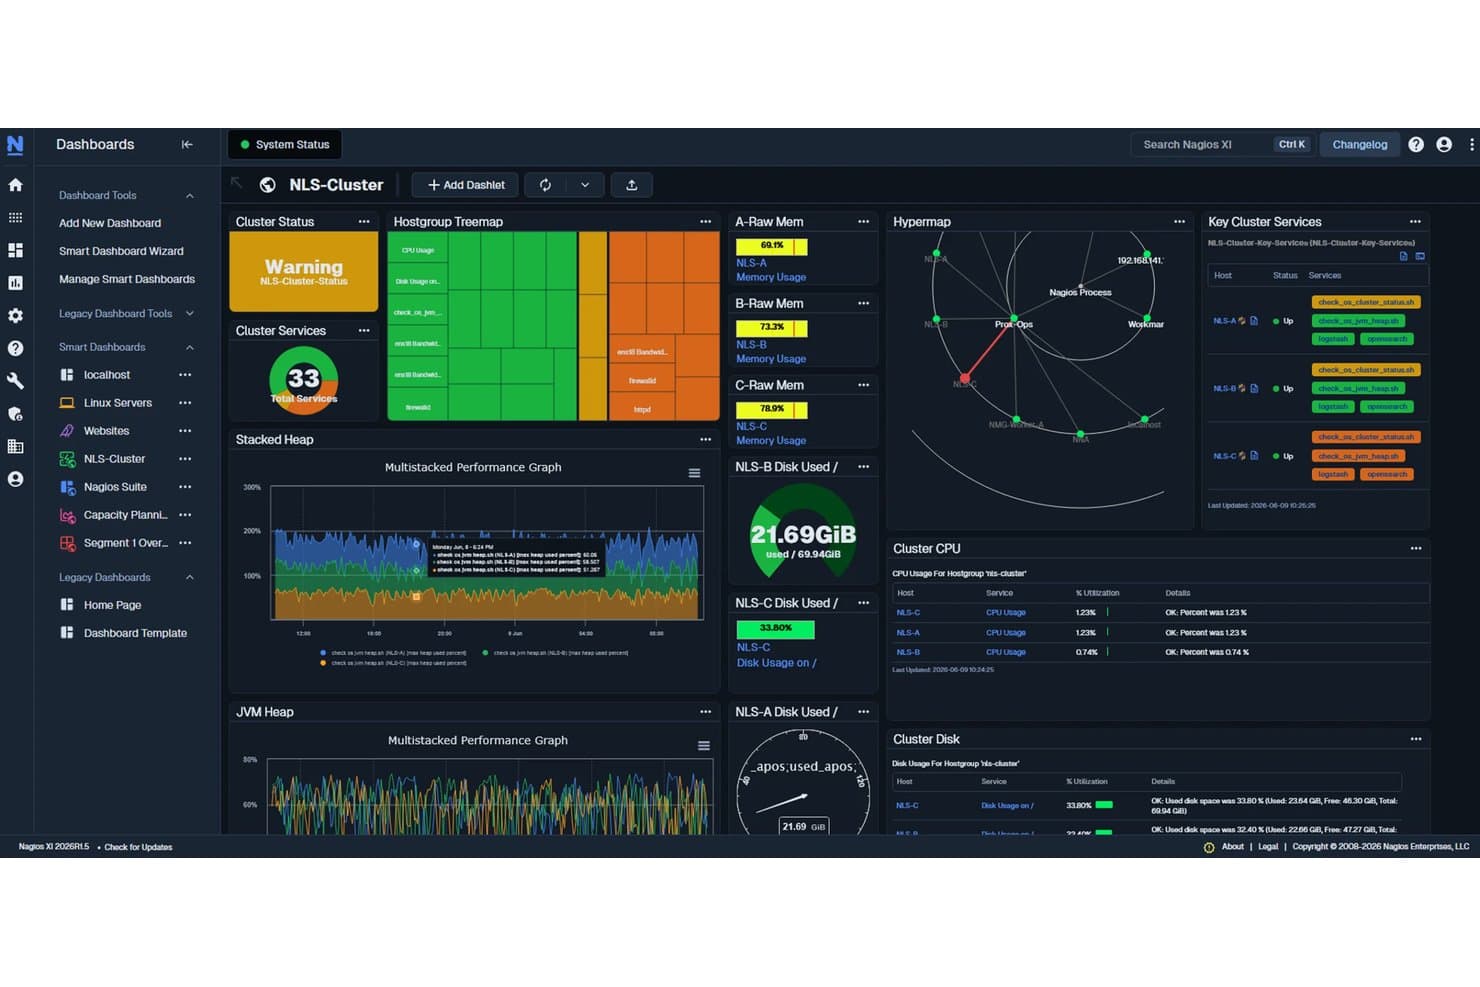
Nagios XI samlar övervakning av klusterhälsa, CPU, disk och tjänster i en enda instrumentpanel. Nagios ger IT-teamet konfigurerbar övervakning av värdar och tjänster för att upptäcka avbrott på servrar, nätverksenheter och i applikationer i varierande infrastrukturer.
Vem passar Nagios bäst för?
Nagios passar infrastruktur- och driftteam som behöver konfigurerbar övervakning i blandade miljöer, inklusive etablerade system och nätverksutrustning.
Varför jag valde Nagios
Jag valde Nagios för en guide om alternativ till Dynatrace eftersom det passar kategorin ”Bäst för omfattande övervakning av IT-infrastruktur” med pluginbaserade kontroller av värdar och tjänster. Jag använder SNMP-kontroller för att övervaka switchar och routrar tillsammans med serverhälsa och konfigurerar sedan aviseringar när kontroller misslyckas. Det gör att jag kan övervaka blandad infrastruktur i ett enda övervakningssystem.
Viktiga funktioner i Nagios
- Automatisk upptäckt: Identifierar enheter och tjänster i nätverket.
- Konfigurationsguider: Vägleder konfigurationen av vanliga enheter och applikationer.
- Instrumentpaneler: Visar statussammanfattningar, kartor och diagram i anpassningsbara vyer.
- Prestandagrafer: Visar övervakningsdata över tid.
Integrationer med Nagios
Nagios XI har dokumenterade integrationer med Slack och PagerDuty för aviseringar om varningar och incidenthantering, konfigurerade via skript och aviseringsinställningar. Dess REST API stöder anpassade anslutningar till verktyg som CMDB- och ärendehanteringssystem.
Pros and Cons
Pros:
- Övervakar blandade värdar genom anpassade kontroller
- Tillförlitliga aviseringar med konfigurerbara tröskelvärden
- Instrumentpaneler visar status och historiska trender
Cons:
- Den initiala konfigurationen kräver expertkunskaper inom Linux-övervakning
- Externa plugin-program kan vara inaktuella eller sakna dokumentation
Learn more about Nagios: Bäst för enhetlig spårning av molntjänster
- Nej
- Från $15/månad (faktureras årsvis)
Visit WebsiteCustomer Rating:4.5/5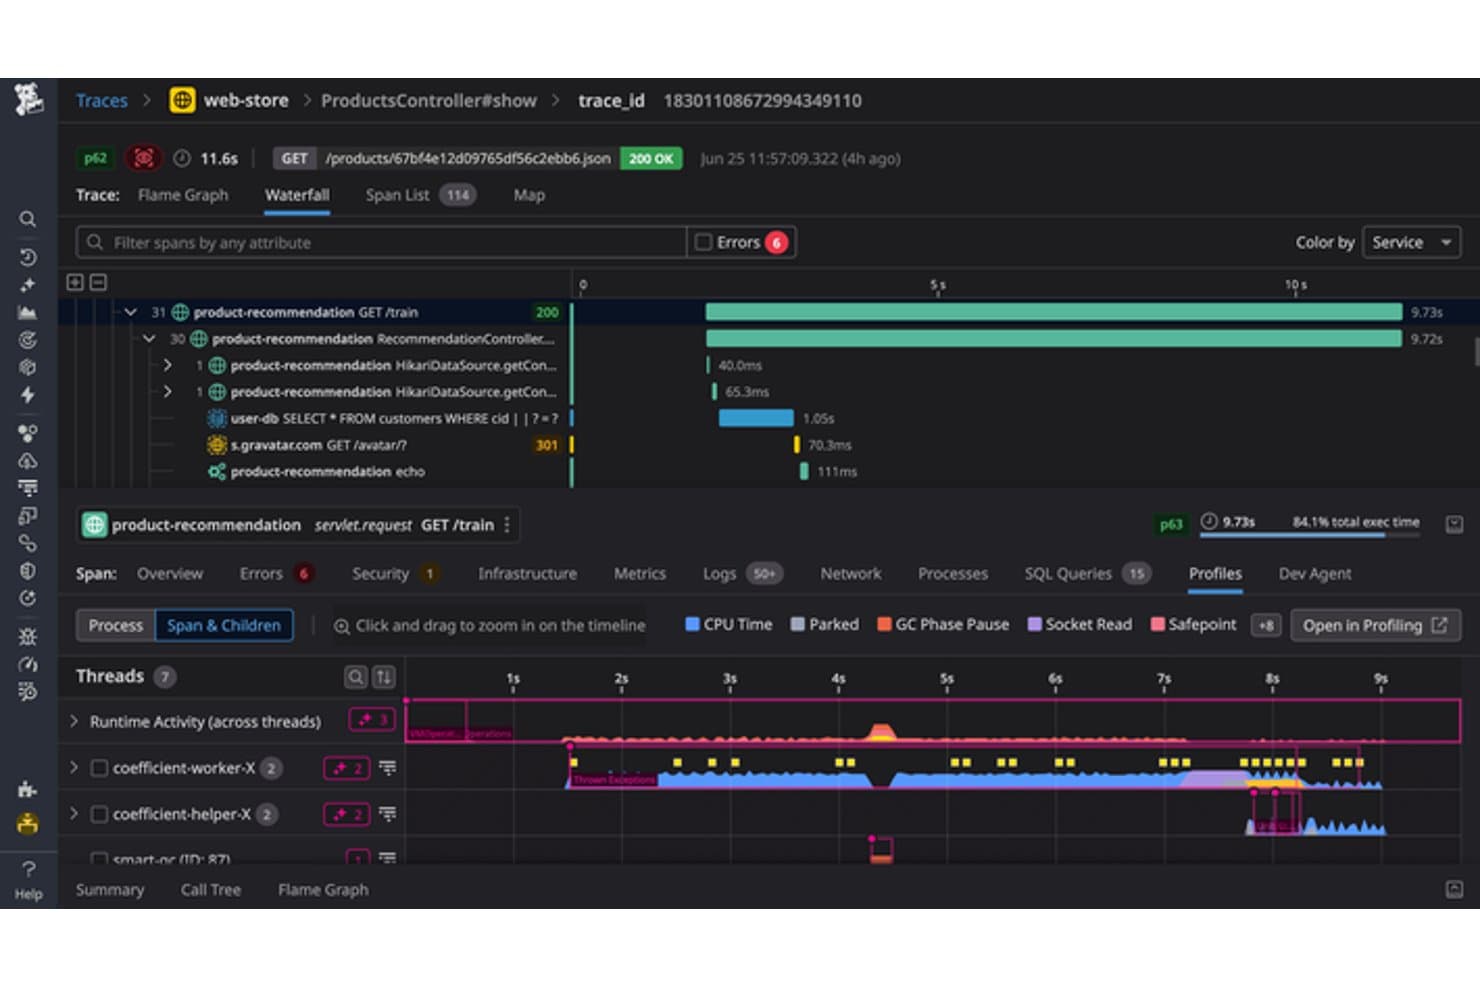
Datadogs APM spårar CPU, trådar och tidslinjer för spann i detalj. Datadog är en observerbarhetsplattform för IT- och DevOps-team som samlar data om applikationer, infrastruktur, loggar och säkerhet för att hjälpa till att diagnostisera prestandaproblem i molnbaserade miljöer.
Vem passar Datadog bäst för?
Molndrift- och SRE-team kan använda Datadog för att övervaka tjänsternas hälsa i distribuerad infrastruktur och hitta problem som påverkar produktionsarbetsbelastningar.
Varför jag valde Datadog
Jag valde Datadog för en guide till de främsta alternativen till Dynatrace eftersom verktyget utses till ”Bäst för enhetlig spårning av molntjänster”. Jag uppskattar hur infrastrukturenheter, distribuerade spår och loggar gör det möjligt att följa en långsam begäran från en molnvärd genom beroende tjänster och granska relaterade fel. Tjänstekartan hjälper mig att hitta ett uppströmsberoende som påverkar produktionens hälsa.
Viktiga funktioner i Datadog
- Övervakning av verkliga användare: Samlar in webbläsarsessioner, frontendfel och sidprestanda.
- Syntetisk övervakning: Kör schemalagda webbläsar- och API-tester mot applikationer.
- Databasövervakning: Visar mätvärden på frågenivå och exekveringsplaner för databaser som stöds.
- Övervakningar och aviseringar: Utvärderar telemetri mot tröskelvärden och skickar aviseringar när villkor uppfylls.
Datadog-integrationer
Datadog erbjuder mer än 1 000 inbyggda integrationer, inklusive AWS, Azure, Google Cloud, Kubernetes, Docker, PostgreSQL, GitHub, Jira, Slack och PagerDuty. Plattformen stöder även anpassade integrationer via sitt API.
Pros and Cons
Pros:
- Korrelerar mätvärden, loggar och spår under incidenter
- Kartlägger beroenden för att hitta fel i uppströms tjänster
- Samlar vyer över infrastrukturens och applikationernas hälsa
Cons:
- Ökande telemetrimängder gör kostnaderna svåra att prognostisera
- Avancerade instrumentpaneler och frågor kräver konfigurationstid
 Bäst för insyn i affärsprestanda i realtid
- Nej
- Från $6/vCPU/månad (faktureras årsvis)
Visit WebsiteCustomer Rating:4.3/5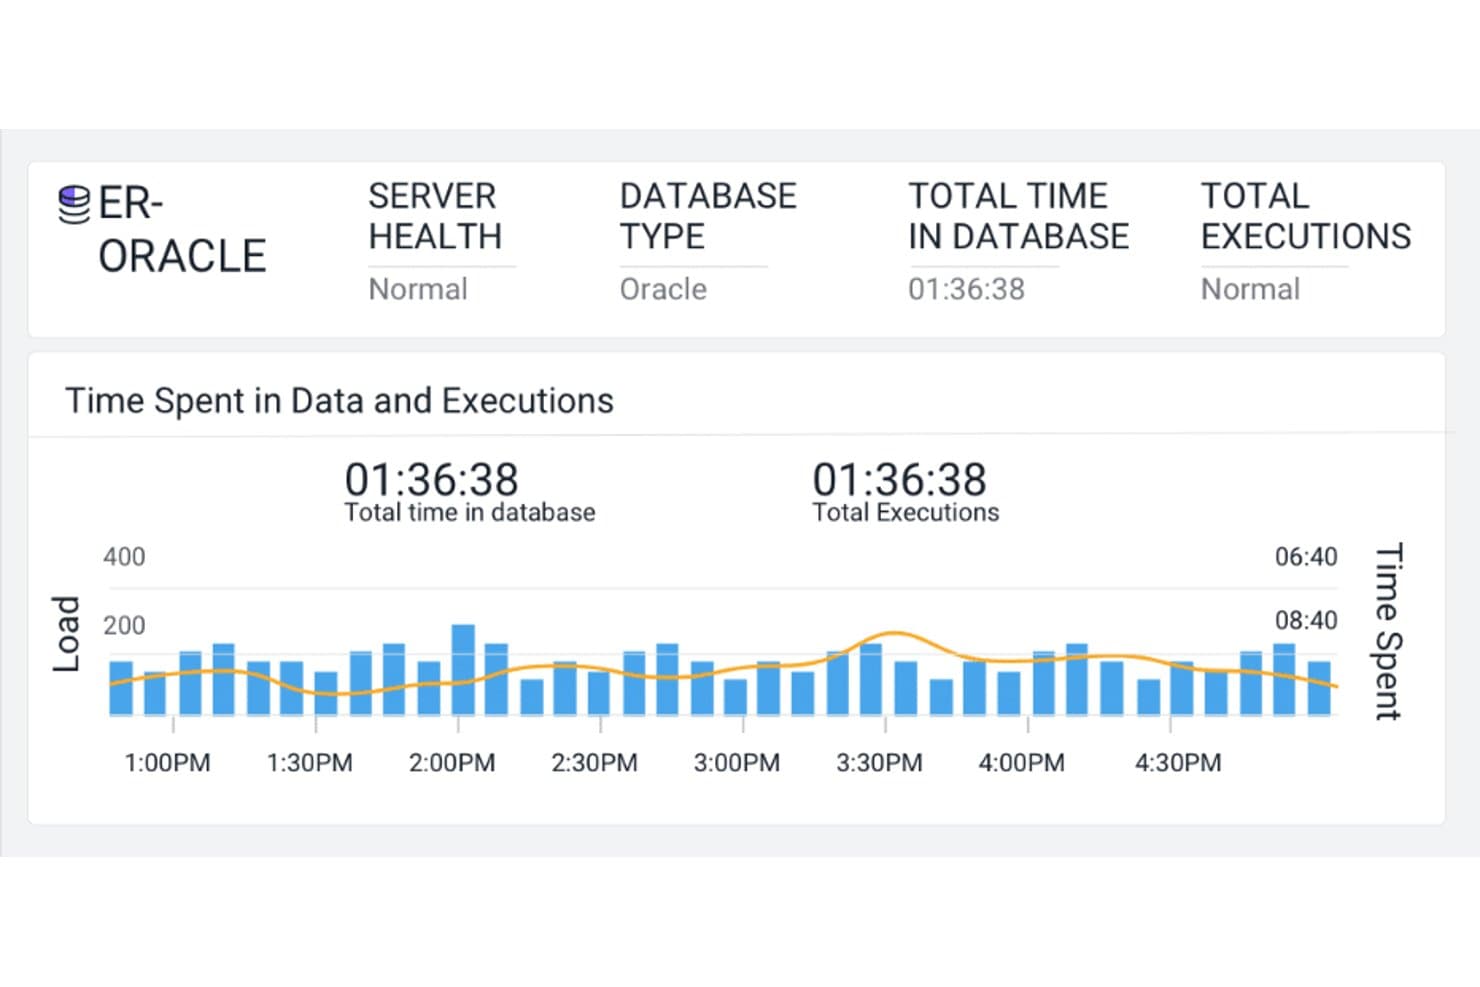
AppDynamics övervakar Oracle-databasens belastning och körningstider visuellt. För IT- och ingenjörsteam som jämför alternativ till Dynatrace kombinerar AppDynamics övervakning av applikationsprestanda med transaktionsspårning för att hjälpa till att lokalisera långsamma processer och fel i komplexa, distribuerade tjänster.
Vem passar AppDynamics bäst för?
AppDynamics passar IT-drift- och applikationsteam som behöver koppla applikationernas aktuella hälsa till de affärstransaktioner som kunderna förlitar sig på.
Varför jag valde AppDynamics
Jag valde AppDynamics eftersom deras fokus, ”Bäst för insyn i affärsprestanda i realtid”, kopplar applikationernas aktuella hälsa till de transaktioner som kunderna är beroende av. Jag uppskattar hur transaktionsspårning hjälper till att lokalisera långsamma processer i distribuerade tjänster, så att jag kan se var en begäran fastnar och koppla problemet till affärsaktiviteten.
Viktiga funktioner i AppDynamics
- Applikationssäkerhet under körning: Upptäck sårbarheter i applikationer och blockera attacker.
- Övervakning av verkliga användare: Registrera webb- och mobilprestanda på olika enheter och i olika webbläsare.
- Syntetisk övervakning: Övervaka webb-, mobil- och API-prestanda med simulerad aktivitet.
- Avvikelsedetektering: Fastställ prestandabaslinjer och flagga avvikelser med AI och maskininlärning.
AppDynamics-integrationer
AppDynamics har en inbyggd tvåvägsintegration med Jira för att skapa och uppdatera incidentärenden samt en integration med Splunk Observability Cloud som fortfarande är i ett tidigt förhandsgranskningsstadium. Plattformen erbjuder även färdiga tillägg och REST API:er för integrationer och automatisering.
Pros and Cons
Pros:
- Affärstransaktionskartor kopplar telemetri till påverkan
- Anropsgrafer stöder analys av grundorsaker på kodnivå
- Baslinjevarningar flaggar avvikelser från det normala
Cons:
- Instrumentering och konfiguration av agenter kräver manuellt arbete
- Gränssnittet känns föråldrat jämfört med nyare verktyg för observerbarhet
Learn more about AppDynamics: Bäst för att fråga efter telemetri i ett enhetligt datalager
- Nej
- $12/användare/månad (faktureras årsvis)
Visit WebsiteCustomer Rating:4.3/5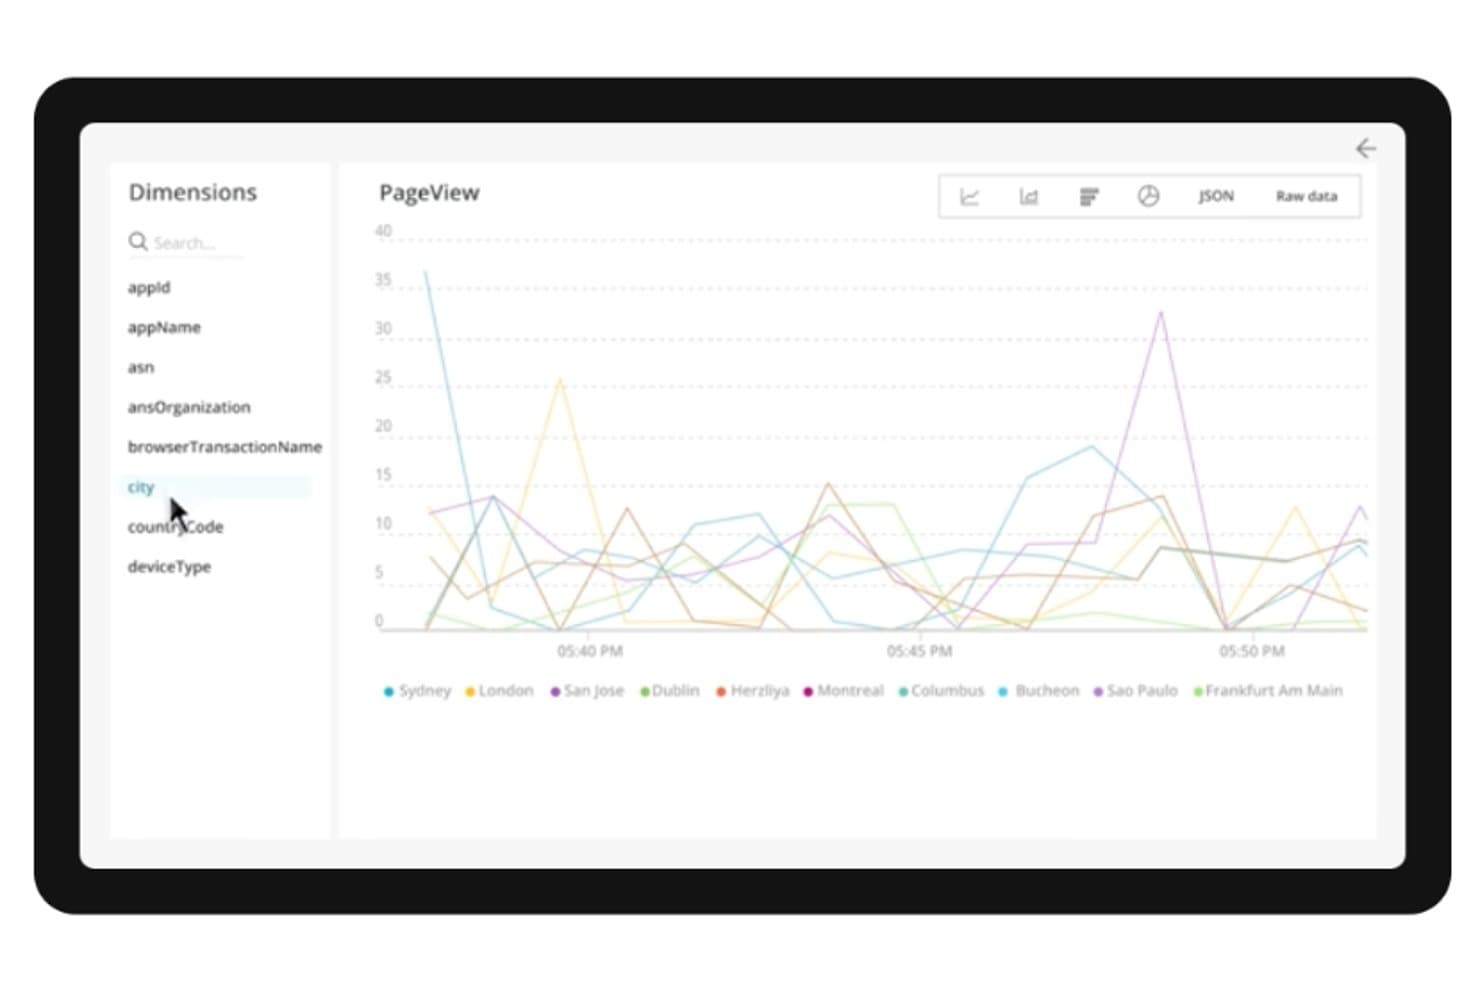
New Relic delar upp PageView-data efter stad i en tidsserie. För IT- och ingenjörsteam som utvärderar alternativ till Dynatrace är New Relic en APM-plattform som hjälper till att spåra programproblem, övervaka tjänsternas hälsa och undersöka långsamma prestanda i distribuerade system.
Vem passar New Relic bäst för?
New Relic passar DevOps- och webbplatstillförlitlighetsteam som behöver koppla samman applikationsspårningar, infrastrukturmätvärden och loggar vid felsökning av produktionsproblem.
Varför jag valde New Relic
Jag valde New Relic för dess fokus på att vara “bäst för omfattande övervakning av applikationsprestanda”: plattformen kopplar samman distribuerade spårningar med tjänsternas hälsa och loggar, vilket hjälper mig att följa långsamma prestanda över flera tjänster. När ett API blir långsammare efter en lansering kan jag spåra dess begäransväg och kontrollera relaterade tjänstesignaler för att hitta det berörda beroendet.
Viktiga funktioner i New Relic
- Databasövervakning: Granska långsamma databasfrågor och deras körningsdetaljer.
- Diagnostik på kodnivå: Profilera applikationskod för att identifiera metoder som förbrukar CPU-tid.
- Driftsättningsspårning: Markera lanseringar för att jämföra applikationsprestanda före och efter ändringar.
- Varningsvillkor: Ange tröskelvärden för applikationsmätvärden och få aviseringar när de överskrids.
New Relic-integreringar
New Relic stöder integreringar för varningsaviseringar med Atlassian Jira, AWS EventBridge, Microsoft Teams, PagerDuty, ServiceNow och Slack, samt fler än 400 värdbaserade integreringar. Plattformen tillhandahåller även API:er och integreringsverktyget Flex för att skicka anpassade data till New Relic.
Pros and Cons
Pros:
- Korrelerar spårningar, loggar och infrastruktursignaler
- Spårar regressionsproblem efter lanseringar över distribuerade transaktioner
- Kopplar samman applikationsprestanda med webbläsarupplevelsen
Cons:
- Tät navigering kan göra incidentutredningar långsammare
- Ökad datainhämtning kan göra kostnaderna oförutsägbara
Learn more about New Relic: Bäst för logghantering och säkerhetsanalys
- Nej
- $108 per användare och månad (debiteras årsvis)
Visit WebsiteCustomer Rating:4.3/5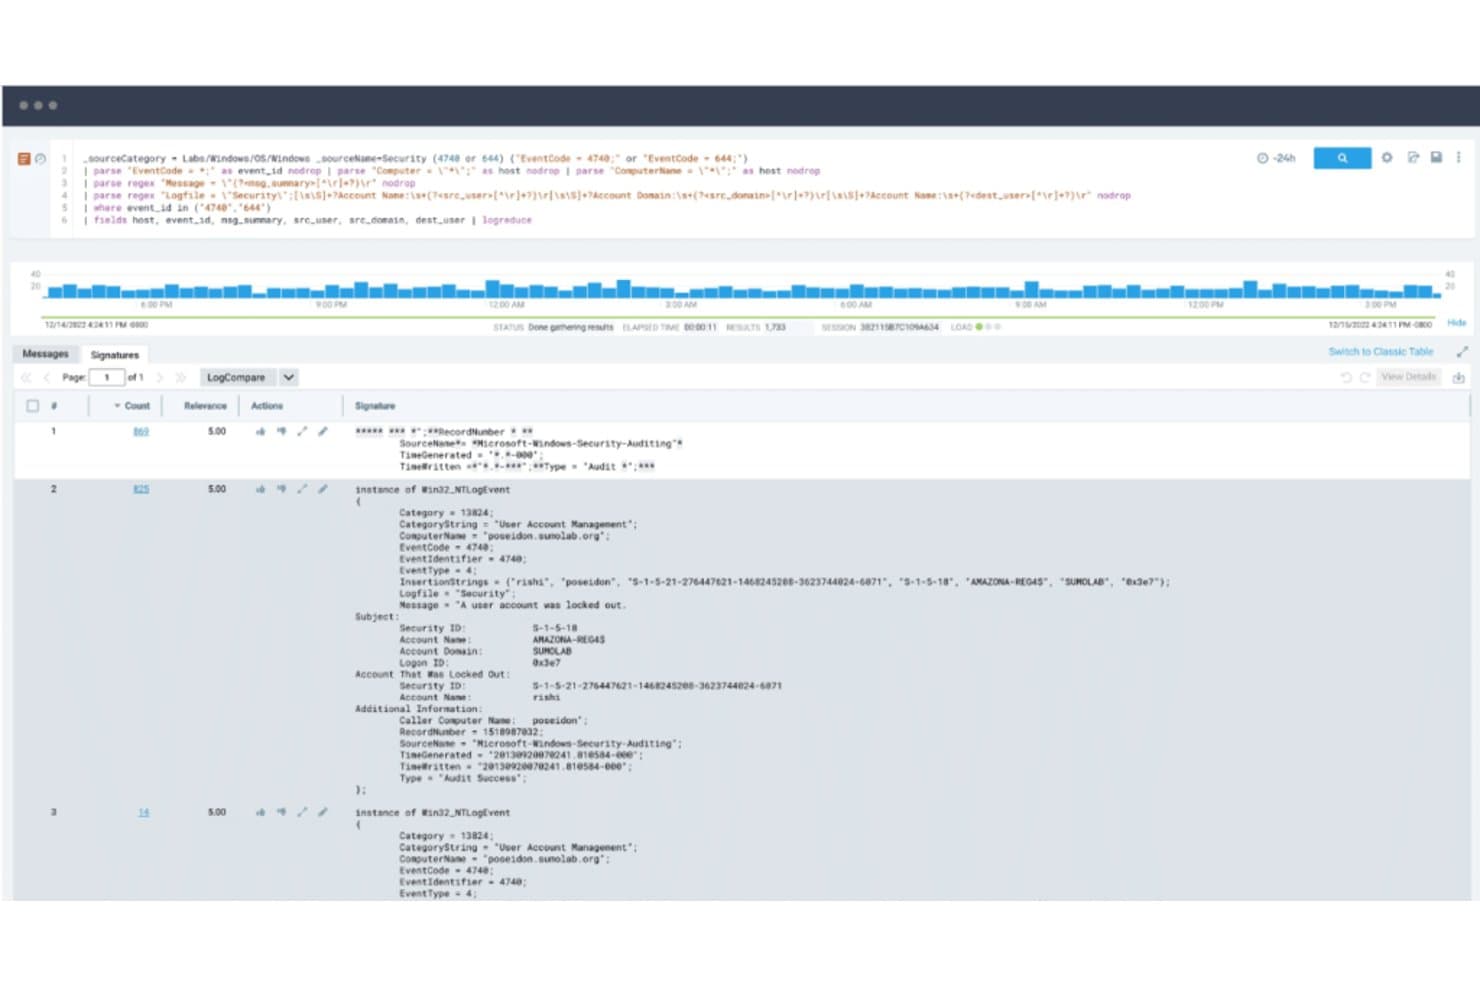
Sumo Logic upptäcker händelser med kontolåsning genom analys av säkerhetsloggar. Sumo Logic är en molnbaserad plattform för observerbarhet som hjälper infrastruktur- och säkerhetsteam att undersöka driftstörningar och förstå aktivitet i distribuerade applikationer, vilket gör den till ett alternativ för team som utvärderar alternativ till Dynatrace.
Vem passar Sumo Logic bäst för?
Säkerhetsanalytiker och IT-driftteam som behöver centraliserad loggdata för felsökning, hotdetektering och utredning passar bra för Sumo Logic.
Varför jag valde Sumo Logic
Jag valde Sumo Logic för den här guiden om alternativ till Dynatrace eftersom den motsvarar “Bäst för logghantering och säkerhetsanalys.” Dess loggsökning hjälper mig att spåra fel över distribuerade tjänster, medan Cloud SIEM korrelerar säkerhetssignaler för att stödja utredning av misstänkt aktivitet.
Viktiga funktioner i Sumo Logic
- Metrikanalys: Fråga tidsseriemetrik med Sumo Logics frågespråk för metriker.
- Distribuerad spårning: Inspektera spårningsintervall för att följa begäranden över instrumenterade tjänster.
- Instrumentpaneler: Skapa visualiseringar från telemetridata och ordna dem i anpassade layouter.
- Övervakare och aviseringar: Definiera villkor för metriker eller frågor som utlöser aviseringar.
Integrationer med Sumo Logic
Sumo Logics appkatalog omfattar hundratals leverantörer och produkter, inklusive AWS, Azure, Datadog, Dynatrace, GitHub och Jira, med erbjudanden som datainsamlingskällor, förbyggda appar och automatiseringsintegrationer. Den tillhandahåller inbyggda webhook-integrationer för ServiceNow och Slack samt REST API:er för anpassade integrationer.
Pros and Cons
Pros:
- Snabba loggsökningar stödjer incidentutredningar
- Centraliserade loggar möjliggör aviseringar i realtid
- Cloud SIEM korrelerar hot för utredning
Cons:
- Det tar tid att lära sig frågespråket
- Logginsamling och parsning behöver förbättras
 10Bäst för storskalig dataanalys och insikter
Splunk
- Nej
- $150/user/month
Visit WebsiteCustomer Rating:4.3/5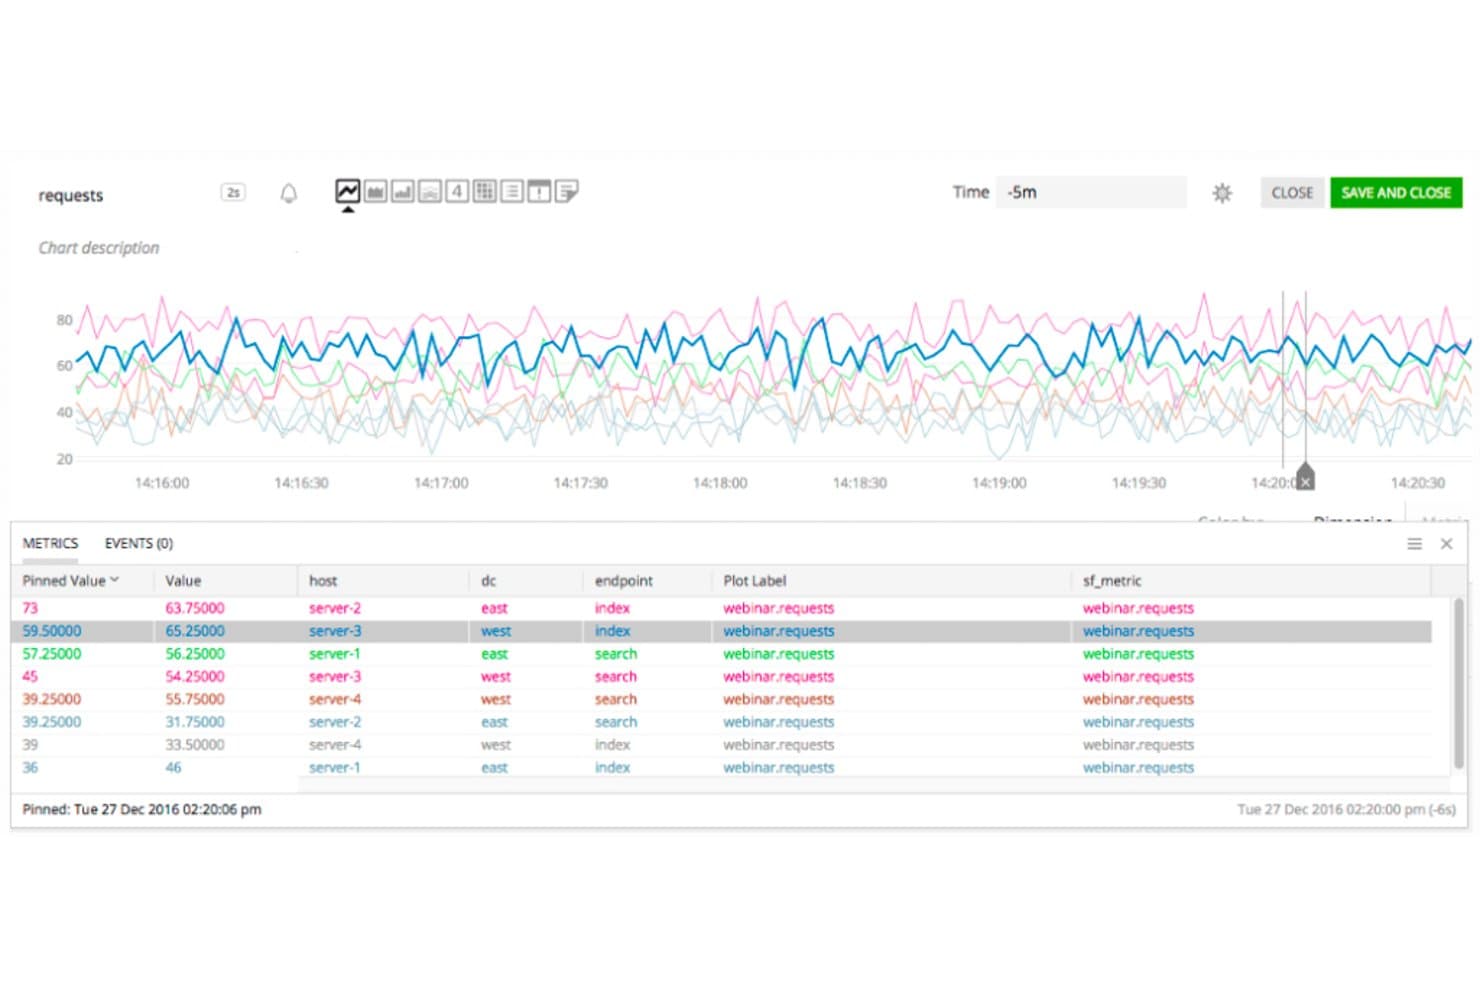
Splunk låter användare övervaka mätvärden för förfrågningar i realtid över servrar och slutpunkter. Splunk kombinerar infrastrukturövervakning med analys av loggar, mätvärden och spårningar, vilket hjälper IT- och driftteam att utreda incidenter i komplexa, distribuerade miljöer.
Vem passar Splunk bäst för?
Splunk passar stora IT- och säkerhetsteam som behöver analysera stora mängder maskindata och upptäcka mönster i komplexa miljöer.
Varför jag valde Splunk
Jag valde Splunk som ett alternativ till Dynatrace på grund av fokuset på ”Bäst för storskalig dataanalys och insikter”. Det kombinerar infrastrukturövervakning med analys av loggar, mätvärden och spårningar, så att jag kan undersöka en tjänsteförsämring i distribuerade system och koppla signaler till relaterade händelser. Det hjälper mig att söka igenom stora mängder maskindata under incidentutredningar.
Splunks viktigaste funktioner
- Anpassade instrumentpaneler: Skapa visuella paneler med diagram, tabeller och tjänstedata.
- Varningsdetektorer: Ange villkor som utlöser varningar när övervakade signaler passerar tröskelvärden.
- Kubernetes-övervakning: Utforska kluster-, nod- och arbetsbelastningsstatus i Kubernetes Navigator.
- Syntetisk övervakning: Kör skriptbaserade tester för att kontrollera applikationstillgänglighet och svarstider.
Splunk-integreringar
Splunk Observability Cloud har stöd för integreringar med AWS CloudWatch, Google Cloud Platform, Microsoft Azure, Jira, Microsoft Teams, PagerDuty, ServiceNow och Slack. Dess API för integreringar konfigurerar anslutningar som stöds, medan Splunkbase tillhandahåller appar, tillägg och anslutningar.
Pros and Cons
Pros:
- Söker igenom stora mängder maskindata efter ledtrådar till incidenter
- Korrelerar loggar, mätvärden och spårningar för utredningar
- Anpassade instrumentpaneler och varningar underlättar fokuserad triagering
Cons:
- Kostnaderna kan öka när mängden insamlad telemetri växer
- Tunga frågor kan göra instrumentpaneler långsammare i stor skala
Learn more about Splunk:
Andra alternativ till Dynatrace
Här är några ytterligare alternativ till Dynatrace som inte kom med på min kortlista, men som ändå är värda att titta närmare på:
- 11PrometheusBäst för robust övervakning i Kubernetes-miljöer
- 12Grafana CloudBäst för visualisering och analys med öppen källkod
- 13ElasticBäst för sökning och dataanalys i realtid
- 14SolarWinds Observability SaaSBäst för AI-driven prioritering av aviseringar
- 15SysdigBäst för container- och Kubernetes-säkerhet
- 16Dotcom MonitorBäst för simuleringar i riktiga webbläsare
- 17IcingaBra för omfattande övervakning med starkt stöd från communityn
Andra programvarurecensioner
- Kodgranskningsverktyg för utvecklare
- Verktyg för webbutveckling
- Verktyg för infrastrukturautomatisering
Så utvärderar jag alternativ till Dynatrace
Jag utvärderar varje verktyg på två nivåer: grundkraven, som fullständig APM och distribuerad spårning, och därefter de särskiljande egenskaper som skiljer plattformar åt för olika team och teknikstackar.
Kärnfunktionalitet (grundkrav för den här listan)
När jag väljer verktyg till min lista betygsätter jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärker sig inom området) för varje kärnfunktion som anges nedan. Därefter omvandlar jag verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå minst 75 % i totalpoäng för att övervägas för inkludering.
- Fullständig APM: Jag kontrollerar om verktyget erbjuder transaktionsspårning på kodnivå för större programmeringsspråk och ramverk, till exempel genom att upptäcka ett långsamt databasanrop som ligger dolt i en Java-mikrotjänst.
- Infrastrukturövervakning: Varje verktyg bör täcka servrar, containrar, Kubernetes-kluster och molntjänster med automatisk identifiering i stället för att kräva manuell konfiguration värd för värd.
- Distribuerad spårning: Jag utvärderar hur spårningar flödar över tjänstegränser och om plattformen stöder inläsning via OpenTelemetry, vilket är viktigt när team använder heterogena teknikstackar.
- Logghantering och analys: Loggar måste korreleras med spårningar och mätvärden i en och samma vy, så att en SRE kan gå från en ökning av felfrekvensen till de exakta loggraderna bakom den.
- AI-driven avvikelsedetektering: Jag letar efter maskininlärning som fastställer normalbeteenden och visar förslag på grundorsaker, inte bara statiska tröskelbaserade aviseringar som överbelastar jourkanalerna.
- Övervakning av riktiga användare och syntetisk övervakning: Plattformen bör erbjuda både RUM för analys av aktiv trafik och syntetiska kontroller som upptäcker trasiga kassaflöden eller API-fel innan riktiga användare gör det.
När jag har en lista över verktyg som uppfyller dessa kriterier undersöker jag vad som skiljer varje plattform från de andra.
Särskiljande faktorer (det som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer:
Utmärkande funktioner
Pristransparens är viktig när man byter från Dynatrace, så jag utvärderar om en plattform erbjuder förutsägbara, användningsbaserade priser med tydlig kostnadskontroll. Inbyggt stöd för OpenTelemetry är en annan viktig särskiljande faktor—team som redan har instrumenterat sina system med OTel-insamlare ska inte behöva riva ut allt för att ersätta det med proprietära agenter. Jag letar också efter automatiserade åtgärdsflöden som utlöser körböcker eller eskalerar via verktyg som PagerDuty när en avvikelse upptäcks, så att aviseringar omvandlas till åtgärder utan manuella insatser.
Mer än funktioner
Flexibilitet vid driftsättning är en viktig faktor—jag kontrollerar om en plattform stöder SaaS-, egenhostade och hybrida modeller, eftersom team i reglerade branscher ofta behöver lokala installationer eller specifika alternativ för datalagring inom en viss region. Integrations-ekosystemet påverkar också hur väl ett verktyg passar in i din befintliga stack. Inbyggda anslutningar till CI/CD-pipelines, ITSM-plattformar som ServiceNow och incidentverktyg som Opsgenie gör stor skillnad under införandet. Jag utvärderar även efterlevnadscertifieringar som SOC 2 Type II och ISO 27001, tillsammans med SSO och rollbaserade åtkomstkontroller.
Varför leta efter ett alternativ till Dynatrace?
Även om Dynatrace är ett bra val av plattform för övervakning av applikationsprestanda (APM), finns det flera anledningar till att vissa användare söker alternativa lösningar. Du kanske letar efter ett alternativ till Dynatrace eftersom…
- Priset kan bli för högt för mindre team
- Inlärningskurvan känns för brant för nya användare
- Du vill ha enklare instrumentpaneler och rapporter
- Du behöver mer flexibla alternativ för aviseringar och notifieringar
- Du kör en hybridmiljö och behöver bredare integrationer
- Du föredrar verktyg med mer transparent fakturering
Om något av detta stämmer in på dig har du kommit rätt. Min lista innehåller flera plattformsalternativ för övervakning av applikationsprestanda (APM) som passar bättre för team som står inför dessa utmaningar med Dynatrace och söker alternativa lösningar.
Dynatraces viktigaste funktioner
Här är några av Dynatraces viktigaste funktioner som hjälper dig att jämföra vad alternativa lösningar erbjuder:
- Fullstackövervakning: Låter dig följa appens prestanda, infrastrukturen och användarupplevelsen på ett och samma ställe.
- Davis AI-motor: Upptäcker problem automatiskt och förklarar grundorsaken, så att ditt team sparar tid.
- Övervakning av verkliga användare: Visar hur riktiga användare interagerar med din app, så att du kan åtgärda problem som verkligen spelar roll.
- Applikationssäkerhet: Flaggar sårbarheter i realtid medan koden körs i produktion.
- Stöd för molnbaserade miljöer: Fungerar bra med Kubernetes, AWS, Azure och andra molnmiljöer.
- Smarta aviseringar: Skickar aviseringar endast när det behövs, så att ditt team slipper aviseringströtthet.
- Anpassade instrumentpaneler: Låter dig skapa vyer som är anpassade efter ditt teams behov och mätvärden.
- Insikter på kodnivå: Hjälper dig att undersöka prestandan ända ner på nivån för enskilda kodrader.
- Logghantering: Låter dig söka i, filtrera och analysera loggar för snabbare felsökning.
- Simulerad övervakning: Simulerar användaråtgärder så att du kan testa appens prestanda från olika platser.
Sammanfattning
I den här köpguiden gick vi på djupet med olika alternativ till Dynatrace och undersökte flera alternativ som är anpassade för specifika användningsområden. Oavsett om du letar efter ett verktyg för övervakning med öppen källkod på företagsnivå, logghantering och säkerhetsanalys eller säkerhet för containrar och Kubernetes, finns det många robusta alternativ att överväga.
Här är tre viktiga slutsatser från guiden:
- Bedöm dina behov: Olika verktyg är utformade med olika användningsområden i åtanke. Vissa passar bra för omfattande logghantering, andra för miljöer med öppen källkod och ytterligare andra för säkerhet för containrar och Kubernetes. Om du förstår din organisations unika behov kan du hitta rätt verktyg.
- Titta på funktionerna: Verktyg kan ha liknande kärnfunktioner, men djävulen sitter i detaljerna. De unika funktionerna i varje verktyg, hur användarvänliga de är och hur väl de integreras med andra verktyg du använder kan göra stor skillnad för din övervakningsupplevelse.
- Ta hänsyn till priset: Även om kostnaden ofta är en viktig faktor är det viktigt att överväga vad du får för pengarna. Ett dyrare verktyg kan erbjuda den robusta funktionalitet eller support du behöver, och i vissa fall kan ett billigare eller till och med kostnadsfritt verktyg uppfylla dina behov.
Kom ihåg att det "bästa" verktyget helt beror på din organisations specifika krav och omständigheter. Med informationen i den här guiden är du på god väg att fatta ett välgrundat beslut.