

Rankning av de 10 bästa programvarorna för big data 2026

10 Urval av de bästa programvarorna för stordata


Att navigera i stordatans värld kan kännas överväldigande. Som teknikexpert ställs du inför utmaningar som att hantera enorma informationsmängder och utvinna meningsfulla insikter. Det är här programvara för stordata kommer in i bilden och gör dina uppgifter mer hanterbara och effektiva.
Enligt min erfarenhet kan valet av rätt verktyg förändra hur du och ditt team arbetar med data. Jag har testat och granskat ett stort antal programvarulösningar för att ge dig en opartisk översikt över de bästa tillgängliga alternativen.
I den här artikeln guidar jag dig genom mina främsta val och lyfter fram funktioner och fördelar som tillgodoser dina behov. Oavsett om du vill förbättra dataanalysen eller fatta bättre beslut hjälper jag dig. Nu går vi igenom den bästa programvaran för stordata på marknaden.
Varför du kan lita på våra programvarurekommendationer
Vårt team har testat och recenserat programvara sedan 2012. Som teknikledare själva vet vi hur svårt — och viktigt — det är att välja rätt programvara.
För den här guiden utvärderade vi verktyg genom praktisk testning och oberoende research, och betygsatte verktygen enligt våra urvalskriterier.
Våra recensioner speglar vårt mänskliga redaktionella omdöme, inte ett säljbudskap.
Sammanfattning av de bästa programvarorna för stordata
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Bäst för att bygga en enhetlig datasjöplattform | 14 dagars kostnadsfri provperiod tillgänglig | Prisuppgift på begäran | Website | |
| 2 | Bäst för interaktiv visualisering av stora datamängder | Gratis provperiod + kostnadsfri plan tillgänglig | $70/user/month (billed annually) | Website | |
| 3 | Bäst för matematisk beräkning med stora datamängder | Gratis provperiod tillgänglig | $50/användare/månad (debiteras årsvis) | Website | |
| 4 | Bäst för automatiserad datatransformering | Gratis demo tillgänglig | Prissättning på begäran | Website | |
| 5 | Bäst för dataidentifiering och regelefterlevnad | Gratis demo tillgänglig | $50/användare/månad (faktureras årsvis) | Website | |
| 6 | Bäst för sökning och analys i realtid | Gratis provperiod tillgänglig | $7/användare/månad (debiteras årsvis) | Website | |
| 7 | Bäst för serverlös och mycket skalbar datalagring | Gratisplan tillgänglig | $20/user/month | Website | |
| 8 | Bäst för storskaliga databehandlingsuppgifter | Not available | Priser på begäran | Website | |
| 9 | Bäst för databearbetning och dataanalys i realtid | Not available | Pris på begäran | Website | |
| 10 | Bäst för dataanalys och insikter på företagsnivå | Not available | Pris på begäran | Website |

Recensioner av de bästa programvarorna för stordata
Bäst för att bygga en enhetlig datasjöplattform

Databricks är en plattform för stordataanalyser utformad för företag som hanterar storskaliga datamängder och erbjuder integrerade verktyg för datateknik, analys, maskininlärning och samarbetsbaserade arbetsflöden i olika molnmiljöer.
Vem passar Databricks bäst för?
Företagsbaserade datateam och teknikdrivna organisationer som hanterar analys- och AI-arbetsbelastningar med stora datavolymer i miljöer med flera moln eller hybrida moln.
Varför jag valde Databricks
Jag valde Databricks som en av de bästa lösningarna eftersom plattformen samlar databearbetning med hög genomströmning, SQL-analys och AI-pipelines på en enda plattform. I praktiken innebär det att mitt team kan förena datalager, datasjöar och maskininlärning i ett enda arbetsflöde.
Viktiga funktioner i Databricks
- Unity Catalog: Centraliserar datastyrning, åtkomstkontroll och granskning i alla molnplattformar.
- Delta Live Tables: Automatiserar utveckling och hantering av ETL-pipelines med hjälp av deklarativa pipeline-definitioner.
- Lakehouse Federation: Möjliggör frågefederering över flera datakällor utan att data behöver flyttas.
- Genie Code: Erbjuder AI-drivna kodförslag och frågor på naturligt språk i notebooks.
Databricks-integrationer
Databricks erbjuder inbyggda integrationer med Apache Spark, Delta Lake, Power BI, AWS, Azure och Google Cloud Platform samt tillhandahåller ett API för anpassade integrationer.
Pros and Cons
Pros:
- Enhetlig datasjöplattform för analys och AI
- Inbyggda MLflow-funktioner för maskininlärningens livscykel
- Automatiserad datahärledning med Unity Catalog
Cons:
- Det kan ta lång tid att starta kluster
- Avancerad plattformskonfiguration är komplex

Tableau
Bäst för interaktiv visualisering av stora datamängder
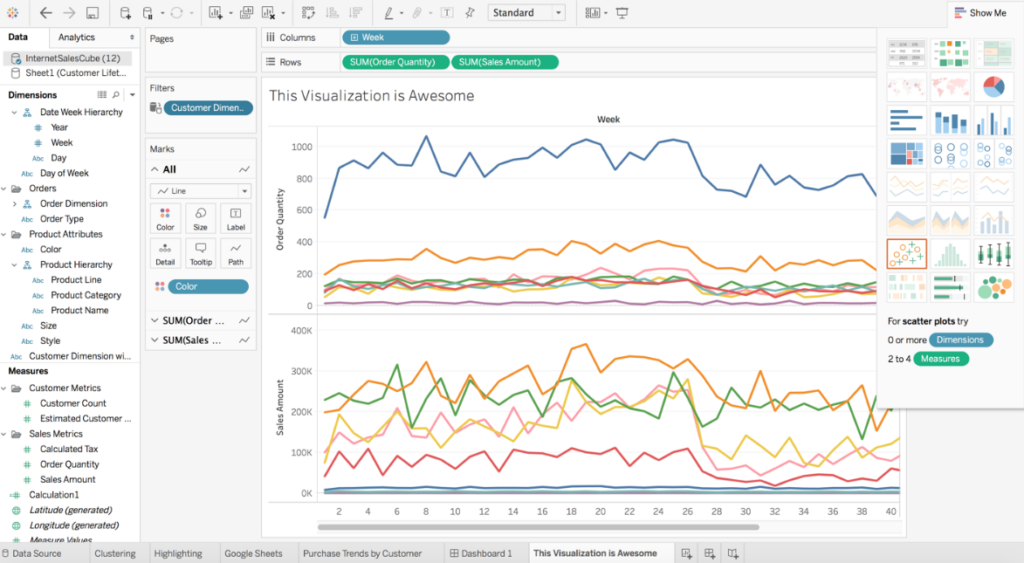
Tableau är en kraftfull aktör inom datavisualisering och gör det möjligt för användare att omvandla rådata till intuitiva, interaktiva visualiseringar och instrumentpaneler. Dess förmåga att erbjuda en uppslukande upplevelse för datautforskning understryker dess renommé som det bästa verktyget för interaktiv visualisering av stora datamängder.
Varför jag valde Tableau: I min strävan efter att hitta den främsta visualiseringslösningen hamnade Tableau ständigt i topp. Jag valde det inte enbart på grund av dess popularitet, utan för dess obestridliga förmåga att ge stora datamängder liv genom visualiseringar som både informerar och engagerar. Dess rykte om att skapa interaktiva datahistorier stärkte min övertygelse om att det verkligen är bäst för detta unika ändamål.
Utmärkande funktioner och integrationer:
Tableau utmärker sig genom sin dra-och-släpp-funktionalitet, som gör det möjligt för användare, oavsett teknisk kompetens, att enkelt skapa avancerade visualiseringar. Dess realtidsanalys av data och samarbetsfunktioner ger en helhetsbild och säkerställer att insikterna inte bara är värdefulla utan också möjliga att omsätta i praktiken.
Utöver dessa funktioner erbjuder Tableau integrationer med en mängd olika datakällor, från traditionella databaser till molntjänster.
Pros and Cons
Pros:
- Intuitivt dra-och-släpp-gränssnitt underlättar skapandet av visualiseringar
- Realtidsanalys säkerställer aktuella insikter
- Omfattande integrationsmöjligheter med varierade datakällor
Cons:
- Kan ha en brantare inlärningskurva för nybörjare jämfört med andra plattformar
- Licenskostnaderna kan bli höga för större team
- Vissa avancerade funktioner kan kräva kunskaper i skriptning
MATLAB
Bäst för matematisk beräkning med stora datamängder
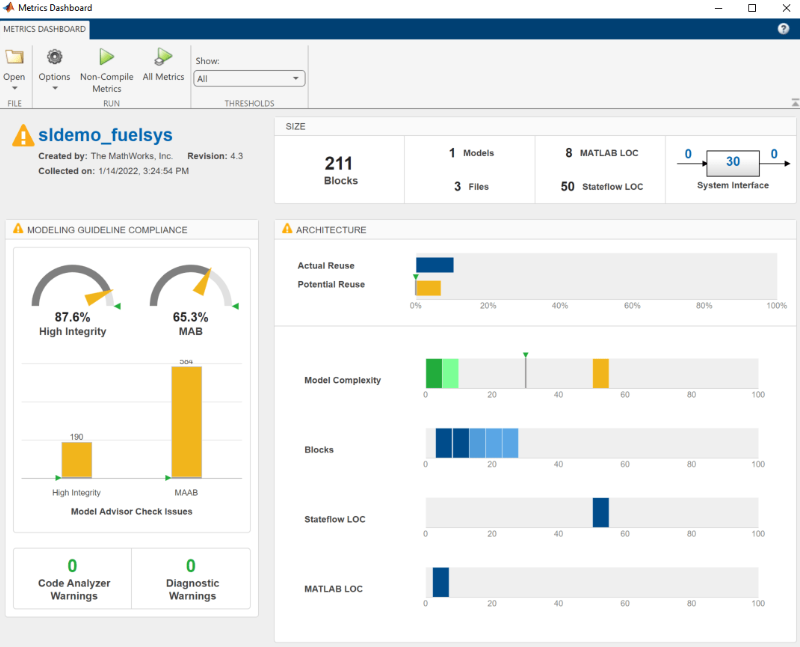
MATLAB, som utvecklats av MathWorks, är ett högpresterande språk för teknisk beräkning. Det är inriktat på funktioner som algoritmutveckling, datavisualisering och numerisk beräkning, och dess utformning är idealisk för dem som söker kraftfull matematisk beräkning inom området stora datamängder.
Varför jag valde MATLAB: När jag gav mig in i världen av programvara för stora datamängder var det oundvikligt att välja MATLAB. Dess rykte inom vetenskapliga och tekniska kretsar föregår det. Den enorma kraft det ger vid matematiska beräkningar, särskilt vid hantering av stora datamängder, utmärker det.
Enligt min åsikt står MATLAB tydligt som det bästa verktyget för komplexa matematiska operationer i miljöer med stora datamängder när olika verktyg jämförs.
Framstående funktioner & integrationer:
MATLAB är känt för sin verktygslåda, som innehåller ett stort urval av funktioner för signalbehandling, maskininlärning och mycket mer. Funktionen Simulink möjliggör modellbaserad utformning, vilket förbättrar processen för simulering och testning av modeller. MATLAB integreras med många miljöer och verktyg från tredje part, däribland C/C++, Java, .NET och Python, vilket säkerställer smidiga arbetsflöden på olika plattformar.
Pros and Cons
Pros:
- Omfattande verktygslåda med många olika funktioner
- Möjliggör både grundläggande och avancerade matematiska beräkningar
- Robusta integrationsmöjligheter med andra språk och plattformar
Cons:
- Kan vara överdimensionerat för enklare uppgifter
- Relativt brant inlärningskurva för dem som inte är bekanta med språket
- Licensstrukturen kan vara komplex för större team

Adverity
Bäst för automatiserad datatransformering
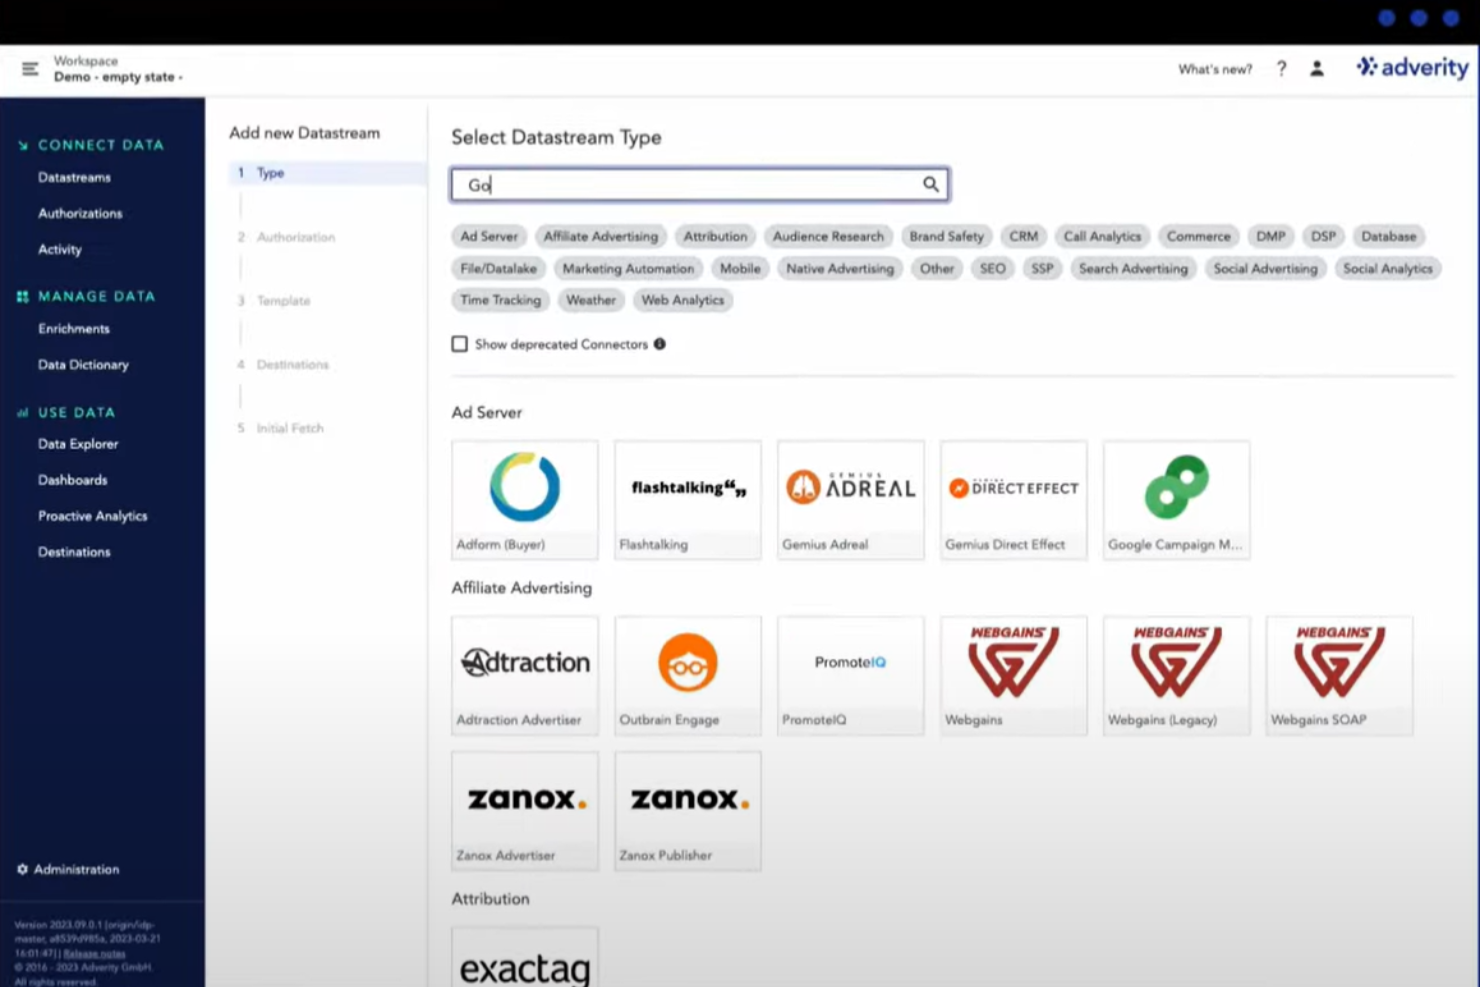
Adverity är en dataplattform som hjälper företag att ansluta, transformera och hantera sina marknadsföringsdata. Den gör det möjligt för team att automatisera datainsamling och databearbetning, vilket gör det enklare att analysera och dela insikter.
Varför jag valde Adverity: Jag valde Adverity eftersom plattformen hjälper ditt team att integrera, transformera och hantera stora datamängder effektivt. De automatiserade transformationerna – som smarta namnkonventioner och valutaomvandlingar – gör det enkelt att standardisera stora datamängder. Du kan också använda den AI-drivna transformationsassistenten för att förbereda data med enkla textinstruktioner i stället för kod. Dessutom gör funktionen för datasamtal det möjligt för icke-tekniska användare att få tillgång till insikter med hjälp av naturligt språk.
Framstående funktioner & integrationer:
Andra funktioner omfattar övervakning av datakvalitet, som genomför kvalitetskontroller för att validera dina data och upprätthålla både renhet och fullständighet. Plattformen erbjuder också en dataordlista som katalogiserar allt åt dig, vilket eliminerar behovet av att skapa egen datadokumentation.
Integrationer omfattar Google, Meta, TikTok, Google BigQuery, Looker Studio, Facebook Ads, Amazon Advertising, HubSpot, Salesforce, Amazon S3, Snowflake och Microsoft Azure.
Pros and Cons
Pros:
- Automatiserad övervakning av datakvalitet
- Kan harmonisera data från olika källor
- Ger möjlighet att skapa personliga instrumentpaneler
Cons:
- Vissa konfigurationer kan kräva teknisk kunskap
- Den initiala konfigurationen kan vara tidskrävande
New Product Updates from Adverity
Adverity Enhances Connectors and Adds TikTok GMV Max
Adverity updates connectors for Amazon Ads, SmartNews Ads, Indeed, and monday.com, and introduces the TikTok GMV Max connector. These updates improve data accuracy, control, and performance across integrations. For more information, visit Adverity’s official site.
 .
OneTrust
Bäst för dataidentifiering och regelefterlevnad
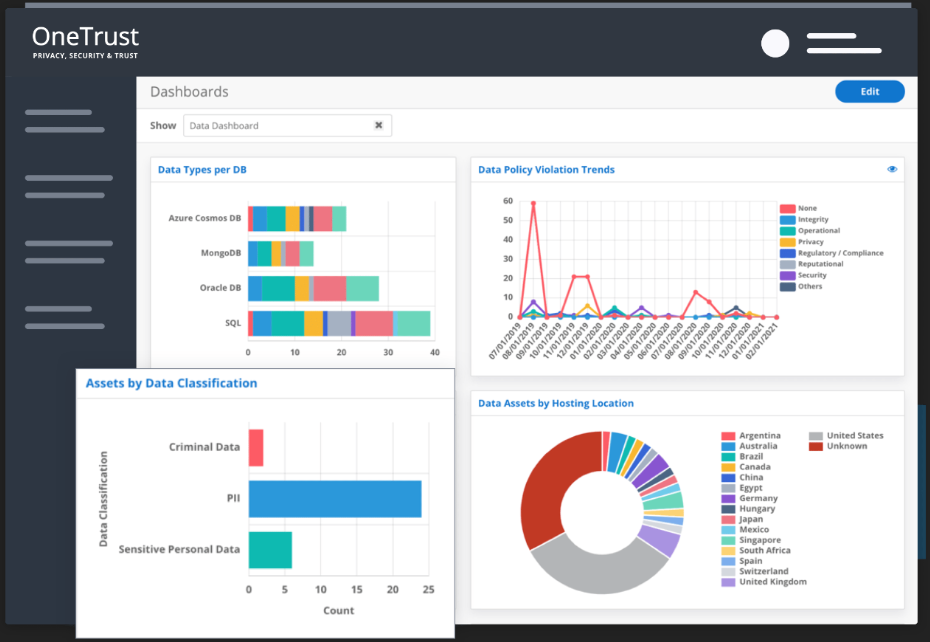
OneTrust tillhandahåller en plattform med fokus på dataidentifiering, integritet, säkerhet och risker kopplade till tredje part. I dagens strikta regelverk står företagets engagemang för att säkerställa regelefterlevnad för data starkt, vilket bekräftar dess position som det bästa verktyget för dataidentifiering och regelefterlevnad.
Varför jag valde OneTrust: När jag navigerade i det trånga utbudet av datahanteringsverktyg fångade OneTrust omedelbart min uppmärksamhet. Verktygets engagemang för att integrera både dataidentifiering och regelefterlevnad stämde väl överens med de framväxande utmaningarna för moderna företag.
Genom noggranna jämförelser och bedömningar kom jag fram till att OneTrust erbjuder en oöverträffad balans mellan att upptäcka dolda data och att säkerställa att de följer regelverket.
Utmärkande funktioner och integrationer:
OneTrust har funktioner som automatiserad dataidentifiering, ett centralt arkiv för alla datarelaterade tillgångar och automatisering av bedömningar, vilka är avgörande för företag som hanterar komplexa dataekosystem.
När det gäller integrationer samarbetar OneTrust smidigt med olika företagsverktyg och plattformar, vilket gör det enkelt för företag att integrera lösningen i sin befintliga infrastruktur.
Pros and Cons
Pros:
- Omfattande mekanismer för dataidentifiering
- Fokus på regelefterlevnad i linje med globala regelverk
- Omfattande integrationer med ledande företagsverktyg
Cons:
- Kan vara komplext för mindre organisationer
- Kräver en viss expertis för optimal användning
- Mängden funktioner kan vara överväldigande för nya användare

Bäst för sökning och analys i realtid
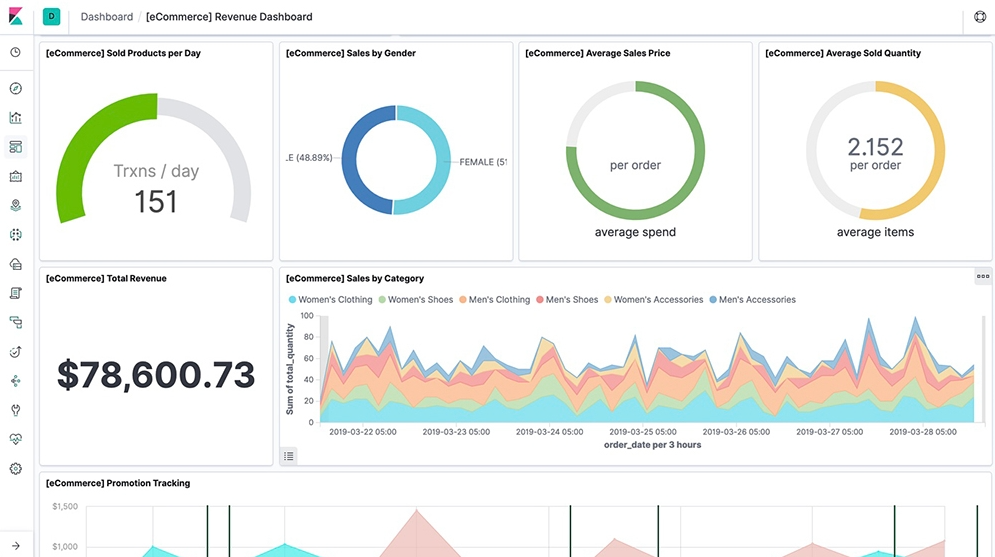
Elasticsearch är en sök- och analysmotor med öppen källkod som möjliggör utforskning och visualisering av data i realtid. Med kapacitet att hantera stora datamängder direkt under pågående arbete underlättar den snabba insikter i komplexa dataset, vilket gör den idealisk för sökning och analys i realtid.
Varför jag valde Elasticsearch: Jag valde Elasticsearch till den här listan tack vare dess enastående förmåga att leverera realtidsanalys, dess robusthet och det omfattande stödet från användarcommunityt. När jag jämförde olika verktyg utmärkte sig Elasticsearch genom sin integration med olika datatyper och sina flexibla frågealternativ.
Jag fastställde att den passar bäst för sökning och analys i realtid tack vare dess snabba indexerings- och sökfunktioner, som gör det möjligt för användare att få tillgång till insikter direkt.
Utmärkande funktioner och integrationer:
Elasticsearch utmärker sig genom sina fulltextsökningsfunktioner, och dess distribuerade natur gör den mycket skalbar. Dess realtidsindexering möjliggör omedelbar databearbetning och extrahering av insikter. Viktiga integrationer omfattar Kibana för visualisering, Logstash för datainsamling och Beats för dataleverans, vilket tillsammans bildar en robust Elastic Stack.
Pros and Cons
Pros:
- Öppen källkod med ett starkt community
- Omfattande analysfunktioner
- Skalbar och anpassningsbar till olika affärsbehov
Cons:
- Brantare inlärningskurva för nybörjare
- Kan kräva betydande hårdvaruresurser för omfattande dataset
- Komplexitet vid hantering och konfigurering av systemet

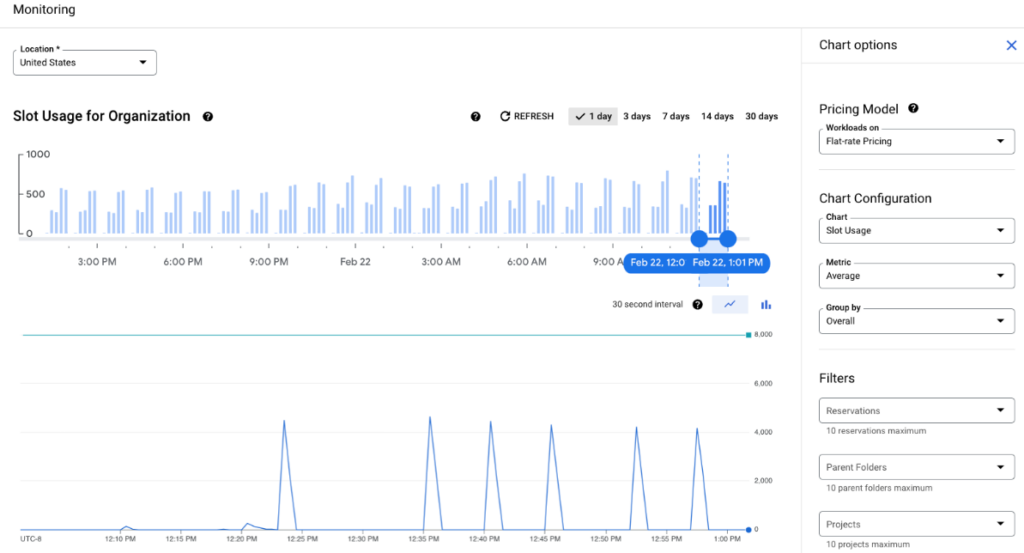
Google Cloud BigQuery tillhandahåller en multicloudlösning som är skräddarsydd för analys av enorma datamängder i realtid. Den serverlösa arkitekturen säkerställer skalbarhet och enkelhet, vilket gör den särskilt lämpad för dem som vill utnyttja datalager utan komplexiteten i serverhantering.
Varför jag valde Google Cloud BigQuery: Efter en grundlig utvärdering av olika verktyg fastställde jag att BigQuerys serverlösa metod och robusta skalningsmekanismer skiljer den från mängden. Jag valde detta verktyg eftersom det eliminerar besväret med serverhantering och samtidigt erbjuder mycket hög prestanda.
För företag som vill skala upp sina behov av datalagring utan att behöva fördjupa sig i serverdetaljer är BigQuery utan tvekan ett av de bästa alternativen.
Utmärkande funktioner och integrationer:
BigQuerys analysfunktion i realtid gör det möjligt för företag att snabbt fatta datadrivna beslut. De automatiska säkerhetskopieringarna och enkla återställningsalternativen säkerställer datasäkerhet och kontinuitet. När det gäller integrationer fungerar BigQuery väl tillsammans med olika Google Cloud-tjänster som Dataflow, Pub/Sub och AI Platform, vilket ger användarna en heltäckande molnupplevelse.
Pros and Cons
Pros:
- Den serverlösa utformningen ger skalbarhet utan manuell hantering
- Analys i realtid möjliggör snabba affärsbeslut
- Enkel integration med andra Google Cloud-tjänster
Cons:
- Kan bli dyrt vid mycket stora frågevolymer
- Inlärningskurva för dem som inte är bekanta med Google Cloud Platform
- Vissa komplexa frågor kan kräva optimering för kostnad och prestanda

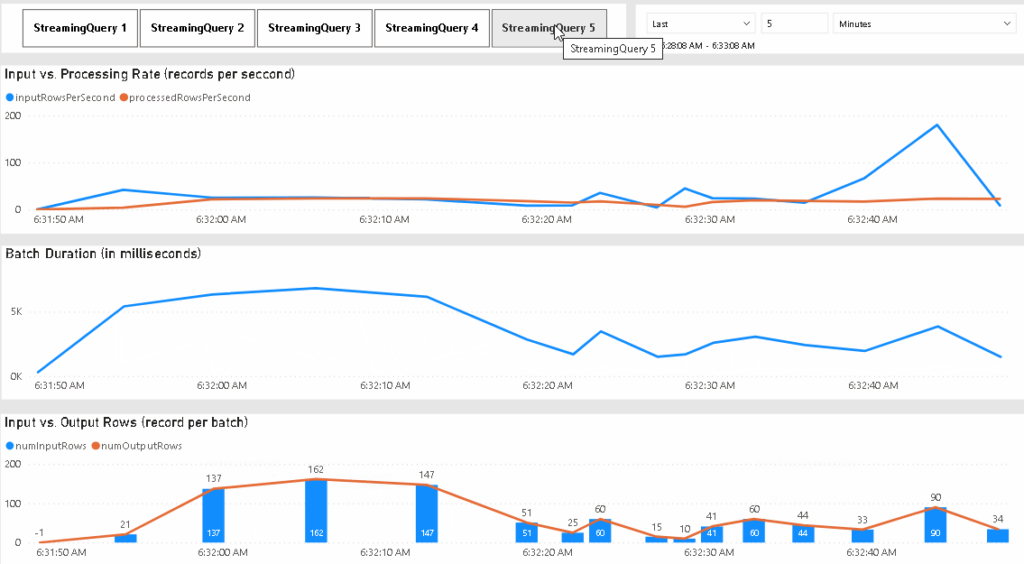
Apache Spark är ett distribuerat system för databehandling med öppen källkod, utformat för att hantera ett mycket brett spektrum av databehandlingsuppgifter med fokus på snabbhet och användarvänlighet. Plattformen riktar sig till organisationer som behöver bearbeta enorma datamängder, vilket gör den väl lämpad för storskaliga databehandlingsuppgifter.
Varför jag valde Apache Spark: När jag sökte efter ett ramverk för att hantera omfattande databehandlingsuppgifter visade sig Apache Spark konsekvent vara ett framstående val. Dess särprägel ligger i dess funktioner för minnesbaserad beräkning, vilket avsevärt påskyndar storskaliga datauppgifter. Med tanke på dess bevisade effektivitet och breda användning inom branschen är jag övertygad om att Spark är det bästa valet för storskalig databehandling.
Utmärkande funktioner & integrationer:
Apache Spark erbjuder imponerande funktioner som minnesbaserad bearbetning, vilket bidrar till att minska den tid data tillbringar på diskar. Dessutom har det en enhetlig plattform som gör det möjligt för användare att kombinera SQL, strömmande data och avancerad analys. Sparks förmåga att integrera med populära datalagringsverktyg som HDFS och Apache Cassandra samt databehandlingsverktyg som Apache Kafka gör det mångsidigt för olika uppgifter.
Pros and Cons
Pros:
- Oöverträffad hastighet tack vare minnesbaserad bearbetning
- Mångsidighet vid hantering av olika uppgifter som batchbearbetning, maskininlärning och grafbearbetning
- En omfattande uppsättning utvecklarbibliotek och API:er för att utöka funktionerna
Cons:
- Kan kräva betydande mängder minne för vissa uppgifter, vilket leder till högre driftskostnader
- Inlärningskurvan kan vara brant för nybörjare
- Att konfigurera och finjustera Spark för optimal prestanda kan vara utmanande

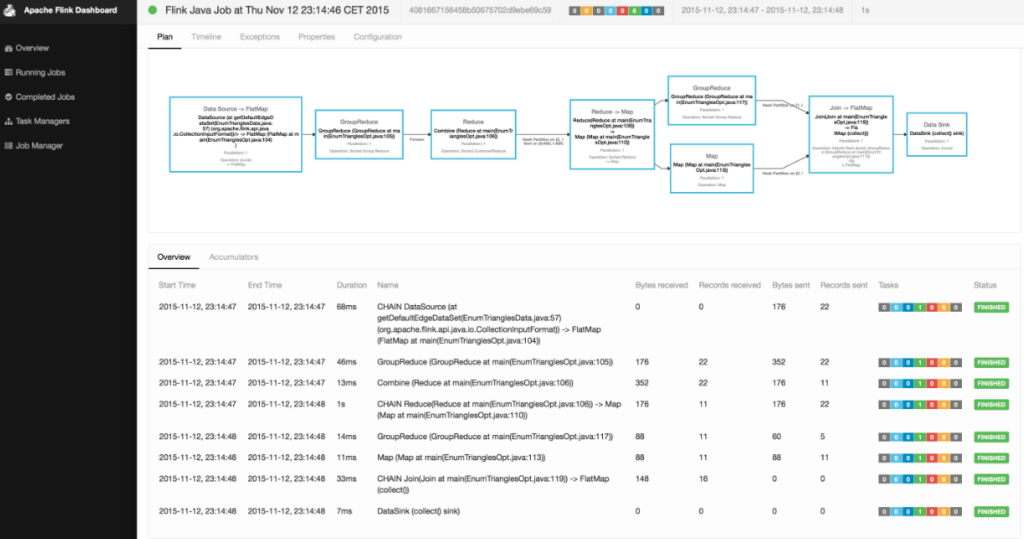
Apache Flink är ett kraftfullt ramverk med öppen källkod för strömbearbetning. Med sin förmåga att bearbeta och analysera data i realtid gör det det möjligt att snabbt och effektivt omvandla stora dataströmmar till användbara insikter.
Varför jag valde Apache Flink: När jag utvärderade vilket verktyg som var bäst lämpat för realtidsanalys hamnade Apache Flink konsekvent i topp i mina jämförelser. Dess särskilda funktioner för strömbearbetning, i kombination med bevisad prestanda i komplexa dataekosystem, gjorde valet enkelt.
För organisationer som prioriterar insikter i realtid och dynamiska reaktioner på data erbjuder Apache Flink en optimal lösning.
Framstående funktioner & integrationer:
Apache Flink har en feltolerant strömningsmodell som säkerställer datatillförlitlighet och konsekvens. Det stöder händelsetidsbearbetning, vilket ger korrekta resultat även när data anländer i fel ordning. Flink integreras smidigt med populära datalagringssystem som Apache Kafka, Apache Cassandra och AWS S3, vilket ger flexibilitet när det gäller datakällor.
Pros and Cons
Pros:
- Stark feltolerans säkerställer dataintegriteten under bearbetningen
- Effektiv händelsetidsbearbetning hanterar data som anländer i fel ordning med precision
- Omfattande integrationsmöjligheter gör det möjligt att ansluta till olika datalagringssystem
Cons:
- Installation och konfiguration kan innebära en brant inlärningskurva för nybörjare
- Skalbarheten är robust, men kan kräva avancerad finjustering vid driftsättning i mycket stor skala
- Som ett verktyg med öppen källkod kan alternativen för kommersiell support vara begränsade

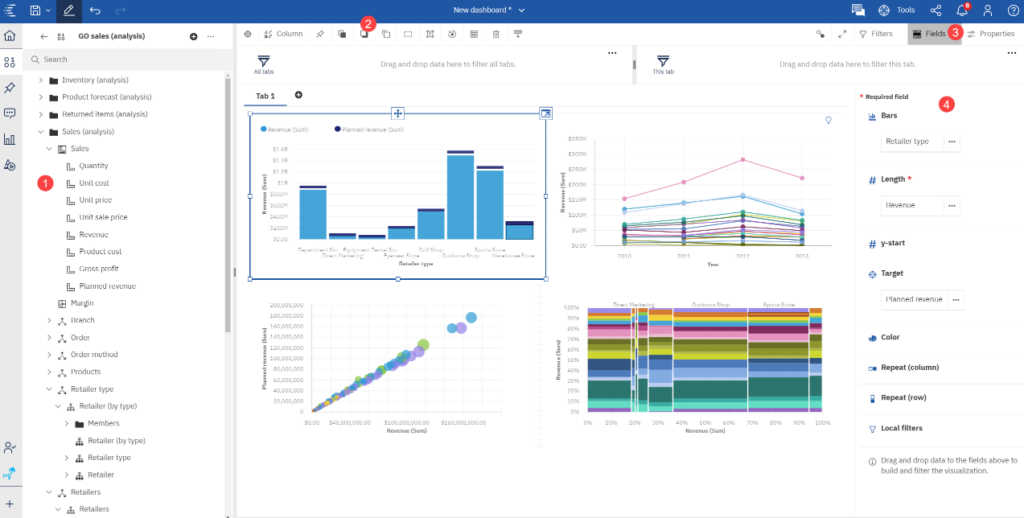
IBM Big Data Analytics är en integrerad plattform från IBM som är utformad för att ge företag de verktyg de behöver för att utvinna användbara insikter ur sina omfattande datalager. Med sina avancerade funktioner anpassade för företag är den perfekt för dem som söker en heltäckande lösning för dataanalys och insikter i större skala.
Varför jag valde IBM Big Data Analytics: När jag undersökte verktyg för dataanalys på företagsnivå framstod IBM Big Data Analytics som en stark kandidat. Jag valde denna plattform på grund av dess rykte om tillförlitlighet och det omfattande utbud av funktioner som den erbjuder och som är anpassade för större företag.
Detta robusta verktyg, i kombination med IBMs långa erfarenhet inom teknikbranschen, övertygade mig om att det är idealiskt lämpat för dataanalys och insikter på företagsnivå.
Utmärkande funktioner och integrationer:
IBM Big Data Analytics erbjuder en mängd verktyg som möjliggör avancerad prediktiv analys, från datautforskning till maskininlärning. Plattformen använder AI-drivna insikter för att göra förutsägelser mer exakta och kan integreras med IBMs övriga datalösningar.
Dessutom förbättrar kompatibiliteten med verktyg som Hadoop och Spark, liksom integrationsmöjligheterna med många tredjepartsplattformar, ytterligare dess värdeerbjudande.
Pros and Cons
Pros:
- Omfattande uppsättning analysverktyg som tillgodoser en mängd olika behov
- Robusta integrationsmöjligheter med både IBM- och tredjepartslösningar
- Tillförlitlig support och tillgängliga resurser tack vare IBMs goda rykte
Cons:
- Kan vara komplext för dem som inte är bekanta med IBMs ekosystem
- Driftsättning och konfiguration kan vara mer omfattande jämfört med andra verktyg
- Kostnaden kan vara för hög för mindre organisationer
Annan programvara för stordata
Nedan finns en lista över ytterligare programvara för stordata som jag tog med i urvalet men som inte kom med bland de tio bästa. De är definitivt värda att ta en titt på.
- Microsoft SQL Server
Bäst för hantering av relationsdatabaser
- Apache Kafka
Bäst för plattformar för dataströmning i realtid
- Qubole
Bäst för skalbar molnnativ stordataanalys
- Explorium
Bäst för integration med externa dataplattformar


Relaterade recensioner
- Verktyg för databasdesign
- Programvara för datamaskering
- Verktyg för dataintegration
- Programvara för skrivbordsdatabaser
- Programvara för datareplikering
Så utvärderar jag programvara för stordata
När jag utvärderar stordataplattformar delar jag upp min bedömning i de grundläggande funktioner som ett verktyg måste ha för att kvalificera sig och de faktorer som skiljer verktyg som är byggda för arbetsbelastningar i petabytsskala åt.
Kärnfunktionalitet (grundkrav för denna lista)
När jag väljer verktyg till min lista rangordnar jag varje verktyg på en skala från 0 (erbjuder inte funktionen) till 5 (utmärker sig inom området) för varje kärnfunktion som anges nedan. Därefter omvandlar jag verktygets totalpoäng till en procentsats. Varje verktyg måste uppnå en totalpoäng på minst 75 % för att övervägas för inkludering.
- Distribuerad databearbetning: Jag utvärderar om en plattform kan parallellisera arbetsbelastningar över kluster och tittar på stöd för motorer som Spark och Flink eller egenutvecklade MPP-ramverk.
- Skalbar lagringsarkitektur: Lagringslagret bör kunna hantera data i petabytsskala inbyggt, oavsett om det sker genom en lakehouse-modell, ett distribuerat filsystem eller ett molnbaserat objektlager.
- Datainläsning i stora volymer: Jag kontrollerar bredden av anslutningar och inläsningslägen, från batchinläsning av filer till realtidsströmmar med CDC som hämtar data från transaktionsdatabaser.
- Fråge- och analysmotor: SQL-prestanda på tabeller med miljarder rader är viktigt här. Jag tittar på optimeringsfunktioner som cachning, indexering, partitionering och frågeplanering.
- Stöd för flera dataformat: Plattformar bör kunna hantera strukturerade tabeller tillsammans med halvstrukturerade loggar och JSON-nyttolaster samt öppna format som Parquet, Avro och ORC.
- Integration och interoperabilitet: Jag letar efter inbyggda anslutningar till BI-verktyg som Tableau och Power BI, ramverk för maskininlärning samt orkestreringsverktyg som Airflow och dbt.
När jag har en lista över verktyg som uppfyller dessa kriterier tittar jag på vad som skiljer varje plattform från de andra.
Särskiljande faktorer (vad som skiljer leverantörerna åt)
Så här jämför jag olika leverantörer:
Utmärkande funktioner
En enhetlig datakatalog med spårning av dataflöden och detaljerade åtkomstkontroller gör stor skillnad när du hanterar hundratals datauppsättningar i olika molnkonton. Serverlös databehandling och automatisk skalning är ett annat område som jag utvärderar noggrant. Team bör kunna starta resurser för ett omfattande Spark-jobb och skala ned igen utan manuell klusterhantering. Inbyggda arbetsflöden för maskininlärning förtjänar också stor uppmärksamhet. Plattformar med integrerade notebook-miljöer eller stöd för MLflow låter datavetare träna modeller direkt där data finns, vilket eliminerar onödig dataförflyttning.
Mer än funktioner
Transparens i prismodellen är en av de första sakerna jag kontrollerar. Förbrukningsbaserad fakturering kan snabbt skena vid stora analytiska arbetsbelastningar, så jag undersöker om en plattform erbjuder kostnadskontroller som isolering av arbetsbelastningar eller utgiftsvarningar. Säkerhets- och efterlevnadsnivån är minst lika viktig. Jag utvärderar certifieringar som SOC 2, HIPAA och beredskap för GDPR, tillsammans med säkerhet på radnivå och revisionsloggning. Jag tar också hänsyn till utvecklarupplevelsen, inklusive dokumentationens kvalitet, stöd för Terraform och verktyg för kommandoradsgränssnitt, eftersom dessa faktorer påverkar hur snabbt teamet kan gå från koncepttest till produktion.
Så väljer du programvara för stordata
Det är lätt att fastna i långa funktionslistor och komplexa prisstrukturer. För att hjälpa dig att hålla fokus när du arbetar dig igenom din unika process för val av programvara kommer här en checklista över faktorer att tänka på:
| Faktor | Att tänka på |
|---|---|
| Skalbarhet | Kan programvaran hantera din datatillväxt? Kontrollera om den stöder ökande datamängder och komplexitet utan prestandaförlust. |
| Integrationer | Fungerar den med dina befintliga verktyg? Kontrollera om den stöder sömlös integration med dina nuvarande system, till exempel molnlagring och programvara för datafabriker. |
| Anpassningsbarhet | Kan du anpassa den efter dina behov? Kontrollera om programvaran kan anpassas till specifika affärskrav och processer. |
| Användarvänlighet | Är den användarvänlig? Utvärdera inlärningskurvan och hur enkelt det är för ditt team att börja använda programvaran och använda den effektivt. |
| Implementering och introduktion | Hur snabbt kan du komma igång? Bedöm hur mycket tid och resurser som krävs för installation och utbildning samt om det finns support som kan hjälpa till under processen. |
| Kostnad | Ryms den inom din budget? Jämför prismodeller och den totala ägandekostnaden, inklusive dolda avgifter och långsiktiga utgifter. |
| Säkerhetsskydd | Är dina data skyddade? Säkerställ att programvaran uppfyller dina säkerhetsstandarder och tillhandahåller nödvändiga funktioner för dataskydd. |
| Efterlevnadskrav | Följer den gällande regler? Kontrollera om programvaran uppfyller branschspecifika standarder för efterlevnad och de juridiska krav som är relevanta för din organisation. |
Vad är programvara för stordata?
Programvara för stordata är ett verktyg som är utformat för att effektivt bearbeta, analysera och hantera stora datamängder. Dataforskare, analytiker och IT-personal använder vanligtvis dessa verktyg för att utvinna insikter och fatta datadrivna beslut. Datalagring, realtidsbearbetning och integrationsfunktioner hjälper till att hantera komplexa dataoperationer och stödja verksamhetens behov. För organisationer som överväger olika alternativ kan en granskning av Databricks eller Databricks konkurrenter ge värdefulla insikter om olika plattformsalternativ. Dessa verktyg erbjuder ett stort värde genom att omvandla enorma mängder data till användbara insikter.
Funktioner
När du väljer programvara för stordata bör du hålla utkik efter följande viktiga funktioner:
- Datalagring: Hanterar effektivt stora datamängder och ger tillförlitlig åtkomst och hantering.
- Realtidsbearbetning: Möjliggör snabb analys av data när den kommer in, vilket underlättar beslut i rätt tid.
- Integrationsfunktioner: Ansluter sömlöst till befintliga system och verktyg, vilket effektiviserar arbetsflöden.
- Skalbarhet: Stöder växande databehov utan att prestandan försämras och möjliggör verksamhetens expansion.
- Verktyg för dataobserverbarhet: Ger en visuell representation av datainsikter, vilket gör komplex information enklare att förstå.
- Anpassningsbarhet: Gör det möjligt att anpassa programvaran efter specifika verksamhetskrav och processer.
- Säkerhetsåtgärder: Skyddar känsliga data med robusta säkerhetsåtgärder och säkerställer efterlevnad och förtroende.
- Stöd för maskininlärning: Underlättar avancerad analys och prediktiv modellering, vilket förbättrar datadrivna strategier.
- Användarvänligt gränssnitt: Förenklar navigering och användning och minskar inlärningströskeln för användarna.
- Automatiserad datarensning: Förbättrar datakvaliteten genom att automatiskt upptäcka och korrigera fel.
Fördelar
Att implementera programvara för stordata ger flera fördelar för ditt team och din verksamhet. Här är några av de fördelar du kan se fram emot:
- Förbättrat beslutsfattande: Realtidsbearbetning och datavisualisering hjälper dig att snabbt förstå trender och fatta välgrundade beslut.
- Ökad effektivitet: Integrationsfunktioner och automatisering minskar manuella uppgifter, så att ditt team kan fokusera på strategiska aktiviteter.
- Skalbarhet: Hanterar enkelt växande databehov och säkerställer att programvaran håller jämna steg med verksamhetens expansion.
- Förbättrad datasäkerhet: Säkerhetsåtgärder skyddar känslig information, upprätthåller efterlevnaden och bygger förtroende.
- Bättre insikter: Stöd för maskininlärning och avancerad analys ger en djupare förståelse och förutsägelser för framtida strategier.
- Kostnadsbesparingar: Effektiv datahantering minskar driftskostnaderna genom att optimera resurser och minimera slöseri.
Kostnader & priser
Att välja programvara för stordata kräver en förståelse för de olika prismodeller och abonnemang som finns tillgängliga. Kostnaderna varierar beroende på funktioner, teamstorlek, tillägg och annat. Tabellen nedan sammanfattar vanliga abonnemang, deras genomsnittliga priser och typiska funktioner som ingår i programvarulösningar för stordata:
Jämförelsetabell för abonnemang för programvara för stordata
| Abonnemangstyp | Genomsnittligt pris | Vanliga funktioner |
|---|---|---|
| Gratisabonnemang | $0 | Grundläggande datalagring, begränsade bearbetningsfunktioner och communitysupport. |
| Personligt abonnemang | $10-$30/user/month | Förbättrad datavisualisering, integration med vanliga verktyg och e-postsupport. |
| Företagsabonnemang | $50-$100/user/month | Avancerad analys, realtidsbearbetning och dedikerad kundsupport. |
| Enterprise-abonnemang | $150-$300/user/month | Anpassningsbara lösningar, stöd för maskininlärning, omfattande säkerhet och support dygnet runt. |
| Jag kunde inte hitta några specifika vanliga frågor från sökresultaten. Baserat på allmän branschkunskap följer dock några avancerade vanliga frågor om programvara för stordata: |
De vanligaste frågorna om programvara för stordata
Kan programvara för stordata förbättra beslutsfattandet?
Ja, programvara för stordata kan avsevärt förbättra beslutsfattandet genom att ge insikter och analyser i realtid. Den hjälper dig att förstå trender, mönster och avvikelser i dina data. Med avancerade analys- och visualiseringsverktyg kan ditt team fatta välgrundade beslut baserade på korrekta och omfattande data.
Vilka är de vanligaste utmaningarna vid implementering av programvara för stordata?
Vanliga utmaningar är dataintegration, att säkerställa datakvalitet och att hantera datasäkerhet. Du kan stöta på svårigheter med att skala programvaran för att hantera ökande datamängder. Rätt utbildning och förändringshantering är avgörande för att säkerställa att ditt team använder programvaran effektivt.
Hur viktigt är datasäkerhet i programvara för stordata?
Datasäkerhet är avgörande i programvara för stordata på grund av den känsliga information som hanteras. Säkerställ att programvaran erbjuder robusta säkerhetsfunktioner som kryptering, åtkomstkontroller och efterlevnad av branschstandarder. Genom att skydda dina data skapar du förtroende hos dina intressenter och minimerar juridiska risker.
Vad händer härnäst:
Om du håller på att undersöka programvara för stordata kan du kontakta en SoftwareSelect-rådgivare för kostnadsfria rekommendationer.
Du fyller i ett formulär och har ett kort samtal där de går igenom dina specifika behov. Sedan får du en kortlista över programvara att granska. De hjälper dig även genom hela köpprocessen, inklusive prisförhandlingar.