

Jako osoba, która poruszała się po rozległym świecie aplikacji, rozwiązań SaaS i narzędzi do monitorowania sieci, rozumiem Twoją potrzebę znalezienia wydajnych i niezawodnych alternatyw dla Sumo Logic. Sumo Logic to zaawansowane narzędzie do wizualizacji danych, które przekształca dane z monitorowania chmury w przejrzyste wykresy. Korzyści są oczywiste: upraszcza analizowanie i przechowywanie danych, oferując rozwiązania chmurowe oraz lokalne. Prawdziwą przewagę zapewnia jednak szeroki wybór wtyczek, dzięki którym narzędzie jest uniwersalne i można je dostosować do różnorodnych potrzeb.
Problemy, które pomaga rozwiązać, koncentrują się na usprawnieniu złożonych procesów zarządzania danymi. Oszczędza Ci żmudnego przeszukiwania ogromnych ilości danych sieciowych i pomaga wskazywać anomalie wymagające Twojej uwagi. Dzięki najlepszym alternatywom dostępnym w jednym miejscu możesz łatwo wybrać rozwiązanie odpowiadające Twoim potrzebom. Zapoznaj się z tymi opcjami i znajdź narzędzie najlepiej dopasowane do Ciebie.
Czym jest Sumo Logic?
Sumo Logic to chmurowa platforma do obserwowalności i zarządzania dziennikami zdarzeń, która pomaga gromadzić, analizować i wizualizować dane z aplikacji oraz infrastruktury. Korzystają z niej zespoły DevOps, analitycy bezpieczeństwa i programiści, którzy muszą monitorować kondycję systemów, wykrywać problemy i analizować incydenty. Analiza dzienników, pulpity nawigacyjne działające w czasie rzeczywistym oraz narzędzia do wykrywania zagrożeń pomagają identyfikować błędy, śledzić wydajność i reagować na ryzyko. Ogólnie rzecz biorąc, Sumo Logic pomaga zespołowi zrozumieć dane systemowe i szybciej działać, gdy coś pójdzie nie tak.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Tabela porównawcza alternatyw dla Sumo Logic
Ta tabela porównawcza podsumowuje szczegóły cenowe dotyczące wybranych przeze mnie najlepszych alternatyw dla Sumo Logic:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Najlepsze rozwiązanie do śledzenia rozproszonego | Dostępny bezpłatny plan | Od $26/miesiąc (rozliczane rocznie) | Website | |
| 2 | Najlepsze do monitorowania ruchu sieciowego | 30-dniowy bezpłatny okres próbny | Od $3/urządzenie/miesiąc | Website | |
| 3 | Najlepsze dla deweloperów łączących dzienniki ze śladami na poziomie kodu | Dostępne bezpłatne demo | Ceny na życzenie | Website | |
| 4 | Najlepszy wybór do obserwowalności opartej na AI w całym stosie operacyjnym | 15-dniowy bezpłatny okres próbny | Od $7/miesiąc | Website | |
| 5 | Najlepszy do ujednolicania logów, metryk i śladów w jednym widoku | Dostępny bezpłatny plan | Od $15/miesiąc (rozliczane rocznie) | Website | |
| 6 | Najlepsze do monitorowania hybrydowej infrastruktury IT na dużą skalę | 14-dniowy bezpłatny okres próbny | Dostępność i cena na żądanie | Website | |
| 7 | Najlepsze do samodzielnego zarządzania wyszukiwaniem dzienników w skali terabajtów | 60-dniowy bezpłatny okres próbny | $150/user/month | Website | |
| 8 | Najlepsze rozwiązanie do łączenia wydajności aplikacji z wpływem na działalność biznesową | Bezpłatny 30-dniowy okres próbny | Od $6/vCPU/miesiąc (przy rozliczeniu rocznym) | Website | |
| 9 | Najlepsze rozwiązanie do pełnostosowej obserwowalności z wbudowaną sztuczną inteligencją | Dostępny bezpłatny plan | Od 10 USD/użytkownika/miesiąc | Website | |
| 10 | Najlepsze rozwiązanie dla nowoczesnych inżynierów potrzebujących zaawansowanego zarządzania logami | Dostępny bezpłatny plan | Od $29/użytkownika/miesiąc (rozliczane rocznie) | Website |


Opinie o najlepszych alternatywach dla Sumo Logic
Poniżej znajdziesz moje szczegółowe podsumowania najlepszych alternatyw dla Sumo Logic, które trafiły na moją listę. W recenzjach szczegółowo omawiam kluczowe funkcje, zalety \u0026 wady, integracje i idealne zastosowania każdego narzędzia, aby pomóc Ci znaleźć najlepsze rozwiązanie.
 Najlepsze rozwiązanie do śledzenia rozproszonego
- Dostępny bezpłatny plan
- Od $26/miesiąc (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.5/5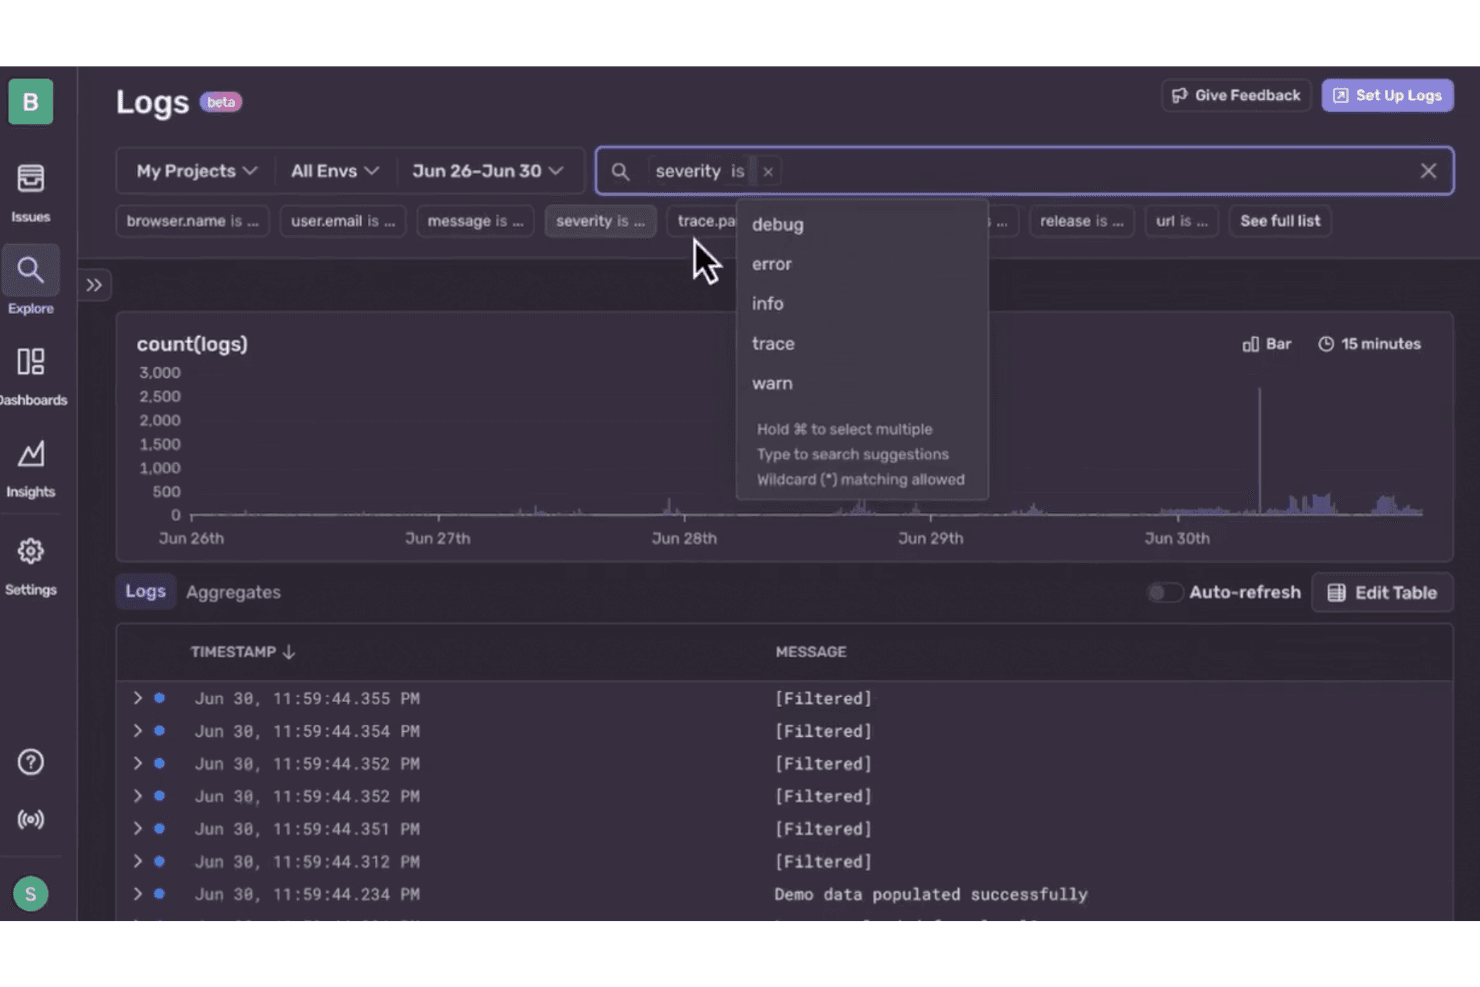
Sentry umożliwia użytkownikom filtrowanie logów według poziomu ważności w celu ukierunkowanego debugowania. Sentry to platforma monitorowania aplikacji dla zespołów programistycznych i IT, która łączy błędy, logi i dane dotyczące wydajności, aby pomóc wskazać przyczyny awarii i problemów widocznych dla użytkowników.
Dla kogo Sentry jest najlepszym wyborem?
Sentry jest odpowiedni dla zespołów inżynierii oprogramowania i DevOps, które potrzebują śledzić żądania w rozproszonych usługach i ustalać, gdzie zaczynają się opóźnienia lub awarie.
Dlaczego wybrałem Sentry
Gdy żądanie przechodzi przez kilka usług, chcę widzieć, gdzie zwalnia lub kończy się niepowodzeniem. Wybrałem Sentry jako najlepsze rozwiązanie do śledzenia rozproszonego, ponieważ jego widok śledzenia łączy błędy z odcinkami śledzenia w różnych usługach, pomagając wskazać powolne wywołanie bazy danych lub niesprawną zależność. Ten kontekst jest pomocny podczas badania problemów z aplikacją, wykraczając poza samo wyszukiwanie w logach.
Najważniejsze funkcje Sentry
- Wyszukiwanie i filtrowanie logów: Przeszukuj ustrukturyzowane logi według komunikatu, poziomu ważności i niestandardowych atrybutów.
- Logi na żywo: Obserwuj przychodzące zdarzenia logów w widoku na żywo.
- Alerty oparte na logach: Ustawiaj alerty dla wzorców lub anomalii w logach.
- Pulpity nawigacyjne logów: Dodawaj do pulpitów wykresy na podstawie zapytań dotyczących logów.
Integracje Sentry
Sentry oferuje integracje z GitHub, GitLab, Bitbucket, Jira, Azure DevOps, Slack, Microsoft Teams, PagerDuty, Discord i Opsgenie. Jego platforma integracyjna, mechanizmy webhooków oraz REST API obsługują niestandardowe integracje.
Pros and Cons
Pros:
- Ślady między usługami łączą błędy z odcinkami śledzenia
- Ślady stosu zawierają ścieżki nawigacyjne i kontekst użytkownika
- Kontekst wydania pomaga wskazać regresje
Cons:
- Skupienie na aplikacji sprawia, że monitorowanie infrastruktury pozostaje poza zakresem
- Limity liczby zdarzeń mogą przerwać widoczność śledzenia
Learn more about Sentry: Najlepsze do monitorowania ruchu sieciowego
- 30-dniowy bezpłatny okres próbny
- Od $3/urządzenie/miesiąc
Visit WebsiteCustomer Rating:4.7/5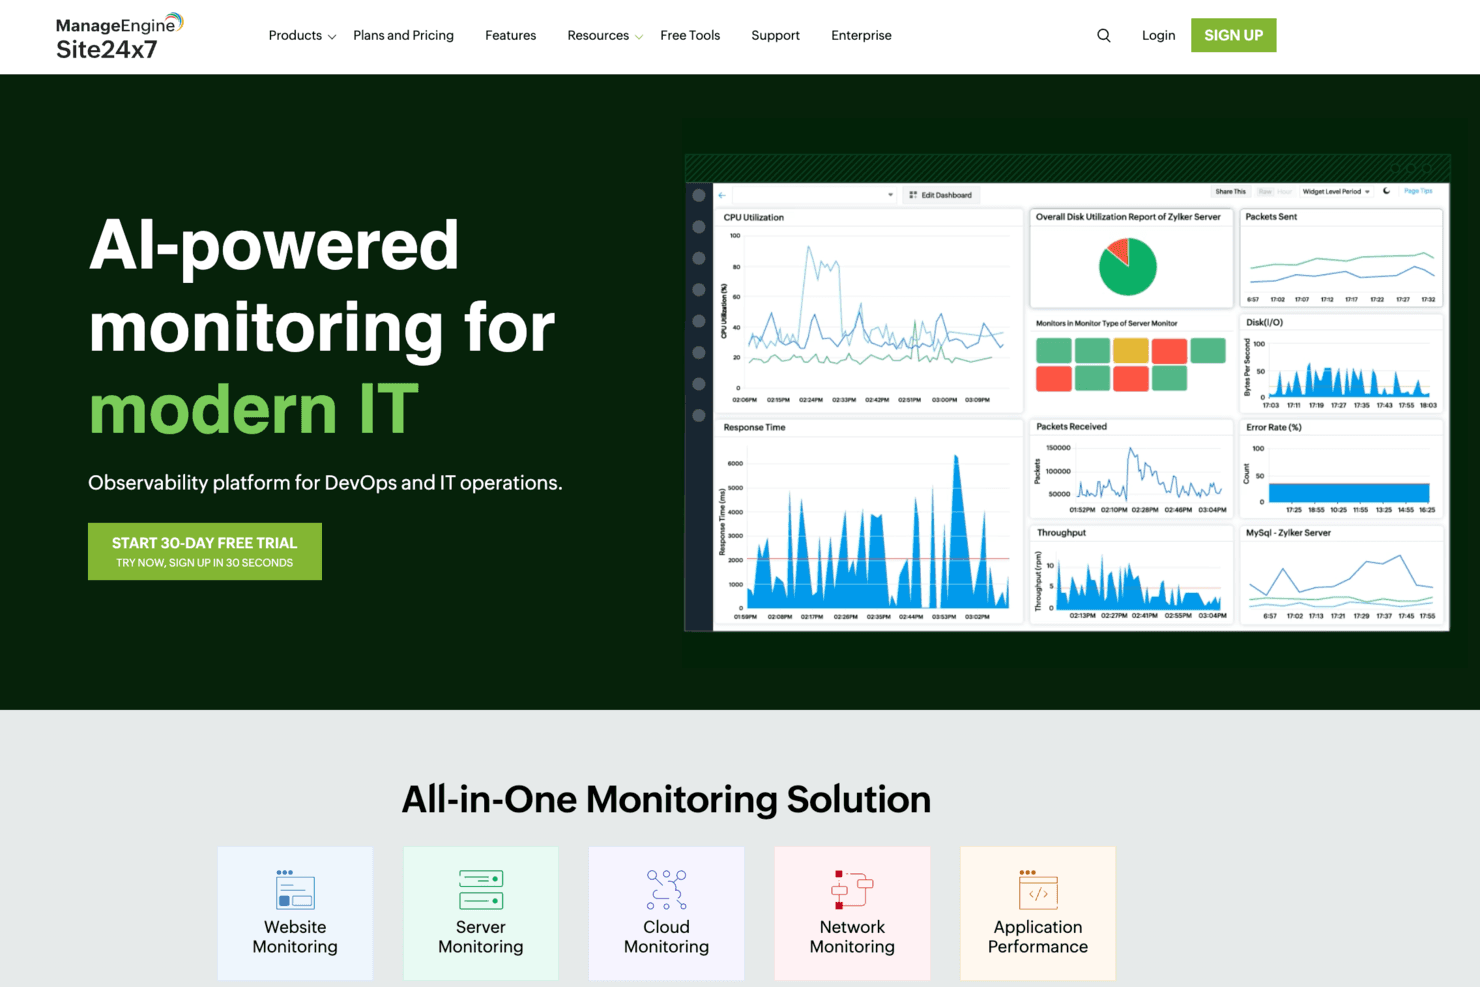
Site24x7 udostępnia pulpity monitorowania oparte na sztucznej inteligencji dla zespołów DevOps i IT. Site24x7 łączy zarządzanie logami z opartym na chmurze monitorowaniem IT, pomagając zespołom ds. infrastruktury badać problemy dotyczące serwerów, aplikacji i usług.
Dla kogo Site24x7 jest najlepszym wyborem?
Administratorzy sieci nadzorujący rozproszone lub hybrydowe środowiska mogą monitorować wzorce ruchu i identyfikować problemy z wydajnością sieci za pomocą Site24x7.
Dlaczego wybrałem Site24x7
Wybrałem Site24x7 w zastosowaniu „Najlepsze do monitorowania ruchu sieciowego”, ponieważ łączy zarządzanie logami z widocznością sieci. Analiza NetFlow rozkłada ruch według urządzenia, interfejsu, aplikacji i konwersacji, dzięki czemu mogę sprawdzić, który host lub usługa spowodowały skok wykorzystania przepustowości.
Najważniejsze funkcje Site24x7
- Zbieranie logów: Zbiera logi serwerów, aplikacji i chmury za pośrednictwem agenta, interfejsu API, Fluentd lub Logstash.
- Obsługa typów logów: Monitoruje ponad 100 typów logów, w tym logi syslog, zdarzeń systemu Windows i audytu Kubernetes.
- Alerty oparte na logach: Ustawia progi dla danych z logów i powiadamia wstępnie zdefiniowane grupy użytkowników.
- Tagowanie logów: Stosuje wstępnie zdefiniowane lub niestandardowe reguły do kategoryzowania logów i tworzenia alertów.
Integracje Site24x7
Site24x7 opisuje integracje z ServiceNow, PagerDuty, Jira Service Management, Slack, Microsoft Teams, Opsgenie, Zendesk i Zapier. Udostępnia również interfejs REST API do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- NetFlow wskazuje aplikacje i konwersacje intensywnie wykorzystujące przepustowość
- Ujednolica kontekst incydentów sieciowych i związanych z logami
- Recenzenci chwalą scentralizowane pulpity i proaktywne alerty
Cons:
- Analiza przepływów wymaga lokalnego modułu odpytującego
- Liczbę alertów i opóźnienia pomiarów trzeba dostosować
Learn more about Site24x7: Najlepsze dla deweloperów łączących dzienniki ze śladami na poziomie kodu
- Dostępne bezpłatne demo
- Ceny na życzenie
Visit WebsiteCustomer Rating:4.7/5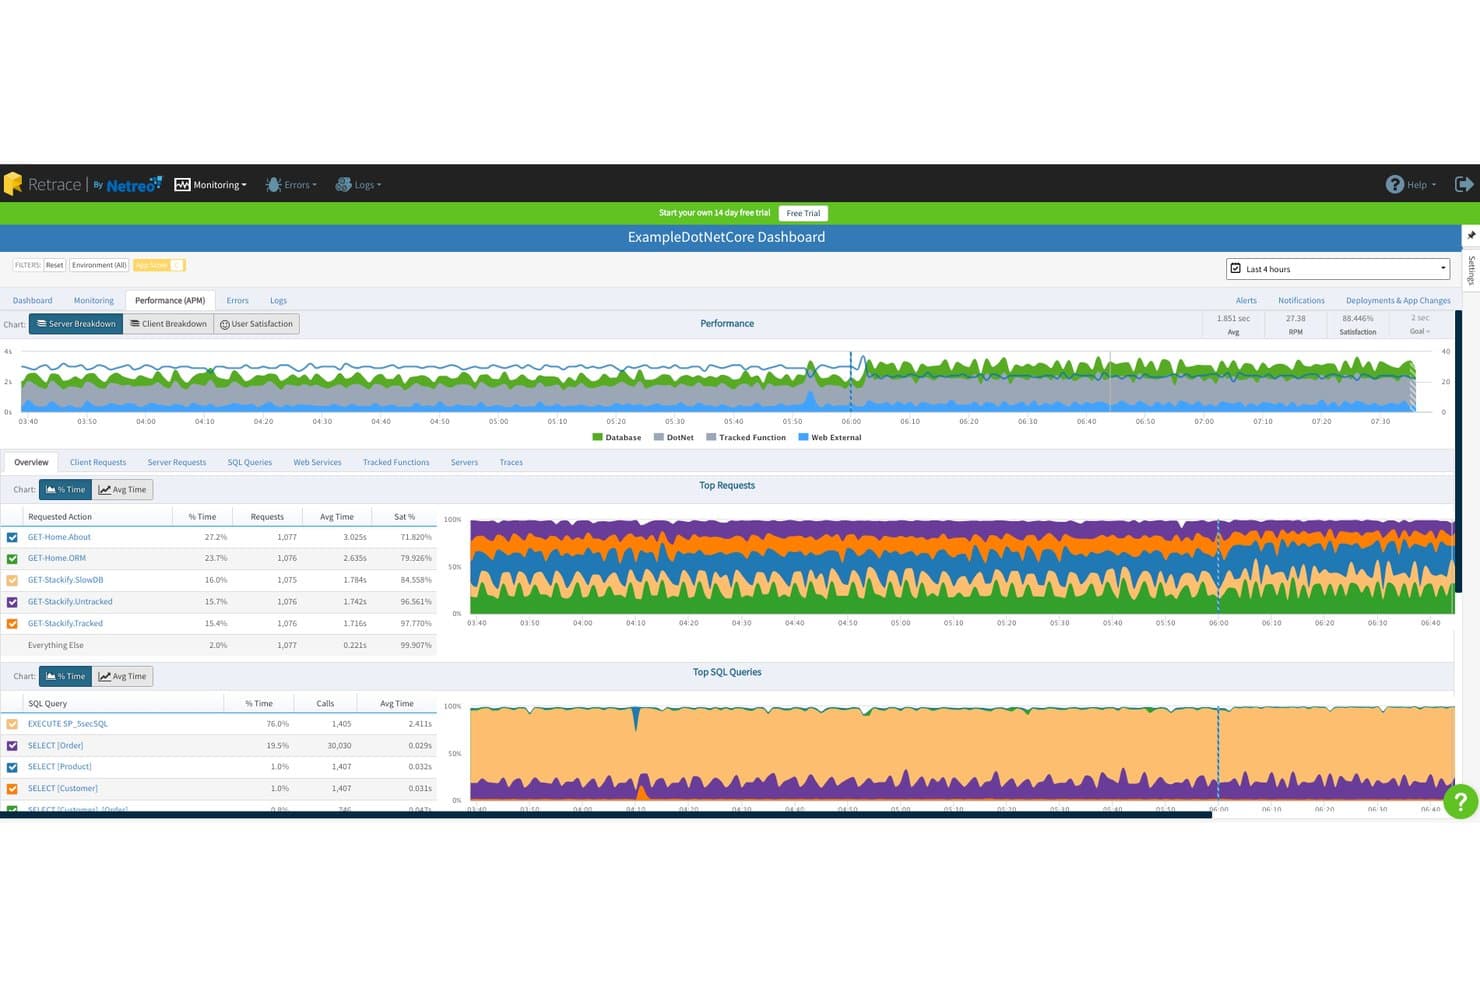
Stackify śledzi wydajność żądań i zapytania SQL na pulpicie APM. Dla deweloperów diagnozujących problemy produkcyjne na podstawie dzienników aplikacji i danych o wydajności Stackify pomaga łączyć błędy ze spowolnieniami, aby zespoły mogły szybciej badać awarie.
Dla kogo Stackify jest najlepszym wyborem?
Stackify odpowiada zespołom programistycznym, które potrzebują monitorowania wydajności aplikacji i śledzenia błędów, aby wspierać codzienne utrzymanie aplikacji.
Dlaczego wybrałem Stackify
Wybrałem Stackify jako „najlepszy wybór dla deweloperów potrzebujących kompleksowych narzędzi do monitorowania wydajności aplikacji”, ponieważ łączy błędy produkcyjne ze spowolnieniami. Jego dzienniki aplikacji, śledzenie błędów i dane o wydajności pomagają mi prześledzić powiązane błędy dotyczące powolnego żądania podczas incydentu.
Najważniejsze funkcje Stackify
- Wyszukiwanie pełnotekstowe: Wyszukiwanie komunikatów dziennika i filtrowanie według pól lub tagów.
- Ustrukturyzowane właściwości dzienników: Wyszukiwanie ustrukturyzowanych wpisów według właściwości niestandardowych i tagów.
- Śledzenie dziennika w czasie rzeczywistym: Śledzenie przychodzących wpisów dziennika w miarę ich pojawiania się.
- Alerty dla zapisanych zapytań: Uruchamianie zapisanych wyszukiwań zgodnie z harmonogramem i wysyłanie alertów, gdy wyniki odpowiadają ustalonym kryteriom.
Integracje Stackify
W dokumentacji Retrace opisano integracje ze Slackiem, Jira, Axosoft, Azure, Octopus i Bamboo. Narzędzie obsługuje również niestandardowe połączenia za pośrednictwem interfejsów API HTTP i webhooków, a także udokumentowaną konfigurację webhooka Zapier.
Pros and Cons
Pros:
- Koreluje wyjątki z otaczającymi je dziennikami aplikacji
- Ślady na poziomie kodu ujawniają powolne zależności SQL
- Znaczniki wdrożeń łączą wydania ze zmianami wydajności
Cons:
- Produkt osiągnie koniec cyklu życia w marcu 2027 r.
- Recenzenci zgłaszają ograniczone możliwości dostosowywania pulpitów
Learn more about Stackify: Najlepszy wybór do obserwowalności opartej na AI w całym stosie operacyjnym
- 15-dniowy bezpłatny okres próbny
- Od $7/miesiąc
Visit WebsiteCustomer Rating:4.5/5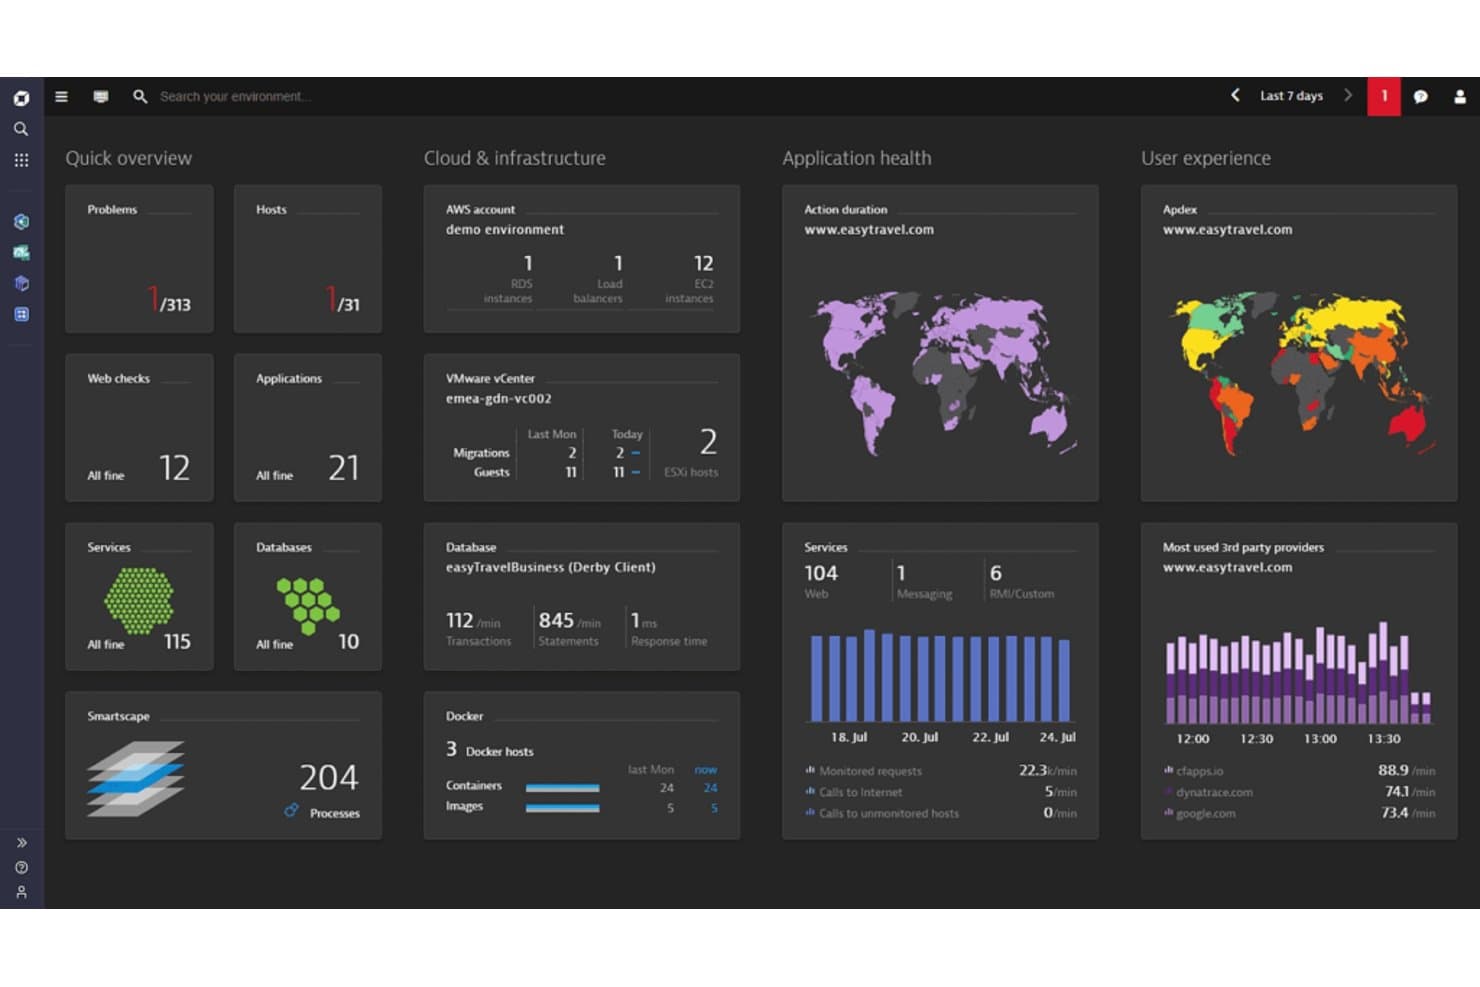
Zdjęcie pulpitu widoczności chmury Dynatrace. Dynatrace to platforma obserwowalności dla zespołów IT i programistycznych, która łączy dane z dzienników, aplikacji i infrastruktury, aby pomagać śledzić problemy z usługami i analizować problemy z wydajnością w złożonych środowiskach.
Dla kogo Dynatrace jest najlepszym wyborem?
Zespoły inżynierii oprogramowania i operacji IT mogą używać Dynatrace do korzystania ze wsparcia AI podczas analizowania wydajności aplikacji i problemów z oprogramowaniem.
Dlaczego wybrałem Dynatrace
Wybrałem Dynatrace jako alternatywę dla Sumo Logic dla organizacji, które traktują priorytetowo wsparcie AI w zakresie inteligencji oprogramowania. Davis AI analizuje dane aplikacji, dzienników i infrastruktury, aby pomóc połączyć spowolnienie usługi z jego prawdopodobną przyczyną. Podoba mi się, że zespoły mogą śledzić problem w obrębie tych sygnałów, zamiast analizować każde źródło danych osobno.
Najważniejsze funkcje Dynatrace
- Pobieranie dzienników: Zbieranie dzienników z hostów, Kubernetes, usług chmurowych i aplikacji.
- Reguły przetwarzania dzienników: Analizowanie, przekształcanie i wzbogacanie dzienników przed ich zapisaniem.
- Wyszukiwanie i filtrowanie dzienników: Wykonywanie zapytań dotyczących dzienników według treści, pól i zakresu czasu.
- Pulpity dzienników: Tworzenie pulpitów z wizualizacjami opartymi na danych z dzienników.
Integracje Dynatrace
Katalog integracji Dynatrace zawiera ponad 750 integracji, w tym GitHub, Jira, Slack i ServiceNow; Workflows oferuje również konektory do AWS, Kubernetes, Microsoft Teams, PagerDuty, GitLab i Jenkins. Dynatrace udostępnia interfejsy API do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Davis AI koreluje sygnały w celu identyfikowania przyczyn źródłowych
- OneAgent automatyzuje wykrywanie w złożonych środowiskach
- Ujednolicone dzienniki, metryki, ślady i monitorowanie użytkowników
Cons:
- Nauka składni DQL wymaga czasu
- Konfiguracja pulpitu może wymagać pracy ręcznej
 Najlepszy do ujednolicania logów, metryk i śladów w jednym widoku
- Dostępny bezpłatny plan
- Od $15/miesiąc (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.5/5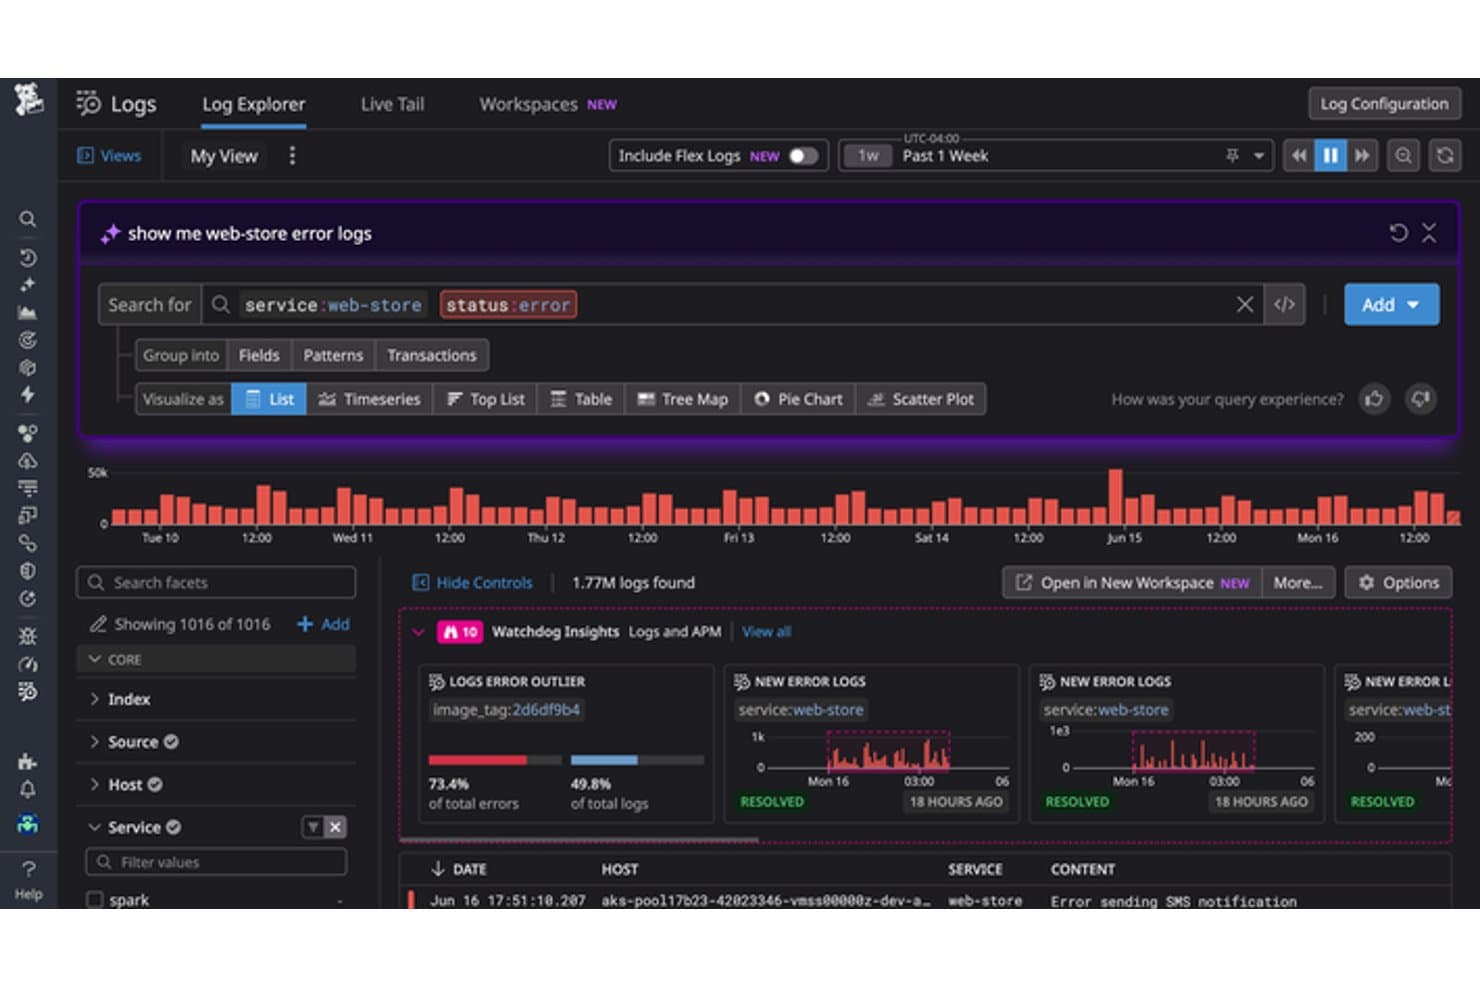
Datadog umożliwia użytkownikom wysyłanie zapytań i analizowanie logów błędów za pomocą wyszukiwania wspomaganego przez AI. Datadog zapewnia zespołom infrastruktury i operacji platformę do zarządzania logami, umożliwiając badanie incydentów w aplikacjach i infrastrukturze oraz pomagając ograniczyć fragmentację procesu rozwiązywania problemów w systemach rozproszonych.
Dla kogo Datadog jest najlepszy?
Datadog sprawdza się w przypadku zespołów operacji IT, SRE i zespołów platformowych, które muszą korelować dane infrastrukturalne i dane aplikacji podczas reagowania na incydenty.
Dlaczego wybrałem Datadog
Datadog znalazł się na mojej liście alternatyw dla Sumo Logic, ponieważ najlepiej sprawdza się w przypadku osób, które potrzebują ujednoliconego widoku metryk, śladów i logów. Podoba mi się, że Eksplorator logów pozwala filtrować i analizować zdarzenia w logach, a następnie korelować je ze śladami i metrykami infrastruktury za pomocą identyfikatorów śladów i tagów. Gdy żądanie realizacji zakupu kończy się niepowodzeniem, mogę śledzić jego błędy w wielu usługach i analizować powiązane sygnały systemowe.
Najważniejsze funkcje Datadog
- Podgląd na żywo: Przesyła zindeksowane i niezindeksowane logi niemal w czasie rzeczywistym.
- Potoki przetwarzania logów: Analizuje i wzbogaca logi za pomocą konfigurowalnych procesorów.
- Archiwa logów: Przekazuje pozyskane logi do pamięci masowej w chmurze w celu ich długoterminowego przechowywania.
- Metryki oparte na logach: Tworzy metryki liczby lub rozkładu na podstawie pasujących logów.
Integracje Datadog
Datadog oferuje ponad 1 000 wbudowanych integracji, w tym z AWS, Azure, Google Cloud, Kubernetes, Slack, PagerDuty i Jira. Zapewnia również interfejs API do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Koreluje logi, ślady i metryki infrastruktury
- Eksplorator logów przyspiesza analizę incydentów przy dużej liczbie danych
- Podgląd na żywo pokazuje zdarzenia niemal w czasie rzeczywistym
Cons:
- Duża liczba logów może prowadzić do nieprzewidywalnych kosztów
- Złożona konfiguracja może wymagać dodatkowego czasu
 Najlepsze do monitorowania hybrydowej infrastruktury IT na dużą skalę
- 14-dniowy bezpłatny okres próbny
- Dostępność i cena na żądanie
Visit WebsiteCustomer Rating:4.5/5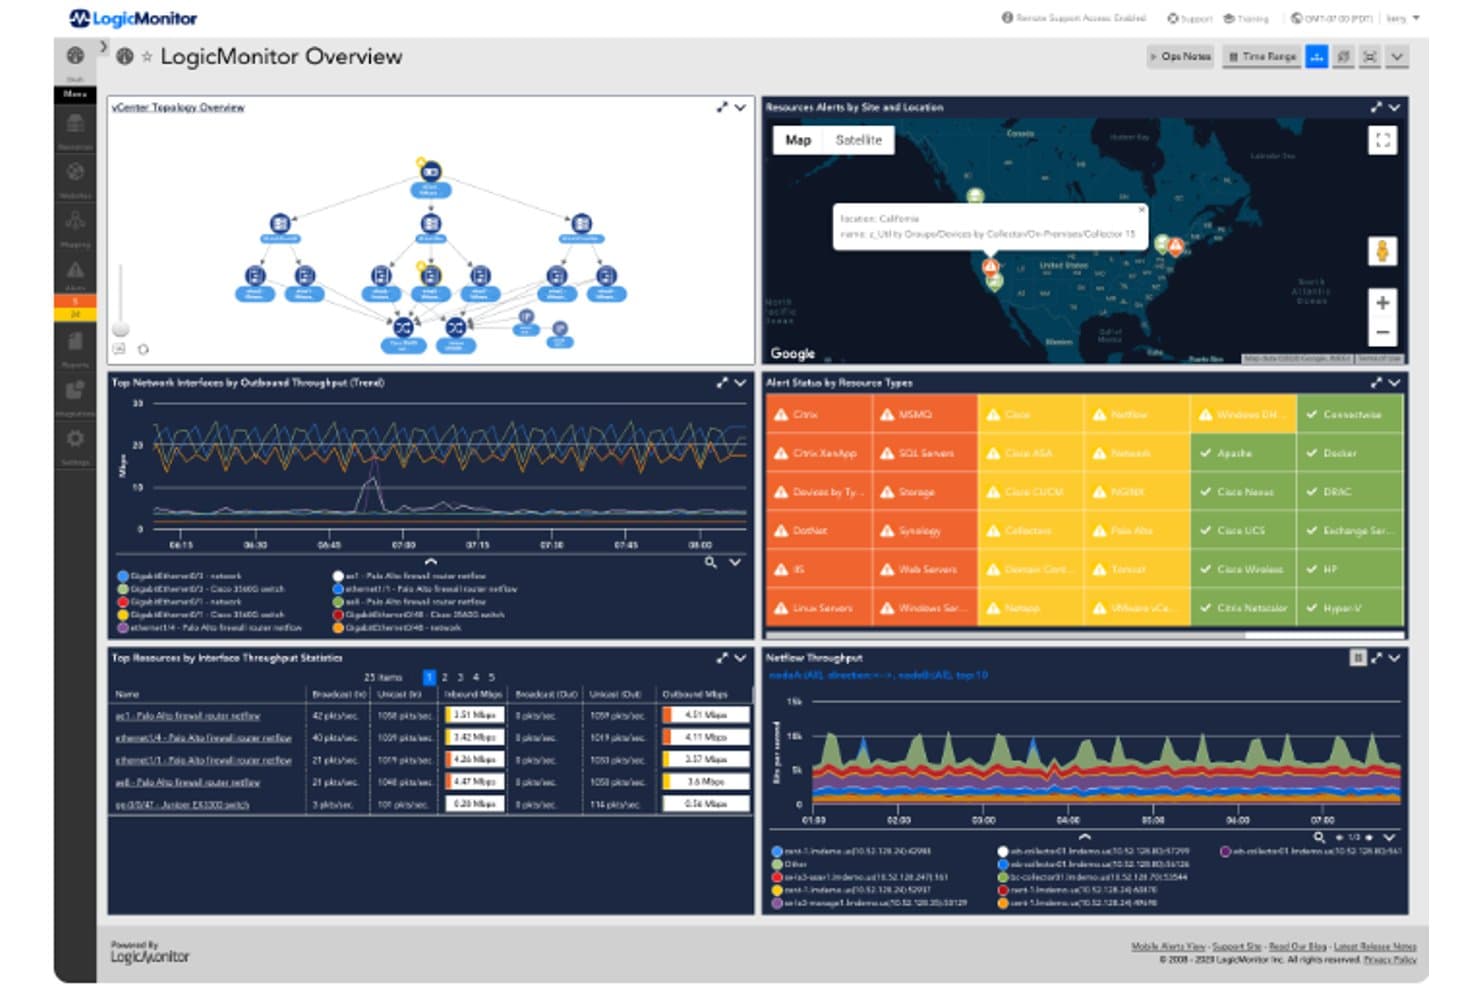
LogicMonitor ujednolica monitorowanie sieci, infrastruktury i alertów na jednym pulpicie nawigacyjnym. Dla zespołów porównujących alternatywy dla Sumo Logic, LogicMonitor to oparta na chmurze platforma obserwowalności, która łączy metryki infrastruktury i logi w jednym widoku, pomagając zespołom IT i DevOps analizować awarie oraz problemy z wydajnością w złożonych środowiskach.
Dla kogo LogicMonitor jest najlepszym wyborem?
LogicMonitor jest odpowiedni dla zespołów operacyjnych IT, które potrzebują zautomatyzowanego monitorowania złożonych środowisk infrastruktury.
Dlaczego wybrałem LogicMonitor
Wybrałem LogicMonitor, ponieważ jego założenia odpowiadają USP: najlepsze rozwiązanie dla zespołów operacyjnych IT i DevOps potrzebujących zautomatyzowanego monitorowania infrastruktury. Podoba mi się, że łączy metryki infrastruktury i logi w jednym widoku, dzięki czemu mogę analizować spowolnienie usługi wraz z powiązanymi zdarzeniami w logach. Zautomatyzowane monitorowanie złożonych środowisk pomaga także zespołom wykrywać problemy z infrastrukturą bez polegania na ręcznych kontrolach.
Najważniejsze funkcje LogicMonitor
- Język zapytań do logów: Przeszukuj logi według zasobu, grupy zasobów i zakresu czasu.
- Filtry źródeł logów: Ustawiaj kryteria uwzględniania lub wykluczania dla gromadzonych zdarzeń w logach.
- Alerty dotyczące logów oparte na wyrażeniach regularnych: Dopasowuj wzorce w logach za pomocą wyrażeń regularnych, aby wyzwalać alerty.
- Profile anomalii w logach: Analizuj zachowanie zasobów i identyfikuj odchylenia od oczekiwanych wzorców.
Integracje LogicMonitor
LogicMonitor opisuje ponad 3000 gotowych integracji z technologiami; wstępnie skonfigurowane integracje alertów i przepływów pracy obejmują Slack, PagerDuty, ServiceNow, Jira Service Management, ConnectWise i Datto Autotask. Jego interfejs REST API obsługuje niestandardowe integracje.
Pros and Cons
Pros:
- Szeroki zakres monitorowania hybrydowej infrastruktury
- Korelacja logów i metryk wspiera analizy
- Pulpity kondycji i alerty zyskują uznanie użytkowników
Cons:
- Raporty niestandardowe wymagają znacznej konfiguracji
- Monitorowanie chmury zależy od łączności z internetem
Learn more about LogicMonitor: Najlepsze do samodzielnego zarządzania wyszukiwaniem dzienników w skali terabajtów
- 60-dniowy bezpłatny okres próbny
- $150/user/month
Visit WebsiteCustomer Rating:4.4/5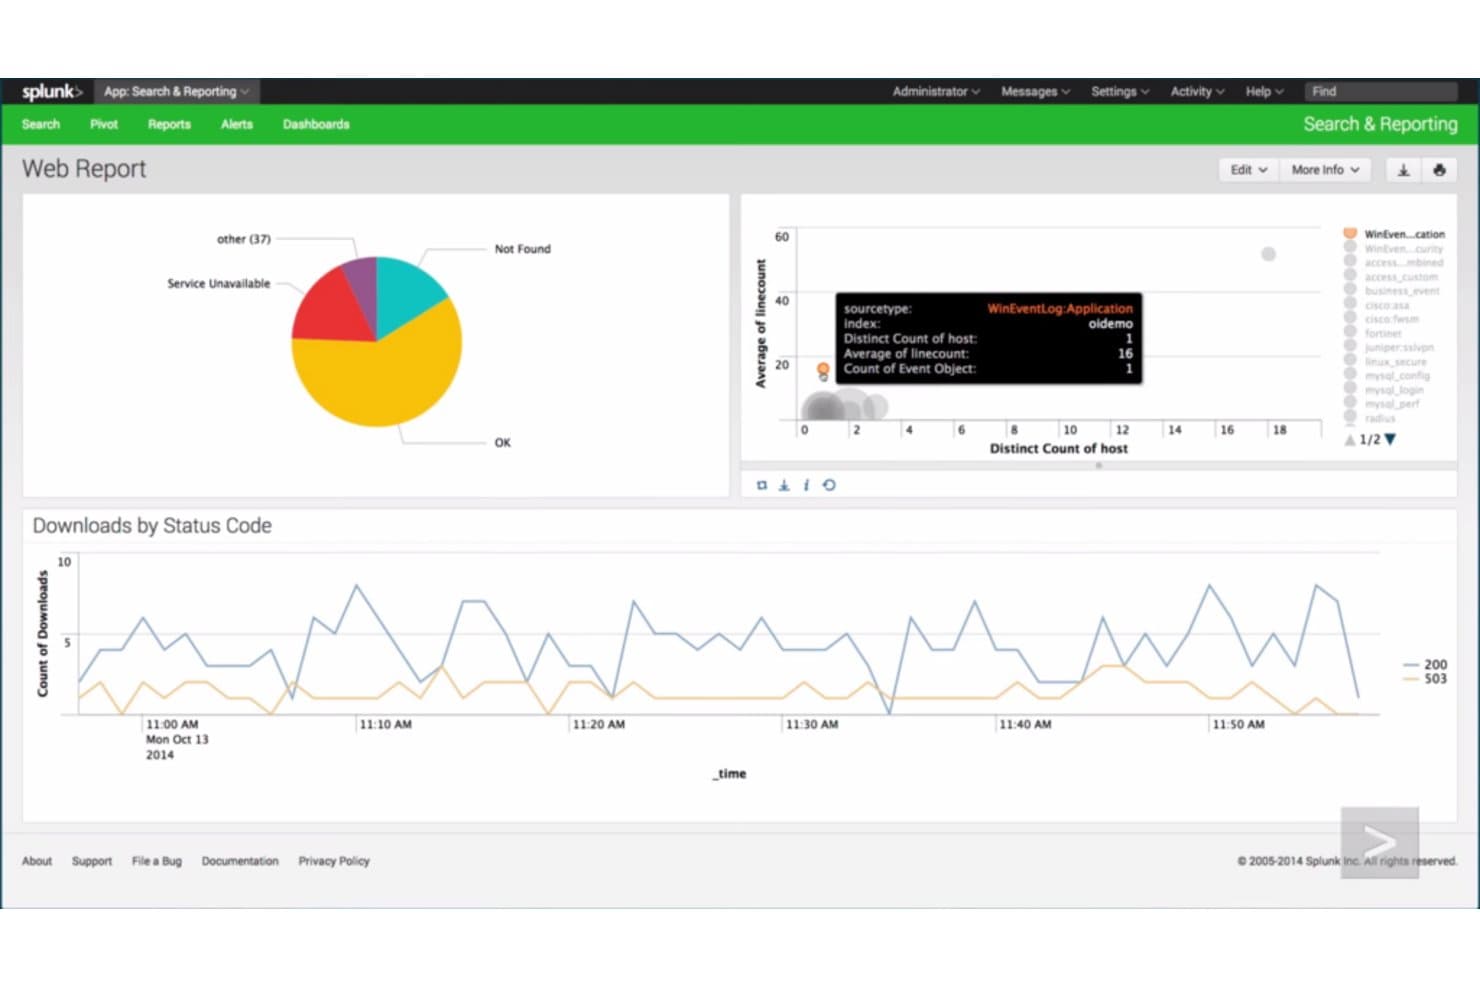
Splunk Enterprise wizualizuje ruch internetowy i pobrania na interaktywnych pulpitach nawigacyjnych. Splunk Enterprise zapewnia zespołom zajmującym się infrastrukturą i bezpieczeństwem przeszukiwalny widok danych maszynowych z systemów lokalnych i chmurowych, pomagając im badać incydenty i diagnozować problemy z usługami.
Dla kogo najlepiej nadaje się Splunk Enterprise?
Splunk Enterprise jest odpowiedni dla zespołów IT i bezpieczeństwa w organizacjach o złożonej infrastrukturze, które muszą gromadzić i analizować dane maszynowe z wielu systemów.
Dlaczego wybrałem Splunk Enterprise
Wybrałem Splunk Enterprise, ponieważ odpowiada kategorii „Najlepsze dla firm wymagających zaawansowanego gromadzenia i analizy danych”. Indeksuje dane maszynowe z systemów lokalnych i chmurowych na potrzeby wyszukiwania w wielu źródłach, a wyszukiwania i alerty SPL pomagają mi śledzić awarie w dziennikach aplikacji i infrastruktury.
Najważniejsze funkcje Splunk Enterprise
- Pulpity nawigacyjne: Twórz wizualne panele na podstawie wyników wyszukiwania, aby monitorować dzienniki i metryki.
- Raporty zaplanowane: Uruchamiaj zapisane wyszukiwania zgodnie z harmonogramem i udostępniaj ich wyniki.
- Kontrola dostępu oparta na rolach: Ustawiaj uprawnienia użytkowników dotyczące danych, wyszukiwań i zadań administracyjnych.
- Ekstrakcja pól: Wyodrębniaj pola z danych zdarzeń, aby ułatwić analizowanie atrybutów dzienników.
Integracje Splunk Enterprise
Splunk Enterprise oferuje ponad 1 000 aplikacji i dodatków dostępnych za pośrednictwem Splunkbase, w tym opcje dla AWS, Microsoft Windows i Google Cloud Platform; dostępność i wsparcie różnią się w zależności od dodatku. Zapewnia również interfejsy REST API i zestawy SDK do tworzenia niestandardowych integracji, a także HTTP Event Collector do wysyłania zdarzeń do Splunk.
Pros and Cons
Pros:
- Koreluje zdarzenia między systemami za pomocą SPL
- Przeszukuje dane maszynowe w środowiskach hybrydowych
- Niestandardowe pulpity nawigacyjne wspierają badanie incydentów
Cons:
- Zapytania SPL wymagają specjalistycznej wiedzy
- Wyszukiwanie może zwalniać przy dużych wolumenach danych
Learn more about Splunk Enterprise: Najlepsze rozwiązanie do łączenia wydajności aplikacji z wpływem na działalność biznesową
- Bezpłatny 30-dniowy okres próbny
- Od $6/vCPU/miesiąc (przy rozliczeniu rocznym)
Visit WebsiteCustomer Rating:4.3/5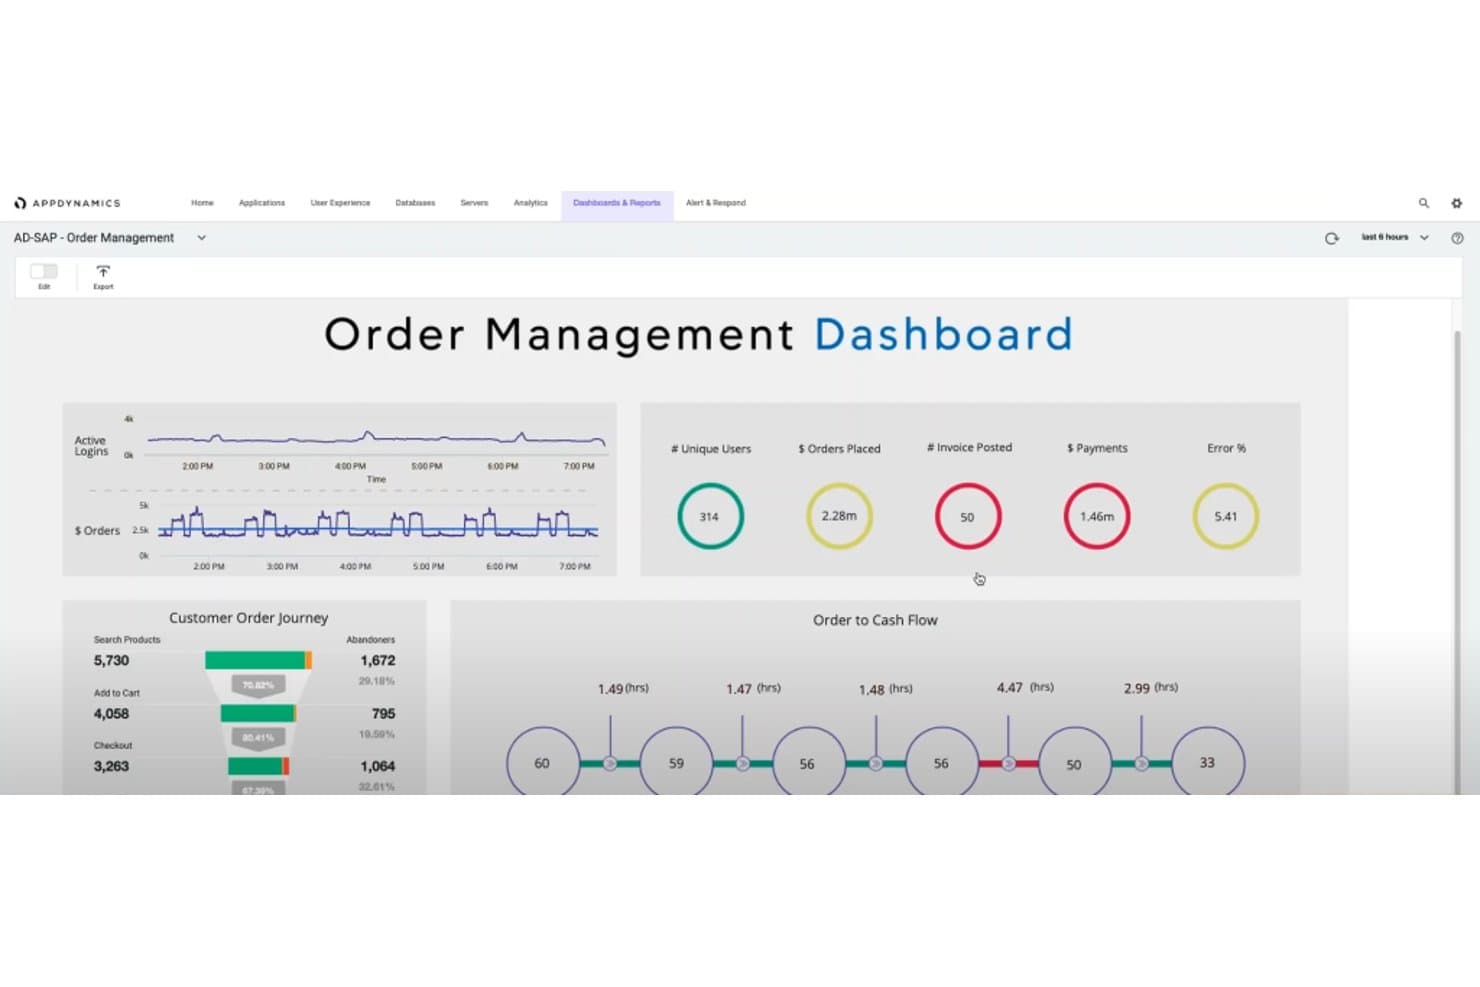
AppDynamics śledzi kluczowe wskaźniki wydajności zarządzania zamówieniami i przebiegi ścieżek klienta. AppDynamics to platforma do monitorowania wydajności aplikacji przeznaczona dla zespołów IT, które muszą łączyć działanie aplikacji z danymi dzienników, aby badać błędy, spowolnienia i przerwy w działaniu usług.
Dla kogo AppDynamics jest najlepszym wyborem?
AppDynamics sprawdzi się w zespołach operacyjnych IT i zespołach zajmujących się aplikacjami, które muszą monitorować wydajność złożonych, wzajemnie połączonych usług biznesowych.
Dlaczego wybrałem AppDynamics
Wybrałem AppDynamics do tej listy alternatyw dla Sumo Logic, ponieważ jest to najlepsze rozwiązanie dla firm poszukujących kompleksowego monitorowania wydajności. Podoba mi się, że łączy monitorowanie transakcji biznesowych z danymi dzienników, dzięki czemu mogę prześledzić powolne żądanie realizacji zakupu i sprawdzić powiązane błędy. To połączenie pomaga mi odróżnić błąd aplikacji od problemu z infrastrukturą podczas incydentu.
Najważniejsze funkcje AppDynamics
- Analiza dzienników: Analizuj dane dzienników za pomocą modułu Analytics i wizualizuj wyniki na pulpitach nawigacyjnych.
- Monitorowanie wzorców: Konfiguruj ciągi tekstowe lub wyrażenia regularne, aby zliczać dopasowania w plikach dzienników.
- Monitorowanie rotowanych plików: Monitoruj pliki dzienników, które stale rosną i są rotowane do wielu plików.
- Metryki i alerty dzienników: Śledź rozmiary plików i liczbę dopasowań jako metryki na potrzeby reguł kondycji.
Integracje AppDynamics
AppDynamics opisuje dziewięć wbudowanych modułów integracji, w tym Jira Actions, ServiceNow i Splunk, oraz obsługuje łączenie z platformą Splunk Cloud Platform lub Splunk Enterprise. Oferuje również interfejsy API REST do niestandardowych integracji i automatyzacji.
Pros and Cons
Pros:
- Ślady transakcji biznesowych ujawniają niedziałające etapy usług
- Migawki na poziomie kodu przyspieszają diagnozowanie przyczyny źródłowej
- Mapy przepływu łączą kondycję aplikacji i infrastruktury
Cons:
- Konfiguracja agentów wymaga znacznych prac wstępnych
- Monitorowanie natywne dla chmury ustępuje nowszym platformom obserwowalności
Learn more about AppDynamics: Najlepsze rozwiązanie do pełnostosowej obserwowalności z wbudowaną sztuczną inteligencją
- Dostępny bezpłatny plan
- Od 10 USD/użytkownika/miesiąc
Visit WebsiteCustomer Rating:4.3/5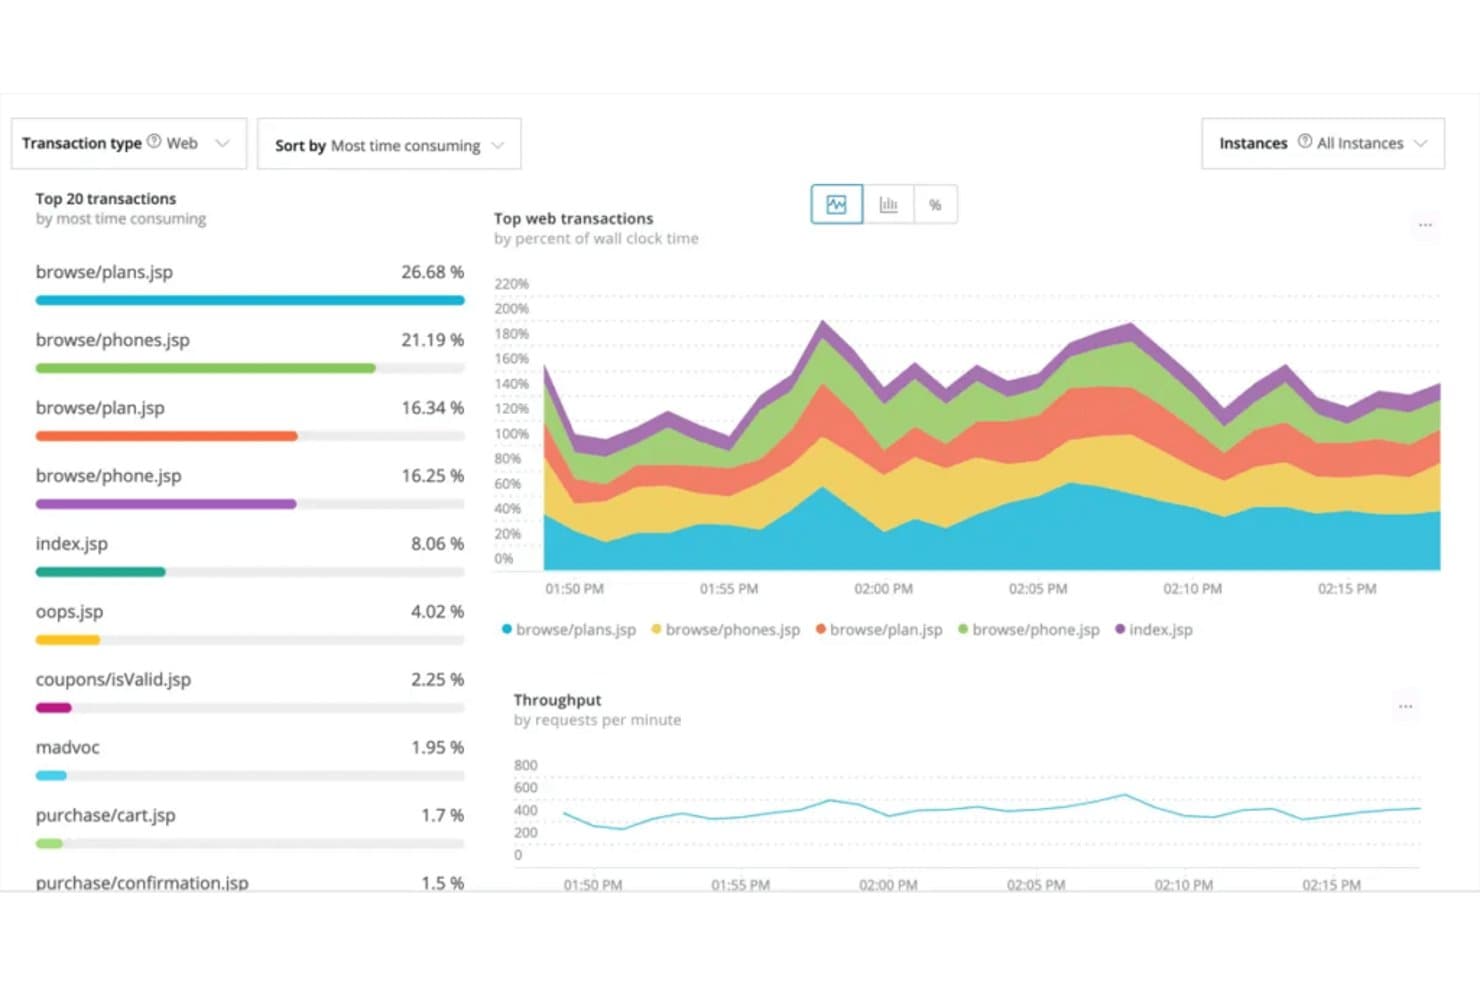
New Relic śledzi najważniejsze transakcje internetowe według czasu zużycia i przepustowości. New Relic to oparta na chmurze platforma obserwowalności dla zespołów IT i DevOps, która łączy logi, metryki i ślady, aby ułatwiać analizowanie awarii, znajdowanie problemów z aplikacjami oraz monitorowanie wydajności infrastruktury.
Dla kogo New Relic jest najlepszym wyborem?
New Relic sprawdzi się w zespołach IT i DevOps, które potrzebują połączyć dane aplikacji, infrastruktury i usług, aby analizować incydenty w złożonych środowiskach.
Dlaczego wybrałem New Relic
Wybrałem New Relic jako najlepsze rozwiązanie do pełnostosowej obserwowalności z wbudowaną sztuczną inteligencją, ponieważ Logi w kontekście łączą zdarzenia w logach z powiązanymi śladami i usługami. Gdy alert wskazuje błędy w wielu usługach, wbudowana sztuczna inteligencja koreluje sygnały w problemy, pomagając mi analizować incydent za pomocą połączonych logów i śladów.
Najważniejsze funkcje New Relic
- Zapytania do logów NRQL: Wyszukiwanie i filtrowanie zdarzeń w logach za pomocą języka zapytań New Relic (NRQL).
- Analizowanie logów: Stosowanie wbudowanych lub niestandardowych reguł do wyodrębniania z logów atrybutów, które można przeszukiwać.
- Wzorce w logach: Grupowanie podobnych komunikatów w celu analizowania powtarzających się wzorców i zmian w czasie.
- Partycje danych: Organizowanie danych logów w partycje na potrzeby ukierunkowanych zapytań.
Integracje New Relic
Katalog Instant Observability firmy New Relic obejmuje ponad 700 integracji i gotowych konfiguracji, z opcjami dla AWS, Azure, Google Cloud, Kubernetes, Apache, Cassandra, MySQL, NGINX, Redis i Oracle Database. Możesz także używać interfejsów API New Relic lub Flex do przesyłania danych z niestandardowych integracji.
Pros and Cons
Pros:
- Koreluje logi ze śladami i usługami
- Zapytania NRQL łączą logi i dane telemetryczne
- Podsumowania generowane przez sztuczną inteligencję przyspieszają analizę alertów w logach
Cons:
- Przeładowany interfejs spowalnia analizowanie logów
- Rozwój ilości pozyskiwanych danych sprawia, że budżety stają się nieprzewidywalne
Learn more about New Relic: Najlepsze rozwiązanie dla nowoczesnych inżynierów potrzebujących zaawansowanego zarządzania logami
- Dostępny bezpłatny plan
- Od $29/użytkownika/miesiąc (rozliczane rocznie)
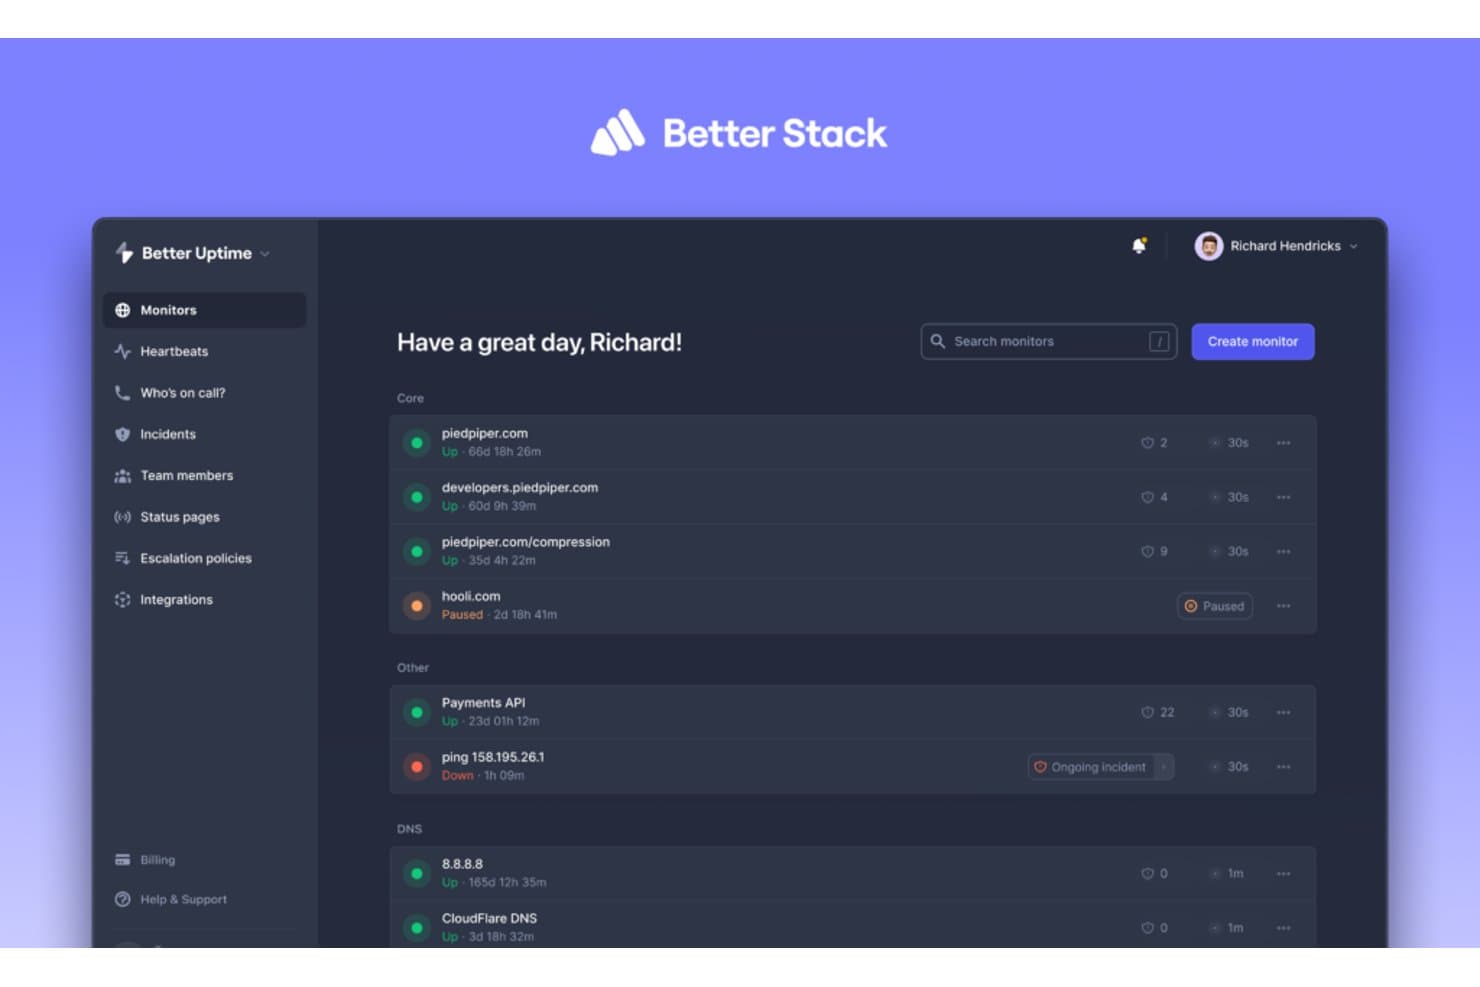
Better Stack pozwala użytkownikom jednocześnie monitorować dostępność wielu usług. Better Stack łączy zarządzanie logami i monitorowanie usług dla zespołów inżynieryjnych, które muszą analizować błędy produkcyjne, wykrywać problemy z infrastrukturą i reagować na incydenty.
Dla kogo Better Stack jest najlepszym wyborem?
Better Stack sprawdzi się w zespołach inżynieryjnych i infrastrukturalnych, które muszą przeszukiwać logi aplikacji i monitorować usługi podczas reagowania na incydenty.
Dlaczego wybrałem Better Stack
Wybrałem Better Stack jako „Najlepsze rozwiązanie dla nowoczesnych inżynierów potrzebujących zaawansowanego zarządzania logami”, ponieważ funkcje śledzenia na żywo i wyszukiwania opartego na SQL pomagają mi śledzić błędy produkcyjne w napływających logach. Używam również alertów logów, aby wykrywać powtarzające się awarie i analizować je podczas incydentów.
Najważniejsze funkcje Better Stack
- Integracje ze źródłami logów: Zbieraj logi z aplikacji, platform Docker i Kubernetes, a także z Vector, Syslog lub OpenTelemetry.
- Automatyczne analizowanie: Analizuj logi na podstawie wybranego typu źródła.
- Transformacje VRL: Usuwaj dane osobowe lub odrzucaj niechciane zdarzenia przed ich zapisaniem.
- Konfigurowalny okres przechowywania: Ustawiaj okresy przechowywania logów osobno dla każdego źródła.
Integracje Better Stack
Better Stack obsługuje pozyskiwanie logów z Docker, Kubernetes, PostgreSQL, Cloudflare, JavaScript/Node.js i Python, a także ich przekazywanie za pośrednictwem Vector, Fluent Bit, Logstash, Fluentd lub Syslog. Oferuje również interfejs API HTTP do niestandardowego pozyskiwania logów i łączy się z Zapier.
Pros and Cons
Pros:
- Wyszukiwanie logów na żywo pomaga śledzić błędy produkcyjne
- Zapytania SQL współpracują z wizualnymi filtrami logów
- Alerty logów łączą analizę problemów z reagowaniem na incydenty
Cons:
- Przepływy pracy związane z zarządzaniem logami mogą być nieporęczne
- Brak opcji samodzielnego hostowania dla ścisłej kontroli danych
Learn more about Better Stack:
Inne alternatywy dla Sumo Logic
Oto kilka dodatkowych alternatyw dla Sumo Logic, które nie trafiły na moją listę, ale nadal warto je sprawdzić:
- 11Grafana CloudNajlepsza do wizualizowania i analizowania metryk z różnych źródeł
- 12GraylogNajlepsze rozwiązanie do zarządzania dużą ilością logów i analizowania ich w czasie rzeczywistym
- 13Logz.ioNajlepsze dla organizacji natywnych dla chmury, które cenią wnioski oparte na sztucznej inteligencji
- 14LogRhythmNajlepsze dla przedsiębiorstw wymagających zaawansowanego zarządzania informacjami i zdarzeniami dotyczącymi bezpieczeństwa
Inne recenzje oprogramowania
- Oprogramowanie do reagowania na incydenty
- Alternatywy dla HoneyComb
- Oprogramowanie do cyberbezpieczeństwa
Jak oceniam alternatywy dla Sumo Logic
Dzielę swoją ocenę na dwie warstwy: podstawowe możliwości, które musi mieć każde narzędzie nadające się do wykorzystania, oraz czynniki wyróżniające, które mają największe znaczenie dla zespołów tonących w logach chmurowych lub poszukujących przyczyn źródłowych incydentów.
Podstawowa funkcjonalność (wymagania niezbędne na tej liście)
Wybierając narzędzia do swojej listy, oceniam każde z nich w skali od 0 (nie oferuje danej funkcjonalności) do 5 (doskonale radzi sobie w tym obszarze) dla każdej z wymienionych poniżej podstawowych funkcjonalności. Następnie przeliczam łączny wynik narzędzia na wartość procentową. Każde narzędzie musi uzyskać minimalny łączny wynik wynoszący 75%, aby zostać uwzględnione na liście.
- Agregacja i pozyskiwanie logów: Oceniam, z jak wielu źródeł narzędzie może pobierać dane od razu — na przykład z zasobników Kubernetes, chmurowych VPC, aplikacji skonteneryzowanych i starszych serwerów syslog, które wszystkie zasilają jeden potok.
- Wyszukiwanie i zapytania w czasie rzeczywistym: Szybkie i elastyczne zapytania mają znaczenie podczas trwającego incydentu. Sprawdzam, jak każde narzędzie obsługuje złożone zapytania w dużych zbiorach danych oraz czy jego język zapytań obsługuje analizowanie, filtrowanie i agregowanie.
- Metryki i obserwowalność: Szukam ujednoliconych widoków, które łączą logi, metryki i ślady. Narzędzie, które zmusza do przełączania się między niepołączonymi pulpitami w celu skorelowania skoku opóźnienia z logiem błędu, spowalnia rozwiązywanie problemów.
- Alerty i wykrywanie anomalii: Dobre alerty wykraczają poza statyczne wartości progowe. Oceniam, czy każde narzędzie oferuje wykrywanie anomalii oparte na uczeniu maszynowym oraz elastyczne kierowanie powiadomień do kanałów takich jak Slack, PagerDuty lub punktów końcowych webhooków.
- Analityka bezpieczeństwa i SIEM: W przypadku zespołów SecOps sprawdzam, czy platforma obsługuje wykrywanie zagrożeń, korelację zdarzeń i raportowanie zgodności z takimi standardami jak SOC 2, HIPAA lub PCI-DSS.
- Natywność chmurowa i integracje: Każde narzędzie powinno integrować się z ekosystemami, z których zespoły już korzystają. Szukam gotowych integracji z AWS, Azure, GCP i popularnymi łańcuchami narzędzi DevOps, a także dostępu do otwartego interfejsu API.
Gdy mam już listę narzędzi spełniających te kryteria, sprawdzam, co wyróżnia każdą platformę.
Czynniki wyróżniające (co odróżnia dostawców)
Oto jak porównuję różnych dostawców:
Wyróżniające się funkcje
Jedną z najważniejszych kwestii jest śledzenie rozproszone — szukam natywnej obsługi OpenTelemetry, która pozwala śledzić pojedyncze żądanie w dziesiątkach mikrousług, aby dokładnie ustalić, gdzie pojawiają się skoki opóźnienia. Znaczenie mają również konfigurowalne poziomy danych, ponieważ bezpośrednio wpływają na koszty; narzędzia oferujące magazynowanie danych w warstwach gorącej, ciepłej i zimnej wraz z możliwością ponownego udostępniania danych zapewniają większą kontrolę nad budżetami przechowywania. Oceniam również spostrzeżenia wspierane przez sztuczną inteligencję, w ramach których platformy automatycznie wskazują przyczyny źródłowe lub anomalie, zamiast wymagać ręcznego tworzenia zapytań podczas incydentu o 2 w nocy.
Więcej niż funkcje
Model cenowy jest jedną z pierwszych rzeczy, które oceniam. Wolumeny logów mogą gwałtownie wzrosnąć podczas incydentów, dlatego sprawdzam, czy struktura rozliczeń dostawcy nakłada kary za takie skoki, czy też zapewnia przewidywalne koszty. Elastyczność wdrożenia również ma znaczenie — zespoły z branż regulowanych często potrzebują opcji samodzielnego hostowania lub środowisk odizolowanych od sieci, obok modelu SaaS. Analizuję również historię skalowalności, ponieważ platforma, która dobrze obsługuje zapytania przy 500 GB dziennie, może mieć problemy przy 5 TB. Certyfikaty zgodności, takie jak SOC 2 i HIPAA, pokazują mi, czy narzędzie jest od razu gotowe do zastosowań korporacyjnych.
Dlaczego warto szukać alternatywy dla Sumo Logic?
Chociaż Sumo Logic jest dobrym wyborem jako platforma do zarządzania dziennikami zdarzeń, istnieje wiele powodów, dla których niektórzy użytkownicy szukają alternatywnych rozwiązań. Możesz szukać alternatywy dla Sumo Logic, ponieważ…
- Ceny nie skalują się dobrze przy dużych ilościach danych.
- Wydajność zapytań spada w przypadku dużych zbiorów danych.
- Interfejs użytkownika może wydawać się przytłaczający dla nowych użytkowników.
- Zaawansowane funkcje wymagają dużo czasu na naukę.
- Integracja z niektórymi narzędziami nie przebiega płynnie.
- Opcje alertów wydają się zbyt ograniczone w stosunku do Twoich potrzeb.
Jeśli któryś z tych punktów opisuje Twoją sytuację, trafiłeś we właściwe miejsce. Moja lista zawiera kilka platform do zarządzania dziennikami zdarzeń, które lepiej odpowiadają potrzebom zespołów mierzących się z tymi wyzwaniami w Sumo Logic i szukających alternatywnych rozwiązań.
Najważniejsze funkcje Sumo Logic
Oto niektóre z najważniejszych funkcji Sumo Logic, które pomogą Ci porównać ofertę alternatywnych rozwiązań:
- Kontrola dostępu oparta na rolach: Umożliwia określenie, kto w Twoim zespole może wyświetlać poszczególne informacje lub wykonywać określone działania.
- Analiza dzienników: Umożliwia zbieranie, wyszukiwanie i analizowanie danych dzienników w całych systemach.
- Pulpity nawigacyjne w czasie rzeczywistym: Pomagają monitorować najważniejsze wskaźniki na bieżąco, aby zespół mógł szybko reagować.
- Alerty: Powiadamiają zespół, gdy w danych wydarzy się coś nietypowego lub ważnego.
- Archiwizacja danych: Umożliwia przechowywanie danych historycznych na potrzeby zgodności z przepisami lub przyszłych analiz.
- Architektura natywna dla chmury: Zapewnia zespołowi elastyczność dzięki skalowalnemu, chmurowemu zarządzaniu dziennikami.
- Analiza bezpieczeństwa: Pomaga wykrywać zagrożenia lub naruszenia zasad na podstawie danych dzienników.
- Integracje: Umożliwia łatwe łączenie z usługami takimi jak AWS, GCP, Azure i Kubernetes.
- Język zapytań: Umożliwia szczegółowe analizowanie danych za pomocą elastycznego języka wyszukiwania.
- Informacje uzyskiwane dzięki uczeniu maszynowemu: Wskazują wzorce lub anomalie, które mogą wymagać uwagi.