

Jako doświadczony specjalista pracujący z interfejsami API, mikrousługami i wieloma technologiami obejmującymi cały stos technologiczny doskonale rozumiem kluczową rolę skutecznego monitorowania wydajności. Na przestrzeni lat osobiście przekonałem się o zaletach korzystania z kompleksowych platform AIOps, takich jak alternatywy dla Dynatrace, które oferują szybkie rozwiązywanie problemów i analizę przyczyn źródłowych.
Te zamienniki Dynatrace są nie tylko przyjazne dla użytkownika, ale także imponują rozbudowanymi funkcjami monitorowania. Bezproblemowa integracja z popularnymi platformami, takimi jak Slack, pomaga usprawnić komunikację w zespole w kluczowych sytuacjach. Dzięki rozbudowanemu profilowaniu i modułowym rozwiązaniom masz do dyspozycji wydajną platformę monitorowania, która może podnieść jakość Twojego stosu technologicznego i zwiększyć ogólną produktywność.
Czym jest Dynatrace?
Dynatrace to platforma do monitorowania wydajności aplikacji (APM), która pomaga śledzić, analizować i optymalizować działanie aplikacji oraz infrastruktury. Korzystają z niej zespoły DevOps, SRE i liderzy IT, którzy muszą wcześnie wykrywać problemy i poprawiać doświadczenia użytkowników. Monitorowanie w czasie rzeczywistym, alerty oparte na sztucznej inteligencji oraz śledzenie działania aplikacji od początku do końca pomagają znajdować spowolnienia, określać przyczyny źródłowe i zapewniać płynne działanie systemów. Ogólnie rzecz biorąc, Dynatrace pomaga zespołowi wyprzedzać problemy z wydajnością, zanim wpłyną one na użytkowników.
Why Trust Our Software Recommendations
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Our team has been testing and reviewing software since 2012. As tech leaders ourselves, we know how difficult—and important—it is to choose the right software.
For this guide, we evaluated tools using hands-on testing and independent research, scoring tools using our selection criteria.
Our reviews reflect our human editorial judgment, not a sales pitch.
Expert reviewers:
- Paulo Gardini MiguelTech Director
 Tim FisherVP of AI
 Gabriel RosasTech Lead & Software Architect
 Christhian GruhnTech Lead & Platform Architect

Tabela porównawcza alternatyw dla Dynatrace
Ta tabela porównawcza przedstawia szczegóły cenowe dotyczące wybranych przeze mnie najlepszych alternatyw dla Dynatrace:
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Najlepsze do rozwiązywania błędów w czasie rzeczywistym | Dostępny bezpłatny plan | Od $26/miesiąc (rozliczane rocznie) | Website | |
| 2 | Najlepsze rozwiązanie zapewniające szeroką obsługę technologii | Dostępny bezpłatny plan | Od $32.92/miesiąc (rozliczane rocznie) | Website | |
| 3 | Najlepsze rozwiązanie dla zróżnicowanych środowisk aplikacji | 30-dniowy bezpłatny okres próbny | Od $10/miesiąc | Website | |
| 4 | Najlepszy do kompleksowego monitorowania infrastruktury IT | 30-dniowy bezpłatny okres próbny | Od $2,595 jednorazowo | Website | |
| 5 | Najlepszy do ujednoliconego monitorowania usług w chmurze | Nie | Od $15/miesiąc (rozliczane rocznie) | Website | |
| 6 | Najlepszy do monitorowania opartego na otwartym oprogramowaniu na poziomie przedsiębiorstwa | Nie | Bezpłatny | Website | |
| 7 | Najlepsze rozwiązanie zapewniające wgląd w wydajność biznesową w czasie rzeczywistym | Nie | Od $6/vCPU/miesiąc (rozliczane rocznie) | Website | |
| 8 | Najlepsze rozwiązanie do odpytywania danych telemetrycznych w ujednoliconym magazynie danych | Nie | $12/użytkownika/miesiąc (rozliczane rocznie) | Website | |
| 9 | Najlepszy do zarządzania logami i analityki bezpieczeństwa | Nie | $108 za użytkownika miesięcznie (rozliczenie roczne) | Website | |
| 10 | Najlepszy do analizy danych na dużą skalę i uzyskiwania wniosków | Nie | $150/user/month | Website |


Recenzje najlepszych alternatyw dla Dynatrace
Poniżej znajdziesz moje szczegółowe podsumowania najlepszych alternatyw dla Dynatrace, które trafiły na moją listę. W recenzjach szczegółowo omawiam najważniejsze funkcje, zalety i wady, integracje oraz idealne zastosowania każdego narzędzia, aby pomóc Ci znaleźć najlepsze rozwiązanie dla siebie.
 Najlepsze do rozwiązywania błędów w czasie rzeczywistym
- Dostępny bezpłatny plan
- Od $26/miesiąc (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.5/5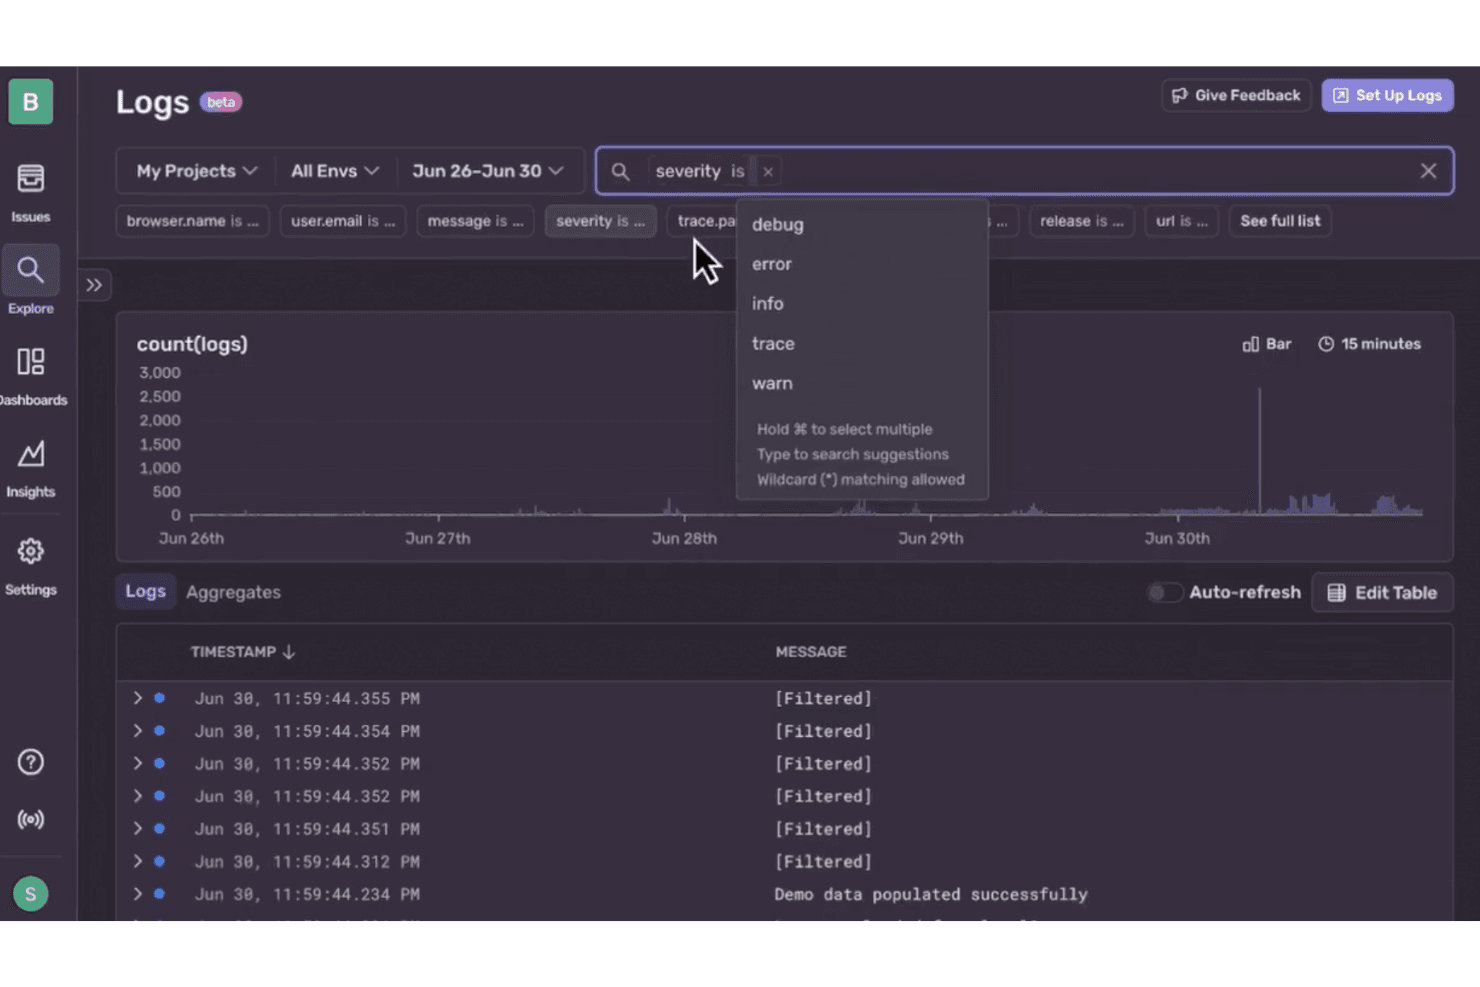
Sentry umożliwia użytkownikom filtrowanie dzienników według poziomów ważności, takich jak debugowanie, błąd lub ostrzeżenie. Sentry łączy monitorowanie wydajności aplikacji ze śledzeniem błędów, oferując zespołom programistycznym alternatywę dla Dynatrace skoncentrowaną na deweloperach, umożliwiającą diagnozowanie problemów w aplikacjach i usługach.
Dla kogo najlepiej nadaje się Sentry?
Sentry dobrze sprawdza się w zespołach inżynierii oprogramowania i DevOps, które muszą identyfikować i rozwiązywać błędy produkcyjne w czasie rzeczywistym.
Dlaczego wybrałem Sentry
Wybrałem Sentry jako najlepsze rozwiązanie do rozwiązywania błędów w czasie rzeczywistym, ponieważ łączy błędy produkcyjne ze śladami stosu i danymi śledzenia, pomagając deweloperom wskazać nieprawidłowo działające ścieżki kodu. Monitorowanie kondycji wydań i regresji może również ujawnić, kiedy wdrożenie wprowadza nowe problemy, dzięki czemu zespoły mogą ustalać priorytety napraw, jednocześnie monitorując wydajność aplikacji.
Najważniejsze funkcje Sentry
- Ciągłe profilowanie: Wyświetlaj profile wykorzystania procesora na poziomie funkcji dla obsługiwanych aplikacji.
- Wskaźniki internetowe: Śledź metryki przeglądarki, takie jak czas ładowania strony i responsywność interakcji.
- Monitorowanie zapytań do bazy danych: Sprawdzaj czas trwania zapytań i identyfikuj powolne operacje na bazie danych.
- Niestandardowa instrumentacja: Dodawaj pomiary w celu monitorowania operacji specyficznych dla aplikacji.
Integracje Sentry
Sentry oferuje integracje z GitHub, GitLab, Jira, Slack, Microsoft Teams, PagerDuty, Azure DevOps, Bitbucket, Vercel i Opsgenie. Jego platforma integracyjna oraz interfejs API REST obsługują niestandardowe integracje.
Pros and Cons
Pros:
- Ślady stosu przyspieszają debugowanie produkcji
- Łączy błędy ze śladami i profilami
- Śledzenie wydań sygnalizuje regresje wdrożeń
Cons:
- Brak monitorowania hostów i infrastruktury
- Grupowanie problemów i alerty mogą generować szum informacyjny
Learn more about Sentry: Najlepsze rozwiązanie zapewniające szeroką obsługę technologii
- Dostępny bezpłatny plan
- Od $32.92/miesiąc (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.3/5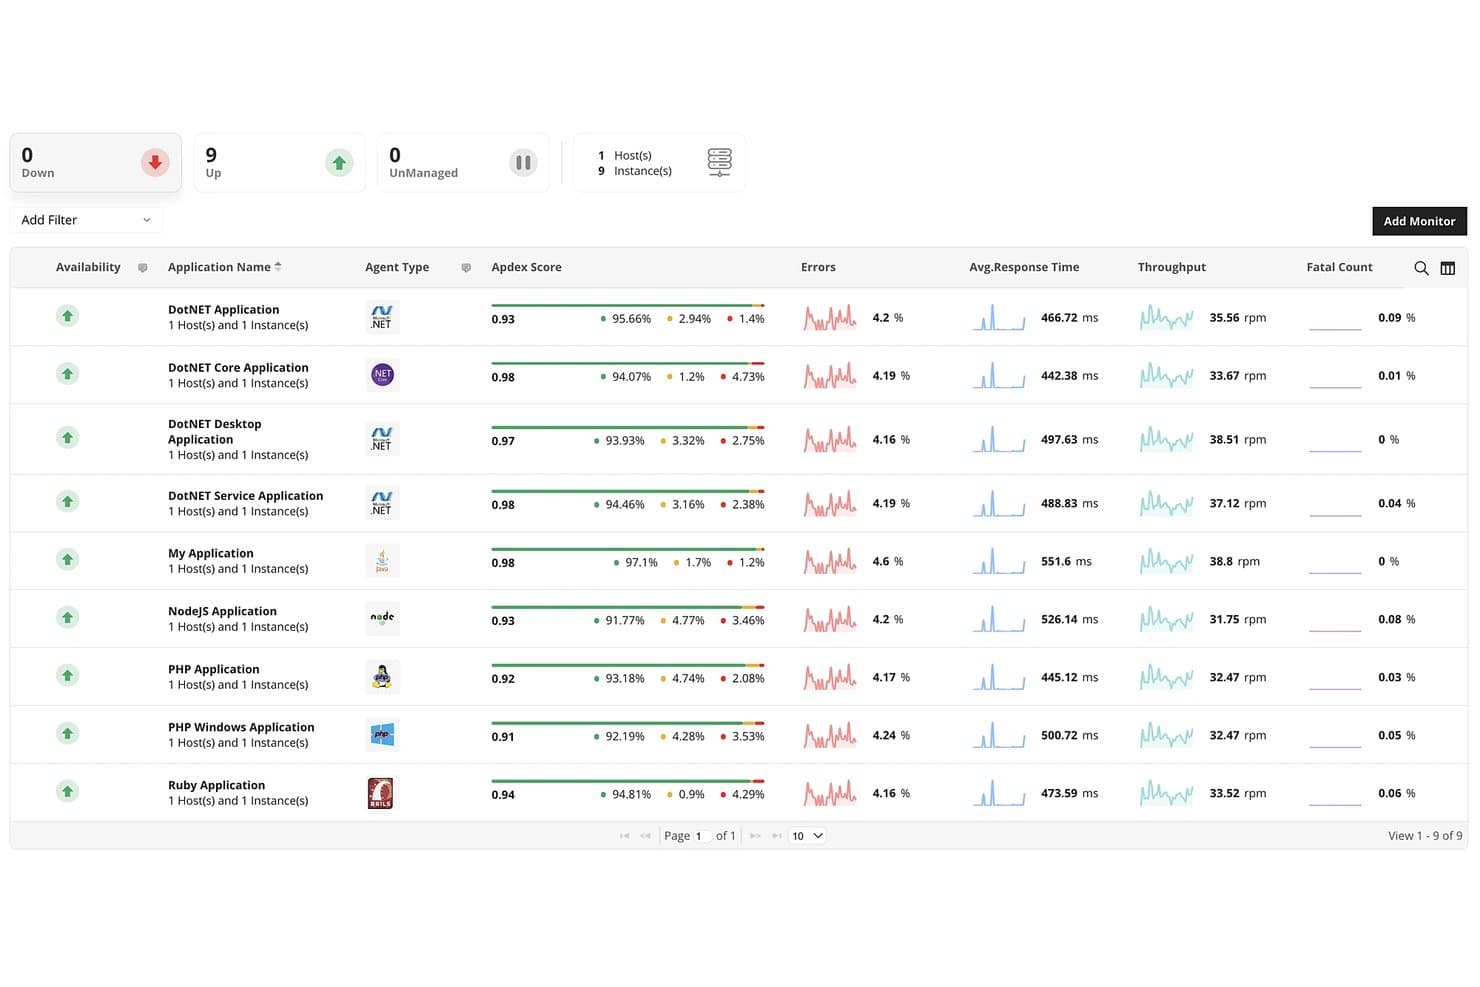
ManageEngine Applications Manager śledzi metryki wydajności aplikacji w wielu instancjach. ManageEngine Applications Manager to platforma do monitorowania wydajności aplikacji przeznaczona dla zespołów IT, które muszą śledzić spowolnienia i awarie w aplikacjach, serwerach, bazach danych oraz usługach chmurowych.
Dla kogo najlepiej sprawdzi się ManageEngine Applications Manager?
Zespoły operacyjne IT nadzorujące zróżnicowane środowiska aplikacyjne i infrastrukturalne w systemach lokalnych oraz chmurowych.
Dlaczego wybrałem ManageEngine Applications Manager
Wybrałem ManageEngine Applications Manager jako „najlepsze rozwiązanie zapewniające szeroką obsługę technologii”, ponieważ monitoruje aplikacje, a także serwery, bazy danych i usługi chmurowe. Doceniam ten szeroki zakres, ponieważ umożliwia śledzenie powolnego żądania w wielu warstwach aplikacyjnych i infrastrukturalnych, a następnie wykorzystanie diagnostyki transakcji do ustalenia, gdzie narasta opóźnienie.
Najważniejsze funkcje ManageEngine Applications Manager
- Wykrywanie anomalii: Porównuj metryki wydajności z historycznymi wartościami bazowymi lub niestandardowymi regułami.
- Zarządzanie logami: Wyszukuj, filtruj i analizuj logi aplikacji oraz serwerów w czasie rzeczywistym.
- Monitorowanie rzeczywistych użytkowników: Śledź wyświetlenia stron, kliknięcia, czas trwania sesji i wyniki Apdex na podstawie rzeczywistego ruchu.
- Prognozowanie pojemności: Analizuj raporty trendów i prognozy oparte na uczeniu maszynowym, aby planować zapotrzebowanie na zasoby.
Integracje ManageEngine Applications Manager
ManageEngine Applications Manager dokumentuje integracje z ManageEngine ServiceDesk Plus, ManageEngine OpManager, Slackiem i ServiceNow, a także z platformami SIEM zgodnymi z Syslog, takimi jak Splunk, Microsoft Sentinel i ManageEngine Log360. Udostępnia również interfejsy API REST umożliwiające łączenie wewnętrznych portali i systemów innych firm.
Pros and Cons
Pros:
- Monitorowanie aplikacji, baz danych, serwerów i chmury
- Alerty w czasie rzeczywistym wspierają proaktywne rozwiązywanie problemów
- Szeroka obsługa starszych środowisk i środowisk hybrydowych
Cons:
- Zaawansowane dostrajanie progów wymaga czasu na konfigurację
- Mniejsza głębokość śledzenia aplikacji natywnych dla chmury
Learn more about ManageEngine Applications Manager: Najlepsze rozwiązanie dla zróżnicowanych środowisk aplikacji
- 30-dniowy bezpłatny okres próbny
- Od $10/miesiąc
Visit WebsiteCustomer Rating:4.7/5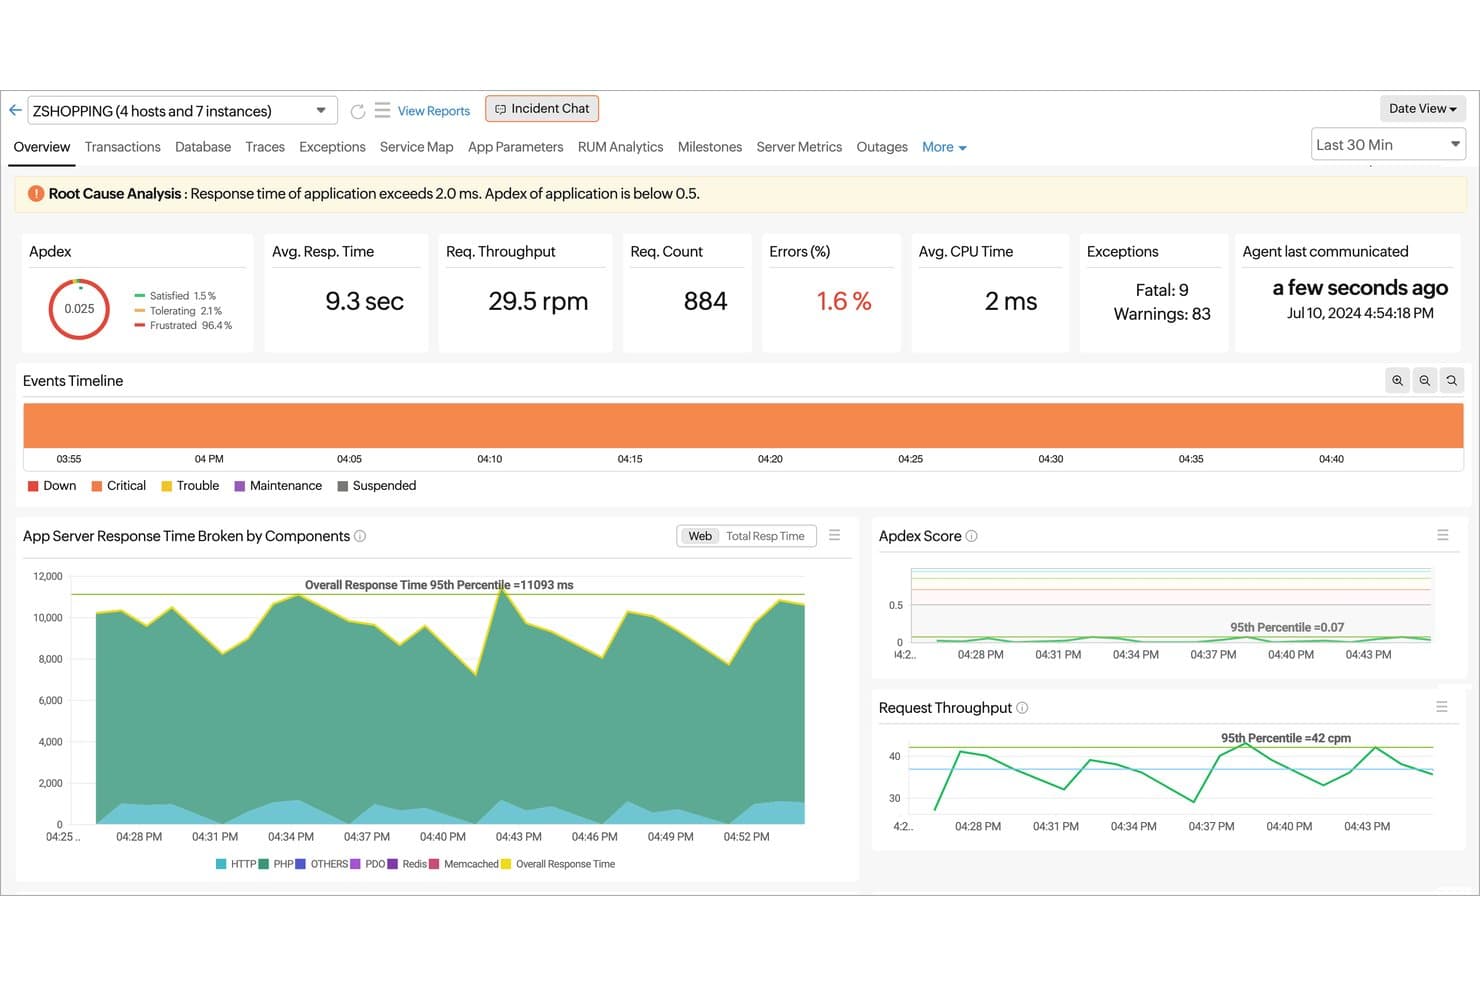
Site24x7 przedstawia analizę przyczyny źródłowej i wskaźniki APM w jednym widoku. Site24x7 to platforma obserwowalności i monitorowania IT dla zespołów oceniających alternatywy dla Dynatrace, pomagająca specjalistom IT śledzić wydajność aplikacji i infrastruktury, diagnozować problemy z usługami oraz monitorować środowiska hybrydowe.
Dla kogo Site24x7 jest najlepszym wyborem?
Site24x7 odpowiada potrzebom zespołów IT monitorujących aplikacje i infrastrukturę w różnorodnych, hybrydowych środowiskach.
Dlaczego wybrałem Site24x7
Wybrałem Site24x7 do zastosowania „Najlepsze rozwiązanie dla zróżnicowanych środowisk aplikacji”, ponieważ jego APM obsługuje języki Java, .NET, PHP, Ruby, Node.js i Python. Podoba mi się, że śledzenie rozproszone i diagnostyka na poziomie kodu pomagają mi śledzić powolne transakcje między usługami, a obsługa OpenTelemetry sprawdza się w zinstrumentowanych środowiskach.
Najważniejsze funkcje Site24x7
- Monitorowanie serwerów: Śledzi wskaźniki procesora, pamięci, dysku i sieci na serwerach fizycznych, wirtualnych i chmurowych.
- Monitorowanie sieci: Mierzy stan urządzeń, przepustowość, opóźnienia i ruch w routerach, przełącznikach oraz zaporach sieciowych.
- Zarządzanie dziennikami: Gromadzi i umożliwia wyszukiwanie dzienników z aplikacji, systemów i źródeł chmurowych.
- Monitorowanie witryn internetowych: Sprawdza dostępność witryn internetowych z ponad 130 lokalizacji na całym świecie.
Integracje Site24x7
Site24x7 obsługuje integracje z ServiceNow, PagerDuty, Jira, Slack, Microsoft Teams, Opsgenie, Amazon EventBridge i Zapier. Udostępnia również interfejsy REST API do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Monitoruje aplikacje w różnorodnych hybrydowych środowiskach
- Śledzi transakcje w obsługiwanych językach aplikacji
- Sprawdza dostępność witryn internetowych z ponad 130 lokalizacji
Cons:
- Dostrajanie alertów może generować fałszywe alarmy
- Pulpity nawigacyjne wydają się przeładowane i oferują ograniczone możliwości dostosowywania
Learn more about Site24x7: Najlepszy do kompleksowego monitorowania infrastruktury IT
- 30-dniowy bezpłatny okres próbny
- Od $2,595 jednorazowo
Visit WebsiteCustomer Rating:4.6/5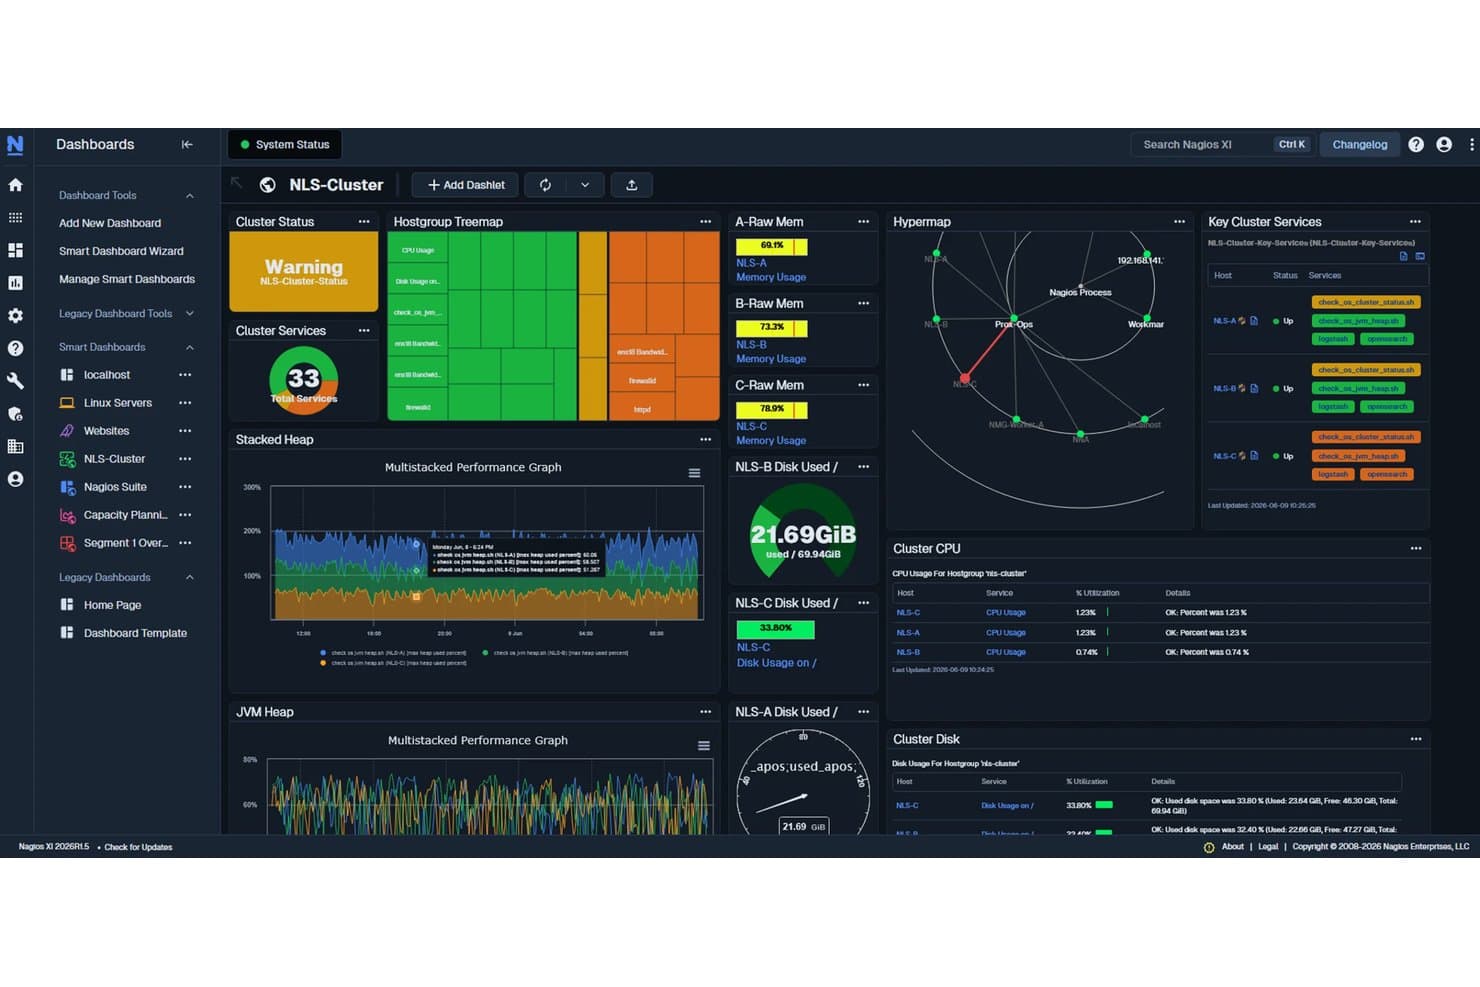
Nagios XI centralizuje monitorowanie stanu klastra, procesora, dysków i usług na jednym pulpicie. Nagios zapewnia zespołom IT konfigurowalne monitorowanie hostów i usług w celu wykrywania awarii serwerów, urządzeń sieciowych i aplikacji w zróżnicowanych środowiskach infrastruktury.
Dla kogo Nagios jest najlepszym wyborem?
Nagios jest odpowiedni dla zespołów zajmujących się infrastrukturą i operacjami, które potrzebują konfigurowalnego monitorowania w mieszanych środowiskach, w tym istniejących systemów i urządzeń sieciowych.
Dlaczego wybrałem Nagios
Wybrałem Nagios do przewodnika po alternatywach dla Dynatrace, ponieważ pasuje do kategorii „Najlepszy do kompleksowego monitorowania infrastruktury IT” dzięki opartym na wtyczkach kontrolom hostów i usług. Używam kontroli SNMP do monitorowania przełączników i routerów wraz ze stanem serwerów, a następnie konfiguruję alerty na wypadek niepowodzenia kontroli. Dzięki temu mogę śledzić mieszaną infrastrukturę w jednym systemie monitorowania.
Najważniejsze funkcje Nagios
- Automatyczne wykrywanie: Wykrywa urządzenia i usługi w sieci.
- Kreatory konfiguracji: Pomagają skonfigurować typowe urządzenia i aplikacje.
- Pulpity: Wyświetlają podsumowania stanu, mapy i wykresy w konfigurowalnych widokach.
- Wykresy wydajności: Przedstawiają dane monitorowania w czasie.
Integracje Nagios
Nagios XI ma udokumentowane integracje ze Slackiem i PagerDuty do powiadamiania o alertach i obsługi incydentów, konfigurowane za pomocą skryptów i ustawień powiadomień. Jego interfejs REST API obsługuje niestandardowe połączenia z narzędziami takimi jak CMDB i systemy obsługi zgłoszeń.
Pros and Cons
Pros:
- Monitoruje różne hosty za pomocą niestandardowych kontroli
- Niezawodne alerty z konfigurowalnymi progami
- Pulpity pokazują stan i trendy historyczne
Cons:
- Początkowa konfiguracja wymaga znajomości monitorowania systemu Linux
- Zewnętrzne wtyczki mogą być nieaktualne lub nieudokumentowane
Learn more about Nagios: Najlepszy do ujednoliconego monitorowania usług w chmurze
- Nie
- Od $15/miesiąc (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.5/5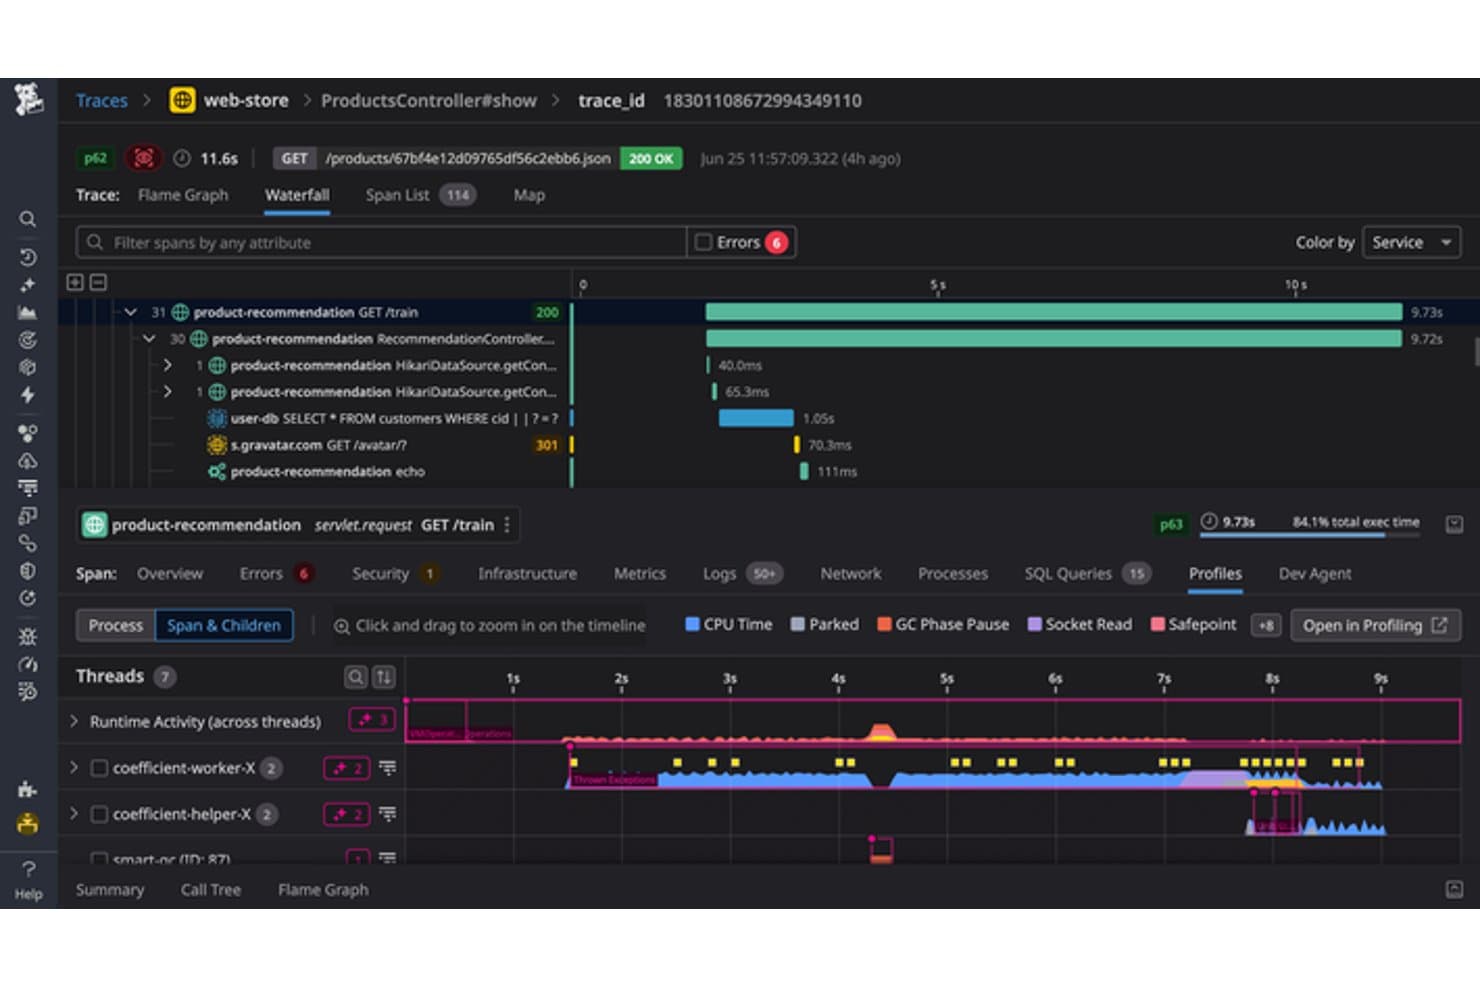
APM Datadog szczegółowo śledzi procesor, wątki i osie czasu segmentów. Datadog to platforma obserwowalności dla zespołów IT i DevOps, która łączy dane dotyczące aplikacji, infrastruktury, dzienników i bezpieczeństwa, aby pomóc diagnozować problemy z wydajnością w środowiskach natywnych dla chmury.
Dla kogo Datadog jest najlepszym wyborem?
Zespoły operacji chmurowych i SRE mogą używać Datadog do śledzenia stanu usług w rozproszonej infrastrukturze oraz wskazywania problemów wpływających na obciążenia produkcyjne.
Dlaczego wybrałem Datadog
Wybrałem Datadog do przewodnika po najlepszych alternatywach dla Dynatrace, ponieważ zasługuje na miano „Najlepszy do ujednoliconego monitorowania usług w chmurze”. Podoba mi się, że jego metryki infrastruktury, śledzenie rozproszone i dzienniki pozwalają prześledzić powolne żądanie od hosta w chmurze przez zależne usługi oraz sprawdzić powiązane błędy. Mapa usług pomaga znaleźć zależność nadrzędną wpływającą na stan środowiska produkcyjnego.
Najważniejsze funkcje Datadog
- Monitorowanie rzeczywistych użytkowników: Rejestruje sesje w przeglądarce, błędy interfejsu użytkownika i wydajność stron.
- Monitorowanie syntetyczne: Uruchamia zaplanowane testy przeglądarki i API dla aplikacji.
- Monitorowanie baz danych: Pokazuje metryki na poziomie zapytań i plany ich wykonania dla obsługiwanych baz danych.
- Monitory i alerty: Oceniają dane telemetryczne względem progów i wysyłają powiadomienia po wystąpieniu określonych warunków.
Integracje Datadog
Datadog oferuje ponad 1000 wbudowanych integracji, w tym AWS, Azure, Google Cloud, Kubernetes, Docker, PostgreSQL, GitHub, Jira, Slack i PagerDuty. Obsługuje również niestandardowe integracje za pośrednictwem swojego API.
Pros and Cons
Pros:
- Koreluje metryki, dzienniki i ślady podczas incydentów
- Mapuje zależności, aby wskazać awarie nadrzędnych usług
- Ujednolica widoki stanu infrastruktury i aplikacji
Cons:
- Rosnąca ilość danych telemetrycznych utrudnia prognozowanie rachunków
- Zaawansowane pulpity i zapytania wymagają czasu na konfigurację
 Najlepszy do monitorowania opartego na otwartym oprogramowaniu na poziomie przedsiębiorstwa
- Nie
- Bezpłatny
Visit WebsiteCustomer Rating:4.4/5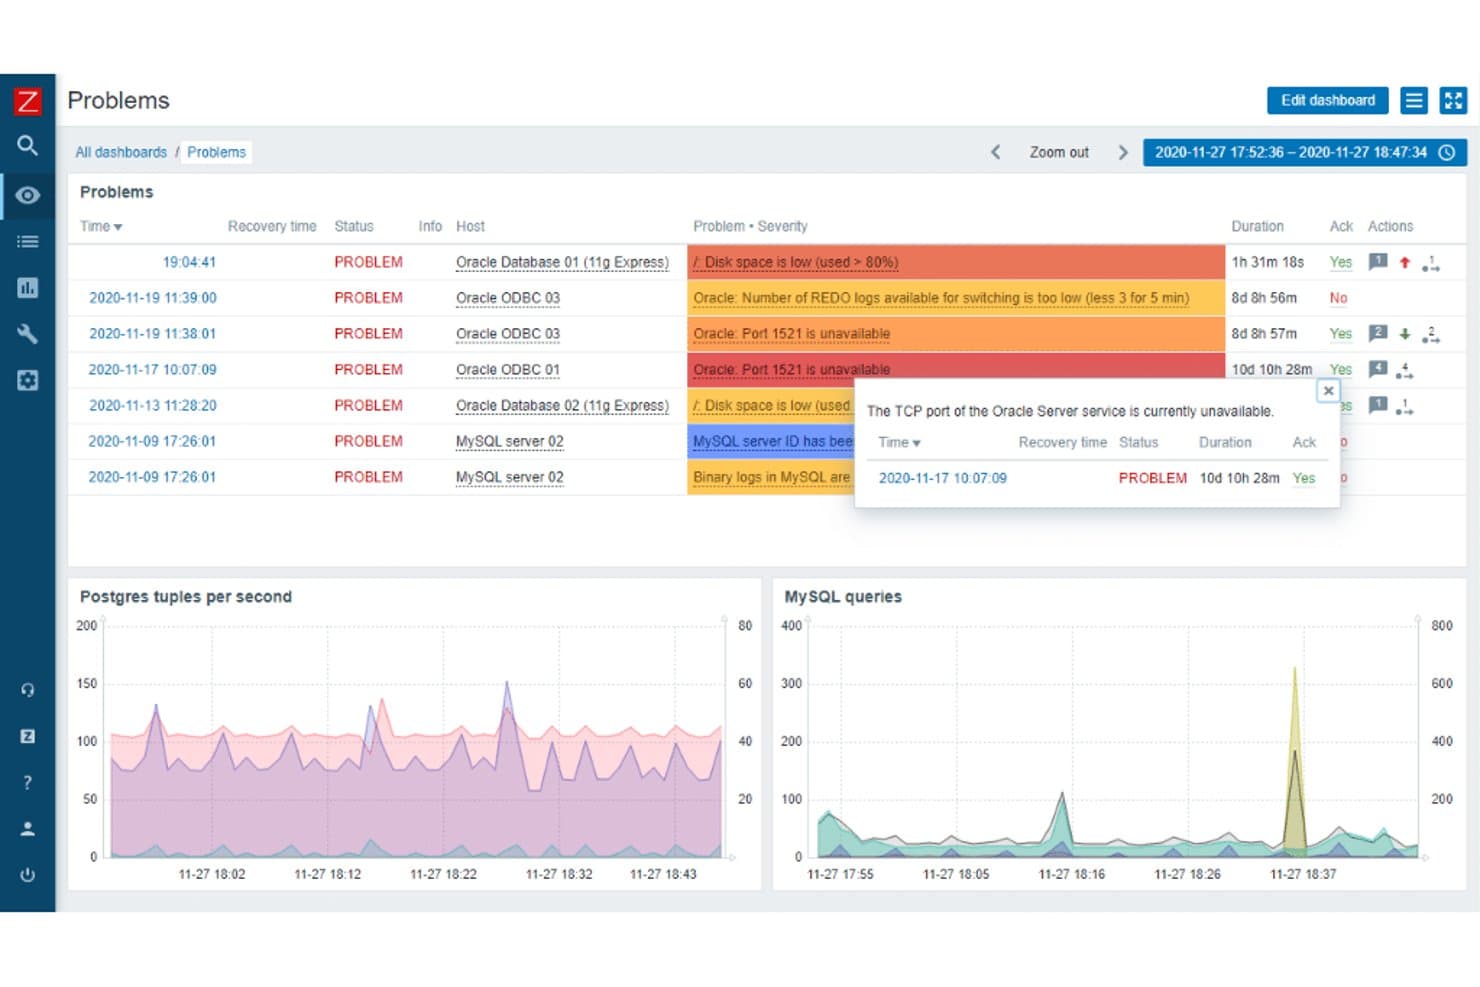
Zabbix pokazuje aktywne problemy baz danych i serwerów wraz ze szczegółami dotyczącymi ich ważności. Zabbix to platforma monitorowania infrastruktury dla zespołów IT, które muszą śledzić serwery, sieci i aplikacje, wykrywać problemy z usługami oraz zarządzać widocznością w złożonych środowiskach.
Dla kogo najlepiej nadaje się Zabbix?
Zabbix jest odpowiedni dla zespołów operacyjnych IT w przedsiębiorstwach, które potrzebują konfigurowalnego monitorowania opartego na otwartym oprogramowaniu w dużych, rozproszonych środowiskach.
Dlaczego wybrałem Zabbix
Wybrałem Zabbix do tego przewodnika po najlepszych alternatywach dla Dynatrace, ponieważ najlepiej nadaje się do monitorowania opartego na otwartym oprogramowaniu na poziomie przedsiębiorstwa. Podoba mi się, że rozproszone serwery proxy zbierają dane z lokalizacji zdalnych, a wielokrotnego użytku szablony stosują kontrole i wyzwalacze na serwerach oraz urządzeniach sieciowych. Dzięki temu zespoły operacyjne mogą monitorować duże, zróżnicowane środowisko bez polegania na zastrzeżonej platformie.
Najważniejsze funkcje Zabbix
- Korelacja zdarzeń: Definiuj reguły grupowania powiązanych problemów i tłumienia zdarzeń będących objawami.
- Monitorowanie aplikacji internetowych: Śledź wieloetapowe scenariusze internetowe i czasy odpowiedzi.
- Mapy sieci: Twórz mapy przedstawiające monitorowane hosty, połączenia i bieżące problemy.
- Wykrywanie zasobów niskiego poziomu: Automatycznie wykrywaj elementy, takie jak interfejsy sieciowe, i twórz elementy monitorujące je.
Integracje Zabbix
Oficjalny katalog integracji Zabbix obejmuje 1 986 rozwiązań od 559 marek, w tym AWS, Azure, Kubernetes, ServiceNow, Slack, Jira i PagerDuty. Udostępnia również oparty na HTTP interfejs API JSON-RPC oraz konfigurowalne webhooki JavaScript na potrzeby niestandardowych integracji.
Pros and Cons
Pros:
- Skaluje się w rozproszonych lokalizacjach dzięki serwerom proxy
- Wielokrotnego użytku szablony ujednolicają kontrole w całej infrastrukturze
- Koreluje powiązane alerty, aby ograniczyć szum
Cons:
- Początkowa konfiguracja wymaga znacznego nakładu pracy ręcznej
- Duże wdrożenia wymagają dostrajania bazy danych i serwerów proxy
 Najlepsze rozwiązanie zapewniające wgląd w wydajność biznesową w czasie rzeczywistym
- Nie
- Od $6/vCPU/miesiąc (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.3/5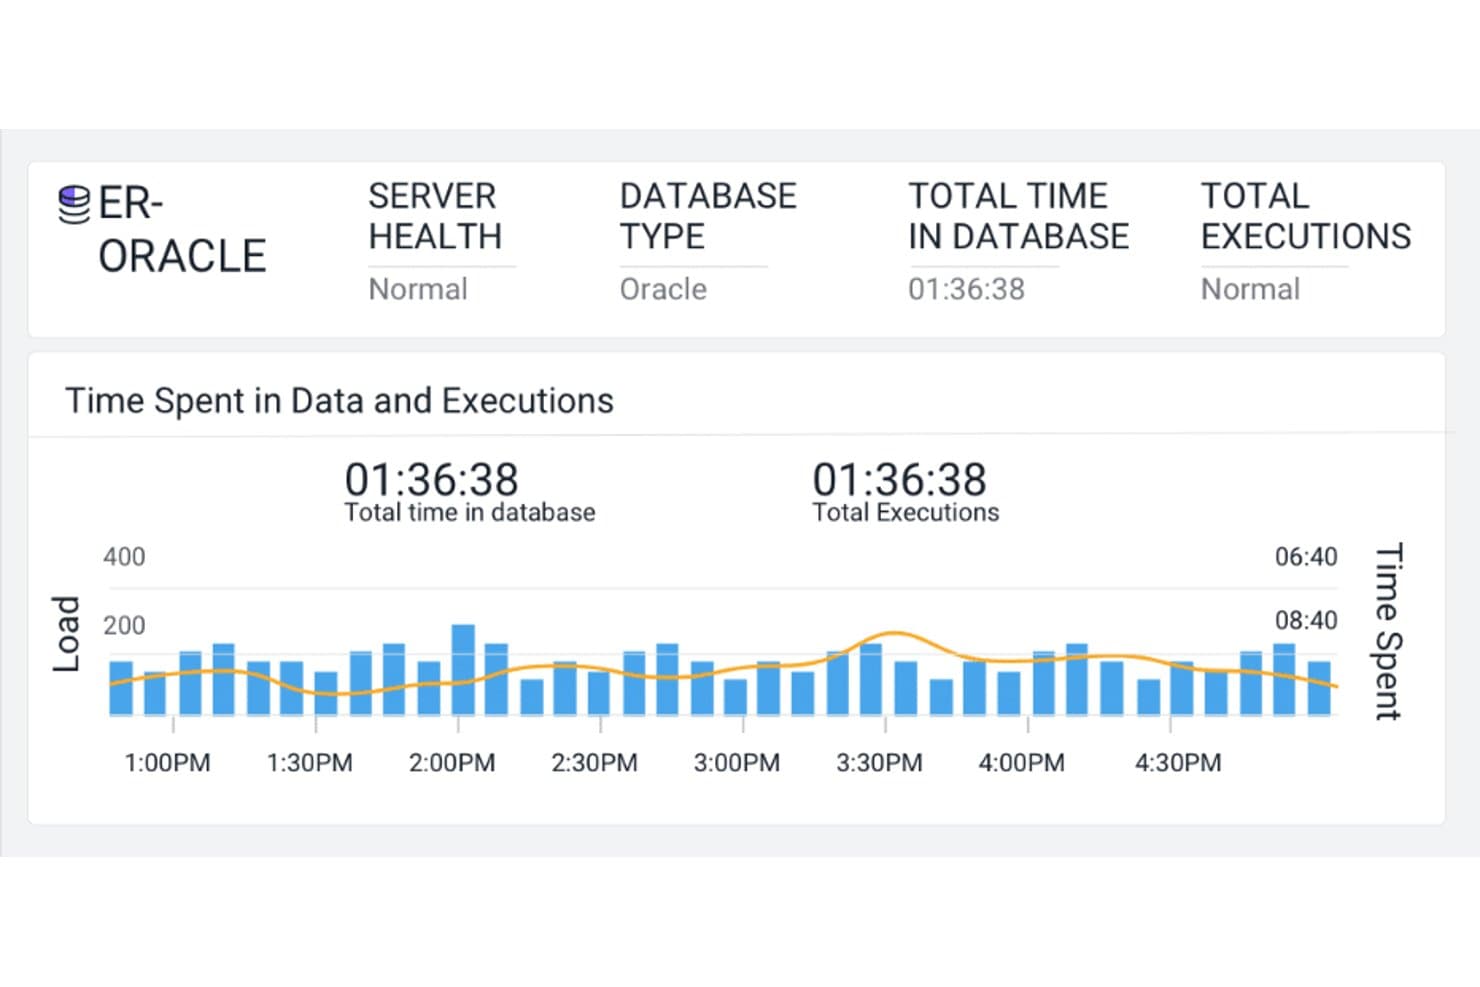
AppDynamics wizualnie monitoruje obciążenie bazy danych Oracle i czasy wykonywania. Dla zespołów IT i inżynieryjnych porównujących alternatywy dla Dynatrace, AppDynamics łączy monitorowanie wydajności aplikacji ze śledzeniem transakcji, aby pomóc zlokalizować spowolnienia i błędy w złożonych, rozproszonych usługach.
Dla kogo AppDynamics jest najlepszym wyborem?
AppDynamics jest odpowiedni dla zespołów operacji IT i zespołów aplikacyjnych, które muszą połączyć bieżący stan aplikacji z transakcjami biznesowymi, na których polegają klienci.
Dlaczego wybrałem AppDynamics
Wybrałem AppDynamics, ponieważ jego główny atut — „najlepsze rozwiązanie zapewniające wgląd w wydajność biznesową w czasie rzeczywistym” — łączy bieżący stan aplikacji z transakcjami, od których zależą klienci. Podoba mi się, że śledzenie transakcji pomaga zlokalizować spowolnienia w rozproszonych usługach, dzięki czemu mogę sprawdzić, gdzie żądanie ulega zatrzymaniu, i powiązać ten problem z aktywnością biznesową.
Najważniejsze funkcje AppDynamics
- Bezpieczeństwo aplikacji w czasie działania: Wykrywanie podatności w aplikacjach i blokowanie ataków.
- Monitorowanie rzeczywistych użytkowników: Rejestrowanie wydajności aplikacji internetowych i mobilnych na różnych urządzeniach i w różnych przeglądarkach.
- Monitorowanie syntetyczne: Monitorowanie wydajności aplikacji internetowych, mobilnych i interfejsów API za pomocą symulowanej aktywności.
- Wykrywanie anomalii: Ustalanie poziomów bazowych wydajności i oznaczanie odchyleń za pomocą sztucznej inteligencji i uczenia maszynowego.
Integracje AppDynamics
AppDynamics ma wbudowaną, dwukierunkową integrację z Jira, która umożliwia tworzenie i aktualizowanie zgłoszeń dotyczących incydentów, a także integrację z Splunk Observability Cloud dostępną we wczesnej wersji testowej. Oferuje również gotowe rozszerzenia i interfejsy API REST do integracji oraz automatyzacji.
Pros and Cons
Pros:
- Mapy transakcji biznesowych łączą dane telemetryczne z wpływem
- Wykresy wywołań wspierają analizę przyczyny źródłowej na poziomie kodu
- Alerty bazowe sygnalizują odchylenia od normy
Cons:
- Instrumentacja i konfiguracja agentów wymagają pracy manualnej
- Interfejs wydaje się przestarzały w porównaniu z nowszymi narzędziami do obserwowalności
Learn more about AppDynamics: Najlepsze rozwiązanie do odpytywania danych telemetrycznych w ujednoliconym magazynie danych
- Nie
- $12/użytkownika/miesiąc (rozliczane rocznie)
Visit WebsiteCustomer Rating:4.3/5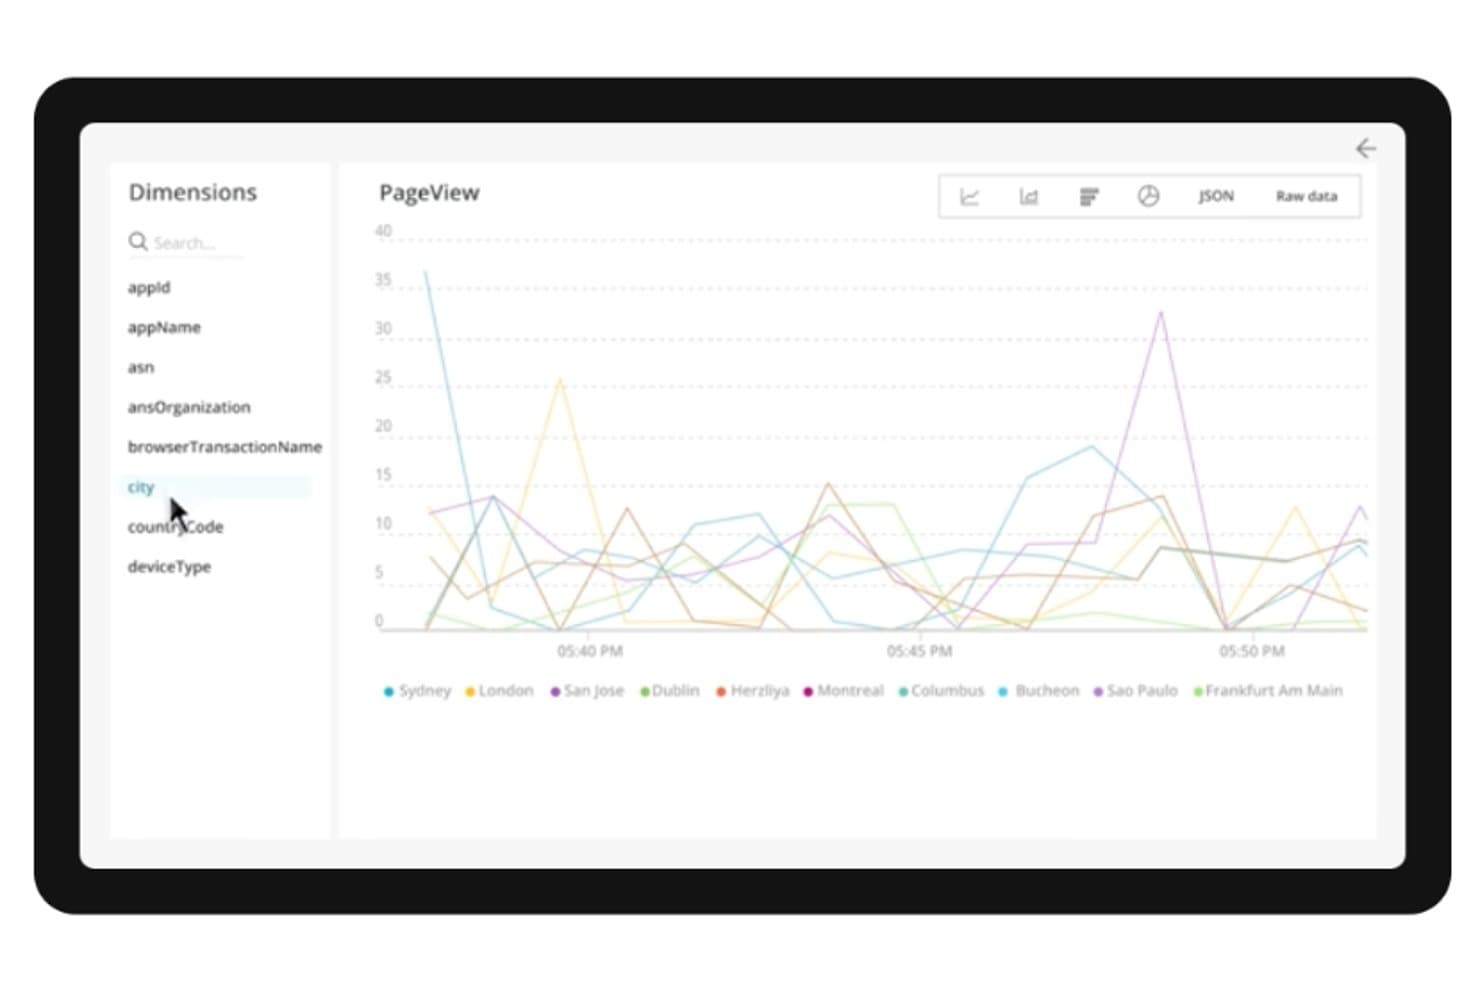
New Relic przedstawia dane PageView według miasta na osi czasu. Dla zespołów IT i inżynieryjnych oceniających alternatywy dla Dynatrace, New Relic to platforma APM, która pomaga śledzić problemy z aplikacjami, monitorować kondycję usług i analizować spowolnienia w systemach rozproszonych.
Dla kogo New Relic jest najlepszym wyborem?
New Relic sprawdzi się w zespołach DevOps i zespołach odpowiedzialnych za niezawodność witryn, które muszą łączyć ślady aplikacji, dane infrastruktury i dzienniki podczas diagnozowania problemów produkcyjnych.
Dlaczego wybrałem New Relic
Wybrałem New Relic ze względu na jego koncentrację na „najlepszym rozwiązaniu do kompleksowego monitorowania wydajności aplikacji”: łączy ślady rozproszone z kondycją usług i dziennikami, pomagając śledzić spowolnienia w różnych usługach. Gdy interfejs API zwalnia po wdrożeniu, mogę prześledzić ścieżkę jego żądania i sprawdzić powiązane sygnały usług, aby zlokalizować zależność powodującą problem.
Najważniejsze funkcje New Relic
- Monitorowanie baz danych: Sprawdzaj wolne zapytania do baz danych i szczegóły ich wykonywania.
- Diagnostyka na poziomie kodu: Profiluj kod aplikacji, aby identyfikować metody zużywające czas procesora.
- Śledzenie wdrożeń: Oznaczaj wydania, aby porównywać wydajność aplikacji przed zmianami i po ich wprowadzeniu.
- Warunki alertów: Ustawiaj progi dla danych aplikacji i otrzymuj powiadomienia po ich przekroczeniu.
Integracje New Relic
New Relic obsługuje integracje powiadomień o alertach z Atlassian Jira, AWS EventBridge, Microsoft Teams, PagerDuty, ServiceNow i Slack, a także ponad 400 integracji działających na hoście. Udostępnia również interfejsy API oraz narzędzie integracji Flex do wysyłania niestandardowych danych do New Relic.
Pros and Cons
Pros:
- Koreluje ślady, dzienniki i sygnały infrastruktury
- Śledzi regresje po wydaniach w ramach transakcji rozproszonych
- Łączy wydajność aplikacji z doświadczeniem użytkownika w przeglądarce
Cons:
- Rozbudowana nawigacja może spowalniać analizę incydentów
- Wzrost ilości pozyskiwanych danych może sprawić, że koszty będą nieprzewidywalne
Learn more about New Relic: Najlepszy do zarządzania logami i analityki bezpieczeństwa
- Nie
- $108 za użytkownika miesięcznie (rozliczenie roczne)
Visit WebsiteCustomer Rating:4.3/5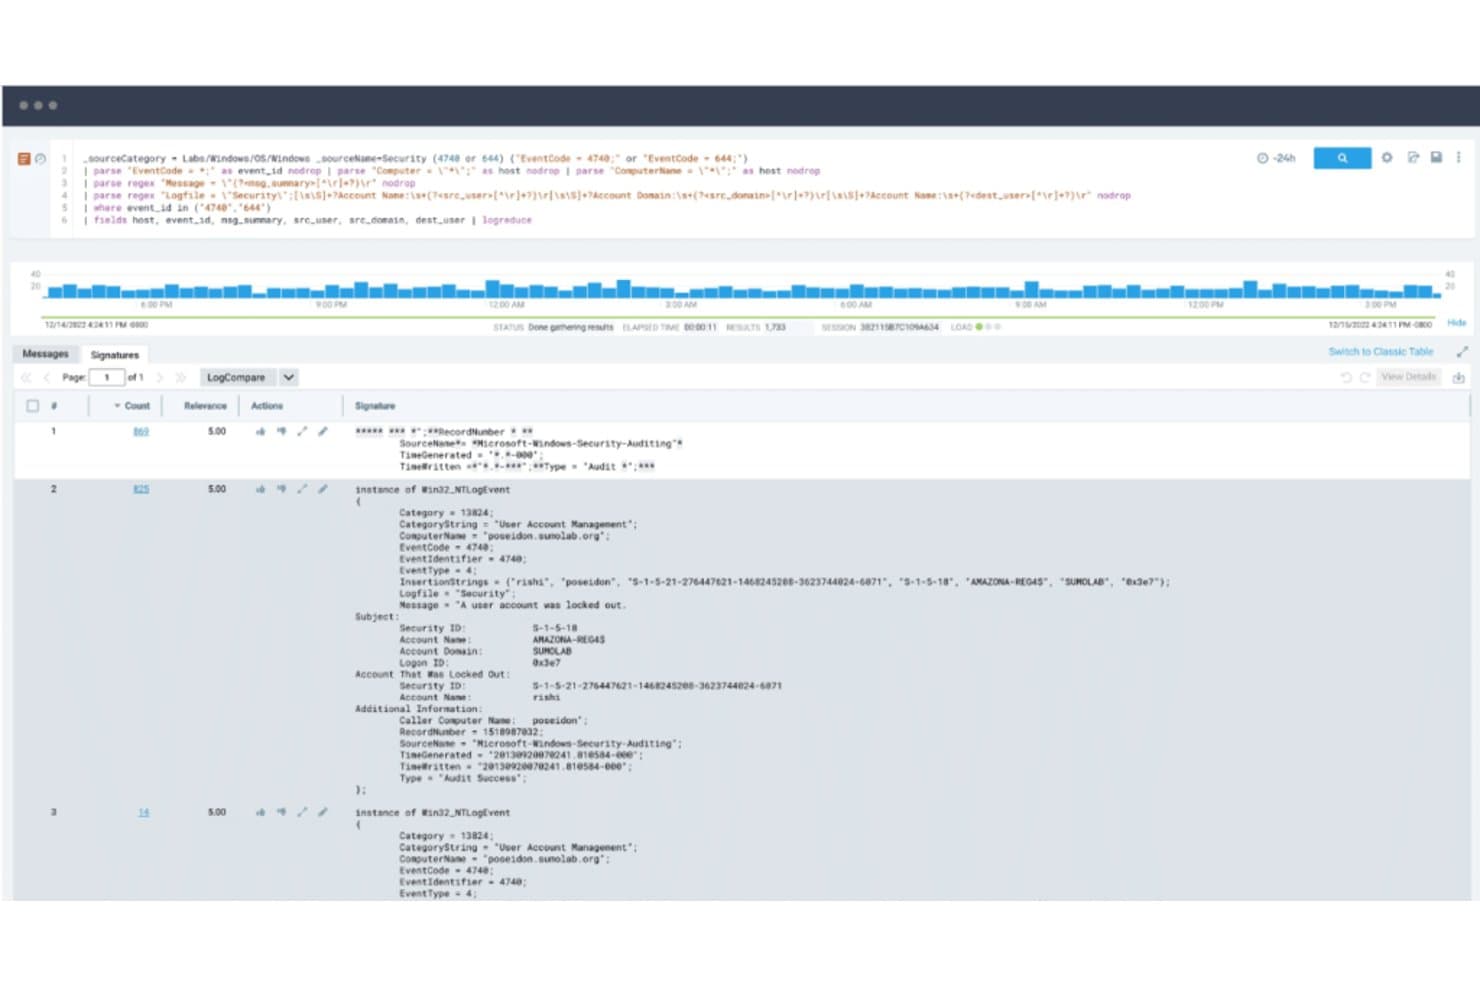
Sumo Logic wykrywa zdarzenia blokady konta za pomocą analizy logów bezpieczeństwa. Sumo Logic to oparta na chmurze platforma obserwowalności, która pomaga zespołom ds. infrastruktury i bezpieczeństwa analizować zakłócenia w działaniu usług oraz rozumieć aktywność w rozproszonych aplikacjach, co czyni ją opcją dla zespołów oceniających alternatywy dla Dynatrace.
Dla kogo Sumo Logic jest najlepszym wyborem?
Sumo Logic dobrze sprawdzi się w przypadku analityków bezpieczeństwa i zespołów ds. operacji IT, które potrzebują scentralizowanych danych dzienników do rozwiązywania problemów, wykrywania zagrożeń i prowadzenia dochodzeń.
Dlaczego wybrałem Sumo Logic
Wybrałem Sumo Logic do tego przewodnika po alternatywach dla Dynatrace, ponieważ pasuje do opisu „Najlepszy do zarządzania logami i analityki bezpieczeństwa”. Wyszukiwanie logów pomaga mi śledzić błędy w rozproszonych usługach, a SIEM w chmurze koreluje sygnały bezpieczeństwa, wspierając analizę podejrzanej aktywności.
Najważniejsze funkcje Sumo Logic
- Analityka metryk: Wysyłaj zapytania dotyczące metryk szeregów czasowych za pomocą języka zapytań metryk Sumo Logic.
- Rozproszone śledzenie: Analizuj fragmenty śladów, aby śledzić żądania w instrumentowanych usługach.
- Pulpity: Twórz wizualizacje na podstawie danych telemetrycznych i układaj je w niestandardowych układach.
- Monitory i alerty: Definiuj warunki dotyczące metryk lub zapytań, aby uruchamiać powiadomienia.
Integracje Sumo Logic
Katalog aplikacji Sumo Logic obejmuje setki dostawców i produktów, w tym AWS, Azure, Datadog, Dynatrace, GitHub i Jira, oferując między innymi źródła gromadzenia danych, gotowe aplikacje oraz integracje automatyzacji. Zapewnia natywne integracje webhooków z ServiceNow i Slackiem, a także interfejsy API REST do tworzenia niestandardowych integracji.
Pros and Cons
Pros:
- Szybkie wyszukiwanie logów wspiera analizę incydentów
- Scentralizowane logi umożliwiają alertowanie w czasie rzeczywistym
- SIEM w chmurze koreluje zagrożenia na potrzeby analizy
Cons:
- Opanowanie języka zapytań wymaga czasu
- Gromadzenie i analizowanie logów wymaga dopracowania
 10Najlepszy do analizy danych na dużą skalę i uzyskiwania wniosków
Splunk
- Nie
- $150/user/month
Visit WebsiteCustomer Rating:4.3/5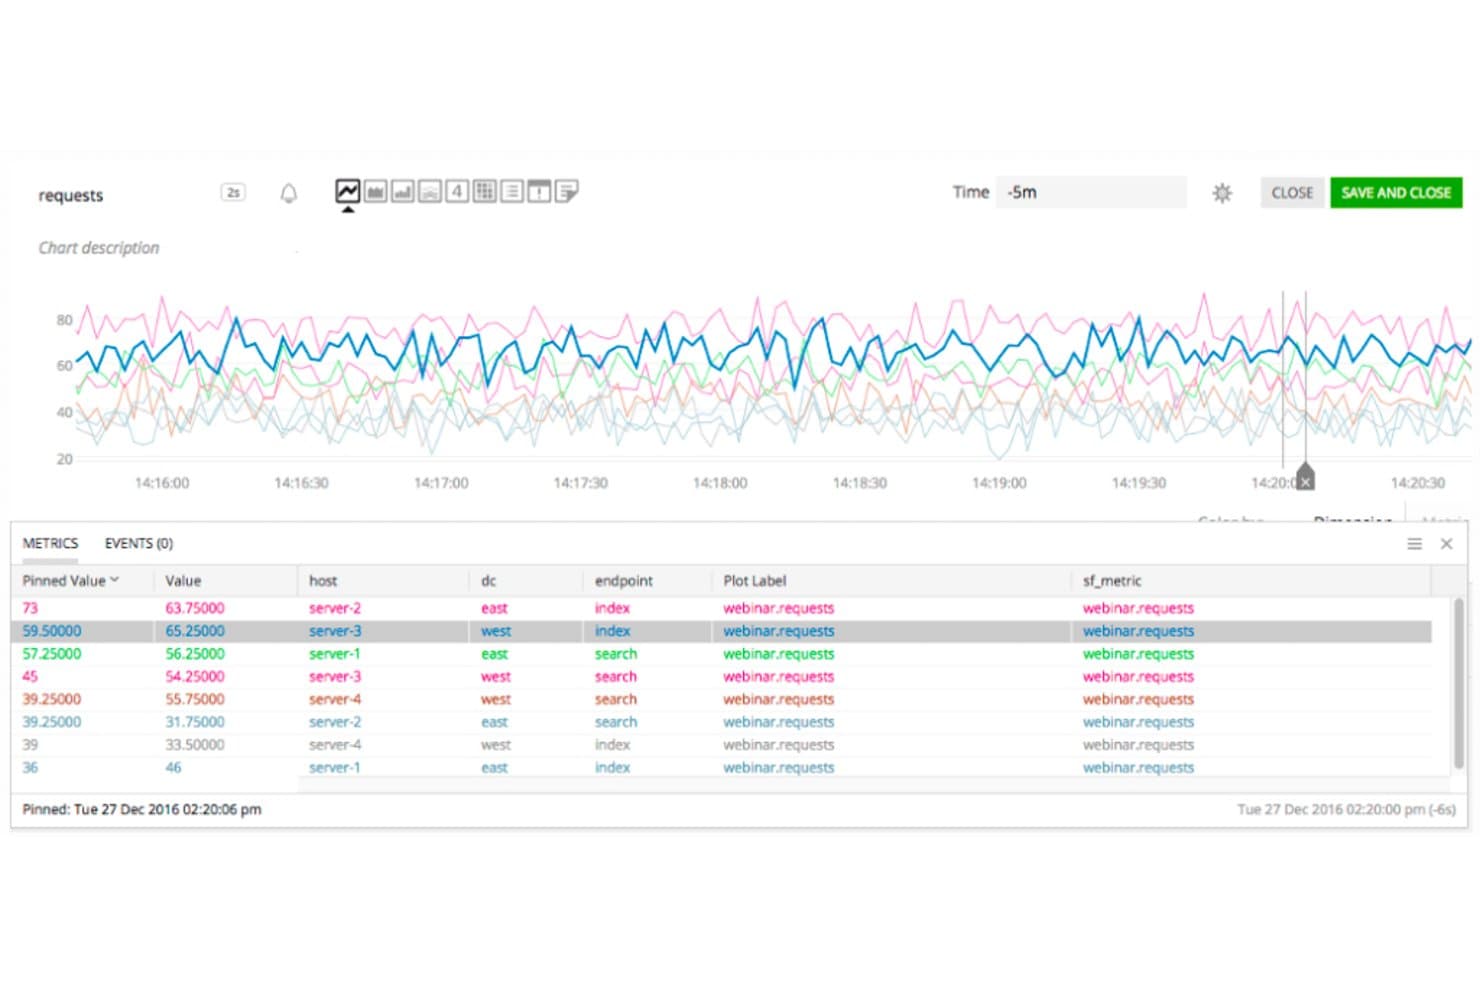
Splunk umożliwia użytkownikom monitorowanie metryk żądań w czasie rzeczywistym na serwerach i punktach końcowych. Splunk łączy monitorowanie infrastruktury z analizą dzienników, metryk i śladów, pomagając zespołom IT i operacyjnym badać incydenty w złożonych, rozproszonych środowiskach.
Dla kogo Splunk jest najlepszym wyborem?
Splunk jest odpowiedni dla dużych zespołów IT i bezpieczeństwa, które muszą analizować duże ilości danych maszynowych i wykrywać wzorce w złożonych środowiskach.
Dlaczego wybrałem Splunk
Wybrałem Splunk jako alternatywę dla Dynatrace ze względu na jego koncentrację na analizie danych na dużą skalę i uzyskiwaniu wniosków. Łączy monitorowanie infrastruktury z analizą dzienników, metryk i śladów, dzięki czemu mogę badać spowolnienie usługi w rozproszonych systemach i łączyć sygnały z powiązanymi zdarzeniami. Pomaga mi to przeszukiwać duże ilości danych maszynowych podczas badania incydentów.
Najważniejsze funkcje Splunk
- Niestandardowe pulpity nawigacyjne: Twórz wizualne panele z wykresami, tabelami i danymi usług.
- Detektory alertów: Ustawiaj warunki, które uruchamiają alerty, gdy monitorowane sygnały przekroczą wartości progowe.
- Monitorowanie Kubernetes: Badaj stan klastra, węzłów i obciążeń w Kubernetes Navigator.
- Monitorowanie syntetyczne: Uruchamiaj skrypty testowe, aby sprawdzać dostępność aplikacji i czasy odpowiedzi.
Integracje Splunk
Splunk Observability Cloud obsługuje integracje z AWS CloudWatch, Google Cloud Platform, Microsoft Azure, Jira, Microsoft Teams, PagerDuty, ServiceNow i Slack. Interfejs API integracji konfiguruje obsługiwane połączenia, a Splunkbase udostępnia aplikacje, dodatki i konektory.
Pros and Cons
Pros:
- Przeszukuje duże ilości danych maszynowych w poszukiwaniu wskazówek dotyczących incydentów
- Koreluje dzienniki, metryki i ślady na potrzeby analiz
- Niestandardowe pulpity nawigacyjne i alerty ułatwiają ukierunkowane ustalanie priorytetów podczas analizy incydentu
Cons:
- Koszty mogą rosnąć wraz ze zwiększaniem ilości gromadzonych danych telemetrycznych
- Złożone zapytania mogą spowalniać pulpity nawigacyjne przy dużej skali
Learn more about Splunk:
Inne alternatywy dla Dynatrace
Oto kilka dodatkowych alternatyw dla Dynatrace, które nie trafiły na moją listę, ale nadal warto się im przyjrzeć:
- 11PrometheusNajlepsze rozwiązanie do niezawodnego monitorowania w środowiskach Kubernetes
- 12Grafana CloudNajlepsze do wizualizacji i analityki o otwartym kodzie źródłowym
- 13ElasticNajlepszy do wyszukiwania i analizy danych w czasie rzeczywistym
- 14SolarWinds Observability SaaSNajlepsze rozwiązanie do ustalania priorytetów alertów opartego na AI
- 15SysdigNajlepsze do zabezpieczania kontenerów i Kubernetes
- 16Dotcom MonitorNajlepszy do symulacji w rzeczywistych przeglądarkach
Inne recenzje oprogramowania
- Narzędzia do przeglądu kodu dla programistów
- Narzędzia do tworzenia stron internetowych
- Narzędzia do automatyzacji infrastruktury
Jak oceniam alternatywy dla Dynatrace
Każde narzędzie oceniam na dwóch poziomach: najważniejszych funkcjach, takich jak APM pełnego stosu i śledzenie rozproszone, oraz elementach wyróżniających, które odróżniają platformy przeznaczone dla różnych zespołów i stosów technologicznych.
Podstawowe funkcje (wymagane na tej liście)
Wybierając narzędzia do mojej listy, oceniam każde z nich w skali od 0 (nie oferuje danej funkcji) do 5 (doskonale sprawdza się w tym obszarze) dla każdej z wymienionych poniżej podstawowych funkcji. Następnie przeliczam łączny wynik narzędzia na wartość procentową. Każde narzędzie musi uzyskać łączny wynik na poziomie co najmniej 75%, aby zostać uwzględnione na liście.
- APM pełnego stosu: Sprawdzam, czy narzędzie zapewnia śledzenie transakcji na poziomie kodu w głównych językach programowania i środowiskach, na przykład umożliwia wykrycie powolnego wywołania bazy danych ukrytego w mikrousłudze Java.
- Monitorowanie infrastruktury: Każde narzędzie powinno obejmować serwery, kontenery, klastry Kubernetes i usługi chmurowe dzięki automatycznemu wykrywaniu, bez konieczności ręcznej konfiguracji każdego hosta z osobna.
- Śledzenie rozproszone: Oceniam, jak ślady przepływają między granicami usług oraz czy platforma obsługuje pozyskiwanie danych OpenTelemetry, co ma znaczenie, gdy zespoły korzystają ze stosów wielojęzycznych.
- Zarządzanie logami i analityka: Logi powinny być skorelowane ze śladami i metrykami w jednym widoku, aby inżynier SRE mógł przejść od nagłego wzrostu współczynnika błędów do konkretnych wierszy logów, które za nim stoją.
- Wykrywanie anomalii oparte na sztucznej inteligencji: Szukam uczenia maszynowego, które ustala wartości bazowe dla normalnego zachowania i przedstawia sugestie dotyczące przyczyny źródłowej, a nie tylko statycznych alertów progowych zalewających kanały dyżurów.
- Monitorowanie rzeczywistych użytkowników i syntetyczne: Platforma powinna oferować zarówno RUM do analizy rzeczywistego ruchu, jak i testy syntetyczne wykrywające niedziałające procesy realizacji zakupu lub awarie interfejsów API, zanim zrobią to prawdziwi użytkownicy.
Po utworzeniu listy narzędzi spełniających te kryteria analizuję, co wyróżnia każdą platformę.
Czynniki wyróżniające (co odróżnia dostawców)
Oto jak porównuję różnych dostawców:
Najważniejsze funkcje
Przejrzystość cen ma znaczenie podczas przechodzenia z Dynatrace, dlatego oceniam, czy platforma oferuje przewidywalne ceny zależne od wykorzystania wraz z jasnymi mechanizmami kontroli kosztów. Natywna obsługa OpenTelemetry to kolejny kluczowy wyróżnik — zespoły, które już korzystają z kolektorów OTel, nie powinny musieć usuwać całej istniejącej konfiguracji na rzecz zastrzeżonych agentów. Szukam również zautomatyzowanych procedur naprawczych, które uruchamiają procedury operacyjne lub eskalują zdarzenia za pośrednictwem narzędzi takich jak PagerDuty, gdy wystąpi anomalia, zamieniając alerty w działania bez ręcznej interwencji.
Nie tylko funkcje
Elastyczność wdrażania jest bardzo istotna — sprawdzam, czy platforma obsługuje modele SaaS, samodzielnego hostingu i hybrydowe, ponieważ zespoły z branż regulowanych często potrzebują wdrożeń lokalnych lub określonych opcji lokalizacji danych. Ekosystem integracji również wpływa na to, jak dobrze narzędzie pasuje do istniejącego stosu. Natywne konektory do potoków CI/CD, platform ITSM takich jak ServiceNow oraz narzędzi do obsługi incydentów, takich jak Opsgenie, mają duże znaczenie podczas wdrażania. Oceniam także certyfikaty zgodności, takie jak SOC 2 Type II i ISO 27001, a także SSO oraz mechanizmy kontroli dostępu oparte na rolach.
Dlaczego warto poszukać alternatywy dla Dynatrace?
Choć Dynatrace jest dobrym wyborem jako platforma do monitorowania wydajności aplikacji (APM), istnieje wiele powodów, dla których niektórzy użytkownicy szukają alternatywnych rozwiązań. Możesz szukać alternatywy dla Dynatrace, ponieważ…
- Ceny mogą okazać się zbyt wysokie dla mniejszych zespołów
- Krzywa uczenia się może być zbyt stroma dla nowych użytkowników
- Potrzebujesz prostszych pulpitów nawigacyjnych i raportów
- Potrzebujesz bardziej elastycznych opcji alertów i powiadomień
- Korzystasz ze środowiska hybrydowego i potrzebujesz szerszego zakresu integracji
- Wolisz narzędzia z bardziej przejrzystym rozliczaniem
Jeśli któryś z tych punktów opisuje Twoją sytuację, jesteś we właściwym miejscu. Moja lista zawiera kilka platform do monitorowania wydajności aplikacji (APM), które lepiej odpowiadają potrzebom zespołów mierzących się z tymi wyzwaniami związanymi z Dynatrace i szukających alternatywnych rozwiązań.
Najważniejsze funkcje Dynatrace
Oto niektóre z kluczowych funkcji Dynatrace, które pomogą Ci zestawić i porównać oferty alternatywnych rozwiązań:
- Monitorowanie całego stosu: Umożliwia śledzenie wydajności aplikacji, infrastruktury i doświadczeń użytkowników w jednym miejscu.
- Silnik Davis AI: Automatycznie wykrywa problemy i wyjaśnia ich przyczyny, oszczędzając czas Twojego zespołu.
- Monitorowanie rzeczywistych użytkowników: Pokazuje, jak rzeczywiści użytkownicy korzystają z Twojej aplikacji, dzięki czemu możesz naprawiać istotne problemy.
- Bezpieczeństwo aplikacji: Wykrywa luki w zabezpieczeniach w czasie rzeczywistym, gdy Twój kod działa na produkcji.
- Obsługa chmury natywnej: Dobrze współpracuje z Kubernetes, AWS, Azure i innymi środowiskami chmurowymi.
- Inteligentne alertowanie: Wysyła alerty tylko wtedy, gdy jest to konieczne, dzięki czemu Twój zespół unika zmęczenia alertami.
- Niestandardowe pulpity: Umożliwia tworzenie widoków dostosowanych do potrzeb i wskaźników Twojego zespołu.
- Analiza na poziomie kodu: Pomaga analizować wydajność aż do poziomu poszczególnych wierszy kodu.
- Zarządzanie logami: Umożliwia wyszukiwanie, filtrowanie i analizowanie logów w celu szybszego rozwiązywania problemów.
- Monitorowanie syntetyczne: Symuluje działania użytkowników, dzięki czemu możesz testować wydajność aplikacji z różnych lokalizacji.
Podsumowanie
W tym przewodniku dla kupujących szczegółowo omówiliśmy alternatywy dla Dynatrace, analizując różne opcje dostosowane do konkretnych zastosowań. Niezależnie od tego, czy szukasz narzędzia do monitorowania rozwiązań otwartoźródłowych na poziomie przedsiębiorstwa, zarządzania logami i analizy bezpieczeństwa, czy też zabezpieczania kontenerów i Kubernetes, masz do rozważenia wiele solidnych opcji.
Oto trzy najważniejsze wnioski z tego przewodnika:
- Oceń swoje potrzeby: Różne narzędzia są projektowane z myślą o różnych zastosowaniach. Niektóre dobrze sprawdzają się przy rozbudowanym zarządzaniu logami, inne w środowiskach otwartoźródłowych, a jeszcze inne w zabezpieczaniu kontenerów i Kubernetes. Zrozumienie wyjątkowych potrzeb Twojej organizacji pomoże Ci wybrać odpowiednie narzędzie.
- Przyjrzyj się funkcjom: Narzędzia mogą mieć podobne podstawowe funkcje, ale diabeł tkwi w szczegółach. Unikalne funkcje każdego narzędzia, jego użyteczność oraz integracje z innymi używanymi przez Ciebie narzędziami mogą mieć decydujące znaczenie dla jakości monitorowania.
- Weź pod uwagę ceny: Chociaż koszt jest często istotnym czynnikiem, ważne jest, aby rozważyć, co otrzymujesz w zamian za swoje pieniądze. Droższe narzędzie może oferować rozbudowane funkcje lub wsparcie, których potrzebujesz, a w niektórych przypadkach tańsze, a nawet bezpłatne narzędzie może spełnić Twoje potrzeby.
Pamiętaj, że „najlepsze” narzędzie zależy wyłącznie od konkretnych wymagań i okoliczności Twojej organizacji. Dzięki informacjom zawartym w tym przewodniku jesteś na dobrej drodze do podjęcia świadomej decyzji.