

10 meilleurs outils de suivi des expériences ML en 2026
Sélection des meilleurs outils de suivi des expériences de ML


Les outils de suivi des expériences de ML vous aident à consigner, organiser et comparer les expériences d’apprentissage automatique afin de gérer les résultats et de reproduire les découvertes en toute confiance. Si vous cherchez des moyens pratiques de suivre les expériences, de partager les progrès avec votre équipe ou de garder vos modèles et jeux de données organisés, le bon outil peut faire une grande différence.
Dans cette liste, vous trouverez des solutions adaptées à différentes piles techniques et méthodes de travail, qui vous aideront à réduire les difficultés, à simplifier les rapports et à vous concentrer sur une gestion fiable des expériences d’apprentissage automatique.
Pourquoi faire confiance à nos avis logiciels
Nous testons et analysons des logiciels depuis 2023. En tant que dirigeants technologiques, nous savons à quel point il est crucial et difficile de faire le bon choix lors de la sélection d’un logiciel.
Nous investissons dans des recherches approfondies pour aider notre audience à prendre de meilleures décisions d’achat de logiciels. Nous avons testé plus de 2 000 outils pour différents usages technologiques et rédigé plus de 1 000 avis complets. Découvrez comment nous restons transparents & notre méthodologie d’évaluation des logiciels.
Résumé des meilleurs outils de suivi des expériences de ML
Ce tableau comparatif récapitule les informations tarifaires concernant ma sélection des meilleurs outils de suivi des expériences de ML afin de vous aider à trouver celui qui convient le mieux à votre budget et aux besoins de votre entreprise.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Idéal pour la comparaison d’expériences en temps réel | Offre gratuite disponible | À partir de $19/utilisateur/mois | Website | |
| 2 | Idéal pour des tableaux de bord de visualisation personnalisables | Forfait gratuit disponible | À partir de $60/mois | Website | |
| 3 | Idéal pour le versionnage automatique des pipelines | Essai gratuit de 14 jours disponible | Tarification sur demande | Website | |
| 4 | Idéal pour l'orchestration automatique des pipelines | Offre gratuite disponible | À partir de $15/utilisateur/mois | Website | |
| 5 | Idéal pour la prise en charge open source du cycle de vie des modèles | Démo gratuite + offre gratuite à vie disponible | Gratuit à vie (open source) | Website | |
| 6 | Idéal pour l’intégration avec les frameworks d’apprentissage profond | Formule gratuite disponible à vie | Gratuit à vie (à code source ouvert) | Website | |
| 7 | Idéal pour la gestion de flux de travail natifs de Kubernetes | Forfait gratuit disponible | Gratuit et à code source ouvert | Website | |
| 8 | Idéal pour l'intégration avec l'écosystème cloud AWS | Offre gratuite disponible | À partir de $0.204/heure | Website | |
| 9 | Idéal pour une architecture à plugins extensible | Offre gratuite disponible | À partir de $399/mois | Website | |
| 10 | Idéal pour les options de déploiement hybrides et sur site | Formule gratuite + démo gratuite disponible | À partir de 450 $/mois (facturé annuellement) | Website |
Avis sur les meilleurs outils de suivi des expériences de ML
Vous trouverez ci-dessous mes résumés détaillés des meilleurs outils de suivi des expériences de ML qui ont été retenus dans ma sélection. Mes avis examinent en détail les fonctionnalités, les intégrations et les meilleurs cas d’utilisation de chaque plateforme afin de vous aider à trouver celle qui vous convient le mieux.

Comet
Idéal pour la comparaison d’expériences en temps réel
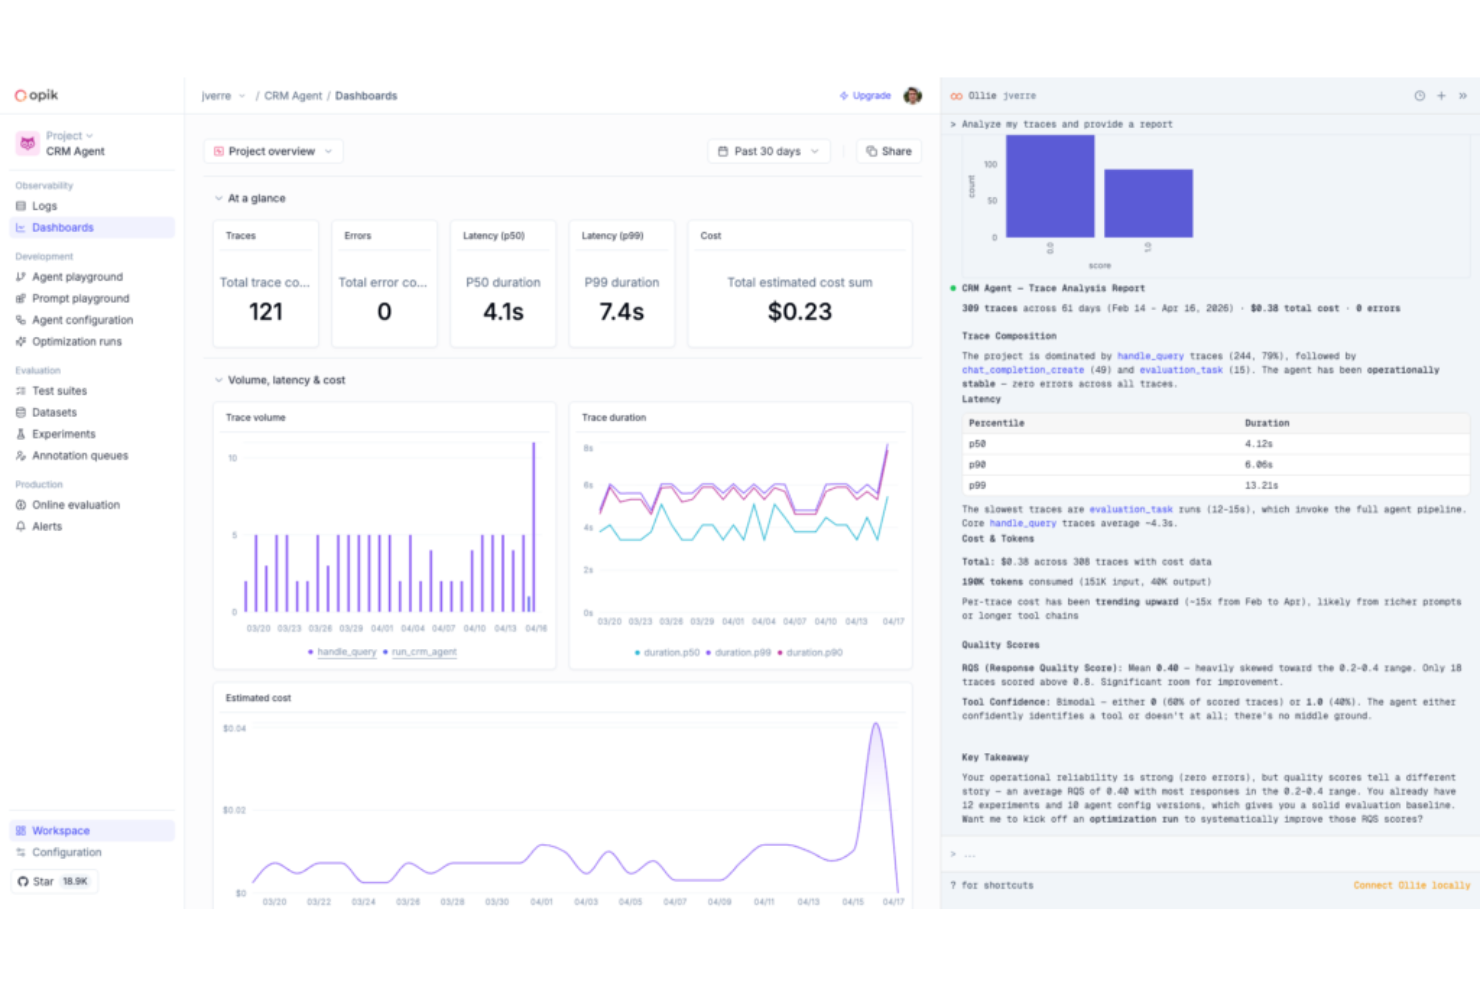
Comet est une plateforme de suivi d’expériences ML et d’évaluation de modèles qui consigne les métriques, hyperparamètres et artefacts issus des entraînements, et s’étend à l’observabilité des LLM et à l’évaluation de l’IA agentique via son produit Opik.
À qui s’adresse Comet ?
Comet convient particulièrement aux équipes ML et IA de sociétés en croissance ou d’entreprises qui réalisent un grand nombre d’expériences et nécessitent une visibilité en temps réel sur les runs d’entraînement.
Pourquoi j’ai choisi Comet
J’ai sélectionné Comet comme l’un des meilleurs outils car son tableau de bord de suivi d’expériences actualise les métriques en direct pendant l’entraînement, permettant à mon équipe de repérer une courbe de perte qui diverge et de stopper un run défaillant avant de gaspiller du calcul. J’utilise également sa vue de comparaison d’expériences côte à côte pour filtrer des dizaines de runs selon la valeur des hyperparamètres et isoler immédiatement la configuration ayant donné la meilleure précision de validation. En plus des fonctionnalités MLOps classiques, Comet propose désormais l’évaluation de LLM grâce à Opik, ce qui fait que je n’ai pas à changer d’outil lors du passage de l’entraînement à la surveillance en production.
Fonctionnalités clés de Comet
- Registre de modèles : Stockez, versionnez et gérez les modèles entraînés dans un registre centralisé avec des étiquettes de stade comme staging ou production.
- Journalisation des artefacts : Consignez et versionnez les jeux de données, images, matrices de confusion et fichiers audio, directement au côté des expériences.
- Panneaux personnalisés : Réalisez des visualisations personnalisées dans l’interface Comet avec JavaScript pour aller au-delà des graphiques par défaut.
- Suivi des métriques systèmes : Capture automatiquement l’utilisation du GPU, la charge CPU et la mémoire à chaque run sans instrumentation supplémentaire.
Intégrations de Comet
Comet offre plus de 30 intégrations natives, dont PyTorch, TensorFlow, Keras, Scikit-learn, XGBoost, Hugging Face Transformers, Ray, Kubeflow, Snowflake et Vertex AI. Il est disponible sur Zapier et propose une API REST ainsi que des SDK Python, Java, JavaScript et R pour des intégrations sur mesure.
Pros and Cons
Pros:
- Journalisation automatique des métriques avec peu de code
- Visualisation en temps réel des runs d’entraînement
- Suit à la fois les expériences ML et les LLM
Cons:
- L’offre Pro limite les équipes à 10 utilisateurs
- Options de personnalisation de l’UI limitées

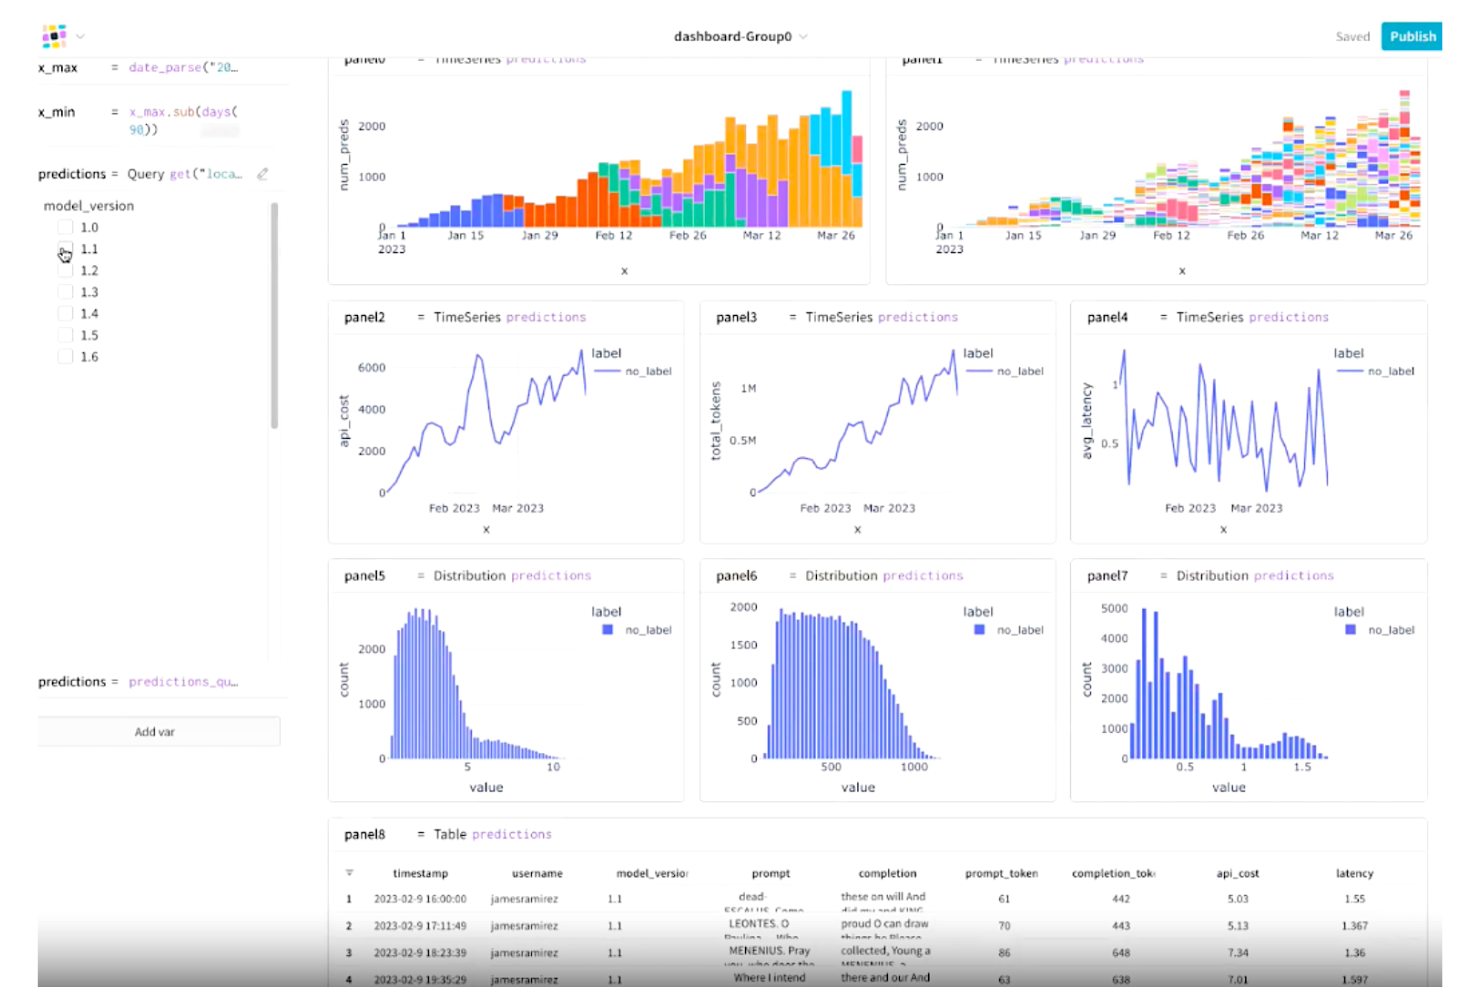
Weights & Biases est une plateforme de suivi d'expériences en apprentissage automatique qui enregistre les métriques, les hyperparamètres et les checkpoints de modèles, tout en permettant de visualiser et de comparer les essais à l'aide de tableaux de bord interactifs.
À qui s'adresse Weights & Biases ?
Weights & Biases convient particulièrement aux data scientists et ingénieurs ML qui réalisent fréquemment des expériences et ont besoin de comparer en détail les résultats au sein de grandes équipes.
Pourquoi j'ai choisi Weights & Biases
Weights & Biases compte parmi mes favoris en raison de ses tableaux de bord de visualisation personnalisables particulièrement poussés. Je peux extraire en direct l'utilisation du GPU, les courbes de perte et des prédictions exemples dans un tableau de bord interactif unique pendant un entraînement, ce qui permet d'identifier rapidement les goulets d'étranglement. La fonctionnalité Sweeps me permet de visualiser les résultats des recherches d'hyperparamètres directement à côté de mes métriques d'expérience, de sorte que je compare tout en un seul endroit. Les rapports offrent également la possibilité à mon équipe d'annoter et de partager ces tableaux de bord sans quitter la plateforme.
Fonctionnalités clés de Weights & Biases
- Artifacts : Versionnez et suivez les jeux de données, modèles et résultats d'évaluation à travers les essais d'expériences.
- Registre de modèles : Centralisez les modèles entraînés et reliez-les directement aux expériences qui les ont produits.
- Regroupement des essais : Organisez les essais associés en groupes afin de comparer les résultats entre différentes configurations d'entraînement.
- Alertes : Définissez des notifications automatiques pour certains seuils de métriques, échecs d'essais ou la fin d'une tâche.
Intégrations Weights & Biases
Weights & Biases propose des intégrations natives avec PyTorch, Keras, TensorFlow, Scikit-learn, XGBoost, Hugging Face Transformers et PyTorch Lightning, ainsi qu'avec des outils LLM comme LangChain et LlamaIndex. Il s'intègre aussi à Kubeflow, Jenkins, Airflow, GitHub Actions, AWS SageMaker et Google Vertex AI. Une API et un SDK Python sont disponibles pour les intégrations personnalisées.
Pros and Cons
Pros:
- Streaming des métriques en temps réel vers des tableaux de bord
- Journalisation automatique des commits git et des configurations
- Rapports collaboratifs riches avec graphiques intégrés
Cons:
- L'interface Web ralentit avec de nombreux essais en parallèle
- Des lacunes dans la documentation sur les fonctionnalités de base

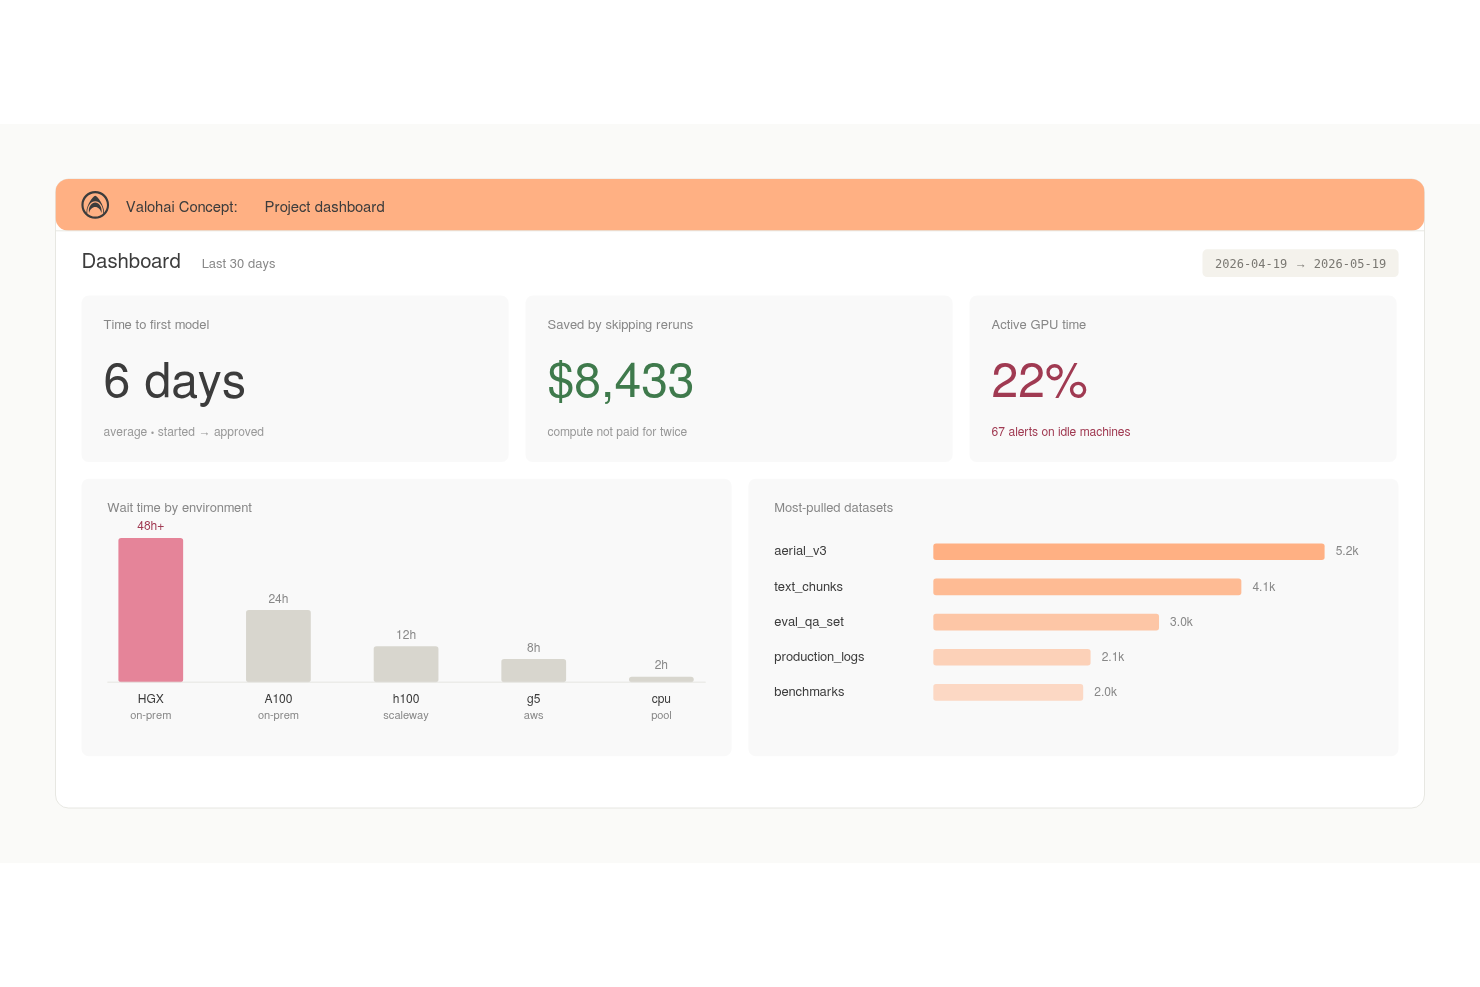
Valohai est une plateforme de ML qui combine le suivi automatique des expériences, le versionnage des jeux de données, la traçabilité des modèles et l'orchestration des ressources de calcul cloud pour les équipes qui développent et entraînent des modèles à grande échelle.
À qui Valohai convient-elle le mieux ?
Valohai convient particulièrement aux équipes d'ingénierie ML des entreprises de taille moyenne à grande qui exécutent fréquemment des tâches d'entraînement dans plusieurs environnements cloud.
Pourquoi j'ai choisi Valohai
J'ai choisi Valohai parmi les meilleures solutions, car le versionnage automatique est véritablement intégré à chaque exécution. Les métriques, les métadonnées, les journaux et les hyperparamètres sont versionnés sans aucun marquage manuel, de sorte que je n'ai jamais à reconstituer ce qui a été exécuté et à quel moment. J'apprécie également le fait que Valohai assure la traçabilité complète des jeux de données et des modèles, ce qui me permet de retracer exactement quelle version d'un jeu de données a produit un modèle donné. Chaque exécution est reproductible par conception, ce qui élimine les suppositions qui compliquent les audits d'expériences.
Fonctionnalités clés de Valohai
- Vue comparative des expériences : Affiche plusieurs exécutions côte à côte, ce qui permet de comparer les hyperparamètres, les métriques et les résultats de différentes expériences dans un même tableau.
- Générateur de pipelines : Un éditeur visuel permettant de construire des pipelines ML en plusieurs étapes, chaque nœud correspondant à une étape d'exécution versionnée.
- Orchestration des ressources de calcul cloud : Provisionne et arrête automatiquement des instances cloud sur AWS, GCP ou Azure pour chaque exécution d'entraînement.
- Déclencheurs de déploiement : Déploie directement les modèles entraînés sur un point de terminaison de service depuis la même plateforme que celle utilisée pour l'entraînement.
Intégrations de Valohai
Valohai propose un ensemble limité d'intégrations préconfigurées via sa bibliothèque Ecosystem, notamment des connecteurs pour Snowflake, BigQuery et Redshift, un modèle Hugging Face, ainsi que des intégrations avec Slurm et OVHcloud. La plateforme fonctionne sur AWS, GCP, Azure et Oracle Cloud Infrastructure, et fournit une API REST pour créer des intégrations personnalisées.
Pros and Cons
Pros:
- Enregistre automatiquement les métriques des journaux JSON affichés
- Fonctionne sur n'importe quel cloud ou matériel sur site
- Traçabilité complète du modèle jusqu'au jeu de données
Cons:
- Adapter les scripts au format Valohai demande des efforts
- La vue principale des expériences semble visuellement peu convaincante

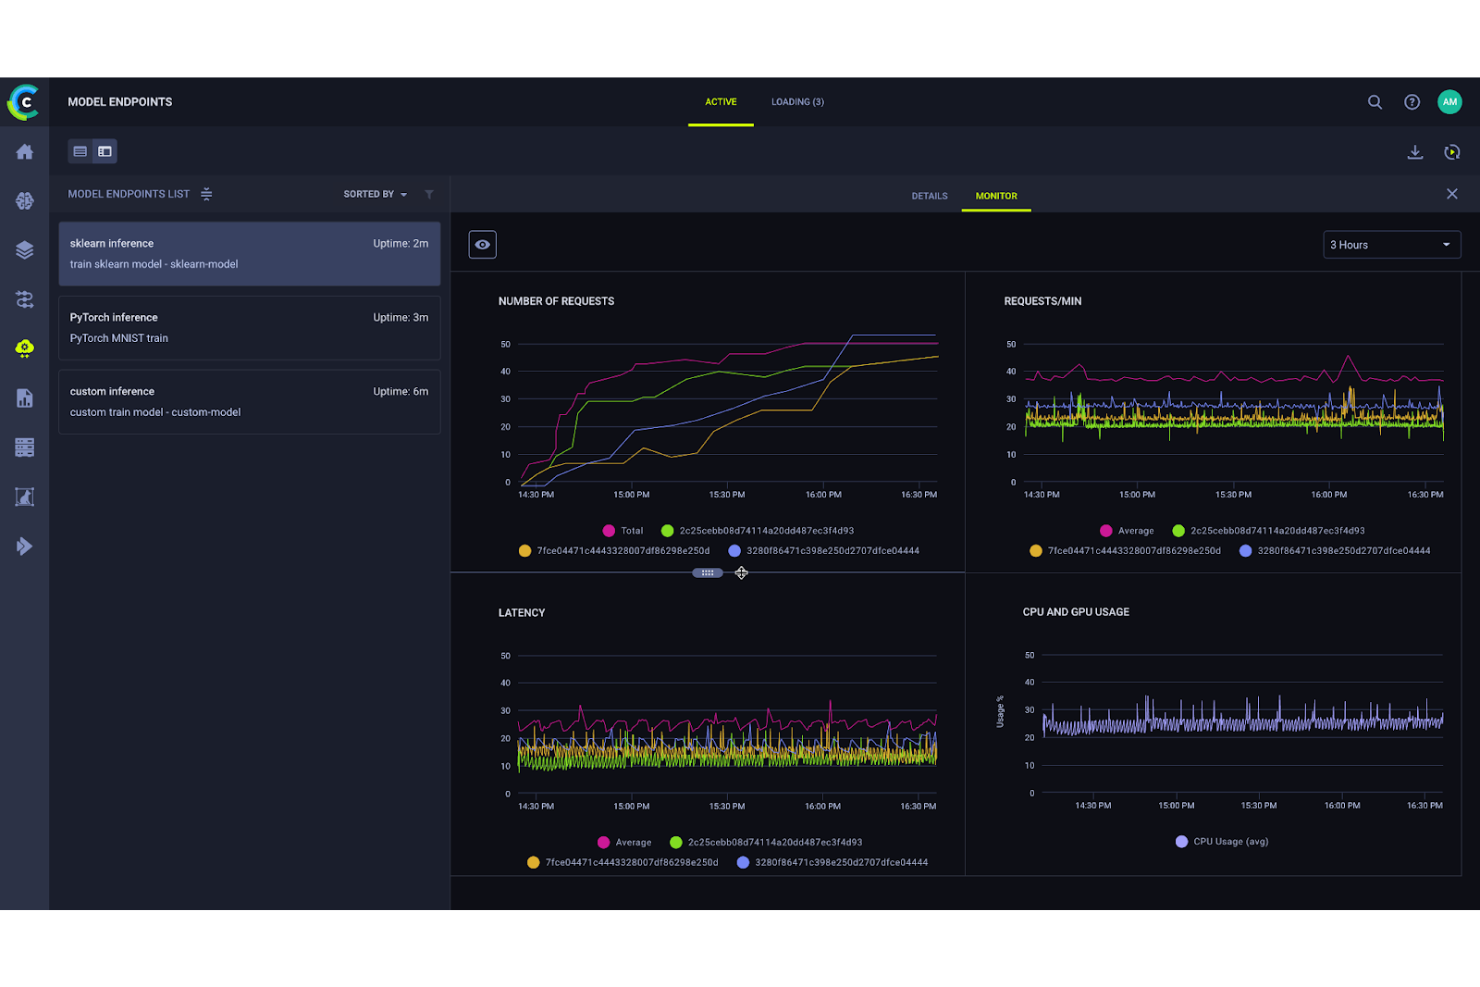
ClearML est une plate-forme MLOps open-source qui couvre le suivi des expériences, la gestion des versions de jeux de données, la gestion des modèles et l'orchestration de pipelines tout au long du cycle de vie du machine learning.
À qui s'adresse ClearML ?
ClearML s'adresse particulièrement aux ingénieurs ML et aux data scientists travaillant dans des organisations qui hébergent elles-mêmes leur infrastructure MLOps et qui souhaitent un contrôle total de leurs pipelines.
Pourquoi j'ai choisi ClearML
ClearML mérite sa place dans ma sélection car son orchestration automatique des pipelines est véritablement sans intervention. Lorsque j'ajoute un travail à une file d'attente, ClearML le containerise avec tout son environnement et gère automatiquement la planification et la gestion des ressources. Je n'ai pas besoin de réécrire le code pour passer de l'on-premise, au cloud ou aux clusters HPC. J'apprécie aussi que les composants de pipeline en cache me permettent d’éviter les étapes redondantes lors des relances, ce qui réduit considérablement le temps de cycle dans les processus d’entraînement itératifs.
Principales fonctionnalités de ClearML
- Journalisation automatique des expériences : Capture automatiquement les métriques, hyperparamètres, sorties console et code source de chaque exécution d'entraînement sans instrumentation supplémentaire.
- Versionnage des données avec ClearML : Gérez et versionnez les jeux de données avec traçabilité complète, chaque version étant liée directement aux expériences qui l'ont utilisée.
- Registre de modèles : Stockez, étiquetez et récupérez les modèles entraînés avec gestion des versions et des étapes tout au long du cycle de développement.
- Optimisation d'hyperparamètres : Lancez des recherches HPO automatisées sur vos expériences avec des stratégies intégrées, telles que l’optimisation bayésienne et la recherche aléatoire.
Intégrations ClearML
ClearML propose des intégrations natives avec PyTorch, TensorFlow, Keras, Scikit-learn, XGBoost, Hugging Face Transformers, FastAI, Optuna et Hydra, ainsi qu'avec des outils de visualisation comme Matplotlib et TensorBoard. Une API et un SDK Python sont disponibles pour des intégrations personnalisées.
Pros and Cons
Pros:
- Serveur open-source auto-hébergé, sans frais d'abonnement
- Journalise automatiquement le code, les jeux de données et les hyperparamètres sans instrumentation
- La conception modulaire permet d'adopter des composants individuellement
Cons:
- Des lacunes dans la documentation ralentissent la prise en main pour les nouveaux utilisateurs
- La navigation entre les modules donne une impression de fragmentation à grande échelle
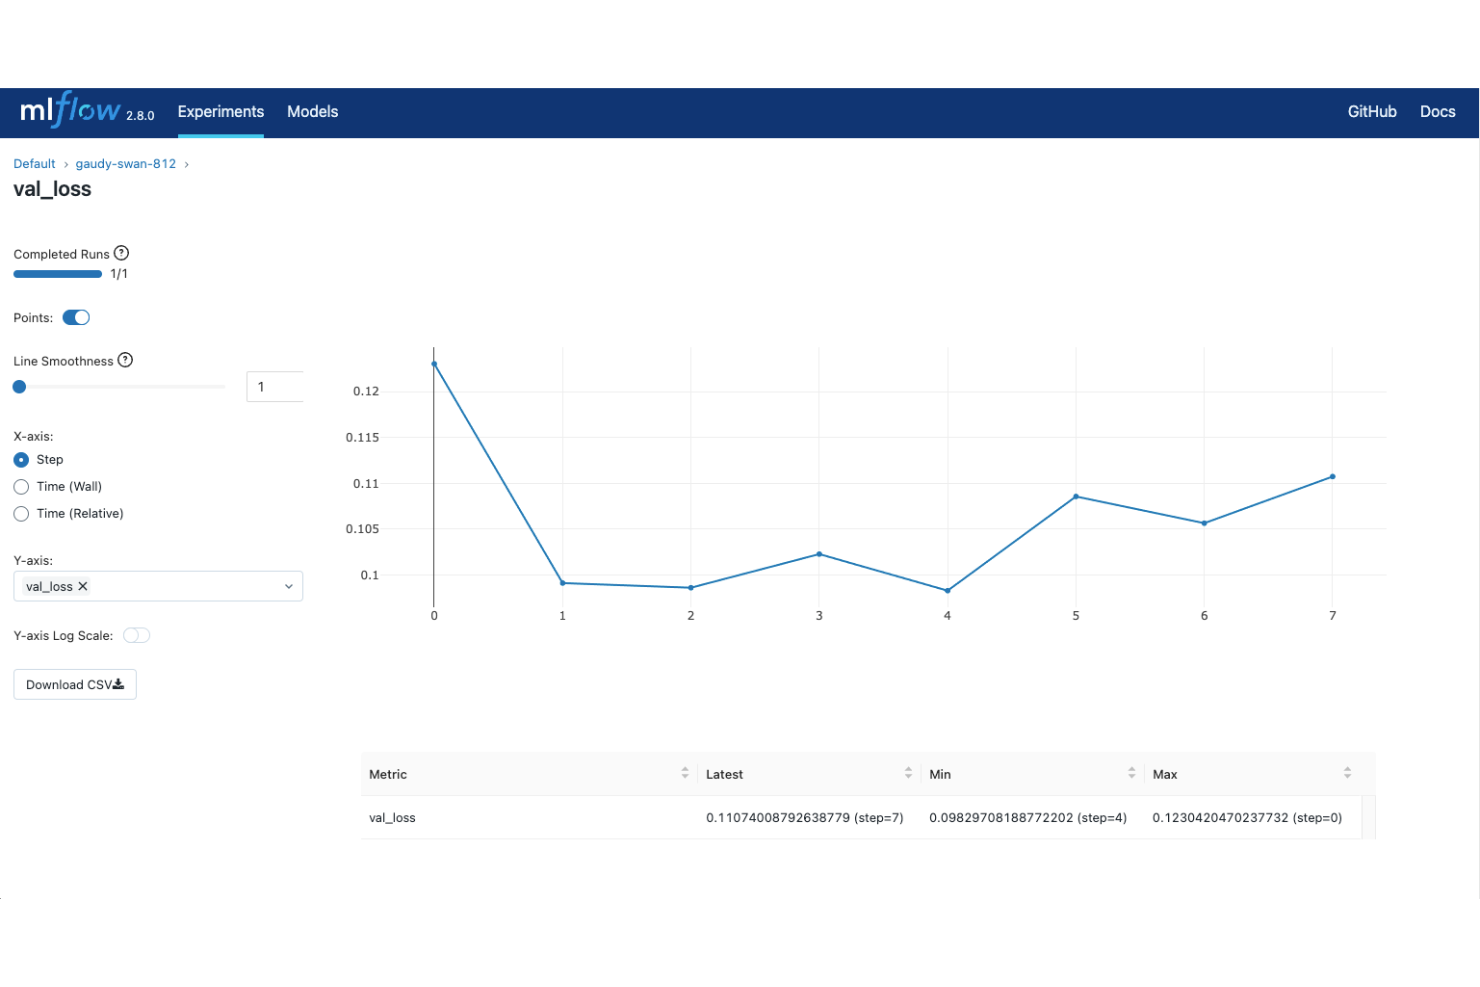
MLflow est une plateforme open source de suivi d'expériences de machine learning couvrant l'intégralité du cycle de vie du modèle, de la journalisation des expériences à la comparaison des exécutions, jusqu'à l'empaquetage, la gestion des versions et le déploiement des modèles.
À qui s'adresse MLflow ?
MLflow est particulièrement adapté aux ingénieurs ML et data scientists travaillant dans des organisations qui hébergent leurs propres outils et souhaitent garder un contrôle total sur leur infrastructure de suivi d'expériences sans dépendance à un fournisseur.
Pourquoi j'ai choisi MLflow
MLflow figure dans ma sélection car il couvre l'ensemble du cycle de vie du modèle au sein d'un même framework open source. J'utilise l'API de suivi MLflow pour enregistrer les paramètres, les métriques et les artefacts à chaque exécution, puis le registre de modèles pour versionner et faire évoluer les modèles du développement à la production. Ce que j'apprécie particulièrement, c'est de pouvoir empaqueter des modèles au format standard MLflow et les déployer sur n'importe quelle cible sans devoir réécrire le code de service.
Principales fonctionnalités de MLflow
- Journalisation automatique : Capture automatiquement les paramètres, métriques et artefacts depuis des bibliothèques prises en charge comme Scikit-learn, XGBoost et PyTorch sans appels de journalisation manuels.
- Interface de comparaison des exécutions : Visualisez et comparez côte à côte les métriques de plusieurs entraînements dans l'interface web intégrée de MLflow.
- MLflow Projects : Emballe le code ML avec ses dépendances et points d'entrée pour garantir la reproductibilité exacte d'une exécution sur toute machine.
- Système de plugins : Étend les fonctionnalités de suivi, de stockage et de déploiement de MLflow grâce à des plugins communautaires, sans modifier le cœur du code.
Intégrations MLflow
MLflow propose plus de 60 intégrations intégrées, y compris PyTorch, TensorFlow, Scikit-learn, XGBoost, LightGBM, Hugging Face Transformers, LangChain, LlamaIndex et OpenAI. Il prend également en charge AWS SageMaker, Azure ML, Databricks et OpenTelemetry. Une API REST et un SDK Python sont disponibles pour les intégrations personnalisées.
Pros and Cons
Pros:
- Journalisation indépendante des frameworks pour diverses bibliothèques ML
- Versionnage complet des modèles avec transitions de stade
- Peut être auto-hébergé sur toute infrastructure
Cons:
- Nécessite des compétences DevOps pour une mise en production
- Visualisation matérielle intégrée limitée pour les profils

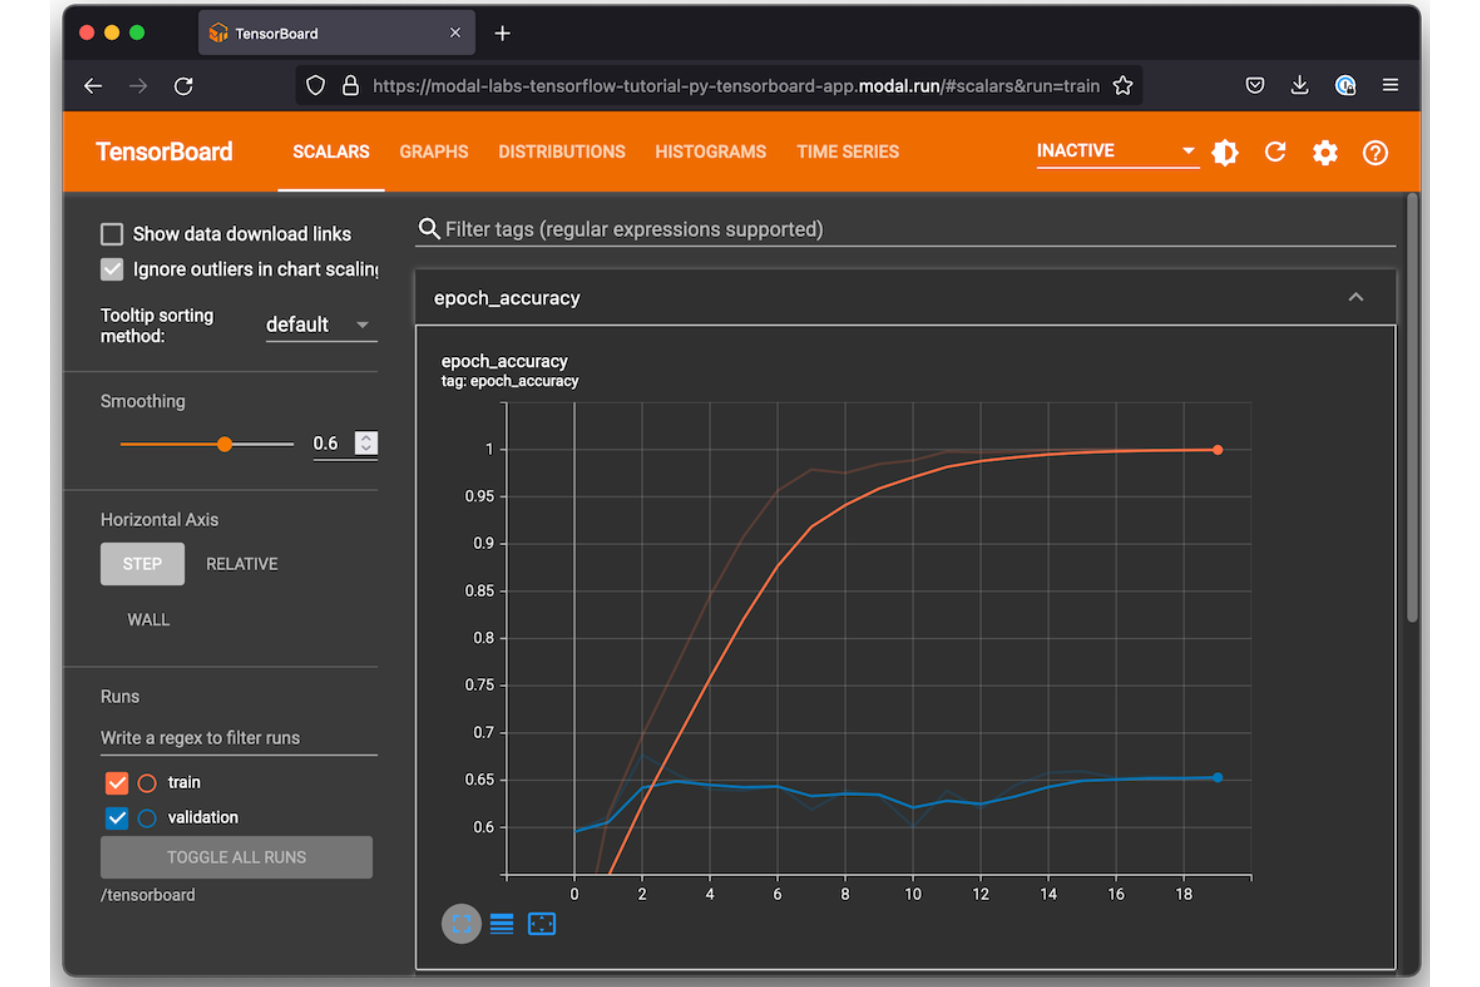
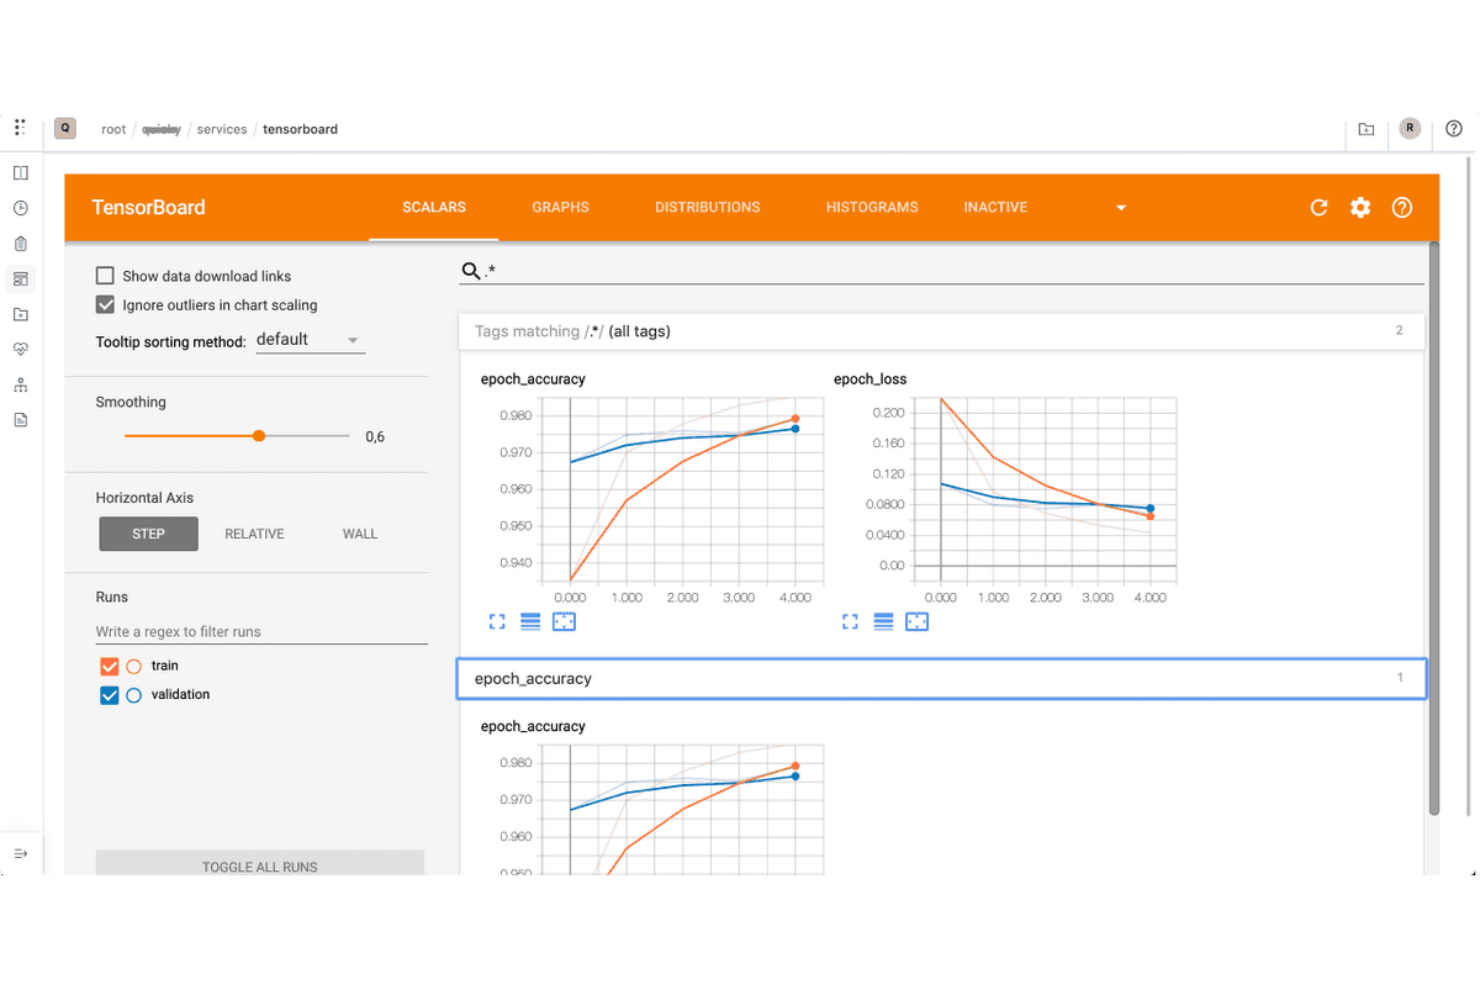
TensorFlow est un framework open source d’apprentissage automatique de Google qui couvre la conception, l’entraînement, l’évaluation et le déploiement de modèles dans les workflows d’apprentissage profond et de réseaux neuronaux.
À qui TensorFlow convient-il le mieux ?
TensorFlow convient particulièrement aux équipes de recherche et aux ingénieurs en apprentissage automatique qui conçoivent et entraînent des modèles d’apprentissage profond à grande échelle, notamment dans les environnements de production.
Pourquoi j’ai choisi TensorFlow
J’ai inclus TensorFlow dans mes meilleurs choix, car son API Keras native me permet de concevoir et d’itérer sur des architectures d’apprentissage profond sans changer de contexte ni de framework. Je m’appuie également sur TensorBoard directement dans TensorFlow pour suivre les métriques d’entraînement, visualiser les graphes de calcul et comparer les exécutions côte à côte. TensorFlow Hub me donne accès à des modèles préentraînés que je peux ajuster, ce qui réduit considérablement le temps d’entraînement pour les expériences d’apprentissage par transfert.
Principales fonctionnalités de TensorFlow
- TensorFlow Extended (TFX) : Un framework de pipeline d’apprentissage automatique destiné à la production, qui orchestre les étapes de validation et de transformation des données, d’entraînement et d’évaluation des modèles.
- API tf.data : Crée des pipelines d’entrée évolutifs pour charger, prétraiter et regrouper les jeux de données lors des sessions d’entraînement des modèles.
- TensorFlow Serving : Déploie les modèles entraînés en production via des points de terminaison REST ou gRPC, sans modifier le code du modèle.
- Format SavedModel : Sérialise les modèles entraînés avec leurs graphes de calcul complets et leurs poids afin de permettre un rechargement et un partage reproductibles.
Intégrations de TensorFlow
TensorFlow est un framework open source plutôt qu’une plateforme SaaS ; il ne propose donc pas d’intégrations natives traditionnelles avec des outils tiers. Son écosystème comprend à la place des bibliothèques intégrées telles que TensorBoard, TFX, TensorFlow.js, TensorFlow Serving, Keras et ML Metadata, qui gèrent le suivi des expériences, l’orchestration des pipelines et le déploiement des modèles au sein du framework lui-même. Des outils tiers de suivi des expériences, comme MLflow et Weights & Biases, proposent leurs propres intégrations avec TensorFlow, et une API Python est disponible pour les extensions personnalisées.
Pros and Cons
Pros:
- Visualisation en temps réel des métriques et des graphiques d’entraînement
- Outils intégrés de réglage et d’optimisation des hyperparamètres
- Déploiement sur les CPU, GPU et TPU
Cons:
- TensorBoard ralentit avec de nombreuses expériences
- Stocke les données localement sans fonctions intégrées de collaboration
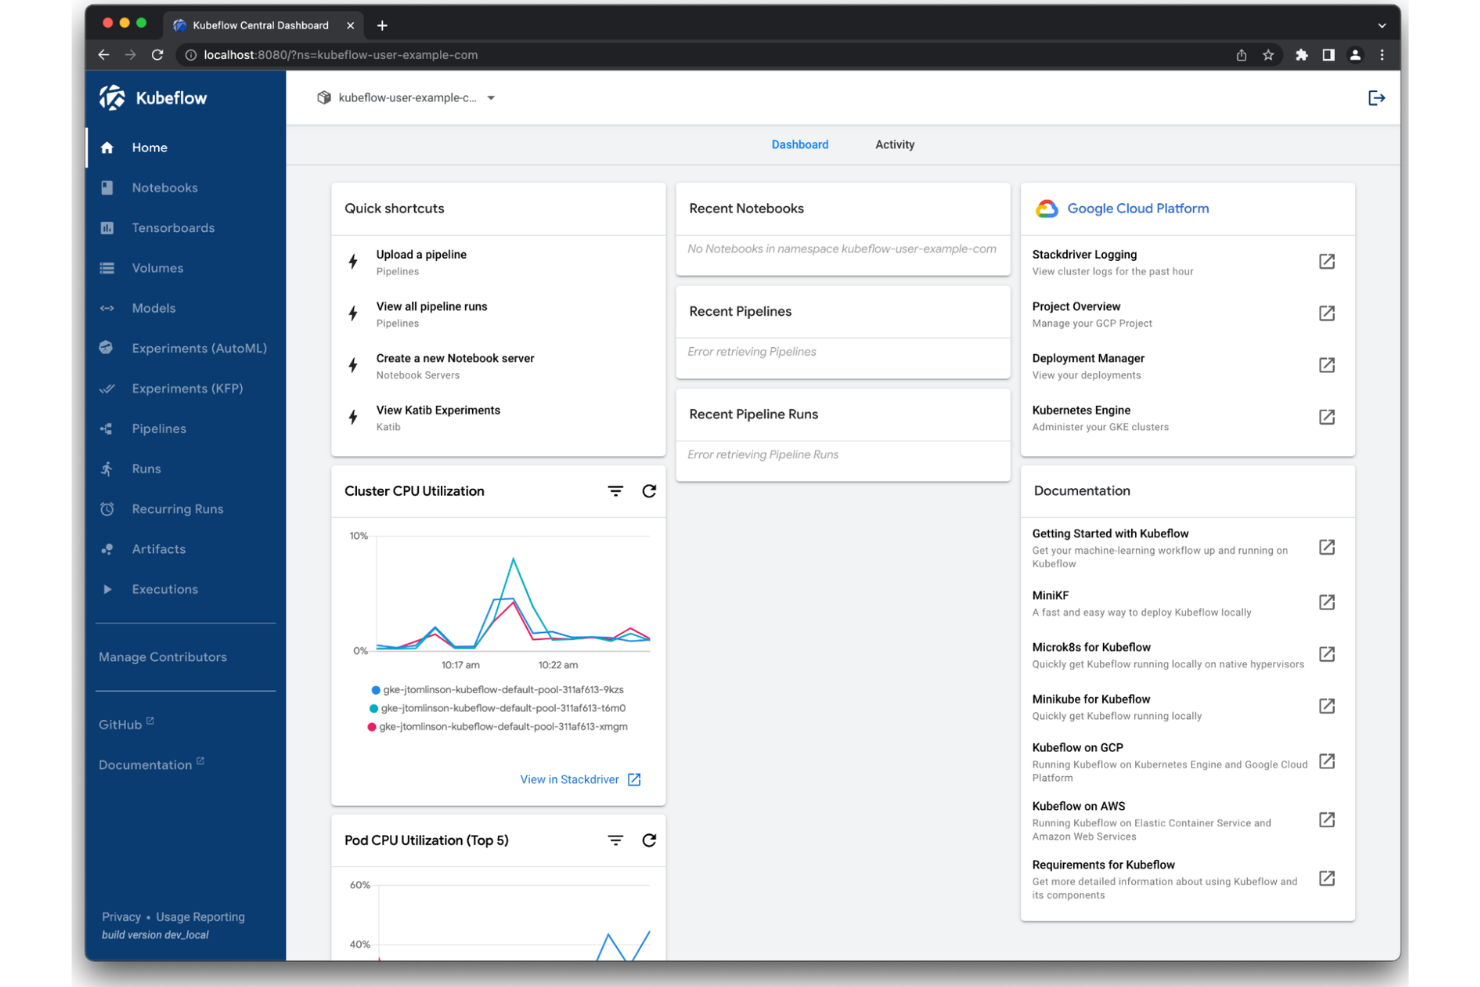
Kubeflow est une plateforme ML à code source ouvert conçue sur Kubernetes, qui couvre nativement l’orchestration des pipelines, le suivi des expériences, l’entraînement des modèles et l’optimisation des hyperparamètres au sein d’une infrastructure conteneurisée.
À qui Kubeflow convient-il le mieux ?
Kubeflow convient naturellement aux équipes d’ingénierie ML qui exécutent déjà des charges de travail sur Kubernetes et souhaitent conserver leur infrastructure de suivi des expériences sur la même plateforme.
Pourquoi j’ai choisi Kubeflow
Kubeflow figure dans ma sélection parce qu’il associe directement chaque étape du pipeline à un pod Kubernetes, ce qui donne aux exécutions d’expériences les mêmes contrôles de ressources que toute autre charge de travail du cluster. J’utilise Kubeflow Pipelines pour versionner et rejouer les exécutions d’entraînement sans sortir de l’environnement Kubernetes. Son composant Katib exécute en parallèle des essais d’optimisation des hyperparamètres sous forme de tâches Kubernetes natives, sans infrastructure distincte.
Fonctionnalités principales de Kubeflow
- Isolation des espaces de noms multi-utilisateurs : Sépare les expériences et les pipelines par équipe ou par projet à l’aide des contrôles d’accès au niveau des espaces de noms Kubernetes.
- Carnets Kubeflow : Lance des serveurs de carnets Jupyter directement dans le cluster, afin de conserver l’exploration des données dans le même environnement que les exécutions d’entraînement.
- Suivi de la traçabilité des artefacts : Enregistre les entrées, les sorties et les métadonnées de chaque étape du pipeline, en reliant les jeux de données et les modèles à des exécutions précises.
- Opérateur d’entraînement : Gère les tâches d’entraînement distribué avec des cadres tels que PyTorch, TensorFlow et XGBoost sous forme de ressources personnalisées Kubernetes natives.
Intégrations de Kubeflow
Kubeflow ne propose pas d’intégrations natives traditionnelles ; il fonctionne plutôt au sein de l’écosystème Kubernetes et prend en charge des cadres ML comme TensorFlow, PyTorch, JAX, XGBoost, HuggingFace et Apache Spark par l’intermédiaire des opérateurs de ses sous-projets. Vous pouvez également le déployer sur des services Kubernetes gérés par AWS, Google Cloud, Microsoft Azure et Red Hat OpenShift.
Pros and Cons
Pros:
- Exécute les expériences directement sur des pods Kubernetes
- Le versionnage des pipelines suit chaque exécution d’entraînement
- Optimisation parallèle des hyperparamètres grâce au composant Katib
Cons:
- La configuration du cluster exige une expertise approfondie de Kubernetes
- L’interface paraît obsolète par rapport aux alternatives commerciales

Amazon SageMaker est une plateforme d'apprentissage automatique (ML) entièrement gérée sur AWS qui couvre le suivi des expériences, l'entraînement des modèles, l'optimisation des hyperparamètres, le registre de modèles et le déploiement sur l'ensemble du cycle de vie du machine learning.
Pour qui Amazon SageMaker est-il le mieux adapté ?
Amazon SageMaker est idéal pour les équipes de data science et d'ingénierie ML qui exploitent déjà des charges de travail sur l'infrastructure AWS.
Pourquoi j'ai choisi Amazon SageMaker
J'ai inclus Amazon SageMaker dans mes favoris car son suivi des expériences est directement intégré à l'écosystème AWS d'une manière que les autres outils ne peuvent pas reproduire. SageMaker Experiments enregistre de manière native les exécutions, les paramètres et les métriques, parallèlement au stockage des artefacts sur S3 et à l'accès contrôlé par IAM, sans qu’il soit nécessaire de gérer une infrastructure distincte. Mon équipe utilise également SageMaker Pipelines pour enchaîner les tâches d'entraînement, les évaluations et l'enregistrement des modèles dans un workflow unique et auditable, sans quitter AWS.
Fonctionnalités clés d'Amazon SageMaker
- Registre de modèles SageMaker : Versionnez, approuvez et mettez en phase les modèles entraînés avec un suivi des métadonnées tout au long du cycle de vie du modèle.
- Optimisation automatique des modèles : Lancez des jobs d'optimisation des hyperparamètres à grande échelle, en utilisant des stratégies telles que la recherche bayésienne, aléatoire ou en grille.
- SageMaker Debugger : Surveillez les tâches d'entraînement en temps réel pour détecter les problèmes comme la disparition des gradients ou le surapprentissage au fur et à mesure qu'ils se produisent.
- SageMaker Feature Store : Stockez, partagez et récupérez les fonctionnalités ML pour l'entraînement et l'inférence à partir d'un référentiel centralisé.
Intégrations avec Amazon SageMaker
Amazon SageMaker s'intègre nativement à l'ensemble de l'écosystème AWS, y compris Amazon S3, Amazon Redshift, AWS Glue, Amazon EMR, Amazon Athena, Amazon ECR, AWS Lambda, Amazon CloudWatch et MLflow. Une API est disponible pour des intégrations sur mesure.
Pros and Cons
Pros:
- Suit les paramètres, les données et les versions du code pour chaque exécution
- Sauvegardes automatiques lors des entraînements longs
- Surveillance intégrée des modèles avec les journaux d'expériences
Cons:
- Les ressources non utilisées peuvent générer des frais de facturation invisibles
- Les artefacts de modèles utilisent des formats spécifiques à AWS, ce qui limite leur portabilité

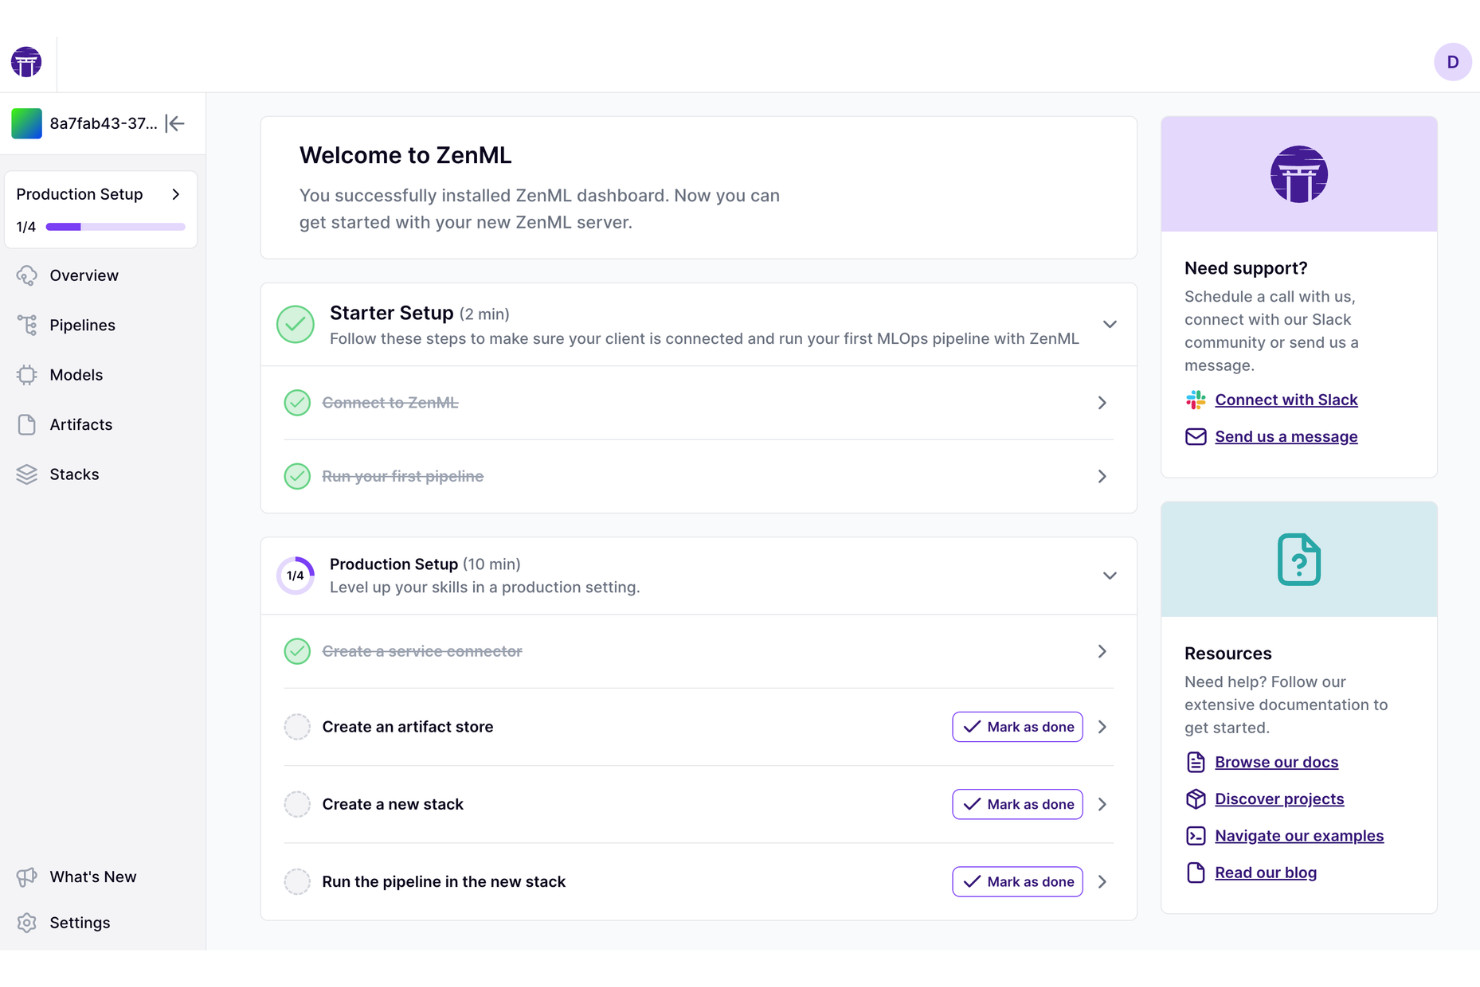
ZenML est une plateforme open source d'orchestration de pipelines ML qui gère l'orchestration des workflows, la gestion de versions des artefacts, la traçabilité des modèles et le suivi des expériences sur toute infrastructure cloud ou pile ML.
À qui s'adresse ZenML ?
ZenML convient particulièrement aux ingénieurs ML et aux équipes de science des données qui doivent standardiser et faire évoluer des pipelines ML sur plusieurs environnements cloud ou infrastructures.
Pourquoi j'ai choisi ZenML
ZenML figure sur ma liste car son architecture par composants de stack me permet d'interchanger n'importe quelle partie de mon infrastructure ML sans réécrire de code de pipeline. Je peux brancher MLflow ou Weights & Biases pour le suivi d'expériences, passer le stockage d'artefacts du local à S3, et changer l'orchestrateur pour Kubeflow, tout cela en modifiant simplement la stack active. J'utilise aussi les saveurs de composants personnalisés de ZenML pour développer des intégrations de suivi propriétaires à intégrer directement dans la même abstraction de pipeline.
Fonctionnalités clés de ZenML
- Mise en cache des étapes du pipeline : Met automatiquement en cache les sorties des étapes déjà exécutées, afin que les étapes inchangées ne soient pas réexécutées lors d'expériences itératives.
- Gestion de versions des artefacts : Suit chaque artefact produit par une exécution de pipeline, y compris les jeux de données, modèles et métriques, avec une traçabilité complète jusqu'à l'étape d'origine.
- Registre de modèles : Stocke et gère la version des modèles entraînés, ainsi que leurs métadonnées associées, les exécutions de pipeline et l'historique des déploiements dans un registre centralisé.
- Tableau de bord ZenML : Offre une interface web pour parcourir les exécutions de pipelines, comparer les résultats d'expériences et inspecter les métadonnées des artefacts à travers les stacks.
Intégrations ZenML
ZenML propose 66 intégrations natives dans l'écosystème ML, y compris MLflow, Weights & Biases, Neptune, Comet et TensorBoard, ainsi que des orchestrateurs comme Kubeflow, Apache Airflow, Kubernetes et Databricks, et des infrastructures cloud pour AWS, Google Cloud et Microsoft Azure. Une API est disponible pour des intégrations personnalisées.
Pros and Cons
Pros:
- Interchanger l'infrastructure sans réécrire le code du pipeline
- Stack indépendante du cloud pour éviter l'enfermement propriétaire
- Versionnement automatique des artefacts sur les exécutions de pipelines
Cons:
- Dépendance à des outils tiers pour la visualisation des expériences
- Configuration initiale de la stack nécessitant un effort de mise en place important

Polyaxon est une plateforme de suivi d'expériences ML et d'orchestration de pipelines qui couvre le suivi des expériences, l'optimisation des hyperparamètres, la gestion de versions des artefacts, le registre des modèles et la planification de travaux distribués sur des infrastructures cloud et sur site.
Pour qui Polyaxon est-il le mieux adapté ?
Polyaxon est particulièrement adapté aux ingénieurs ML dans les grandes entreprises qui opèrent sous des exigences strictes en matière de gouvernance des données ou qui ont besoin d'exécuter des charges de travail sur une infrastructure privée.
Pourquoi j'ai choisi Polyaxon
J'ai inclus Polyaxon dans mes meilleurs choix car il s'agit de l'une des rares plateformes de suivi d'expériences ML conçues dès le départ pour fonctionner entièrement au sein de votre propre infrastructure. Je l'exécute sur un cluster Kubernetes privé, et chaque journal d'expérience, artefact et modèle reste à l'intérieur de notre réseau. Son architecture basée sur des agents me permet de connecter des environnements isolés sur site à un plan de contrôle central, sans exposer de données brutes à l'extérieur, ce qui est une exigence réelle dans les secteurs réglementés.
Fonctionnalités clés de Polyaxon
- Recherche et optimisation d'hyperparamètres : Exécutez des groupes d'expériences en parallèle à l'aide de stratégies de recherche distribuée pour trouver les configurations de modèles optimales.
- Hub de composants : Définissez des modules réutilisables avec entrées et sorties typées pouvant être partagés et versionnés entre les pipelines de votre équipe.
- Recherche avancée : Filtrez les exécutions par nom, description, regex, champs spécifiques, métriques ou configurations afin de localiser rapidement les expériences.
- Respect des SLA : Appliquez des politiques de TTL, de délai d'expiration et de nouvelle tentative à chaque opération afin de maintenir les pipelines dans les limites définies.
Intégrations Polyaxon
Polyaxon propose un large éventail d'intégrations natives dans les domaines du suivi ML, de l'orchestration et de l'infrastructure, dont TensorBoard, PyTorch, TensorFlow, Keras, XGBoost, Hugging Face, Kubeflow, Slack, GitHub et Jenkins. Il se connecte également à Zapier et propose une API pour des intégrations personnalisées et l'automatisation CI/CD.
Pros and Cons
Pros:
- Planification native Kubernetes des tâches d'entraînement distribuées
- Multi-location intégré avec contrôles d'accès fins
- Prend en charge les déploiements sur site, cloud et hybrides
Cons:
- Nécessite une expertise Kubernetes approfondie pour l'exploitation
- Communauté plus restreinte que MLflow ou W&B
Autres outils de suivi des expériences de ML
Voici quelques outils supplémentaires de suivi des expériences de ML qui n’ont pas été retenus dans ma sélection, mais qui méritent tout de même votre attention :
- Databricks
Idéal pour un espace de travail analytique unifié pour les équipes
- Domino Data Lab
Idéal pour un contrôle centralisé dans la recherche collaborative
- iguazio
Idéal pour la surveillance en temps réel de modèles à grande échelle
- Dagster
Idéal pour la création programmatique de pipelines de données


Comment j'évalue les outils de suivi d'expériences ML
Je divise mon évaluation en deux niveaux : ce que chaque outil doit absolument faire (comme la journalisation automatique des exécutions PyTorch) et ce qui distingue les meilleurs outils.
Fonctionnalités de base (Critères essentiels pour cette liste)
Lorsque je sélectionne des outils pour ma liste, j'attribue un score à chacun sur une échelle de 0 (ne propose pas la fonctionnalité) à 5 (excelle dans ce domaine) pour chaque fonctionnalité essentielle ci-dessous. Ensuite, je calcule le score total de l'outil en pourcentage. Chaque outil doit atteindre un score total minimum de 65 % pour être pris en compte dans la sélection.
- Journalisation des expériences : Je vérifie si l'outil capture automatiquement les métriques, hyperparamètres et la télémétrie système des phases d'entraînement ou s'il nécessite l'instrumentation manuelle du SDK pour chaque point de données.
- Comparaison et visualisation des exécutions : Les tableaux comparatifs côte à côte sont un début, mais je recherche des graphiques interactifs, comme des tracés de coordonnées parallèles, qui aident à repérer des tendances à travers des dizaines d'exécutions dans vos projets ML.
- Versionnage des artefacts et des modèles : J'évalue comment chaque outil gère les versions de jeux de données, les points de sauvegarde des modèles (checkpoints) et des sorties, y compris s'il relie les artefacts à l'exécution spécifique qui les a générés.
- Prise en charge des frameworks ML : L'outil doit couvrir les frameworks réellement utilisés par votre équipe, de PyTorch et TensorFlow à Hugging Face Transformers et XGBoost, avec un minimum de code d'adaptation.
- Reproductibilité et traçabilité : Je privilégie les outils qui capturent ensemble les commits du code, les instantanés de dépendances et l'état des jeux de données, afin que vous puissiez relancer une expérience réalisée il y a six mois et obtenir le même résultat.
- Collaboration et partage : Les équipes réparties sur plusieurs fuseaux horaires ont besoin d'espaces de travail partagés, d'un accès basé sur les rôles, et de la possibilité de commenter ou de partager des exécutions précises sans devoir exporter de fichiers CSV en permanence.
Une fois que j'ai une liste d'outils qui répondent à ces critères, j'analyse ce qui différencie chaque plateforme.
Facteurs de différenciation (Ce qui distingue les fournisseurs)
Voici comment je compare et distingue les différents fournisseurs :
Fonctionnalités remarquables
L'optimisation des hyperparamètres est un facteur clé de différenciation. Je recherche des fonctionnalités intégrées permettant d'automatiser les recherches à travers plusieurs exécutions distribuées et de visualiser les performances selon les différentes configurations en un seul endroit. Le suivi en direct des ressources est aussi un vrai plus : lorsqu'on peut surveiller l'utilisation GPU et mémoire pendant l'entraînement, on détecte les goulets d'étranglement avant de gaspiller des heures de calcul. Le reporting collaboratif complète l'offre pour les grandes équipes, où des tableaux de bord partageables remplacent les feuilles de calcul manuelles et permettent aux data scientists de discuter des résultats avec les parties prenantes sans changer d'outil.
Au-delà des fonctionnalités
La flexibilité de déploiement compte plus que ce que beaucoup d'équipes imaginent. J'évalue si un outil prend en charge l'auto-hébergement ou les installations isolées (air-gapped) pour les équipes qui manipulent de la propriété intellectuelle sensible ou des données réglementées. L'évolutivité est un autre critère : la journalisation de milliers d'exécutions simultanées ne doit pas dégrader les performances des requêtes ni provoquer de pics de coûts imprévisibles. L'expérience d'intégration différencie également les outils, car une documentation de démarrage rapide efficace et des forums communautaires actifs permettent à votre équipe d'instrumenter ses scripts d'entraînement en quelques heures, pas en quelques semaines.
Comment choisir des outils de suivi des expériences de ML
Il est facile de se perdre dans de longues listes de fonctionnalités et des structures tarifaires complexes. Pour vous aider à rester concentré pendant votre processus personnalisé de sélection de logiciels, voici une liste de contrôle des facteurs à garder à l’esprit :
| Facteur | Points à prendre en compte |
|---|---|
| Évolutivité | L’outil peut-il gérer le volume et la fréquence des expériences prévus à mesure que votre équipe et vos données se développent ? |
| Intégrations | Se connectera-t-il directement à vos cadriciels de ML, outils d’orchestration et systèmes de déploiement privilégiés ? |
| Personnalisation | Pouvez-vous adapter les champs de métadonnées, les étapes du flux de travail et les rapports aux exigences particulières de votre équipe ? |
| Facilité d’utilisation | Vos chercheurs et ingénieurs trouveront-ils l’interface intuitive ou la courbe d’apprentissage est-elle importante ? |
| Mise en œuvre et intégration | À quelle vitesse pouvez-vous passer de l’achat au suivi de votre première expérience ? Quelles ressources sont nécessaires pour la configuration ? |
| Coût | La tarification à l’usage, les frais de stockage ou les modules complémentaires requis sont-ils clairs et prévisibles pour vos besoins prévus ? |
| Mesures de sécurité | L’outil prend-il en charge le chiffrement, les autorisations granulaires et l’authentification afin de protéger les données sensibles ? |
| Exigences de conformité | L’outil vous aidera-t-il à respecter les réglementations du secteur, des clients ou des zones géographiques (SOC 2, ISO 27001, RGPD) ? |
Que sont les outils de suivi des expériences de ML ?
Les outils de suivi des expériences de ML sont des plateformes logicielles qui consignent, organisent et versionnent les expériences liées aux modèles d’apprentissage automatique, notamment leurs paramètres, leur code, leurs jeux de données et leurs métriques. Ces outils aident votre équipe à conserver l’historique des expériences, à comparer les résultats et à reproduire entièrement les exécutions passées, ce qui facilite la collaboration et les audits à mesure que les flux de travail des projets deviennent plus complexes.
Fonctionnalités
Lors de la sélection d’outils de suivi des expériences de ML, surveillez les fonctionnalités clés suivantes :
- Journalisation des expériences : Enregistre les paramètres, les configurations, les références au code source et les métriques de chaque exécution d’entraînement afin de conserver une piste d’audit claire.
- Comparaison des exécutions : Permet d’afficher et d’analyser plusieurs expériences côte à côte afin de comprendre comment différents paramètres ou changements influencent vos résultats.
- Gestion des versions des artefacts : Attribue automatiquement des versions aux jeux de données, aux modèles de ML versionnés et aux autres résultats afin que vous puissiez toujours reproduire ou poursuivre les travaux antérieurs.
- Intégrations aux frameworks : Se connecte directement aux frameworks de ML populaires, ce qui facilite le démarrage du suivi avec un minimum de modifications de votre flux de travail.
- Suivi de la traçabilité : Cartographie toute la chaîne, des données brutes au modèle final, afin de favoriser la reproductibilité et de répondre aux exigences de conformité réglementaire.
- Outils de collaboration : Permet à plusieurs utilisateurs de commenter, de documenter leurs observations et de partager les résultats au sein de votre équipe.
- Métadonnées personnalisées : Permet d’ajouter des champs ou des balises spécifiques au projet afin de catégoriser les expériences selon les exigences de votre flux de travail.
- Contrôle d’accès basé sur les rôles : Restreint l’accès aux données et aux actions sensibles, tout en contribuant à la gouvernance au niveau de l’organisation et au respect des normes de sécurité.
- Tableaux de bord et visualisations : Génère des rapports personnalisables et des visualisations de données afin de mettre rapidement en évidence les tendances et les anomalies dans vos données d’expérience.
- Recherche et filtrage : Permet à votre équipe de trouver facilement les expériences, les exécutions et les artefacts pertinents par paramètre, date ou autre critère, ce qui fait gagner du temps à mesure que votre projet se développe.
Fonctionnalités d’IA des outils courants de suivi des expériences de ML
Au-delà des fonctionnalités standard des outils de suivi des expériences de ML présentées ci-dessus, nombre de ces solutions intègrent l’IA avec des fonctionnalités telles que :
- Détection automatisée des anomalies : Utilise l’IA pour surveiller les métriques des expériences et signaler les schémas inhabituels ou les valeurs aberrantes, aidant ainsi les équipes à détecter rapidement la dérive des données ou les comportements inattendus des modèles.
- Suggestions intelligentes d’hyperparamètres : Applique l’apprentissage automatique pour recommander des valeurs optimales d’hyperparamètres à partir des données historiques des expériences, réduisant les approximations manuelles et accélérant l’ajustement des modèles.
- Requêtes d’expériences en langage naturel : Permet aux utilisateurs de rechercher et de filtrer les expériences au moyen d’un langage conversationnel, facilitant ainsi l’accès des parties prenantes non techniques aux résultats des expériences et leur compréhension.
- Allocation prédictive des ressources : Utilise l’IA pour prévoir les besoins en puissance de calcul et en mémoire des prochaines exécutions, aidant les équipes à planifier les ressources et à éviter les goulots d’étranglement.
- Résumé automatisé des expériences : Exploite l’IA pour générer des résumés concis des résultats des expériences, en mettant en évidence les principales conclusions et tendances afin d’accélérer la production de rapports et la prise de décision.
Avantages
La mise en œuvre d’outils de suivi des expériences de ML offre plusieurs avantages à votre équipe et à votre entreprise. Voici quelques-uns des avantages dont vous pouvez bénéficier :
- Reproductibilité des expériences : Suivez les paramètres, les jeux de données et les détails de l’environnement afin de recréer et de valider facilement les expériences précédentes.
- Collaboration simplifiée : Les tableaux de bord partagés, les commentaires et la documentation des projets aident les équipes à travailler ensemble et à communiquer efficacement les résultats.
- Développement accéléré des modèles : Les comparaisons côte à côte des exécutions et la gestion automatisée des versions des artefacts accélèrent les cycles d’expérimentation et la prise de décision.
- Gestion centralisée des connaissances : L’historique complet du projet et les métadonnées des expériences sont stockés au même endroit, ce qui préserve les connaissances institutionnelles à mesure que les équipes se développent.
- Amélioration de la conformité et de l’auditabilité : Le suivi intégré de la traçabilité et les journaux d’audit répondent aux exigences réglementaires et aux normes de gouvernance des entreprises.
- Maîtrise des coûts des ressources : Les fonctionnalités de surveillance en temps réel des ressources et d’allocation prédictive permettent aux équipes d’optimiser l’utilisation du matériel et d’éviter les dépenses inutiles.
- Prise en charge de flux de travail personnalisables : Les champs de métadonnées et les options de flux de travail flexibles s’adaptent aux processus et aux préférences existants de votre équipe.
Coûts et tarifs
La sélection d’outils de suivi des expériences de ML nécessite de comprendre les différents modèles tarifaires et forfaits disponibles. Les coûts varient en fonction des fonctionnalités, de la taille de l’équipe, des modules complémentaires et d’autres facteurs. Le tableau ci-dessous récapitule les forfaits courants, leurs prix moyens et les fonctionnalités généralement incluses dans les solutions d’outils de suivi des expériences de ML :
Tableau comparatif des forfaits d’outils de suivi des expériences de ML
| Type de forfait | Prix moyen | Fonctionnalités courantes |
|---|---|---|
| Forfait gratuit | $0 | Suivi de base des expériences, nombre d’utilisateurs limité, assistance communautaire et projets publics. |
| Forfait personnel | $5-$25/utilisateur/mois | Expériences illimitées, espace de stockage accru, projets privés et intégrations de base. |
| Forfait professionnel | $30-$70/utilisateur/mois | Outils de collaboration d’équipe, accès basé sur les rôles, intégrations avancées, sécurité renforcée et journaux d’audit. |
| Forfait Entreprise | $80-$150/utilisateur/mois | Options de déploiement personnalisées, SSO/SAML, outils de conformité, assistance premium et personnalisation avancée. |
FAQ sur les outils de suivi des expériences de ML
Voici quelques réponses aux questions courantes sur les outils de suivi des expériences de ML :
Ces outils nécessitent-ils beaucoup de configuration ou de modifications du code ?
Non, la plupart des outils proposent des SDK légers ou des extensions qui vous permettent de commencer à enregistrer vos expériences avec un minimum de modifications du code. Vous pouvez souvent intégrer le suivi à vos scripts en seulement quelques lignes.
Comment ces outils contribuent-ils à la conformité et aux audits des équipes ?
Ils enregistrent les paramètres, le code et les résultats de chaque exécution, créent un historique traçable des expériences et tiennent à jour des pistes d’audit, ce qui facilite la documentation de la conformité et le partage de preuves lors des contrôles ou des audits.
Ces solutions sont-elles compatibles avec les notebooks Jupyter ?
Oui, la plupart des outils de suivi des expériences de ML sont conçus pour fonctionner directement dans les notebooks Jupyter, ainsi qu’avec des scripts et des pipelines, vous n’avez donc pas besoin de modifier votre flux de travail.
Que se passe-t-il si mon équipe dépasse les capacités du forfait gratuit ?
Vous pouvez passer à une offre payante pour bénéficier de davantage d’utilisateurs, de limites de stockage plus élevées, d’intégrations avancées et de fonctionnalités destinées aux entreprises. Examinez attentivement les tarifs afin de ne pas être surpris lors de la transition.
Puis-je stocker des données sensibles ou propriétaires avec ces outils ?
Oui, mais vous devez examiner les mesures de sécurité du fournisseur, telles que le chiffrement, les contrôles d’accès et les certifications de conformité, afin de garantir la protection de vos données. Les options sur site ou dans un cloud privé peuvent offrir encore davantage de contrôle.