

Trouver le bon outil de gestion des données de test peut s’avérer difficile. Avec autant d’options disponibles, il est compliqué de déterminer laquelle répond réellement à vos besoins sans perdre un temps ou des ressources précieux. Si vous avez rencontré des problèmes avec des outils excessivement complexes, qui ne s’adaptent pas à l’évolution de vos projets ou qui ne respectent pas les réglementations relatives à la confidentialité des données, vous n’êtes pas seul. Un excellent outil de gestion des données de test doit simplifier la création, la gestion et la sécurisation de vos ensembles de données, tout en s’intégrant parfaitement à vos flux de travail de test.
En tant que professionnel des tests logiciels disposant d’une expérience pratique de dizaines d’outils, j’ai rencontré et surmonté les mêmes difficultés que celles auxquelles vous êtes confronté. C’est pourquoi j’ai créé ce guide : pour simplifier votre recherche et vous fournir une liste soigneusement sélectionnée des meilleurs outils de gestion des données de test actuellement disponibles. Que votre priorité soit l’automatisation, la conformité ou l’évolutivité, cet article vous aidera à prendre une décision éclairée.
Pourquoi faire confiance à nos recommandations de logiciels
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Notre équipe teste et évalue des logiciels depuis 2012. En tant que leaders technologiques nous-mêmes, nous savons à quel point il est difficile — et important — de choisir le bon logiciel.
Pour ce guide, nous avons évalué les outils grâce à des tests pratiques et une recherche indépendante, en notant les outils selon nos critères de sélection.
Nos avis reflètent notre jugement éditorial humain, et non un argumentaire de vente.
Réviseurs experts:
- Paulo Gardini MiguelDirecteur technique
 Tim FisherVP de l'IA
 Gabriel RosasTech Lead et architecte logiciel
 Christhian GruhnTech Lead et architecte plateforme

Tableau comparatif des outils de gestion des données de test
Le tableau ci-dessous compare les tarifs de mes meilleurs outils de gestion des données de test.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Idéal pour le masquage conforme aux exigences réglementaires avec création automatique de sous-ensembles | Essai gratuit de 14 jours | Tarification sur demande | Website | |
| 2 | Idéal pour les données de test synthétiques natives des pipelines CI/CD | Démo gratuite disponible | Tarifs sur demande | Website | |
| 3 | Idéal pour gérer différents environnements de données de test depuis un emplacement centralisé | Essai gratuit de 14 jours | À partir de 15 000 € / utilisateur / an (facturation annuelle) | Website | |
| 4 | Idéal pour la GDT couvrant l'ensemble du cycle de vie avec clonage de bases de données | Démo gratuite disponible | Tarification sur demande | Website | |
| 5 | Idéal pour le masquage des données de test incluant les environnements mainframe | Non disponible | Tarification sur demande | Website | |
| 6 | Idéal pour les entreprises dotées d’environnements complexes | Essai gratuit de 30 jours disponible | Tarification sur demande | Website | |
| 7 | Meilleure création de sous-ensembles entre bases de données dans les secteurs réglementés | Démo gratuite disponible | Tarification sur demande | Website | |
| 8 | Idéal pour le masquage dans les pipelines comportant plusieurs bases de données | Démo gratuite disponible | Tarification sur demande | Website | |
| 9 | Idéal pour la conception visuelle des données fondée sur la couverture | Essai gratuit de 14 jours | Tarification sur demande | Website | |
| 10 | Idéal pour le clonage de bases de données de type Git sur cinq moteurs | Démo gratuite disponible | Tarification sur demande | Website |




Avis sur les meilleurs outils de gestion des données de test
Vous trouverez ci-dessous mes résumés détaillés des meilleurs outils de gestion des données de test qui figurent dans ma sélection. Mes avis présentent en détail les fonctionnalités clés, les avantages et inconvénients, les intégrations et les cas d’utilisation idéaux de chaque outil afin de vous aider à trouver celui qui vous convient le mieux.
 Idéal pour le masquage conforme aux exigences réglementaires avec création automatique de sous-ensembles
- Essai gratuit de 14 jours
- Tarification sur demande
Visit WebsiteCustomer Rating:4.3/5
Tonic masque et désidentifie les colonnes sensibles des bases de données pour des données de test sécurisées. Tonic Structural est une plateforme de gestion des données de test qui masque, crée des sous-ensembles et provisionne les données de production pour les environnements hors production, avec une prise en charge des bases de données relationnelles, des bases NoSQL, des entrepôts de données et des sources de fichiers.
À qui Tonic est-il le mieux adapté ?
Tonic Structural convient particulièrement aux équipes des secteurs de la santé et de la finance axées sur la conformité, qui doivent masquer et créer des sous-ensembles de données de production tout en conservant une documentation de confidentialité prête pour les audits.
Pourquoi ai-je choisi Tonic ?
Tonic figure sur ma liste restreinte, car ses fonctionnalités de masquage et de création de sous-ensembles sont étroitement couplées, ce que je vois rarement. J’apprécie la façon dont le Centre de confidentialité signale chaque colonne comme étant À risque, Protégée ou Non sensible, puis permet d’appliquer des générateurs en masse et d’exporter un rapport de confidentialité complet à des fins d’audit. Le créateur de sous-ensembles breveté gère automatiquement les clés étrangères virtuelles et les dépendances circulaires, de sorte que votre sous-ensemble masqué conserve l’intégrité référentielle, même dans des schémas complexes comportant plusieurs tables.
Fonctionnalités clés de Tonic
- Agent de structure : Un assistant conversationnel fondé sur l’IA intégré à l’application, qui résume les résultats des analyses de sensibilité, recommande des générateurs et les applique automatiquement à vos colonnes.
- Contrôles de confidentialité différentielle : Les générateurs catégoriels et continus prennent en charge la confidentialité différentielle, avec un budget de confidentialité configurable pour limiter l’inférence statistique à partir des données transformées.
- Sortie vers un référentiel de conteneurs : Structural écrit directement les données masquées et organisées en sous-ensembles sous forme de volumes de conteneurs pour PostgreSQL, MySQL et SQL Server, ce qui vous permet de lancer des bases de données isolées à la demande.
- Historique des versions : Enregistre chaque modification de la configuration de l’espace de travail : générateurs, règles de création de sous-ensembles, modes des tables et scripts post-traitement, avec attribution et possibilité de restaurer des versions antérieures.
Intégrations de Tonic
Tonic propose des intégrations natives avec PostgreSQL, MySQL, SQL Server, Oracle, MongoDB, Snowflake, BigQuery, Redshift, Databricks et Amazon S3. La plateforme prend également en charge l’API REST, GitHub Actions, Kubernetes, Helm et les référentiels de conteneurs, notamment Amazon ECR, Google Artifact Registry et Azure Container Registry.
Pros and Cons
Pros:
- Préserve les jointures entre des schémas complexes
- Le Centre de confidentialité recense les colonnes sensibles pour les audits
- Les données ressemblant à celles de la production conservent leurs relations statistiques
Cons:
- La synthèse à partir de zéro nécessite le produit Fabricate distinct
- Les bases de données conteneurisées nécessitent un déploiement Kubernetes
Learn more about Tonic: Idéal pour les données de test synthétiques natives des pipelines CI/CD
- Démo gratuite disponible
- Tarifs sur demande
Visit WebsiteCustomer Rating:4.6/5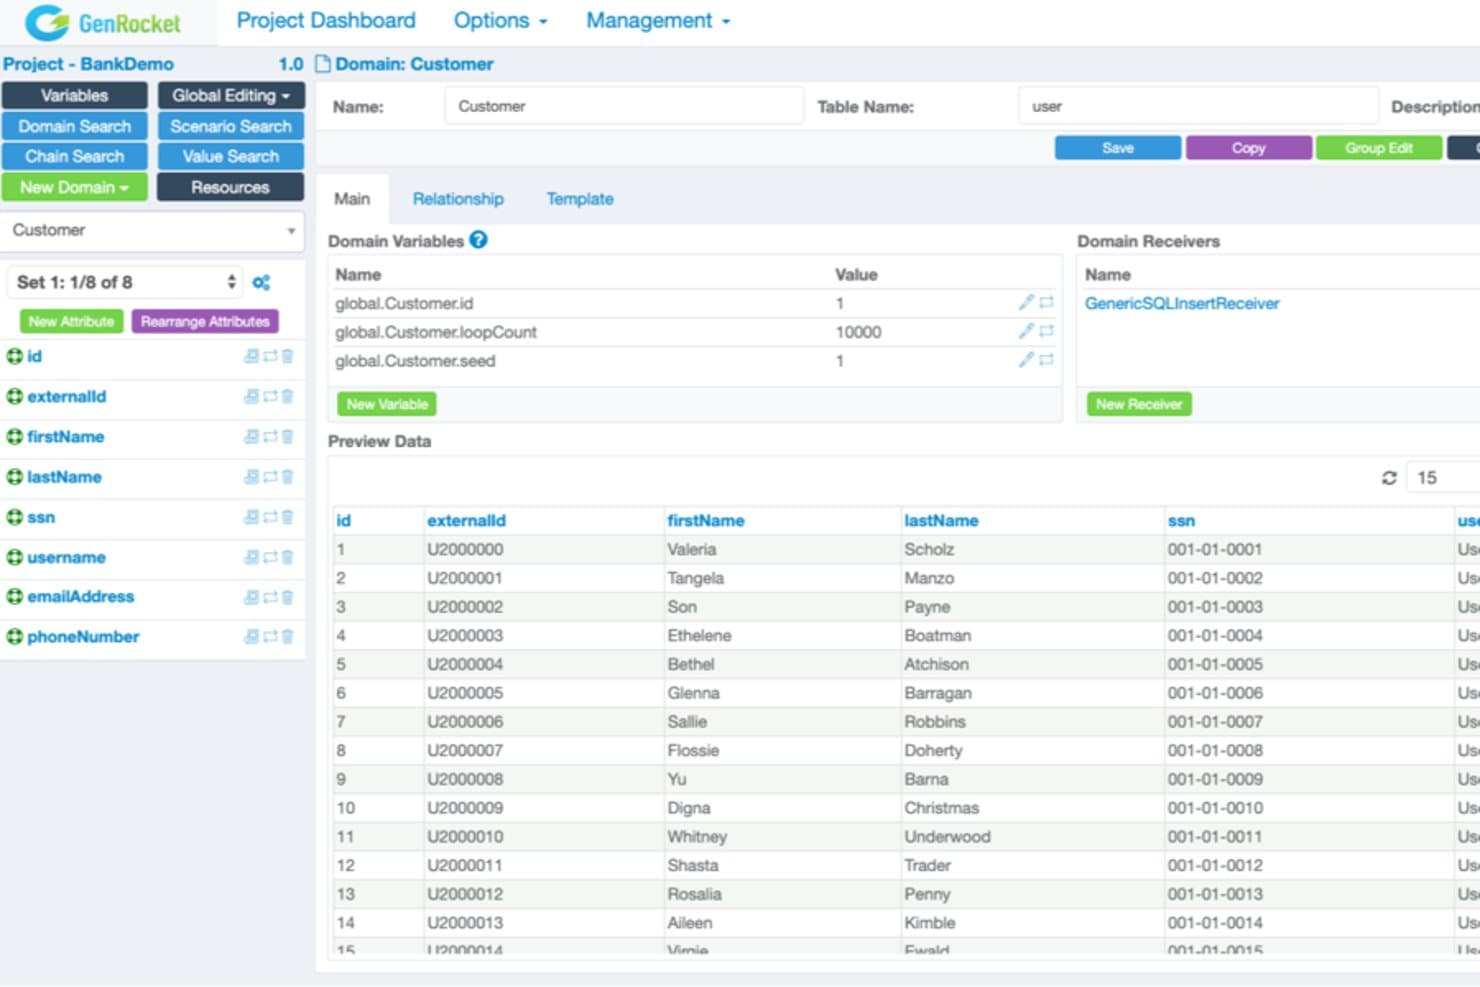
GenRocket permet aux utilisateurs de prévisualiser et de configurer visuellement les domaines de données de test. GenRocket est une plateforme de gestion des données de test synthétiques qui génère des données en temps réel à partir de métadonnées et de schémas, couvrant le masquage des données, le sous-ensemble intelligent, la sortie multiformat et le provisionnement en libre-service dans les pipelines CI/CD.
À qui GenRocket convient-il le mieux ?
GenRocket convient particulièrement aux équipes d’assurance qualité et de DevOps qui ont besoin de données de test synthétiques générées à la demande directement dans les pipelines CI/CD, sans jamais manipuler de données de production.
Pourquoi j’ai choisi GenRocket
GenRocket figure sur ma liste restreinte, car c’est la seule plateforme de données de test que j’ai vue conçue spécifiquement pour générer des données synthétiques en temps réel, directement dans un pipeline CI/CD, sans jamais manipuler de données de production. Son moteur breveté d’intégrité référentielle assure la cohérence des données entre plusieurs schémas et bases de données simultanément, ce qui est véritablement rare. J’apprécie également le fait que chaque jeu de données de cas de test soit généré en seulement 100 millisecondes au minimum, afin que l’exécution du pipeline ne soit pas ralentie par l’attente du provisionnement des données.
Fonctionnalités clés de GenRocket
- Détection des changements de schéma G-Delta : Identifie automatiquement les changements de schéma de base de données dans MySQL, MS SQL, Oracle et PostgreSQL, puis déclenche G-Refactor pour mettre à jour tous les cas de données de test concernés.
- Masquage sur place : Remplace les champs sensibles dans les bases de données Oracle, MS SQL Server, IBM DB2, PostgreSQL et MySQL par des équivalents générés synthétiquement, sans jamais lire les valeurs réelles de production.
- Portail en libre-service G-Portal : Fournit aux développeurs et aux testeurs une interface basée sur les rôles pour rechercher, demander, suivre et télécharger des cas de données de test sans solliciter une équipe centrale de données pour chaque demande.
- Plus de 750 générateurs de données intelligents : Couvre pratiquement tous les types de données, domaines ou règles métier, notamment la logique conditionnelle, les dépendances entre champs et les contraintes regex.
Intégrations de GenRocket
GenRocket s’intègre à Jenkins, Azure DevOps, TeamCity, CircleCI, GitHub, Cucumber, Selenium, JUnit, JMeter et LoadRunner. Il prend également en charge l’API REST, JDBC, SOAP, les sockets TCP/IP et le déploiement Docker pour les workflows CI/CD personnalisés.
Pros and Cons
Pros:
- La génération de données synthétiques préserve l’intégrité référentielle
- Provisionnement des données en temps réel pour les pipelines CI/CD
- Volume de données illimité sans cycles d’actualisation
Cons:
- Aucun masquage conservant le format ou réversible
- La détection des PII ne sera pas entièrement disponible avant {{year}}
Learn more about GenRocket: Idéal pour gérer différents environnements de données de test depuis un emplacement centralisé
- Essai gratuit de 14 jours
- À partir de 15 000 € / utilisateur / an (facturation annuelle)
Visit WebsiteCustomer Rating:4.5/5
Le masquage des données vous aide à préserver la confidentialité des informations sensibles de vos clients. DATPROF est une plateforme de gestion des données de test qui combine le masquage des données, le sous-ensemble de données, la génération de données synthétiques, la découverte des informations personnelles identifiables (PII), la virtualisation des bases de données et le provisionnement centralisé sur des sources de données relationnelles, NoSQL et cloud.
À qui DATPROF convient-il le mieux ?
DATPROF convient particulièrement aux ingénieurs de données et aux administrateurs de bases de données des entreprises moyennes à grandes qui gèrent des environnements complexes comportant plusieurs bases de données, où l'intégrité référentielle et la conformité sont non négociables.
Pourquoi j'ai choisi DATPROF
J'ai choisi DATPROF comme l'une des meilleures solutions, car son modèle de licence indépendant du volume le distingue véritablement : le coût de votre licence reste fixe, que vous masquiez 500 Go ou 100 To, ce qui est important lorsque vous créez un sous-ensemble d'une base de données de production comme celle de 23 To que Heineken a réduite à 130 Go. La détection brevetée des cycles de clés étrangères de DATPROF Subset gère des schémas complexes comportant plusieurs milliers de tables tout en préservant l'intégrité référentielle entre les systèmes. Ajoutez à cela l'orchestration centralisée du portail Runtime, et chaque membre de l'équipe peut provisionner son propre environnement actualisé sans attendre un administrateur de base de données.
Principales fonctionnalités de DATPROF
- Masquage déterministe entre systèmes : applique des valeurs masquées cohérentes pour une même entrée dans plusieurs bases de données simultanément, en préservant l'intégrité référentielle pour assurer la traçabilité des tests de bout en bout.
- Découverte et profilage des PII : analyse les bases de données afin d'identifier automatiquement où se trouvent les données sensibles, avec la prise en charge de règles de détection personnalisées utilisant des expressions régulières ou des expressions fondées sur des listes.
- Portail de provisionnement en libre-service : permet aux testeurs et aux développeurs de se connecter à DATPROF Runtime et d'actualiser eux-mêmes leurs environnements de test, sans attendre un administrateur de base de données.
- Clonage de bases de données par copie à l'écriture : DATPROF Virtualize déploie des environnements de bases de données virtuels de taille complète sans consommer d'espace de stockage supplémentaire, avec une restauration à partir d'un instantané effectuée en moins de 20 secondes.
Intégrations de DATPROF
DATPROF prend en charge les intégrations CI/CD avec Jenkins, Azure DevOps, GitLab et Bamboo, ainsi que les intégrations d'automatisation des tests avec Parasoft et Tosca. Son API REST prend en charge les intégrations personnalisées, et des offres sont disponibles sur Azure Marketplace et AWS Marketplace.
Pros and Cons
Pros:
- Le masquage préserve l'intégrité référentielle entre les bases de données
- Le sous-ensemble réduit efficacement les jeux de données de production volumineux
- Portail web basé sur les rôles pour l'actualisation en libre-service
Cons:
- Prise en charge native limitée des sources de données SaaS
- Aucune prise en charge des mainframes ni couverture étendue des bases de données NoSQL
Learn more about DATPROF: Idéal pour la GDT couvrant l'ensemble du cycle de vie avec clonage de bases de données
- Démo gratuite disponible
- Tarification sur demande

Enov8 offre une visibilité exécutive instantanée sur les PII dans les différentes sources de données. Enov8 est une plateforme de gestion des données de test qui couvre l'ensemble du cycle de vie de la GDT, notamment le profilage des données assisté par l'IA, le masquage, le sous-ensemble, la génération de données synthétiques et la virtualisation des bases de données grâce à son moteur de clonage vME.
À qui Enov8 convient-il le mieux ?
Enov8 convient particulièrement aux équipes DevOps et d'assurance qualité des secteurs réglementés qui ont besoin d'une plateforme unique pour gérer conjointement le masquage, le sous-ensemble, les données synthétiques et la virtualisation des bases de données.
Pourquoi ai-je choisi Enov8 ?
J'ai choisi Enov8 comme l'un des meilleurs outils parce que c'est le seul de ma liste qui associe une GDT couvrant l'ensemble du cycle de vie à son moteur de clonage de bases de données vME, lequel crée des copies de bases de données réalistes par rapport à la production d'environ 40 Mo par clone, quelle que soit la taille de la source. J'apprécie particulièrement le fait que le masquage, le sous-ensemble et la génération de données synthétiques alimentent directement la couche de virtualisation, de sorte que les clones respectent déjà les exigences de confidentialité avant d'être déployés dans un environnement de test.
Principales fonctionnalités d'Enov8
- Découverte des informations personnelles identifiables (PII) assistée par l'IA : Un moteur de profilage piloté par l'apprentissage automatique analyse automatiquement les sources de données connectées afin de classifier les champs sensibles et de signaler les colonnes présentant un risque réglementaire avant le début du masquage.
- Réservation des données de test : Un système de réservation intégré permet aux équipes de réserver et de gérer les jeux de données de manière centralisée, évitant ainsi les conflits entre les utilisateurs et les environnements simultanés.
- Analyse de validation post-masquage : Une analyse de validation alimentée par l'apprentissage automatique confirme l'efficacité du masquage après chaque opération de sécurisation et génère des preuves de conformité prêtes pour les audits.
- Centre d'intégration DevOps Manager : Une couche d'orchestration indépendante du langage qui héberge des scripts d'automatisation en Python, Bash, Ansible, Java et dans d'autres langages, reliant Enov8 aux pipelines CI/CD de Jenkins, GitLab CI/CD et Azure DevOps.
Intégrations d'Enov8
Enov8 prend en charge plus de 100 intégrations, notamment Jenkins, GitLab CI/CD, Azure DevOps, CircleCI, Travis CI, Bitbucket Pipelines, AWS CodeDeploy et Ansible. Son API REST, ses webhooks, son planificateur et la prise en charge de DevOps Manager permettent de créer des flux de travail CI/CD personnalisés.
Pros and Cons
Pros:
- Virtualisation des bases de données avec de minuscules clones de 40 Mo
- Découverte des PII et validation du masquage pilotées par l'IA
- La réservation centralisée des données de test évite les conflits d'allocation
Cons:
- Le volume d'avis publics est relativement limité
- Aucune attestation de conformité de tiers n'est répertoriée
Learn more about Enov8: Idéal pour le masquage des données de test incluant les environnements mainframe
- Non disponible
- Tarification sur demande

Broadcom Test Data Manager suit l'état des tâches d'importation dans une seule vue. Broadcom Test Data Manager est une plateforme de gestion des données de test destinée aux entreprises, qui combine le masquage des données, la génération de données synthétiques, le sous-ensemble de données, la découverte des informations personnelles identifiables (PII), la virtualisation des bases de données et la mise à disposition en libre-service, avec une prise en charge dédiée des environnements mainframe en parallèle des bases de données distribuées et cloud modernes.
À qui Broadcom Test Data Manager convient-il le mieux ?
Les grandes entreprises qui utilisent des environnements mainframe parallèlement à des systèmes distribués modernes tireront le meilleur parti de cette plateforme.
Pourquoi ai-je choisi Broadcom Test Data Manager ?
J'ai inclus Broadcom Test Data Manager dans ma sélection principale, car c'est la seule plateforme que j'ai vue qui traite les environnements mainframe comme des environnements de premier ordre, parallèlement aux systèmes distribués modernes. Son module CA TDM for Mainframe dédié vous permet de masquer et de sous-ensemble les données sur z/OS, VSAM et IMS depuis la même interface que celle utilisée pour SQL Server ou Oracle. La carte thermique automatisée des PII analyse des schémas mainframe entiers et signale les champs sensibles avant même que vous n'appliquiez une seule règle de masquage, ce qui réduit le travail de mappage manuel qui ralentit généralement les équipes chargées de la conformité.
Principales fonctionnalités de Broadcom Test Data Manager
- Portail de données en libre-service : Un catalogue centralisé où les testeurs demandent, réservent et libèrent des données de test à la demande à l'aide de formulaires dynamiques, sans devoir attendre les administrateurs de bases de données.
- Virtualisation des bases de données DAVE : Un moteur de clonage selon le principe de la copie à l'écriture qui crée en quelques minutes des clones de bases de données indépendants à partir d'une image de base partagée, avec une surcharge de stockage minimale.
- Automatisation des flux de travail Javelin : Un moteur d'automatisation visuelle intégré qui orchestre les tâches de masquage, de sous-ensemble et de mise à disposition, et qui peut être déclenché via une API REST ou des pipelines CI/CD.
- Préservation de l'intégrité référentielle : Les opérations de masquage et de sous-ensemble préservent les relations entre les tables afin que les jeux de données de test restent fonctionnellement cohérents pour les tests de bout en bout.
Intégrations de Broadcom Test Data Manager
Les intégrations documentées incluent Azure DevOps, CA Release Automation, CA Service Virtualization, CA BlazeMeter, CA Agile Requirements Designer, HP ALM et CA Agile Central. Les API REST prennent en charge les flux de travail CI/CD personnalisés, tandis que Docker et Kubernetes permettent les déploiements conteneurisés.
Pros and Cons
Pros:
- Masquage des données de test incluant les environnements mainframe
- Découverte automatisée des PII et cartes thermiques
- Virtualisation des bases de données selon le principe de la copie à l'écriture (DAVE)
Cons:
- Aucune option de déploiement SaaS disponible
- L'interface utilisateur semble obsolète et complexe
Learn more about Broadcom Test Data Manager: Idéal pour les entreprises dotées d’environnements complexes
- Essai gratuit de 30 jours disponible
- Tarification sur demande
Visit WebsiteCustomer Rating:4.5/5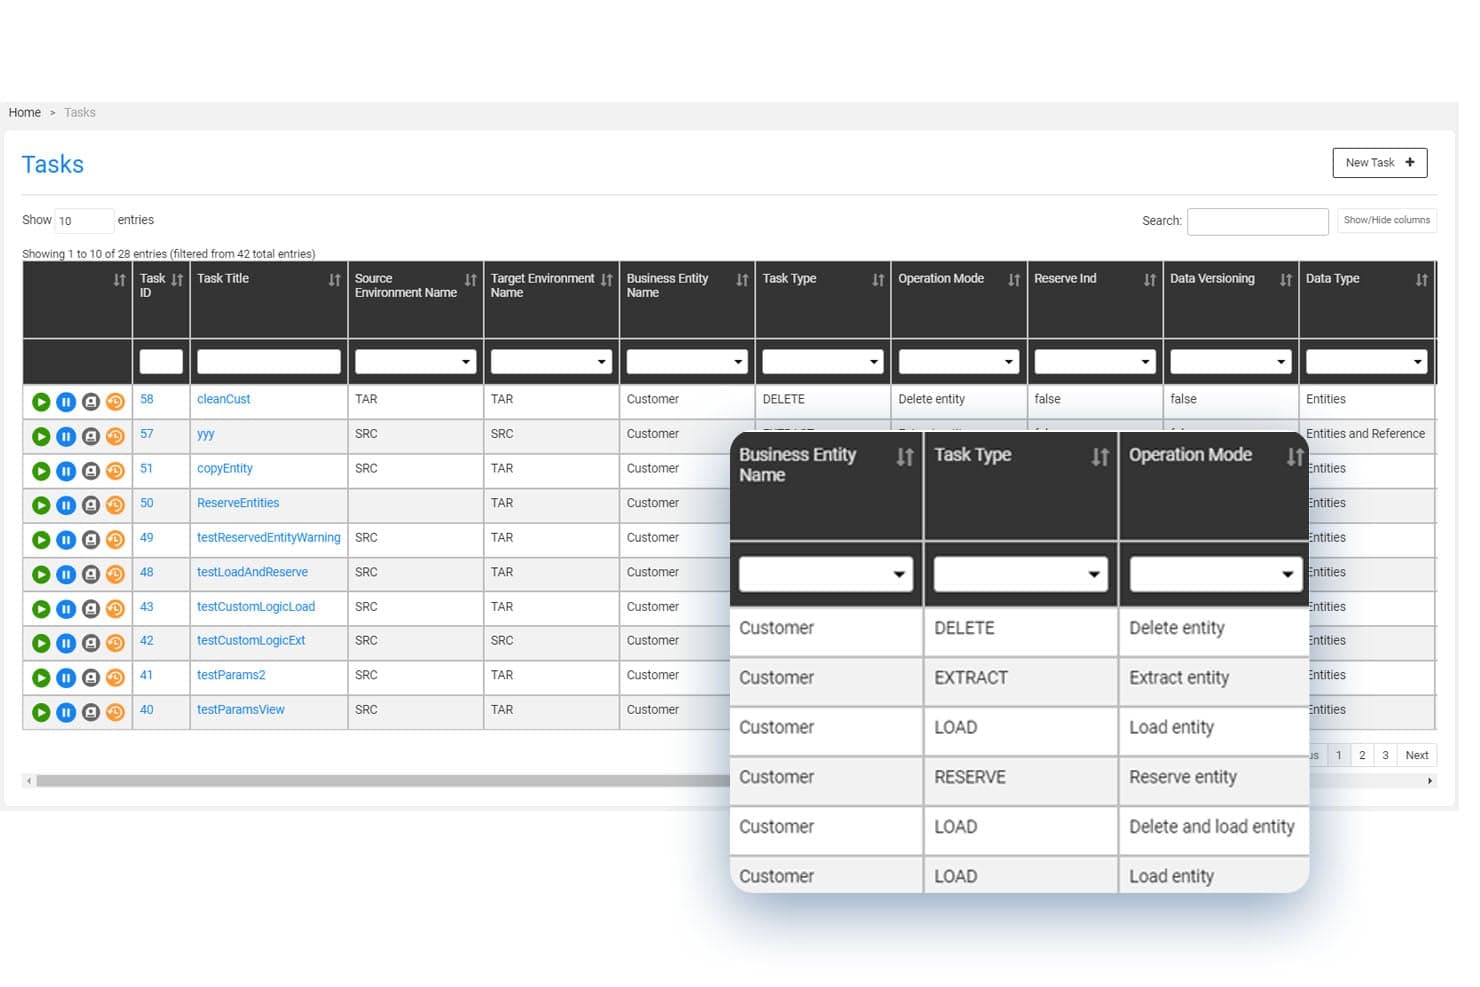
K2View Gestion des données de test permet aux utilisateurs de gérer et de filtrer les tâches de données par type et par mode d’opération. K2View Gestion des données de test est une plateforme TDM d’entreprise qui unifie le masquage des données, la génération de données synthétiques, le sous-ensemble de données et la mise à disposition en libre-service pour les sources de données relationnelles, NoSQL, de systèmes centraux et cloud grâce à une architecture brevetée Micro-Database™.
À qui s’adresse le mieux K2View Gestion des données de test ?
K2View est conçu pour les grandes entreprises qui gèrent des données de test dans des environnements mixtes — systèmes centraux, cloud, NoSQL et relationnels — simultanément.
Pourquoi j’ai choisi K2View Gestion des données de test
K2View mérite sa place dans ma sélection parce que son architecture brevetée Micro-Database™ résout un problème que la plupart des outils TDM contournent : préserver l’intégrité référentielle simultanément entre des sources de systèmes centraux, NoSQL et cloud. Je suis particulièrement impressionné par son masquage à la volée, ce qui signifie que les IIP sont masquées au moment de l’extraction et n’arrivent jamais sans masquage dans un environnement de test. Son sous-ensemble de données centré sur les entités permet aux équipes d’extraire en une seule opération un dossier client complet couvrant Oracle, Kafka et MongoDB, sans règles de jointure manuelles.
Fonctionnalités clés de K2View Gestion des données de test
- Portail TDM en libre-service : une interface web qui permet aux testeurs de demander, réserver et restaurer des données de test sans faire intervenir les équipes chargées des données ou les administrateurs de bases de données.
- Instantané et restauration avec la machine à remonter le temps : enregistre des états spécifiques des données de test à tout moment afin que les testeurs puissent restaurer instantanément les environnements dans une configuration connue.
- Découverte automatisée des IIP : des classificateurs intégrés analysent toutes les sources connectées, identifient les champs sensibles et recommandent ou appliquent automatiquement des politiques de masquage.
- TDM agentique : une fonctionnalité pilotée par l’IA qui lit les cas de test et assemble de manière autonome des jeux de données conformes, prêts à être mis à disposition, sans configuration manuelle.
Intégrations de K2View Gestion des données de test
K2View propose des connecteurs intégrés pour Oracle, SQL Server, PostgreSQL, DB2, MongoDB, Snowflake, Salesforce, Amazon S3, Kafka et les systèmes de systèmes centraux. La connectivité REST, JDBC et ODBC prend en charge les intégrations personnalisées et les workflows CI/CD avec Jenkins, GitHub Actions et Azure DevOps.
Pros and Cons
Pros:
- Le masquage à la volée empêche l’exposition d’IIP non masquées
- Le sous-ensemble de données centré sur les entités couvre les environnements de systèmes centraux et cloud
- Découverte automatisée des IIP intégrée à la plateforme
Cons:
- Non conçu pour les petites équipes
- L’intégration CI/CD basée sur une API nécessite une configuration
Learn more about K2View Test Data Management: Meilleure création de sous-ensembles entre bases de données dans les secteurs réglementés
- Démo gratuite disponible
- Tarification sur demande

IBM InfoSphere Optim vous aide à créer rapidement des données de test. IBM Test Data Management est une solution de gestion des données de test destinée aux entreprises, qui couvre le masquage des données, la création de sous-ensembles entre bases de données et la mise à disposition des données à la demande pour un large éventail de sources de données relationnelles et de systèmes centraux.
À qui IBM Test Data Management convient-il le mieux ?
IBM Test Data Management convient particulièrement aux grandes entreprises des secteurs réglementés—services financiers, santé et assurance—qui utilisent des environnements complexes comportant plusieurs bases de données ou des systèmes centraux, où le masquage des données et la création de sous-ensembles entre bases de données sont des exigences de conformité.
Pourquoi j'ai choisi IBM Test Data Management
IBM Test Data Management figure sur ma liste restreinte en raison de sa capacité à créer des sous-ensembles entre bases de données au niveau des objets métier, en extrayant simultanément des sous-ensembles conservant l'intégrité référentielle à partir de plusieurs bases de données interconnectées. Je suis particulièrement impressionné par sa capacité d'extraction fédérée, qui permet aux équipes de travailler sur des environnements de données hétérogènes, notamment avec des sources de systèmes centraux comme VSAM et IMS, où presque aucun outil concurrent ne fonctionne. Ses plus de 40 règles de masquage prédéfinies, avec une sortie préservant le format, les rendent réellement utiles dans les environnements réglementés par le GDPR et l'HIPAA.
Fonctionnalités clés d'IBM Test Data Management
- Intégration au Governance Catalog : Faites glisser-déposer des règles de classification des données directement sur les mappages de colonnes afin d'attribuer automatiquement des routines de masquage à partir d'un catalogue central de politiques.
- Environnement d'exécution Apache Spark : Un moteur Spark intégré prend en charge le traitement des données à grande échelle au sein des flux de travail automatisés de création de sous-ensembles et de masquage.
- Contrôle d'accès basé sur les rôles : Le contrôle d'accès basé sur les rôles, alimenté par Keycloak et prenant en charge LDAP, SAML, OIDC et Kerberos, contrôle les personnes autorisées à accéder aux jeux de données de test, à les demander et à les actualiser.
- Rapports de conformité : Les rapports intégrés valident l'application des politiques de confidentialité des données dans les environnements réglementés par le GDPR et l'HIPAA.
Intégrations d'IBM Test Data Management
Les intégrations documentées comprennent IBM Governance Catalog, IBM Cloud Pak for Data, Keycloak, Apache Spark, ainsi que des bases de données telles que Db2, Oracle, SQL Server, PostgreSQL, Snowflake, SAP, Teradata, Informix, Netezza et MongoDB dans une mesure limitée. Son API REST OpenAPI 2.0 prend en charge l'orchestration personnalisée et les flux de travail CI/CD, tandis que l'édition z/OS se connecte à VSAM et IMS.
Pros and Cons
Pros:
- Préserve l'intégrité référentielle entre les bases de données
- Le masquage préservant le format prend en charge les données réglementées
- Gère les sous-ensembles VSAM et IMS
Cons:
- Aucune génération native de données synthétiques
- Les copies physiques remplacent le clonage virtuel
Learn more about IBM Test Data Management: Idéal pour le masquage dans les pipelines comportant plusieurs bases de données
- Démo gratuite disponible
- Tarification sur demande

Tonic.ai permet aux utilisateurs de gérer les règles de masquage des données dans les tables de bases de données. Tonic.ai est une plateforme de gestion des données de test qui couvre le masquage et le sous-ensemble des données structurées, la rédaction des données non structurées et la génération de données entièrement synthétiques dans les bases de données relationnelles, les magasins NoSQL et les entrepôts de données cloud.
À qui Tonic.ai convient-il le mieux ?
Tonic.ai convient particulièrement aux ingénieurs data et aux administrateurs de bases de données qui gèrent des données de test dans des environnements complexes comportant plusieurs bases de données relationnelles, magasins NoSQL et entrepôts de données cloud.
Pourquoi ai-je choisi Tonic.ai ?
J'ai choisi Tonic.ai parmi les meilleures solutions, car son moteur de masquage déterministe applique des valeurs masquées cohérentes pour une même entrée dans PostgreSQL, MongoDB, Snowflake et toutes les autres sources de votre pipeline simultanément. Ainsi, un identifiant client masqué dans votre base de données relationnelle correspond à la même valeur masquée dans votre entrepôt de données et votre magasin de documents, ce qui préserve les jointures entre les systèmes. Son moteur de sous-ensemble breveté renforce cette capacité en extrayant des portions cohérentes du point de vue référentiel, ce qui a permis à eBay de réduire un jeu de données de 8 Po à un environnement de test propre de 1 Go sans rompre aucune relation entre les tables.
Principales fonctionnalités de Tonic.ai
- Détection automatisée des informations personnelles et de santé protégées : Analyse les sources de données connectées, détecte les champs sensibles et recommande des transformations de masquage sans mappage manuel colonne par colonne.
- Tonic Ephemeral : Déploie à la demande des bases de données isolées au sein des pipelines CI/CD à l'aide de connexions DNS directes, puis les supprime automatiquement une fois l'exécution des tests terminée.
- Détection des modifications de schéma : Identifie les colonnes nouvelles ou modifiées et peut bloquer automatiquement la génération de données afin d'empêcher toute fuite accidentelle d'informations personnelles dans les environnements de test.
- Préréglages de générateurs : Permet d'enregistrer et de réutiliser des règles de masquage et de transformation nommées à l'échelle globale dans les espaces de travail, afin de garantir la cohérence des politiques de masquage à grande échelle.
Intégrations de Tonic.ai
Tonic.ai propose une intégration native avec GitHub Actions, ainsi qu'une connectivité via API REST pour Jenkins et GitLab CI. La plateforme se connecte à PostgreSQL, MySQL, SQL Server, Oracle, MongoDB, DynamoDB, Snowflake, BigQuery, Redshift et Databricks.
Pros and Cons
Pros:
- Le moteur de sous-ensemble breveté préserve l'intégrité référentielle
- Masquage déterministe sur plusieurs plateformes de bases de données
- Détection automatisée des informations personnelles avec recommandations par IA
Cons:
- Aucune prise en charge native des sources de données mainframe
- La configuration initiale peut être complexe pour les grandes entreprises
Learn more about Tonic.ai: Idéal pour la conception visuelle des données fondée sur la couverture
- Essai gratuit de 14 jours
- Tarification sur demande

Curiosity Software visualise les relations entre les données au moyen d'un diagramme de partition radiale. Curiosity Software est une plateforme de gestion des données de test qui combine le masquage des données, la génération de données synthétiques, le sous-ensemble de données, la virtualisation et la mise à disposition en libre-service sur plus de 250 intégrations de sources, notamment des systèmes mainframe comme VSAM, IMS et CICS.
À qui Curiosity Software convient-il le mieux ?
Curiosity Software convient aux équipes d'assurance qualité d'entreprise et aux ingénieurs données travaillant dans des environnements complexes à sources multiples, en particulier ceux qui prennent en charge des systèmes mainframe ou gèrent à grande échelle des données de test soumises à des exigences de conformité.
Pourquoi j'ai choisi Curiosity Software
J'ai choisi Curiosity Software comme l'une des meilleures solutions, car son approche de la conception des données fondée sur la couverture la distingue véritablement. Au lieu de créer manuellement des scripts de règles pour les données de test, vous construisez des modèles visuels de flux de données qui encodent la logique métier et les contraintes, tandis que la plateforme identifie automatiquement les lacunes de couverture et génère des données synthétiques pour les combler. Je trouve l'utilitaire « Rechercher et créer » particulièrement utile : il localise les données existantes nécessaires à vos tests et génère des enregistrements synthétiques ciblés uniquement là où des lacunes subsistent, afin que vous ne surprovisionniez jamais vos données et ne travailliez jamais à l'aveugle.
Fonctionnalités clés de Curiosity Software
- Découverte automatisée des données personnelles : Analyse les sources de données connectées afin de localiser et de signaler automatiquement les champs sensibles avant la mise à disposition des données dans des environnements hors production.
- Portail de mise à disposition en libre-service : Un portail web permet aux équipes de demander et de mettre à disposition des données de test à la demande à l'aide de tâches paramétrées et réutilisables, sans faire intervenir l'équipe chargée des données de test.
- Intégration aux pipelines CI/CD : Les tâches de données de test peuvent être déclenchées dynamiquement via une API dans Jenkins, GitLab, GitHub, Azure DevOps et Bitbucket afin de fournir les données au moment opportun.
- Lignage des données fondé sur les graphes : Stocke les informations de traçabilité et de relations entre sources à l'aide de Neo4j, en produisant des représentations visuelles des pipelines qui mettent en évidence les clés étrangères, les jointures et les références orphelines.
Intégrations de Curiosity Software
Curiosity Software propose plus de 250 intégrations, notamment avec Oracle, SQL Server, Snowflake, Salesforce, VSAM, IMS, Jenkins, GitHub, GitLab et Azure DevOps. Ses API prennent en charge les intégrations personnalisées ainsi que la mise à disposition de données de test au moment opportun, déclenchée par CI/CD, dans des environnements cloud, sur site et hybrides.
Pros and Cons
Pros:
- Conception visuelle des données de test fondée sur des modèles
- Masquage et sous-ensemble des données mainframe inclus
- Découverte automatisée des données personnelles avec des fonctionnalités axées sur la conformité
Cons:
- Options de sous-ensemble moins détaillées dans la documentation
- Aucune certification SOC 2 ou ISO 27001 publiée
Learn more about Curiosity Software: Idéal pour le clonage de bases de données de type Git sur cinq moteurs
- Démo gratuite disponible
- Tarification sur demande

Redgate SQL Provision permet aux utilisateurs de gérer des clones de bases de données sur plusieurs instances SQL. Redgate SQL Provision est un outil de gestion des données de test qui couvre le masquage des données, la création de sous-ensembles et le clonage de bases de données de type Git pour SQL Server, PostgreSQL, MySQL, MariaDB et Oracle.
À qui Redgate SQL Provision convient-il le mieux ?
Redgate SQL Provision convient particulièrement aux DBAs et aux ingénieurs QA qui ont besoin d'un clonage et d'un masquage rapides de bases de données, avec contrôle de version, sur plusieurs moteurs relationnels.
Pourquoi ai-je choisi Redgate SQL Provision ?
J'ai choisi Redgate SQL Provision comme l'un des meilleurs outils, car son clonage de bases de données de type Git est véritablement différent de tout ce que j'ai pu voir sur cinq moteurs. Redgate Clone démarre un conteneur de données actif en quelques secondes, quelle que soit la taille de la base de données : une base SQL Server de 5 To est donc provisionnée aussi rapidement qu'une base de 128 Mo. Vous pouvez créer des branches, réinitialiser et enregistrer des révisions comme dans un flux de travail Git, ce qui permet de fournir facilement à chaque testeur son propre environnement isolé sans dupliquer le stockage.
Principales fonctionnalités de Redgate SQL Provision
- CLI d’anonymisation (
rganonymize) : un outil en ligne de commande en trois étapes qui classe les colonnes contenant des informations personnelles, associe des règles de masquage et remplace les valeurs réelles dans SQL Server, PostgreSQL, MySQL, MariaDB et Oracle. - Masquage déterministe : masque toujours une même valeur d'entrée avec une même valeur de sortie à l'aide d'une graine fixe, afin de conserver la cohérence des données masquées entre les tables associées.
- Création de sous-ensembles de données : l'interface CLI
rgsubsetextrait une portion configurable de votre base de données source — 10 % par défaut — tout en suivant les clés étrangères pour préserver l'intégrité référentielle. - Jeux de données personnalisés par IA : vous permet de décrire en langage courant les valeurs dont vous avez besoin et génère une liste vérifiable de 1 000 valeurs maximum à utiliser pour le remplacement lors du masquage.
Intégrations de Redgate SQL Provision
Redgate SQL Provision s'intègre à SQL Server, PostgreSQL, MySQL, MariaDB, Oracle, Docker, AWS CloudFormation, Azure Kubernetes Service, SQL Data Catalog, PowerShell et dbatools. Ses interfaces CLI prennent en charge les flux de travail CI/CD scriptés, mais les modules natifs pour Jenkins, Azure DevOps et GitHub Actions ne sont pas documentés.
Pros and Cons
Pros:
- La création de branches de type Git actualise rapidement les bases de données de test
- Le masquage déterministe préserve la cohérence entre les tables
- La création de sous-ensembles tenant compte des clés étrangères protège l'intégrité relationnelle
Cons:
- La génération de données synthétiques s'arrête aux listes de valeurs
- Le positionnement du produit crée de l'incertitude chez les acheteurs
Learn more about Redgate SQL Provision:
Autres outils de gestion des données de test
Voici quelques autres options d’outils de gestion des données de test qui ne figurent pas dans ma sélection, mais qui méritent tout de même votre attention :
- 11Perforce DelphixIdéal pour virtualiser des clones complets de bases de données de production
- 12SynthesizedIdéal pour le masquage des données de test natif SAP
- 13Tricentis ToscaIdéal pour les tests alimentés par l’IA
- 14InformaticaIdéal pour les tests d’entreprise
- 15BMC CompuwareIdéal pour les tests immédiats
- 16Rocket Data ExpressIdéal pour économiser des ressources de test
- 17Accelario Continuous DataOps PlatformIdéal pour la virtualisation de bases de données déclenchée par CI/CD
- 18Avo Test Data ManagementIdéal pour la génération rapide et fiable de données de test
- 19SynthoIdéal pour la génération de données synthétiques axée sur la confidentialité
- 20IRI VoracityIdéal pour masquer ensemble les données structurées et les données obscures
Comment j’évalue les outils de gestion des données de test
Je divise mon évaluation en trois parties, la fonctionnalité principale ayant le plus de poids : un outil doit masquer les données sensibles et générer des jeux de données synthétiques réalistes. Ensuite, j’examine les fonctionnalités remarquables, comme la découverte des données sensibles. Au-delà des fonctionnalités, je prends en compte la flexibilité du déploiement, l’assistance du fournisseur et la clarté de la tarification.
Fonctionnalité principale (critères essentiels pour cette liste)
Lorsque je sélectionne les outils de ma liste, j’attribue à chacun une note sur une échelle de 0 (la fonctionnalité n’est pas proposée) à 5 (excellence dans ce domaine) pour chacune des fonctionnalités principales présentées ci-dessous. Je convertis ensuite le total en pourcentage afin de mieux évaluer l’adéquation globale de chaque outil, en accordant un poids supplémentaire aux fonctionnalités que j’ai jugées essentielles.
- Masquage des données (essentiel) : Je vérifie si les techniques de masquage restent cohérentes entre les différentes sources, afin qu’un identifiant client masqué dans une table corresponde partout où il apparaît.
- Génération de données synthétiques (essentielle) : Je recherche des outils capables de produire des jeux de données statistiquement réalistes, et pas seulement des chaînes aléatoires, afin que les équipes d’assurance qualité puissent détecter les cas limites pendant les tests.
- Sous-ensemble de données : J’évalue la capacité d’un outil à extraire des jeux de données plus petits tout en préservant les relations entre clés étrangères dans des schémas complexes comportant plusieurs tables.
- Provisionnement des environnements de test : La rapidité des cycles de clonage et d’actualisation est essentielle ici. J’examine la vitesse à laquelle les équipes peuvent mettre en place un environnement vierge avant chaque sprint.
- Gestion de l’intégrité référentielle : Les relations rompues entre les tables invalident les résultats des tests. Je vérifie que les jointures et les contraintes sont conservées après les opérations de masquage ou d’extraction de sous-ensembles.
- Intégration aux pipelines : Je recherche des intégrations natives avec des outils d’intégration et de déploiement continus comme Jenkins ou GitLab, afin que le provisionnement des données s’effectue automatiquement en parallèle des étapes de compilation et de déploiement.
Une fois que j’ai établi une liste d’outils répondant aux critères, j’examine ce qui distingue chaque plateforme.
Facteurs de différenciation (ce qui distingue les fournisseurs)
Voici comment je compare les différents fournisseurs et fais ressortir leurs différences :
Fonctionnalités remarquables
Je recherche une génération de données pilotée par l’IA, capable d’apprendre les schémas de production et de produire des jeux de données synthétiques statistiquement fidèles, sans nécessiter la création manuelle de règles. La découverte des données sensibles est tout aussi importante, car la classification automatique des informations personnelles identifiables dans les différentes sources réduit les risques de non-conformité avant même le début du masquage. J’évalue également les données de test gérées par contrôle de version, qui permettent aux équipes de créer des branches et de restaurer des jeux de données entre les cycles de sprint.
Au-delà des fonctionnalités
J’évalue si un fournisseur propose des modèles de déploiement sur site, dans le cloud et hybrides, car les équipes des secteurs réglementés doivent souvent conserver les données derrière un pare-feu. La transparence des tarifs est tout aussi importante : certains fournisseurs facturent en fonction du volume de données, tandis que d’autres facturent par environnement, et cette distinction détermine la possibilité d’étendre l’adoption à plusieurs équipes produit. Je vérifie également la disponibilité d’un accompagnement à l’intégration et la qualité de la documentation, en particulier pour les organisations qui ne disposent pas d’une solide expertise interne en ingénierie des données.
Comment choisir un outil de gestion des données de test
Il est facile de se perdre dans de longues listes de fonctionnalités et des structures tarifaires complexes. Pour vous aider à rester concentré tout au long de votre processus personnalisé de sélection de logiciels, voici une liste de contrôle des facteurs à prendre en compte :
| Facteur | Points à prendre en compte |
|---|---|
| FacteurÉvolutivité | Points à prendre en compteL’outil évoluera-t-il avec votre équipe ? Tenez compte du volume futur de données et de la croissance du nombre d’utilisateurs. Recherchez des forfaits flexibles capables de s’adapter à cette croissance sans augmentation significative des coûts. |
| FacteurIntégrations | Points à prendre en compteFonctionne-t-il avec vos systèmes existants ? Vérifiez sa compatibilité avec vos outils de test, bases de données et flux de travail actuels afin d’éviter les perturbations. |
| FacteurPersonnalisation | Points à prendre en comptePouvez-vous adapter l’outil à vos besoins ? Vérifiez si l’outil permet de créer des modèles de données et des flux de travail personnalisés adaptés à vos processus. |
| FacteurFacilité d’utilisation | Points à prendre en compteEst-il convivial pour votre équipe ? Tenez compte de la courbe d’apprentissage et de la possibilité pour le personnel non technique de naviguer facilement dans l’outil sans formation approfondie. |
| FacteurMise en œuvre et intégration | Points à prendre en compteÀ quelle vitesse pouvez-vous commencer ? Recherchez des outils offrant une configuration rapide, des ressources de formation et une assistance afin de garantir une transition fluide. |
| FacteurCoût | Points à prendre en compteLe prix correspond-il à votre budget ? Comparez les modèles tarifaires et vérifiez l’absence de frais cachés. Vérifiez si un essai gratuit ou une démonstration est disponible pour tester l’outil avant de vous engager. |
| FacteurMesures de sécurité | Points à prendre en compteComment protège-t-il vos données ? Assurez-vous que l’outil respecte les normes de sécurité des données et propose un chiffrement ainsi que des contrôles d’accès pour protéger les informations sensibles. |
| FacteurExigences de conformité | Points à prendre en compteRépond-il aux exigences réglementaires ? Vérifiez si l’outil prend en charge la conformité aux réglementations pertinentes en matière de protection des données, telles que le RGPD ou la HIPAA, selon les exigences de votre secteur. |
Que sont les outils de gestion des données de test ?
Les outils de gestion des données de test sont des logiciels utilisés pour générer, gérer et maintenir des données destinées aux tests logiciels. Ils prennent en charge la création et la manipulation des données de test, en veillant à ce qu’elles soient exactes, sécurisées et adaptées à différents scénarios de test.
Ces outils jouent un rôle essentiel dans l’organisation et la mise à disposition des données pour les tests fonctionnels, de performance et de régression dans le développement logiciel, souvent en complément des outils de test de bases de données afin de garantir une validation complète des données.
Fonctionnalités
Lors de la sélection d’outils de gestion des données de test, surveillez les fonctionnalités clés suivantes :
- Masquage des données : Protège les informations sensibles en les remplaçant par des données fictives, garantissant ainsi le respect des exigences en matière de confidentialité.
- Sous-ensemble de données : Extrait un sous-ensemble de données à partir de jeux de données volumineux, rendant les tests plus faciles à gérer et plus efficaces.
- Capacités d’intégration : Se connecte aux outils de test et aux bases de données existants, facilitant des flux de travail fluides.
- Modèles de données personnalisés : Permet aux utilisateurs de créer des modèles adaptés à leurs besoins spécifiques en matière de tests, améliorant ainsi la flexibilité.
- Génération de données pilotée par l’IA : Utilise l’intelligence artificielle pour générer des données de test réalistes, améliorant la précision des tests.
- Mise à disposition des données en temps réel : Fournit un accès immédiat aux données de test requises, réduisant les retards dans le processus de test.
- Prise en charge multicloud : Permet à l’outil de fonctionner dans différents environnements cloud, offrant une grande flexibilité de déploiement.
- Chiffrement et contrôles d’accès : Garantit la sécurité des données en les chiffrant et en définissant les autorisations d’accès des utilisateurs.
- Ressources de formation : Propose des tutoriels, des webinaires et d’autres supports pédagogiques pour accompagner l’intégration des utilisateurs et l’adoption de l’outil.
- Prise en charge de la conformité : Contribue à garantir que le traitement des données respecte les normes et réglementations du secteur, telles que le RGPD ou HIPAA.
Avantages
La mise en œuvre d’outils de gestion des données de test offre plusieurs avantages à votre équipe et à votre entreprise. Voici quelques-uns des bénéfices dont vous pouvez profiter :
- Protection renforcée des données : Les fonctionnalités de masquage des données contribuent à protéger les informations sensibles et à garantir le respect des réglementations en matière de confidentialité.
- Efficacité accrue des tests : La mise à disposition des données en temps réel réduit les retards et permet d’accélérer les cycles de test.
- Précision accrue des données : La génération de données pilotée par l’IA crée des données de test réalistes, augmentant la fiabilité des résultats des tests.
- Réduction des coûts : La création de sous-ensembles de données extrait uniquement les données nécessaires, réduisant ainsi les coûts de stockage et de traitement.
- Flexibilité du déploiement : La prise en charge multicloud permet à l’outil de fonctionner dans différents environnements et de s’adapter aux besoins de votre infrastructure.
- Intégration conviviale des utilisateurs : L’accès aux ressources de formation et aux tutoriels favorise une adoption rapide et une utilisation efficace de l’outil.
- Conformité réglementaire : Les fonctionnalités de prise en charge de la conformité contribuent au respect des normes du secteur et réduisent le risque de problèmes juridiques.
Coûts & tarifs
La sélection d’outils de gestion des données de test nécessite de comprendre les différents modèles et forfaits tarifaires disponibles. Les coûts varient en fonction des fonctionnalités, de la taille de l’équipe, des modules complémentaires et d’autres facteurs. Le tableau ci-dessous récapitule les forfaits courants, leurs prix moyens et les fonctionnalités généralement incluses dans les solutions de gestion des données de test :
Tableau comparatif des forfaits pour les outils de gestion des données de test
| Type de forfait | Prix moyen | Fonctionnalités courantes |
|---|---|---|
| Type de forfaitForfait gratuit | Prix moyen$0 | Fonctionnalités courantesMasquage basique des données, sous-ensemble de données limité et capacités d’intégration limitées. |
| Type de forfaitForfait personnel | Prix moyen$5-$25/utilisateur/mois | Fonctionnalités courantesProtection renforcée des données, génération de données pilotée par l’IA et assistance de base. |
| Type de forfaitForfait professionnel | Prix moyen$30-$75/utilisateur/mois | Fonctionnalités courantesSous-ensemble avancé de données, prise en charge multicloud et accès aux ressources de formation. |
| Type de forfaitForfait entreprise | Prix moyen$100+/utilisateur/mois | Fonctionnalités courantesModèles de données personnalisés, prise en charge complète de la conformité, assistance client premium et capacités d’intégration complètes. |
FAQ sur les outils de gestion des données de test
Voici quelques réponses aux questions fréquentes sur les outils de gestion des données de test :
Devriez-vous choisir des fonctionnalités de masquage ou de données synthétiques ?
Le masquage protège les données réelles en dissimulant les informations personnelles. Les logiciels qui génèrent des données synthétiques créent des jeux de données fictifs, mais réalistes. Choisissez le masquage si vous utilisez des données de production ; choisissez les données synthétiques si vous souhaitez disposer de jeux de données de test plus sûrs et entièrement générés.
Si vous êtes encore dans la phase où vous devez « rassembler davantage de données de test », essayez : 10 meilleurs outils de test d’utilisabilité pour recueillir les commentaires des utilisateurs réels.
Pourquoi la sécurité des données est-elle importante dans les outils de TDM ?
Les logiciels de TDM traitent souvent des données de production sensibles. Sans masquage ni chiffrement appropriés, vous vous exposez à des fuites de données ou à des problèmes de conformité. Choisissez toujours un outil prenant en charge le chiffrement, l’anonymisation et les contrôles d’accès.
Quelles intégrations un outil de TDM doit-il prendre en charge ?
Il doit fonctionner avec vos outils CI/CD tels que Jenkins, GitLab ou Azure DevOps. L’intégration avec les principales bases de données (Oracle, SQL Server, PostgreSQL) et les plateformes cloud est également essentielle pour une automatisation fluide.
Comment tester un outil de TDM avant de l’acheter ?
Réalisez une petite preuve de concept. Essayez de cloner, de masquer et d’actualiser les données dans votre environnement réel. Vérifiez sa rapidité d’exécution et sa compatibilité avec votre flux de travail existant.
Comment les outils de TDM peuvent-ils contribuer à la conformité ?
Les bons outils suivent chaque modification des données, tiennent des journaux d’audit et garantissent la cohérence des données masquées. Cela aide votre équipe à rester conforme à des réglementations telles que le RGPD, l’HIPAA ou la CCPA.