

10 meilleurs logiciels de vision par ordinateur en 2026
Sélection des meilleurs logiciels de vision par ordinateur


Les logiciels de vision par ordinateur vous fournissent les outils nécessaires pour extraire, analyser et interpréter des informations à partir d’images ou de vidéos à l’aide de l’IA. Si vous recherchez la meilleure façon d’automatiser les tâches liées aux données visuelles ou de déployer la vision industrielle en tant que débutant dans vos projets, il est essentiel de choisir une solution adaptée à vos flux de travail et capable de répondre à vos besoins de mise à l’échelle.
Dans ce guide, vous découvrirez un aperçu ciblé des plateformes riches en fonctionnalités pour l’étiquetage, l’entraînement, le déploiement et la gestion des modèles de vision par ordinateur, afin d’avancer rapidement et de prendre des décisions éclairées.
Pourquoi faire confiance à nos avis logiciels
Nous testons et analysons des logiciels depuis 2023. En tant que dirigeants technologiques, nous savons à quel point il est crucial et difficile de faire le bon choix lors de la sélection d’un logiciel.
Nous investissons dans des recherches approfondies pour aider notre audience à prendre de meilleures décisions d’achat de logiciels. Nous avons testé plus de 2 000 outils pour différents usages technologiques et rédigé plus de 1 000 avis complets. Découvrez comment nous restons transparents & notre méthodologie d’évaluation des logiciels.
Résumé des meilleurs logiciels de vision par ordinateur
Ce tableau comparatif récapitule les informations tarifaires relatives à ma sélection des meilleurs logiciels de vision par ordinateur afin de vous aider à trouver la solution la mieux adaptée à votre budget et aux besoins de votre entreprise.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Idéal pour gérer de grandes équipes d'annotation | Démo gratuite disponible | Tarification sur demande | Website | |
| 2 | Idéal pour l'analyse d'images et de vidéos cloud-native | Niveau gratuit de 12 mois disponible | À partir de $0.001/image | Website | |
| 3 | Idéal pour la reconnaissance visuelle sectorielle | Démo gratuite disponible | Tarification sur demande | Website | |
| 4 | Idéal pour l'annotation intégrée d'images et de vidéos | Démo gratuite disponible | Tarif sur demande | Website | |
| 5 | Idéal pour concevoir des pipelines IA de vision de bout en bout | Plan gratuit + démo gratuite disponible | À partir de $30/mois | Website | |
| 6 | Idéal pour un déploiement rapide de modèles sur des jeux de données personnalisés | Formule gratuite + essai gratuit + démo gratuite disponible | À partir de $99/mois | Website | |
| 7 | Idéal pour l'annotation automatisée de données à grande échelle | Démo gratuite disponible | Prix sur demande | Website | |
| 8 | Idéal pour les workflows avancés d’annotation de données | Essai gratuit disponible | Tarification sur demande | Website | |
| 9 | Idéal pour la gestion à grande échelle du cycle de vie des modèles d’IA | Essai gratuit de 14 jours disponible | Tarification sur demande | Website | |
| 10 | Idéal pour des services d'annotation de niveau entreprise | Démo gratuite disponible | Tarification sur demande | Website |

Avis sur les meilleurs logiciels de vision par ordinateur
Vous trouverez ci-dessous mes résumés détaillés des meilleurs logiciels de vision par ordinateur qui ont été retenus dans ma sélection. Mes avis présentent en détail les fonctionnalités, les meilleurs cas d’utilisation et les intégrations de chaque plateforme afin de vous aider à trouver celle qui vous convient le mieux.

Idéal pour gérer de grandes équipes d'annotation
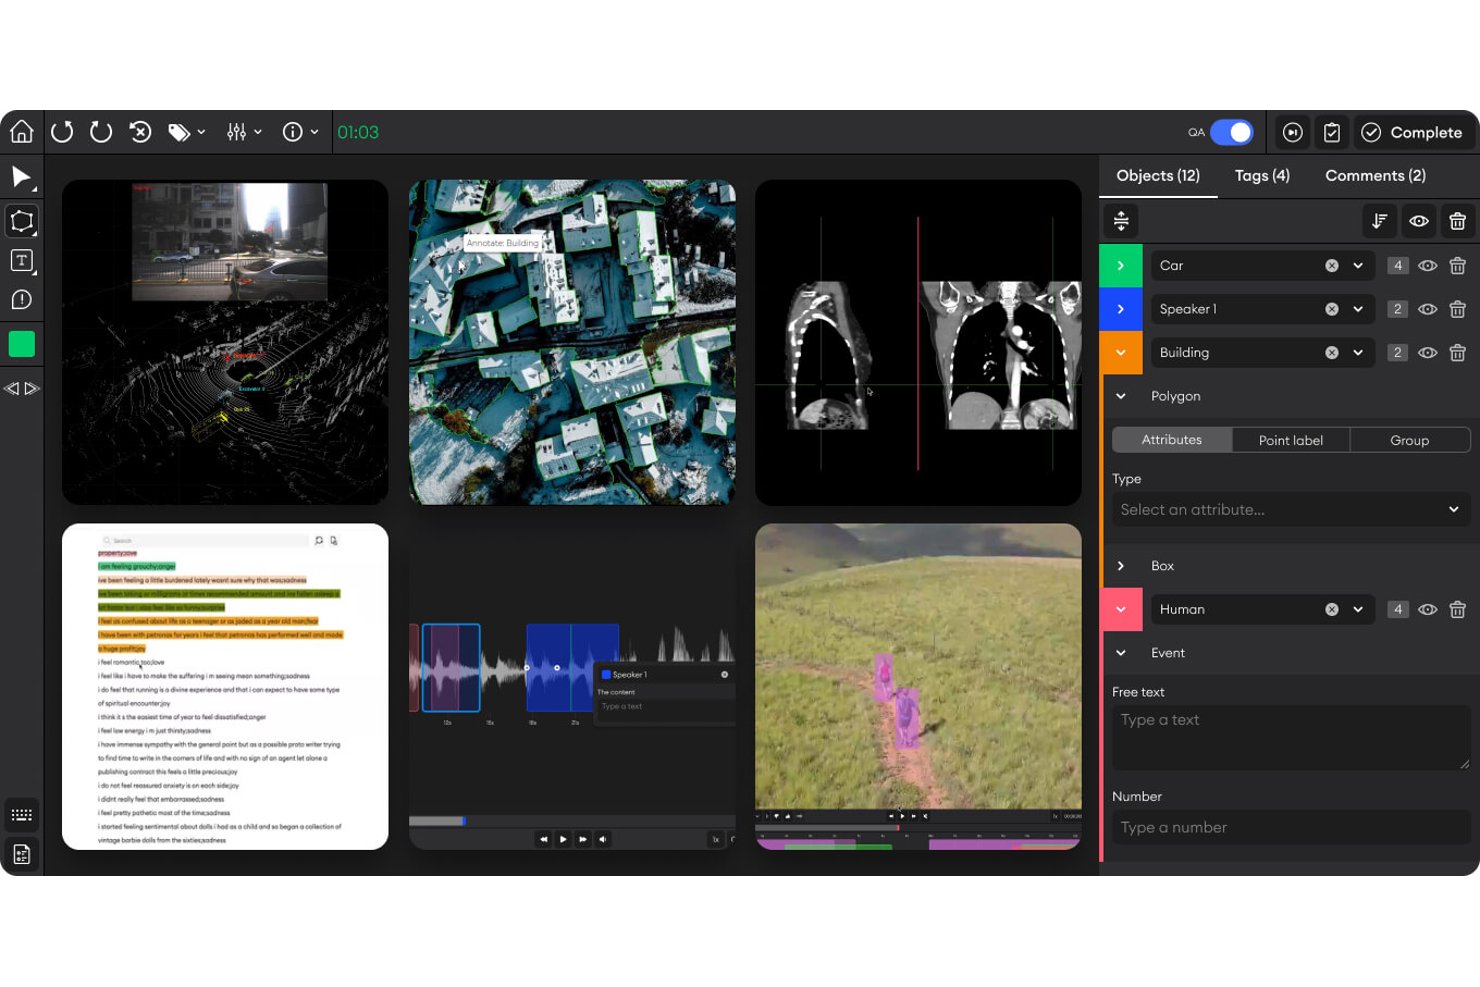
SuperAnnotate est une plateforme de gestion de projets d'annotation conçue pour les équipes de vision par ordinateur, offrant des outils avancés pour l'étiquetage des données image, vidéo, texte et audio, la collaboration et les flux de travail d'assurance qualité.
Pour qui SuperAnnotate est-il le mieux adapté ?
Responsables d'annotation et chefs de data science dans les entreprises coordonnant de grandes équipes distribuées pour des projets d'étiquetage de données de vision par ordinateur.
Pourquoi j'ai choisi SuperAnnotate
J'ai choisi SuperAnnotate parmi les meilleurs car mon équipe compte sur ses outils de gestion d'annotations avancés pour coordonner de grandes équipes, appliquer des flux d'assurance qualité sur des images et des vidéos, et suivre l'avancement des projets à grande échelle. Ses fonctionnalités de collaboration nous permettent de gérer efficacement des pipelines de données complexes.
Fonctionnalités clés de SuperAnnotate
- Support d'annotation multimodal : Étiquetez des images, vidéos, textes et données audio dans des projets unifiés.
- SDK Python et API : Automatisez l'importation, l'exportation et l'intégration des données dans des pipelines de ML personnalisés.
- Configuration avancée de taxonomie des labels : Créez des structures d'étiquetage complexes et hiérarchiques adaptées à chaque projet.
- Gestion intégrée des fournisseurs et des équipes : Organisez les tâches entre équipes internes et prestataires d'annotation externes.
Intégrations SuperAnnotate
SuperAnnotate propose des intégrations natives avec AWS S3, GCP, Nvidia, Databricks, Snowflake et IBM Cloud. Un SDK Python et une API REST sont disponibles pour des intégrations personnalisées dans des pipelines d'apprentissage automatique existants.
Pros and Cons
Pros:
- Annotation multimodale sur une seule plateforme
- Flux de travail collaboratifs et QA avancés
- Gestion des fournisseurs et des équipes incluse
Cons:
- Pas de capacité d'entraînement de modèle intégrée
- Rapports limités aux métriques centrées sur l'annotation

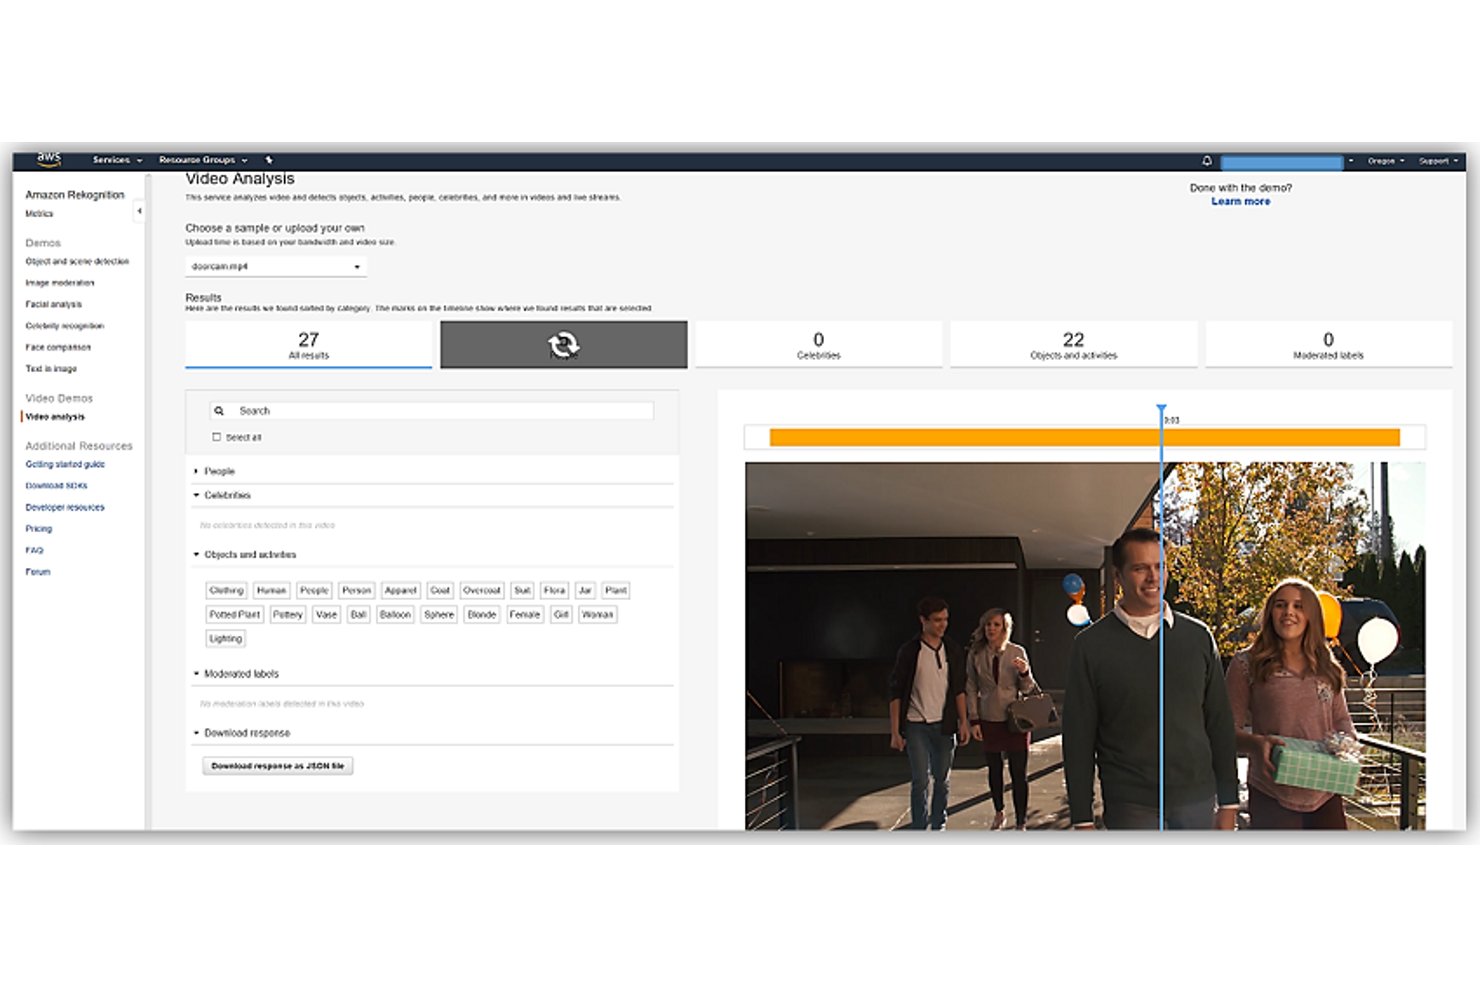
Amazon Rekognition est une plateforme de vision par ordinateur basée sur le cloud, qui propose l'analyse d'images et de vidéos, la détection d'objets et de visages, la modération de contenu, l'étiquetage de scènes, ainsi qu'un support pour la création de modèles de vision personnalisés.
Pour qui Amazon Rekognition est-il le mieux adapté ?
Les équipes qui gèrent une analyse d'images ou de vidéos à grand volume sur l'infrastructure AWS ou qui développent des workflows de vision par ordinateur cloud-native et évolutifs.
Pourquoi j'ai choisi Amazon Rekognition
J'ai choisi Amazon Rekognition parmi les meilleurs car je peux analyser d'énormes ensembles de données d'images et de vidéos directement dans le cloud. Je compte sur son analyse en temps réel des flux vidéo et sa classification personnalisée d'images pour automatiser la modération de contenu et la reconnaissance faciale dans des projets de grande envergure.
Fonctionnalités clés d'Amazon Rekognition
- Comparaison et recherche de visages : Faire correspondre les visages dans des images ou des vidéos avec des collections à grande échelle.
- Détection de texte (OCR) : Identifier et extraire du texte dans des images comportant plusieurs écritures et formats.
- Modération d'images : Détecter le contenu explicite, suggestif ou dangereux des images grâce à des classificateurs pré-entraînés.
- Reconnaissance de célébrités : Taguer automatiquement des personnalités publiques connues sur des photos et des vidéos.
Intégrations Amazon Rekognition
Amazon Rekognition propose des intégrations natives dans tout l'écosystème AWS, y compris S3, Lambda, Kinesis, SageMaker Ground Truth, SNS et SQS. Une API est disponible pour des intégrations personnalisées.
Pros and Cons
Pros:
- Modèles pré-entraînés pour les tâches d'imagerie courantes
- Capacités d'analyse vidéo et image en temps réel
- S'adapte au traitement à haut volume dans le cloud
Cons:
- Pas d'option de déploiement hors ligne ou sur site
- Absence de fonctionnalités de segmentation au niveau du pixel
Idéal pour la reconnaissance visuelle sectorielle
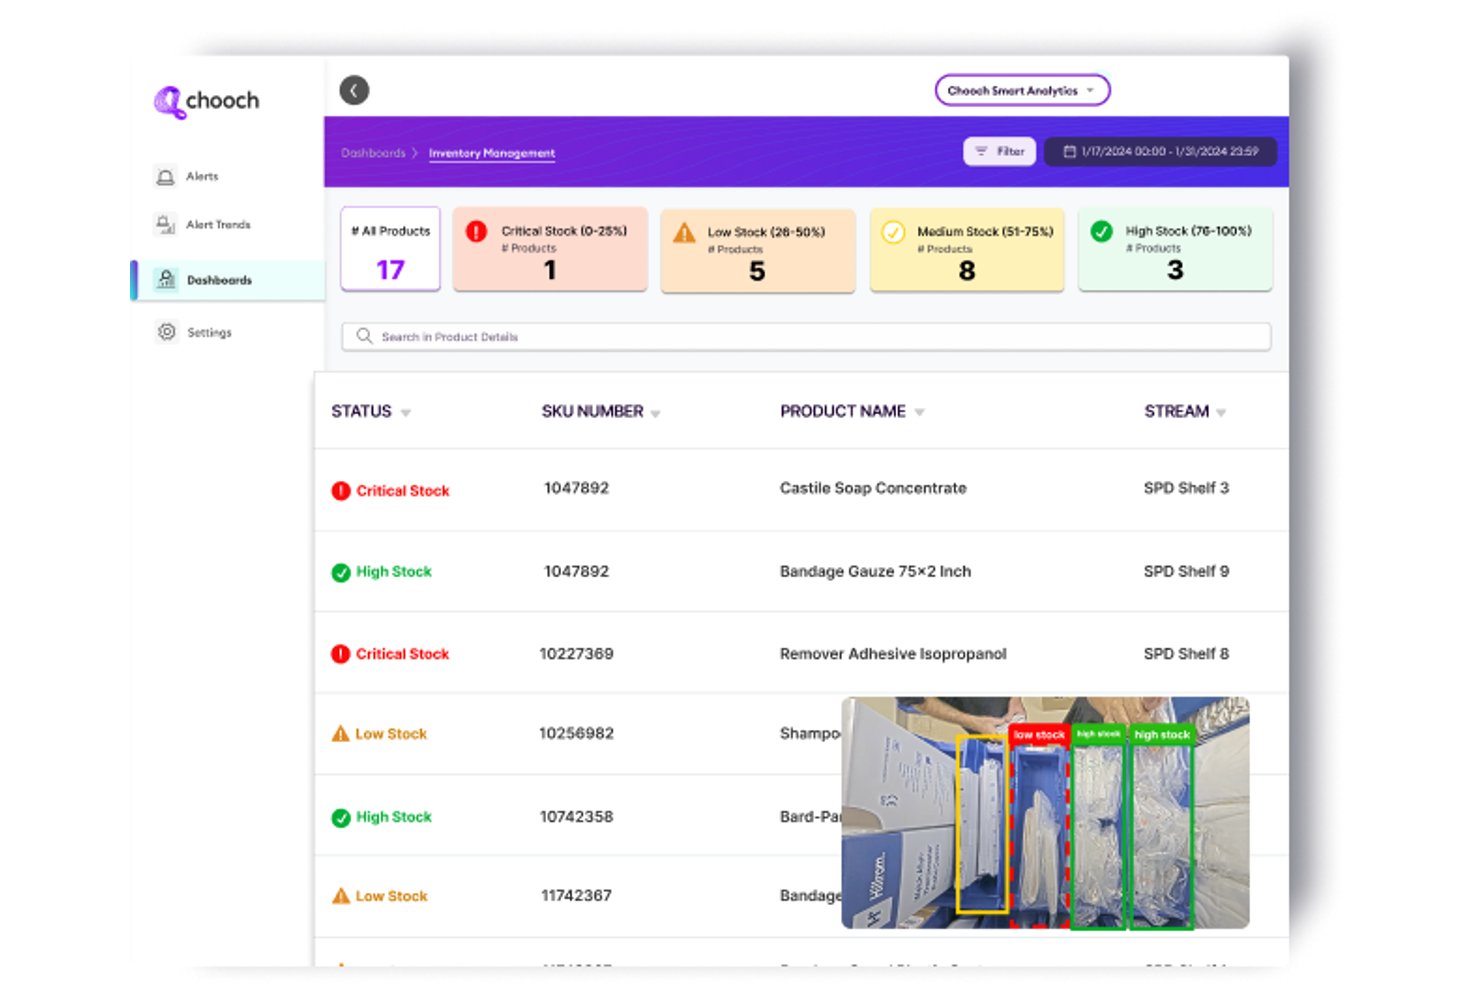
Chooch AI est une plateforme de vision par ordinateur conçue pour les organisations ayant besoin d’un entraînement personnalisé, d’une annotation rapide et d’un déploiement de modèles à grande échelle sur le cloud, l’edge et sur site.
À qui s’adresse Chooch AI ?
Chooch AI s’adresse aux ingénieurs ML et aux équipes informatiques dans les secteurs manufacturier, médical ou industriel qui ont besoin d’une reconnaissance visuelle adaptée à des environnements complexes.
Pourquoi j’ai choisi Chooch AI
J’ai choisi Chooch AI parmi les meilleurs car il propose des modèles de reconnaissance visuelle préconfigurés, adaptés à la santé, à l’industrie et à la sécurité publique. Mon équipe déploie ces modèles sur des périphériques edge pour la détection en temps réel dans des cas industriels.
Fonctionnalités clés de Chooch AI
- Annotation intelligente : Étiquette automatiquement les objets dans les images et vidéos à l’aide de boîtes englobantes et de polygones.
- Apprentissage continu : Permet le réentraînement des modèles déjà déployés avec de nouvelles données afin d’en améliorer la précision.
- Déploiement edge : Exécute les modèles de vision sur des appareils comme Nvidia Jetson pour un traitement à faible latence.
- API et SDK intégrés : Fournit une API REST et des SDK pour accéder aux capacités de vision par ordinateur et les intégrer dans les applications.
Intégrations Chooch AI
Les intégrations natives ne sont pas publiquement répertoriées. Chooch AI fournit une API et des SDK pour développer des intégrations personnalisées.
Pros and Cons
Pros:
- Modèles de reconnaissance visuelle prêts à l’emploi disponibles pour l’industrie
- Compatible avec le déploiement sur edge, cloud, sur site
- Entraînement de modèles d’IA personnalisés pour des jeux de données uniques
Cons:
- Peu d’avis d’utilisateurs tiers publics
- L’analyse avancée 3D ou temporelle est limitée

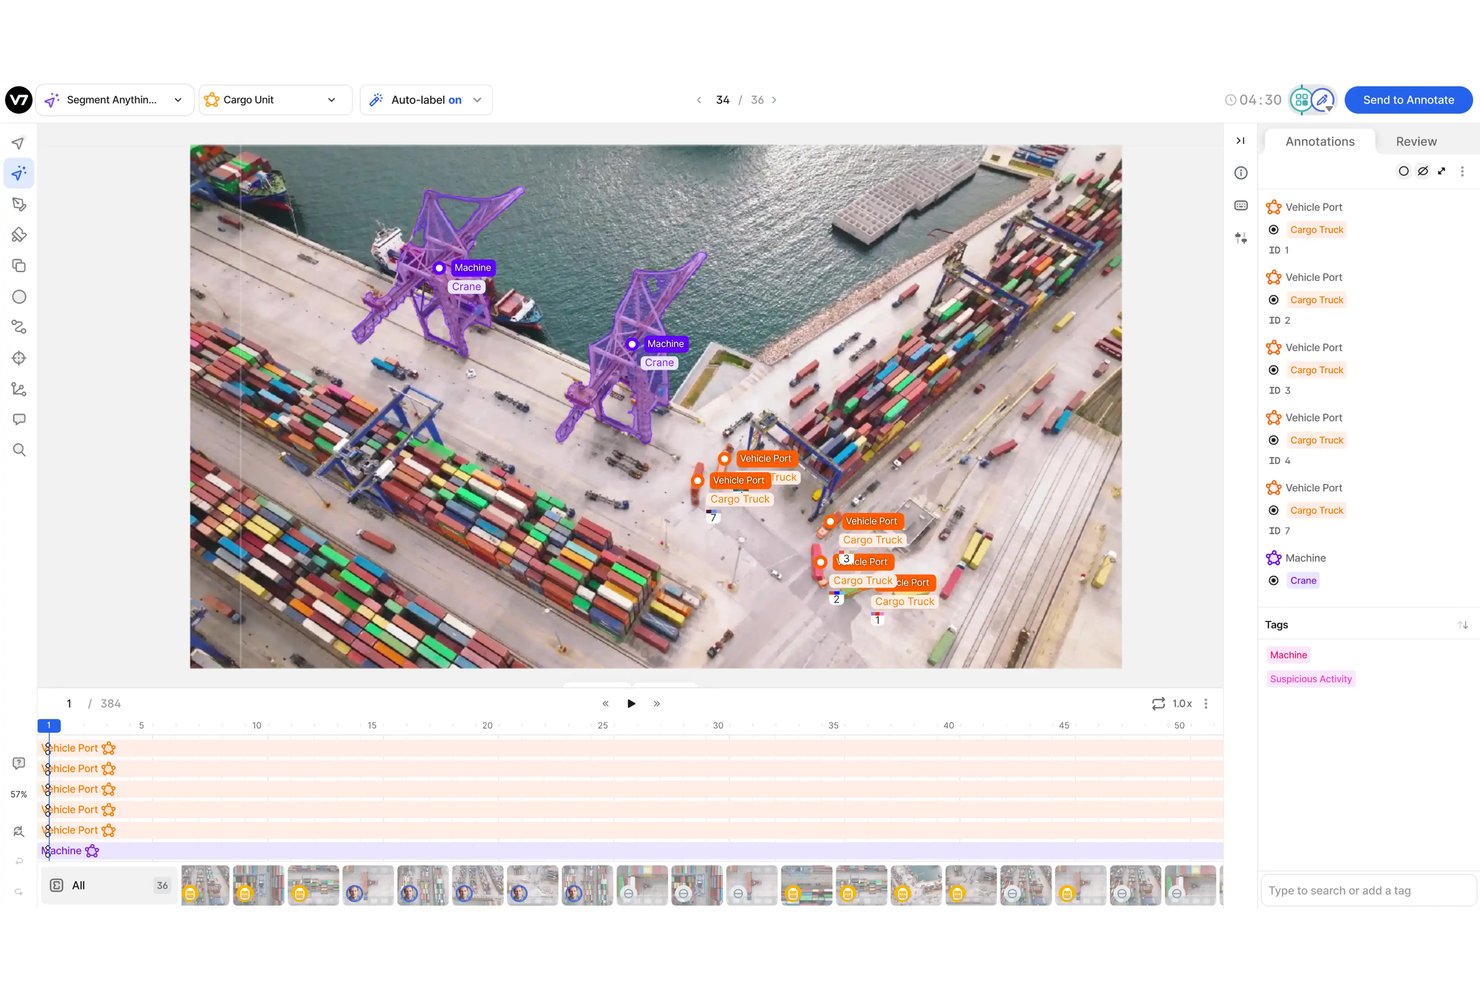
V7 est une plateforme de vision par ordinateur conçue pour les équipes ayant besoin d'outils avancés pour l'étiquetage, l'annotation et la gestion de grands volumes d'images et de vidéos.
À qui s'adresse V7 ?
Idéal pour les équipes de machine learning et de science des données dans des secteurs tels que la santé, l'automobile ou l'industrie, qui nécessitent des workflows d'annotation d'images et de vidéos détaillés.
Pourquoi ai-je choisi V7
J'ai sélectionné V7 comme l'un des meilleurs car il me permet de gérer des projets complexes d'annotation d'images et de vidéos dans un espace de travail unique. J'utilise des outils intégrés comme l'auto-étiquetage avec des modèles de segmentation et le suivi d'objets dans les vidéos, tous intégrés dans un workflow de relecture et d'assurance qualité.
Fonctionnalités clés de V7
- Workflows de consensus et d'assurance qualité : Attribuez des tâches d'annotation et gérez des processus d'examen multi-niveaux pour le contrôle qualité.
- Versionnage des ensembles de données : Suivez les modifications et maintenez différentes versions des ensembles de données annotées pour l'audit et la reproductibilité.
- Prise en charge des images médicales et du format DICOM : Annotez et gérez directement sur la plateforme des formats médicaux spécialisés comme DICOM et NifTI.
- SDK Python et API REST : Intégrez la gestion de jeux de données et des pipelines d'annotation dans vos workflows ML personnalisés ou d'automatisation.
Intégrations V7
V7 propose des intégrations natives avec AWS et Google Cloud, et propose une API pour créer des intégrations personnalisées.
Pros and Cons
Pros:
- Prend en charge les formats médicaux comme DICOM et NifTI
- Annotation d'objet et d'image par image intégrée pour la vidéo
- Workflows personnalisables d'assurance qualité et de consensus
Cons:
- Aucune fonctionnalité intégrée d'entraînement de modèle
- Prise en charge limitée pour l'annotation 3D et lidar
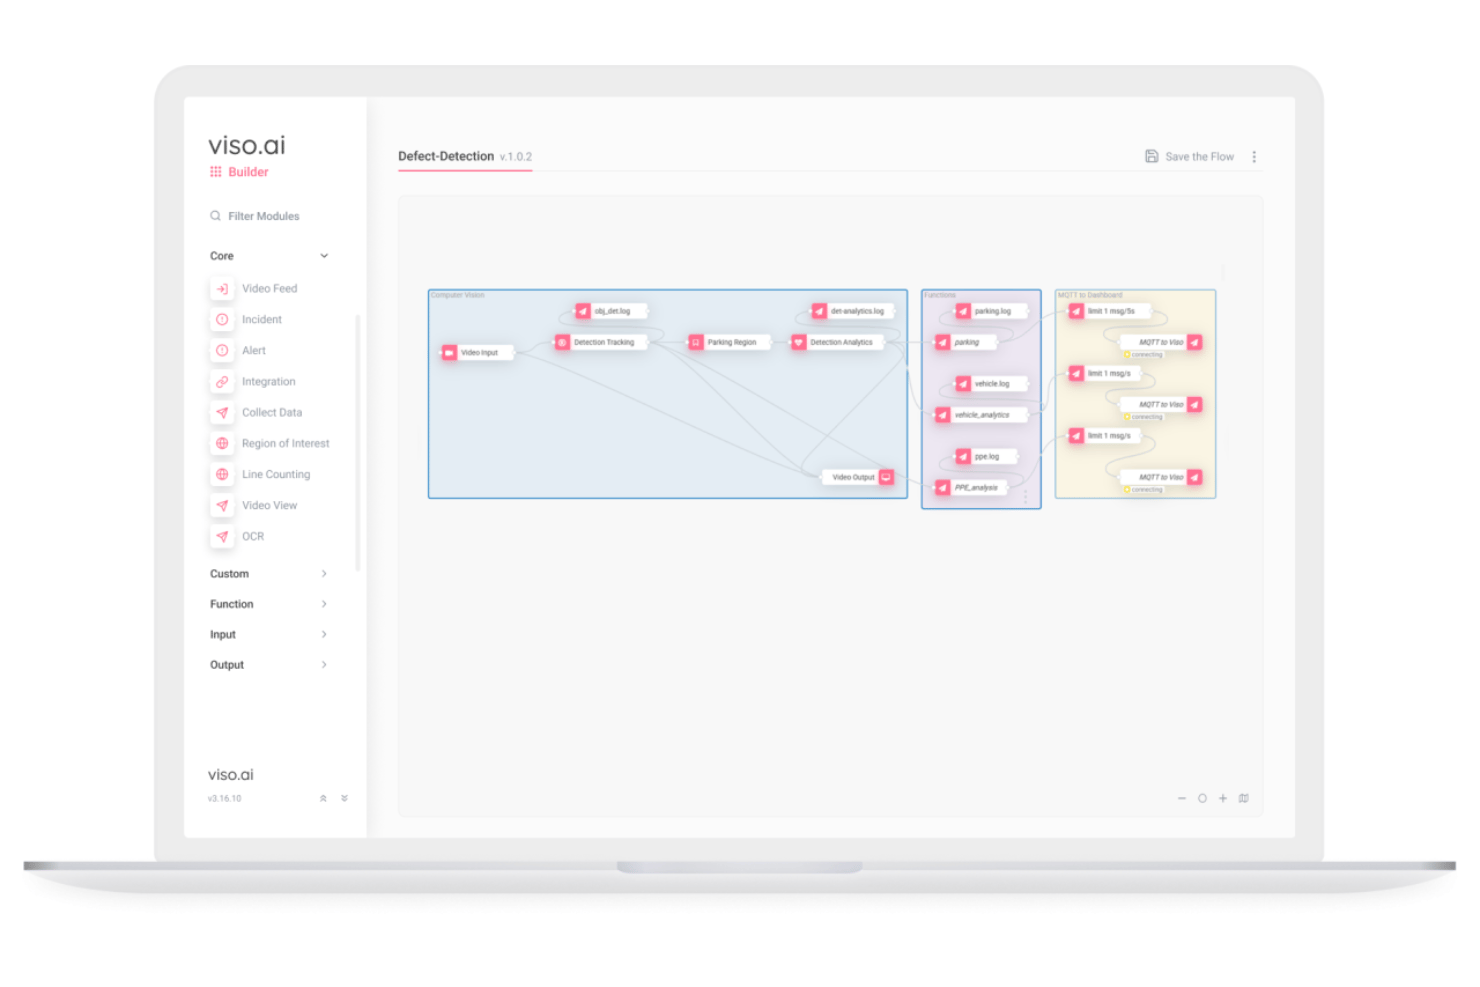
Viso Suite est une plateforme de vision par ordinateur de bout en bout permettant de créer, entraîner, déployer et gérer des pipelines de vision IA à grande échelle sur des environnements edge, sur site et cloud.
À qui Viso Suite convient-il le mieux ?
Les entreprises et équipes informatiques qui déploient des flux de travail d'IA visuelle à grande échelle sur plusieurs sites, secteurs d’activité et environnements d’infrastructure edge ou hybrides.
Pourquoi ai-je choisi Viso Suite
J’ai choisi Viso Suite parmi les meilleurs car je peux concevoir, déployer et gérer des pipelines complets de vision IA, depuis la collecte de données jusqu’à l’inférence en temps réel, dans un environnement unifié. Le générateur de workflows sans code et la prise en charge du déploiement edge, cloud et sur site rendent les projets à grande échelle réalisables.
Fonctionnalités clés de Viso Suite
- Modèles avancés de détection d’objets : Choisissez parmi une bibliothèque de modèles de pointe pour des tâches complexes de reconnaissance visuelle.
- Workflows d’annotation collaboratifs : Plusieurs utilisateurs peuvent annoter et réviser les ensembles de données grâce aux outils d’assurance qualité intégrés.
- Traitement en temps réel des flux vidéo : Analysez et suivez simultanément les données visuelles provenant de milliers de caméras en direct.
- Contrôle d’accès granulaire basé sur les rôles : Gérez la sécurité et les autorisations des utilisateurs pour les projets au niveau de l’espace de travail et du déploiement.
Intégrations de Viso Suite
Viso Suite propose des intégrations natives avec des systèmes de caméras IP, Google Cloud Platform, Azure et AWS, et offre une API pour des intégrations personnalisées.
Pros and Cons
Pros:
- Passe à l’échelle de milliers d’appareils edge ou cloud
- Workflow d’annotation de données collaboratif intégré
- Prend en charge des analyses vidéo multicaméras complexes
Cons:
- Peu d’avis tiers ou de soutien communautaire
- Les outils d’annotation se limitent uniquement aux données 2D
Roboflow
Idéal pour un déploiement rapide de modèles sur des jeux de données personnalisés
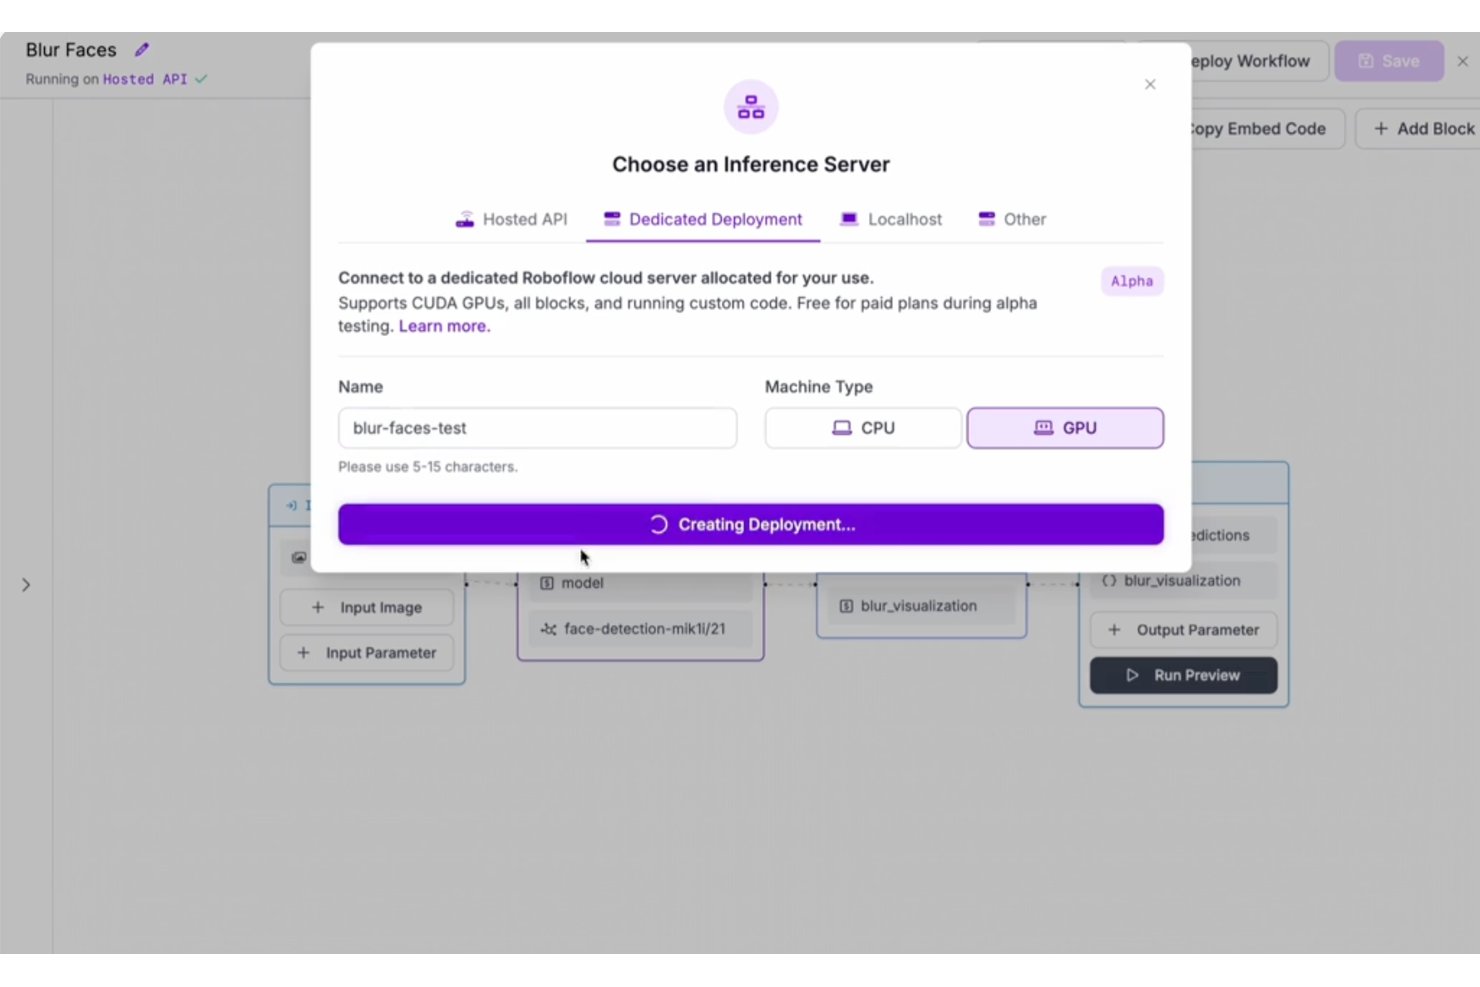
Roboflow est une plateforme de vision par ordinateur pour créer, annoter, entraîner et déployer des modèles personnalisés de classification d'images et de détection d'objets à partir de vos propres jeux de données.
À qui s'adresse Roboflow ?
Ingénieurs en apprentissage automatique et développeurs dans des startups ou entreprises qui ont besoin de déployer et d'améliorer rapidement des modèles de vision par ordinateur personnalisés.
Pourquoi j'ai choisi Roboflow
J'ai choisi Roboflow parmi les meilleurs car je peux importer mes propres jeux de données, les annoter et déployer des modèles personnalisés de vision par ordinateur en quelques minutes. Mon équipe utilise son pipeline d'entraînement des modèles et ses outils de déploiement en un clic pour optimiser l'itération rapide.
Fonctionnalités clés de Roboflow
- Bibliothèque de modèles pré-construits : Choisissez parmi une collection de modèles publics de vision par ordinateur prêts à être déployés ou à affiner.
- Accès API et SDK : Connectez directement les modèles à vos applications en utilisant les API REST et les SDK pris en charge.
- Espace de travail collaboratif pour l'annotation : Attribuez des tâches d'annotation, suivez la progression et gérez les jeux de données avec les membres de l'équipe sur une plateforme unifiée.
- Prise en charge de plusieurs formats d'exportation : Exportez jeux de données et modèles dans des formats compatibles avec TensorFlow, PyTorch, YOLO, et plus encore.
Intégrations Roboflow
Roboflow propose des intégrations natives avec HuggingFace, Google Cloud Vision, Supervisely, SuperAnnotate, OBS, IBM Cloud, LabelMe, YOLOv8 et d'autres. Zapier est pris en charge et une API est disponible pour des intégrations personnalisées.
Pros and Cons
Pros:
- Déploiement rapide de modèles de vision personnalisés
- Espace de travail collaboratif intégré pour l'annotation des données
- Prise en charge de l'exportation vers les principaux formats de modèles d'IA
Cons:
- Ne prend pas en charge nativement l'annotation 3D
- Les fonctionnalités avancées d'analyse vidéo sont limitées

Encord
Idéal pour l'annotation automatisée de données à grande échelle
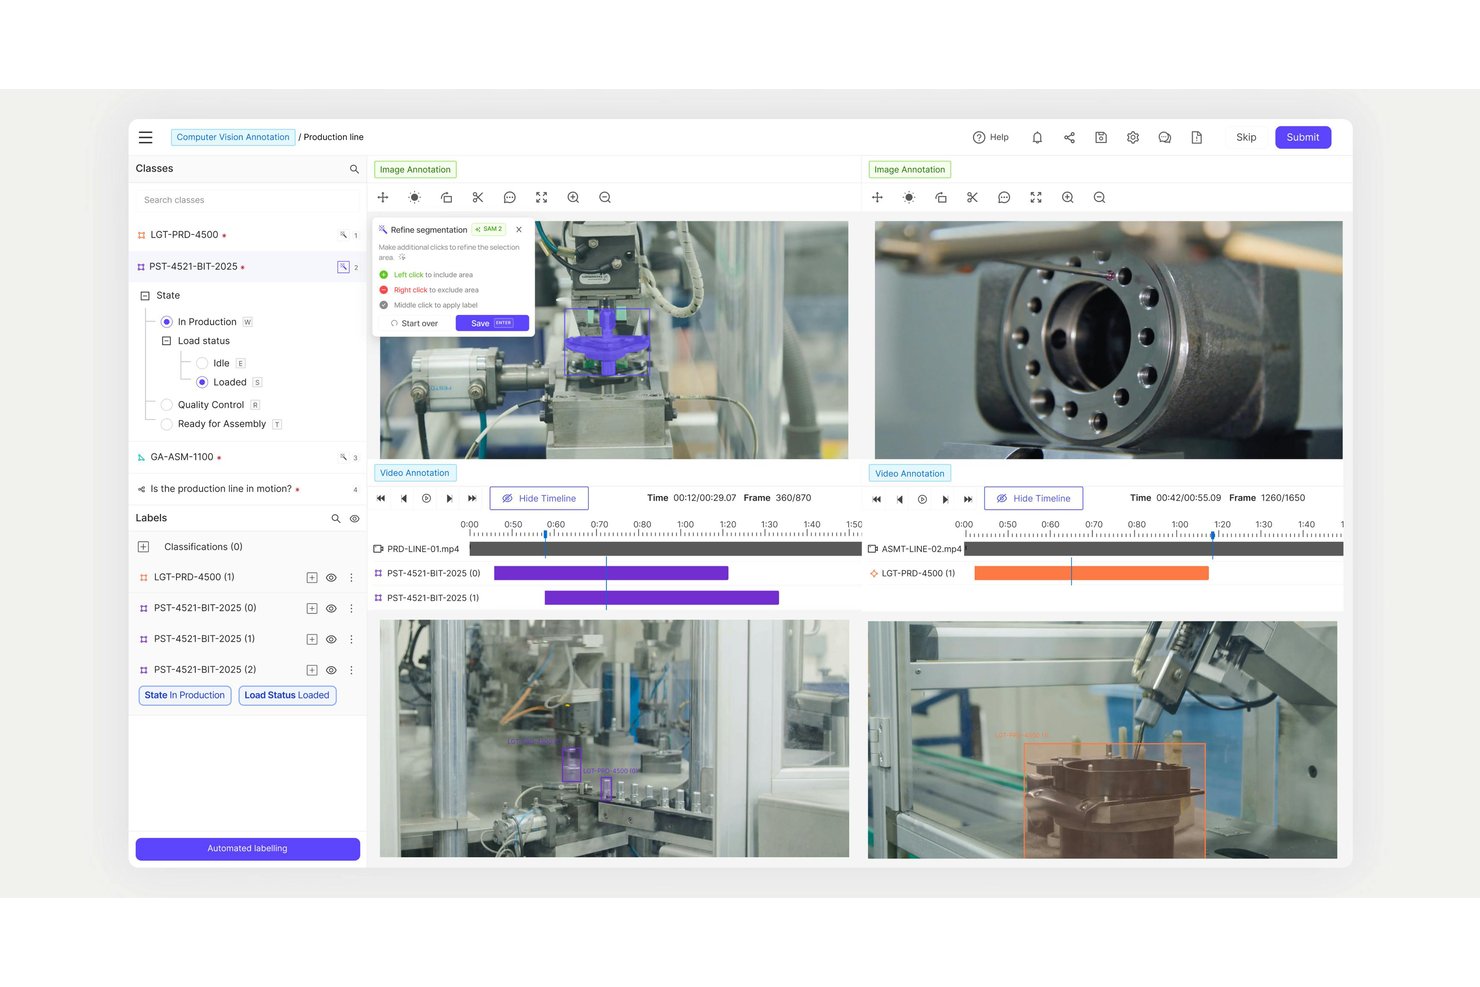
Encord est une plateforme logicielle de vision par ordinateur axée sur les données qui offre des outils d'annotation d'images, de vidéos et de données multimodales à grande échelle ainsi que des fonctionnalités intégrées d'étiquetage automatique, des flux de travail d'assurance qualité et une gestion de projet conçus pour les équipes IA en entreprise.
À qui s'adresse Encord ?
Aux équipes de data science en entreprise et aux ingénieurs ML dans les secteurs réglementés qui ont besoin d'une annotation automatisée et à grande échelle pour des projets de vision par ordinateur complexes.
Pourquoi j'ai choisi Encord
J'ai choisi Encord comme l'un des meilleurs car je peux automatiser l'annotation de jeux de données énormes grâce à des flux d'étiquetage pilotés par IA, utiliser des outils avancés pour les images, vidéos et la 3D, et m'appuyer sur des processus QA intégrés pour gérer des tâches de vision par ordinateur complexes et à grande échelle.
Principales fonctionnalités d'Encord
- Outils d'annotation multimodale : Annotez images, vidéos, LiDAR et données textuelles sur une même plateforme.
- Apprentissage actif intégré : Utilisez les capacités model-in-the-loop pour cibler et prioriser les cas limites.
- Espaces projet collaboratifs : Permettent l’annotation et la révision simultanées par de grandes équipes.
- Contrôle d'accès basé sur les rôles : Définissez rôles et permissions pour garantir sécurité et conformité.
Intégrations Encord
Encord propose des intégrations natives avec AWS S3, Google Cloud Storage et Azure Blob Storage. Une API est disponible pour des intégrations personnalisées.
Pros and Cons
Pros:
- Annotation automatisée pour de larges jeux d’images
- Workflows QA et traçabilité avancés
- Prend en charge l'étiquetage de vidéos, la 3D et le multimodal
Cons:
- Absence de pipeline intégré d'entraînement de modèle
- L'interface d'annotation peut connaître des lenteurs avec de très gros jeux de données
Labelbox
Idéal pour les workflows avancés d’annotation de données
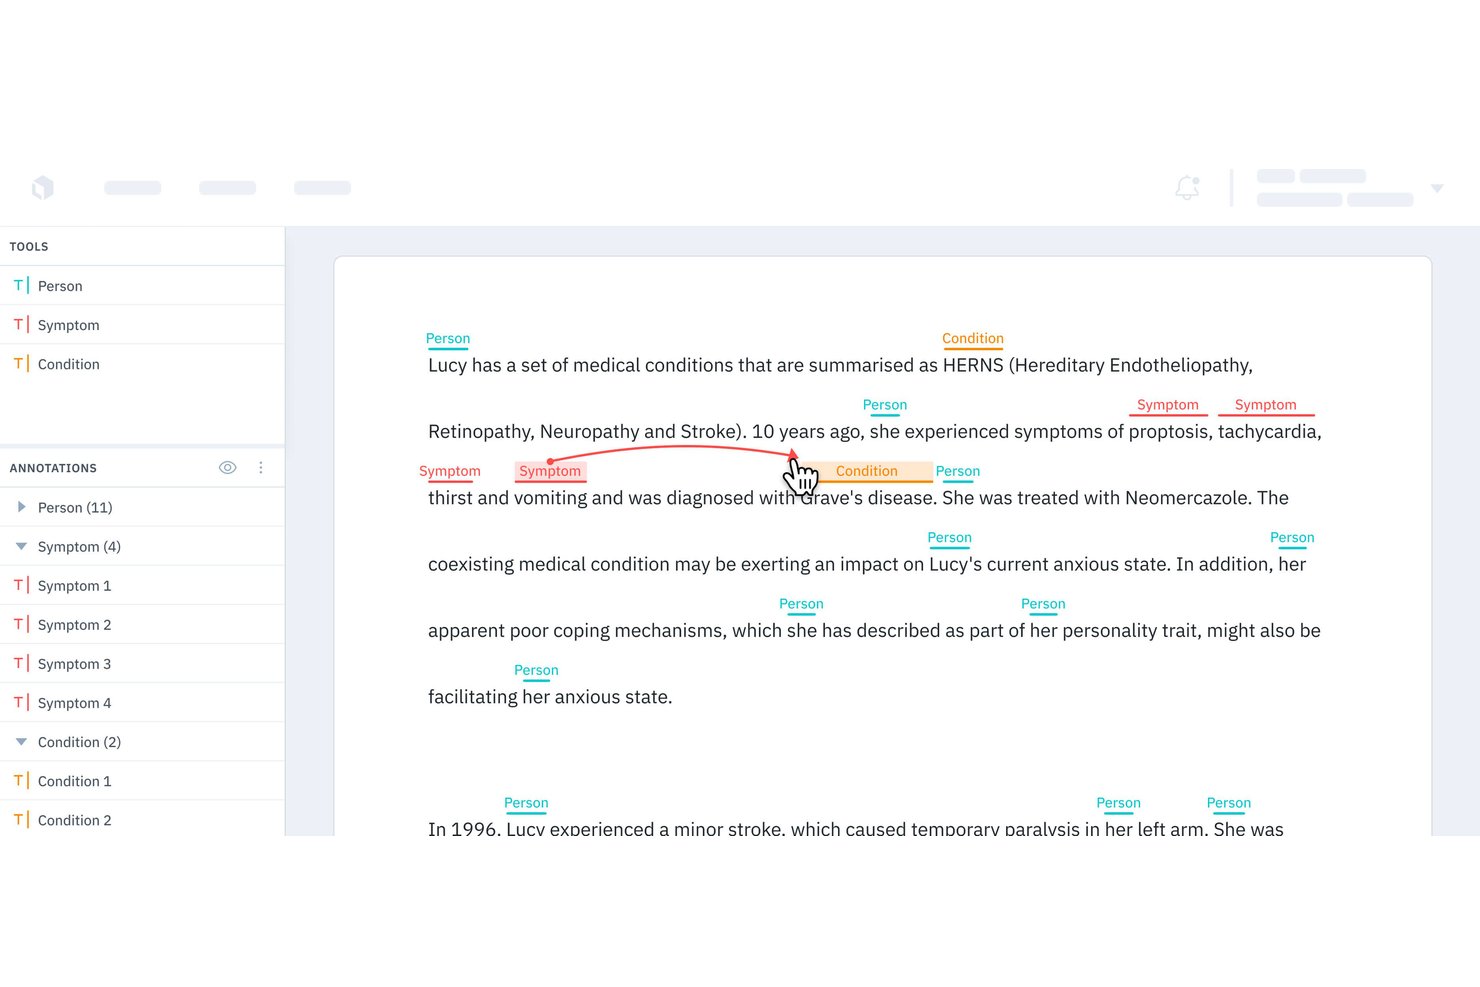
Labelbox est une plateforme d’annotation de données pour la vision par ordinateur qui offre à votre équipe des outils avancés pour annoter, gérer et contrôler la qualité de grands ensembles de données d’images, de vidéos et 3D pour les workflows d’apprentissage automatique.
Pour qui Labelbox est-il le mieux adapté ?
Labelbox convient particulièrement aux équipes de data science et aux ingénieurs ML dans les entreprises de taille moyenne à grande, gérant des projets de vision par ordinateur à grande échelle.
Pourquoi j'ai choisi Labelbox
J’ai choisi Labelbox comme outil hautes performances car je compte sur ses workflows avancés d’annotation pour des projets d’images, de vidéos et d’annotations 3D à grande échelle. Mon équipe utilise ses fonctionnalités d’annotation automatique et de relecture pour accélérer l’assurance qualité et faciliter la collaboration sur des ensembles de données complexes.
Fonctionnalités clés de Labelbox
- Personnalisation de l’éditeur d’annotations : Créez des interfaces d’annotation adaptées aux types de données spécifiques de vision par ordinateur.
- Gestion de l’ontologie : Définissez des structures d’étiquettes hiérarchiques correspondant aux exigences de votre projet.
- Annotation assistée par modèle : Intégrez vos modèles pour générer des pré-étiquettes et appliquer des stratégies d’apprentissage actif.
- SDK Python et API : Accédez à des options d’automatisation et d’intégration pour la gestion de données et de workflows à grande échelle.
Intégrations Labelbox
Labelbox propose des intégrations natives avec Google Cloud Storage, Amazon S3, Snowflake, MySQL, Kafka, Looker, Redshift, MotherDuck et d’autres encore. Une API est disponible pour les intégrations personnalisées.
Pros and Cons
Pros:
- Gère l’annotation de données à grande échelle
- Supporte l’annotation d’images, de vidéos et 3D
- Automatisation avancée pour les workflows d’assurance qualité
Cons:
- Pas de formation de modèles de vision par ordinateur intégrée
- Ralentissements occasionnels sur des ensembles de données massifs

Clarifai
Idéal pour la gestion à grande échelle du cycle de vie des modèles d’IA
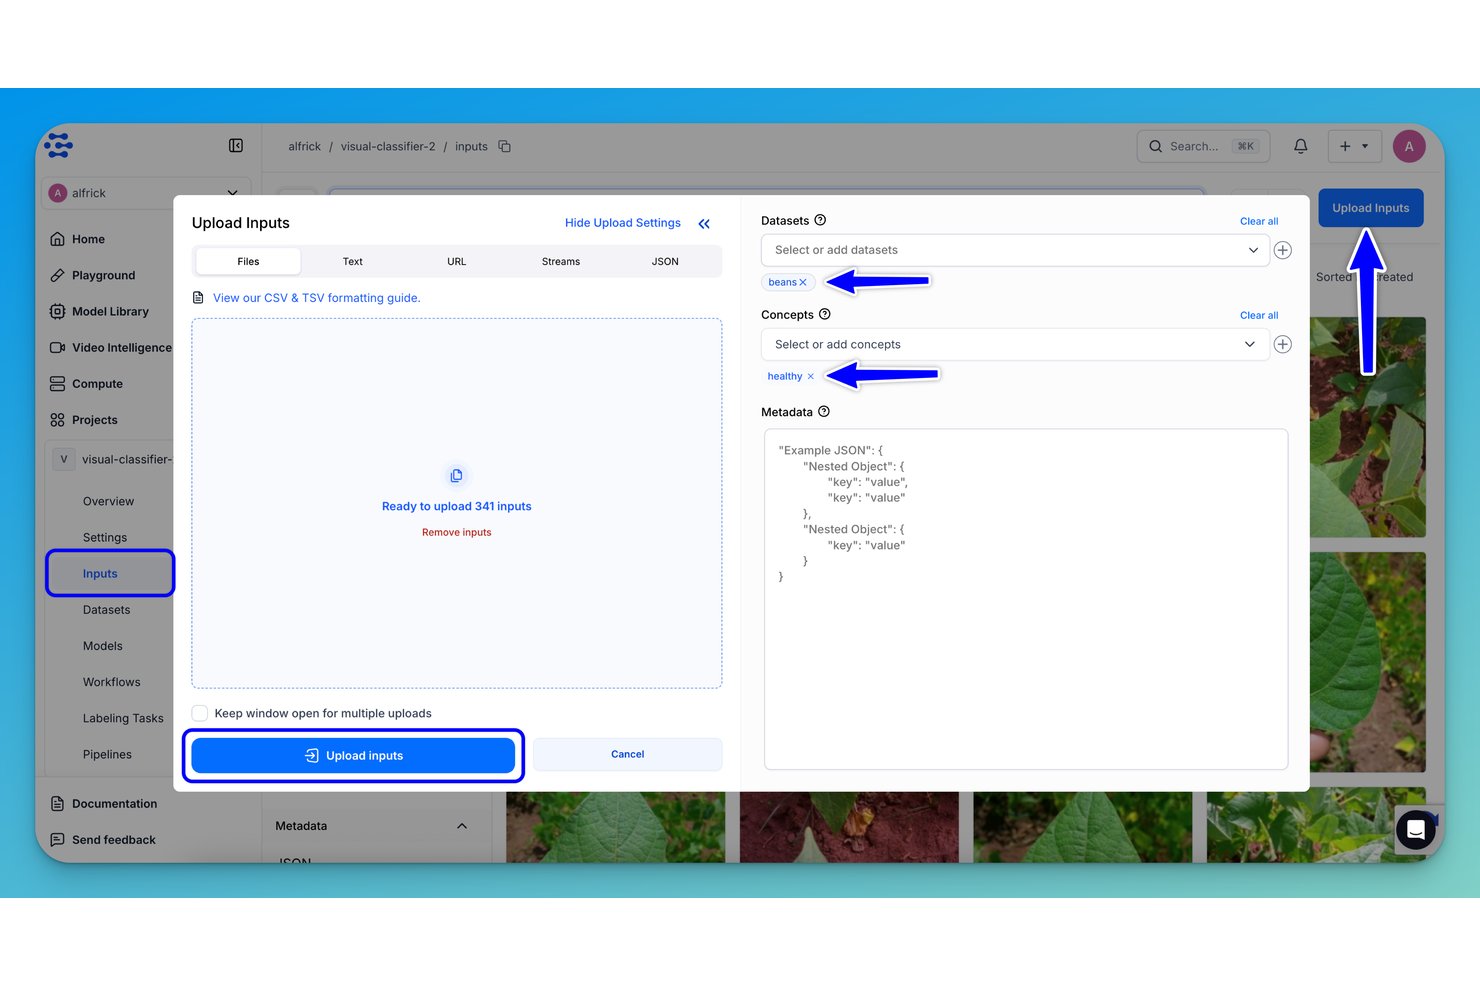
Clarifai est une plateforme de vision par ordinateur destinée aux entreprises, conçue pour développer, entraîner et déployer à grande échelle des modèles de reconnaissance d’images et de vidéos. Elle propose des outils avancés pour la gestion de modèles personnalisés, l’annotation de données et l’analyse visuelle en temps réel.
Pour qui Clarifai est-il le mieux adapté ?
Pour les entreprises et équipes disposant d’ingénieurs spécialisés en apprentissage automatique ou de data scientists travaillant sur des projets de vision par ordinateur à grande échelle.
Pourquoi j’ai choisi Clarifai
J’ai sélectionné Clarifai parmi les meilleurs car il me permet de gérer chaque étape de mon pipeline de modèles d’IA, de l’annotation des ensembles de données jusqu’au déploiement, au sein d’un seul système. Je compte sur ses outils avancés de MLOps, ses capacités puissantes d’analyse vidéo et ses options de déploiement fluide sur les périphériques de bord.
Fonctionnalités clés de Clarifai
- Bibliothèque de modèles pré-entraînés : Accès à un large éventail de modèles de vision par ordinateur prêts à l’emploi pour des déploiements rapides.
- Outils collaboratifs d’annotation de données : Permettent aux équipes d’étiqueter et de gérer de grands ensembles d’images et de vidéos dans un espace de travail partagé.
- Intégrations API et SDK : Connectez vos modèles et workflows à vos applications via des API REST et de multiples SDK de programmation.
- Pipelines de workflow personnalisables : Concevez et gérez des chaînes de traitement visuel de bout en bout adaptées aux projets complexes.
Intégrations Clarifai
Clarifai propose des intégrations natives avec Snowflake et Amazon S3, ainsi qu’une API et des SDK pour des intégrations d’applications personnalisées en Python, Java et Node.js.
Pros and Cons
Pros:
- Modèles pré-entraînés pour de nombreuses tâches d’imagerie
- Outils rapides pour l’annotation et la collaboration
- Déploiements sur site, cloud et en périphérie
Cons:
- Mise en place d’automatisation complexe pour les pipelines avancés
- Peu de références de performances publiées pour certains modèles
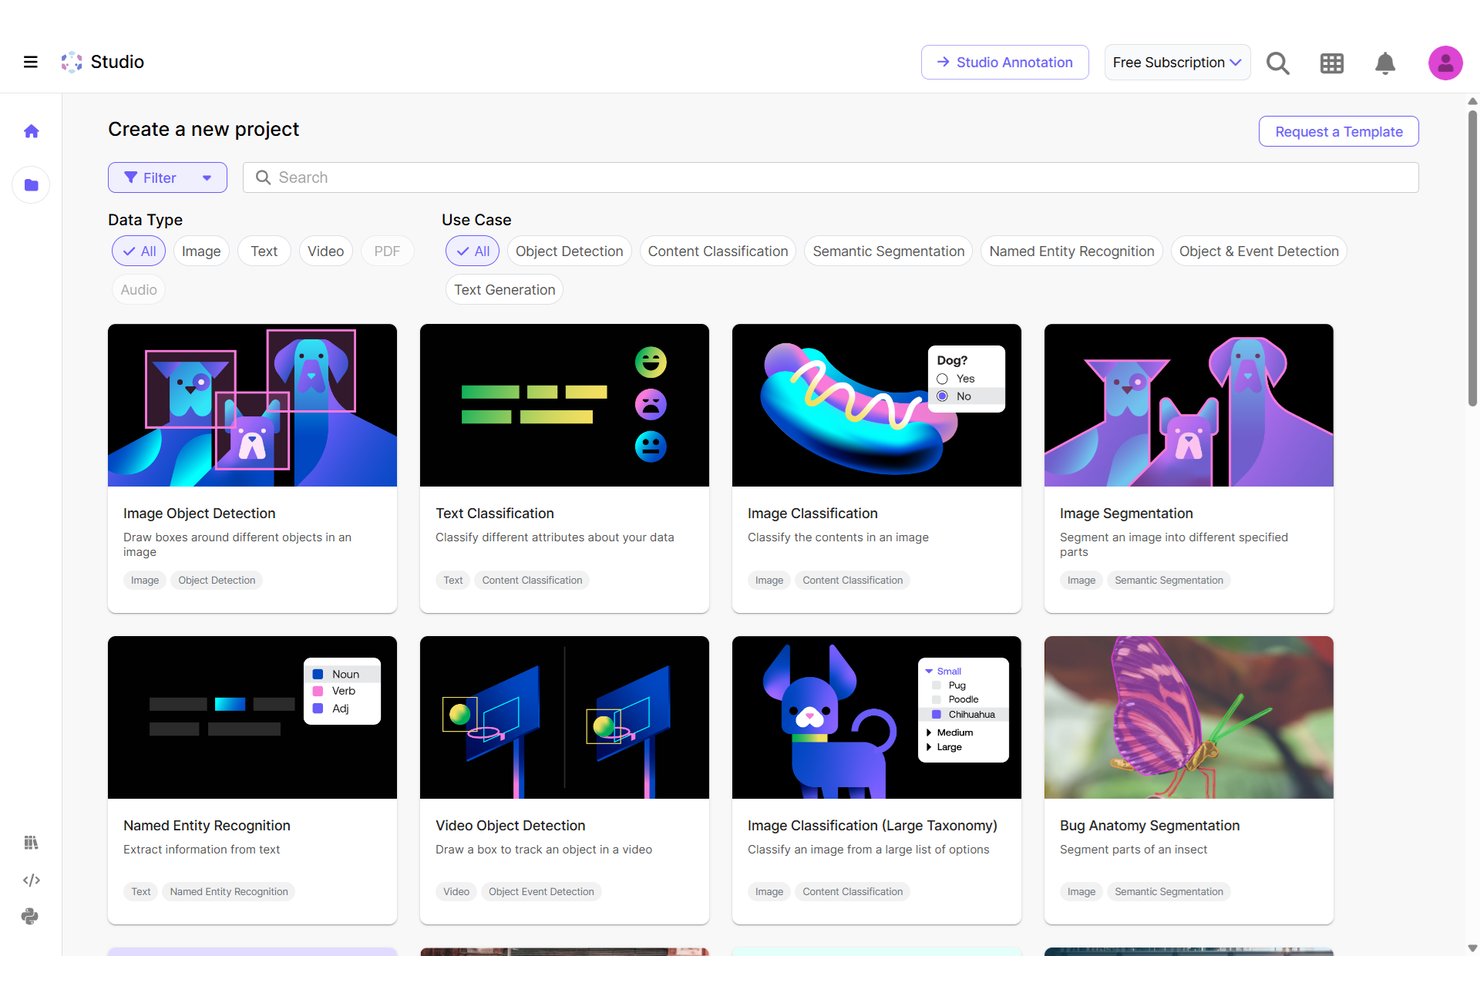
Scale AI est une plateforme logicielle de vision par ordinateur axée sur les entreprises, offrant des fonctions complètes d'annotation, de gestion de jeux de données et des API évolutives pour les flux de travail d'images, de vidéos et de données 3D.
À qui s'adresse Scale AI ?
Scale AI convient aux grandes entreprises et aux équipes d'IA avancées qui gèrent des projets de vision par ordinateur exigeants et des flux de travail d'annotation de données complexes et volumineux.
Pourquoi j'ai choisi Scale AI
J'ai sélectionné Scale AI parmi les meilleurs car je compte sur ses services d'annotation de niveau entreprise pour des jeux de données de vision par ordinateur volumineux et complexes. Mon équipe utilise ses flux de travail d'annotation avancés, ses processus rapides de contrôle qualité, ainsi que la prise en charge des données vidéo et 3D pour des projets de vision exigeants.
Fonctionnalités clés de Scale AI
- Prise en charge de données multi-modalités : Annotez des images, des vidéos, des données LiDAR et du texte optimisé pour les modèles de langage, le tout sur une plateforme unifiée.
- Intégration pilotée par API : Connectez les pipelines de données via des API REST pour une gestion optimisée des jeux de données et de l'automatisation.
- Outils de collaboration en temps réel : Permettez à plusieurs utilisateurs de réviser, commenter et ajuster simultanément les étiquettes visuelles.
- Environnement de données sécurisé : Protégez les informations sensibles grâce à des contrôles d'accès et des dispositifs de confidentialité de niveau entreprise.
Intégrations Scale AI
Les intégrations natives ne sont pas publiquement listées. Scale AI propose une API pour des intégrations personnalisées.
Pros and Cons
Pros:
- Annotation en grand volume pour des types de données complexes
- Contrôle qualité avancé sur les jeux de données annotés
- Prend en charge l'annotation 2D, 3D et vidéo
Cons:
- Pertinence limitée pour les projets de petites équipes
- Aucune documentation claire des intégrations natives tierces
Autres logiciels de vision par ordinateur
Voici quelques autres options de logiciels de vision par ordinateur qui n’ont pas été retenues dans ma sélection, mais qui méritent tout de même votre attention :
- Supervisely
Meilleur pour la configuration de projet sans code
- CVAT
Idéal pour la personnalisation open-source de l'annotation
- Vertex AI
Idéal pour l'intégration avec Google Cloud
- DataLoop
Idéal pour la gestion automatisée des pipelines de données
- Azure AI Custom Vision
Idéal pour l'entraînement rapide de modèles personnalisés via API
- Ultralytics
Idéal pour la prise en charge de modèles YOLO préentraînés
- Hive AI
Idéal pour la modération de contenu à grande échelle
- OpenCV
Idéal pour les bibliothèques d'algorithmes open source
- Milestone Systems
Idéal pour l'enquête vidéo légale


How I Evaluate Computer Vision Software
I split my evaluation into baseline requirements—like annotation tooling and API deployment—and differentiators like edge support and MLOps maturity.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. Then, I calculate the tool's total score into a percentage. Each tool needs to achieve a minimum total score of 75% to be considered for inclusion.
- Image Recognition & Classification: I evaluate how well a platform classifies objects, scenes, and attributes in static images, from pre-trained general models to custom classifiers trained on domain-specific data like retail product catalogs or medical scans.
- Object Detection & Segmentation: I look for support beyond basic bounding boxes, checking whether the tool handles instance segmentation, semantic segmentation, or pose estimation for use cases like warehouse inventory counting or defect inspection on production lines.
- Model Training & Customization: The ability to fine-tune or train models on your own labeled datasets matters here. I check for AutoML options, architecture flexibility, hyperparameter tuning, and experiment tracking so teams can iterate without starting from scratch.
- Video Analysis Capabilities: I consider whether the platform can process live video streams with multi-object tracking and event detection, not just frame-by-frame image analysis. Real-time surveillance feeds and manufacturing line monitoring are where this really gets tested.
- Data Annotation & Labeling: Strong annotation tooling with collaboration features, QA review workflows, and AI-assisted auto-labeling saves enormous time. I look at how each platform handles labeling for both images and video, including support for polygon, keypoint, and 3D annotation types.
- Deployment & API Integration: I check whether models can be deployed across cloud, on-prem, and edge environments via REST APIs, SDKs, or containerized runtimes. Platforms that support exports to formats like ONNX or TensorRT give your team more flexibility when targeting specific hardware.
Once I have a list of tools that meet the criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
Edge deployment support is a major differentiator—I check whether a platform can push models to devices like NVIDIA Jetson boards or industrial cameras for real-time inference without relying on cloud connectivity. MLOps tooling matters just as much once models hit production. Drift detection and automated retraining pipelines keep accuracy from degrading as real-world conditions shift. I also look at pre-trained model libraries, since a strong catalog of ready-to-use models for tasks like OCR or pose estimation lets teams validate use cases before investing in custom training.
Beyond Features
Compliance and security weigh heavily in my evaluation, especially for platforms handling facial recognition or biometric data. I check for certifications like SOC 2 and HIPAA, plus built-in privacy features like PII blurring and audit logs. Deployment flexibility also matters—a platform that supports cloud, on-prem, and hybrid options gives your team room to meet data residency requirements without rearchitecting later. Pricing transparency is another factor I consider closely, since costs can spiral when training compute, storage, and per-inference fees are all billed separately.
Comment choisir un logiciel de vision par ordinateur
Il est facile de se perdre dans de longues listes de fonctionnalités et des structures tarifaires complexes. Pour vous aider à rester concentré tout au long de votre processus de sélection de logiciels, qui vous est propre, voici une liste des facteurs à garder à l’esprit :
| Facteur | Points à prendre en compte |
|---|---|
| Évolutivité | La plateforme pourra-t-elle gérer une augmentation du volume de données, des modèles supplémentaires ou de nouveaux sites sans dégradation des performances ? |
| Intégrations | Pouvez-vous connecter l’outil à vos systèmes actuels, à votre stockage cloud, à vos appareils IoT ou à vos pipelines de données sans développement personnalisé ? |
| Personnalisation | Vous permet-il d’adapter les flux de travail des modèles ou les interfaces d’annotation aux projets, environnements ou types de données propres à votre équipe ? |
| Facilité d’utilisation | Les membres techniques et non techniques de votre équipe pourront-ils utiliser efficacement la plateforme, ou son utilisation nécessitera-t-elle une expertise approfondie en ML ? |
| Mise en œuvre et intégration initiale | Quelles ressources, quelle documentation ou quelle assistance sont fournies pour mettre vos modèles et vos données en production sur le nouveau système sans longs délais ? |
| Coût | Tous les coûts sont-ils clairement indiqués, notamment ceux liés à la puissance de calcul pour l’entraînement, au stockage des données, à l’utilisation de l’API et à l’annotation ? Méfiez-vous des frais cachés et des frais de dépassement. |
| Mesures de sécurité | L’outil propose-t-il une gestion des accès basée sur les rôles, le chiffrement des données et des journaux d’audit pour protéger vos jeux de données et la propriété intellectuelle de vos modèles contre les menaces internes et externes ? |
| Exigences de conformité | Le logiciel prend-il en charge la confidentialité des données et les normes du secteur (RGPD, HIPAA, etc.) pertinentes pour votre domaine ou votre région ? |
Qu’est-ce qu’un logiciel de vision par ordinateur ?
Les logiciels de vision par ordinateur constituent une catégorie d’outils qui utilisent l’IA pour détecter, analyser et interpréter des images ou des vidéos. Ces plateformes permettent aux équipes d’automatiser des tâches telles que l’étiquetage d’images, la détection d’objets et l’analyse vidéo. En prenant en charge l’entraînement et le déploiement des modèles ainsi que leur intégration à d’autres systèmes, les logiciels de vision par ordinateur aident les entreprises à exploiter les informations issues des données visuelles et à automatiser les processus dans un large éventail d’applications de vision par ordinateur.
Fonctionnalités
Lorsque vous choisissez un logiciel de vision par ordinateur, soyez attentif aux fonctionnalités clés suivantes :
- Classification d’images : Attribue des étiquettes ou des catégories aux images, permettant d’organiser et de trier automatiquement de grands ensembles de données en reconnaissant les éléments ou les motifs clés.
- Détection d’objets : Localise et identifie les objets dans les images ou les images vidéo, prenant en charge des cas d’utilisation tels que l’assurance qualité, le suivi des stocks ou la sécurité automobile.
- Segmentation : Divise les images en régions ou objets distincts, permettant une analyse, une mesure ou un isolement précis de zones telles que les imageries médicales ou les environnements cartographiés.
- Traitement vidéo : Analyse et extrait des informations de flux ou de fichiers vidéo, permettant la détection en temps réel, le suivi d’événements et l’analyse des mouvements pour la surveillance ou le contrôle.
- Outils d’annotation des données : Fournit des interfaces pour l’étiquetage manuel des images ou des images vidéo, favorisant la précision des modèles en garantissant que les données sont correctement étiquetées pour l’entraînement.
- Traitement par lots : Traite de grandes quantités d’images ou de vidéos dans un même flux de travail, économisant du temps et des efforts lors de l’entraînement, de la validation ou du retraitement des modèles.
- Intégration d’API : Permet au logiciel de se connecter à d’autres plateformes, en autorisant l’automatisation des pipelines de traitement et l’intégration de fonctionnalités de vision dans vos propres applications.
- Accès fondé sur les rôles : Permet de gérer les autorisations des groupes d’utilisateurs, en veillant à ce que les membres appropriés de l’équipe puissent annoter les données, examiner les résultats ou déployer les modèles en toute sécurité.
- Rapports et visualisation : Propose des tableaux de bord ou des outils d’analyse pour visualiser les résultats, suivre les améliorations et communiquer clairement les conclusions aux équipes ou aux parties prenantes.
- Compatibilité matérielle : Prend en charge différents GPU, CPU ou accélérateurs spécialisés, facilitant le déploiement et la mise à l’échelle dans l’ensemble de votre infrastructure.
Fonctionnalités d’IA courantes des logiciels de vision par ordinateur
Au-delà des fonctionnalités standard des logiciels de vision par ordinateur présentées ci-dessus, bon nombre de ces solutions intègrent l’IA avec des fonctionnalités telles que :
- Étiquetage automatique : Utilise l’IA pour générer automatiquement des annotations pour les images ou les images vidéo, accélérant considérablement la préparation des ensembles de données et réduisant les efforts manuels.
- Détection des anomalies : Exploite l’apprentissage automatique pour identifier les motifs inhabituels ou les défauts dans les images ou les vidéos, prenant en charge des applications telles que le contrôle qualité ou la surveillance de sécurité.
- Reconnaissance faciale : Utilise l’apprentissage profond pour détecter et comparer les visages dans les images ou les vidéos, permettant la vérification d’identité, le contrôle d’accès ou l’analyse des clients.
- Estimation de la pose : Utilise des modèles d’IA pour déterminer la position et l’orientation des objets ou des personnes, prenant en charge des applications dans l’analyse sportive, la robotique ou les évaluations ergonomiques.
- Compréhension des scènes : Applique l’IA pour interpréter des environnements complexes, reconnaître les relations entre les objets et prédire le contexte pour des tâches telles que la navigation autonome ou l’analyse de la vente au détail.
- Apprentissage actif : Intègre l’IA pour suggérer les échantillons de données à étiqueter ensuite, optimisant les flux de travail d’annotation et améliorant les performances des modèles avec moins de données étiquetées.
Avantages
La mise en œuvre d’un logiciel de vision par ordinateur offre plusieurs avantages à votre équipe et à votre entreprise. Voici quelques-uns de ceux dont vous pouvez bénéficier :
- Prise de décision plus rapide : L’analyse automatisée des images et des flux vidéo fournit des informations en temps réel pour des applications telles que le contrôle qualité ou la surveillance de sécurité.
- Productivité accrue : L’automatisation des flux de travail et les outils d’annotation alimentés par l’IA aident votre équipe à traiter davantage de données avec moins d’efforts manuels.
- Opérations évolutives : Les options de déploiement dans le cloud, sur site et en périphérie vous permettent de passer de projets pilotes à une production à grande échelle sans refonte majeure.
- Précision améliorée : L’entraînement personnalisable des modèles et les flux de travail d’apprentissage actif améliorent continuellement les résultats de détection, de classification et de segmentation.
- Sécurité renforcée des données : L’accès fondé sur les rôles, la journalisation des audits et les fonctionnalités de conformité protègent les données visuelles sensibles et respectent les exigences en matière de confidentialité.
- Intégrations simplifiées : L’accès aux API et les SDK connectent les modèles aux systèmes d’entreprise existants pour assurer une circulation fluide des données et des flux de travail personnalisés.
- Informations exploitables : Les tableaux de bord de rapports et les visualisations transforment les données visuelles complexes en conclusions claires et pertinentes pour l’entreprise, afin d’améliorer la planification stratégique.
Coûts et tarification
La sélection d’un logiciel de vision par ordinateur nécessite de comprendre les différents modèles et forfaits tarifaires disponibles. Les coûts varient selon les fonctionnalités, la taille de l’équipe, les modules complémentaires et bien d’autres facteurs. Le tableau ci-dessous récapitule les forfaits courants, leurs prix moyens et les fonctionnalités généralement incluses dans les solutions logicielles de vision par ordinateur :
Tableau comparatif des forfaits pour les logiciels de vision par ordinateur
| Type de forfait | Prix moyen | Fonctionnalités courantes |
|---|---|---|
| Forfait gratuit | $0 | Jeux de données limités, traitement d’images de base, outils d’annotation essentiels et assistance de la communauté. |
| Forfait personnel | $25-$100/utilisateur/mois | Accès pour un seul utilisateur, traitement par lots, modèles essentiels de vision par ordinateur, exportation des données et assistance par e-mail. |
| Forfait professionnel | $100-$500/utilisateur/mois | Collaboration entre plusieurs utilisateurs, personnalisation avancée des modèles, accès à l’API, options d’intégration et assistance prioritaire. |
| Forfait entreprise | $500+/utilisateur/mois | Déploiement personnalisé, contrôle d’accès basé sur les rôles, fonctionnalités de conformité, intégration personnalisée, SLA personnalisés et assistance complète. |
FAQ sur les logiciels de vision par ordinateur
Voici quelques réponses aux questions courantes sur les logiciels de vision par ordinateur :
Quels secteurs utilisent des logiciels de vision par ordinateur ?
Vous trouverez des logiciels de vision par ordinateur dans l’industrie manufacturière, les soins de santé, le commerce de détail, la sécurité, la logistique et l’agriculture — en fait, partout où les organisations souhaitent extraire de la valeur des données visuelles à des fins d’inspection, d’automatisation ou d’analyse.
Les utilisateurs non techniques peuvent-ils travailler avec des plateformes de vision par ordinateur ?
Oui, de nombreuses plateformes proposent désormais des interfaces nécessitant peu de code, des flux de travail guidés et des modèles préentraînés. Les experts métier et les opérateurs peuvent ainsi étiqueter les données et utiliser des modèles de base sans posséder une expertise approfondie en apprentissage automatique.
Comment les logiciels de vision par ordinateur protègent-ils les données sensibles ?
La plupart des plateformes proposent des fonctionnalités telles que le chiffrement des données, le contrôle d’accès basé sur les rôles, les journaux d’audit et des options de traitement sur l’appareil afin de protéger les images ou vidéos sensibles et de vous aider à respecter les exigences de conformité.
Est-il possible d’intégrer un logiciel de vision par ordinateur aux systèmes d’entreprise existants ?
Oui, l’accès à l’API et les SDK sont courants, ce qui facilite la connexion aux plateformes ERP, MES, VMS ou de stockage infonuagique, ainsi que l’intégration des résultats de vision dans vos propres flux de travail.
Que dois-je savoir sur la mise à l’échelle d’une solution de vision par ordinateur ?
Vérifiez si la solution peut gérer l’augmentation des volumes de données, plusieurs utilisateurs et des déploiements dans le nuage, sur site ou sur des appareils périphériques sans problèmes de performance ni reconfiguration complexe.