Les pipelines ETL sont un ensemble de processus utilisés pour déplacer des données depuis une ou plusieurs sources vers une base de données ou un entrepôt de données. ETL signifie « extraction, transformation et chargement », ce qui décrit les processus nécessaires à cette opération. Savoir concevoir des pipelines ETL efficaces peut considérablement améliorer vos activités de veille stratégique et simplifier la gestion des données.
Les pipelines ETL sont souvent utilisés en science des données en raison de leur utilité pour le nettoyage des données et l’optimisation des ensembles de données. Ils sont toutefois également utiles dans les environnements professionnels, notamment dans le monde moderne des mégadonnées.
Aujourd’hui, de nombreux outils peuvent rationaliser les flux de travail de gestion des données et, comme nous le verrons dans ce guide, ces outils constituent un élément essentiel des pipelines ETL modernes.
Que sont les pipelines ETL ?
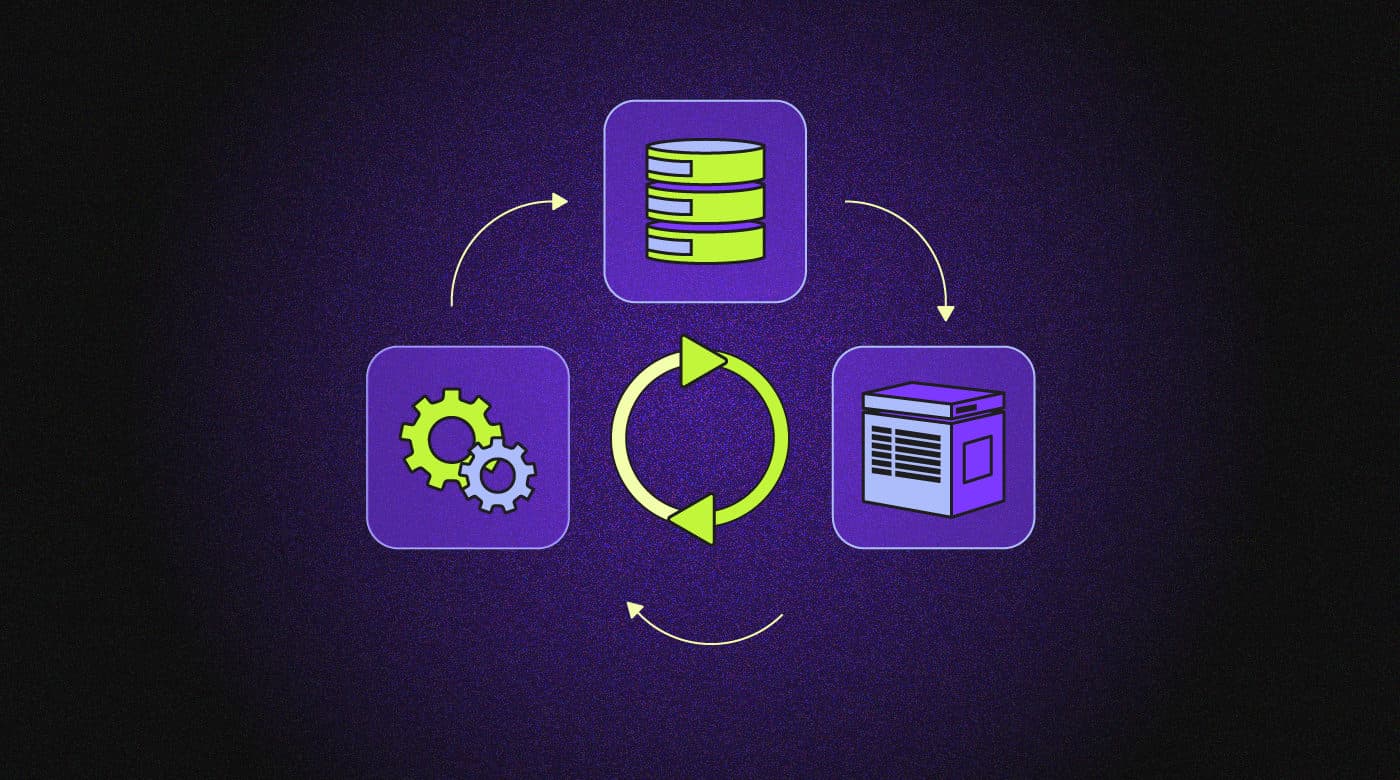
ETL signifie extraction, transformation et chargement. Examinons chacune des étapes du processus à tour de rôle :
- Extraction : ce processus extrait les données d’une API, les extrait d’une base de données ou les lit à partir d’un fichier de vidage (tel qu’un fichier XML ou JSON). Selon le nombre de sources de données dont vous souhaitez extraire les données, la configuration des connecteurs et l’analyse des données peuvent constituer un processus complexe. Les outils de gestion des données peuvent souvent aider à convertir les données provenant de plusieurs sources dans un format unique et cohérent.
- Transformation : une fois les données obtenues, l’étape suivante consiste à les assainir, à supprimer les doublons, à les standardiser (par exemple, en veillant à ce que toutes les dates suivent le même format), à les restructurer pour qu’elles correspondent au schéma de la base de données cible et à vérifier que tous les champs sont correctement mappés. Ce processus peut prendre beaucoup de temps et nécessiter des vérifications régulières si certaines sources de données modifient la manière dont elles fournissent leurs données.
- Chargement : enfin, les données transformées peuvent être importées dans la base de données, l’entrepôt de données ou la plateforme cible. Le processus exact permettant d’effectuer ce chargement peut varier selon la plateforme cible. Le chargement initial peut prendre un certain temps, car il implique l’importation d’une grande quantité de données pour alimenter la base de données. Par la suite, les mises à jour peuvent être gérées au moyen de modifications incrémentielles des données, mais des actualisations complètes peuvent être effectuées ponctuellement afin de garantir l’intégrité des données. De nombreux ingénieurs des données automatisent le processus de mise à jour et le planifient pendant les périodes creuses, lorsque les systèmes sources enregistrent un trafic minimal.
Planification et conception de pipelines ETL efficaces
Le volume considérable de données traité par les pipelines ETL fait de leur mise en œuvre une entreprise importante. Pour garantir la réussite du processus, les ingénieurs des données doivent bien comprendre les données qu’ils vont traiter ainsi que les objectifs des personnes qui les exploitent.
Have an account? Log In
Points clés à prendre en compte avant de créer un pipeline ETL
La gestion des mégadonnées présente plusieurs défis majeurs :
- Volume des données : un élément essentiel est la quantité de données collectées et les coûts associés à leur stockage (et à leur transmission). Dans certains cas, les organisations n’ont aucun contrôle sur le volume de données fourni par des tiers lorsqu’elles demandent une exportation. Cependant, vous pouvez décider quelles données conserver et lesquelles sont redondantes.
- Variété des données : vous devez également tenir compte des types et des formats des données avec lesquels vous travaillez, ainsi que de leur caractère structuré ou non structuré. Les ingénieurs des données peuvent relever ce défi en utilisant des outils de transformation et de standardisation afin de convertir toutes les données dans un format commun.
- Vélocité des données : ce terme désigne la vitesse et la fréquence auxquelles les données sont collectées. Une vélocité élevée des données peut entraîner des problèmes lorsque vous tentez d’automatiser vos pipelines, en particulier si vous recherchez les données les plus précises provenant de toutes les sources pour prendre des décisions fondées sur les données.
Une fois ces problèmes traités, vous pouvez réfléchir à l’objectif de la consolidation des données et aux objectifs finaux de l’analyse des données. Ces objectifs peuvent influencer les décisions relatives à la conception de la base de données.
Choisir les outils et technologies ETL adaptés
Il est possible de créer vos propres outils ETL à partir de zéro — et certaines petites organisations choisissent cette voie, en supposant qu’elle sera moins coûteuse et plus simple que l’utilisation de solutions prêtes à l’emploi.
Bien que cela puisse être vrai lorsque l’importation provient d’une ou deux sources de données seulement et que leurs formats d’exportation changent rarement, c’est rarement la meilleure solution. Les outils ETL offrent des solutions plus avancées de traitement, de nettoyage et de profilage des données, des fonctionnalités avancées d’automatisation et de traitement par lots, ainsi que des avantages considérables en matière de fiabilité et de facilité d’utilisation.
Lorsque vous choisissez une solution ETL, tenez compte des éléments suivants :
- Formats de données pris en charge (fichiers SQL, XML, JSON, CSV, etc.)
- Intégrations d’API
- Disponibilité du streaming en temps réel pour l’ingestion des données (Apache Kafka est une solution populaire pour cela)
- Caractère natif dans le cloud de la solution (Les outils qui prennent en charge le chargement facile des données dans des lacs de données Amazon AWS ou Google Cloud peuvent être précieux pour les organisations qui exigent flexibilité et agilité dans leur entreposage de données)
- Délais de réponse du support
- Tarification
De nombreuses solutions ETL open source sont disponibles, certaines proposant des éditions communautaires gratuites et finançant leur développement en facturant le support technique. Si votre organisation dispose d’un budget limité pour la mise en œuvre de son système ETL, choisir une solution open source largement utilisée pourrait vous faire économiser beaucoup d’argent.
Principes de conception pour des pipelines ETL évolutifs et faciles à maintenir
Lors de la conception d’un pipeline ETL, il est essentiel de prendre en compte non seulement les sources de données avec lesquelles vous travaillez actuellement, mais aussi la manière dont vos besoins pourraient évoluer à l’avenir. Voici quelques éléments à prendre en considération :
- Conception modulaire : Décomposez le système en processus d’extraction des données, de nettoyage des données et de chargement. Tenez compte des différents formats de données avec lesquels vous pourriez devoir travailler et créez un système modulaire, afin de pouvoir modifier facilement différentes parties du système sans interrompre l’ensemble du pipeline.
- Gestion des erreurs : Concevez votre système de manière à ce qu’il échoue de façon contrôlée et affiche un message d’erreur clair s’il rencontre des données qu’il ne comprend pas ou qui sont dans un format incorrect. Il vaut mieux qu’un système ignore les enregistrements qu’il ne peut pas traiter et fournisse un message d’avertissement plutôt que d’échouer complètement, ce qui entraînerait des retards dans le processus de chargement ou, pire encore, chargerait des données incorrectes et corromprait le référentiel de données principal.
- Documentation claire et complète : Une documentation claire est essentielle. Gardez à l’esprit que tous les membres de votre équipe ne sont pas des spécialistes des données. Nombre des personnes qui interagissent avec les données peuvent être des chefs d’équipe ou des responsables de service qui souhaitent simplement disposer d’un moyen facile d’accéder simultanément à des données en temps réel provenant de plusieurs sources différentes. Prévoyez un ensemble de documents pour ces personnes et un autre pour les développeurs, qui explique le pipeline plus en détail. Présentez les principes de conception essentiels, tels que la modularité, la gestion des erreurs et les pratiques de documentation.
Pipeline ETL et pipeline de données
Les pipelines ETL et les pipelines de données sont des processus similaires, mais leurs cas d’utilisation diffèrent légèrement. Un pipeline ETL couvre l’extraction des données à partir d’une ou plusieurs sources, la transformation de ces données, puis leur chargement.
En revanche, un pipeline de données peut inclure certaines ou la totalité des étapes ci-dessus, mais ne se termine pas par le processus de chargement. Une fois les données chargées, elles peuvent être utilisées dans d’autres processus et flux de travail, par exemple pour un système de visualisation ou pour déclencher conditionnellement une action dans un système d’automatisation.

Author's Tip
Considérez un pipeline ETL comme un type de pipeline de données dont le rôle est défini de manière étroite : prendre des données structurées et non structurées, les transformer dans un format commun et les stocker dans un entrepôt de données ou une base de données.
Principaux avantages des pipelines ETL
Les pipelines ETL peuvent être extrêmement utiles pour alimenter les systèmes d’analyse et de veille stratégique. Parce qu’ils unifient les données provenant de plusieurs sources, par exemple en réunissant les données des réseaux sociaux, des systèmes CRM, des outils ERP et d’autres bases de données, ils facilitent l’obtention d’informations commerciales fiables.
Le processus ETL implique l’optimisation, la validation et le nettoyage des données, ce qui contribue à garantir que les informations intégrées à la base de données sont aussi précises et à jour que possible.
La fiabilité de vos pipelines ETL dépend des outils que vous utilisez. Un pipeline peut être aussi simple que quelques scripts Python ou être plus robuste et utiliser Snowflake, Kafka et d’autres outils modernes. Aujourd’hui, les outils disponibles pour traiter les données et créer un pipeline ETL sont assez matures. Les interfaces graphiques faciles à utiliser et les communautés d’utilisateurs actives permettent même aux spécialistes des données débutants de se lancer avec les pipelines ETL.
Inconvénients des pipelines ETL
Bien que les chaînes d’outils permettant de créer des pipelines ETL soient matures et que les entrepôts de données cloud soient aujourd’hui bien plus abordables qu’il y a quelques années, certains défis subsistent lors de la création de pipelines de données :
- La gestion des données structurées, non structurées et semi-structurées peut être difficile.
- Les coûts du stockage des données peuvent être prohibitifs pour certaines organisations.
- La diffusion des données en temps réel peut être à la fois complexe et gourmande en ressources.
- La mise en correspondance des bases de données et la configuration des intégrations ne constituent pas une tâche ponctuelle. Les fournisseurs de données peuvent modifier leurs formats d’exportation ou leurs schémas de base de données, ce qui vous oblige à modifier votre pipeline.
Mise en œuvre du pipeline ETL
Envisagez le flux de travail suivant pour mettre en œuvre un pipeline ETL :
- Créez des données de référence afin de disposer d’éléments sur lesquels travailler lors des transformations de données.
- Créez des connecteurs pour les sources de données avec lesquelles vous souhaitez travailler, notamment :
- Des interfaces API pour les plateformes de réseaux sociaux
- Des outils d’extraction pour les pages web (si les conditions d’utilisation l’autorisent)
- Des analyseurs pour les fichiers XML/CSV/JSON
- Des connecteurs de bases de données pour vos propres systèmes sur site
- Définissez des règles pour valider les données.
- Appliquez des transformations pour nettoyer et standardiser les données et supprimer les doublons.
- Chargez les données dans un système intermédiaire.
- Chargez les données du système intermédiaire vers l’entrepôt de données.
Certaines des étapes ci-dessus sont facultatives. Par exemple, les données de référence ne sont pas obligatoires, mais elles sont utiles, car elles facilitent la définition de règles pour tester les données et effectuer les transformations. En outre, il n’est pas nécessaire de préparer les données dans un système intermédiaire avant de les charger. Cependant, il est recommandé de le faire, car il est plus facile de restaurer la couche intermédiaire en cas de problème, et cette couche peut être utilisée pour les rapports d’audit et d’autres exigences de conformité.
More Articles
Outils de pipeline ETL à tester
De nombreux outils ETL disponibles peuvent simplifier le traitement, l’agrégation, le nettoyage et le chargement des données dans votre système cible. Le marché des logiciels ETL est évalué à environ 3,1 milliards de dollars et devrait atteindre 10,3 milliards de dollars d’ici 2030. Les options ne manquent donc pas.
Parmi les outils populaires, on trouve :
- Informatica Power Center : Une solution polyvalente prenant en charge le cloud, avec notamment des outils nécessitant peu ou pas de code pour les pipelines ETL
- Apache Airflow : Une plateforme open source puissante proposant des interfaces en ligne de commande et graphiques
- IBM Infosphere Datastage : Une solution rapide et puissante dotée de fonctionnalités d’équilibrage de charge et de parallélisation
Il existe de nombreuses autres options, notamment des solutions d’Oracle et de Microsoft. Lors du choix d’une solution ETL, tenez compte de votre budget et de votre écosystème existant, car rester auprès de fournisseurs que vous connaissez déjà bien peut constituer un choix fiable et économique.
Points à retenir
Les pipelines ETL constituent un élément essentiel de la gestion des données pour les entreprises modernes qui traitent d’importants volumes de données. La mise en œuvre d’un pipeline ETL peut contribuer à améliorer la prise de décision de votre organisation et à donner à votre entreprise un avantage concurrentiel.
Cependant, la gestion de données brutes provenant de plusieurs sources peut être difficile, et les responsables technologiques doivent souligner l’importance d’une planification et d’une documentation rigoureuses tout au long du processus, ainsi que le respect des réglementations en matière de protection et de confidentialité des données.
Pour en savoir plus sur les pipelines ETL, le traitement des données ainsi que les autres défis et innovations liés aux mégadonnées, abonnez-vous à la newsletter du CTO Club.