

Los 10 mejores programas de gestión de operaciones de TI en 2026

Mejor software de gestión de operaciones de TI


El software de gestión de operaciones de TI te ayuda a gestionar y comprender toda tu infraestructura de TI, con cobertura de la supervisión, la automatización, la seguridad y el estado de los servicios en entornos locales y en la nube.
Esta lista está dirigida a CTO y responsables de TI que necesitan una visión unificada, un análisis más rápido de las causas raíz y soluciones preparadas para operaciones híbridas y multinube. Encontrarás opciones de automatización basada en IA, observabilidad profunda, integraciones de seguridad nativas y la capacidad de personalización que necesitas para ampliar lo que importa.
Por qué confiar en nuestras reseñas de software
Llevamos probando y revisando software desde 2023. Como líderes tecnológicos, sabemos lo crítico y difícil que es tomar la decisión correcta al seleccionar software.
Invertimos en una investigación profunda para ayudar a nuestra audiencia a tomar mejores decisiones de compra de software. Hemos probado más de 2,000 herramientas para diferentes casos de uso tecnológicos y escrito más de 1,000 reseñas de software exhaustivas. Descubre cómo mantenemos la transparencia y nuestra metodología de revisión de software.
Compara el mejor software de gestión de operaciones de TI
Compara precios y especificaciones, lado a lado, del software de gestión de operaciones de TI que incluí en mi lista de selección.
| Tool | Best For | Trial Info | Price | ||
|---|---|---|---|---|---|
| 1 | Ideal para operaciones de registros y métricas integradas con SecOps | Prueba gratuita disponible | Desde $0.15/crédito | Website | |
| 2 | La mejor opción para obtener visibilidad operativa de pila completa nativa de OTel | Prueba gratuita de 14 días | Desde $99/mes | Website | |
| 3 | Ideal para operaciones de TI híbridas multiinquilino de nivel MSP | Demostración gratuita disponible | Precio bajo solicitud | Website | |
| 4 | Ideal para una visibilidad profunda de las operaciones de almacenamiento y GPU | Demostración gratuita disponible | Precio bajo solicitud | Website | |
| 5 | La mejor para la validación de lanzamientos de pila completa basada en IA | Prueba gratuita de 15 días | Desde $7/host/mes | Website | |
| 6 | Ideal para operaciones de causa raíz basadas en IA, desde las alertas hasta la topología | Prueba gratuita de 14 días | Precios disponibles previa solicitud | Website | |
| 7 | Ideal para la observabilidad de pila completa a nivel de transacción | Plan gratuito disponible | Desde $99/usuario/mes | Website | |
| 8 | Ideal para operaciones de TI híbridas a gran escala basadas en una CMDB | Demo gratuita disponible | Precios bajo consulta | Website | |
| 9 | Ideal para operaciones del estado de los servicios entre dominios nativos de Cisco | Demostración gratuita disponible | Precios disponibles previa solicitud | Website | |
| 10 | La mejor opción para IA agéntica en operaciones desde sistemas centrales hasta la nube | Demostración gratuita disponible | Precio bajo consulta | Website |
Reseñas del mejor software de gestión de operaciones de TI
A continuación encontrarás mis resúmenes detallados del mejor software de gestión de operaciones de TI que incluí en mi lista de selección. Mis reseñas ofrecen un análisis detallado de las funciones, los mejores casos de uso y las integraciones de cada plataforma para ayudarte a encontrar la mejor opción para ti.

Ideal para operaciones de registros y métricas integradas con SecOps
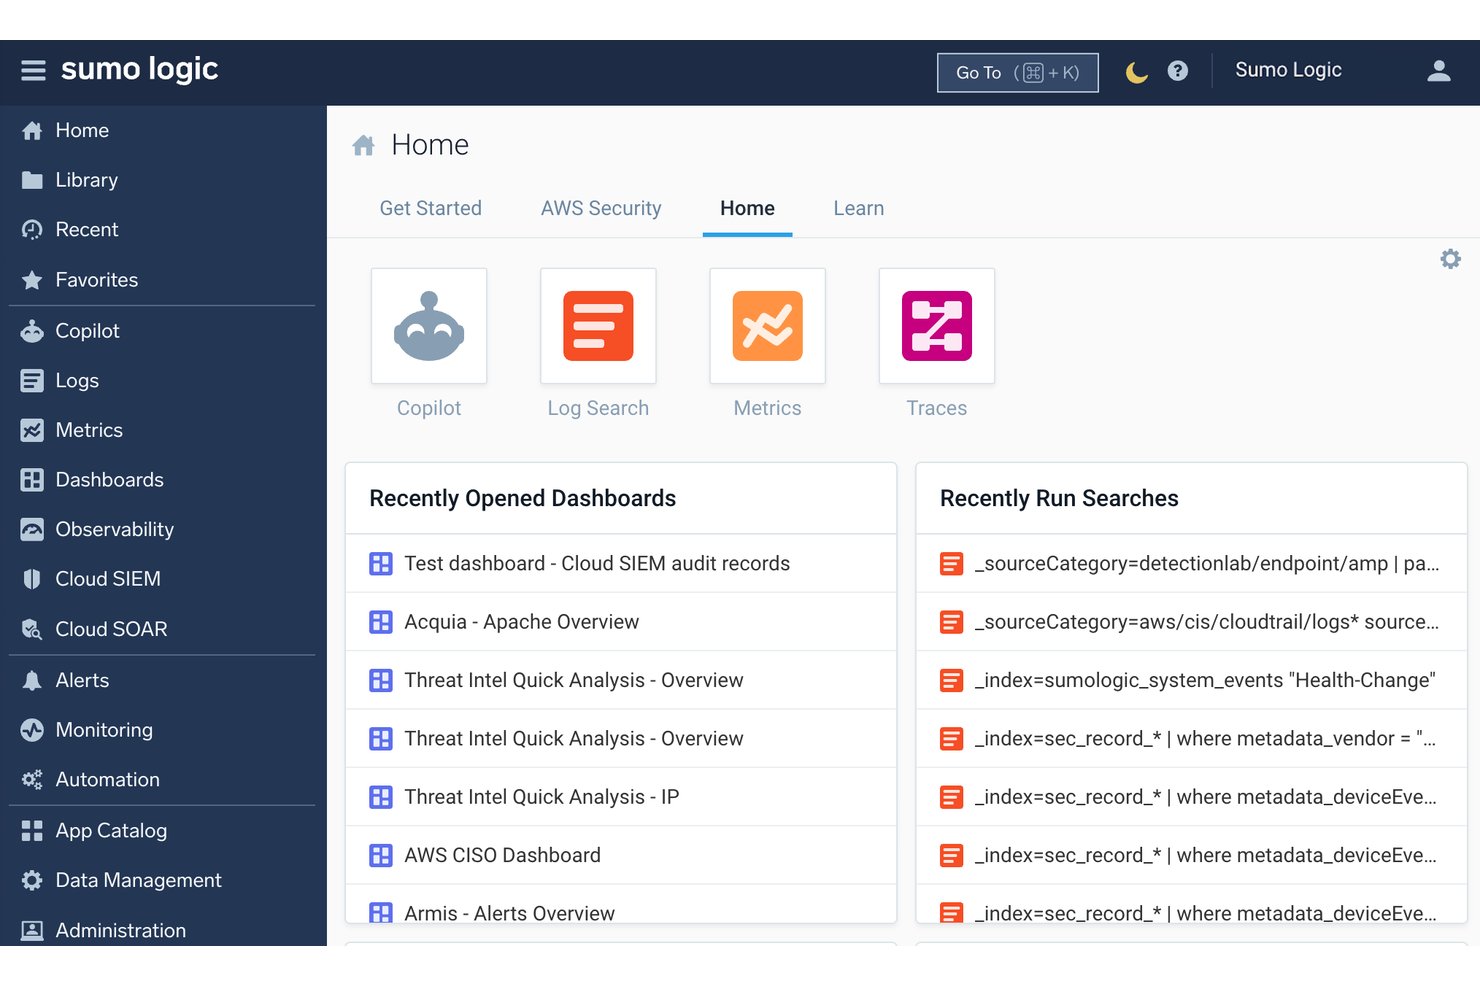
Sumo Logic es una plataforma de gestión de operaciones de TI nativa de la nube que unifica el análisis de registros, la monitorización de infraestructura, las métricas, el trazado distribuido y las operaciones de seguridad en una única solución de observabilidad y SIEM basada en SaaS.
¿Para quién es más adecuado Sumo Logic?
Sumo Logic es una opción excelente para equipos de TI y operaciones preocupados por la seguridad que necesitan capacidades de análisis de registros, métricas y SIEM en una única plataforma SaaS.
Por qué elegí Sumo Logic
Sumo Logic ocupa un lugar en mi lista corta porque es una de las pocas plataformas que integra el análisis de registros y las operaciones de seguridad en una herramienta SaaS única y realmente unificada. Me gusta cómo sus operadores patentados LogReduce y LogExplain revelan las causas raíz directamente a partir de datos de registros sin procesar, reduciendo la búsqueda manual de patrones que ralentiza la resolución de incidentes. La plataforma multiagente de IA Dojo también destaca: el agente de analista del SOC automatiza la clasificación de alertas de nivel 1 y proporciona veredictos respaldados por evidencias, algo que mi equipo considera inestimable cuando los flujos de trabajo de SecOps e ITOps se solapan.
Funciones principales de Sumo Logic
- Monitores de métricas impulsados por IA: La detección de anomalías basada en ML ajusta automáticamente las líneas base estacionales de los datos de métricas, reduciendo el volumen de alertas falsas positivas.
- Gestión multiempresa: Una organización principal controla monitores, paneles, roles y acceso en las organizaciones secundarias desde una única interfaz centralizada.
- Paneles de informes de cumplimiento: Los paneles prediseñados relacionan sus datos con los marcos PCI, HIPAA, GDPR, SOX e ISO para proporcionar visibilidad continua de la postura de cumplimiento.
- Agente distribuidor de OpenTelemetry: Un único agente unificado recopila registros, métricas y trazas en Linux, Windows, macOS y más de 25 configuraciones de origen.
Integraciones de Sumo Logic
Sumo Logic ofrece más de 450 integraciones, incluidas ServiceNow, PagerDuty, Jira, Slack, Microsoft Teams, AWS, Microsoft Azure, Google Cloud Platform, Kubernetes y Docker. También proporciona API REST, webhooks, Terraform, SumoQL y un Marco de Integración Abierta para la conectividad personalizada.
Pros and Cons
Pros:
- Dojo AI automatiza la clasificación y resolución de incidentes
- Los paneles de cumplimiento se relacionan directamente con los principales marcos
- Centraliza registros, métricas y trazas en una sola plataforma
Cons:
- La automatización avanzada favorece la seguridad por encima de las operaciones de TI
- La consulta de grandes conjuntos de datos históricos puede ser lenta

La mejor opción para obtener visibilidad operativa de pila completa nativa de OTel
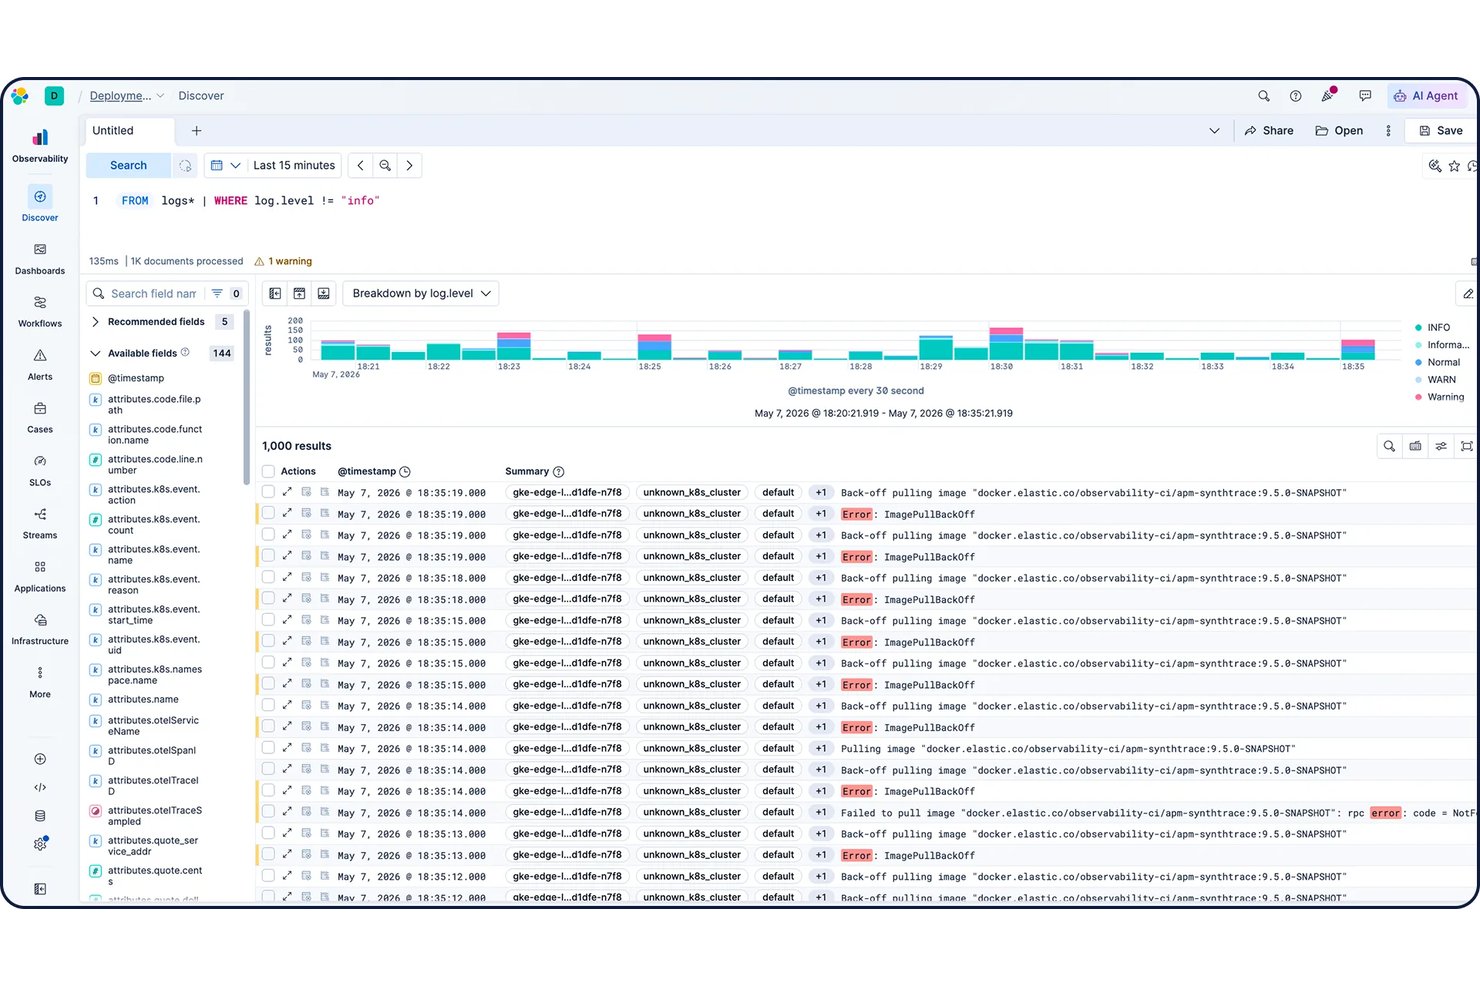
Elastic Observability es una plataforma de observabilidad de pila completa que unifica la supervisión de registros, las métricas de infraestructura, APM, el rastreo distribuido, la supervisión sintética y AIOps en entornos locales, en la nube e híbridos.
¿Para quién es más adecuada Elastic Observability?
Elastic Observability es una opción excelente para SRE y especialistas en infraestructura de empresas medianas y grandes que necesitan visibilidad unificada de registros, métricas, trazas y APM en entornos híbridos y multinube, especialmente para equipos que ya utilizan OpenTelemetry.
Por qué elegí Elastic Observability
Elastic Observability está en mi lista de opciones principales porque es una de las pocas plataformas creadas con un enfoque prioritario en OpenTelemetry, lo que significa que los datos de registros, métricas, trazas y APM llegan a un único esquema sin obligarte a lidiar con agentes propietarios. Me gusta especialmente la capa de ML sin configuración: más de 100 trabajos de detección de anomalías preconfigurados se ejecutan automáticamente en cada flujo de datos, de modo que, cuando se produce una ingesta a escala de Comcast, tu equipo no tiene que ajustar modelos manualmente. El análisis de registros basado en Streams y el motor de consultas ES|QL hacen que identificar las causas raíz en entornos híbridos sea realmente rápido.
Características principales de Elastic Observability
- Supervisión sintética: Ejecuta pruebas ligeras y pruebas completas del navegador sobre recorridos de usuario mediante una infraestructura global de pruebas administrada o ubicaciones privadas locales.
- Seguimiento de objetivos de nivel de servicio (SLO): Define, supervisa e informa sobre objetivos de fiabilidad directamente en Kibana, junto con tus paneles y alertas existentes.
- Alertas de Kibana: Configura alertas basadas en reglas para datos de APM, métricas, tiempo de actividad y seguridad mediante una configuración basada en formularios con compatibilidad con notificaciones multicanal.
- Más de 550 integraciones prediseñadas: Conéctate a proveedores de nube, herramientas de ITSM, plataformas de seguridad y fuentes de datos mediante agentes prediseñados y recopiladores sin agentes.
Integraciones de Elastic Observability
Elastic Observability ofrece más de 550 integraciones prediseñadas, incluidas AWS, Microsoft Azure, Google Cloud Platform, ServiceNow, Jira, PagerDuty, Slack, Microsoft Teams, Kubernetes y OpenTelemetry. También admite API REST, webhooks, Elastic Agent, Logstash, Beats y recopiladores de OpenTelemetry para conexiones personalizadas.
Pros and Cons
Pros:
- Visibilidad unificada en entornos híbridos y multinube
- El ML sin configuración detecta anomalías automáticamente
- La ingesta nativa de OTel evita la dependencia del proveedor
Cons:
- No incluye programación nativa de guardias
- La documentación es insuficiente para configuraciones complejas de OTel

OpsRamp
Ideal para operaciones de TI híbridas multiinquilino de nivel MSP
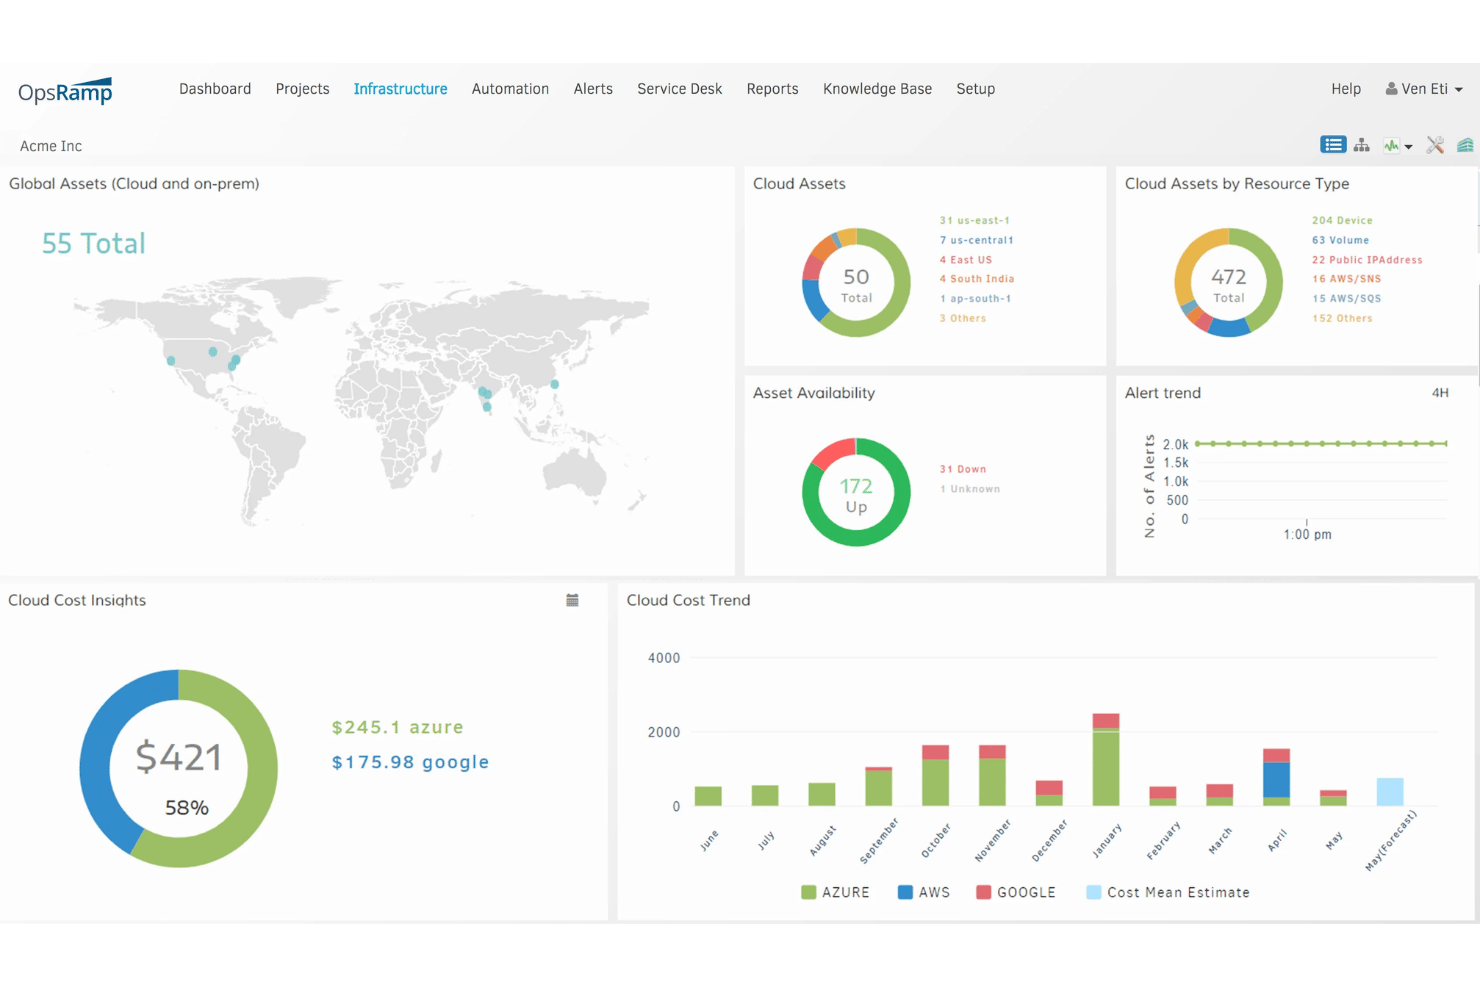
HPE OpsRamp es una plataforma de gestión de operaciones de TI basada en AIOps que unifica la monitorización de la infraestructura, la correlación de eventos, la gestión de incidentes, la automatización de procedimientos operativos y la visibilidad de entornos híbridos y multinube en entornos locales, de nube privada y de nube pública.
¿Para quién es más adecuado OpsRamp?
OpsRamp es una opción sólida para proveedores de servicios gestionados y grandes empresas que gestionan entornos de TI híbridos complejos en infraestructuras locales y multinube.
Por qué elegí OpsRamp
OpsRamp ocupa un lugar en mi lista de favoritos porque su arquitectura multiinquilino está diseñada específicamente para proveedores de servicios gestionados que administran decenas de entornos de clientes desde una única vista. Me gusta especialmente su motor de correlación de eventos AIOps, que agrupa las alertas relacionadas entre inquilinos y reduce el ruido hasta en un 90 %, para que tu equipo no se vea abrumado por los tickets de las distintas cuentas de clientes. Sus mapas de topología y servicios ofrecen una vista actualizada de las dependencias en entornos híbridos que abarcan AWS, Azure, GCP y sistemas locales, algo realmente difícil de replicar a esa escala.
Características principales de OpsRamp
- Motor de automatización de procedimientos operativos: Ejecuta automáticamente scripts de corrección predefinidos en respuesta a problemas detectados, con acceso a trabajos y flujos de procesos controlado mediante RBAC.
- Gestión de clientes multiinquilino: Gestiona múltiples entornos de clientes desde una única instancia de la plataforma, con configuración de integraciones por inquilino y gestión de datos aislada.
- Informes de costes de la nube: Desglosa el gasto en la nube por cuenta, región, servicio y tipo de instancia en AWS, Azure y GCP, con rangos de fechas personalizables.
- Recepción de OpenTelemetry: Incorpora métricas, registros y trazas de cualquier fuente compatible con OpenTelemetry, junto con la instrumentación automática asistida por eBPF para obtener una visibilidad profunda de las cargas de trabajo.
Integraciones de OpsRamp
OpsRamp ofrece más de 3.000 integraciones, incluidas ServiceNow, Jira Service Management, Zendesk, AWS, Microsoft Azure, Google Cloud Platform, Kubernetes, OpenTelemetry y Prometheus. Su API REST OAuth 2.0, los webhooks y la compatibilidad con la importación y exportación JSON permiten establecer conexiones personalizadas.
Pros and Cons
Pros:
- Gestión multiinquilino para entornos de clientes de proveedores de servicios gestionados
- Reducción del ruido de alertas de hasta un 90 %
- Visualizaciones de topología híbrida y multinube
Cons:
- Las funciones de monitorización de aplicaciones aún están madurando
- El rendimiento del panel puede ralentizarse a gran escala
Virtana
Ideal para una visibilidad profunda de las operaciones de almacenamiento y GPU
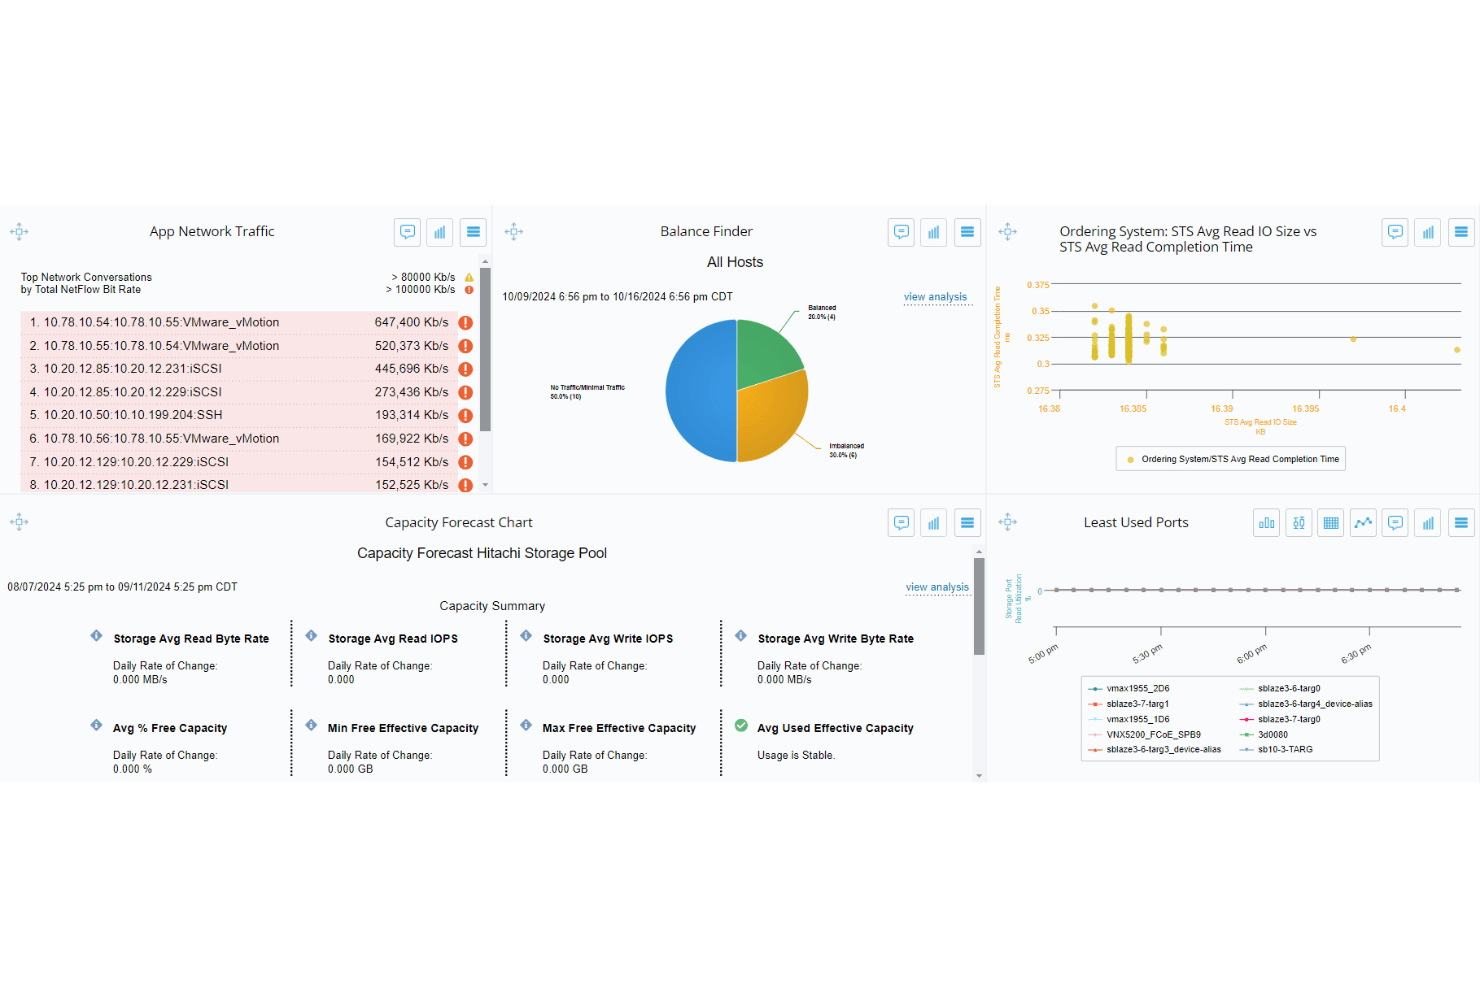
Virtana es una plataforma de AIOps y observabilidad de la infraestructura que supervisa entornos híbridos de computación, almacenamiento, redes, Kubernetes e infraestructura de GPU, con correlación de eventos basada en IA, detección de anomalías y gestión automatizada de incidentes integradas en su núcleo.
¿Para quién es más adecuada Virtana?
Virtana es una excelente opción para ingenieros de infraestructura y NetOps que gestionan entornos híbridos complejos donde la profundidad del almacenamiento, la visibilidad de las cargas de trabajo de GPU y la correlación de incidentes basada en IA son imprescindibles.
Por qué elegí Virtana
Elegí Virtana como una de las mejores opciones porque ninguna otra plataforma de mi lista analiza las métricas de almacenamiento con este nivel de profundidad: más de 16.000 métricas que abarcan entornos de bloques, NAS, SAN, SDS y HCI, todas correlacionadas en tiempo real con el contexto de computación y redes. Me impresiona especialmente su módulo específico de observabilidad de fábricas de IA, que realiza un seguimiento de la utilización de la GPU, la capacidad ociosa, la limitación del rendimiento y el rendimiento de NVLink/PCIe para equipos que ejecutan cargas de trabajo de entrenamiento o inferencia de LLM a gran escala. Su detección de anomalías basada en aprendizaje automático alcanza hasta un 95 % de precisión y revela los problemas antes de que se superen los umbrales, en lugar de hacerlo después de que se produzcan los daños.
Características principales de Virtana
- Remediación agéntica mediante IA: Los agentes de IA recorren el grafo de dependencias del sistema para investigar problemas de forma autónoma y ejecutar flujos de trabajo de remediación gobernados sin transferencias manuales.
- Previsión de capacidad: Utiliza hasta 12 meses de datos históricos para prever las necesidades de capacidad de computación, almacenamiento, redes y GPU con hasta un año de antelación.
- Sincronización bidireccional con ServiceNow: Crea, actualiza y cierra automáticamente incidentes de ServiceNow según los eventos detectados, con asignación de criticidad empresarial e integración con CMDB.
- Mapeo de topología y dependencias: Descubre automáticamente y de forma continua las relaciones entre aplicaciones, servicios e infraestructura, y las representa para mantener un modelo del sistema activo y consultable.
Integraciones de Virtana
Virtana cuenta con una integración nativa con ServiceNow, además de integraciones con Slack, Microsoft Teams, PagerDuty, AWS, Azure, GCP, Kubernetes, VMware y OpenTelemetry. Las API REST y un servidor MCP admiten integraciones personalizadas y el acceso de agentes de IA.
Pros and Cons
Pros:
- Recopila más de 16.000 métricas de almacenamiento en distintos entornos
- Realiza un seguimiento nativo del rendimiento de la GPU y de las cargas de trabajo de IA
- La detección de anomalías basada en IA alcanza una gran precisión
Cons:
- Las visualizaciones de la interfaz de usuario pueden parecer limitadas
- La base de reseñas es menor que la de los principales competidores
La mejor para la validación de lanzamientos de pila completa basada en IA
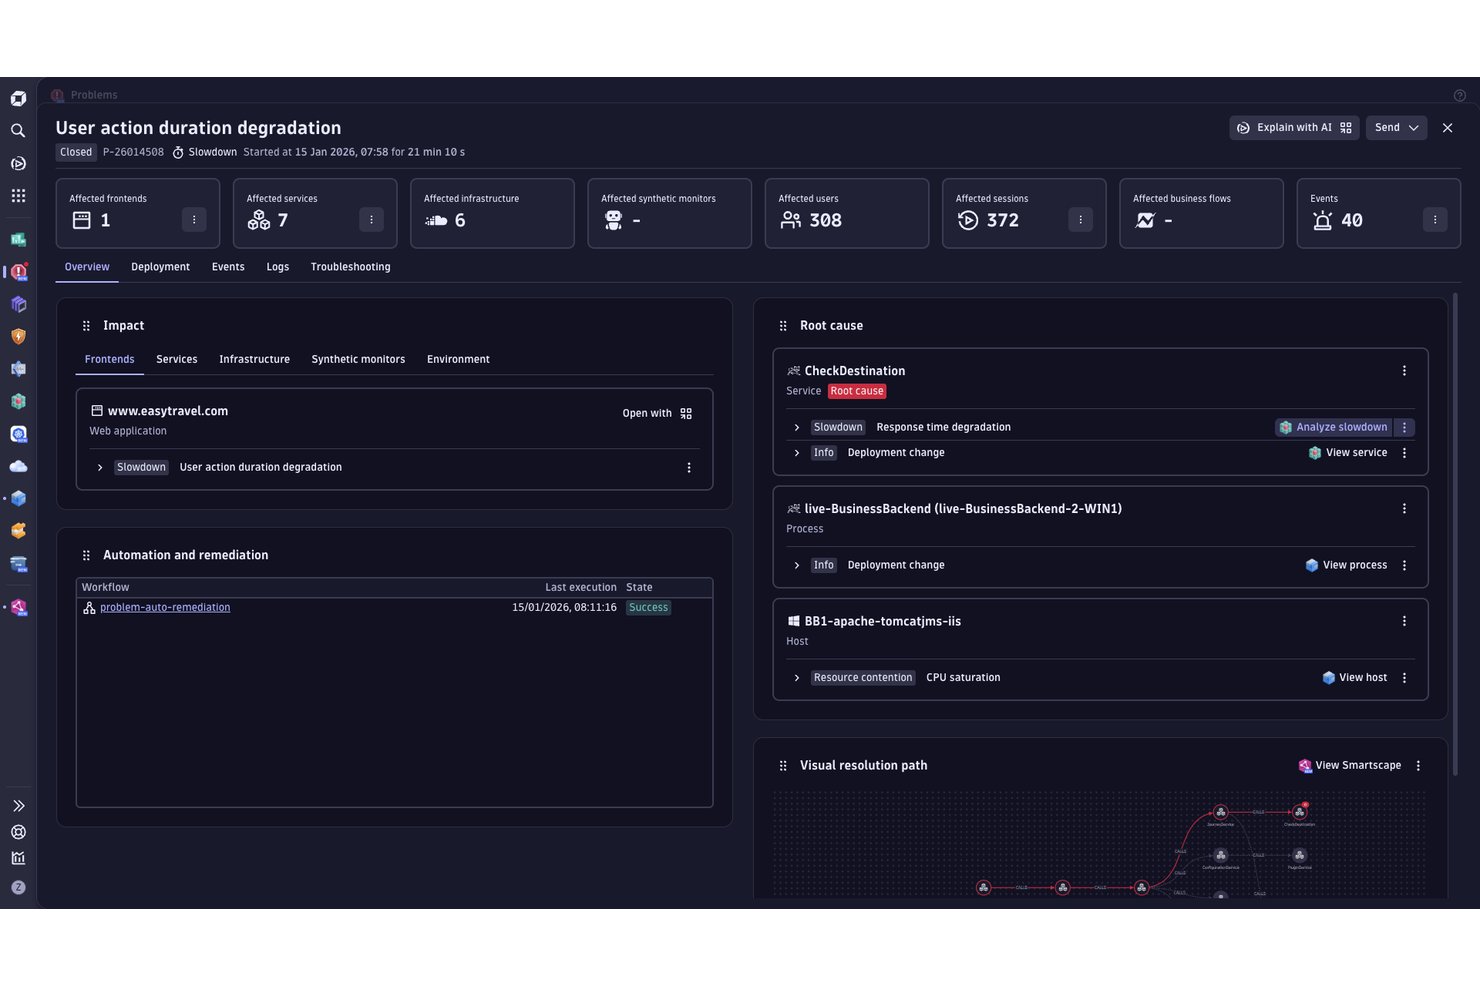
Dynatrace es una plataforma de gestión de operaciones de TI de pila completa que abarca la monitorización de la infraestructura, la detección de incidentes basada en AIOps, el análisis de registros y la automatización de flujos de trabajo en entornos híbridos y multinube.
¿Para quién es más adecuada Dynatrace?
Dynatrace es una opción adecuada para equipos empresariales de TI y SRE que gestionan entornos híbridos o multinube complejos y necesitan observabilidad basada en IA, respuesta automatizada a incidentes y validación de lanzamientos a gran escala.
Por qué elegí Dynatrace
Elegí Dynatrace como una de las mejores porque su función de garantía de fiabilidad del sitio es la configuración de validación de lanzamientos más completa que he visto en esta categoría: evalúa automáticamente cada despliegue según SLOs y KPIs predefinidos antes de que el código llegue a producción, bloqueando los lanzamientos defectuosos sin revisión manual. Si a eso le sumamos la capacidad de Davis AI para rastrear una anomalía en producción hasta una única causa raíz entre miles de millones de dependencias activas, obtenemos una plataforma que detecta lo que supera los controles de calidad y explica exactamente por qué.
Características principales de Dynatrace
- Mapeo de topología Smartscape: Detecta y visualiza automáticamente las dependencias en tiempo real entre hosts, contenedores, servicios y procesos en entornos híbridos y multinube.
- Lago de datos Grail: Unifica métricas, registros, trazas, eventos y señales de seguridad en un único almacén sin índices, consultable mediante DQL sin configurar esquemas.
- Constructor de flujos de trabajo AutomationEngine: Un editor visual sin código/con poco código para crear flujos de automatización basados en eventos o programados, fundamentados en datos de observabilidad activos.
- Alertas predictivas: Pronostica las infracciones de capacidad y rendimiento antes de que ocurran mediante líneas base de comportamiento aprendidas continuamente en cada componente monitorizado.
Integraciones de Dynatrace
Dynatrace ofrece más de 900 integraciones a través de Dynatrace Hub, incluidas ServiceNow, Jira Service Management, PagerDuty, Slack, Microsoft Teams, AWS, Azure, Google Cloud y OpenTelemetry. Su API REST, los webhooks y el SDK de AppEngine permiten crear integraciones personalizadas.
Pros and Cons
Pros:
- Un único agente detecta automáticamente todos los activos de la pila
- Davis AI identifica la verdadera causa raíz
- Remediación automatizada con controles humanos en el proceso
Cons:
- La tarificación por consumo dificulta la elaboración de presupuestos
- El modelo basado únicamente en SaaS limita las opciones para necesidades de entornos aislados
Ideal para operaciones de causa raíz basadas en IA, desde las alertas hasta la topología
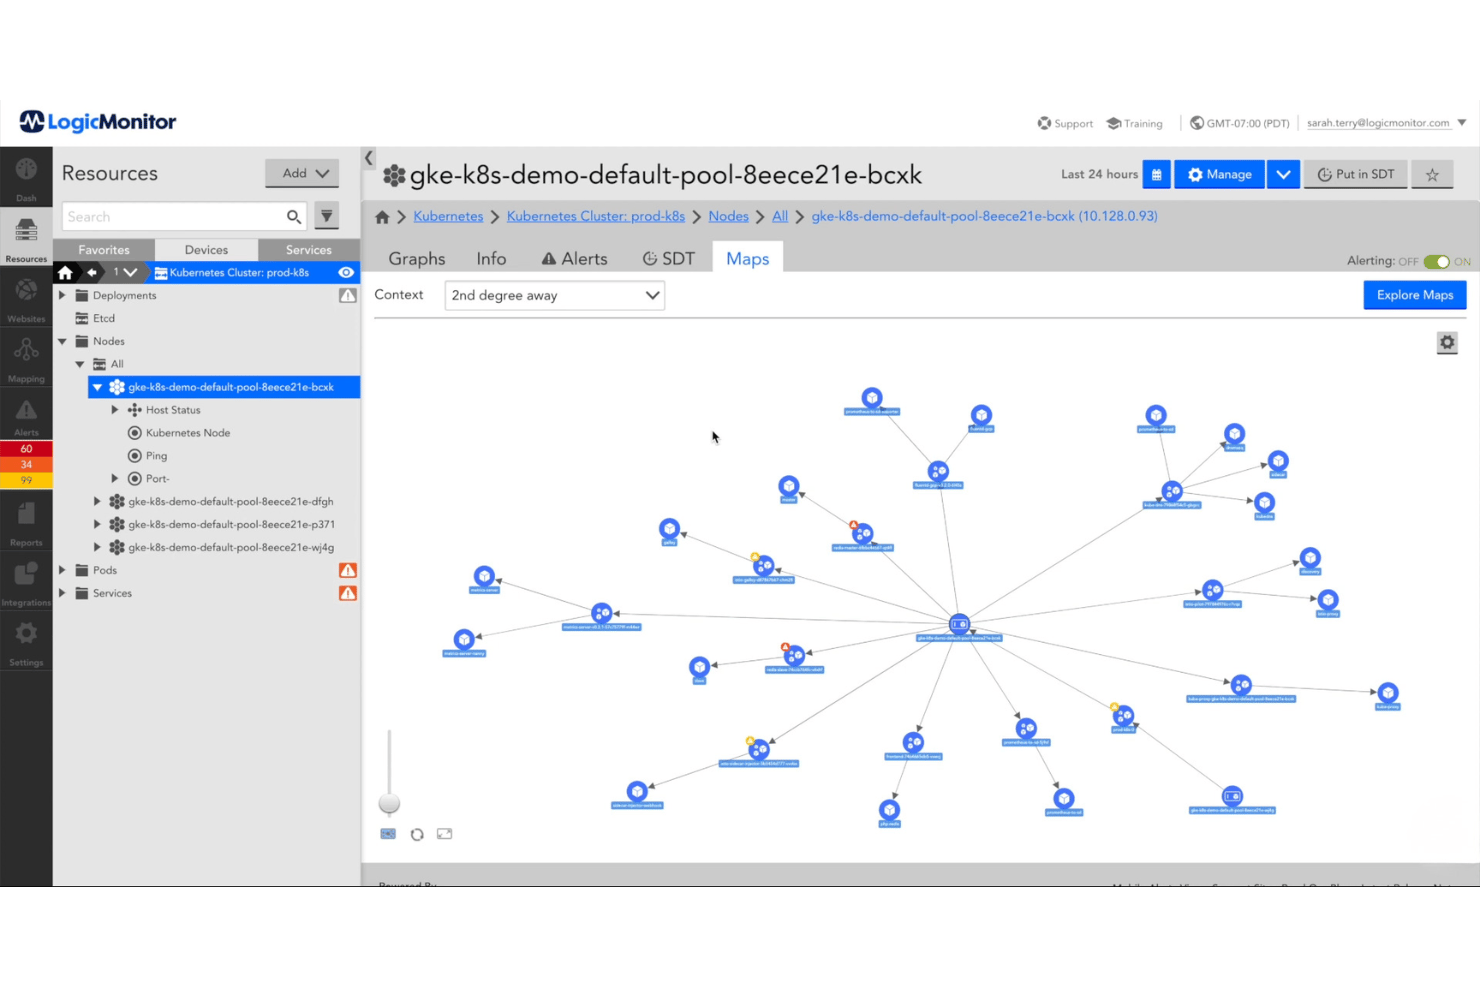
LogicMonitor es una plataforma de gestión de operaciones de TI de pila completa que abarca la supervisión de infraestructura, redes, nubes, contenedores y aplicaciones, junto con la correlación de alertas basada en AIOps, el mapeo de topologías y el análisis de registros en una única plataforma unificada.
¿Para quién es más adecuado LogicMonitor?
LogicMonitor es una opción sólida para los equipos de operaciones de infraestructura y redes que gestionan entornos grandes e híbridos en instalaciones locales y en múltiples nubes.
Por qué elegí LogicMonitor
LogicMonitor está en mi lista de opciones principales por la estrecha conexión entre la correlación de alertas y el análisis de causas raíz basado en la topología. Edwin AI comprime las avalanchas de alertas en incidentes priorizados y explicables, mientras que ITOps Context Graph combina la topología, la telemetría y los datos de cambios para que puedas identificar una causa raíz probable en minutos en lugar de horas. He visto equipos reducir el ruido de las alertas en un 78 % después de implementar Edwin AI, lo que significa que los ingenieros de guardia dedican menos tiempo a clasificar el ruido y más tiempo a resolver el problema real.
Características principales de LogicMonitor
- Supervisión de infraestructura de pila completa: Supervisa servidores, dispositivos de red, máquinas virtuales, bases de datos, almacenamiento y contenedores en entornos híbridos desde una única plataforma.
- LM Exchange: Te ofrece acceso a más de 2.000 LogicModules prediseñados que abarcan proveedores de nube, equipos de red, bases de datos y aplicaciones.
- Análisis e inteligencia de registros: Correlaciona los datos de los registros con las métricas en tiempo real para que puedas investigar incidentes sin cambiar de herramienta.
- Integraciones bidireccionales con ITSM: Sincroniza los ciclos de vida de las alertas y los tickets con ServiceNow, Jira Service Management, PagerDuty, ConnectWise y Autotask.
Integraciones de LogicMonitor
LogicMonitor ofrece más de 2.000 integraciones de marketplace a través de LM Exchange, además de integraciones nativas con ServiceNow, Jira Service Management, PagerDuty, ConnectWise y Datto Autotask. Una API REST documentada permite crear integraciones personalizadas.
Pros and Cons
Pros:
- Reduce el ruido de las alertas con Edwin AI
- Mapea la topología para agilizar el análisis de causas raíz
- Paneles personalizables para distintas funciones de TI
Cons:
- La estructura de precios es difícil de entender
- Los cambios en la interfaz dificultan la navegación
Ideal para la observabilidad de pila completa a nivel de transacción
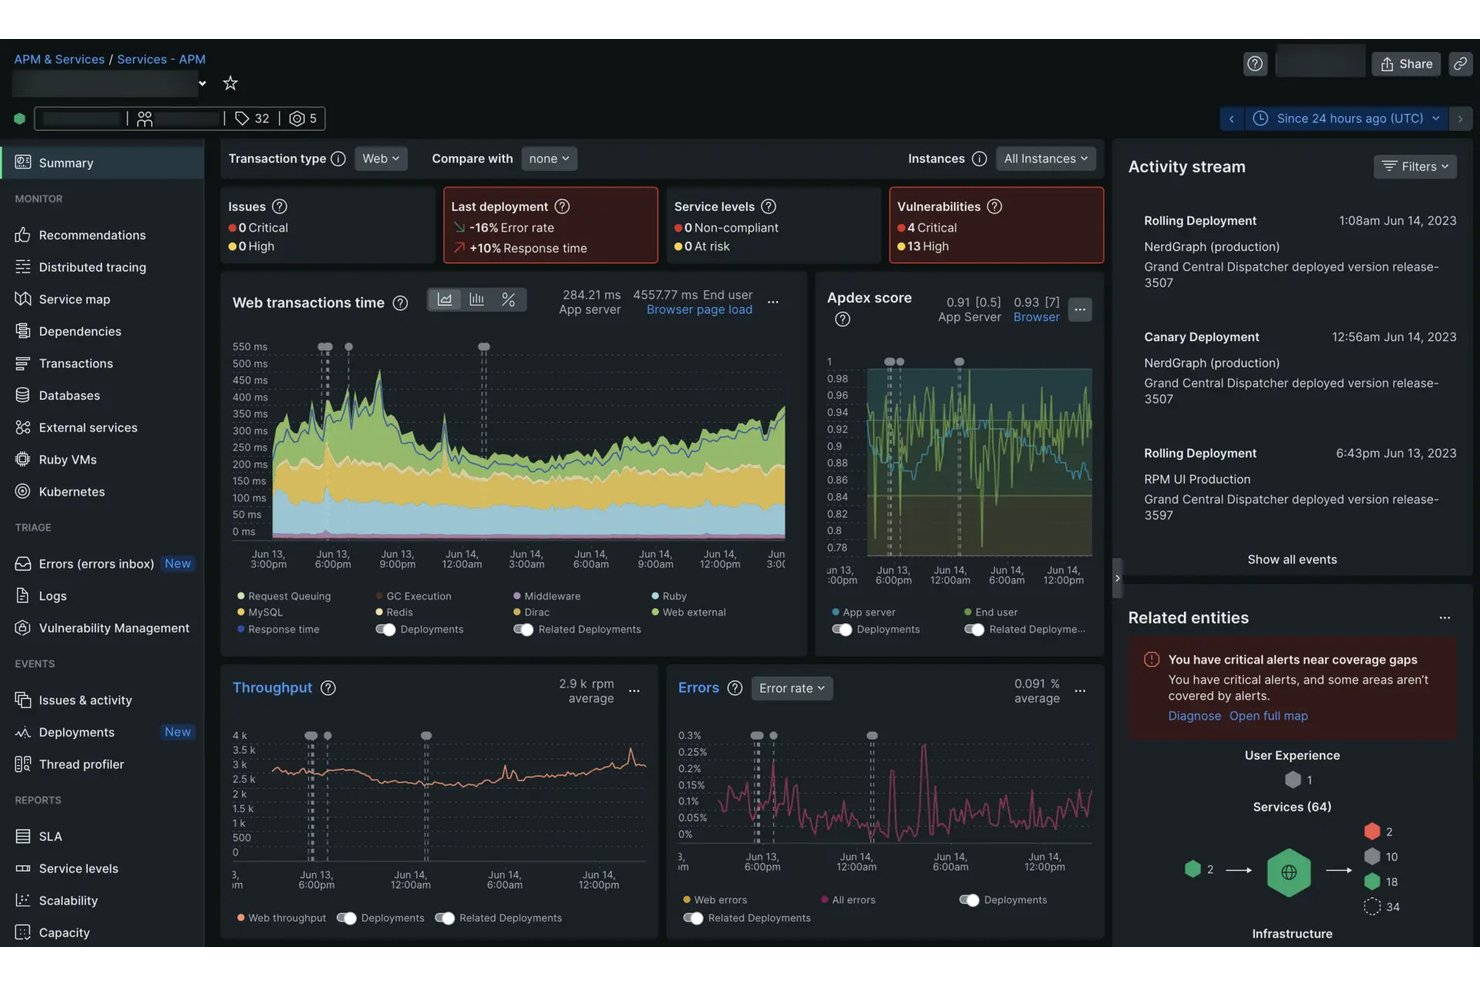
New Relic es una plataforma de observabilidad de pila completa que unifica métricas, registros, trazas y datos de experiencia digital de la infraestructura, las aplicaciones, los entornos de nube y las redes en una sola interfaz.
¿Para quién es más adecuado New Relic?
New Relic es una opción excelente para los ingenieros de SRE y de infraestructura que gestionan entornos de producción complejos y de alto tráfico, donde la visibilidad a nivel de transacción en toda la pila es imprescindible.
Por qué elegí New Relic
New Relic ocupa un lugar en mi lista de favoritos gracias a Transaction 360, que correlaciona la telemetría, las alertas y los cambios de implementación a nivel de cada transacción y reduce el MTTR hasta 5 veces. También me gusta cómo los agentes de Autopilot investigan incidentes de forma autónoma utilizando telemetría en tiempo real y procedimientos operativos, y luego muestran un razonamiento transparente y auditable en lugar de simplemente ejecutar una acción de remediación. Esta combinación de trazas a nivel de transacción y resolución de incidentes mediante agentes es lo que convierte a New Relic en mi opción preferida para la observabilidad de pila completa.
Características principales de New Relic
- Alertas inteligentes: El ajuste dinámico de los umbrales utiliza la volatilidad histórica para minimizar los falsos positivos y dirige automáticamente las alertas al equipo adecuado mediante etiquetas de entidad.
- Inteligencia sobre costes de la nube: Seguimiento de costes en tiempo real en AWS, Azure, GCP y Kubernetes, con recomendaciones de dimensionamiento adecuado vinculadas a los patrones de uso reales y alertas de umbral presupuestario.
- Automatización de flujos de trabajo: Un lienzo sin código de arrastrar y soltar permite crear flujos de trabajo de remediación de varios pasos con lógica condicional, bucles y consultas NRQL en tiempo real.
- Registros federados: Consulta los registros directamente desde los depósitos de S3 sin volver a ingerirlos ni mover los datos, lo que facilita el cumplimiento de los requisitos de residencia de datos y conformidad.
Integraciones de New Relic
New Relic ofrece más de 800 integraciones prediseñadas, incluidas ServiceNow, Jira, PagerDuty, Slack, Microsoft Teams, AWS, Azure, Google Cloud Platform, Kubernetes y VMware. NerdGraph, la API REST, los webhooks, OpenTelemetry y la compatibilidad con Prometheus permiten establecer conexiones personalizadas.
Pros and Cons
Pros:
- Correlaciona métricas, registros y trazas al instante
- Automatiza el enrutamiento de alertas mediante etiquetas de entidad
- Investigación de incidentes transparente basada en IA
Cons:
- Los precios basados en el consumo pueden aumentar rápidamente
- La retención ampliada de datos requiere una actualización de pago

Ideal para operaciones de TI híbridas a gran escala basadas en una CMDB
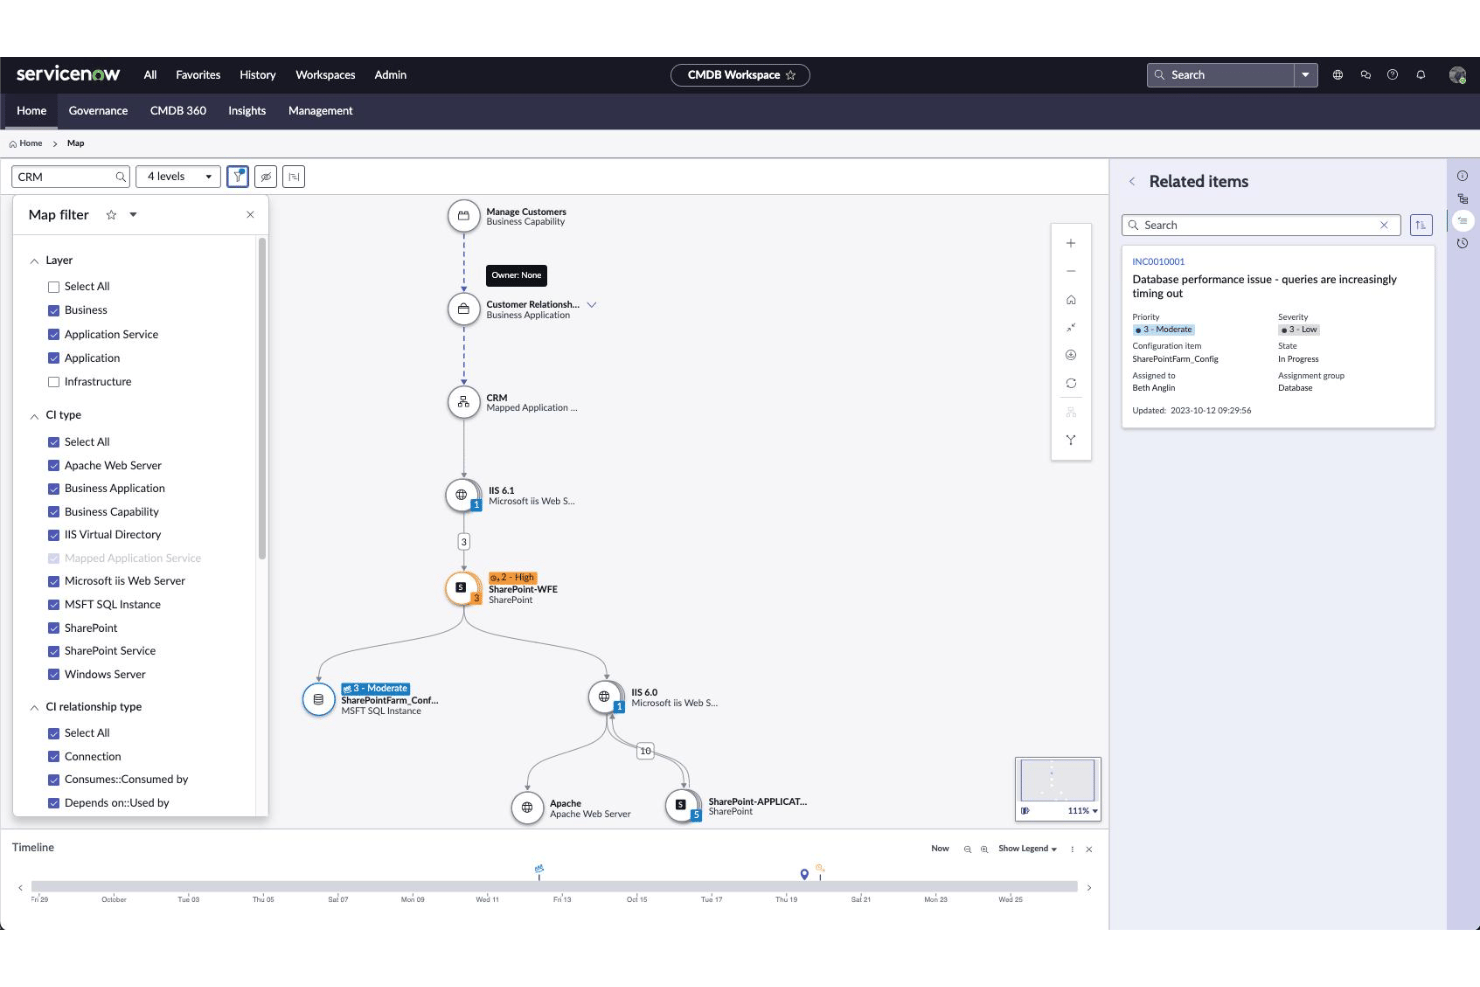
ServiceNow ITOM es una plataforma empresarial de gestión de operaciones de TI basada en una CMDB continuamente actualizada, que ofrece descubrimiento sin agentes, gestión de eventos impulsada por AIOps, mapeo de servicios, visibilidad de la nube y orquestación automatizada en entornos híbridos y multinube.
¿Para quién es más adecuado ServiceNow ITOM?
ServiceNow ITOM está diseñado para grandes empresas que operan entornos de TI híbridos complejos, donde una CMDB continuamente actualizada constituye la columna vertebral operativa.
Por qué elegí ServiceNow ITOM
ServiceNow ITOM ocupa un lugar en mi lista de favoritos porque aquí la CMDB no es simplemente una base de datos, sino la columna vertebral operativa activa a la que Discovery y los conectores de Service Graph aportan continuamente datos reales de todo el entorno híbrido. Me gusta especialmente cómo Service Mapping crea automáticamente visualizaciones de dependencias entre la infraestructura y los servicios empresariales, de modo que, cuando una instancia de AWS se degrada, puedes ver exactamente qué servicios se ven afectados antes de que los usuarios lo noten. AIOps LEAP va más allá al analizar incidentes cerrados para generar e implementar manuales de corrección automatizados, junto con un panel de ROI que registra lo que realmente se ha ahorrado.
Funciones principales de ServiceNow ITOM
- Análisis de registros de estado: Utiliza IA para analizar los datos de registro en tiempo real, señalar anomalías y mostrar recomendaciones de corrección antes de que los problemas se agraven.
- Supervisión sintética: Simula transacciones de usuarios finales para detectar problemas de disponibilidad y rendimiento antes de que afecten a los usuarios reales.
- Aceleración de la nube: Automatiza el aprovisionamiento y desaprovisionamiento de recursos en la nube, al tiempo que aplica políticas de etiquetado, costes y seguridad en AWS, Azure y GCP.
- Gestión de certificados: Descubre y realiza un seguimiento automático de los certificados TLS/PKI en todo el entorno y activa flujos de trabajo de renovación antes de su vencimiento.
Integraciones de ServiceNow ITOM
ServiceNow ITOM se integra con AWS, Microsoft Azure, Google Cloud Platform, Alibaba Cloud, Datadog, Dynatrace, Splunk, PagerDuty, Jenkins y GitHub. Las API REST y SOAP, los webhooks y las integraciones de ServiceNow Store permiten establecer conectividad personalizada.
Pros and Cons
Pros:
- La CMDB impulsa la visibilidad de las operaciones en tiempo real
- La IA generativa automatiza la clasificación y corrección de incidentes
- El descubrimiento multinube abarca AWS, Azure y GCP
Cons:
- Solo SaaS, sin opción de implementación autogestionada
- Las funciones avanzadas requieren licencias de módulos independientes

Ideal para operaciones del estado de los servicios entre dominios nativos de Cisco
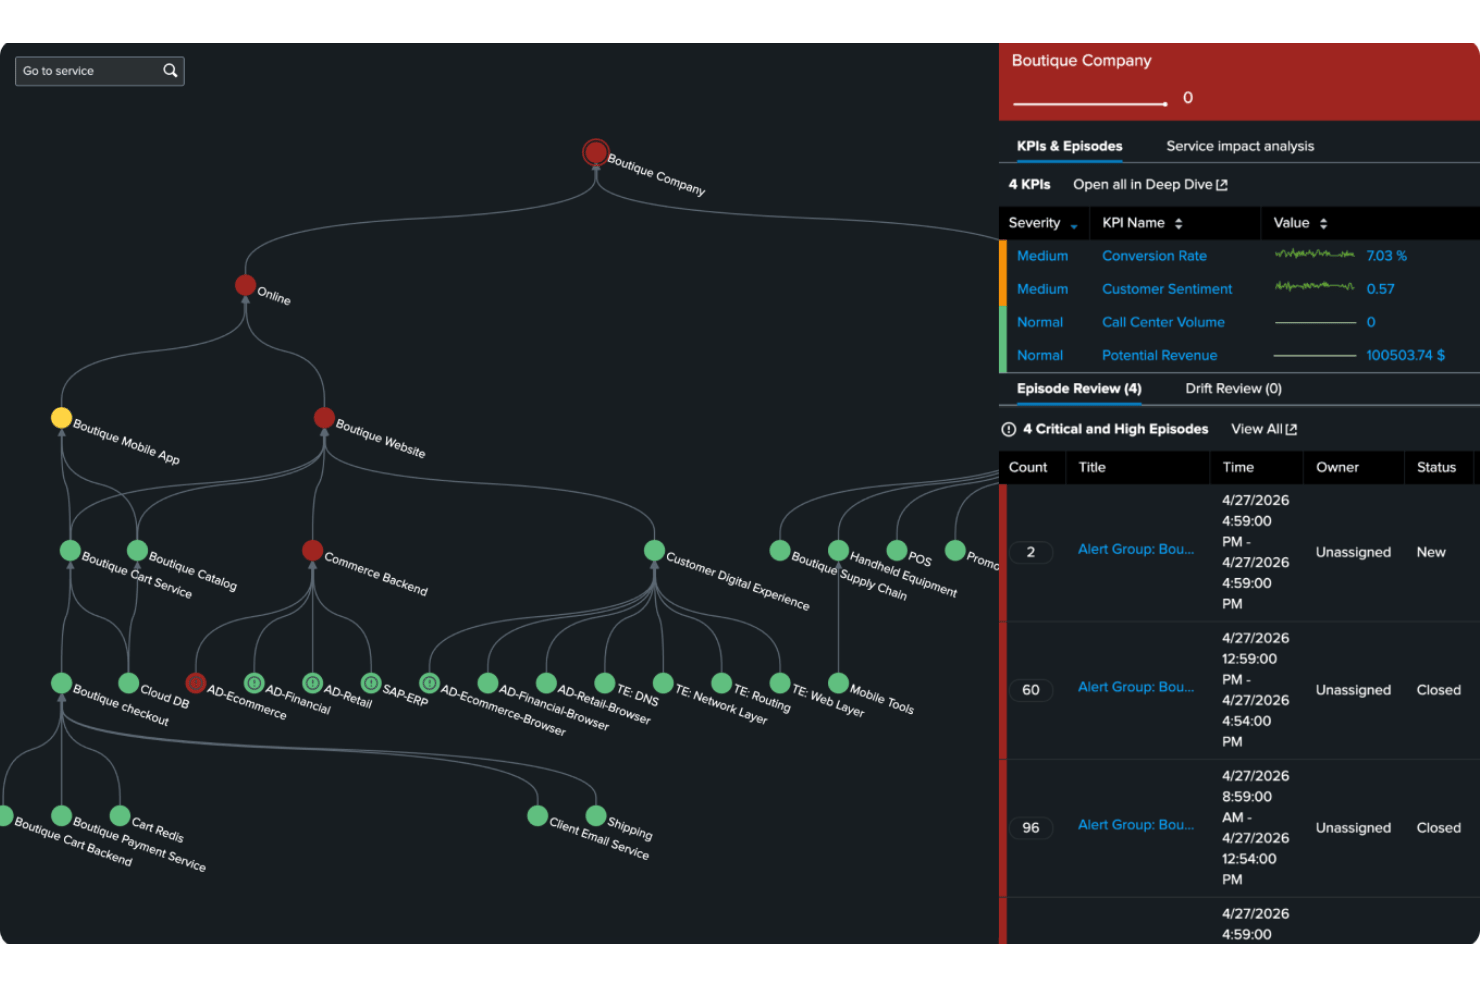
Splunk IT Service Intelligence (ITSI) es una plataforma de gestión de operaciones de TI impulsada por AIOps que ofrece puntuación del estado de los servicios basada en KPI, correlación de alertas mediante IA, mapeo de topologías y visibilidad entre dominios de la infraestructura, las aplicaciones y las redes.
¿Para quién es más adecuado Splunk IT Service Intelligence?
Splunk ITSI es una opción excelente para los equipos empresariales de operaciones de TI, especialmente aquellos que ya utilizan Splunk o trabajan en entornos Cisco, y que necesitan correlacionar el estado de los servicios de la infraestructura, las aplicaciones y las redes a gran escala.
Por qué elegí Splunk IT Service Intelligence
Splunk ITSI ocupa un lugar en mi lista de opciones porque gestiona el estado de los servicios entre dominios en entornos nativos de Cisco. Me gusta que incorpore directamente las señales de Cisco ThousandEyes, Meraki y Catalyst Center en su modelo de puntuación del estado basado en KPI, de modo que la visibilidad entre la red y las aplicaciones no tenga que integrarse manualmente. Su motor Event iQ correlaciona después esas señales en episodios consolidados, reduciendo el ruido de las alertas antes de que el equipo pierda tiempo con duplicados.
Funciones principales de Splunk IT Service Intelligence
- Tablas de cristal: Crea paneles de control de precisión a nivel de píxel mediante la función de arrastrar y soltar, que asignan las puntuaciones activas del estado de los servicios a KPI empresariales como el cumplimiento de los SLA o el impacto en los ingresos.
- Umbrales adaptativos: Los modelos de ML establecen una línea base del comportamiento normal de cada KPI a lo largo del tiempo y activan alertas ante desviaciones estadísticas en lugar de umbrales fijos.
- Espacio de trabajo de revisión de episodios: Una interfaz de triaje centralizada donde aparecen grupos de alertas correlacionados mediante IA, con puntuación de gravedad, contexto del servicio afectado y próximos pasos recomendados.
- Modelado de dependencias de servicios: Define y visualiza relaciones jerárquicas entre servicios empresariales, subservicios, hosts y dispositivos de red para aislar más rápidamente las causas raíz.
Integraciones de Splunk IT Service Intelligence
Splunk IT Service Intelligence se integra con ServiceNow, PagerDuty, Jira Cloud, Cisco ThousandEyes, Cisco Catalyst Center, Cisco Meraki, Splunk Observability Cloud, AppDynamics y Red Hat Ansible Automation Platform. También ofrece integraciones del marketplace de Splunkbase, acceso a la API REST, SDK de Python, webhooks y Kafka.
Pros and Cons
Pros:
- Correlación y triaje avanzados de alertas mediante IA
- Supervisión unificada entre dominios para entornos Cisco
- Paneles de control altamente personalizables para métricas empresariales
Cons:
- Elevados requisitos de recursos para implementaciones grandes
- Complejidad de implementación para el modelado de servicios y entidades
La mejor opción para IA agéntica en operaciones desde sistemas centrales hasta la nube
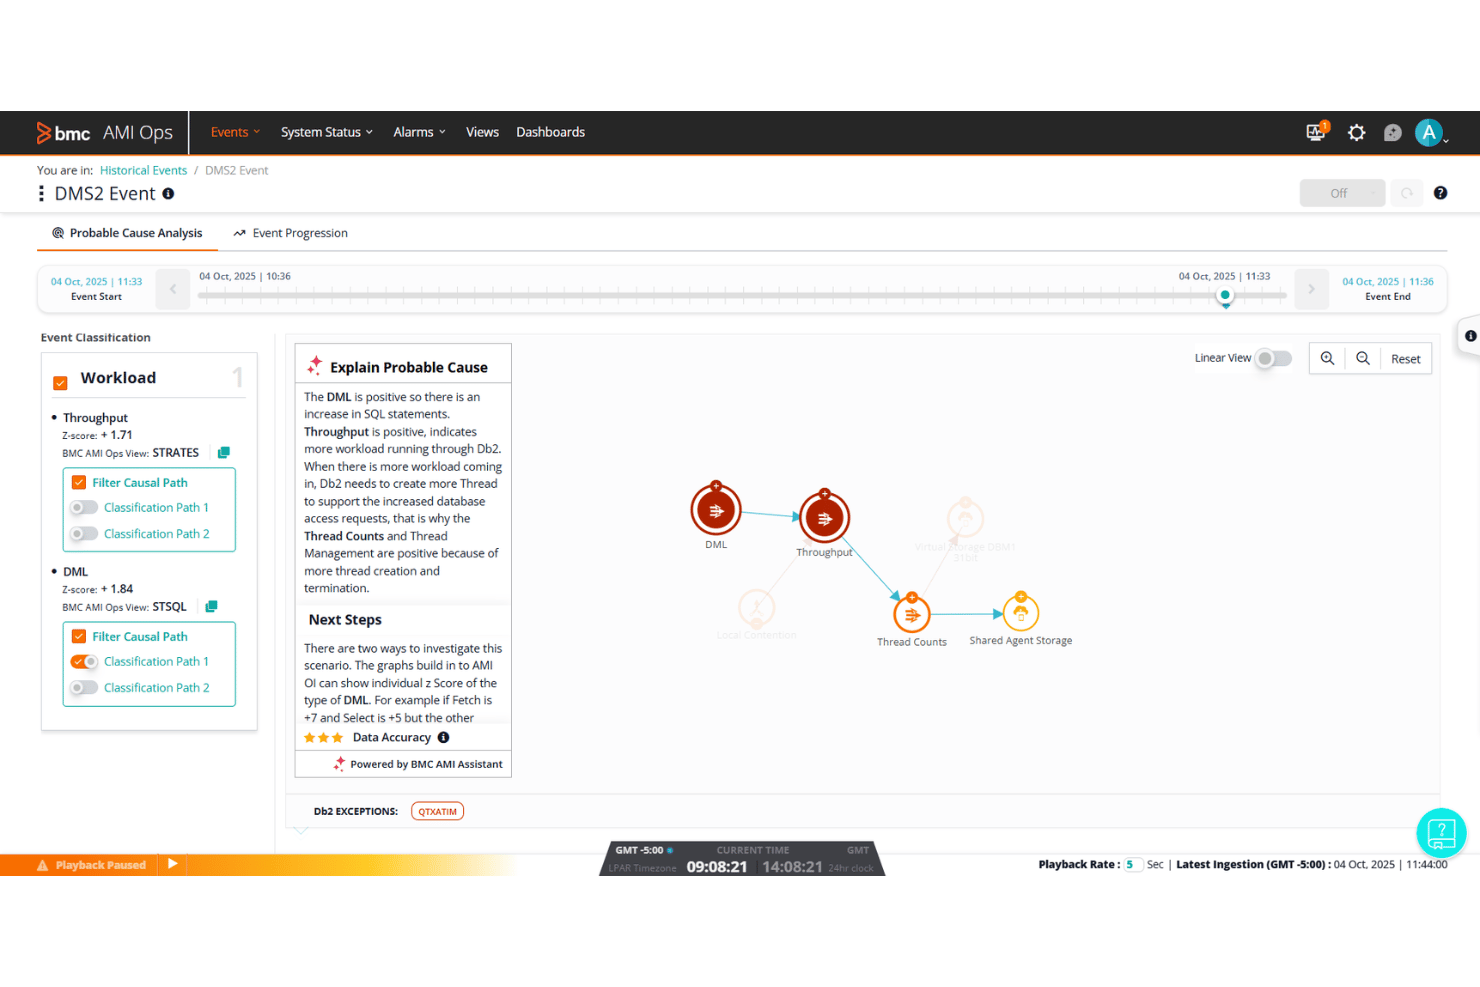
BMC Helix AIOps es una plataforma de gestión de operaciones de TI nativa de la nube que unifica la supervisión de eventos, la correlación de incidentes basada en IA, la remediación automatizada y el mapeo de topología en entornos locales, de nube y de sistemas centrales.
¿Para quién es más adecuado BMC Helix AIOps?
BMC Helix AIOps está diseñado para grandes empresas que ejecutan entornos híbridos complejos que abarcan sistemas centrales, infraestructura local y varias nubes públicas.
Por qué elegí BMC Helix AIOps
BMC Helix AIOps ocupa un lugar en mi lista de opciones porque es una de las pocas plataformas que he visto que realmente abarca desde el sistema central hasta la nube sin tratar ninguno de los extremos como algo secundario. Confío en las capacidades de IA agéntica de HelixGPT, específicamente Agent Builder y Ops Swarmer, para gestionar el triaje autónomo de incidentes en entornos z/OS y clústeres de Kubernetes dentro del mismo flujo de trabajo. La correlación de situaciones basada en IA reduce el ruido de las alertas hasta en un 90 %, lo que en la práctica significa que mi equipo no se ve inundado de alertas duplicadas en 600 paneles.
Funciones principales de BMC Helix AIOps
- Análisis de la causa probable: La IA correlaciona los datos de topología y eventos para identificar la causa raíz más probable de una situación antes de que comience la investigación manual.
- Analizador de autopsias de HelixGPT: Genera automáticamente resúmenes detallados de las revisiones posteriores a incidentes para ayudar a los equipos de SRE y operaciones después de la resolución.
- Creación dinámica de planos de servicios: Se integra con BMC Helix Discovery para generar automáticamente y actualizar de forma continua modelos de servicios que representan las dependencias en todo el entorno híbrido.
- Vistas de paneles basadas en roles: Segmenta los datos operativos y los informes por rol, proporcionando a cada miembro del equipo una vista filtrada de las métricas y los eventos relevantes para su función.
Integraciones de BMC Helix AIOps
BMC Helix AIOps se integra con BMC Helix ITSM, ServiceNow, AWS, Azure, Google Cloud Platform, Microsoft Teams, Slack, BMC Helix Discovery y Jitterbit. También admite API REST, conectividad con CMDB, herramientas de supervisión de terceros y la implementación desde AWS Marketplace.
Pros and Cons
Pros:
- Supervisión nativa de sistemas centrales y nubes híbridas
- Reducción del ruido de alertas basada en IA de hasta el 90 %
- Mapeo automatizado de topología y dependencias incluido
Cons:
- La configuración requiere una experiencia técnica considerable
- La personalización de los paneles es menos intuitiva que la de los competidores
Otro software de gestión de operaciones de TI
Estas son algunas opciones adicionales de software de gestión de operaciones de TI que no llegaron a mi lista de selección, pero que aun así merece la pena consultar:
- Datadog
Ideal para telemetría unificada con FinOps integrado
- ManageEngine OpManager
La mejor opción para la automatización de flujos de trabajo del fallo a la solución sin código
- BigPanda
Ideal para la puntuación del riesgo de cambios impulsada por IA
- PagerDuty
Ideal para la respuesta a incidentes de guardia a escala
- Zabbix
Ideal para la supervisión de operaciones de código abierto a cualquier escala
- Moogsoft
Ideal para la reducción del ruido de alertas impulsada por ML
- Checkmk
Ideal para precios basados en servicios en infraestructuras híbridas
- Ivanti Neurons
La mejor opción para la automatización de TI y SecOps centrada en ITSM
- Grafana Cloud
Ideal para la observabilidad de operaciones de pila completa guiada por ML
- SolarWinds Observability SaaS
La mejor opción para la observabilidad de pila completa basada en NetOps


How I Evaluate IT Operations Management Software
When an alert storm hits at 2 a.m. and your team needs to trace a degraded API back to a misconfigured container in a hybrid cluster, the tools either hold up or they don't—so I split my evaluation into baseline functionality every platform must cover and the differentiators that separate good from great.
Core Functionality (Table Stakes For This List)
When I'm selecting tools for my list, I rank each one on a scale from 0 (does not offer the functionality) to 5 (excels in this area) for each core functionality listed below. I then calculate the tool's total score into a percentage, using 75% as a benchmark to help assess its overall fit for the list.
- Infrastructure & App Monitoring: I check whether the platform covers servers, networks, apps, and cloud resources with real-time metrics, logs, and traces.
- Alerting & Incident Management: Each tool's alert correlation, escalation policies, and incident workflows matter—especially how well it cuts through noise during an outage.
- IT Automation & Orchestration: I look for visual workflow builders, auto-remediation playbooks, and cross-platform runbooks that reduce manual toil on recurring tasks.
- Hybrid & Multi-Cloud Visibility: Unified dashboards across on-prem, AWS, Azure, and GCP are table stakes—I evaluate topology mapping and dynamic discovery depth.
- Reporting & Analytics Dashboards: Customizable dashboards with drill-downs, SLA/SLO tracking, and capacity forecasting tell me how well a tool supports planning conversations.
- Integrations & API Access: I evaluate prebuilt connectors to ITSM, DevOps, and chatops tools, plus REST API coverage for teams that need to build custom workflows.
Once I have a list of tools that meet the criteria, I consider what sets each platform apart.
Differentiating Factors (What Sets Vendors Apart)
Here's how I compare and contrast different vendors:
Standout Features
I evaluate how well each platform's AIOps engine baselines normal behavior and correlates related events into a single incident—during a noisy outage, the difference between 200 alerts and one actionable incident is hours of recovery time. Topology and dependency mapping matters just as much: I check whether the tool auto-discovers relationships across containers, hosts, and network paths so you can trace a failing checkout API back to an undersized pod without switching screens. I also look at built-in cloud cost visibility, since platforms like Datadog and Dynatrace now tie resource utilization directly to spend, helping you spot idle workloads before finance does.
Beyond Features
I evaluate total cost of ownership closely because ingestion-based pricing can spiral fast—adding custom metrics or doubling log volume in platforms like Datadog or New Relic often triggers surprise overages that dwarf the original quote. Deployment flexibility matters just as much; I check whether a vendor offers SaaS, self-hosted, and air-gapped options, since regulated industries frequently need on-prem control that pure-SaaS tools can't deliver. I also look at ecosystem depth, specifically bidirectional ITSM integrations and open API coverage, so operations data flows into existing DevOps and ChatOps workflows without custom glue code.
Cómo elegir un software de gestión de operaciones de TI
Al decidir qué software de gestión de operaciones de TI se adapta mejor a tu entorno, empieza por centrarte en tus desafíos operativos más urgentes:
| Si tu prioridad es... | Busca... |
|---|---|
| Un análisis rápido y preciso de las causas raíz | Correlación de incidentes basada en IA y procedimientos automatizados |
| Entornos híbridos y multinube | Conectores nativos para entornos locales, AWS, Azure y GCP |
| Reducir las tareas manuales de corrección | Creadores visuales de flujos de trabajo con automatización prediseñada |
| Controlar el gasto relacionado con la supervisión | Precios transparentes basados en el uso y paneles de costes |
| Integraciones profundas con herramientas de gestión de servicios de TI | Conectores prediseñados y documentación de API abierta |
Cómo evaluar tu lista de selección
- Prueba los flujos de trabajo de clasificación de incidentes: Realiza una prueba de 48 horas y simula al menos tres tipos de interrupciones para verificar la agrupación de incidentes y las respuestas automatizadas.
- Solicita una demostración del mapa de topología: Pide al proveedor que genere un mapa de dependencias de extremo a extremo —incluidos los clústeres híbridos— utilizando datos de muestra reales o anonimizados.
- Abre un ticket multiplataforma: Abre un ticket de soporte relacionado con una integración multinube y documenta la precisión de las respuestas y los SLA durante un periodo de 3 días.
- Evalúa la integridad de los informes: Revisa o exporta un panel de análisis de muestra y confirma la visibilidad de los costes, los SLA y las métricas personalizadas de tu pila tecnológica real.
- Agilidad del SaaS frente al control del alojamiento propio: Decide si la rápida distribución de funciones del SaaS compensa las necesidades de cumplimiento y acceso que satisfacen las implementaciones locales o aisladas de la red.
¿Qué es el software de gestión de operaciones de TI?
El software de gestión de operaciones de TI es una categoría de herramientas diseñadas para supervisar, automatizar y gestionar la infraestructura de TI, las aplicaciones, las redes y los servicios en entornos locales y de nube. Estas plataformas ayudan a tu equipo a centralizar las alertas, mantener el estado de los sistemas, gestionar los incidentes y optimizar el uso de los recursos. Al consolidar los datos de operaciones y la automatización, el software de gestión de operaciones de TI facilita una resolución de problemas más rápida, impulsa la eficiencia y permite que tu organización escale la tecnología de forma fiable.
Funciones del software de gestión de operaciones de TI
Al seleccionar un software de gestión de operaciones de TI, presta atención a las siguientes funciones clave:
- Supervisión de la infraestructura y las aplicaciones: Supervisa servidores, redes, contenedores y aplicaciones en tiempo real. Te ayuda a detectar comportamientos anómalos del sistema, un rendimiento degradado o interrupciones antes de que afecten a los usuarios.
- Alertas y gestión de incidentes: Centraliza las alertas y agiliza los flujos de trabajo de escalamiento. Permite que tu equipo responda rápidamente, contextualice los incidentes y realice un seguimiento de su resolución de principio a fin.
- Automatización y orquestación: Proporciona herramientas para automatizar tareas rutinarias y coordinar flujos de trabajo en distintos entornos. Reduce el esfuerzo manual y mitiga los errores humanos durante las implementaciones o el mantenimiento.
- Compatibilidad con entornos híbridos y multinube: Ofrece visibilidad unificada en la infraestructura local, la nube privada y la nube pública. Te ayuda a gestionar entornos complejos como una única entidad operativa.
- Paneles y generación de informes personalizables: Te permite crear paneles e informes adaptados a tus necesidades. Facilita el análisis de tendencias, la supervisión de los SLA y el intercambio de información con las partes interesadas técnicas y empresariales.
- Integración y acceso a API: Se conecta con plataformas de ITSM, DevOps y colaboración. Permite que tu equipo incorpore directamente los datos de operaciones de TI en sistemas de emisión de tickets, chat y otros sistemas.
- Mapeo de topología y dependencias: Visualiza las relaciones entre sistemas, servicios y componentes de la infraestructura. Facilita el rastreo de la causa raíz de los incidentes y la comprensión del riesgo operativo.
- Control de acceso basado en usuarios y roles: Te permite definir quién puede ver o editar partes de tu entorno. Protege los datos confidenciales y limita la exposición según las responsabilidades de cada usuario.
- Planificación y previsión de capacidad: Analiza las tendencias del consumo de recursos para predecir las necesidades futuras. Te ayuda a anticipar las actualizaciones de la infraestructura y a presupuestar el crecimiento.
- Seguimiento de cambios y registros de auditoría: Registra los cambios de configuración y las acciones de los usuarios. Facilita el cumplimiento de los requisitos normativos y ayuda a solucionar incidentes anteriores al proporcionar un historial claro de cambios.
Funciones de AI habituales del software de gestión de operaciones de TI
Además de las funciones estándar del software de gestión de operaciones de TI mencionadas anteriormente, muchas de estas soluciones están incorporando AI con funciones como:
- Detección de anomalías basada en AI: Utiliza el aprendizaje automático para identificar automáticamente patrones o comportamientos inusuales en las métricas del sistema, los registros o el tráfico de red. Esto ayuda a tu equipo a detectar problemas emergentes antes de que se agraven, incluso cuando los umbrales no se han establecido manualmente.
- Análisis automatizado de la causa raíz: Aplica algoritmos de AI para correlacionar eventos, registros y datos de rendimiento en toda tu pila tecnológica. Esta función señala el origen probable de los incidentes, reduce el tiempo que tu equipo dedica a investigar y acelera la recuperación.
- Previsión predictiva de incidentes: Utiliza datos históricos y modelos de AI para anticipar posibles interrupciones o degradaciones del rendimiento. Esto te permite tomar medidas proactivas para prevenir incidentes y planificar el mantenimiento de forma más eficaz.
- Reducción inteligente del ruido de las alertas: Utiliza AI para agrupar alertas relacionadas, suprimir duplicados y priorizar las notificaciones según su impacto y contexto. Reduce la fatiga causada por las alertas y garantiza que tu equipo se concentre en los problemas más importantes.
- Sugerencias de solución basadas en AI: Analiza los datos de los incidentes y las resoluciones anteriores para recomendar los pasos siguientes o soluciones automatizadas. Esto ayuda a tu equipo a responder más rápido y estandariza las prácticas recomendadas en todas tus operaciones.
Beneficios del software de gestión de operaciones de TI
La implementación de un software de gestión de operaciones de TI proporciona varios beneficios para tu equipo y tu empresa. Estos son algunos de los que puedes esperar:
- Visibilidad centralizada: Unifica la supervisión de servidores, redes, aplicaciones y recursos en la nube mediante un único panel, para que tu equipo se mantenga al tanto de los problemas en todos los entornos.
- Resolución más rápida de incidentes: Utiliza la agregación de alertas, la correlación basada en IA y las funciones automatizadas de análisis de causa raíz para identificar, priorizar y responder rápidamente a los problemas operativos.
- Menor esfuerzo manual: Automatiza las tareas recurrentes de mantenimiento, corrección y flujo de trabajo mediante herramientas prediseñadas de automatización y orquestación, liberando tiempo para iniciativas de mayor valor.
- Gestión proactiva de riesgos: Predice interrupciones y cuellos de botella de recursos con herramientas de detección de anomalías y pronóstico basadas en IA que identifican posibles problemas antes de que se agraven.
- Optimización de costes y recursos: Supervisa el uso de la infraestructura, el rendimiento de las aplicaciones y el gasto en recursos mediante funciones de informes y análisis, lo que te ayuda a gestionar los presupuestos y planificar la capacidad.
- Mayor seguridad y cumplimiento: Confía en los controles de acceso de usuarios, los registros de auditoría y las funciones de seguimiento de cambios para proteger los datos confidenciales y cumplir los requisitos normativos.
- Integración fluida con el ecosistema: Conecta plataformas de ITSM, DevOps y chat mediante integraciones prediseñadas y API abiertas, lo que facilita incorporar los datos operativos a la forma en que tu equipo ya trabaja.
Costes y precios del software de gestión de operaciones de TI
La selección de un software de gestión de operaciones de TI requiere comprender los distintos modelos de precios y planes disponibles. Los costes varían según las funciones, el tamaño del equipo, los complementos y otros factores. La siguiente tabla resume los planes habituales, sus precios medios y las funciones que suelen incluir las soluciones de software de gestión de operaciones de TI:
Tabla comparativa de planes de software de gestión de operaciones de TI
| Tipo de plan | Precio medio | Funciones habituales |
|---|---|---|
| Plan gratuito | $0 | Supervisión básica de la infraestructura, alertas limitadas, acceso para equipos pequeños y asistencia de la comunidad. |
| Plan personal | $10–$30/usuario/mes | Supervisión en tiempo real, automatización básica, paneles básicos, integración con herramientas populares y asistencia por correo electrónico. |
| Plan empresarial | $40–$80/usuario/mes | Supervisión de toda la pila, gestión de alertas e incidentes, automatización de flujos de trabajo, paneles avanzados, acceso a la API y control de acceso basado en roles. |
| Plan corporativo | $90–$200/usuario/mes | Visibilidad híbrida y multicloud, funciones basadas en IA, SLA personalizados, asistencia para el cumplimiento, integraciones específicas y asistencia prémium. |
Preguntas frecuentes sobre el software de gestión de operaciones de TI
Estas son algunas respuestas a preguntas frecuentes sobre el software de gestión de operaciones de TI:
¿Cómo se comparan las distintas plataformas de software de gestión de operaciones de TI?
Empieza por enumerar las funciones imprescindibles, como la compatibilidad con múltiples nubes, la automatización y el nivel de integración. Después, prueba las plataformas utilizando escenarios habituales de incidentes y compara cómo gestiona cada herramienta las alertas, el análisis de la causa raíz y los informes. También es importante examinar el coste total de propiedad, las integraciones con el ecosistema y la flexibilidad de implementación antes de tomar una decisión final.
¿Puede el software de gestión de operaciones de TI automatizar la respuesta ante incidentes?
Sí, la mayoría de los programas modernos de gestión de operaciones de TI permiten automatizar la respuesta ante incidentes mediante runbooks, creadores de flujos de trabajo e incluso corrección automática basada en IA. Esto ayuda a reducir los pasos manuales y garantiza una respuesta coherente ante problemas recurrentes.
¿Qué integraciones debo buscar en un software de gestión de operaciones de TI?
Busca acceso a API, conectores prediseñados para herramientas de ITSM (como ServiceNow), plataformas de chat (como Slack o Microsoft Teams) y canalizaciones de DevOps. Las integraciones profundas permiten a tu equipo enviar alertas, activar flujos de trabajo y sincronizar tickets entre los sistemas existentes sin necesidad de middleware personalizado.
¿Ayuda el software de gestión de operaciones de TI con el cumplimiento normativo y las auditorías?
Sí, un software sólido de gestión de operaciones de TI realiza un seguimiento de los cambios del sistema y las acciones de los usuarios, y proporciona los registros de auditoría necesarios para el cumplimiento normativo. Esto resulta especialmente útil en sectores regulados, donde se necesitan pruebas claras de los controles y un historial completo de cambios para los informes.
¿Cómo puedo evitar costes inesperados con un software de gestión de operaciones de TI?
Revisa siempre cómo cobra la plataforma por la ingesta de datos, las métricas personalizadas y las cuentas de usuario. Elige herramientas con precios transparentes basados en el uso y paneles de costes integrados en la aplicación, para poder supervisar el gasto y evitar excesos inesperados a medida que crece tu entorno.
¿Cuál es la mejor manera de conseguir el apoyo de las partes interesadas para una nueva plataforma de gestión de operaciones de TI?
Muestra cómo la plataforma ayuda a alcanzar los objetivos empresariales: una resolución más rápida de los incidentes, una gestión proactiva de los riesgos y una mejora de los informes. Comparte una demostración o los resultados de un proyecto piloto, destaca las eficiencias previstas y relaciona las funciones con los problemas que las partes interesadas reconocen.