

Databricks frente a Cloudera: Comparación y reseñas para 2026
Elegir entre Databricks y Cloudera depende de cómo gestiona tu equipo los datos en entornos de nube e híbridos. Comparo sus fortalezas, desventajas y casos de uso más adecuados.

Revisamos herramientas de forma independiente y las comisiones ayudan a financiar nuestras pruebas. Consulta nuestra política de transparencia, nuestra metodología o sugiere una herramienta.
As data environments spread across cloud, on-premises systems, and multiple pipelines, keeping ingestion and transformation workflows consistent gets harder. The right DataOps tool should help teams manage that complexity without creating more operational overhead.
Databricks and Cloudera both support large-scale data engineering and analytics, but they solve the problem from different starting points. Databricks centers on a lakehouse model with managed pipelines, streaming, governance, and AI, while Cloudera emphasizes hybrid data operations across cloud, data center, and edge environments.
In this article, I compare Databricks and Cloudera across features, pricing, security, ease of use, and best-fit scenarios to help you decide which platform suits your data strategy and infrastructure.
Databricks
4.5/5
- Free edition available + 14-day free trial
- From $0.15/DBU
Cloudera
4.1/5
- 60-day free trial
- From $0.04/CCU/hour
Por qué confiar en nuestras recomendaciones de software
6,700+
Reviews
20
Industry experts
16+
Evaluation factors
14
Years
Nuestro equipo lleva probando y evaluando software desde 2012. Como líderes tecnológicos, sabemos lo difícil —y lo importante— que es elegir el software adecuado.
Para esta guía, evaluamos las herramientas mediante pruebas prácticas e investigación independiente, puntuando las herramientas según nuestros criterios de selección.
Nuestras reseñas reflejan nuestro criterio editorial humano, no un discurso de ventas.
Revisores expertos:
- Paulo Gardini MiguelDirector técnico
 Tim FisherVP de IA
 Gabriel RosasTech Lead y arquitecto de software
 Christhian GruhnTech Lead y arquitecto de plataforma

| Databricks | Cloudera | |
|---|---|---|
| Free Trial | Free edition available + 14-day free trial | 60-day free trial |
| Pricing | From $0.15/DBU | From $0.04/CCU/hour |
Precios y costes ocultos de Databricks frente a Cloudera
Databricks utiliza un modelo de precios basado en el consumo para la ingeniería de datos, el almacenamiento de datos, la IA y otras cargas de trabajo, con costes determinados por el uso de la computación, además de la infraestructura en la nube, el almacenamiento, las redes y el soporte. Cloudera adopta un enfoque híbrido: sus servicios en la nube se facturan según el consumo mediante Cloudera Compute Units (CCU), mientras que las implementaciones locales utilizan suscripciones anuales. En ambos casos, la infraestructura y las redes pueden aumentar el coste total más allá de las tarifas básicas de la plataforma.
Al comparar ambas opciones, conviene mirar más allá de los precios anunciados y determinar dónde se ejecutarán las cargas de trabajo y con qué frecuencia se ejecutan las canalizaciones, los trabajos de transmisión y las transformaciones. Con Databricks, una computación ineficiente o de larga duración y la transferencia de datos pueden aumentar el gasto. Cloudera, por su parte, puede añadir costes mediante la infraestructura, las redes, Private Link, la observabilidad y servicios como Data Flow o Lakehouse Optimizer. Tener en cuenta el modelo de implementación, el volumen de las cargas de trabajo, el soporte y las necesidades de escalabilidad proporcionará una visión más realista del coste a largo plazo.
| Databricks | Cloudera | |
|---|---|---|
| A/B Testing | No | No |
| Analytics | Yes | Yes |
| API | Yes | Yes |
| Conversion Tracking | No | No |
| Custom Reports | Yes | Yes |
| Dashboards | Yes | Yes |
| Data Export | Yes | Yes |
| Data Import | Yes | Yes |
| Data Mining | Yes | Yes |
| Data Visualization | Yes | Yes |
| External Integrations | Yes | Yes |
| Forecasting | Yes | Yes |
| Keyword Tracking | No | No |
| Link Tracking | No | No |
| Multi-User | Yes | Yes |
| Notifications | Yes | Yes |
| Reports | Yes | Yes |
| Scenario Planning | No | No |
| SEO | No | No |
| Visualization | Yes | Yes |
| Integración | Databricks | Cloudera |
|---|---|---|
| IntegraciónMicrosoft Azure | Databricks✅ | Cloudera✅ |
| IntegraciónAmazon Web Services | Databricks✅ | Cloudera✅ |
| IntegraciónGoogle Cloud Platform | Databricks✅ | Cloudera✅ |
| IntegraciónTableau | Databricks✅ | Cloudera✅ |
| IntegraciónInformatica | Databricks✅ | Cloudera✅ |
| IntegraciónSalesforce | Databricks✅ | Cloudera✅ |
| IntegraciónQlik | Databricks✅ | Cloudera✅ |
| IntegraciónOracle Database | Databricks✅ | Cloudera✅ |
| IntegraciónMongoDB | Databricks✅ | Cloudera✅ |
| IntegraciónAPI | Databricks✅ | Cloudera✅ |
| IntegraciónZapier | Databricks✅ | Cloudera❌ |
Tanto Databricks como Cloudera admiten amplios ecosistemas de plataformas en la nube, bases de datos, herramientas de BI, API y servicios de datos. Databricks integra estas conexiones en Lakeflow, Partner Connect y sus flujos de trabajo gestionados de ingeniería de datos, mientras que Cloudera hace hincapié en la conectividad entre entornos en la nube, locales e híbridos.
| Factor | Databricks | Cloudera |
|---|---|---|
| FactorCifrado | DatabricksCifra los datos en reposo y en tránsito, con compatibilidad con claves administradas por el cliente, gestión de claves nativa de la nube y protección granular para los datos y recursos de IA gobernados. | ClouderaAdmite el cifrado en reposo y en tránsito, la gestión de claves y controles de seguridad en entornos de nube y locales. |
| FactorControles de acceso | DatabricksUnity Catalog centraliza las políticas de acceso detalladas en datos, modelos, aplicaciones y recursos de IA, con SSO, integraciones de identidad, controles de filas y columnas, y vinculaciones de espacios de trabajo. | ClouderaUtiliza Apache Ranger, Knox e integraciones de identidad para gestionar la autenticación, la autorización, el SSO y el acceso detallado en entornos híbridos. |
| FactorCumplimiento normativo | DatabricksCuenta con las certificaciones SOC 1 Type II, SOC 2 Type II, ISO 27001, ISO 27017 e ISO 27018, además de compatibilidad con el cumplimiento de HIPAA, PCI DSS, HITRUST y FedRAMP Moderate y High, según la nube, la región y la configuración. | ClouderaMantiene certificaciones y programas como SOC 2 Type II, ISO 27001, PCI DSS y FedRAMP Moderate para los entornos de Cloudera que cumplen los requisitos. |
| FactorFiabilidad | DatabricksAdmite el escalado automático, la computación sin servidor y administrada, el aislamiento de cargas de trabajo y la disponibilidad nativa de la nube en AWS, Azure y Google Cloud, con estrategias de recuperación configuradas según los requisitos de cada carga de trabajo. | ClouderaAdmite implementaciones multizona, infraestructura redundante, conmutación por error y recuperación ante desastres en implementaciones en la nube e híbridas. |
| FactorGobernanza de datos | DatabricksUnity Catalog proporciona auditoría, descubrimiento, clasificación y linaje automatizado centralizados, desde los datos de origen hasta los cuadernos, trabajos, modelos, servicios y paneles. | ClouderaSDX combina Apache Ranger y Atlas para aplicar políticas, auditoría, gestión de metadatos, clasificación y linaje en datos de la nube y locales. |
Ambas plataformas proporcionan seguridad y gobernanza de nivel empresarial, pero el enfoque es diferente. Databricks reúne el control de acceso, la auditoría, la clasificación y el linaje mediante Unity Catalog en las cargas de trabajo de datos e IA, mientras que Cloudera amplía la gobernanza centralizada a entornos híbridos y locales mediante SDX, Ranger y Atlas.
| Factor | Databricks | Cloudera |
|---|---|---|
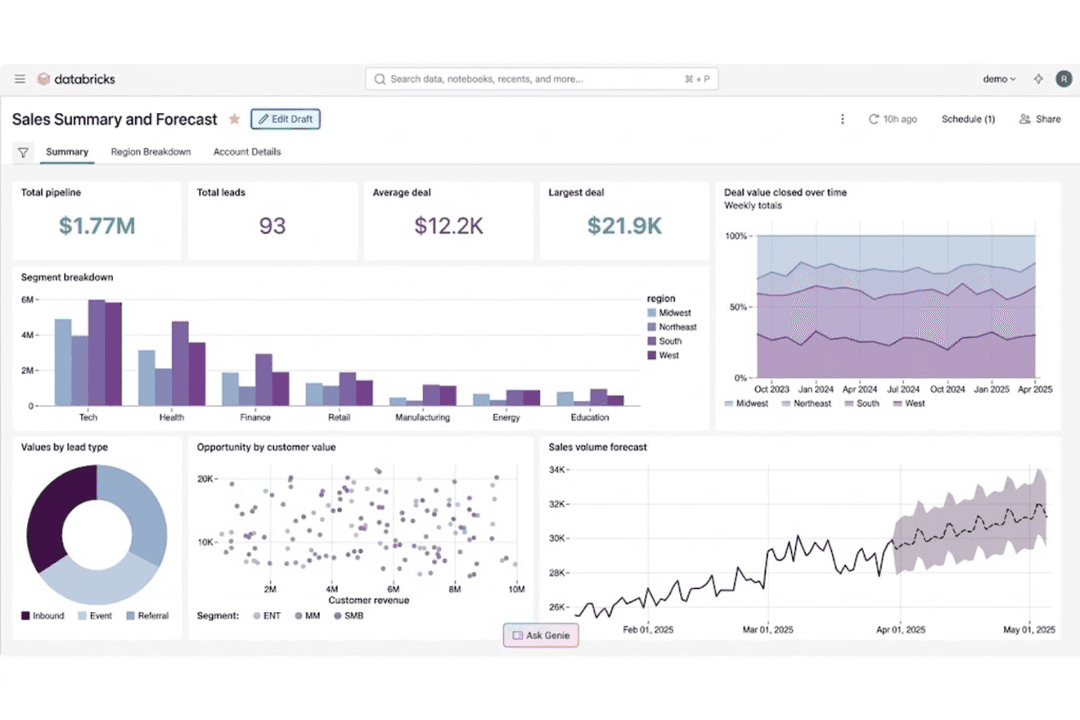
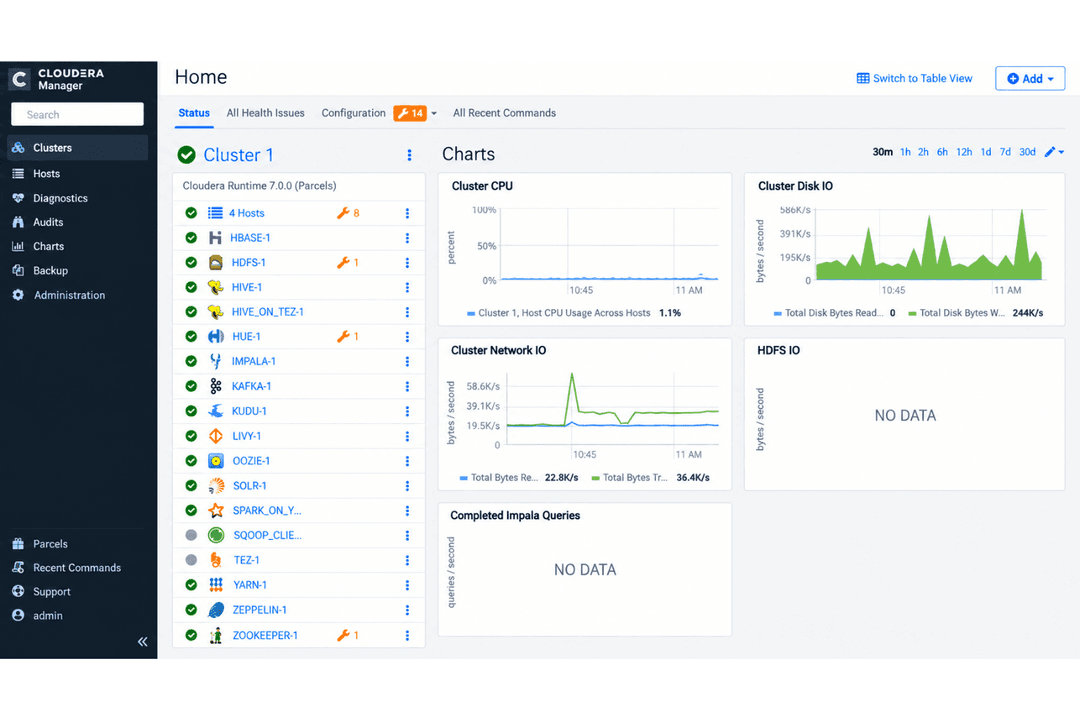
| FactorInterfaz de usuario | DatabricksCombina cuadernos colaborativos, herramientas SQL, paneles y flujos de trabajo visuales en un solo espacio de trabajo para equipos de ingeniería, análisis e IA. | ClouderaUtiliza consolas administrativas e interfaces específicas de cada servicio para gestionar los datos y la infraestructura híbrida. |
| FactorProceso de configuración | DatabricksLos espacios de trabajo en la nube pueden aprovisionarse rápidamente, mientras que la computación sin servidor y administrada reduce la configuración de la infraestructura para las cargas de trabajo habituales. | ClouderaLa configuración depende del modelo de implementación, con configuraciones adicionales para entornos híbridos y locales. |
| FactorIncorporación | DatabricksProporciona una configuración guiada, cuadernos de ejemplo, formación y servicios administrados que ayudan a los equipos a pasar de la experimentación inicial a flujos de trabajo de producción gobernados. | ClouderaRequiere familiaridad con su ecosistema más amplio, especialmente cuando los equipos trabajan con tecnologías como NiFi, Spark, Ranger e infraestructura híbrida. |
| FactorDocumentación | DatabricksOfrece amplia documentación, tutoriales, orientación para la implementación y formación sobre ingeniería de datos, gobernanza, análisis e IA. | ClouderaProporciona documentación técnica sobre la nube, entornos locales, seguridad y administración de la plataforma. |
| FactorAcceso al soporte | DatabricksOfrece recursos públicos y soporte de pago por niveles, con contactos técnicos, vías de escalado y cobertura de problemas críticos para implementaciones empresariales. | ClouderaIncluye soporte empresarial y recursos técnicos para sus ofertas en la nube y locales. |
Desde el punto de vista de la facilidad de uso, Databricks combina un entorno de desarrollo técnico con servicios administrados que reducen el trabajo de infraestructura en canalizaciones, análisis e IA. Cloudera admite entornos en la nube, locales e híbridos, lo que implica consideraciones adicionales de implementación. Para los equipos de datos centrados en la nube, Databricks proporciona un flujo de trabajo unificado desde el desarrollo hasta la producción, mientras que Cloudera se adapta a las organizaciones que necesitan operar con una infraestructura mixta.
Databricks
- Unifies data engineering, analytics, governance, and AI workloads, reducing the need to maintain separate platforms and duplicate data
- Built on open technologies like Delta Lake and Apache Spark, giving teams more flexibility and portability than proprietary data formats
- Unity Catalog applies governance and access policies consistently across data and workloads, which is useful for complex or multi-cloud environments
- Usage-based pricing can become difficult to predict as workloads grow, especially without careful compute and query optimization
- Requires strong technical expertise in areas like SQL, Python, Spark, and data engineering to get full value from the platform
- Can be excessive for teams with simple reporting or low-volume analytics needs, where the platform’s complexity may outweigh the benefits
Cloudera
- Handles petabyte-scale datasets with strong data governance tools
- Flexible deployment across on-premises, private, and public clouds
- Open-source architecture with full control over data location
- Interface is complex for smaller or less technical teams
- Initial setup and onboarding can be time-consuming
- Performance tuning requires deep technical expertise
Databricks
- Large EnterprisesOrganizations with multiple data teams and high-volume workloads can use Databricks to centralize data engineering, analytics, governance, and AI while reducing duplicated data and tooling.
- Financial ServicesBanks, insurers, and other financial organizations can use Databricks for governed analytics, fraud detection, risk modeling, and machine learning across sensitive datasets.
- Healthcare and Life SciencesHealthcare and life sciences teams can manage large, sensitive datasets while applying centralized governance to analytics, research, and AI workloads.
- Retail and Consumer GoodsRetailers can combine customer, transaction, inventory, and operational data for forecasting, personalization, supply chain analytics, and machine learning.
- ManufacturingManufacturers can bring together operational, IoT, and enterprise data for predictive maintenance, production analytics, forecasting, and AI-driven optimization.
- Technology and SoftwareTechnology companies with data-intensive products or services can use Databricks for large-scale pipelines, real-time analytics, ML development, and AI applications.
Cloudera
- Financial ServicesCloudera’s advanced governance, lineage, and security features make it a reliable fit for meeting banking and financial regulatory demands.
- Healthcare & Life SciencesStrict data governance, in-depth audit trails, and hybrid cloud options match healthcare’s compliance and privacy requirements.
- TelecommunicationsManaging massive data pipelines is easier with Cloudera’s Apache Spark, Kafka, and NiFi integrations.
- Large EnterprisesCloudera’s hybrid deployment support and control over complex infrastructures suit organizations with diverse, global operations.
- Data Engineering TeamsNative integration with tools like Apache Airflow, Impala, and Hive gives data engineers extensive workflow and processing flexibility.
- Government AgenciesFull data residency control, advanced security controls, and detailed auditing cater to public sector compliance standards.
¿Quién debería utilizar Databricks y quién debería utilizar Cloudera?
Si buscas una plataforma DataOps que reúna la ingeniería de datos, el análisis, la gobernanza y la IA en el mismo entorno centrado en la nube, Databricks probablemente sea la opción más adecuada. Es especialmente útil para los equipos que quieren canalizaciones administradas, cuadernos colaborativos, compatibilidad con el procesamiento de flujos y gobernanza centralizada sin tener que gestionar tanta infraestructura manualmente.
Si, en cambio, necesitas ejecutar flujos de trabajo de datos en entornos de nube, locales e híbridos, Cloudera puede adaptarse mejor a tu infraestructura. Es una opción sólida para empresas con estrictos requisitos de cumplimiento o residencia de datos, ecosistemas consolidados de código abierto y equipos que gestionan plataformas de datos distribuidas en múltiples entornos.
| Databricks | Cloudera | |
|---|---|---|
| Compute & Development | Databricks Workload-aware compute, autoscaling, and collaborative notebooks support engineering, SQL, and AI workloads without provisioning everything for peak demand. | Cloudera Provides configurable compute and data services designed to operate across cloud and on-premises infrastructure. |
| Data Intelligence | Databricks Its Data Intelligence Engine uses organizational metadata and context to improve discovery, governance, optimization, analytics, and AI workflows. | Cloudera Uses metadata, cataloging, and platform services to manage data and analytics across distributed environments. |
| Deployment Model | Databricks Runs as a cloud-native platform across AWS, Azure, and Google Cloud, with managed and serverless compute reducing infrastructure work across data and AI workloads. | Cloudera Extends across public cloud, private cloud, on-premises data centers, and edge environments. |
| Governance Model | Databricks Unity Catalog centralizes access policies, auditing, discovery, and lineage across data, models, applications, and AI assets. | Cloudera SDX combines technologies such as Apache Ranger and Atlas for policy enforcement, auditing, metadata, and lineage. |
| Lakehouse Foundation | Databricks Combines warehousing, engineering, BI, ML, and AI on a lakehouse built around open technologies such as Delta Lake and Apache Spark. | Cloudera Uses an open lakehouse approach based on technologies such as Apache Iceberg, HDFS, and the broader Apache ecosystem. |
| Analytics & Machine Learning | Both support SQL analytics, data science, machine learning, and AI workloads within their broader data platforms. |
|---|---|
| Apache Spark Support | Both use Apache Spark for distributed data processing and large-scale engineering workloads. |
| Batch & Streaming | Both process batch and real-time data for analytics, operational workflows, and downstream applications. |
| Data Integration & ETL | Both support ingestion, transformation, orchestration, and monitoring for large-scale data pipelines. |
| Integrations & APIs | Both connect with major cloud platforms, databases, BI tools, and enterprise systems and provide APIs for extending workflows. |